
فصل ۱۲: تشخیص شیء
در فصل قبل، قطعهبندی تصویر را بررسی کردیم: فرایند انتساب یک برچسب کلاس به هر پیکسل منفرد در یک تصویر. این کار به شما امکان میدهد اشیاء مجزا را شناسایی کرده و خطوط پیرامونی دقیق آنها را ترسیم کنید.
یکی دیگر از کاربردهای بسیار متداول در بینایی ماشین، تشخیص شیء (object detection) است: ترسیم مستطیلهایی به دور اشیاء درون یک تصویر و برچسبگذاری هر مستطیل با یک کلاس مشخص، همانطور که در شکل ۱۲.۱ نشان داده شده است.1 به این مستطیلها کادرهای محدودکننده (bounding boxes) گفته میشود. تشخیص شیء معمولاً شامل شناسایی کادرها به همراه طبقهبندی آنها میشود — به عنوان مثال، یافتن کادرهایی که شامل انسان، سگ، خودرو و غیره هستند. این کار به شما امکان میدهد نه تنها بدانید چه اشیایی در یک تصویر قرار دارند، بلکه بدانید در کجای تصویر قرار گرفتهاند. برخی از رایجترین کاربردهای آن عبارتند از:
- شمارش (Counting) — مشخص کردن اینکه چه تعداد نمونه از یک شیء در یک تصویر وجود دارد.
- ردیابی (Tracking) — ردیابی نحوهٔ حرکت اشیاء در طول زمان در یک صحنه با انجام تشخیص شیء روی تکتک فریمهای یک فیلم.
- برش / کادربندی (Cropping) — شناسایی ناحیهای از تصویر که شامل شیء مورد نظر است تا برش داده شود و نسخهای با وضوح بالاتر از آن وصلهٔ تصویر به یک طبقهبند یا یک مدل تشخیص نوری نویسهها (OCR) ارسال شود.
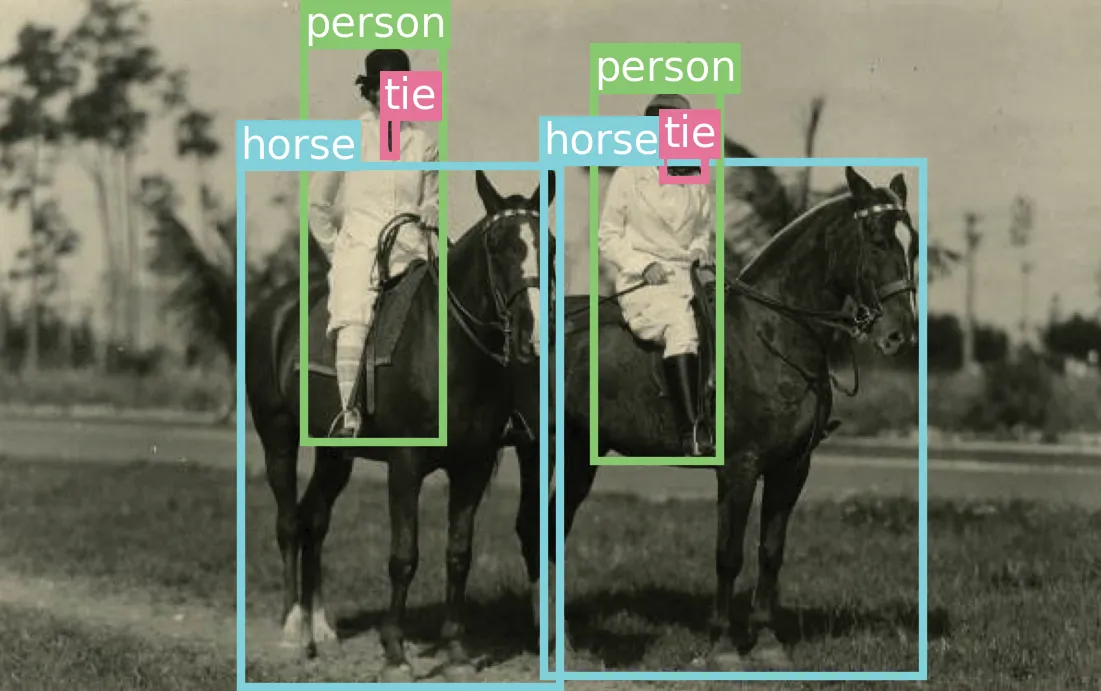
شکل ۱۲.۱: آشکارسازهای شیء کادرهایی به دور اشیاء درون تصویر ترسیم کرده و آنها را برچسبگذاری میکنند.
اگر با دقت به آن فکر کنید، تشخیص شیء در واقع نوعی نسخهٔ ضعیفتر از قطعهبندی نمونه (instance segmentation) است: با تعیین یک کادر محدودکننده برای هر شیء، شما در واقع یک ماسک پیکسلبهپیکسل بسیار تقریبی برای آن شیء ارائه میدهید — ماسکی که فقط یک مستطیل است. اگر یک مدل قطعهبندی نمونه داشته باشید، همیشه میتوانید با یافتن مستطیلهای محاطکنندهٔ ماسکهای تولیدشده برای اشیاء مختلف، خروجیهای آن را به کادرهای محدودکننده تبدیل کنید. بنابراین، یک مدل قطعهبندی تصویر تمام اطلاعاتی را که توسط یک مدل تشخیص شیء بازگردانده میشود — به علاوهٔ مقدار بسیار بیشتری اطلاعات — به دست میدهد. این ثروت افزوده از اطلاعات، هزینهٔ محاسباتی قابل توجهی به همراه دارد: یک مدل تشخیص شیء خوب معمولاً بسیار سریعتر از یک مدل قطعهبندی تصویر اجرا میشود. همچنین هزینهٔ برچسبگذاری داده دارد: برای آموزش یک مدل قطعهبندی، باید ماسکهای دقیق پیکسلی جمعآوری کنید که تولید آنها بسیار زمانبرتر از کادرهای محدودکنندهٔ سادهٔ مورد نیاز در مدلهای تشخیص شیء است.
در نتیجه، اگر نیازی به اطلاعات در سطح پیکسل ندارید — به عنوان مثال، اگر تمام آنچه میخواهید شمارش اشیاء در یک تصویر است — همیشه ترجیح میدهید از یک مدل تشخیص شیء استفاده کنید.
آشکارسازهای شیء تکمرحلهای در برابر دومرحلهای
Section titled “آشکارسازهای شیء تکمرحلهای در برابر دومرحلهای”دو دستهٔ کلی از معماریهای تشخیص شیء وجود دارد:
- آشکارسازهای دومرحلهای که ابتدا پیشنهادهای ناحیه را استخراج میکنند، معروف به مدلهای شبکههای عصبی کانولوشنی مبتنی بر ناحیه (R-CNN)
- آشکارسازهای تکمرحلهای، مانند RetinaNet یا خانوادهٔ مدلهای You Only Look Once (YOLO)
در اینجا نحوهٔ کارکرد آنها آمده است.
آشکارسازهای دومرحلهای R-CNN
Section titled “آشکارسازهای دومرحلهای R-CNN”یک ConvNet مبتنی بر ناحیه، یا مدل R-CNN، یک مدل دومرحلهای است. مرحلهٔ اول تصویری را دریافت کرده و چند هزار کادر محدودکننده با همپوشانی جزئی به دور مناطقی که شبیه شیء به نظر میرسند تولید میکند. به این کادرها پیشنهادهای ناحیه (region proposals) گفته میشود. این مرحله چندان هوشمند نیست، بنابراین در آن نقطه هنوز کاملاً مطمئن نیستیم که آیا نواحی پیشنهادی واقعاً حاوی اشیاء هستند یا خیر، و اگر هستند، چه اشیایی در آنها قرار دارد.
این وظیفهٔ مرحلهٔ دوم است — یک ConvNet که به هر پیشنهاد ناحیه نگاه میکند و آن را در تعدادی کلاس از پیش تعیینشده طبقهبندی مینماید، درست مانند مدلهایی که در فصل ۹ دیدید (شکل ۱۲.۲ را ببینید). پیشنهادهای ناحیهای که امتیاز پایینی در تمام کلاسهای مد نظر دارند دور ریخته میشوند. سپس با مجموعهٔ بسیار کوچکتری از کادرها مواجه میشویم که هر کدام امتیاز بالایی برای حضور یک کلاس خاص دارند. در نهایت، کادرهای محدودکننده به دور هر شیء بیشتر اصلاح و تنظیم میشوند تا موارد تکراری حذف شده و هر کادر محدودکننده تا حد ممکن دقیق شود.
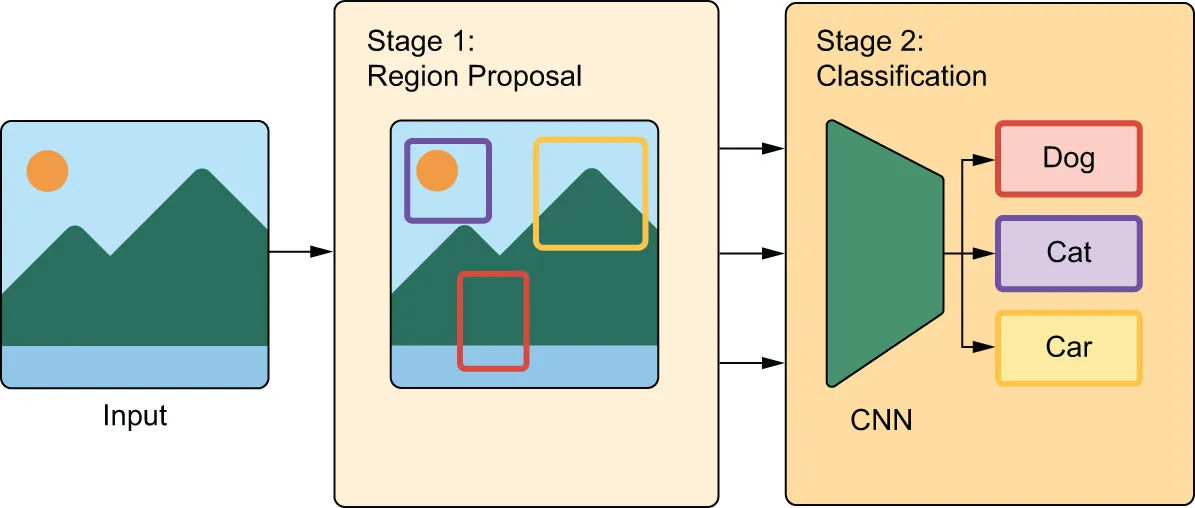
شکل ۱۲.۲: یک R-CNN ابتدا پیشنهادهای ناحیه را استخراج کرده و سپس این پیشنهادها را با یک ConvNet (یک CNN) طبقهبندی میکند.
در نسخههای اولیهٔ R-CNN، مرحلهٔ اول یک مدل ابتکاری (heuristic model) به نام Selective Search بود که از تعریفی از سازگاری فضایی برای شناسایی مناطق شیءمانند استفاده میکرد. هیوریستیک یا ابتکاری اصطلاحی است که در یادگیری ماشین بسیار خواهید شنید — این واژه صرفاً به معنای «مجموعهای از قوانین با کدنویسی سخت است که شخصی آنها را ابداع کرده است». این اصطلاح معمولاً در برابر مدلهای یادگرفتهشده (که در آنها قوانین به طور خودکار استخراج میشوند) یا مدلهای برگرفته از نظریه به کار میرود. در نسخههای بعدی R-CNN، مانند Faster-R-CNN، مرحلهٔ تولید کادر به یک مدل یادگیری عمیق به نام شبکهٔ پیشنهاد ناحیه (Region Proposal Network) تبدیل شد.
رویکرد دومرحلهای R-CNN در عمل بسیار خوب کار میکند، اما از نظر محاسباتی بسیار سنگین است، به ویژه به این دلیل که شما را ملزم میکند هزاران وصله (patch) را — برای تکتک تصاویری که پردازش میکنید — طبقهبندی نمایید. این امر آن را برای بیشتر کاربردهای بلادرنگ و سیستمهای تعبیهشده نامناسب میسازد. نظر شخصی من این است که در کاربردهای عملی، شما معمولاً هرگز به یک سیستم تشخیص شیء محاسباتی سنگین مانند R-CNN نیاز ندارید؛ زیرا اگر در حال انجام استنتاج در سمت سرور با یک GPU قدرتمند هستید، احتمالاً بهتر است به جای آن از یک مدل قطعهبندی مانند مدل Segment Anything که در فصل قبل دیدیم استفاده کنید. و اگر از نظر منابع محدود هستید، آنگاه میخواهید از یک معماری تشخیص شیء با کارایی محاسباتی بالاتر — یعنی یک آشکارساز تکمرحلهای — استفاده نمایید.
آشکارسازهای تکمرحلهای
Section titled “آشکارسازهای تکمرحلهای”در حدود سال ۲۰۱۵، پژوهشگران و متخصصان شروع به آزمایش استفاده از یک مدل یادگیری عمیق واحد کردند تا مختصات کادرهای محدودکننده را همراه با برچسبهای آنها به طور همزمان پیشبینی کند؛ معماریای که آشکارساز تکمرحلهای (single-stage detector) نامیده میشود. خانوادههای اصلی آشکارسازهای تکمرحلهای عبارتند از RetinaNet، آشکارسازهای MultiBox تکشلیک (SSD)، و خانوادهٔ You Only Look Once که به اختصار YOLO نامیده میشود. بله، درست مثل میم اینترنتی؛ که البته کاملاً عمدی است.
آشکارسازهای تکمرحلهای، به ویژه تکرارهای اخیر YOLO، به سرعتهای قابل توجهی بالاتر و کارایی بیشتری نسبت به همتایان دومرحلهای خود میبالند، هرچند با مصالحهای اندک در دقت همراه هستند. امروزه، YOLO بدون شک محبوبترین مدل تشخیص شیء در دسترس است، به ویژه زمانی که پای کاربردهای بلادرنگ به میان میآید. معمولاً نسخهٔ جدیدی از آن هر سال عرضه میشود — جالب است بدانید که هر نسخهٔ جدید معمولاً توسط یک سازمان مستقل توسعه مییابد.
در بخش بعدی، ما یک مدل سادهشدهٔ YOLO را از ابتدا خواهیم ساخت.
آموزش یک مدل YOLO از ابتدا
Section titled “آموزش یک مدل YOLO از ابتدا”به طور کلی، ساخت یک آشکارساز شیء میتواند تا حدودی یک پروژهٔ پرزحمت باشد — نه به این دلیل که از نظر تئوری پیچیدگی خاصی دارد، بلکه صرفاً به دلیل حجم زیاد کدی است که برای دستکاری کادرهای محدودکننده و خروجیهای پیشبینیشده مورد نیاز است. برای ساده نگه داشتن قضایا، ما همان اولین مدل YOLO از سال ۲۰۱۵ را بازسازی خواهیم کرد. در زمان نگارش این کتاب ۱۲ نسخه از YOLO وجود دارد، اما کار با نسخهٔ اصلی کمی سادهتر است.
دانلود مجموعهدادهٔ COCO
Section titled “دانلود مجموعهدادهٔ COCO”قبل از شروع ساخت مدل، به دادههایی برای آموزش نیاز داریم. مجموعهدادهٔ COCO1، که مخفف اشیاء متداول در بافتار (Common Objects in Context) است، یکی از شناختهشدهترین و پرکاربردترین مجموعهدادههای تشخیص شیء است. این مجموعهداده شامل عکسهای دنیای واقعی از منابع مختلف به همراه حاشیهنویسیهای ایجادشده توسط انسان است. این موارد شامل برچسبهای شیء، حاشیهنویسیهای کادر محدودکننده، و ماسکهای کامل قطعهبندی میشوند. ما از ماسکهای قطعهبندی صرفنظر کرده و تنها از کادرهای محدودکننده استفاده خواهیم کرد.
بیایید نسخهٔ ۲۰۱۷ مجموعهدادهٔ COCO را دانلود کنیم. هرچند با استانداردهای امروزی مجموعهدادهٔ بزرگی محسوب نمیشود، اما این مجموعهدادهٔ ۱۸ گیگابایتی بزرگترین مجموعهدادهای خواهد بود که در این کتاب استفاده میکنیم. اگر همزمان با مطالعه در حال اجرای کد هستید، این فرصت خوبی برای استراحت است.
لیستینگ ۱۲.۱: دانلود مجموعهدادهٔ COCO 2017
import kerasimport keras_hub
images_path = keras.utils.get_file(    "coco",    "http://images.cocodataset.org/zips/train2017.zip",    extract=True,)annotations_path = keras.utils.get_file(    "annotations",    "http://images.cocodataset.org/annotations/annotations_trainval2017.zip",    extract=True,)
قبل از اینکه آمادهٔ استفاده از این دادهها باشیم، باید مقداری آمادهسازی ورودی انجام دهیم. اولین دانلود یک دایرکتوری بدون برچسب از تمام تصاویر COCO در اختیار ما میگذارد. دانلود دوم شامل تمام فرادادههای تصاویر از طریق یک فایل JSON است. مجموعهدادهٔ COCO هر فایل تصویر را با یک شناسه (ID) مرتبط میکند، و هر کادر محدودکننده با یکی از این شناسهها جفت میشود. ما باید تمام دادههای کادر و تصویر را در کنار هم گردآوری کنیم.
هر کادر محدودکننده با مختصات پیکسلی x, y, width, height ارائه میشود که از گوشهٔ بالا سمت چپ تصویر شروع میشود. همانطور که دادههای خود را بارگذاری میکنیم، میتوانیم مقیاس تمام مختصات کادرهای محدودکننده را تغییر دهیم تا نقاطی در یک مربع واحد [0, 1] باشند. این امر دستکاری این کادرها را بدون نیاز به بررسی اندازهٔ هر تصویر ورودی آسانتر میکند.
لیستینگ ۱۲.۲: تجزیهٔ دادههای COCO
import json
with open(f"{annotations_path}/annotations/instances_train2017.json", "r") as f:    annotations = json.load(f)
# Sorts image metadata by IDimages = {image["id"]: image for image in annotations["images"]}
# Converts bounding box to coordinates on a unit squaredef scale_box(box, width, height):    scale = 1.0 / max(width, height)    x, y, w, h = [v * scale for v in box]    x += (height - width) * scale / 2 if height > width else 0    y += (width - height) * scale / 2 if width > height else 0    return [x, y, w, h]
# Aggregates all bounding box annotations by image IDmetadata = {}for annotation in annotations["annotations"]:    id = annotation["image_id"]    if id not in metadata:        metadata[id] = {"boxes": [], "labels": []}    image = images[id]    box = scale_box(annotation["bbox"], image["width"], image["height"])    metadata[id]["boxes"].append(box)    metadata[id]["labels"].append(annotation["category_id"])    metadata[id]["path"] = images_path + "/train2017/" + image["file_name"]metadata = list(metadata.values())
بیایید نگاهی به دادههایی که به تازگی بارگذاری کردیم بیندازیم.
لیستینگ ۱۲.۳: بازرسی دادههای COCO
>>> len(metadata)ما ۱۱۷,۲۶۶ تصویر در اختیار داریم. هر تصویر میتواند از ۱ تا ۶۳ شیء همراه با یک کادر محدودکنندهٔ مرتبط داشته باشد. تنها ۹۱ برچسب ممکن برای اشیاء وجود دارد که توسط سازندگان مجموعهدادهٔ COCO انتخاب شدهاند.
ما میتوانیم از ابزار کمکی keras_hub.utils.coco_id_to_name(id) در KerasHub برای نگاشت این برچسبهای عدد صحیح به نامهای خوانا برای انسان استفاده کنیم، مشابه ابزاری که در فصل ۸ برای رمزگشایی پیشبینیهای ImageNet به برچسبهای متنی به کار بردیم.
بیایید یک تصویر نمونه را بصریسازی کنیم تا موضوع کمی ملموستر شود. میتوانیم تابعی برای رسم تصویر با Matplotlib و تابع دیگری برای رسم یک کادر محدودکنندهٔ برچسبدار روی این تصویر تعریف کنیم. در سرتاسر این فصل به هر دوی این توابع نیاز خواهیم داشت. ما میتوانیم از فضای رنگی HSV به عنوان یک ترفند ساده برای تولید رنگهای جدید به ازای هر برچسب جدیدی که میبینیم استفاده کنیم. با ثابت نگه داشتن اشباع و روشنایی رنگ و تنها بهروزرسانی فام (hue) آن، میتوانیم رنگهای روشن و جدیدی تولید کنیم که به وضوح از تصویر ما متمایز باشند.
لیستینگ ۱۲.۴: بصریسازی یک تصویر COCO همراه با حاشیهنویسیهای کادر
import matplotlib.pyplot as pltfrom matplotlib.colors import hsv_to_rgbfrom matplotlib.patches import Rectangle
color_map = {0: "gray"}
def label_to_color(label):    # Uses the golden ratio to generate new hues of a bright color with    # the HSV colorspace    if label not in color_map:        h, s, v = (len(color_map) * 0.618) % 1, 0.5, 0.9        color_map[label] = hsv_to_rgb((h, s, v))    return color_map[label]
def draw_box(ax, box, text, color):    x, y, w, h = box    ax.add_patch(Rectangle((x, y), w, h, lw=2, ec=color, fc="none"))    textbox = dict(fc=color, pad=1, ec="none")    ax.text(x, y, text, c="white", size=10, va="bottom", bbox=textbox)
def draw_image(ax, image):    # Draws the image on a unit cube with (0, 0) at the top left    ax.set(xlim=(0, 1), ylim=(1, 0), xticks=[], yticks=[], aspect="equal")    image = plt.imread(image)    height, width = image.shape[:2]    # Pads the image so it fits inside the unit cube    hpad = (1 - height / width) / 2 if width > height else 0    wpad = (1 - width / height) / 2 if height > width else 0    extent = [wpad, 1 - wpad, 1 - hpad, hpad]    ax.imshow(image, extent=extent)
بیایید از بصریسازی جدید خود برای مشاهدهٔ تصویر نمونهای2 که قبلاً بررسی میکردیم استفاده کنیم (شکل ۱۲.۳ را ببینید):
sample = metadata[435]ig, ax = plt.subplots(dpi=300)draw_image(ax, sample["path"])for box, label in zip(sample["boxes"], sample["labels"]): label_name = keras_hub.utils.coco_id_to_name(label) draw_box(ax, box, label_name, label_to_color(label))plt.show()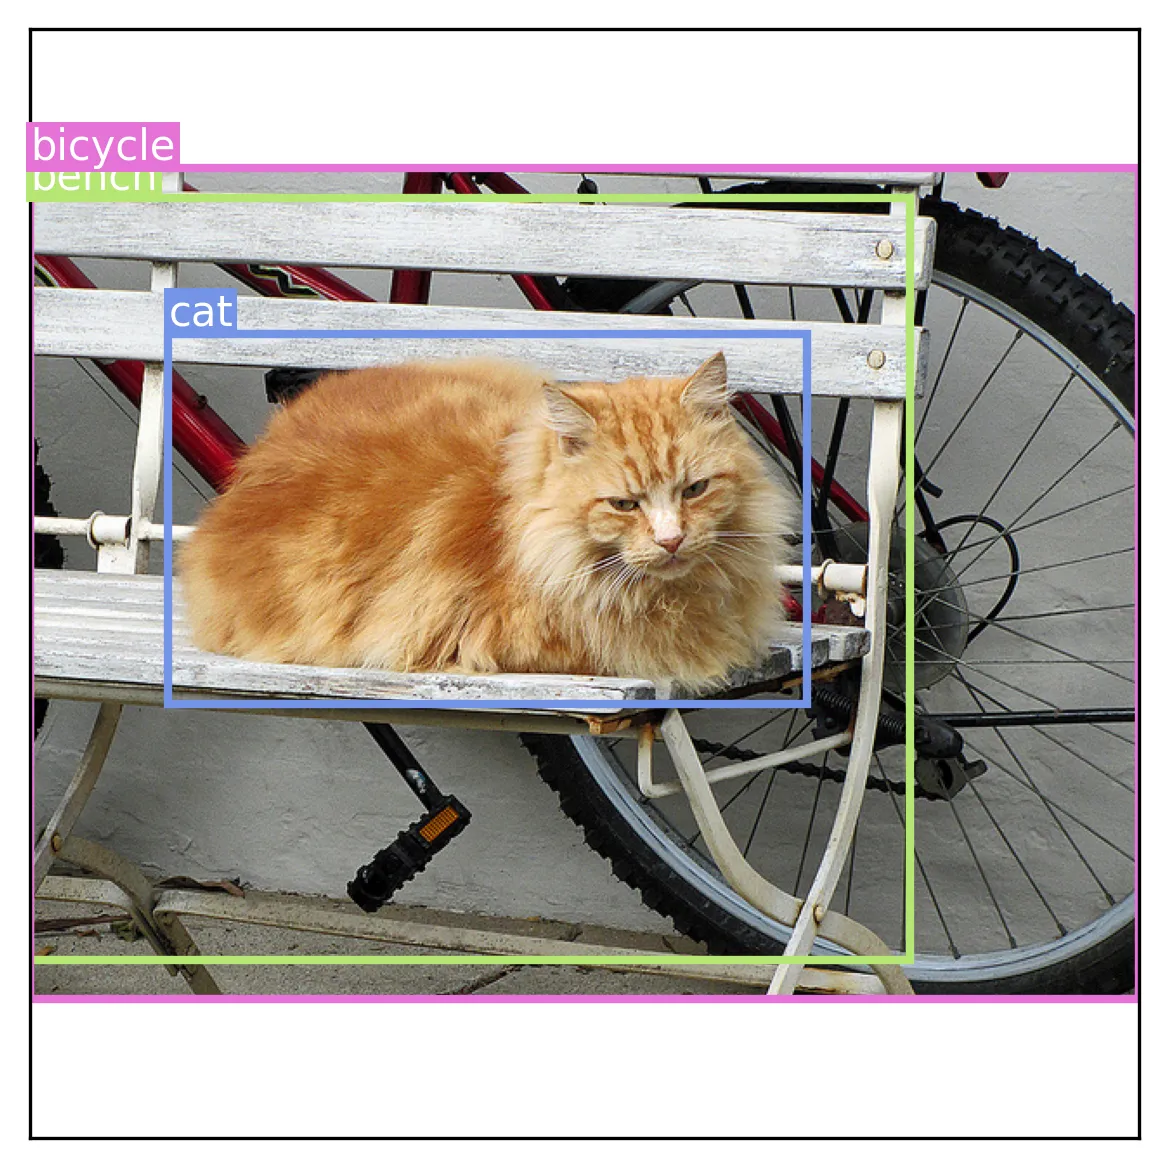
شکل ۱۲.۳: خروجیهای YOLO شامل یک پیشبینی کادر محدودکننده و برچسب کلاس برای هر ناحیه از تصویر است.
در حالی که آموزش روی تمام ۱۸ گیگابایت دادههای ورودی ما میتواند جذاب باشد، اما میخواهیم مثالهای این کتاب روی سختافزارهای معمولی به راحتی قابل اجرا باقی بمانند. اگر خود را تنها به تصاویری با چهار کادر یا کمتر محدود کنیم، مسئلهٔ آموزش خود را سادهتر کرده و حجم دادهها را به نصف کاهش میدهیم. بیایید این کار را انجام دهیم و دادههای خود را بر بزنیم (shuffle) — تصاویر بر اساس نوع شیء گروهبندی شدهاند که برای آموزش بسیار نامطلوب خواهد بود:
import random
metadata = list(filter(lambda x: len(x["boxes"]) <= 4, metadata))random.shuffle(metadata)
بارگذاری دادهها به پایان رسید! بیایید ساخت مدل YOLO خود را آغاز کنیم.
ساخت یک مدل YOLO
Section titled “ساخت یک مدل YOLO”همانطور که قبلاً ذکر شد، مدل YOLO یک آشکارساز تکمرحلهای است. به جای تلاش اولیه برای شناسایی تمام اشیاء نامزد در یک صحنه و سپس طبقهبندی نواحی اشیاء، YOLO کادرهای محدودکننده و برچسبهای شیء را در یک مرحله پیشنهاد میدهد.
مدل ما یک تصویر را به یک شبکهٔ شطرنجی (grid) تقسیم میکند و دو خروجی مجزا در هر موقعیت شبکه پیشبینی مینماید — یک کادر محدودکننده و یک برچسب کلاس. در مقالهٔ اصلی توسط ردمون و همکاران3، مدل در واقع چند کادر را در هر موقعیت شبکه پیشبینی میکرد، اما ما برای ساده نگه داشتن امور، فقط یک کادر در هر خانهٔ شبکه پیشبینی میکنیم.
در بیشتر تصاویر، اشیاء به طور یکنواخت در سراسر یک شبکه پخش نشدهاند، و برای در نظر گرفتن این موضوع، مدل یک امتیاز اطمینان (confidence score) را همراه با هر کادر خروجی میدهد، همانطور که در شکل ۱۲.۴ نشان داده شده است. ما میخواهیم این اطمینان زمانی که یک شیء در یک موقعیت شناسایی میشود بالا باشد، و زمانی که هیچ شیئی وجود ندارد صفر باشد. بیشتر خانههای شبکه هیچ شیئی نخواهند داشت و باید اطمینانی نزدیک به صفر گزارش کنند.
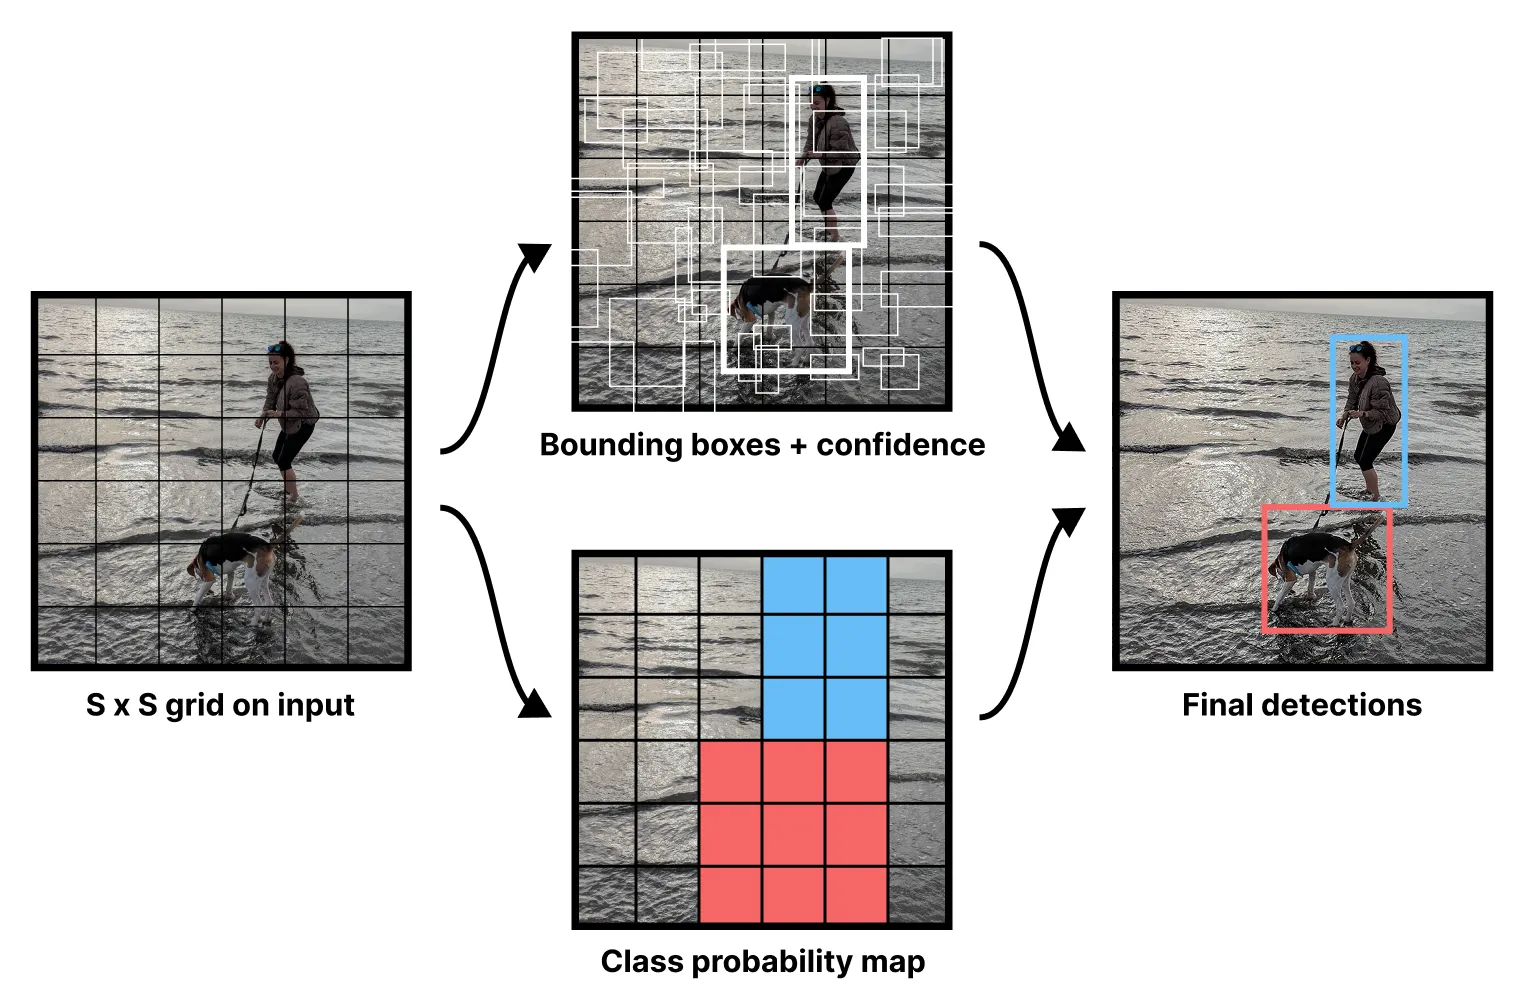
شکل ۱۲.۴: خروجیهای YOLO همانطور که در اولین مقالهٔ YOLO به تصویر کشیده شده است
مانند بسیاری از مدلها در بینایی ماشین، مدل YOLO از یک ستون فقرات (backbone) مبتنی بر ConvNet برای به دست آوردن ویژگیهای سطح بالای جالب برای یک تصویر ورودی استفاده میکند؛ مفهومی که برای نخستین بار در فصل ۸ بررسی کردیم. در مقالهٔ خود، نویسندگان مدل ستون فقرات اختصاصی خود را ساختند و آن را از قبل با ImageNet برای طبقهبندی آموزش دادند. ما به جای انجام این کار توسط خودمان، میتوانیم از KerasHub برای بارگذاری یک ستون فقرات از پیش آموزشدیده استفاده کنیم.
به جای استفاده از ستون فقرات Xception که تاکنون در این کتاب استفاده کردهایم، به سراغ ResNet میرویم، خانوادهای از مدلها که برای اولین بار در فصل ۹ به آنها اشاره کردیم. ساختار آن کاملاً شبیه به Xception است، اما ResNet از گامها (strides) به جای لایههای ادغام (pooling) برای کاهش ابعاد تصویر استفاده میکند. همانطور که در فصل ۱۱ ذکر کردیم، کانولوشنهای گامدار زمانی که به موقعیت مکانی ورودی اهمیت میدهیم عملکرد بهتری دارند.
بیایید مدل از پیش آموزشدیدهٔ خود و پیشپردازش متناظر با آن را (برای تغییر مقیاس تصویر) بارگذاری کنیم. ما اندازهٔ تصاویر خود را به ۴۴۸ × ۴۴۸ تغییر میدهیم؛ اندازهٔ ورودی تصویر برای وظیفهٔ تشخیص شیء بسیار مهم است.
لیستینگ ۱۲.۵: بارگذاری مدل ResNet
image_size = 448
backbone = keras_hub.models.Backbone.from_preset(    "resnet_50_imagenet",)preprocessor = keras_hub.layers.ImageConverter.from_preset(    "resnet_50_imagenet",    image_size=(image_size, image_size),)
سپس، میتوانیم ستون فقرات خود را با افزودن لایههای جدید برای تولید پیشبینیهای کادر و کلاس، به یک مدل تشخیص تبدیل کنیم. ساختار پیشنهادی در مقالهٔ YOLO بسیار ساده است: خروجی یک ستون فقرات ConvNet را بگیرید و آن را از میان دو لایهٔ متراکم متصل با یک تابع فعالسازی در میان آنها عبور دهید. سپس خروجی را تقسیم کنید. پنج عدد اول برای پیشبینی کادر محدودکننده استفاده خواهند شد (چهار عدد برای کادر و یک عدد برای اطمینان کادر). بقیه برای نقشهٔ احتمال کلاس نشاندادهشده در شکل ۱۲.۴ استفاده خواهند شد — یک پیشبینی طبقهبندی برای هر موقعیت شبکه روی تمام ۹۱ برچسب ممکن.
بیایید این را پیادهسازی کنیم.
لیستینگ ۱۲.۶: اتصال یک هد پیشبینی YOLO
from keras import layers
grid_size = 6num_labels = 91
inputs = keras.Input(shape=(image_size, image_size, 3))x = backbone(inputs)# Makes our backbone outputs smaller and then flattens the output# featuresx = layers.Conv2D(512, (3, 3), strides=(2, 2))(x)x = keras.layers.Flatten()(x)# Passes our flattened feature maps through two densely connected# layersx = layers.Dense(2048, activation="relu", kernel_initializer="glorot_normal")(x)x = layers.Dropout(0.5)(x)x = layers.Dense(grid_size * grid_size * (num_labels + 5))(x)# Reshapes outputs to a 6 × 6 gridx = layers.Reshape((grid_size, grid_size, num_labels + 5))(x)# Split box and class predictionsbox_predictions = x[..., :5]class_predictions = layers.Activation("softmax")(x[..., 5:])outputs = {"box": box_predictions, "class": class_predictions}model = keras.Model(inputs, outputs)میتوانیم با نگاه کردن به خلاصهٔ مدل، درک بهتری از آن به دست آوریم:
>>> model.summary()خروجیهای ستون فقرات ما دارای شکل (batch_size, 14, 14, 2048) هستند. این مقدار برابر با ۴۰۱,۴۰۸ عدد اعشاری خروجی به ازای هر تصویر است، که کمی برای ارسال به لایههای متراکم ما بیش از حد زیاد است. ما نقشههای ویژگی را با یک لایهٔ کانولوشن گامدار به (batch_size, 6, 6, 512) با مقدار قابل مدیریتتر ۱۸,۴۳۲ عدد اعشاری به ازای هر تصویر کاهش مقیاس میدهیم.
سپس، میتوانیم دو لایهٔ متراکم متصل خود را اضافه کنیم. ما کل نقشهٔ ویژگی را مسطح (flatten) میکنیم، آن را از یک Dense با فعالسازی relu عبور میدهیم و سپس آن را از یک Dense نهایی با تعداد دقیق پیشبینیهای خروجی خود عبور میدهیم — ۵ برای کادر محدودکننده و اطمینان و ۹۱ برای هر کلاس شیء در هر موقعیت شبکه.
در نهایت، خروجیها را دوباره به یک شبکهٔ ۶ × ۶ تغییر شکل میدهیم و پیشبینیهای کادر و کلاس خود را تقسیم میکنیم. طبق معمول برای خروجیهای طبقهبندی، یک سافتمکس اعمال مینماییم. خروجیهای کادر به بررسیهای ویژهٔ بیشتری نیاز خواهند داشت؛ ما این موضوع را بعداً پوشش خواهیم داد.
عالی به نظر میرسد! توجه داشته باشید که چون کل نقشهٔ ویژگی را از طریق لایهٔ طبقهبندی مسطح میکنیم، هر آشکارساز شبکه میتواند از ویژگیهای کل تصویر استفاده کند؛ هیچ محدودیت مکانی وجود ندارد. این امر بر اساس طراحی است — اشیاء بزرگ در یک خانهٔ شبکهٔ منفرد محصور نخواهند ماند.
آمادهسازی دادههای COCO برای مدل YOLO
Section titled “آمادهسازی دادههای COCO برای مدل YOLO”مدل ما نسبتاً ساده است، اما همچنان باید ورودیهای خود را پیشپردازش کنیم تا آنها را با شبکهٔ پیشبینی تراز نماییم. هر آشکارساز شبکه مسئول تشخیص هر کادری خواهد بود که مرکز آن در داخل خانهٔ شبکه قرار میگیرد. مدل ما پنج عدد اعشاری برای کادر به صورت (x, y, w, h, confidence) خروجی میدهد. مقادیر x و y نشاندهندهٔ مرکز شیء نسبت به مرزهای خانهٔ شبکه (از ۰ تا ۱) خواهند بود. مقادیر w و h نشاندهندهٔ اندازهٔ شیء نسبت به اندازهٔ کل تصویر خواهند بود.
ما از قبل مقادیر صحیح w و h را در دادههای آموزشی خود داریم. با این حال، باید مقادیر x و y خود را به مختصات شبکه و برعکس تبدیل کنیم. بیایید دو تابع کمکی تعریف کنیم:
def to_grid(box):    x, y, w, h = box    cx, cy = (x + w / 2) * grid_size, (y + h / 2) * grid_size    ix, iy = int(cx), int(cy)    return (ix, iy), (cx - ix, cy - iy, w, h)
def from_grid(loc, box):    (xi, yi), (x, y, w, h) = loc, box    x = (xi + x) / grid_size - w / 2    y = (yi + y) / grid_size - h / 2    return (x, y, w, h)
بیایید دادههای آموزشی خود را به گونهای بازطراحی کنیم که با این ساختار شبکهٔ جدید مطابقت داشته باشد. ما میتوانیم دو آرایه به طول مجموعهدادهٔ خود با شبکه بسازیم:
- اولین آرایه شامل نقشهٔ احتمال کلاس ما خواهد بود. ما تمام خانههای شبکهای را که با یک کادر محدودکننده تقاطع دارند با برچسب صحیح علامتگذاری میکنیم. برای ساده نگه داشتن کد خود، نگران کادرهای دارای همپوشانی نخواهیم بود.
- دومین آرایه شامل خود کادرها خواهد بود. ما تمام کادرها را به شبکه ترجمه کرده و خانهٔ شبکهٔ صحیح را با مختصات کادر برچسبگذاری میکنیم. اطمینان (confidence) برای یک کادر واقعی در دادههای برچسب ما همیشه یک خواهد بود، و اطمینان برای تمام موقعیتهای دیگر صفر خواهد بود.
لیستینگ ۱۲.۷: ایجاد هدفهای YOLO
import numpy as npimport math
class_array = np.zeros((len(metadata), grid_size, grid_size))box_array = np.zeros((len(metadata), grid_size, grid_size, 5))
for index, sample in enumerate(metadata):    boxes, labels = sample["boxes"], sample["labels"]    for box, label in zip(boxes, labels):        (x, y, w, h) = box        # Finds all grid cells whose center falls inside the box        left, right = math.floor(x * grid_size), math.ceil((x + w) * grid_size)        bottom, top = math.floor(y * grid_size), math.ceil((y + h) * grid_size)        class_array[index, bottom:top, left:right] = label
for index, sample in enumerate(metadata):    boxes, labels = sample["boxes"], sample["labels"]    for box, label in zip(boxes, labels):        # Transforms the box to the grid coordinate system        (xi, yi), (grid_box) = to_grid(box)        box_array[index, yi, xi] = [*grid_box, 1.0]        # Makes sure the class label for the box's center location        # matches the box        class_array[index, yi, xi] = label
بیایید دادههای آموزشی YOLO خود را با توابع کمکی رسم کادر خود بصریسازی کنیم (شکل ۱۲.۵). ما کل نقشهٔ فعالسازی کلاس را روی اولین تصویر ورودی خود رسم میکنیم4 و امتیاز اطمینان یک کادر را همراه با برچسب آن اضافه مینماییم.
لیستینگ ۱۲.۸: بصریسازی یک هدف YOLO
def draw_prediction(image, boxes, classes, cutoff=None):    fig, ax = plt.subplots(dpi=300)    draw_image(ax, image)    # Draws the YOLO output grid and class probability map    for yi, row in enumerate(classes):        for xi, label in enumerate(row):            color = label_to_color(label) if label else "none"            x, y, w, h = (v / grid_size for v in (xi, yi, 1.0, 1.0))            r = Rectangle((x, y), w, h, lw=2, ec="black", fc=color, alpha=0.5)            ax.add_patch(r)    # Draws all boxes at each grid location above our cutoff    for yi, row in enumerate(boxes):        for xi, box in enumerate(row):            box, confidence = box[:4], box[4]            if not cutoff or confidence >= cutoff:                box = from_grid((xi, yi), box)                label = classes[yi, xi]                color = label_to_color(label)                name = keras_hub.utils.coco_id_to_name(label)                draw_box(ax, box, f"{name} {max(confidence, 0):.2f}", color)    plt.show()
draw_prediction(metadata[0]["path"], box_array[0], class_array[0], cutoff=1.0)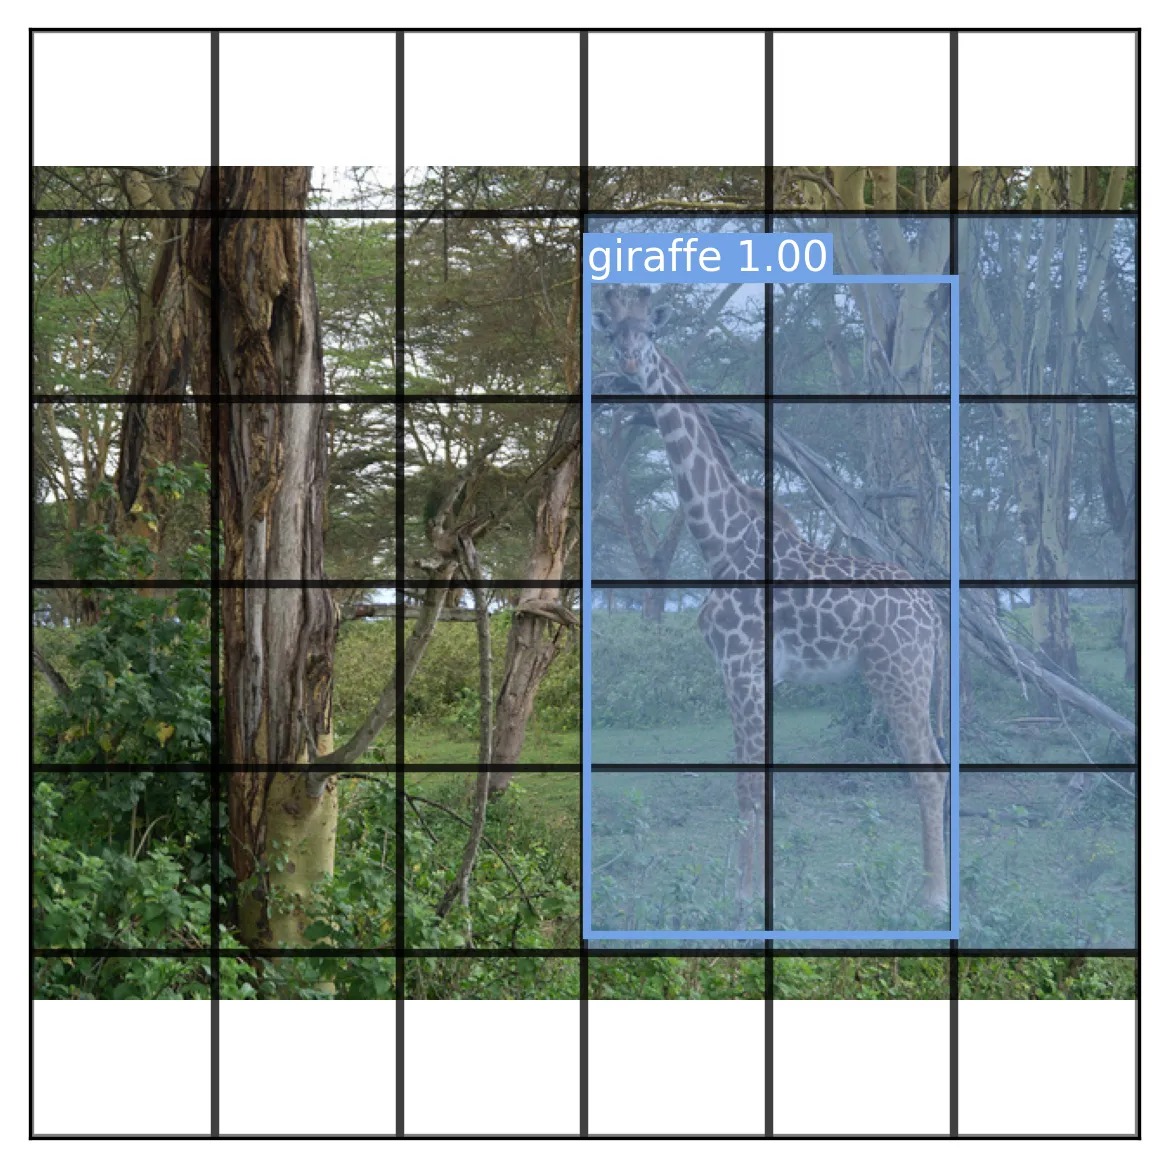
شکل ۱۲.۵: خروجیهای YOLO شامل یک پیشبینی کادر محدودکننده و برچسب کلاس برای هر ناحیه از تصویر است.
در نهایت، بیایید از tf.data برای بارگذاری دادههای تصویری خود استفاده کنیم. ما تصاویر خود را از روی دیسک بارگذاری کرده، پیشپردازش خود را اعمال میکنیم و آنها را دستهبندی مینماییم. ما همچنین باید یک مجموعهٔ اعتبارسنجی را برای نظارت بر آموزش جدا کنیم.
لیستینگ ۱۲.۹: ایجاد یک مجموعهداده برای آموزش
import tensorflow as tf
# Loads and resizes the model with tf.datadef load_image(path):    x = tf.io.read_file(path)    x = tf.image.decode_jpeg(x, channels=3)    return preprocessor(x)
images = tf.data.Dataset.from_tensor_slices([x["path"] for x in metadata])images = images.map(load_image, num_parallel_calls=8)labels = {"box": box_array, "class": class_array}labels = tf.data.Dataset.from_tensor_slices(labels)
# Creates a merged dataset and batches itdataset = tf.data.Dataset.zip(images, labels).batch(16).prefetch(2)# Splits off some validation dataval_dataset, train_dataset = dataset.take(500), dataset.skip(500)
با این کار، دادههای ما برای آموزش آماده هستند.
آموزش مدل YOLO
Section titled “آموزش مدل YOLO”ما مدل و دادههای آموزشی خود را آماده کردهایم، اما یک عنصر نهایی دیگر وجود دارد که قبل از اجرای واقعی fit() به آن نیاز داریم: تابع زیان. مدل ما کادرهای پیشبینیشده و برچسبهای شبکهٔ پیشبینیشده را خروجی میدهد. در فصل ۷ دیدیم که چگونه میتوانیم چند تابع زیان برای هر خروجی تعریف کنیم — Keras در طول آموزش صرفاً این توابع زیان را با هم جمع میکند. ما میتوانیم زیان طبقهبندی را طبق معمول با sparse_categorical_crossentropy مدیریت کنیم.
با این حال، زیان کادر نیازمند بررسیهای ویژهای است. زیان پایهٔ پیشنهادی توسط نویسندگان YOLO نسبتاً ساده است. آنها از مجموع مربعات خطای تفاوت بین پارامترهای کادر هدف و پارامترهای پیشبینیشده استفاده میکنند. ما این خطا را فقط برای خانههای شبکهای محاسبه خواهیم کرد که دارای کادرهای واقعی در دادههای برچسبدار هستند.
بخش چالشبرانگیز تابع زیان، خروجی اطمینان کادر است. نویسندگان میخواستند خروجی اطمینان نه تنها حضور یک شیء، بلکه کیفیت کادر پیشبینیشده را نیز منعکس کند. برای ایجاد یک برآورد هموار از میزان کیفیت پیشبینی یک کادر، نویسندگان استفاده از معیار تقاطع بر روی اجتماع (Intersection over Union یا IoU) را که در فصل قبل دیدیم پیشنهاد میکنند. اگر یک خانهٔ شبکه خالی باشد، اطمینان پیشبینیشده در آن موقعیت باید صفر باشد. با این حال، اگر یک خانهٔ شبکه حاوی یک شیء باشد، میتوانیم از امتیاز IoU بین پیشبینی کادر فعلی و کادر واقعی به عنوان مقدار اطمینان هدف استفاده کنیم. به این ترتیب، با بهتر شدن مدل در پیشبینی موقعیت کادرها، امتیاز IoU و مقادیر اطمینان آموختهشده افزایش مییابند.
این امر نیازمند یک تابع زیان سفارشی است. ما میتوانیم با تعریف یک ابزار کمکی برای محاسبهٔ امتیازهای IoU برای کادرهای هدف و پیشبینیشده شروع کنیم.
لیستینگ ۱۲.۱۰: محاسبهٔ IoU برای دو کادر
from keras import ops
# Unpacks a tensor of boxesdef unpack(box):    return box[..., 0], box[..., 1], box[..., 2], box[..., 3]
# Computes the intersection area between two box tensorsdef intersection(box1, box2):    cx1, cy1, w1, h1 = unpack(box1)    cx2, cy2, w2, h2 = unpack(box2)    left = ops.maximum(cx1 - w1 / 2, cx2 - w2 / 2)    bottom = ops.maximum(cy1 - h1 / 2, cy2 - h2 / 2)    right = ops.minimum(cx1 + w1 / 2, cx2 + w2 / 2)    top = ops.minimum(cy1 + h1 / 2, cy2 + h2 / 2)    return ops.maximum(0.0, right - left) * ops.maximum(0.0, top - bottom)
# Computes the IoU between two box tensorsdef intersection_over_union(box1, box2):    cx1, cy1, w1, h1 = unpack(box1)    cx2, cy2, w2, h2 = unpack(box2)    intersection_area = intersection(box1, box2)    a1 = ops.maximum(w1, 0.0) * ops.maximum(h1, 0.0)    a2 = ops.maximum(w2, 0.0) * ops.maximum(h2, 0.0)    union_area = a1 + a2 - intersection_area    return ops.divide_no_nan(intersection_area, union_area)
بیایید از این تابع کمکی برای تعریف تابع زیان سفارشی خود استفاده کنیم. ردمون و همکاران چند ترفند مقیاسبندی زیان را برای بهبود کیفیت آموزش پیشنهاد میکنند:
- آنها زیان مکانیابی کادر را با ضریب پنج افزایش مقیاس میدهند تا به بخش مهمتری از آموزش کلی تبدیل شود.
- از آنجا که بیشتر خانههای شبکه خالی هستند، آنها همچنین زیان اطمینان را در موقعیتهای خالی با ضریب دو کاهش میدهند. این امر مانع از غلبهٔ این پیشبینیهای با اطمینان صفر بر کل زیان میشود.
- آنها قبل از محاسبهٔ زیان، ریشهٔ دوم (جذر) عرض و ارتفاع را میگیرند. این کار برای متوقف کردن تأثیر نامتناسب کادرهای بزرگ نسبت به کادرهای کوچک است. ما از یک تابع
sqrtاستفاده خواهیم کرد که علامت ورودی را حفظ میکند، زیرا ممکن است مدل ما در ابتدای آموزش عرضها و ارتفاعهای منفی پیشبینی کند.
بیایید این را بنویسیم.
لیستینگ ۱۲.۱۱: تعریف تابع زیان کادر محدودکنندهٔ YOLO
def signed_sqrt(x):    return ops.sign(x) * ops.sqrt(ops.absolute(x) + keras.config.epsilon())
def box_loss(true, pred):    # Unpacks values    xy_true, wh_true, conf_true = true[..., :2], true[..., 2:4], true[..., 4:]    xy_pred, wh_pred, conf_pred = pred[..., :2], pred[..., 2:4], pred[..., 4:]    # If confidence_true is 0.0, there is no object in this grid cell.    no_object = conf_true == 0.0    # Computes box placement errors    xy_error = ops.square(xy_true - xy_pred)    wh_error = ops.square(signed_sqrt(wh_true) - signed_sqrt(wh_pred))    # Computes confidence error    iou = intersection_over_union(true, pred)    conf_target = ops.where(no_object, 0.0, ops.expand_dims(iou, -1))    conf_error = ops.square(conf_target - conf_pred)    # Concatenates the errors weith scaling hacks    error = ops.concatenate(        (            ops.where(no_object, 0.0, xy_error * 5.0),            ops.where(no_object, 0.0, wh_error * 5.0),            ops.where(no_object, conf_error * 0.5, conf_error),        ),        axis=-1,    )    # Returns one loss value per sample; Keras will sum over the batch.    return ops.sum(error, axis=(1, 2, 3))
ما در نهایت آماده هستیم تا آموزش مدل YOLO خود را آغاز کنیم. صرفاً برای کوتاه نگه داشتن این مثال، از معیارها صرفنظر میکنیم. در یک محیط دنیای واقعی، شما معیارهای زیادی را در اینجا میخواهید — مانند دقت مدل در سطوح مختلف آستانهٔ اطمینان.
لیستینگ ۱۲.۱۲: آموزش مدل YOLO
model.compile( optimizer=keras.optimizers.Adam(2e-4), loss={"box": box_loss, "class": "sparse_categorical_crossentropy"},)model.fit( train_dataset, validation_data=val_dataset, epochs=4,)آموزش بیش از یک ساعت در محیط زمان اجرای GPU رایگان Colab طول میکشد، و مدل ما هنوز کمآموزشدیده (undertrained) است (زیان اعتبارسنجی هنوز در حال کاهش است!). بیایید بصریسازی یک خروجی از مدل خود را امتحان کنیم (شکل ۱۲.۶). ما از یک آستانهٔ اطمینان پایین استفاده خواهیم کرد، زیرا مدل ما هنوز یک آشکارساز شیء خیلی خوب نیست.
لیستینگ ۱۲.۱۳: آموزش مدل YOLO
# Rebatches our dataset to get a single sample instead of 16x, y = next(iter(val_dataset.rebatch(1)))preds = model.predict(x)boxes = preds["box"][0]# Uses argmax to find the most likely label at each grid locationclasses = np.argmax(preds["class"][0], axis=-1)# Loads the image from disk to view it a full sizepath = metadata[0]["path"]draw_prediction(path, boxes, classes, cutoff=0.1)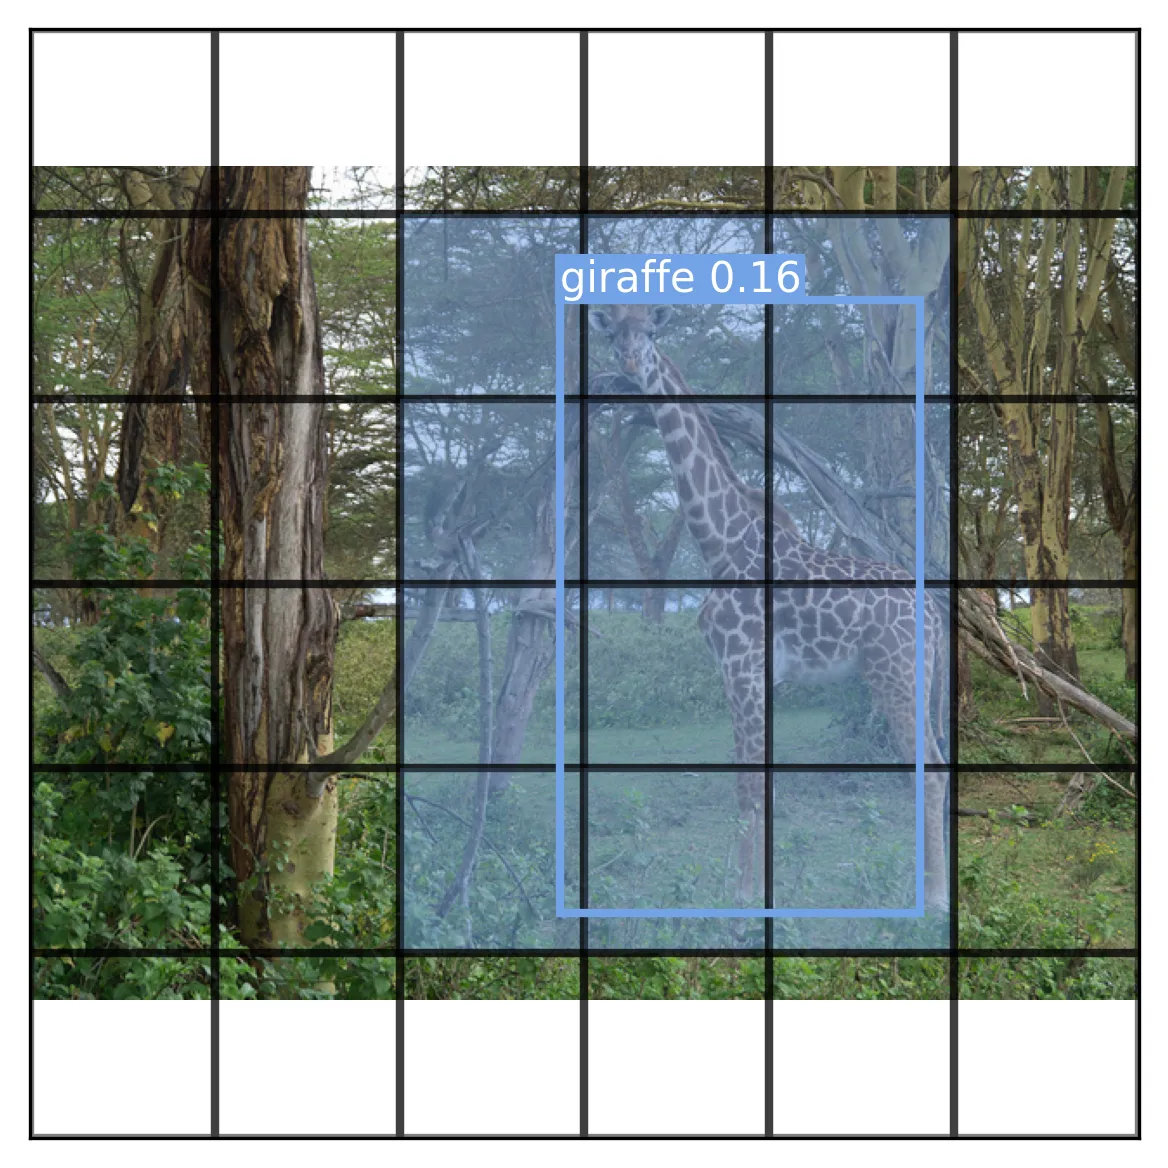
شکل ۱۲.۶: پیشبینیها برای تصویر نمونهٔ ما
ما میتوانیم ببینیم که مدل ما شروع به درک موقعیت کادرها و برچسبهای کلاس کرده است، اگرچه هنوز خیلی دقیق نیست. بیایید هر کادر پیشبینیشده توسط مدل را بصریسازی کنیم (شکل ۱۲.۷)، حتی مواردی با اطمینان صفر:
draw_prediction(path, boxes, classes, cutoff=None)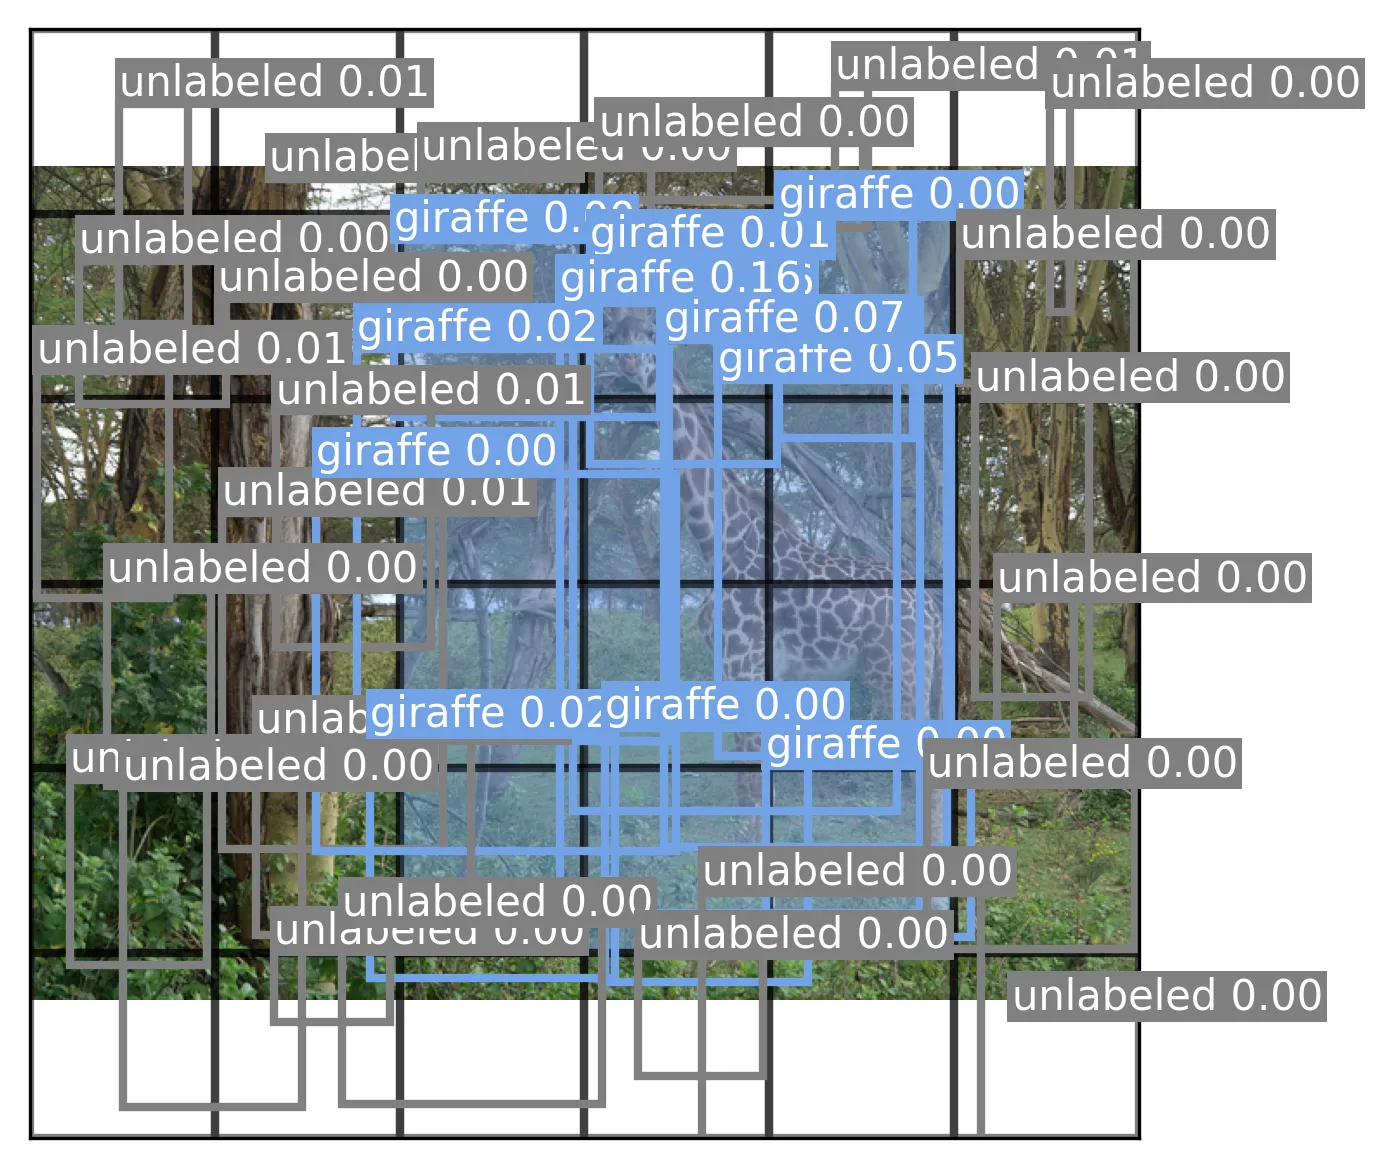
شکل ۱۲.۷: هر کادر محدودکنندهٔ پیشبینیشده توسط مدل YOLO
مدل ما مقادیر اطمینان بسیار پایینی را یاد میگیرد زیرا هنوز یاد نگرفته است که به طور مداوم اشیاء را در یک صحنه مکانیابی کند. برای بهبود بیشتر مدل، باید موارد متعددی را امتحان کنیم:
- آموزش برای دورههای بیشتر
- استفاده از کل مجموعهدادهٔ COCO
- افزونگی داده (data augmentation) (مانند انتقال و چرخش تصاویر و کادرهای ورودی)
- بهبود نقشهٔ احتمال کلاس برای کادرهای دارای همپوشانی
- پیشبینی چند کادر در هر موقعیت شبکه با استفاده از یک شبکهٔ خروجی بزرگتر
همهٔ این موارد بر عملکرد مدل تأثیر مثبت خواهند گذاشت و ما را به دستورالعمل آموزشی اصلی YOLO نزدیکتر خواهند کرد. با این حال، این مثال واقعاً فقط برای به دست آوردن حسی از آموزش تشخیص شیء است — آموزش یک مدل تشخیص دقیق COCO از ابتدا نیازمند مقدار زیادی محاسبات و زمان است. در عوض، برای به دست آوردن حسی از یک مدل تشخیص با عملکرد بهتر، بیایید از یک مدل تشخیص شیء از پیش آموزشدیده به نام RetinaNet استفاده کنیم.
استفاده از یک آشکارساز از پیش آموزشدیدهٔ RetinaNet
Section titled “استفاده از یک آشکارساز از پیش آموزشدیدهٔ RetinaNet”مدل RetinaNet نیز یک آشکارساز شیء تکمرحلهای است و بر اساس همان اصول پایهٔ مدل YOLO عمل میکند. بزرگترین تفاوت مفهومی بین مدل ما و RetinaNet این است که RetinaNet از ConvNet زیربنایی خود به شیوهٔ متفاوتی برای مدیریت بهتر اشیاء کوچک و بزرگ به طور همزمان استفاده میکند.
در مدل YOLO خود، ما صرفاً خروجیهای نهایی ConvNet خود را گرفتیم و از آنها برای ساخت آشکارساز شیء خود استفاده کردیم. این ویژگیهای خروجی به نواحی بزرگی روی تصویر ورودی ما نگاشت میشوند — در نتیجه، در یافتن اشیاء کوچک در صحنه خیلی مؤثر نیستند.
یک گزینه برای حل این مشکل مقیاس، استفادهٔ مستقیم از خروجی لایههای اولیه در ConvNet ما خواهد بود. این کار ویژگیهای با وضوح بالا را استخراج میکند که به نواحی کوچک محلی تصویر ورودی ما نگاشت میشوند. با این حال، خروجی این لایههای اولیه از نظر معنایی خیلی جالب نیست. ممکن است به انواع مختلفی از ویژگیهای ساده مانند لبهها و منحنیها نگاشت شود، اما تنها در لایههای بعدی ConvNet است که شروع به ساخت بازنماییهای نهفته برای کل اشیاء میکنیم.
راه حل مورد استفاده توسط RetinaNet، شبکهٔ هرم ویژگی (feature pyramid network یا FPN) نامیده میشود. ویژگیهای نهایی از مدل پایهٔ ConvNet با لایههای تدریجی Conv2DTranspose فراپنمونهبرداری (upsample) میشوند، درست مانند آنچه در فصل قبل دیدیم. اما نکتهٔ حیاتی این است که ما همچنین اتصالات جانبی (lateral connections) را در نظر میگیریم که در آنها این نقشههای ویژگی فراپنمونهبرداریشده را با نقشههای ویژگی هماندازه از ConvNet اصلی جمع میکنیم. این کار ویژگیهای از نظر معنایی جالب و با وضوح پایین در انتهای ConvNet را با ویژگیهای با وضوح بالا و مقیاس کوچک از ابتدای ConvNet ترکیب میکند. طرح تقریبی این معماری در شکل ۱۲.۸ نشان داده شده است.
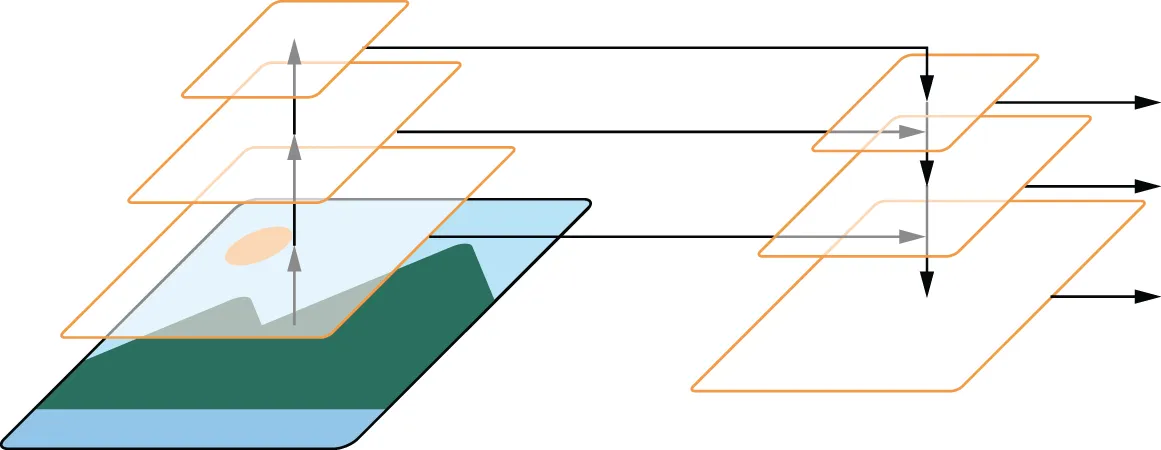
شکل ۱۲.۸: یک شبکهٔ هرم ویژگی نقشههای ویژگی از نظر معنایی جالب را در مقیاسهای مختلف ایجاد میکند.
شبکههای هرم ویژگی میتوانند با ساخت ویژگیهای مؤثر برای اشیاء کوچک و بزرگ از نظر ردپای پیکسلی، عملکرد را به طور قابل توجهی افزایش دهند. نسخههای اخیر YOLO نیز از همین ساختار استفاده میکنند.
بیایید مدل RetinaNet را امتحان کنیم که آن هم روی مجموعهدادهٔ COCO آموزش دیده است. برای جذابتر کردن موضوع، بیایید تصویری را امتحان کنیم که خارج از توزیع (out-of-distribution) مدل است، نقاشی نقطهچینی (Pointillist) یک بعدازظهر یکشنبه در جزیرهٔ گراند ژات.
ما میتوانیم با دانلود تصویر و تبدیل آن به یک آرایهٔ NumPy شروع کنیم:
url = "https://s3.us-east-1.amazonaws.com/book.keras.io/3e/seurat.jpg"path = keras.utils.get_file(origin=url)image = np.array([keras.utils.load_img(path)])سپس، بیایید مدل را دانلود کرده و یک پیشبینی انجام دهیم. همانطور که در فصل قبل انجام دادیم، میتوانیم از API وظیفهٔ سطح بالا در KerasHub برای ایجاد یک ObjectDetector و استفاده از آن استفاده کنیم — پیشپردازش نیز لحاظ شده است.
لیستینگ ۱۲.۱۴: ایجاد مدل ResNet
detector = keras_hub.models.ObjectDetector.from_preset( "retinanet_resnet50_fpn_v2_coco", bounding_box_format="rel_xywh",)predictions = detector.predict(image)توجه خواهید کرد که ما یک آرگومان اضافی برای تعیین فرمت کادر محدودکننده ارسال میکنیم. میتوانیم این کار را برای اکثر مدلها و لایههای Keras که از کادرهای محدودکننده پشتیبانی میکنند انجام دهیم. ما "rel_xywh" را ارسال میکنیم تا از همان فرمتی که برای مدل YOLO استفاده کردیم استفاده کنیم، بنابراین میتوانیم از همان توابع کمکی رسم کادر استفاده نماییم. در اینجا، rel مخفف نسبت به اندازهٔ تصویر (مثلاً از [0, 1]) است. بیایید پیشبینیای را که به تازگی انجام دادهایم بررسی کنیم:
>>> [(k, v.shape) for k, v in predictions.items()]ما چهار خروجی مختلف مدل داریم: کادرهای محدودکننده، اطمینانها، برچسبها، و تعداد کل تشخیصها. این ساختار در کل کاملاً مشابه مدل YOLO ما است. مدل میتواند در مجموع ۱۰۰ شیء را برای هر مدل ورودی پیشبینی کند.
بیایید نمایش پیشبینی را با توابع کمکی رسم کادر خود امتحان کنیم (شکل ۱۲.۹).
لیستینگ ۱۲.۱۵: اجرای استنتاج با RetinaNet
fig, ax = plt.subplots(dpi=300)draw_image(ax, path)num_detections = predictions["num_detections"][0]for i in range(num_detections): box = predictions["boxes"][0][i] label = predictions["labels"][0][i] label_name = keras_hub.utils.coco_id_to_name(label) draw_box(ax, box, label_name, label_to_color(label))plt.show()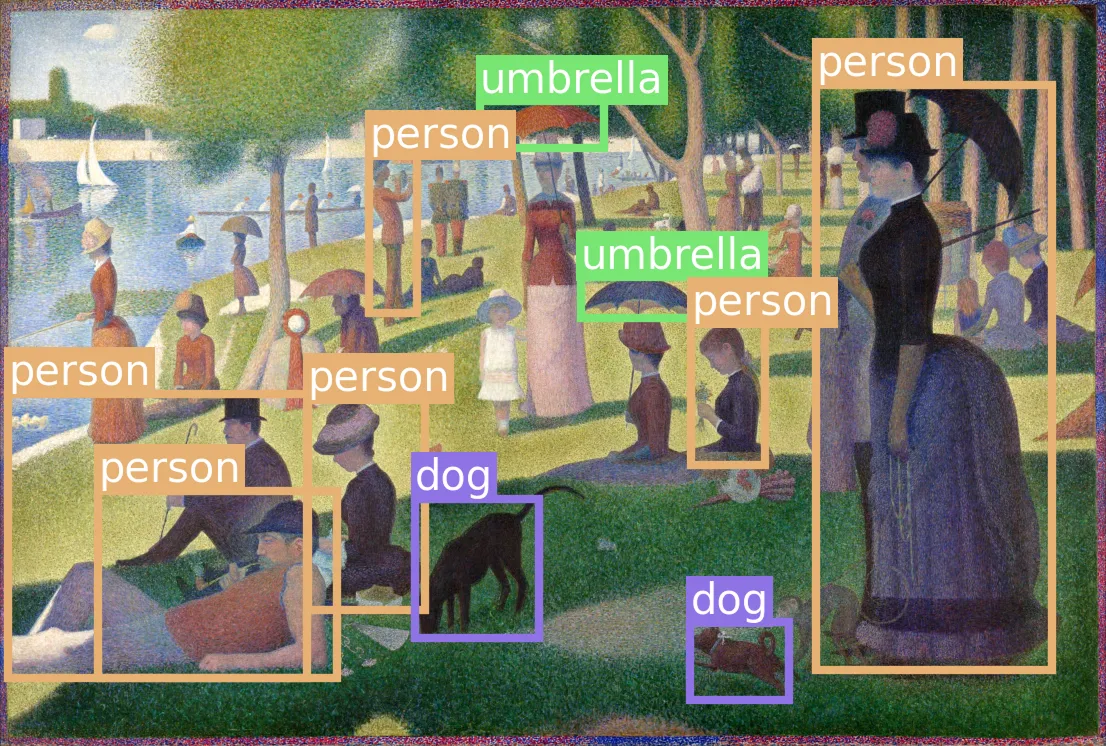
شکل ۱۲.۹: پیشبینیها روی یک تصویر آزمایش از مدل RetinaNet
مدل RetinaNet قادر است به راحتی به یک نقاشی نقطهچینی تعمیم یابد، علیرغم اینکه هیچ آموزشی روی این سبک از ورودی ندیده است! این در واقع یکی از مزایای آشکارسازهای شیء تکمرحلهای است. نقاشیها و عکسها در سطح پیکسل بسیار متفاوت هستند اما در سطح بالا ساختار مشابهی دارند. در مقابل، آشکارسازهای دومرحلهای مانند R-CNNها مجبورند وصلههای کوچک یک تصویر ورودی را به صورت مجزا طبقهبندی کنند، که این کار زمانی که وصلههای کوچک پیکسلها بسیار متفاوت از دادههای آموزشی به نظر میرسند بسیار دشوارتر است. آشکارسازهای تکمرحلهای میتوانند از ویژگیهای کل ورودی بهره ببرند و در برابر ورودیهای جدید در زمان آزمایش مقاومتر هستند.
با این کار، شما به پایان بخش بینایی ماشین این کتاب رسیدهاید! ما طبقهبندیکنندههای تصویر، قطعهبندیکنندهها، و آشکارسازهای شیء را از ابتدا آموزش دادهایم. ما شهود خوبی برای نحوهٔ عملکرد ConvNetها، اولین موفقیت بزرگ دوران یادگیری عمیق، به دست آوردهایم. کار ما هنوز با تصاویر کاملاً تمام نشده است؛ شما در فصل ۱۷ زمانی که شروع به تولید خروجی تصویر میکنیم دوباره آنها را خواهید دید.
- تشخیص شیء اشیاء را درون یک تصویر با استفاده از کادرهای محدودکننده شناسایی و مکانیابی میکند. این کار اساساً نسخهٔ ضعیفتری از قطعهبندی تصویر است، اما میتوان آن را بسیار کارآمدتر اجرا کرد.
- دو رویکرد اصلی برای تشخیص شیء وجود دارد:
- شبکههای عصبی کانولوشنی مبتنی بر ناحیه (R-CNN)، که مدلهای دومرحلهای هستند که ابتدا نواحی مورد نظر را پیشنهاد میدهند و سپس آنها را با یک ConvNet طبقهبندی میکنند.
- آشکارسازهای تکمرحلهای (مانند RetinaNet و YOLO)، که هر دو وظیفه را در یک گام منفرد انجام میدهند. آشکارسازهای تکمرحلهای به طور کلی سریعتر و کارآمدتر هستند و آنها را برای کاربردهای بلادرنگ (مانند خودروهای خودران) مناسب میسازد.
- مدل YOLO دو خروجی مجزا را به طور همزمان در طول آموزش محاسبه میکند — کادرهای محدودکنندهٔ ممکن و یک نقشهٔ احتمال کلاس:
- هر کادر محدودکنندهٔ کاندید با یک امتیاز اطمینان جفت میشود، که آموزش میبیند تا تقاطع بر روی اجتماع (IoU) کادر پیشبینیشده و کادر مرجع واقعی را هدف قرار دهد.
- نقشهٔ احتمال کلاس، نواحی مختلف یک تصویر را به عنوان متعلق به اشیاء مختلف طبقهبندی میکند.
- مدل RetinaNet این ایده را با استفاده از یک شبکهٔ هرم ویژگی (FPN) توسعه میدهد، که ویژگیها را از چندین لایهٔ ConvNet برای ایجاد نقشههای ویژگی در مقیاسهای مختلف ترکیب میکند و به آن اجازه میدهد اشیاء با اندازههای مختلف را با دقت بیشتری تشخیص دهد.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
مجموعهدادهٔ تشخیص شیء COCO 2017 را میتوان در https://cocodataset.org/ کاوش کرد. بیشتر تصاویر این فصل از این مجموعهداده گرفته شدهاند. ↩
-
تصویر از مجموعهدادهٔ COCO 2017، https://cocodataset.org/. تصویر از Flickr، http://farm8.staticflickr.com/7250/7520201840_3e01349e3f_z.jpg، تحت مجوز CC BY 2.0 https://creativecommons.org/licenses/by/2.0/. ↩
-
Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” CoRR (2015), https://arxiv.org/abs/1506.02640. ↩
-
تصویر از مجموعهدادهٔ COCO 2017، https://cocodataset.org/. تصویر از Flickr، http://farm9.staticflickr.com/8081/8387882360_5b97a233c4_z.jpg، تحت مجوز CC BY 2.0 https://creativecommons.org/licenses/by/2.0/. ↩

مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.