
فصل ۱۱: قطعهبندی تصویر
فصل ۸ اولین آشنایی با یادگیری عمیق در حوزه بینایی ماشین را از طریق یک کاربرد ساده به شما ارائه داد: طبقهبندی دودویی تصاویر. اما بینایی ماشین بسیار فراتر از طبقهبندی تصویر است! این فصل بهطور عمیقتر به یکی دیگر از کاربردهای ضروری بینایی ماشین میپردازد — یعنی قطعهبندی تصویر (Image Segmentation).
وظایف بینایی ماشین
Section titled “وظایف بینایی ماشین”تاکنون، تمرکز ما بر روی مدلهای طبقهبندی تصویر بوده است: یک تصویر وارد میشود و یک برچسب بیرون میآید. «این تصویر احتمالاً حاوی یک گربه است؛ آن یکی احتمالاً حاوی یک سگ است.» اما طبقهبندی تصویر تنها یکی از چندین کاربرد ممکن یادگیری عمیق در بینایی ماشین است. بهطور کلی، سه وظیفه اساسی در بینایی ماشین وجود دارد که باید درباره آنها بدانید:
- طبقهبندی تصویر (Image classification) ، که هدف آن اختصاص دادن یک یا چند برچسب به یک تصویر است. این کار میتواند بهصورت طبقهبندی تکبرچسبی (single-label classification) باشد (بدین معنی که دستهها مانعالجمع هستند و تصویر فقط به یک دسته تعلق دارد) و یا طبقهبندی چندبرچسبی (multilabel classification) (برچسبگذاری تمامی دستههایی که یک تصویر به آنها تعلق دارد، همانطور که در شکل ۱۱.۱ نشان داده شده است). برای مثال، زمانی که یک کلیدواژه را در اپلیکیشن Google Photos جستجو میکنید، در پشت صحنه در حال پرسوجو از یک مدل طبقهبندی چندبرچسبی بسیار بزرگ هستید — مدلی با بیش از ۲۰,۰۰۰ کلاس مختلف که بر روی میلیونها تصویر آموزش دیده است.
- قطعهبندی تصویر (Image segmentation) ، که هدف آن «قطعهبندی» یا «افراز» (بخشبندی) یک تصویر به نواحی مختلف است، بهطوری که هر ناحیه معمولاً نماینده یک دسته است (همانطور که در شکل ۱۱.۱ نشان داده شده است). بهعنوان نمونه، هنگامی که نرمافزارهای Zoom یا Google Meet در یک تماس ویدیویی یک پسزمینه سفارشی را در پشت سر شما نمایش میدهند، در حال استفاده از یک مدل قطعهبندی تصویر هستند تا چهره و بدن شما را از آنچه در پشت سرتان قرار دارد، با دقت در سطح پیکسل تفکیک کنند.
- تشخیص اشیاء (Object detection) ، که هدف آن رسم مستطیلهایی (موسوم به کادرهای محاطی یا bounding boxes ) به دور اشیاء مورد نظر در یک تصویر و مرتبط ساختن هر مستطیل با یک کلاس مشخص است. برای مثال، یک خودروی خودران میتواند از یک مدل تشخیص اشیاء برای پایش خودروها، عابران پیاده و علائم راهنمایی و رانندگی در میدان دید دوربینهای خود استفاده کند.
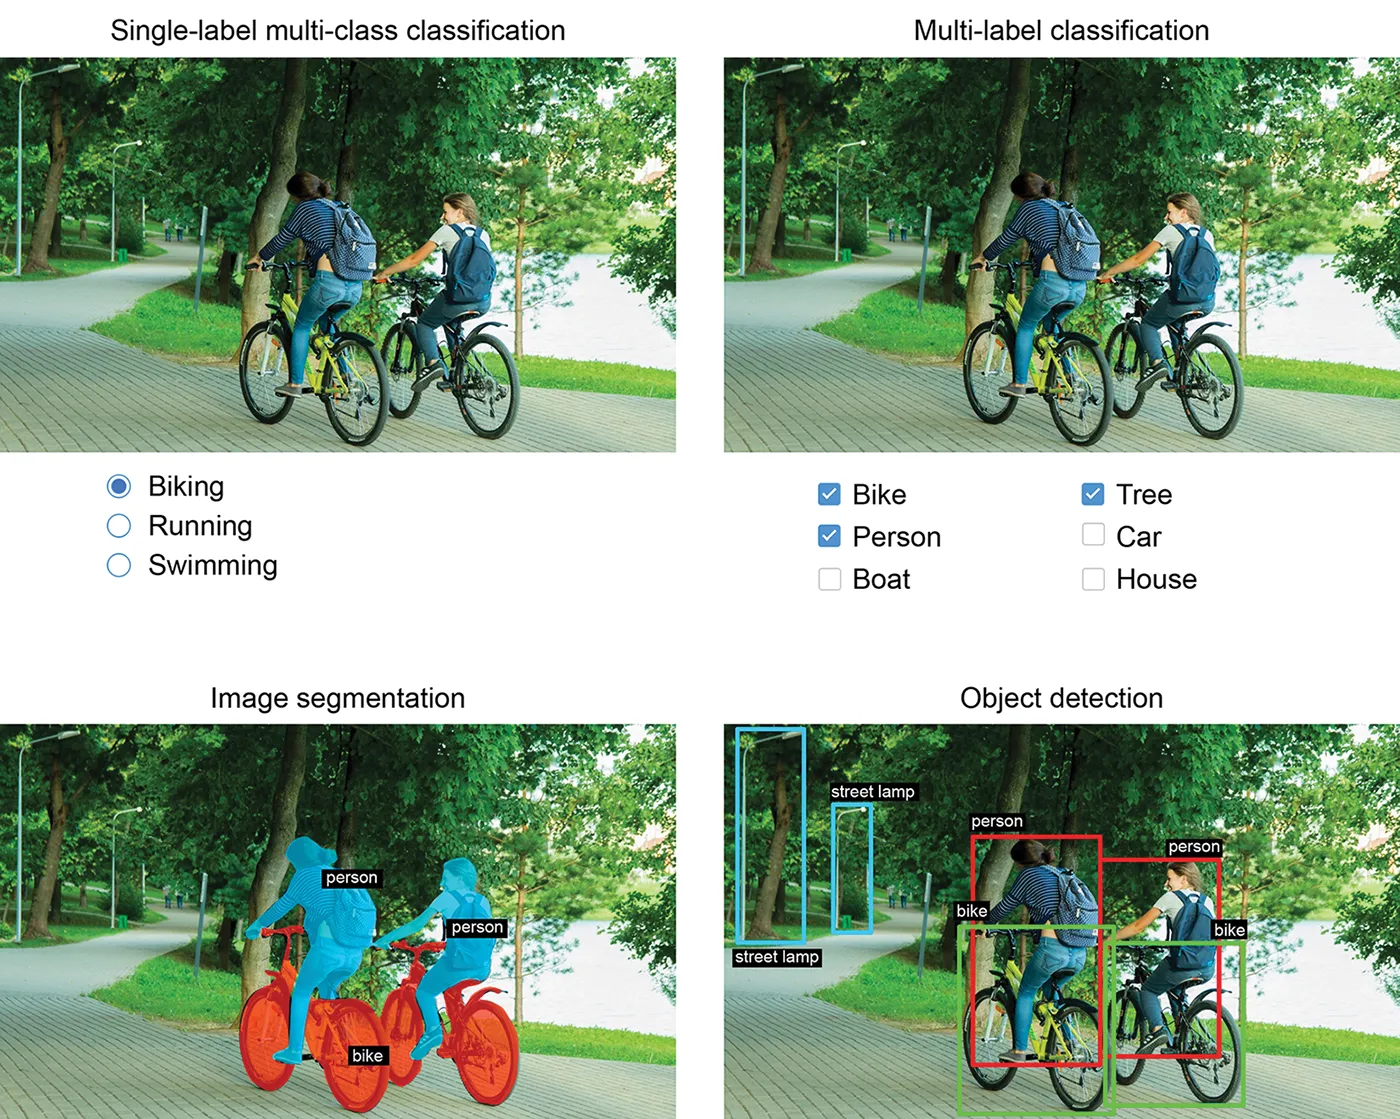
شکل ۱۱.۱: سه وظیفه اصلی بینایی ماشین: طبقهبندی، قطعهبندی و تشخیص
یادگیری عمیق برای بینایی ماشین علاوه بر این سه مورد، شامل تعدادی وظایف تخصصیتر نیز میشود، از جمله امتیازدهی شباهت تصویر (تخمین میزان شباهت بصری دو تصویر به یکدیگر)، تشخیص نقاط کلیدی (keypoint detection - مشخص کردن دقیق ویژگیهای مورد نظر در یک تصویر، مانند اجزای صورت)، تخمین حالت بدن (pose estimation)، تخمین مش سهبعدی (3D mesh estimation)، تخمین عمق (depth estimation) و موارد دیگر. اما برای شروع، طبقهبندی تصویر، قطعهبندی تصویر و تشخیص اشیاء پایههای اصلی را تشکیل میدهند که هر مهندس یادگیری ماشین باید با آنها آشنا باشد. تقریباً تمام کاربردهای بینایی ماشین به یکی از این سه مورد خلاصه میشوند.
شما در فصل ۸ طبقهبندی تصویر را در عمل دیدید. در ادامه، بیایید به سراغ قطعهبندی تصویر برویم. این یک تکنیک بسیار کاربردی و همهکاره است و با آموختههای قبلی خود میتوانید بهراحتی به سراغ آن بروید. سپس، در فصل بعدی، با جزئیات کامل درباره تشخیص اشیاء خواهید آموخت.
انواع قطعهبندی تصویر
Section titled “انواع قطعهبندی تصویر”قطعهبندی تصویر با یادگیری عمیق عبارت است از استفاده از یک مدل برای اختصاص دادن یک کلاس به هر پیکسل در یک تصویر، و در نتیجه قطعهبندی (بخشبندی) تصویر به نواحی مختلف (مانند «پسزمینه» و «پیشزمینه» یا «جاده»، «خودرو» و «پیادهرو»). این دسته کلی از تکنیکها میتواند برای راهاندازی طیف بسیار گستردهای از کاربردهای ارزشمند در ویرایش تصویر و ویدیو، رانندگی خودران، رباتیک، تصویربرداری پزشکی و غیره مورد استفاده قرار گیرد.
سه نوع مختلف از قطعهبندی تصویر وجود دارد که باید درباره آنها بدانید:
- قطعهبندی معنایی (Semantic segmentation) ، که در آن هر پیکسل بهطور مستقل در یک دسته معنایی، مانند «گربه»، طبقهبندی میشود. اگر دو گربه در تصویر وجود داشته باشد، تمام پیکسلهای متناظر با آنها به همان دسته کلی «گربه» نگاشت میشوند (شکل ۱۱.۲ را ببینید).
- قطعهبندی نمونه (Instance segmentation) ، که به دنبال تفکیک نمونههای مجزای اشیاء است. در تصویری که دو گربه در آن حضور دارند، قطعهبندی نمونه میان پیکسلهای متعلق به «گربه ۱» و پیکسلهای متعلق به «گربه ۲» تمایز قائل میشود (شکل ۱۱.۲ را ببینید).
- قطعهبندی پانوراما / جامع (Panoptic segmentation) ، که قطعهبندی معنایی و قطعهبندی نمونه را با اختصاص دادن هر دو برچسب معنایی (مانند «گربه») و برچسب نمونه (مانند «گربه ۲») به هر پیکسل در تصویر ترکیب میکند. این روش، غنیترین و آموزندهترین نوع در میان هر سه نوع قطعهبندی است.
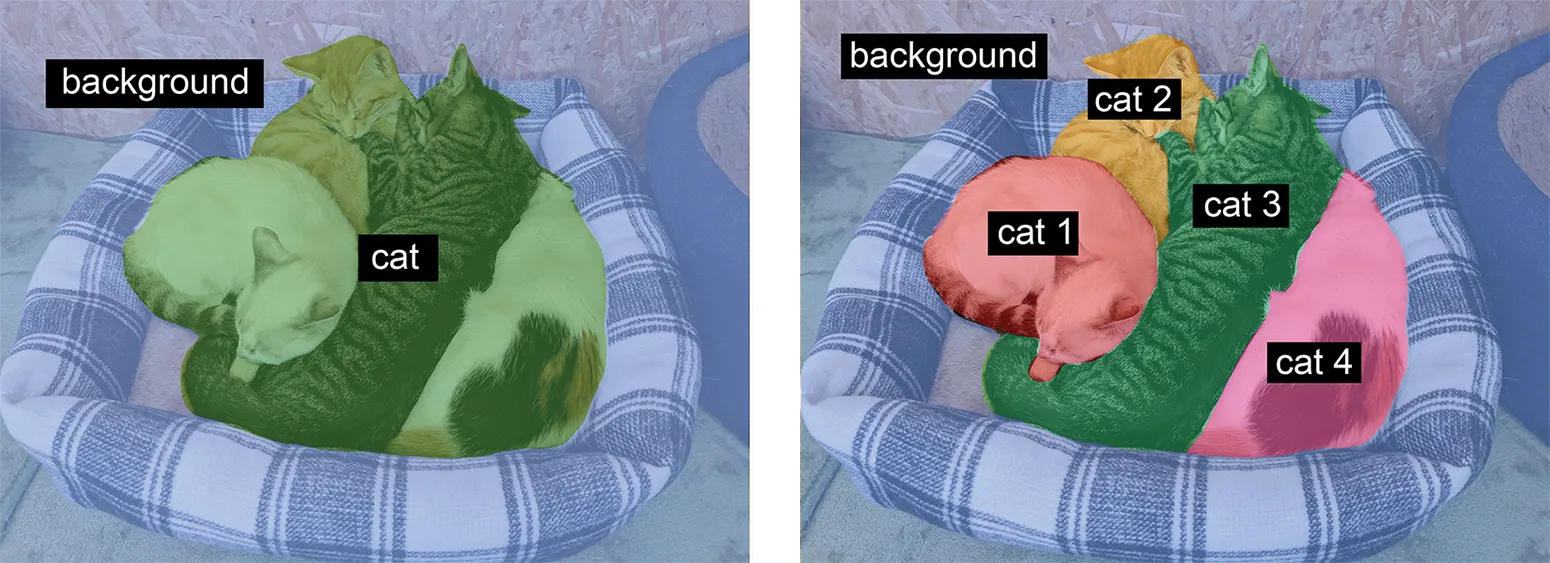
شکل ۱۱.۲: قطعهبندی معنایی در برابر قطعهبندی نمونه
برای آشنایی بیشتر با قطعهبندی، بیایید کار را با آموزش دادن یک مدل کوچک قطعهبندی از پایه بر روی دادههای خودمان آغاز کنیم.
آموزش یک مدل قطعهبندی از پایه
Section titled “آموزش یک مدل قطعهبندی از پایه”در این مثال اول، ما بر روی قطعهبندی معنایی تمرکز خواهیم کرد. بار دیگر به سراغ تصاویر گربهها و سگها میرویم و این بار یاد میگیریم که چگونه سوژه اصلی و پسزمینه آن را از یکدیگر تشخیص دهیم.
دانلود یک مجموعهداده قطعهبندی
Section titled “دانلود یک مجموعهداده قطعهبندی”ما با مجموعهداده Oxford-IIIT Pets (https://www.robots.ox.ac.uk/~vgg/data/pets/) کار خواهیم کرد که شامل ۷,۳۹۰ تصویر از نژادهای مختلف گربه و سگ، به همراه ماسکهای قطعهبندی (segmentation masks) پیشزمینه-پسزمینه برای هر تصویر است. یک ماسک قطعهبندی، معادل یک برچسب در وظیفه قطعهبندی تصویر است: تصویری هماندازه با تصویر ورودی، با یک کانال رنگی واحد که در آن هر مقدار عدد صحیح، متناظر با کلاس پیکسل مربوطه در تصویر ورودی است. در مورد ما، پیکسلهای ماسکهای قطعهبندی میتوانند یکی از سه مقدار عدد صحیح زیر را اختیار کنند:
- ۱ (پیشزمینه / سوژه)
- ۲ (پسزمینه)
- ۳ (خطوط مرزی / دورخط)
بیایید با دانلود و استخراج (خارج کردن از حالت فشرده) مجموعهداده خود با استفاده از ابزارهای خط فرمان wget و tar شروع کنیم:
!wget http://www.robots.ox.ac.uk/~vgg/data/pets/data/images.tar.gz!wget http://www.robots.ox.ac.uk/~vgg/data/pets/data/annotations.tar.gz!tar -xf images.tar.gz!tar -xf annotations.tar.gzتصاویر ورودی بهصورت فایلهای JPG در پوشه images/ ذخیره شدهاند (مانند images/Abyssinian_1.jpg)، و ماسک قطعهبندی متناظر با هر کدام بهصورت یک فایل PNG با همان نام در پوشه annotations/trimaps/ ذخیره شده است (مانند annotations/trimaps/Abyssinian_1.png).
بیایید فهرست مسیر فایلهای ورودی و همچنین فهرست مسیر فایلهای ماسک متناظر با آنها را آماده کنیم:
import pathlib
input_dir = pathlib.Path("images")target_dir = pathlib.Path("annotations/trimaps")
input_img_paths = sorted(input_dir.glob("*.jpg"))# Ignores some spurious files in the trimaps directory that start with# a "."target_paths = sorted(target_dir.glob("[!.]*.png"))
حال، یکی از این ورودیها و ماسک متناظرش چه شکلی است؟ بیایید نگاهی سریع به آن بیندازیم (شکل ۱۱.۳ را ببینید).
import matplotlib.pyplot as pltfrom keras.utils import load_img, img_to_array, array_to_img
plt.axis("off")# Displays input image number 9plt.imshow(load_img(input_img_paths[9]))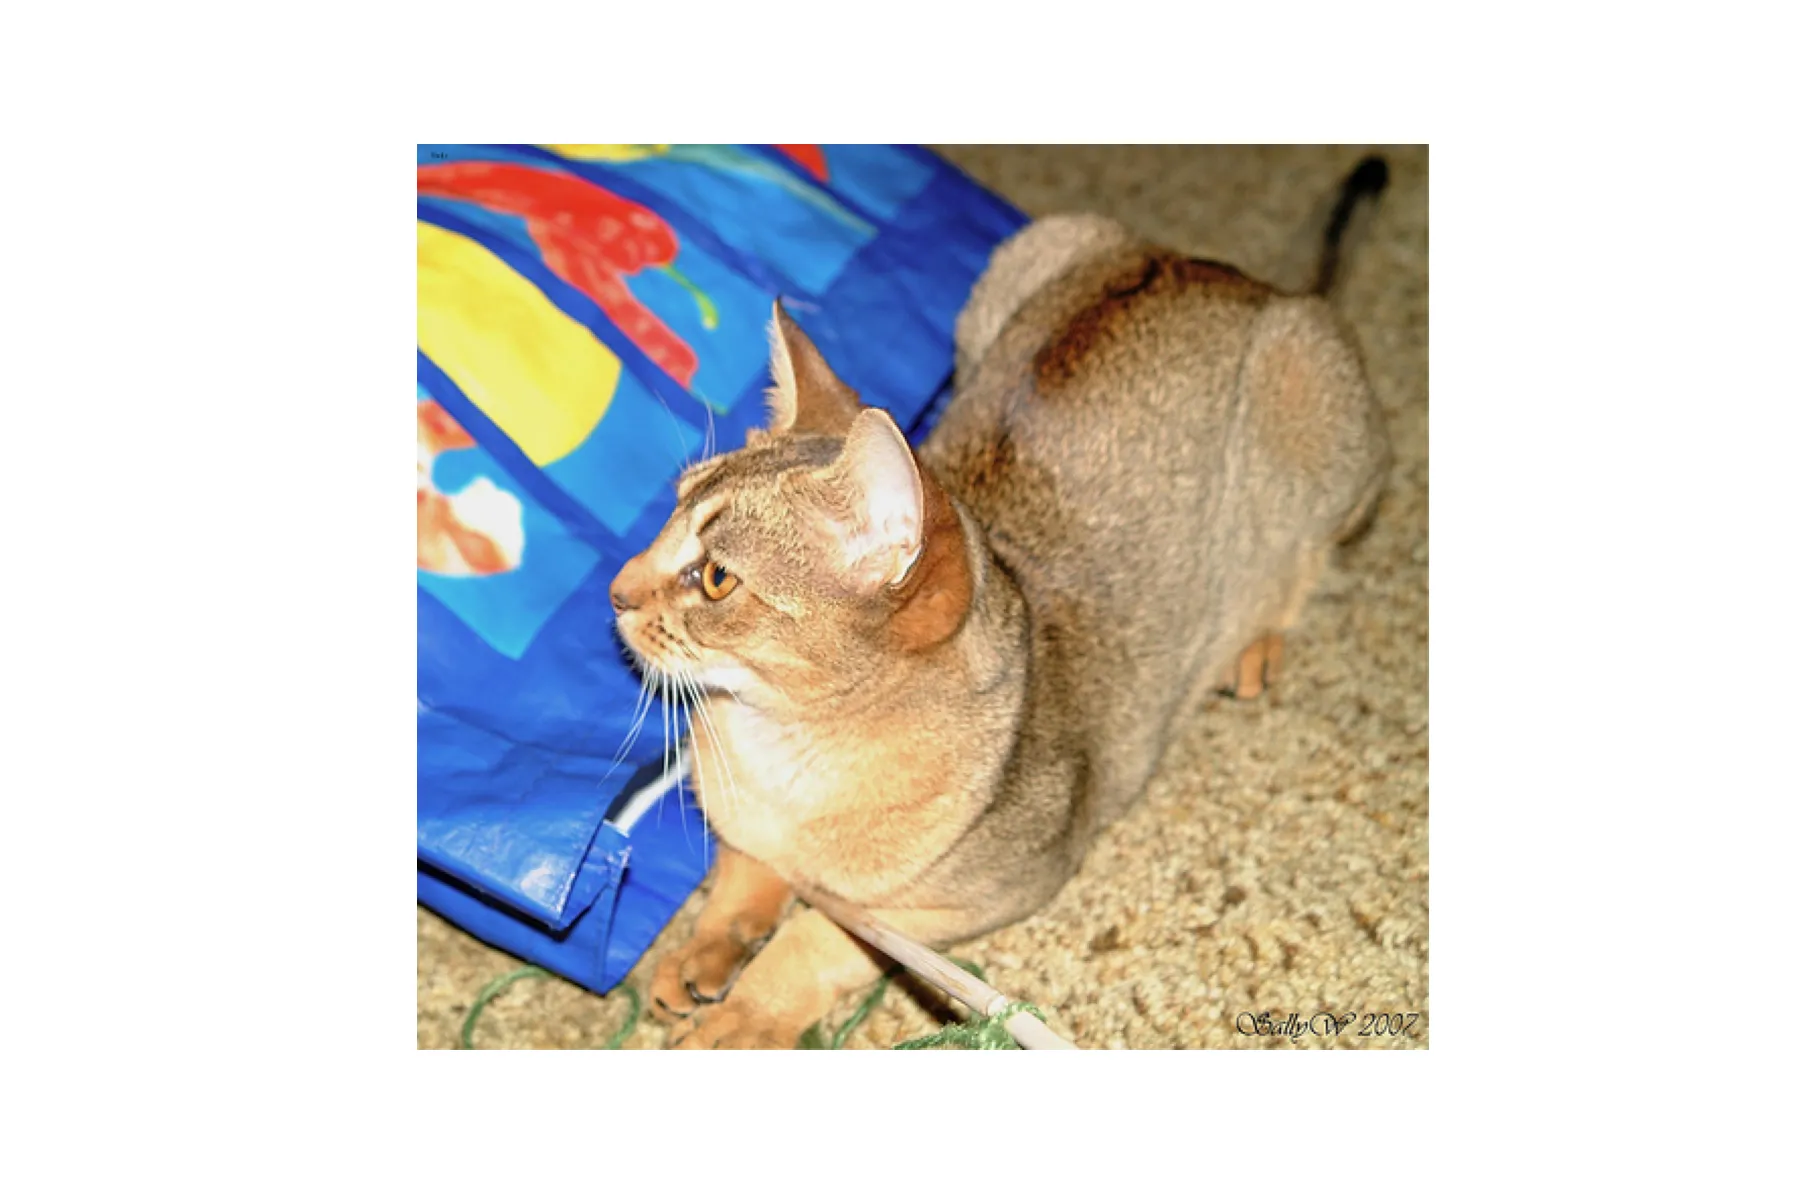
شکل ۱۱.۳: یک تصویر نمونه
بیایید به ماسک هدف آن نیز نگاهی بیندازیم (شکل ۱۱.۴ را ببینید):
def display_target(target_array):    # The original labels are 1, 2, and 3. We subtract 1 so that the    # labels range from 0 to 2, and then we multiply by 127 so that the    # labels become 0 (black), 127 (gray), 254 (near-white).    normalized_array = (target_array.astype("uint8") - 1) * 127    plt.axis("off")    plt.imshow(normalized_array[:, :, 0])
# We use color_mode='grayscale' so that the image we load is treated as# having a single color channel.img = img_to_array(load_img(target_paths[9], color_mode="grayscale"))display_target(img)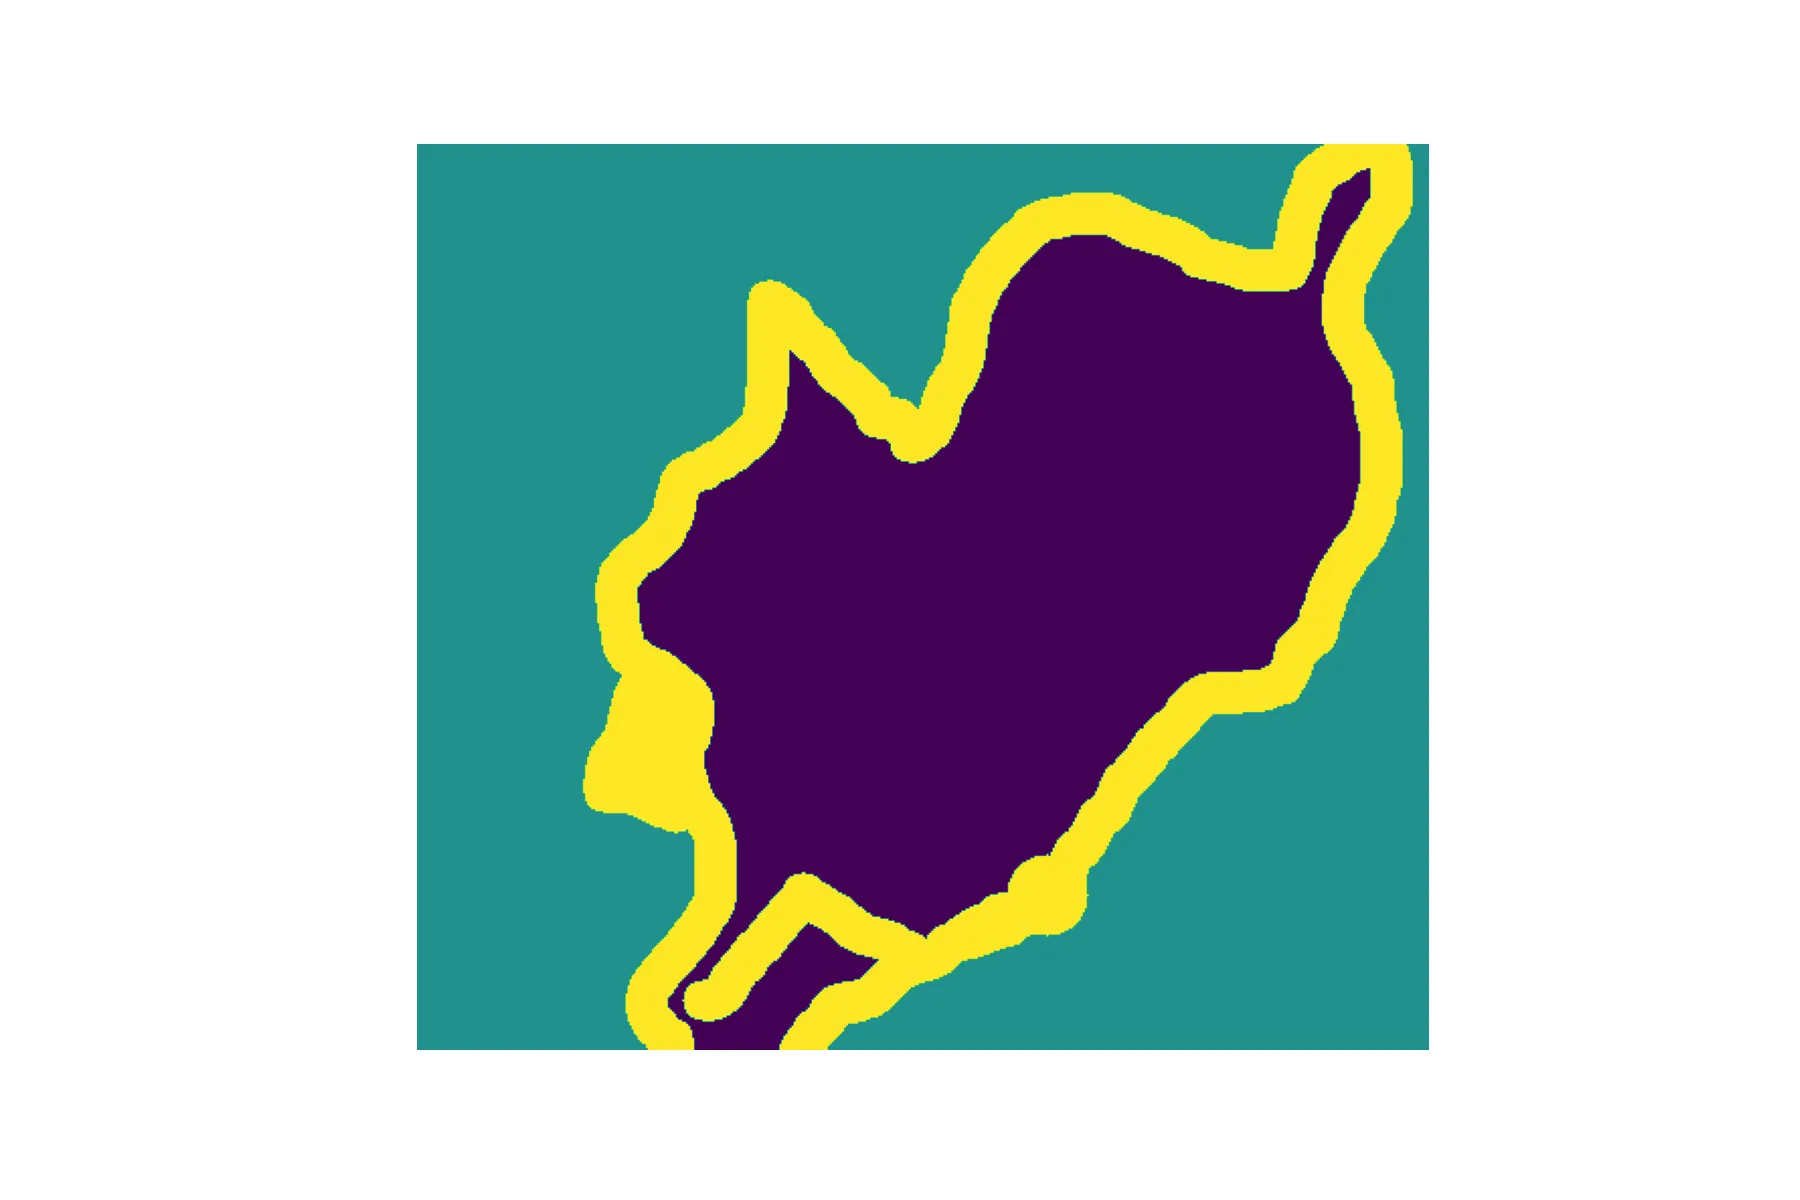
شکل ۱۱.۴: ماسک هدف متناظر
در مرحله بعد، بیایید ورودیها و اهداف (targets) خود را در دو آرایه NumPy بارگذاری کنیم. از آنجا که این مجموعهداده بسیار کوچک است، میتوانیم همهچیز را در حافظه (RAM) بارگذاری کنیم:
import numpy as npimport random
# We resize everything to 200 x 200 for this example.img_size = (200, 200)# Total number of samples in the datanum_imgs = len(input_img_paths)
# Shuffles the file paths (they were originally sorted by breed). We# use the same seed (1337) in both statements to ensure that the input# paths and target paths stay in the same order.random.Random(1337).shuffle(input_img_paths)random.Random(1337).shuffle(target_paths)
def path_to_input_image(path):    return img_to_array(load_img(path, target_size=img_size))
def path_to_target(path):    img = img_to_array(        load_img(path, target_size=img_size, color_mode="grayscale")    )    # Subtracts 1 so that our labels become 0, 1, and 2    img = img.astype("uint8") - 1    return img
# Loads all images in the input_imgs float32 array and their masks in# the targets uint8 array (same order). The inputs have three channels# (RGB values), and the targets have a single channel (which contains# integer labels).input_imgs = np.zeros((num_imgs,) + img_size + (3,), dtype="float32")targets = np.zeros((num_imgs,) + img_size + (1,), dtype="uint8")for i in range(num_imgs):    input_imgs[i] = path_to_input_image(input_img_paths[i])    targets[i] = path_to_target(target_paths[i])
طبق معمول، بیایید آرایهها را به دو مجموعه آموزشی (training) و اعتبارسنجی (validation) تقسیم کنیم:
# Reserves 1,000 samples for validationnum_val_samples = 1000# Splits the data into a training and a validation settrain_input_imgs = input_imgs[:-num_val_samples]train_targets = targets[:-num_val_samples]val_input_imgs = input_imgs[-num_val_samples:]val_targets = targets[-num_val_samples:]ساخت و آموزش مدل قطعهبندی
Section titled “ساخت و آموزش مدل قطعهبندی”اکنون زمان تعریف مدل ما فرا رسیده است:
import kerasfrom keras.layers import Rescaling, Conv2D, Conv2DTranspose
def get_model(img_size, num_classes):    inputs = keras.Input(shape=img_size + (3,))    # Don't forget to rescale input images to the [0–1] range.    x = Rescaling(1.0 / 255)(inputs)
    # We use padding="same" everywhere to avoid the influence of border    # padding on feature map size.    x = Conv2D(64, 3, strides=2, activation="relu", padding="same")(x)    x = Conv2D(64, 3, activation="relu", padding="same")(x)    x = Conv2D(128, 3, strides=2, activation="relu", padding="same")(x)    x = Conv2D(128, 3, activation="relu", padding="same")(x)    x = Conv2D(256, 3, strides=2, padding="same", activation="relu")(x)    x = Conv2D(256, 3, activation="relu", padding="same")(x)
    x = Conv2DTranspose(256, 3, activation="relu", padding="same")(x)    x = Conv2DTranspose(256, 3, strides=2, activation="relu", padding="same")(x)    x = Conv2DTranspose(128, 3, activation="relu", padding="same")(x)    x = Conv2DTranspose(128, 3, strides=2, activation="relu", padding="same")(x)    x = Conv2DTranspose(64, 3, activation="relu", padding="same")(x)    x = Conv2DTranspose(64, 3, strides=2, activation="relu", padding="same")(x)
    # We end the model with a per-pixel three-way softmax to classify    # each output pixel into one of our three categories.    outputs = Conv2D(num_classes, 3, activation="softmax", padding="same")(x)
    return keras.Model(inputs, outputs)
model = get_model(img_size=img_size, num_classes=3)
نیمه اول مدل شباهت زیادی به نوع شبکههای کانولوشنی (ConvNet) دارد که برای طبقهبندی تصویر استفاده میکنید: پشتهای از لایههای Conv2D، با اندازه فیلترهایی که بهتدریج افزایش مییابند. ما تصاویر خود را سه بار و هر بار با ضریب دو، کاهش نمونه (downsample) میدهیم — و در نهایت به فعالسازیهایی (activations) با اندازه (25, 25, 256) میرسیم. هدف از این نیمه اول، رمزگذاری (encode) تصاویر به نقشههای ویژگی کوچکتر است، جایی که هر مکان فضایی (یا «پیکسل») حاوی اطلاعاتی درباره یک بخش فضایی بزرگ از تصویر اصلی است. میتوانید آن را بهعنوان نوعی فشردهسازی درک کنید.
یک تفاوت مهم بین نیمه اول این مدل و مدلهای طبقهبندی که قبلاً دیدهاید، روشی است که ما برای کاهش نمونهبرداری (downsampling) استفاده میکنیم: در شبکههای کانولوشنی طبقهبندی از فصل ۸، ما از لایههای MaxPooling2D برای کاهش اندازه نقشههای ویژگی استفاده کردیم. در اینجا، ما کاهش نمونهبرداری را با افزودن گامها (strides) به یک در میان لایههای کانولوشن انجام میدهیم (اگر جزئیات نحوه کارکرد گامهای کانولوشن را به خاطر ندارید، به فصل ۸، بخش ۸.۱.۱ مراجعه کنید). ما این کار را انجام میدهیم زیرا در مبحث قطعهبندی تصویر، مکان فضایی اطلاعات در تصویر برایمان بسیار اهمیت دارد، چرا که باید ماسکهای هدف را به ازای هر پیکسل بهعنوان خروجی مدل تولید کنیم. هنگامی که شما ادغام بیشینه (max pooling) با ابعاد ۲ × ۲ انجام میدهید، اطلاعات مکانی درون هر پنجره ادغام را بهطور کامل از بین میبرید: شما به ازای هر پنجره یک مقدار اسکالر واحد برمیگردانید، با آگاهی صفر از اینکه این مقدار از کدامیک از چهار مکان داخل پنجره آمده است.
بنابراین، در حالی که لایههای ادغام بیشینه (max pooling) برای وظایف طبقهبندی عملکرد خوبی دارند، در یک وظیفه قطعهبندی آسیب جدی به عملکرد ما وارد میکنند. در مقابل، کانولوشنهای گامدار (strided convolutions) در حین حفظ اطلاعات مکانی، کار بهتری در کاهش اندازه نقشههای ویژگی انجام میدهند. در سراسر این کتاب، متوجه خواهید شد که در هر مدلی که به مکان ویژگیها اهمیت میدهد — مانند مدلهای مولد در فصل ۱۷ — ما تمایل داریم از گامها (strides) به جای ادغام بیشینه استفاده کنیم.
نیمه دوم مدل، پشتهای از لایههای Conv2DTranspose است. این لایهها چه هستند؟ خب، خروجی نیمه اول مدل یک نقشهٔ ویژگی با شکل (25, 25, 256) است، اما ما میخواهیم خروجی نهایی ما برای هر پیکسل یک کلاس را پیشبینی کند که با ابعاد فضایی اصلی مطابقت داشته باشد. خروجی نهایی مدل دارای شکل (200, 200, num_classes) خواهد بود که در اینجا برابر با (200, 200, 3) است. بنابراین، ما باید نوعی معکوس از تبدیلهایی که تاکنون اعمال کردهایم را به کار ببریم؛ چیزی که نقشههای ویژگی را به جای کاهش نمونهبرداری، افزایش نمونهبرداری (upsample) دهد. این دقیقاً هدف لایه Conv2DTranspose است: میتوانید آن را بهعنوان نوعی لایه کانولوشن در نظر بگیرید که یاد میگیرد چگونه افزایش نمونهبرداری (بزرگنمایی) انجام دهد. اگر یک ورودی با شکل (100, 100, 64) داشته باشید و آن را از لایه Conv2D(128, 3, strides=2, padding="same") عبور دهید، خروجیای با شکل (50, 50, 128) دریافت میکنید. اگر این خروجی را از لایه Conv2DTranspose(64, 3, strides=2, padding="same") عبور دهید، دوباره خروجیای با شکل (100, 100, 64)، دقیقاً مشابه حالت اولیه، به دست میآورید. بنابراین، پس از فشردهسازی ورودیهایمان به نقشههای ویژگی با شکل (25, 25, 256) از طریق پشتهای از لایههای Conv2D، میتوانیم بهسادگی دنباله متناظری از لایههای Conv2DTranspose و در ادامه یک لایه نهایی Conv2D را اعمال کنیم تا خروجیهایی با شکل (200, 200, 3) تولید شود.
برای ارزیابی مدل، از معیاری به نام اشتراک بر اجتماع (Intersection over Union - IoU) استفاده خواهیم کرد. این معیار، میزان تطابق بین ماسکهای قطعهبندی واقعی (ground truth) و ماسکهای پیشبینیشده را اندازهگیری میکند. این معیار میتواند برای هر کلاس بهطور جداگانه محاسبه شود یا میانگین آن بر روی چندین کلاس گرفته شود. نحوه کارکرد آن به این صورت است:
- اشتراک (intersection) بین ماسکها را محاسبه کنید؛ یعنی ناحیهای که در آن پیشبینی مدل و واقعیت (ground truth) با هم همپوشانی دارند.
- اجتماع (union) ماسکها را محاسبه کنید؛ یعنی کل مساحتی که توسط هر دو ماسک در کنار هم پوشش داده شده است. این کل فضایی است که ما به آن علاقهمندیم — شیء هدف به علاوه هر بخش اضافی که مدل شما ممکن است به اشتباه وارد کرده باشد.
- مساحت اشتراک را بر مساحت اجتماع تقسیم کنید تا مقدار IoU به دست آید. این مقدار عددی بین ۰ و ۱ است، که در آن ۱ نشاندهنده تطابق کامل و ۰ نشاندهنده عدم تطابق کامل است.
به جای اینکه خودمان این معیار را پیادهسازی کنیم، میتوانیم بهسادگی از یک معیار توکار (built-in) در Keras استفاده کنیم:
foreground_iou = keras.metrics.IoU( # Specifies the total number of classes num_classes=3, # Specifies the class to compute IoU for (0 = foreground) target_class_ids=(0,), name="foreground_iou", # Our targets are sparse (integer class IDs). sparse_y_true=True, # But our model's predictions are a dense softmax! sparse_y_pred=False,)اکنون میتوانیم مدل خود را کامپایل و آموزش (fit) دهیم:
model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=[foreground_iou],)callbacks = [ keras.callbacks.ModelCheckpoint( "oxford_segmentation.keras", save_best_only=True, ),]history = model.fit( train_input_imgs, train_targets, epochs=50, callbacks=callbacks, batch_size=64, validation_data=(val_input_imgs, val_targets),)بیایید نمودار خطای (loss) آموزش و اعتبارسنجی را نمایش دهیم (شکل ۱۱.۵ را ببینید):
epochs = range(1, len(history.history["loss"]) + 1)loss = history.history["loss"]val_loss = history.history["val_loss"]plt.figure()plt.plot(epochs, loss, "r--", label="Training loss")plt.plot(epochs, val_loss, "b", label="Validation loss")plt.title("Training and validation loss")plt.legend()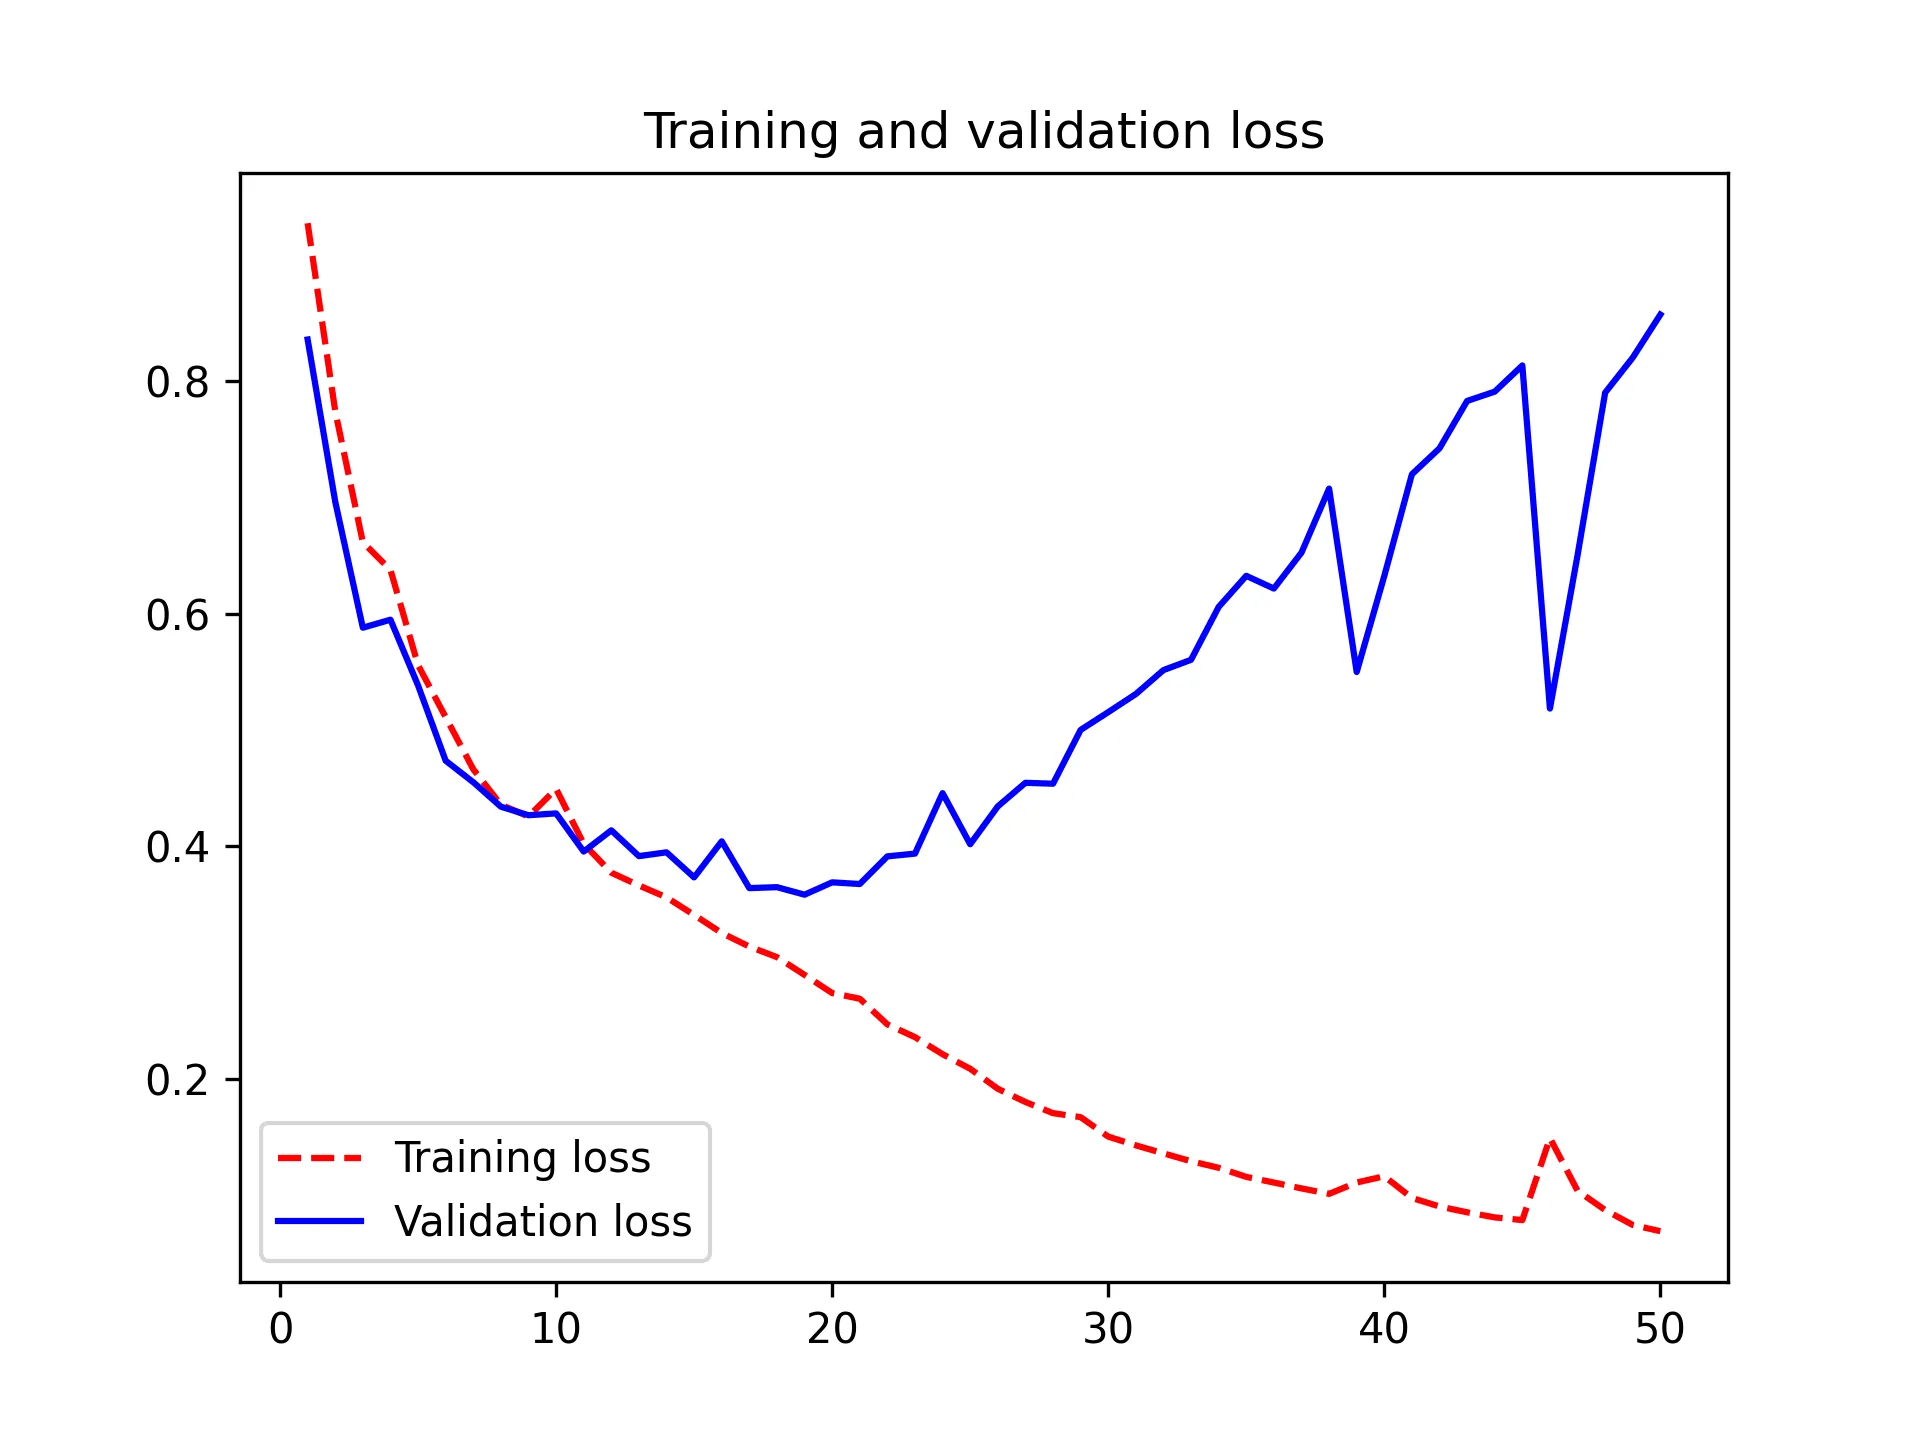
شکل ۱۱.۵: نمایش منحنیهای خطای آموزش و اعتبارسنجی
میتوانید ببینید که در اواسط کار، حدود دور (epoch) ۲۵، دچار بیشبرازش (overfitting) میشویم. بیایید بهترین مدل خود را بر اساس کمترین خطای اعتبارسنجی مجدداً بارگذاری کنیم و نحوه استفاده از آن برای پیشبینی یک ماسک قطعهبندی را نشان دهیم (شکل ۱۱.۶ را ببینید):
model = keras.models.load_model("oxford_segmentation.keras")
i = 4test_image = val_input_imgs[i]plt.axis("off")plt.imshow(array_to_img(test_image))
mask = model.predict(np.expand_dims(test_image, 0))[0]
# Utility to display a model's predictiondef display_mask(pred):    mask = np.argmax(pred, axis=-1)    mask *= 127    plt.axis("off")    plt.imshow(mask)
display_mask(mask)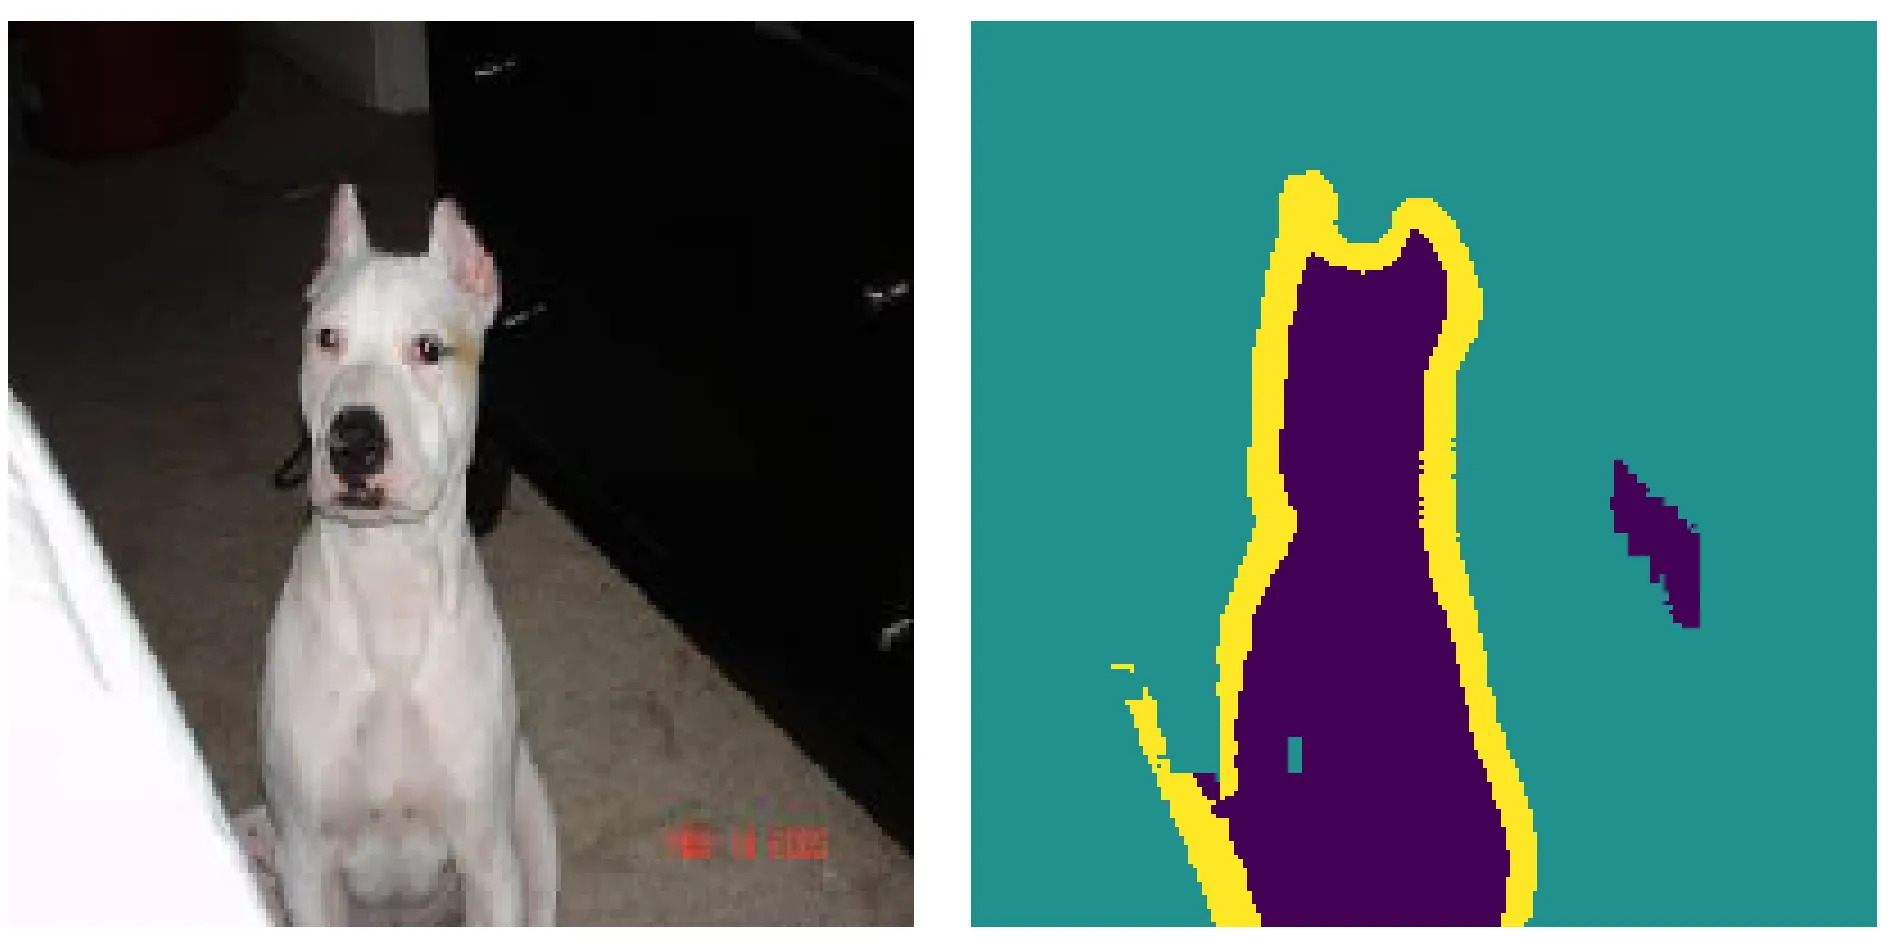
شکل ۱۱.۶: یک تصویر آزمایشی و ماسک قطعهبندی پیشبینیشده برای آن
چند نویز و خطای کوچک (artifacts) در ماسک پیشبینیشده ما وجود دارد که ناشی از اشکال هندسی در پیشزمینه و پسزمینه است. با این حال، به نظر میرسد مدل ما بهخوبی کار میکند.
استفاده از یک مدل قطعهبندی ازپیشآموزشدیده
Section titled “استفاده از یک مدل قطعهبندی ازپیشآموزشدیده”در مثال طبقهبندی تصویر از فصل ۸، دیدید که چگونه استفاده از یک مدل ازپیشآموزشدیده میتواند دقت شما را بهطور چشمگیری افزایش دهد — بهویژه زمانی که تنها تعداد کمی نمونه برای آموزش در اختیار دارید. قطعهبندی تصویر نیز از این قاعده مستثنی نیست.
مدل قطعهبندی هر چیز (Segment Anything Model)،1 یا به اختصار SAM، یک مدل قطعهبندی ازپیشآموزشدیده قدرتمند است که میتوانید از آن برای، خب، تقریباً هر چیزی استفاده کنید. این مدل توسط Meta AI توسعه یافته و در آوریل ۲۰۲۳ منتشر شده است. این مدل بر روی ۱۱ میلیون تصویر و ماسکهای قطعهبندی آنها آموزش دیده است که بیش از ۱ میلیارد نمونه شیء را پوشش میدهد. این حجم عظیم از دادههای آموزشی، دانش درونی (built-in) درباره تقریباً هر شیئی که در تصاویر طبیعی ظاهر میشود را در اختیار مدل قرار میدهد.
نوآوری اصلی SAM در این است که به یک مجموعه ازپیشتعریفشده از کلاسهای اشیاء محدود نیست. شما میتوانید از آن برای قطعهبندی اشیاء جدید تنها با ارائه یک نمونه (یا اشاره) از آنچه به دنبالش هستید استفاده کنید. حتی نیازی نیست ابتدا مدل را تنظیم دقیق (fine-tune) کنید. بیایید ببینیم این کار چگونه انجام میشود.
دانلود مدل Segment Anything
Section titled “دانلود مدل Segment Anything”ابتدا، بیایید یک نمونه از SAM بسازیم و وزنهای آن را دانلود کنیم. بار دیگر، میتوانیم از بسته KerasHub برای استفاده از این مدل ازپیشآموزشدیده بهره ببریم، بدون اینکه نیازی به پیادهسازی آن از پایه داشته باشیم.
وظیفه (task) ImageClassifier را که در فصل قبل استفاده کردیم به خاطر دارید؟ ما میتوانیم از وظیفه دیگری در KerasHub به نام ImageSegmenter برای بستهبندی مدلهای قطعهبندی تصویر ازپیشآموزشدیده در قالب یک مدل سطح بالا با ورودیها و خروجیهای استاندارد استفاده کنیم. در اینجا، ما از مدل ازپیشآموزشدیده sam_huge_sa1b استفاده خواهیم کرد، که در آن sam مخفف نام مدل است، huge به تعداد پارامترهای مدل اشاره دارد، و sa1b مخفف مجموعهداده SA-1B است که به همراه مدل منتشر شده و دارای ۱ میلیارد ماسک حاشیهنویسیشده (برچسبخورده) است. بیایید همین حالا آن را دانلود کنیم:
import keras_hub
model = keras_hub.models.ImageSegmenter.from_preset("sam_huge_sa1b")نکتهای که در همان ابتدا میتوانیم به آن توجه کنیم این است که مدل ما واقعاً عظیم (huge) است:
>>> model.count_params()با ۶۴۱ میلیون پارامتر، SAM بزرگترین مدلی است که تا به اینجا در این کتاب استفاده کردهایم. روند بزرگتر شدن روزافزون مدلهای ازپیشآموزشدیده و استفاده از دادههای بیشتر و بیشتر، با جزئیات بیشتری در فصل ۱۶ مورد بحث قرار خواهد گرفت.
مدل Segment Anything چگونه کار میکند
Section titled “مدل Segment Anything چگونه کار میکند”قبل از اینکه انجام قطعهبندی با این مدل را امتحان کنیم، بیایید کمی بیشتر درباره نحوه کارکرد SAM صحبت کنیم. بخش بزرگی از قابلیتهای این مدل ناشی از مقیاس مجموعهداده پیشآموزش (pretraining) آن است. شرکت Meta مجموعهداده SA-1B را به موازات خود مدل توسعه داد، بهطوری که از مدلِ تا حدی آموزشدیده برای کمک به فرآیند برچسبگذاری دادهها استفاده شد. به عبارت دیگر، مجموعهداده و مدل با هم در نوعی حلقه بازخورد توسعه یافتند.
هدف در مجموعهداده SA-1B ایجاد تصاویر کاملاً قطعهبندیشده است، جایی که به هر شیء در تصویر یک ماسک قطعهبندی منحصربهفرد اختصاص داده میشود. شکل ۱۱.۷ را بهعنوان یک نمونه ببینید. هر تصویر در این مجموعهداده بهطور میانگین دارای حدود ۱۰۰ ماسک است و برخی تصاویر بیش از ۵۰۰ شیء ماسکگذاریشده مجزا دارند. این کار از طریق یک خط لوله (pipeline) جمعآوری داده که بهتدریج خودکارتر میشد، انجام گرفت. در ابتدا، متخصصان انسانی یک مجموعهداده نمونه کوچک از تصاویر را بهصورت دستی قطعهبندی کردند که برای آموزش یک مدل اولیه مورد استفاده قرار گرفت. سپس از این مدل برای پیشبرد مرحله نیمهخودکار جمعآوری دادهها استفاده شد، جایی که تصاویر ابتدا توسط SAM قطعهبندی میشدند و سپس توسط اصلاحات انسانی و حاشیهنویسیهای بیشتر بهبود مییافتند.
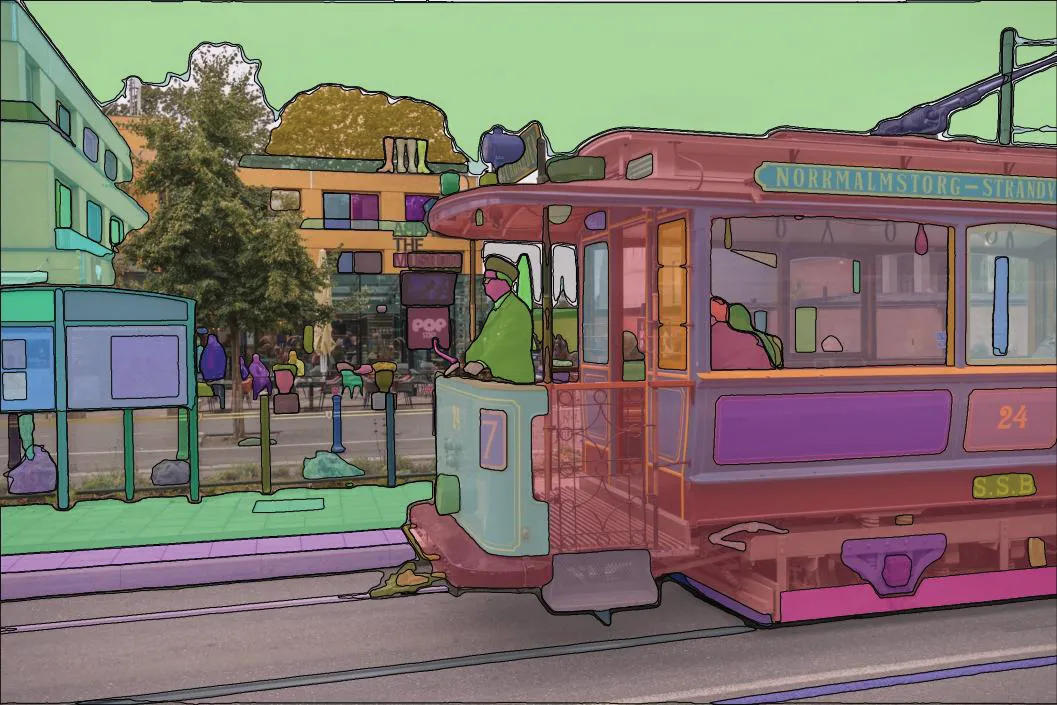
شکل ۱۱.۷: یک تصویر نمونه از مجموعهداده SA-1B
این مدل بر روی سهتاییهای (image, prompt, mask) آموزش دیده است. image (تصویر) و prompt (پرامپت / راهنما) ورودیهای مدل هستند. تصویر میتواند هر تصویر ورودی دلخواهی باشد و پرامپت میتواند یکی از دو شکل زیر را داشته باشد:
- یک نقطه در داخل شیء مورد نظر برای ماسکگذاری
- یک کادر (مستطیل) به دور شیء مورد نظر برای ماسکگذاری
با دریافت ورودیهای image و prompt، از مدل انتظار میرود که یک ماسک پیشبینیشده دقیق برای شیء اشارهشده توسط پرامپت تولید کند، که سپس با برچسب mask واقعی (ground truth) مقایسه میشود.
مدل از چند بخش مجزا تشکیل شده است. یک رمزگذار تصویر (image encoder)، مشابه مدل Xception که در فصلهای قبل استفاده کردیم، یک تصویر ورودی را دریافت کرده و یک تعبیه تصویر (image embedding) بسیار کوچکتر را خروجی میدهد. این چیزی است که از قبل نحوه ساخت آن را میدانیم.
در مرحله بعد، یک رمزگذار پرامپت (prompt encoder) اضافه میکنیم که مسئول نگاشت پرامپتها در هر یک از اشکال ذکرشده قبلی به یک بردار تعبیهشده (embedded vector) است، و همچنین یک رمزگشای ماسک (mask decoder) که هر دو تعبیه تصویر و تعبیه پرامپت را دریافت کرده و چند ماسک پیشبینیشده محتمل را خروجی میدهد. ما در اینجا وارد جزئیات رمزگذار پرامپت و رمزگشای ماسک نخواهیم شد، زیرا آنها از تکنیکهای مدلسازیای استفاده میکنند که تا فصلهای بعدی با آنها آشنا نخواهیم شد. ما میتوانیم این ماسکهای پیشبینیشده را دقیقاً مشابه کاری که در بخش ابتدایی این فصل انجام دادیم، با ماسک واقعی خود مقایسه کنیم (شکل ۱۱.۸ را ببینید).
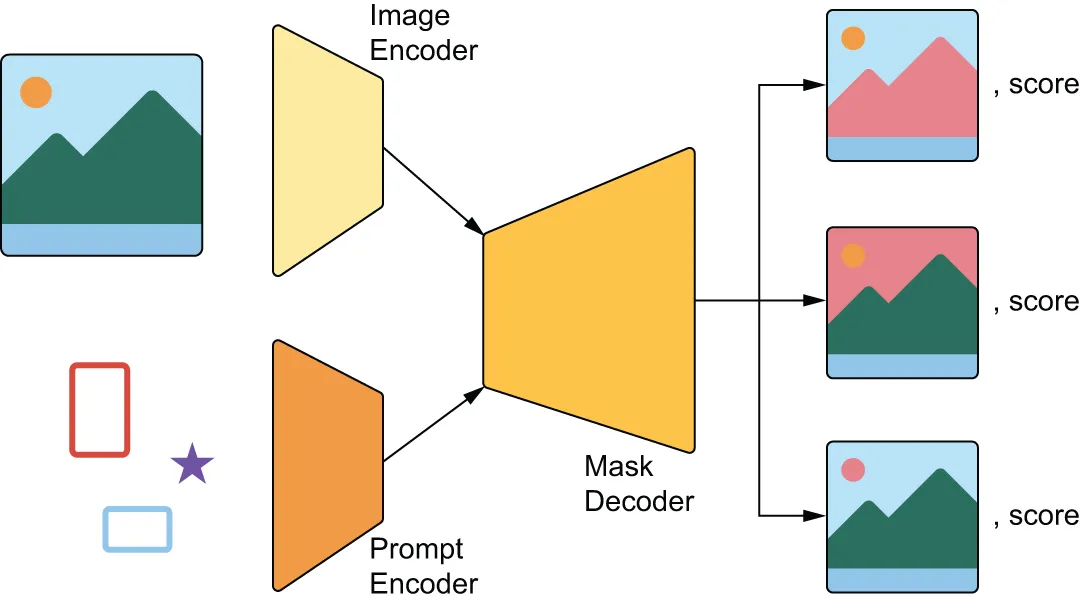
شکل ۱۱.۸: نمای کلی معماری سطح بالای مدل Segment Anything
تمامی این زیربخشها بهطور همزمان و با تشکیل دستههایی (batches) از سهتاییهای جدید (image, prompt, mask) از دادههای تصویر و ماسک مجموعهداده SA-1B آموزش میبینند. فرآیند کار در اینجا در واقع بسیار ساده است. برای یک تصویر ورودی معین، یک ماسک تصادفی را در ورودی انتخاب کنید. سپس، بهطور تصادفی تصمیم بگیرید که یک پرامپت کادری (box prompt) بسازید یا یک پرامپت نقطهای (point prompt). برای ساخت یک پرامپت نقطهای، یک پیکسل تصادفی در داخل برچسب ماسک انتخاب کنید. برای ساخت یک پرامپت کادری، یک کادر به دور تمام نقاط موجود در داخل برچسب ماسک رسم کنید. میتوانیم این فرآیند را بهطور نامحدود تکرار کنیم و تعدادی سهتایی (image, prompt, mask) از هر تصویر ورودی نمونهبرداری کنیم.
آمادهسازی یک تصویر آزمایشی
Section titled “آمادهسازی یک تصویر آزمایشی”بیایید با امتحان کردن مدل، این موضوع را کمی ملموستر کنیم. میتوانیم کار را با بارگذاری یک تصویر آزمایشی برای عملیات قطعهبندی خود شروع کنیم. ما از تصویر یک کاسه میوه استفاده خواهیم کرد (شکل ۱۱.۹ را ببینید):
# Downloads the image and returns the local file pathpath = keras.utils.get_file(    origin="https://s3.amazonaws.com/keras.io/img/book/fruits.jpg")# Loads the image as a Python Imaging Library (PIL) objectpil_image = keras.utils.load_img(path)# Turns the PIL object into a NumPy matriximage_array = keras.utils.img_to_array(pil_image)
# Displays the NumPy matrixplt.imshow(image_array.astype("uint8"))plt.axis("off")plt.show()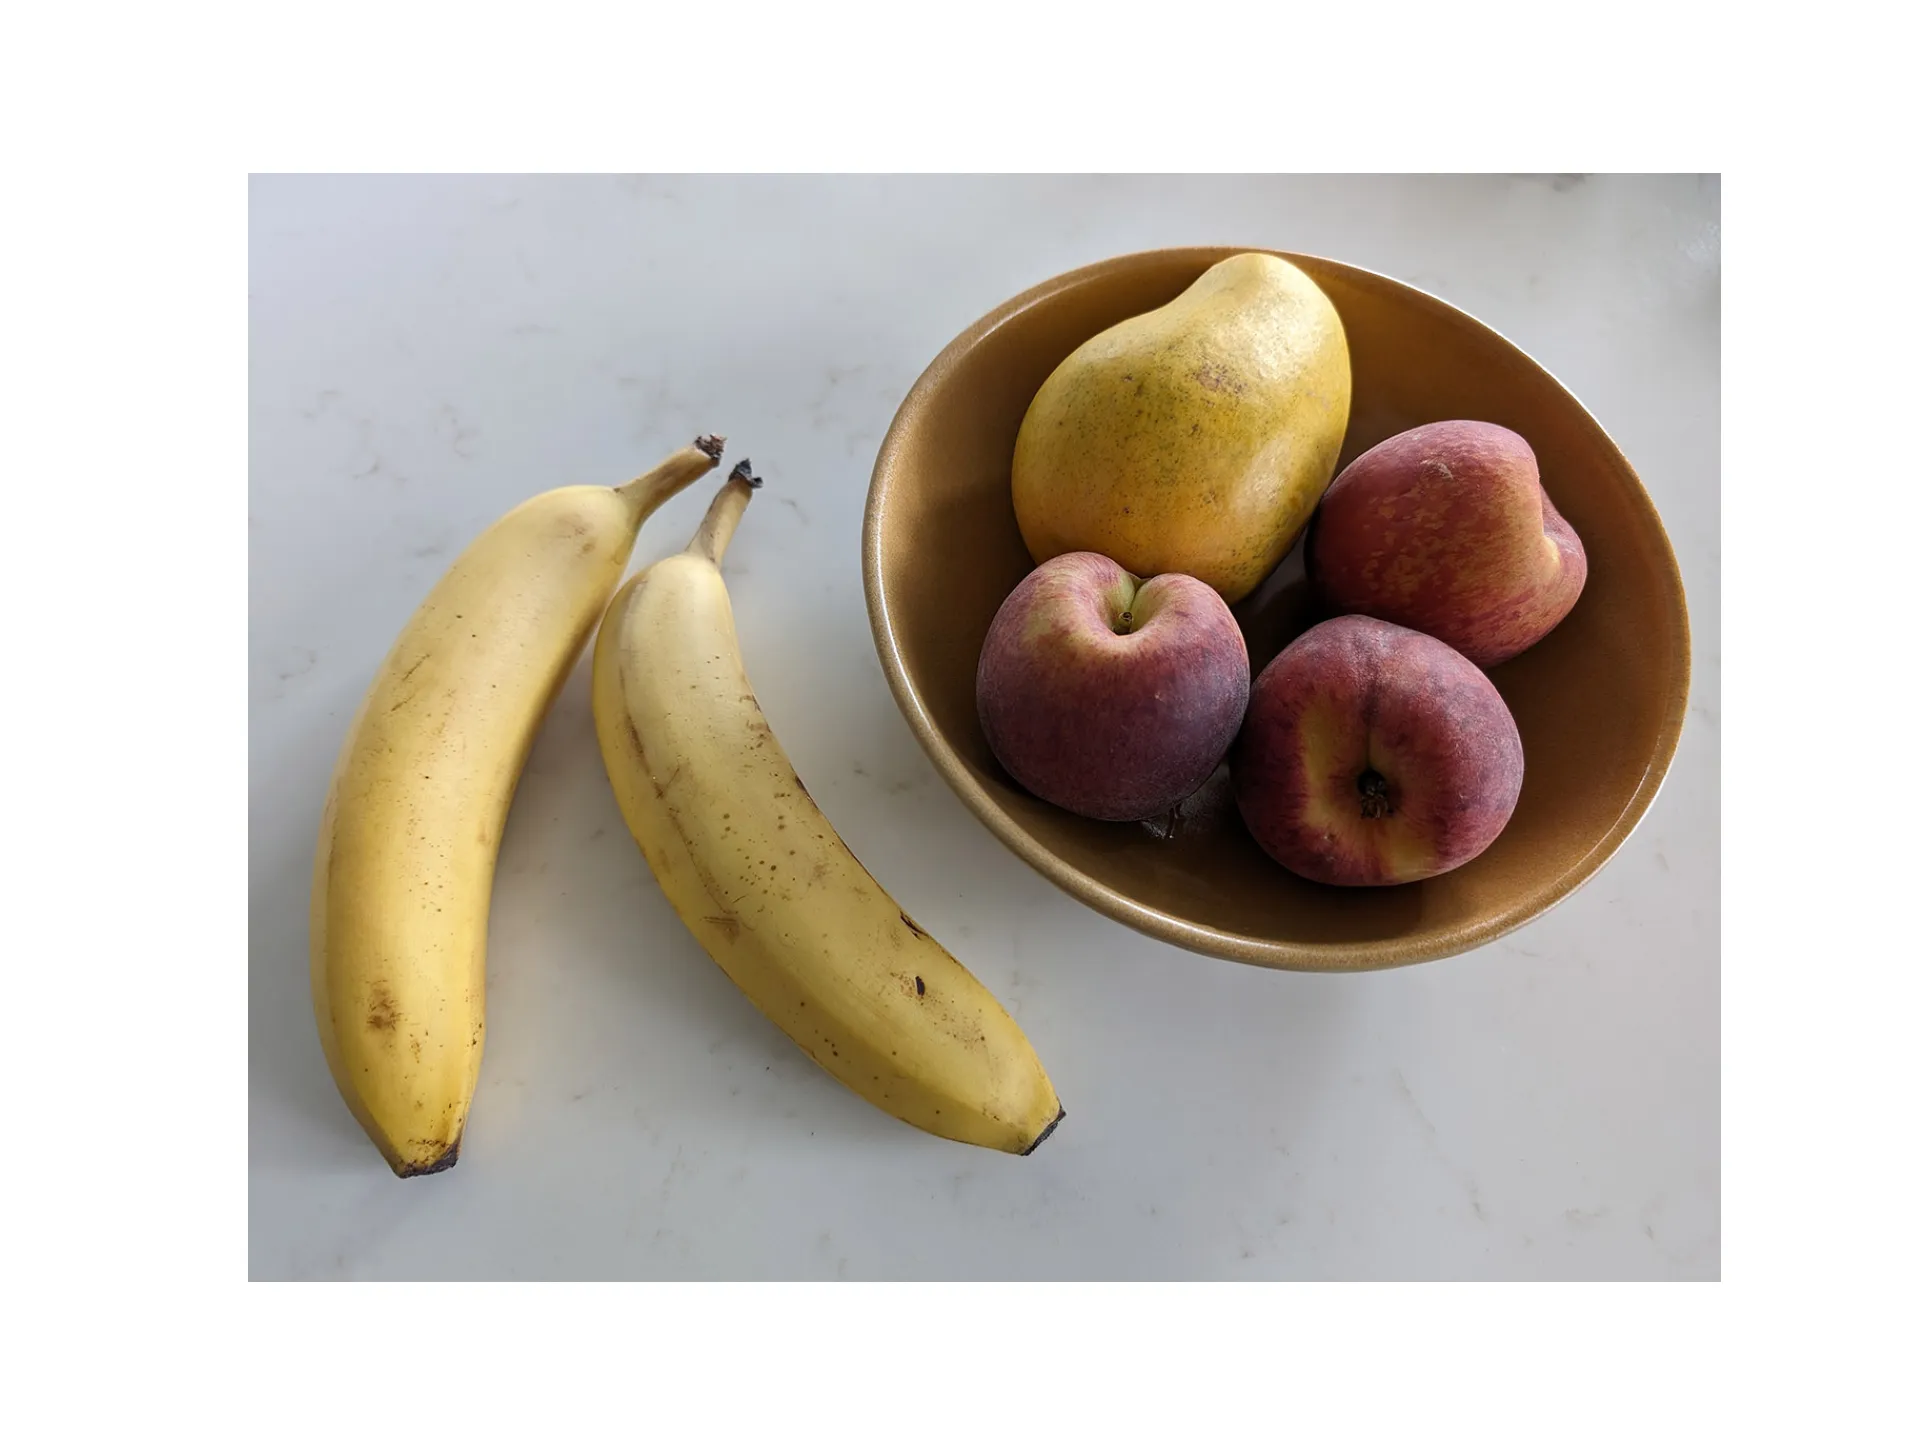
شکل ۱۱.۹: تصویر آزمایشی ما
مدل SAM انتظار ورودیهایی با ابعاد ۱۰۲۴ × ۱۰۲۴ دارد. با این حال، تغییر اندازه اجباری تصاویر دلخواه به ۱۰۲۴ × ۱۰۲۴ نسبت ابعاد (aspect ratio) آنها را برهم میزند — برای مثال، تصویر ما مربعی نیست. بهتر است ابتدا اندازه تصویر را طوری تغییر دهیم که بلندترین ضلع آن ۱۰۲۴ پیکسل شود و سپس پیکسلهای باقیمانده را با یک مقدار پرکننده (حاشیهگذاری)، مانند ۰، پر کنیم. ما میتوانیم این کار را با استفاده از آرگومان pad_to_aspect_ratio در عملیات keras.ops.image.resize() به شکل زیر انجام دهیم:
from keras import ops
image_size = (1024, 1024)
def resize_and_pad(x):    return ops.image.resize(x, image_size, pad_to_aspect_ratio=True)
image = resize_and_pad(image_array)
در مرحله بعد، بیایید چند تابع کمکی تعریف کنیم که هنگام استفاده از مدل به کارمان میآیند. ما نیاز داریم که کارهای زیر را انجام دهیم:
- نمایش تصاویر.
- نمایش ماسکهای قطعهبندی منطبقشده (overlaid) بر روی تصویر.
- برجسته کردن نقاط خاص بر روی تصویر.
- نمایش کادرهای منطبقشده بر روی تصویر.
تمامی توابع کمکی ما یک شیء axis از کتابخانه Matplotlib (با نام ax) دریافت میکنند تا همگی بتوانند بر روی یک شکل (figure) واحد ترسیم شوند:
import matplotlib.pyplot as pltfrom keras import ops
def show_image(image, ax):    ax.imshow(ops.convert_to_numpy(image).astype("uint8"))
def show_mask(mask, ax):    color = np.array([30 / 255, 144 / 255, 255 / 255, 0.6])    h, w, _ = mask.shape    mask_image = mask.reshape(h, w, 1) * color.reshape(1, 1, -1)    ax.imshow(mask_image)
def show_points(points, ax):    x, y = points[:, 0], points[:, 1]    ax.scatter(x, y, c="green", marker="*", s=375, ec="white", lw=1.25)
def show_box(box, ax):    box = box.reshape(-1)    x0, y0 = box[0], box[1]    w, h = box[2] - box[0], box[3] - box[1]    ax.add_patch(plt.Rectangle((x0, y0), w, h, ec="red", fc="none", lw=2))
پرامپت دادن به مدل با یک نقطه هدف
Section titled “پرامپت دادن به مدل با یک نقطه هدف”برای استفاده از SAM، باید به آن پرامپت (راهنما) بدهید. این بدان معناست که ما به یکی از موارد زیر نیاز داریم:
- پرامپتهای نقطهای (Point prompts) — یک نقطه را در تصویر انتخاب کنید و بگذارید مدل شیئی را که آن نقطه به آن تعلق دارد قطعهبندی کند.
- پرامپتهای کادری (Box prompts) — یک کادر تقریبی به دور یک شیء بکشید (نیازی نیست خیلی دقیق باشد) و بگذارید مدل شیء داخل کادر را قطعهبندی کند.
بیایید با یک پرامپت نقطهای شروع کنیم. نقاط دارای برچسب هستند، بهطوری که عدد ۱ نشاندهنده پیشزمینه (شیئی که میخواهید قطعهبندی کنید) و عدد ۰ نشاندهنده پسزمینه (همهچیز در اطراف شیء) است. در موارد مبهم، برای بهبود نتایج خود، میتوانید به جای یک نقطه واحد، چندین نقطه برچسبدار را ارسال کنید تا تعریف خود را از آنچه باید گنجانده شود (نقاط با برچسب ۱) و آنچه باید مستثنی شود (نقاط با برچسب ۰) دقیقتر کنید.
ما یک نقطه پیشزمینه واحد را امتحان میکنیم (شکل ۱۱.۱۰ را ببینید). در اینجا یک نقطه آزمایشی آورده شده است:
import numpy as np
# Coordinates of our pointinput_point = np.array([[580, 450]])# 1 means foreground, and 0 means background.input_label = np.array([1])
plt.figure(figsize=(10, 10))# "gca" means "get current axis" — the current figure.show_image(image, plt.gca())show_points(input_point, plt.gca())plt.show()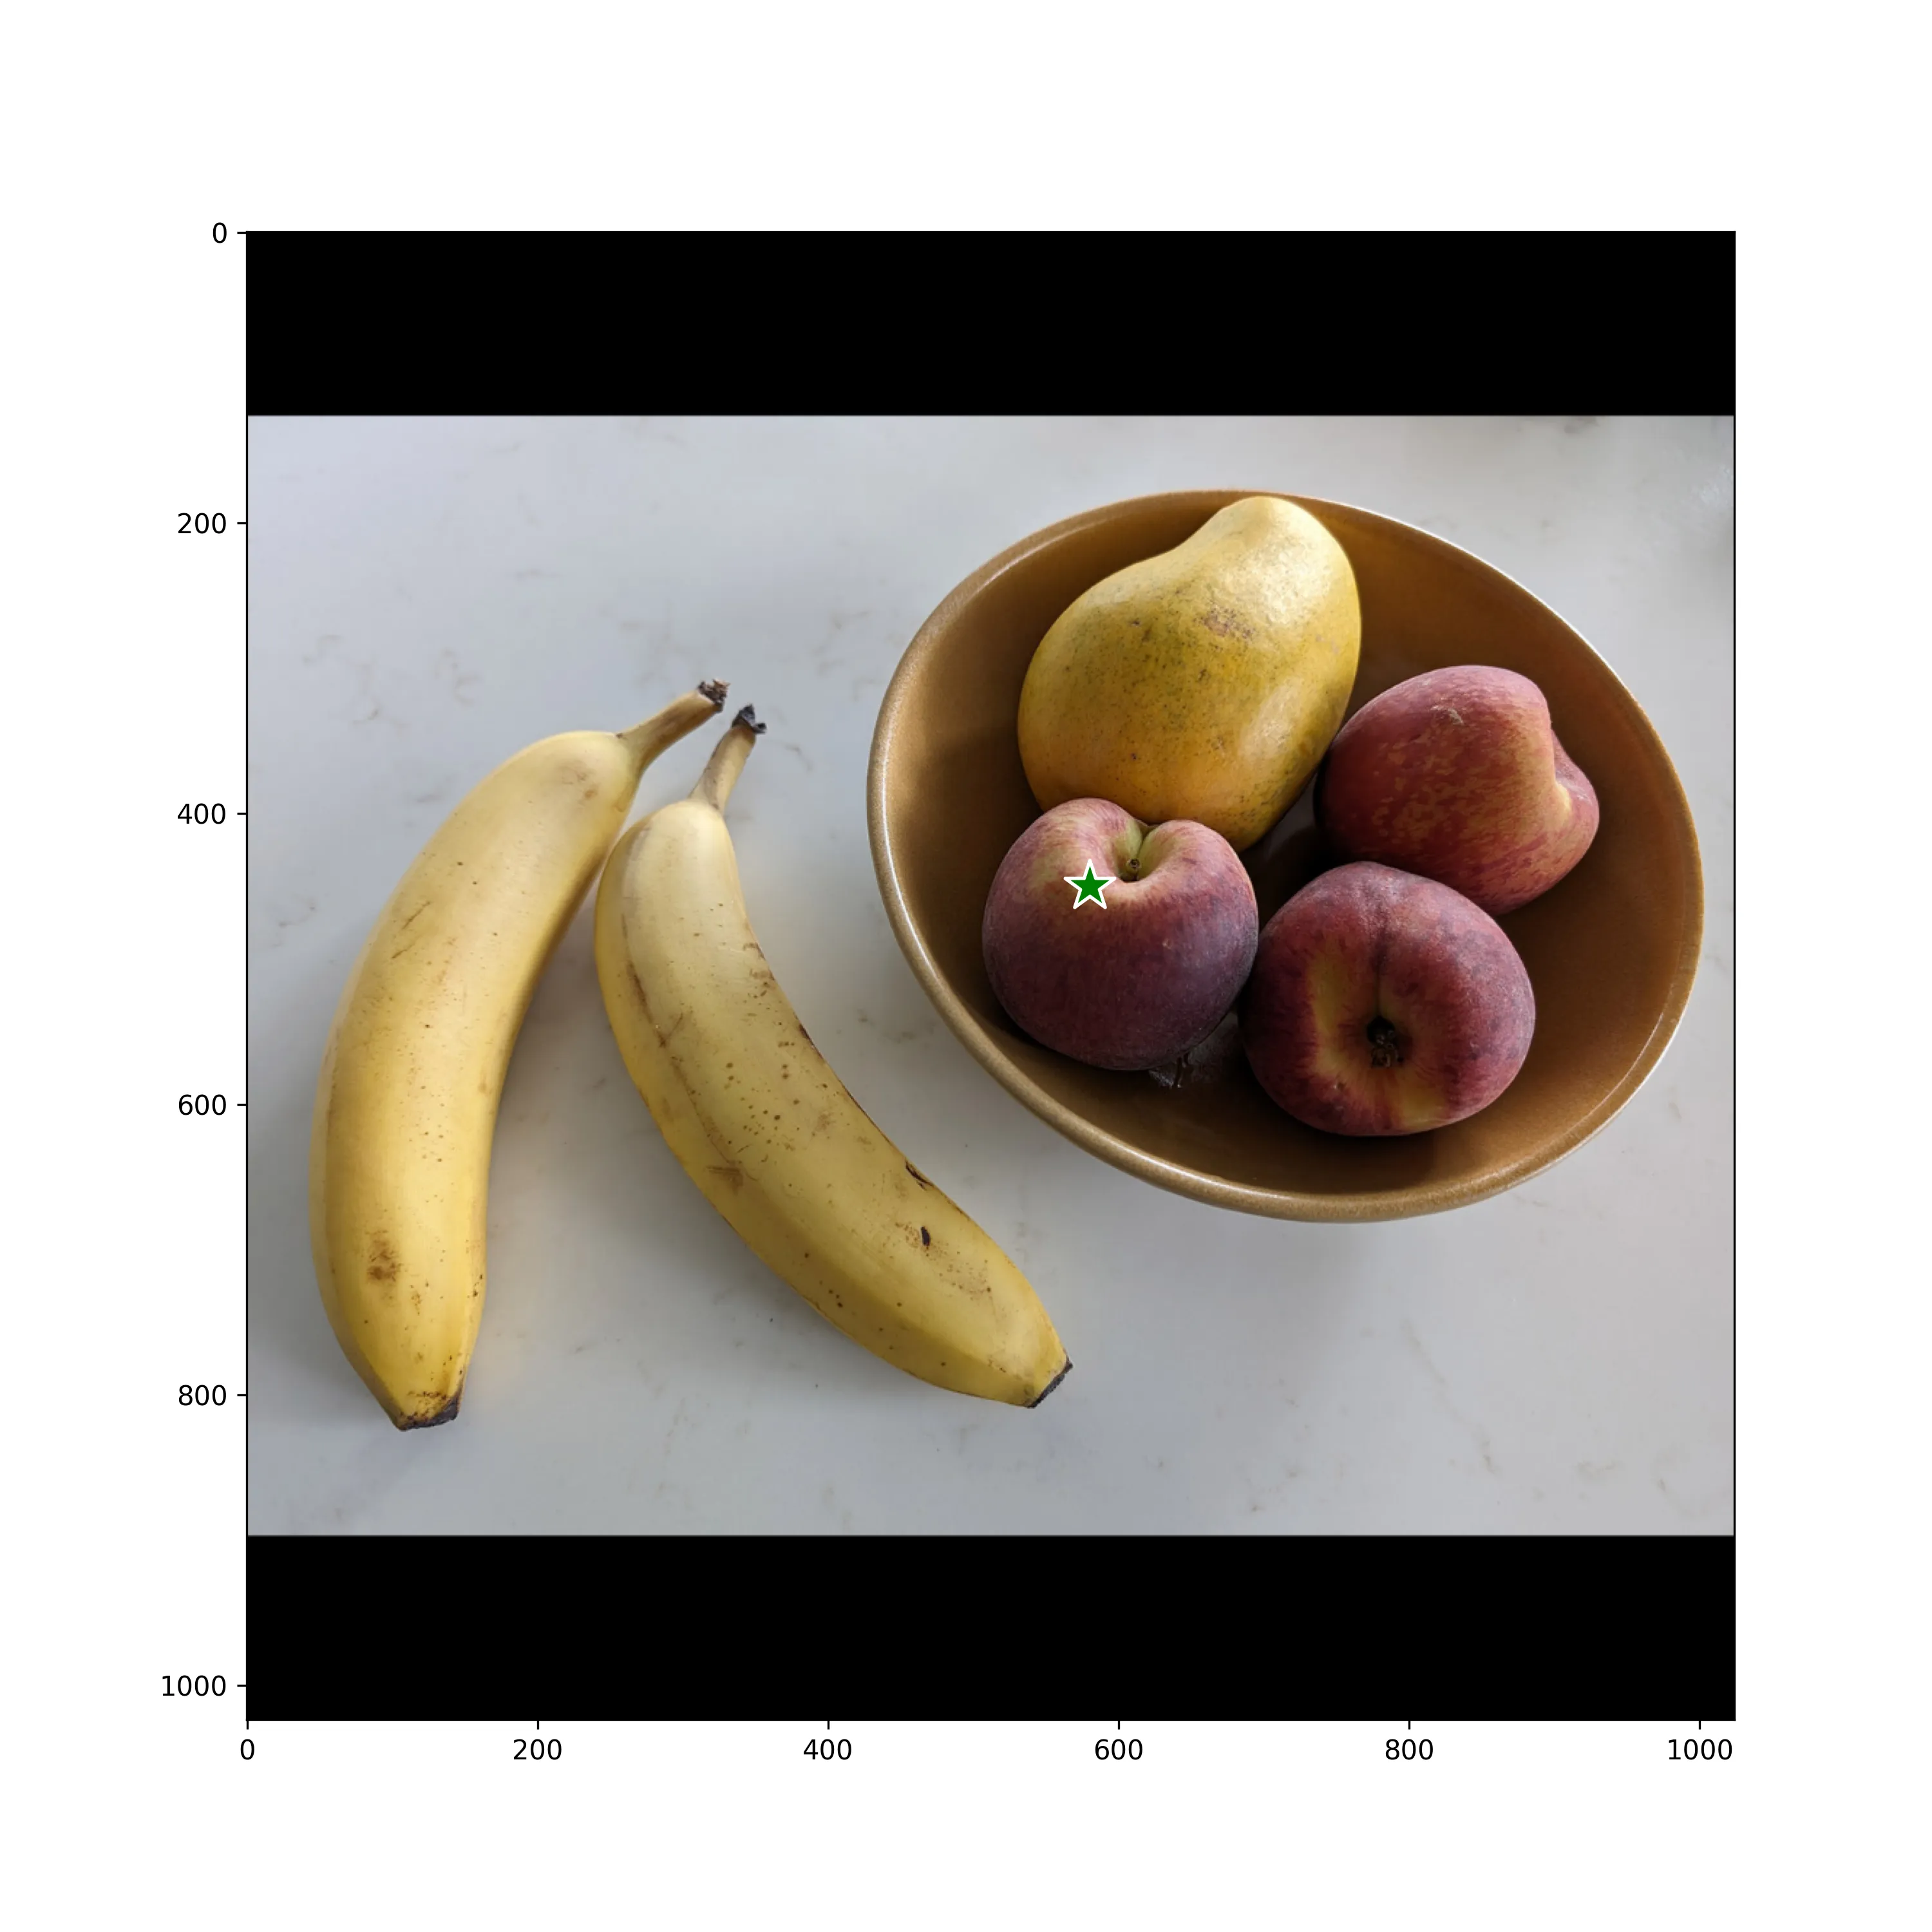
شکل ۱۱.۱۰: یک نقطه پرامپت که بر روی یک هلو قرار گرفته است
بیایید با استفاده از این نقطه به SAM پرامپت بدهیم:
outputs = model.predict( { "images": ops.expand_dims(image, axis=0), "points": ops.expand_dims(input_point, axis=0), "labels": ops.expand_dims(input_label, axis=0), })مقدار بازگشتی outputs دارای یک فیلد "masks" است که شامل چهار ماسک کاندید با ابعاد ۲۵۶ × ۲۵۶ برای شیء هدف است که به ترتیب کاهش کیفیت تطابق رتبهبندی شدهاند. امتیازات کیفیت ماسکها تحت فیلد "iou_pred" بهعنوان بخشی از خروجی مدل در دسترس هستند:
>>> outputs["masks"].shapeبیایید اولین ماسک را بر روی تصویر منطبق کنیم (شکل ۱۱.۱۱ را ببینید):
def get_mask(sam_outputs, index=0):    mask = sam_outputs["masks"][0][index]    mask = np.expand_dims(mask, axis=-1)    mask = resize_and_pad(mask)    return ops.convert_to_numpy(mask) > 0.0
mask = get_mask(outputs, index=0)
plt.figure(figsize=(10, 10))show_image(image, plt.gca())show_mask(mask, plt.gca())show_points(input_point, plt.gca())plt.show()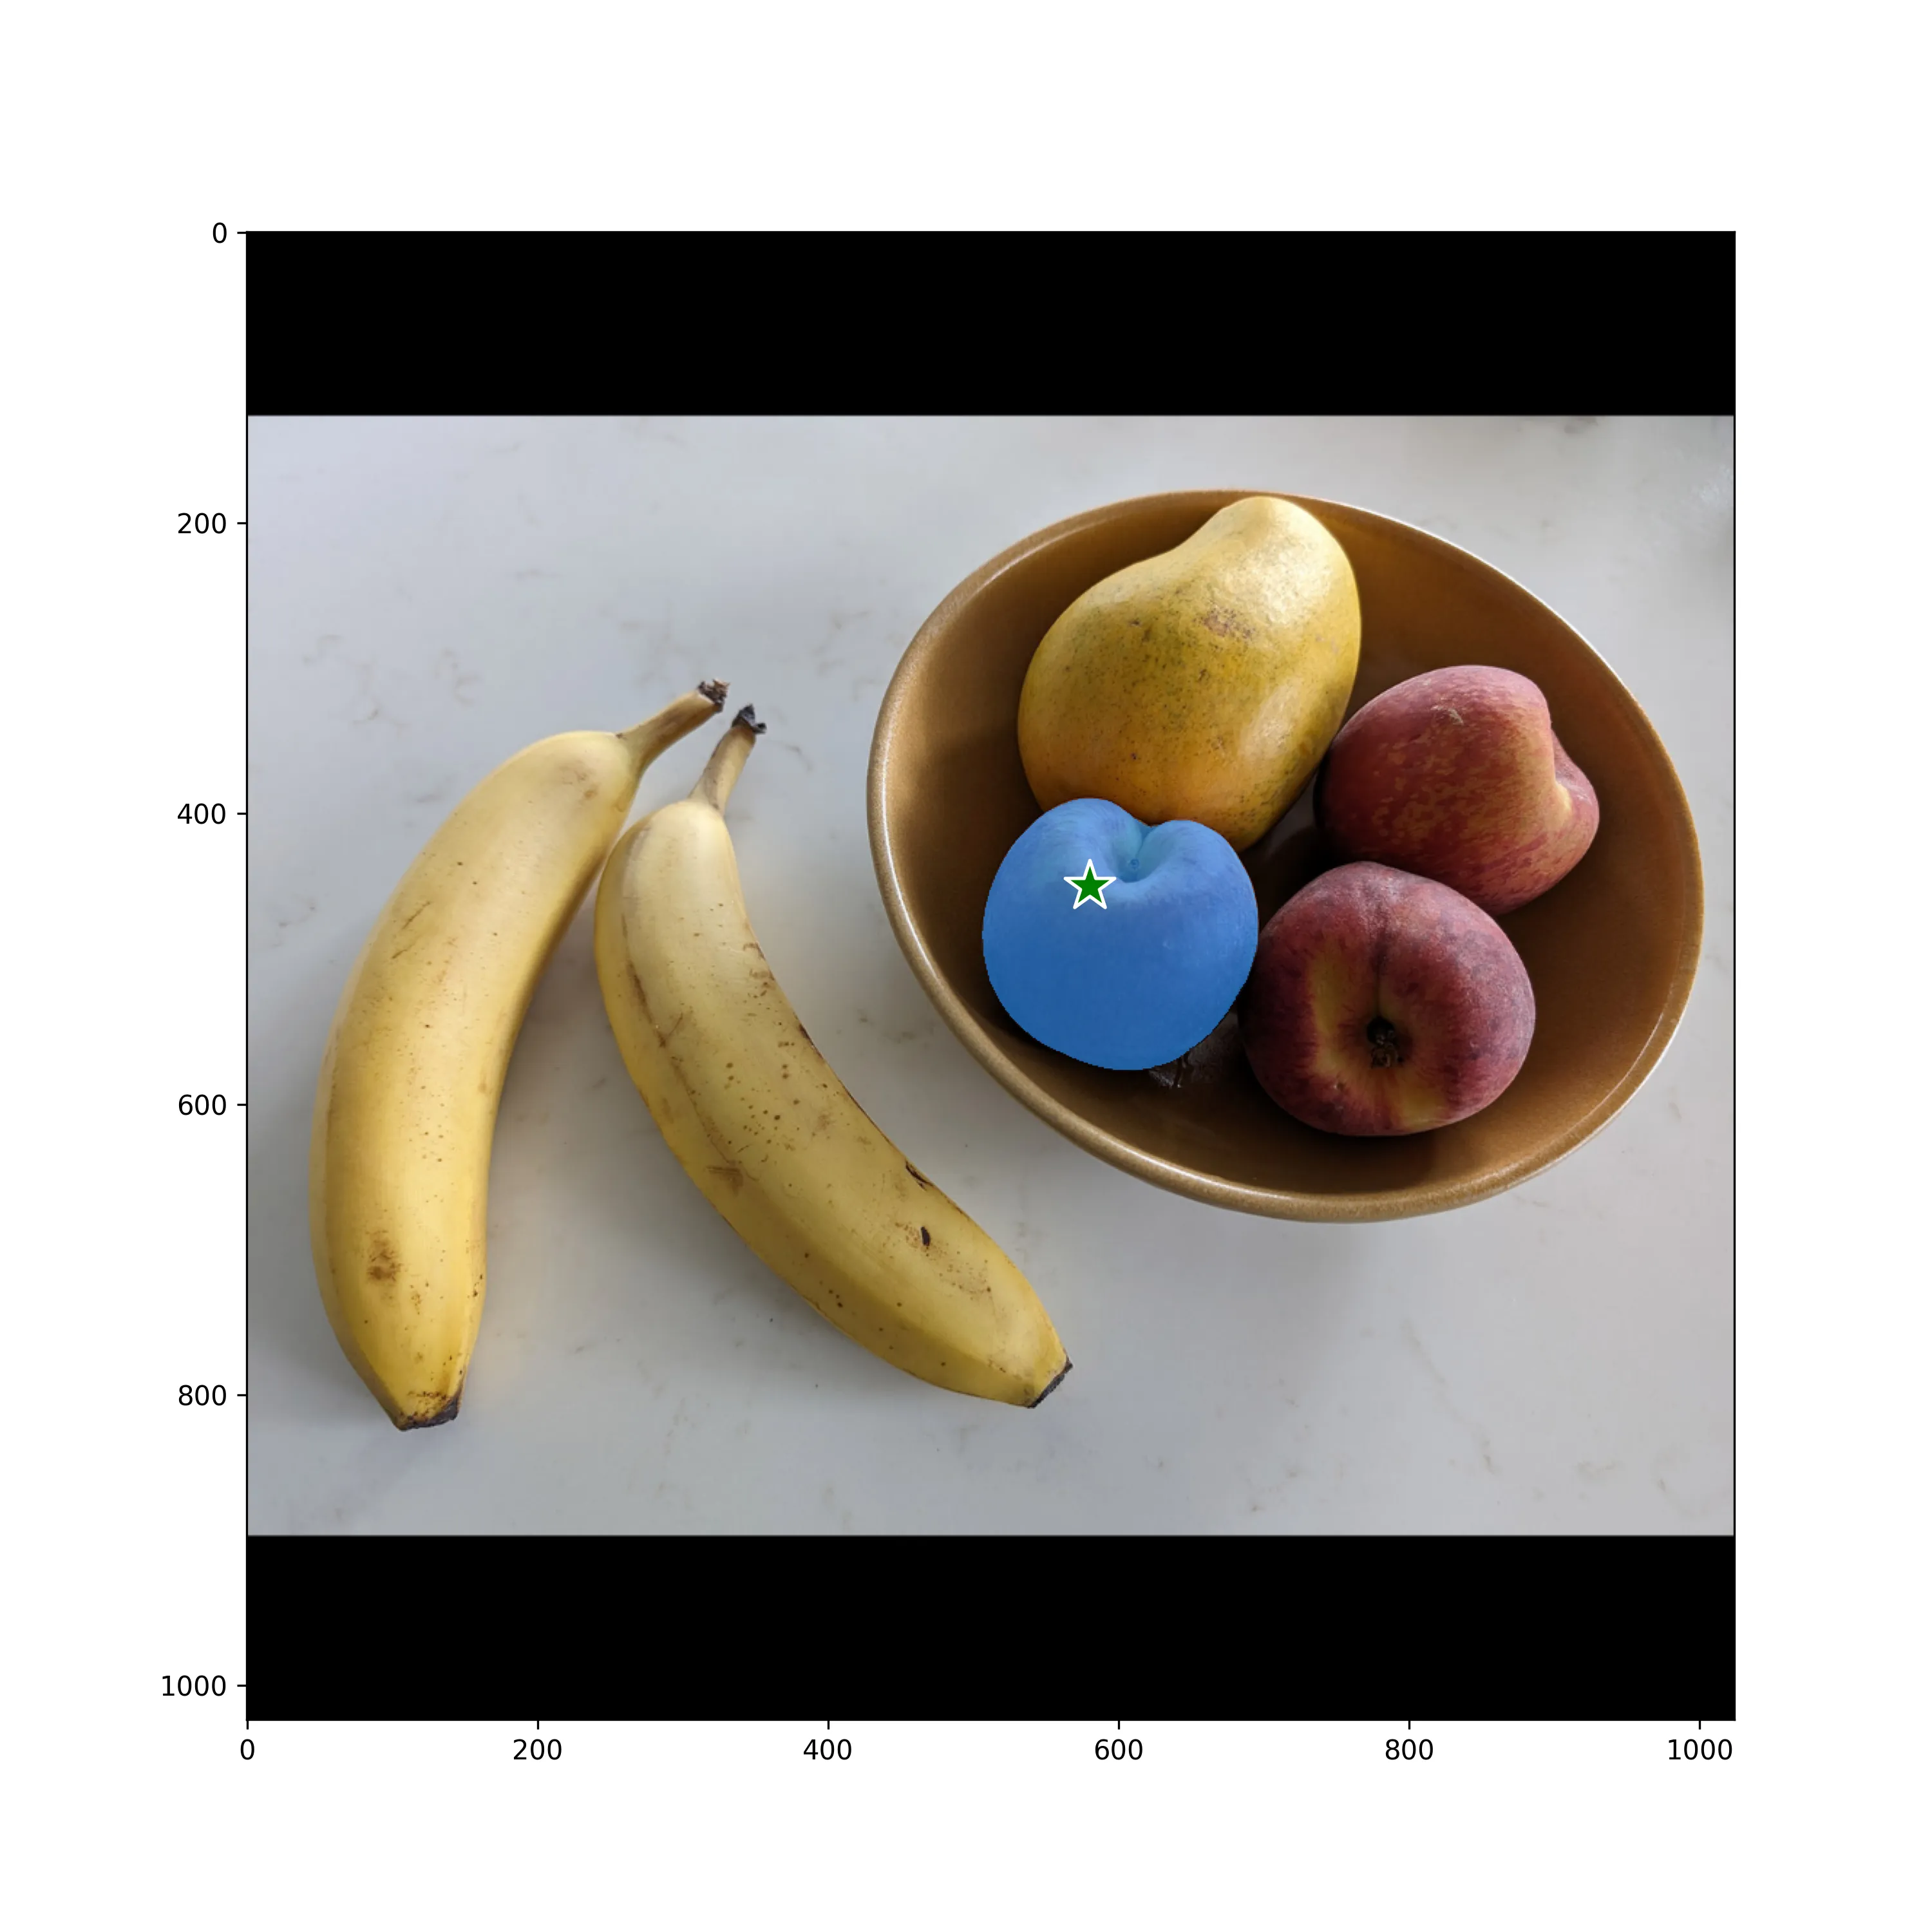
شکل ۱۱.۱۱: هلوی قطعهبندیشده
بسیار عالی!
در مرحله بعد، بیایید یک موز را امتحان کنیم. ما با مختصات (300, 550) به مدل پرامپت میدهیم، که بر روی دومین موز از سمت چپ قرار میگیرد (شکل ۱۱.۱۲ را ببینید):
input_point = np.array([[300, 550]])input_label = np.array([1])
outputs = model.predict(    {        "images": ops.expand_dims(image, axis=0),        "points": ops.expand_dims(input_point, axis=0),        "labels": ops.expand_dims(input_label, axis=0),    })mask = get_mask(outputs, index=0)
plt.figure(figsize=(10, 10))show_image(image, plt.gca())show_mask(mask, plt.gca())show_points(input_point, plt.gca())plt.show()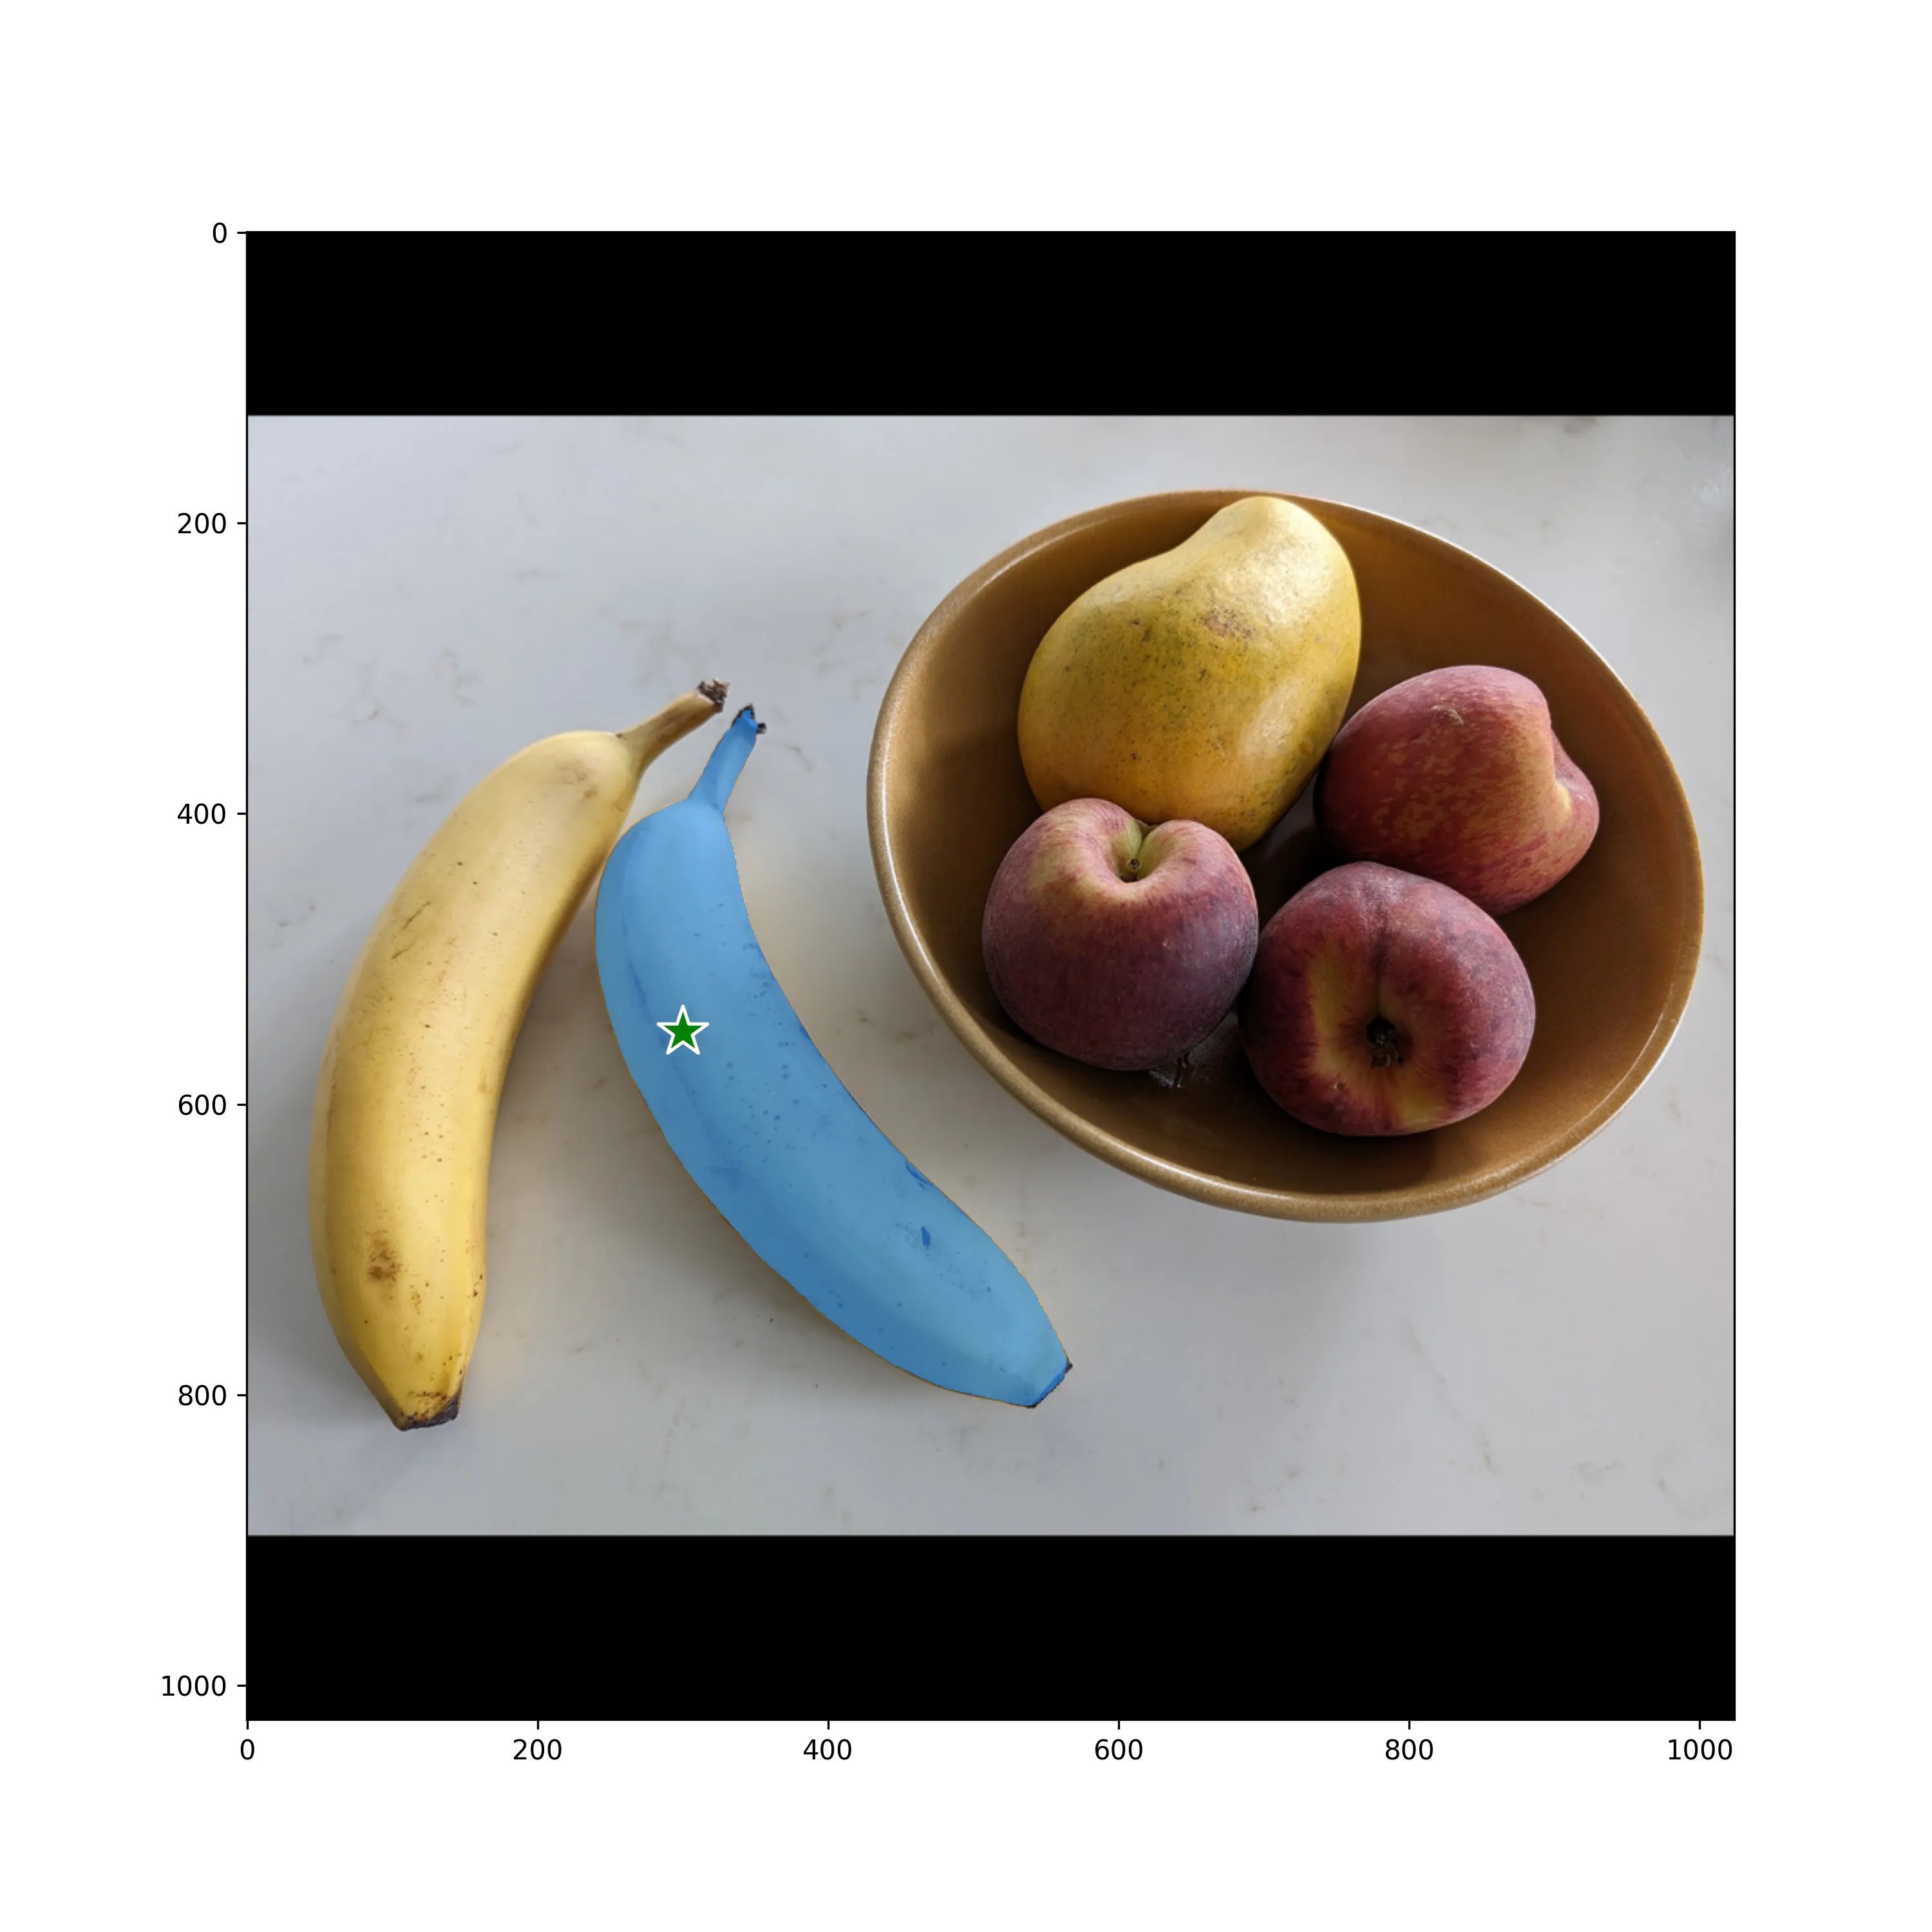
شکل ۱۱.۱۲: موز قطعهبندیشده
حال، سایر ماسکهای کاندید چطور؟ آنها میتوانند برای پرامپتهای مبهم بسیار مفید باشند. بیایید سه ماسک دیگر را رسم کنیم (شکل ۱۱.۱۳ را ببینید):
fig, axes = plt.subplots(1, 3, figsize=(20, 60))masks = outputs["masks"][0][1:]for i, mask in enumerate(masks): show_image(image, axes[i]) show_points(input_point, axes[i]) mask = get_mask(outputs, index=i + 1) show_mask(mask, axes[i]) axes[i].set_title(f"Mask {i + 1}", fontsize=16) axes[i].axis("off")plt.show()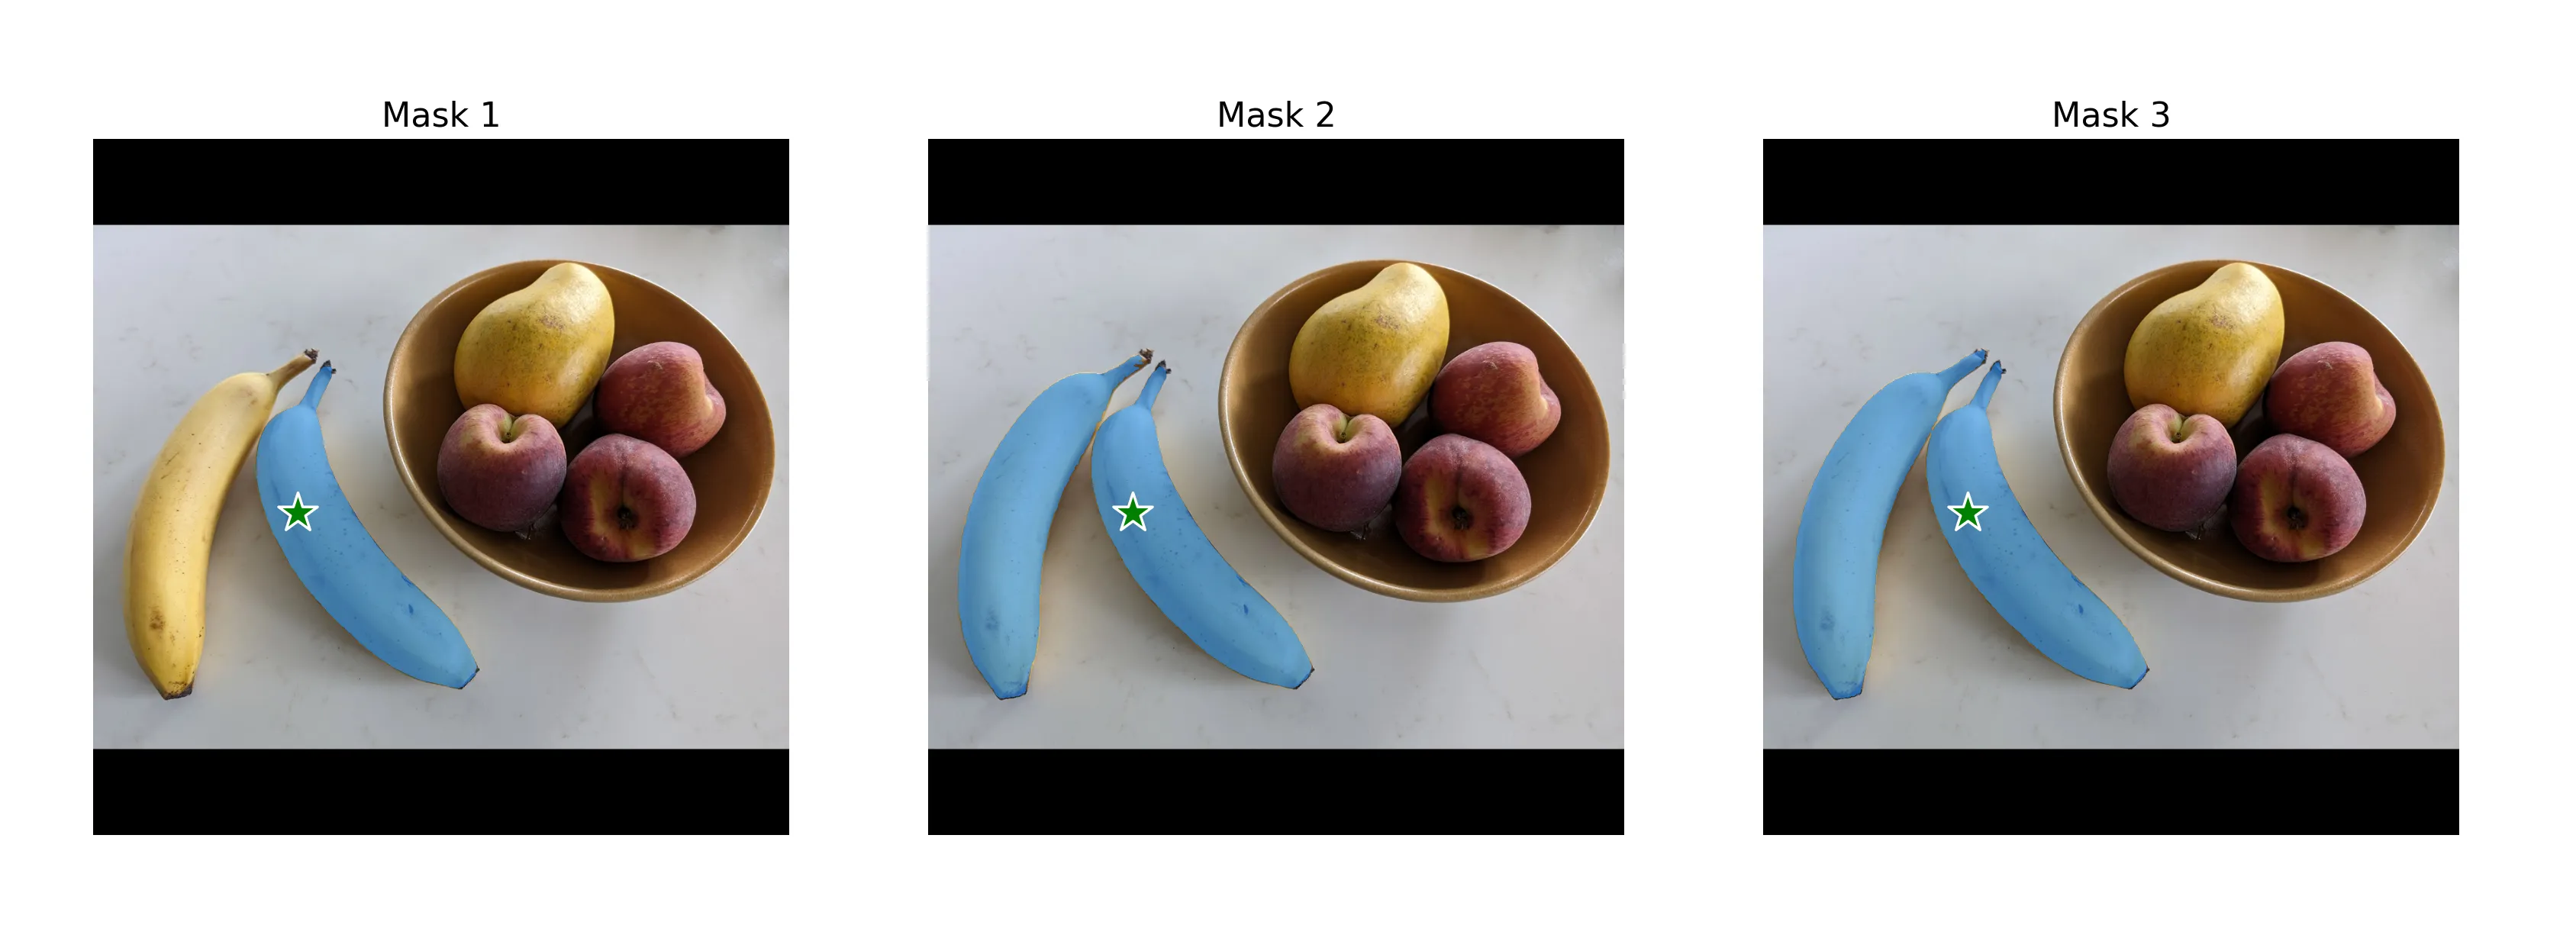
شکل ۱۱.۱۳: ماسکهای قطعهبندی جایگزین برای پرامپت موز
همانطور که در اینجا میبینید، یکی از قطعهبندیهای جایگزینِ یافتشده توسط مدل، هر دو موز را با هم شامل میشود.
پرامپت دادن به مدل با یک کادر هدف
Section titled “پرامپت دادن به مدل با یک کادر هدف”علاوه بر ارائه یک یا چند نقطه هدف، میتوانید کادرهایی را نیز ارائه دهید که مکان شیء مورد نظر برای قطعهبندی را بهطور تقریبی مشخص میکنند. این کادرها باید از طریق مختصات گوشه بالا-چپ و گوشه پایین-راست آنها ارسال شوند. در اینجا یک کادر به دور انبه آورده شده است (شکل ۱۱.۱۴ را ببینید):
input_box = np.array(    [        # Top-left corner        [520, 180],        # Bottom-right corner        [770, 420],    ])
plt.figure(figsize=(10, 10))show_image(image, plt.gca())show_box(input_box, plt.gca())plt.show()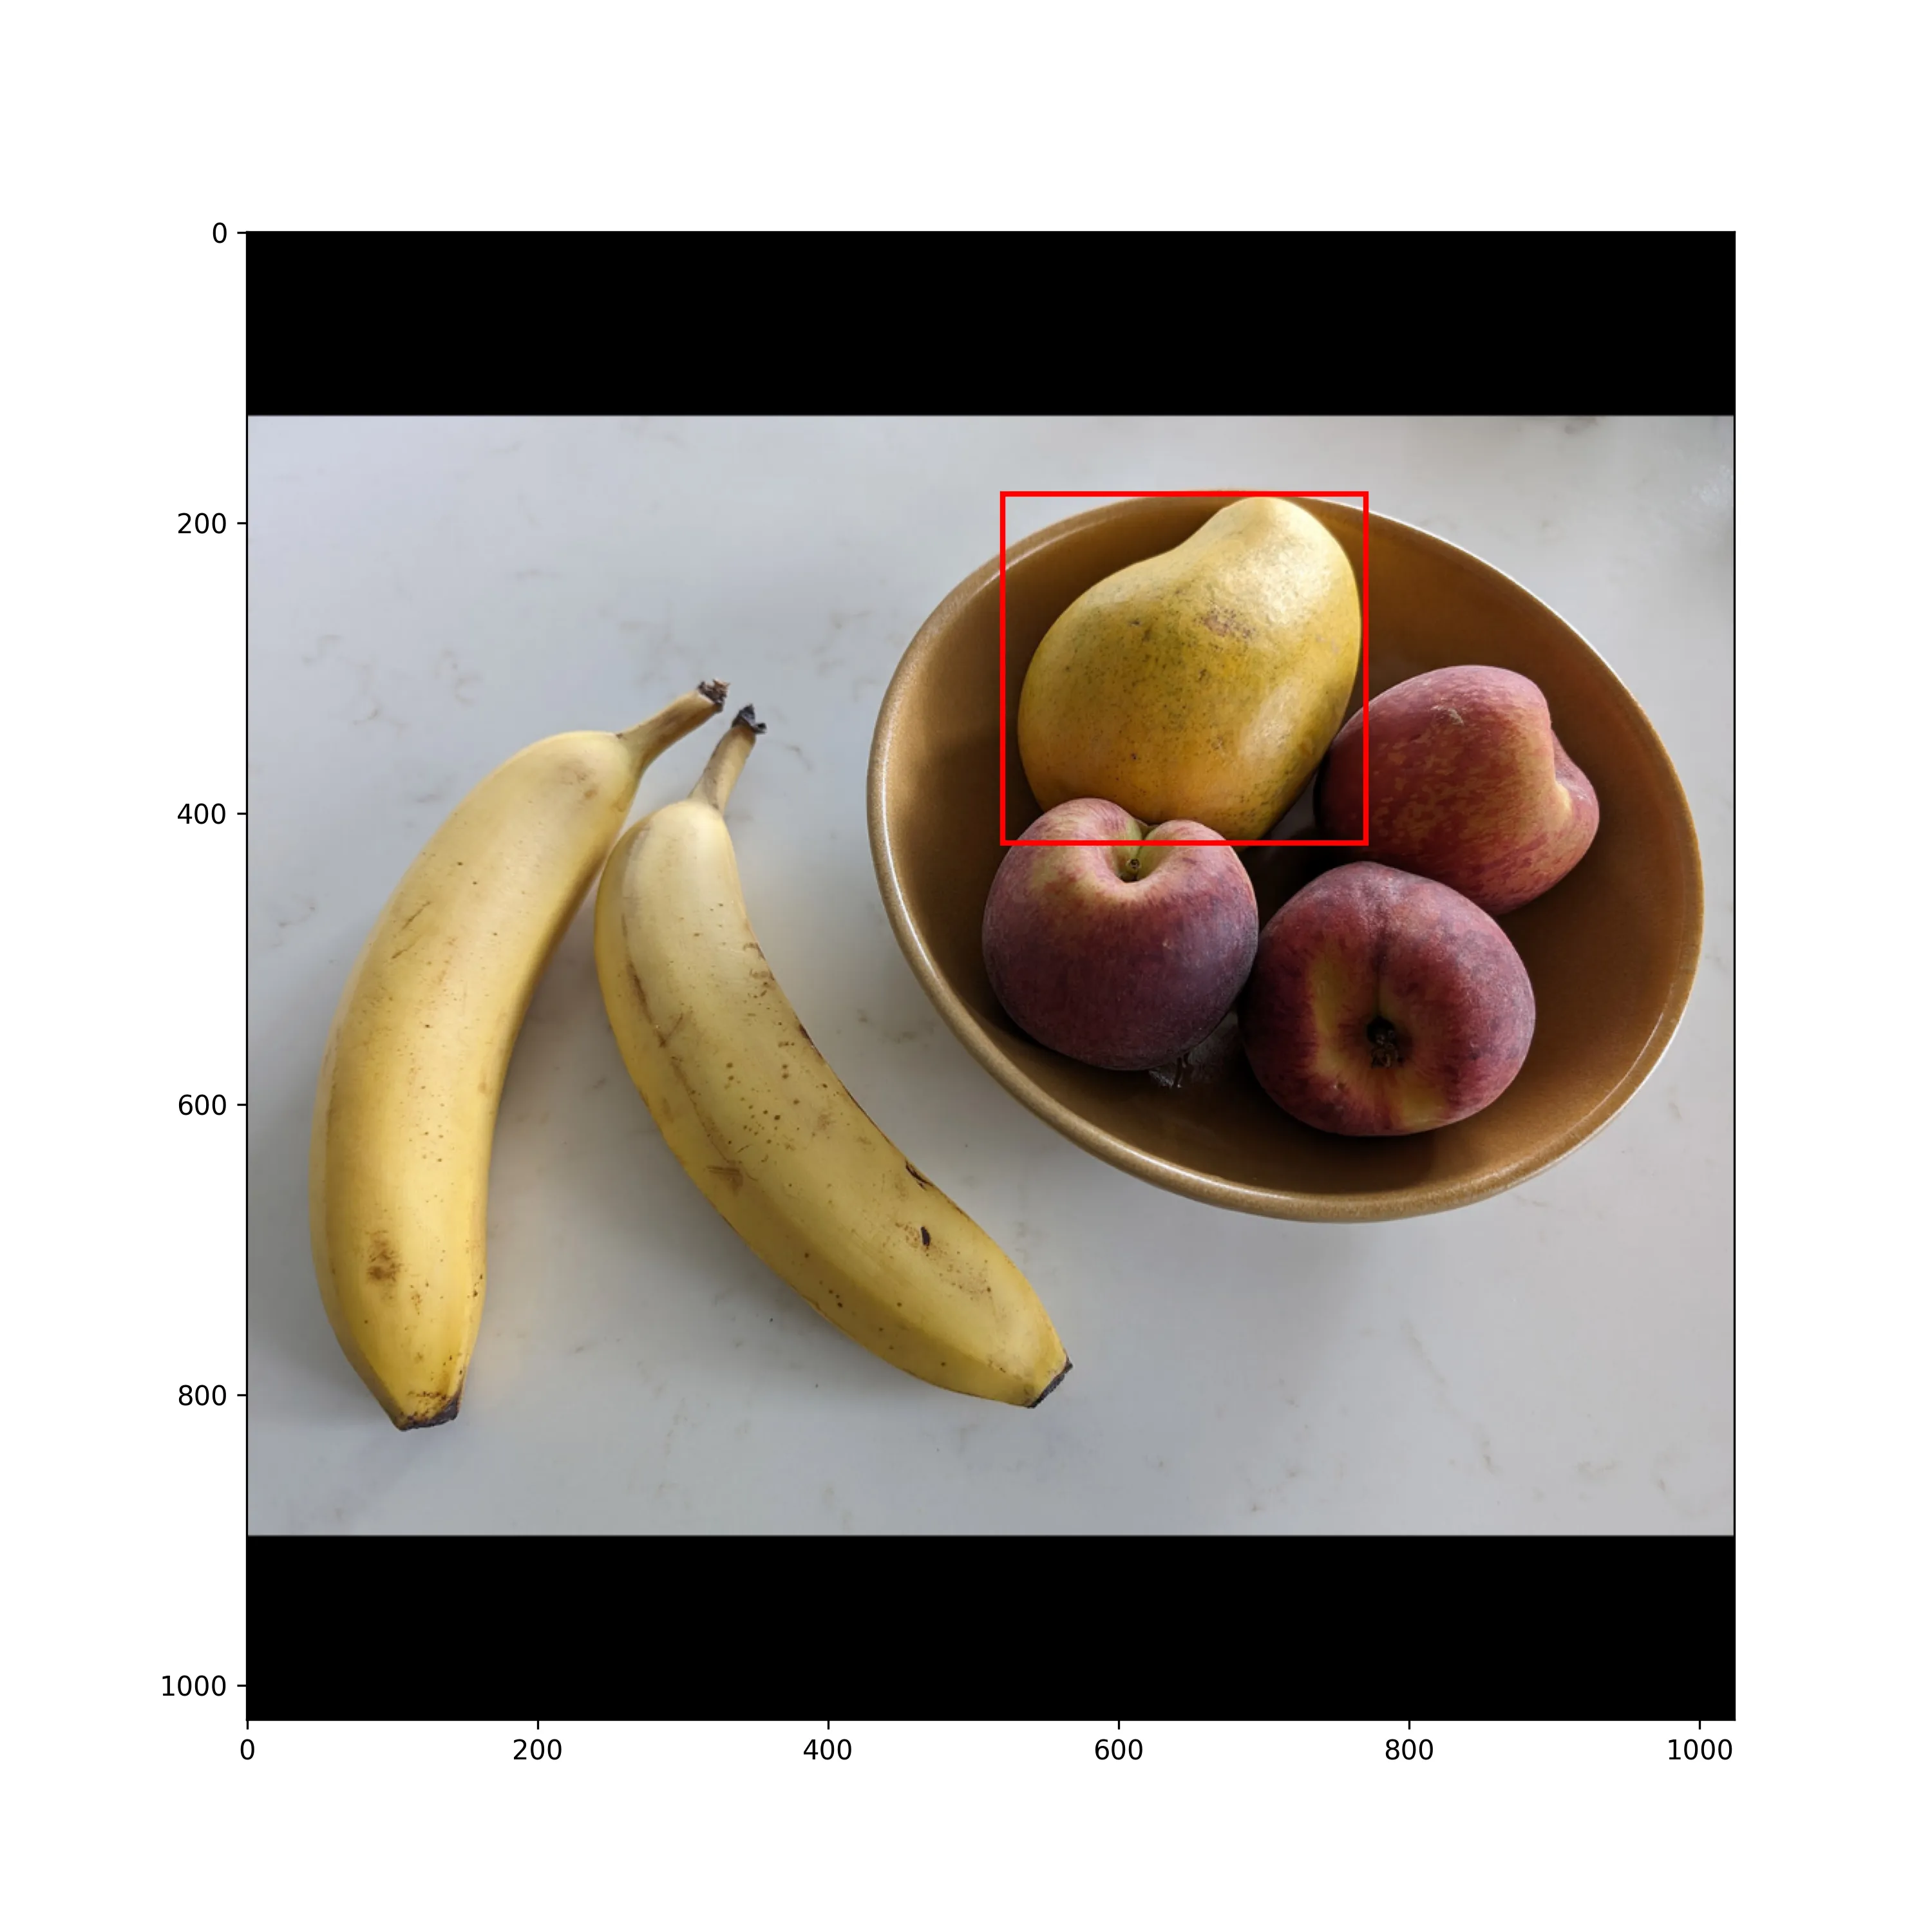
شکل ۱۱.۱۴: پرامپت کادری به دور انبه
بیایید با استفاده از آن به SAM پرامپت بدهیم (شکل ۱۱.۱۵ را ببینید):
outputs = model.predict( { "images": ops.expand_dims(image, axis=0), "boxes": ops.expand_dims(input_box, axis=(0, 1)), })mask = get_mask(outputs, 0)plt.figure(figsize=(10, 10))show_image(image, plt.gca())show_mask(mask, plt.gca())show_box(input_box, plt.gca())plt.show()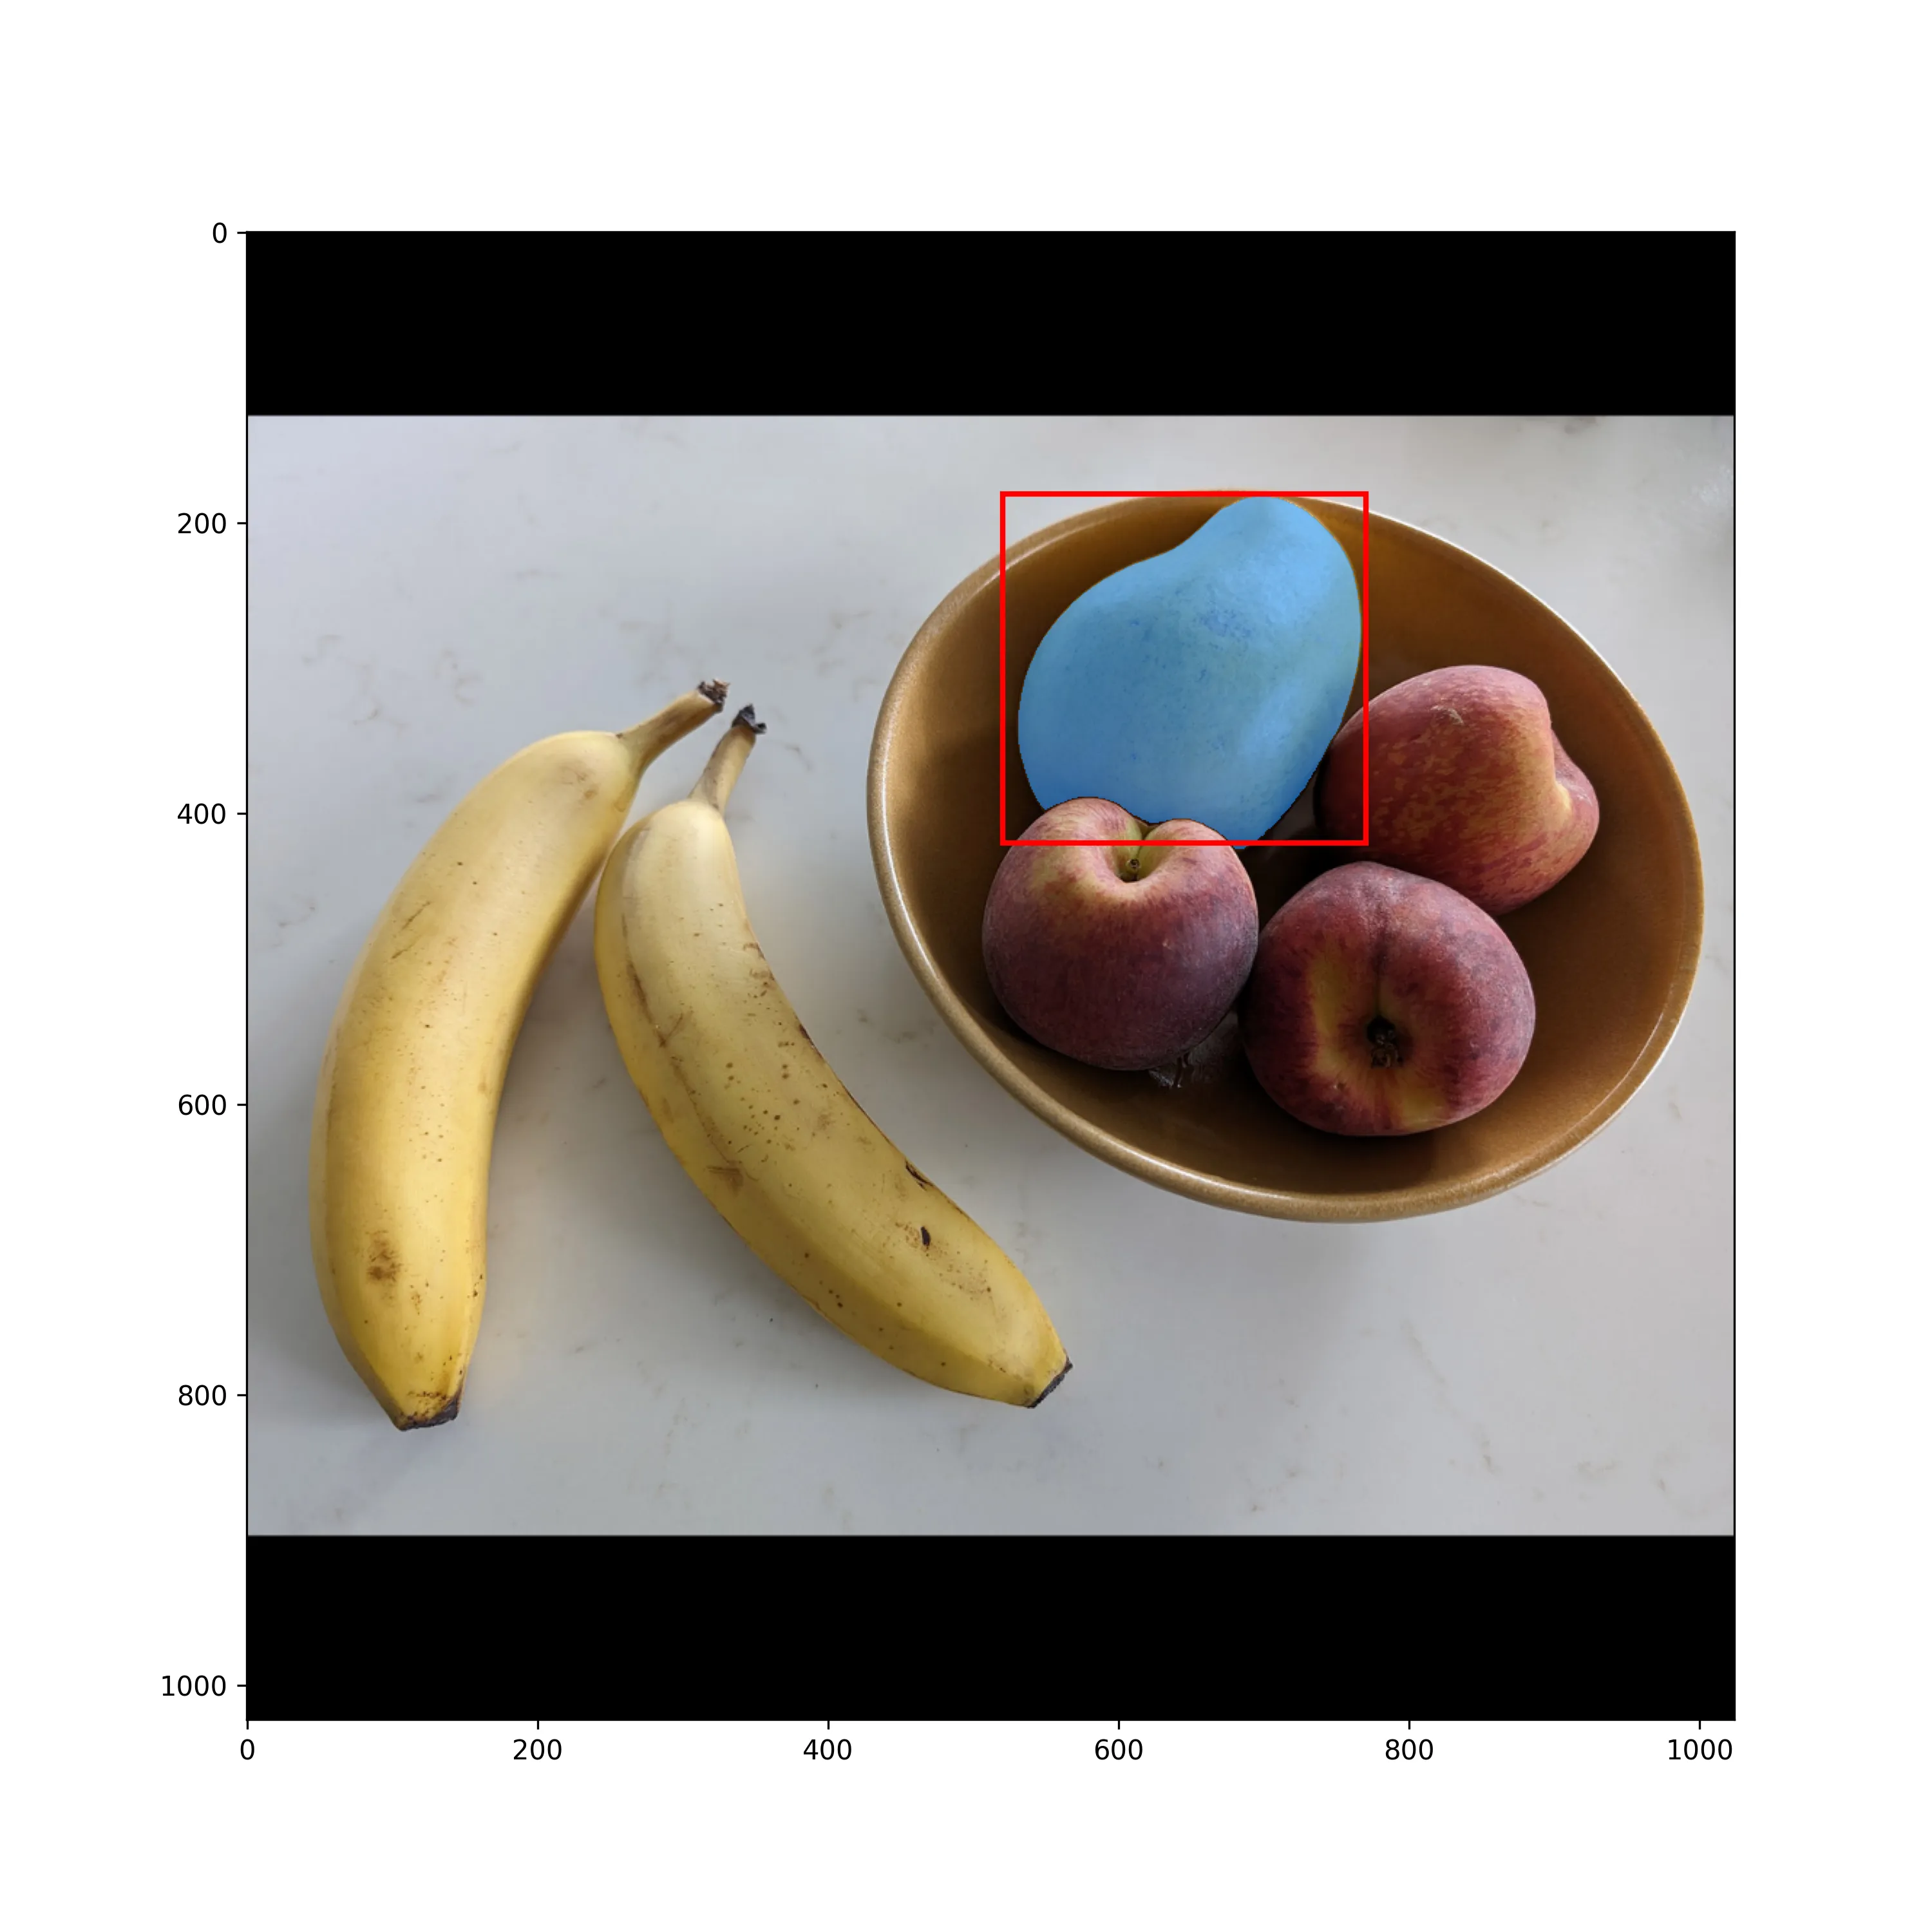
شکل ۱۱.۱۵: انبه قطعهبندیشده
مدل SAM میتواند ابزاری قدرتمند برای ایجاد سریع مجموعهدادههای بزرگ از تصاویر حاشیهنویسیشده با ماسکهای قطعهبندی باشد.
- قطعهبندی تصویر یکی از دستههای اصلی وظایف در بینایی ماشین است. این کار شامل محاسبه ماسکهای قطعهبندی است که محتویات یک تصویر را در سطح پیکسل توصیف میکنند.
- برای ساخت مدل قطعهبندی خودتان، از پشتهای از لایههای گامدار (strided)
Conv2Dبرای «فشردهسازی» تصویر ورودی به یک نقشهٔ ویژگی کوچکتر استفاده کنید، و در ادامه آن پشتهای از لایههای متناظرConv2DTransposeقرار دهید تا نقشهٔ ویژگی را «گسترش» داده و به یک ماسک قطعهبندی هماندازه با تصویر ورودی تبدیل کند. - شما همچنین میتوانید از یک مدل قطعهبندی ازپیشآموزشدیده استفاده کنید. مدل Segment Anything که در KerasHub گنجانده شده است، مدلی قدرتمند است که از پرامپتهای تصویری، پرامپتهای متنی، پرامپتهای نقطهای و پرامپتهای کادری پشتیبانی میکند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
Kirillov et al., “Segment Anything,” in Proceedings of the IEEE/CVF International Conference on Computer Vision, arXiv (2023), https://arxiv.org/abs/2304.02643. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.