
فصل ۱۰: تفسیر آنچه ConvNetها یاد میگیرند
یک مشکل بنیادین هنگام ساخت یک کاربرد بینایی ماشین، تفسیرپذیری است: چرا طبقهبند شما فکر کرده است که یک تصویر خاص شامل یخچال است، در حالی که تنها چیزی که میتوانید ببینید یک کامیون است؟ این موضوع بهویژه در مواردی که یادگیری عمیق برای تکمیل تخصص انسانی استفاده میشود، مانند کاربردهای تصویربرداری پزشکی، اهمیت دارد. این فصل شما را با طیفی از تکنیکهای مختلف برای تجسم آنچه ConvNetها یاد میگیرند و درک تصمیماتی که میگیرند آشنا میکند.
اغلب گفته میشود که مدلهای یادگیری عمیق «جعبهسیاه» هستند: آنها بازنماییهایی یاد میگیرند که استخراج و ارائهٔ آنها به شکلی قابلخواندن برای انسان دشوار است. اگرچه این گفته برای برخی انواع خاص مدلهای یادگیری عمیق تا حدی درست است، اما قطعاً برای ConvNetها درست نیست. بازنماییهایی که ConvNetها یاد میگیرند بهشدت برای تجسم مناسباند، تا حد زیادی به این دلیل که آنها بازنمایی مفاهیم بصری هستند. از سال ۲۰۱۳، طیف گستردهای از تکنیکها برای تجسم و تفسیر این بازنماییها توسعه یافته است. ما همهٔ آنها را مرور نمیکنیم، اما سه مورد از در دسترسترین و مفیدترین آنها را پوشش میدهیم:
- تجسم خروجیهای میانی ConvNet (فعالسازیهای میانی) — مفید برای درک اینکه لایههای متوالی ConvNet چگونه ورودی خود را تبدیل میکنند، و برای به دست آوردن اولین ایده از معنای فیلترهای منفرد ConvNet.
- تجسم فیلترهای ConvNet — مفید برای درک دقیق اینکه هر فیلتر در ConvNet به چه الگوی بصری یا مفهومی پاسخ میدهد.
- تجسم نقشههای حرارتی فعالسازی کلاس در یک تصویر — مفید برای درک اینکه کدام بخشهای تصویر بهعنوان متعلق به یک کلاس خاص شناسایی شدهاند، و بنابراین به شما امکان میدهد اشیاء را در تصاویر مکانیابی کنید.
برای روش اول — تجسم فعالسازی — از ConvNet کوچکی استفاده خواهید کرد که از ابتدا روی مسئلهٔ طبقهبندی سگ در برابر گربه در فصل ۸ آموزش دادهاید. برای دو روش بعدی، از یک مدل Xception از پیش آموزشدیده استفاده خواهید کرد.
تجسم فعالسازیهای میانی
Section titled “تجسم فعالسازیهای میانی”تجسم فعالسازیهای میانی شامل نمایش مقادیری است که لایههای مختلف کانولوشن و پولینگ در یک مدل، بهازای یک ورودی مشخص برمیگردانند (خروجی یک لایه اغلب فعالسازی آن نامیده میشود، خروجی تابع فعالسازی). این کار دیدی از اینکه چگونه یک ورودی به فیلترهای مختلف یادگرفتهشده توسط شبکه تجزیه میشود ارائه میدهد. شما میخواهید نقشههای ویژگی با سه بُعد را تجسم کنید: عرض، ارتفاع و عمق (کانالها). هر کانال ویژگیهای نسبتاً مستقلی را کدگذاری میکند، بنابراین روش صحیح تجسم این نقشههای ویژگی، رسم مستقل محتویات هر کانال بهصورت یک تصویر دوبعدی است. بیایید با بارگذاری مدلی که در بخش ۸.۲ ذخیره کردهاید شروع کنیم:
>>> import keras>>> model = keras.models.load_model(... "convnet_from_scratch_with_augmentation.keras"... )>>> model.summary()سپس، یک تصویر ورودی دریافت میکنید — تصویری از یک گربه، که بخشی از تصاویر آموزشدیدهٔ شبکه نیست.
لیستینگ ۱۰.۱: پیشپردازش یک تصویر
import kerasimport numpy as np
# Downloads a test imageimg_path = keras.utils.get_file(    fname="cat.jpg", origin="https://img-datasets.s3.amazonaws.com/cat.jpg")
def get_img_array(img_path, target_size):    # Opens the image file and resizes it    img = keras.utils.load_img(img_path, target_size=target_size)    # Turns the image into a float32 NumPy array of shape (180, 180, 3)    array = keras.utils.img_to_array(img)    # We add a dimension to transform our array into a "batch" of a    # single sample. Its shape is now (1, 180, 180, 3).    array = np.expand_dims(array, axis=0)    return array
img_tensor = get_img_array(img_path, target_size=(180, 180))
بیایید تصویر را نمایش دهیم (شکل ۱۰.۱ را ببینید).
لیستینگ ۱۰.۲: نمایش تصویر آزمایشی
import matplotlib.pyplot as plt
plt.axis("off")plt.imshow(img_tensor[0].astype("uint8"))plt.show()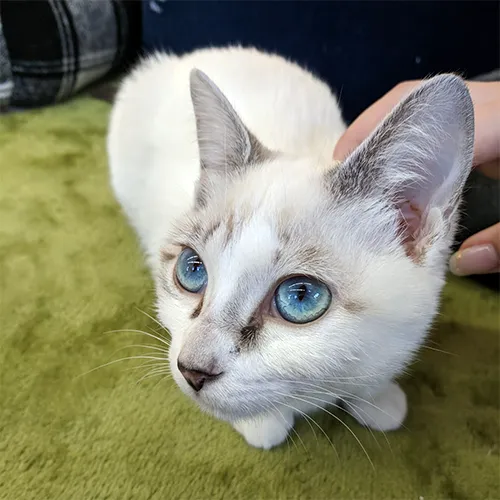
شکل ۱۰.۱: تصویر گربه آزمایشی
برای استخراج نقشههای ویژگی که میخواهید ببینید، یک مدل Keras ایجاد میکنید که دستههایی از تصاویر را بهعنوان ورودی میگیرد و فعالسازیهای تمام لایههای کانولوشن و پولینگ را خروجی میدهد.
لیستینگ ۱۰.۳: نمونهسازی مدلی که فعالسازیهای لایه را برمیگرداند
from keras import layers
layer_outputs = []layer_names = []# Extracts the outputs of all Conv2D and MaxPooling2D layers and put# them in a listfor layer in model.layers:    if isinstance(layer, (layers.Conv2D, layers.MaxPooling2D)):        layer_outputs.append(layer.output)        # Saves the layer names for later        layer_names.append(layer.name)# Creates a model that will return these outputs, given the model inputactivation_model = keras.Model(inputs=model.input, outputs=layer_outputs)
وقتی این مدل با یک تصویر ورودی تغذیه شود، مقادیر فعالسازیهای لایه در مدل اصلی را بهصورت یک لیست برمیگرداند. این اولین بار در این کتاب است که در عمل با یک مدل چندخروجی مواجه میشوید — از زمانی که در فصل ۷ دربارهٔ آنها یاد گرفتید: تا کنون، مدلهایی که دیدهاید دقیقاً یک ورودی و یک خروجی داشتهاند. این مدل یک ورودی و نه خروجی دارد — یک خروجی بهازای هر فعالسازی لایه.
لیستینگ ۱۰.۴: استفاده از مدل برای محاسبهٔ فعالسازیهای لایه
# Returns a list of nine NumPy arrays — one array per layer activationactivations = activation_model.predict(img_tensor)برای مثال، این فعالسازی اولین لایهٔ کانولوشن برای تصویر ورودی گربه است:
>>> first_layer_activation = activations[0]>>> print(first_layer_activation.shape)این یک نقشهٔ ویژگی ۱۷۸ × ۱۷۸ با ۳۲ کانال است. بیایید کانال ششم فعالسازی اولین لایهٔ مدل اصلی را رسم کنیم (شکل ۱۰.۲ را ببینید).
لیستینگ ۱۰.۵: تجسم کانال ششم
import matplotlib.pyplot as plt
plt.matshow(first_layer_activation[0, :, :, 5], cmap="viridis")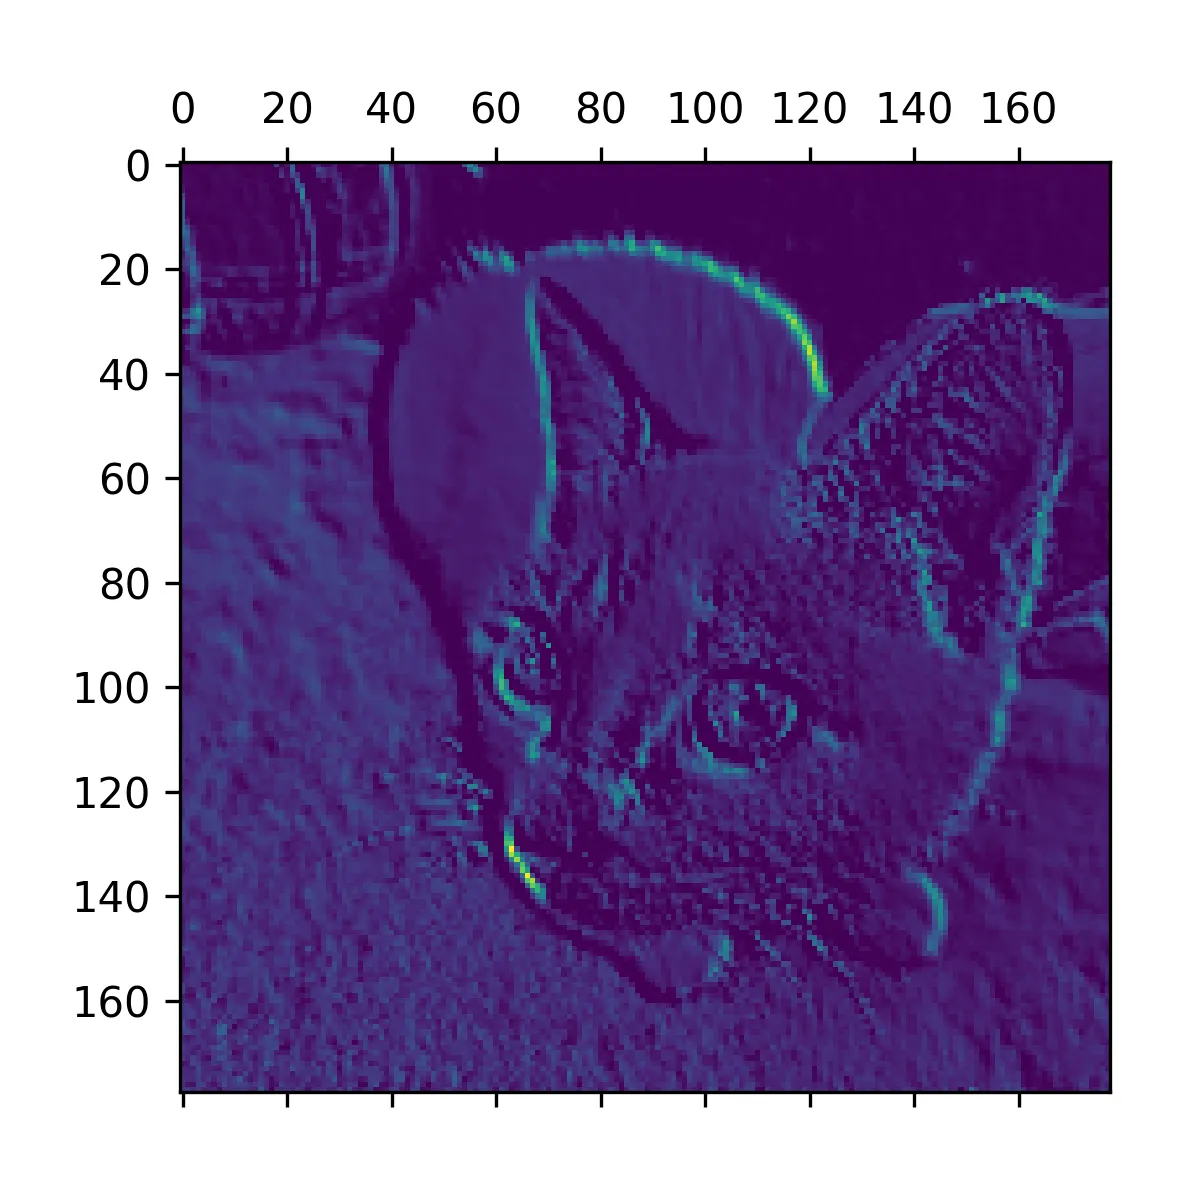
شکل ۱۰.۲: کانال ششم فعالسازی لایهٔ اول روی تصویر گربهٔ آزمایشی
به نظر میرسد این کانال یک آشکارساز لبهٔ مورب را کدگذاری میکند، اما توجه داشته باشید که کانالهای شما ممکن است متفاوت باشند، زیرا فیلترهای خاصی که لایههای کانولوشن یاد میگیرند قطعی نیستند.
حالا بیایید یک تجسم کامل از تمام فعالسازیهای شبکه رسم کنیم (شکل ۱۰.۳ را ببینید). ما هر کانال را در هر یک از فعالسازیهای لایه استخراج و رسم میکنیم، و نتایج را در یک شبکهٔ بزرگ روی هم میچینیم، با کانالها کنار هم.
لیستینگ ۱۰.۶: تجسم هر کانال در هر فعالسازی میانی
images_per_row = 16# Iterates over the activations (and the names of the corresponding# layers)for layer_name, layer_activation in zip(layer_names, activations): # The layer activation has shape (1, size, size, n_features). n_features = layer_activation.shape[-1] size = layer_activation.shape[1] n_cols = n_features // images_per_row # Prepares an empty grid for displaying all the channels in this # activation display_grid = np.zeros( ((size + 1) * n_cols - 1, images_per_row * (size + 1) - 1) ) for col in range(n_cols): for row in range(images_per_row): channel_index = col * images_per_row + row # This is a single channel (or feature). channel_image = layer_activation[0, :, :, channel_index].copy() # Normalizes channel values within the [0, 255] range. # All-zero channels are kept at zero. if channel_image.sum() != 0: channel_image -= channel_image.mean() channel_image /= channel_image.std() channel_image *= 64 channel_image += 128 channel_image = np.clip(channel_image, 0, 255).astype("uint8") # Places the channel matrix in the empty grid we prepared display_grid[ col * (size + 1) : (col + 1) * size + col, row * (size + 1) : (row + 1) * size + row, ] = channel_image # Displays the grid for the layer scale = 1.0 / size plt.figure( figsize=(scale * display_grid.shape[1], scale * display_grid.shape[0]) ) plt.title(layer_name) plt.grid(False) plt.axis("off") plt.imshow(display_grid, aspect="auto", cmap="viridis")
شکل ۱۰.۳: هر کانال از هر فعالسازی لایه روی تصویر گربهٔ آزمایشی
چند نکته در اینجا قابل توجه است:
- لایهٔ اول بهعنوان مجموعهای از آشکارسازهای لبه عمل میکند. در آن مرحله، فعالسازیها تقریباً تمام اطلاعات موجود در تصویر اولیه را حفظ میکنند.
- هر چه بالاتر میروید، فعالسازیها انتزاعیتر و کمتر قابل تفسیر بصری میشوند. آنها شروع به کدگذاری مفاهیم سطح بالاتر مانند «گوش گربه» و «چشم گربه» میکنند. بازنماییهای بالاتر اطلاعات کمتری دربارهٔ محتوای بصری تصویر و اطلاعات بیشتری مرتبط با کلاس تصویر حمل میکنند.
- پراکندگی فعالسازیها با عمق لایه افزایش مییابد: در لایهٔ اول، همهٔ فیلترها توسط تصویر ورودی فعال میشوند، اما در لایههای بعدی، فیلترهای بیشتری خالی هستند. این یعنی الگویی که فیلتر کدگذاری میکند در تصویر ورودی یافت نمیشود.
ما بهتازگی یک ویژگی جهانی مهم از بازنماییهای یادگرفتهشده توسط شبکههای عصبی عمیق را مشاهده کردیم: ویژگیهای استخراجشده توسط یک لایه با عمق لایه انتزاعیتر میشوند. فعالسازیهای لایههای بالاتر اطلاعات کمتری دربارهٔ ورودی خاص دیدهشده و اطلاعات بیشتری دربارهٔ هدف (در این مورد، کلاس تصویر: گربه یا سگ) حمل میکنند. یک شبکهٔ عصبی عمیق در واقع بهعنوان یک خط لولهٔ تقطیر اطلاعات عمل میکند، با دادههای خام که وارد میشوند (در این مورد، تصاویر RGB) و بهطور مکرر تبدیل میشوند تا اطلاعات نامرتبط فیلتر شود (برای مثال، ظاهر بصری خاص تصویر) و اطلاعات مفید بزرگ و تصفیه شود (برای مثال، کلاس تصویر).
این مشابه روشی است که انسانها و حیوانات جهان را درک میکنند: پس از مشاهدهٔ یک صحنه برای چند ثانیه، یک انسان میتواند به یاد آورد که چه اشیاء انتزاعی در آن حضور داشتند (دوچرخه، درخت) اما نمیتواند ظاهر خاص آن اشیاء را به یاد آورد. در واقع، اگر سعی کنید یک دوچرخهٔ عمومی را از حافظه رسم کنید، به احتمال زیاد حتی نمیتوانید آن را از دور هم درست بکشید، حتی اگر در طول زندگی خود هزاران دوچرخه دیده باشید (برای مثال، شکل ۱۰.۴ را ببینید). همین حالا امتحان کنید: این اثر کاملاً واقعی است. مغز شما یاد گرفته است که ورودی بصری خود را کاملاً انتزاعی کند — آن را به مفاهیم بصری سطح بالا تبدیل کند و در عین حال جزئیات بصری نامرتبط را فیلتر کند — و این کار یادآوری ظاهر چیزهای اطراف شما را بسیار دشوار میکند.
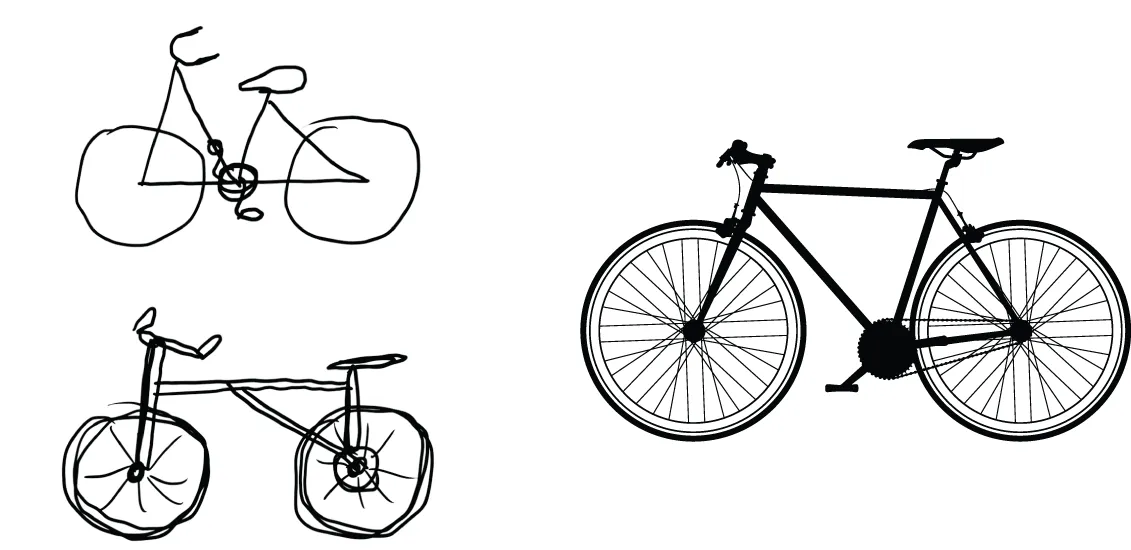
شکل ۱۰.۴: چپ: تلاشهایی برای رسم یک دوچرخه از حافظه. راست: یک دوچرخهٔ شماتیک باید چگونه به نظر برسد.
تجسم فیلترهای ConvNet
Section titled “تجسم فیلترهای ConvNet”روش آسان دیگری برای بررسی فیلترهای یادگرفتهشده توسط ConvNetها، نمایش الگوی بصری است که هر فیلتر قرار است به آن پاسخ دهد. این کار با صعود گرادیان در فضای ورودی انجام میشود، با اعمال نزول گرادیان به مقدار تصویر ورودی یک ConvNet بهگونهای که پاسخ یک فیلتر خاص را بیشینه کند، با شروع از یک تصویر ورودی خالی. تصویر ورودی حاصل، تصویری خواهد بود که فیلتر انتخابشده حداکثر پاسخ را به آن میدهد.
بیایید این کار را با فیلترهای مدل Xception امتحان کنیم. فرآیند ساده است: ما یک تابع زیان میسازیم که مقدار یک فیلتر معین در یک لایهٔ کانولوشن معین را بیشینه میکند، و سپس از نزول گرادیان تصادفی برای تنظیم مقادیر تصویر ورودی استفاده میکنیم تا این مقدار فعالسازی را بیشینه کنیم. این دومین نمونهٔ شما از یک حلقهٔ سطح پایین نزول گرادیان خواهد بود (اولی در فصل ۲ بود). ما آن را برای TensorFlow، PyTorch و Jax نشان خواهیم داد.
ابتدا، بیایید مدل Xception آموزشدیده روی مجموعهدادهٔ ImageNet را نمونهسازی کنیم. میتوانیم دوباره از کتابخانهٔ KerasHub استفاده کنیم، دقیقاً همانطور که در فصل ۸ انجام دادیم.
لیستینگ ۱۰.۷: نمونهسازی پایهٔ کانولوشن Xception
import keras_hub
# Instantiates the feature extractor network from pretrained weightsmodel = keras_hub.models.Backbone.from_preset(    "xception_41_imagenet",)# Loads the matching preprocessing to scale our input imagespreprocessor = keras_hub.layers.ImageConverter.from_preset(    "xception_41_imagenet",    image_size=(180, 180),)
ما به لایههای کانولوشن مدل علاقهمندیم — لایههای Conv2D و SeparableConv2D. برای بازیابی خروجی آنها باید نامهایشان را بدانیم. بیایید نامهایشان را به ترتیب عمق چاپ کنیم.
لیستینگ ۱۰.۸: چاپ نام تمام لایههای کانولوشن در Xception
for layer in model.layers: if isinstance(layer, (keras.layers.Conv2D, keras.layers.SeparableConv2D)): print(layer.name)متوجه خواهید شد که لایههای SeparableConv2D در اینجا همگی چیزی مانند block6_sepconv1، block7_sepconv2 و غیره نامیده میشوند — Xception به بلوکهایی ساختار یافته است که هر کدام شامل چندین لایهٔ کانولوشن هستند.
حالا بیایید یک مدل دوم ایجاد کنیم که خروجی یک لایهٔ خاص را برمیگرداند — یک مدل «استخراجکنندهٔ ویژگی». از آنجا که مدل ما یک مدل Functional API است، قابل بازرسی است: میتوانید output یکی از لایههای آن را پرسوجو کنید و در یک مدل جدید دوباره استفاده کنید. نیازی به کپی کردن کل کد Xception نیست.
لیستینگ ۱۰.۹: یک مدل استخراجکنندهٔ ویژگی که یک خروجی خاص را برمیگرداند
# You could replace this with the name of any layer in the Xception# convolutional base.layer_name = "block3_sepconv1"# This is the layer object we're interested in.layer = model.get_layer(name=layer_name)# We use model.input and layer.output to create a model that, given an# input image, returns the output of our target layer.feature_extractor = keras.Model(inputs=model.input, outputs=layer.output)برای استفاده از این مدل، میتوانیم بهسادگی آن را روی برخی دادههای ورودی فراخوانی کنیم، اما باید مراقب باشیم که پیشپردازش تصویر مخصوص مدل خود را اعمال کنیم تا تصاویر ما به همان محدودهای مقیاس شوند که دادههای پیشآموزش Xception دارند.
لیستینگ ۱۰.۱۰: استفاده از استخراجکنندهٔ ویژگی
activation = feature_extractor(preprocessor(img_tensor))بیایید از مدل استخراجکنندهٔ ویژگی خود برای تعریف تابعی استفاده کنیم که یک مقدار اسکالر را برمیگرداند که کمیت میکند یک تصویر ورودی معین چقدر یک فیلتر معین را در لایه «فعال» میکند. این همان تابع زیانی است که در طول فرآیند صعود گرادیان بیشینه خواهیم کرد:
from keras import ops
# The loss function takes an image tensor and the index of the filter# we consider (an integer).def compute_loss(image, filter_index): activation = feature_extractor(image) # We avoid border artifacts by only involving nonborder pixels in # the loss: we discard the first 2 pixels along the sides of the # activation. filter_activation = activation[:, 2:-2, 2:-2, filter_index] # Returns the mean of the activation values for the filter return ops.mean(filter_activation)یک ترفند غیربدیهی برای کمک به روانی فرآیند صعود گرادیان، نرمالسازی تانسور گرادیان با تقسیم آن بر نرم L2 آن است (ریشهٔ دوم مجموع مربعات مقادیر موجود در تانسور). این تضمین میکند که بزرگی بهروزرسانیهای انجامشده روی تصویر ورودی همیشه در یک محدوده باشد.
بیایید تابع گام صعود گرادیان را تنظیم کنیم. هر چیزی که شامل گرادیان باشد نیازمند فراخوانی APIهای سطح بکاند است، مانند GradientTape در TensorFlow، .backward() در PyTorch، و jax.grad() در JAX. بیایید تمام قطعهکدهای هر سه بکاند را به ترتیب، با شروع از TensorFlow، ردیف کنیم.
صعود گرادیان در TensorFlow
Section titled “صعود گرادیان در TensorFlow”برای TensorFlow، میتوانیم فقط یک محدودهٔ GradientTape باز کنیم و زیان را درون آن محاسبه کنیم تا گرادیانهای مورد نیازمان را بازیابی کنیم. از دکوراتور @tf.function برای سرعتبخشیدن به محاسبات استفاده خواهیم کرد:
لیستینگ ۱۰.۱۱: بیشینهسازی زیان از طریق صعود گرادیان تصادفی: TensorFlow
import tensorflow as tf
@tf.functiondef gradient_ascent_step(image, filter_index, learning_rate):    with tf.GradientTape() as tape:        # Explicitly watches the image tensor, since it isn't a        # TensorFlow Variable (only Variables are automatically watched        # in a gradient tape)        tape.watch(image)        # Computes the loss scalar, indicating how much the current        # image activates the filter        loss = compute_loss(image, filter_index)    # Computes the gradients of the loss with respect to the image    grads = tape.gradient(loss, image)    # Applies the "gradient normalization trick"    grads = ops.normalize(grads)    # Moves the image a little bit in a direction that activates our    # target filter more strongly    image += learning_rate * grads    # Returns the updated image, so we can run the step function in a    # loop    return image
صعود گرادیان در PyTorch
Section titled “صعود گرادیان در PyTorch”در مورد PyTorch، از loss.backward() و image.grad برای بهدست آوردن گرادیانهای زیان نسبت به تصویر ورودی استفاده میکنیم، مانند این.
لیستینگ ۱۰.۱۲: بیشینهسازی زیان از طریق صعود گرادیان تصادفی: PyTorch
import torch
def gradient_ascent_step(image, filter_index, learning_rate):    # Creates a copy of "image" that we can get gradients for.    image = image.clone().detach().requires_grad_(True)    loss = compute_loss(image, filter_index)    loss.backward()    grads = image.grad    grads = ops.normalize(grads)    image = image + learning_rate * grads    return image
نیازی به بازنشانی گرادیانها نیست چون تانسور تصویر در هر تکرار دوباره ایجاد میشود.
صعود گرادیان در JAX
Section titled “صعود گرادیان در JAX”در مورد JAX، از jax.grad() برای بهدست آوردن تابعی استفاده میکنیم که گرادیانهای زیان نسبت به تصویر ورودی را برمیگرداند.
لیستینگ ۱۰.۱۳: بیشینهسازی زیان از طریق صعود گرادیان تصادفی: JAX
import jax
grad_fn = jax.grad(compute_loss)
@jax.jitdef gradient_ascent_step(image, filter_index, learning_rate):    grads = grad_fn(image, filter_index)    grads = ops.normalize(grads)    image += learning_rate * grads    return image
حلقهٔ تجسم فیلتر
Section titled “حلقهٔ تجسم فیلتر”اکنون همهٔ قطعات را دارید. بیایید آنها را در یک تابع پایتون کنار هم بگذاریم که یک شاخص فیلتر بهعنوان ورودی میگیرد و یک تانسور را برمیگرداند که الگوی بیشینهکنندهٔ فعالسازی فیلتر مشخصشده در لایهٔ هدف ما را نشان میدهد.
لیستینگ ۱۰.۱۴: تابعی برای تولید تجسمهای فیلتر
img_width = 200img_height = 200
def generate_filter_pattern(filter_index):    # The number of gradient ascent steps to apply    iterations = 30    # The amplitude of a single step    learning_rate = 10.0    image = keras.random.uniform(        # Initialize an image tensor with random values. (The Xception        # model expects input values in the [0, 1] range, so here we        # pick a range centered on 0.5.)        minval=0.4, maxval=0.6, shape=(1, img_width, img_height, 3)    )    # Repeatedly updates the values of the image tensor to maximize our    # loss function    for i in range(iterations):        image = gradient_ascent_step(image, filter_index, learning_rate)    return image[0]
تانسور تصویر حاصل یک آرایهٔ ممیز شناور با شکل (200, 200, 3) است، با مقادیری که ممکن است اعداد صحیح در محدودهٔ [0, 255] نباشند. از این رو، باید این تانسور را پسپردازش کنید تا به یک تصویر قابل نمایش تبدیل شود. این کار را با تابع کمکی سادهٔ زیر انجام میدهید.
لیستینگ ۱۰.۱۵: تابع کمکی برای تبدیل یک تانسور به یک تصویر معتبر
def deprocess_image(image): # Normalizes image values within the [0, 255] range image -= ops.mean(image) image /= ops.std(image) image *= 64 image += 128 image = ops.clip(image, 0, 255) # Center crop to avoid border artifacts image = image[25:-25, 25:-25, :] image = ops.cast(image, dtype="uint8") return ops.convert_to_numpy(image)بیایید امتحانش کنیم (شکل ۱۰.۵ را ببینید):
>>> plt.axis("off")>>> plt.imshow(deprocess_image(generate_filter_pattern(filter_index=2)))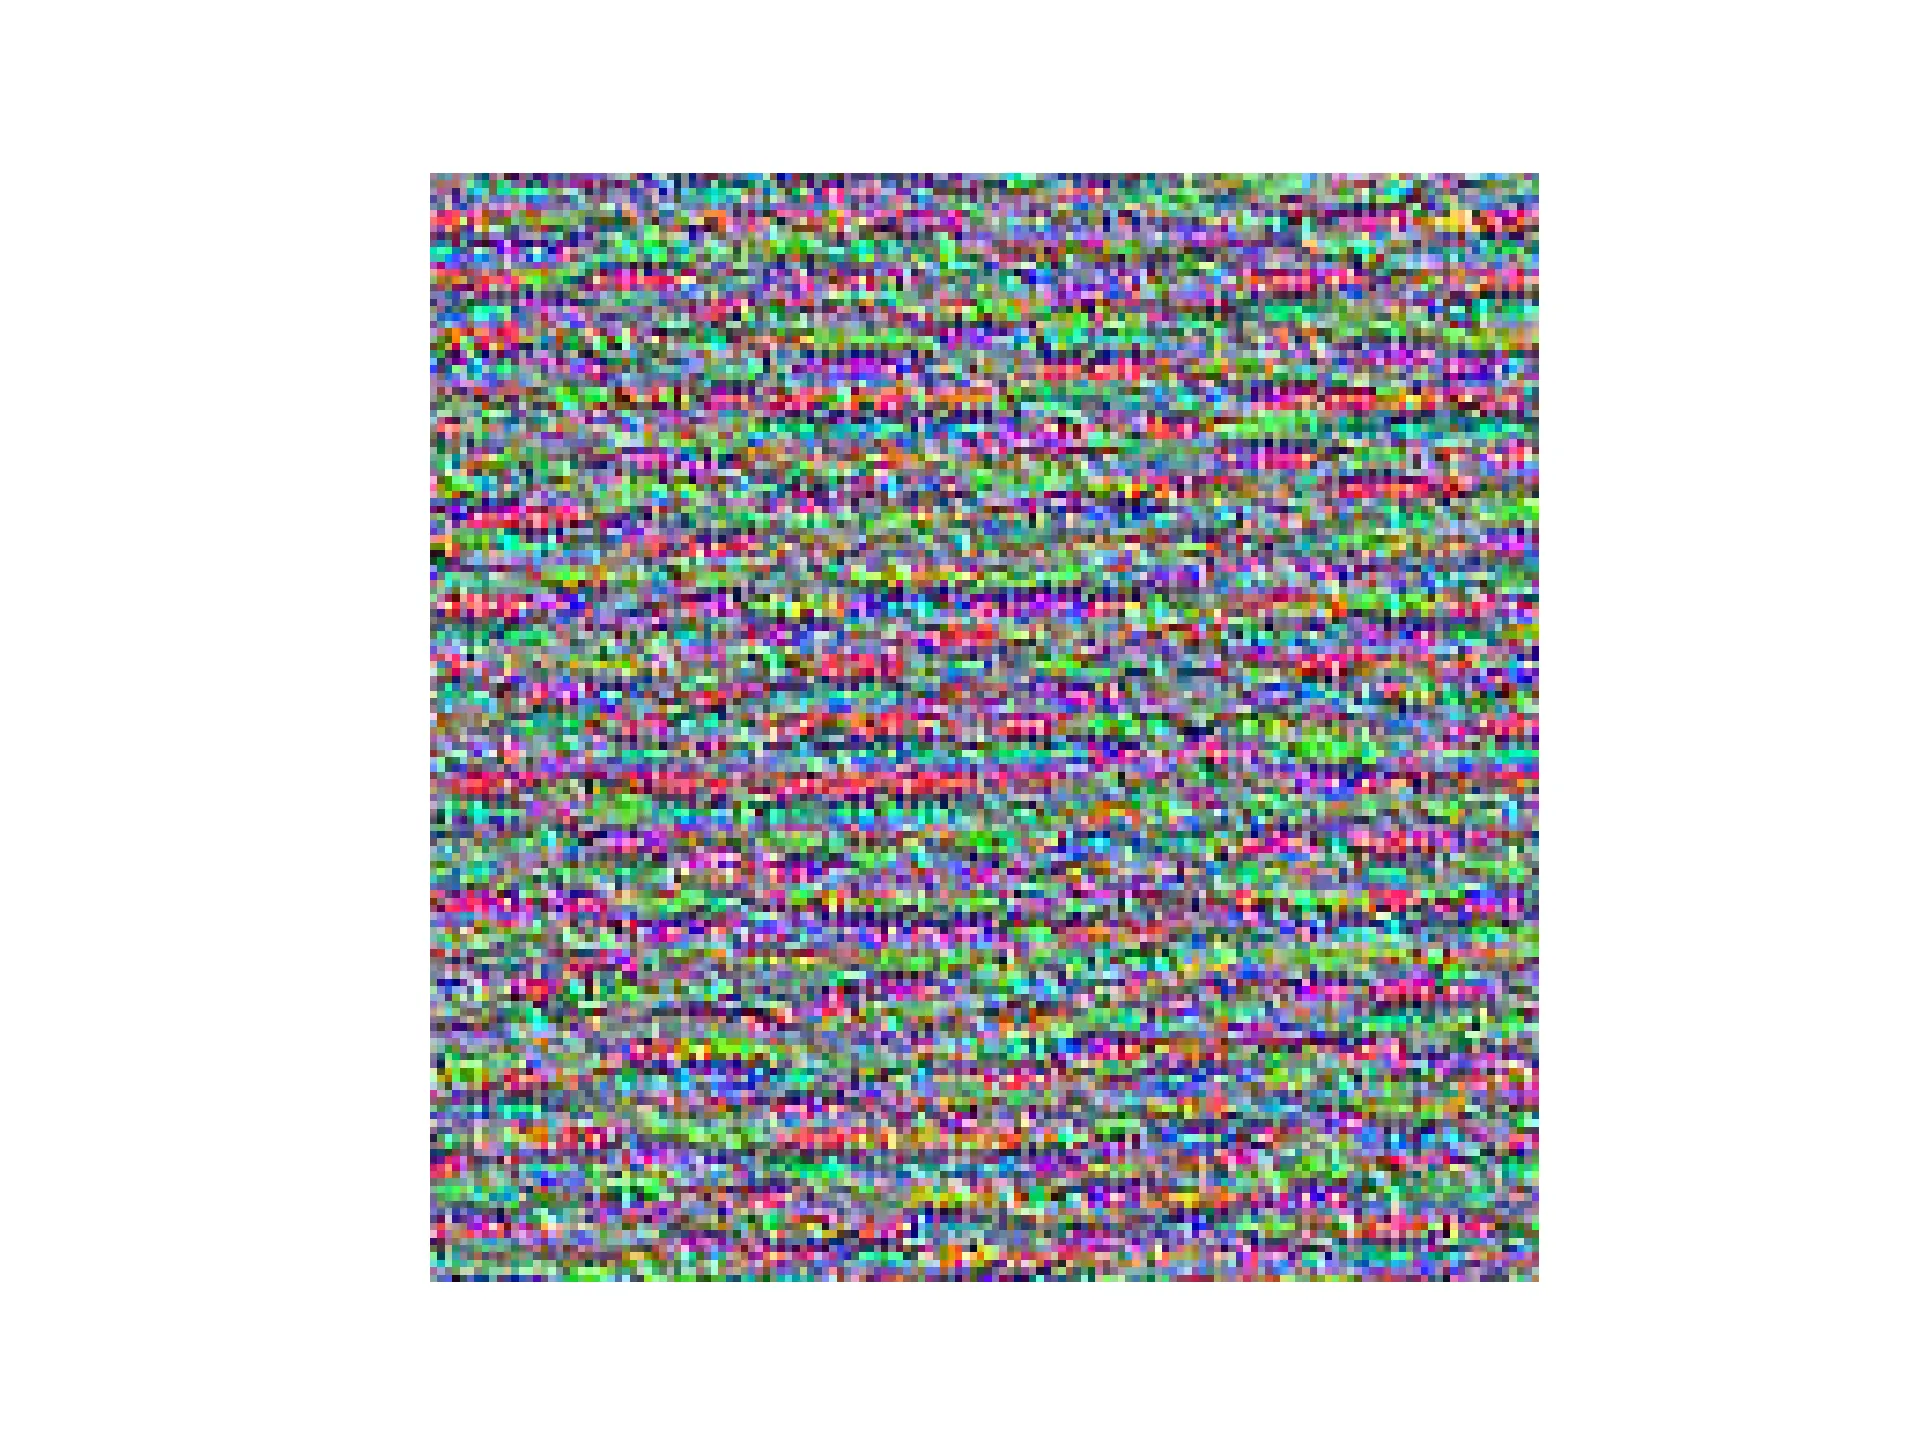
شکل ۱۰.۵: الگویی که کانال دوم در لایهٔ block3_sepconv1 حداکثر به آن پاسخ میدهد
به نظر میرسد فیلتر ۲ در لایهٔ block3_sepconv1 به یک الگوی خطوط افقی، تا حدی شبیه آب یا خز، پاسخ میدهد.
حالا بخش سرگرمکننده: میتوانید تجسم هر فیلتر در لایه — و حتی هر فیلتر در هر لایهٔ مدل — را شروع کنید (شکل ۱۰.۶ را ببینید).
لیستینگ ۱۰.۱۶: تولید یک شبکه از تمام الگوهای پاسخ فیلتر
# Generates and saves visualizations for the first 64 filters in the# layerall_images = []for filter_index in range(64):    print(f"Processing filter {filter_index}")    image = deprocess_image(generate_filter_pattern(filter_index))    all_images.append(image)
# Prepares a blank canvas for us to paste filter visualizationsmargin = 5n = 8box_width = img_width - 25 * 2box_height = img_height - 25 * 2full_width = n * box_width + (n - 1) * marginfull_height = n * box_height + (n - 1) * marginstitched_filters = np.zeros((full_width, full_height, 3))
# Fills the picture with our saved filtersfor i in range(n):    for j in range(n):        image = all_images[i * n + j]        stitched_filters[            (box_width + margin) * i : (box_width + margin) * i + box_width,            (box_height + margin) * j : (box_height + margin) * j + box_height,            :,        ] = image
# Saves the canvas to diskkeras.utils.save_img(f"filters_for_layer_{layer_name}.png", stitched_filters)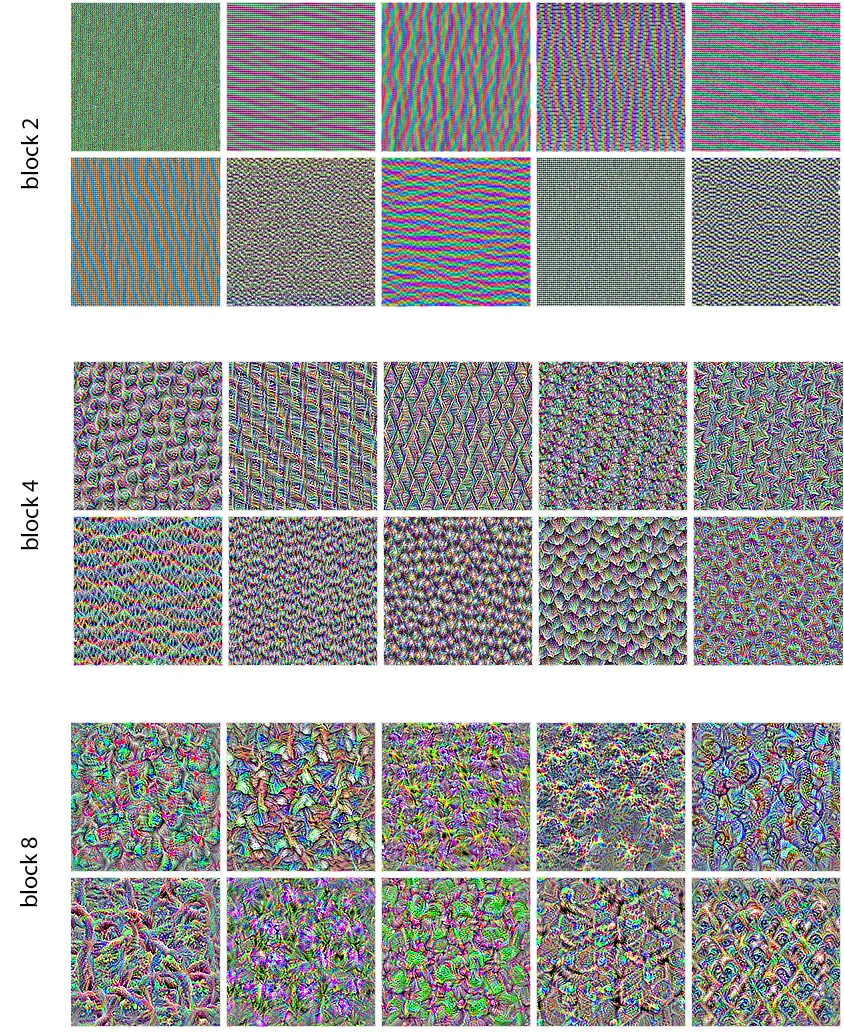
شکل ۱۰.۶: برخی از الگوهای فیلتر برای لایههای block2_sepconv1، block4_sepconv1 و block8_sepconv1
این تجسمهای فیلتر چیزهای زیادی دربارهٔ نحوهٔ دیدن جهان توسط لایههای ConvNet به شما میگویند: هر لایه در یک ConvNet مجموعهای از فیلترها را یاد میگیرد بهگونهای که ورودیهایشان میتوانند بهصورت ترکیبی از فیلترها بیان شوند. این مشابه روشی است که تبدیل فوریه سیگنالها را روی یک بانک از توابع کسینوسی تجزیه میکند. فیلترهای این بانکهای فیلتر ConvNet با بالا رفتن در مدل پیچیدهتر و تصفیهشدهتر میشوند:
- فیلترهای لایههای اول در مدل، لبههای جهتدار ساده و رنگها (یا در برخی موارد، لبههای رنگی) را کدگذاری میکنند.
- فیلترهای لایههای کمی بالاتر در پشته، مانند
block4_sepconv1، بافتهای سادهٔ ساختهشده از ترکیب لبهها و رنگها را کدگذاری میکنند. - فیلترهای لایههای بالاتر شروع به شبیه شدن به بافتهای موجود در تصاویر طبیعی میکنند: پر، چشم، برگ و غیره.
تجسم نقشههای حرارتی فعالسازی کلاس
Section titled “تجسم نقشههای حرارتی فعالسازی کلاس”در اینجا یک تکنیک تجسم آخر — یکی که برای درک اینکه کدام بخشهای یک تصویر معین، یک ConvNet را به تصمیم طبقهبندی نهاییاش هدایت کردهاند مفید است. این برای «اشکالزدایی» فرآیند تصمیم یک ConvNet مفید است، بهویژه در مورد یک اشتباه طبقهبندی (یک حوزهٔ مسئله به نام تفسیرپذیری مدل). همچنین میتواند به شما امکان مکانیابی اشیاء خاص در یک تصویر را بدهد.
این دستهٔ کلی از تکنیکها تجسم نقشهٔ فعالسازی کلاس (CAM) نامیده میشود، و شامل تولید نقشههای حرارتی فعالسازی کلاس روی تصاویر ورودی است. یک نقشهٔ حرارتی فعالسازی کلاس یک شبکهٔ دوبعدی از امتیازهای مرتبط با یک کلاس خروجی خاص است که برای هر مکان در هر تصویر ورودی محاسبه میشود و نشان میدهد هر مکان چقدر نسبت به کلاس مورد نظر مهم است. برای مثال، با توجه به تصویری که به یک ConvNet سگ در برابر گربه داده شده، تجسم CAM به شما امکان میدهد یک نقشهٔ حرارتی برای کلاس «گربه» تولید کنید که نشان میدهد بخشهای مختلف تصویر چقدر گربهمانند هستند، و همچنین یک نقشهٔ حرارتی برای کلاس «سگ» که نشان میدهد بخشهای تصویر چقدر سگمانند هستند. پیادهسازی خاصی که استفاده خواهیم کرد همانی است که در Selvaraju و همکاران توصیف شده است.1
Grad-CAM شامل گرفتن نقشهٔ ویژگی خروجی یک لایهٔ کانولوشن، با توجه به یک تصویر ورودی، و وزندهی به هر کانال در آن نقشهٔ ویژگی با گرادیان کلاس نسبت به آن کانال است. بهطور شهودی، یک راه برای درک این ترفند این است که شما یک نقشهٔ فضایی از «شدت فعالسازی تصویر ورودی برای کانالهای مختلف» را با «اهمیت هر کانال نسبت به کلاس» وزندهی میکنید، که منجر به یک نقشهٔ فضایی از «شدت فعالسازی تصویر ورودی برای کلاس» میشود.
بیایید این تکنیک را با استفاده از مدل Xception از پیش آموزشدیده نشان دهیم. تصویر دو فیل آفریقایی نشان دادهشده در شکل ۱۰.۷ را در نظر بگیرید، احتمالاً یک مادر و بچهاش که در ساوانا قدم میزنند. میتوانیم با دانلود این تصویر و تبدیل آن به یک آرایهٔ NumPy شروع کنیم، همانطور که در شکل ۱۰.۷ نشان داده شده است.
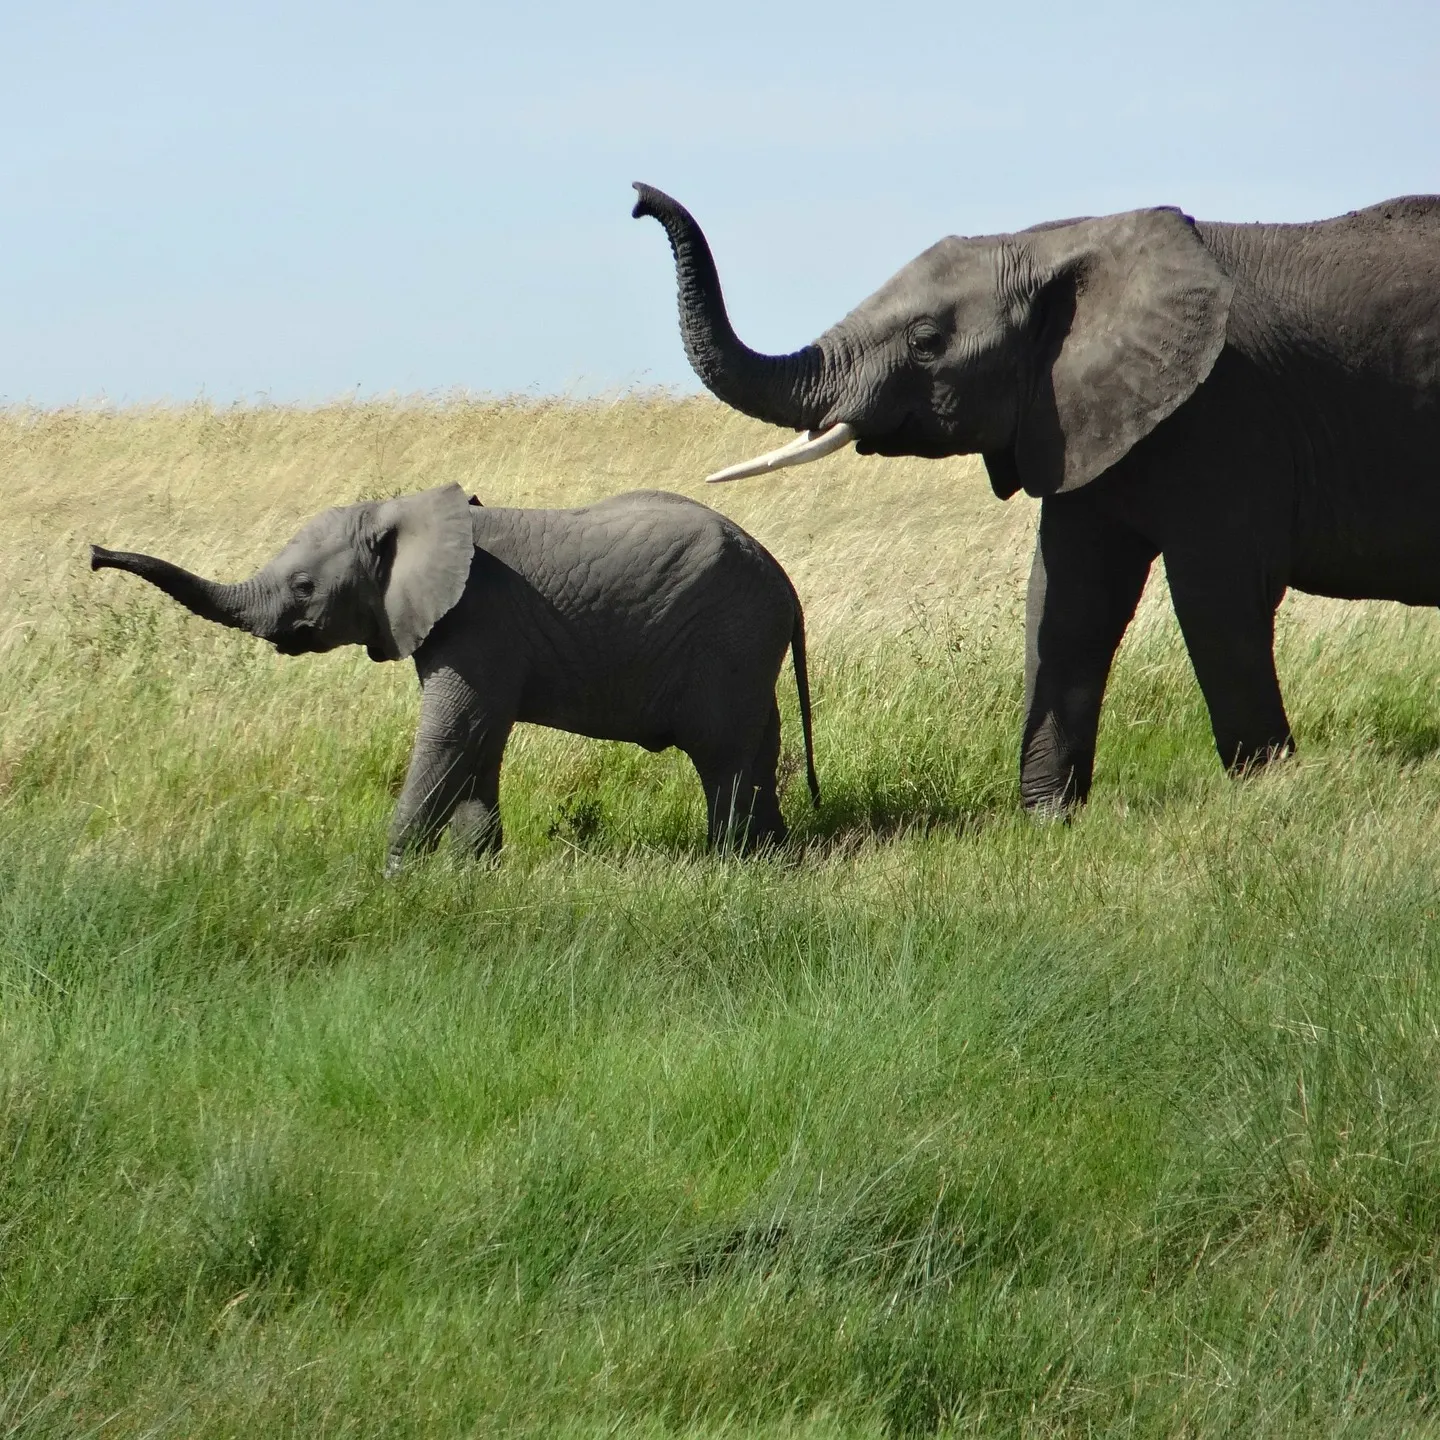
شکل ۱۰.۷: تصویر آزمایشی فیلهای آفریقایی
لیستینگ ۱۰.۱۷: پیشپردازش یک تصویر ورودی برای Xception
# Downloads the image and stores it locally under the path img_pathimg_path = keras.utils.get_file( fname="elephant.jpg", origin="https://img-datasets.s3.amazonaws.com/elephant.jpg",)# Returns a Python Imaging Library (PIL) imageimg = keras.utils.load_img(img_path)img_array = np.expand_dims(img, axis=0)تا کنون، ما فقط از KerasHub برای نمونهسازی یک شبکهٔ استخراجکنندهٔ ویژگی از پیش آموزشدیده با استفاده از کلاس backbone استفاده کردهایم. برای Grad-CAM، به کل مدل Xception شامل سر طبقهبندی نیاز داریم — به یاد داشته باشید که Xception روی مجموعهدادهٔ ImageNet با حدود ۱ میلیون تصویر برچسبدار متعلق به ۱۰۰۰ کلاس مختلف آموزش دیده است.
KerasHub یک API سطح بالای task برای گردشکارهای سرتاسری رایج مانند طبقهبندی تصویر، طبقهبندی متن، تولید تصویر و غیره فراهم میکند. یک task پیشپردازش، یک شبکهٔ استخراج ویژگی و یک سر مخصوص task را در یک کلاس واحد بستهبندی میکند که استفاده از آن آسان است. بیایید آن را امتحان کنیم:
>>> model = keras_hub.models.ImageClassifier.from_preset(... "xception_41_imagenet",... # We can configure the final activation of the classifier. Here,... # we use a softmax activation so our outputs are probabilities.... activation="softmax",... )>>> preds = model.predict(img_array)>>> # ImageNet has 1,000 classes, so each prediction from our>>> # classifier has 1,000 entries.>>> preds.shapeپنج کلاس برتر پیشبینیشده برای این تصویر به شرح زیر است:
- فیل آفریقایی (با احتمال ۹۰٪)
- فیل عاجدار (با احتمال ۵٪)
- فیل هندی (با احتمال ۲٪)
- تریسراتوپس و سگ مکزیکی بیمو با احتمال کمتر از ۰.۱٪
شبکه تصویر را بهعنوان شامل مقدار نامشخصی از فیلهای آفریقایی شناسایی کرده است. ورودی در بردار پیشبینی که حداکثر فعالسازی را داشت، همانی است که با کلاس «فیل آفریقایی» مطابقت دارد، در شاخص ۳۸۶:
>>> np.argmax(preds[0])برای تجسم اینکه کدام بخشهای تصویر بیشترین شباهت را به فیل آفریقایی دارند، بیایید فرآیند Grad-CAM را تنظیم کنیم.
توجه خواهید کرد که ما نیازی به پیشپردازش تصویر قبل از فراخوانی مدل task نداشتیم. این به این دلیل است که ImageClassifier در KerasHub ورودیها را بهعنوان بخشی از predict() برای ما پیشپردازش میکند. بیایید خودمان تصویر را پیشپردازش کنیم تا بتوانیم مستقیماً از ورودیهای پیشپردازششده استفاده کنیم:
# KerasHub tasks like ImageClassifier have a preprocessor layer.img_array = model.preprocessor(img_array)ابتدا، مدلی ایجاد میکنیم که تصویر ورودی را به فعالسازیهای آخرین لایهٔ کانولوشن نگاشت میکند.
لیستینگ ۱۰.۱۸: برگرداندن خروجی آخرین لایهٔ کانولوشن
last_conv_layer_name = "block14_sepconv2_act"last_conv_layer = model.backbone.get_layer(last_conv_layer_name)last_conv_layer_model = keras.Model(model.inputs, last_conv_layer.output)دوم، مدلی ایجاد میکنیم که فعالسازیهای آخرین لایهٔ کانولوشن را به پیشبینیهای نهایی کلاس نگاشت میکند.
لیستینگ ۱۰.۱۹: رفتن از خروجی آخرین کانولوشن به پیشبینیهای نهایی
classifier_input = last_conv_layer.outputx = classifier_inputfor layer_name in ["pooler", "predictions"]: x = model.get_layer(layer_name)(x)classifier_model = keras.Model(classifier_input, x)سپس، گرادیان کلاس برتر پیشبینیشده برای تصویر ورودی خود را نسبت به فعالسازیهای آخرین لایهٔ کانولوشن محاسبه میکنیم. یک بار دیگر، داشتن نیاز به محاسبهٔ گرادیانها به این معنی است که باید از APIهای بکاند استفاده کنیم.
گرفتن گرادیان کلاس برتر: نسخهٔ TensorFlow
Section titled “گرفتن گرادیان کلاس برتر: نسخهٔ TensorFlow”بیایید با نسخهٔ TensorFlow شروع کنیم، یک بار دیگر با استفاده از GradientTape.
لیستینگ ۱۰.۲۰: محاسبهٔ گرادیانهای کلاس برتر با TensorFlow
import tensorflow as tf
def get_top_class_gradients(img_array):    # Computes activations of the last conv layer and makes the tape    # watch it    last_conv_layer_output = last_conv_layer_model(img_array)    with tf.GradientTape() as tape:        tape.watch(last_conv_layer_output)        preds = classifier_model(last_conv_layer_output)        top_pred_index = ops.argmax(preds[0])        # Retrieves the activation channel corresponding to the top        # predicted class        top_class_channel = preds[:, top_pred_index]
    # Gets the gradient of the top predicted class with regard to the    # output feature map of the last convolutional layer    grads = tape.gradient(top_class_channel, last_conv_layer_output)    return grads, last_conv_layer_output
grads, last_conv_layer_output = get_top_class_gradients(img_array)grads = ops.convert_to_numpy(grads)last_conv_layer_output = ops.convert_to_numpy(last_conv_layer_output)
گرفتن گرادیان کلاس برتر: نسخهٔ PyTorch
Section titled “گرفتن گرادیان کلاس برتر: نسخهٔ PyTorch”در ادامه، نسخهٔ PyTorch، با استفاده از .backward() و .grad.
لیستینگ ۱۰.۲۱: محاسبهٔ گرادیانهای کلاس برتر با PyTorch
def get_top_class_gradients(img_array):    # Computes activations of the last conv layer    last_conv_layer_output = last_conv_layer_model(img_array)    # Creates a copy of last_conv_layer_output that we can get    # gradients for    last_conv_layer_output = (        last_conv_layer_output.clone().detach().requires_grad_(True)    )    # Retrieves the activation channel corresponding to the top    # predicted class    preds = classifier_model(last_conv_layer_output)    top_pred_index = ops.argmax(preds[0])    top_class_channel = preds[:, top_pred_index]    # Gets the gradient of the top predicted class with regard to the    # output feature map of the last convolutional layer    top_class_channel.backward()    grads = last_conv_layer_output.grad    return grads, last_conv_layer_output
grads, last_conv_layer_output = get_top_class_gradients(img_array)grads = ops.convert_to_numpy(grads)last_conv_layer_output = ops.convert_to_numpy(last_conv_layer_output)
گرفتن گرادیان کلاس برتر: نسخهٔ JAX
Section titled “گرفتن گرادیان کلاس برتر: نسخهٔ JAX”در نهایت، JAX را انجام دهیم. یک تابع محاسبهٔ زیان جداگانه تعریف میکنیم که خروجی لایهٔ نهایی را میگیرد و کانال فعالسازی مربوط به کلاس برتر پیشبینیشده را برمیگرداند. از این مقدار فعالسازی بهعنوان زیان خود استفاده میکنیم، و این به ما امکان محاسبهٔ گرادیان را میدهد.
لیستینگ ۱۰.۲۲: محاسبهٔ گرادیانهای کلاس برتر با Jax
import jax
# Defines a separate loss functiondef loss_fn(last_conv_layer_output):    preds = classifier_model(last_conv_layer_output)    top_pred_index = ops.argmax(preds[0])    top_class_channel = preds[:, top_pred_index]    # Returns the activation value of the top-class channel    return top_class_channel[0]
# Creates a gradient functiongrad_fn = jax.grad(loss_fn)
def get_top_class_gradients(img_array):    last_conv_layer_output = last_conv_layer_model(img_array)    # Now  retrieving the gradient of the top-class channel is just a    # matter of calling the gradient function!    grads = grad_fn(last_conv_layer_output)    return grads, last_conv_layer_output
grads, last_conv_layer_output = get_top_class_gradients(img_array)grads = ops.convert_to_numpy(grads)last_conv_layer_output = ops.convert_to_numpy(last_conv_layer_output)
نمایش نقشهٔ حرارتی فعالسازی کلاس
Section titled “نمایش نقشهٔ حرارتی فعالسازی کلاس”اکنون، برای بهدست آوردن نقشهٔ حرارتی فعالسازی کلاس، پولینگ و وزندهی اهمیت را روی تانسور گرادیان اعمال میکنیم.
لیستینگ ۱۰.۲۳: پولینگ گرادیان و وزندهی اهمیت کانال
# This is a vector where each entry is the mean intensity of the# gradient for a given channel. It quantifies the importance of each# channel with regard to the top predicted class.pooled_grads = np.mean(grads, axis=(0, 1, 2))last_conv_layer_output = last_conv_layer_output[0].copy()# Multiplies each channel in the output of the last convolutional layer# by how important this channel isfor i in range(pooled_grads.shape[-1]): last_conv_layer_output[:, :, i] *= pooled_grads[i]# The channel-wise mean of the resulting feature map is our heatmap of# class activation.heatmap = np.mean(last_conv_layer_output, axis=-1)برای اهداف تجسم، نقشهٔ حرارتی را نیز بین ۰ و ۱ نرمال میکنید. نتیجه در شکل ۱۰.۸ نشان داده شده است.
لیستینگ ۱۰.۲۴: پسپردازش نقشهٔ حرارتی
heatmap = np.maximum(heatmap, 0)heatmap /= np.max(heatmap)plt.matshow(heatmap)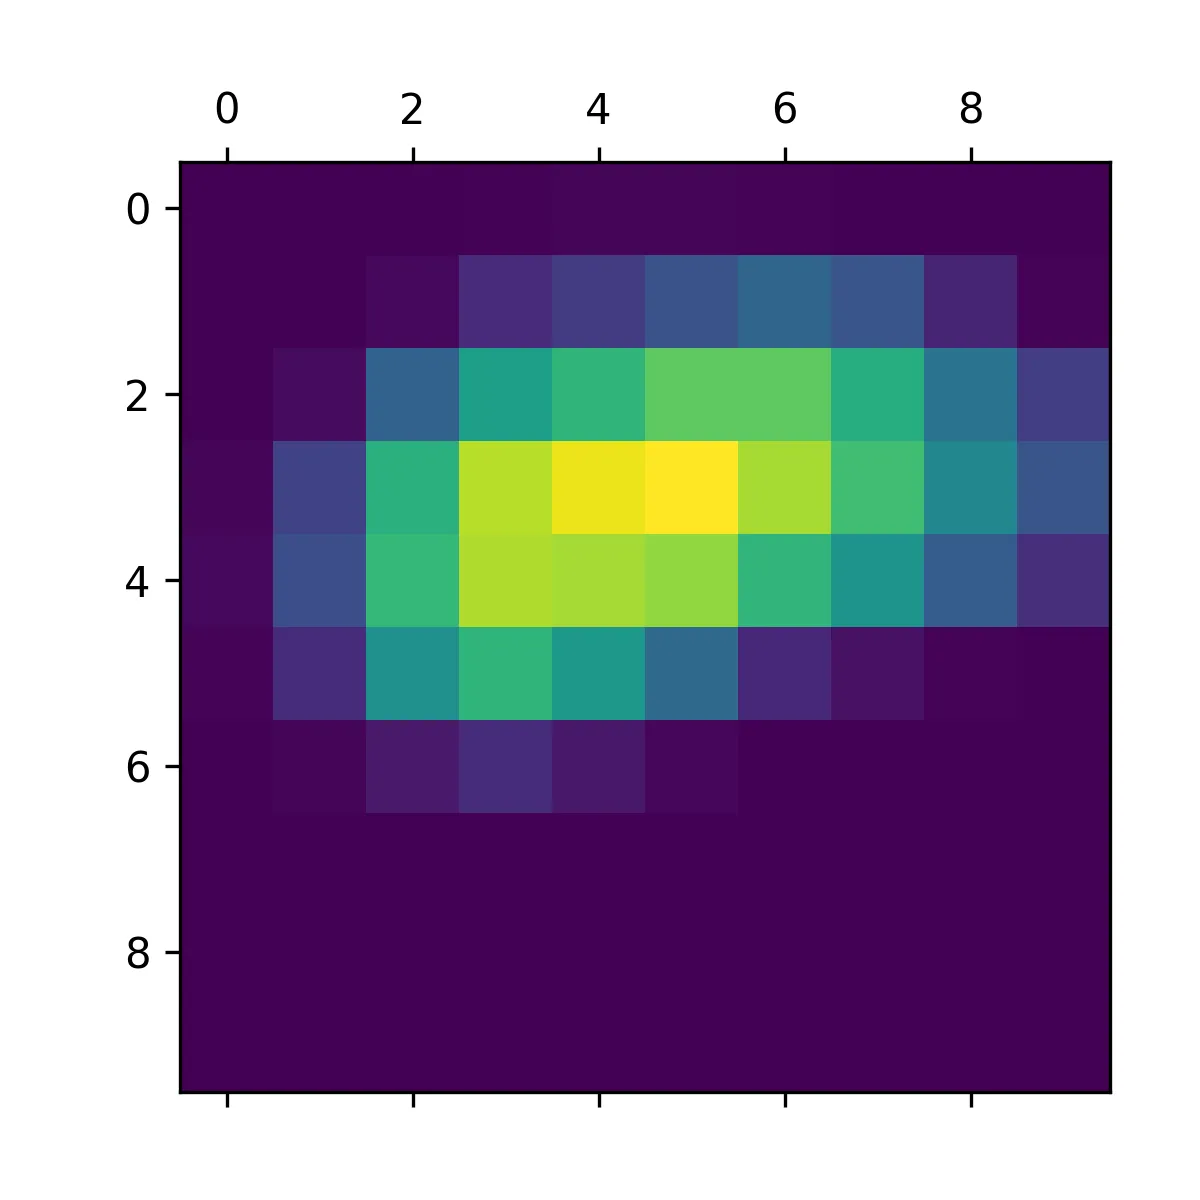
شکل ۱۰.۸: نقشهٔ حرارتی فعالسازی کلاس بهتنهایی
در نهایت، بیایید تصویری تولید کنیم که تصویر اصلی را روی نقشهٔ حرارتی که بهتازگی بهدست آوردید قرار دهد (شکل ۱۰.۹ را ببینید).
لیستینگ ۱۰.۲۵: قرار دادن نقشهٔ حرارتی روی تصویر اصلی
import matplotlib.cm as cm
# Loads the original imageimg = keras.utils.load_img(img_path)img = keras.utils.img_to_array(img)
# Rescales the heatmap to the range 0–255heatmap = np.uint8(255 * heatmap)
# Uses the "jet" colormap to recolorize the heatmapjet = cm.get_cmap("jet")jet_colors = jet(np.arange(256))[:, :3]jet_heatmap = jet_colors[heatmap]
# Creates an image that contains the recolorized heatmapjet_heatmap = keras.utils.array_to_img(jet_heatmap)jet_heatmap = jet_heatmap.resize((img.shape[1], img.shape[0]))jet_heatmap = keras.utils.img_to_array(jet_heatmap)
# Superimposes the heatmap and the original image, with the heatmap at# 40% opacitysuperimposed_img = jet_heatmap * 0.4 + imgsuperimposed_img = keras.utils.array_to_img(superimposed_img)
# Shows the superimposed imageplt.imshow(superimposed_img)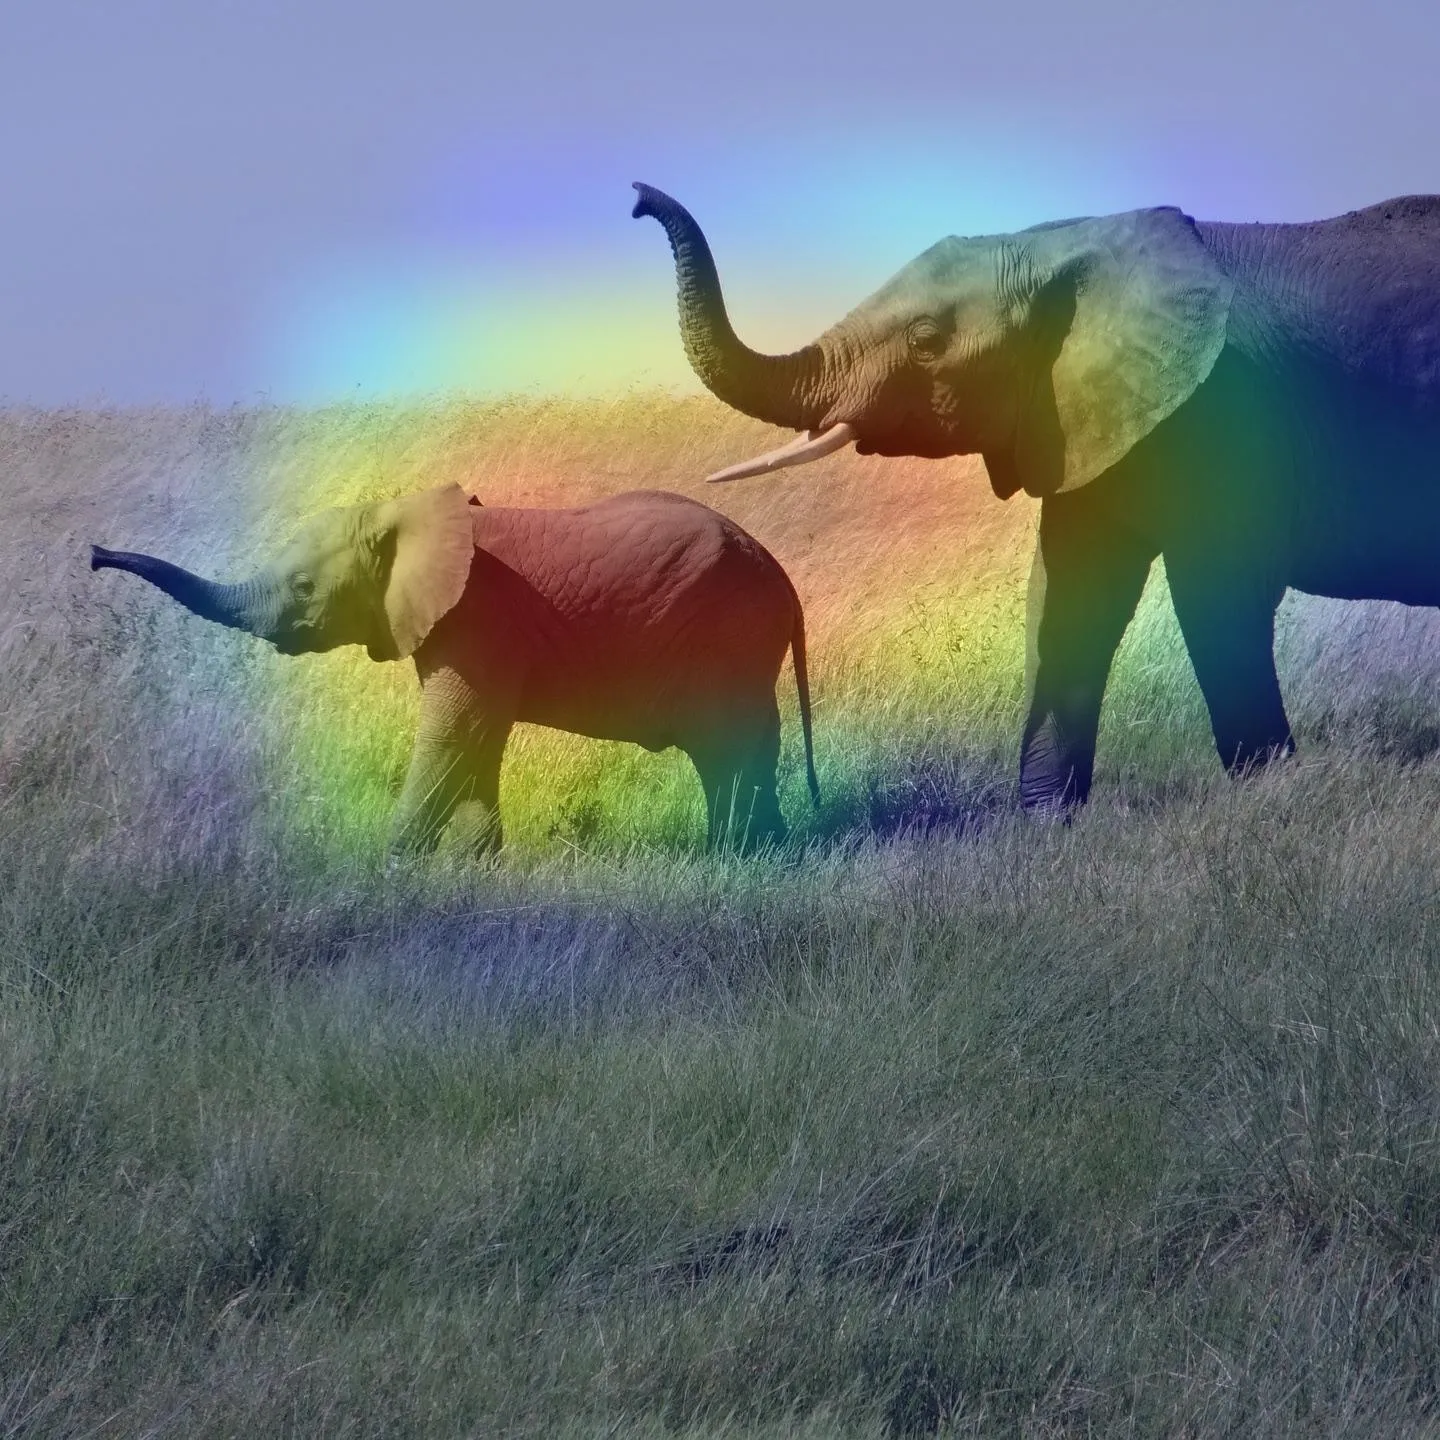
شکل ۱۰.۹: نقشهٔ حرارتی فعالسازی کلاس فیل آفریقایی روی تصویر آزمایشی
این تکنیک تجسم به دو سؤال مهم پاسخ میدهد:
- چرا شبکه فکر کرد این تصویر شامل یک فیل آفریقایی است؟
- فیل آفریقایی در کجای تصویر قرار دارد؟
بهطور خاص، جالب است بدانید که گوشهای بچهفیل بهشدت فعال میشوند: این احتمالاً روشی است که شبکه میتواند تفاوت بین فیل آفریقایی و هندی را تشخیص دهد.
- ConvNetها تصاویر را با اعمال مجموعهای از فیلترهای یادگرفتهشده پردازش میکنند. فیلترهای لایههای اولیه لبهها و بافتهای پایه را تشخیص میدهند، در حالی که فیلترهای لایههای بعدی مفاهیم انتزاعیتری را تشخیص میدهند.
- شما میتوانید هم الگویی که یک فیلتر تشخیص میدهد و هم نقشهٔ پاسخ فیلتر در عرض یک تصویر را تجسم کنید.
- میتوانید از تکنیک Grad-CAM برای تجسم اینکه کدام ناحیه(ها) در یک تصویر مسئول تصمیم یک طبقهبند بودهاند استفاده کنید.
- در کنار هم، این تکنیکها ConvNetها را بهشدت تفسیرپذیر میکنند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
Ramprasaath R. Selvaraju, et al., “Grad-CAM: Visual Explanations from Deep Networks via Gradient-Based Localization,” arxiv (2019), https://arxiv.org/abs/1610.02391. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.