
فصل ۹: الگوهای معماری ConvNet
«معماری» یک مدل مجموع انتخابهایی است که در ایجاد آن انجام شده: از کدام لایهها استفاده شود، چگونه پیکربندی شوند، در چه ترتیبی به هم متصل شوند. این انتخابها فضای فرضیه مدل شما را تعریف میکنند: فضای توابع ممکنی که نزول گرادیان میتواند روی آنها جستجو کند، که توسط وزنهای مدل پارامتری شدهاند. مانند مهندسی ویژگی، یک فضای فرضیهٔ خوب دانش پیشینی را که دربارهٔ مسئلهٔ پیشرو و راهحل آن دارید کدگذاری میکند. برای مثال، استفاده از لایههای کانولوشن به این معناست که از قبل میدانید الگوهای مرتبط موجود در تصاویر ورودی شما نسبت به جابجایی ثابت هستند. برای یادگیری مؤثر از داده، باید دربارهٔ آنچه به دنبالش هستید فرضیاتی بسازید.
معماری مدل اغلب تفاوت بین موفقیت و شکست است. اگر انتخابهای معماری نامناسبی انجام دهید، مدل شما ممکن است با معیارهای زیربهینه گیر کند و هیچ مقدار دادهٔ آموزشی آن را نجات نخواهد داد. برعکس، یک معماری مدل خوب یادگیری را تسریع میکند و مدل شما را قادر میسازد از دادههای آموزشی در دسترس بهطور کارآمد استفاده کند، و نیاز به مجموعهدادههای بزرگ را کاهش دهد. یک معماری مدل خوب معماریای است که اندازهٔ فضای جستجو را کاهش میدهد یا به شکل دیگری همگرایی به یک نقطهٔ خوب از فضای جستجو را آسانتر میکند. درست مانند مهندسی ویژگی و گردآوری داده، معماری مدل همه دربارهٔ آسانتر کردن مسئله برای حل توسط نزول گرادیان است — و به یاد داشته باشید که نزول گرادیان یک فرآیند جستجوی نسبتاً احمقانه است، بنابراین به هر کمکی که بتواند نیاز دارد.
معماری مدل بیشتر هنر است تا علم. مهندسان یادگیری ماشین باتجربه قادرند بهطور شهودی در اولین تلاش مدلهای با عملکرد بالا بسازند، در حالی که مبتدیان اغلب برای ایجاد مدلی که اصلاً آموزش ببیند دستوپنجه نرم میکنند. کلمهٔ کلیدی در اینجا بهطور شهودی است: هیچکس نمیتواند توضیح واضحی از آنچه کار میکند و چه چیزی نمیکند به شما بدهد. کارشناسان بر تطبیق الگو تکیه میکنند، تواناییای که از طریق تجربهٔ عملی گسترده به دست میآورند. شما در طول این کتاب شهود خود را توسعه خواهید داد. با این حال، همهٔ آن هم دربارهٔ شهود نیست — در واقع علم زیادی در کار نیست، اما مانند هر رشتهٔ مهندسی، بهترین روشهایی وجود دارد.
در بخشهای زیر، چند بهترین روش اساسی معماری ConvNet را مرور خواهیم کرد، بهویژه اتصالات باقیمانده، نرمالسازی دستهای و کانولوشن جداشدنی. زمانی که بر نحوهٔ استفاده از آنها مسلط شوید، قادر خواهید بود مدلهای تصویری بسیار مؤثری بسازید. ما نشان خواهیم داد که چگونه آنها را روی مسئلهٔ طبقهبندی سگ در برابر گربه اعمال کنیم.
بیایید از نمای پرنده شروع کنیم: فرمول ماژولاریتی-سلسلهمراتب-استفادهٔ مجدد (MHR) برای معماری سیستم.
ماژولاریتی، سلسلهمراتب و استفادهٔ مجدد
Section titled “ماژولاریتی، سلسلهمراتب و استفادهٔ مجدد”اگر میخواهید یک سیستم پیچیده را سادهتر کنید، یک دستور جهانی وجود دارد که میتوانید اعمال کنید: فقط سوپ بیشکل پیچیدگی خود را به ماژولها ساختار دهید، ماژولها را در یک سلسلهمراتب سازمان دهید و شروع به استفادهٔ مجدد از همان ماژولها در مکانهای متعدد بهصورت مناسب کنید («استفادهٔ مجدد» کلمهٔ دیگری برای انتزاع است). این فرمول ماژولاریتی-سلسلهمراتب-استفادهٔ مجدد (MHR) است (شکل ۹.۱ را ببینید)، و زیربنای معماری سیستم در تقریباً هر حوزهای است که اصطلاح معماری در آن استفاده میشود. این فرمول در قلب سازماندهی هر سیستم پیچیدگی معنادار قرار دارد، خواه یک کلیسای جامع باشد، خواه بدن خود شما، خواه نیروی دریایی ایالات متحده، یا کدبیس Keras.
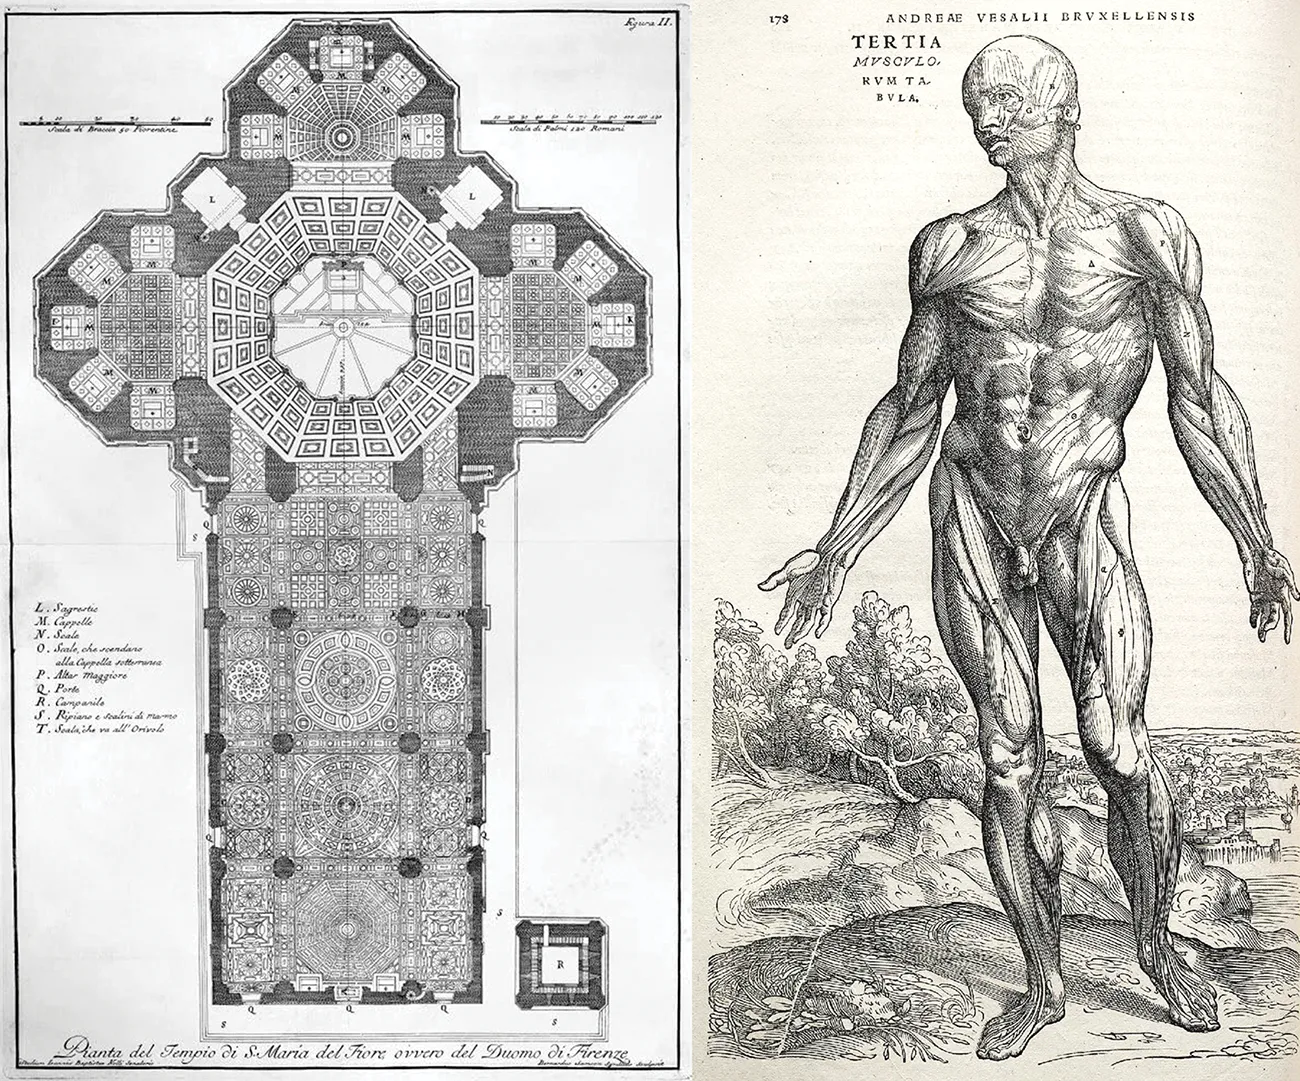
شکل ۹.۱: سیستمهای پیچیده از یک ساختار سلسلهمراتبی پیروی میکنند و در ماژولهای متمایزی سازماندهی میشوند که چندین بار دوباره استفاده میشوند (مانند ۴ اندام شما، که همه انواعی از همان طرح هستند، یا ۲۰ انگشت شما).
اگر مهندس نرمافزار هستید، قبلاً با این اصول کاملاً آشنا هستید: یک کدبیس مؤثر کدبیسی است که ماژولار، سلسلهمراتبی باشد و در آن چیزی را دو بار دوباره پیادهسازی نکنید بلکه به کلاسها و توابع قابل استفادهٔ مجدد تکیه کنید. اگر کد خود را با پیروی از این اصول فاکتور کنید، میتوانید بگویید که در حال انجام «معماری نرمافزار» هستید.
یادگیری عمیق خود صرفاً کاربرد این دستور برای بهینهسازی پیوسته از طریق نزول گرادیان است: شما یک تکنیک بهینهسازی کلاسیک (نزول گرادیان روی یک فضای توابع پیوسته) را میگیرید و فضای جستجو را در ماژولها (لایهها) ساختار میدهید، در یک سلسلهمراتب عمیق (اغلب فقط یک پشته، سادهترین نوع سلسلهمراتب) سازماندهی میکنید، و هر چیزی که میتوانید را دوباره استفاده میکنید (برای مثال، کانولوشنها همه دربارهٔ استفادهٔ مجدد از همان اطلاعات در مکانهای فضایی مختلف هستند).
به همین ترتیب، معماری مدل یادگیری عمیق عمدتاً دربارهٔ استفادهٔ هوشمندانه از ماژولاریتی، سلسلهمراتب و استفادهٔ مجدد است. متوجه خواهید شد که تمام معماریهای محبوب ConvNet نهتنها در لایهها ساختار یافتهاند، بلکه در گروههای تکراری از لایهها (که بلوک یا ماژول نامیده میشوند) نیز ساختار یافتهاند. برای مثال، معماری Xception (که در فصل قبل استفاده شد) در بلوکهای تکراری SeparableConv - SeparableConv - MaxPooling ساختار یافته است (شکل ۹.۲ را ببینید).
علاوه بر این، بیشتر ConvNetها اغلب ساختارهای هرمی (سلسلهمراتب ویژگی) دارند. برای مثال، پیشرفت در تعداد فیلترهای کانولوشن که در اولین ConvNet خود در فصل قبل ساختیم را به یاد بیاورید: ۳۲، ۶۴، ۱۲۸. تعداد فیلترها با عمق لایه رشد میکند، در حالی که اندازهٔ نقشههای ویژگی به همان نسبت کوچک میشود. همین الگو را در بلوکهای مدل Xception خواهید دید (شکل ۹.۲ را ببینید).
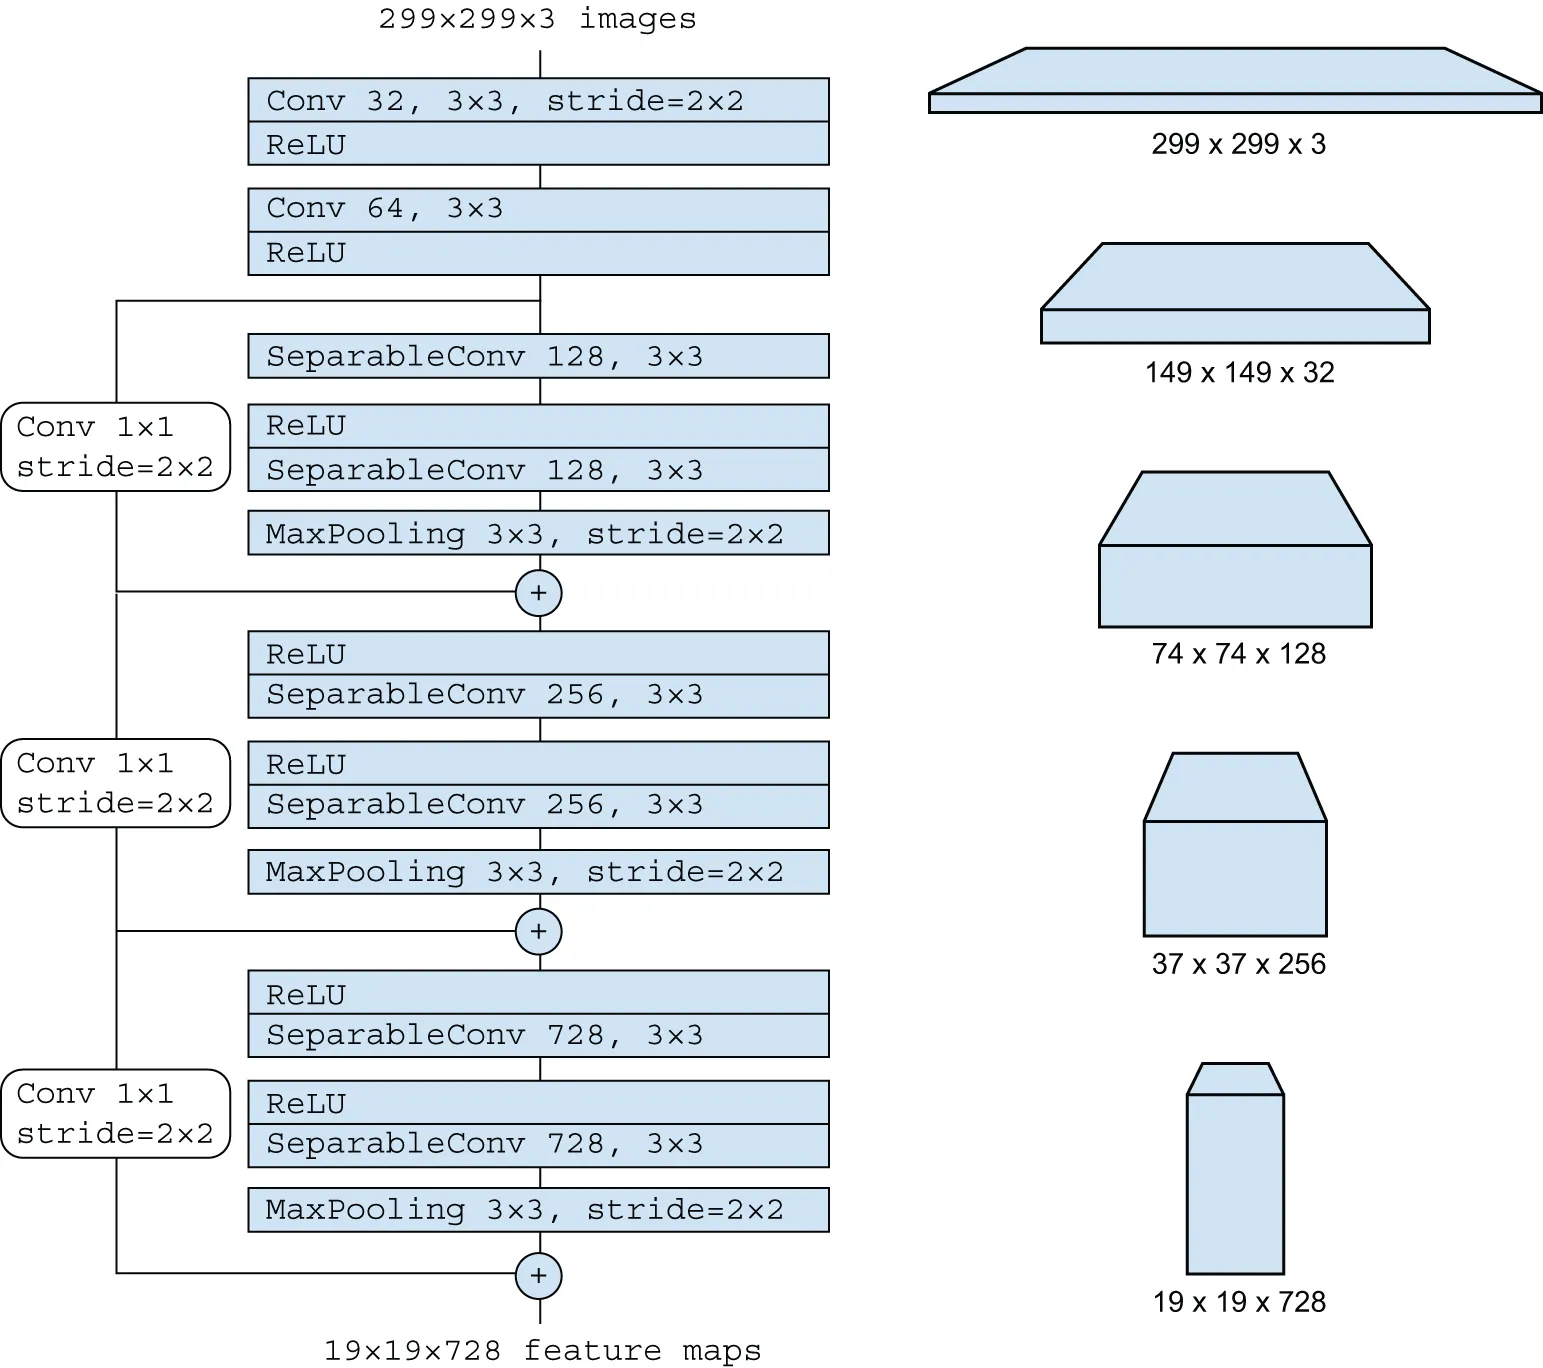
شکل ۹.۲: «جریان ورودی» معماری Xception: به بلوکهای تکراری لایه و نقشههای ویژگی بهتدریج کوچکشونده و عمیقشونده توجه کنید، از ۲۹۹×۲۹۹×۳ به ۱۹×۱۹×۷۲۸.
سلسلهمراتبهای عمیقتر ذاتاً خوب هستند زیرا استفادهٔ مجدد از ویژگی را تشویق میکنند و بنابراین انتزاع را. بهطور کلی، یک پشتهٔ عمیق از لایههای باریک بهتر از یک پشتهٔ کمعمق از لایههای بزرگ عمل میکند. با این حال، محدودیتی برای عمق پشتهٔ لایهها وجود دارد: مسئلهٔ گرادیانهای ناپدیدشونده. این ما را به اولین الگوی اساسی معماری مدل ما میرساند: اتصالات باقیمانده.
اتصالات باقیمانده
Section titled “اتصالات باقیمانده”احتمالاً با بازی تلفن، که در بریتانیا نجواهای چینی و در فرانسه تلفن عربی نیز نامیده میشود، آشنا هستید، جایی که یک پیام اولیه در گوش یک بازیکن نجوا میشود، که سپس آن را در گوش بازیکن بعدی نجوا میکند و به همین ترتیب. پیام نهایی شباهت بسیار کمی به نسخهٔ اصلی خود دارد. این یک استعارهٔ سرگرمکننده برای خطاهای تجمعی است که در انتقال متوالی از طریق یک کانال نویزی رخ میدهند.
همانطور که اتفاق میافتد، پسانتشار در یک مدل یادگیری عمیق متوالی بسیار شبیه به بازی تلفن است. شما یک زنجیره از توابع دارید، مانند این:
y = f4(f3(f2(f1(x))))
نام بازی تنظیم پارامترهای هر تابع در زنجیره بر اساس خطای ثبتشده در خروجی f4 (زیان مدل) است. برای تنظیم f1، باید اطلاعات خطا را از طریق f2، f3 و f4 منتشر کنید. با این حال، هر تابع متوالی در زنجیره مقداری نویز در فرآیند وارد میکند. اگر زنجیرهٔ توابع شما بیشازحد عمیق باشد، این نویز شروع به غلبه بر اطلاعات گرادیان میکند و پسانتشار متوقف میشود. مدل شما اصلاً آموزش نمیبیند. این مسئلهٔ گرادیانهای ناپدیدشونده نامیده میشود.
راهحل ساده است: فقط هر تابع در زنجیره را مجبور کنید غیرمخرب باشد — یک نسخهٔ بدون نویز از اطلاعات موجود در ورودی قبلی را حفظ کند. سادهترین راه برای پیادهسازی این اتصال باقیمانده نامیده میشود. بسیار آسان است: فقط ورودی یک لایه یا بلوک از لایهها را به خروجی آن اضافه کنید (شکل ۹.۳ را ببینید). اتصال باقیمانده بهعنوان یک میانبر اطلاعاتی حول بلوکهای مخرب یا نویزی عمل میکند (مانند بلوکهایی که شامل فعالسازیهای ReLU یا لایههای dropout هستند)، و اطلاعات گرادیان خطا را از لایههای اولیه قادر میسازد بدون نویز از طریق یک شبکهٔ عمیق منتشر شوند. این تکنیک در سال ۲۰۱۵ با خانوادهٔ مدلهای ResNet (توسعهیافته توسط He و همکاران در مایکروسافت) معرفی شد.1
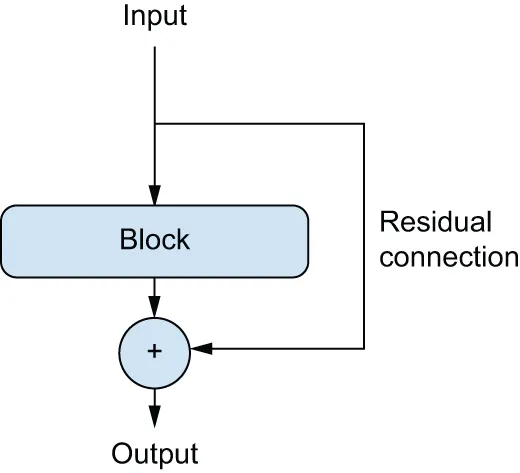
شکل ۹.۳: یک اتصال باقیمانده حول یک بلوک پردازش
در عمل، یک اتصال باقیمانده را مانند لیستینگ زیر پیادهسازی میکنید.
لیستینگ ۹.۱: یک اتصال باقیمانده بهصورت شبهکد
# Some input tensorx = ...# Saves a reference to the original input. This is called the residual.residual = x# This computation block can potentially be destructive or noisy, and# that's fine.x = block(x)# Adds the original input to the layer's output. The final output will# thus always preserve full information about the original input.x = add([x, residual])توجه داشته باشید که افزودن ورودی به خروجی یک بلوک به این معناست که خروجی باید همان شکل ورودی را داشته باشد. این در صورتی که بلوک شما شامل لایههای کانولوشن با تعداد افزایشیافتهٔ فیلترها یا یک لایهٔ max pooling باشد، صادق نیست. در چنین مواردی، از یک لایهٔ Conv2D ۱×۱ بدون فعالسازی برای تصویر خطی باقیمانده به شکل خروجی مورد نظر استفاده کنید. معمولاً در لایههای کانولوشن در بلوک هدف از padding="same" استفاده میکنید تا از کاهش نمونهبرداری فضایی ناشی از پر کردن جلوگیری کنید، و از گامها در تصویر باقیمانده برای مطابقت با هر کاهش نمونهبرداری ناشی از یک لایهٔ max pooling استفاده میکنید.
لیستینگ ۹.۲: بلوک هدف با تغییر تعداد فیلترهای خروجی
import kerasfrom keras import layers
inputs = keras.Input(shape=(32, 32, 3))x = layers.Conv2D(32, 3, activation="relu")(inputs)# Sets aside the residualresidual = x# This is the layer around which we create a residual connection: it# increases the number of output filers from 32 to 64. We use# padding="same" to avoid downsampling due to padding.x = layers.Conv2D(64, 3, activation="relu", padding="same")(x)# The residual only had 32 filters, so we use a 1 x 1 Conv2D to project# it to the correct shape.residual = layers.Conv2D(64, 1)(residual)# Now the block output and the residual have the same shape and can be# added.x = layers.add([x, residual])
لیستینگ ۹.۳: بلوک هدف شامل یک لایهٔ max pooling
inputs = keras.Input(shape=(32, 32, 3))x = layers.Conv2D(32, 3, activation="relu")(inputs)# Sets aside the residualresidual = x# This is the block of two layers around which we create a residual# connection: it includes a 2 x 2 max pooling layer. We use# padding="same" in both the convolution layer and the max pooling# layer to avoid downsampling due to padding.x = layers.Conv2D(64, 3, activation="relu", padding="same")(x)x = layers.MaxPooling2D(2, padding="same")(x)# We use strides=2 in the residual projection to match the downsampling# created by the max pooling layer.residual = layers.Conv2D(64, 1, strides=2)(residual)# Now the block output and the residual have the same shape and can be# added.x = layers.add([x, residual])برای عینیتر کردن این ایدهها، در اینجا یک مثال از یک ConvNet ساده که در مجموعهای از بلوکها ساختار یافته است، هر بلوک از دو لایهٔ کانولوشن و یک لایهٔ max pooling اختیاری تشکیل شده، با یک اتصال باقیمانده حول هر بلوک:
inputs = keras.Input(shape=(32, 32, 3))x = layers.Rescaling(1.0 / 255)(inputs)
# Utility function to apply a convolutional block with a residual# connection, with an option to add max poolingdef residual_block(x, filters, pooling=False):    residual = x    x = layers.Conv2D(filters, 3, activation="relu", padding="same")(x)    x = layers.Conv2D(filters, 3, activation="relu", padding="same")(x)    if pooling:        x = layers.MaxPooling2D(2, padding="same")(x)        # If we use max pooling, we add a strided convolution to        # project the residual to the expected shape.        residual = layers.Conv2D(filters, 1, strides=2)(residual)    elif filters != residual.shape[-1]:        # If we don't use max pooling, we only project the residual if        # the number of channels has changed.        residual = layers.Conv2D(filters, 1)(residual)    x = layers.add([x, residual])    return x
# First blockx = residual_block(x, filters=32, pooling=True)# Second block. Note the increasing filter count in each block.x = residual_block(x, filters=64, pooling=True)# The last block doesn't need a max pooling layer, since we will apply# global average pooling right after it.x = residual_block(x, filters=128, pooling=False)
x = layers.GlobalAveragePooling2D()(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs=inputs, outputs=outputs)
بیایید نگاهی به خلاصهٔ مدل بیندازیم:
>>> model.summary()با اتصالات باقیمانده، میتوانید شبکههایی با عمق دلخواه بسازید، بدون اینکه نگران گرادیانهای ناپدیدشونده باشید. حالا، بیایید به سراغ الگوی اساسی بعدی معماری ConvNet برویم: نرمالسازی دستهای.
نرمالسازی دستهای
Section titled “نرمالسازی دستهای”نرمالسازی در یادگیری ماشین یک دستهٔ گسترده از روشها است که سعی میکنند نمونههای مختلف دیدهشده توسط یک مدل یادگیری ماشین را به هم شبیهتر کنند، که به مدل کمک میکند یاد بگیرد و روی دادههای جدید به خوبی تعمیم یابد. رایجترین شکل نرمالسازی داده یکی است که قبلاً چندین بار در این کتاب دیدهاید: مرکز کردن داده روی صفر با کم کردن میانگین از داده و دادن انحراف معیار واحد به داده با تقسیم داده بر انحراف معیار آن. در واقع، این فرض را میسازد که داده از یک توزیع نرمال (یا گاوسی) پیروی میکند و مطمئن میشود که این توزیع حول صفر مرکز شده و به واریانس واحد مقیاس شده است:
normalized_data = (data - np.mean(data, axis=...)) / np.std(data, axis=...)مثالهای قبلی که در این کتاب دیدید دادهها را قبل از تغذیه به مدلها نرمالسازی میکردند. اما نرمالسازی داده ممکن است پس از هر تبدیل انجامشده توسط شبکه نیز یک نگرانی باشد: حتی اگر دادههای ورودی به یک شبکهٔ Dense یا Conv2D میانگین ۰ و واریانس واحد داشته باشند، هیچ دلیلی وجود ندارد که از پیش انتظار داشته باشیم این برای دادههای خروجی صادق باشد. آیا نرمالسازی فعالسازیهای میانی میتواند کمک کند؟
نرمالسازی دستهای دقیقاً همین کار را میکند. این یک نوع لایه (BatchNormalization در Keras) است که در سال ۲۰۱۵ توسط Ioffe و Szegedy معرفی شد؛2 این لایه میتواند دادهها را بهصورت تطبیقی نرمالسازی کند حتی زمانی که میانگین و واریانس در طول آموزش تغییر میکنند. در طول آموزش، از میانگین و واریانس دستهٔ فعلی داده برای نرمالسازی نمونهها استفاده میکند، و در استنتاج (زمانی که یک دستهٔ بهاندازهٔ کافی بزرگ از دادههای نماینده ممکن است در دسترس نباشد)، از یک میانگین متحرک نمایی از میانگین و واریانس دستهای دادههای دیدهشده در طول آموزش استفاده میکند.
اگرچه مقالهٔ اصلی Ioffe و Szegedy پیشنهاد میکرد که نرمالسازی دستهای با «کاهش تغییر کوواریت داخلی» عمل میکند، هیچکس واقعاً مطمئن نیست که چرا نرمالسازی دستهای کمک میکند. فرضیههای مختلفی وجود دارد اما هیچ قطعیتی نیست. خواهید دید که این در مورد بسیاری از چیزها در یادگیری عمیق صادق است — یادگیری عمیق یک علم دقیق نیست بلکه مجموعهای از بهترین روشهای مهندسی دائماً در حال تغییر و بهصورت تجربی استخراجشده است که با روایتهای غیرقابل اعتماد در هم بافته شدهاند. گاهی اوقات احساس خواهید کرد که کتابی که در دست دارید به شما میگوید چگونه کاری را انجام دهید اما کاملاً رضایتبخش نمیگوید چرا کار میکند: این به این دلیل است که ما چگونه را میدانیم اما چرا را نمیدانیم. هر زمان توضیح قابل اعتمادی در دسترس باشد، حتماً به آن اشاره میکنیم. نرمالسازی دستهای یکی از این موارد نیست.
در عمل، به نظر میرسد اثر اصلی نرمالسازی دستهای این است که به انتشار گرادیان کمک میکند — بسیار شبیه به اتصالات باقیمانده — و بنابراین اجازه میدهد شبکههای عمیقتری داشته باشید. برخی شبکههای بسیار عمیق فقط در صورتی میتوانند آموزش ببینند که شامل چندین لایهٔ BatchNormalization باشند. برای مثال، نرمالسازی دستهای بهطور آزادانه در بسیاری از معماریهای پیشرفتهٔ ConvNet که همراه Keras بستهبندی شدهاند استفاده میشود، مانند ResNet50، EfficientNet و Xception.
لایهٔ BatchNormalization میتواند پس از هر لایهای استفاده شود — Dense، Conv2D و غیره:
x = ...# Because the output of the Conv2D layer gets normalized, the layer# doesn't need its own bias vector.x = layers.Conv2D(32, 3, use_bias=False)(x)x = layers.BatchNormalization()(x)مهم است که، بهطور کلی توصیه میکنم فعالسازی لایهٔ قبلی را پس از لایهٔ نرمالسازی دستهای قرار دهید (اگرچه این هنوز موضوع بحث است). بنابراین بهجای انجام
لیستینگ ۹.۴: نحوهٔ استفاده نادرست از نرمالسازی دستهای
x = layers.Conv2D(32, 3, activation="relu")(x)x = layers.BatchNormalization()(x)در واقع موارد زیر را انجام میدهید:
لیستینگ ۹.۵: نحوهٔ استفاده از نرمالسازی دستهای
# Note the lack of activation here.x = layers.Conv2D(32, 3, use_bias=False)(x)x = layers.BatchNormalization()(x)# We place the activation after the BatchNormalization layer.x = layers.Activation("relu")(x)دلیل شهودی این است که نرمالسازی دستهای ورودیهای شما را روی صفر مرکز میکند، در حالی که فعالسازی ReLU شما از صفر بهعنوان محور برای نگه داشتن یا حذف کانالهای فعالشده استفاده میکند: انجام نرمالسازی قبل از فعالسازی استفاده از ReLU را به حداکثر میرساند. با این حال، این بهترین روش ترتیبدهی دقیقاً حیاتی نیست، بنابراین اگر کانولوشن-فعالسازی-نرمالسازی دستهای انجام دهید، مدل شما همچنان آموزش میبیند و لزوماً نتایج بدتری نخواهید دید.
حالا، بیایید نگاهی به آخرین الگوی معماری در مجموعهٔ خود بیندازیم: کانولوشنهای جداشدنی عمقی.
کانولوشنهای جداشدنی عمقی
Section titled “کانولوشنهای جداشدنی عمقی”چه میشد اگر به شما میگفتیم لایهای وجود دارد که میتوانید بهعنوان جایگزینی مستقیم برای Conv2D استفاده کنید که مدل شما را کوچکتر (وزنهای آموزشپذیر کمتر)، سبکتر (عملیات ممیز شناور کمتر) میکند و باعث میشود چند درصد بهتر روی وظیفهٔ خود عمل کند؟ این دقیقاً همان کاری است که لایهٔ کانولوشن جداشدنی عمقی انجام میدهد (SeparableConv2D در Keras). این لایه یک کانولوشن فضایی روی هر کانال از ورودی خود، بهطور مستقل، قبل از ترکیب کانالهای خروجی از طریق یک کانولوشن نقطهای (یک کانولوشن ۱×۱) انجام میدهد، همانطور که در شکل ۹.۴ نشان داده شده است.
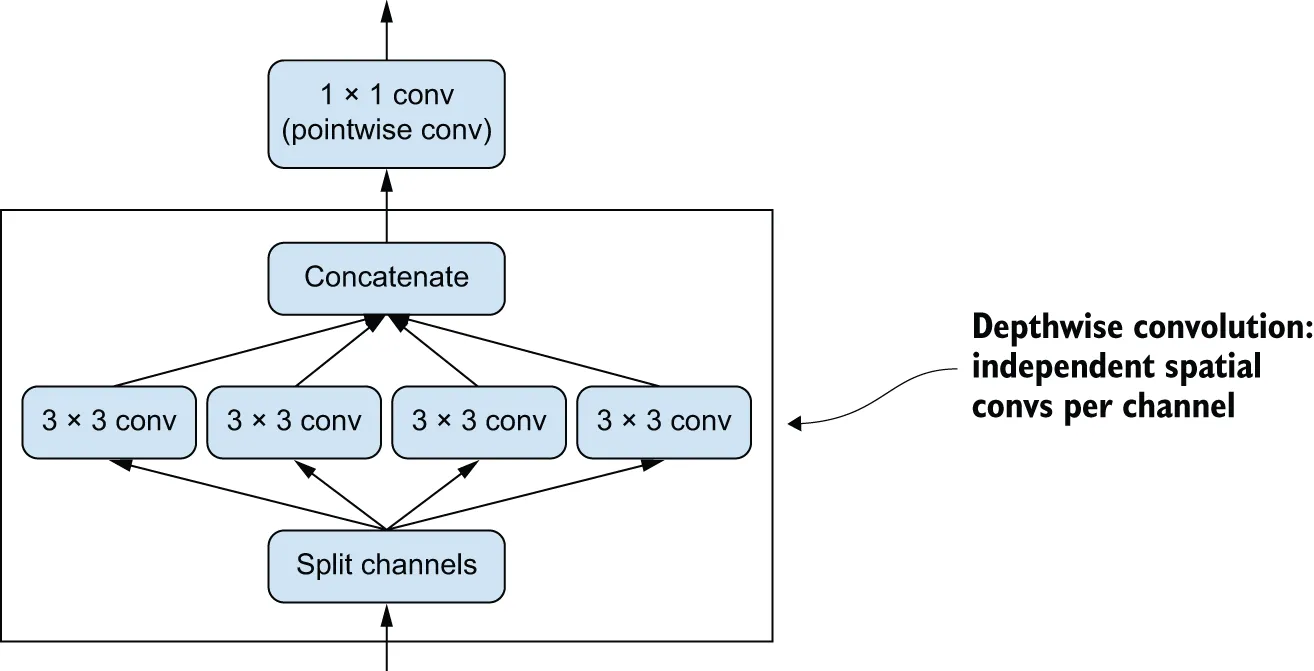
شکل ۹.۴: کانولوشن جداشدنی عمقی: یک کانولوشن عمقی و سپس یک کانولوشن نقطهای
این معادل جداسازی یادگیری ویژگیهای فضایی و یادگیری ویژگیهای کانالی است. بسیار شبیه به اینکه کانولوشن بر این فرض تکیه میکند که الگوهای موجود در تصاویر به مکانهای خاصی گره نخوردهاند، کانولوشن جداشدنی عمقی بر این فرض تکیه میکند که مکانهای فضایی در فعالسازیهای میانی بهشدت همبسته هستند، اما کانالهای مختلف بهشدت مستقل هستند. از آنجا که این فرض عموماً برای بازنماییهای تصویری یادگرفتهشده توسط شبکههای عصبی عمیق صادق است، بهعنوان یک پیشینی مفید عمل میکند که به مدل کمک میکند از دادههای آموزشی خود استفادهٔ کارآمدتری کند. مدلی با پیشینیهای قویتر دربارهٔ ساختار اطلاعاتی که باید پردازش کند، مدل بهتری است — تا زمانی که پیشینیها دقیق باشند.
کانولوشن جداشدنی عمقی بهطور قابل توجهی پارامترهای کمتری نیاز دارد و محاسبات کمتری نسبت به کانولوشن معمولی دارد، در حالی که قدرت بازنمایی قابل مقایسهای دارد. آنها مدلهای کوچکتری تولید میکنند که سریعتر همگرا میشوند و کمتر مستعد بیشبرازش هستند. این مزایا بهویژه هنگام آموزش مدلهای کوچک از صفر روی دادههای محدود مهم میشوند.
وقتی صحبت از مدلهای در مقیاس بزرگتر میشود، کانولوشنهای جداشدنی عمقی اساس معماری Xception هستند، یک ConvNet با عملکرد بالا که همراه Keras بستهبندی شده است. میتوانید دربارهٔ مبنای نظری کانولوشنهای جداشدنی عمقی و Xception در مقالهٔ «Xception: Deep Learning with Depthwise Separable Convolutions» بیشتر بخوانید.3
کنار هم گذاشتن همهچیز: یک مدل کوچک شبیه Xception
Section titled “کنار هم گذاشتن همهچیز: یک مدل کوچک شبیه Xception”بهعنوان یادآوری، اینها اصول معماری ConvNet هستند که تاکنون یاد گرفتهاید:
- مدل شما باید در بلوکهای تکراری از لایهها، که معمولاً از چندین لایهٔ کانولوشن و یک لایهٔ max pooling تشکیل شدهاند، سازماندهی شود.
- تعداد فیلترها در لایههای شما باید با کاهش اندازهٔ نقشههای ویژگی فضایی افزایش یابد.
- عمیق و باریک بهتر از پهن و کمعمق است.
- معرفی اتصالات باقیمانده حول بلوکهای لایه به شما کمک میکند شبکههای عمیقتری آموزش دهید.
- معرفی لایههای نرمالسازی دستهای پس از لایههای کانولوشن شما میتواند مفید باشد.
- جایگزینی لایههای
Conv2Dبا لایههایSeparableConv2Dمیتواند مفید باشد، زیرا از نظر پارامتر کارآمدتر هستند.
بیایید همهٔ این ایدهها را در یک مدل واحد کنار هم بگذاریم. معماری آن شبیه به نسخهٔ کوچکتری از Xception است. ما آن را روی وظیفهٔ سگ در برابر گربه از فصل قبل اعمال خواهیم کرد. برای بارگذاری داده و آموزش مدل، بهسادگی از همان تنظیماتی که در فصل ۸، بخش ۸.۲ استفاده کردیم دوباره استفاده کنید — اما تعریف مدل را با ConvNet زیر جایگزین کنید:
import keras
inputs = keras.Input(shape=(180, 180, 3))# Don't forget input rescaling!x = layers.Rescaling(1.0 / 255)(inputs)# The assumption that underlies separable convolution, "Feature# channels are largely independent," does not hold for RGB images! Red,# green, and blue color channels are actually highly correlated in# natural images. As such, the first layer in our model is a regular# `Conv2D` layer. We'll start using `SeparableConv2D` afterward.x = layers.Conv2D(filters=32, kernel_size=5, use_bias=False)(x)
# We apply a series of convolutional blocks with increasing feature# depth. Each block consists of two batch-normalized depthwise# separable convolution layers and a max pooling layer, with a residual# connection around the entire block.for size in [32, 64, 128, 256, 512]:    residual = x
    x = layers.BatchNormalization()(x)    x = layers.Activation("relu")(x)    x = layers.SeparableConv2D(size, 3, padding="same", use_bias=False)(x)
    x = layers.BatchNormalization()(x)    x = layers.Activation("relu")(x)    x = layers.SeparableConv2D(size, 3, padding="same", use_bias=False)(x)
    x = layers.MaxPooling2D(3, strides=2, padding="same")(x)
    residual = layers.Conv2D(        size, 1, strides=2, padding="same", use_bias=False    )(residual)    x = layers.add([x, residual])
# In the original model, we used a Flatten layer before the Dense# layer. Here, we go with a GlobalAveragePooling2D layer.x = layers.GlobalAveragePooling2D()(x)# Like in the original model, we add a dropout layer for# regularization.x = layers.Dropout(0.5)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs=inputs, outputs=outputs)
این ConvNet تعداد پارامتر آموزشپذیر ۷۲۱,۸۵۷ دارد، بهطور قابل توجهی کمتر از ۱,۵۶۹,۰۸۹ پارامتر آموزشپذیر مدل فصل قبل، اما نتایج بهتری به دست میآورد. شکل ۹.۵ منحنیهای آموزش و اعتبارسنجی را نشان میدهد.
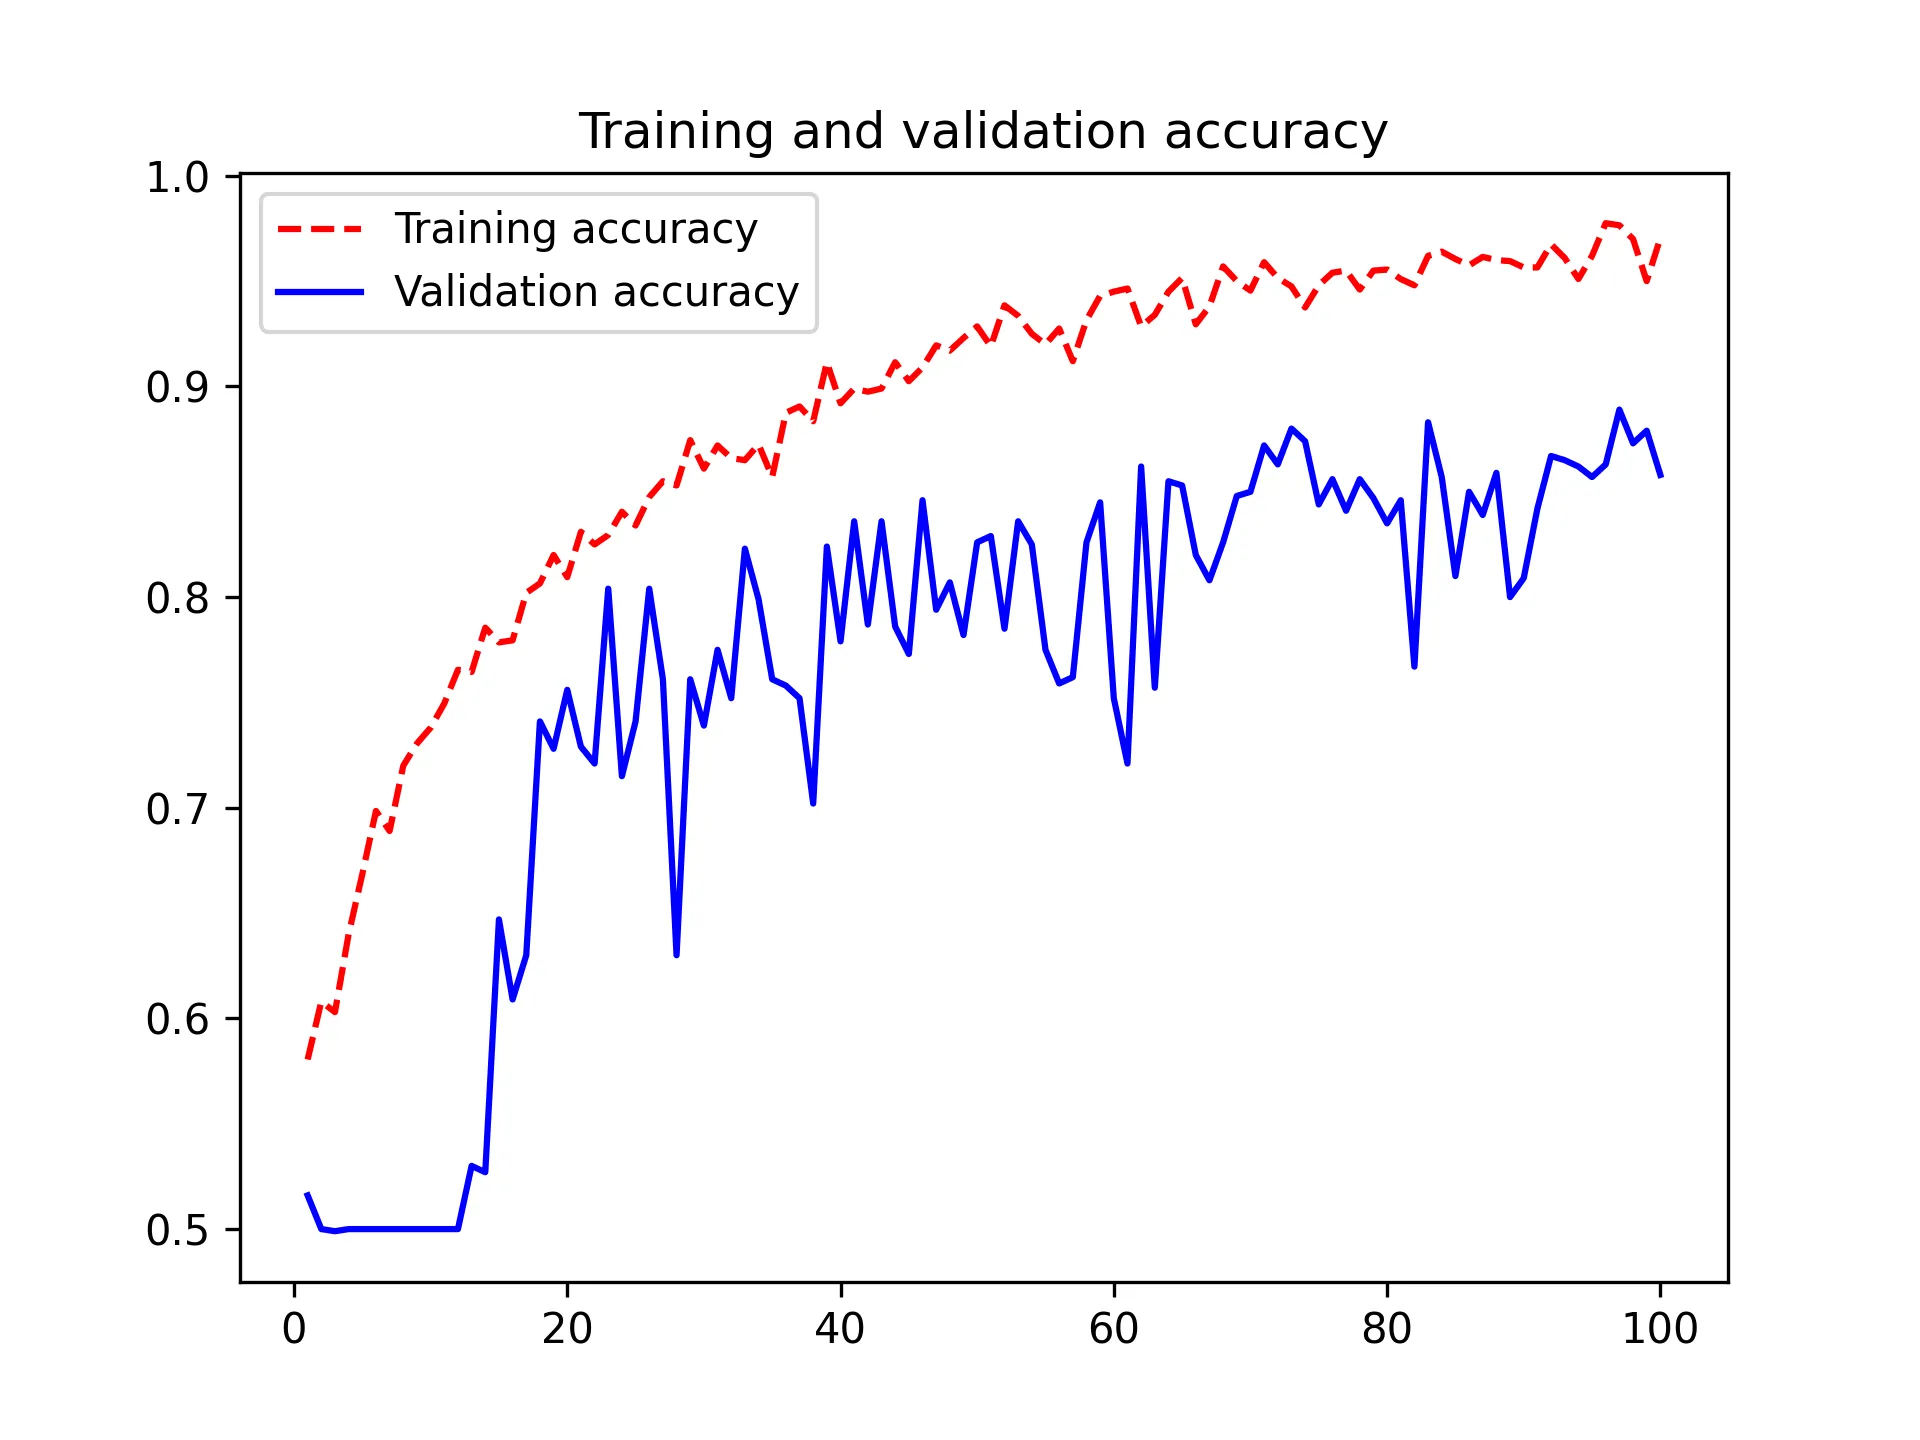
شکل ۹.۵: معیارهای آموزش و اعتبارسنجی با یک معماری شبیه Xception
خواهید دید که مدل جدید ما به دقت آزمایش ۹۰.۸٪ میرسد — در مقایسه با ۸۳.۹٪ برای مدل قبلی. همانطور که میبینید، پیروی از بهترین روشهای معماری تأثیر فوری و قابل توجهی بر عملکرد مدل دارد!
در این مرحله، اگر میخواهید عملکرد را بیشتر بهبود دهید، باید شروع به تنظیم سیستماتیک فراپارامترهای معماری خود کنید — موضوعی که در فصل ۱۸ با جزئیات پوشش میدهیم. ما این مرحله را در اینجا طی نکردهایم، بنابراین پیکربندی مدل قبلی صرفاً از بهترین روشهایی است که ترسیم کردیم، بهعلاوه، وقتی صحبت از سنجش اندازهٔ مدل میشود، مقدار کمی شهود.
فراتر از کانولوشن: Vision Transformerها
Section titled “فراتر از کانولوشن: Vision Transformerها”در حالی که ConvNetها از اواسط دههٔ ۲۰۱۰ بر حوزهٔ بینایی ماشین تسلط داشتهاند، اخیراً با یک معماری جایگزین رقابت میکنند: Vision Transformerها (یا بهطور مختصر ViT). ممکن است ViTها در بلندمدت جایگزین ConvNetها شوند — اگرچه، در حال حاضر، ConvNetها در بیشتر موارد بهترین گزینهٔ شما باقی میمانند.
شما هنوز نمیدانید Transformerها چیستند زیرا در فصل ۱۵ آنها را پوشش خواهیم داد. بهطور خلاصه، معماری Transformer برای پردازش متن توسعه یافت — این معماری اساساً یک معماری پردازش دنباله است. و Transformerها در آن بسیار خوب هستند، که منجر به این سؤال شده است: آیا میتوانیم از آنها برای تصاویر نیز استفاده کنیم؟
از آنجا که ViTها نوعی Transformer هستند، آنها نیز دنبالهها را پردازش میکنند: یک تصویر را به یک دنبالهٔ یکبعدی از تکهها تقسیم میکنند، هر تکه را به یک بردار مسطح تبدیل میکنند و دنبالهٔ بردار را پردازش میکنند. معماری Transformer به ViTها اجازه میدهد روابط دوربرد بین بخشهای مختلف تصویر را ثبت کنند، چیزی که ConvNetها گاهی اوقات با آن دستوپنجه نرم میکنند.
تجربهٔ کلی ما با Transformerها این است که اگر با یک مجموعهدادهٔ عظیم کار میکنید انتخاب عالی هستند. آنها بهسادگی در استفاده از مقادیر زیادی داده بهتر هستند. با این حال، برای مجموعهدادههای کوچکتر، آنها به دو دلیل تمایل دارند زیربهینه باشند. اول، آنها پیشینی فضایی ConvNetها را ندارند — معماری دوبعدی مبتنی بر تکهٔ ConvNetها فرضیات بیشتری دربارهٔ ساختار محلی فضای بصری در بر میگیرد، که آنها را داده-کارآمدتر میکند. دوم، برای درخشش ViTها، آنها باید واقعاً بزرگ باشند. در نهایت برای هر چیزی کوچکتر از ImageNet دستوپاگیر میشوند.
نبرد برای برتری تشخیص تصویر هنوز تمام نشده است، اما ViTها بدون شک فصل جدید و هیجانانگیزی را باز کردهاند. احتمالاً در زمینهٔ مدلهای تصویری مولد در مقیاس بزرگ با این معماری کار خواهید کرد — موضوعی که در فصل ۱۷ پوشش میدهیم. با این حال، برای نیازهای طبقهبندی تصویر در مقیاس کوچک شما، ConvNetها بهترین گزینهٔ شما باقی میمانند.
این معرفی ما از بهترین روشهای اساسی معماری ConvNet را به پایان میرساند. با این اصول در دست، قادر خواهید بود مدلهای با عملکرد بالاتر را در طیف گستردهای از وظایف بینایی ماشین توسعه دهید. شما اکنون در مسیر تبدیل شدن به یک متخصص ماهر بینایی ماشین هستید. برای تعمیق بیشتر تخصص خود، یک موضوع مهم آخر وجود دارد که باید پوشش دهیم: تفسیر اینکه یک مدل چگونه به پیشبینیهایش میرسد.
- معماری یک مدل یادگیری عمیق فرضیات کلیدی دربارهٔ ماهیت مسئلهٔ پیشرو را کدگذاری میکند.
- فرمول ماژولاریتی-سلسلهمراتب-استفادهٔ مجدد زیربنای معماری تقریباً تمام سیستمهای پیچیده، از جمله مدلهای یادگیری عمیق است.
- الگوهای کلیدی معماری برای بینایی ماشین شامل اتصالات باقیمانده، نرمالسازی دستهای و کانولوشنهای جداشدنی عمقی هستند.
- Vision Transformerها یک جایگزین در حال ظهور برای ConvNetها در وظایف بینایی ماشین در مقیاس بزرگ هستند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
Kaiming He et al., “Deep Residual Learning for Image Recognition,” Conference on Computer Vision and Pattern Recognition (2015), https://arxiv.org/abs/1512.03385. ↩
-
Sergey Ioffe and Christian Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” Proceedings of the 32nd International Conference on Machine Learning (2015), https://arxiv.org/abs/1502.03167. ↩
-
François Chollet, “Xception: Deep Learning with Depthwise Separable Convolutions,” Conference on Computer Vision and Pattern Recognition (2017), https://arxiv.org/abs/1610.02357. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.