
فصل ۸: طبقهبندی تصویر
بینایی ماشین اولین داستان موفقیت بزرگ یادگیری عمیق بود. این حوزه منجر به ظهور اولیهٔ یادگیری عمیق بین سالهای ۲۰۱۱ و ۲۰۱۵ شد. نوعی از یادگیری عمیق به نام شبکههای عصبی کانولوشنی در آن زمان شروع به گرفتن نتایج بهطور قابل توجهی خوب در مسابقات طبقهبندی تصویر کرد، ابتدا با دن سیرسان که دو مسابقهٔ تخصصی را برد (مسابقهٔ تشخیص کاراکتر چینی ICDAR 2011 و مسابقهٔ تشخیص علائم ترافیک آلمانی IJCNN 2011) و سپس، بهطور قابل توجهتر، در پاییز ۲۰۱۲، با تیم هینتون که مسابقهٔ پرحاشیهٔ تشخیص بصری در مقیاس بزرگ ImageNet را برد. بسیاری از نتایج امیدوارکنندهٔ دیگر بهسرعت در سایر وظایف بینایی ماشین ظاهر شدند.
جالب است که این موفقیتهای اولیه برای جریان اصلی کردن یادگیری عمیق در آن زمان کافی نبود — چند سال طول کشید. جامعهٔ تحقیقاتی بینایی ماشین سالها در روشهای غیر از شبکههای عصبی سرمایهگذاری کرده بود و آماده نبود فقط به این دلیل که یک تازهوارد در محله است از آنها دست بکشد. در سالهای ۲۰۱۳ و ۲۰۱۴، یادگیری عمیق هنوز با تردید شدید بسیاری از محققان ارشد بینایی ماشین روبرو بود. تنها در سال ۲۰۱۶ بود که در نهایت غالب شد. یکی از نویسندگان به یاد میآورد که در فوریهٔ ۲۰۱۴ از یک استاد بازنشسته میخواست به یادگیری عمیق روی آورد. او میگفت: «این چیز بزرگ بعدی است!» استاد پاسخ میداد: «خب، شاید فقط یک مد باشد.» تا سال ۲۰۱۶، کل آزمایشگاه او در حال انجام یادگیری عمیق بود. هیچ چیز نمیتواند ایدهای را که زمانش فرا رسیده متوقف کند.
امروزه، شما دائماً با مدلهای بینایی مبتنی بر یادگیری عمیق تعامل دارید — از طریق Google Photos، جستجوی تصویر گوگل، دوربین گوشی خود، YouTube، نرمافزار OCR و بسیاری موارد دیگر. این مدلها همچنین در قلب تحقیقات پیشرو در رانندگی خودکار، رباتیک، تشخیص پزشکی به کمک هوش مصنوعی، سیستمهای پرداخت خودکار خردهفروشی و حتی کشاورزی خودکار قرار دارند.
این فصل شبکههای عصبی کانولوشنی، که بهعنوان ConvNet یا CNN نیز شناخته میشوند، را معرفی میکند — نوعی از مدل یادگیری عمیق که توسط بیشتر برنامههای بینایی ماشین استفاده میشود. شما یاد خواهید گرفت که ConvNetها را روی مسائل طبقهبندی تصویر اعمال کنید — بهویژه آنهایی که شامل مجموعهدادههای آموزشی کوچک هستند، که رایجترین مورد استفاده است اگر شما یک شرکت فناوری بزرگ نیستید.
معرفی ConvNetها
Section titled “معرفی ConvNetها”ما در شرف شیرجه زدن به نظریهٔ آنچه ConvNetها هستند و چرا در وظایف بینایی ماشین اینقدر موفق بودهاند هستیم. اما ابتدا، بیایید نگاهی عملی به یک مثال سادهٔ ConvNet بیندازیم. از یک ConvNet برای طبقهبندی ارقام MNIST استفاده میکند، وظیفهای که در فصل ۲ با استفاده از یک شبکهٔ متراکم متصل انجام دادیم (دقت آزمایش ما در آن زمان ۹۷.۸٪ بود). حتی اگر ConvNet پایه باشد، دقت آن بهطور قابل توجهی از مدل متراکم متصل فصل ۲ بهتر خواهد بود.
خطوط کد زیر به شما نشان میدهد یک ConvNet پایه چگونه به نظر میرسد. این یک پشته از لایههای Conv2D و MaxPooling2D است. در یک دقیقه دقیقاً خواهید دید آنها چه کاری انجام میدهند. ما مدل را با استفاده از Functional API میسازیم، که در فصل قبل معرفی کردیم.
لیستینگ ۸.۱: نمونهسازی یک ConvNet کوچک
import kerasfrom keras import layers
inputs = keras.Input(shape=(28, 28, 1))x = layers.Conv2D(filters=64, kernel_size=3, activation="relu")(inputs)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=128, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=256, kernel_size=3, activation="relu")(x)x = layers.GlobalAveragePooling2D()(x)outputs = layers.Dense(10, activation="softmax")(x)model = keras.Model(inputs=inputs, outputs=outputs)
مهم است که یک ConvNet تانسورهایی با شکل (image_height, image_width, image_channels) را بهعنوان ورودی میگیرد (بدون احتساب بُعد دسته). در این مورد، ConvNet را پیکربندی میکنیم تا ورودیهایی با اندازهٔ (28, 28, 1) را پردازش کند، که قالب تصاویر MNIST است.
بیایید معماری ConvNet خود را نمایش دهیم.
لیستینگ ۸.۲: نمایش خلاصهٔ مدل
>>> model.summary()میبینید که خروجی هر لایهٔ Conv2D و MaxPooling2D یک تانسور سهبعدی با شکل (height, width, channels) است. ابعاد عرض و ارتفاع تمایل دارند با عمیقتر شدن مدل کوچک شوند. تعداد کانالها توسط اولین آرگومان پاسدادهشده به لایههای Conv2D کنترل میشود (۶۴، ۱۲۸ یا ۲۵۶).
پس از آخرین لایهٔ Conv2D، به خروجیای با شکل (3, 3, 256) میرسیم — یک نقشهٔ ویژگی ۳×۳ با ۲۵۶ کانال. گام بعدی تغذیهٔ این خروجی به یک طبقهبند متراکم متصل مانند آنهایی است که قبلاً با آنها آشنا هستید: یک پشته از لایههای Dense. این طبقهبندها بردارها را پردازش میکنند، که یکبعدی هستند، در حالی که خروجی فعلی یک تانسور مرتبهٔ ۳ است. برای پر کردن شکاف، خروجیهای سهبعدی را با یک لایهٔ GlobalAveragePooling2D قبل از افزودن لایههای Dense به یکبعدی مسطح میکنیم. این لایه میانگین هر نقشهٔ ویژگی ۳×۳ در تانسور با شکل (3, 3, 256) را میگیرد و در نتیجه یک بردار خروجی با شکل (256,) به دست میآید. در نهایت، طبقهبندی ۱۰-way انجام میدهیم، بنابراین آخرین لایهٔ ما ۱۰ خروجی و یک فعالسازی softmax دارد.
حالا، بیایید ConvNet را روی ارقام MNIST آموزش دهیم. ما از بخش زیادی از کد مثال MNIST فصل ۲ دوباره استفاده خواهیم کرد. از آنجا که طبقهبندی ۱۰-way با خروجی softmax انجام میدهیم، از زیان categorical crossentropy استفاده خواهیم کرد و از آنجا که برچسبهای ما اعداد صحیح هستند، از نسخهٔ sparse آن، sparse_categorical_crossentropy استفاده خواهیم کرد.
لیستینگ ۸.۳: آموزش ConvNet روی تصاویر MNIST
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()train_images = train_images.reshape((60000, 28, 28, 1))train_images = train_images.astype("float32") / 255test_images = test_images.reshape((10000, 28, 28, 1))test_images = test_images.astype("float32") / 255model.compile(    optimizer="adam",    loss="sparse_categorical_crossentropy",    metrics=["accuracy"],)model.fit(train_images, train_labels, epochs=5, batch_size=64)
بیایید مدل را روی دادههای آزمایشی ارزیابی کنیم.
لیستینگ ۸.۴: ارزیابی ConvNet
>>> test_loss, test_acc = model.evaluate(test_images, test_labels)>>> print(f"Test accuracy: {test_acc:.3f}")در حالی که مدل متراکم متصل فصل ۲ دقت آزمایش ۹۷.۸٪ داشت، ConvNet پایه دقت آزمایش ۹۹.۱٪ دارد: نرخ خطا را حدود ۶۰٪ (نسبی) کاهش دادیم. بد نیست!
اما چرا این ConvNet ساده در مقایسه با یک مدل متراکم متصل اینقدر خوب کار میکند؟ برای پاسخ به این سؤال، بیایید به آنچه لایههای Conv2D و MaxPooling2D انجام میدهند بپردازیم.
عملیات کانولوشن
Section titled “عملیات کانولوشن”تفاوت بنیادین بین یک لایهٔ متراکم متصل و یک لایهٔ کانولوشن این است: لایههای Dense الگوهای جهانی در فضای ویژگی ورودی خود یاد میگیرند (برای مثال، برای یک رقم MNIST، الگوهای شامل تمام پیکسلها)، در حالی که لایههای کانولوشن الگوهای محلی را یاد میگیرند (شکل ۸.۱ را ببینید): در مورد تصاویر، الگوهای موجود در پنجرههای دوبعدی کوچک از ورودیها. در مثال قبلی، این پنجرهها همگی ۳×۳ بودند.
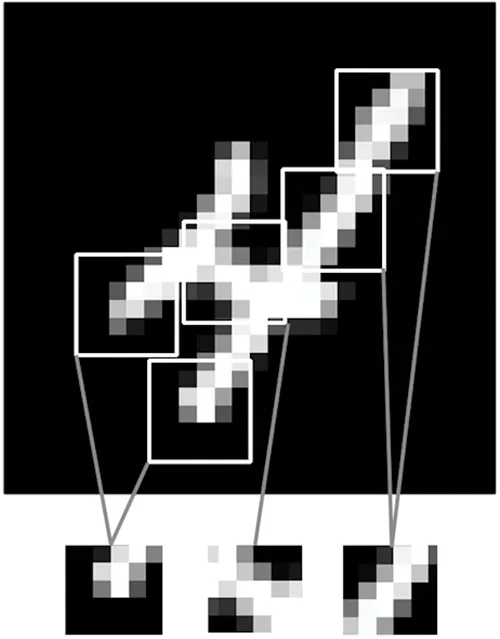
شکل ۸.۱: تصاویر میتوانند به الگوهای محلی مانند لبهها، بافتها و غیره تجزیه شوند.
این ویژگی کلیدی به ConvNetها دو ویژگی جالب میدهد:
- الگوهایی که یاد میگیرند نسبت به جابجایی ثابت هستند . پس از یادگیری یک الگوی خاص در گوشهٔ پایین سمت راست یک تصویر، یک ConvNet میتواند آن را در هر جایی تشخیص دهد: برای مثال، در گوشهٔ بالا سمت چپ. یک مدل متراکم متصل باید الگو را از نو یاد بگیرد اگر در مکان جدیدی ظاهر شود. این کار ConvNetها را در پردازش تصاویر داده-کارآمد میکند — زیرا جهان بصری اساساً نسبت به جابجایی ثابت است . آنها به نمونههای آموزشی کمتری برای یادگیری بازنماییهایی که قدرت تعمیم دارند نیاز دارند.
- میتوانند سلسلهمراتب فضایی الگوها را یاد بگیرند (شکل ۸.۲ را ببینید) . یک لایهٔ کانولوشن اول الگوهای محلی کوچک مانند لبهها را یاد میگیرد، یک لایهٔ کانولوشن دوم الگوهای بزرگتری ساختهشده از ویژگیهای لایههای اول را یاد میگیرد و به همین ترتیب. این به ConvNetها امکان میدهد بهطور کارآمد مفاهیم بصری بهطور فزاینده پیچیده و انتزاعی را یاد بگیرند — زیرا جهان بصری اساساً از نظر فضایی سلسلهمراتبی است .
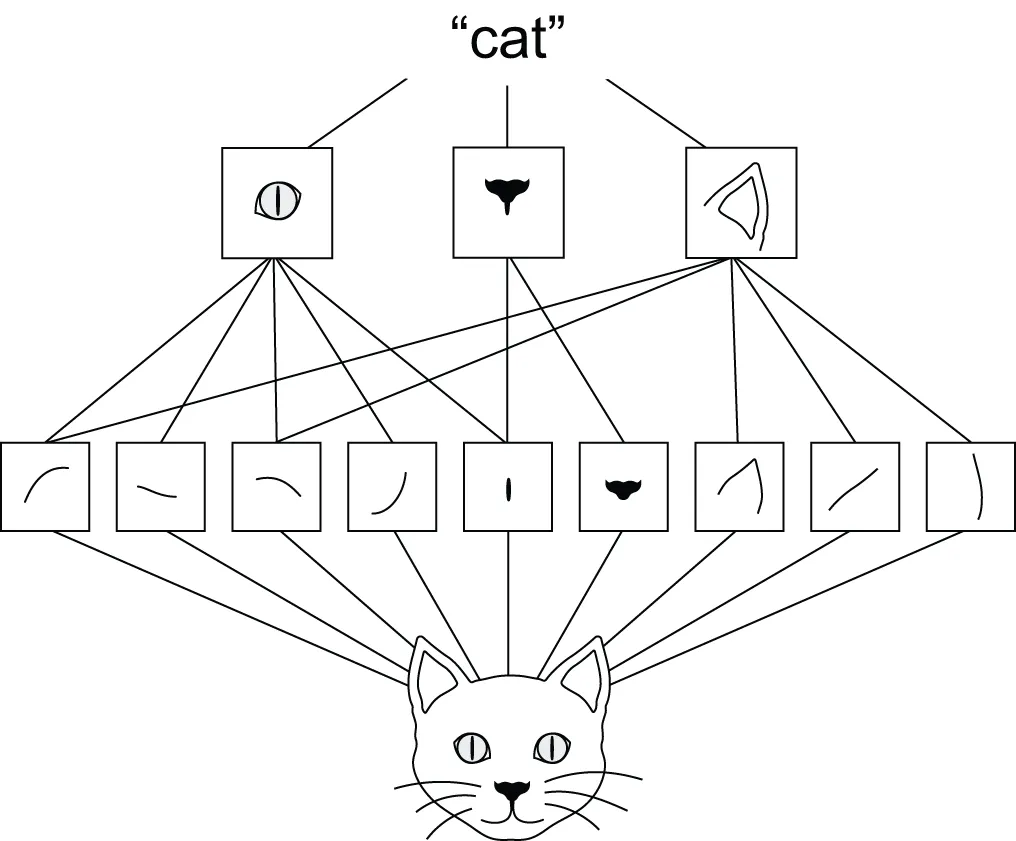
شکل ۸.۲: جهان بصری یک سلسلهمراتب فضایی از ماژولهای بصری را تشکیل میدهد: خطوط یا بافتهای ابتدایی به اشیاء ساده مانند چشمها یا گوشها ترکیب میشوند، که به مفاهیم سطح بالا مانند «گربه» ترکیب میشوند.
کانولوشنها روی تانسورهای مرتبهٔ ۳ عمل میکنند، که نقشههای ویژگی نامیده میشوند، با دو محور فضایی (ارتفاع و عرض) و همچنین یک محور عمق (که محور کانالها نیز نامیده میشود). برای یک تصویر RGB، بُعد محور عمق ۳ است، زیرا تصویر سه کانال رنگی دارد: قرمز، سبز و آبی. برای یک تصویر سیاه و سفید، مانند ارقام MNIST، عمق ۱ است (سطوح خاکستری). عملیات کانولوشن تکههایی از نقشهٔ ویژگی ورودی خود را استخراج میکند و همان تبدیل را روی تمام این تکهها اعمال میکند و یک نقشهٔ ویژگی خروجی تولید میکند. این نقشهٔ ویژگی خروجی هنوز یک تانسور مرتبهٔ ۳ است: عرض و ارتفاع دارد. عمق آن میتواند دلخواه باشد زیرا عمق خروجی یک پارامتر از لایه است، و کانالهای مختلف در آن محور عمق دیگر نمایندهٔ رنگهای خاص مانند ورودی RGB نیستند؛ بلکه نمایندهٔ فیلترها هستند. فیلترها جنبههای خاصی از دادههای ورودی را کدگذاری میکنند: در سطح بالا، یک فیلتر منفرد میتواند مفهوم «حضور یک چهره در ورودی» را کدگذاری کند، برای مثال.
در مثال MNIST، اولین لایهٔ کانولوشن یک نقشهٔ ویژگی با اندازهٔ (28, 28, 1) میگیرد و یک نقشهٔ ویژگی با اندازهٔ (26, 26, 64) خروجی میدهد: این لایه ۶۴ فیلتر روی ورودی خود محاسبه میکند. هر یک از این ۶۴ کانال خروجی شامل یک شبکهٔ ۲۶×۲۶ از مقادیر است، که یک نقشهٔ پاسخ از فیلتر روی ورودی است، که پاسخ آن الگوی فیلتر را در مکانهای مختلف در ورودی نشان میدهد (شکل ۸.۳ را ببینید). این همان چیزی است که اصطلاح نقشهٔ ویژگی به معنای آن است: هر بُعد در محور عمق یک ویژگی (یا فیلتر) است، و تانسور مرتبهٔ ۲ output[:, :, n] نقشهٔ فضایی دوبعدی پاسخ این فیلتر روی ورودی است.
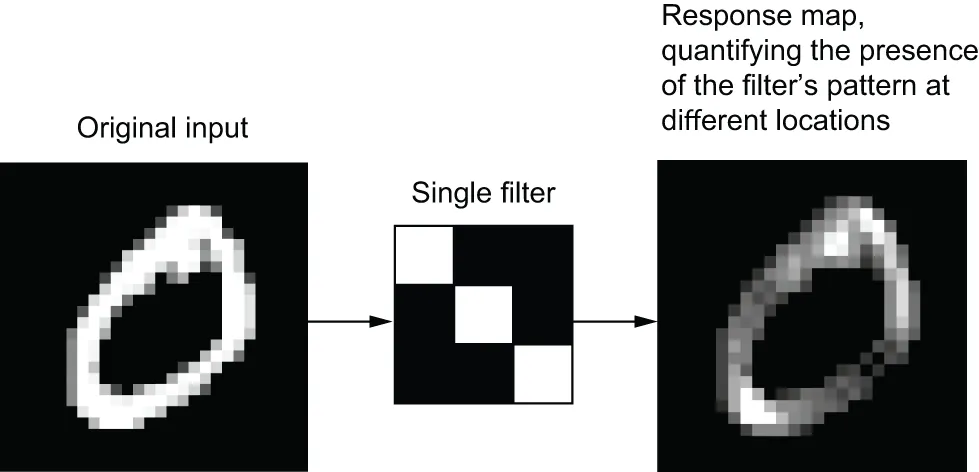
شکل ۸.۳: مفهوم نقشهٔ پاسخ: یک نقشهٔ دوبعدی از حضور یک الگو در مکانهای مختلف در یک ورودی
کانولوشنها توسط دو پارامتر کلیدی تعریف میشوند:
- اندازهٔ تکههای استخراجشده از ورودیها — اینها معمولاً ۳×۳ یا ۵×۵ هستند. در مثال، آنها ۳×۳ بودند، که یک انتخاب رایج است.
- عمق نقشهٔ ویژگی خروجی — تعداد فیلترهای محاسبهشده توسط کانولوشن. مثال با عمق ۳۲ شروع شد و با عمق ۶۴ پایان یافت.
در لایههای Conv2D Keras، این پارامترها اولین آرگومانهایی هستند که به لایه پاس داده میشوند: Conv2D(output_depth, (window_height, window_width)).
یک کانولوشن با لغزاندن این پنجرههای ۳×۳ یا ۵×۵ روی نقشهٔ ویژگی سهبعدی ورودی کار میکند، در هر مکان ممکن توقف میکند، و تکهٔ سهبعدی ویژگیهای اطراف با شکل (window_height, window_width, input_depth) را استخراج میکند. هر چنین تکهٔ سهبعدی سپس به یک بردار یکبعدی با شکل (output_depth,) تبدیل میشود، که از طریق یک ضرب تانسوری با یک ماتریس وزن یادگرفتهشده به نام هستهٔ کانولوشن انجام میشود — همان هسته در هر تکه دوباره استفاده میشود. همهٔ این بردارها (یکی برای هر تکه) سپس بهصورت فضایی در یک نقشهٔ خروجی سهبعدی با شکل (height, width, output_depth) دوباره مونتاژ میشوند. هر مکان فضایی در نقشهٔ ویژگی خروجی با همان مکان در نقشهٔ ویژگی ورودی مطابقت دارد (برای مثال، گوشهٔ پایین سمت راست خروجی شامل اطلاعاتی دربارهٔ گوشهٔ پایین سمت راست ورودی است). برای مثال، با پنجرههای ۳×۳، بردار output[i, j, :] از تکهٔ سهبعدی input[i-1:i+1, j-1:j+1, :] میآید. فرآیند کامل در شکل ۸.۴ به تفصیل آمده است.
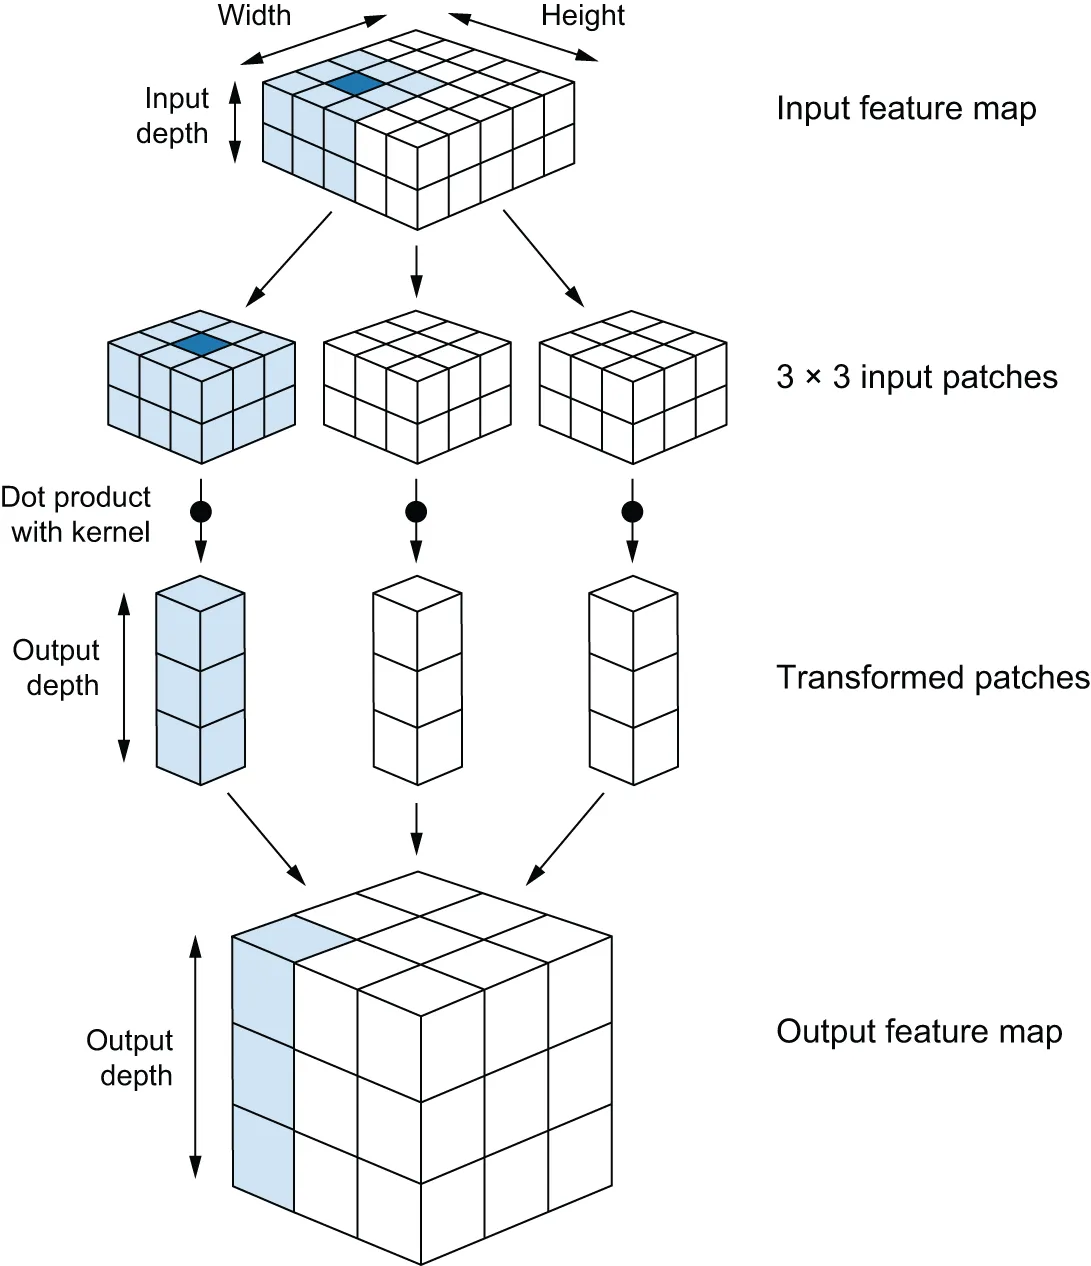
شکل ۸.۴: نحوهٔ کار کانولوشن
توجه داشته باشید که عرض و ارتفاع خروجی ممکن است با عرض و ارتفاع ورودی متفاوت باشند. آنها به دو دلیل ممکن است متفاوت باشند:
- اثرات مرزی، که میتوان با پر کردن نقشهٔ ویژگی ورودی با آنها مقابله کرد
- استفاده از گامها (strides) ، که در یک لحظه تعریف خواهیم کرد
بیایید نگاه دقیقتری به این مفاهیم بیندازیم.
درک اثرات مرزی و پر کردن
Section titled “درک اثرات مرزی و پر کردن”یک نقشهٔ ویژگی ۵×۵ را در نظر بگیرید (در مجموع ۲۵ کاشی). تنها ۹ کاشی وجود دارد که میتوانید یک پنجرهٔ ۳×۳ را حول آنها مرکز کنید و یک شبکهٔ ۳×۳ تشکیل دهید (شکل ۸.۵ را ببینید). از این رو، نقشهٔ ویژگی خروجی ۳×۳ خواهد بود. کمی کوچک میشود: دقیقاً دو کاشی در امتداد هر بُعد، در این مورد. میتوانید این اثر مرزی را در مثال قبلی در عمل ببینید: با ورودیهای ۲۸×۲۸ شروع میکنید، که پس از اولین لایهٔ کانولوشن به ۲۶×۲۶ تبدیل میشوند.
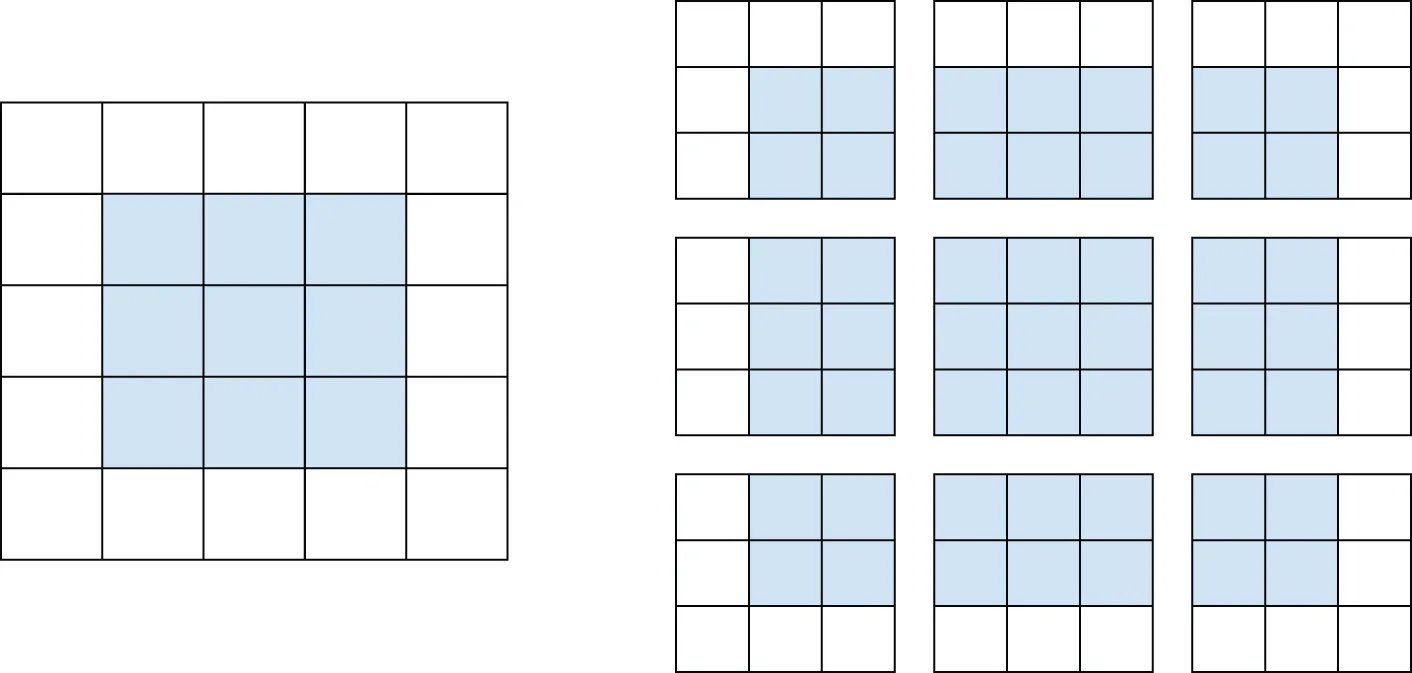
شکل ۸.۵: مکانهای معتبر تکههای ۳×۳ در یک نقشهٔ ویژگی ورودی ۵×۵
اگر میخواهید یک نقشهٔ ویژگی خروجی با همان ابعاد فضایی ورودی داشته باشید، میتوانید از پر کردن (padding) استفاده کنید. پر کردن شامل افزودن تعداد مناسبی از سطرها و ستونها در هر طرف نقشهٔ ویژگی ورودی است تا امکان جا دادن پنجرههای کانولوشن مرکز شده حول هر کاشی ورودی فراهم شود. برای یک پنجرهٔ ۳×۳، یک ستون در سمت راست، یک ستون در سمت چپ، یک سطر در بالا و یک سطر در پایین اضافه میکنید. برای یک پنجرهٔ ۵×۵، دو سطر اضافه میکنید (شکل ۸.۶ را ببینید).
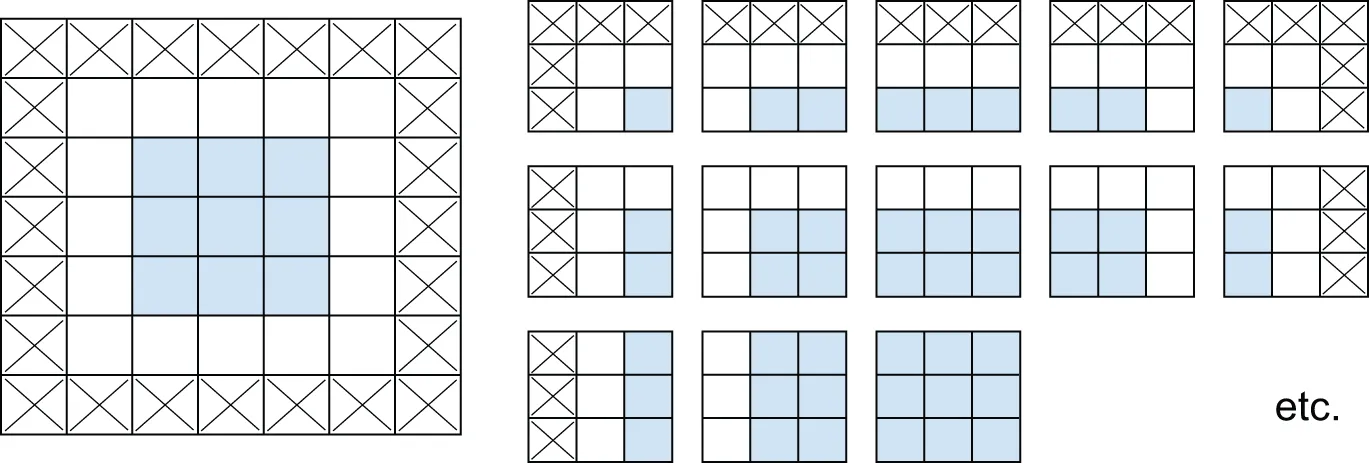
شکل ۸.۶: پر کردن یک ورودی ۵×۵ برای امکان استخراج ۲۵ تکهٔ ۳×۳
در لایههای Conv2D، پر کردن از طریق آرگومان padding قابل پیکربندی است، که دو مقدار میگیرد: "valid"، که به معنای بدون پر کردن است (فقط مکانهای معتبر پنجره استفاده میشوند)؛ و "same"، که به معنای «بهگونهای پر کن که خروجی با عرض و ارتفاع یکسان با ورودی داشته باشی» است. آرگومان padding بهطور پیشفرض "valid" است.
درک گامهای کانولوشن
Section titled “درک گامهای کانولوشن”عامل دیگری که میتواند بر اندازهٔ خروجی تأثیر بگذارد مفهوم گامها است. توصیف کانولوشن تا اینجا فرض کرده است که کاشیهای مرکزی پنجرههای کانولوشن همه به هم پیوسته هستند. اما فاصلهٔ بین دو پنجرهٔ متوالی یک پارامتر از کانولوشن است، که گام آن نامیده میشود و بهطور پیشفرض ۱ است. امکان داشتن کانولوشنهای گامدار وجود دارد: کانولوشنهایی با گام بیشتر از ۱. در شکل ۸.۷، تکههای استخراجشده توسط یک کانولوشن ۳×۳ با گام ۲ روی یک ورودی ۵×۵ (بدون پر کردن) را میبینید.
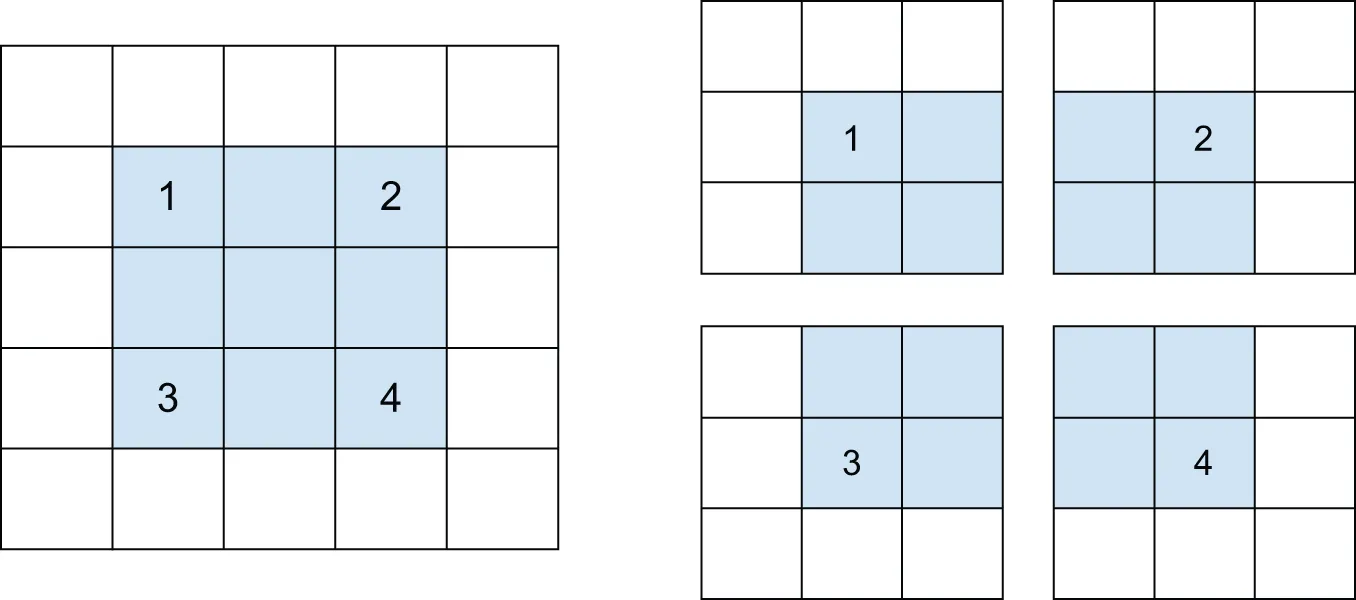
شکل ۸.۷: تکههای کانولوشن ۳×۳ با گامهای ۲×۲
استفاده از گام ۲ به این معناست که عرض و ارتفاع نقشهٔ ویژگی با ضریب ۲ کاهش مییابد (علاوه بر هر تغییری که توسط اثرات مرزی ایجاد میشود). کانولوشنهای گامدار بهندرت در مدلهای طبقهبندی استفاده میشوند، اما در برخی انواع مدلها مفید هستند، همانطور که در فصل بعد خواهید دید.
در مدلهای طبقهبندی، بهجای گامها، ما تمایل داریم از عملیات max-pooling برای کاهش نقشههای ویژگی استفاده کنیم — که در اولین مثال ConvNet ما در عمل دیدید. بیایید نگاه عمیقتری به آن بیندازیم.
عملیات max-pooling
Section titled “عملیات max-pooling”در مثال ConvNet، ممکن است متوجه شده باشید که اندازهٔ نقشههای ویژگی پس از هر لایهٔ MaxPooling2D نصف میشود. برای مثال، قبل از اولین لایهٔ MaxPooling2D، نقشهٔ ویژگی ۲۶×۲۶ است، اما عملیات max-pooling آن را به ۱۳×۱۳ نصف میکند. این نقش max pooling است: کاهش تهاجمی نقشههای ویژگی، بسیار شبیه به کانولوشنهای گامدار.
Max pooling شامل استخراج پنجرههایی از نقشههای ویژگی ورودی و خروجی حداکثر مقدار هر کانال است. این از نظر مفهومی مشابه کانولوشن است، با این تفاوت که بهجای تبدیل تکههای محلی از طریق یک تبدیل خطی یادگرفتهشده (هستهٔ کانولوشن)، آنها از طریق یک عملیات تانسوری max سختکدشده تبدیل میشوند. یک تفاوت بزرگ با کانولوشن این است که max pooling معمولاً با پنجرههای ۲×۲ و گام ۲ انجام میشود تا نقشههای ویژگی را با ضریب ۲ کاهش دهد. از سوی دیگر، کانولوشن معمولاً با پنجرههای ۳×۳ و بدون گام (گام ۱) انجام میشود.
چرا نقشههای ویژگی را اینگونه کاهش میدهیم؟ چرا لایههای max-pooling را حذف نکنیم و نقشههای ویژگی نسبتاً بزرگ را تا بالا نگه نداریم؟ بیایید این گزینه را بررسی کنیم. مدل ما سپس شبیه این خواهد بود.
لیستینگ ۸.۵: یک ConvNet با ساختار نادرست که لایههای max-pooling خود را ندارد
inputs = keras.Input(shape=(28, 28, 1))x = layers.Conv2D(filters=64, kernel_size=3, activation="relu")(inputs)x = layers.Conv2D(filters=128, kernel_size=3, activation="relu")(x)x = layers.Conv2D(filters=256, kernel_size=3, activation="relu")(x)x = layers.GlobalAveragePooling2D()(x)outputs = layers.Dense(10, activation="softmax")(x)model_no_max_pool = keras.Model(inputs=inputs, outputs=outputs)در اینجا خلاصهٔ مدل آمده است:
>>> model_no_max_pool.summary()چه چیزی در این تنظیم اشتباه است؟ دو چیز:
- این تنظیم به یادگیری یک سلسلهمراتب فضایی از ویژگیها کمک نمیکند. پنجرههای ۳×۳ در لایهٔ سوم فقط حاوی اطلاعاتی از پنجرههای ۷×۷ در ورودی اولیه خواهند بود. الگوهای سطح بالای یادگرفتهشده توسط ConvNet هنوز نسبت به ورودی اولیه بسیار کوچک خواهند بود، که ممکن است برای یادگیری طبقهبندی ارقام کافی نباشد (سعی کنید یک رقم را فقط با نگاه کردن به آن از طریق پنجرههای ۷×۷ پیکسلی تشخیص دهید!). ما نیاز داریم که ویژگیهای آخرین لایهٔ کانولوشن حاوی اطلاعاتی دربارهٔ کل ورودی باشند.
- نقشهٔ ویژگی نهایی ابعاد ۲۲×۲۲ دارد. این بسیار بزرگ است — وقتی میانگین هر نقشهٔ ویژگی ۲۲×۲۲ را میگیرید، در مقایسه با زمانی که نقشههای ویژگی شما فقط ۳×۳ بودند، مقدار زیادی اطلاعات را از بین میبرید.
بهطور خلاصه، دلیل استفاده از کاهش نمونهبرداری کاهش اندازهٔ نقشههای ویژگی است، و اطلاعات موجود در آنها را بهطور فزاینده کمتر از نظر فضایی توزیعشده و بهطور فزاینده در کانالها متمرکز میکند، در حالی که همچنین سلسلهمراتب فیلترهای فضایی را با واداشتن لایههای کانولوشن متوالی به «نگاه کردن» به پنجرههای بهطور فزاینده بزرگ (از نظر کسری از تصویر ورودی اصلی که پوشش میدهند) ایجاد میکند.
توجه داشته باشید که max pooling تنها راه برای دستیابی به چنین کاهش نمونهبرداری نیست. همانطور که قبلاً میدانید، میتوانید از گامها در لایهٔ کانولوشن قبلی نیز استفاده کنید. و میتوانید از average pooling بهجای max pooling استفاده کنید، که در آن هر تکهٔ ورودی محلی با گرفتن مقدار میانگین هر کانال روی تکه تبدیل میشود، نه حداکثر. اما max pooling تمایل دارد بهتر از این راهحلهای جایگزین کار کند. بهطور خلاصه، دلیل این است که ویژگیها تمایل دارند حضور فضایی یک الگو یا مفهوم را روی کاشیهای مختلف نقشهٔ ویژگی کدگذاری کنند (از این رو اصطلاح نقشهٔ ویژگی)، و آموزندهتر است که به حداکثر حضور ویژگیهای مختلف نگاه کنیم تا به حضور میانگین آنها. بنابراین منطقیترین استراتژی زیرنمونهبرداری این است که ابتدا نقشههای چگال ویژگی تولید کنیم (از طریق کانولوشنهای بدون گام) و سپس به حداکثر فعالسازی ویژگیها روی تکههای کوچک نگاه کنیم، نه نگاه کردن به پنجرههای پراکندهتر ورودیها (از طریق کانولوشنهای گامدار) یا میانگینگیری تکههای ورودی، که میتواند باعث شود اطلاعات حضور ویژگی را از دست بدهید یا رقیق کنید.
در این مرحله، باید مبانی ConvNetها را درک کنید — نقشههای ویژگی، کانولوشن و max pooling — و میدانید چگونه یک ConvNet کوچک برای حل یک مسئلهٔ اسباببازی مانند طبقهبندی ارقام MNIST بسازید. حالا بیایید به سراغ کاربردهای مفیدتر و عملیتر برویم.
آموزش یک ConvNet از صفر روی یک مجموعهدادهٔ کوچک
Section titled “آموزش یک ConvNet از صفر روی یک مجموعهدادهٔ کوچک”داشتن آموزش یک مدل طبقهبندی تصویر با استفاده از دادهٔ بسیار کم یک وضعیت رایج است که احتمالاً در عمل با آن روبرو خواهید شد اگر تاکنون بینایی ماشین را در یک زمینهٔ حرفهای انجام داده باشید. «چند» نمونه میتواند از چند صد تا چند ده هزار تصویر باشد. بهعنوان یک مثال عملی، ما روی طبقهبندی تصاویر بهعنوان سگ یا گربه تمرکز خواهیم کرد. ما با یک مجموعهدادهٔ شامل ۵,۰۰۰ عکس سگ و گربه (۲,۵۰۰ گربه، ۲,۵۰۰ سگ) که از مجموعهدادهٔ اصلی Kaggle گرفته شده است کار خواهیم کرد. ما از ۲,۰۰۰ عکس برای آموزش، ۱,۰۰۰ برای اعتبارسنجی و ۲,۰۰۰ برای آزمایش استفاده خواهیم کرد.
در این بخش، یک استراتژی اساسی برای رویکرد به این مسئله را مرور خواهیم کرد: آموزش یک مدل جدید از صفر با استفاده از همان دادهٔ کمی که داریم. ما با آموزش سادهٔ یک ConvNet کوچک روی ۲,۰۰۰ نمونهٔ آموزشی، بدون هیچ تنظیمی، برای تعیین یک خط پایه برای آنچه میتوان به دست آورد شروع میکنیم. این ما را به دقت طبقهبندی حدود ۸۰٪ میرساند. در آن مرحله، مسئلهٔ اصلی بیشبرازش خواهد بود. سپس افزونگی داده را معرفی میکنیم، یک تکنیک قدرتمند برای کاهش بیشبرازش در بینایی ماشین. با استفاده از افزونگی داده، مدل را بهبود میبخشیم تا به دقت آزمایش حدود ۸۴٪ برسیم.
در بخش بعدی، دو تکنیک اساسی دیگر برای اعمال یادگیری عمیق روی مجموعهدادههای کوچک را مرور خواهیم کرد: استخراج ویژگی با یک مدل از پیش آموزشدیده و تنظیم دقیق یک مدل از پیش آموزشدیده (که ما را به دقت نهایی ۹۸.۵٪ میرساند). با هم، این سه استراتژی — آموزش یک مدل کوچک از صفر، استخراج ویژگی با استفاده از یک مدل از پیش آموزشدیده، و تنظیم دقیق یک مدل از پیش آموزشدیده — جعبهابزار آیندهٔ شما برای رویکرد به مسئلهٔ طبقهبندی تصویر با مجموعهدادههای کوچک را تشکیل میدهند.
ارتباط یادگیری عمیق برای مسائل دادهٔ کوچک
Section titled “ارتباط یادگیری عمیق برای مسائل دادهٔ کوچک”آنچه بهعنوان «نمونههای کافی» برای آموزش یک مدل واجد شرایط است نسبی است — نسبت به اندازه و عمق مدلی که سعی در آموزش آن دارید، برای شروع. امکان آموزش یک ConvNet برای حل یک مسئلهٔ پیچیده با فقط چند ده نمونه وجود ندارد، اما چند صد نمونه میتواند بهطور بالقوه کافی باشد اگر مدل کوچک و بهخوبی تنظیم شده و وظیفه ساده باشد. از آنجا که ConvNetها ویژگیهای محلی و ثابت نسبت به جابجایی را یاد میگیرند، آنها در مسائل ادراکی بسیار داده-کارآمد هستند. آموزش یک ConvNet از صفر روی یک مجموعهدادهٔ تصویری بسیار کوچک همچنان نتایج معقولی به همراه خواهد داشت بهرغم کمبود نسبی داده، بدون نیاز به هیچ مهندسی ویژگی سفارشی. این را در این بخش در عمل خواهید دید.
علاوه بر این، مدلهای یادگیری عمیق ذاتاً بهشدت قابل استفادهٔ مجدد هستند: میتوانید برای مثال یک مدل طبقهبندی تصویر یا گفتار به متن آموزشدیده روی یک مجموعهدادهٔ بزرگ را بگیرید و با تغییرات جزئی روی یک مسئلهٔ کاملاً متفاوت دوباره استفاده کنید. بهطور خاص، در مورد بینایی ماشین، بسیاری از مدلهای طبقهبندی از پیش آموزشدیده بهصورت عمومی برای دانلود در دسترس هستند و میتوانند برای راهاندازی مدلهای بینایی قدرتمند از دادهٔ بسیار کم استفاده شوند. این یکی از بزرگترین نقاط قوت یادگیری عمیق است: استفادهٔ مجدد از ویژگی. این را در بخش بعدی بررسی خواهید کرد.
بیایید با به دست آوردن دادهها شروع کنیم.
دانلود دادهها
Section titled “دانلود دادهها”مجموعهدادهٔ Dogs vs. Cats که استفاده خواهیم کرد همراه Keras بستهبندی نشده است. این مجموعه توسط Kaggle بهعنوان بخشی از یک مسابقهٔ بینایی ماشین در اواخر سال ۲۰۱۳ در دسترس قرار گرفت، زمانی که ConvNetها جریان اصلی نبودند. میتوانید مجموعهدادهٔ اصلی را از www.kaggle.com/c/dogs-vs-cats/data دانلود کنید (اگر از قبل حساب Kaggle ندارید باید ایجاد کنید — نگران نباشید، فرآیند بدون درد است). همچنین میتوانید از API Kaggle برای دانلود مجموعهداده در Colab استفاده کنید.
تصاویر موجود در مجموعهدادهٔ ما JPEGهای رنگی با وضوح متوسط هستند. شکل ۸.۸ چند نمونه را نشان میدهد.
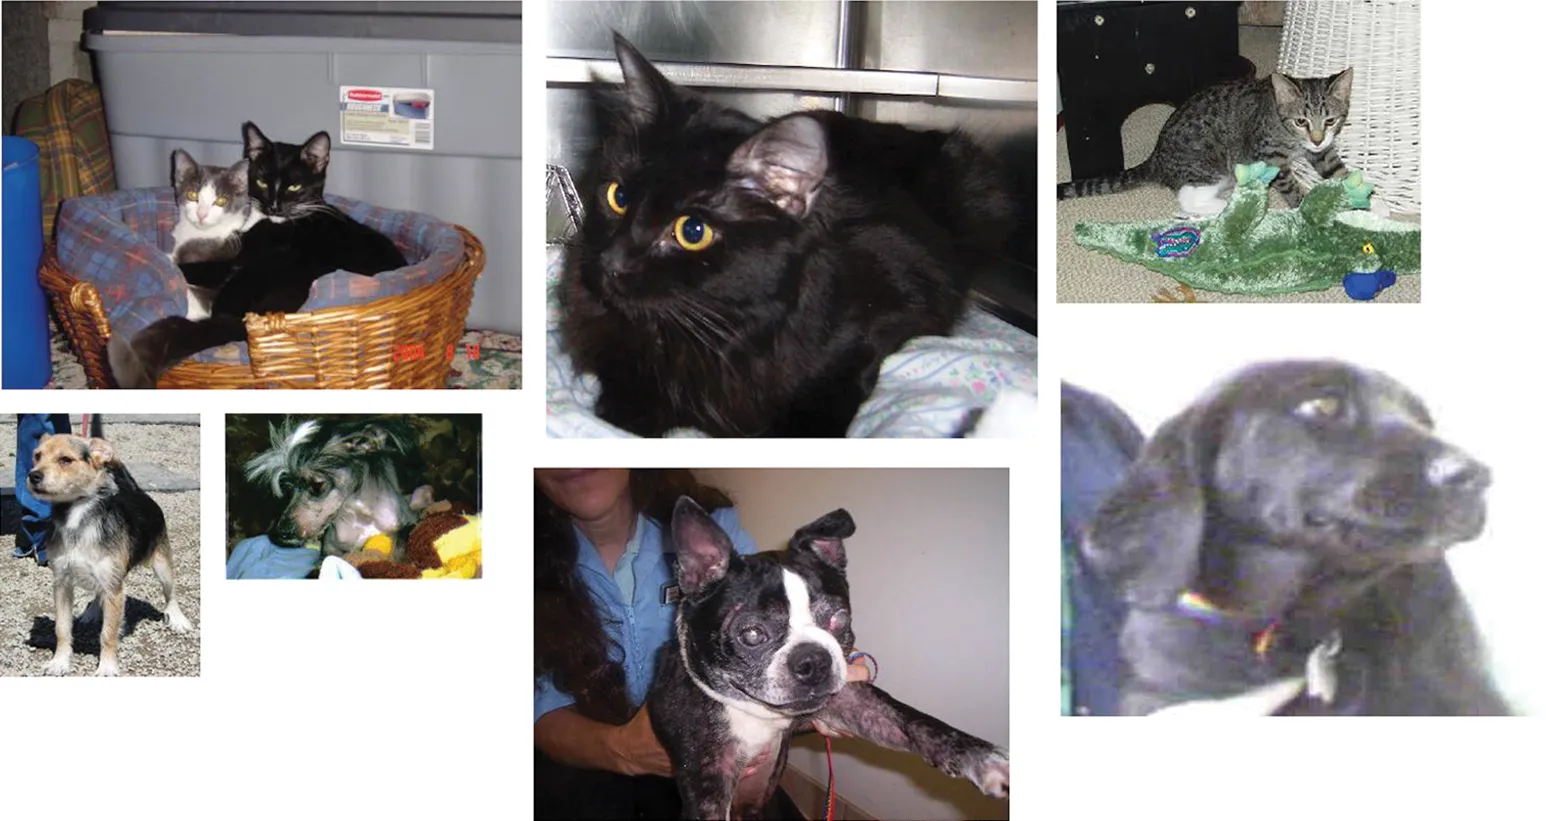
شکل ۸.۸: نمونههایی از مجموعهدادهٔ Dogs vs. Cats. اندازهها تغییر نکردهاند: نمونهها در اندازهها، رنگها، پسزمینهها و غیره متفاوت هستند.
جای تعجب نیست که مسابقهٔ اصلی Dogs vs. Cats Kaggle، در سال ۲۰۱۳، توسط شرکتکنندگانی که از ConvNetها استفاده کردند برنده شد. بهترین ورودیها به دقت ۹۵٪ رسیدند. در این مثال، ما بهطور نسبتاً نزدیک به این دقت خواهیم رسید (در بخش بعدی)، حتی اگر مدلهای خود را روی کمتر از ۱۰٪ دادههایی که در دسترس شرکتکنندگان بود آموزش دهیم.
این مجموعهداده شامل ۲۵,۰۰۰ تصویر سگ و گربه (۱۲,۵۰۰ از هر کلاس) است و ۵۴۳ مگابایت (فشرده) است. پس از دانلود و از حالت فشرده خارج کردن داده، یک مجموعهدادهٔ جدید شامل سه زیرمجموعه ایجاد میکنیم: یک مجموعهٔ آموزشی با ۱,۰۰۰ نمونه از هر کلاس، یک مجموعهٔ اعتبارسنجی با ۵۰۰ نمونه از هر کلاس و یک مجموعهٔ آزمایشی با ۱,۰۰۰ نمونه از هر کلاس. چرا این کار را بکنیم؟ زیرا بسیاری از مجموعهدادههای تصویری که در حرفهٔ خود با آنها روبرو خواهید شد فقط چند هزار نمونه دارند، نه دهها هزار. داشتن دادهٔ بیشتر در دسترس مسئله را آسانتر میکند — بنابراین تمرین خوبی است که با یک مجموعهدادهٔ کوچک یاد بگیرید.
مجموعهدادهٔ زیرنمونهبرداریشدهای که با آن کار خواهیم کرد ساختار دایرکتوری زیر را خواهد داشت:
dogs_vs_cats_small/...train/# Contains 1,000 cat images......cat/# Contains 1,000 dog images......dog/...validation/# Contains 500 cat images......cat/# Contains 500 dog images......dog/...test/# Contains 1,000 cat images......cat/# Contains 1,000 dog images......dog/بیایید این کار را در چند فراخوانی shutil، یک کتابخانهٔ پایتون برای اجرای دستورات شبیه شل، انجام دهیم.
لیستینگ ۸.۶: کپی کردن تصاویر به دایرکتوریهای آموزش، اعتبارسنجی و آزمایش
import os, shutil, pathlib
# Path to the directory where the original dataset was uncompressedoriginal_dir = pathlib.Path("train")# Directory where we will store our smaller datasetnew_base_dir = pathlib.Path("dogs_vs_cats_small")
# Utility function to copy cat (respectively, dog) images from index# `start_index` to index `end_index` to the subdirectory# `new_base_dir/{subset_name}/cat` (respectively, dog). "subset_name"# will be either "train," "validation," or "test."def make_subset(subset_name, start_index, end_index):    for category in ("cat", "dog"):        dir = new_base_dir / subset_name / category        os.makedirs(dir)        fnames = [f"{category}.{i}.jpg" for i in range(start_index, end_index)]        for fname in fnames:            shutil.copyfile(src=original_dir / fname, dst=dir / fname)
# Creates the training subset with the first 1,000 images of each# categorymake_subset("train", start_index=0, end_index=1000)# Creates the validation subset with the next 500 images of each# categorymake_subset("validation", start_index=1000, end_index=1500)# Creates the test subset with the next 1,000 images of each categorymake_subset("test", start_index=1500, end_index=2500)
اکنون ۲,۰۰۰ تصویر آموزشی، ۱,۰۰۰ تصویر اعتبارسنجی و ۲,۰۰۰ تصویر آزمایشی داریم. هر تقسیم شامل تعداد یکسانی نمونه از هر کلاس است: این یک مسئلهٔ طبقهبندی دودویی متعادل است، که به این معنی است که دقت طبقهبندی معیار مناسبی برای موفقیت خواهد بود.
ساختن مدل شما
Section titled “ساختن مدل شما”ما از همان ساختار کلی مدل که در مثال اول دیدید دوباره استفاده خواهیم کرد: ConvNet یک پشته از لایههای Conv2D (با فعالسازی relu) و MaxPooling2D متناوب خواهد بود.
اما از آنجا که با تصاویر بزرگتر و یک مسئلهٔ پیچیدهتر سر و کار داریم، مدل خود را به همان نسبت بزرگتر خواهیم کرد: دو مرحلهٔ Conv2D + MaxPooling2D دیگر خواهد داشت. این هم برای افزایش ظرفیت مدل و هم برای کاهش بیشتر اندازهٔ نقشههای ویژگی کار میکند تا وقتی به لایهٔ pooling میرسیم بیشازحد بزرگ نباشند. در اینجا، از آنجا که از ورودیهای ۱۸۰×۱۸۰ پیکسلی شروع میکنیم (یک انتخاب نسبتاً دلخواه)، با نقشههای ویژگی ۷×۷ درست قبل از لایهٔ GlobalAveragePooling2D پایان مییابیم.
از آنجا که ما با یک مسئلهٔ طبقهبندی دودویی روبرو هستیم، مدل را با یک واحد منفرد (یک لایهٔ Dense با اندازهٔ ۱) و یک فعالسازی sigmoid پایان خواهیم داد. این واحد احتمال اینکه مدل به یکی از کلاسها نگاه میکند را کدگذاری میکند، نه دیگری.
یک تفاوت کوچک آخر: مدل را با یک لایهٔ Rescaling شروع خواهیم کرد، که ورودیهای تصویری (که مقادیر آنها در اصل در محدودهٔ [۰, ۲۵۵] است) را به محدودهٔ [۰, ۱] مقیاسبندی میکند.
لیستینگ ۸.۷: نمونهسازی یک ConvNet کوچک برای طبقهبندی سگ در برابر گربه
import kerasfrom keras import layers
# The model expects RGB images of size 180 x 180.inputs = keras.Input(shape=(180, 180, 3))# Rescales inputs to the [0, 1] range by dividing them by 255x = layers.Rescaling(1.0 / 255)(inputs)x = layers.Conv2D(filters=32, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=64, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=128, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=256, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=512, kernel_size=3, activation="relu")(x)# Flattens the 3D activations with shape (height, width, 512) into 1D# activations with shape (512,) by averaging them over spatial# dimensionsx = layers.GlobalAveragePooling2D()(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs=inputs, outputs=outputs)
بیایید ببینیم ابعاد نقشههای ویژگی با هر لایهٔ متوالی چگونه تغییر میکنند:
>>> model.summary()برای مرحلهٔ کامپایل، مثل همیشه با بهینهساز adam پیش خواهید رفت. از آنجا که مدل را با یک واحد sigmoid منفرد پایان دادید، از binary crossentropy بهعنوان زیان استفاده خواهید کرد (بهعنوان یادآوری، جدول ۶.۱ در فصل ۶ را برای یک برگهٔ تقلب دربارهٔ اینکه در موقعیتهای مختلف از چه تابع زیانی استفاده کنید ببینید).
لیستینگ ۸.۸: پیکربندی مدل برای آموزش
model.compile( loss="binary_crossentropy", optimizer="adam", metrics=["accuracy"],)پیشپردازش داده
Section titled “پیشپردازش داده”همانطور که تا اینجا میدانید، دادهها باید قبل از تغذیه به مدل به تانسورهای ممیز شناور بهدرستی پیشپردازششده تبدیل شوند. در حال حاضر، دادهها روی یک درایو بهصورت فایلهای JPEG قرار دارند، بنابراین مراحل آوردن آنها به مدل تقریباً به شرح زیر است:
- خواندن فایلهای تصویری.
- رمزگشایی محتوای JPEG به شبکههای RGB پیکسلی.
- تبدیل اینها به تانسورهای ممیز شناور.
- تغییر اندازهٔ آنها به یک اندازهٔ مشترک (ما از ۱۸۰×۱۸۰ استفاده خواهیم کرد).
- بستهبندی آنها در دستهها (ما از دستههای ۳۲ تصویری استفاده خواهیم کرد).
این ممکن است کمی دلهرهآور به نظر برسد، اما خوشبختانه Keras ابزارهایی برای مدیریت خودکار این مراحل دارد. بهطور خاص، Keras دارای تابع ابزار image_dataset_from_directory است که به شما امکان میدهد بهسرعت یک خط لولهٔ داده راهاندازی کنید که میتواند بهطور خودکار فایلهای تصویری روی دیسک را به دستههایی از تانسورهای پیشپردازششده تبدیل کند. این همان چیزی است که در اینجا استفاده خواهید کرد.
فراخوانی image_dataset_from_directory(directory) ابتدا زیردایرکتوریهای directory را لیست میکند و فرض میکند هر کدام حاوی تصاویری از یکی از کلاسهای شما هستند. سپس فایلهای تصویری را در هر زیردایرکتوری فهرست میکند. در نهایت، یک شیء tf.data.Dataset ایجاد و برمیگرداند که برای خواندن این فایلها، بههمریختن آنها، رمزگشایی آنها به تانسورها، تغییر اندازهٔ آنها به یک اندازهٔ مشترک و بستهبندی آنها در دستهها پیکربندی شده است.
لیستینگ ۸.۹: استفاده از image_dataset_from_directory برای خواندن تصاویر از دایرکتوریها
from keras.utils import image_dataset_from_directory
batch_size = 64image_size = (180, 180)train_dataset = image_dataset_from_directory(    new_base_dir / "train", image_size=image_size, batch_size=batch_size)validation_dataset = image_dataset_from_directory(    new_base_dir / "validation", image_size=image_size, batch_size=batch_size)test_dataset = image_dataset_from_directory(    new_base_dir / "test", image_size=image_size, batch_size=batch_size)
درک اشیاء Dataset در TensorFlow
Section titled “درک اشیاء Dataset در TensorFlow”TensorFlow API tf.data را برای ایجاد خطوط لولهٔ ورودی کارآمد برای مدلهای یادگیری ماشین در دسترس قرار میدهد. کلاس اصلی آن tf.data.Dataset است.
کلاس Dataset میتواند برای بارگذاری و پیشپردازش داده در هر چارچوبی — نه فقط TensorFlow — استفاده شود. میتوانید آن را همراه با JAX یا PyTorch استفاده کنید. وقتی آن را با یک مدل Keras استفاده میکنید، مستقل از بکاندی که در حال حاضر استفاده میکنید، یکسان کار میکند.
یک شیء Dataset یک تکرارکننده است: میتوانید آن را در یک حلقهٔ for استفاده کنید. این معمولاً دستههایی از دادههای ورودی و برچسبها را برمیگرداند. میتوانید یک شیء Dataset را مستقیماً به متد fit() یک مدل Keras پاس دهید.
کلاس Dataset بسیاری از ویژگیهای کلیدی را که در غیر این صورت پیادهسازی آنها دستوپاگیر بود مدیریت میکند، بهویژه موازیسازی منطق پیشپردازش در چندین هستهٔ CPU و همچنین واکشی ناهمگام داده (پیشپردازش دستهٔ بعدی داده در حالی که دستهٔ قبلی توسط مدل پردازش میشود، که اجرا را بدون وقفه نگه میدارد).
کلاس Dataset همچنین یک API کارکردی برای تغییر مجموعهدادهها در معرض دید قرار میدهد. در اینجا یک مثال سریع آمده است: بیایید یک نمونهٔ Dataset از یک آرایهٔ NumPy از اعداد تصادفی ایجاد کنیم. ما ۱,۰۰۰ نمونه را در نظر میگیریم که هر نمونه یک بردار با اندازهٔ ۱۶ است.
لیستینگ ۸.۱۰: نمونهسازی یک Dataset از یک آرایهٔ NumPy
import numpy as npimport tensorflow as tf
random_numbers = np.random.normal(size=(1000, 16))# The from_tensor_slices() class method can be used to create a Dataset# from a NumPy array or a tuple or dict of NumPy arrays.dataset = tf.data.Dataset.from_tensor_slices(random_numbers)
در ابتدا، مجموعهدادهٔ ما فقط نمونههای منفرد تولید میکند.
لیستینگ ۸.۱۱: تکرار روی یک مجموعهداده
>>> for i, element in enumerate(dataset):>>> print(element.shape)>>> if i >= 2:>>> breakمیتوانید از متد .batch() برای دستهبندی دادهها (batching) استفاده کنید.
لیستینگ ۸.۱۲: دستهبندی (batching) یک مجموعهداده
>>> batched_dataset = dataset.batch(32)>>> for i, element in enumerate(batched_dataset):>>> print(element.shape)>>> if i >= 2:>>> breakبهطور کلیتر، به مجموعهای از متدهای مفید مجموعهداده دسترسی دارید، مانند اینها:
.shuffle(buffer_size)عناصر را درون یک بافر بههم میریزد..prefetch(buffer_size)یک بافر از عناصر را در حافظهٔ GPU واکشی میکند تا استفادهٔ بهتر از دستگاه به دست آید..map(callable)یک تبدیل دلخواه را روی هر عنصر مجموعهداده اعمال میکند (تابعcallable، که انتظار میرود بهعنوان ورودی یک عنصر منفرد تولیدشده توسط مجموعهداده را بگیرد).
متد .map(function, num_parallel_calls) بهطور خاص یکی است که اغلب استفاده خواهید کرد. در اینجا یک مثال آمده است: بیایید از آن برای تغییر شکل عناصر در مجموعهدادهٔ اسباببازی خود از شکل (16,) به شکل (4, 4) استفاده کنیم.
لیستینگ ۸.۱۳: اعمال یک تبدیل به عناصر Dataset با استفاده از map()
>>> reshaped_dataset = dataset.map(... lambda x: tf.reshape(x, (4, 4)),... num_parallel_calls=8)>>> for i, element in enumerate(reshaped_dataset):... print(element.shape)... if i >= 2:... breakدر فصلهای آینده عملکردهای بیشتری از map() را خواهید دید.
برازش مدل
Section titled “برازش مدل”بیایید به خروجی یکی از این اشیاء Dataset نگاه کنیم: دستههایی از تصاویر RGB ۱۸۰×۱۸۰ (شکل (32, 180, 180, 3)) و برچسبهای عدد صحیح (شکل (32,)) تولید میکند. در هر دسته ۳۲ نمونه وجود دارد (اندازهٔ دسته).
لیستینگ ۸.۱۴: نمایش شکلهای تولیدشده توسط Dataset
>>> for data_batch, labels_batch in train_dataset:>>> print("data batch shape:", data_batch.shape)>>> print("labels batch shape:", labels_batch.shape)>>> breakبیایید مدل را روی مجموعهدادهٔ خود برازش دهیم. از آرگومان validation_data در fit() برای نظارت بر معیارهای اعتبارسنجی روی یک شیء Dataset جداگانه استفاده میکنیم.
توجه داشته باشید که ما همچنین از یک callback ModelCheckpoint برای ذخیرهٔ مدل پس از هر دوره استفاده میکنیم. آن را با مسیر ذخیرهٔ فایل و همچنین آرگومانهای save_best_only=True و monitor="val_loss" پیکربندی میکنیم: آنها به callback میگویند که فقط یک فایل جدید (با بازنویسی هر فایل قبلی) زمانی ذخیره کند که مقدار فعلی معیار val_loss کمتر از هر زمان قبلی در طول آموزش باشد. این تضمین میکند که فایل ذخیرهشدهٔ شما همیشه حاوی حالت مدل مربوط به بهترین دورهٔ آموزشی آن از نظر عملکرد روی دادههای اعتبارسنجی باشد. در نتیجه، اگر شروع به بیشبرازش کنیم، مجبور نخواهیم بود یک مدل جدید برای تعداد کمتر دورهها دوباره آموزش دهیم: میتوانیم بهسادگی فایل ذخیرهشدهٔ خود را دوباره بارگذاری کنیم.
لیستینگ ۸.۱۵: برازش مدل با استفاده از یک Dataset
callbacks = [ keras.callbacks.ModelCheckpoint( filepath="convnet_from_scratch.keras", save_best_only=True, monitor="val_loss", )]history = model.fit( train_dataset, epochs=50, validation_data=validation_dataset, callbacks=callbacks,)بیایید زیان و دقت مدل را در طول آموزش روی دادههای آموزشی و اعتبارسنجی رسم کنیم (شکل ۸.۹ را ببینید).
لیستینگ ۸.۱۶: نمایش منحنیهای زیان و دقت در طول آموزش
import matplotlib.pyplot as plt
accuracy = history.history["accuracy"]val_accuracy = history.history["val_accuracy"]loss = history.history["loss"]val_loss = history.history["val_loss"]epochs = range(1, len(accuracy) + 1)
plt.plot(epochs, accuracy, "r--", label="Training accuracy")plt.plot(epochs, val_accuracy, "b", label="Validation accuracy")plt.title("Training and validation accuracy")plt.legend()plt.figure()
plt.plot(epochs, loss, "r--", label="Training loss")plt.plot(epochs, val_loss, "b", label="Validation loss")plt.title("Training and validation loss")plt.legend()plt.show()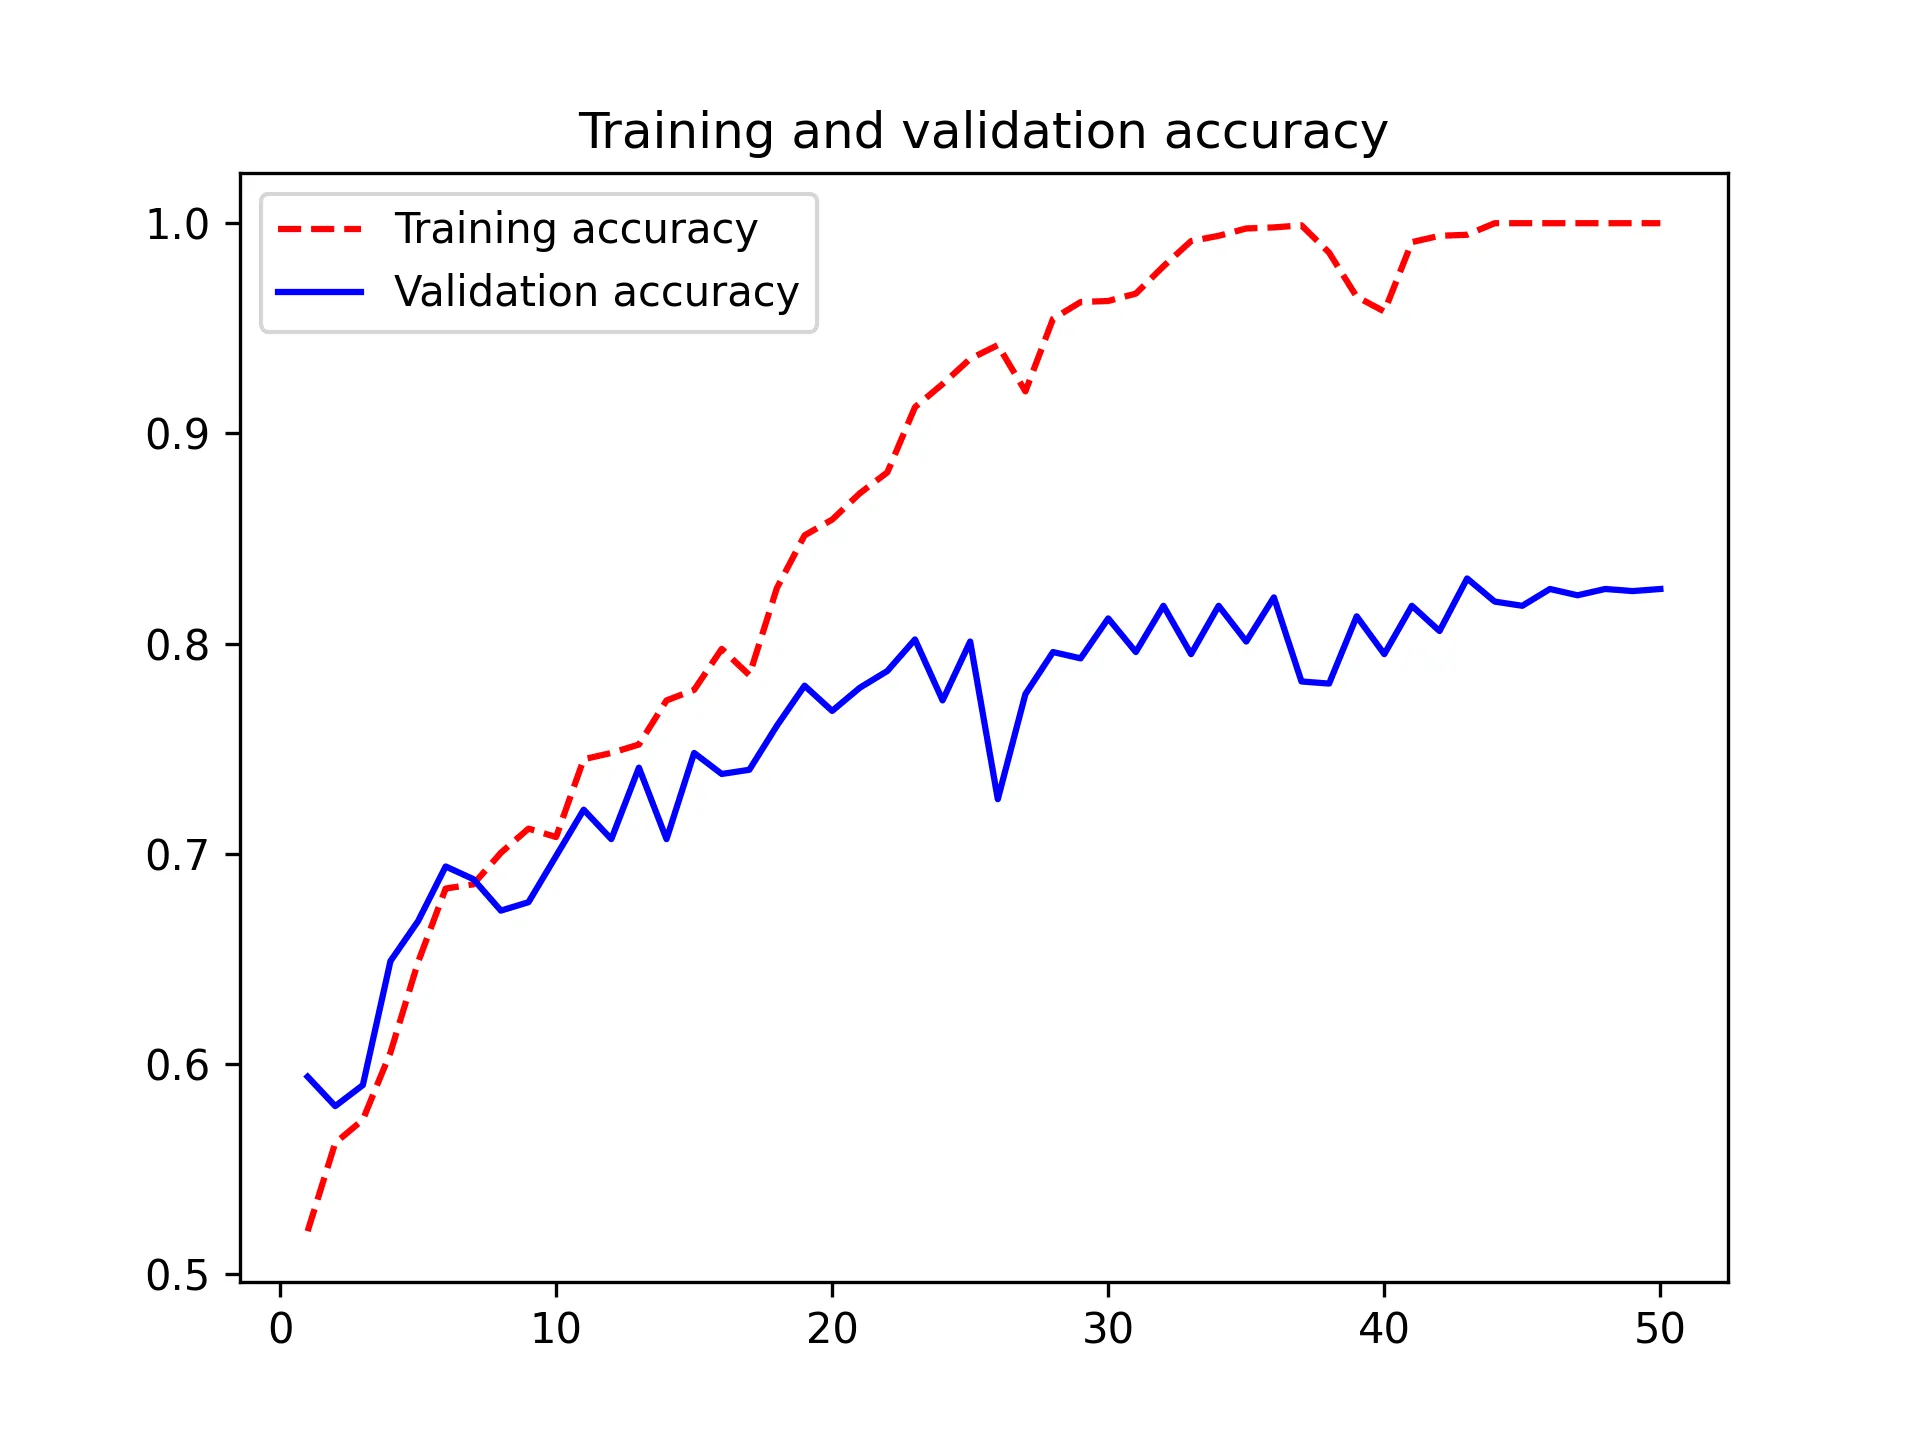
شکل ۸.۹: معیارهای آموزش و اعتبارسنجی برای یک ConvNet ساده
این نمودارها مشخصهٔ بیشبرازش هستند. دقت آموزش در طول زمان بهطور خطی افزایش مییابد تا به نزدیک ۱۰۰٪ برسد، در حالی که دقت اعتبارسنجی حول ۸۰٪ به اوج میرسد. زیان اعتبارسنجی پس از تنها ۱۰ دوره به حداقل خود میرسد و سپس متوقف میشود، در حالی که زیان آموزش با پیشرفت آموزش بهطور خطی کاهش مییابد.
بیایید دقت آزمایش را بررسی کنیم. ما مدل را از فایل ذخیرهشدهٔ خود دوباره بارگذاری میکنیم تا آن را همانطور که قبل از شروع بیشبرازش بود ارزیابی کنیم.
لیستینگ ۸.۱۷: ارزیابی مدل روی مجموعهٔ آزمایشی
test_model = keras.models.load_model("convnet_from_scratch.keras")test_loss, test_acc = test_model.evaluate(test_dataset)print(f"Test accuracy: {test_acc:.3f}")ما به دقت آزمایش ۷۸.۶٪ میرسیم (به دلیل تصادفی بودن مقداردهی اولیهٔ شبکههای عصبی، ممکن است اعدادی در چند درصد از این عدد به دست آورید).
از آنجا که نمونههای آموزشی نسبتاً کمی دارید (۲,۰۰۰)، بیشبرازش نگرانی شمارهٔ یک شما خواهد بود. شما قبلاً دربارهٔ تعدادی تکنیک که میتوانند به کاهش بیشبرازش کمک کنند میدانید، مانند dropout و decay وزن (تنظیم L2). ما اکنون با یک تکنیک جدید کار خواهیم کرد، که مخصوص بینایی ماشین است و تقریباً بهطور جهانی هنگام پردازش تصاویر با مدلهای یادگیری عمیق استفاده میشود: افزونگی داده.
استفاده از افزونگی داده
Section titled “استفاده از افزونگی داده”بیشبرازش ناشی از داشتن نمونههای بسیار کم برای یادگیری است و شما را قادر نمیسازد مدلی آموزش دهید که بتواند به دادههای جدید تعمیم یابد. با دادهٔ بینهایت، مدل شما در معرض هر جنبهٔ ممکن از توزیع دادههای در دسترس قرار میگرفت: هرگز بیشبرازش نمیکردید. افزونگی داده رویکرد تولید دادههای آموزشی بیشتر از نمونههای آموزشی موجود را در پیش میگیرد، با افزونگی نمونهها از طریق تعدادی تبدیل تصادفی که تصاویر باورپذیری ایجاد میکنند. هدف این است که در زمان آموزش، مدل شما هرگز همان تصویر دقیق را دو بار نبیند. این به قرار گرفتن مدل در معرض جنبههای بیشتری از داده کمک میکند و بهتر تعمیم مییابد.
در Keras، این کار میتواند از طریق لایههای افزونگی داده انجام شود. چنین لایههایی میتوانند به یکی از دو روش اضافه شوند:
- در ابتدای مدل — داخل مدل. در مورد ما، لایهها درست قبل از لایهٔ
Rescalingقرار میگیرند. - داخل خط لولهٔ داده — خارج از مدل. در مورد ما، آنها را از طریق یک فراخوانی
map()رویDatasetخود اعمال میکردیم.
تفاوت اصلی بین این دو گزینه این است که افزونگی داده انجامشده در داخل مدل روی GPU اجرا میشود، درست مانند بقیهٔ مدل. در همین حال، افزونگی داده انجامشده در خط لولهٔ داده روی CPU اجرا میشود، معمولاً بهصورت موازی روی چندین هستهٔ CPU. گاهی اوقات میتواند مزایای عملکردی برای انجام اولی وجود داشته باشد، اما دومی معمولاً گزینهٔ بهتر است. پس بیایید با آن پیش برویم!
لیستینگ ۸.۱۸: تعریف یک مرحلهٔ افزونگی داده
# Defines the transformations to apply as a listdata_augmentation_layers = [    layers.RandomFlip("horizontal"),    layers.RandomRotation(0.1),    layers.RandomZoom(0.2),]
# Creates a function that applies them sequentiallydef data_augmentation(images, targets):    for layer in data_augmentation_layers:        images = layer(images)    return images, targets
# Maps this function into the datasetaugmented_train_dataset = train_dataset.map( data_augmentation, num_parallel_calls=8)# Enables prefetching of batches on GPU memory; important for best# performanceaugmented_train_dataset = augmented_train_dataset.prefetch(tf.data.AUTOTUNE)اینها فقط چند مورد از لایههای موجود هستند (برای موارد بیشتر، مستندات Keras را ببینید). بیایید سریع این کد را مرور کنیم:
RandomFlip("horizontal")یک بازتاب افقی را روی ۵۰٪ تصادفی از تصاویری که از آن عبور میکنند اعمال میکند.RandomRotation(0.1)تصاویر ورودی را با یک مقدار تصادفی در محدودهٔ [–۱۰٪, +۱۰٪] میچرخاند (اینها کسری از یک دایرهٔ کامل هستند — بر حسب درجه محدوده [–۳۶ درجه, +۳۶ درجه] خواهد بود).RandomZoom(0.2)تصویر را با یک عامل تصادفی در محدودهٔ [–۲۰٪, +۲۰٪] بزرگنمایی یا کوچکنمایی میکند.
بیایید تصاویر افزودهشده را ببینیم (شکل ۸.۱۰ را ببینید).
لیستینگ ۸.۱۹: نمایش چند تصویر آموزشی بهطور تصادفی افزودهشده
plt.figure(figsize=(10, 10))# You can use take(N) to only sample N batches from the dataset. This# is equivalent to inserting a break in the loop after the Nth batch.for image_batch, _ in train_dataset.take(1): image = image_batch[0] for i in range(9): ax = plt.subplot(3, 3, i + 1) augmented_image, _ = data_augmentation(image, None) augmented_image = keras.ops.convert_to_numpy(augmented_image) # Displays the first image in the output batch. For each of the # nine iterations, this is a different augmentation of the same # image. plt.imshow(augmented_image.astype("uint8")) plt.axis("off")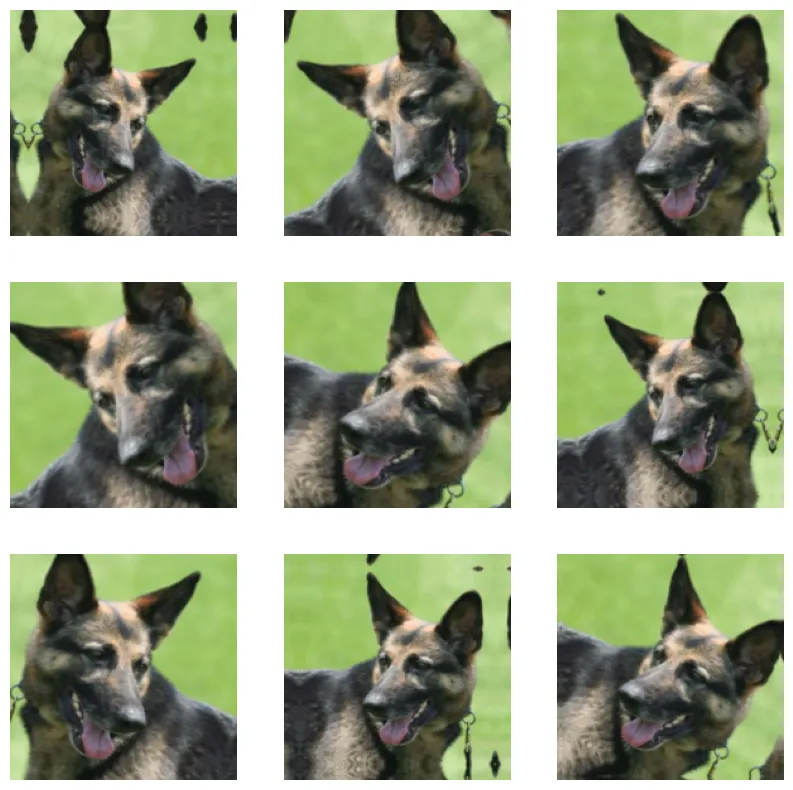
شکل ۸.۱۰: تولید تغییراتی از یک پسر خیلی خوب از طریق افزونگی دادهٔ تصادفی
اگر یک مدل جدید با استفاده از این پیکربندی افزونگی داده آموزش دهید، مدل هرگز همان ورودی را دو بار نخواهد دید. اما ورودیهایی که میبیند هنوز بهشدت به هم مرتبط هستند، زیرا از تعداد کمی تصویر اصلی میآیند — شما نمیتوانید اطلاعات جدیدی تولید کنید؛ فقط میتوانید اطلاعات موجود را بازترکیب کنید. به این ترتیب، این ممکن است برای خلاص شدن کامل از بیشبرازش کافی نباشد. برای مبارزهٔ بیشتر با بیشبرازش، یک لایهٔ Dropout نیز به مدل خود اضافه خواهید کرد، درست قبل از طبقهبند متراکم متصل.
لیستینگ ۸.۲۰: تعریف یک ConvNet جدید که شامل dropout است
inputs = keras.Input(shape=(180, 180, 3))x = layers.Rescaling(1.0 / 255)(inputs)x = layers.Conv2D(filters=32, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=64, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=128, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=256, kernel_size=3, activation="relu")(x)x = layers.MaxPooling2D(pool_size=2)(x)x = layers.Conv2D(filters=512, kernel_size=3, activation="relu")(x)x = layers.GlobalAveragePooling2D()(x)x = layers.Dropout(0.25)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs=inputs, outputs=outputs)
model.compile(    loss="binary_crossentropy",    optimizer="adam",    metrics=["accuracy"],)
بیایید مدل را با استفاده از افزونگی داده و dropout آموزش دهیم. از آنجا که انتظار داریم بیشبرازش بسیار دیرتر در طول آموزش رخ دهد، دو برابر دورهها — ۱۰۰ — آموزش خواهیم داد. توجه داشته باشید که ما روی تصاویری ارزیابی میکنیم که افزوده نشدهاند — افزونگی داده معمولاً فقط در زمان آموزش انجام میشود، زیرا یک تکنیک تنظیم است.
لیستینگ ۸.۲۱: آموزش ConvNet تنظیمشده روی تصاویر افزودهشده
callbacks = [ keras.callbacks.ModelCheckpoint( filepath="convnet_from_scratch_with_augmentation.keras", save_best_only=True, monitor="val_loss", )]history = model.fit( augmented_train_dataset, # Since we expect the model to overfit slower, we train for more # epochs. epochs=100, validation_data=validation_dataset, callbacks=callbacks,)بیایید نتایج را دوباره رسم کنیم؛ شکل ۸.۱۱ را ببینید. به لطف افزونگی داده و dropout، ما بسیار دیرتر شروع به بیشبرازش میکنیم، حدود دورههای ۶۰-۷۰ (در مقایسه با دورهٔ ۱۰ برای مدل اصلی). دقت اعتبارسنجی در نهایت بالای ۸۵٪ به اوج میرسد — یک بهبود بزرگ نسبت به تلاش اول ما.
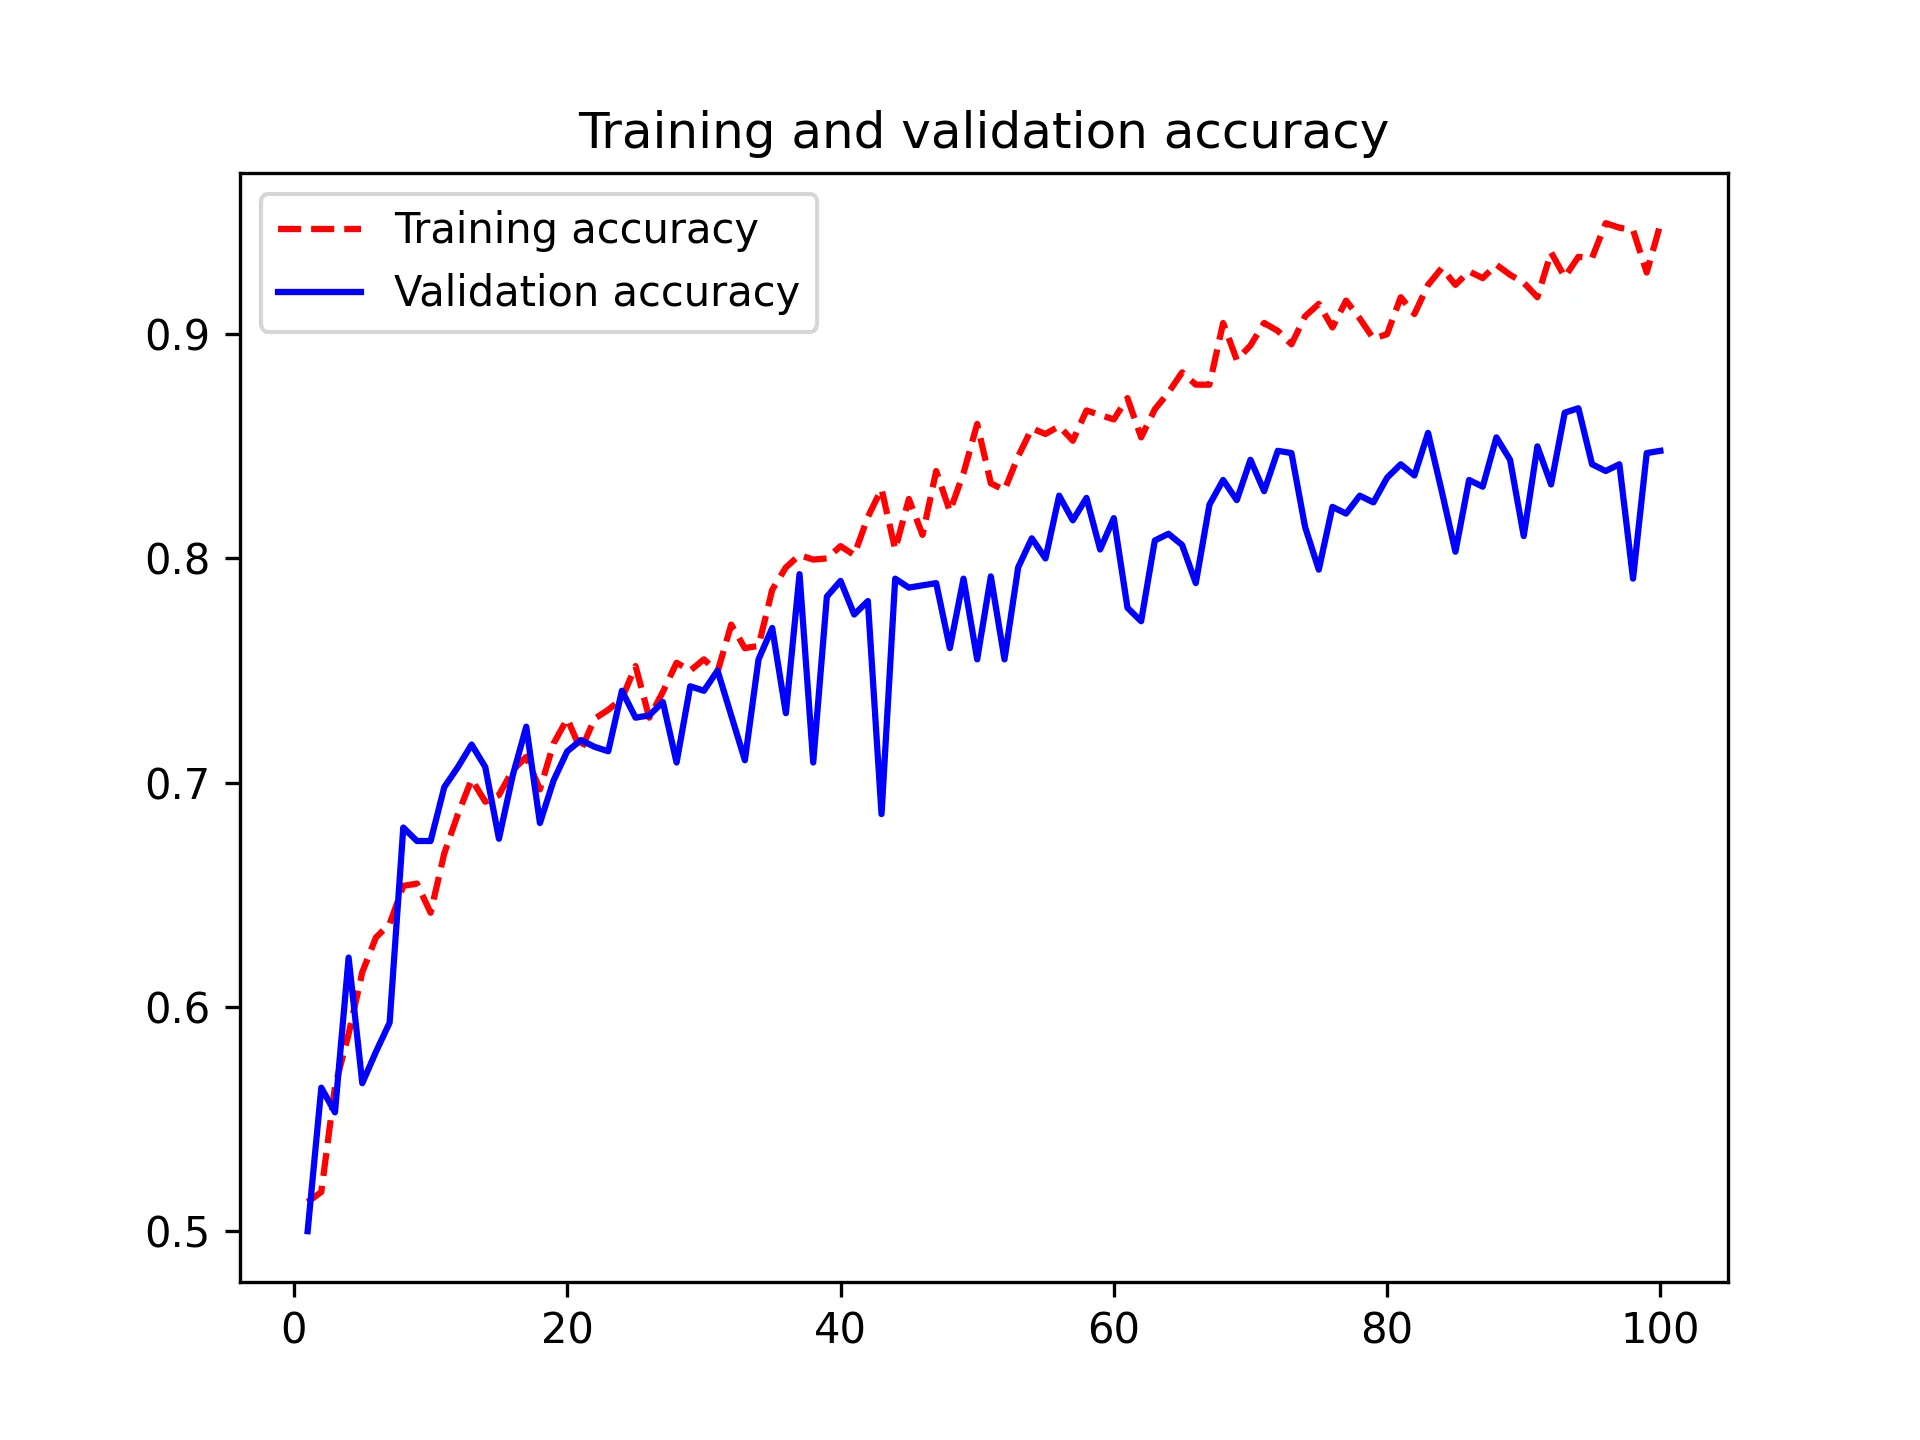
شکل ۸.۱۱: معیارهای آموزش و اعتبارسنجی با افزونگی داده
بیایید دقت آزمایش را بررسی کنیم.
لیستینگ ۸.۲۲: ارزیابی مدل روی مجموعهٔ آزمایشی
test_model = keras.models.load_model( "convnet_from_scratch_with_augmentation.keras")test_loss, test_acc = test_model.evaluate(test_dataset)print(f"Test accuracy: {test_acc:.3f}")ما به دقت آزمایش ۸۳.۹٪ میرسیم. شروع به خوب به نظر رسیدن کرده است! اگر از Colab استفاده میکنید، مطمئن شوید که فایل ذخیرهشده (convnet_from_scratch_with_augmentation.keras) را دانلود کنید، زیرا از آن برای برخی آزمایشها در فصل بعد استفاده خواهیم کرد.
با تنظیم بیشتر پیکربندی مدل (مانند تعداد فیلترهای هر لایهٔ کانولوشن یا تعداد لایههای مدل)، ممکن است بتوانید دقت بهتری به دست آورید، احتمالاً تا ۹۰٪. اما دشوار خواهد بود که فقط با آموزش ConvNet خود از صفر بالاتر بروید زیرا دادهٔ بسیار کمی برای کار دارید. بهعنوان گام بعدی برای بهبود دقت خود در این مسئله، باید از یک مدل از پیش آموزشدیده استفاده کنید، که تمرکز دو بخش بعدی است.
استفاده از یک مدل از پیش آموزشدیده
Section titled “استفاده از یک مدل از پیش آموزشدیده”یک رویکرد رایج و بسیار مؤثر برای یادگیری عمیق روی مجموعهدادههای تصویری کوچک استفاده از یک مدل از پیش آموزشدیده است. یک مدل از پیش آموزشدیده مدلی است که قبلاً روی یک مجموعهدادهٔ بزرگ، معمولاً روی یک وظیفهٔ طبقهبندی تصویر در مقیاس بزرگ، آموزش دیده است. اگر این مجموعهدادهٔ اصلی بهاندازهٔ کافی بزرگ و عمومی باشد، آنگاه سلسلهمراتب فضایی ویژگیهای یادگرفتهشده توسط مدل از پیش آموزشدیده میتواند بهطور مؤثر بهعنوان یک مدل عمومی از جهان بصری عمل کند، و از این رو ویژگیهای آن میتواند برای بسیاری از مسائل بینایی ماشین مختلف مفید باشد، حتی اگر این مسائل جدید شامل کلاسهای کاملاً متفاوتی از وظیفهٔ اصلی باشند. برای مثال، میتوانستید یک مدل روی ImageNet آموزش دهید (که در آن کلاسها عمدتاً حیوانات و اشیاء روزمره هستند) و سپس این مدل آموزشدیده را برای چیزی به دور از دسترسی مانند شناسایی اقلام مبلمان در تصاویر دوباره استفاده کنید. چنین قابلیت حمل ویژگیهای یادگرفتهشده در مسائل مختلف یک مزیت کلیدی یادگیری عمیق در مقایسه با بسیاری از رویکردهای یادگیری کمعمق قدیمیتر است و یادگیری عمیق را برای مسائل دادهٔ کوچک بسیار مؤثر میکند.
در این مورد، بیایید یک ConvNet بزرگ آموزشدیده روی مجموعهدادهٔ ImageNet (۱.۴ میلیون تصویر برچسبدار و ۱,۰۰۰ کلاس مختلف) را در نظر بگیریم. ImageNet شامل کلاسهای حیوانات بسیاری است، از جمله گونههای مختلف گربه و سگ، و بنابراین میتوانید انتظار داشته باشید که روی مسئلهٔ طبقهبندی سگ در برابر گربه عملکرد خوبی داشته باشد.
ما از معماری Xception استفاده خواهیم کرد. این ممکن است اولین برخورد شما با یکی از این نامهای مدل بامزه باشد — Xception، ResNet، EfficientNet و غیره؛ اگر به انجام یادگیری عمیق برای بینایی ماشین ادامه دهید به آنها عادت خواهید کرد زیرا مکرراً ظاهر میشوند. در فصل بعد دربارهٔ جزئیات معماری Xception یاد خواهید گرفت.
دو راه برای استفاده از یک مدل از پیش آموزشدیده وجود دارد: استخراج ویژگی و تنظیم دقیق. ما هر دو را پوشش خواهیم داد. بیایید با استخراج ویژگی شروع کنیم.
استخراج ویژگی با یک مدل از پیش آموزشدیده
Section titled “استخراج ویژگی با یک مدل از پیش آموزشدیده”استخراج ویژگی شامل استفاده از بازنماییهای یادگرفتهشده توسط یک مدل قبلاً آموزشدیده برای استخراج ویژگیهای جالب از نمونههای جدید است. سپس این ویژگیها از طریق یک طبقهبند جدید که از صفر آموزش دیده اجرا میشوند.
همانطور که قبلاً دیدید، ConvNetهای مورد استفاده برای طبقهبندی تصویر از دو بخش تشکیل شدهاند: با یک سری لایههای pooling و کانولوشن شروع میشوند و با یک طبقهبند متراکم متصل پایان مییابند. بخش اول پایهٔ کانولوشنی یا ستون فقرات مدل نامیده میشود. در مورد ConvNetها، استخراج ویژگی شامل گرفتن پایهٔ کانولوشنی یک شبکهٔ قبلاً آموزشدیده، اجرای دادههای جدید از طریق آن و آموزش یک طبقهبند جدید روی خروجی است (شکل ۸.۱۲ را ببینید).
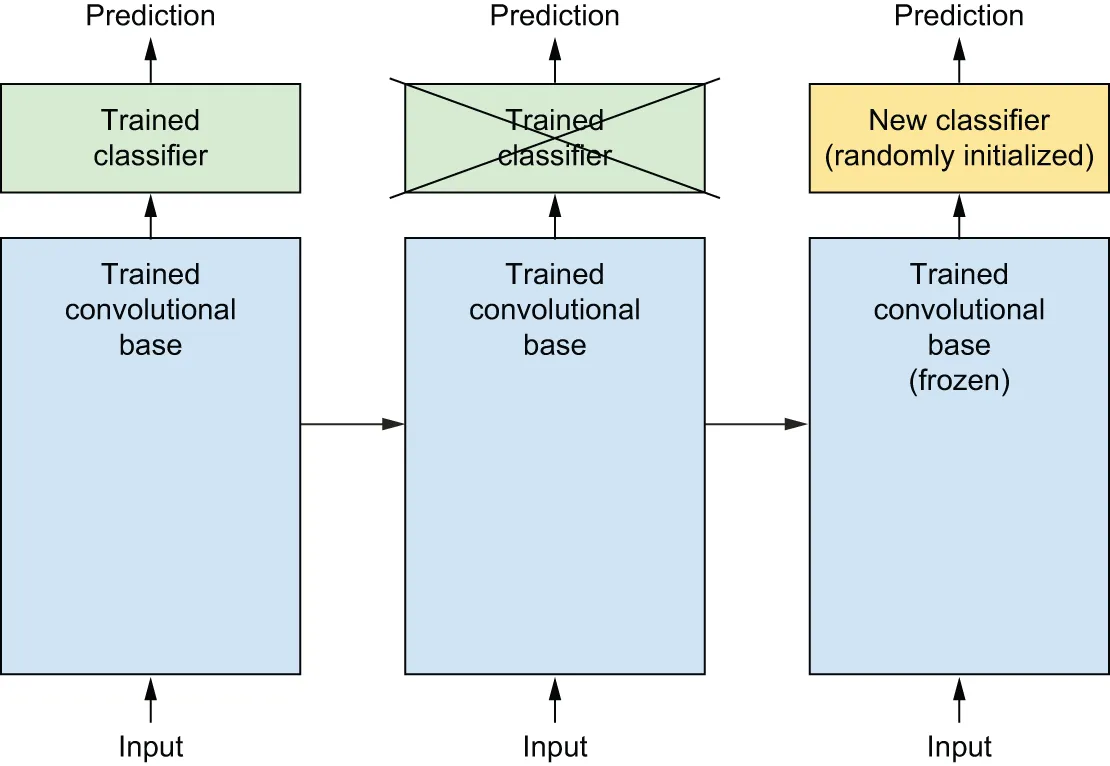
شکل ۸.۱۲: تعویض طبقهبندها در حالی که همان پایهٔ کانولوشنی حفظ میشود
چرا فقط از پایهٔ کانولوشنی دوباره استفاده کنیم؟ آیا میتوانستید از طبقهبند متراکم متصل نیز دوباره استفاده کنید؟ بهطور کلی، انجام این کار باید اجتناب شود. دلیل این است که بازنماییهای یادگرفتهشده توسط پایهٔ کانولوشنی احتمالاً عمومیتر و در نتیجه قابل استفادهٔ مجددتر هستند: نقشههای ویژگی یک ConvNet نقشههای حضور مفاهیم عمومی روی یک تصویر هستند، که احتمالاً صرفنظر از مسئلهٔ بینایی ماشین در دسترس مفید خواهند بود. اما بازنماییهای یادگرفتهشده توسط طبقهبند لزوماً مخصوص مجموعهای از کلاسها خواهند بود که مدل روی آن آموزش دیده است — آنها فقط حاوی اطلاعاتی دربارهٔ احتمال حضور این یا آن کلاس در کل تصویر خواهند بود. علاوه بر این، بازنماییهای موجود در لایههای متراکم متصل دیگر هیچ اطلاعاتی دربارهٔ مکان اشیاء در تصویر ورودی ندارند: این لایهها مفهوم فضا را حذف میکنند، در حالی که مکان شیء هنوز توسط نقشههای ویژگی کانولوشنی توصیف میشود. برای مسائلی که مکان شیء اهمیت دارد، ویژگیهای متراکم متصل تا حد زیادی بیفایده هستند.
توجه داشته باشید که سطح عمومیت (و بنابراین قابلیت استفادهٔ مجدد) بازنماییهای استخراجشده توسط لایههای کانولوشن خاص به عمق لایه در مدل بستگی دارد. لایههایی که در مدل زودتر میآیند نقشههای ویژگی محلی و بسیار عمومی استخراج میکنند (مانند لبههای بصری، رنگها و بافتها)، در حالی که لایههایی که بالاتر هستند مفاهیم انتزاعیتری (مانند «گوش گربه» یا «چشم سگ») استخراج میکنند. بنابراین اگر مجموعهدادهٔ جدید شما با مجموعهدادهای که مدل اصلی روی آن آموزش دیده بسیار متفاوت است، ممکن است بهتر باشد فقط از چند لایهٔ اول مدل برای انجام استخراج ویژگی استفاده کنید، نه از کل پایهٔ کانولوشنی.
در این مورد، از آنجا که مجموعهٔ کلاس ImageNet شامل چندین کلاس سگ و گربه است، احتمالاً مفید است که از اطلاعات موجود در لایههای متراکم متصل مدل اصلی دوباره استفاده کنیم. اما ما انتخاب میکنیم این کار را نکنیم تا بتوانیم حالت عمومیتر را پوشش دهیم که در آن مجموعهٔ کلاس مسئلهٔ جدید با مجموعهٔ کلاس مدل اصلی همپوشانی ندارد. بیایید این را در عمل با استفاده از پایهٔ کانولوشنی مدل از پیش آموزشدیده خود برای استخراج ویژگیهای جالب از تصاویر گربه و سگ و سپس آموزش یک طبقهبند سگ در برابر گربه روی این ویژگیها پیاده کنیم.
ما از کتابخانهٔ KerasHub برای ایجاد تمام مدلهای از پیش آموزشدیدهٔ استفادهشده در این کتاب استفاده خواهیم کرد. KerasHub شامل پیادهسازیهای Keras از معماریهای مدل از پیش آموزشدیدهٔ محبوب همراه با وزنهای از پیش آموزشدیدهای است که میتوانند روی دستگاه شما دانلود شوند. این شامل تعدادی ConvNet مانند Xception، ResNet، EfficientNet و MobileNet و همچنین مدلهای بزرگتر و مولد است که در فصلهای بعدی این کتاب استفاده خواهیم کرد. بیایید امتحان کنیم که از آن برای نمونهسازی مدل Xception آموزشدیده روی مجموعهدادهٔ ImageNet استفاده کنیم.
لیستینگ ۸.۲۳: نمونهسازی پایهٔ کانولوشنی Xception
import keras_hub
conv_base = keras_hub.models.Backbone.from_preset("xception_41_imagenet")
چند نکته را متوجه خواهید شد. اول، KerasHub از اصطلاح backbone برای اشاره به شبکهٔ استخراجکنندهٔ ویژگی زیرین بدون سر طبقهبندی استفاده میکند (تایپ کردن آن کمی آسانتر از «پایهٔ کانولوشنی» است). همچنین از یک سازندهٔ ویژه به نام from_preset() استفاده میکند که پیکربندی و وزنهای مدل Xception را دانلود خواهد کرد.
آن «۴۱» در نام مدلی که استفاده میکنیم چیست؟ ConvNetهای از پیش آموزشدیده طبق قرارداد اغلب با نامگذاری بر اساس «عمق» آنها نامیده میشوند. در این مورد، ۴۱ به این معناست که مدل Xception ما ۴۱ لایهٔ آموزشپذیر (لایههای conv و dense) دارد که روی هم چیده شدهاند. این «عمیقترین» مدلی است که تاکنون در این کتاب با اختلاف زیاد استفاده کردهایم.
یک قطعهٔ گمشدهٔ دیگر وجود دارد که قبل از استفاده از این مدل به آن نیاز داریم. هر ConvNet از پیش آموزشدیده قبل از آموزش قبلی، مقداری تغییر مقیاس و تغییر اندازهٔ تصاویر را انجام میدهد. مهم است که مطمئن شویم تصاویر ورودی ما مطابقت دارند؛ در غیر این صورت، مدل ما باید دوباره یاد بگیرد که چگونه از تصاویر با محدودهٔ ورودی کاملاً متفاوت ویژگی استخراج کند. بهجای پیگیری اینکه کدام مدلهای از پیش آموزشدیده از محدودهٔ ورودی [0, 1] برای مقادیر پیکسل استفاده میکنند و کدام از محدودهٔ [-1, 1]، میتوانیم از یک لایهٔ KerasHub به نام ImageConverter استفاده کنیم که تصاویر ما را برای مطابقت با چکپوینت از پیش آموزشدیدهٔ ما تغییر مقیاس میدهد. این لایه همان سازندهٔ ویژهٔ from_preset() را مانند کلاس backbone دارد.
لیستینگ ۸.۲۴: نمونهسازی پیشپردازش جفتشده با مدل Xception
preprocessor = keras_hub.layers.ImageConverter.from_preset( "xception_41_imagenet", image_size=(180, 180),)در این مرحله، دو راه میتوانستید ادامه دهید:
- اجرای پایهٔ کانولوشنی روی مجموعهدادهٔ خود، ثبت خروجی آن در یک آرایهٔ NumPy روی دیسک و سپس استفاده از این داده بهعنوان ورودی به یک طبقهبند متراکم متصل مستقل مشابه آنهایی که در فصلهای ۴ و ۵ دیدید. این راهحل سریع و ارزان برای اجراست، زیرا فقط نیاز دارد پایهٔ کانولوشنی یک بار برای هر تصویر ورودی اجرا شود و پایهٔ کانولوشنی بهمراتب گرانترین بخش خط لوله است. اما به همین دلیل، این تکنیک به شما اجازه استفاده از افزونگی داده را نمیدهد.
- گسترش مدلی که دارید (
conv_base) با افزودن لایههایDenseروی آن و اجرای کل آن بهصورت سرتاسری روی دادههای ورودی. این به شما اجازه استفاده از افزونگی داده را میدهد زیرا هر تصویر ورودی هر بار که مدل آن را میبیند از پایهٔ کانولوشنی عبور میکند. اما به همین دلیل، این تکنیک بسیار گرانتر از اولی است.
ما هر دو تکنیک را پوشش خواهیم داد. بیایید کد لازم برای راهاندازی اولی را مرور کنیم: ثبت خروجی conv_base روی دادههای شما و استفاده از این خروجیها بهعنوان ورودی به یک مدل جدید.
استخراج ویژگی سریع بدون افزونگی داده
Section titled “استخراج ویژگی سریع بدون افزونگی داده”ما با استخراج ویژگیها بهصورت آرایههای NumPy شروع میکنیم، با فراخوانی متد predict() مدل conv_base روی مجموعهدادههای آموزش، اعتبارسنجی و آزمایشی خود. بیایید روی مجموعهدادههای خود تکرار کنیم تا ویژگیهای مدل از پیش آموزشدیده را استخراج کنیم.
لیستینگ ۸.۲۵: استخراج ویژگیهای تصویر و برچسبهای متناظر
def get_features_and_labels(dataset):    all_features = []    all_labels = []    for images, labels in dataset:        preprocessed_images = preprocessor(images)        features = conv_base.predict(preprocessed_images, verbose=0)        all_features.append(features)        all_labels.append(labels)    return np.concatenate(all_features), np.concatenate(all_labels)
train_features, train_labels = get_features_and_labels(train_dataset)val_features, val_labels = get_features_and_labels(validation_dataset)test_features, test_labels = get_features_and_labels(test_dataset)
مهم است که predict() فقط انتظار تصاویر را دارد، نه برچسبها، اما مجموعهدادهٔ فعلی ما دستههایی را تولید میکند که هم تصاویر و هم برچسبهایشان را شامل میشوند.
ویژگیهای استخراجشده در حال حاضر شکل (samples, 6, 6, 2048) دارند:
>>> train_features.shapeدر این مرحله، میتوانید طبقهبند متراکم متصل خود را تعریف کنید (به استفاده از dropout برای تنظیم توجه کنید) و آن را روی دادهها و برچسبهایی که همین الان ثبت کردید آموزش دهید.
لیستینگ ۸.۲۶: تعریف و آموزش طبقهبند متراکم متصل
inputs = keras.Input(shape=(6, 6, 2048))# Averages spatial dimensions to flatten the feature mapx = layers.GlobalAveragePooling2D()(inputs)x = layers.Dense(256, activation="relu")(x)x = layers.Dropout(0.25)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs, outputs)model.compile(    loss="binary_crossentropy",    optimizer="adam",    metrics=["accuracy"],)
callbacks = [    keras.callbacks.ModelCheckpoint(        filepath="feature_extraction.keras",        save_best_only=True,        monitor="val_loss",    )]history = model.fit(    train_features,    train_labels,    epochs=10,    validation_data=(val_features, val_labels),    callbacks=callbacks,)
آموزش بسیار سریع است زیرا فقط باید با دو لایهٔ Dense سر و کار داشته باشید — یک دوره حتی روی CPU کمتر از ۱ ثانیه طول میکشد.
بیایید منحنیهای زیان و دقت را در طول آموزش ببینیم (شکل ۸.۱۳ را ببینید).
لیستینگ ۸.۲۷: رسم نتایج
import matplotlib.pyplot as plt
acc = history.history["accuracy"]val_acc = history.history["val_accuracy"]loss = history.history["loss"]val_loss = history.history["val_loss"]epochs = range(1, len(acc) + 1)plt.plot(epochs, acc, "r--", label="Training accuracy")plt.plot(epochs, val_acc, "b", label="Validation accuracy")plt.title("Training and validation accuracy")plt.legend()plt.figure()plt.plot(epochs, loss, "r--", label="Training loss")plt.plot(epochs, val_loss, "b", label="Validation loss")plt.title("Training and validation loss")plt.legend()plt.show()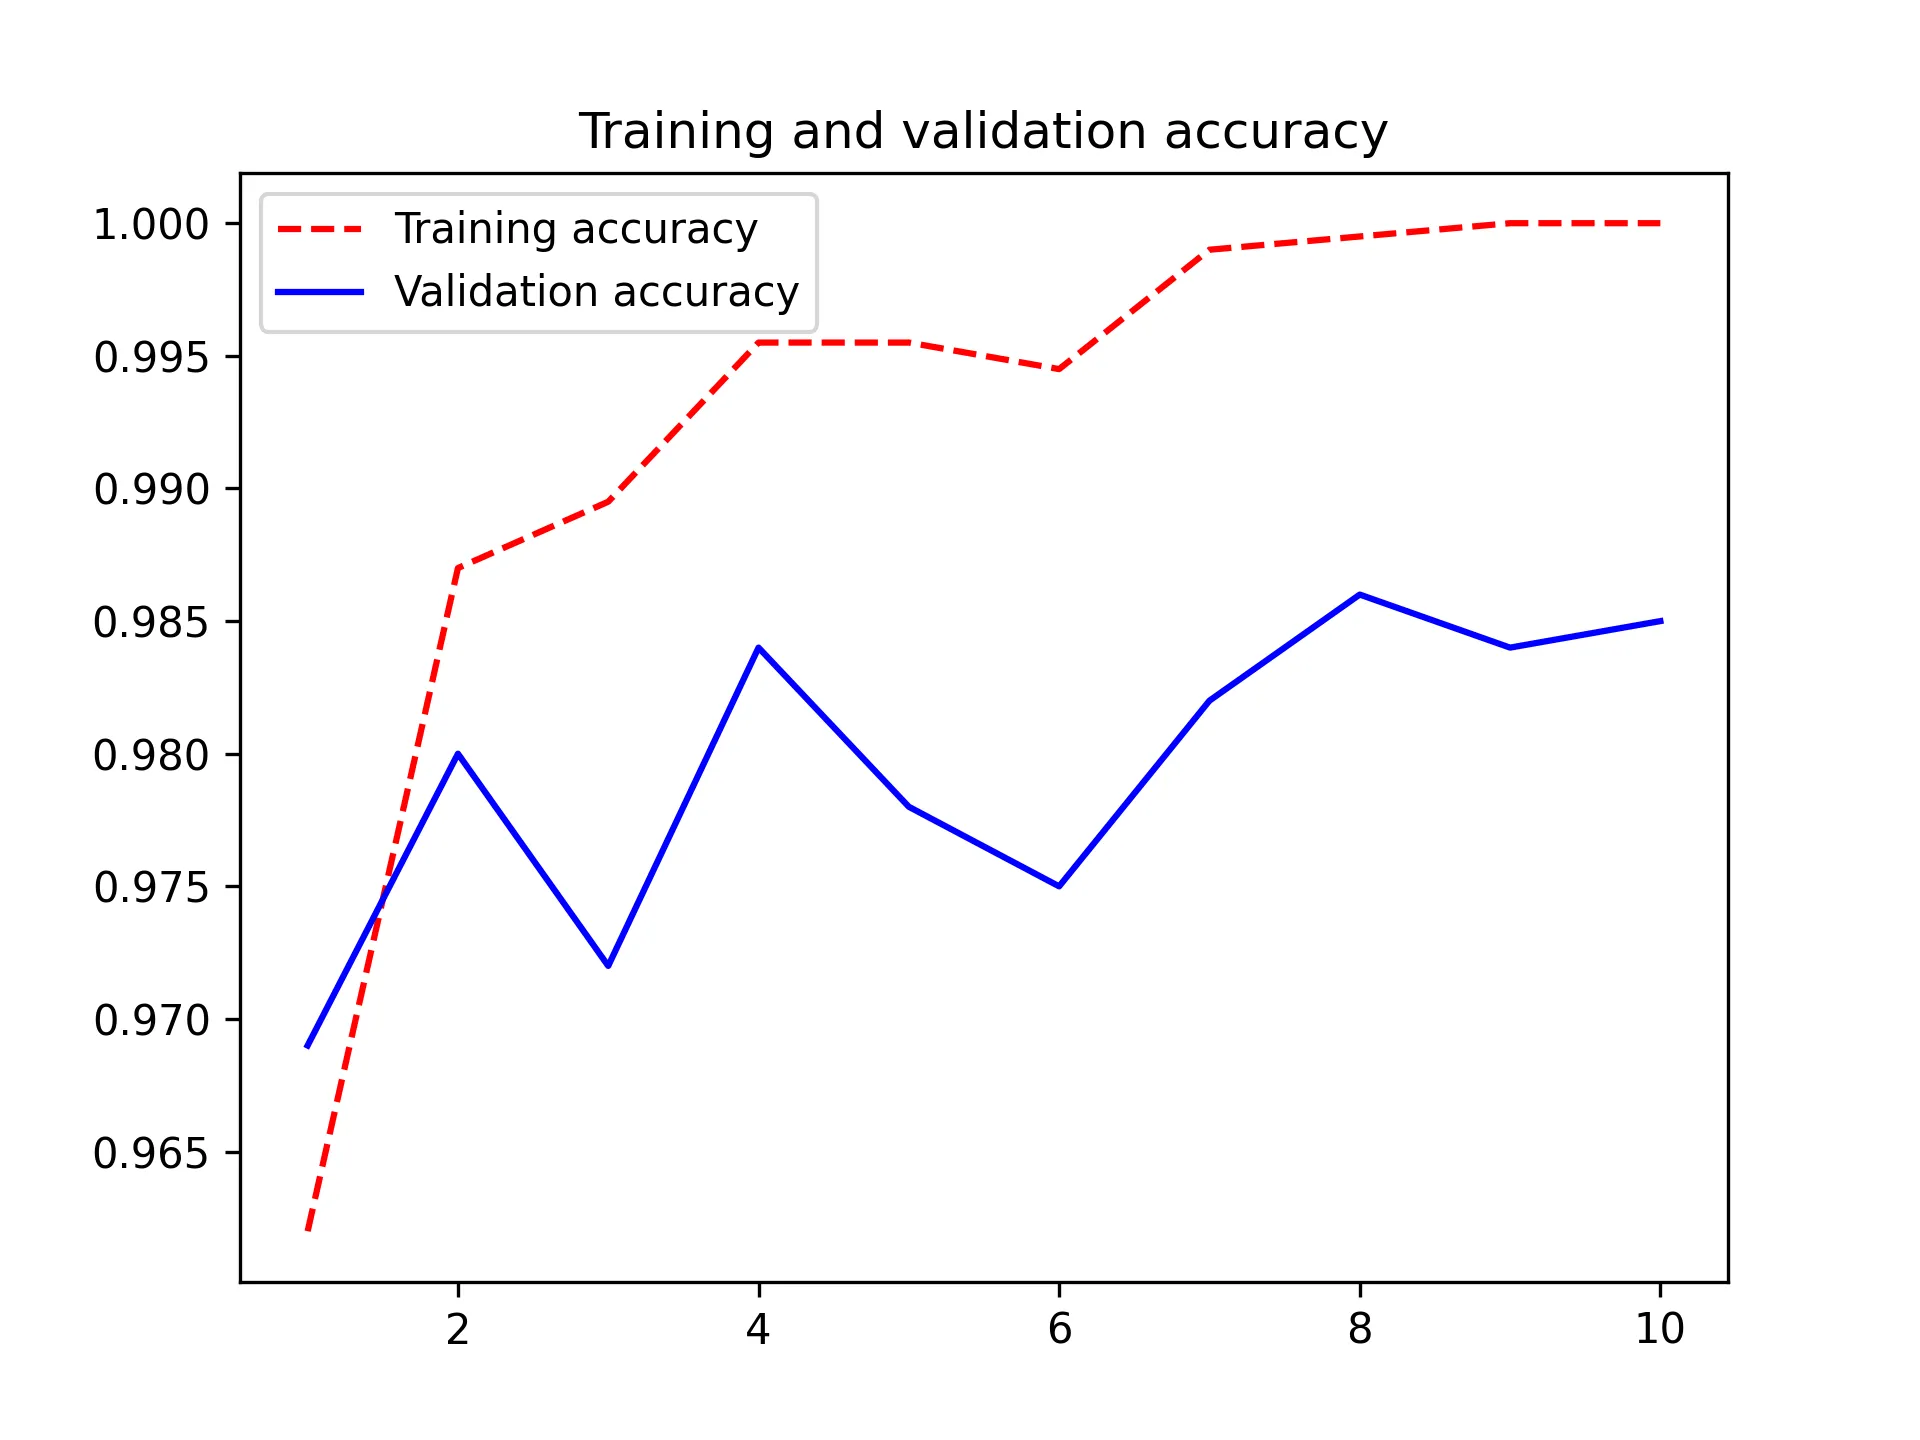
شکل ۸.۱۳: معیارهای آموزش و اعتبارسنجی برای استخراج ویژگی ساده
به دقت اعتبارسنجی کمی بالای ۹۸٪ میرسید — بسیار بهتر از آنچه در بخش قبل با مدل کوچک آموزشدیده از صفر به دست آوردید. با این حال، این مقایسه کمی ناعادلانه است، زیرا ImageNet شامل نمونههای بسیاری از سگ و گربه است، که به این معناست که مدل از پیش آموزشدیدهٔ ما از قبل دانش دقیق مورد نیاز برای وظیفهٔ پیشرو را دارد. این همیشه در هنگام استفاده از ویژگیهای از پیش آموزشدیده صادق نخواهد بود.
با این حال، نمودارها همچنین نشان میدهند که تقریباً از همان ابتدا بیشبرازش میکنید — با وجود استفاده از dropout با نرخ نسبتاً بزرگ. این به این دلیل است که این تکنیک از افزونگی داده استفاده نمیکند، که برای جلوگیری از بیشبرازش با مجموعهدادههای تصویری کوچک ضروری است.
بیایید دقت آزمایش را بررسی کنیم:
test_model = keras.models.load_model("feature_extraction.keras")test_loss, test_acc = test_model.evaluate(test_features, test_labels)print(f"Test accuracy: {test_acc:.3f}")ما به دقت آزمایش ۹۸.۱٪ میرسیم — یک بهبود بسیار خوب نسبت به آموزش یک مدل از صفر!
استخراج ویژگی همراه با افزونگی داده
Section titled “استخراج ویژگی همراه با افزونگی داده”حالا، بیایید تکنیک دومی را که برای انجام استخراج ویژگی ذکر کردیم مرور کنیم، که بسیار کندتر و گرانتر است اما به شما اجازه استفاده از افزونگی داده در طول آموزش را میدهد: ایجاد یک مدل که conv_base را با یک طبقهبند متراکم جدید زنجیره میکند و آن را بهصورت سرتاسری روی ورودیها آموزش میدهد.
برای انجام این کار، ابتدا پایهٔ کانولوشنی را منجمد میکنیم. منجمد کردن یک لایه یا مجموعهای از لایهها به معنای جلوگیری از بهروزرسانی وزنهای آنها در طول آموزش است. در اینجا، اگر این کار را نکنید، آنگاه بازنماییهایی که قبلاً توسط پایهٔ کانولوشنی یاد گرفته شدهاند در طول آموزش اصلاح میشوند. از آنجا که لایههای Dense روی آن بهطور تصادفی مقداردهی اولیه شدهاند، بهروزرسانیهای وزن بسیار بزرگی از طریق شبکه منتشر میشوند و بهطور مؤثر بازنماییهای یادگرفتهشدهٔ قبلی را از بین میبرند.
در Keras، یک لایه یا مدل را با تنظیم ویژگی trainable آن روی False منجمد میکنید.
لیستینگ ۸.۲۸: ایجاد پایهٔ کانولوشنی منجمد
import keras_hub
conv_base = keras_hub.models.Backbone.from_preset(    "xception_41_imagenet",    trainable=False,)
تنظیم trainable روی False لیست وزنهای آموزشپذیر لایه یا مدل را خالی میکند.
لیستینگ ۸.۲۹: چاپ لیست وزنهای آموزشپذیر قبل و بعد از انجماد
>>> conv_base.trainable = True>>> # The number of trainable weights before freezing the conv base>>> len(conv_base.trainable_weights)حالا، میتوانیم بهسادگی یک مدل جدید ایجاد کنیم که پایهٔ کانولوشنی منجمد ما و یک طبقهبند متراکم را به هم زنجیره میکند، مانند این:
inputs = keras.Input(shape=(180, 180, 3))x = preprocessor(inputs)x = conv_base(x)x = layers.GlobalAveragePooling2D()(x)x = layers.Dense(256)(x)x = layers.Dropout(0.25)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs, outputs)model.compile( loss="binary_crossentropy", optimizer="adam", metrics=["accuracy"],)با این تنظیم، فقط وزنهای دو لایهٔ Dense که اضافه کردید آموزش خواهند دید. این در مجموع چهار تانسور وزن است: دو تا برای هر لایه (ماتریس وزن اصلی و بردار بایاس). توجه داشته باشید که برای اینکه این تغییرات اعمال شوند، ابتدا باید مدل را کامپایل کنید. اگر هر زمان پس از کامپایل قابلیت آموزش وزنها را اصلاح کردید، باید مدل را دوباره کامپایل کنید، وگرنه این تغییرات نادیده گرفته میشوند.
بیایید مدل خود را آموزش دهیم. ما از مجموعهدادهٔ افزودهشدهٔ augmented_train_dataset خود دوباره استفاده خواهیم کرد. به لطف افزونگی داده، شروع بیشبرازش مدل بسیار بیشتر طول میکشد، بنابراین میتوانیم برای دورههای بیشتری آموزش دهیم — بیایید ۳۰ دوره انجام دهیم:
callbacks = [ keras.callbacks.ModelCheckpoint( filepath="feature_extraction_with_data_augmentation.keras", save_best_only=True, monitor="val_loss", )]history = model.fit( augmented_train_dataset, epochs=30, validation_data=validation_dataset, callbacks=callbacks,)بیایید نتایج را دوباره رسم کنیم (شکل ۸.۱۴ را ببینید). این مدل به دقت اعتبارسنجی ۹۸.۲٪ میرسد.
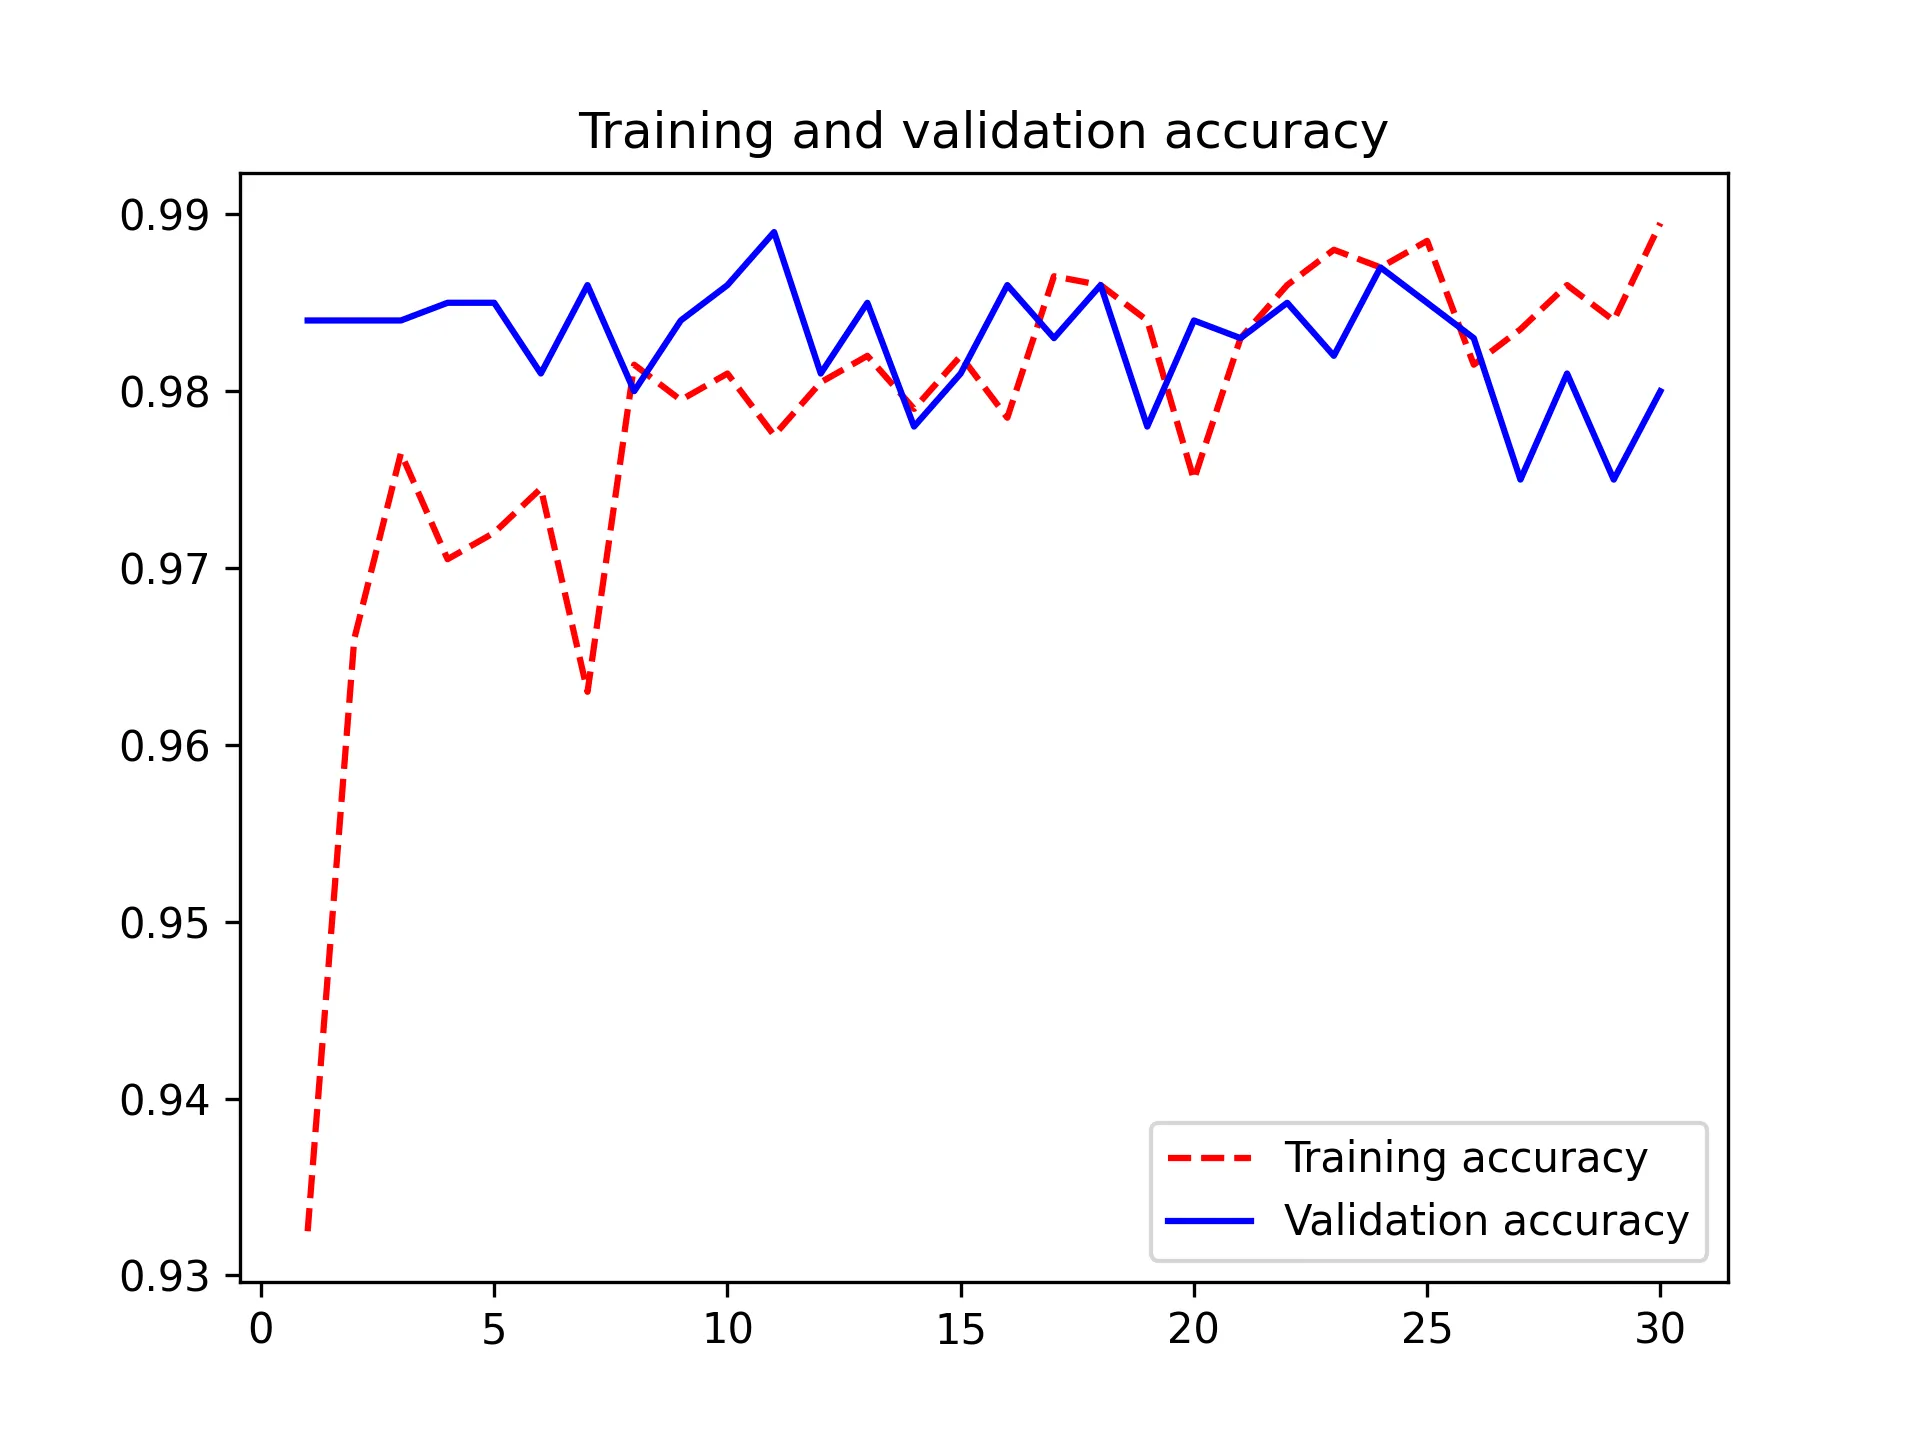
شکل ۸.۱۴: معیارهای آموزش و اعتبارسنجی برای استخراج ویژگی با افزونگی داده
بیایید دقت آزمایش را بررسی کنیم.
لیستینگ ۸.۳۰: ارزیابی مدل روی مجموعهٔ آزمایشی
test_model = keras.models.load_model( "feature_extraction_with_data_augmentation.keras")test_loss, test_acc = test_model.evaluate(test_dataset)print(f"Test accuracy: {test_acc:.3f}")ما به دقت آزمایش ۹۸.۴٪ میرسیم. این یک بهبود نسبت به مدل قبلی نیست، که کمی ناامیدکننده است. این میتواند نشانهای باشد که پیکربندی افزونگی دادهٔ ما دقیقاً با توزیع دادههای آزمایشی مطابقت ندارد. بیایید ببینیم آیا میتوانیم با آخرین تلاش خود بهتر عمل کنیم.
تنظیم دقیق یک مدل از پیش آموزشدیده
Section titled “تنظیم دقیق یک مدل از پیش آموزشدیده”تکنیک دیگری که بهطور گسترده برای استفادهٔ مجدد از مدل، مکمل استخراج ویژگی است، تنظیم دقیق است (شکل ۸.۱۵ را ببینید). تنظیم دقیق شامل رفع انجماد پایهٔ مدل منجمدشدهٔ استفادهشده برای استخراج ویژگی و آموزش مشترک هم بخش تازهاضافهشدهٔ مدل (در این مورد، طبقهبند کاملاً متصل) و هم مدل پایه است. این تنظیم دقیق نامیده میشود زیرا بازنماییهای انتزاعیتر مدلی که دوباره استفاده میشود را کمی تنظیم میکند تا آنها را برای مسئلهٔ پیشرو مرتبطتر کند.
قبلاً بیان کردیم که لازم است ابتدا پایهٔ کانولوشنی از پیش آموزشدیده را منجمد کنید تا بتوانید یک طبقهبند بهطور تصادفی مقداردهی اولیهشده را روی آن آموزش دهید. به همین دلیل، فقط پس از اینکه طبقهبند روی آن قبلاً آموزش دیده باشد امکان تنظیم دقیق پایهٔ کانولوشنی وجود دارد. اگر طبقهبند قبلاً آموزش ندیده باشد، آنگاه سیگنال خطای منتشرشده از طریق شبکه در طول آموزش بیشازحد بزرگ خواهد بود و بازنماییهایی که قبلاً توسط لایههایی که تنظیم دقیق میشوند یاد گرفته شدهاند از بین میروند. بنابراین، مراحل تنظیم دقیق یک شبکه به شرح زیر است:
- شبکهٔ سفارشی خود را روی یک شبکهٔ پایهٔ قبلاً آموزشدیده اضافه کنید.
- شبکهٔ پایه را منجمد کنید.
- بخشی را که اضافه کردید آموزش دهید.
- شبکهٔ پایه را رفع انجماد کنید.
- بهطور مشترک هم این لایهها و هم بخشی که اضافه کردید را آموزش دهید.
توجه داشته باشید که نباید لایههای «batch normalization» را رفع انجماد کنید (BatchNormalization). Batch normalization و تأثیر آن بر تنظیم دقیق در فصل بعد توضیح داده شده است.
شما قبلاً سه مرحلهٔ اول را هنگام انجام استخراج ویژگی تکمیل کردهاید. بیایید با مرحلهٔ ۴ ادامه دهیم: conv_base خود را رفع انجماد خواهید کرد.
بیایید تنظیم دقیق مدل را با استفاده از یک نرخ یادگیری بسیار پایین شروع کنیم. دلیل استفاده از نرخ یادگیری پایین این است که میخواهید بزرگی اصلاحاتی که در بازنماییهای لایههایی که تنظیم دقیق میکنید ایجاد میکنید را محدود کنید. بهروزرسانیهایی که بیشازحد بزرگ باشند ممکن است به این بازنماییها آسیب برسانند.
لیستینگ ۸.۳۱: تنظیم دقیق مدل
model.compile(    loss="binary_crossentropy",    optimizer=keras.optimizers.Adam(learning_rate=1e-5),    metrics=["accuracy"],)
callbacks = [    keras.callbacks.ModelCheckpoint(        filepath="fine_tuning.keras",        save_best_only=True,        monitor="val_loss",    )]history = model.fit(    augmented_train_dataset,    epochs=30,    validation_data=validation_dataset,    callbacks=callbacks,)
حالا در نهایت میتوانید این مدل را روی دادههای آزمایشی ارزیابی کنید (شکل ۸.۱۵ را ببینید):
model = keras.models.load_model("fine_tuning.keras")test_loss, test_acc = model.evaluate(test_dataset)print(f"Test accuracy: {test_acc:.3f}")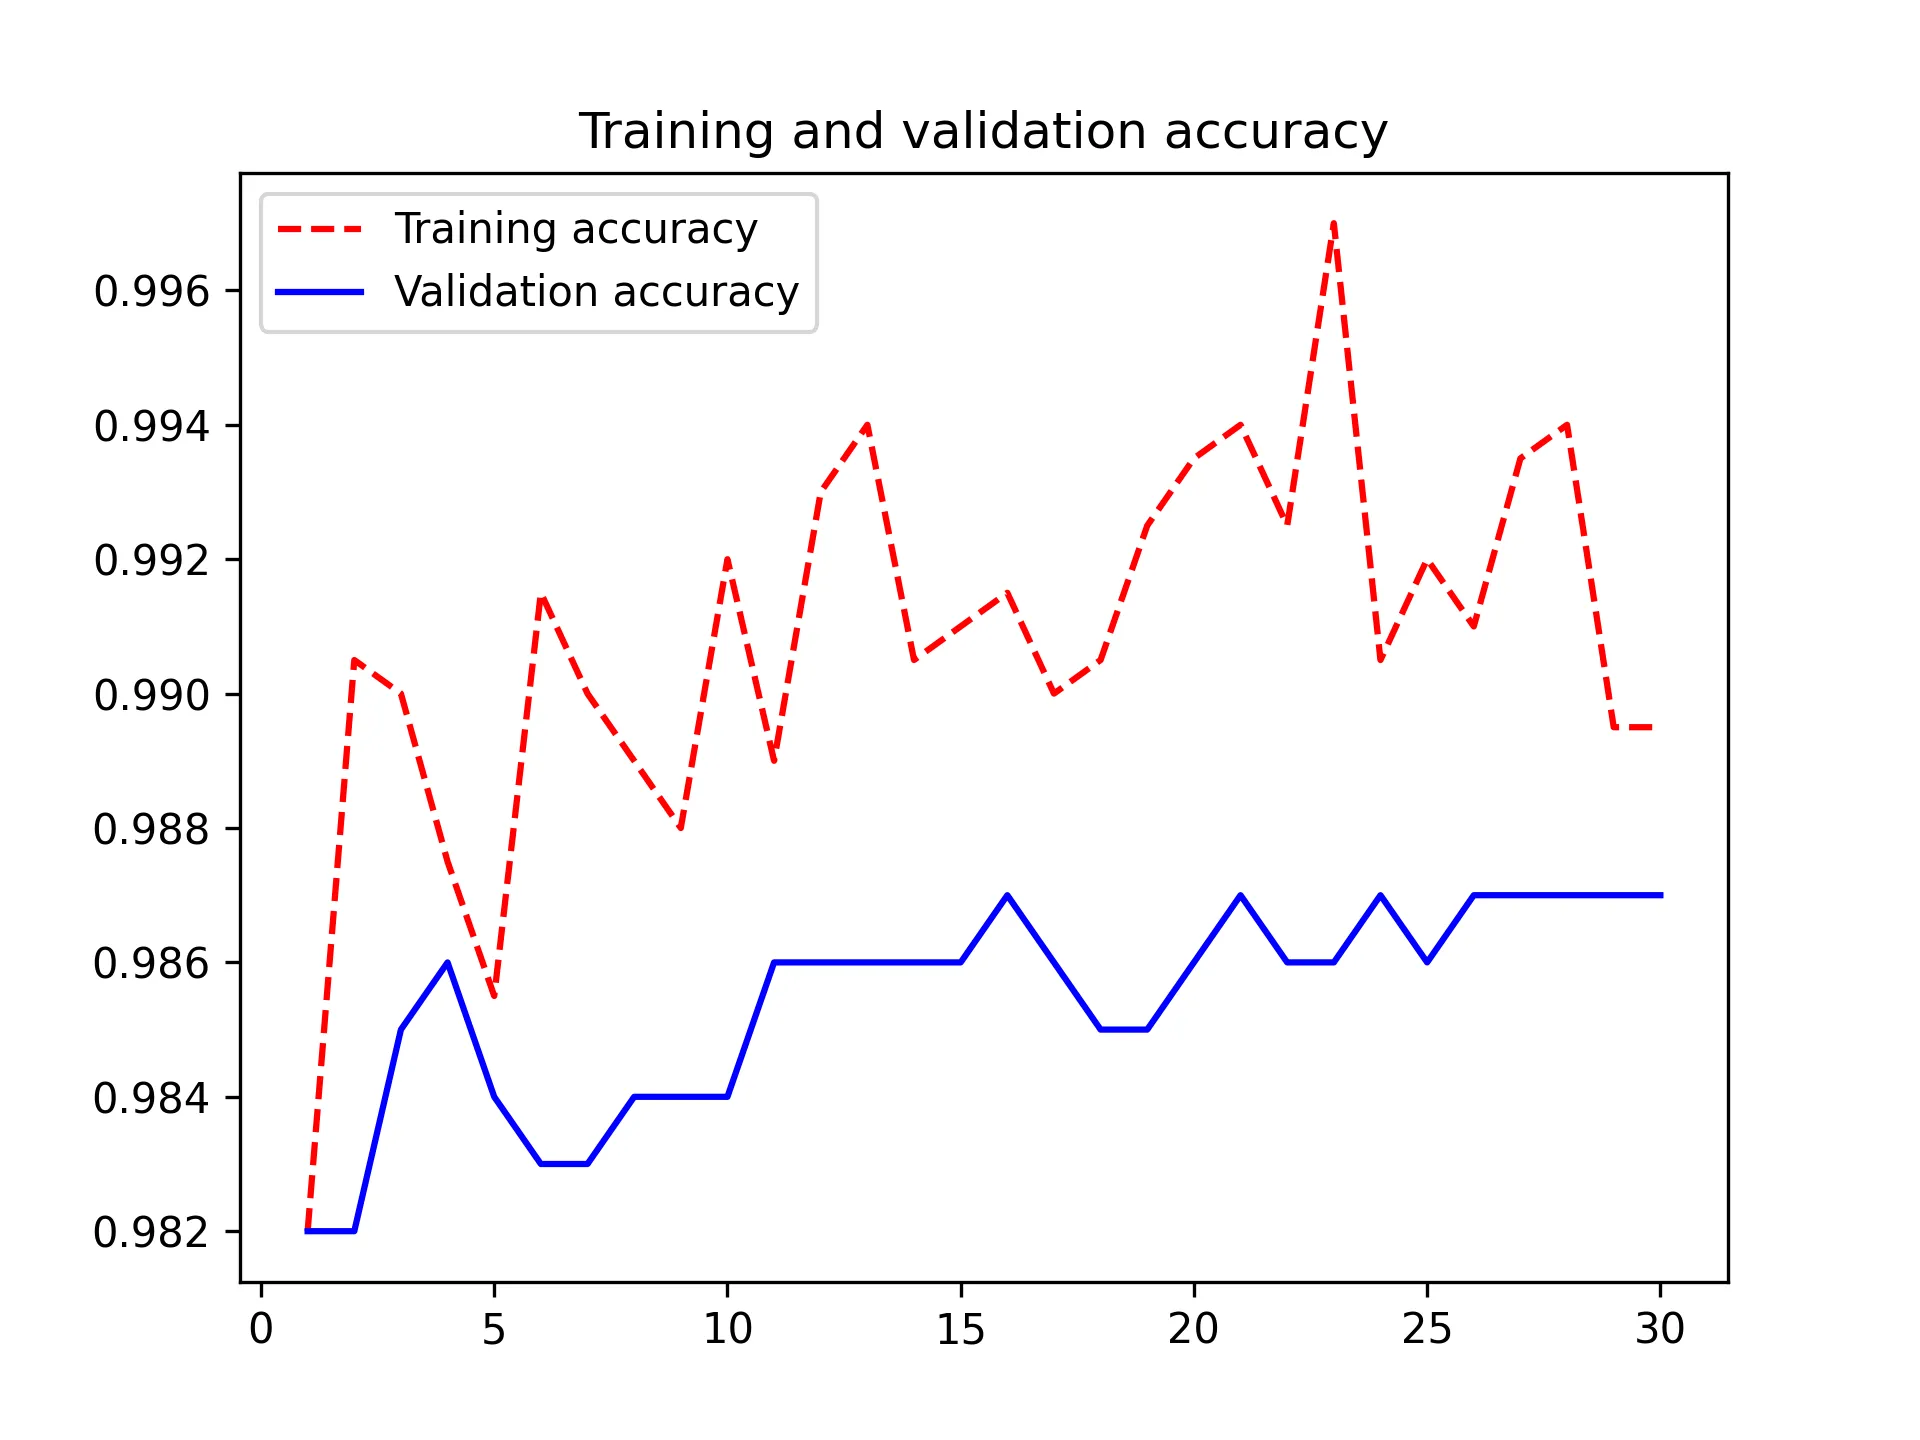
شکل ۸.۱۵: معیارهای آموزش و اعتبارسنجی برای تنظیم دقیق
در اینجا، به دقت آزمایش ۹۸.۶٪ میرسید (دوباره، نتایج خودتان ممکن است در محدودهٔ نیم درصد باشند). در مسابقهٔ اصلی Kaggle حول این مجموعهداده، این یکی از نتایج برتر میبود. با این حال، مقایسهٔ کاملاً منصفانهای نیست، زیرا شما از ویژگیهای از پیش آموزشدیدهای استفاده کردید که از قبل دانش پیشینی دربارهٔ گربهها و سگها داشتند، که شرکتکنندگان در آن زمان نمیتوانستند از آن استفاده کنند.
از جنبهٔ مثبت، با استفاده از تکنیکهای مدرن یادگیری عمیق، موفق شدید این نتیجه را تنها با استفاده از کسری کوچک از دادههای آموزشی که برای مسابقه در دسترس بود (حدود ۱۰٪) به دست آورید. تفاوت بزرگی بین توانایی آموزش روی ۲۰,۰۰۰ نمونه در مقایسه با ۲,۰۰۰ نمونه وجود دارد!
اکنون مجموعهٔ محکمی از ابزارها برای برخورد با مسائل طبقهبندی تصویر — بهویژه با مجموعهدادههای کوچک — دارید.
- ConvNetها در وظایف بینایی ماشین عالی هستند. امکان آموزش یکی از صفر، حتی روی یک مجموعهدادهٔ بسیار کوچک، با نتایج قابل قبول وجود دارد.
- ConvNetها با یادگیری یک سلسلهمراتب از الگوها و مفاهیم مدولار برای بازنمایی جهان بصری کار میکنند.
- روی یک مجموعهدادهٔ کوچک، بیشبرازش مسئلهٔ اصلی خواهد بود. افزونگی داده یک راه قدرتمند برای مبارزه با بیشبرازش هنگام کار با دادههای تصویری است.
- استفادهٔ مجدد از یک ConvNet موجود روی یک مجموعهدادهٔ جدید از طریق استخراج ویژگی آسان است. این یک تکنیک ارزشمند برای کار با مجموعهدادههای تصویری کوچک است.
- بهعنوان مکمل استخراج ویژگی، میتوانید از تنظیم دقیق استفاده کنید، که برخی از بازنماییهای یادگرفتهشدهٔ قبلی توسط یک مدل موجود را با یک مسئلهٔ جدید سازگار میکند. این عملکرد را کمی بیشتر بهبود میبخشد.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.