
فصل ۷: غوطهوری در Keras
شما کمکم در حال کسب تجربیاتی با Keras هستید. با مدل Sequential، لایههای Dense، و APIهای توکار برای آموزش، ارزیابی، و استنتاج — یعنی compile()، fit()، evaluate() و predict() آشنایی دارید. حتی در فصل ۳ یاد گرفتید که چگونه از کلاس Layer ارثبری کنید تا لایههای سفارشی بسازید، و چگونه از APIهای گرادیان در TensorFlow، JAX و PyTorch برای پیادهسازی یک حلقهٔ آموزش گامبهگام استفاده کنید.
در فصلهای آینده، به بررسی بینایی ماشین، پیشبینی سریهای زمانی، پردازش زبان طبیعی و یادگیری عمیق مولد خواهیم پرداخت. این کاربردهای پیچیده به چیزی بسیار بیشتر از یک معماری Sequential و حلقهٔ پیشفرض fit() نیاز خواهند داشت. بنابراین بیایید ابتدا شما را به یک متخصص Keras تبدیل کنیم! در این فصل، مروری کامل بر روشهای کلیدی کار با APIهای Keras به دست خواهید آورد: هر آنچه برای کار با کاربردهای پیشرفتهٔ یادگیری عمیقی که در ادامه با آنها روبرو میشوید نیاز دارید.
طیفی از گردشکارها
Section titled “طیفی از گردشکارها”طراحی Keras API بر اساس اصل افشای تدریجی پیچیدگی (progressive disclosure of complexity) هدایت میشود: شروع کار را آسان کنید، با این حال امکان رسیدگی به موارد کاربردی بسیار پیچیده را فراهم آورید، طوری که در هر مرحله فقط به یادگیری تدریجی نیاز باشد. موارد استفادهٔ ساده باید آسان و دستیافتنی باشند، و گردشکارهای با پیچیدگی دلخواه باید امکانپذیر باشند: فارغ از اینکه کاری که میخواهید انجام دهید چقدر خاص و پیچیده باشد، باید مسیری روشن برای رسیدن به آن وجود داشته باشد؛ مسیری که بر پایهٔ آموختههای مختلف شما از گردشکارهای سادهتر بنا شده است. این بدان معناست که میتوانید از یک مبتدی تا یک متخصص رشد کنید و همچنان از همان ابزارها استفاده کنید — تنها به شیوههایی متفاوت.
به این ترتیب، یک روش «واقعی» واحد برای استفاده از Keras وجود ندارد. بلکه Keras طیفی از گردشکارها را ارائه میدهد، از بسیار ساده تا بسیار منعطف. روشهای مختلفی برای ساخت مدلهای Keras، و روشهای مختلفی برای آموزش آنها وجود دارد که به نیازهای متفاوتی پاسخ میدهند.
برای مثال، شما طیفی از روشها برای ساخت مدلها و آرایهای از روشها برای آموزش آنها در اختیار دارید که هر کدام نشاندهندهٔ مصالحهای معین بین کاربردپذیری و انعطافپذیری هستند. شما میتوانید از Keras به شکلی که از scikit-learn استفاده میکنید بهره ببرید — صرفاً با فراخوانی fit() و سپردن کار به فریمورک — یا میتوانید مانند NumPy از آن استفاده کنید — با به دست گرفتن کنترل کامل بر تکتک جزئیات ریز.
از آنجا که تمام این گردشکارها بر پایهٔ APIهای مشترک، مانند Layer و Model بنا شدهاند، مؤلفههای هر گردشکار را میتوان در هر گردشکار دیگری به کار برد: آنها همگی میتوانند با یکدیگر تعامل داشته باشند. این بدان معناست که هر آنچه اکنون در حین شروع کار یاد میگیرید، زمانی که به یک متخصص تبدیل شدید نیز همچنان مرتبط خواهد بود. میتوانید بهسادگی کار را آغاز کنید و سپس بهتدریج در گردشکارهایی عمیق شوید که در آنها منطق بیشتری را از ابتدا مینویسید. هنگام گذر از مرحلهٔ دانشجویی به پژوهشگری، یا از دانشمند داده به مهندس یادگیری عمیق، نیازی نخواهد بود به یک فریمورک کاملاً متفاوت کوچ کنید.
این فلسفه بیشباهت به خود پایتون نیست! برخی زبانها تنها یک روش برای نوشتن برنامهها ارائه میدهند — برای مثال، برنامهنویسی شیءگرا یا برنامهنویسی تابعی. در این میان، پایتون یک زبان چندپارادایمی است: طیفی از الگوهای کاربردی ممکن را ارائه میدهد که همگی به زیبایی در کنار یکدیگر کار میکنند. این امر پایتون را برای طیف وسیعی از موارد استفادهٔ بسیار متفاوت مناسب میسازد: مدیریت سیستم، علم داده، مهندسی یادگیری ماشین، توسعهٔ وب، یا صرفاً یادگیری برنامهنویسی. به همین ترتیب، میتوانید Keras را پایتونِ یادگیری عمیق در نظر بگیرید: زبانی کاربرپسند برای یادگیری عمیق که تنوعی از گردشکارها را برای پروفایلهای کاربری مختلف ارائه میدهد.
روشهای مختلف ساخت مدلهای Keras
Section titled “روشهای مختلف ساخت مدلهای Keras”سه API برای ساخت مدل در Keras وجود دارد، همانطور که در شکل ۷.۱ نشان داده شده است:
- مدل ترتیبی (Sequential model) قابلدسترسترین API است — اساساً یک لیست پایتون است. به این ترتیب، به پشتههای سادهای از لایهها محدود میشود.
- ایپیآی تابعی (Functional API) که بر معماریهای مدل گرافمانند تمرکز دارد. این ایپیآی نقطهٔ تعادل مناسبی بین کاربردپذیری و انعطافپذیری ارائه میدهد و به این ترتیب، پرکاربردترین API برای ساخت مدل است.
- زیرکلاسسازی مدل (Model subclassing) ، یک گزینهٔ سطح پایین که در آن همهچیز را خودتان از ابتدا مینویسید. این گزینه زمانی ایدهآل است که بخواهید کنترل کامل بر تکتک جزئیات ریز داشته باشید. با این حال، به بسیاری از ویژگیهای توکار Keras دسترسی نخواهید داشت و بیشتر در معرض خطر اشتباه کردن خواهید بود.
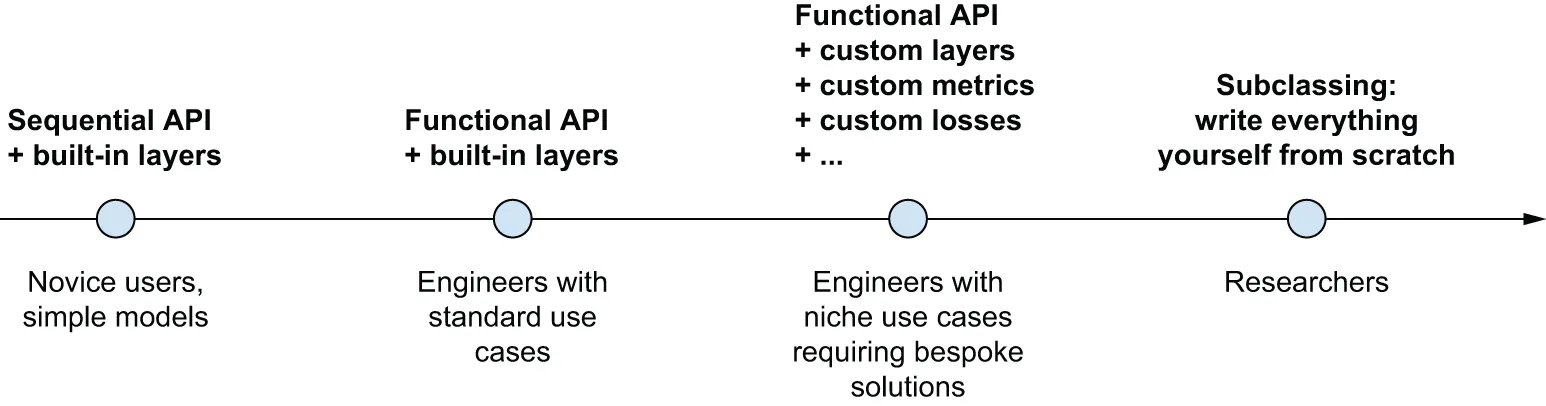
شکل ۷.۱: افشای تدریجی پیچیدگی برای ساخت مدل
مدل ترتیبی (Sequential)
Section titled “مدل ترتیبی (Sequential)”سادهترین راه برای ساخت مدل Keras، مدل Sequential است که از قبل با آن آشنایی دارید.
لیستینگ ۷.۱: کلاس Sequential
import kerasfrom keras import layers
model = keras.Sequential(    [        layers.Dense(64, activation="relu"),        layers.Dense(10, activation="softmax"),    ])
توجه داشته باشید که امکان ساخت همان مدل بهصورت تدریجی و گامبهگام از طریق متد add() وجود دارد، مشابه متد append() در یک لیست پایتون.
لیستینگ ۷.۲: ساخت گامبهگام یک مدل Sequential
model = keras.Sequential()model.add(layers.Dense(64, activation="relu"))model.add(layers.Dense(10, activation="softmax"))در فصل ۳ دیدید که لایهها تنها زمانی ساخته میشوند (یعنی وزنهای خود را ایجاد میکنند) که برای اولین بار فراخوانی شوند. دلیل آن این است که شکل وزنهای لایهها به شکل ورودی آنها بستگی دارد: تا زمانی که شکل ورودی مشخص نباشد، نمیتوان آنها را ایجاد کرد.
به این ترتیب، مدل Sequential قبلی هیچ وزنی ندارد تا زمانی که آن را واقعاً روی دادهها فراخوانی کنید، یا متد build() آن را با یک شکل ورودی صدا بزنید.
لیستینگ ۷.۳: مدلهایی که هنوز ساخته نشدهاند وزنی ندارند
>>> # At that point, the model isn't built yet.>>> model.weightsلیستینگ ۷.۴: فراخوانی مدل برای اولین بار جهت ساخت آن
>>> # Builds the model. Now the model will expect samples of shape>>> # (3,). The None in the input shape signals that the batch size>>> # could be anything.>>> model.build(input_shape=(None, 3))>>> # Now you can retrieve the model's weights.>>> model.weightsپس از ساخته شدن مدل، میتوانید محتویات آن را از طریق متد summary() نمایش دهید که برای اشکالزدایی بسیار مفید است.
لیستینگ ۷.۵: متد summary
>>> model.summary()همانطور که میبینید، نام مدل شما بهطور تصادفی sequential_1 شده است. در واقع میتوانید به همهچیز در Keras نام اختصاص دهید — به هر مدل و هر لایه.
لیستینگ ۷.۶: نامگذاری مدلها و لایهها با آرگومان name
>>> model = keras.Sequential(name="my_example_model")>>> model.add(layers.Dense(64, activation="relu", name="my_first_layer"))>>> model.add(layers.Dense(10, activation="softmax", name="my_last_layer"))>>> model.build((None, 3))>>> model.summary()هنگام ساخت گامبهگام یک مدل Sequential، این قابلیت که بتوان پس از افزودن هر لایه خلاصهٔ وضعیت فعلی مدل را چاپ کرد مفید است. اما شما نمیتوانید خلاصه را تا قبل از ساخته شدن مدل چاپ کنید! در واقع راهی وجود دارد تا مدل Sequential شما بهطور آنی ساخته شود: کافی است شکل ورودیهای مدل را از قبل اعلام کنید. این کار را میتوانید از طریق کلاس Input انجام دهید.
لیستینگ ۷.۷: مشخص کردن شکل ورودی مدل از قبل
model = keras.Sequential()# Use an Input to declare the shape of the inputs. Note that the shape# argument must be the shape of each sample, not the shape of one# batch.model.add(keras.Input(shape=(3,)))model.add(layers.Dense(64, activation="relu"))اکنون میتوانید با استفاده از summary() نحوهٔ تغییر شکل خروجی مدل خود را با افزودن لایههای بیشتر دنبال کنید:
>>> model.summary()این یک گردشکار اشکالزدایی بسیار رایج هنگام کار با لایههایی است که ورودیهای خود را به روشهای پیچیده تبدیل میکنند، مانند لایههای کانولوشنی که در فصل ۸ با آنها آشنا خواهید شد.
ایپیآی تابعی (Functional API)
Section titled “ایپیآی تابعی (Functional API)”استفاده از مدل Sequential آسان است، اما کاربرد آن بسیار محدود است: تنها میتواند مدلهایی با یک ورودی واحد و یک خروجی واحد را بیان کند که لایهها را یکی پس از دیگری بهصورت ترتیبی اعمال میکند. در عمل، مواجهه با مدلهایی با چند ورودی (مثلاً یک تصویر و فرادادهٔ آن)، چند خروجی (موارد متفاوتی که میخواهید دربارهٔ داده پیشبینی کنید)، یا یک توپولوژی غیرخطی بسیار متداول است.
در چنین مواردی، مدل خود را با استفاده از Functional API میسازید. این همان چیزی است که بیشتر مدلهای Keras در دنیای واقعی از آن استفاده میکنند. کار با آن لذتبخش و قدرتمند است — درست مانند بازی با بلوکهای لگو.
یک مثال ساده
Section titled “یک مثال ساده”بیایید با چیز سادهای شروع کنیم: همان پشتهٔ دولایهای که در بخش قبلی استفاده کردیم. نسخهٔ Functional API آن شبیه به لیستینگ زیر است.
لیستینگ ۷.۸: یک مدل تابعی ساده با دو لایهٔ Dense
inputs = keras.Input(shape=(3,), name="my_input")features = layers.Dense(64, activation="relu")(inputs)outputs = layers.Dense(10, activation="softmax")(features)model = keras.Model(inputs=inputs, outputs=outputs, name="my_functional_model")بیایید این را گامبهگام بررسی کنیم. با تعریف یک Input شروع کردیم (توجه داشته باشید که میتوانید مانند هر چیز دیگری به این شیءهای ورودی نیز نام اختصاص دهید):
inputs = keras.Input(shape=(3,), name="my_input")این شیء inputs اطلاعات مربوط به شکل و dtype دادههایی را که مدل پردازش خواهد کرد در خود نگه میدارد:
>>> # The model will process batches where each sample has shape (3,).>>> # The number of samples per batch is variable (indicated by the>>> # None batch size).>>> inputs.shapeما چنین شیئی را یک تانسور نمادین (symbolic tensor) مینامیم. این شیء حاوی هیچ دادهٔ واقعی نیست، اما مشخصات تانسورهای واقعی داده را که مدل هنگام استفاده مشاهده خواهد کرد رمزگذاری میکند. این شیء نمایندهٔ تانسورهای آیندهٔ داده است.
سپس، یک لایه ایجاد کردیم و آن را روی ورودی فراخوانی کردیم:
features = layers.Dense(64, activation="relu")(inputs)همهٔ لایههای Keras را میتوان هم روی تانسورهای واقعی داده و هم روی این تانسورهای نمادین فراخوانی کرد. در حالت دوم، آنها یک تانسور نمادین جدید با اطلاعات شکل و dtype بهروزشده بازمیگردانند:
>>> features.shapeپس از به دست آوردن خروجیهای نهایی، مدل را با مشخص کردن ورودیها و خروجیهای آن در سازندهٔ Model نمونهسازی کردیم:
outputs = layers.Dense(10, activation="softmax")(features)model = keras.Model(inputs=inputs, outputs=outputs, name="my_functional_model")در اینجا خلاصهٔ مدل ما آمده است:
>>> model.summary()مدلهای چندورودی، چندخروجی
Section titled “مدلهای چندورودی، چندخروجی”برخلاف این مدل اسباببازی، بیشتر مدلهای یادگیری عمیق شبیه لیست نیستند — آنها شبیه گراف هستند. برای مثال، ممکن است دارای چند ورودی یا چند خروجی باشند. دقیقاً برای همین نوع مدلها است که Functional API واقعاً میدرخشد.
فرض کنید در حال ساخت سیستمی برای اولویتبندی تیکتهای پشتیبانی مشتری و ارجاع آنها به بخش مربوطه هستید. مدل شما سه ورودی دارد:
- عنوان تیکت (ورودی متنی)
- متن اصلی تیکت (ورودی متنی)
- هرگونه برچسب (تگ) افزودهشده توسط کاربر (ورودی دستهای، که در اینجا فرض میشود بهصورت multi-hot کدگذاری شده است)
ما میتوانیم ورودیهای متنی را بهصورت آرایههایی از ۰ و ۱ به اندازهٔ vocabulary_size کدگذاری کنیم (برای اطلاعات دقیق دربارهٔ تکنیکهای کدگذاری متن به فصل ۱۴ مراجعه کنید).
مدل شما همچنین دو خروجی دارد:
- امتیاز اولویت تیکت، یک اسکالر بین ۰ و ۱ (خروجی سیگموئید)
- بخشی که باید به تیکت رسیدگی کند (یک سافتمکس روی مجموعهٔ بخشها)
میتوانید این مدل را در چند خط با Functional API بسازید.
لیستینگ ۷.۹: یک مدل تابعی چندورودی، چندخروجی
vocabulary_size = 10000num_tags = 100num_departments = 4
# Defines model inputstitle = keras.Input(shape=(vocabulary_size,), name="title")text_body = keras.Input(shape=(vocabulary_size,), name="text_body")tags = keras.Input(shape=(num_tags,), name="tags")
# Combines input features into a single tensor, features, by# concatenating themfeatures = layers.Concatenate()([title, text_body, tags])# Applies intermediate layer to recombine input features into richer# representationsfeatures = layers.Dense(64, activation="relu", name="dense_features")(features)
# Defines model outputspriority = layers.Dense(1, activation="sigmoid", name="priority")(features)department = layers.Dense(    num_departments, activation="softmax", name="department")(features)
# Creates the model by specifying its inputs and outputsmodel = keras.Model( inputs=[title, text_body, tags], outputs=[priority, department],)ایپیآی تابعی روشی ساده، لگومانند، و در عین حال بسیار منعطف برای تعریف گرافهای دلخواه از لایهها مانند این موارد است.
آموزش یک مدل چندورودی، چندخروجی
Section titled “آموزش یک مدل چندورودی، چندخروجی”شما میتوانید مدل خود را تقریباً به همان روشی که یک مدل Sequential را آموزش میدادید آموزش دهید، یعنی با فراخوانی fit() همراه با لیستهایی از دادههای ورودی و خروجی. این لیستهای داده باید همان ترتیبی را رعایت کنند که در ورودیهای ارائهشده به سازندهٔ Model() استفاده کردید.
لیستینگ ۷.۱۰: آموزش یک مدل با ارائهٔ لیستهایی از آرایههای ورودی و هدف
import numpy as np
num_samples = 1280
# Dummy input datatitle_data = np.random.randint(0, 2, size=(num_samples, vocabulary_size))text_body_data = np.random.randint(0, 2, size=(num_samples, vocabulary_size))tags_data = np.random.randint(0, 2, size=(num_samples, num_tags))
# Dummy target datapriority_data = np.random.random(size=(num_samples, 1))department_data = np.random.randint(0, num_departments, size=(num_samples, 1))
model.compile(    optimizer="adam",    loss=["mean_squared_error", "sparse_categorical_crossentropy"],    metrics=[["mean_absolute_error"], ["accuracy"]],)model.fit(    [title_data, text_body_data, tags_data],    [priority_data, department_data],    epochs=1,)model.evaluate(    [title_data, text_body_data, tags_data], [priority_data, department_data])priority_preds, department_preds = model.predict(    [title_data, text_body_data, tags_data])
اگر نمیخواهید به ترتیب ورودیها وابسته باشید (مثلاً به این دلیل که ورودیها یا خروجیهای زیادی دارید)، میتوانید از نامهایی که به شیءهای Input و لایههای خروجی دادهاید استفاده کنید و دادهها را از طریق دیکشنریها ارسال نمایید.
لیستینگ ۷.۱۱: آموزش یک مدل با ارائهٔ دیکشنریهایی از آرایههای ورودی و هدف
model.compile( optimizer="adam", loss={ "priority": "mean_squared_error", "department": "sparse_categorical_crossentropy", }, metrics={ "priority": ["mean_absolute_error"], "department": ["accuracy"], },)model.fit( {"title": title_data, "text_body": text_body_data, "tags": tags_data}, {"priority": priority_data, "department": department_data}, epochs=1,)model.evaluate( {"title": title_data, "text_body": text_body_data, "tags": tags_data}, {"priority": priority_data, "department": department_data},)priority_preds, department_preds = model.predict( {"title": title_data, "text_body": text_body_data, "tags": tags_data})قدرت ایپیآی تابعی: دسترسی به اتصالات لایهها
Section titled “قدرت ایپیآی تابعی: دسترسی به اتصالات لایهها”یک مدل تابعی یک ساختار دادهٔ گرافی صریح است. این امر امکان بررسی نحوهٔ اتصال لایهها و استفادهٔ مجدد از گرههای قبلی گراف (که خروجیهای لایه هستند) را به عنوان بخشی از مدلهای جدید فراهم میکند. همچنین بهخوبی با «مدل ذهنی» که اکثر پژوهشگران هنگام فکر کردن به یک شبکهٔ عصبی عمیق استفاده میکنند مطابقت دارد: گرافی از لایهها.
این ویژگی دو مورد استفادهٔ مهم را ممکن میسازد: بصریسازی مدل و استخراج ویژگی. بیایید نگاهی بیندازیم.
رسم نمودار اتصالات لایهها
Section titled “رسم نمودار اتصالات لایهها”بیایید اتصالات مدلی را که به تازگی تعریف کردیم بصریسازی کنیم (توپولوژی مدل). شما میتوانید یک مدل تابعی را مانند شکل ۷.۲ به عنوان یک گراف با ابزار کاربردی plot_model() رسم کنید:
keras.utils.plot_model(model, "ticket_classifier.png")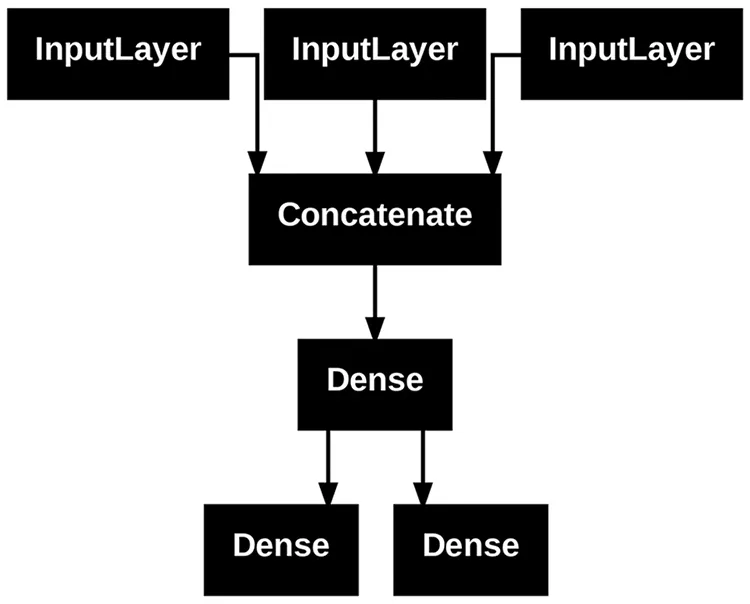
شکل ۷.۲: نمودار تولیدشده توسط plot_model() برای مدل طبقهبندیکنندهٔ تیکت ما
شما میتوانید شکلهای ورودی و خروجی هر لایه در مدل را همراه با نام لایهها (بهجای صرفاً انواع لایهها) به این نمودار اضافه کنید، که میتواند در طول اشکالزدایی مفید باشد (شکل ۷.۳):
keras.utils.plot_model( model, "ticket_classifier_with_shape_info.png", show_shapes=True, show_layer_names=True,)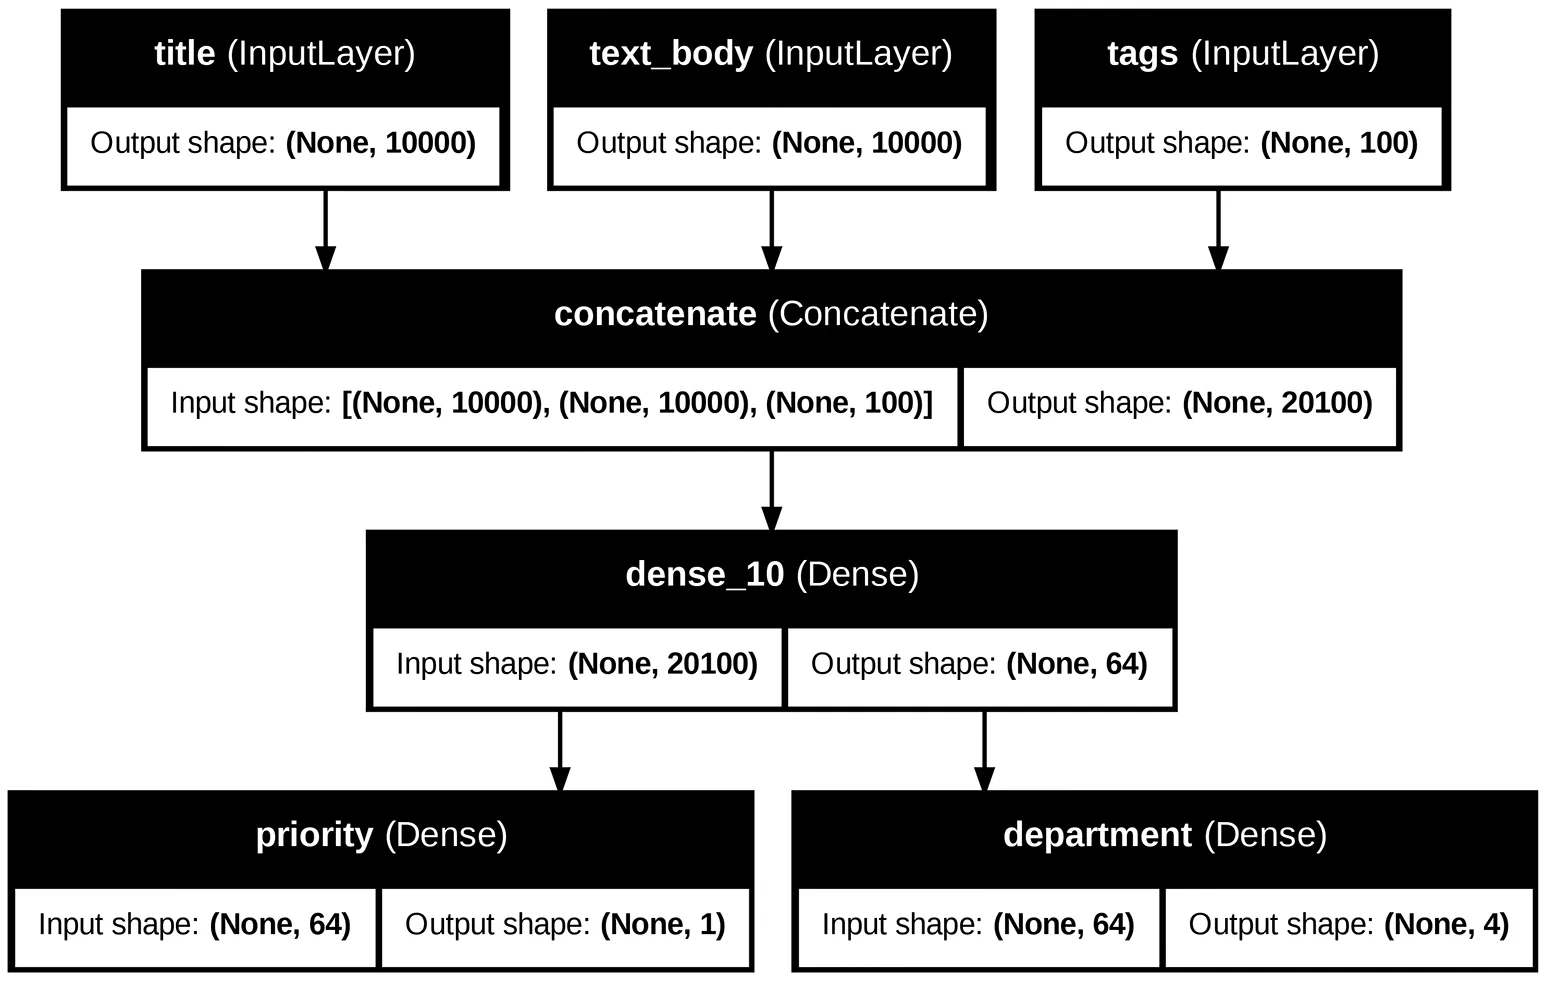
شکل ۷.۳: نمودار مدل همراه با اضافه شدن اطلاعات شکل دادهها
مقدار None در شکلهای تانسور نشاندهندهٔ اندازهٔ دسته (batch size) است: این مدل دستههایی با هر اندازهای را میپذیرد.
استخراج ویژگی با یک مدل تابعی
Section titled “استخراج ویژگی با یک مدل تابعی”دسترسی به اتصالات لایهها همچنین بدان معناست که میتوانید گرههای منفرد (فراخوانیهای لایه) را در گراف بازرسی کرده و مجدداً استفاده کنید. ویژگی model.layers در مدل لیستی از لایههای تشکیلدهندهٔ مدل را فراهم میکند، و برای هر لایه، میتوانید layer.input و layer.output را استعلام کنید.
لیستینگ ۷.۱۲: بازیابی ورودیها یا خروجیهای یک لایه در یک مدل تابعی
>>> model.layersاین امر شما را قادر به انجام استخراج ویژگی (feature extraction) میسازد: ایجاد مدلهایی که از ویژگیهای میانی یک مدل دیگر مجدداً استفاده میکنند.
فرض کنید میخواهید خروجی دیگری به مدلی که قبلاً تعریف کردیم اضافه کنید — میخواهید تخمینی از مدتزمان لازم برای حل یک تیکت مشکل معین را نیز پیشبینی کنید، نوعی رتبهبندی دشواری. شما میتوانید این کار را از طریق یک لایهٔ طبقهبندی روی سه دسته انجام دهید — «سریع»، «متوسط»، و «دشوار». نیازی نیست یک مدل را از ابتدا بازسازی کرده و دوباره آموزش دهید! میتوانید صرفاً از ویژگیهای میانی مدل قبلی خود شروع کنید، زیرا به آنها دسترسی دارید.
لیستینگ ۷.۱۳: ایجاد یک مدل جدید با استفادهٔ مجدد از خروجیهای لایهٔ میانی
# layers[4] is our intermediate Dense layer.features = model.layers[4].outputdifficulty = layers.Dense(3, activation="softmax", name="difficulty")(features)
new_model = keras.Model(    inputs=[title, text_body, tags], outputs=[priority, department, difficulty])
بیایید مدل جدید خود را رسم کنیم، همانطور که در شکل ۷.۴ نشان داده شده است:
keras.utils.plot_model( new_model, "updated_ticket_classifier.png", show_shapes=True, show_layer_names=True,)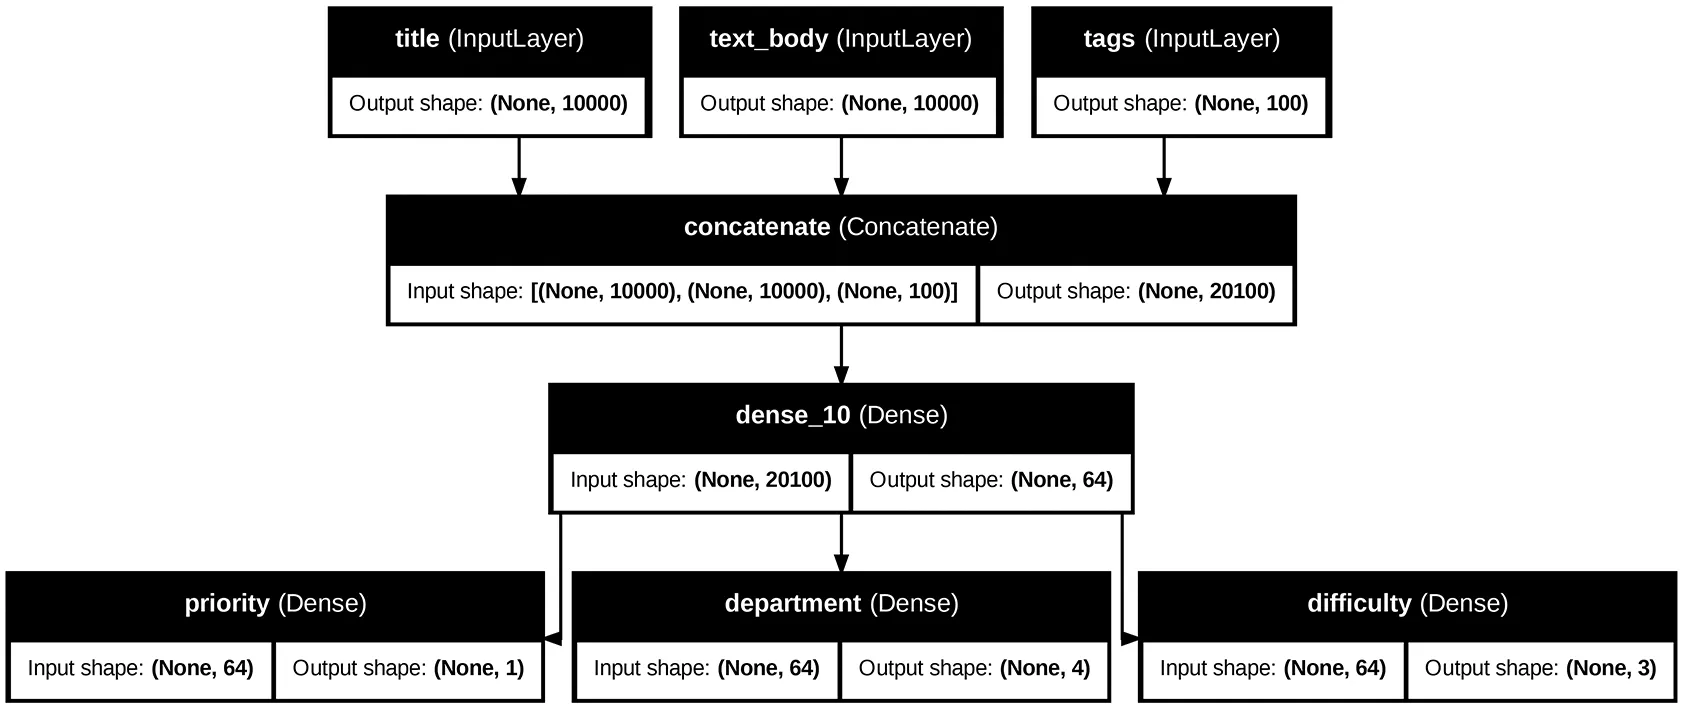
شکل ۷.۴: نمودار مدل جدید ما
زیرکلاسسازی کلاس Model
Section titled “زیرکلاسسازی کلاس Model”آخرین الگوی ساخت مدلی که باید بشناسید پیشرفتهترین الگو است: زیرکلاسسازی Model. شما قبلاً در فصل ۳ یاد گرفتهاید که چگونه از کلاس Layer برای ساخت لایههای سفارشی ارثبری کنید. زیرکلاسسازی Model بسیار مشابه است:
- در متد
__init__، لایههایی را که مدل استفاده خواهد کرد تعریف کنید. - در متد
call، گذر رو به جلو (forward pass) مدل را با استفادهٔ مجدد از لایههایی که قبلاً ایجاد شدهاند تعریف کنید. - از زیرکلاس خود نمونهسازی کنید و آن را روی دادهها فراخوانی کنید تا وزنهای آن ایجاد شوند.
بازنویسی مثال قبلیمان به عنوان یک مدل زیرکلاسشده
Section titled “بازنویسی مثال قبلیمان به عنوان یک مدل زیرکلاسشده”بیایید نگاهی به یک مثال ساده بیندازیم: ما مدل مدیریت تیکت پشتیبانی مشتری را با استفاده از یک زیرکلاس Model مجدداً پیادهسازی خواهیم کرد.
لیستینگ ۷.۱۴: یک مدل زیرکلاسشدهٔ ساده
class CustomerTicketModel(keras.Model):    def __init__(self, num_departments):        # Don't forget to call the super constructor!        super().__init__()        # Defines sublayers in the constructor        self.concat_layer = layers.Concatenate()        self.mixing_layer = layers.Dense(64, activation="relu")        self.priority_scorer = layers.Dense(1, activation="sigmoid")        self.department_classifier = layers.Dense(            num_departments, activation="softmax"        )
    # Defines the forward pass in the call() method    def call(self, inputs):        title = inputs["title"]        text_body = inputs["text_body"]        tags = inputs["tags"]
        features = self.concat_layer([title, text_body, tags])        features = self.mixing_layer(features)        priority = self.priority_scorer(features)        department = self.department_classifier(features)        return priority, department
پس از تعریف مدل، میتوانید آن را نمونهسازی کنید. توجه داشته باشید که تنها زمانی وزنهای خود را ایجاد میکند که برای اولین بار آن را روی دادهها فراخوانی کنید — دقیقاً مانند زیرکلاسهای Layer:
model = CustomerTicketModel(num_departments=4)
priority, department = model(    {"title": title_data, "text_body": text_body_data, "tags": tags_data})
تا اینجا، همهچیز بسیار شبیه به زیرکلاسسازی Layer به نظر میرسد، گردشکاری که قبلاً در فصل ۳ با آن روبرو شدید. پس تفاوت بین یک زیرکلاس Layer و یک زیرکلاس Model چیست؟ ساده است: یک لایه یک بلوک سازنده است که برای ساخت مدلها استفاده میکنید، و یک مدل شیء سطح بالایی است که در واقع آن را آموزش میدهید، برای استنتاج صادر میکنید و غیره. به طور خلاصه، یک Model دارای متدهای fit()، evaluate() و predict() است. لایهها این متدها را ندارند. به غیر از این، این دو کلاس عملاً یکسان هستند (تفاوت دیگر این است که میتوانید یک مدل را در فایلی روی دیسک ذخیره کنید — که در چند بخش آینده آن را پوشش خواهیم داد).
شما میتوانید یک زیرکلاس Model را دقیقاً مانند یک مدل ترتیبی یا تابعی کامپایل کرده و آموزش دهید:
model.compile( optimizer="adam", # The structure of what you pass as the loss and metrics must match # exactly what gets returned by call() — since we returned a list # of two elements, so should loss and metrics be lists of two # elements. loss=["mean_squared_error", "sparse_categorical_crossentropy"], metrics=[["mean_absolute_error"], ["accuracy"]],)model.fit( # The structure of the input data must match exactly what is # expected by the call() method, and the structure of the target # data must match exactly what gets returned by the call() method. # Here, the input data must be a dict with three keys (title, # text_body, and tags) and the target data must be a list of two # elements. {"title": title_data, "text_body": text_body_data, "tags": tags_data}, [priority_data, department_data], epochs=1,)model.evaluate( {"title": title_data, "text_body": text_body_data, "tags": tags_data}, [priority_data, department_data],)priority_preds, department_preds = model.predict( {"title": title_data, "text_body": text_body_data, "tags": tags_data})گردشکار زیرکلاسسازی Model منعطفترین راه برای ساخت یک مدل است: شما را قادر میسازد مدلهایی بسازید که نمیتوان آنها را بهعنوان گرافهای جهتدار بدون دور از لایهها بیان کرد — برای مثال، مدلی را تصور کنید که در آن متد call() از لایهها درون یک حلقهٔ for استفاده میکند، یا حتی آنها را بهصورت بازگشتی فراخوانی میکند. همهچیز ممکن است — کنترل در دست شماست.
مراقب باشید: آنچه مدلهای زیرکلاسشده پشتیبانی نمیکنند
Section titled “مراقب باشید: آنچه مدلهای زیرکلاسشده پشتیبانی نمیکنند”این آزادی هزینهای به همراه دارد: با مدلهای زیرکلاسشده، شما مسئول بخش بیشتری از منطق مدل هستید، که بدان معناست سطح خطای بالقوهٔ شما بسیار بزرگتر است. در نتیجه، کار اشکالزدایی بیشتری پیش رو خواهید داشت. شما در حال توسعهٔ یک شیء جدید پایتون هستید، نه صرفاً اتصال بلوکهای لگو به یکدیگر.
مدلهای تابعی و زیرکلاسشده همچنین از نظر ماهیت تفاوتهای اساسی دارند: یک مدل تابعی یک ساختار دادهٔ صریح است — گرافی از لایهها، که میتوانید آن را مشاهده، بازرسی و اصلاح کنید. در همین حال، یک مدل زیرکلاسشده قطعهای از بایتکد است — یک کلاس پایتون با یک متد call() که حاوی کد خام است. این امر منبع انعطافپذیری گردشکار زیرکلاسسازی است — شما میتوانید هر عملکردی را که دوست دارید کدنویسی کنید — اما محدودیتهای جدیدی ایجاد میکند.
برای مثال، از آنجا که نحوهٔ اتصال لایهها به یکدیگر در داخل بدنهٔ متد call() پنهان است، نمیتوانید به آن اطلاعات دسترسی داشته باشید. فراخوانی summary() اتصالات لایهها را نمایش نمیدهد، و نمیتوانید توپولوژی مدل را از طریق plot_model() رسم کنید. به همین ترتیب، اگر یک مدل زیرکلاسشده داشته باشید، نمیتوانید به گرههای گراف لایهها برای انجام استخراج ویژگی دسترسی پیدا کنید — زیرا اصلاً گرافی وجود ندارد. به محض اینکه مدل نمونهسازی شود، گذر رو به جلوی آن به یک جعبهسیاه کامل تبدیل میشود.
ترکیب و تطبیق مؤلفههای مختلف
Section titled “ترکیب و تطبیق مؤلفههای مختلف”نکتهٔ حائز اهمیت این است که انتخاب یکی از این الگوها — مدل Sequential، ایپیآی تابعی، یا زیرکلاسسازی Model — شما را از بقیه محروم نمیکند. همهٔ مدلها در Keras API میتوانند بهصورت روان با یکدیگر همکاری کنند، چه مدلهای ترتیبی باشند، چه مدلهای تابعی، یا مدلهای زیرکلاسشدهای که از ابتدا نوشته شدهاند. همهٔ آنها بخشی از همان طیف گردشکارها هستند. برای مثال، میتوانید از یک لایه یا مدل زیرکلاسشده در یک مدل تابعی استفاده کنید.
لیستینگ ۷.۱۵: ایجاد یک مدل تابعی که شامل یک مدل زیرکلاسشده است
class Classifier(keras.Model):    def __init__(self, num_classes=2):        super().__init__()        if num_classes == 2:            num_units = 1            activation = "sigmoid"        else:            num_units = num_classes            activation = "softmax"        self.dense = layers.Dense(num_units, activation=activation)
    def call(self, inputs):        return self.dense(inputs)
inputs = keras.Input(shape=(3,))features = layers.Dense(64, activation="relu")(inputs)outputs = Classifier(num_classes=10)(features)model = keras.Model(inputs=inputs, outputs=outputs)بهطور معکوس، میتوانید از یک مدل تابعی بهعنوان بخشی از یک لایه یا مدل زیرکلاسشده استفاده کنید.
لیستینگ ۷.۱۶: ایجاد یک مدل زیرکلاسشده که شامل یک مدل تابعی است
inputs = keras.Input(shape=(64,))outputs = layers.Dense(1, activation="sigmoid")(inputs)binary_classifier = keras.Model(inputs=inputs, outputs=outputs)
class MyModel(keras.Model):    def __init__(self, num_classes=2):        super().__init__()        self.dense = layers.Dense(64, activation="relu")        self.classifier = binary_classifier
    def call(self, inputs):        features = self.dense(inputs)        return self.classifier(features)
model = MyModel()
به یاد داشته باشید: از ابزار مناسب برای کار استفاده کنید
Section titled “به یاد داشته باشید: از ابزار مناسب برای کار استفاده کنید”شما دربارهٔ طیف گردشکارها برای ساخت مدلهای Keras یاد گرفتید، از سادهترین گردشکار — مدل Sequential — تا پیشرفتهترین آن، زیرکلاسسازی مدل. چه زمانی باید از یکی به جای دیگری استفاده کنید؟ هر کدام مزایا و معایب خود را دارند — مناسبترین گزینه را برای کار در دست انتخاب کنید.
به طور کلی، ایپیآی تابعی مصالحهٔ بسیار خوبی بین سهولت استفاده و انعطافپذیری برای شما فراهم میکند. همچنین به شما دسترسی مستقیم به اتصالات لایهها میدهد که برای مواردی مانند رسم مدل یا استخراج ویژگی بسیار قدرتمند است. اگر میتوانید از ایپیآی تابعی استفاده کنید — یعنی اگر مدل شما میتواند بهصورت یک گراف جهتدار بدون دور از لایهها بیان شود — توصیه میکنیم از آن به جای زیرکلاسسازی مدل استفاده کنید.
در ادامه، تمام مثالهای این کتاب از ایپیآی تابعی استفاده خواهند کرد — صرفاً به این دلیل که تمام مدلهایی که با آنها کار خواهیم کرد بهصورت گرافهایی از لایهها قابل بیان هستند. با این حال، ما مکرراً از لایههای زیرکلاسشده استفاده خواهیم کرد. بهطور کلی، استفاده از مدلهای تابعی که شامل لایههای زیرکلاسشده هستند بهترین مزایای هر دو دنیا را فراهم میکند: انعطافپذیری بالای توسعه همراه با حفظ مزایای ایپیآی تابعی.
استفاده از حلقههای توکار آموزش و ارزیابی
Section titled “استفاده از حلقههای توکار آموزش و ارزیابی”اصل افشای تدریجی پیچیدگی — دسترسی به طیفی از گردشکارها که از بسیار ساده تا منعطف با پیچیدگی دلخواه پیش میروند، گام به گام — در آموزش مدل نیز صدق میکند. Keras گردشکارهای مختلفی را برای آموزش مدلها در اختیار شما قرار میدهد — این کار میتواند به سادگیِ فراخوانی fit() روی دادههایتان باشد یا به پیشرفتگیِ نوشتن یک الگوریتم آموزشی کاملاً جدید از ابتدا.
شما قبلاً با گردشکار compile()، fit()، evaluate() و predict() آشنا شدهاید. جهت یادآوری، این گردشکار شبیه به لیستینگ زیر است.
لیستینگ ۷.۱۷: گردشکار استاندارد: compile()، fit()، evaluate()، predict()
from keras.datasets import mnist
# Creates a model. (We factor this into a separate function so as to# reuse it later.)def get_mnist_model():    inputs = keras.Input(shape=(28 * 28,))    features = layers.Dense(512, activation="relu")(inputs)    features = layers.Dropout(0.5)(features)    outputs = layers.Dense(10, activation="softmax")(features)    model = keras.Model(inputs, outputs)    return model
# Loads your data, reserving some for validation(images, labels), (test_images, test_labels) = mnist.load_data()images = images.reshape((60000, 28 * 28)).astype("float32") / 255test_images = test_images.reshape((10000, 28 * 28)).astype("float32") / 255train_images, val_images = images[10000:], images[:10000]train_labels, val_labels = labels[10000:], labels[:10000]
model = get_mnist_model()# Compiles the model by specifying its optimizer, the loss function to# minimize, and metrics to monitormodel.compile(    optimizer="adam",    loss="sparse_categorical_crossentropy",    metrics=["accuracy"],)# Uses `fit()` to train the model, optionally providing validation data# to monitor performance on unseen datamodel.fit(    train_images,    train_labels,    epochs=3,    validation_data=(val_images, val_labels),)# Uses `evaluate()` to compute the loss and metrics on new datatest_metrics = model.evaluate(test_images, test_labels)# Uses `predict()` to compute classification probabilities on new datapredictions = model.predict(test_images)
چندین روش برای سفارشیسازی این گردشکار ساده وجود دارد:
- ارائهٔ معیارهای سفارشی اختصاصی خودتان
- ارسال کالبکها (callbacks) به متد
fit()برای زمانبندی اقداماتی که باید در نقاط خاصی در طول آموزش انجام شوند
بیایید به این موارد نگاهی بیندازیم.
نوشتن معیارهای اختصاصی خودتان
Section titled “نوشتن معیارهای اختصاصی خودتان”معیارها کلید سنجش عملکرد مدل شما هستند — بهویژه برای اندازهگیری تفاوت بین عملکرد آن روی دادههای آموزشی و عملکرد آن روی دادههای آزمایش. معیارهای پرکاربرد برای طبقهبندی و رگرسیون از قبل بخشی از ماژول توکار keras.metrics هستند — در بیشتر مواقع، از همانها استفاده خواهید کرد. اما اگر کاری خارج از روال معمول انجام میدهید، باید بتوانید معیارهای اختصاصی خود را بنویسید. این کار ساده است!
یک معیار Keras زیرکلاسی از کلاس keras.metrics.Metric است. مشابه لایهها، یک معیار دارای وضعیتی داخلی است که در متغیرهای Keras ذخیره میشود. بر خلاف لایهها، این متغیرها از طریق پسانتشار بهروزرسانی نمیشوند، بنابراین باید منطق بهروزرسانی وضعیت را خودتان بنویسید — که در متد update_state() رخ میدهد. برای مثال، در اینجا یک معیار سفارشی ساده آورده شده است که ریشهٔ میانگین مربعات خطا (RMSE) را اندازهگیری میکند.
لیستینگ ۷.۱۸: پیادهسازی یک معیار سفارشی با زیرکلاسسازی کلاس Metric
from keras import ops
# Subclasses the Metric classclass RootMeanSquaredError(keras.metrics.Metric):    # Defines the state variables in the constructor. Like for layers,    # you have access to the add_weight() method.    def __init__(self, name="rmse", **kwargs):        super().__init__(name=name, **kwargs)        self.mse_sum = self.add_weight(name="mse_sum", initializer="zeros")        self.total_samples = self.add_weight(            name="total_samples", initializer="zeros"        )
    # Implements the state update logic in update_state(). The y_true    # argument is the targets (or labels) for one batch, while y_pred    # represents the corresponding predictions from the model. To match    # our MNIST model, we expect categorical predictions and integer    # labels. You can ignore the sample_weight argument; we won't use    # it here.    def update_state(self, y_true, y_pred, sample_weight=None):        y_true = ops.one_hot(y_true, num_classes=ops.shape(y_pred)[1])        mse = ops.sum(ops.square(y_true - y_pred))        self.mse_sum.assign_add(mse)        num_samples = ops.shape(y_pred)[0]        self.total_samples.assign_add(num_samples)
شما از متد result() برای بازگرداندن مقدار فعلی معیار استفاده میکنید:
def result(self): return ops.sqrt(self.mse_sum / self.total_samples)در عین حال، شما همچنین باید راهی برای بازنشانی وضعیت معیار بدون نیاز به نمونهسازی مجدد آن ارائه دهید — این امر امکان استفاده از همان شیءهای معیار را در دورههای مختلف آموزش یا در هر دو فرایند آموزش و ارزیابی فراهم میکند. این کار را در متد reset_state() انجام میدهید:
def reset_state(self): self.mse_sum.assign(0.) self.total_samples.assign(0.)معیارهای سفارشی را میتوان دقیقاً مانند معیارهای توکار استفاده کرد. بیایید معیار اختصاصی خود را آزمایش کنیم:
model = get_mnist_model()model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy", RootMeanSquaredError()],)model.fit( train_images, train_labels, epochs=3, validation_data=(val_images, val_labels),)test_metrics = model.evaluate(test_images, test_labels)اکنون میتوانید ببینید که نوار پیشرفت fit() مقدار RMSE مدل شما را نمایش میدهد.
استفاده از کالبکها
Section titled “استفاده از کالبکها”راهاندازی یک اجرای آموزشی روی یک مجموعهدادهٔ بزرگ برای دهها دوره با استفاده از model.fit() میتواند کمی شبیه به پرتاب یک موشک کاغذی باشد: پس از ضربهٔ اولیه، هیچ کنترلی بر مسیر حرکت یا نقطهٔ فرود آن ندارید. اگر میخواهید از نتایج نامطلوب (و در نتیجه هدر رفتن موشکهای کاغذی) جلوگیری کنید، هوشمندانهتر است که به جای موشک کاغذی، از یک پهپاد استفاده کنید که بتواند محیط خود را حس کند، دادهها را به اپراتور خود ارسال کند، و به طور خودکار بر اساس وضعیت فعلی خود تصمیمات هدایتی اتخاذ نماید. ایپیآی کالبکهای Keras به شما کمک میکند فراخوانی خود به model.fit() را از یک موشک کاغذی به یک پهپاد هوشمند و خودران تبدیل کنید که میتواند دروننگری کند و به طور پویا دست به عمل بزند.
یک کالبک (callback) شیئی است (یک نمونه کلاس که متدهای خاصی را پیادهسازی میکند) که در فراخوانی به fit() به مدل ارسال میشود و توسط مدل در نقاط مختلف در طول آموزش فراخوانی میگردد. این شیء به تمام دادههای موجود در مورد وضعیت مدل و عملکرد آن دسترسی دارد، و میتواند اقداماتی انجام دهد: قطع آموزش، ذخیرهٔ یک مدل، بارگذاری یک مجموعه وزن متفاوت، یا تغییر وضعیت مدل به شیوهای دیگر.
در اینجا چند مثال از روشهایی که میتوانید از کالبکها استفاده کنید آورده شده است:
- چکپوینتگذاری مدل (Model checkpointing) — ذخیرهٔ وضعیت فعلی مدل در نقاط مختلف در طول آموزش.
- توقف زودهنگام (Early stopping) — متوقف کردن آموزش زمانی که زیان اعتبارسنجی دیگر بهبود نمییابد (و البته، ذخیرهٔ بهترین مدلی که در طول آموزش به دست آمده است).
- تنظیم پویای مقدار پارامترهای مشخص در طول آموزش — مانند نرخ یادگیری بهینهساز.
- ثبت معیارهای آموزش و اعتبارسنجی در طول آموزش، یا بصریسازی بازنماییهای آموختهشده توسط مدل همزمان با بهروزرسانی آنها — نوار پیشرفت
fit()که با آن آشنایی دارید در واقع یک کالبک است!
ماژول keras.callbacks شامل تعدادی کالبک توکار است (این یک لیست جامع نیست):
keras.callbacks.ModelCheckpointkeras.callbacks.EarlyStoppingkeras.callbacks.LearningRateSchedulerkeras.callbacks.ReduceLROnPlateaukeras.callbacks.CSVLoggerبیایید دو مورد از آنها را بررسی کنیم تا ایدهای از نحوهٔ استفاده از آنها به دست آورید: EarlyStopping و ModelCheckpoint.
کالبکهای EarlyStopping و ModelCheckpoint
Section titled “کالبکهای EarlyStopping و ModelCheckpoint”هنگام آموزش یک مدل، چیزهای زیادی وجود دارد که نمیتوانید در ابتدا پیشبینی کنید. به ویژه، نمیتوانید بگویید چند دوره برای رسیدن به یک زیان اعتبارسنجی بهینه نیاز خواهد بود. مثالهای ما تاکنون این استراتژی را در پیش گرفتهاند که برای دورههای کافی آموزش داده شوند تا بیشبرازش آغاز شود، از اولین اجرا برای تعیین تعداد دورههای بهینه استفاده کنند، و سپس در نهایت یک اجرای آموزشی جدید را از ابتدا با استفاده از این تعداد بهینه آغاز نمایند. البته این رویکرد همراه با اتلاف منابع است. روشی بسیار بهتر برای مدیریت این موضوع، متوقف کردن آموزش زمانی است که متوجه میشوید زیان اعتبارسنجی دیگر بهبود نمییابد. این کار را میتوان با استفاده از کالبک EarlyStopping انجام داد.
کالبک EarlyStopping آموزش را به محض اینکه یک معیار هدف تحت نظارت برای تعداد مشخصی دوره متوقف شود قطع میکند. برای مثال، این کالبک به شما امکان میدهد به محض شروع بیشبرازش، آموزش را متوقف کنید، و در نتیجه از نیاز به آموزش مجدد مدل خود برای تعداد دورههای کمتر جلوگیری نمایید. این کالبک معمولاً در ترکیب با ModelCheckpoint استفاده میشود، که به شما امکان میدهد مدل را به طور مداوم در طول آموزش ذخیره کنید (و در صورت تمایل، تنها بهترین مدل فعلی تاکنون را ذخیره نمایید: نسخهای از مدل که در پایان یک دوره به بهترین عملکرد دست یافته است).
لیستینگ ۷.۱۹: استفاده از آرگومان callbacks در متد fit()
# Callbacks are passed to the model via the callbacks argument in# fit(), which takes a list of callbacks. You can pass any number of# callbacks.callbacks_list = [ # Interrupts training when improvement stops keras.callbacks.EarlyStopping( # Monitors the model's validation accuracy monitor="accuracy", # Interrupts training when accuracy has stopped improving for # more than one epoch (that is, two epochs) patience=1, ), # Saves the current weights after every epoch keras.callbacks.ModelCheckpoint( # Path to the destination model file filepath="checkpoint_path.keras", # These two arguments mean you won't overwrite the model file # unless val_loss has improved, which allows you to keep the # best model seen during training. monitor="val_loss", save_best_only=True, ),]model = get_mnist_model()model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", # You monitor accuracy, so it should be part of the model's # metrics. metrics=["accuracy"],)# Because the callback will monitor validation loss and validation# accuracy, you need to pass validation_data to the call to fit().model.fit( train_images, train_labels, epochs=10, callbacks=callbacks_list, validation_data=(val_images, val_labels),)توجه داشته باشید که همیشه میتوانید مدلها را پس از آموزش نیز به صورت دستی ذخیره کنید — کافی است model.save("my_checkpoint_path.keras") را فراخوانی کنید. برای بارگذاری مجدد مدلی که ذخیره کردهاید، از دستور زیر استفاده کنید:
model = keras.models.load_model("checkpoint_path.keras")نوشتن کالبکهای اختصاصی خودتان
Section titled “نوشتن کالبکهای اختصاصی خودتان”اگر لازم است اقدامی خاص را در طول آموزش انجام دهید که توسط یکی از کالبکهای توکار پوشش داده نشده است، میتوانید کالبک اختصاصی خود را بنویسید. کالبکها با زیرکلاسسازی کلاس keras.callbacks.Callback پیادهسازی میشوند. سپس میتوانید هر تعداد از متدهای زیر با نامگذاریهای روشن و شفاف را پیادهسازی کنید، که در نقاط مختلف در طول آموزش فراخوانی میشوند:
# Called at the start of every epochon_epoch_begin(epoch, logs)# Called at the end of every epochon_epoch_end(epoch, logs)# Called right before processing each batchon_batch_begin(batch, logs)# Called right after processing each batchon_batch_end(batch, logs)# Called at the start of trainingon_train_begin(logs)# Called at the end of trainingon_train_end(logs)همهٔ این متدها با یک آرگومان logs فراخوانی میشوند، که دیکشنری حاوی اطلاعات مربوط به دسته، دوره، یا اجرای آموزشی قبلی است: معیارهای آموزش و اعتبارسنجی، و غیره. متدهای on_epoch_* و on_batch_* همچنین اندیس دوره یا دسته را به عنوان آرگومان اول (یک عدد صحیح) دریافت میکنند.
در اینجا یک کالبک نمونهٔ ساده آورده شده است که لیستی از مقادیر زیان به ازای هر دسته را در طول آموزش ذخیره میکند و این مقادیر را در پایان هر دوره رسم مینماید.
لیستینگ ۷.۲۰: ایجاد یک کالبک سفارشی با زیرکلاسسازی کلاس Callback
from matplotlib import pyplot as plt
class LossHistory(keras.callbacks.Callback):    def on_train_begin(self, logs):        self.per_batch_losses = []
    def on_batch_end(self, batch, logs):        self.per_batch_losses.append(logs.get("loss"))
    def on_epoch_end(self, epoch, logs):        plt.clf()        plt.plot(            range(len(self.per_batch_losses)),            self.per_batch_losses,            label="Training loss for each batch",        )        plt.xlabel(f"Batch (epoch {epoch})")        plt.ylabel("Loss")        plt.legend()        plt.savefig(f"plot_at_epoch_{epoch}", dpi=300)        self.per_batch_losses = []
بیایید آن را آزمایش کنیم:
model = get_mnist_model()model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)model.fit( train_images, train_labels, epochs=10, callbacks=[LossHistory()], validation_data=(val_images, val_labels),)ما نمودارهایی دریافت میکنیم که شبیه شکل ۷.۵ هستند.
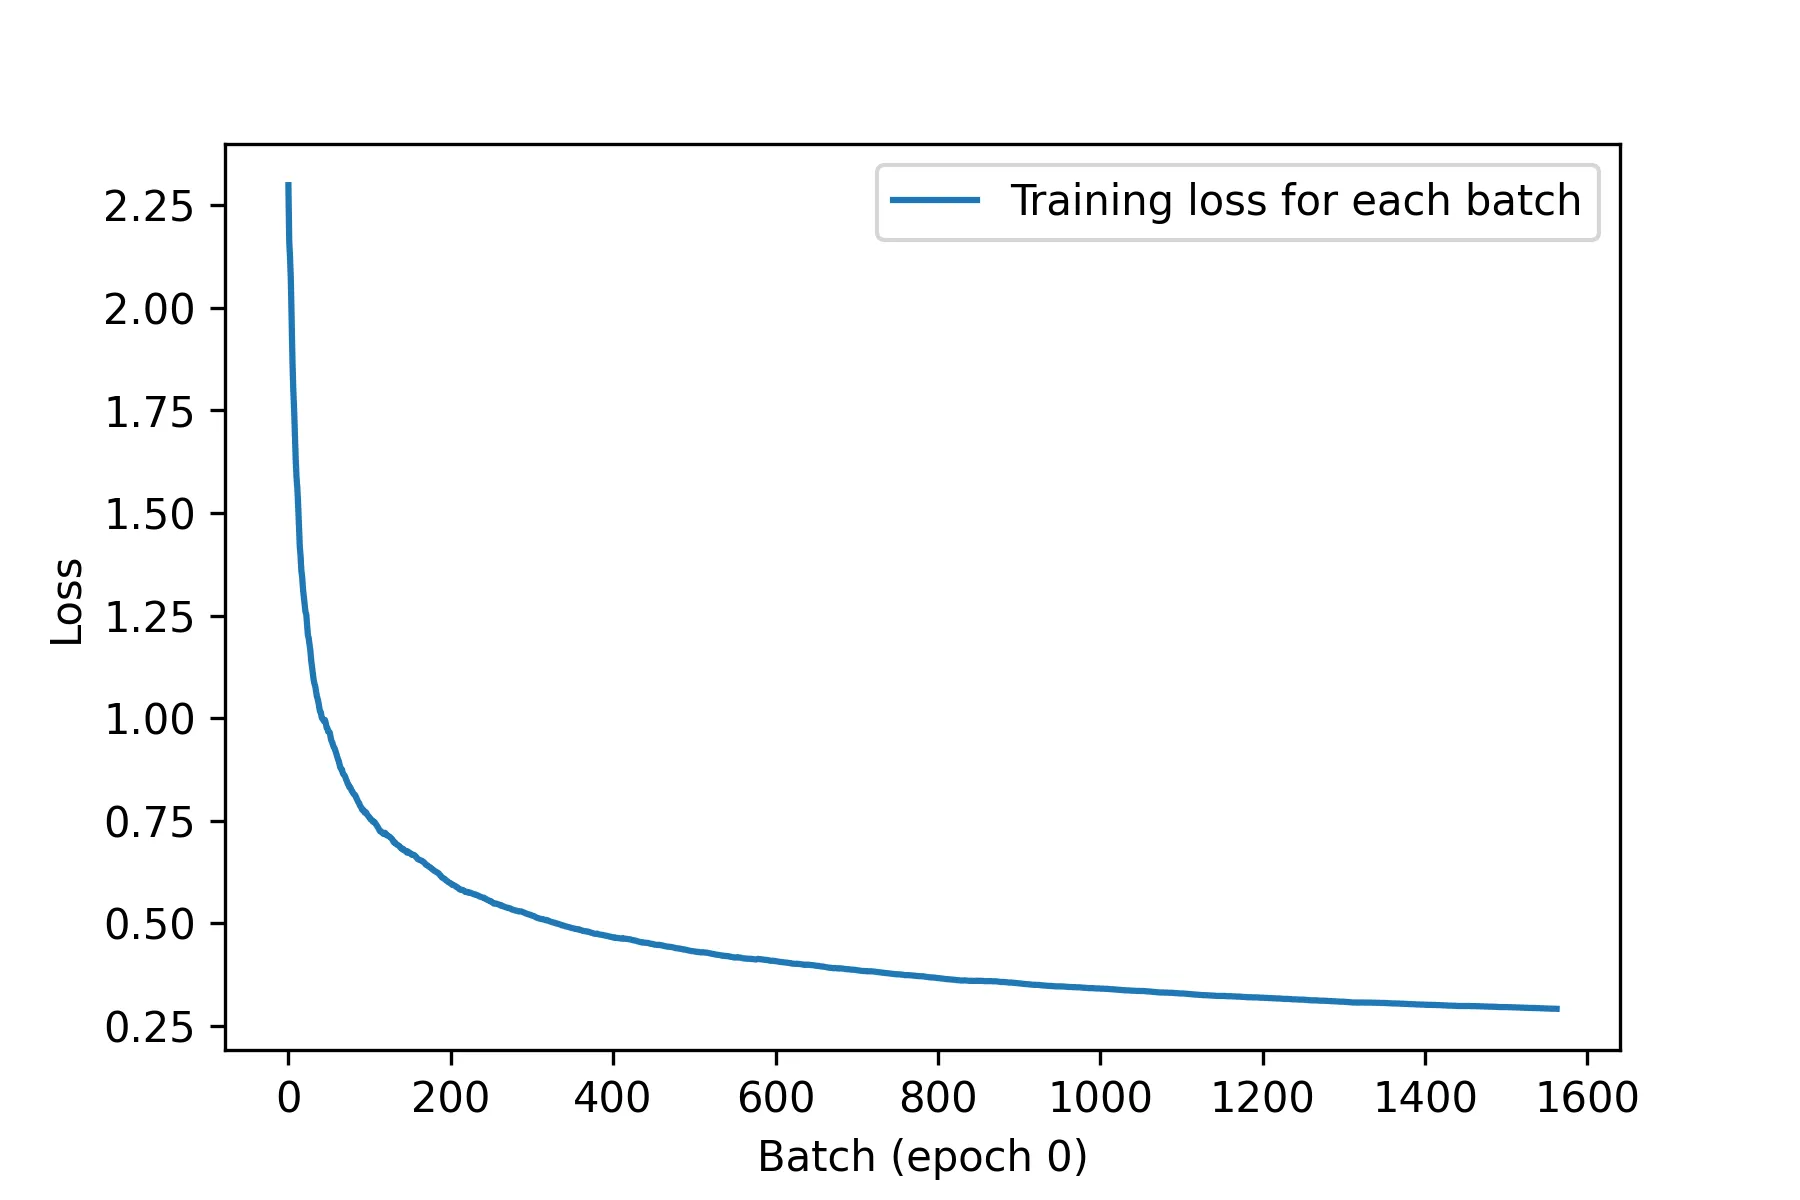
شکل ۷.۵: خروجی کالبک سفارشی ما برای رسم تاریخچه
نظارت و بصریسازی با TensorBoard
Section titled “نظارت و بصریسازی با TensorBoard”برای انجام پژوهش خوب یا توسعهٔ مدلهای خوب، به بازخوردهای مکرر و غنی دربارهٔ آنچه درون مدلهایتان در طول آزمایشها رخ میدهد نیاز دارید. هدف از اجرای آزمایشها همین است: کسب اطلاعات دربارهٔ میزان کارایی یک مدل — تا جای ممکن بیشترین اطلاعات. پیشرفت کردن یک فرایند تکرارشونده و یک حلقه است: شما با یک ایده شروع میکنید و آن را به صورت یک آزمایش بیان مینمایید، در تلاش برای اعتبارسنجی یا رد ایدهٔ خود. این آزمایش را اجرا میکنید و اطلاعات تولیدشده توسط آن را پردازش مینمایید، همانطور که در شکل ۷.۶ نشان داده شده است. این امر الهامبخش ایدهٔ بعدی شما میشود. هر چه تکرارهای بیشتری از این حلقه را بتوانید اجرا کنید، ایدههای شما دقیقتر و قدرتمندتر میشوند. Keras به شما کمک میکند در کمترین زمان ممکن از ایده به آزمایش برسید، و GPUهای سریع میتوانند به شما کمک کنند در سریعترین زمان ممکن از آزمایش به نتیجه دست یابید. اما در مورد پردازش نتایج آزمایش چطور؟ اینجاست که TensorBoard وارد میشود.
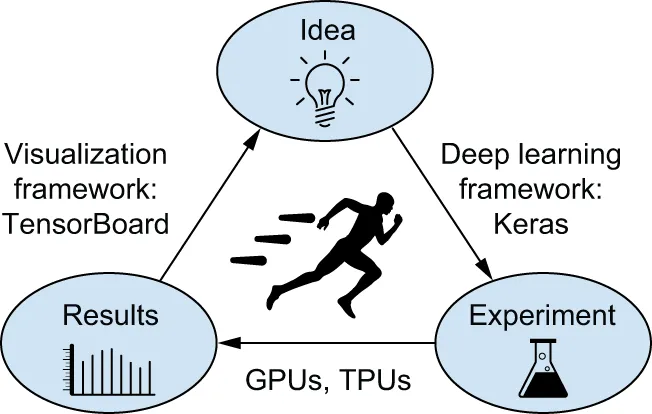
شکل ۷.۶: حلقهٔ پیشرفت
ابزار TensorBoard یک برنامهٔ مبتنی بر مرورگر است که میتوانید آن را به صورت محلی اجرا کنید. این ابزار بهترین راه برای نظارت بر هر آنچه در طول آموزش درون مدل شما اتفاق میافتد است. با TensorBoard میتوانید:
- معیارها را به صورت بصری در طول آموزش نظارت کنید
- معماری مدل خود را بصریسازی کنید
- هیستوگرامهای فعالسازیها و گرادیانها را بصریسازی نمایید
- جاسازیها (embeddings) را به صورت سهبعدی کاوش کنید
اگر اطلاعات بیشتری نسبت به صرفاً زیان نهایی مدل را رصد کنید، میتوانید دید واضحتری نسبت به کارهایی که مدل انجام میدهد و انجام نمیدهد پیدا کنید، و میتوانید سریعتر پیشرفت نمایید.
سادهترین راه برای استفاده از TensorBoard همراه با یک مدل Keras و متد fit()، کالبک keras.callbacks.TensorBoard است. در سادهترین حالت، کافی است مشخص کنید که میخواهید کالبک لاگها را در کجا بنویسد، و آمادهٔ حرکت هستید:
model = get_mnist_model()model.compile(    optimizer="adam",    loss="sparse_categorical_crossentropy",    metrics=["accuracy"],)
tensorboard = keras.callbacks.TensorBoard(    log_dir="/full_path_to_your_log_dir",)model.fit(    train_images,    train_labels,    epochs=10,    validation_data=(val_images, val_labels),    callbacks=[tensorboard],)
به محض اینکه مدل شروع به اجرا کند، لاگها را در مکان هدف خواهد نوشت. اگر اسکریپت پایتون خود را روی یک سیستم محلی اجرا میکنید، میتوانید سپس سرور محلی TensorBoard را با استفاده از دستور زیر راهاندازی کنید (توجه داشته باشید که فایل اجرایی tensorboard اگر TensorFlow را از طریق pip نصب کرده باشید باید از قبل در دسترس باشد؛ در غیر این صورت، میتوانید TensorBoard را به صورت دستی از طریق pip install tensorboard نصب کنید):
tensorboard --logdir /full_path_to_your_log_dirسپس میتوانید به نشانی URL که دستور برمیگرداند مراجعه کنید تا به رابط کاربری TensorBoard دسترسی پیدا کنید.
اگر اسکریپت خود را در یک نوتبوک Colab اجرا میکنید، میتوانید یک نمونهٔ تعبیهشدهٔ TensorBoard را به عنوان بخشی از نوتبوک خود با استفاده از دستورهای زیر اجرا کنید:
%load_ext tensorboard%tensorboard --logdir /full_path_to_your_log_dirدر رابط کاربری TensorBoard، قادر خواهید بود نمودارهای زنده از معیارهای آموزش و ارزیابی خود را نظارت کنید، همانطور که در شکل ۷.۷ نشان داده شده است.
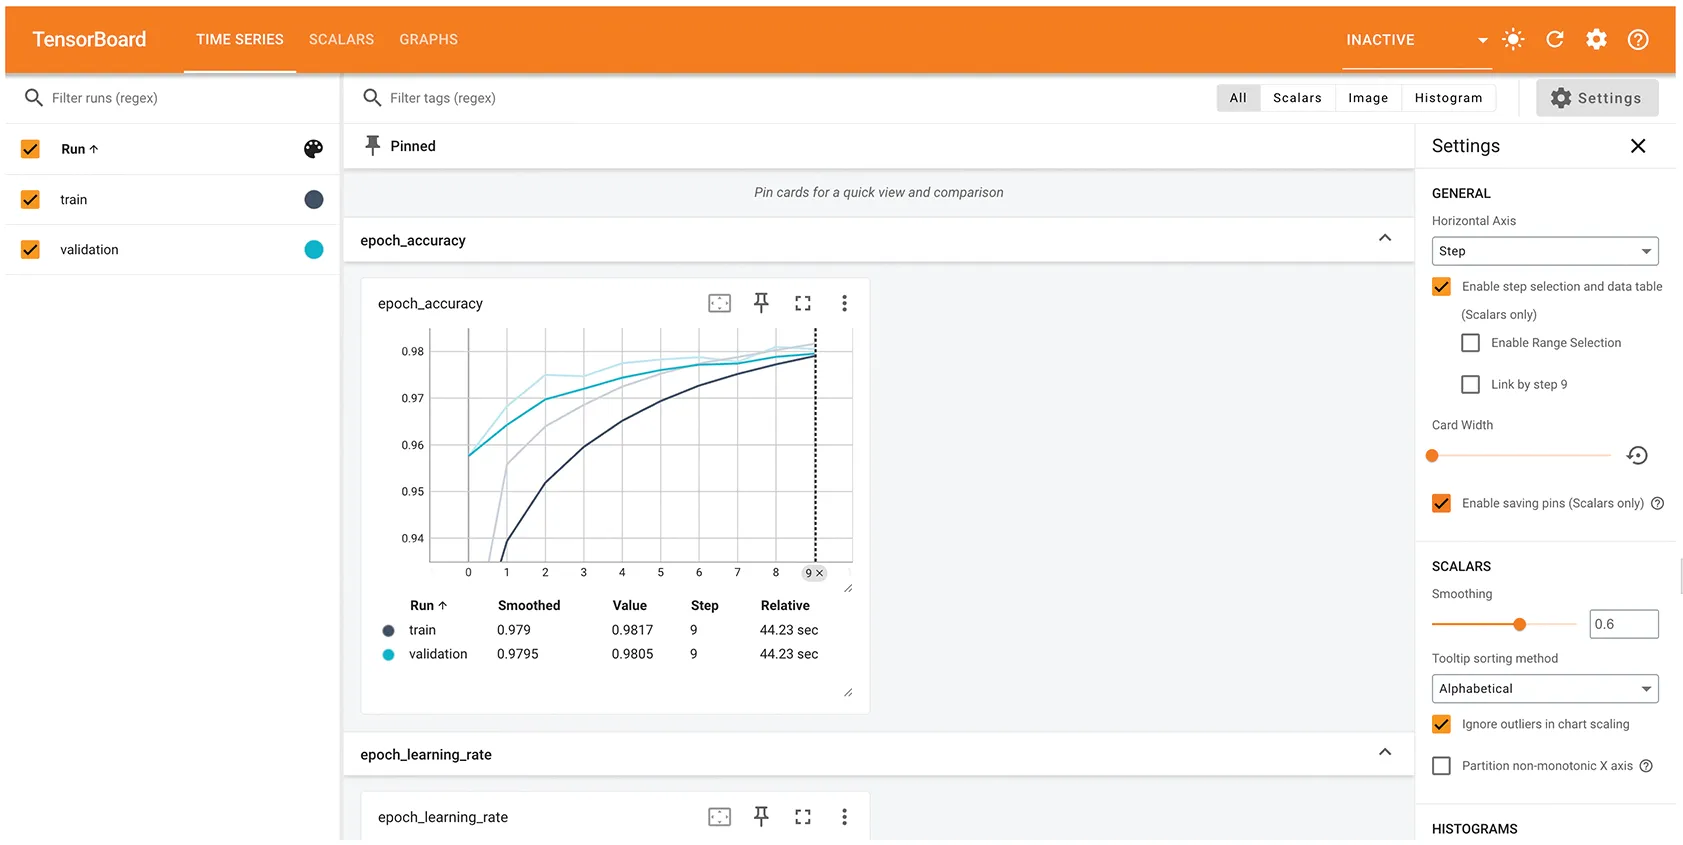
شکل ۷.۷: از TensorBoard میتوان برای نظارت آسان بر معیارهای آموزش و ارزیابی استفاده کرد.
نوشتن حلقههای آموزش و ارزیابی اختصاصی خودتان
Section titled “نوشتن حلقههای آموزش و ارزیابی اختصاصی خودتان”گردشکار fit() تعادل بسیار خوبی بین سهولت استفاده و انعطافپذیری برقرار میکند. این همان چیزی است که بیشتر اوقات از آن استفاده خواهید کرد. با این حال، قرار نیست از هر کاری که ممکن است یک پژوهشگر یادگیری عمیق بخواهد انجام دهد پشتیبانی کند — حتی با معیارهای سفارشی، زیانهای سفارشی، و کالبکهای سفارشی.
در نهایت، گردشکار توکار fit() صرفاً بر یادگیری با نظارت متمرکز است: ساختاری که در آن هدفها (که برچسبها یا حاشیهنویسیها نیز نامیده میشوند) مشخص و مرتبط با دادههای ورودی شما وجود دارند و شما تابع زیان خود را به عنوان تابعی از این هدفها و پیشبینیهای مدل محاسبه میکنید. با این حال، هر شکلی از یادگیری ماشین در این دسته قرار نمیگیرد. ساختارهای دیگری وجود دارند که در آنها هیچ هدف صریحی وجود ندارد، مانند یادگیری مولد (که در فصل ۱۶ معرفی خواهیم کرد)، یادگیری خودنظارتی (جایی که هدفها از خود ورودیها به دست میآیند)، یا یادگیری تقویتی (که در آن یادگیری توسط «پاداشهای» گاهبهگاه هدایت میشود — درست مانند آموزش دادن به یک سگ). و حتی اگر در حال انجام یادگیری بانظارت معمولی باشید، به عنوان یک پژوهشگر ممکن است بخواهید امکانات و نوآوریهای جدیدی اضافه کنید که نیازمند انعطافپذیری سطح پایین هستند.
هر زمان که خود را در وضعیتی یافتید که در آن fit() توکار کافی نیست، باید منطق آموزشی سفارشی خود را بنویسید. شما قبلاً مثالهای سادهای از حلقههای آموزشی سطح پایین را در فصلهای ۲ و ۳ دیدهاید. جهت یادآوری، محتویات یک حلقهٔ آموزشی معمولی به این صورت است:
- اجرای «گذر رو به جلو» (محاسبهٔ خروجی مدل) برای به دست آوردن مقدار زیان برای دستهٔ فعلی دادهها.
- بازیابی گرادیانهای تابع زیان نسبت به وزنهای مدل.
- بهروزرسانی وزنهای مدل به منظور کاهش مقدار زیان روی دستهٔ فعلی دادهها.
این مراحل برای هر تعداد دسته که لازم باشد تکرار میشوند. این اساساً همان کاری است که fit() در پشت صحنه انجام میدهد. در این بخش، یاد خواهید گرفت که fit() را از ابتدا دوباره پیادهسازی کنید، که تمام دانش لازم برای نوشتن هر الگوریتم آموزشی را که ممکن است به ذهنتان برسد در اختیارتان قرار میدهد.
بیایید جزئیات را مرور کنیم. در طول چند بخش آینده، شما گام به گام تا نوشتن یک حلقهٔ آموزشی سفارشی کامل در TensorFlow، PyTorch و JAX پیش خواهید رفت.
آموزش در برابر استنتاج
Section titled “آموزش در برابر استنتاج”در مثالهای حلقهٔ آموزش سطح پایین که تاکنون دیدهاید، مرحلهٔ ۱ (گذر رو به جلو) از طریق predictions = model(inputs) انجام میشد، و مرحلهٔ ۲ (بازیابی گرادیانهای محاسبهشده توسط نوار گرادیان) از طریق یک API اختصاصی بکاند صورت میگرفت، مانند:
gradients = tape.gradient(loss, model.weights)در TensorFlowloss.backward()در PyTorchjax.value_and_grad()در JAX
در حالت کلی، در واقع دو نکتهٔ ظریف وجود دارد که باید در نظر بگیرید.
برخی از لایههای Keras، مانند لایهٔ Dropout، در طول فرایند آموزش و در طول فرایند استنتاج (زمانی که از آنها برای تولید پیشبینی استفاده میکنید) رفتارهای متفاوتی دارند. چنین لایههایی یک آرگومان بولی training را در متد call() خود ارائه میدهند. فراخوانی dropout(inputs, training=True) برخی از درایههای فعالسازی را حذف میکند، در حالی که فراخوانی dropout(inputs, training=False) هیچ کاری انجام نمیدهد. به عنوان تعمیمی از این موضوع، مدلهای تابعی و مدلهای ترتیبی نیز این آرگومان training را در متدهای call() خود ارائه میدهند. به یاد داشته باشید که هنگام فراخوانی یک مدل Keras در طول گذر رو به جلو، training=True را ارسال کنید! بنابراین گذر رو به جلوی ما به predictions = model(inputs, training=True) تبدیل میشود.
علاوه بر این، توجه داشته باشید که هنگام بازیابی گرادیانهای وزنهای مدل خود، نباید از model.weights استفاده کنید، بلکه باید از model.trainable_weights بهره ببرید. در واقع، لایهها و مدلها دارای دو نوع وزن هستند:
- وزنهای آموزشپذیر (Trainable weights) ، که قرار است از طریق پسانتشار برای به حداقل رساندن زیان مدل بهروزرسانی شوند، مانند کرنل (kernel) و بایاس (bias) یک لایهٔ
Dense. - وزنهای آموزشناپذیر (Non-trainable weights) ، که قرار است در طول گذر رو به جلو توسط لایههایی که مالک آنها هستند بهروزرسانی شوند. برای مثال، اگر میخواستید یک لایهٔ سفارشی شمارندهای از تعداد دستههایی که تاکنون پردازش کرده است نگه دارد، آن اطلاعات در یک وزن آموزشناپذیر ذخیره میشد و در هر دسته، لایهٔ شما شمارنده را یک واحد افزایش میداد.
در میان لایههای توکار Keras، تنها لایهای که دارای وزنهای آموزشناپذیر است، لایهٔ BatchNormalization است که در فصل ۹ آن را معرفی خواهیم کرد. لایهٔ BatchNormalization برای ردیابی اطلاعات مربوط به میانگین و انحراف معیار دادههایی که از آن عبور میکنند به وزنهای آموزشناپذیر نیاز دارد، تا تقریب آنلاینی از نرمالسازی ویژگیها (مفهومی که در فصلهای ۴ و ۶ با آن آشنا شدید) انجام دهد.
نوشتن توابع سفارشی گام آموزش
Section titled “نوشتن توابع سفارشی گام آموزش”با در نظر گرفتن این دو نکته، یک گام آموزش در یادگیری با نظارت در شبهکد به این صورت درمیآید:
def train_step(inputs, targets): # Runs the forward pass predictions = model(inputs, training=True) # Computes the loss for the current batch loss = loss_fn(targets, predictions) # Retrieves the gradients of the loss with regard to the model's # trainable weights This function doesn't actually exist! gradients = get_gradients_of(loss, wrt=model.trainable_weights) # Updates the model's trainable weights based on the gradients optimizer.apply(gradients, model.trainable_weights)این قطعهکد به جای کد واقعی، شبهکد است زیرا شامل یک تابع فرضی به نام get_gradients_of() است. در واقعیت، بازیابی گرادیانها به روشی انجام میشود که مختص بکاند فعلی شماست — JAX، TensorFlow یا PyTorch.
بیایید از آنچه در فصل ۳ دربارهٔ هر فریمورک یاد گرفتید برای پیادهسازی نسخهٔ واقعی این تابع train_step() استفاده کنیم. با TensorFlow و PyTorch شروع میکنیم زیرا این دو کار را نسبتاً ساده میکنند، بنابراین نقطهٔ شروع خوبی هستند. در پایان به سراغ JAX میرویم که به مراتب پیچیدهتر است.
تابع گام آموزش در TensorFlow
Section titled “تابع گام آموزش در TensorFlow”فریمورک TensorFlow به شما امکان میدهد کدی بنویسید که بسیار شبیه به قطعهکد شبهکد ما باشد. تنها تفاوت این است که گذر رو به جلوی شما باید درون یک دامنهٔ GradientTape انجام شود. سپس میتوانید از شیء tape برای بازیابی گرادیانها استفاده کنید:
import tensorflow as tf
model = get_mnist_model()loss_fn = keras.losses.SparseCategoricalCrossentropy()optimizer = keras.optimizers.Adam()
def train_step(inputs, targets):    # Opens a GradientTape    with tf.GradientTape() as tape:        # Runs the forward pass        predictions = model(inputs, training=True)        loss = loss_fn(targets, predictions)    # Retrieves the gradients from the tape    gradients = tape.gradient(loss, model.trainable_weights)    # Updates the model's trainable weights based on the gradients    optimizer.apply(gradients, model.trainable_weights)    return loss
بیایید آن را برای یک گام اجرا کنیم:
batch_size = 32inputs = train_images[:batch_size]targets = train_labels[:batch_size]loss = train_step(inputs, targets)به اندازهٔ کافی ساده بود! اکنون بیایید به سراغ PyTorch برویم.
تابع گام آموزش در PyTorch
Section titled “تابع گام آموزش در PyTorch”هنگامی که از بکاند PyTorch استفاده میکنید، تمام لایهها و مدلهای Keras شما از کلاس torch.nn.Module در PyTorch ارثبری میکنند و API بومی Module را ارائه میدهند. در نتیجه، مدل شما، وزنهای آموزشپذیر آن، و تانسور زیان همگی از یکدیگر آگاه هستند و از طریق سه متد با یکدیگر تعامل دارند: loss.backward()، weight.value.grad، و model.zero_grad().
جهت یادآوری از فصل ۳، مدل ذهنی که باید به خاطر داشته باشید به این شرح است:
- با هر گذر رو به جلو، PyTorch یک گراف محاسباتی یکباره میسازد که محاسبات انجامشده را ردیابی میکند.
- فراخوانی
.backward()روی هر گرهٔ اسکالر مشخص از این گراف (مانند تابع زیان شما) گراف را از آن گره به سمت عقب اجرا میکند و به طور خودکار یک ویژگیtensor.gradرا روی تمام تانسورهای درگیر (در صورتی کهrequires_grad=Trueداشته باشند) مقداردهی میکند، که حاوی گرادیان گرهٔ خروجی نسبت به آن تانسور است. به ویژه، ویژگیgradپارامترهای آموزشپذیر شما را پر میکند. - برای پاک کردن محتویات آن ویژگی
tensor.grad، بایدtensor.grad = Noneرا روی تمام تانسورهای خود فراخوانی کنید. از آنجا که انجام این کار به صورت جداگانه روی تکتک متغیرهای مدل کمی دشوار است، میتوانید به سادگی آن را در سطح مدل از طریقmodel.zero_grad()انجام دهید — فراخوانیzero_grad()به تمام متغیرهای ردیابیشده توسط مدل منتشر میشود. پاک کردن گرادیانها حیاتی است زیرا فراخوانیهایbackward()جمعپذیر (additive) هستند: اگر گرادیانها را در هر گام پاک نکنید، مقادیر گرادیان انباشته میشوند و آموزش پیش نخواهد رفت.
بیایید این مراحل را به هم متصل کنیم:
import torch
model = get_mnist_model()loss_fn = keras.losses.SparseCategoricalCrossentropy()optimizer = keras.optimizers.Adam()
def train_step(inputs, targets):    # Runs the forward pass    predictions = model(inputs, training=True)    loss = loss_fn(targets, predictions)    # Runs the backward pass, populating gradient values    loss.backward()    # Recovers the gradient associated with each trainable variable.    # That weight.value is the PyTorch tensor that contains the    # variable's value.    gradients = [weight.value.grad for weight in model.trainable_weights]    # Updates the model's trainable weights based on the gradients.    # This must be done in a no_grad() scope.    with torch.no_grad():        optimizer.apply(gradients, model.trainable_weights)    # Don't forget to clear the gradients!    model.zero_grad()    return loss
بیایید آن را برای یک گام اجرا کنیم:
batch_size = 32inputs = train_images[:batch_size]targets = train_labels[:batch_size]loss = train_step(inputs, targets)خیلی سخت نبود! اکنون، بیایید به سراغ JAX برویم.
تابع گام آموزش در JAX
Section titled “تابع گام آموزش در JAX”وقتی نوبت به کد آموزش سطح پایین میرسد، JAX به دلیل ماهیت کاملاً بدون وضعیت (stateless) خود، معمولاً پیچیدهترین مورد در میان سه بکاند است. بدون وضعیت بودن باعث میشود JAX عملکرد و مقیاسپذیری بسیار بالایی داشته باشد و برای کامپایل و بهینهسازیهای خودکار عملکرد بسیار مناسب باشد. با این حال، نوشتن کد بدون وضعیت مستلزم عبور از موانع مختلفی است.
از آنجا که تابع گرادیان از طریق فرا-برنامهنویسی (metaprogramming) به دست میآید، ابتدا باید تابعی را تعریف کنید که مقدار زیان شما را برمیگرداند. علاوه بر این، این تابع باید بدون وضعیت باشد، بنابراین باید تمام متغیرهایی را که قرار است استفاده کند به عنوان آرگومان دریافت نماید، و باید مقدار هر متغیری را که بهروزرسانی کرده است بازگرداند. آن وزنهای آموزشناپذیر را به یاد دارید که ممکن است در طول گذر رو به جلو اصلاح شوند؟ اینها همان متغیرهایی هستند که باید بازگردانیم.
برای آسانتر کردن کار با پارادایم برنامهنویسی بدون وضعیت JAX، مدلهای Keras یک متد گذر رو به جلوی بدون وضعیت را در دسترس قرار میدهند: متد stateless_call(). این متد دقیقاً مانند __call__ عمل میکند، با این تفاوت که:
- علاوه بر آرگومانهای
inputsوtraining، وزنهای آموزشپذیر و وزنهای آموزشناپذیر مدل را به عنوان ورودی دریافت میکند. - علاوه بر خروجیهای مدل، وزنهای آموزشناپذیر بهروزشدهٔ مدل را نیز برمیگرداند.
به این صورت عمل میکند:
outputs, non_trainable_weights = model.stateless_call( trainable_weights, non_trainable_weights, inputs)ما میتوانیم از stateless_call() برای پیادهسازی تابع زیان JAX خود استفاده کنیم. از آنجا که تابع زیان بهروزرسانیها را برای تمام متغیرهای آموزشناپذیر نیز محاسبه میکند، نام آن را compute_loss_and_updates() میگذاریم:
model = get_mnist_model()loss_fn = keras.losses.SparseCategoricalCrossentropy()
# Gradients are computed for the entries in the first argument# (trainable_variables here)def compute_loss_and_updates(    trainable_variables, non_trainable_variables, inputs, targets):    # Calls stateless_call    outputs, non_trainable_variables = model.stateless_call(        trainable_variables, non_trainable_variables, inputs, training=True    )    loss = loss_fn(targets, outputs)    # Returns the scalar loss value and the updated non-trainable    # weights    return loss, non_trainable_variables
هنگامی که این تابع compute_loss_and_updates() را در اختیار داریم، میتوانیم آن را به jax.value_and_grad ارسال کنیم تا محاسبات گرادیان را به دست آوریم:
import jax
grad_fn = jax.value_and_grad(fn)loss, gradients = grad_fn(...)
اکنون، فقط یک مشکل کوچک وجود دارد. هم jax.grad() و هم jax.value_and_grad() نیاز دارند که fn تنها یک مقدار اسکالر بازگرداند. تابع compute_loss_and_updates() ما به عنوان اولین خروجی خود یک مقدار اسکالر را بازمیگرداند، اما مقدار جدید وزنهای آموزشناپذیر را نیز برمیگرداند. آنچه در فصل ۳ یاد گرفتید را به خاطر دارید؟ راه حل ارسال آرگومان has_aux به grad() یا value_and_grad() است، به این شکل:
import jax
grad_fn = jax.value_and_grad(compute_loss_and_updates, has_aux=True)
به این صورت از آن استفاده میکنید:
(loss, non_trainable_weights), gradients = grad_fn( trainable_variables, non_trainable_variables, inputs, targets)بسیار خب، این مقدار زیادی از ویژگیهای خاص JAX بود. اما اکنون تقریباً همهچیزهایی را که برای سرهمبندی گام آموزشی JAX خود نیاز داریم در اختیار داریم. ما فقط به آخرین قطعهٔ پازل نیاز داریم: optimizer.apply().
هنگامی که اولین گام آموزشی پایهٔ خود را در TensorFlow در ابتدای فصل ۲ نوشتید، تابع گام بهروزرسانی نوشتید که به این شکل بود:
learning_rate = 1e-3
def update_weights(gradients, weights):    for g, w in zip(gradients, weights):        w.assign(w - g * learning_rate)
این متناظر با کاری است که بهینهساز keras.optimizers.SGD انجام میدهد. با این حال، هر بهینهساز دیگری در Keras API تا حدودی پیچیدهتر از آن است و متغیرهای کمکی را ردیابی میکند که به سرعت بخشیدن به آموزش کمک میکنند — به ویژه، بیشتر بهینهسازها از نوعی تکانه (momentum) استفاده میکنند که در فصل ۲ با آن آشنا شدید. این متغیرهای اضافی در هر گام از آموزش بهروزرسانی میشوند، و در دنیای JAX، این بدان معناست که شما باید به یک تابع بدون وضعیت دست پیدا کنید که این متغیرها را به عنوان آرگومان دریافت کرده و مقدار جدید آنها را بازگرداند.
برای آسان کردن این کار، Keras متد stateless_apply() را در همهٔ بهینهسازها در دسترس قرار میدهد. به این صورت عمل میکند:
trainable_variables, optimizer_variables = optimizer.stateless_apply( optimizer_variables, grads, trainable_variables)اکنون، اطلاعات کافی برای سرهمبندی یک گام آموزش سرتاسری در اختیار داریم:
optimizer = keras.optimizers.Adam()optimizer.build(model.trainable_variables)
# The state is part of the function arguments.def train_step(state, inputs, targets):    # Unpacks the state    (trainable_variables, non_trainable_variables, optimizer_variables) = state    # Computes gradients and updates to non-trainable variables    (loss, non_trainable_variables), grads = grad_fn(        trainable_variables, non_trainable_variables, inputs, targets    )    # Updates trainable variables and optimizer variables    trainable_variables, optimizer_variables = optimizer.stateless_apply(        optimizer_variables, grads, trainable_variables    )    return loss, (        # Returns the updated state alongside the loss        trainable_variables,        non_trainable_variables,        optimizer_variables,    )
بیایید آن را برای یک گام اجرا کنیم:
batch_size = 32inputs = train_images[:batch_size]targets = train_labels[:batch_size]
trainable_variables = [v.value for v in model.trainable_variables]non_trainable_variables = [v.value for v in model.non_trainable_variables]optimizer_variables = [v.value for v in optimizer.variables]
state = (trainable_variables, non_trainable_variables, optimizer_variables)loss, state = train_step(state, inputs, targets)
قطعاً کمی بیشتر از TensorFlow و PyTorch زحمت دارد، اما مزایای سرعت و مقیاسپذیری JAX بیش از اندازه این زحمت را جبران میکند.
در ادامه، بیایید نگاهی به عنصر مهم دیگری از یک حلقهٔ آموزشی سفارشی بیندازیم: معیارها (metrics).
استفادهٔ سطح پایین از معیارها
Section titled “استفادهٔ سطح پایین از معیارها”در یک حلقهٔ آموزش سطح پایین، احتمالاً میخواهید از معیارهای Keras (چه معیارهای سفارشی و چه معیارهای توکار) استفاده کنید. شما قبلاً با API معیارها آشنا شدهاید: کافی است update_state(y_true, y_pred) را برای هر دسته از هدفها و پیشبینیها فراخوانی کنید، و سپس از result() برای استعلام مقدار فعلی معیار استفاده نمایید:
from keras import ops
metric = keras.metrics.SparseCategoricalAccuracy()targets = ops.array([0, 1, 2])predictions = ops.array([[1, 0, 0], [0, 1, 0], [0, 0, 1]])metric.update_state(targets, predictions)current_result = metric.result()print(f"result: {current_result:.2f}")
شما همچنین ممکن است نیاز داشته باشید میانگین یک مقدار اسکالر، مانند زیان مدل را ردیابی کنید. میتوانید این کار را از طریق معیار keras.metrics.Mean انجام دهید:
values = ops.array([0, 1, 2, 3, 4])mean_tracker = keras.metrics.Mean()for value in values: mean_tracker.update_state(value)print(f"Mean of values: {mean_tracker.result():.2f}")به یاد داشته باشید زمانی که میخواهید نتایج فعلی را بازنشانی کنید (در ابتدای یک دورهٔ آموزشی یا در ابتدای ارزیابی) از metric.reset_state() استفاده کنید.
حال، اگر از JAX استفاده میکنید، متدهای اصلاحکنندهٔ وضعیت مانند update_state() یا reset() را نمیتوان درون یک تابع بدون وضعیت استفاده کرد. در عوض، میتوانید از API معیارهای بدون وضعیت استفاده کنید، که شبیه به متدهای model.stateless_call() و optimizer.stateless_apply() است که قبلاً با آنها آشنا شدید. در اینجا نحوهٔ کارکرد آن آمده است:
metric = keras.metrics.SparseCategoricalAccuracy()targets = ops.array([0, 1, 2])predictions = ops.array([[1, 0, 0], [0, 1, 0], [0, 0, 1]])
# Gets the metric's state variablesmetric_variables = metric.variables# Gets updated values for the metric's statemetric_variables = metric.stateless_update_state(    metric_variables, targets, predictions)# Computes the metric value corresponding to the current statecurrent_result = metric.stateless_result(metric_variables)print(f"result: {current_result:.2f}")
# Gets blank variable values for the metricmetric_variables = metric.stateless_reset_state()
استفاده از fit() همراه با یک حلقهٔ آموزش سفارشی
Section titled “استفاده از fit() همراه با یک حلقهٔ آموزش سفارشی”در بخشهای قبلی، ما منطق آموزشی خود را کاملاً از ابتدا مینوشتیم. انجام این کار بیشترین انعطافپذیری را برای شما فراهم میکند، اما کد زیادی مینویسید، در حالی که همزمان بسیاری از ویژگیهای راحت fit() را از دست میدهید، مانند کالبکها، بهینهسازیهای عملکرد، یا پشتیبانی توکار از آموزش توزیعشده.
چه میشود اگر به یک الگوریتم آموزشی سفارشی نیاز داشته باشید، اما همچنان بخواهید از قدرت حلقهٔ آموزش توکار Keras استفاده کنید؟ در واقع یک راه میانه بین fit() و یک حلقهٔ آموزشی که از ابتدا نوشته شده وجود دارد: میتوانید یک تابع گام آموزش سفارشی ارائه دهید و بقیه کار را به فریمورک بسپارید.
شما میتوانید این کار را با بازنویسی (override) متد train_step() در کلاس Model انجام دهید. این تابعی است که توسط fit() برای هر دسته از دادهها فراخوانی میشود. سپس قادر خواهید بود fit() را طبق معمول فراخوانی کنید — و در پشت صحنه الگوریتم یادگیری سفارشی شما اجرا خواهد شد.
به این صورت عمل میکند:
- یک کلاس جدید بسازید که از
keras.Modelارثبری میکند. - متد
train_step()را بازنویسی کنید. محتویات آن تقریباً مشابه آنچه در بخش قبل استفاده کردیم است. - یک دیکشنری بازگردانید که نامهای معیارها (شامل تابع زیان) را به مقدار فعلی آنها نگاشت میکند.
به موارد زیر توجه داشته باشید:
- این الگو مانع از ساخت مدلها با ایپیآی تابعی نمیشود. شما میتوانید این کار را چه در حال ساخت مدلهای
Sequentialباشید، چه مدلهای Functional API، و چه مدلهای زیرکلاسشده انجام دهید. - زمانی که
train_step()را بازنویسی میکنید نیازی به استفاده از دکوراتور@tf.functionیا@jax.jitندارید — فریمورک این کار را برای شما انجام میدهد.
سفارشیسازی fit() با TensorFlow
Section titled “سفارشیسازی fit() با TensorFlow”بیایید با کدنویسی یک گام آموزش سفارشی در TensorFlow شروع کنیم:
لیستینگ ۷.۲۱: سفارشیسازی fit(): نسخهٔ TensorFlow
import kerasfrom keras import layers
loss_fn = keras.losses.SparseCategoricalCrossentropy()# This metric object will be used to track the average of per-batch# losses during training and evaluation.loss_tracker = keras.metrics.Mean(name="loss")
class CustomModel(keras.Model):    # Overrides the train_step() method    def train_step(self, data):        inputs, targets = data        with tf.GradientTape() as tape:            # We use self(inputs, training=True) instead of            # model(inputs, training=True) since our model is the class            # itself.            predictions = self(inputs, training=True)            loss = loss_fn(targets, predictions)        gradients = tape.gradient(loss, self.trainable_weights)        self.optimizer.apply(gradients, self.trainable_weights)
        # Updates the loss tracker metric that tracks the average of        # the loss        loss_tracker.update_state(loss)        # Returns the average loss so far by querying the loss tracker        # metric        return {"loss": loss_tracker.result()}
    # Listing the loss tracker metric in the model.metrics property    # enables the model to automatically call reset_state() on it at    # the start of each epoch and at the start of a call to evaluate()    # — so you don't have to do it by hand. Any metric you would like    # to reset across epochs should be listed here.    @property    def metrics(self):        return [loss_tracker]
اکنون میتوانیم از مدل سفارشی خود نمونهسازی کنیم، آن را کامپایل کنیم (ما فقط بهینهساز را ارسال میکنیم، زیرا تابع زیان از قبل در خارج از مدل تعریف شده است)، و آن را طبق معمول با استفاده از fit() آموزش دهیم.
بیایید تعریف مدل را در تابع قابل استفادهٔ مجدد خود قرار دهیم:
def get_custom_model(): inputs = keras.Input(shape=(28 * 28,)) features = layers.Dense(512, activation="relu")(inputs) features = layers.Dropout(0.5)(features) outputs = layers.Dense(10, activation="softmax")(features) model = CustomModel(inputs, outputs) model.compile(optimizer=keras.optimizers.Adam()) return modelبیایید آن را امتحان کنیم:
model = get_custom_model()model.fit(train_images, train_labels, epochs=3)سفارشیسازی fit() با PyTorch
Section titled “سفارشیسازی fit() با PyTorch”در ادامه، نسخهٔ PyTorch:
import kerasfrom keras import layers
loss_fn = keras.losses.SparseCategoricalCrossentropy()loss_tracker = keras.metrics.Mean(name="loss")
class CustomModel(keras.Model):    def train_step(self, data):        inputs, targets = data        # Runs the forward pass        predictions = self(inputs, training=True)        loss = loss_fn(targets, predictions)
        # Retrieves the gradients        loss.backward()        trainable_weights = [v for v in self.trainable_weights]        gradients = [v.value.grad for v in trainable_weights]
        with torch.no_grad():            # Updates weights            self.optimizer.apply(gradients, trainable_weights)
        # Updates loss tracker metric        loss_tracker.update_state(loss)        # Returns the average loss so far by querying the loss tracker        # metric        return {"loss": loss_tracker.result()}
    @property    def metrics(self):        return [loss_tracker]
بیایید آن را امتحان کنیم:
model = get_custom_model()model.fit(train_images, train_labels, epochs=3)سفارشیسازی fit() با JAX
Section titled “سفارشیسازی fit() با JAX”در نهایت، بیایید نسخهٔ JAX را بنویسیم. ابتدا باید متد compute_loss_and_updates() را تعریف کنیم، مشابه تابع compute_loss_and_updates() که در مثال گام آموزش سفارشی خود استفاده کردیم:
import kerasfrom keras import layers
loss_fn = keras.losses.SparseCategoricalCrossentropy()
class CustomModel(keras.Model):    def compute_loss_and_updates(        self,        trainable_variables,        non_trainable_variables,        inputs,        targets,        training=False,    ):        predictions, non_trainable_variables = self.stateless_call(            trainable_variables,            non_trainable_variables,            inputs,            training=training,        )        loss = loss_fn(targets, predictions)        # Returns both the loss and the updated non-trainable variables        return loss, non_trainable_variables
توجه داشته باشید که بر خلاف دو بکاند دیگر، میانگین متحرک زیان را محاسبه نمیکنیم. در عوض، صرفاً مقدار زیان به ازای هر دسته را بازمیگردانیم، که کاربرد کمتری دارد. ما این کار را برای سادهسازی مدیریت وضعیت معیارها در مثال انجام میدهیم: اگر آن را اضافه میکردیم، کد بسیار طولانی میشد (در بخش بعدی دربارهٔ مدیریت معیارها یاد خواهید گرفت):
    def train_step(self, state, data):        # Unpacks the state. metrics_variables are part of it, although        # we won't use them here.        (            trainable_variables,            non_trainable_variables,            optimizer_variables,            metrics_variables,        ) = state        inputs, targets = data
        # Gets the gradient function        grad_fn = jax.value_and_grad(            self.compute_loss_and_updates, has_aux=True        )
        # Computes gradients and updates to non-trainable variables        (loss, non_trainable_variables), grads = grad_fn(            trainable_variables,            non_trainable_variables,            inputs,            targets,            training=True,        )
        # Updates trainable variables and optimizer variables        (            trainable_variables,            optimizer_variables,        ) = self.optimizer.stateless_apply(            optimizer_variables, grads, trainable_variables        )
        # We aren't computing a moving average of the loss, instead        # returning the per-batch value.        logs = {"loss": loss}        state = (            trainable_variables,            non_trainable_variables,            optimizer_variables,            metrics_variables,        )        # Returns metric logs and updated state variables        return logs, state
بیایید آن را آزمایش کنیم:
model = get_custom_model()model.fit(train_images, train_labels, epochs=3)مدیریت معیارها در یک train_step() سفارشی
Section titled “مدیریت معیارها در یک train_step() سفارشی”در نهایت، وضعیت loss و metrics که میتوانید به compile() ارسال کنید چگونه است؟ پس از فراخوانی compile()، به موارد زیر دسترسی پیدا میکنید:
self.compute_loss— این مورد تابع زیانی را که بهcompile()ارسال کردهاید با زیانهای منظمسازی (regularization) که ممکن است توسط لایههای خاصی اضافه شده باشند، ترکیب میکند.self.metrics— لیست معیارهایی که بهcompile()ارسال کردهاید. توجه داشته باشید که این لیست همچنین شامل معیاری است که زیان را ردیابی میکند.
مدیریت معیارهای train_step() با TensorFlow
Section titled “مدیریت معیارهای train_step() با TensorFlow”در اینجا نحوهٔ پیادهسازی آن با TensorFlow آورده شده است:
import kerasfrom keras import layers
class CustomModel(keras.Model):    def train_step(self, data):        inputs, targets = data        with tf.GradientTape() as tape:            predictions = self(inputs, training=True)            # Computes the loss via self.compute_loss            loss = self.compute_loss(y=targets, y_pred=predictions)
        gradients = tape.gradient(loss, self.trainable_weights)        self.optimizer.apply(gradients, self.trainable_weights)
        # Updates the model's metrics, including the one that tracks        # the loss        for metric in self.metrics:            if metric.name == "loss":                metric.update_state(loss)            else:                metric.update_state(targets, predictions)
        # Returns a dict mapping metric names to their current value        return {m.name: m.result() for m in self.metrics}
بیایید آن را امتحان کنیم:
def get_custom_model():    inputs = keras.Input(shape=(28 * 28,))    features = layers.Dense(512, activation="relu")(inputs)    features = layers.Dropout(0.5)(features)    outputs = layers.Dense(10, activation="softmax")(features)    model = CustomModel(inputs, outputs)    model.compile(        optimizer=keras.optimizers.Adam(),        loss=keras.losses.SparseCategoricalCrossentropy(),        metrics=[keras.metrics.SparseCategoricalAccuracy()],    )    return model
model = get_custom_model()model.fit(train_images, train_labels, epochs=3)
مدیریت معیارهای train_step() با PyTorch
Section titled “مدیریت معیارهای train_step() با PyTorch”و در اینجا نحوهٔ پیادهسازی آن با PyTorch آورده شده است — دقیقاً همان تغییرات کد است!
import kerasfrom keras import layers
class CustomModel(keras.Model):    def train_step(self, data):        inputs, targets = data        predictions = self(inputs, training=True)        loss = self.compute_loss(y=targets, y_pred=predictions)
        loss.backward()        trainable_weights = [v for v in self.trainable_weights]        gradients = [v.value.grad for v in trainable_weights]
        with torch.no_grad():            self.optimizer.apply(gradients, trainable_weights)
        for metric in self.metrics:            if metric.name == "loss":                metric.update_state(loss)            else:                metric.update_state(targets, predictions)
        return {m.name: m.result() for m in self.metrics}
بیایید ببینیم چگونه اجرا میشود:
def get_custom_model():    inputs = keras.Input(shape=(28 * 28,))    features = layers.Dense(512, activation="relu")(inputs)    features = layers.Dropout(0.5)(features)    outputs = layers.Dense(10, activation="softmax")(features)    model = CustomModel(inputs, outputs)    model.compile(        optimizer=keras.optimizers.Adam(),        loss=keras.losses.SparseCategoricalCrossentropy(),        metrics=[keras.metrics.SparseCategoricalAccuracy()],    )    return model
model = get_custom_model()model.fit(train_images, train_labels, epochs=3)
مدیریت معیارهای train_step() با JAX
Section titled “مدیریت معیارهای train_step() با JAX”در نهایت، نحوهٔ پیادهسازی آن با JAX به این صورت است. برای شروع، میتوانید از compute_loss() در متد compute_loss_and_updates() خود برای استفاده از زیان ارسالشده به compile() بهره ببرید:
import kerasfrom keras import layers
class CustomModel(keras.Model):    def compute_loss_and_updates(        self,        trainable_variables,        non_trainable_variables,        inputs,        targets,        training=False,    ):        predictions, non_trainable_variables = self.stateless_call(            trainable_variables,            non_trainable_variables,            inputs,            training=training,        )        loss = self.compute_loss(y=targets, y_pred=predictions)        return loss, (predictions, non_trainable_variables)
مرحلهٔ بعد: مدیریت معیارها. طبق معمول، به دلیل الزامات بدون وضعیت بودن در JAX، کمی پیچیدهتر است:
    def train_step(self, state, data):        (            trainable_variables,            non_trainable_variables,            optimizer_variables,            # Metric variables are part of the state.            metrics_variables,        ) = state        inputs, targets = data
        grad_fn = jax.value_and_grad(            self.compute_loss_and_updates, has_aux=True        )
        (loss, (predictions, non_trainable_variables)), grads = grad_fn(            trainable_variables,            non_trainable_variables,            inputs,            targets,            training=True,        )        (            trainable_variables,            optimizer_variables,        ) = self.optimizer.stateless_apply(            optimizer_variables, grads, trainable_variables        )
        new_metrics_vars = []        logs = {}        # Iterates over metrics        for metric in self.metrics:            num_prev = len(new_metrics_vars)            num_current = len(metric.variables)            # Grabs the variables of the current metrics            current_vars = metrics_variables[num_prev : num_prev + num_current]            # Updates the metric's state            if metric.name == "loss":                current_vars = metric.stateless_update_state(current_vars, loss)            else:                current_vars = metric.stateless_update_state(                    current_vars, targets, predictions                )            # Stores the results in the logs dict            logs[metric.name] = metric.stateless_result(current_vars)            new_metrics_vars += current_vars
        state = (            trainable_variables,            non_trainable_variables,            optimizer_variables,            # Returns the new metrics variables as part of the state            new_metrics_vars,        )        return logs, state
این اطلاعات بسیار زیادی بود، اما تا الان به اندازهٔ کافی میدانید که از Keras برای انجام تقریباً هر کاری استفاده کنید!
- پلتفرم Keras بر اساس اصل افشای تدریجی پیچیدگی ، طیفی از گردشکارهای مختلف را ارائه میدهد. همهٔ آنها بهصورت روان با یکدیگر همکاری و تعامل دارند.
- شما میتوانید مدلها را از طریق کلاس
Sequential، از طریق ایپیآی تابعی (Functional API)، یا با زیرکلاسسازی کلاسModelبسازید. در بیشتر مواقع، از ایپیآی تابعی استفاده خواهید کرد. - سادهترین راه برای آموزش و ارزیابی یک مدل، استفاده از متدهای پیشفرض
fit()وevaluate()است. - کالبکهای Keras روشی ساده برای نظارت بر مدلها در طول فراخوانی شما به
fit()و انجام خودکار اقدامات بر اساس وضعیت مدل ارائه میدهند. - شما همچنین میتوانید با بازنویسی متد
train_step()و با استفاده از APIهای بکاند انتخابی خود — JAX، TensorFlow یا PyTorch — بر آنچهfit()انجام میدهد کنترل کامل داشته باشید. - فراتر از
fit()، شما همچنین میتوانید حلقههای آموزشی خود را کاملاً از ابتدا و به شیوهٔ بومی بکاند بنویسید. این کار برای پژوهشگرانی که الگوریتمهای آموزشی کاملاً جدید پیادهسازی میکنند مفید است.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.