
فصل ۱۳: پیشبینی سریهای زمانی
این فصل به سریهای زمانی میپردازد، جایی که ترتیب زمانی همه چیز است. ما بر رایجترین و ارزشمندترین وظیفه در سریهای زمانی تمرکز خواهیم کرد: پیشبینی. استفاده از گذشتهٔ نزدیک برای پیشبینی آیندهٔ نزدیک یک توانمندی قدرتمند است، چه در حال تلاش برای پیشبینی تقاضای انرژی باشید، چه مدیریت موجودی انبار، یا صرفاً پیشبینی آبوهوا.
انواع مختلف وظایف سریهای زمانی
Section titled “انواع مختلف وظایف سریهای زمانی”یک سری زمانی (timeseries) میتواند هر دادهای باشد که از طریق اندازهگیری در فواصل زمانی منظم به دست میآید، مانند قیمت روزانهٔ یک سهم، مصرف ساعتی برق یک شهر، یا فروش هفتگی یک فروشگاه. سریهای زمانی در همه جا وجود دارند، چه به پدیدههای طبیعی نگاه کنیم (مانند فعالیتهای لرزهای، تکامل جمعیت ماهیها در یک رودخانه، یا آبوهوا در یک مکان) و چه الگوهای فعالیت انسانی (مانند بازدیدکنندگان یک وبسایت، تولید ناخالص داخلی یک کشور، یا تراکنشهای کارت اعتباری). بر خلاف انواع دادههایی که تاکنون با آنها مواجه شدهاید، کار با سریهای زمانی مستلزم درک پویایی (dynamics) یک سیستم است — چرخههای دورهای آن، نحوهٔ روندیابی آن در طول زمان، رژیم منظم آن، و جهشهای ناگهانی آن.
تا کنون، رایجترین وظیفهٔ مرتبط با سریهای زمانی پیشبینی (forecasting) است: پیشبینی آنچه در ادامه در سری رخ میدهد. پیشبینی مصرف برق چند ساعت قبل تا بتوانید تقاضا را پیشبینی کنید، پیشبینی درآمد چند ماه قبل تا بتوانید بودجهٔ خود را برنامهریزی نمایید، پیشبینی آبوهوا چند روز قبل تا بتوانید برنامهٔ خود را تنظیم کنید. پیشبینی موضوعی است که این فصل بر آن تمرکز دارد. اما در واقع طیف گستردهای از کارهای دیگر وجود دارد که میتوانید با سریهای زمانی انجام دهید، مانند:
- تشخیص ناهنجاری (Anomaly detection) — تشخیص هرگونه اتفاق غیرمعمول در یک جریان پیوسته از دادهها. فعالیت غیرمعمول در شبکهٔ شرکتی شما؟ ممکن است یک مهاجم باشد. خوانشهای غیرمعمول در یک خط تولید؟ وقت آن است که یک انسان برود و نگاهی بیندازد. تشخیص ناهنجاری معمولاً از طریق یادگیری بدون نظارت انجام میشود، زیرا اغلب نمیدانید به دنبال چه نوع ناهنجاری هستید، و در نتیجه نمیتوانید روی نمونههای ناهنجاری خاص آموزش دهید.
- طبقهبندی (Classification) — اختصاص یک یا چند برچسب طبقهبندی به یک سری زمانی. به عنوان مثال، با توجه به سری زمانی فعالیت یک بازدیدکننده در یک وبسایت، طبقهبندی کنید که آیا بازدیدکننده یک ربات است یا یک انسان.
- تشخیص رویداد (Event detection) — شناسایی وقوع یک رویداد خاص و مورد انتظار در یک جریان پیوسته از دادهها. یک کاربرد به ویژه مفید، «تشخیص کلمهٔ کلیدی (hotword detection)» است، که در آن یک مدل یک جریان صوتی را رصد میکند و عباراتی مانند «OK, Google» یا «Hey, Alexa» را تشخیص میدهد.
در این فصل، شما با شبکههای عصبی برگشتی (RNNها) و نحوهٔ اعمال آنها در پیشبینی سریهای زمانی آشنا خواهید شد.
یک مثال پیشبینی دما
Section titled “یک مثال پیشبینی دما”در سرتاسر این فصل، تمام مثالهای کد ما یک مسئلهٔ واحد را هدف قرار خواهند داد: پیشبینی دما برای ۲۴ ساعت در آینده، با توجه به یک سری زمانی از اندازهگیریهای ساعتی مقادیری مانند فشار جوی و رطوبت، که در طول گذشتهٔ نزدیک توسط مجموعهای از حسگرها روی پشتبام یک ساختمان ثبت شدهاند. همانطور که خواهید دید، این یک مسئلهٔ نسبتاً چالشبرانگیز است!
ما از این وظیفهٔ پیشبینی دما برای برجسته کردن آنچه دادههای سری زمانی را اساساً از انواع مجموعهدادههایی که تاکنون با آنها روبرو شدهاید متمایز میکند استفاده خواهیم کرد؛ برای نشان دادن اینکه شبکههای متراکم متصل و شبکههای کانولوشنی به خوبی برای مقابله با آن مجهز نیستند، و برای به نمایش گذاشتن نوع جدیدی از تکنیکهای یادگیری ماشین که واقعاً در این نوع مسئله میدرخشد: شبکههای عصبی برگشتی (RNNها).
ما با یک مجموعهدادهٔ سری زمانی آبوهوا کار خواهیم کرد که در ایستگاه هواشناسی در مؤسسهٔ ماکس پلانک برای بیوژئوشیمی در ینا (Jena)، آلمان ثبت شده است.1 در این مجموعهداده، ۱۴ کمیت مختلف (مانند دما، فشار جوی، رطوبت، جهت باد، و غیره) هر ۱۰ دقیقه یکبار در طول چند سال ثبت شدهاند. دادههای اصلی به سال ۲۰۰۳ بازمیگردد، اما زیرمجموعهای از دادهها که ما دانلود خواهیم کرد به سالهای ۲۰۰۹ تا ۲۰۱۶ محدود شده است.
بیایید با دانلود و از حالت فشرده خارج کردن دادهها شروع کنیم:
!wget https://s3.amazonaws.com/keras-datasets/jena_climate_2009_2016.csv.zip!unzip jena_climate_2009_2016.csv.zipبیایید به دادهها نگاهی بیندازیم.
لیستینگ ۱۳.۱: بازرسی دادههای مجموعهدادهٔ آبوهوای Jena
import os
fname = os.path.join("jena_climate_2009_2016.csv")
with open(fname) as f:    data = f.read()
lines = data.split("\n")header = lines[0].split(",")lines = lines[1:]print(header)print(len(lines))
این دستور تعداد ۴۲۰,۵۵۱ خط داده (هر خط یک گام زمانی است: رکوردی از یک تاریخ و ۱۴ مقدار مرتبط با آبوهوا)، و همچنین سربرگ زیر را خروجی میدهد:
["Date Time", "p (mbar)", "T (degC)", "Tpot (K)", "Tdew (degC)", "rh (%)", "VPmax (mbar)", "VPact (mbar)", "VPdef (mbar)", "sh (g/kg)", "H2OC (mmol/mol)", "rho (g/m**3)", "wv (m/s)", "max. wv (m/s)", "wd (deg)"]اکنون، تمام ۴۲۰,۵۵۱ خط داده را به آرایههای NumPy تبدیل کنید: یک آرایه برای دما (بر حسب درجهٔ سانتیگراد)، و یکی دیگر برای بقیهٔ دادهها — ویژگیهایی که برای پیشبینی دماهای آینده استفاده خواهیم کرد. توجه داشته باشید که ستون «Date Time» را کنار میگذاریم.
لیستینگ ۱۳.۲: تجزیهٔ دادهها
import numpy as np
temperature = np.zeros((len(lines),))raw_data = np.zeros((len(lines), len(header) - 1))
for i, line in enumerate(lines):    values = [float(x) for x in line.split(",")[1:]]    # We store column 1 in the temperature array.    temperature[i] = values[1]    # We store all columns (including the temperature) in the raw_data    # array.    raw_data[i, :] = values[:]
شکل ۱۳.۱ نمودار دما (بر حسب درجهٔ سانتیگراد) را در طول زمان نشان میدهد. در این نمودار، میتوانید دورهای بودن سالانهٔ دما را به وضوح مشاهده کنید — دادهها هشت سال را در بر میگیرند.
لیستینگ ۱۳.۳: رسم سری زمانی دما
from matplotlib import pyplot as plt
plt.plot(range(len(temperature)), temperature)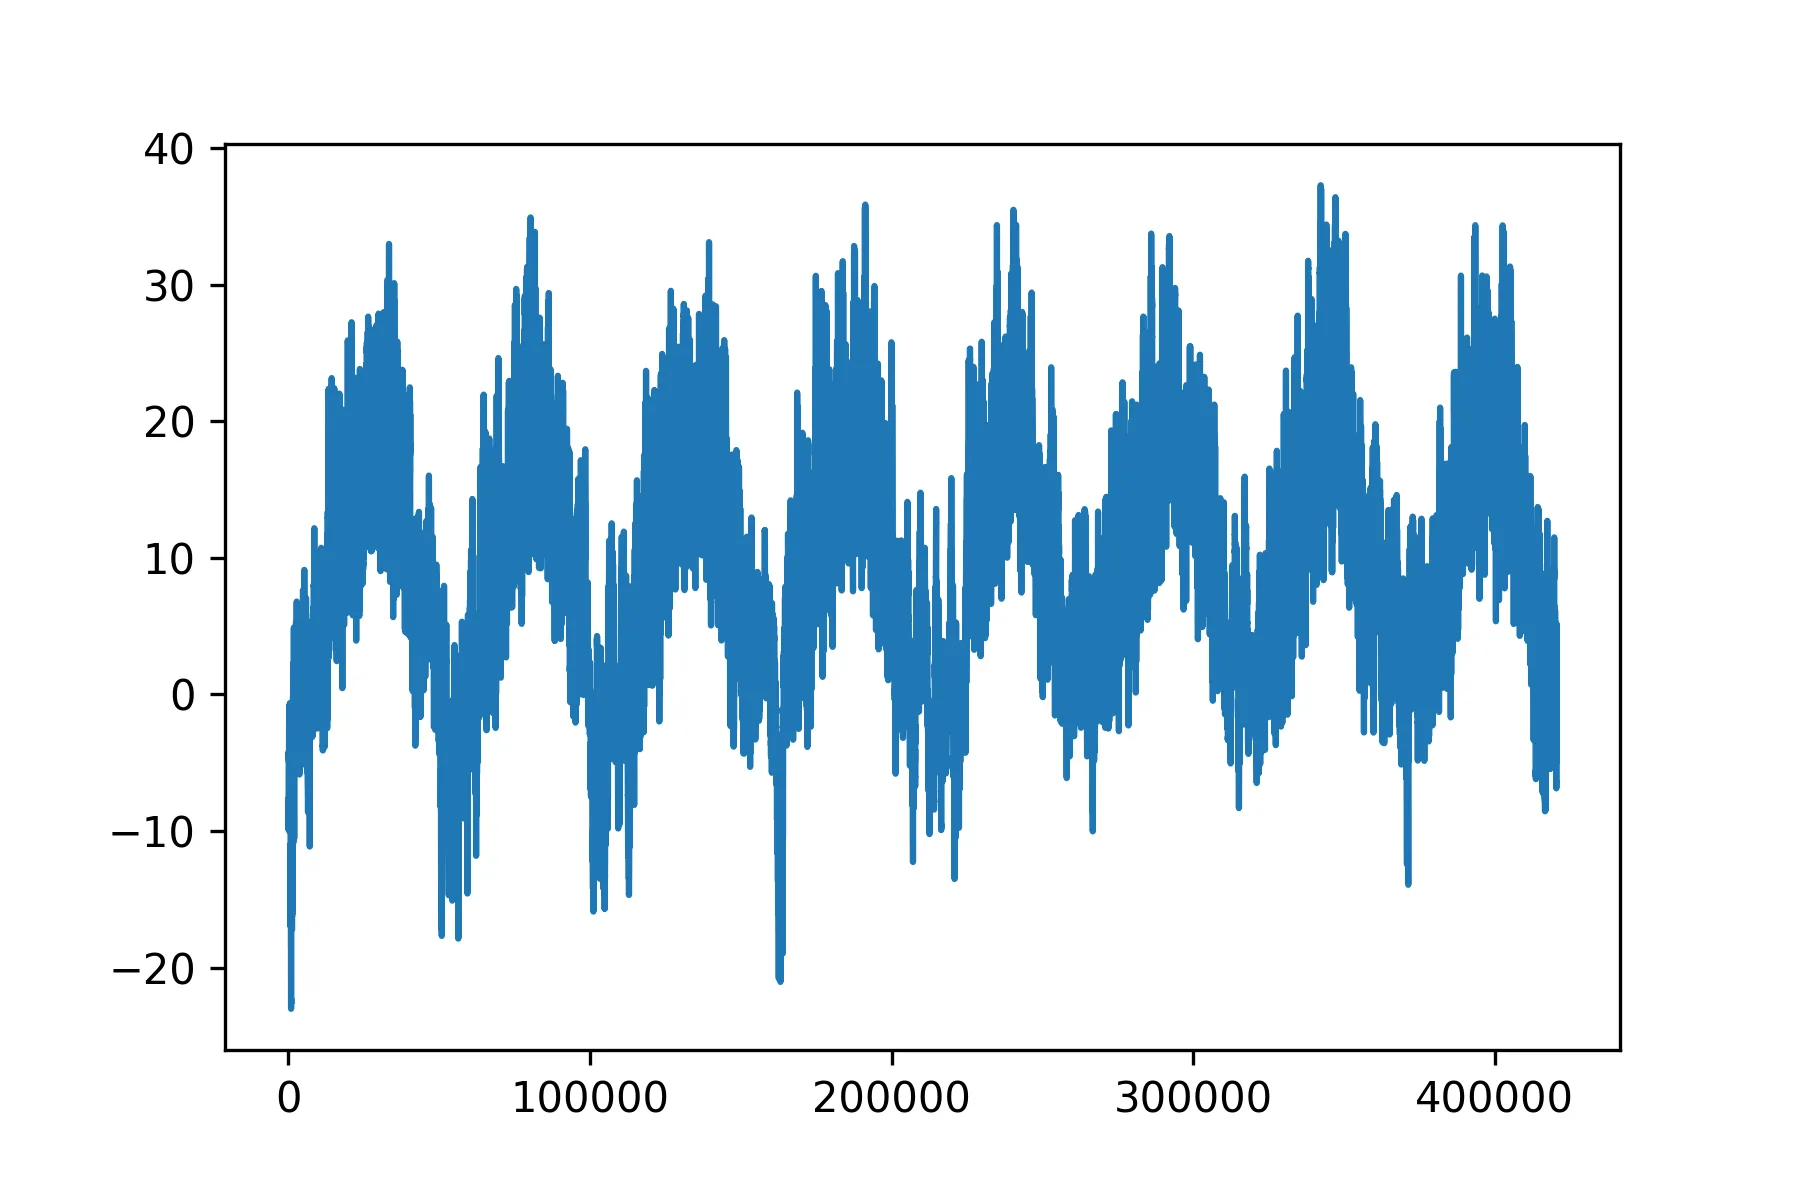
شکل ۱۳.۱: دما در کل بازهٔ زمانی مجموعهداده (سانتیگراد)
شکل ۱۳.۲ نمودار محدودتری از ۱۰ روز اول دادههای دما را نشان میدهد. از آنجا که دادهها هر ۱۰ دقیقه یکبار ثبت میشوند، شما ۲۴ × ۶ = ۱۴۴ نقطهٔ داده در روز دریافت میکنید.
لیستینگ ۱۳.۴: رسم ۱۰ روز اول سری زمانی دما
plt.plot(range(1440), temperature[:1440])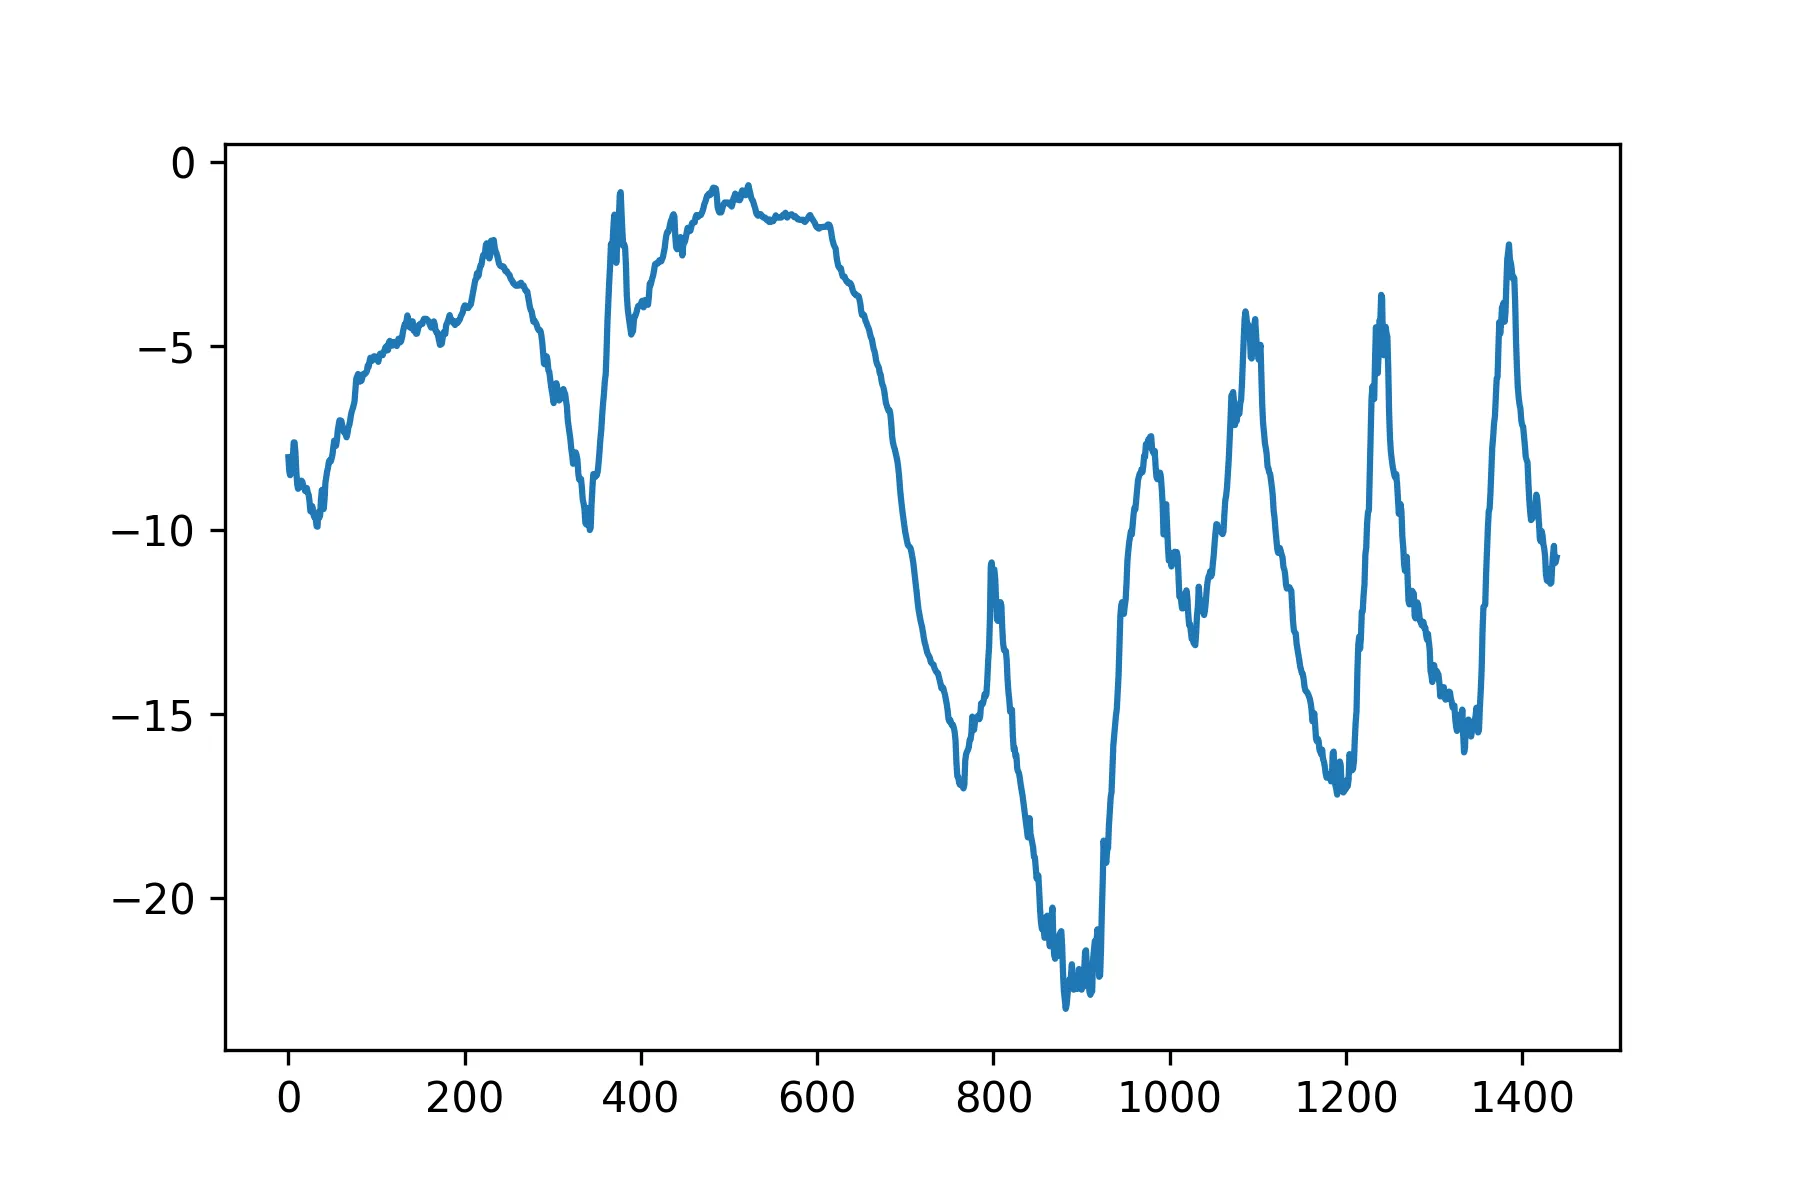
شکل ۱۳.۲: دما در طول ۱۰ روز اول مجموعهداده (سانتیگراد)
روی این نمودار، میتوانید دورهای بودن روزانه را مشاهده کنید، که به ویژه برای چهار روز آخر مشهود است. همچنین توجه داشته باشید که این دورهٔ ۱۰ روزه باید مربوط به یک ماه زمستانی نسبتاً سرد باشد.
با مجموعهدادهٔ ما، اگر در تلاش برای پیشبینی میانگین دما برای ماه آینده با داشتن چند ماه از دادههای گذشته بودید، مسئله به دلیل دورهای بودن قابل اعتماد در مقیاس سالانهٔ دادهها آسان میبود. اما با نگاه کردن به دادهها در مقیاس روزها، دما بسیار آشفتهتر به نظر میرسد. آیا این سری زمانی در مقیاس روزانه قابل پیشبینی است؟ بیایید دریابیم.
در تمام آزمایشهای خود، از ۵۰٪ اول دادهها برای آموزش، ۲۵٪ بعدی برای اعتبارسنجی، و ۲۵٪ آخر برای آزمایش استفاده خواهیم کرد. هنگام کار با دادههای سری زمانی، استفاده از دادههای اعتبارسنجی و آزمایشی که جدیدتر از دادههای آموزشی هستند مهم است، زیرا شما در تلاش برای پیشبینی آینده با توجه به گذشته هستید، نه برعکس، و تفکیکهای اعتبارسنجی/آزمایش شما باید این ترتیب زمانی را منعکس کنند. برخی مسائل اتفاقاً اگر محور زمان را معکوس کنید به طور قابل توجهی سادهتر میشوند!
لیستینگ ۱۳.۵: محاسبهٔ تعداد نمونهها برای هر بخش داده
>>> num_train_samples = int(0.5 * len(raw_data))>>> num_val_samples = int(0.25 * len(raw_data))>>> num_test_samples = len(raw_data) - num_train_samples - num_val_samples>>> print("num_train_samples:", num_train_samples)>>> print("num_val_samples:", num_val_samples)>>> print("num_test_samples:", num_test_samples)آمادهسازی دادهها
Section titled “آمادهسازی دادهها”فرمولبندی دقیق مسئله به این صورت خواهد بود: با داشتن دادههای پنج روز گذشته که هر یک ساعت یکبار نمونهبرداری شدهاند، آیا میتوانیم دما را در ۲۴ ساعت آینده پیشبینی کنیم؟
ابتدا بیایید دادهها را به قالبی پیشپردازش کنیم که یک شبکهٔ عصبی بتواند دریافت کند. این کار آسان است: دادهها از قبل عددی هستند، بنابراین نیازی به برداریسازی ندارید. اما هر سری زمانی در دادهها در مقیاس متفاوتی قرار دارد (برای مثال، فشار جوی بر حسب میلیبار حدود ۱,۰۰۰ است، در حالی که H2OC بر حسب میلیمول در مول حدود ۳ است). ما هر سری زمانی را به طور مستقل نرمالسازی خواهیم کرد تا همگی مقادیر کوچکی را در یک مقیاس مشابه به خود بگیرند. ما قرار است از ۲۱۰,۲۲۵ گام زمانی اول به عنوان دادههای آموزشی استفاده کنیم، بنابراین میانگین و انحراف معیار را فقط روی این کسری از دادهها محاسبه خواهیم کرد.
لیستینگ ۱۳.۶: نرمالسازی دادهها
mean = raw_data[:num_train_samples].mean(axis=0)raw_data -= meanstd = raw_data[:num_train_samples].std(axis=0)raw_data /= stdسپس، بیایید یک شیء Dataset بسازیم که دستههایی از دادههای پنج روز گذشته را همراه با دمای هدف ۲۴ ساعت آینده تولید میکند. از آنجا که نمونهها در مجموعهداده بسیار افزونه و تکراری هستند (نمونهٔ N و نمونهٔ N + 1 بیشتر گامهای زمانی مشترک دارند)، اختصاص حافظهٔ صریح برای تکتک نمونهها اتلاف منابع خواهد بود. در عوض، ما نمونهها را به صورت آنی و در حین اجرا تولید خواهیم کرد و در عین حال تنها آرایههای اصلی raw_data و temperature را در حافظه نگه میداریم و نه بیشتر.
ما به راحتی میتوانستیم یک مولد پایتون برای انجام این کار بنویسیم، اما یک ابزار کمکی توکار مجموعهداده در Keras وجود دارد که دقیقاً همین کار را انجام میدهد (timeseries_dataset_from_array())، بنابراین میتوانیم با استفاده از آن در کار خود صرفهجویی کنیم. شما به طور کلی میتوانید از آن برای هر نوع وظیفهٔ پیشبینی سریهای زمانی استفاده کنید.
ما از timeseries_dataset_from_array برای نمونهسازی سه مجموعهداده استفاده خواهیم کرد: یکی برای آموزش، یکی برای اعتبارسنجی، و یکی برای آزمایش.
ما از مقادیر پارامتر زیر استفاده خواهیم کرد:
sampling_rate = 6— مشاهدات با نرخ یک نقطهٔ داده در ساعت نمونهبرداری میشوند: ما فقط یک نقطهٔ داده از هر شش نقطه را نگه میداریم.sequence_length = 120— مشاهدات به پنج روز قبل بازمیگردند (۱۲۰ ساعت).delay = sampling_rate * (sequence_length + 24 - 1)— هدف برای یک دنباله دمای ۲۴ ساعت پس از پایان دنباله خواهد بود.start_index = 0وend_index = num_train_samples— برای مجموعهدادهٔ آموزشی، تا فقط از ۵۰٪ اول دادهها استفاده شود.start_index = num_train_samplesوend_index = num_train_samples + num_val_samples— برای مجموعهدادهٔ اعتبارسنجی، تا فقط از ۲۵٪ بعدی دادهها استفاده شود.start_index = num_train_samples + num_val_samples— برای مجموعهدادهٔ آزمایش، تا از نمونههای باقیمانده استفاده شود.
لیستینگ ۱۳.۷: نمونهسازی مجموعهدادهها برای آموزش، اعتبارسنجی، و آزمایش
sampling_rate = 6sequence_length = 120delay = sampling_rate * (sequence_length + 24 - 1)batch_size = 256
train_dataset = keras.utils.timeseries_dataset_from_array(    raw_data[:-delay],    targets=temperature[delay:],    sampling_rate=sampling_rate,    sequence_length=sequence_length,    shuffle=True,    batch_size=batch_size,    start_index=0,    end_index=num_train_samples,)
val_dataset = keras.utils.timeseries_dataset_from_array(    raw_data[:-delay],    targets=temperature[delay:],    sampling_rate=sampling_rate,    sequence_length=sequence_length,    shuffle=True,    batch_size=batch_size,    start_index=num_train_samples,    end_index=num_train_samples + num_val_samples,)
test_dataset = keras.utils.timeseries_dataset_from_array(    raw_data[:-delay],    targets=temperature[delay:],    sampling_rate=sampling_rate,    sequence_length=sequence_length,    shuffle=True,    batch_size=batch_size,    start_index=num_train_samples + num_val_samples,)
هر مجموعهداده یک تاپل (samples, targets) تولید میکند، که در آن samples یک دسته از ۲۵۶ نمونه است که هر کدام شامل ۱۲۰ ساعت متوالی از دادههای ورودی هستند، و targets آرایهٔ متناظر از ۲۵۶ دمای هدف است. توجه داشته باشید که نمونهها به طور تصادفی بر زده میشوند، بنابراین دو دنبالهٔ متوالی در یک دسته (مانند samples[0] و samples[1]) لزوماً از نظر زمانی به هم نزدیک نیستند.
لیستینگ ۱۳.۸: بازرسی مجموعهداده
>>> for samples, targets in train_dataset:>>> print("samples shape:", samples.shape)>>> print("targets shape:", targets.shape)>>> breakیک خط مبنای مبتنی بر عقل سلیم، غیر مبتنی بر یادگیری ماشین
Section titled “یک خط مبنای مبتنی بر عقل سلیم، غیر مبتنی بر یادگیری ماشین”قبل از اینکه شروع به استفاده از مدلهای جعبهسیاه یادگیری عمیق برای حل مسئلهٔ پیشبینی دما کنید، بیایید یک رویکرد ساده و مبتنی بر عقل سلیم را امتحان کنیم. این کار به عنوان یک بررسی عقلانی عمل خواهد کرد، و خط مبنایی را تعیین میکند که باید آن را پشت سر بگذارید تا سودمندی مدلهای پیشرفتهتر یادگیری ماشین را نشان دهید. چنین خطوط مبنای مبتنی بر عقل سلیم زمانی که به مسئلهٔ جدیدی نزدیک میشوید که هیچ راهحل شناختهشدهای (هنوز) برای آن وجود ندارد میتوانند مفید باشند. یک مثال کلاسیک وظایف طبقهبندی نامتعادل است، جایی که برخی از کلاسها بسیار رایجتر از بقیه هستند. اگر مجموعهدادهٔ شما شامل ۹۰٪ نمونههای کلاس A و ۱۰٪ نمونههای کلاس B باشد، آنگاه یک رویکرد مبتنی بر عقل سلیم برای وظیفهٔ طبقهبندی این است که هنگام مواجهه با یک نمونهٔ جدید همیشه «A» را پیشبینی کنید. چنین طبقهبندیکنندهای به طور کلی ۹۰٪ دقت دارد، و بنابراین هر رویکرد مبتنی بر یادگیری باید این امتیاز ۹۰٪ را شکست دهد تا سودمندی خود را اثبات کند. گاهی اوقات، شکست دادن چنین خطوط مبنای ابتدایی به طور شگفتآوری سخت است.
در این مورد، میتوان با اطمینان فرض کرد که سری زمانی دما پیوسته است (دماهای فردا احتمالاً نزدیک به دماهای امروز خواهند بود) و همچنین دارای دورهای با تناوب روزانه است. بنابراین، یک رویکرد مبتنی بر عقل سلیم این است که همیشه پیشبینی کنیم دمای ۲۴ ساعت بعد برابر با دمای همین الان خواهد بود. بیایید این رویکرد را با استفاده از معیار میانگین قدر مطلق خطا (MAE) ارزیابی کنیم، که به صورت زیر تعریف میشود:
np.mean(np.abs(preds - targets))در اینجا حلقهٔ ارزیابی آورده شده است.
لیستینگ ۱۳.۹: محاسبهٔ MAE خط مبنای مبتنی بر عقل سلیم
def evaluate_naive_method(dataset):    total_abs_err = 0.0    samples_seen = 0    for samples, targets in dataset:        # The temperature feature is at column 1, so `samples[:, -1,        # 1]` is the last temperature measurement in the input        # sequence. Recall that we normalized our features to retrieve        # a temperature in Celsius degrees, we need to un-normalize it,        # by multiplying it by the standard deviation and adding back        # the mean.        preds = samples[:, -1, 1] * std[1] + mean[1]        total_abs_err += np.sum(np.abs(preds - targets))        samples_seen += samples.shape[0]    return total_abs_err / samples_seen
print(f"Validation MAE: {evaluate_naive_method(val_dataset):.2f}")print(f"Test MAE: {evaluate_naive_method(test_dataset):.2f}")
این خط مبنای مبتنی بر عقل سلیم به یک MAE اعتبارسنجی ۲.۴۴ درجهٔ سانتیگراد و MAE آزمایش ۲.۶۲ درجهٔ سانتیگراد دست مییابد. بنابراین اگر همیشه فرض کنید که دمای ۲۴ ساعت آینده برابر با دمای فعلی خواهد بود، به طور میانگین حدود دو و نیم درجه خطا خواهید داشت. این نتیجه چندان بد نیست، اما احتمالاً میتوانید کار بهتری انجام دهید.
بیایید یک مدل یادگیری ماشین پایه را امتحان کنیم
Section titled “بیایید یک مدل یادگیری ماشین پایه را امتحان کنیم”به همان روشی که برقراری یک خط مبنای مبتنی بر عقل سلیم قبل از امتحان کردن مدلهای یادگیری ماشین مفید است، امتحان کردن مدلهای ساده و کلاسیک یادگیری ماشین (مانند مدلهای کوچک و متراکم متصل) قبل از پرداختن به مدلهای پیچیدهتر و پرهزینهتر از نظر محاسباتی مانند RNNها کار مفیدی است. این بهترین راه برای اطمینان از این است که هر پیچیدگی دیگری که بعداً اضافه میکنید واقعاً مشروع است و مزایای واقعی به همراه دارد.
لیستینگ زیر یک مدل کاملاً متصل ساده را نشان میدهد که با مسطح کردن دادهها شروع میشود و سپس آن را از طریق دو لایهٔ Dense عبور میدهد. توجه داشته باشید که هیچ لایهٔ فعالسازی روی لایهٔ Dense آخر وجود ندارد، که برای یک مسئلهٔ رگرسیون معمول است. ما از میانگین مربعات خطا (MSE) به عنوان تابع زیان استفاده میکنیم، زیرا بر خلاف MAE، در حول صفر هموار و مشتقپذیر است، که ویژگی خوبی برای نزول گرادیان محسوب میشود. ما همچنین MAE را با ارسال metrics=["mae"] در compile() نظارت خواهیم کرد.
لیستینگ ۱۳.۱۰: آموزش و ارزیابی یک مدل متراکم متصل
import kerasfrom keras import layers
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.Flatten()(inputs)x = layers.Dense(16, activation="relu")(x)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
callbacks = [    # We use a callback to save the best-performing model.    keras.callbacks.ModelCheckpoint("jena_dense.keras", save_best_only=True)]model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=10,    validation_data=val_dataset,    callbacks=callbacks,)
# Reloads the best model and evaluates it on the test datamodel = keras.models.load_model("jena_dense.keras")print(f"Test MAE: {model.evaluate(test_dataset)[1]:.2f}")
بیایید منحنیهای زیان را برای اعتبارسنجی و آموزش نمایش دهیم (شکل ۱۳.۳ را ببینید).
لیستینگ ۱۳.۱۱: رسم نتایج
import matplotlib.pyplot as plt
loss = history.history["mae"]val_loss = history.history["val_mae"]epochs = range(1, len(loss) + 1)plt.figure()plt.plot(epochs, loss, "r--", label="Training MAE")plt.plot(epochs, val_loss, "b", label="Validation MAE")plt.title("Training and validation MAE")plt.legend()plt.show()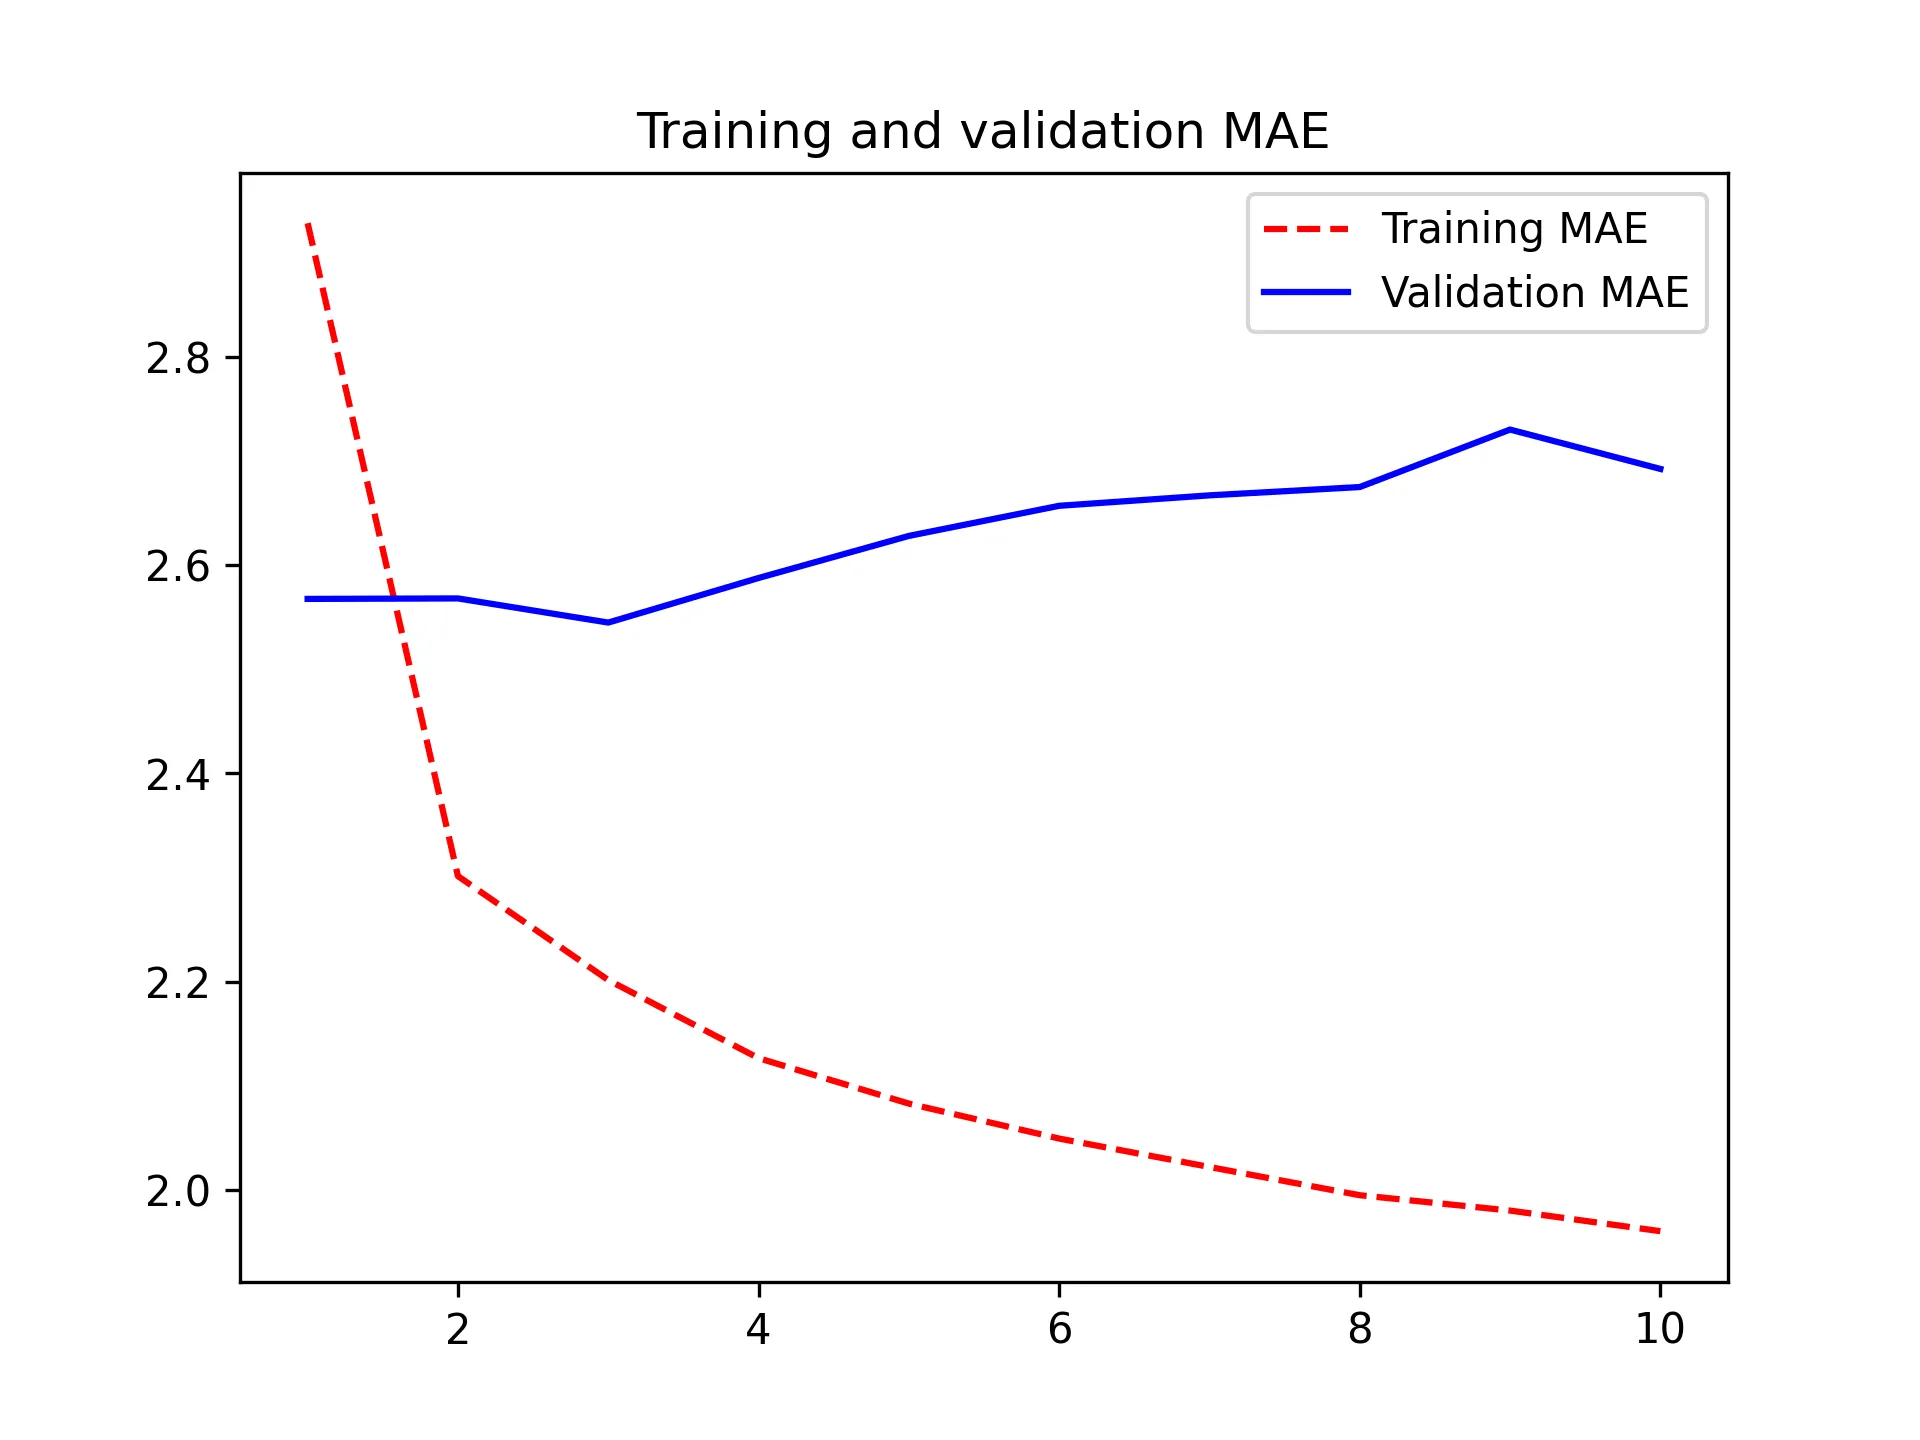
شکل ۱۳.۳: MAE آموزش و اعتبارسنجی در وظیفهٔ پیشبینی دمای Jena با یک شبکهٔ متراکم متصل ساده
برخی از زیانهای اعتبارسنجی به خط مبنای بدون یادگیری نزدیک هستند، اما نه به طور قابل اعتماد. این نشاندهندهٔ ارزش داشتن این خط مبنا در وهلهٔ اول است: معلوم میشود که پشت سر گذاشتن آن آسان نیست. عقل سلیم شما حاوی اطلاعات ارزشمند زیادی است که یک مدل یادگیری ماشین به آنها دسترسی ندارد.
ممکن است بپرسید، اگر یک مدل ساده و با عملکرد خوب برای رفتن از دادهها به هدفها وجود دارد (خط مبنای مبتنی بر عقل سلیم)، چرا مدلی که آموزش میدهید آن را پیدا نمیکند و بهبود نمیبخشد؟ خوب، فضای مدلهایی که در آن به دنبال راهحل میگردید — یعنی فضای فرضیهٔ شما — فضای تمام شبکههای دولایهای ممکن با پیکربندیای است که تعریف کردهاید. هیوریستیک مبتنی بر عقل سلیم فقط یک مدل در میان میلیونها مدلی است که میتوان در این فضا بازنمایی کرد. این شبیه به جستجوی سوزن در انبار کاه است. صرف اینکه یک راهحل خوب از نظر فنی در فضای فرضیهٔ شما وجود دارد به این معنی نیست که قادر خواهید بود آن را از طریق نزول گرادیان پیدا کنید.
این یک محدودیت بسیار مهم در یادگیری ماشین به طور کلی است: مگر اینکه الگوریتم یادگیری برای جستجوی نوع خاصی از مدل ساده کدنویسی شده باشد، گاهی اوقات میتواند در یافتن یک راهحل ساده برای یک مسئلهٔ ساده شکست بخورد. به همین دلیل است که استفاده از مهندسی ویژگیهای مناسب و پیشفرضهای معماری مرتبط ضروری است: شما باید به طور دقیق به مدل خود بگویید که باید به دنبال چه چیزی باشد.
بیایید یک مدل کانولوشنی یکبعدی را امتحان کنیم
Section titled “بیایید یک مدل کانولوشنی یکبعدی را امتحان کنیم”صحبت از استفاده از پیشفرضهای معماری درست شد: از آنجا که دنبالههای ورودی ما دارای چرخههای روزانه هستند، شاید یک مدل کانولوشنی بتواند کار کند؟ یک ConvNet زمانی میتواند از همان بازنماییها در روزهای مختلف مجدداً استفاده کند، درست مانند اینکه یک ConvNet مکانی میتواند از همان بازنماییها در مکانهای مختلف درون یک تصویر استفاده نماید.
شما از قبل با لایههای Conv2D و SeparableConv2D آشنا هستید، که ورودیهای خود را از طریق پنجرههای کوچکی که روی شبکههای دوبعدی حرکت میکنند میبینند. همچنین نسخههای یکبعدی و حتی سهبعدی از این لایهها وجود دارد: Conv1D، SeparableConv1D، و Conv3D.2 لایهٔ Conv1D بر پنجرههای یکبعدی تکیه دارد که روی دنبالههای ورودی میلغزند، و لایهٔ Conv3D بر پنجرههای مکعبی متکی است که روی حجمهای ورودی حرکت میکنند.
بنابراین میتوانید ConvNetهای یکبعدی بسازید که کاملاً مشابه ConvNetهای دوبعدی هستند. آنها برای هر دادهٔ دنبالهای که از فرض ناوردایی انتقالی (translation invariance) پیروی میکند بسیار مناسب هستند (به این معنی که اگر پنجرهای را روی دنباله بلغزانید، محتوای پنجره باید صرفنظر از مکان پنجره از همان ویژگیها پیروی کند).
بیایید یکی از آنها را روی مسئلهٔ پیشبینی دمای خود امتحان کنیم. ما یک طول پنجرهٔ اولیهٔ ۲۴ را انتخاب میکنیم، به طوری که در هر بار به ۲۴ ساعت از دادهها نگاه کنیم (یک چرخه). همانطور که دنبالهها را کاهش ابعاد میدهیم (از طریق لایههای MaxPooling1D)، اندازهٔ پنجره را نیز متناسب با آن کاهش خواهیم داد (شکل ۱۳.۴):
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.Conv1D(8, 24, activation="relu")(inputs)x = layers.MaxPooling1D(2)(x)x = layers.Conv1D(8, 12, activation="relu")(x)x = layers.MaxPooling1D(2)(x)x = layers.Conv1D(8, 6, activation="relu")(x)x = layers.GlobalAveragePooling1D()(x)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
callbacks = [    keras.callbacks.ModelCheckpoint("jena_conv.keras", save_best_only=True)]model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=10,    validation_data=val_dataset,    callbacks=callbacks,)
model = keras.models.load_model("jena_conv.keras")print(f"Test MAE: {model.evaluate(test_dataset)[1]:.2f}")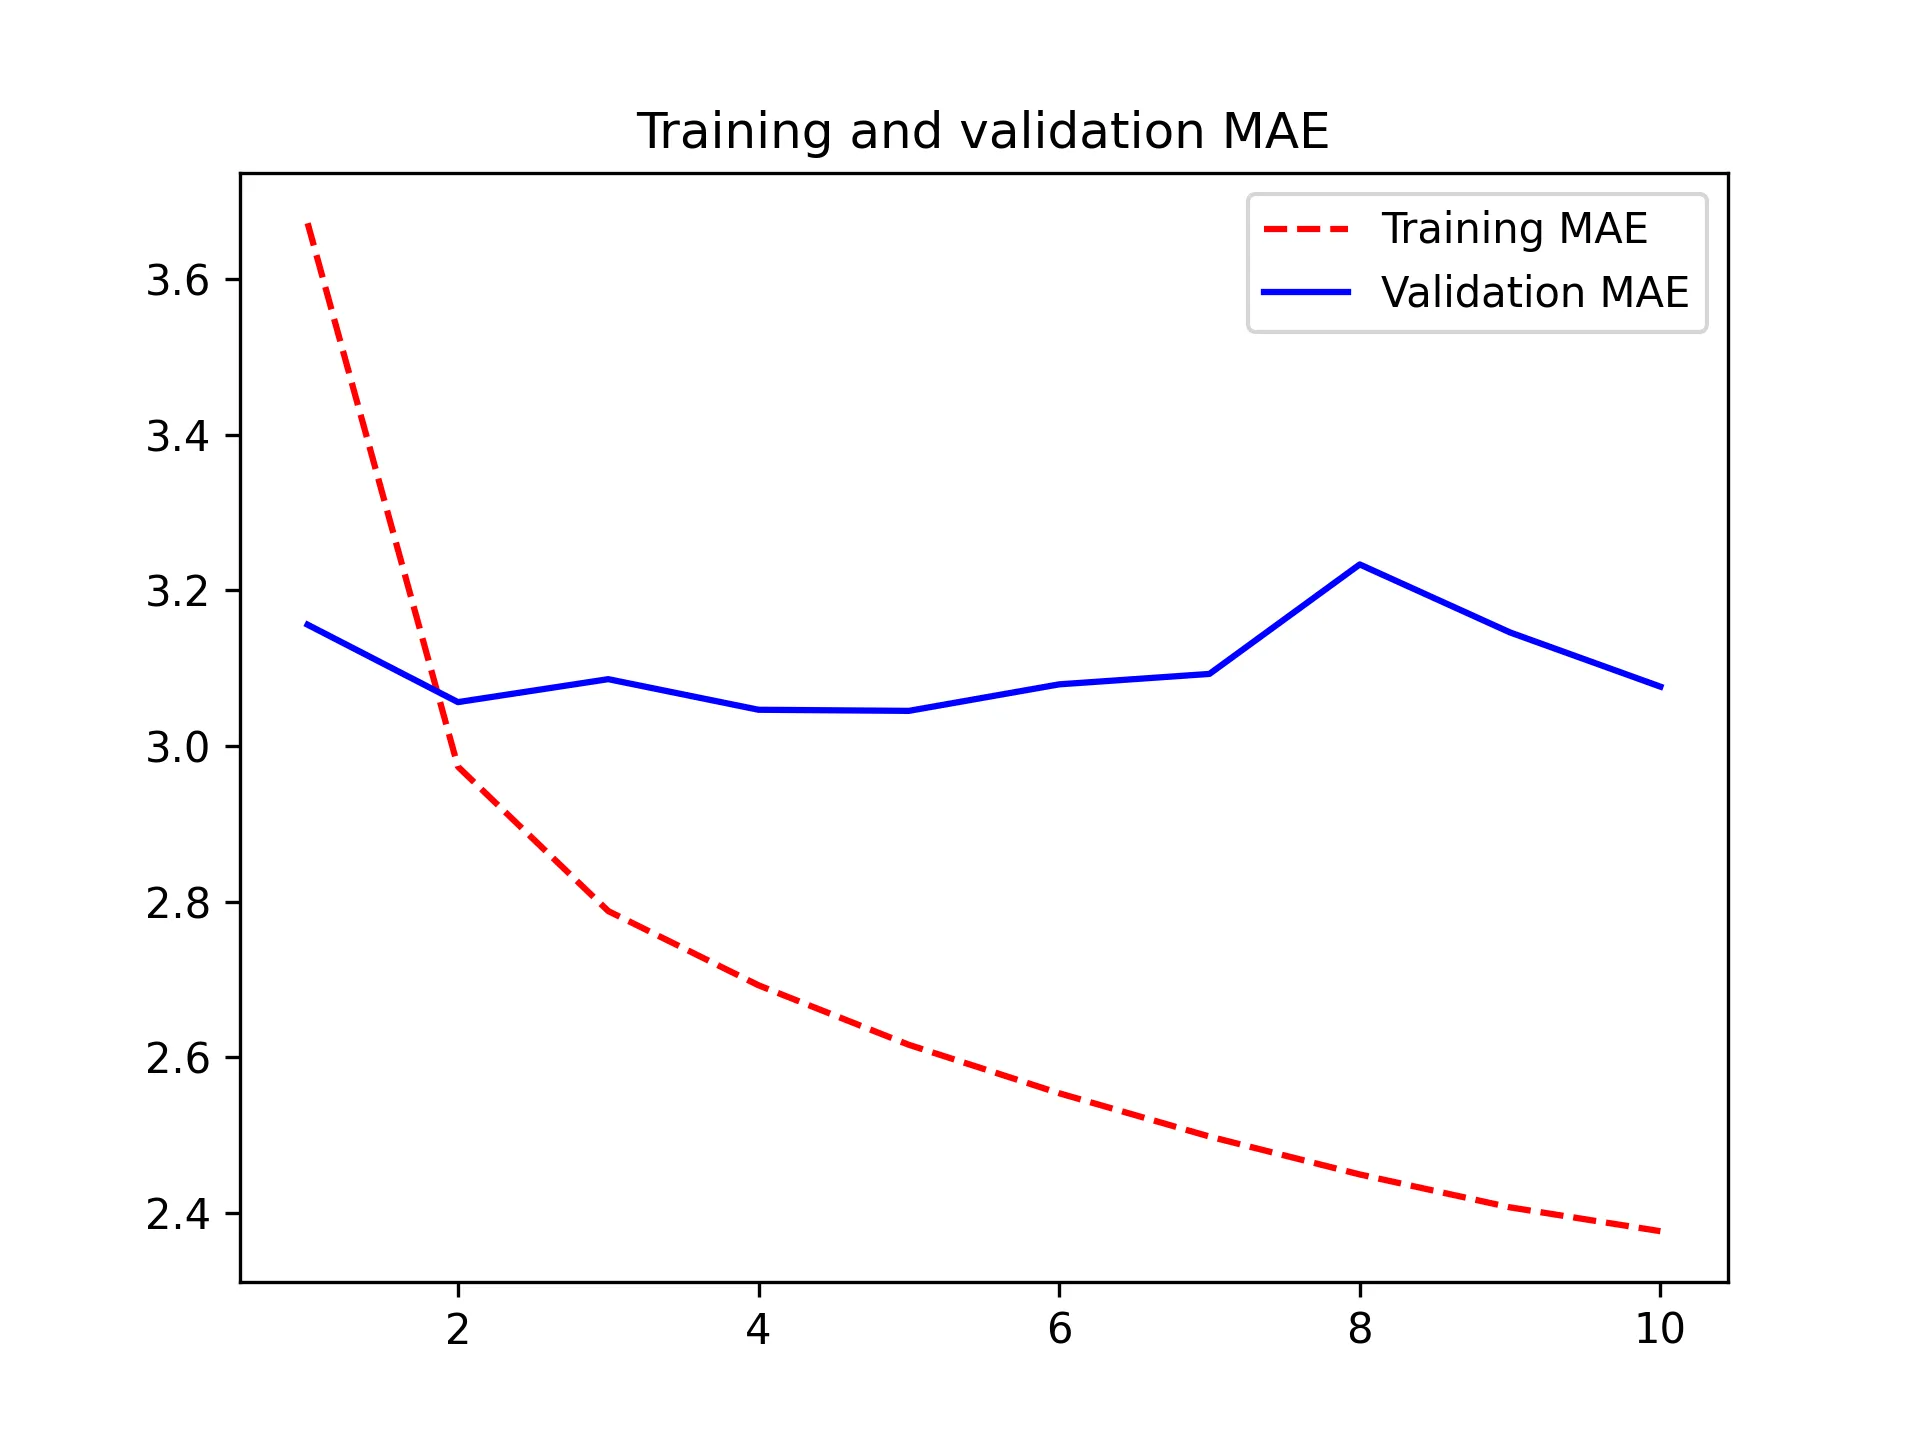
شکل ۱۳.۴: MAE آموزش و اعتبارسنجی در وظیفهٔ پیشبینی دمای Jena با یک ConvNet یکبعدی
همانطور که مشخص شد، عملکرد این مدل حتی بدتر از مدل متراکم متصل است و تنها به MAE اعتبارسنجی حدود ۲.۹ درجه دست مییابد که فاصلهٔ زیادی با خط مبنای مبتنی بر عقل سلیم دارد. چه چیزی در اینجا اشتباه پیش رفت؟ دو چیز:
- اول اینکه دادههای آبوهوا کاملاً به فرض ناوردایی انتقالی پایبند نیستند. در حالی که دادهها دارای چرخههای روزانه هستند، دادههای صبح از ویژگیهای متفاوتی نسبت به دادههای عصر یا نیمهشب پیروی میکنند. دادههای آبوهوا فقط برای یک مقیاس زمانی بسیار خاص ناوردای انتقالی هستند.
- دوم اینکه ترتیب در دادههای ما اهمیت دارد — بسیار زیاد. گذشتهٔ نزدیک برای پیشبینی دمای روز بعد بسیار آموزندهتر از دادههای پنج روز پیش است. یک ConvNet یکبعدی قادر نیست از این واقعیت استفاده کند. به طور خاص، لایههای max pooling و global average pooling ما تا حد زیادی اطلاعات مربوط به ترتیب را از بین میبرند.
شبکههای عصبی برگشتی
Section titled “شبکههای عصبی برگشتی”نه رویکرد کاملاً متصل و نه رویکرد کانولوشنی عملکرد خوبی نداشتند، اما این بدان معنا نیست که یادگیری ماشین برای این مسئله کاربرد ندارد. رویکرد متراکم متصل ابتدا سری زمانی را مسطح کرد که مفهوم زمان را از دادههای ورودی حذف نمود. رویکرد کانولوشنی با هر بخش از دادهها به یک شکل رفتار کرد، و حتی از ادغام (pooling) استفاده کرد که اطلاعات ترتیب را از بین برد. در عوض، بیایید به دادهها آنگونه که واقعاً هستند نگاه کنیم: یک دنباله، که در آن علیت و ترتیب اهمیت دارند.
خانوادهای از معماریهای شبکهٔ عصبی وجود دارند که به طور خاص برای این مورد استفاده طراحی شدهاند: شبکههای عصبی برگشتی. در میان آنها، به ویژه لایهٔ حافظهٔ کوتاهمدت طولانی (LSTM) مدتهاست که بسیار محبوب بوده است. تا یک دقیقهٔ دیگر خواهیم دید که این مدلها چگونه کار میکنند — اما بیایید با امتحان کردن لایهٔ LSTM شروع کنیم.
لیستینگ ۱۳.۱۲: یک مدل سادهٔ مبتنی بر LSTM
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.LSTM(16)(inputs)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
callbacks = [    keras.callbacks.ModelCheckpoint("jena_lstm.keras", save_best_only=True)]model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=10,    validation_data=val_dataset,    callbacks=callbacks,)
model = keras.models.load_model("jena_lstm.keras")print("Test MAE: {model.evaluate(test_dataset)[1]:.2f}")
شکل ۱۳.۵ نتایج را نشان میدهد. بسیار بهتر! ما به MAE اعتبارسنجی به پایینی ۲.۳۹ درجه و MAE آزمایش ۲.۵۵ درجه دست مییابیم. مدل مبتنی بر LSTM در نهایت میتواند خط مبنای مبتنی بر عقل سلیم را شکست دهد (اگرچه در حال حاضر فقط کمی)، که ارزش یادگیری ماشین را روی این وظیفه نشان میدهد.
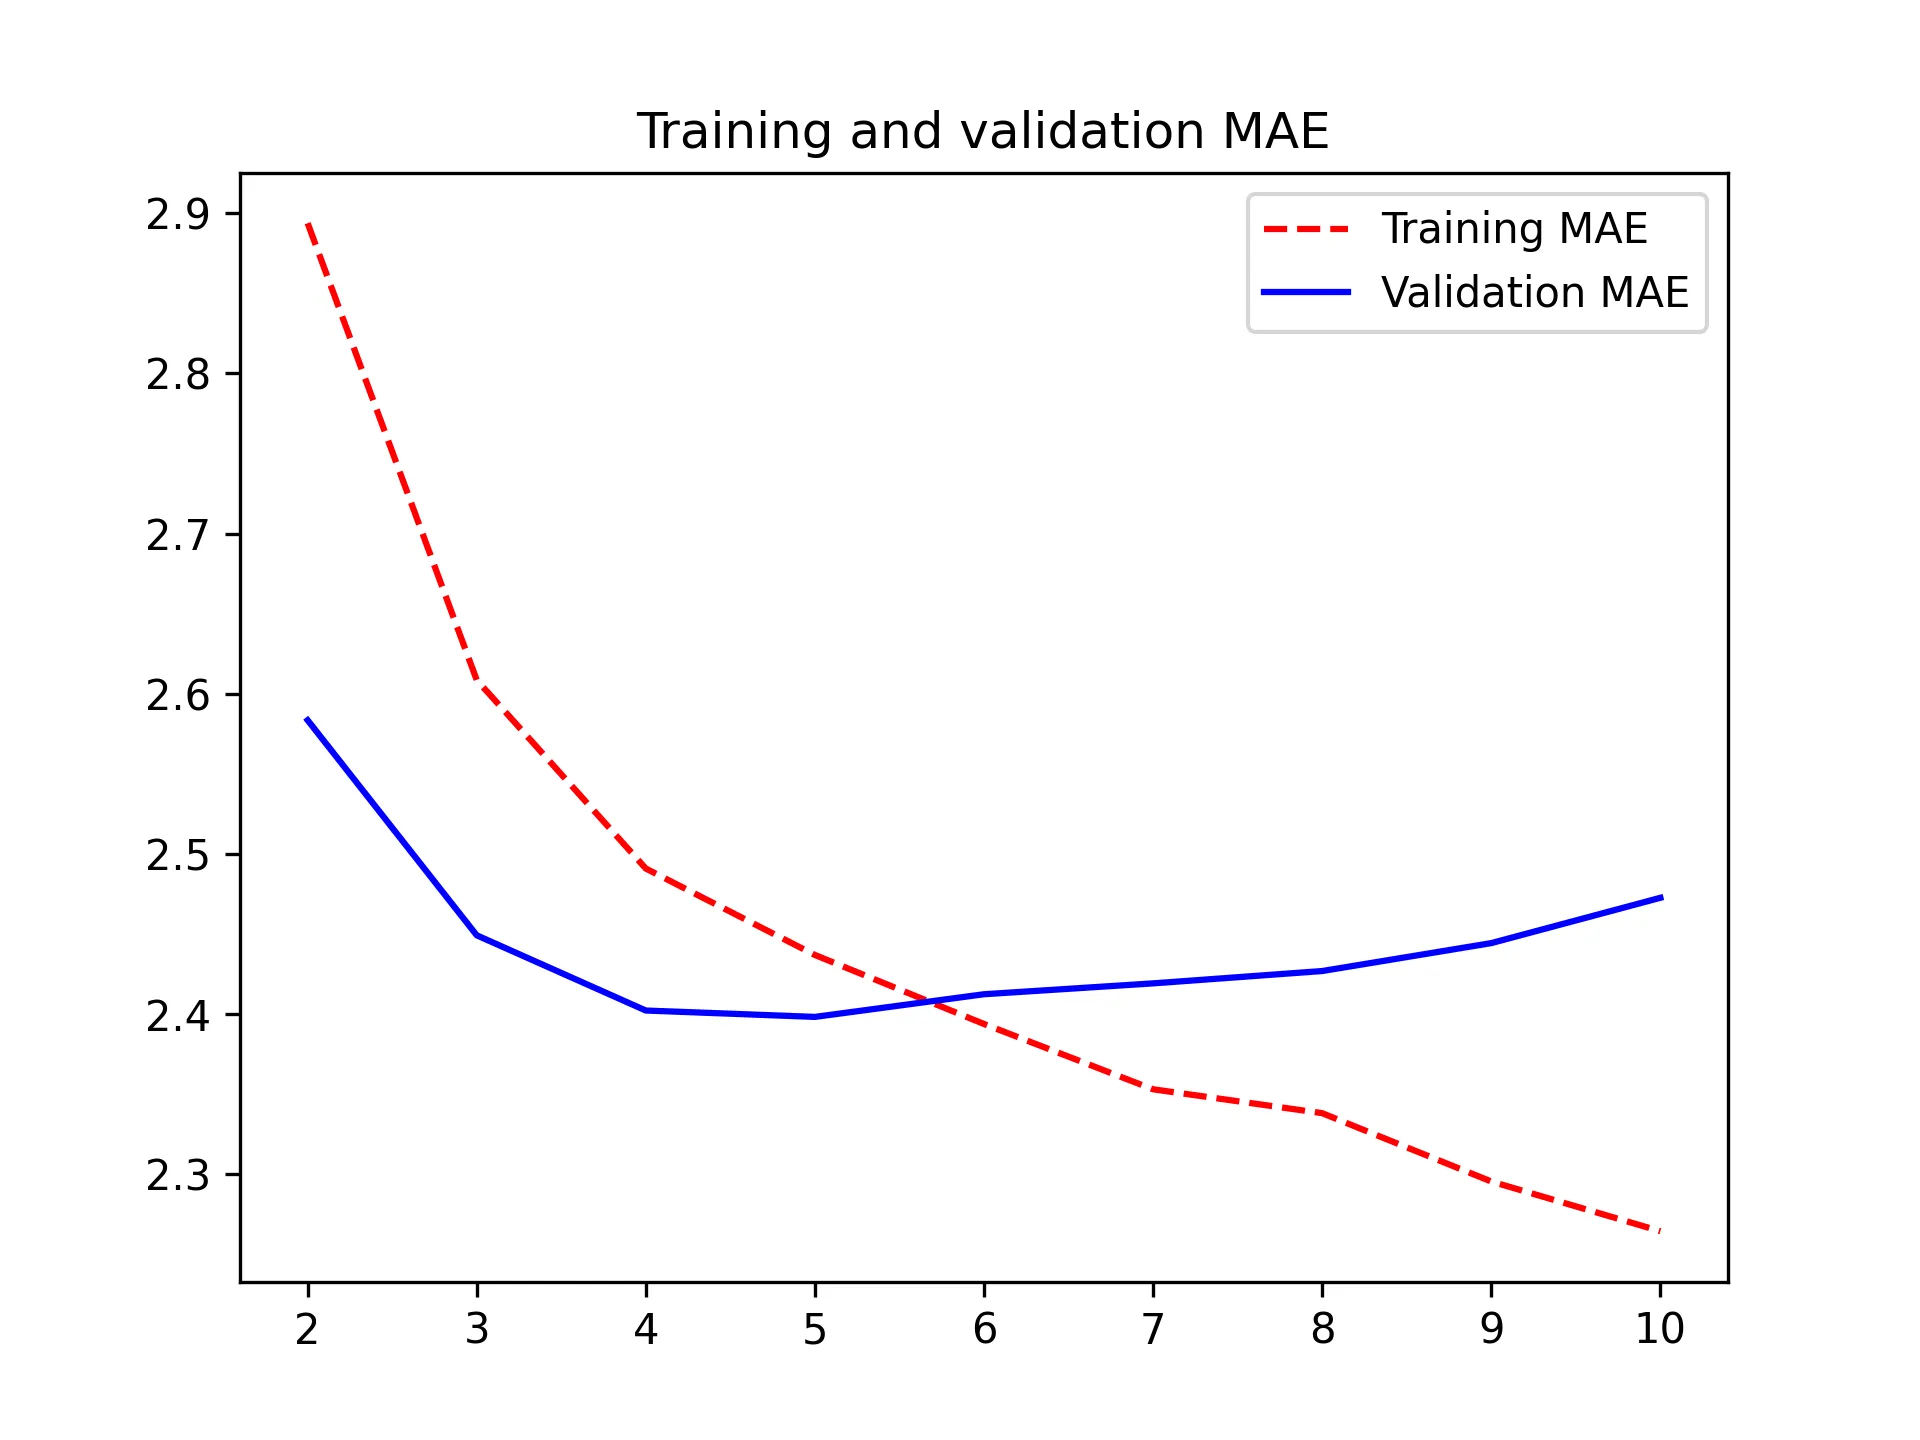
شکل ۱۳.۵: MAE آموزش و اعتبارسنجی در وظیفهٔ پیشبینی دمای Jena با یک مدل مبتنی بر LSTM. (توجه داشته باشید که دورهٔ ۱ را در این نمودار حذف کردهایم زیرا MAE بالای آموزش (۷.۷۵) در دورهٔ ۱ مقیاس را مخدوش میکرد.)
اما چرا مدل LSTM به طور محسوسی بهتر از مدل متراکم متصل یا ConvNet عمل کرد؟ و چگونه میتوانیم مدل را بیشتر اصلاح کنیم؟ برای پاسخ به این پرسش، بیایید نگاه دقیقتری به شبکههای عصبی برگشتی بیندازیم.
درک شبکههای عصبی برگشتی
Section titled “درک شبکههای عصبی برگشتی”یک ویژگی عمدهٔ تمام شبکههای عصبی که تاکنون دیدهاید، مانند شبکههای متراکم متصل و ConvNetها، این است که حافظهای ندارند. هر ورودی نشاندادهشده به آنها به طور مستقل پردازش میشود، بدون اینکه هیچ وضعیتی بین ورودیها حفظ شود. با چنین شبکههایی، برای پردازش یک دنباله یا یک سری زمانی از نقاط داده، باید کل دنباله را یکجا به شبکه نشان دهید: آن را به یک نقطهٔ دادهٔ واحد تبدیل کنید. برای مثال، این همان کاری است که در مثال شبکهٔ متراکم متصل انجام دادیم: دادههای پنج روز را به صورت یک بردار بزرگ منفرد مسطح کردیم و آن را در یک نوبت پردازش نمودیم. به چنین شبکههایی شبکههای پیشخور (feedforward networks) گفته میشود.
در مقابل، همانطور که در حال خواندن جملهٔ حاضر هستید، آن را کلمه به کلمه — یا بهتر است بگوییم، پرش چشمی به پرش چشمی — پردازش میکنید و در عین حال خاطرات آنچه را که پیش از این آمده حفظ مینمایید؛ این به شما بازنمایی روانی از معنای منتقلشده توسط این جمله میدهد. هوش بیولوژیکی اطلاعات را به صورت تدریجی پردازش میکند در حالی که یک مدل درونی از آنچه در حال پردازش آن است حفظ مینماید؛ مدلی که از اطلاعات گذشته ساخته شده و با ورود اطلاعات جدید دائماً بهروزرسانی میشود.
یک شبکهٔ عصبی برگشتی (recurrent neural network یا RNN) از همین اصل پیروی میکند، هرچند در نسخهای بسیار سادهشده: دنبالهها را با تکرار روی عناصر دنباله و حفظ یک وضعیت (state) حاوی اطلاعات مربوط به آنچه تاکنون دیده است پردازش میکند. در واقع، یک RNN نوعی شبکهٔ عصبی است که دارای یک حلقهٔ درونی (internal loop) است (شکل ۱۳.۶ را ببینید).
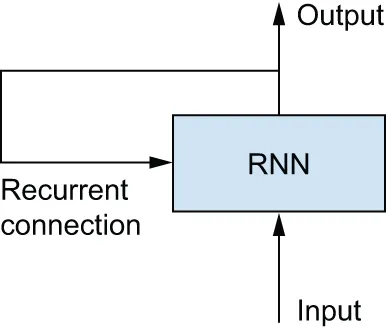
شکل ۱۳.۶: یک شبکهٔ برگشتی: شبکهای با یک حلقه
وضعیت RNN بین پردازش دو دنبالهٔ مجزا و مستقل (مانند دو نمونه در یک دسته) بازنشانی میشود، بنابراین شما همچنان یک دنباله را یک نقطهٔ دادهٔ واحد در نظر میگیرید: یک ورودی منفرد به شبکه. آنچه تغییر میکند این است که این نقطهٔ داده دیگر در یک گام منفرد پردازش نمیشود؛ بلکه شبکه به طور درونی روی عناصر دنباله حلقه میزند.
برای روشن شدن این مفاهیم حلقه و وضعیت، بیایید گذر رو به جلوی یک RNN اسباببازی را پیادهسازی کنیم. این RNN به عنوان ورودی یک دنباله از بردارها را دریافت میکند، که ما آن را به صورت یک تانسور رتبه-۲ با اندازهٔ (timesteps, input_features) کدگذاری خواهیم کرد. روی گامهای زمانی حلقه میزند، و در هر گام زمانی، وضعیت فعلی خود را در t و ورودی در t (با شکل (input_features,)) در نظر میگیرد و آنها را برای به دست آوردن خروجی در t ترکیب میکند. سپس وضعیت را برای گام بعدی برابر با این خروجی قبلی قرار میدهیم. برای اولین گام زمانی، خروجی قبلی تعریف نشده است؛ از این رو، وضعیت فعلی وجود ندارد. بنابراین وضعیت را به عنوان یک بردار کاملاً صفر به نام وضعیت اولیهٔ شبکه مقداردهی اولیه میکنیم.
در شبهکد، این همان RNN است.
لیستینگ ۱۳.۱۳: شبهکد RNN
# The state at tstate_t = 0# Iterates over sequence elementsfor input_t in input_sequence: output_t = f(input_t, state_t) # The previous output becomes the state for the next iteration. state_t = output_tشما حتی میتوانید تابع f را بسط دهید: تبدیل ورودی و وضعیت به یک خروجی توسط دو ماتریس، W و U، و یک بردار بایاس پارامتریزه خواهد شد. این شبیه به تبدیلی است که توسط یک لایهٔ متراکم متصل در یک شبکهٔ پیشخور انجام میشود.
لیستینگ ۱۳.۱۴: شبهکد دقیقتر برای RNN
state_t = 0for input_t in input_sequence: output_t = activation(dot(W, input_t) + dot(U, state_t) + b) state_t = output_tبرای اینکه این مفاهیم کاملاً بدون ابهام شوند، بیایید یک پیادهسازی سادهٔ NumPy از گذر رو به جلوی یک RNN ساده بنویسیم.
لیستینگ ۱۳.۱۵: پیادهسازی یک RNN ساده با NumPy
import numpy as np
# Number of timesteps in the input sequencetimesteps = 100# Dimensionality of the input feature spaceinput_features = 32# Dimensionality of the output feature spaceoutput_features = 64# Input data: random noise for the sake of the exampleinputs = np.random.random((timesteps, input_features))# Initial state: an all-zero vectorstate_t = np.zeros((output_features,))# Creates random weight matricesW = np.random.random((output_features, input_features))U = np.random.random((output_features, output_features))b = np.random.random((output_features,))successive_outputs = []# input_t is a vector of shape (input_features,).for input_t in inputs:    # Combines the input with the current state (the previous output)    # to obtain the current output. We use tanh to add nonlinearity (we    # could use any other activation function).    output_t = np.tanh(np.dot(W, input_t) + np.dot(U, state_t) + b)    # Stores this output in a list    successive_outputs.append(output_t)    # Updates the state of the network for the next timestep    state_t = output_t# The final output is a rank-2 tensor of shape (timesteps,# output_features).final_output_sequence = np.concatenate(successive_outputs, axis=0)
به اندازهٔ کافی ساده است: به طور خلاصه، یک RNN صرفاً یک حلقهٔ for است که از مقادیر محاسبهشده در طول تکرار قبلی حلقه دوباره استفاده میکند، و نه چیزی بیشتر. البته، RNNهای بسیار متفاوتی وجود دارند که با این تعریف مطابقت دارند و شما میتوانید بسازید — این مثال یکی از سادهترین فرمولبندیهای RNN است. شبکههای عصبی برگشتی با تابع گام خود مشخص میشوند، مانند تابع زیر در این مورد (شکل ۱۳.۷ را ببینید):
output_t = tanh(matmul(input_t, W) + matmul(state_t, U) + b)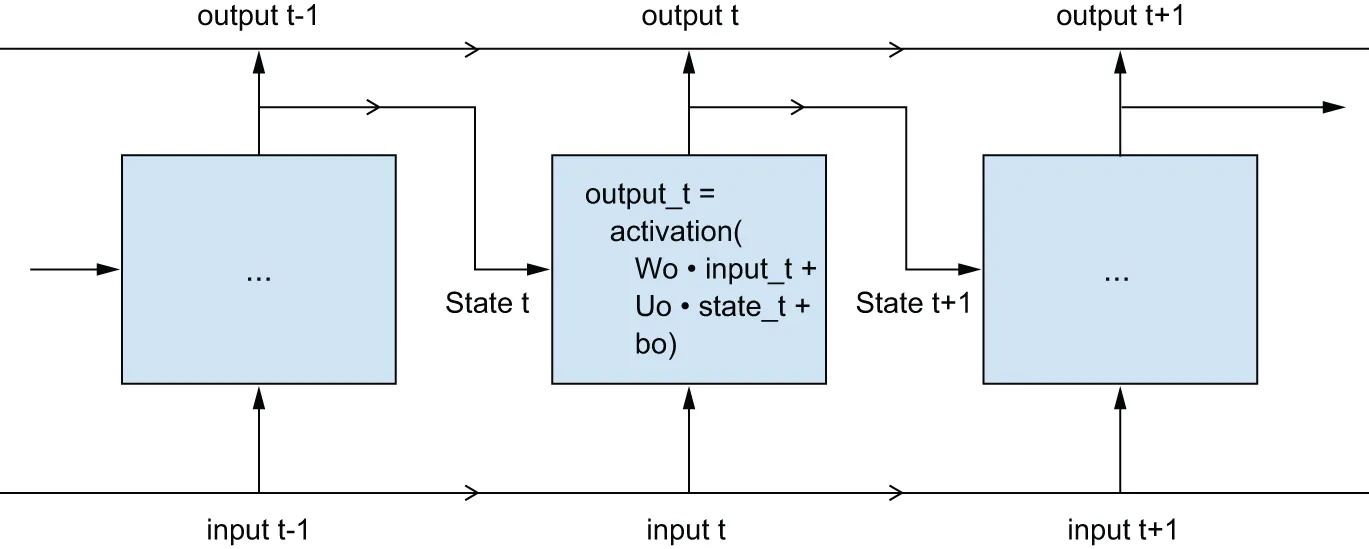
شکل ۱۳.۷: یک RNN ساده، بازشده در طول زمان
یک لایهٔ برگشتی در Keras
Section titled “یک لایهٔ برگشتی در Keras”فرایندی که به تازگی به صورت ساده در NumPy پیادهسازی کردید با یک لایهٔ واقعی در Keras مطابقت دارد — لایهٔ SimpleRNN.
یک تفاوت جزئی وجود دارد: SimpleRNN دستههایی از دنبالهها را مانند سایر لایههای Keras پردازش میکند، نه یک دنبالهٔ منفرد مانند مثال NumPy. این بدان معناست که ورودیهایی با شکل (batch_size, timesteps, input_features) را دریافت میکند و نه (timesteps, input_features). هنگام تعیین آرگومان shape در Input() اولیهٔ خود، توجه داشته باشید که میتوانید درایهٔ timesteps را روی None تنظیم کنید، که شبکهٔ شما را قادر میسازد دنبالههایی با طول دلخواه را پردازش کند.
لیستینگ ۱۳.۱۶: یک لایهٔ RNN که میتواند دنبالههایی با هر طولی را پردازش کند
num_features = 14inputs = keras.Input(shape=(None, num_features))outputs = layers.SimpleRNN(16)(inputs)این قابلیت به ویژه زمانی مفید است که مدل شما قرار است دنبالههایی با طول متغیر را پردازش کند. با این حال، اگر تمام دنبالههای شما طول یکسانی دارند، توصیه میکنم یک شکل ورودی کامل را مشخص کنید، زیرا این امر model.summary() را قادر میسازد اطلاعات طول خروجی را نمایش دهد، که همیشه خوب است، و میتواند برخی از بهینهسازیهای عملکرد را باز کند (یادداشت «دربارهٔ عملکرد زمان اجرای RNN» را در ادامهٔ این فصل ببینید).
تمام لایههای برگشتی در Keras (یعنی SimpleRNN، LSTM، و GRU) میتوانند در دو حالت مختلف اجرا شوند: آنها میتوانند یا دنبالههای کاملی از خروجیهای متوالی برای هر گام زمانی (یک تانسور رتبه-۳ با شکل (batch_size, timesteps, output_features)) یا فقط آخرین خروجی را برای هر دنبالهٔ ورودی (یک تانسور رتبه-۲ با شکل (batch_size, output_features)) بازگردانند. این دو حالت توسط آرگومان سازندهٔ return_sequences کنترل میشوند. بیایید به مثالی نگاه کنیم که از SimpleRNN استفاده میکند و تنها خروجی آخرین گام زمانی را برمیگرداند.
لیستینگ ۱۳.۱۷: یک لایهٔ RNN که تنها آخرین گام خروجی خود را بازمیگرداند
>>> num_features = 14>>> steps = 120>>> inputs = keras.Input(shape=(steps, num_features))>>> # Note that return_sequences=False is the default.>>> outputs = layers.SimpleRNN(16, return_sequences=False)(inputs)>>> print(outputs.shape)مثال زیر دنبالهٔ کامل خروجی را بازمیگرداند.
لیستینگ ۱۳.۱۸: یک لایهٔ RNN که دنبالهٔ کامل خروجی خود را بازمیگرداند
>>> num_features = 14>>> steps = 120>>> inputs = keras.Input(shape=(steps, num_features))>>> # Sets return_sequences to True>>> outputs = layers.SimpleRNN(16, return_sequences=True)(inputs)>>> print(outputs.shape)گاهی اوقات پشتهسازی چندین لایهٔ برگشتی پشت سر هم برای افزایش توان بازنمایی یک شبکه مفید است. در چنین ساختاری، باید تمام لایههای میانی را طوری تنظیم کنید که دنبالهٔ کامل خروجیها را بازگردانند.
لیستینگ ۱۳.۱۹: پشتهسازی لایههای RNN
inputs = keras.Input(shape=(steps, num_features))x = layers.SimpleRNN(16, return_sequences=True)(inputs)x = layers.SimpleRNN(16, return_sequences=True)(x)outputs = layers.SimpleRNN(16)(x)حال، در عمل، شما به ندرت با لایهٔ SimpleRNN کار خواهید کرد. این لایه به طور کلی بیش از حد ساده است و کاربرد واقعی ندارد. به ویژه، SimpleRNN یک مشکل عمده دارد: اگرچه از نظر تئوری باید بتواند در زمان t اطلاعات مربوط به ورودیهای دیدهشده در گامهای زمانی بسیار قبلتر را حفظ کند، اما در عمل یادگیری چنین وابستگیهای بلندمدتی غیرممکن است. این به دلیل مسئلهٔ محوشدگی گرادیان (vanishing gradients problem) است، اثری مشابه آنچه در شبکههای غیربرگشتی (شبکههای پیشخور) که لایههای عمیق زیادی دارند مشاهده میشود: با افزودن مداوم لایهها به یک شبکه، شبکه در نهایت غیرقابل آموزش میشود. دلایل نظری این پدیده توسط هوخرایتر، اشمیدهوبر و بنجیو در اوایل دههٔ ۱۹۹۰ مورد بررسی قرار گرفت.3
خوشبختانه، SimpleRNN تنها لایهٔ برگشتی موجود در Keras نیست. دو لایهٔ دیگر وجود دارد، LSTM و GRU، که برای حل این مشکل طراحی شدهاند.
بیایید لایهٔ LSTM را در نظر بگیریم. لایهٔ حافظهٔ کوتاهمدت طولانی (LSTM)4 توسط هوخرایتر و اشمیدهوبر در سال ۱۹۹۷ توسعه یافت؛ این لایه اوج پژوهشهای آنها روی مسئلهٔ محوشدگی گرادیان بود.
این لایه نوعی از لایهٔ SimpleRNN است که روشی را برای انتقال اطلاعات در طول چندین گام زمانی اضافه میکند. تصور کنید یک مسیر نقاله در موازات دنبالهای که در حال پردازش آن هستید حرکت میکند. اطلاعات مربوط به دنباله میتوانند در هر نقطهای به مسیر بپرند، به یک گام زمانی بعدی منتقل شوند، و در صورت نیاز، دستنخورده از آن پیاده شوند. این دقیقاً کاری است که LSTM انجام میدهد: اطلاعات را برای استفادهٔ بعدی ذخیره میکند، و در نتیجه از ناپدید شدن تدریجی سیگنالهای قدیمیتر در طول آموزش جلوگیری مینماید. این کار باید شما را به یاد اتصالات باقیمانده (residual connections) بیندازد که در فصل ۹ با آنها آشنا شدید: اساساً همان ایده است.
برای درک دقیق این فرایند، بیایید از سلول SimpleRNN شروع کنیم (شکل ۱۳.۸ را ببینید). از آنجا که ماتریسهای وزن زیادی خواهید داشت، ماتریسهای W و U در سلول را با حرف o (یعنی Wo و Uo) برای خروجی (output) اندیسگذاری کنید.
شکل ۱۳.۸: نقطهٔ شروع یک لایهٔ LSTM: یک SimpleRNN
بیایید یک جریان دادهٔ اضافی به این تصویر اضافه کنیم که اطلاعات را در طول گامهای زمانی حمل میکند. مقادیر آن را در گامهای زمانی مختلف Ct بنامید، که در آن C مخفف حمل (carry) است. این اطلاعات تأثیر زیر را روی سلول خواهند گذاشت: با اتصال ورودی و اتصال برگشتی ترکیب میشوند (از طریق یک تبدیل متراکم: حاصلضرب نقطهای با یک ماتریس وزن به همراه جمع یک بایاس و اعمال یک تابع فعالسازی)، و بر وضعیتی که به گام زمانی بعدی ارسال میشود تأثیر میگذارند (از طریق یک تابع فعالسازی و یک عمل ضرب). از نظر مفهومی، جریان دادهٔ حمل روشی برای تعدیل خروجی بعدی و وضعیت بعدی است (شکل ۱۳.۹ را ببینید). تا اینجا ساده است.
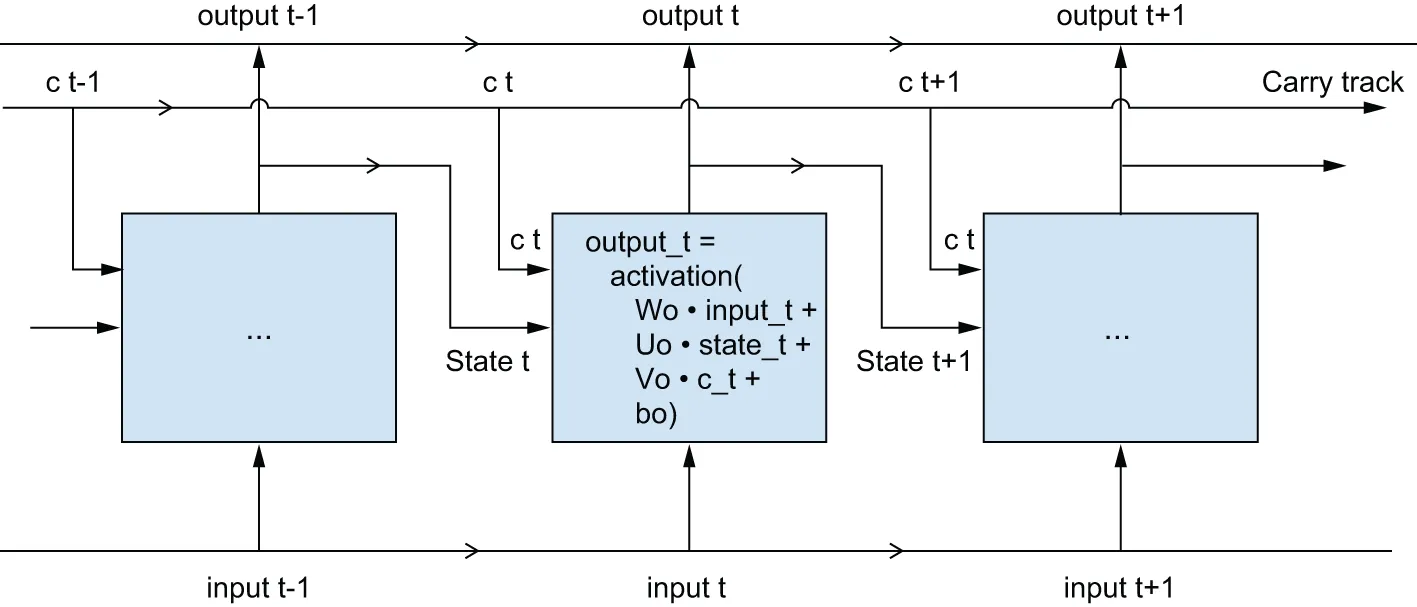
شکل ۱۳.۹: گذر از یک SimpleRNN به یک LSTM: افزودن یک مسیر حمل
حال نکتهٔ ظریف: روش محاسبهٔ مقدار بعدی جریان دادهٔ حمل. این محاسبه شامل سه تبدیل مجزا است. هر سه تبدیل شکلی شبیه به یک سلول SimpleRNN دارند:
y = activation(dot(state_t, U) + dot(input_t, W) + b)اما هر سه تبدیل ماتریسهای وزن اختصاصی خود را دارند که شما آنها را با حروف i، f، و k اندیسگذاری خواهید کرد. در اینجا آنچه تاکنون در اختیار دارید آمده است (ممکن است کمی دلخواه به نظر برسد، اما با من همراه باشید).
لیستینگ ۱۳.۲۰: جزئیات شبهکد معماری LSTM (بخش ۱/۲)
output_t = activation(dot(state_t, Uo) + dot(input_t, Wo) + dot(C_t, Vo) + bo)i_t = activation(dot(state_t, Ui) + dot(input_t, Wi) + bi)f_t = activation(dot(state_t, Uf) + dot(input_t, Wf) + bf)k_t = activation(dot(state_t, Uk) + dot(input_t, Wk) + bk)شما وضعیت حمل جدید (مقدار بعدی c_t) را با ترکیب i_t، f_t، و k_t به دست میآورید.
لیستینگ ۱۳.۲۱: جزئیات شبهکد معماری LSTM (بخش ۲/۲)
c_t+1 = i_t * k_t + c_t * f_tاین را همانطور که در شکل ۱۳.۱۰ نشان داده شده است اضافه کنید. و تمام. چندان پیچیده نیست — صرفاً اندکی بغرنج است.
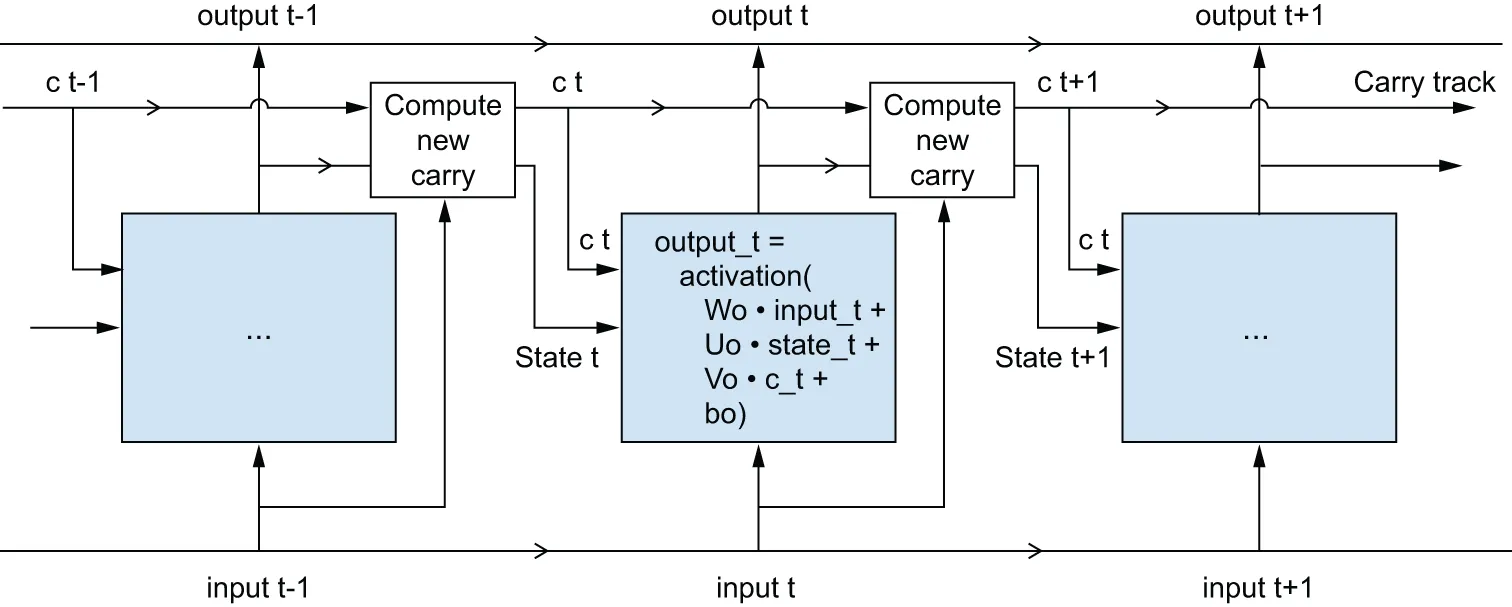
شکل ۱۳.۱۰: کالبدشناسی یک LSTM
اگر بخواهید نگاهی فلسفی داشته باشید، میتوانید تفسیر کنید که هر یک از این عملیاتها قرار است چه کاری انجام دهند. برای مثال، میتوانید بگویید که ضرب c_t و f_t روشی برای فراموش کردن عمدی اطلاعات نامربوط در جریان دادهٔ حمل است. در همین حال، i_t و k_t اطلاعاتی دربارهٔ زمان حال ارائه میدهند و مسیر حمل را با اطلاعات جدید بهروزرسانی میکنند. اما در نهایت، این تفاسیر معنای چندانی ندارند زیرا آنچه این عملیاتها واقعاً انجام میدهند توسط محتوای وزنهای پارامتریزه کنندهٔ آنها تعیین میشود، و این وزنها به شیوهٔ سرتاسری (end-to-end) آموخته میشوند و با هر دور آموزش از نو آغاز میگردند، که نسبت دادن این یا آن عملیات به یک هدف خاص را غیرممکن میسازد. مشخصات یک سلول RNN (همانطور که شرح داده شد) فضای فرضیهٔ شما را تعیین میکند — فضایی که در آن در طول آموزش به دنبال یک پیکربندی خوب از مدل میگردید — اما تعیین نمیکند که سلول چه کاری انجام میدهد؛ این امر بر عهدهٔ وزنهای سلول است. همان سلول با وزنهای متفاوت میتواند کارهای بسیار متفاوتی انجام دهد. بنابراین ترکیب عملیاتهایی که یک سلول RNN را تشکیل میدهند بهتر است به عنوان مجموعهای از قیود (constraints) بر جستجوی شما تفسیر شوند، نه به عنوان یک طراحی مهندسی به معنای متداول آن.
به احتمال زیاد، انتخاب چنین قیودی — یعنی مسئلهٔ نحوهٔ پیادهسازی سلولهای RNN — بهتر است به الگوریتمهای بهینهسازی (مانند الگوریتمهای ژنتیک یا فرایندهای یادگیری تقویتی) واگذار شود تا مهندسان انسانی. در آینده، ما مدلهای خود را به این شیوه خواهیم ساخت. به طور خلاصه، نیازی نیست چیزی دربارهٔ معماری خاص یک سلول LSTM بدانید؛ به عنوان یک انسان، درک آن نباید وظیفهٔ شما باشد. فقط به خاطر داشته باشید که سلول LSTM قرار است چه کاری انجام دهد: امکان تزریق مجدد اطلاعات گذشته را در زمان بعدی فراهم کند، و در نتیجه با مسئلهٔ محوشدگی گرادیان مبارزه نماید.
بیشترین بهرهبرداری از شبکههای عصبی برگشتی
Section titled “بیشترین بهرهبرداری از شبکههای عصبی برگشتی”تا این نقطه، شما موارد زیر را آموختهاید:
- شبکههای عصبی برگشتی (RNNها) چه هستند و چگونه کار میکنند
- یک LSTM چیست و چرا روی دنبالههای طولانی بهتر از یک RNN ساده عمل میکند
- نحوهٔ استفاده از لایههای RNN در Keras برای پردازش دادههای دنبالهای
در ادامه، تعدادی از ویژگیهای پیشرفتهتر RNNها را بررسی خواهیم کرد که میتوانند به شما کمک کنند بیشترین بهره را از مدلهای دنبالهای یادگیری عمیق خود ببرید. تا پایان این بخش، بیشتر آنچه را که باید دربارهٔ استفاده از شبکههای برگشتی با Keras بدانید خواهید دانست.
ما موارد زیر را پوشش خواهیم داد:
- دراپاوت برگشتی (Recurrent dropout) — این نوعی از دراپاوت است که برای مبارزه با بیشبرازش در لایههای برگشتی استفاده میشود.
- پشتهسازی لایههای برگشتی (Stacking recurrent layers) — این کار توان بازنمایی مدل را افزایش میدهد (به قیمت بار محاسباتی بیشتر).
- لایههای برگشتی دوطرفه (Bidirectional recurrent layers) — این لایهها همان اطلاعات را به روشهای متفاوتی به یک شبکهٔ برگشتی ارائه میدهند که باعث افزایش دقت و کاهش مشکلات فراموشی میشود.
ما از این تکنیکها برای اصلاح و ارتقای RNN پیشبینی دمای خود استفاده خواهیم کرد.
استفاده از دراپاوت برگشتی برای مبارزه با بیشبرازش
Section titled “استفاده از دراپاوت برگشتی برای مبارزه با بیشبرازش”بیایید به مدل مبتنی بر LSTM که پیشتر در این فصل استفاده کردیم برگردیم — اولین مدلی که توانست خط مبنای مبتنی بر عقل سلیم را شکست دهد. اگر به منحنیهای آموزش و اعتبارسنجی نگاه کنید، مشهود است که مدل به سرعت در حال بیشبرازش است، علیرغم اینکه تنها واحدهای بسیار کمی دارد: زیانهای آموزش و اعتبارسنجی پس از چند دوره به طور قابل توجهی شروع به واگرایی میکنند. شما قبلاً با یک تکنیک کلاسیک برای مبارزه با این پدیده آشنا شدهاید: دراپاوت، که به طور تصادفی واحدهای ورودی یک لایه را صفر میکند تا همبستگیهای تصادفی را در دادههای آموزشی که لایه در معرض آنها قرار دارد بشکند. اما نحوهٔ اعمال صحیح دراپاوت در شبکههای برگشتی مسئلهای ساده و پیشپاافتاده نیست.
مدتهاست مشخص شده که اعمال دراپاوت قبل از یک لایهٔ برگشتی به جای کمک به منظمسازی، مانع از یادگیری میشود. در سال ۲۰۱۵، یارین گال به عنوان بخشی از پایاننامهٔ دکتری خود در زمینهٔ یادگیری عمیق بیزی،5 روش مناسب استفاده از دراپاوت با یک شبکهٔ برگشتی را تعیین کرد: همان ماسک دراپاوت (همان الگوی واحدهای حذفشده) باید در هر گام زمانی اعمال شود، به جای ماسک دراپاوتی که به طور تصادفی از یک گام زمانی به گام زمانی دیگر تغییر کند. علاوه بر این، برای منظمسازی بازنماییهای تشکیلشده توسط گیتهای برگشتی لایههایی مانند GRU و LSTM، باید یک ماسک دراپاوت ثابت در طول زمان به فعالسازیهای برگشتی درونی لایه اعمال شود (یک ماسک دراپاوت برگشتی). استفاده از همان ماسک دراپاوت در هر گام زمانی به شبکه اجازه میدهد تا خطای یادگیری خود را به درستی در طول زمان منتشر کند؛ یک ماسک دراپاوت تصادفی در طول زمان این سیگنال خطا را مختل کرده و به فرایند یادگیری آسیب میرساند.
یارین گال پژوهش خود را با استفاده از Keras انجام داد و به ساخت مستقیم این سازوکار درون لایههای برگشتی Keras کمک کرد. هر لایهٔ برگشتی در Keras دو آرگومان مرتبط با دراپاوت دارد: dropout، یک عدد اعشاری که نرخ دراپاوت را برای واحدهای ورودی لایه مشخص میکند، و recurrent_dropout، که نرخ دراپاوت واحدهای برگشتی را تعیین مینماید. بیایید دراپاوت برگشتی را به لایهٔ LSTM اولین مثال LSTM خود اضافه کنیم و ببینیم که انجام این کار چگونه بر بیشبرازش تأثیر میگذارد.
به لطف دراپاوت، نیازی نخواهد بود که برای منظمسازی تا این حد به اندازهٔ شبکه وابسته باشیم، بنابراین از یک لایهٔ LSTM با دو برابر واحد بیشتر استفاده خواهیم کرد که امیدواریم گویاتر باشد (بدون دراپاوت، این شبکه بلافاصله شروع به بیشبرازش میکرد — امتحان کنید). از آنجا که شبکههایی که با دراپاوت منظمسازی میشوند همیشه زمان بسیار بیشتری برای همگرایی کامل نیاز دارند، ما مدل را برای پنج برابر دورهٔ بیشتر آموزش خواهیم داد.
لیستینگ ۱۳.۲۲: آموزش و ارزیابی یک LSTM منظمسازیشده با دراپاوت
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.LSTM(32, recurrent_dropout=0.25)(inputs)# To regularize the Dense layer, we also add a Dropout layer after the# LSTM.x = layers.Dropout(0.5)(x)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
callbacks = [    keras.callbacks.ModelCheckpoint(        "jena_lstm_dropout.keras", save_best_only=True    )]model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=50,    validation_data=val_dataset,    callbacks=callbacks,)
شکل ۱۳.۱۱ نتایج را نشان میدهد. موفقیتآمیز بود! ما دیگر در طول ۲۰ دورهٔ اول دچار بیشبرازش نمیشویم. ما به MAE اعتبارسنجی به پایینی ۲.۲۷ درجه (۷٪ بهبود نسبت به خط مبنای بدون یادگیری) و MAE آزمایش ۲.۴۵ درجه (۶.۵٪ بهبود نسبت به خط مبنا) دست مییابیم. نتیجهٔ بسیار خوبی است.
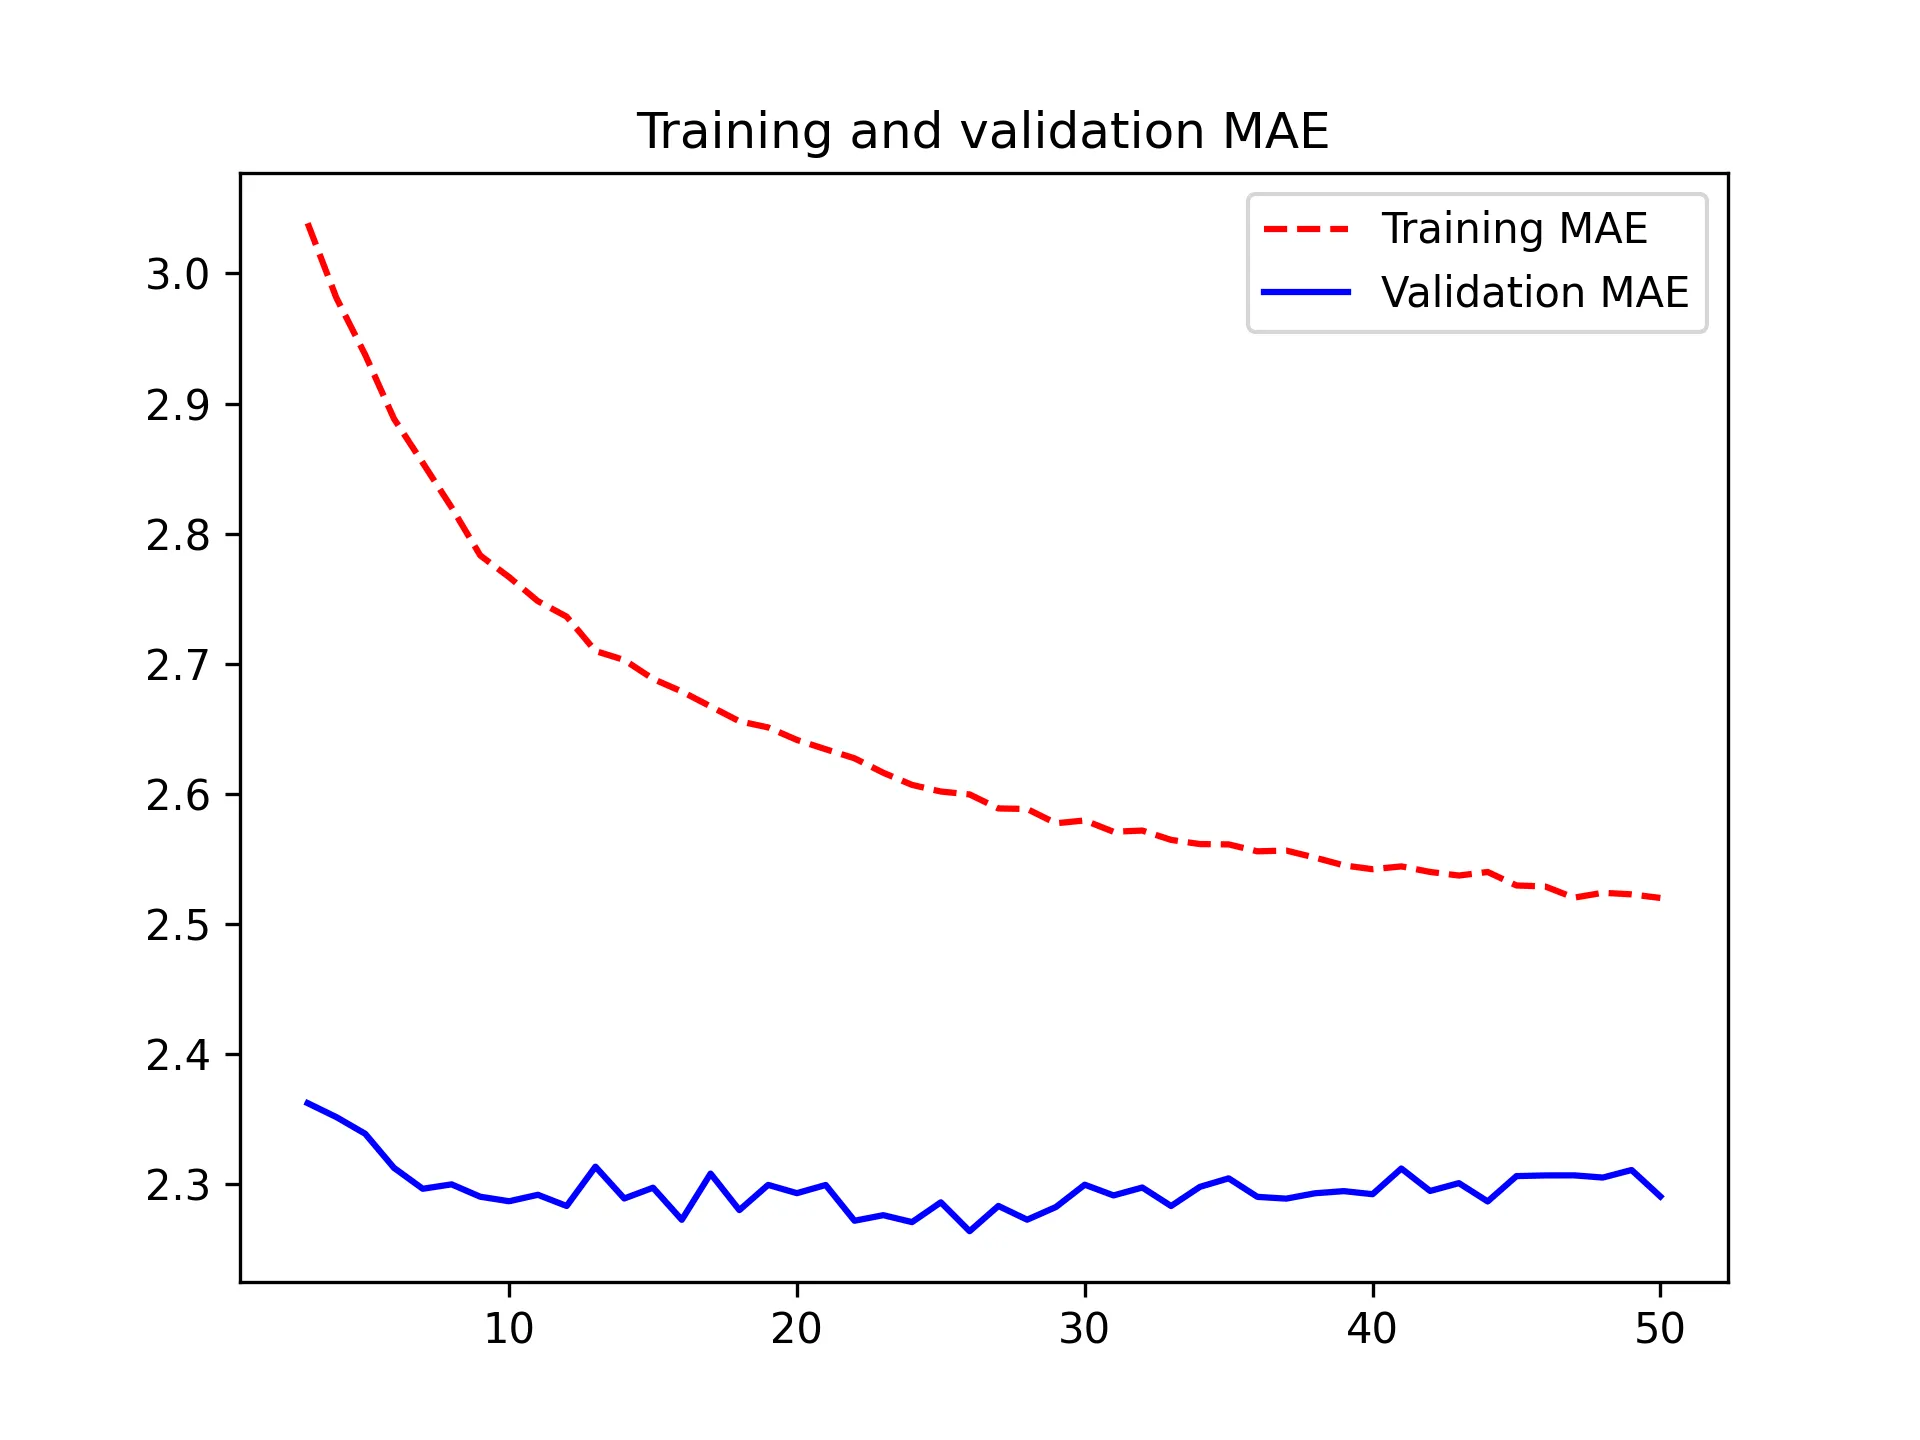
شکل ۱۳.۱۱: زیان آموزش و اعتبارسنجی در وظیفهٔ پیشبینی دمای Jena با یک LSTM منظمسازیشده با دراپاوت
پشتهسازی لایههای برگشتی
Section titled “پشتهسازی لایههای برگشتی”از آنجا که دیگر دچار بیشبرازش نمیشوید، اما به نظر میرسد به یک گلوگاه عملکرد برخورد کردهاید، باید افزایش ظرفیت و توان بیانگری شبکه را در نظر بگیرید. شرح گردشکار یادگیری ماشین جهانی را به یاد بیاورید: معمولاً ایدهٔ خوبی است که ظرفیت مدل خود را افزایش دهید تا زمانی که بیشبرازش به مانع اصلی تبدیل شود (با این فرض که قبلاً اقدامات اساسی را برای کاهش بیشبرازش انجام دادهاید، مانند استفاده از دراپاوت). تا زمانی که بیشبرازش خیلی شدیدی ندارید، احتمالاً ظرفیت مدل شما کمتر از حد لازم است.
افزایش ظرفیت شبکه معمولاً با افزایش تعداد واحدها در لایهها یا افزودن لایههای بیشتر انجام میشود. پشتهسازی لایههای برگشتی یک روش کلاسیک برای ساخت شبکههای برگشتی قدرتمندتر است: برای مثال، آنچه زمانی به الگوریتم Google Translate قدرت میبخشید پشتهای از هفت لایهٔ بزرگ LSTM بود — این واقعاً عظیم بود.
برای پشتهسازی لایههای برگشتی روی یکدیگر در Keras، تمام لایههای میانی باید دنبالهٔ کامل خروجیهای خود را بازگردانند (تانسورهای سهبعدی) به جای خروجیهای آخرین گام زمانی خود. این کار با مشخص کردن return_sequences=True انجام میشود، همانطور که قبلاً دیدید.
در مثال زیر، پشتهای از دو لایهٔ برگشتی را امتحان خواهیم کرد. به منظور تنوع، به جای لایههای LSTM از لایههای واحد برگشتی دروازهدار (Gated Recurrent Unit یا GRU) استفاده خواهیم کرد. GRU بسیار شبیه به LSTM است — میتوانید آن را نسخهٔ کمی سادهشده و ارزانتر از نظر محاسباتی از معماری LSTM در نظر بگیرید، اگرچه ممکن است قدرت بیانگری کمتری داشته باشد. این لایه توسط چوئه و همکاران در سال ۲۰۱۴ معرفی شد،6 زمانی که پژوهش روی شبکههای برگشتی دوباره شتاب گرفته بود.
لیستینگ ۱۳.۲۳: آموزش و ارزیابی یک مدل پشتهشدهٔ GRU منظمسازیشده با دراپاوت
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.GRU(32, recurrent_dropout=0.5, return_sequences=True)(inputs)x = layers.GRU(32, recurrent_dropout=0.5)(x)x = layers.Dropout(0.5)(x)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
callbacks = [    keras.callbacks.ModelCheckpoint(        "jena_stacked_gru_dropout.keras", save_best_only=True    )]model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=50,    validation_data=val_dataset,    callbacks=callbacks,)model = keras.models.load_model("jena_stacked_gru_dropout.keras")print(f"Test MAE: {model.evaluate(test_dataset)[1]:.2f}")
شکل ۱۳.۱۲ نتایج را نشان میدهد. ما به MAE اعتبارسنجی ۲.۲۷ و MAE آزمایش ۲.۴۴ دست مییابیم (بهبود ناچیز نسبت به مدل قبلی). میتوانید ببینید که افزودن یک لایه مقداری عملکرد را بهبود میبخشد، هرچند چندان چشمگیر نیست. در این مرحله، احتمالاً در حال تجربهٔ بازده نزولی در افزایش ظرفیت شبکه هستید.
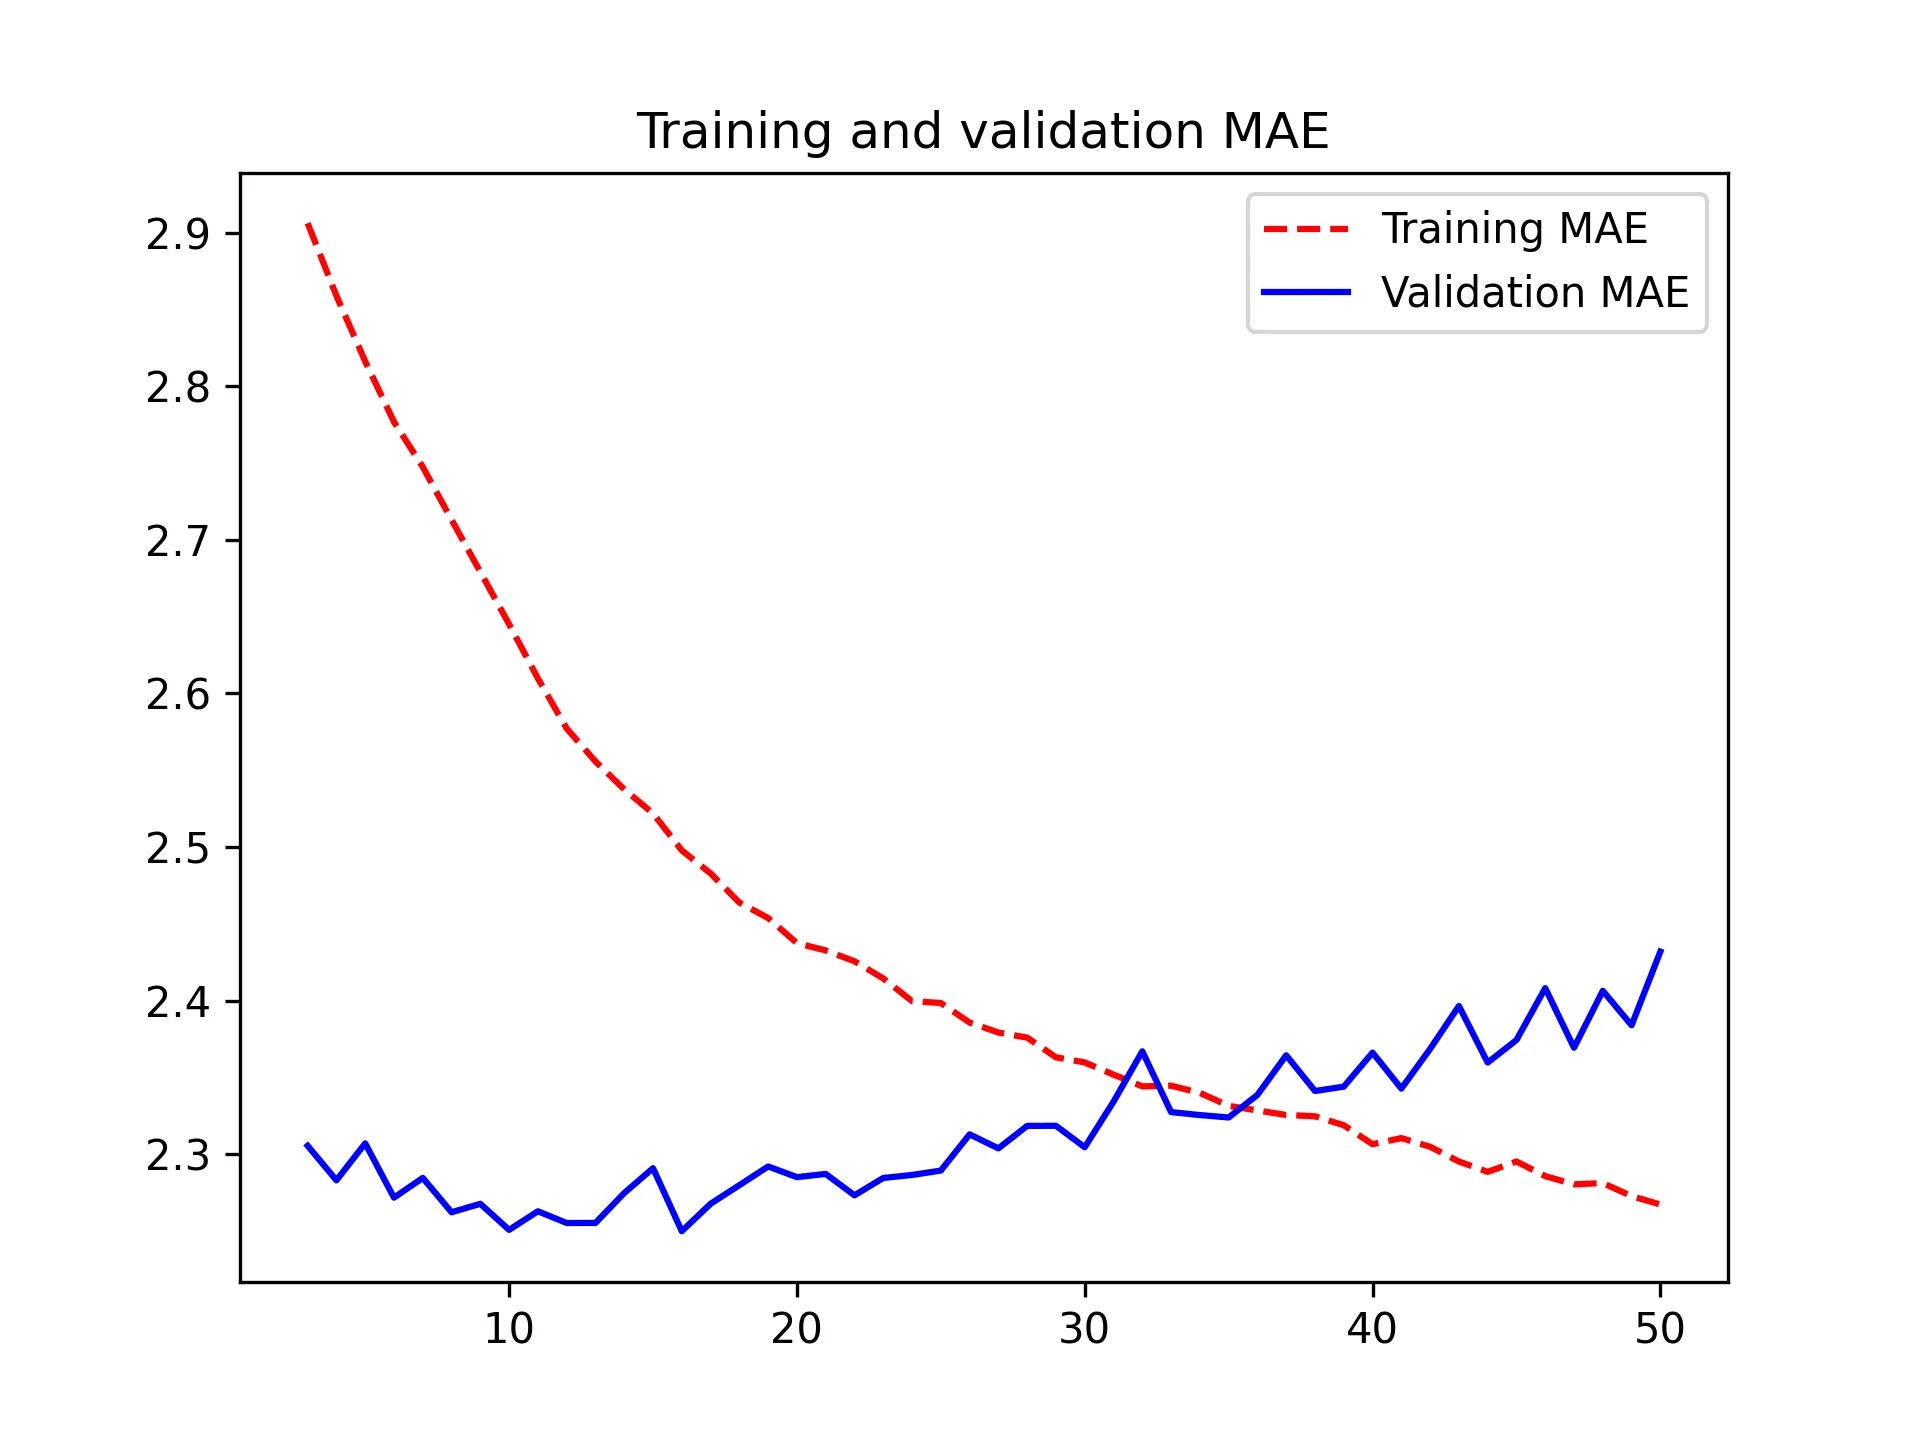
شکل ۱۳.۱۲: زیان آموزش و اعتبارسنجی در وظیفهٔ پیشبینی دمای Jena با یک شبکهٔ پشتهشدهٔ GRU
استفاده از RNNهای دوطرفه
Section titled “استفاده از RNNهای دوطرفه”آخرین تکنیکی که در این بخش به آن نگاه خواهیم کرد، RNN دوطرفه (bidirectional RNN) نام دارد. یک RNN دوطرفه یک معماری رایج RNN است که میتواند در وظایف خاص عملکرد بسیار بهتری نسبت به یک RNN معمولی ارائه دهد. اغلب در پردازش زبان طبیعی استفاده میشود — میتوانید آن را آچارفرانسهٔ یادگیری عمیق برای پردازش زبان طبیعی بدانید.
شبکههای عصبی برگشتی به طور ویژه به ترتیب وابسته هستند: آنها گامهای زمانی دنبالههای ورودی خود را به ترتیب پردازش میکنند، و بازآرایی یا معکوس کردن گامهای زمانی میتواند بازنماییهایی را که RNN از دنباله استخراج میکند کاملاً تغییر دهد. این دقیقاً دلیل عملکرد خوب آنها روی مسائلی است که ترتیب در آنها معنادار است، مانند مسئلهٔ پیشبینی دمای ما: گذشتهٔ نزدیک اطلاعات متفاوتی نسبت به گذشتهٔ دورتر به همراه دارد.
جالب توجه است که این واقعیت که لایههای RNN در این بخش دنبالهها را به ترتیب زمانی تقویمی (گامهای زمانی قدیمیتر در ابتدا) پردازش کردهاند، ممکن است تصمیمی دلخواه بوده باشد. دستکم، این تصمیمی است که تاکنون تلاشی برای زیر سؤال بردن آن نکردهایم. آیا اگر RNNها دنبالههای ورودی را به ترتیب عکس زمانی، برای مثال، گامهای زمانی جدیدتر در ابتدا، پردازش میکردند، عملکرد به اندازهٔ کافی خوبی میداشتند؟ بیایید این را در عمل امتحان کنیم و ببینیم چه اتفاقی میافتد. تنها کاری که باید انجام دهید نوشتن گونهای از مولد داده است که در آن دنبالههای ورودی در امتداد بعد زمان معکوس شده باشند (خط آخر را با yield samples[:, ::-1, :], targets جایگزین کنید).
هنگام آموزش همان مدل مبتنی بر LSTM که در اولین آزمایش در این بخش استفاده کردید، متوجه خواهید شد که چنین LSTM با ترتیب معکوس عملکردی به شدت ضعیفتر حتی از خط مبنای مبتنی بر عقل سلیم دارد. این نشان میدهد که در این مورد، پردازش زمانی تقویمی برای موفقیت این رویکرد اهمیت اساسی دارد. این کاملاً منطقی است: لایهٔ زیربنایی LSTM معمولاً در به خاطر سپردن گذشتهٔ نزدیک بهتر از گذشتهٔ دور عمل خواهد کرد، و طبیعتاً، نقاط دادهٔ جدیدتر آبوهوا برای این مسئله نسبت به نقاط دادهٔ قدیمیتر پیشبینیکنندهتر هستند (همین امر است که خط مبنای مبتنی بر عقل سلیم را نسبتاً قوی میسازد). بنابراین نسخهٔ زمانی تقویمی لایه ناگزیر است که عملکرد بهتری نسبت به نسخهٔ با ترتیب معکوس داشته باشد.
با این حال، این موضوع برای بسیاری از مسائل دیگر، از جمله زبان طبیعی، صادق نیست: از نظر شهودی، اهمیت یک کلمه در درک یک جمله وابستگی شدیدی به موقعیت آن در جمله ندارد. روی دادههای متنی، پردازش با ترتیب معکوس به همان خوبیِ پردازش زمانی تقویمی کار میکند — شما میتوانید متن را از آخر به اول نیز به خوبی بخوانید (امتحان کنید!). اگرچه ترتیب کلمات در درک زبان اهمیت دارد، اما اینکه از کدام ترتیب استفاده میکنید تعیینکننده نیست.
نکتهٔ مهم این است که یک RNN که روی دنبالههای معکوس آموزش دیده است، بازنماییهای متفاوتی را نسبت به مدلی که روی دنبالههای اصلی آموزش دیده است یاد خواهد گرفت، بسیار شبیه به اینکه اگر زمان در دنیای واقعی به سمت عقب حرکت میکرد — اگر در دنیایی زندگی میکردید که در اولین روز خود میمردید و در آخرین روز خود متولد میشدید — مدلهای ذهنی متفاوتی میداشتید. در یادگیری ماشین، بازنماییهایی که متفاوت و در عین حال مفید هستند همیشه ارزش بهرهبرداری را دارند، و هر چه تفاوت بیشتری داشته باشند، بهتر است: آنها زاویهٔ دید جدیدی را برای نگاه کردن به دادههایتان ارائه میدهند و جنبههایی از دادهها را ثبت میکنند که توسط رویکردهای دیگر نادیده گرفته شده بود، و بنابراین میتوانند به افزایش عملکرد روی یک وظیفه کمک کنند. این همان شهود پشت انسمبلسازی (ensembling) است؛ مفهومی که در فصل ۱۸ به بررسی آن خواهیم پرداخت.
یک RNN دوطرفه از این ایده برای بهبود عملکرد RNNهای با ترتیب زمانی تقویمی بهره میبرد. این شبکه دنبالهٔ ورودی خود را از هر دو جهت میبیند (شکل ۱۳.۱۳ را ببینید)، و بازنماییهای بالقوه غنیتری به دست میآورد و الگوهایی را ثبت میکند که ممکن است توسط نسخهٔ صرفاً با ترتیب زمانی نادیده گرفته شده باشند.
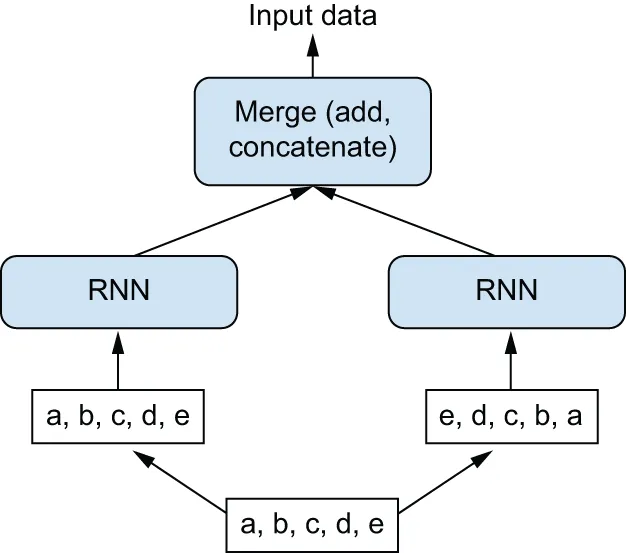
شکل ۱۳.۱۳: نحوهٔ کارکرد یک لایهٔ RNN دوطرفه
برای نمونهسازی یک RNN دوطرفه در Keras، از لایهٔ Bidirectional استفاده میکنید که به عنوان آرگومان اول خود نمونهای از یک لایهٔ برگشتی را دریافت میکند. لایهٔ Bidirectional یک نمونهٔ دوم و جداگانه از این لایهٔ برگشتی میسازد و از یک نمونه برای پردازش دنبالههای ورودی به ترتیب زمانی و از نمونهٔ دیگر برای پردازش دنبالههای ورودی به ترتیب معکوس استفاده میکند. میتوانید آن را روی وظیفهٔ پیشبینی دمای ما امتحان کنید.
لیستینگ ۱۳.۲۴: آموزش و ارزیابی یک LSTM دوطرفه
inputs = keras.Input(shape=(sequence_length, raw_data.shape[-1]))x = layers.Bidirectional(layers.LSTM(16))(inputs)outputs = layers.Dense(1)(x)model = keras.Model(inputs, outputs)
model.compile(optimizer="adam", loss="mse", metrics=["mae"])history = model.fit(    train_dataset,    epochs=10,    validation_data=val_dataset,)
خواهید دید که عملکرد آن به خوبی لایهٔ معمولی LSTM نیست. درک دلیل آن آسان است: تمام ظرفیت پیشبینی باید از نیمهٔ زمانی تقویمی شبکه حاصل شود زیرا مشخص است که نیمهٔ معکوس زمانی در این وظیفه عملکرد به شدت ضعیفی دارد (دوباره، به این دلیل که گذشتهٔ نزدیک در این مورد بسیار بیشتر از گذشتهٔ دور اهمیت دارد). در عین حال، وجود نیمهٔ معکوس زمانی ظرفیت شبکه را دو برابر میکند و باعث میشود بسیار زودتر دچار بیشبرازش شود.
با این حال، RNNهای دوطرفه برای دادههای متنی بسیار مناسب هستند — یا هر نوع دادهٔ دیگری که ترتیب در آن اهمیت دارد، اما اینکه از کدام جهت استفاده میکنید مهم نیست. در واقع، برای مدتی در سال ۲۰۱۶، LSTMهای دوطرفه به عنوان پیشرفتهترین حالت در بسیاری از وظایف پردازش زبان طبیعی در نظر گرفته میشدند (قبل از ظهور معماری Transformer، که در فصل ۱۵ با آن آشنا خواهید شد).
فراتر رفتن
Section titled “فراتر رفتن”کارهای بسیار دیگری وجود دارد که میتوانید برای بهبود عملکرد در مسئلهٔ پیشبینی دما امتحان کنید:
- تنظیم تعداد واحدها در هر لایهٔ برگشتی در ساختار پشتهای، و همچنین میزان دراپاوت. انتخابهای فعلی تا حد زیادی دلخواه و بنابراین احتمالاً زیرحدبهینه هستند.
- تنظیم نرخ یادگیری مورد استفاده توسط بهینهساز
Adamیا امتحان کردن یک بهینهساز متفاوت. - امتحان کردن استفاده از پشتهای از لایههای
Denseبه عنوان رگرسیونکننده روی لایهٔ برگشتی، به جای یک لایهٔDenseمنفرد. - بهبود ورودی مدل: استفاده از دنبالههای طولانیتر یا کوتاهتر، یا نرخ نمونهبرداری متفاوت، یا شروع به انجام مهندسی ویژگیها.
مثل همیشه، یادگیری عمیق بیشتر یک هنر است تا یک علم. ما میتوانیم دستورالعملهایی ارائه دهیم که نشان میدهند چه چیزی احتمالاً روی یک مسئلهٔ معین کار میکند یا کار نمیکند، اما در نهایت، هر مجموعهدادهای منحصر به فرد است؛ شما باید استراتژیهای مختلف را به صورت تجربی ارزیابی کنید. در حال حاضر هیچ نظریهای وجود ندارد که از قبل دقیقاً به شما بگوید برای حل بهینهٔ یک مسئله چه کاری باید انجام دهید. شما باید تکرار کنید.
بر اساس تجربهٔ ما، بهبود حدود ۱۰ درصدی نسبت به خط مبنای بدون یادگیری احتمالاً بهترین کاری است که میتوانید با این مجموعهداده انجام دهید. این نتیجه خیلی چشمگیر نیست، اما این نتایج منطقی هستند: در حالی که آبوهوای آیندهٔ نزدیک در صورتی که به دادههای شبکهٔ گستردهای از مکانهای مختلف دسترسی داشته باشید بسیار قابل پیشبینی است، اگر فقط اندازهگیریهایی از یک مکان منفرد داشته باشید چندان قابل پیشبینی نیست. تکامل آبوهوا در جایی که شما هستید به الگوهای فعلی آبوهوا در مناطق اطراف بستگی دارد.
- همانطور که برای اولین بار در فصل ۶ یاد گرفتید، هنگام پرداختن به یک مسئلهٔ جدید، بهتر است ابتدا خطوط مبنای مبتنی بر عقل سلیم را برای معیار انتخابی خود تعیین کنید. اگر خط مبنایی برای شکست دادن نداشته باشید، نمیتوانید بگویید که آیا پیشرفت واقعی داشتهاید یا خیر.
- قبل از مدلهای پرهزینه، مدلهای ساده را امتحان کنید تا هزینهٔ اضافی را توجیه نمایید. گاهی اوقات یک مدل ساده بهترین گزینهٔ شما خواهد بود.
- هنگامی که دادههایی دارید که ترتیب در آنها اهمیت دارد — به ویژه برای دادههای سری زمانی — شبکههای برگشتی بسیار مناسب هستند و به راحتی از مدلهایی که ابتدا دادههای زمانی را مسطح میکنند بهتر عمل مینمایند. دو لایهٔ اساسی RNN موجود در Keras عبارتند از لایهٔ
LSTMو لایهٔGRU. - برای استفاده از دراپاوت در شبکههای برگشتی، باید از یک ماسک دراپاوت ثابت در طول زمان و ماسک دراپاوت برگشتی استفاده کنید. این قابلیتها درون لایههای برگشتی Keras تعبیه شدهاند، بنابراین تنها کاری که باید انجام دهید استفاده از آرگومانهای
recurrent_dropoutدر لایههای برگشتی است. - شبکههای RNN پشتهشده توان بازنمایی بیشتری نسبت به یک لایهٔ برگشتی منفرد فراهم میکنند. آنها همچنین بسیار پرهزینهتر هستند و بنابراین همیشه ارزش این هزینه را ندارند. اگرچه آنها دستاوردهای مشخصی در مسائل پیچیده (مانند ترجمهٔ ماشینی) ارائه میدهند، اما ممکن است همیشه برای مسائل کوچکتر و سادهتر کاربرد نداشته باشند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
آدام اریکسون و اولاف کوله، https://www.bgc-jena.mpg.de/wetter. ↩
-
هیچ لایهٔ
SeparableConv3Dوجود ندارد، نه به دلیل نظری، بلکه صرفاً به این دلیل که ما آن را پیادهسازی نکردهایم. ↩ -
برای مثال، یوشوا بنجیو، پاتریس سیمارد، و پائولو فراسکونی را ببینید: “Learning Long-Term Dependencies with Gradient Descent Is Difficult,” IEEE Transactions on Neural Networks 5, no. 2 (1994). ↩
-
سپ هوخرایتر و یورگن اشمیدهوبر، “Long Short-Term Memory,” Neural Computation 9, no. 8 (1997). ↩
-
یارین گال را ببینید: “Uncertainty in Deep Learning (PhD Thesis),” October 13, 2016, https://www.cs.ox.ac.uk/people/yarin.gal/website/blog_2248.html. ↩
-
چوئه و همکاران را ببینید: “On the Properties of Neural Machine Translation: Encoder-Decoder Approaches,” 2014, https://arxiv.org/abs/1409.1259. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.