
فصل ۱۴: طبقهبندی متن
این فصل پایهای را برای کار با ورودیهای متنی ایجاد میکند که در دو فصل بعدی این کتاب روی آن بنا خواهیم کرد. در پایان این فصل، شما قادر خواهید بود به روشهای مختلف یک طبقهبند متن ساده بسازید. این امر زمینه را برای ساخت مدلهای پیچیدهتر، مانند ترنسفورمر (Transformer)، در فصل بعد فراهم میکند.
تاریخچهٔ کوتاهی از پردازش زبان طبیعی
Section titled “تاریخچهٔ کوتاهی از پردازش زبان طبیعی”در علوم رایانه، ما به زبانهای انسانی مانند انگلیسی یا ماندارین، زبانهای «طبیعی» میگوییم تا آنها را از زبانهایی که برای ماشینها طراحی شدهاند، مانند لیسپ (LISP)، اسمبلی (Assembly) و XML، متمایز کنیم. هر زبان ماشینی طراحی شده است: نقطهٔ شروع آن مهندسی بود که مجموعهای از قواعد رسمی را برای توصیف اینکه چه گزارههایی را میتوانید بیان کنید و معنای آنها چیست، نوشت. قواعد ابتدا آمدند و مردم تنها پس از تکمیل مجموعهٔ قواعد شروع به استفاده از زبان کردند. در زبان انسانی، قضیه برعکس است: کاربرد ابتدا میآید و قواعد بعداً شکل میگیرند. زبان طبیعی توسط یک فرایند تکاملی، بسیار شبیه به موجودات زنده شکل گرفت — این همان چیزی است که آن را «طبیعی» میکند. «قواعد» آن، مانند گرامر زبان انگلیسی، پس از واقعیت فرموله شدند و اغلب توسط کاربرانش نادیده گرفته یا نقض میشوند. در نتیجه، در حالی که زبان ماشینخوان بسیار ساختاریافته و دقیق است، زبان طبیعی نامنظم است — مبهم، پرهرجومرج، گسترده و دائماً در حال تغییر.
دانشمندان رایانه مدتهاست که بر پتانسیل سیستمهایی که میتوانند زبان طبیعی را دریافت یا تولید کنند تمرکز کردهاند. زبان، به ویژه متن نوشتاری، زیربنای بخش اعظم ارتباطات و تولیدات فرهنگی ماست. قرنها دانش بشری از طریق متن ذخیره شده است؛ اینترنت عمدتاً متن است و حتی افکار ما بر پایهٔ زبان استوار است! شیوهٔ استفاده از رایانهها برای تفسیر و دستکاری زبان، پردازش زبان طبیعی (natural language processing) یا به اختصار NLP نامیده میشود. این حوزه اولین بار بلافاصله پس از جنگ جهانی دوم به عنوان یک زمینهٔ مطالعاتی مطرح شد، جایی که برخی تصور میکردند میتوانیم درک زبان را به عنوان شکلی از «رمزگشایی (code cracking)» در نظر بگیریم، که در آن زبان طبیعی «کد» مورد استفاده برای انتقال اطلاعات است.
در روزهای اولیهٔ این حوزه، بسیاری از مردم سادهلوحانه فکر میکردند که میتوان «مجموعه قواعد زبان انگلیسی» را نوشت، بسیار شبیه به اینکه چگونه میتوان مجموعه قواعد لیسپ را نوشت. در اوایل دههٔ ۱۹۵۰، پژوهشگران IBM و دانشگاه جرجتاون سیستمی را به نمایش گذاشتند که میتوانست زبان روسی را به انگلیسی ترجمه کند. این سیستم از گرامری با شش قاعدهٔ هاردکدشده و یک جدول جستجو (lookup table) با چند صد عنصر (کلمات و پسوندها) برای ترجمهٔ دقیق ۶۰ جملهٔ دستچینشدهٔ روسی استفاده میکرد. هدف این بود که هیجان و بودجه را برای ترجمهٔ ماشینی برانگیزد و از این جهت، موفقیتی عظیم بود. با وجود ماهیت محدود این نمایش، نویسندگان ادعا کردند که ظرف پنج سال، ترجمه یک مسئلهٔ حلشده خواهد بود. بودجه برای بخش عمدهای از یک دهه سرازیر شد. با این حال، تعمیم دادن چنین سیستمی به شکل دیوانهکنندهای دشوار از آب درآمد. کلمات معنای خود را به طور چشمگیری بسته به زمینه (context) تغییر میدهند. هر قاعدهٔ گرامری نیازمند استثنائات بیشماری بود. توسعهٔ برنامهای که بتواند روی چند مثال دستچینشده بدرخشد به اندازهٔ کافی ساده بود، اما ساخت یک سیستم قوی که بتواند با مترجمان انسانی رقابت کند مسئلهٔ دیگری بود. یک گزارش تأثیرگذار دولتی آمریکا یک دهه بعد فقدان پیشرفت را آشکار کرد و بودجهها متوقف شدند.
علیرغم این شکستها و نوسانات مکرر از شور و شوق به ناامیدی، قواعد دستساز تا دههٔ ۱۹۹۰ به عنوان رویکرد غالب پابرجا ماندند. مشکلات واضح بودند، اما هیچ جایگزین مناسبی برای نوشتن قواعد نمادین جهت توصیف گرامر وجود نداشت. با این حال، با در دسترس قرار گرفتن رایانههای سریعتر و مقادیر بیشتری از دادهها در اواخر دههٔ ۱۹۸۰، پژوهشها در مسیر جدیدی آغاز شد. هنگامی که میبینید در حال ساختن سیستمهایی هستید که تودههای بزرگی از قواعد موردی (ad hoc) هستند، به عنوان یک مهندس باهوش، احتمالاً شروع به پرسیدن میکنید: «آیا میتوانم از یک مجموعه داده (corpus) برای خودکارسازی فرایند یافتن این قواعد استفاده کنم؟ آیا میتوانم به جای اینکه خودم قواعد را ابداع کنم، آنها را در یک فضای قاعده جستجو کنم؟» و درست به همین سادگی، شما به انجام یادگیری ماشین ارتقا پیدا کردهاید.
در اواخر دههٔ ۱۹۸۰، ما شاهد رویکردهای یادگیری ماشین در پردازش زبان طبیعی بودیم. اولین آنها مبتنی بر درختهای تصمیمگیری بودند — هدف به معنای واقعی کلمه خودکارسازی توسعهٔ همان نوع قواعد if/then/else در سیستمهای زبانی هاردکدشده بود. سپس، رویکردهای آماری شروع به سرعت گرفتن کردند که با رگرسیون لجستیک آغاز شد. به مرور زمان، مدلهای پارامتریک آموختهشده حاکم شدند و زبانشناسی توسط برخی به عنوان مانعی دیده شد وقتی که مستقیماً در مدل تعبیه میشد. فردریک جلینک، یکی از پژوهشگران اولیهٔ بازشناسی گفتار، در دههٔ ۱۹۹۰ به شوخی گفت: «هر بار که یک زبانشناس را اخراج میکنم، عملکرد سیستم بازشناسی گفتار بالاتر میرود.»
همانطور که بینایی ماشین در واقع بازشناسی الگو اعمالشده بر پیکسلها است، حوزهٔ مدرن NLP نیز تماماً در مورد بازشناسی الگو اعمالشده بر کلمات در متن است. هیچ کمبودی در کاربردهای عملی وجود ندارد:
- با توجه به متن یک ایمیل، احتمال اسپم بودن آن چقدر است؟ ( طبقهبندی متن )
- با توجه به یک جملهٔ انگلیسی، محتملترین ترجمهٔ روسی آن چیست؟ ( ترجمه )
- با توجه به یک جملهٔ ناقص، احتمالاً چه کلمهای در ادامه خواهد آمد؟ ( مدلسازی زبان )
مدلهای پردازش متنی که در این کتاب آموزش خواهید داد، درک انسانمانندی از زبان نخواهند داشت؛ بلکه آنها صرفاً به دنبال نظمها و الگوهای آماری در دادههای ورودی خود میگردند، که معلوم میشود برای عملکرد خوب در طیف گستردهای از وظایف دنیای واقعی کافی است.
در دههٔ گذشته، پژوهشگران و متخصصان NLP کشف کردهاند که یادگیری پاسخ به پرسشهای آماری دقیق دربارهٔ متن چقدر میتواند به طور تکاندهندهای مؤثر باشد. در دههٔ ۲۰۱۰، پژوهشگران شروع به اعمال مدلهای LSTM بر روی متن کردند، که تعداد پارامترها در مدلهای NLP و منابع محاسباتی مورد نیاز برای آموزش آنها را به طور چشمگیری افزایش داد. نتایج دلگرمکننده بودند — LSTMها میتوانستند با دقتی بسیار بالاتر از رویکردهای قبلی به مثالهای دیدهنشده تعمیم یابند، اما سرانجام به محدودیتهایی برخوردند. LSTMها در ردیابی وابستگیها در زنجیرههای طولانی متن با جملات و پاراگرافهای متعدد با مشکل مواجه میشدند و در مقایسه با مدلهای بینایی ماشین، آموزش آنها کند و دستوپاگیر بود.
در اواخر دههٔ ۲۰۱۰، پژوهشگران گوگل معماری جدیدی به نام ترنسفورمر (Transformer) را کشف کردند که بسیاری از مسائل مقیاسپذیری که گریبانگیر LSTMها بود را حل کرد. تا زمانی که اندازهٔ یک مدل و دادههای آموزشی آن را همگام با هم افزایش میدادید، به نظر میرسید ترنسفورمرها دقیقتر و دقیقتر عمل میکنند. بهتر از آن، محاسبات مورد نیاز برای آموزش ترنسفورمر میتوانست به طور مؤثری موازیسازی شود، حتی برای دنبالههای طولانی. اگر تعداد ماشینهای در حال آموزش را دو برابر میکردید، میتوانستید تقریباً زمانی را که باید برای یک نتیجه منتظر بمانید به نصف برسانید.
کشف معماری ترنسفورمر، همراه با پردازندههای گرافیکی (GPU) و پردازندههای مرکزی (CPU) همواره سریعتر، به انفجار چشمگیری از سرمایهگذاری و علاقه به مدلهای NLP در طول چند سال گذشته منجر شده است. سیستمهای چت مانند ChatGPT با توانایی خود در تولید متنی روان و طبیعی در مورد موضوعات و سوالات به ظاهر اختیاری، توجه عموم را به خود جلب کردهاند. متن خامی که برای آموزش این مدلها استفاده میشود بخش قابل توجهی از تمام زبانهای نوشتاری موجود در اینترنت است و توان محاسباتی برای آموزش تکتک این مدلها میتواند دهها میلیون دلار هزینه داشته باشد. برخی از هیاهوها شایستهٔ تقلیل یافتن هستند — اینها ماشینهای بازشناسی الگو هستند. علیرغم گرایش همیشگی انسان به یافتن هوش در «چیزهایی که حرف میزنند»، این مدلها دادههای آموزشی را به شیوهای کپی و ترکیب میکنند که کاملاً متمایز (و بسیار کمتر کارآمد!) از هوش انسانی است. با این حال، این نیز منصفانه است که بگوییم پدیداری رفتارهای پیچیده از ساختارهای آموزشی فوقالعاده سادهٔ «کلمهٔ مفقود را حدس بزن»، یکی از شگفتانگیزترین نتایج تجربی در دههٔ گذشتهٔ یادگیری ماشین بوده است.
در سه فصل بعدی، ما به طیف وسیعی از تکنیکها برای یادگیری ماشین با دادههای متنی نگاه خواهیم کرد. از بحث دربارهٔ ویژگیهای زبانی هاردکدشده که تا دههٔ ۱۹۹۰ غالب بودند صرفنظر میکنیم، اما همه چیز را از اجرای رگرسیون لجستیک برای طبقهبندی متن تا آموزش LSTMها برای ترجمهٔ ماشینی بررسی خواهیم کرد. ما مدل ترنسفورمر را از نزدیک بررسی خواهیم کرد و در مورد آنچه که آن را بسیار مقیاسپذیر و در تعمیم در دامنهٔ متنی مؤثر میسازد بحث خواهیم کرد. بیایید شروع کنیم.
آمادهسازی دادههای متنی
Section titled “آمادهسازی دادههای متنی”بیایید یک جملهٔ انگلیسی را در نظر بگیریم:
The quick brown fox jumped over the lazy dog.یک مانع آشکار قبل از اینکه بتوانیم هر یک از تکنیکهای یادگیری عمیق فصلهای قبل را اعمال کنیم وجود دارد — ورودی ما عددی نیست! قبل از شروع هر مدلسازی، باید کلمات نوشتاری را به تانسورهایی از اعداد ترجمه کنیم. برخلاف تصاویر که نمایش عددی نسبتاً طبیعی دارند، شما میتوانید یک نمایش عددی از متن را به چندین روش بسازید.
یک رویکرد ساده این است که از فرمتهای فایل متنی استاندارد برای متن قرض بگیریم و از چیزی مانند کدگذاری ASCII استفاده کنیم. میتوانیم ورودی را به دنبالهای از کاراکترها خرد کنیم و به هر کدام یک اندیس منحصر به فرد اختصاص دهیم. رویکرد شهودی دیگر، ساختن نمایشی بر اساس کلمات است، به این صورت که ابتدا جملات را بر اساس تمام فاصلهها و علائم نگارشی بشکنیم و سپس هر کلمه را به یک نمایش عددی منحصر به فرد نگاشت کنیم.
هر دوی اینها رویکردهای خوبی برای امتحان کردن هستند و به طور کلی، تمام پیشپردازشهای متن شامل یک مرحلهٔ تقسیمبندی (splitting) خواهند بود، که در آن متن به واحدهای فردی کوچک به نام توکن (token) تقسیم میشود. یک ابزار قدرتمند برای تقسیمبندی متن عبارات منظم (regular expressions یا regex) است که میتواند الگوهای کاراکتری را در متن به صورت منعطف مطابقت دهد.
بیایید ببینیم چگونه میتوان از یک عبارت منظم برای تقسیم یک رشته به دنبالهای از کاراکترها استفاده کرد. ابتداییترین رجکسی که میتوانیم اعمال کنیم "." است که با هر کاراکتری در متن ورودی مطابقت دارد:
import regex as re
def split_chars(text): return re.findall(r".", text)میتوانیم این تابع را روی رشتهٔ ورودی مثال خود اعمال کنیم:
>>> chars = split_chars("The quick brown fox jumped over the lazy dog.")>>> chars[:12]رجکس را میتوان به راحتی برای تقسیم متن ما به کلمات نیز اعمال کرد. عبارت منظم "[\w]+" کاراکترهای غیرفاصلهای متوالی را میگیرد و "[.,!?;]" میتواند علائم نگارشی بین براکتها را مطابقت دهد. ما میتوانیم این دو را ترکیب کنیم تا به یک عبارت منظم برسیم که هر کلمه و علامت نگارشی را به یک توکن تقسیم میکند:
def split_words(text): return re.findall(r"[\w]+|[.,!?;]", text)اینجا میبینید که این تابع با یک جملهٔ آزمایشی چه میکند:
>>> split_words("The quick brown fox jumped over the dog.")تقسیمبندی ما را از یک رشتهٔ واحد به دنبالهای از توکنها میبرد، اما هنوز باید توکنهای رشتهای خود را به ورودیهای عددی تبدیل کنیم. تا کنون متداولترین رویکرد این است که هر توکن را به یک اندیس عدد صحیح منحصر به فرد نگاشت کنیم، که اغلب اندیسگذاری (indexing) ورودی ما نامیده میشود. این یک نمایش انعطافپذیر و برگشتپذیر از ورودی توکنسازیشدهٔ ما است که میتواند با طیف وسیعی از رویکردهای مدلسازی کار کند. بعداً، میتوانیم تصمیم بگیریم که چگونه از اندیسهای توکن به یک فضای نهان که توسط مدل دریافت میشود، نگاشت انجام دهیم.
برای توکنهای کاراکتری، میتوانیم از جستجوهای ASCII برای اندیسگذاری هر توکن استفاده کنیم — به عنوان مثال، ord('A') → 65 و ord('z') → 122. با این حال، هنگامی که زبانهای دیگر را در نظر میگیرید، این روش ممکن است مقیاسپذیری ضعیفی داشته باشد — بیش از یک میلیون کاراکتر در مشخصات یونیکد وجود دارد! یک تکنیک قویتر این است که نگاشتی از توکنهای خاص در دادههای آموزشی خود به اندیسهایی که در دادههای مورد نظر ما رخ میدهند بسازیم، که در NLP به آن واژگان (vocabulary) میگویند. این روش ویژگی بسیار خوبی دارد که برای توکنهای سطح کلمه به همان اندازهٔ توکنهای سطح کاراکتر به آسانی کار میکند.
بیایید نگاهی بیندازیم به اینکه چگونه میتوانیم از یک واژگان برای تبدیل متن استفاده کنیم. ما یک دیکشنری سادهٔ پایتون میسازیم که توکنها را به اندیسها نگاشت میکند، ورودی خود را به توکنها تقسیم میکنیم و در نهایت توکنهایمان را اندیسگذاری میکنیم:
vocabulary = { "[UNK]": 0, "the": 1, "quick": 2, "brown": 3, "fox": 4, "jumped": 5, "over": 6, "dog": 7, ".": 8,}words = split_words("The quick brown fox jumped over the lazy dog.")indices = [vocabulary.get(word, 0) for word in words]این کد خروجی زیر را تولید میکند:
[0, 2, 3, 4, 5, 6, 1, 0, 7, 8]ما یک توکن ویژه به نام "[UNK]" را به واژگان خود معرفی میکنیم که نشاندهندهٔ توکنی است که برای واژگان ناشناخته است. به این ترتیب، میتوانیم تمام ورودیهایی را که با آنها مواجه میشویم اندیسگذاری کنیم، حتی اگر برخی از اصطلاحات فقط در دادههای آزمایشی ما رخ دهند. در مثال قبلی، "lazy" به اندیس 0 مربوط به "[UNK]" نگاشت میشود، زیرا در واژگان ما گنجانده نشده بود.
با این تبدیلات سادهٔ متنی، ما در مسیر ساخت یک خط لولهٔ پیشپردازش متن به خوبی پیش میرویم. با این حال، یک نوع متداول دیگر از دستکاری متن وجود دارد که باید در نظر بگیریم — استانداردسازی.
این دو جمله را در نظر بگیرید:
- “sunset came. i was staring at the Mexico sky. Isnt nature splendid??”
- “Sunset came; I stared at the México sky. Isn’t nature splendid?”
آنها بسیار شبیهاند — در واقع تقریباً یکسان هستند. با این حال، اگر بخواهید آنها را همانطور که پیشتر توضیح داده شد به اندیسها تبدیل کنید، با نمایشهای بسیار متفاوتی روبرو خواهید شد، زیرا «i» و «I» دو کاراکتر متمایز هستند، «Mexico» و «México» دو کلمهٔ متمایز هستند، «isnt» همان «isn’t» نیست و غیره. یک مدل یادگیری ماشین از پیش نمیداند که «i» و «I» یک حرف هستند، «é» همان «e» با اکسان است، یا «staring» و «stared» دو شکل از یک فعل هستند. استانداردسازی (standardizing) متن شکلی پایهای از مهندسی ویژگی است که هدف آن پاک کردن تفاوتهای کدگذاری است که نمیخواهید مدل شما مجبور به سر و کله زدن با آنها باشد. این کار مختص یادگیری ماشین هم نیست — اگر در حال ساخت یک موتور جستجو هم بودید، مجبور میشدید همین کار را انجام دهید.
یک طرح استانداردسازی ساده و گسترده، تبدیل به حروف کوچک و حذف کاراکترهای نشانهگذاری است. دو جملهٔ ما تبدیل میشوند به:
- “sunset came i was staring at the mexico sky isnt nature splendid”
- “sunset came i stared at the méxico sky isnt nature splendid”
همین حالا بسیار نزدیکتر شد. اگر علائم اکسان را روی تمام کاراکترها حذف میکردیم، باز هم نزدیکتر میشدیم.
کارهای زیادی میتوانید با استانداردسازی انجام دهید، و این کار قبلاً یکی از مهمترین بخشها برای بهبود عملکرد مدل بود. برای دههها در NLP، این یک رویهٔ معمول بود که از عبارات منظم برای تلاش جهت نگاشت کلمات به یک ریشهٔ مشترک استفاده شود (مانند “tired” → “tire” و “trophies” → “trophy”)، که ریشهیابی (stemming) یا وارواژهسازی (lemmatization) نامیده میشود. اما از آنجا که مدلها گویاتر شدهاند، این نوع استانداردسازی تمایل دارد آسیب بیشتری نسبت به فایده بزند. زمان و جمع بودن یک کلمه نشانههای ضروری برای معنای آن هستند. برای مدلهای بزرگتری که امروزه استفاده میشوند، بیشتر استانداردسازیها تا حد ممکن ملایم هستند — به عنوان مثال، تبدیل همهٔ ورودیها به یک کدگذاری کاراکتری استاندارد قبل از پردازش بیشتر.
با استانداردسازی، ما اکنون سه مرحلهٔ متمایز را برای پیشپردازش متن دیدهایم (شکل ۱۴.۱):
- استانداردسازی — جایی که ما ورودی را با تبدیلات پایهٔ متنبهمتن نرمالسازی میکنیم
- تقسیمبندی — جایی که متن خود را به دنبالههایی از توکنها خرد میکنیم
- اندیسگذاری — جایی که توکنهای خود را با استفاده از یک واژگان به اندیسها نگاشت میکنیم
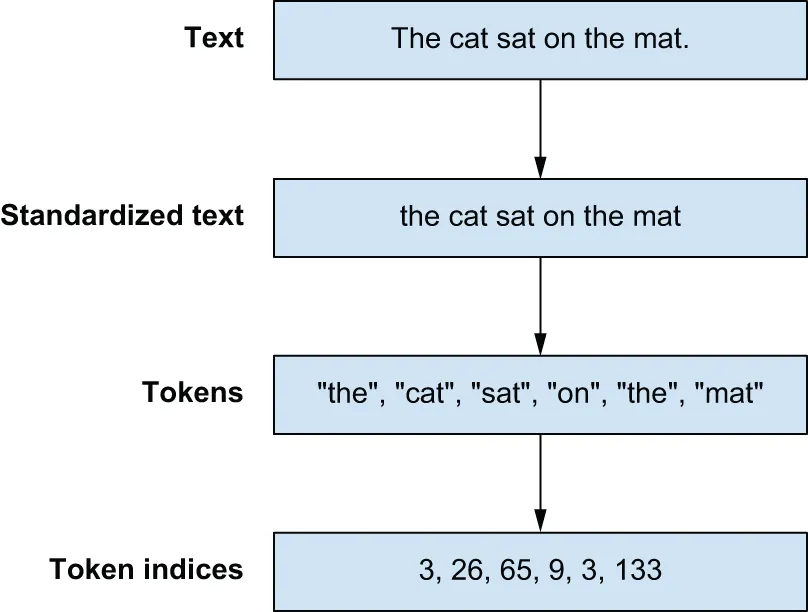
شکل ۱۴.۱: خط لولهٔ پیشپردازش متن
افراد اغلب کل این فرایند را توکنسازی (tokenization) مینامند، و شیئی را که متن را به دنبالهای از اندیسهای توکن نگاشت میکند توکنساز (tokenizer) میگویند. بیایید ساخت چند توکنساز را امتحان کنیم.
توکنسازی کاراکتری و کلمهای
Section titled “توکنسازی کاراکتری و کلمهای”برای شروع، بیایید یک توکنساز در سطح کاراکتر بسازیم که هر کاراکتر را در یک رشتهٔ ورودی به یک عدد صحیح نگاشت میکند. برای ساده نگه داشتن امور، ما تنها از یک مرحلهٔ استانداردسازی استفاده خواهیم کرد — تمام ورودیها را به حروف کوچک تبدیل میکنیم.
فهرست ۱۴.۱: یک توکنساز پایهای در سطح کاراکتر
class CharTokenizer:    def __init__(self, vocabulary):        self.vocabulary = vocabulary        self.unk_id = vocabulary["[UNK]"]
    def standardize(self, inputs):        return inputs.lower()
    def split(self, inputs):        return re.findall(r".", inputs)
    def index(self, tokens):        return [self.vocabulary.get(t, self.unk_id) for t in tokens]
    def __call__(self, inputs):        inputs = self.standardize(inputs)        tokens = self.split(inputs)        indices = self.index(tokens)        return indices
بسیار ساده است. قبل از استفاده از این، ما همچنین باید تابعی بسازیم که واژگانی از توکنها را بر اساس متنی از ورودی محاسبه کند. به جای اینکه صرفاً تمام کاراکترها را به یک اندیس منحصر به فرد نگاشت کنیم، بیایید این توانایی را به خودمان بدهیم که اندازهٔ واژگان خود را فقط به رایجترین توکنها در دادههای ورودی خود محدود کنیم. هنگامی که وارد جنبهٔ مدلسازی میشویم، محدود کردن اندازهٔ واژگان راه مهمی برای محدود کردن تعداد پارامترهای یک مدل خواهد بود.
فهرست ۱۴.۲: محاسبهٔ یک واژگان در سطح کاراکتر
import collections
def compute_char_vocabulary(inputs, max_size):    char_counts = collections.Counter()    for x in inputs:        x = x.lower()        tokens = re.findall(r".", x)        char_counts.update(tokens)    vocabulary = ["[UNK]"]    most_common = char_counts.most_common(max_size - len(vocabulary))    for token, count in most_common:        vocabulary.append(token)    return dict((token, i) for i, token in enumerate(vocabulary))
اکنون میتوانیم همین کار را برای یک توکنساز در سطح کلمه انجام دهیم. میتوانیم از همان کد توکنساز در سطح کاراکتر خود با یک مرحلهٔ تقسیمبندی متفاوت استفاده کنیم.
فهرست ۱۴.۳: یک توکنساز پایهای در سطح کلمه
class WordTokenizer:    def __init__(self, vocabulary):        self.vocabulary = vocabulary        self.unk_id = vocabulary["[UNK]"]
    def standardize(self, inputs):        return inputs.lower()
    def split(self, inputs):        return re.findall(r"[\w]+|[.,!?;]", inputs)
    def index(self, tokens):        return [self.vocabulary.get(t, self.unk_id) for t in tokens]
    def __call__(self, inputs):        inputs = self.standardize(inputs)        tokens = self.split(inputs)        indices = self.index(tokens)        return indices
ما همچنین میتوانیم این قاعدهٔ تقسیمبندی جدید را در تابع واژگان خود جایگزین کنیم.
فهرست ۱۴.۴: محاسبهٔ یک واژگان در سطح کلمه
def compute_word_vocabulary(inputs, max_size): word_counts = collections.Counter() for x in inputs: x = x.lower() tokens = re.findall(r"[\w]+|[.,!?;]", x) word_counts.update(tokens) vocabulary = ["[UNK]"] most_common = word_counts.most_common(max_size - len(vocabulary)) for token, count in most_common: vocabulary.append(token) return dict((token, i) for i, token in enumerate(vocabulary))بیایید توکنسازهای خود را روی یک ورودی دنیای واقعی امتحان کنیم — متن کامل موبی دیک نوشتهٔ هرمان ملویل. ما ابتدا واژگانی برای هر دو توکنساز میسازیم و سپس از آن برای توکنسازی متنی استفاده میکنیم:
import keras
filename = keras.utils.get_file(    origin="https://www.gutenberg.org/files/2701/old/moby10b.txt",)moby_dick = list(open(filename, "r"))
vocabulary = compute_char_vocabulary(moby_dick, max_size=100)char_tokenizer = CharTokenizer(vocabulary)
بیایید بررسی کنیم که توکنساز سطح کاراکتر ما چه چیزی را محاسبه کرده است:
>>> print("Vocabulary length:", len(vocabulary))حالا دربارهٔ توکنساز سطح کلمه چطور؟
vocabulary = compute_word_vocabulary(moby_dick, max_size=2_000)word_tokenizer = WordTokenizer(vocabulary)میتوانیم همان دادهها را برای توکنساز سطح کلمهٔ خود چاپ کنیم:
>>> print("Vocabulary length:", len(vocabulary))ما هماکنون میتوانیم برخی از نقاط قوت و ضعف هر دو تکنیک توکنسازی را ببینیم. یک توکنساز سطح کاراکتر تنها به ۶۴ اصطلاح واژگان نیاز دارد تا کل کتاب را پوشش دهد، اما هر ورودی را به صورت یک دنبالهٔ بسیار طولانی کدگذاری میکند. یک توکنساز سطح کلمه به سرعت یک واژگان ۲۰۰۰ اصطلاحی را پر میکند (شما به یک دیکشنری با ۱۷,۰۰۰ اصطلاح نیاز دارید تا هر کلمه در کتاب را اندیسگذاری کنید!)، اما خروجیهای توکنساز سطح کلمه بسیار کوتاهتر هستند.
همانطور که متخصصان یادگیری ماشین مدلها را با دادهها و پارامترهای بیشتر و بیشتر مقیاس دادهاند، جنبههای منفی توکنسازی کلمهای و کاراکتری آشکار شده است. «فشردهسازی» ارائهشده توسط توکنسازی در سطح کلمه معلوم میشود که بسیار مهم است — این به مدل اجازه میدهد دنبالههای طولانیتری را تغذیه کند. با این حال، اگر بخواهید یک واژگان در سطح کلمه برای یک مجموعه دادهٔ بزرگ بسازید (امروزه ممکن است مجموعه دادهای با تریلیونها کلمه ببینید)، یک واژگان غیرقابل استفاده و بزرگ با صدها میلیون اصطلاح خواهید داشت. اگر اندازهٔ واژگان در سطح کلمهٔ خود را به شدت محدود کنید، بخش زیادی از متن را به توکن "[UNK]" کدگذاری خواهید کرد و اطلاعات ارزشمندی را دور میریزید.
این مسائل منجر به افزایش محبوبیت نوع سومی از توکنسازی شده است که توکنسازی زیرکلمهای (subword tokenization) نامیده میشود و تلاش میکند شکاف بین رویکردهای سطح کلمه و سطح کاراکتر را پر کند.
توکنسازی زیرکلمهای
Section titled “توکنسازی زیرکلمهای”توکنسازی زیرکلمهای قصد دارد بهترین ویژگیهای هر دو تکنیک کدگذاری کاراکتری و کلمهای را ترکیب کند. ما توانایی WordTokenizer در تولید خروجی مختصر و توانایی CharTokenizer در کدگذاری طیف گستردهای از ورودیها با یک واژگان کوچک را میخواهیم.
میتوانیم جستجو برای توکنساز ایدهآل را به عنوان شکار فشردهسازی ایدهآل برای دادههای ورودی تصور کنیم. کاهش طول توکن، طول کلی مثالهای ما را فشرده میکند. یک واژگان کوچک، تعداد بایتهایی را که برای نشان دادن هر توکن نیاز داریم کاهش میدهد. اگر به هر دو دست یابیم، قادر خواهیم بود دنبالههای کوتاه و غنی از اطلاعات را به مدل یادگیری عمیق خود تغذیه کنیم.
این قیاس بین فشردهسازی و توکنسازی همیشه بدیهی نبود، اما معلوم میشود که بسیار قدرتمند است. یکی از مؤثرترین ترفندهای عملی که در دههٔ گذشتهٔ پژوهشهای NLP یافت شد، استفادهٔ مجدد از الگوریتمی متعلق به دههٔ ۱۹۹۰ برای فشردهسازی بدون اتلاف به نام کدگذاری جفتبایت (byte-pair encoding)1 برای توکنسازی بود. این روش توسط ChatGPT و بسیاری از مدلهای دیگر تا به امروز استفاده میشود. در این بخش، ما توکنسازی میسازیم که از الگوریتم کدگذاری جفتبایت استفاده میکند.
ایده در کدگذاری جفتبایت این است که با یک واژگان پایهای از کاراکترها شروع کنیم و به تدریج جفتهای رایج را در دنبالههای طولانیتر و طولانیتری از کاراکترها «ادغام (merge)» کنیم. فرض کنید با متن ورودی زیر شروع میکنیم:
data = [ "the quick brown fox", "the slow brown fox", "the quick brown foxhound",]مانند WordTokenizer، ما با محاسبهٔ تعداد کلمات برای تمام کلمات موجود در متن شروع خواهیم کرد. همانطور که دیکشنری تعداد کلمات خود را ایجاد میکنیم، تمام متن خود را به کاراکترها تقسیم میکنیم و کاراکترها را با یک فاصله به هم متصل میکنیم. این کار در مرحلهٔ بعدی بررسی جفتهای کاراکتر را آسانتر میکند.
فهرست ۱۴.۵: مقداردهی اولیهٔ وضعیت برای الگوریتم کدگذاری جفتبایت
def count_and_split_words(data):    counts = collections.Counter()    for line in data:        line = line.lower()        for word in re.findall(r"[\w]+|[.,!?;]", line):            chars = re.findall(r".", word)            split_word = " ".join(chars)            counts[split_word] += 1    return dict(counts)
counts = count_and_split_words(data)
بیایید این را روی دادههای خود امتحان کنیم:
>>> countsبرای اعمال کدگذاری جفتبایت بر روی تعداد کلمات تقسیمشدهٔ خود، دو کاراکتر را پیدا میکنیم و آنها را در یک نماد جدید ادغام میکنیم. ما تمام جفتهای کاراکتر را در تمام کلمات در نظر میگیریم و فقط رایجترین جفتی را که پیدا میکنیم ادغام میکنیم. در مثال قبلی، رایجترین جفت کاراکتر ("o", "w") است، هم در کلمهٔ "brown" (که سه بار در دادههای ما رخ میدهد) و هم در "slow" (که یک بار رخ میدهد). ما این جفت را در یک نماد جدید "ow" ترکیب میکنیم و تمام رخدادهای "o w" را ادغام میکنیم.
سپس ادامه میدهیم، جفتها را میشماریم و جفتها را ادغام میکنیم، با این تفاوت که اکنون "ow" یک واحد منفرد خواهد بود که میتواند برای مثال با "l" ادغام شود و "low" را تشکیل دهد. با ادغام تدریجی پرتکرارترین جفت نمادها، ما واژگانی از زیرکلمات بزرگتر و بزرگتر میسازیم.
بیایید این را روی مجموعه دادهٔ اسباببازی خود امتحان کنیم.
فهرست ۱۴.۶: اجرای چند مرحله از ادغام جفتبایت
def count_pairs(counts):    pairs = collections.Counter()    for word, freq in counts.items():        symbols = word.split()        for pair in zip(symbols[:-1], symbols[1:]):            pairs[pair] += freq    return pairs
def merge_pair(counts, first, second):    # Matches an unmerged pair    split = re.compile(f"(?<!\S){first} {second}(?!\S)")    # Replaces all occurances with a merged version    merged = f"{first}{second}"    return {split.sub(merged, word): count for word, count in counts.items()}
for i in range(10):    pairs = count_pairs(counts)    first, second = max(pairs, key=pairs.get)    counts = merge_pair(counts, first, second)    print(list(counts.keys()))
این چیزی است که به دست میآوریم:
["t h e", "q u i c k", "b r ow n", "f o x", "s l ow", "f o x h o u n d"]["th e", "q u i c k", "b r ow n", "f o x", "s l ow", "f o x h o u n d"]["the", "q u i c k", "b r ow n", "f o x", "s l ow", "f o x h o u n d"]["the", "q u i c k", "br ow n", "f o x", "s l ow", "f o x h o u n d"]["the", "q u i c k", "brow n", "f o x", "s l ow", "f o x h o u n d"]["the", "q u i c k", "brown", "f o x", "s l ow", "f o x h o u n d"]["the", "q u i c k", "brown", "fo x", "s l ow", "fo x h o u n d"]["the", "q u i c k", "brown", "fox", "s l ow", "fox h o u n d"]["the", "qu i c k", "brown", "fox", "s l ow", "fox h o u n d"]["the", "qui c k", "brown", "fox", "s l ow", "fox h o u n d"]میتوانیم ببینیم چگونه کلمات رایج کاملاً ادغام میشوند، در حالی که کلمات کمتر رایج فقط تا حدی ادغام میشوند.
اکنون میتوانیم این را به یک تابع کامل برای محاسبهٔ واژگان کدگذاری جفتبایت گسترش دهیم. ما واژگان خود را با تمام کاراکترهای موجود در متن ورودی شروع میکنیم، و نمادهای ادغامشده (زیرکلمات بزرگتر و بزرگتر) را به تدریج به واژگان خود اضافه میکنیم تا زمانی که به طول مورد نظر ما برسد. ما همچنین یک دیکشنری جداگانه از قواعد ادغام خود نگه میداریم، از جمله رتبه و ترتیبی که آنها را اعمال کردهایم. در ادامه، خواهیم دید که چگونه از این قواعد ادغام برای توکنسازی متن ورودی جدید استفاده کنیم.
فهرست ۱۴.۷: محاسبهٔ یک واژگان کدگذاری جفتبایت
def compute_sub_word_vocabulary(dataset, vocab_size):    counts = count_and_split_words(dataset)
    char_counts = collections.Counter()    for word in counts:        for char in word.split():            char_counts[char] += counts[word]    most_common = char_counts.most_common()    vocab = ["[UNK]"] + [char for char, freq in most_common]    merges = []
    while len(vocab) < vocab_size:        pairs = count_pairs(counts)        if not pairs:            break        first, second = max(pairs, key=pairs.get)        counts = merge_pair(counts, first, second)        vocab.append(f"{first}{second}")        merges.append(f"{first} {second}")
    vocab = dict((token, index) for index, token in enumerate(vocab))    merges = dict((token, rank) for rank, token in enumerate(merges))    return vocab, merges
بیایید یک SubWordTokenizer بسازیم که قواعد ادغام ما را برای توکنسازی متن ورودی جدید اعمال کند. مراحل standardize() و index() میتوانند همانند WordTokenizer باقی بمانند و تمام تغییرات در متد split() رخ میدهد.
در مرحلهٔ تقسیمبندی، ابتدا تمام ورودیها را به کلمات تقسیم میکنیم، سپس تمام کلمات را به کاراکترها تقسیم میکنیم و در نهایت قواعد ادغام آموختهشدهٔ خود را بر روی کاراکترهای تقسیمشده اعمال میکنیم. آنچه باقی میماند زیرکلمات هستند — توکنهایی که ممکن است کلمات کامل، بخشهایی از کلمات یا کاراکترهای ساده باشند، بسته به فراوانی کلمهٔ ورودی در دادههای آموزشی ما. این زیرکلمات توکنهایی در خروجی ما هستند.
فهرست ۱۴.۸: یک توکنساز کدگذاری جفتبایت
class SubWordTokenizer:    def __init__(self, vocabulary, merges):        self.vocabulary = vocabulary        self.merges = merges        self.unk_id = vocabulary["[UNK]"]
    def standardize(self, inputs):        return inputs.lower()
    def bpe_merge(self, word):        while True:            # Matches all symbol pairs in the text            pairs = re.findall(r"(?<!\S)\S+ \S+(?!\S)", word, overlapped=True)            if not pairs:                break            # We apply merge rules in "rank" order. More frequent pairs            # are merged first.            best = min(pairs, key=lambda pair: self.merges.get(pair, 1e9))            if best not in self.merges:                break            first, second = best.split()            split = re.compile(f"(?<!\S){first} {second}(?!\S)")            merged = f"{first}{second}"            word = split.sub(merged, word)        return word
    def split(self, inputs):        tokens = []        # Split words        for word in re.findall(r"[\w]+|[.,!?;]", inputs):            # Joins all characters with a space            word = " ".join(re.findall(r".", word))            # Applies byte-pair encoding merge rules            word = self.bpe_merge(word)            tokens.extend(word.split())        return tokens
    def index(self, tokens):        return [self.vocabulary.get(t, self.unk_id) for t in tokens]
    def __call__(self, inputs):        inputs = self.standardize(inputs)        tokens = self.split(inputs)        indices = self.index(tokens)        return indices
بیایید توکنساز خود را روی متن کامل موبی دیک امتحان کنیم:
vocabulary, merges = compute_sub_word_vocabulary(moby_dick, 2_000)sub_word_tokenizer = SubWordTokenizer(vocabulary, merges)میتوانیم به واژگان خود نگاهی بیندازیم و یک جملهٔ آزمایشی را روی توکنساز خود امتحان کنیم، همانطور که با WordTokenizer و CharTokenizer انجام دادیم:
>>> print("Vocabulary length:", len(vocabulary))کلاس SubWordTokenizer طول کمی طولانیتری برای جملهٔ آزمایشی ما نسبت به WordTokenizer دارد (۱۶ توکن در مقابل ۱۳ توکن)، اما برخلاف WordTokenizer، میتواند هر کلمه در موبی دیک را بدون استفاده از توکن "[UNK]" توکنسازی کند. واژگان شامل هر کاراکتر در متن منبع ما است، بنابراین بدترین عملکرد توکنسازی یک کلمه به کاراکترهای منفرد خواهد بود. ما به طول میانگین توکن کوتاهی دست یافتهایم در حالی که کلمات نادر را با یک واژگان کوچک مدیریت میکنیم. این مزیت توکنسازهای زیرکلمهای است.
شاید متوجه شوید که اجرای این کد به طور قابل توجهی کندتر از توکنسازهای کلمهای و کاراکتری است؛ روی سختافزار مرجع ما حدود یک دقیقه طول میکشد. یادگیری قواعد ادغام بسیار پیچیدهتر از صرفاً شمارش کلمات در یک مجموعه دادهٔ ورودی است. با اینکه این یک نکتهٔ منفی برای توکنسازی زیرکلمهای است، اما در عمل به ندرت یک نگرانی مهم به حساب میآید. شما فقط باید یک بار برای هر مدل یک واژگان را یاد بگیرید و هزینهٔ یادگیری یک واژگان زیرکلمهای به طور کلی در مقایسه با آموزش مدل ناچیز است.
ما اکنون سه رویکرد جداگانه را برای توکنسازی ورودی دیدهایم. حال که میتوانیم از متن به ورودی عددی ترجمه کنیم، میتوانیم به سمت آموزش یک مدل حرکت کنیم.
یک نکتهٔ پایانی در مورد توکنسازی — هرچند درک نحوهٔ کارکرد توکنسازها بسیار مهم است، اما به ندرت پیش میآید که نیاز داشته باشید خودتان یکی از آنها را بسازید. کراس با ابزارهایی برای توکنسازی ورودی متنی همراه است، همانطور که اکثر چارچوبهای یادگیری عمیق اینگونه هستند. برای بقیهٔ این فصل، ما از قابلیتهای داخلی کراس برای توکنسازی استفاده خواهیم کرد.
مجموعهها در برابر دنبالهها
Section titled “مجموعهها در برابر دنبالهها”اینکه یک مدل یادگیری ماشین چگونه باید توکنهای منفرد را نشان دهد، سوالی نسبتاً بدون مناقشه است: آنها ویژگیهای دستهای هستند (مقدارهایی از یک مجموعهٔ از پیش تعریفشده)، و ما میدانیم چگونه با آنها کار کنیم. آنها باید به عنوان ابعادی در یک فضای ویژگی یا به عنوان بردارهای دستهای (در این مورد بردارهای توکن) کدگذاری شوند. با این حال، سوال بسیار چالشبرانگیزتر این است که چگونه ترتیب توکنها را در متن کدگذاری کنیم.
مسئلهٔ ترتیب در زبان طبیعی مسئلهٔ جالبی است: بر خلاف گامهای یک سری زمانی، کلمات در یک جمله ترتیب طبیعی و قاعدهمند ندارند. زبانهای مختلف کلمات مشابه را به روشهای بسیار متفاوتی مرتب میکنند. به عنوان مثال، ساختار جمله در زبان انگلیسی کاملاً با زبان ژاپنی متفاوت است. حتی در یک زبان معین، معمولاً میتوانید همان مفهوم را با کمی بر هم زدن ترتیب کلمات به روشهای مختلفی بیان کنید. اگر کلمات یک جملهٔ کوتاه را کاملاً تصادفی کنید، باز هم گاهی اوقات میتوانید متوجه شوید که چه میگوید — هرچند در بسیاری از موارد، ابهام قابل توجهی ایجاد خواهد شد. ترتیب به وضوح مهم است، اما رابطهٔ آن با معنا سرراست و مستقیم نیست.
چگونگی نمایش ترتیب کلمات، سوال محوری است که معماریهای مختلف NLP از آن سرچشمه میگیرند. سادهترین کاری که میتوانید انجام دهید این است که ترتیب را دور بریزید و با متن به عنوان یک مجموعهٔ نامرتب از کلمات رفتار کنید — این به شما مدلهای کیسهٔ کلمات (bag-of-words) را میدهد. همچنین میتوانید تصمیم بگیرید که کلمات باید دقیقاً به همان ترتیبی که ظاهر میشوند، یکی پس از دیگری، مانند گامهای یک سری زمانی پردازش شوند — سپس میتوانید از مدلهای بازگشتی فصل قبل استفاده کنید. در نهایت، یک رویکرد ترکیبی نیز امکانپذیر است: معماری ترنسفورمر (Transformer) از نظر فنی از ترتیب مستقل است، با این حال اطلاعات موقعیت کلمات را به نمایشهایی که پردازش میکند تزریق میکند، که به آن امکان میدهد همزمان به بخشهای مختلف یک جمله نگاه کند (برخلاف RNNها) در حالی که همچنان از ترتیب آگاه است. از آنجا که RNNها و ترنسفورمرها هر دو ترتیب کلمات را در نظر میگیرند، مدلهای دنبالهای (sequence models) نامیده میشوند.
از نظر تاریخی، بیشتر کاربردهای اولیهٔ یادگیری ماشین در NLP صرفاً شامل مدلهای کیسهٔ کلمات بودند که دادههای دنبالهای را نادیده میگرفتند. علاقه به مدلهای دنبالهای تنها در سال ۲۰۱۵، با تولد دوبارهٔ RNNها شروع به افزایش کرد. امروزه، هر دو رویکرد همچنان مرتبط و کاربردی باقی ماندهاند. بیایید ببینیم آنها چگونه کار میکنند و چه زمانی باید از کدام یک استفاده کرد.
ما هر رویکرد را روی یک معیار شناختهشدهٔ طبقهبندی متن نشان خواهیم داد: مجموعه دادهٔ طبقهبندی احساسات نقد فیلم IMDb. در فصلهای ۴ و ۵، شما با یک نسخهٔ از پیش برداریشده از مجموعه دادهٔ IMDb کار کردید؛ اکنون بیایید دادههای متنی خام IMDb را پردازش کنیم، درست مانند کاری که هنگام مواجهه با یک مسئلهٔ طبقهبندی متن جدید در دنیای واقعی انجام میدهید.
بارگذاری مجموعه دادهٔ طبقهبندی IMDb
Section titled “بارگذاری مجموعه دادهٔ طبقهبندی IMDb”برای شروع، بیایید مجموعه دادهٔ خود را دانلود و استخراج کنیم.
فهرست ۱۴.۹: دانلود مجموعه دادهٔ نقد فیلم IMDb
import os, pathlib, shutil, random
zip_path = keras.utils.get_file(    origin="https://ai.stanford.edu/~amaas/data/sentiment/aclImdb_v1.tar.gz",    fname="imdb",    extract=True,)
imdb_extract_dir = pathlib.Path(zip_path) / "aclImdb"
بیایید ساختار دایرکتوری خود را فهرست کنیم:
>>> for path in imdb_extract_dir.glob("*/*"):... if path.is_dir():... print(path)ما میتوانیم هر دو مجموعهٔ آموزش (train) و آزمون (test) را با مثالهای مثبت و منفی ببینیم. نقدهای فیلم با امتیاز کاربری پایین در سایت IMDb در دایرکتوری neg/ و نقدهای با امتیاز بالا در دایرکتوری pos/ مرتب شدند. ما همچنین میتوانیم یک دایرکتوری unsup/ را ببینیم که مخفف unsupervised (بدون نظارت) است. اینها نقدهایی هستند که عمداً توسط سازندهٔ مجموعه داده بدون برچسب رها شدهاند؛ آنها میتوانند نقدهای منفی یا مثبت باشند.
بیایید نگاهی به محتوای چند مورد از این فایلهای متنی بیندازیم. چه با دادههای متنی کار میکنید و چه دادههای تصویری، به یاد داشته باشید که قبل از شیرجه زدن به مدلسازی، ظاهر دادههای خود را بررسی کنید. این شهود شما را در مورد آنچه مدلتان واقعاً انجام میدهد تقویت میکند.
فهرست ۱۴.۱۰: پیشنمایش یک نقد منفرد IMDb
>>> print(open(imdb_extract_dir / "train" / "pos" / "4077_10.txt", "r").read())قبل از اینکه توکنسازی متن ورودی خود را آغاز کنیم، یک کپی از دادههای آموزشی خود با چند تغییر مهم ایجاد خواهیم کرد. ما فعلاً میتوانیم نقدهای بدون نظارت را نادیده بگیریم و یک مجموعهٔ اعتبارسنجی جداگانه ایجاد کنیم تا دقت خود را در طول آموزش زیر نظر داشته باشیم. ما این کار را با جدا کردن ۲۰٪ از فایلهای متنی آموزشی در یک دایرکتوری جدید انجام میدهیم.
فهرست ۱۴.۱۱: جداسازی اعتبارسنجی از مجموعه دادهٔ IMDb
train_dir = pathlib.Path("imdb_train")test_dir = pathlib.Path("imdb_test")val_dir = pathlib.Path("imdb_val")
# Moves the test data unalteredshutil.copytree(imdb_extract_dir / "test", test_dir)
# Splits the training data into a train set and a validation setval_percentage = 0.2for category in ("neg", "pos"):    src_dir = imdb_extract_dir / "train" / category    src_files = os.listdir(src_dir)    random.Random(1337).shuffle(src_files)    num_val_samples = int(len(src_files) * val_percentage)
    os.makedirs(val_dir / category)    for file in src_files[:num_val_samples]:        shutil.copy(src_dir / file, val_dir / category / file)    os.makedirs(train_dir / category)    for file in src_files[num_val_samples:]:        shutil.copy(src_dir / file, train_dir / category / file)
اکنون آمادهٔ بارگذاری دادهها هستیم. به یاد دارید چگونه در فصل ۸، از ابزار کمکی image_dataset_from_directory برای ایجاد یک Dataset از تصاویر و برچسبهای آنها برای یک ساختار دایرکتوری استفاده کردیم؟ شما میتوانید دقیقاً همین کار را برای فایلهای متنی با استفاده از ابزار کمکی text_dataset_from_directory انجام دهید. بیایید سه شیء Dataset برای آموزش، اعتبارسنجی و آزمون ایجاد کنیم.
فهرست ۱۴.۱۲: بارگذاری مجموعه دادهٔ IMDb برای استفاده با کراس
from keras.utils import text_dataset_from_directory
batch_size = 32train_ds = text_dataset_from_directory(train_dir, batch_size=batch_size)val_ds = text_dataset_from_directory(val_dir, batch_size=batch_size)test_ds = text_dataset_from_directory(test_dir, batch_size=batch_size)
در ابتدا ما ۲۵,۰۰۰ مثال آموزشی و ۲۵,۰۰۰ مثال آزمایشی داشتیم، و پس از جداسازی اعتبارسنجی، ۲۰,۰۰۰ نقد برای آموزش و ۵,۰۰۰ نقد برای اعتبارسنجی داریم. بیایید تلاش کنیم چیزی از این دادهها یاد بگیریم.
مدلهای مجموعهای
Section titled “مدلهای مجموعهای”سادهترین رویکردی که میتوانیم در رابطه با ترتیب توکنها در متن اتخاذ کنیم این است که آن را دور بیندازیم. ما همچنان نقدهای ورودی خود را به طور معمول به عنوان دنبالهای از شناسههای توکن، توکنسازی میکنیم، اما بلافاصله پس از توکنسازی، کل مثال آموزشی را به یک مجموعه تبدیل میکنیم — یک «کیسهٔ» ساده و نامرتب از توکنها که در یک نقد فیلم یا حضور دارند یا غایب هستند.
ایده در اینجا این است که از این مجموعهها برای ساخت یک مدل بسیار ساده استفاده کنیم که به هر کلمهٔ منفرد در یک نقد، یک وزن اختصاص میدهد. حضور کلمهٔ "terrible" احتمالاً (هرچند نه همیشه) نشاندهندهٔ یک نقد بد است، و "riveting" ممکن است نشاندهندهٔ یک نقد خوب باشد. ما میتوانیم یک مدل کوچک بسازیم که بتواند این وزنها را یاد بگیرد — که مدل کیسهٔ کلمات (bag-of-words model) نامیده میشود.
به عنوان مثال، فرض کنید یک جملهٔ ورودی و یک واژگان ساده داشتید:
"this movie made me cry"
{"[UNK]": 0, "movie": 1, "film": 2, "made": 3, "laugh": 4, "cry": 5}
ما این نقد کوچک را به این صورت توکنسازی میکنیم:
[0, 1, 3, 0, 5]با دور ریختن ترتیب، میتوانیم این را به یک مجموعه از شناسههای توکن تبدیل کنیم:
{0, 1, 3, 5}در نهایت، میتوانیم از کدگذاری چندیکپایه (multi-hot encoding) برای تبدیل مجموعه به یک بردار با اندازهٔ ثابت و همطول با واژگان استفاده کنیم:
[1, 1, 0, 1, 0, 1]مقدار 0 در موقعیت پنجم در اینجا به این معنی است که کلمهٔ "laugh" در نقد ما وجود ندارد، و مقدار 1 در موقعیت ششم به این معنی است که "cry" وجود دارد. این کدگذاری ساده از نقد ورودی ما میتواند مستقیماً برای آموزش یک مدل استفاده شود.
آموزش یک مدل کیسهٔ کلمات
Section titled “آموزش یک مدل کیسهٔ کلمات”برای انجام این پردازش متن در کد، گسترش دادن WordTokenizer که پیشتر در این فصل داشتیم به اندازهٔ کافی آسان خواهد بود. یک راهحل حتی آسانتر، استفاده از لایهٔ TextVectorization است که در کراس تعبیه شده است. لایهٔ TextVectorization توکنسازی کلمهای و کاراکتری را مدیریت میکند و با چندین ویژگی اضافی، از جمله کدگذاری چندیکپایه (multi-hot) برای خروجی لایه همراه است.
لایهٔ TextVectorization، مانند بسیاری از لایههای پیشپردازش در کراس، دارای متد adapt() برای یادگیری وضعیت لایه از دادههای ورودی است. در مورد TextVectorization، متد adapt() با تکرار روی یک مجموعه دادهٔ ورودی، یک واژگان را در لحظه برای مجموعه داده یاد خواهد گرفت. بیایید از آن برای توکنسازی و کدگذاری دادههای ورودی خود استفاده کنیم. ما واژگانی متشکل از ۲۰,۰۰۰ کلمه میسازیم که نقطهٔ شروع خوبی برای مسائل طبقهبندی متن است.
فهرست ۱۴.۱۳: اعمال کدگذاری کیسهٔ کلمات بر روی نقدهای IMDb
from keras import layers
max_tokens = 20_000text_vectorization = layers.TextVectorization(    max_tokens=max_tokens,    # Learns a word-level vocabulary    split="whitespace",    output_mode="multi_hot",)train_ds_no_labels = train_ds.map(lambda x, y: x)text_vectorization.adapt(train_ds_no_labels)
bag_of_words_train_ds = train_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)bag_of_words_val_ds = val_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)bag_of_words_test_ds = test_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)
بیایید به یک دسته (batch) واحد از دادههای ورودی پیشپردازششدهٔ خود نگاه کنیم:
>>> x, y = next(bag_of_words_train_ds.as_numpy_iterator())>>> x.shapeمیتوانید ببینید که پس از پیشپردازش، هر نمونه در دستهٔ ما به یک بردار از ۲۰,۰۰۰ عدد تبدیل میشود که هر کدام حضور یا عدم حضور یک اصطلاح واژگان را ردیابی میکنند.
سپس، میتوانیم یک مدل خطی بسیار ساده را آموزش دهیم. ما کد مدلسازی خود را به عنوان یک تابع ذخیره میکنیم تا بتوانیم بعداً دوباره از آن استفاده کنیم.
فهرست ۱۴.۱۴: ساخت یک مدل رگرسیون کیسهٔ کلمات
def build_linear_classifier(max_tokens, name):    inputs = keras.Input(shape=(max_tokens,))    outputs = layers.Dense(1, activation="sigmoid")(inputs)    model = keras.Model(inputs, outputs, name=name)    model.compile(        optimizer="adam",        loss="binary_crossentropy",        metrics=["accuracy"],    )    return model
model = build_linear_classifier(max_tokens, "bag_of_words_classifier")
بیایید به خلاصهٔ مدل خود نگاهی بیندازیم:
>>> model.summary()این مدل بینهایت ساده است. ما فقط ۲۰,۰۰۱ پارامتر داریم، یکی برای هر کلمه در واژگان خود و یکی برای عبارت بایاس (انحراف). بیایید آن را آموزش دهیم. ما کالبک EarlyStopping را اضافه خواهیم کرد که اولین بار در فصل ۷ پوشش داده شد، که وقتی زیان اعتبارسنجی متوقف از بهبود شود، آموزش را به طور خودکار متوقف میکند و وزنها را از بهترین دوره بازیابی مینماید.
فهرست ۱۴.۱۵: آموزش مدل رگرسیون کیسهٔ کلمات
early_stopping = keras.callbacks.EarlyStopping( monitor="val_loss", restore_best_weights=True, patience=2,)history = model.fit( bag_of_words_train_ds, validation_data=bag_of_words_val_ds, epochs=10, callbacks=[early_stopping],)مدل ما در بسیار کمتر از یک دقیقه آموزش میبیند که با توجه به اندازهاش تعجبآور نیست. توکنسازی و کدگذاری ورودی ما در واقع کمی گرانتر از بهروزرسانی پارامترهای مدل ما است. بیایید نمودار دقت مدل را رسم کنیم (شکل ۱۴.۲):
import matplotlib.pyplot as plt
accuracy = history.history["accuracy"]val_accuracy = history.history["val_accuracy"]epochs = range(1, len(accuracy) + 1)
plt.plot(epochs, accuracy, "r--", label="Training accuracy")plt.plot(epochs, val_accuracy, "b", label="Validation accuracy")plt.title("Training and validation accuracy")plt.legend()plt.show()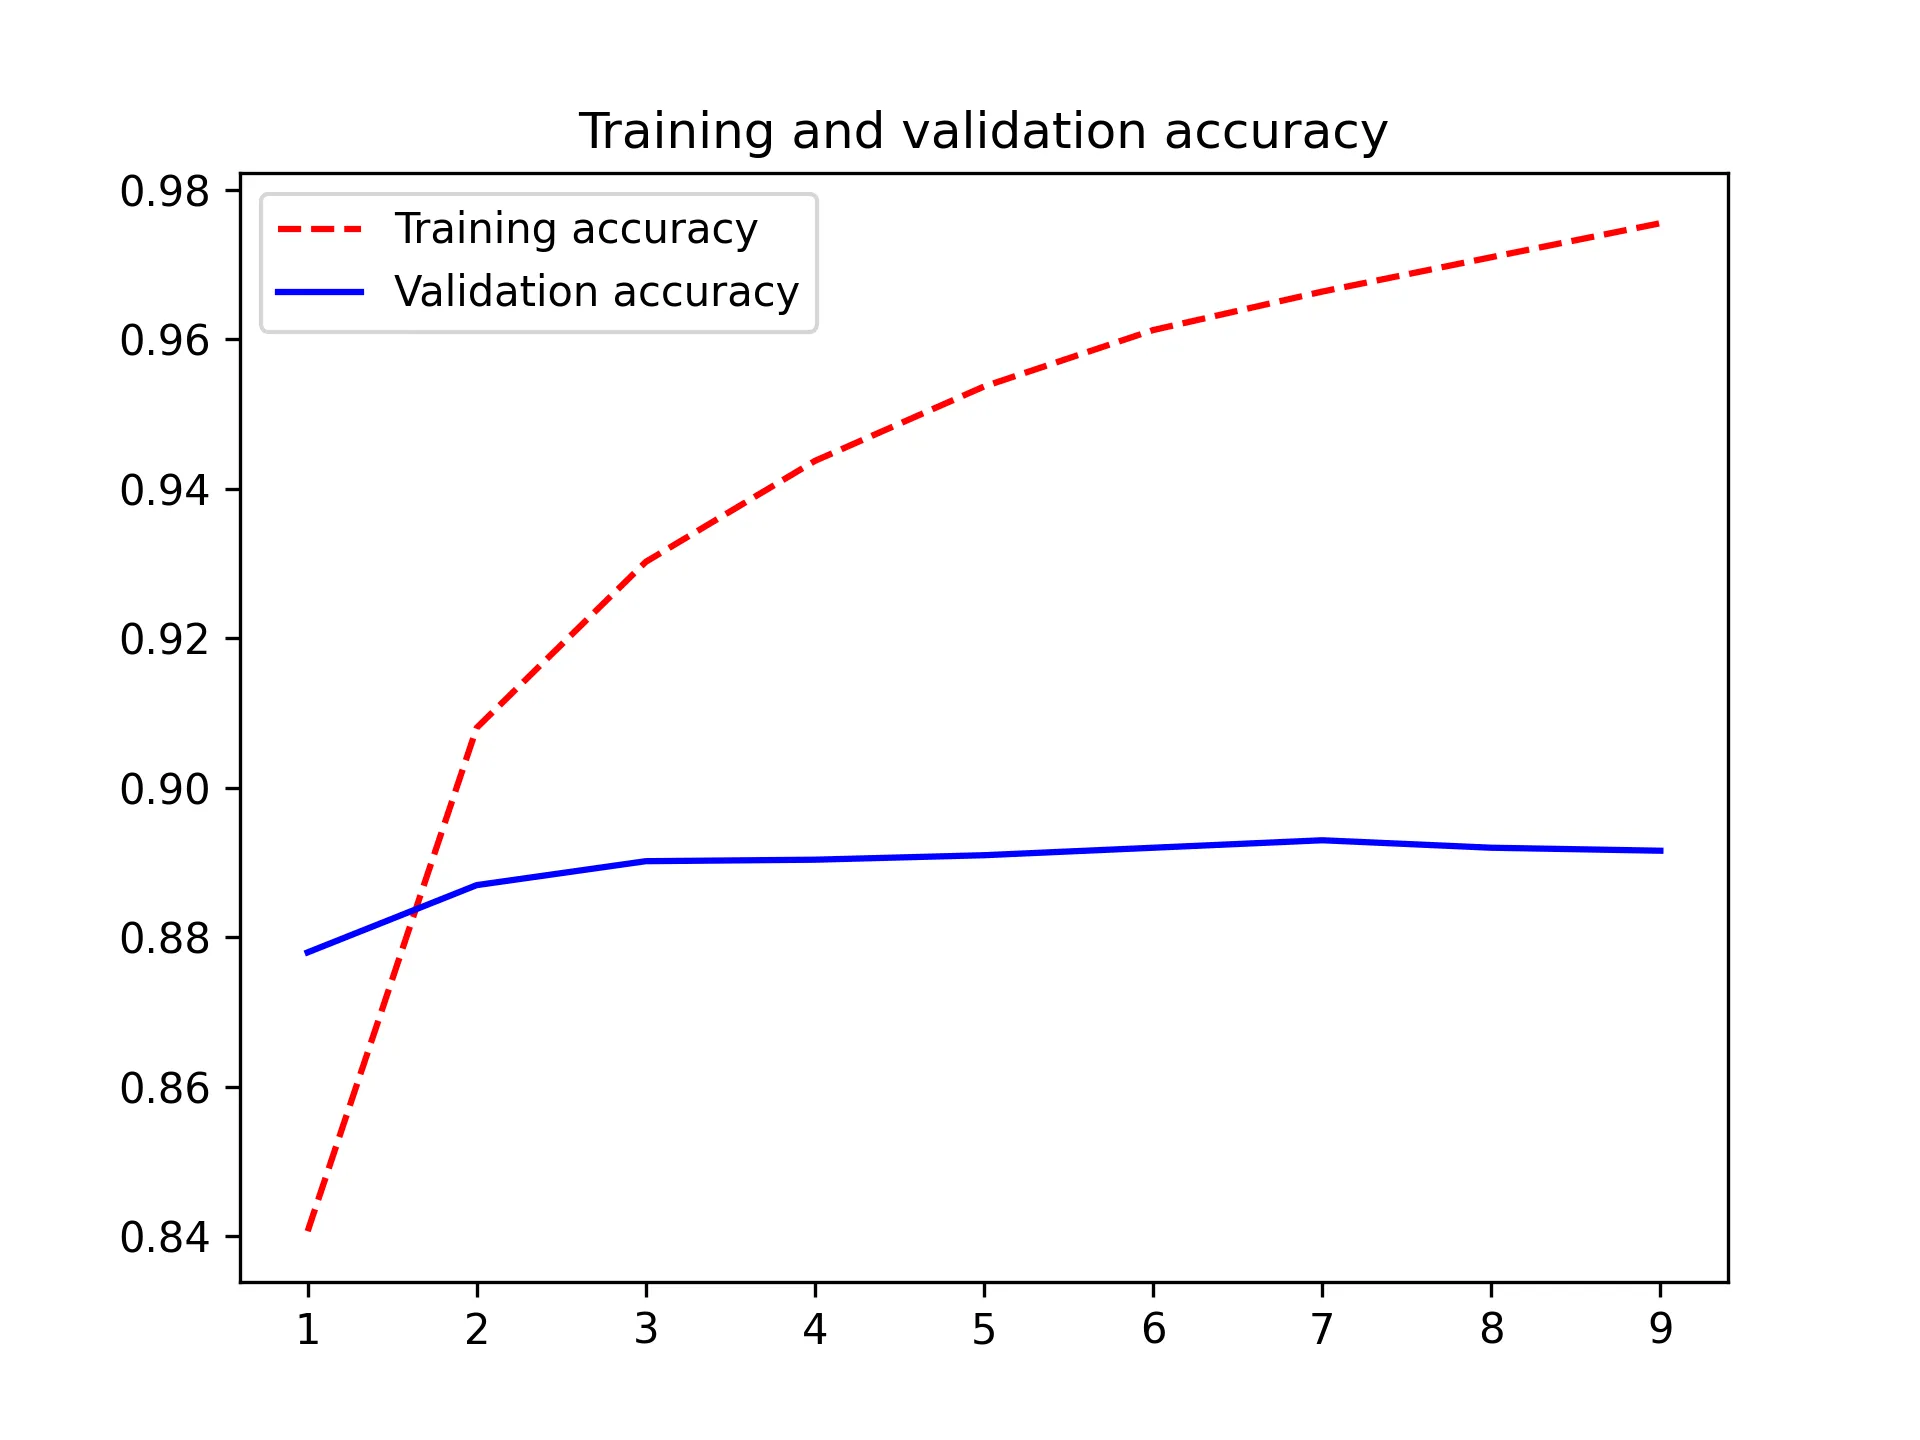
شکل ۱۴.۲: معیارهای آموزش و اعتبارسنجی برای مدل کیسهٔ کلمات ما
میتوانیم ببینیم که عملکرد اعتبارسنجی به جای کاهش قابل توجه، تثبیت میشود؛ مدل ما آنقدر ساده است که واقعاً نمیتواند بیشبرازش پیدا کند. بیایید ارزیابی آن را روی مجموعهٔ آزمون خود امتحان کنیم.
فهرست ۱۴.۱۶: ارزیابی مدل رگرسیون کیسهٔ کلمات
>>> test_loss, test_acc = model.evaluate(bag_of_words_test_ds)>>> test_accما میتوانیم احساسات یک نقد را در ۸۸٪ مواقع با یک کار آموزشی به اندازهٔ کافی سبک که بتواند به طور کارآمد روی یک CPU تکی اجرا شود، به درستی پیشبینی کنیم.
شایان ذکر است که به انتخاب توکنسازی کلمهای در این مثال توجه کنیم. دلیل اجتناب از توکنسازی در سطح کاراکتر در اینجا کاملاً واضح است — یک «کیسه» از تمام کاراکترها در یک نقد فیلم، چیز بسیار کمی در مورد محتوای آن به شما میگوید. توکنسازی زیرکلمهای با یک واژگان به اندازهٔ کافی بزرگ انتخاب خوبی خواهد بود، اما در اینجا نیازی به آن نیست. از آنجا که مدلی که آموزش میدهیم بسیار کوچک است، استفاده از واژگانی که آموزش آن سریع باشد و وزنهای ما متناظر با کلمات واقعی انگلیسی باشند، راحت است.
آموزش یک مدل بایگرام
Section titled “آموزش یک مدل بایگرام”البته، میتوانیم به طور شهودی حدس بزنیم که دور انداختن تمام ترتیب کلمات بسیار تقلیلگرایانه است، زیرا حتی مفاهیم پایهای را میتوان از طریق چند کلمه بیان کرد: عبارت «United States» مفهومی را منتقل میکند که کاملاً متمایز از معنای کلمات «states» و «united» به صورت جداگانه است. فیلمی که «not bad» (بد نیست) است و فیلمی که «bad» (بد) است احتمالاً باید امتیازات احساسی متفاوتی دریافت کنند.
بنابراین، معمولاً ایدهٔ خوبی است که مقداری آگاهی از ترتیب محلی کلمات را به یک مدل تزریق کنیم، حتی برای این مدلهای سادهٔ مبتنی بر مجموعه که در حال حاضر میسازیم. یک راه آسان برای انجام این کار در نظر گرفتن بایگرامها (bigrams) است — اصطلاحی برای دو توکن که به صورت متوالی در متن ورودی ظاهر میشوند. با توجه به مثال ما «this movie made me cry»، مجموعهٔ {"this", "movie", "made", "me", "cry"} مجموعهٔ تمام تکگرامهای (unigrams) کلمهای در ورودی است، و {"this movie", "movie made", "made me", "me cry"} مجموعهٔ تمام بایگرامها است. مدل کیسهٔ کلماتی که به تازگی آموزش دادیم را میتوان به طور معادل یک مدل تکگرام نامید، و اصطلاح انگرام (n-gram) به دنبالهای مرتب از n توکن برای هر n دلخواهی اشاره دارد.
برای افزودن بایگرامها به مدل خود، میخواهیم فراوانی تمام بایگرامها را در حین ساخت واژگان خود در نظر بگیریم. میتوانیم این کار را به دو روش انجام دهیم: با ایجاد واژگانی صرفاً از بایگرامها، یا با اجازه دادن به هر دو دستهٔ بایگرامها و تکگرامها برای رقابت بر سر فضا در یک واژگان یکسان. برای حالت دوم، اصطلاح "United States" اگر در متن ورودی مکررتر ظاهر شود، قبل از "ventriloquism" در واژگان ما گنجانده خواهد شد.
مجدداً، میتوانستیم این را با گسترش دادن WordTokenizer خود از ابتدای فصل بسازیم، اما نیازی نیست. TextVectorization این قابلیت را به صورت آماده فراهم میکند. ما واژگانی کمی بزرگتر را برای در نظر گرفتن حضور بایگرامها آموزش خواهیم داد، یک واژگان جدید را با adapt() تنظیم میکنیم، و بردارهای خروجی شامل بایگرامها را به صورت چندیکپایه (multi-hot) کدگذاری میکنیم.
فهرست ۱۴.۱۷: اعمال کدگذاری بایگرام بر روی نقدهای IMDb
max_tokens = 30_000text_vectorization = layers.TextVectorization(    max_tokens=max_tokens,    # Learns a word-level vocabulary    split="whitespace",    output_mode="multi_hot",    # Considers all unigrams and bigrams    ngrams=2,)text_vectorization.adapt(train_ds_no_labels)
bigram_train_ds = train_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)bigram_val_ds = val_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)bigram_test_ds = test_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)
بیایید دوباره یک دسته از ورودیهای پیشپردازششدهٔ خود را بررسی کنیم:
>>> x, y = next(bigram_train_ds.as_numpy_iterator())>>> x.shapeاگر به بخش کوچکی از واژگان خود نگاه کنیم، میتوانیم هر دو اصطلاح تکگرام و بایگرام را ببینیم:
>>> text_vectorization.get_vocabulary()[100:108]با کدگذاری جدیدمان برای دادههای ورودی، میتوانیم یک مدل خطی بدون تغییر نسبت به قبل را آموزش دهیم.
فهرست ۱۴.۱۸: آموزش مدل رگرسیون بایگرام
model = build_linear_classifier(max_tokens, "bigram_classifier")model.fit( bigram_train_ds, validation_data=bigram_val_ds, epochs=10, callbacks=[early_stopping],)این مدل کمی بزرگتر از مدلهای کیسهٔ کلمات ما خواهد بود (۳۰,۰۰۱ پارامتر به جای ۲۰,۰۰۱ پارامتر)، اما همچنان تقریباً در همان مدت زمان آموزش میبیند. عملکرد آن چطور بود؟
فهرست ۱۴.۱۹: ارزیابی مدل رگرسیون بایگرام
>>> test_loss, test_acc = model.evaluate(bigram_test_ds)>>> test_accما اکنون به ۹۰٪ دقت در آزمون دست یافتهایم، یک بهبود قابل توجه!
ما میتوانیم این عدد را حتی با در نظر گرفتن تریگرامها (سهتاییهای کلمات) بیشتر بهبود بخشیم، اگرچه فراتر از تریگرامها، مسئله به سرعت غیرقابل مدیریت میشود. فضای ۴-گرامهای ممکن از کلمات در زبان انگلیسی بسیار وسیع است و مسئله با طولانیتر و طولانیتر شدن دنبالهها به طور نمایی رشد میکند. شما به یک واژگان عظیم نیاز خواهید داشت تا پوشش مناسبی از ۴-گرامها را فراهم کند، و مدل شما توانایی تعمیم خود را از دست میدهد و صرفاً قطعات کاملی از جملات را با وزنهای متصل به آنها به خاطر میسپارد. برای اینکه دنبالههای متنی با ترتیب طولانیتر را به طور قوی در نظر بگیریم، به تکنیکهای مدلسازی پیشرفتهتری نیاز خواهیم داشت.
مدلهای دنبالهای
Section titled “مدلهای دنبالهای”دو مدل قبلی ما نشان دادند که اطلاعات دنباله مهم هستند. ما یک مدل خطی پایهای را با افزودن ویژگیهایی با مقداری اطلاعات در مورد ترتیب محلی کلمات بهبود بخشیدیم.
با این حال، این کار با مهندسی دستی ویژگیهای ورودی انجام شد، و ما میتوانیم ببینیم که چگونه این رویکرد فقط تا یک ترتیب محلی از چند کلمه مقیاس مییابد. همانطور که اغلب در یادگیری عمیق پیش میآید، به جای تلاش برای ساخت این ویژگیها توسط خودمان، باید مدل را در معرض دنبالهٔ کلمات خام قرار دهیم و به آن اجازه دهیم وابستگیهای موقعیتی بین توکنها را مستقیماً یاد بگیرد.
مدلهایی که یک دنبالهٔ کامل توکن را دریافت میکنند، به سادگی مدلهای دنبالهای (sequence models) نامیده میشوند. ما در اینجا چند انتخاب برای معماری داریم. میتوانیم یک مدل RNN بسازیم همانطور که برای مدلسازی سریهای زمانی انجام دادیم. میتوانیم یک ConvNet یکبعدی (1D ConvNet) بسازیم، مشابه مدلهای پردازش تصویر ما، اما با اعمال فیلترهای پیچشی روی یک بعد تکدنباله. و همانطور که در فصل بعد به طور عمیق بررسی خواهیم کرد، میتوانیم یک ترنسفورمر بسازیم.
قبل از در پیش گرفتن هر یک از این رویکردها، باید ورودیهای خود را به صورت دنبالههای مرتب پیشپردازش کنیم. ما یک دنبالهٔ عدد صحیح از شناسههای توکن میخواهیم، همانطور که در بخش توکنسازی این فصل دیدیم، اما با یک نکتهٔ اضافی که باید مدیریت شود. هنگامی که محاسبات را روی یک دسته (batch) از ورودیها اجرا میکنیم، میخواهیم همهٔ ورودیها مستطیلی شکل باشند تا تمام محاسبات بتوانند به طور مؤثری در سرتاسر دسته روی یک GPU موازی شوند. با این حال، ورودیهای توکنسازیشده تقریباً همیشه طولهای متفاوتی خواهند داشت. نقدهای فیلم IMDb از چند جمله تا چندین پاراگراف با تعداد کلمات متغیر متغیر هستند.
برای سازگاری با این واقعیت، میتوانیم دنبالههای ورودی خود را کوتاه (truncate) کنیم یا آنها را با یک توکن ویژهٔ دیگر به نام "[PAD]" «حاشیهگذاری (pad)» کنیم، مشابه توکن "[UNK]" که پیشتر استفاده کردیم. به عنوان مثال، با داشتن دو جملهٔ ورودی و طول مطلوب هشت:
"the quick brown fox jumped over the lazy dog"
"the slow brown badger"
ما آنها را به شناسههای عدد صحیح برای توکنهای زیر توکنسازی میکنیم:
["the", "quick", "brown", "fox", "jumped", "over", "the", "lazy"]["the", "slow", "brown", "badger", "[PAD]", "[PAD]", "[PAD]", "[PAD]"]این کار به محاسبات دستهای ما اجازه میدهد بسیار سریعتر پیش بروند، اگرچه باید با توکنهای حاشیهگذاری خود مراقب باشیم تا اطمینان حاصل کنیم که بر کیفیت پیشبینیهای مدل ما تأثیر نمیگذارند.
برای حفظ اندازهٔ ورودی قابل مدیریت، میتوانیم نقدهای IMDb خود را پس از ۶۰۰ کلمهٔ اول کوتاه کنیم. این یک انتخاب منطقی است، زیرا میانگین طول یک نقد ۲۳۳ کلمه است و تنها ۵٪ از نقدها طولانیتر از ۶۰۰ کلمه هستند. بار دیگر، میتوانیم از لایهٔ TextVectorization استفاده کنیم که گزینهای برای حاشیهگذاری یا کوتاه کردن ورودیها دارد و یک توکن "[PAD]" را در اندیس صفر واژگان آموختهشده قرار میدهد.
فهرست ۱۴.۲۰: حاشیهگذاری نقدهای IMDb تا رسیدن به طول دنبالهٔ ثابت
max_length = 600max_tokens = 30_000text_vectorization = layers.TextVectorization(    max_tokens=max_tokens,    # Learns a word-level vocabulary    split="whitespace",    # Outputs a integer sequence of token IDs    output_mode="int",    # Pads and truncates to 600 tokens    output_sequence_length=max_length,)text_vectorization.adapt(train_ds_no_labels)
sequence_train_ds = train_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)sequence_val_ds = val_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)sequence_test_ds = test_ds.map(    lambda x, y: (text_vectorization(x), y), num_parallel_calls=8)
بیایید به یک دسته ورودی منفرد نگاهی بیندازیم:
>>> x, y = next(sequence_test_ds.as_numpy_iterator())>>> x.shapeهر دسته پس از پیشپردازش دارای شکل (batch_size, sequence_length) است، و تقریباً تمام نمونههای آموزشی دارای تعدادی 0 برای حاشیهگذاری در انتها هستند.
آموزش یک مدل بازگشتی
Section titled “آموزش یک مدل بازگشتی”بیایید آموزش یک LSTM را امتحان کنیم. همانطور که در فصل قبل دیدیم، LSTMها میتوانند به طور کارآمد با دادههای دنبالهای کار کنند. قبل از اینکه بتوانیم آن را اعمال کنیم، هنوز باید اعداد صحیح شناسههای توکن خود را به دادههای ممیز شناور قابل دریافت توسط یک لایهٔ Dense نگاشت کنیم.
سرراستترین رویکرد این است که شناسههای ورودی خود را تکداغ (one-hot) کنیم، مشابه کدگذاری چندیکپایهای که برای یک دنبالهٔ کامل انجام دادیم. هر توکن به یک بردار طولانی با تمام 0ها و یک 1 منفرد در اندیس توکن در واژگان ما تبدیل میشود. بیایید لایهای برای کدگذاری تکداغ دنبالهٔ ورودی خود بسازیم.
فهرست ۱۴.۲۱: ساخت یک لایهٔ کدگذاری تکداغ با عملیاتهای کراس
from keras import ops
class OneHotEncoding(keras.Layer):    def __init__(self, depth, **kwargs):        super().__init__(**kwargs)        self.depth = depth
    def call(self, inputs):        # Flattens the inputs        flat_inputs = ops.reshape(ops.cast(inputs, "int"), [-1])        # Builds an identity matrix with all possible one-hot vectors        one_hot_vectors = ops.eye(self.depth)        # Uses our input token IDs to gather the correct vector for        # each token        outputs = ops.take(one_hot_vectors, flat_inputs, axis=0)        # Unflattens the output        return ops.reshape(outputs, ops.shape(inputs) + (self.depth,))
one_hot_encoding = OneHotEncoding(max_tokens)
بیایید این لایه را روی یک دسته ورودی منفرد امتحان کنیم:
>>> x, y = next(sequence_train_ds.as_numpy_iterator())>>> one_hot_encoding(x).shapeمیتوانیم این لایه را مستقیماً درون یک مدل بسازیم و از یک LSTM دوطرفه (bidirectional LSTM) استفاده کنیم تا به اطلاعات اجازه دهیم هم به سمت جلو و هم به سمت عقب در امتداد دنبالهٔ توکن منتشر شوند. بعداً، هنگامی که به تولید متن نگاه میکنیم، نیاز به مدلهای دنبالهای یکطرفه را خواهیم دید (جایی که وضعیت یک توکن فقط به وضعیت توکن قبل از آن بستگی دارد). برای وظایف طبقهبندی، یک LSTM دوطرفه گزینهٔ مناسبی است.
بیایید مدلمان را بسازیم.
فهرست ۱۴.۲۲: ساخت یک مدل دنبالهای LSTM
hidden_dim = 64inputs = keras.Input(shape=(max_length,), dtype="int32")x = one_hot_encoding(inputs)x = layers.Bidirectional(layers.LSTM(hidden_dim))(x)x = layers.Dropout(0.5)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs, outputs, name="lstm_with_one_hot")model.compile( optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"],)میتوانیم به خلاصهٔ مدل خود نگاه کنیم تا تصوری از تعداد پارامترهای خود به دست آوریم:
>>> model.summary()این یک جهش قابل توجه در اندازه نسبت به مدلهای تکگرام و بایگرام است. با حدود ۱۵ میلیون پارامتر، این یکی از بزرگترین مدلهایی است که تا کنون در کتاب آموزش دادهایم، آن هم فقط با یک لایهٔ LSTM تکی. بیایید آموزش مدل را امتحان کنیم.
فهرست ۱۴.۲۳: آموزش مدل دنبالهای LSTM
model.fit( sequence_train_ds, validation_data=sequence_val_ds, epochs=10, callbacks=[early_stopping],)عملکرد آن چگونه است؟
فهرست ۱۴.۲۴: ارزیابی مدل دنبالهای LSTM
>>> test_loss, test_acc = model.evaluate(sequence_test_ds)>>> test_accاین مدل کار میکند، اما بسیار کند آموزش میبیند، به خصوص در مقایسه با مدل سبک بخش قبل. دلیل آن این است که ورودیهای ما بسیار بزرگ هستند: هر نمونهٔ ورودی به صورت ماتریسی به اندازهٔ (600, 30000) کدگذاری میشود (۶۰۰ کلمه در هر نمونه، ۳۰,۰۰۰ کلمهٔ ممکن). این یعنی ۱۸,۰۰۰,۰۰۰ عدد ممیز شناور برای یک نقد فیلم منفرد! LSTM دوطرفهٔ ما کارهای زیادی برای انجام دادن دارد. علاوه بر کند بودن، این مدل تنها به ۸۴٪ دقت آزمون میرسد — اصلاً به خوبی مدلهای بسیار سریع مبتنی بر مجموعهٔ ما عمل نمیکند.
واضح است که استفاده از کدگذاری تکداغ برای تبدیل کلمات به بردارها، که سادهترین کاری بود که میتوانستیم انجام دهیم، ایدهٔ خوبی نبود. راه بهتری وجود دارد — جاسازیهای کلمه (word embeddings).
درک جاسازیهای کلمه
Section titled “درک جاسازیهای کلمه”هنگامی که چیزی را از طریق کدگذاری تکداغ (one-hot) کدگذاری میکنید، در حال گرفتن یک تصمیم مهندسی ویژگی هستید. شما در حال تزریق یک فرض بنیادین در مورد ساختار فضای ویژگی خود به مدل هستید. آن فرض این است که توکنهای متفاوتی که کدگذاری میکنید همگی از یکدیگر مستقل هستند: در واقع، بردارهای تکداغ همگی نسبت به یکدیگر متعامدند. در مورد کلمات، این فرض آشکارا غلط است. کلمات یک فضای ساختاریافته را تشکیل میدهند: آنها اطلاعات را با یکدیگر به اشتراک میگذارند. کلمات «movie» و «film» در اکثر جملات قابل تعویض هستند، بنابراین برداری که «movie» را نشان میدهد نباید نسبت به برداری که «film» را نشان میدهد متعامد باشد — آنها باید بردار یکسانی باشند، یا به اندازهٔ کافی نزدیک به هم باشند.
برای اینکه انتزاعیتر بگوییم، رابطهٔ هندسی بین بردارهای دو کلمه باید بازتابدهندهٔ رابطهٔ معنایی بین این کلمات باشد. به عنوان مثال، در یک فضای برداری کلمهٔ معقول، انتظار دارید کلمات مترادف به بردارهای کلمهٔ مشابهی جاسازی شوند، و به طور کلی، انتظار دارید فاصلهٔ هندسی (مانند فاصلهٔ کسینوسی یا فاصلهٔ L2) بین هر دو بردار کلمه با «فاصلهٔ معنایی» بین کلمات مرتبط در ارتباط باشد. کلماتی که معنای متفاوتی دارند باید دور از یکدیگر قرار گیرند، در حالی که کلمات مرتبط باید نزدیکتر باشند.
جاسازیهای کلمه (word embeddings) نمایشهای برداری از کلمات هستند که دقیقاً به این هدف دست مییابند: آنها زبان انسانی را به یک فضای هندسی ساختاریافته نگاشت میکنند.
در حالی که بردارهای به دست آمده از طریق کدگذاری تکداغ، دودویی، تنک (که عمدتاً از صفرها تشکیل شدهاند) و با ابعاد بسیار بالا هستند (همان ابعاد تعداد کلمات در واژگان)، جاسازیهای کلمه بردارهای ممیز شناور کمبعد هستند (یعنی بردارهای متراکم، در مقابل بردارهای تنک)؛ شکل ۱۴.۳ را ببینید. هنگام کار با واژگان بسیار بزرگ، معمول است که جاسازیهای کلمهای ۲۵۶ بعدی، ۵۱۲ بعدی یا ۱۰۲۴ بعدی را ببینید. از سوی دیگر، کدگذاری تکداغ کلمات معمولاً به بردارهایی ۳۰,۰۰۰ بعدی در مورد واژگان فعلی ما منجر میشود. بنابراین، جاسازیهای کلمه اطلاعات بیشتری را در ابعاد بسیار کمتری بستهبندی میکنند.
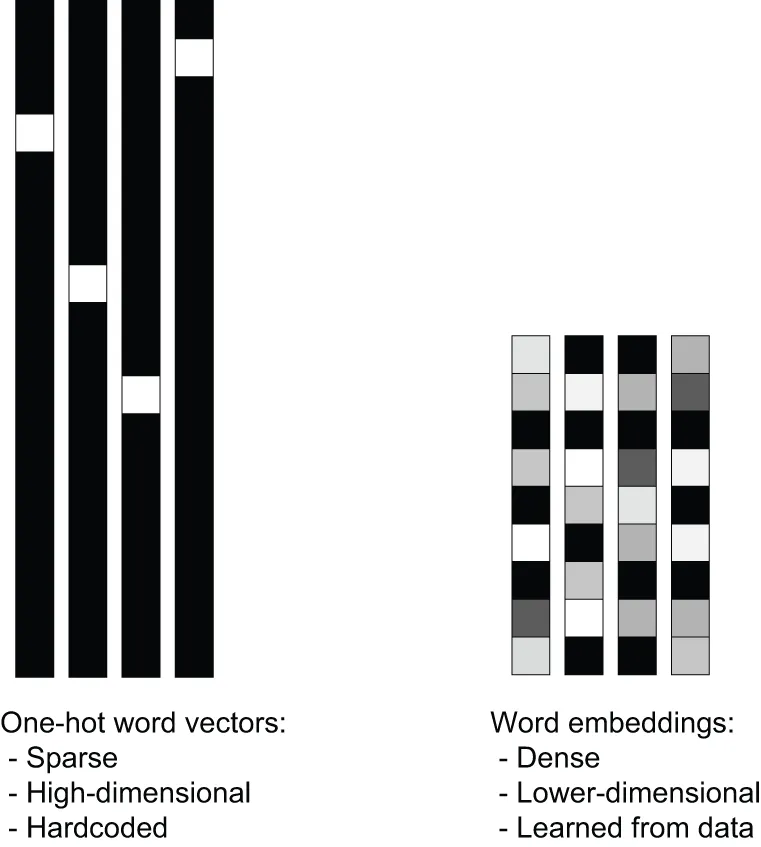
شکل ۱۴.۳: نمایشهای کلمه حاصل از کدگذاری تکداغ یا درهمسازی پراکنده، با ابعاد بالا و هاردکدشده هستند. جاسازیهای کلمه متراکم، با ابعاد نسبتاً پایین، و آموختهشده از دادهها هستند.
علاوه بر متراکم بودن، جاسازیهای کلمه نمایشهای ساختاریافتهای نیز هستند و ساختار آنها از دادهها آموخته میشود. کلمات مشابه در مکانهای نزدیک به هم جاسازی میشوند، و فراتر از آن، جهتهای خاصی در فضای جاسازی معنادار هستند. برای واضحتر شدن این موضوع، بیایید به یک مثال عینی نگاه کنیم. در شکل ۱۴.۴، چهار کلمه روی یک صفحهٔ دوبعدی جاسازی شدهاند: گربه (cat)، سگ (dog)، گرگ (wolf) و ببر (tiger). با نمایشهای برداری که در اینجا انتخاب کردیم، برخی از روابط معنایی بین این کلمات را میتوان به عنوان تبدیلات هندسی کدگذاری کرد. برای مثال، همان بردار به ما اجازه میدهد از گربه به ببر و از سگ به گرگ برویم: این بردار میتواند به عنوان بردار «از حیوان خانگی به حیوان وحشی» تفسیر شود. به طور مشابه، بردار دیگری به ما اجازه میدهد از سگ به گربه و از گرگ به ببر برویم، که میتواند به عنوان بردار «از سگسانان به گربهسانان» تفسیر شود.
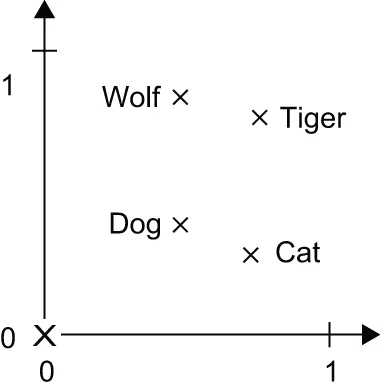
شکل ۱۴.۴: یک مثال اسباببازی از یک فضای جاسازی کلمه
در فضاهای جاسازی کلمه در دنیای واقعی، نمونههای معمولی از تبدیلات هندسی معنادار، بردارهای «جنسیت» و بردارهای «جمع» هستند. به عنوان مثال، با افزودن یک بردار «زن» به بردار «پادشاه (king)»، بردار «ملکه (queen)» را به دست میآوریم. با افزودن یک بردار «جمع»، «پادشاهان (kings)» را به دست میآوریم. فضاهای جاسازی کلمه معمولاً دارای هزاران بردار قابل تفسیر و بالقوه مفید از این دست هستند.
بیایید ببینیم چگونه میتوان از چنین فضای جاسازی در عمل استفاده کرد.
استفاده از یک جاسازی کلمه
Section titled “استفاده از یک جاسازی کلمه”آیا یک فضای جاسازی کلمهٔ ایدهآل وجود دارد که زبان انسانی را به طور کامل نگاشت کند و بتواند برای هر وظیفهٔ NLP استفاده شود؟ احتمالاً، اما ما هنوز نتوانستهایم چیزی از این دست را محاسبه کنیم. همچنین، هیچ زبان انسانی یگانهای وجود ندارد که بتوانیم سعی در نگاشت آن داشته باشیم — زبانهای مختلف زیادی وجود دارد و آنها نسبت به یکدیگر همریخت (ایزومورفیک) نیستند، زیرا یک زبان بازتابی از یک فرهنگ خاص و یک زمینهٔ ویژه است. عملگرایانهتر بگوییم، آنچه یک فضای جاسازی کلمهٔ خوب را میسازد به شدت به وظیفهٔ شما بستگی دارد: فضای جاسازی کلمهٔ عالی برای یک مدل تحلیل احساسات نقد فیلم به زبان انگلیسی ممکن است با فضای جاسازی ایدهآل برای یک مدل طبقهبندی اسناد حقوقی به زبان انگلیسی متفاوت به نظر برسد، زیرا اهمیت برخی روابط معنایی از وظیفهای به وظیفهٔ دیگر تغییر میکند.
بنابراین منطقی است که با هر وظیفهٔ جدید، یک فضای جاسازی جدید یاد بگیریم. خوشبختانه، پسانتشار این کار را آسان میکند، و کراس آن را حتی آسانتر مینماید. مسئله یادگیری وزنهای لایهٔ Embedding در کراس است.
لایهٔ Embedding به بهترین وجه به عنوان یک دیکشنری درک میشود که اندیسهای عدد صحیح (که نشاندهندهٔ کلمات خاص هستند) را به بردارهای متراکم نگاشت میکند. این لایه اعداد صحیح را به عنوان ورودی میگیرد، آنها را در یک دیکشنری داخلی جستجو میکند، و بردارهای مرتبط را برمیگرداند. این عملاً یک جستجوی دیکشنری است (شکل ۱۴.۵ را ببینید).
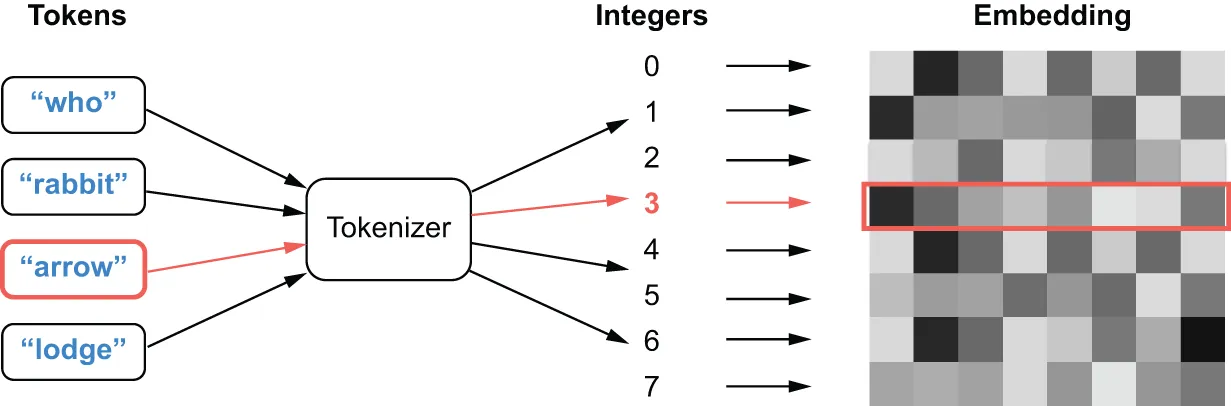
شکل ۱۴.۵: یک لایهٔ Embedding به عنوان یک دیکشنری عمل میکند که اعداد صحیح را به بردارهای نقطه شناور نگاشت مینماید.
لایهٔ Embedding یک تانسور مرتبه ۲ با شکل (batch_size, sequence_length) را به عنوان ورودی میگیرد، که در آن هر ورودی دنبالهای از اعداد صحیح است. این لایه یک تانسور ممیز شناور با شکل (batch_size, sequence_length, embedding_size) را برمیگرداند.
هنگامی که یک لایهٔ Embedding را نمونهسازی میکنید، وزنهای آن (دیکشنری داخلی آن از بردارهای توکن) در ابتدا مانند هر لایهٔ دیگری تصادفی هستند. در طول آموزش، این بردارهای کلمه به تدریج از طریق پسانتشار تنظیم میشوند و فضا را به چیزی تبدیل میکنند که مدل پاییندست میتواند از آن بهرهبرداری کند. پس از آموزش کامل، فضای جاسازی ساختار زیادی را نشان خواهد داد — نوعی ساختار که برای مسئلهٔ خاصی که مدل خود را برای آن آموزش میدهید، تخصصی شده است.
بیایید مدلی با یک لایهٔ Embedding بسازیم و آن را در وظیفهٔ خود معیار قرار دهیم.
فهرست ۱۴.۲۵: ساخت یک مدل دنبالهای LSTM با یک لایهٔ Embedding
hidden_dim = 64inputs = keras.Input(shape=(max_length,), dtype="int32")x = keras.layers.Embedding( input_dim=max_tokens, output_dim=hidden_dim, mask_zero=True,)(inputs)x = keras.layers.Bidirectional(keras.layers.LSTM(hidden_dim))(x)x = keras.layers.Dropout(0.5)(x)outputs = keras.layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs, outputs, name="lstm_with_embedding")model.compile( optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"],)دو آرگومان اول برای لایهٔ Embedding نسبتاً سرراست هستند. پارامتر input_dim دامنهٔ کل مقادیر ممکن برای ورودیهای عدد صحیح به لایه را تعیین میکند — یعنی چند کلید ممکن در جستجوی دیکشنری ما وجود دارد. پارامتر output_dim ابعاد بردار خروجی را که جستجو میکنیم تعیین میکند — یعنی ابعاد فضای برداری ساختاریافتهٔ ما برای کلمات.
آرگومان سوم، mask_zero=True، کمی ظریفتر است. این آرگومان به کراس میگوید که کدام ورودیها در دنبالهٔ ما توکنهای "[PAD]" هستند، تا بتوانیم بعداً این ورودیها را در مدل ماسکگذاری (mask) کنیم.
به یاد بیاورید که هنگام پیشپردازش ورودی دنبالهٔ خود، ممکن است توکنهای حاشیهگذاری زیادی به ورودی اصلی خود اضافه کنیم به طوری که یک دنبالهٔ توکن ممکن است شبیه این باشد:
["the", "movie", "was", "awful", "[PAD]", "[PAD]", "[PAD]", "[PAD]"]همهٔ آن توکنهای حاشیهگذاری ابتدا جاسازی شده و سپس به لایهٔ LSTM تغذیه میشوند. این بدان معناست که آخرین نمایشی که از سلول LSTM دریافت میکنیم ممکن است حاوی نتایج پردازش مکرر و بازگشتی نمایش توکن "[PAD]" باشد. ما علاقهٔ چندانی به نمایش آموختهشدهٔ LSTM برای آخرین توکن "[PAD]" در دنبالهٔ قبلی نداریم. در عوض، ما به نمایش "awful"، آخرین توکن غیر حاشیهگذاری، علاقهمندیم. یا به طور معادل، میخواهیم تمام توکنهای "[PAD]" را ماسکگذاری کنیم تا بر پیشبینی نهایی خروجی ما تأثیر نگذارند.
پارامتر mask_zero=True صرفاً یک راه میانبر برای انجام آسان چنین ماسکگذاری در کراس با لایهٔ Embedding است. کراس تمام عناصری را در دنبالهٔ ما که در ابتدا حاوی مقدار صفر بودند، علامتگذاری میکند، جایی که فرض میشود صفر شناسهٔ توکن برای توکن "[PAD]" است. این ماسک به صورت داخلی توسط لایهٔ LSTM استفاده خواهد شد. به جای خروجی دادن آخرین نمایش آموختهشده برای کل دنباله، این لایه آخرین نمایش ماسکنشده را خروجی میدهد.
این شکل از ماسکگذاری ضمنی (implicit) و استفاده از آن آسان است، اما در صورت نیاز همیشه میتوانید صریحاً مشخص کنید که کدام موارد در یک دنباله را میخواهید ماسک کنید. لایهٔ LSTM یک آرگومان فراخوانی اختیاری mask را برای ماسکگذاری صریح یا سفارشی دریافت میکند.
قبل از اینکه این مدل جدید را آموزش دهیم، بیایید نگاهی به خلاصهٔ مدل بیندازیم:
>>> model.summary()ما تعداد پارامترهای مدل LSTM کدگذاری تکداغ خود را از ۱۵ میلیون به ۲ میلیون کاهش دادهایم. بیایید مدل را آموزش داده و ارزیابی کنیم.
فهرست ۱۴.۲۶: آموزش و ارزیابی LSTM با یک لایهٔ Embedding
>>> model.fit(... sequence_train_ds,... validation_data=sequence_val_ds,... epochs=10,... callbacks=[early_stopping],... )>>> test_loss, test_acc = model.evaluate(sequence_test_ds)>>> test_accبا جاسازی، ما هم زمان آموزش و هم اندازهٔ مدل خود را به میزان یک مرتبهٔ بزرگی کاهش دادهایم. یک جاسازی آموختهشده آشکارا بسیار کارآمدتر از کدگذاری تکداغ ورودی ما است.
با این حال، عملکرد کلی LSTM تغییر نکرد. دقت سرسختانه در حدود ۸۴٪ باقی ماند، که هنوز بسیار دور از مدلهای کیسهٔ کلمات و بایگرام است. آیا این بدان معناست که یک «فضای جاسازی ساختاریافته» برای توکنهای ورودی در عمل چندان مفید نیست؟ یا برای وظایف طبقهبندی متن مفید نیست؟
کاملاً برعکس، یک فضای جاسازی توکن به خوبی آموزشدیده میتواند سقف عملکرد عملی مدلی مانند این را به طور چشمگیری بهبود بخشد. مشکل در این مورد خاص به ساختار آموزشی ما مربوط میشود. ما در ۲۰,۰۰۰ مثال نقد خود فاقد دادههای کافی برای آموزش مؤثر یک جاسازی کلمهٔ خوب هستیم. تا پایان ۱۰ دورهٔ آموزشی ما، دقت مجموعهٔ آموزش ما از ۹۹٪ عبور کرده است. مدل ما شروع به بیشبرازش و به خاطر سپردن ورودی ما کرده است، و معلوم میشود که خیلی قبل از اینکه مجموعهٔ بهینهای از جاسازیهای کلمه را برای کار مورد نظر یاد بگیریم، این اتفاق میافتد.
برای مواردی از این دست، میتوانیم به پیشآموزش (pretraining) روی آوریم. به جای آموزش مشترک جاسازی کلمه با وظیفهٔ طبقهبندی، میتوانیم آن را به طور جداگانه، روی دادههای بیشتر، بدون نیاز به برچسبهای نقد مثبت و منفی آموزش دهیم. بیایید نگاهی بیندازیم.
پیشآموزش یک جاسازی کلمه
Section titled “پیشآموزش یک جاسازی کلمه”دههٔ گذشتهٔ پیشرفت سریع در NLP همزمان با ظهور پیشآموزش (pretraining) به عنوان رویکرد غالب برای مسائل مدلسازی متن بوده است. هنگامی که از مدلهای رگرسیون سادهٔ مبتنی بر مجموعه فراتر میرویم و به مدلهای دنبالهای با میلیونها یا حتی میلیاردها پارامتر میرسیم، مدلهای متنی به شدت تشنهٔ داده میشوند. ما معمولاً با توانایی خود در یافتن مثالهای برچسبدار برای یک مسئلهٔ خاص در دامنهٔ متنی محدود میشویم.
ایده این است که یک وظیفهٔ بدون نظارت برای آموزش پارامترهای مدلی که نیازی به دادههای برچسبدار ندارند، ابداع کنیم. دادههای پیشآموزش میتوانند متنی در یک دامنهٔ مشابه با وظیفهٔ نهایی ما باشند، یا حتی صرفاً متنی اختیاری در زبانهایی باشند که ما علاقهمند به کار با آنها هستیم. پیشآموزش به ما امکان میدهد الگوهای کلی را در زبان یاد بگیریم، و عملاً مدل خود را قبل از اینکه آن را برای وظیفهٔ نهایی مورد نظر خود تخصصی کنیم، آماده (prime) سازیم.
جاسازیهای کلمه یکی از اولین موفقیتهای بزرگ در پیشآموزش متن بودند، و ما در این بخش نحوهٔ پیشآموزش یک جاسازی کلمه را نشان خواهیم داد. دایرکتوری unsup/ را که در آمادهسازی مجموعه دادهٔ IMDb خود نادیده گرفتیم به یاد دارید؟ این پوشه شامل ۲۵,۰۰۰ نقد دیگر است — هماندازه با دادههای آموزشی ما. ما تمام دادههای آموزشی خود را با هم ترکیب خواهیم کرد و نشان میدهیم که چگونه پارامترهای یک لایهٔ Embedding را با یک وظیفهٔ بدون نظارت پیشآموزش دهیم.
یکی از سرراستترین ساختارها برای آموزش یک جاسازی کلمه، مدل کیسهٔ کلمات پیوسته (Continuous Bag of Words یا CBOW)2 نامیده میشود. ایده این است که یک پنجره را روی تمام متنهای یک مجموعه داده بلغزانیم، جایی که به طور مداوم تلاش میکنیم یک کلمهٔ مفقود را بر اساس کلماتی که مستقیماً در سمت راست و چپ آن ظاهر میشوند حدس بزنیم (شکل ۱۴.۶). برای مثال، اگر «کیسهٔ» کلمات احاطهکنندهٔ ما حاوی کلمات «بادبان»، «موج» و «دکل» باشد، ممکن است حدس بزنیم که کلمهٔ میانی «قایق» یا «اقیانوس» است.
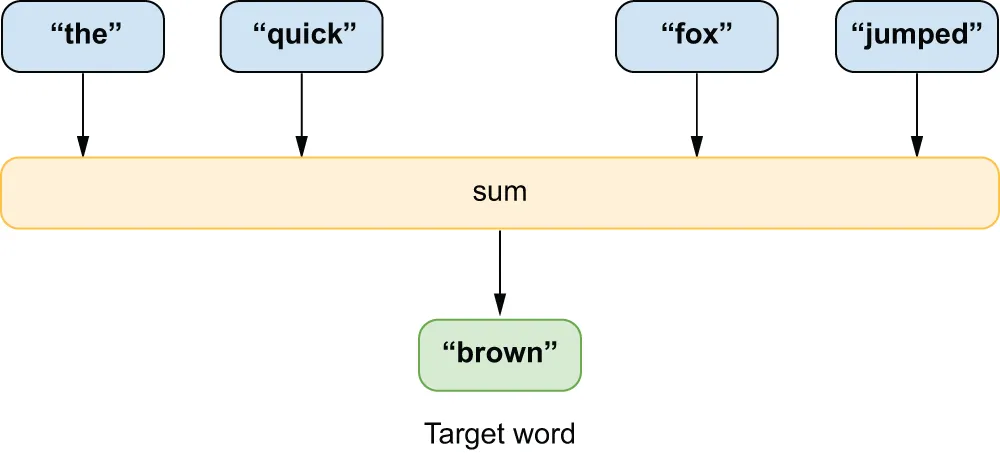
شکل ۱۴.۶: مدل کیسهٔ کلمات پیوسته (Continuous Bag of Words) یک کلمه را بر اساس بافت احاطهکنندهٔ آن با یک شبکهٔ عصبی کمعمق پیشبینی میکند.
در مسئلهٔ خاص طبقهبندی IMDb ما، علاقهمند به «آمادهسازی (priming)» جاسازی کلمهٔ مدل LSTM هستیم که به تازگی آموزش دادیم. میتوانیم از واژگان TextVectorization که قبلاً محاسبه کردیم مجدداً استفاده کنیم. تمام کاری که ما در اینجا سعی داریم انجام دهیم این است که یک بردار ۶۴ بعدی خوب برای هر کلمه در این واژگان یاد بگیریم.
میتوانیم یک لایهٔ TextVectorization جدید با همان واژگان ایجاد کنیم که ورودی را کوتاه یا حاشیهگذاری نکند. ما توکنهای خروجی این لایه را با لغزاندن یک پنجرهٔ زمینه در سرتاسر متن خود پیشپردازش خواهیم کرد.
فهرست ۱۴.۲۷: حذف حاشیهگذاری از لایهٔ پیشپردازش TextVectorization ما
imdb_vocabulary = text_vectorization.get_vocabulary()tokenize_no_padding = keras.layers.TextVectorization( vocabulary=imdb_vocabulary, split="whitespace", output_mode="int",)برای پیشپردازش دادههای خود، یک پنجره را در سرتاسر دادههای آموزشی خود میلغزانیم و «کیسههایی» از نه توکن متوالی ایجاد میکنیم. سپس، از کلمهٔ میانی به عنوان برچسب خود و از هشت کلمهٔ باقیمانده به عنوان یک زمینهٔ نامرتب برای پیشبینی برچسب خود استفاده میکنیم.
برای انجام این کار، دوباره از tf.data برای پیشپردازش ورودیهای خود استفاده خواهیم کرد، هرچند این انتخاب پشتیبان مورد استفادهٔ ما برای آموزش واقعی مدل را محدود نمیکند.
فهرست ۱۴.۲۸: پیشپردازش دادههای IMDb ما برای پیشآموزش یک مدل CBOW
import tensorflow as tf
# Words to the left or right of labelcontext_size = 4# Total window sizewindow_size = 9
def window_data(token_ids):    num_windows = tf.maximum(tf.size(token_ids) - context_size * 2, 0)    windows = tf.range(window_size)[None, :]    windows = windows + tf.range(num_windows)[:, None]    windowed_tokens = tf.gather(token_ids, windows)    return tf.data.Dataset.from_tensor_slices(windowed_tokens)
def split_label(window):    left = window[:context_size]    right = window[context_size + 1 :]    bag = tf.concat((left, right), axis=0)    label = window[4]    return bag, label
# Uses all training data, including the unsup/ directorydataset = keras.utils.text_dataset_from_directory(    imdb_extract_dir / "train", batch_size=None)# Drops labeldataset = dataset.map(lambda x, y: x, num_parallel_calls=8)# Tokenizesdataset = dataset.map(tokenize_no_padding, num_parallel_calls=8)# Creates context windowsdataset = dataset.interleave(window_data, cycle_length=8, num_parallel_calls=8)# Splits middle wonder into a labeldataset = dataset.map(split_label, num_parallel_calls=8)
پس از پیشپردازش، میتوانیم ببینیم که هشت شناسهٔ توکن عدد صحیح به عنوان بافت، جفتشده با یک برچسب شناسهٔ توکن تکی داریم.
مدلی که با این دادهها آموزش میدهیم بسیار ساده است. ما از یک لایهٔ Embedding برای جاسازی تمام توکنهای بافت و از یک لایهٔ GlobalAveragePooling1D برای محاسبهٔ میانگین جاسازی «کیسهٔ» توکنهای بافت خود استفاده خواهیم کرد. سپس، از آن میانگین جاسازی برای پیشبینی مقدار توکن برچسب میانی خود استفاده میکنیم.
همین! با پالایش مکرر فضای جاسازی خود به طوری که در پیشبینی یک کلمه بر اساس جاسازیهای کلمات نزدیک مهارت پیدا کنیم، یک جاسازی غنی از توکنهای استفادهشده در نقدهای فیلم یاد میگیریم.
فهرست ۱۴.۲۹: ساخت یک مدل CBOW
hidden_dim = 64inputs = keras.Input(shape=(2 * context_size,))cbow_embedding = layers.Embedding( max_tokens, hidden_dim,)x = cbow_embedding(inputs)x = layers.GlobalAveragePooling1D()(x)outputs = layers.Dense(max_tokens, activation="sigmoid")(x)cbow_model = keras.Model(inputs, outputs)cbow_model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["sparse_categorical_accuracy"],)>>> cbow_model.summary()از آنجا که مدل ما بسیار ساده است، میتوانیم از یک اندازهٔ دستهٔ بزرگ برای سرعت بخشیدن به آموزش بدون نگرانی در مورد محدودیتهای حافظه استفاده کنیم.
ما همچنین متد cache() را روی این مجموعه دادهٔ دستهبندیشده فراخوانی خواهیم کرد تا به جای محاسبهٔ مجدد آن در هر دوره، کل مجموعه دادهٔ پیشپردازششده را در حافظه ذخیره کنیم. دلیل آن این است که برای این مدل بسیار ساده، گلوگاه ما روی پیشپردازش است تا آموزش. یعنی توکنسازی متن ما و محاسبهٔ پنجرههای لغزان روی CPU کندتر از بهروزرسانی پارامترهای مدل ما روی GPU است.
در چنین مواردی، ذخیرهٔ خروجیهای پیشپردازششده در حافظه یا روی دیسک معمولاً ایدهٔ خوبی است. متوجه خواهید شد که دورههای بعدی ما بیش از سه برابر سریعتر از دورهٔ اول هستند. این به لطف کش دادههای آموزشی پیشپردازششده است.
فهرست ۱۴.۳۰: آموزش مدل CBOW
dataset = dataset.batch(1024).cache()cbow_model.fit(dataset, epochs=4)در پایان آموزش، ما میتوانیم کلمهٔ میانی را در حدود ۱۲٪ از مواقع صرفاً بر اساس هشت کلمهٔ همسایه حدس بزنیم. این ممکن است نتیجهٔ فوقالعادهای به نظر نرسد، اما با توجه به اینکه هر بار ۳۰,۰۰۰ کلمه برای حدس زدن داریم، این در واقع یک امتیاز دقت معقول است.
بیایید از این جاسازی کلمه برای بهبود عملکرد مدل LSTM خود استفاده کنیم.
استفاده از جاسازی پیشآموزشدیده برای طبقهبندی
Section titled “استفاده از جاسازی پیشآموزشدیده برای طبقهبندی”اکنون که یک جاسازی کلمهٔ جدید را آموزش دادهایم، اعمال آن بر روی مدل LSTM ما ساده است. ابتدا مدل را دقیقاً همانند قبل ایجاد میکنیم.
فهرست ۱۴.۳۱: ساخت یک مدل دنبالهای LSTM دیگر با یک لایهٔ Embedding
inputs = keras.Input(shape=(max_length,))lstm_embedding = layers.Embedding( input_dim=max_tokens, output_dim=hidden_dim, mask_zero=True,)x = lstm_embedding(inputs)x = layers.Bidirectional(layers.LSTM(hidden_dim))(x)x = layers.Dropout(0.5)(x)outputs = layers.Dense(1, activation="sigmoid")(x)model = keras.Model(inputs, outputs, name="lstm_with_cbow")سپس، وزنهای جاسازی خود را از لایهٔ جاسازی CBOW بر روی لایهٔ جاسازی LSTM اعمال میکنیم. این عملاً به عنوان یک مقداردهی اولیهٔ جدید و بهتر برای تقریباً ۲ میلیون پارامتر جاسازی در مدل LSTM عمل میکند.
فهرست ۱۴.۳۲: استفادهٔ مجدد از جاسازی CBOW برای آغازش مدل LSTM
lstm_embedding.embeddings.assign(cbow_embedding.embeddings)با این کار، میتوانیم مدل LSTM خود را طبق معمول کامپایل و آموزش دهیم.
فهرست ۱۴.۳۳: آموزش مدل LSTM با یک جاسازی پیشآموزشدیده
model.compile( optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"],)model.fit( sequence_train_ds, validation_data=sequence_val_ds, epochs=10, callbacks=[early_stopping],)بیایید مدل LSTM خود را ارزیابی کنیم.
فهرست ۱۴.۳۴: ارزیابی مدل LSTM با یک جاسازی پیشآموزشدیده
>>> test_loss, test_acc = model.evaluate(sequence_test_ds)>>> test_accبا وزنهای جاسازی پیشآموزشدیده، ما عملکرد LSTM خود را تقریباً به اندازهٔ مدلهای مبتنی بر مجموعهٔ خود افزایش دادهایم. ما کمی بهتر از مدل تکگرام و کمی بدتر از مدل بایگرام عمل میکنیم.
این ممکن است پس از تمام کارهایی که انجام دادیم کمی ناامیدکننده به نظر برسد. آیا یادگیری روی کل دنباله، با اطلاعات ترتیب، صرفاً ایدهٔ بدی است؟ مشکل این است که ما برای مدل نهایی LSTM خود همچنان با محدودیت داده مواجه هستیم. این مدل به اندازهٔ کافی گویا و قدرتمند است که با نقدهای فیلم کافی، به راحتی از رویکردهای مبتنی بر مجموعه پیشی میگیرد، اما قبل از اینکه سقف عملکرد مدل ما برآورده شود، به آموزش بسیار بیشتری روی دادههای مرتبشده نیاز داریم.
این مسئلهای است که با منابع محاسباتی کافی به راحتی قابل حل است. در فصل بعدی، مدل ترنسفورمر را پوشش خواهیم داد. این مدل در یادگیری وابستگیها در سرتاسر دنبالههای طولانیتر توکن کمی بهتر است، اما مهمتر از همه، این مدلها اغلب روی مقادیر زیادی از متن انگلیسی، از جمله تمام اطلاعات ترتیب کلمات آموزش میبینند. این به مدل اجازه میدهد تا به بیان تقریبی، شکل آماری الگوهای گرامری حاکم بر زبان را یاد بگیرد. این نوع الگوهای آماری حول ترتیب کلمات دقیقاً دلیلی است که مدل LSTM فعلی ما بیش از حد با محدودیت داده مواجه است تا بتواند به طور مؤثر یاد بگیرد.
با این حال، همانطور که به سمت مدلهای بزرگتر و پیشرفتهتری حرکت میکنیم که مرزهای عملکرد طبقهبندی متن را به جلو میرانند، ارزش اشاره دارد که رویکردهای رگرسیون سادهٔ مبتنی بر مجموعه مانند مدل بایگرام ما، «بیشترین بازدهی در ازای هزینه» را به شما میدهند. مدلهای مبتنی بر مجموعه فوقالعاده سریع هستند و میتوانند تنها چند هزار پارامتر داشته باشند، که بسیار دور از مدلهای زبان بزرگ میلیارد پارامتری است که امروزه اخبار را تسخیر کردهاند.
اگر در محیطی کار میکنید که محاسبات محدود است و میتوانید مقداری از دقت را فدا کنید، مدلهای مبتنی بر مجموعه اغلب میتوانند مقرونبهصرفهترین رویکرد باشند.
- تمام مسائل مدلسازی متن شامل یک مرحلهٔ پیشپردازش هستند که در آن متن خرد شده و به دادههای عدد صحیح تبدیل میشود، که توکنسازی (tokenization) نامیده میشود.
- توکنسازی را میتوان به سه مرحله تقسیم کرد: استانداردسازی (standardization) ، تقسیمبندی (splitting) ، و اندیسگذاری (indexing) . استانداردسازی متن را نرمال میکند، تقسیمبندی متن را به توکنها خرد میکند، و اندیسگذاری به هر توکن یک شناسهٔ عدد صحیح منحصر به فرد اختصاص میدهد.
- سه نوع اصلی توکنسازی وجود دارد: توکنسازی کاراکتری ، کلمهای ، و زیرکلمهای . با یک مدل به اندازهٔ کافی گویا و دادههای آموزشی کافی، توکنسازی زیرکلمهای معمولاً مؤثرترین گزینه است.
- مدلهای NLP اساساً در نحوهٔ مدیریت ترتیب توکنهای ورودی با یکدیگر تفاوت دارند:
- مدلهای مجموعهای (Set models) بیشتر اطلاعات ترتیب را نادیده میگیرند و مدلهایی ساده و سریع را صرفاً بر اساس حضور یا عدم حضور توکنها در ورودی یاد میگیرند. مدلهای بایگرام (bigram) یا تریگرام (trigram) حضور یا عدم حضور دو یا سه توکن متوالی را در نظر میگیرند. مدلهای مجموعهای برای آموزش و استقرار فوقالعاده سریع هستند.
- مدلهای دنبالهای (Sequence models) تلاش میکنند با دنبالهٔ مرتبشدهٔ توکنها در دادههای ورودی یاد بگیرند. مدلهای دنبالهای برای یادگیری مؤثر به مقادیر زیادی داده نیاز دارند.
- یک جاسازی (embedding) روشی کارآمد برای تبدیل شناسههای توکن به یک فضای نهان آموختهشده است. جاسازیها را میتوان به طور معمول با نزول گرادیان آموزش داد.
- پیشآموزش (Pretraining) برای مدلهای دنبالهای به عنوان راهی برای دور زدن ماهیت دادهمحور این مدلها حیاتی است. در طول پیشآموزش ، یک وظیفهٔ بدون نظارت به مدلها اجازه میدهد تا از مقادیر زیادی از دادههای متنی بدون برچسب یاد بگیرند. پارامترهای آموختهشده سپس میتوانند به یک وظیفهٔ پاییندست منتقل شوند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
فیلیپ گیج، “A New Algorithm for Data Compression,” The C Users Journal Archive (1994), https://dl.acm.org/doi/10.5555/177910.177914. ↩
-
میکولوف و همکاران، “Efficient Estimation of Word Representations in Vector Space,” International Conference on Learning Representations (2013), https://arxiv.org/abs/1301.3781. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.