
فصل ۱۵: مدلهای زبان و ترنسفورمر
با پوشش مبانی پیشپردازش و مدلسازی متن در فصل قبل، این فصل به برخی مسائل پیچیدهتر زبانی مانند ترجمهٔ ماشینی میپردازد. ما شهودی قوی برای مدل ترنسفورمر (Transformer) خواهیم ساخت که محصولاتی مانند ChatGPT را قدرت میبخشد و به ایجاد موجی از سرمایهگذاری در پردازش زبان طبیعی (NLP) کمک کرده است.
مدل زبان
Section titled “مدل زبان”در فصل قبل، یاد گرفتیم که چگونه دادههای متنی را به ورودیهای عددی تبدیل کنیم، و از این نمایش عددی برای طبقهبندی نقدهای فیلم استفاده کردیم. با این حال، طبقهبندی متن از جهات مختلف، مسئلهای منحصراً ساده است. ما فقط باید یک عدد ممیز شناور منفرد را برای طبقهبندی دودویی و در بدترین حالت، N عدد را برای طبقهبندی N-کلاسه خروجی دهیم.
در مورد سایر وظایف مبتنی بر متن مانند پاسخ به پرسشها یا ترجمه چطور؟ برای بسیاری از مسائل دنیای واقعی، ما علاقهمند به مدلی هستیم که بتواند برای یک ورودی معین، خروجی متنی تولید کند. درست همانطور که برای مدیریت متن در ورودی یک مدل به توکنسازها و جاسازیها نیاز داشتیم، باید تکنیکهایی را نیز قبل از تولید متن در خروجی ایجاد کنیم.
ما نیازی به شروع از ابتدا نداریم؛ میتوانیم همچنان از ایدهٔ دنبالهٔ عدد صحیح به عنوان یک نمایش عددی طبیعی برای متن استفاده کنیم. در فصل قبل، توکنسازی یک رشته را پوشش دادیم، جایی که ورودیها را به توکنها تقسیم کرده و هر توکن را به یک عدد صحیح نگاشت میکردیم. ما میتوانیم با پیش رفتن در جهت معکوس، یک دنباله را توکنزدایی (detokenize) کنیم — اعداد صحیح را دوباره به توکنهای رشتهای نگاشت کنیم و آنها را به یکدیگر متصل نماییم. با این رویکرد، مسئلهٔ ما ساخت مدلی میشود که بتواند یک دنبالهٔ عدد صحیح از توکنها را پیشبینی کند.
سادهترین گزینهای که میتوان در نظر گرفت ممکن است آموزش یک طبقهبند مستقیم بر روی فضای تمام دنبالههای عدد صحیح خروجی ممکن باشد، اما محاسبات سرانگشتی به سرعت نشان میدهد که این کار غیرقابل کنترل است. با یک واژگان ۲۰,۰۰۰ کلمهای، ۲۰,۰۰۰ به توان ۴، یا ۱۶۰ کوادریلیون دنبالهٔ ۴ کلمهای ممکن وجود دارد، و تعداد اتمهای موجود در جهان از تعداد دنبالههای ۲۰ کلمهای ممکن کمتر است. تلاش برای نمایش هر دنبالهٔ خروجی به عنوان یک خروجی طبقهبند منحصر به فرد، منابع محاسباتی را صرفنظر از نحوهٔ طراحی مدلمان تحتالشعاع قرار میدهد.
یک رویکرد عملی برای ممکن ساختن چنین مسئلهٔ پیشبینی، ساخت مدلی است که در هر لحظه تنها یک خروجی توکن تکی را پیشبینی میکند. یک مدل زبان (language model) مدلی است که در سادهترین شکل خود، یک توزیع احتمال سرراست اما عمیق را یاد میگیرد: p(token|past tokens). با داشتن دنبالهای از تمام توکنهای مشاهدهشده تا یک نقطه، یک مدل زبان تلاش میکند یک توزیع احتمال را روی تمام توکنهای ممکنی که میتوانند در ادامه بیایند، خروجی دهد. یک واژگان ۲۰,۰۰۰ کلمهای به این معنی است که مدل فقط باید ۲۰,۰۰۰ خروجی را پیشبینی کند، اما با پیشبینی مکرر توکن بعدی، ما مدلی ساختهایم که میتواند دنبالهٔ طولانی از متن تولید کند.
بیایید این موضوع را با ساخت یک مدل زبان ساده که کاراکتر بعدی را در دنبالهای از کاراکترها پیشبینی میکند، عینیتر کنیم. ما یک مدل کوچک آموزش خواهیم داد که میتواند متنی شبیه به شکسپیر خروجی دهد.
آموزش یک مدل زبان شکسپیر
Section titled “آموزش یک مدل زبان شکسپیر”برای شروع، میتوانیم مجموعهای از برخی نمایشنامهها و غزلیات شکسپیر را دانلود کنیم.
فهرست ۱۵.۱: دانلود مجموعهٔ خلاصهشدهای از آثار شکسپیر
import keras
filename = keras.utils.get_file(    origin=(        "https://storage.googleapis.com/download.tensorflow.org/"        "data/shakespeare.txt"    ),)shakespeare = open(filename, "r").read()
بیایید نگاهی به بخشی از دادهها بیندازیم:
>>> shakespeare[:250]برای ساخت یک مدل زبان از این ورودی، باید متن منبع خود را آمادهسازی کنیم. ابتدا دادههای خود را به تکههایی با طول مساوی تقسیم میکنیم که بتوانیم آنها را دستهبندی کرده و برای آموزش مدل استفاده کنیم، بسیار شبیه کاری که برای اندازهگیریهای آبوهوا در فصل سریهای زمانی انجام دادیم. از آنجا که در اینجا از یک توکنساز در سطح کاراکتر استفاده خواهیم کرد، میتوانیم این تکهتکهسازی را مستقیماً روی ورودی رشتهای انجام دهیم. یک رشتهٔ ۱۰۰ کاراکتری به یک دنبالهٔ ۱۰۰ عددی نگاشت خواهد شد.
ما همچنین هر ورودی را به دو دنبالهٔ جداگانهٔ ویژگی و برچسب تقسیم خواهیم کرد، به طوری که هر دنبالهٔ برچسب صرفاً همان دنبالهٔ ورودی با یک جابهجایی به اندازهٔ یک کاراکتر است.
فهرست ۱۵.۲: تقسیم متن به تکهها برای آموزش مدل زبان
import tensorflow as tf
# The chunk size we will use during training. We only train on# sequences of 100 characters at a time.sequence_length = 100
def split_input(input, sequence_length):    for i in range(0, len(input), sequence_length):        yield input[i : i + sequence_length]
features = list(split_input(shakespeare[:-1], sequence_length))labels = list(split_input(shakespeare[1:], sequence_length))dataset = tf.data.Dataset.from_tensor_slices((features, labels))
بیایید به یک نمونه ورودی (x, y) نگاه کنیم. برچسب ما در هر موقعیت از دنباله، کاراکتر بعدی در دنباله است:
>>> x, y = next(dataset.as_numpy_iterator())>>> x[:50], y[:50]برای نگاشت این ورودی به دنبالهای از اعداد صحیح، میتوانیم دوباره از لایهٔ TextVectorization که در فصل قبل دیدیم استفاده کنیم. برای یادگیری واژگانی در سطح کاراکتر به جای واژگانی در سطح کلمه، میتوانیم آرگومان split خود را تغییر دهیم. به جای تقسیم پیشفرض بر اساس "whitespace"، بر اساس "character" تقسیم میکنیم. در اینجا هیچ استانداردسازی انجام نمیدهیم — برای ساده نگه داشتن موارد، بزرگی و کوچکی حروف را حفظ میکنیم و علائم نگارشی را بدون تغییر عبور میدهیم.
فهرست ۱۵.۳: یادگیری یک واژگان در سطح کاراکتر با لایهٔ TextVectorization
from keras import layers
tokenizer = layers.TextVectorization(    standardize=None,    split="character",    output_sequence_length=sequence_length,)tokenizer.adapt(dataset.map(lambda text, labels: text))
بیایید واژگان را بررسی کنیم:
>>> vocabulary_size = tokenizer.vocabulary_size()>>> vocabulary_sizeما برای مدیریت کل متن منبع تنها به ۶۷ کاراکتر نیاز داریم.
سپس، میتوانیم لایهٔ توکنسازی خود را روی متن ورودی اعمال کنیم. و در نهایت، میتوانیم مجموعه دادهٔ خود را بر هم بزنیم (shuffle)، دستهبندی کنیم و در حافظه کش نماییم تا نیازی به محاسبهٔ مجدد آن در هر دوره نباشد:
dataset = dataset.map( lambda features, labels: (tokenizer(features), tokenizer(labels)), num_parallel_calls=8,)training_data = dataset.shuffle(10_000).batch(64).cache()با این کار، آمادهٔ شروع مدلسازی هستیم.
برای ساخت مدل زبان سادهٔ خود، میخواهیم احتمال یک کاراکتر را با در نظر گرفتن تمام کاراکترهای گذشته پیشبینی کنیم. از بین تمام امکانات مدلسازی که تا کنون در این کتاب دیدهایم، یک RNN طبیعیترین گزینه است، زیرا وضعیت بازگشتی هر سلول به مدل اجازه میدهد هنگام پیشبینی برچسب کاراکتر فعلی، اطلاعات مربوط به کاراکترهای گذشته را منتشر کند. ما همچنین میتوانیم از یک Embedding، همانطور که در فصل قبل دیدیم، برای جاسازی هر کاراکتر ورودی به عنوان یک بردار ۲۵۶ بعدی منحصر به فرد استفاده کنیم.
ما تنها از یک لایهٔ بازگشتی منفرد استفاده خواهیم کرد تا این مدل را کوچک و آموزش آن را آسان نگه داریم. هر لایهٔ بازگشتی در اینجا کار خواهد کرد، اما برای ساده نگه داشتن امور، از یک GRU استفاده میکنیم که سریع است و وضعیت داخلی سادهتری نسبت به یک LSTM دارد.
فهرست ۱۵.۴: ساخت یک مدل زبان مینیاتوری
embedding_dim = 256hidden_dim = 1024
inputs = layers.Input(shape=(sequence_length,), dtype="int", name="token_ids")x = layers.Embedding(vocabulary_size, embedding_dim)(inputs)x = layers.GRU(hidden_dim, return_sequences=True)(x)x = layers.Dropout(0.1)(x)# Outputs a probability distribution over all potential tokens in our# vocabularyoutputs = layers.Dense(vocabulary_size, activation="softmax")(x)model = keras.Model(inputs, outputs)
بیایید نگاهی به خلاصهٔ مدل خود بیندازیم:
>>> model.summary()این مدل یک احتمال سافتمکس را برای هر کاراکتر ممکن در واژگان ما خروجی میدهد، و ما آن را با یک زیان آنتروپی متقاطع compile() خواهیم کرد. توجه داشته باشید که مدل ما همچنان روی یک مسئلهٔ طبقهبندی آموزش میبیند، فقط اینکه ما یک پیشبینی طبقهبندی برای هر توکن در دنبالهٔ خود انجام خواهیم داد. برای دستهٔ ۶۴ تایی ما از نمونههایی با ۱۰۰ کاراکتر در هر کدام، ما ۶,۴۰۰ برچسب منفرد را پیشبینی خواهیم کرد. معیارهای زیان و دقت گزارششده توسط کراس در طول آموزش ابتدا در سرتاسر هر دنباله و سپس در سرتاسر هر دسته میانگینگیری میشوند.
بیایید جلو برویم و مدل زبان خود را آموزش دهیم.
فهرست ۱۵.۵: آموزش یک مدل زبان مینیاتوری
model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["sparse_categorical_accuracy"],)model.fit(training_data, epochs=20)پس از ۲۰ دوره، مدل ما در نهایت میتواند کاراکتر بعدی در دنبالههای ورودی ما را در حدود ۷۰٪ مواقع پیشبینی کند.
تولید شکسپیر
Section titled “تولید شکسپیر”اکنون که مدلی را آموزش دادهایم که میتواند توکنهای منفرد بعدی را با مقداری دقت پیشبینی کند، میخواهیم از آن برای برونیابی یک دنبالهٔ کامل پیشبینیشده استفاده کنیم. میتوانیم این کار را با فراخوانی مدل در یک حلقه انجام دهیم، جایی که خروجی پیشبینیشدهٔ مدل در یک گام زمانی، به ورودی مدل در گام زمانی بعدی تبدیل میشود. مدلی که برای این نوع حلقهٔ بازخورد ساخته شده است گاهی اوقات یک مدل خودهمبسته (autoregressive) نامیده میشود.
برای اجرای چنین حلقهای، باید یک جراحی جزئی روی مدلی که به تازگی آموزش دادهایم انجام دهیم. در طول آموزش، مدل ما فقط یک دنباله با طول ثابت ۱۰۰ توکن را مدیریت میکرد، و وضعیت سلول GRU هنگام فراخوانی لایه به طور ضمنی مدیریت میشد. در طول تولید، ما میخواهیم در هر لحظه یک توکن خروجی منفرد را پیشبینی کنیم و وضعیت سلول GRU را به طور صریح خروجی دهیم. ما باید آن وضعیت را که حاوی تمام اطلاعاتی است که مدل در مورد کاراکترهای ورودی گذشته کدگذاری کرده است، دفعهٔ بعد که مدل را فراخوانی میکنیم منتشر کنیم.
بیایید مدلی بسازیم که در هر زمان یک کاراکتر ورودی منفرد را مدیریت کند و اجازه دهد وضعیت RNN به طور صریح منتقل شود. از آنجا که این مدل دارای ساختار محاسباتی یکسانی با ورودیها و خروجیهای کمی تغییریافته خواهد بود، میتوانیم وزنها را از یک مدل به مدل دیگر اختصاص دهیم.
فهرست ۱۵.۶: اصلاح مدل زبان برای استنتاج خودهمبسته
# Creates a model that receives and outputs the RNN stateinputs = keras.Input(shape=(1,), dtype="int", name="token_ids")input_state = keras.Input(shape=(hidden_dim,), name="state")
x = layers.Embedding(vocabulary_size, embedding_dim)(inputs)x, output_state = layers.GRU(hidden_dim, return_state=True)(    x, initial_state=input_state)outputs = layers.Dense(vocabulary_size, activation="softmax")(x)generation_model = keras.Model(    inputs=(inputs, input_state),    outputs=(outputs, output_state),)# Copies the parameters from the original modelgeneration_model.set_weights(model.get_weights())
با این کار، میتوانیم مدل را برای پیشبینی یک دنبالهٔ خروجی در یک حلقه فراخوانی کنیم. قبل از اینکه این کار را انجام دهیم، جداول جستجوی صریحی میسازیم تا از کاراکترها به اعداد صحیح سوئیچ کنیم و یک پرامپت (prompt) انتخاب کنیم — قطعهای از متن که قبل از شروع پیشبینی توکنهای جدید به عنوان ورودی به مدل تغذیه میکنیم:
tokens = tokenizer.get_vocabulary()token_ids = range(vocabulary_size)char_to_id = dict(zip(tokens, token_ids))id_to_char = dict(zip(token_ids, tokens))
prompt = """KING RICHARD III:"""
برای شروع تولید، ابتدا باید وضعیت داخلی GRU را با پرامپت خود «آماده (prime)» کنیم. برای انجام این کار، پرامپت را توکنبهتوکن به مدل تغذیه خواهیم کرد. این کار وضعیت دقیق RNN را که مدل در صورت مواجهه با این پرامپت در طول آموزش میدید، محاسبه میکند.
هنگامی که آخرین کاراکتر پرامپت را به مدل تغذیه میکنیم، خروجی وضعیت ما اطلاعات مربوط به کل دنبالهٔ پرامپت را ثبت خواهد کرد. ما میتوانیم پیشبینی خروجی نهایی را ذخیره کنیم تا بعداً اولین کاراکتر پاسخ تولیدشدهٔ خود را انتخاب کنیم.
فهرست ۱۵.۷: استفاده از یک پرامپت ثابت برای محاسبهٔ وضعیت شروع مدل زبان
input_ids = [char_to_id[c] for c in prompt]state = keras.ops.zeros(shape=(1, hidden_dim))for token_id in input_ids: inputs = keras.ops.expand_dims([token_id], axis=0) # Feeds the prompt character by character to update state predictions, state = generation_model.predict((inputs, state), verbose=0)اکنون آمادهایم به مدل اجازه دهیم دنبالهٔ خروجی جدیدی را پیشبینی کند. در یک حلقه، تا رسیدن به طول مورد نظر، به طور مداوم محتملترین کاراکتر بعدی پیشبینیشده توسط مدل را انتخاب میکنیم، آن را به مدل تغذیه میکنیم و وضعیت جدید RNN را پایدار نگه میداریم. به این ترتیب، میتوانیم یک دنبالهٔ کامل را توکنبهتوکن پیشبینی کنیم.
فهرست ۱۵.۸: پیشبینی با مدل زبان توکنبهتوکن
import numpy as np
generated_ids = []max_length = 250# Generates characters one by one, computing a new state each iterationfor i in range(max_length):    # The next character is the output index with the highest    # probability.    next_char = int(np.argmax(predictions, axis=-1)[0])    generated_ids.append(next_char)    inputs = keras.ops.expand_dims([next_char], axis=0)    predictions, state = generation_model.predict((inputs, state), verbose=0)
بیایید دنبالهٔ عدد صحیح خروجی خود را به رشته تبدیل کنیم تا ببینیم مدل چه چیزی پیشبینی کرده است. برای توکنزدایی (detokenize) ورودی خود، به سادگی تمام شناسههای توکن را به رشتهها نگاشت میکنیم و آنها را به یکدیگر متصل مینماییم:
output = "".join([id_to_char[token_id] for token_id in generated_ids])print(prompt + output)خروجی زیر را دریافت میکنیم:
KING RICHARD III:Stay, men! hear me speak.
FRIAR LAURENCE:Thou wouldst have done thee here that he hath made for them?
BUCKINGHAM:What straight shall stop his dismal threatening son,Thou bear them both. Here comes the king;Though I be good to put a wife to him,
ما هنوز تراژدی بزرگ بعدی را تولید نکردهایم، اما این نتیجه برای دو دقیقه آموزش روی یک مجموعه دادهٔ حداقلی بد نیست. هدف این مثال اسباببازی نشان دادن قدرت ساختار مدل زبان است. ما مدل را روی مسئلهٔ محدود حدس زدن یک کاراکتر منفرد در هر لحظه آموزش دادیم اما همچنان از آن برای یک مسئلهٔ بسیار گستردهتر، یعنی تولید یک پاسخ متنی باز و شبیه به شکسپیر استفاده میکنیم.
مهم است توجه داشته باشیم که این ساختار آموزشی فقط به این دلیل کار میکند که یک شبکهٔ عصبی بازگشتی اطلاعات را فقط رو به جلو در دنباله منتقل مینماید. اگر مایل هستید، لایهٔ GRU را با یک Bidirectional(GRU(...)) جایگزین کنید. دقت آموزش بلافاصله به بالای ۹۹٪ افزایش مییابد و تولید کاملاً متوقف خواهد شد. در طول آموزش، مدل ما در هر گام آموزشی کل دنباله را میبیند. اگر با اجازه دادن به اطلاعات حاصل از توکن بعدی در دنباله برای تأثیرگذاری بر پیشبینی توکن فعلی «تقلب» کنیم، مسئلهمان را به شکلی بدیهی ساده کردهایم.
این ساختار مدلسازی زبان برای مسائل بیشماری در حوزهٔ متن اساسی است. همچنین در مقایسه با سایر مسائل مدلسازی که تا کنون در این کتاب دیدهایم تا حدودی منحصر به فرد است. ما نمیتوانیم صرفاً model.predict() را فراخوانی کنیم تا خروجی مورد نظر را دریافت نماییم. یک حلقهٔ کامل و مقدار غیرقابلتوجهی از منطق وجود دارد که تنها در زمان استنتاج وجود دارد! چرخهٔ وضعیت در سلول RNN هم برای آموزش و هم برای استنتاج رخ میدهد، اما در هیچ نقطهای در طول آموزش، برچسبهای پیشبینیشدهٔ یک مدل را به عنوان ورودی دوباره به خود مدل تغذیه نمیکنیم.
یادگیری دنبالهبهدنباله
Section titled “یادگیری دنبالهبهدنباله”بیایید ایدهٔ مدل زبان را در نظر بگیریم و آن را برای مقابله با یک مسئلهٔ مهم — ترجمهٔ ماشینی — گسترش دهیم. ترجمه متعلق به کلاسی از مسائل مدلسازی است که اغلب مدلسازی دنبالهبهدنباله (sequence-to-sequence) (یا اگر میخواهید در تایپ صرفهجویی کنید، seq2seq) نامیده میشود. ما به دنبال ساخت مدلی هستیم که بتواند یک متن مبدأ را به عنوان یک دنبالهٔ ورودی ثابت دریافت کند و دنبالهٔ متن ترجمهشده را به عنوان نتیجه تولید نماید. پاسخ به پرسشها یکی دیگر از مسائل کلاسیک دنبالهبهدنباله است.
الگوی کلی در پس مدلهای دنبالهبهدنباله در شکل ۱۵.۱ توصیف شده است. در طول آموزش، موارد زیر رخ میدهد:
- یک مدل رمزگذار (encoder) دنبالهٔ مبدأ را به یک نمایش میانی تبدیل میکند.
- یک رمزگشا (decoder) با استفاده از همان ساختار مدلسازی زبانی که قبلاً دیدیم آموزش داده میشود. این رمزگشا با نگاه کردن به تمام توکنهای هدف قبلی و نمایش رمزگذار ما از دنبالهٔ مبدأ، به طور بازگشتی توکن بعدی در دنبالهٔ هدف را پیشبینی میکند.
در طول استنتاج، ما به دنبالهٔ هدف دسترسی نداریم — ما در تلاشیم آن را از ابتدا پیشبینی کنیم. ما آن را توکنبهتوکن تولید خواهیم کرد، درست مانند کاری که با مولد شکسپیر خود انجام دادیم:
- ما دنبالهٔ کدگذاریشدهٔ مبدأ را از رمزگذار به دست میآوریم.
- رمزگشا با نگاه کردن به دنبالهٔ کدگذاریشدهٔ مبدأ و همچنین یک توکن «بذر (seed)» اولیه (مانند رشتهٔ
"[start]") شروع میکند و از آنها برای پیشبینی اولین توکن واقعی در دنباله استفاده مینماید. - دنبالهٔ پیشبینیشده تا کنون، در یک حلقه به رمزگشا بازگردانده میشود تا زمانی که یک توکن توقف (مانند رشتهٔ
"[end]") تولید کند.
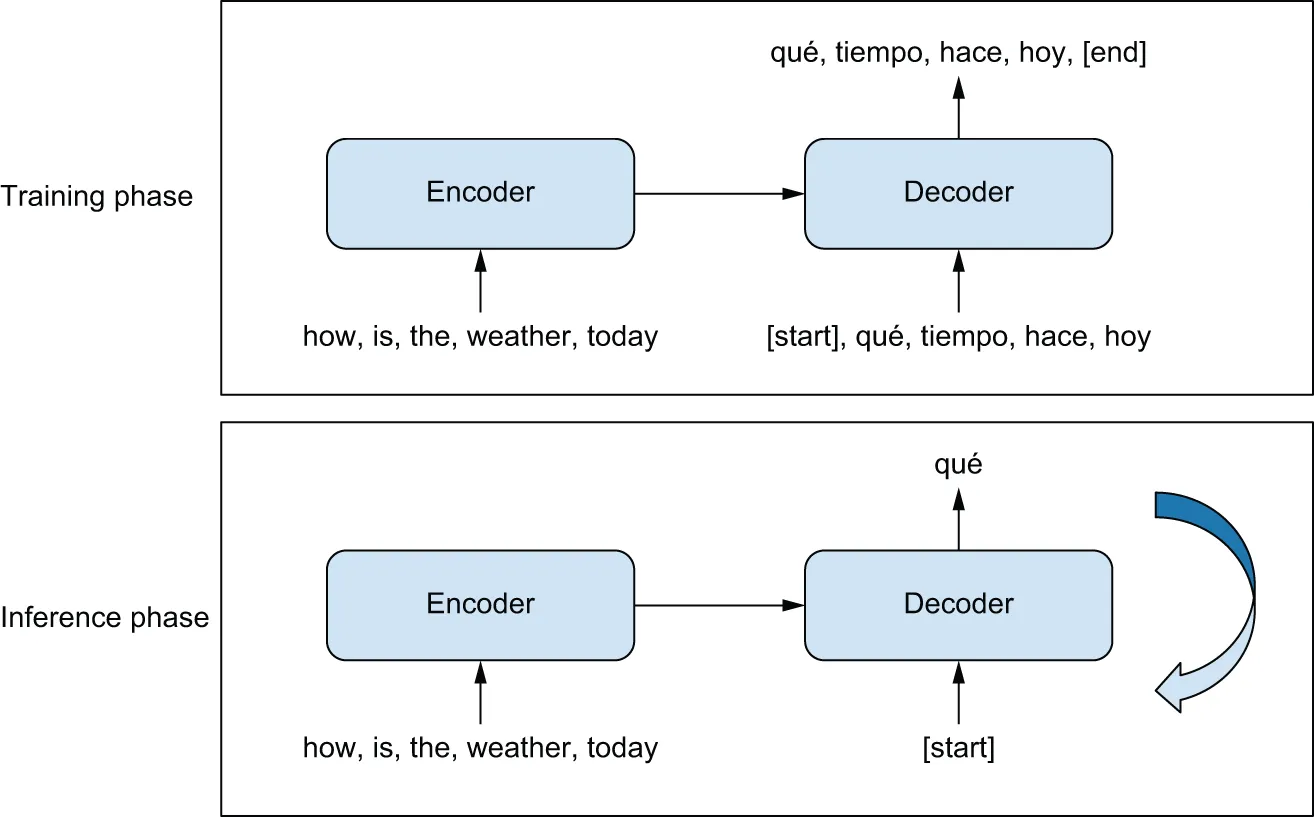
شکل ۱۵.۱: یادگیری دنبالهبهدنباله: دنبالهٔ مبدأ توسط رمزگذار پردازش میشود و سپس به رمزگشا فرستاده میشود. رمزگشا به دنبالهٔ هدف تا کنون نگاه میکند و دنبالهٔ هدف را با یک گام جابهجایی در آینده پیشبینی مینماید. در طول استنتاج، ما در هر لحظه یک توکن هدف تولید میکنیم و آن را دوباره به رمزگشا تغذیه میکنیم.
بیایید یک مدل ترجمهٔ دنبالهبهدنباله بسازیم.
ترجمهٔ انگلیسی به اسپانیایی
Section titled “ترجمهٔ انگلیسی به اسپانیایی”ما با یک مجموعه دادهٔ ترجمهٔ انگلیسی به اسپانیایی کار خواهیم کرد. بیایید آن را دانلود کنیم:
import pathlib
zip_path = keras.utils.get_file(    origin=(        "http://storage.googleapis.com/download.tensorflow.org/data/spa-eng.zip"    ),    fname="spa-eng",    extract=True,)text_path = pathlib.Path(zip_path) / "spa-eng" / "spa.txt"
فایل متنی شامل یک مثال در هر سطر است: یک جملهٔ انگلیسی، به دنبال آن یک کاراکتر تب (tab)، و به دنبال آن جملهٔ اسپانیایی متناظر. بیایید این فایل را تجزیه کنیم:
with open(text_path) as f: lines = f.read().split("\n")[:-1]text_pairs = []for line in lines: english, spanish = line.split("\t") spanish = "[start] " + spanish + " [end]" text_pairs.append((english, spanish))جفتهای text_pairs ما شبیه این هستند:
>>> import random>>> random.choice(text_pairs)بیایید آنها را بر هم بزنیم و به مجموعههای معمول آموزش، اعتبارسنجی و آزمون تقسیم کنیم:
import random
random.shuffle(text_pairs)val_samples = int(0.15 * len(text_pairs))train_samples = len(text_pairs) - 2 * val_samplestrain_pairs = text_pairs[:train_samples]val_pairs = text_pairs[train_samples : train_samples + val_samples]test_pairs = text_pairs[train_samples + val_samples :]
سپس، بیایید دو لایهٔ TextVectorization جداگانه آماده کنیم: یکی برای انگلیسی و دیگری برای اسپانیایی. ما باید نحوهٔ پیشپردازش رشتهها را سفارشیسازی کنیم:
- ما باید توکنهای
"[start]"و"[end]"را که وارد کردهایم حفظ کنیم. به طور پیشفرض، کاراکترهای[و]حذف میشوند، اما ما میخواهیم آنها را نگه داریم تا بتوانیم کلمهٔ"start"را از توکن شروع"[start]"متمایز کنیم. - علائم نگارشی از زبانی به زبان دیگر متفاوت است! در لایهٔ
TextVectorizationزبان اسپانیایی، اگر قرار است کاراکترهای نشانهگذاری را حذف کنیم، باید کاراکتر¿را نیز حذف نماییم.
توجه داشته باشید که برای یک مدل ترجمهٔ غیر اسباببازی، ما با کاراکترهای نشانهگذاری به عنوان توکنهای جداگانه رفتار میکنیم تا اینکه آنها را حذف کنیم، زیرا میخواهیم بتوانیم جملاتی با نشانهگذاری صحیح تولید کنیم. در مورد ما، برای سادگی، از شر تمام علائم نگارشی خلاص میشویم.
فهرست ۱۵.۹: یادگیری واژگانهای توکن برای متن انگلیسی و اسپانیایی
import stringimport re
strip_chars = string.punctuation + "¿"strip_chars = strip_chars.replace("[", "")strip_chars = strip_chars.replace("]", "")
def custom_standardization(input_string):    lowercase = tf.strings.lower(input_string)    return tf.strings.regex_replace(        lowercase, f"[{re.escape(strip_chars)}]", ""    )
vocab_size = 15000sequence_length = 20
english_tokenizer = layers.TextVectorization(    max_tokens=vocab_size,    output_mode="int",    output_sequence_length=sequence_length,)spanish_tokenizer = layers.TextVectorization(    max_tokens=vocab_size,    output_mode="int",    output_sequence_length=sequence_length + 1,    standardize=custom_standardization,)train_english_texts = [pair[0] for pair in train_pairs]train_spanish_texts = [pair[1] for pair in train_pairs]english_tokenizer.adapt(train_english_texts)spanish_tokenizer.adapt(train_spanish_texts)
در نهایت، میتوانیم دادههای خود را به یک خط لولهٔ tf.data تبدیل کنیم. ما میخواهیم یک چندتایی (inputs, target, sample_weights) برگرداند که در آن inputs یک دیکشنری با دو کلید است: "english" (جملهٔ انگلیسی توکنسازیشده) و "spanish" (جملهٔ اسپانیایی توکنسازیشده)، و target جملهٔ اسپانیایی است که یک گام به جلو منتقل شده است. متغیر sample_weights در اینجا برای گفتن به کراس استفاده میشود که هنگام محاسبهٔ زیان و معیارهای ما از کدام برچسبها استفاده کند. خروجیهای ترجمهٔ ما همگی از نظر طول برابر نیستند، و برخی از دنبالههای برچسب ما با صفرها حاشیهگذاری خواهند شد. ما فقط به پیشبینیها برای برچسبهای غیر صفر که نشاندهندهٔ متن ترجمهشدهٔ واقعی هستند اهمیت میدهیم.
این با برچسبهای «یک گام جابهجا» در مدل تولیدی که به تازگی ساختیم مطابقت دارد، همراه با اضافه شدن ورودیهای ثابت رمزگذار که در مدل ما به طور جداگانه مدیریت خواهند شد.
فهرست ۱۵.۱۰: توکنسازی و آمادهسازی دادههای ترجمه
batch_size = 64
def format_dataset(eng, spa):    eng = english_tokenizer(eng)    spa = spanish_tokenizer(spa)    features = {"english": eng, "spanish": spa[:, :-1]}    labels = spa[:, 1:]    sample_weights = labels != 0    return features, labels, sample_weights
def make_dataset(pairs):    eng_texts, spa_texts = zip(*pairs)    eng_texts = list(eng_texts)    spa_texts = list(spa_texts)    dataset = tf.data.Dataset.from_tensor_slices((eng_texts, spa_texts))    dataset = dataset.batch(batch_size)    dataset = dataset.map(format_dataset, num_parallel_calls=4)    return dataset.shuffle(2048).cache()
train_ds = make_dataset(train_pairs)val_ds = make_dataset(val_pairs)
این چیزی است که خروجیهای مجموعه دادهٔ ما شبیه آن هستند:
>>> inputs, targets, sample_weights = next(iter(train_ds))>>> print(inputs["english"].shape)دادهها اکنون آماده هستند — زمان ساخت چند مدل است.
یادگیری دنبالهبهدنباله با RNNها
Section titled “یادگیری دنبالهبهدنباله با RNNها”قبل از اینکه ساختار دوقلوی رمزگذار/رمزگشا را که قبلاً به آن اشاره کردیم امتحان کنیم، بیایید گزینههای سادهتر را بررسی نماییم. سادهترین و سادهلوحانهترین راه برای استفاده از RNNها جهت تبدیل یک دنباله به دنبالهٔ دیگر این است که خروجی RNN را در هر گام زمانی نگه داریم و یک توکن خروجی را از آن پیشبینی کنیم. در کراس، شبیه این خواهد بود:
inputs = keras.Input(shape=(sequence_length,), dtype="int32")x = layers.Embedding(input_dim=vocab_size, output_dim=128)(inputs)x = layers.LSTM(32, return_sequences=True)(x)outputs = layers.Dense(vocab_size, activation="softmax")(x)model = keras.Model(inputs, outputs)با این حال، یک مشکل حیاتی در این رویکرد وجود دارد. به دلیل ماهیت گامبهگام RNNها، مدل فقط به توکنهای 0...N در دنبالهٔ مبدأ نگاه میکند تا توکن N را در دنبالهٔ هدف پیشبینی کند. ترجمهٔ جملهٔ «I will bring the bag to you» را در نظر بگیرید. در اسپانیایی، این میشود «Te traeré la bolsa»، جایی که «Te»، اولین کلمه از ترجمه، متناظر با «you» در متن مبدأ انگلیسی است. هیچ راهی برای خروجی دادن اولین کلمهٔ ترجمه بدون دیدن آخرین کلمهٔ متن انگلیسی مبدأ وجود ندارد!
اگر شما یک مترجم انسانی باشید، قبل از شروع به ترجمه، ابتدا کل جملهٔ مبدأ را میخوانید. این به ویژه اگر با زبانهایی با ترتیب کلمات به شدت متفاوت سروکار دارید، بسیار مهم است. و این دقیقاً همان کاری است که مدلهای استاندارد دنبالهبهدنباله انجام میدهند. در یک ساختار مناسب دنبالهبهدنباله (شکل ۱۵.۲ را ببینید)، ابتدا از یک RNN رمزگذار برای تبدیل کل دنبالهٔ مبدأ به یک نمایش واحد از متن مبدأ استفاده میکنید. این میتواند آخرین خروجی RNN یا، به عنوان گزینهای دیگر، بردارهای وضعیت داخلی نهایی آن باشد. ما میتوانیم به جای یک وضعیت اولیه از صفرها که در مولد شکسپیر خود استفاده کردیم، از این نمایش به عنوان وضعیت اولیهٔ یک RNN رمزگشا در ساختار مدل زبان استفاده کنیم. این رمزگشا یاد میگیرد که کلمهٔ بعدی ترجمهٔ اسپانیایی را با داشتن کلمهٔ فعلی ترجمه پیشبینی کند، در حالی که تمام اطلاعات مربوط به دنبالهٔ انگلیسی از آن وضعیت اولیهٔ RNN میآید.
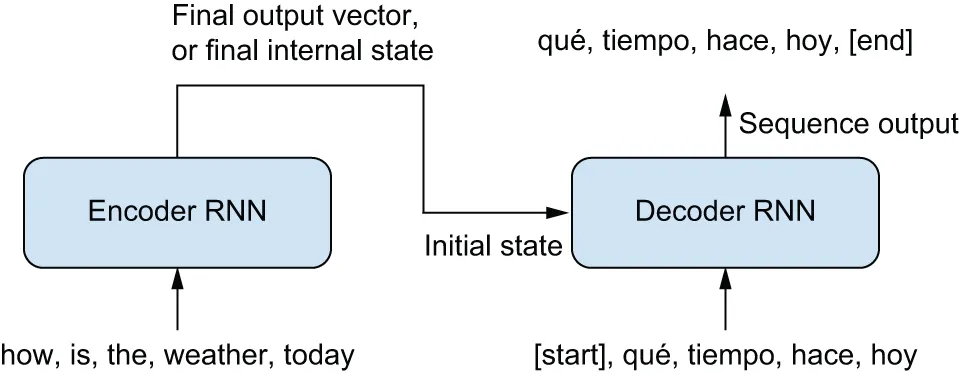
شکل ۱۵.۲: یک RNN دنبالهبهدنباله: یک رمزگذار RNN برای تولید برداری که کل دنبالهٔ مبدأ را کدگذاری میکند استفاده میشود، که به عنوان وضعیت اولیه برای یک رمزگشا RNN به کار میرود.
بیایید این را در کراس، با رمزگذارها و رمزگشاهای مبتنی بر GRU پیادهسازی کنیم. میتوانیم فقط با رمزگذار شروع کنیم. از آنجا که ما در واقع قرار نیست توکنها را در دنبالهٔ رمزگذار پیشبینی کنیم، نیازی نیست نگران «تقلب» با اجازه دادن به مدل برای انتقال اطلاعات از انتهای دنباله به موقعیتهای ابتدایی باشیم. در واقع، این ایدهٔ خوبی است، زیرا ما نمایشی غنی از دنبالهٔ مبدأ میخواهیم. ما میتوانیم با یک لایهٔ Bidirectional به این هدف دست یابیم.
فهرست ۱۵.۱۱: ساخت یک رمزگذار دنبالهبهدنباله
embed_dim = 256hidden_dim = 1024
source = keras.Input(shape=(None,), dtype="int32", name="english")x = layers.Embedding(vocab_size, embed_dim, mask_zero=True)(source)rnn_layer = layers.GRU(hidden_dim)rnn_layer = layers.Bidirectional(rnn_layer, merge_mode="sum")encoder_output = rnn_layer(x)
سپس، بیایید رمزگشا را اضافه کنیم — یک لایهٔ سادهٔ GRU که جملهٔ مبدأ کدگذاریشده را به عنوان وضعیت اولیهٔ خود دریافت میکند. روی آن، یک لایهٔ Dense اضافه میکنیم که یک توزیع احتمال را روی واژگان اسپانیایی برای هر گام خروجی تولید مینماید. در اینجا، ما میخواهیم توکنهای بعدی را فقط بر اساس آنچه قبلاً آمده است پیشبینی کنیم، بنابراین یک RNN از نوع Bidirectional با بسیار ساده کردن تابع زیان، آموزش را مختل میکند.
فهرست ۱۵.۱۲: ساخت یک رمزگشا دنبالهبهدنباله
target = keras.Input(shape=(None,), dtype="int32", name="spanish")x = layers.Embedding(vocab_size, embed_dim, mask_zero=True)(target)rnn_layer = layers.GRU(hidden_dim, return_sequences=True)x = rnn_layer(x, initial_state=encoder_output)x = layers.Dropout(0.5)(x)# Predicts the next word of the translation, given the current wordtarget_predictions = layers.Dense(vocab_size, activation="softmax")(x)seq2seq_rnn = keras.Model([source, target], target_predictions)بیایید به مدل seq2seq به طور کامل نگاهی بیندازیم:
>>> seq2seq_rnn.summary()مدل و دادههای ما هر دو آماده هستند. اکنون میتوانیم آموزش مدل ترجمهٔ خود را آغاز کنیم:
seq2seq_rnn.compile( optimizer="adam", loss="sparse_categorical_crossentropy", weighted_metrics=["accuracy"],)seq2seq_rnn.fit(train_ds, epochs=15, validation_data=val_ds)ما دقت را به عنوان یک روش ابتدایی برای نظارت بر عملکرد مجموعهٔ اعتبارسنجی در طول آموزش انتخاب کردیم. ما به ۶۵٪ دقت میرسیم: به طور متوسط، مدل کلمهٔ بعدی در جملهٔ اسپانیایی را در ۶۵٪ مواقع به درستی پیشبینی میکند. با این حال، در عمل، دقت توکن بعدی معیار چندان مناسبی برای مدلهای ترجمهٔ ماشینی نیست، به ویژه به این دلیل که این فرض را مطرح میکند که توکنهای هدف صحیح از 0 تا N هنگام پیشبینی توکن N + 1 از قبل شناخته شدهاند. در واقعیت، در طول استنتاج، شما جملهٔ هدف را از ابتدا تولید میکنید و نمیتوانید به اینکه توکنهای قبلاً تولیدشده ۱۰۰٪ صحیح باشند تکیه کنید. هنگام کار بر روی یک سیستم ترجمهٔ ماشینی در دنیای واقعی، معیارها باید با دقت بیشتری طراحی شوند. معیارهای استانداردی مانند امتیاز BLEU وجود دارند که شباهت متن ترجمهشده توسط ماشین را با مجموعهای از ترجمههای مرجع با کیفیت بالا اندازهگیری میکنند و میتوانند دنبالههایی با ناهمترازی جزئی را تحمل نمایند.
سرانجام، بیایید از مدل خود برای استنتاج استفاده کنیم. چند جمله را در مجموعهٔ آزمون انتخاب میکنیم و نحوهٔ ترجمهٔ آنها توسط مدلمان را بررسی مینماییم. ما از توکن بذر "[start]" شروع میکنیم و آن را همراه با جملهٔ مبدأ انگلیسی کدگذاریشده به مدل رمزگشا تغذیه میکنیم. ما یک پیشبینی توکن بعدی را بازیابی میکنیم و آن را به طور مکرر به رمزگشا تزریق مینماییم، و در هر تکرار یک توکن هدف جدید نمونهبرداری میکنیم تا زمانی که به "[end]" برسیم یا به حداکثر طول جمله برسیم.
فهرست ۱۵.۱۳: تولید ترجمهها با یک RNN دنبالهبهدنباله
import numpy as np
spa_vocab = spanish_tokenizer.get_vocabulary()spa_index_lookup = dict(zip(range(len(spa_vocab)), spa_vocab))
def generate_translation(input_sentence):    tokenized_input_sentence = english_tokenizer([input_sentence])    decoded_sentence = "[start]"    for i in range(sequence_length):        tokenized_target_sentence = spanish_tokenizer([decoded_sentence])        inputs = [tokenized_input_sentence, tokenized_target_sentence]        next_token_predictions = seq2seq_rnn.predict(inputs, verbose=0)        sampled_token_index = np.argmax(next_token_predictions[0, i, :])        sampled_token = spa_index_lookup[sampled_token_index]        decoded_sentence += " " + sampled_token        if sampled_token == "[end]":            break    return decoded_sentence
test_eng_texts = [pair[0] for pair in test_pairs]for _ in range(5): input_sentence = random.choice(test_eng_texts) print("-") print(input_sentence) print(generate_translation(input_sentence))ترجمههای دقیق از اجرایی به اجرای دیگر متفاوت خواهند بود، زیرا وزنهای نهایی مدل به مقداردهیهای تصادفی اولیهٔ وزنهای ما و بر هم زدن تصادفی دادههای ورودی ما بستگی دارند. این چیزی است که ما به دست آوردیم:
-You know that.[start] tú lo sabes [end]-"Thanks." "You're welcome."[start] gracias tú [UNK] [end]-The prisoner was set free yesterday.[start] el plan fue ayer a un atasco [end]-I will tell you tomorrow.[start] te lo voy mañana a decir [end]-I think they're happy.[start] yo creo que son felices [end]مدل ما برای یک مدل اسباببازی به خوبی کار میکند، اگرچه هنوز اشتباهات ابتدایی زیادی مرتکب میشود.
توجه داشته باشید که این ساختار استنتاج، در عین حال که بسیار ساده است، ناکارآمد است، زیرا ما هر بار که کلمهٔ جدیدی را نمونهبرداری میکنیم، کل جملهٔ مبدأ و کل جملهٔ هدف تولیدشده را دوباره پردازش میکنیم. در یک کاربرد عملی، باید مراقب باشید که وضعیتی را که تغییر نکرده است دوباره محاسبه نکنید. تمام آنچه واقعاً برای پیشبینی یک توکن جدید در رمزگشا نیاز داریم توکن فعلی و وضعیت قبلی RNN است، که میتوانیم قبل از هر تکرار حلقه آن را کش کنیم.
راههای زیادی برای بهبود این مدل اسباببازی وجود دارد. میتوانیم از پشتهای عمیق از لایههای بازگشتی هم برای رمزگذار و هم برای رمزگشا استفاده کنیم، میتوانیم لایههای RNN دیگری مانند LSTM را امتحان کنیم، و مواردی از این دست. با این حال، فراتر از چنین تغییراتی، رویکرد RNN به یادگیری دنبالهبهدنباله دارای چند محدودیت اساسی است:
- نمایش دنبالهٔ مبدأ باید به طور کامل در بردار وضعیت رمزگذار نگه داشته شود، که این امر اندازه و پیچیدگی جملاتی را که میتوانید ترجمه کنید به طور قابل توجهی محدود مینماید.
- RNNها در مواجهه با دنبالههای بسیار طولانی دچار مشکل میشوند زیرا تمایل دارند به تدریج گذشته را فراموش کنند — تا زمانی که به صدمین توکن در هر دنباله برسید، اطلاعات کمی در مورد شروع دنباله باقی میماند.
شبکههای عصبی بازگشتی در اواسط دههٔ ۲۰۱۰ بر یادگیری دنبالهبهدنباله تسلط داشتند. گوگل ترنسلیت در حدود سال ۲۰۱۷ توسط پشتهای از هفت لایهٔ بزرگ LSTM در ساختاری مشابه آنچه به تازگی ایجاد کردیم قدرت میگرفت. با این حال، این محدودیتهای RNNها در نهایت منجر به توسعهٔ سبک جدیدی از مدل دنبالهای توسط پژوهشگران شد که ترنسفورمر (Transformer) نام دارد.
معماری ترنسفورمر
Section titled “معماری ترنسفورمر”در سال ۲۰۱۷، واسوانی و همکاران معماری ترنسفورمر (Transformer) را در مقالهٔ بنیادین «Attention Is All You Need» معرفی کردند.1 نویسندگان در حال کار بر روی سیستمهای ترجمهای مانند سیستمی بودند که ما به تازگی ساختیم، و کشف حیاتی درست در عنوان مقاله قرار دارد. همانطور که معلوم شد، یک مکانیزم ساده به نام توجه (attention) میتواند برای ساخت مدلهای دنبالهای قدرتمندی استفاده شود که اصلاً شامل هیچ لایهٔ بازگشتی نیستند. ایدهٔ توجه جدید نبود و در هنگام انتشار آن مقاله، دو سالی بود که در سیستمهای NLP استفاده میشد. اما این ایده که توجه به قدری مفید است که میتواند تنها مکانیزم مورد استفاده برای انتقال اطلاعات در سرتاسر یک دنباله باشد، در آن زمان کاملاً شگفتآور بود.
این یافته چیزی کمتر از یک انقلاب در پردازش زبان طبیعی — و فراتر از آن — ایجاد نکرد. توجه به سرعت به یکی از تأثیرگذارترین ایدهها در یادگیری عمیق تبدیل شده است. در این بخش، توضیحی عمیق در مورد نحوهٔ کارکرد آن و چرایی اثبات اثربخشی فوقالعادهاش برای مدلسازی دنباله دریافت خواهید کرد. سپس از توجه برای بازسازی مدل ترجمهٔ انگلیسی به اسپانیایی خود استفاده خواهیم کرد.
بنابراین، با تمام این مقدمهچینیها، توجه دقیقاً چیست؟ و چگونه جایگزینی برای شبکههای عصبی بازگشتی که تاکنون استفاده کردهایم ارائه میدهد؟
توجه در واقع به عنوان راهی برای تقویت یک مدل RNN مانند مدلی که به تازگی ساختیم توسعه داده شد. پژوهشگران متوجه شدند که با اینکه RNNها در مدلسازی وابستگیها در یک همسایگی محلی سرآمد هستند، با طولانیتر شدن دنبالهها در یادآوری دچار مشکل میشوند. فرض کنید در حال ساخت سیستمی برای پاسخ به سوالات دربارهٔ یک سند مبدأ هستید. اگر طول سند بیش از حد زیاد شود، نتایج RNN کاملاً بد میشود و فاصلهٔ زیادی با عملکرد انسانی پیدا میکند.
به عنوان یک آزمایش فکری، تصور کنید از این کتاب برای ساخت یک مدل پیشبینی آبوهوا استفاده میکنید. اگر زمان کافی داشتید، ممکن بود کل کتاب را از ابتدا تا انتها بخوانید، اما وقتی واقعاً مدل خود را پیادهسازی میکردید، توجه ویژهای صرفاً به فصلهای سریهای زمانی معطوف میکردید. حتی در داخل یک فصل، ممکن است نمونه کدها و توضیحات خاصی را بیابید که اغلب به آنها رجوع میکنید. از سوی دیگر، در حین کار بر روی کد خود، نگرانی خاصی در مورد جزئیات پیچشهای تصویر نخواهید داشت. تعداد کل کلمات این کتاب به خوبی بیش از ۱۰۰,۰۰۰ کلمه است، بسیار فراتر از هر طول دنبالهای که با آن دستوپنجه نرم کردهایم، اما انسانها میتوانند در نحوهٔ استخراج اطلاعات از متن گزینشی و زمینهمحور عمل کنند.
از سوی دیگر، RNNها فاقد هرگونه مکانیزمی برای ارجاع مستقیم به بخش قبلی یک دنباله هستند. بر اساس طراحی، تمام اطلاعات باید از طریق وضعیت داخلی یک سلول RNN در یک حلقه، از طریق تکتک موقعیتها در یک دنباله منتقل شوند. این کمی شبیه به تمام کردن این کتاب، بستن آن و تلاش برای پیادهسازی آن مدل پیشبینی آبوهوا کاملاً از روی حافظه است. ایده در توجه، ساخت مکانیزمی است که به وسیلهٔ آن یک شبکهٔ عصبی بتواند بسته به ورودی فعلی که در حال پردازش است، به طور زمینهمحور به برخی از بخشهای یک دنباله وزن بیشتری و به سایر بخشها وزن کمتری اختصاص دهد (شکل ۱۵.۳).
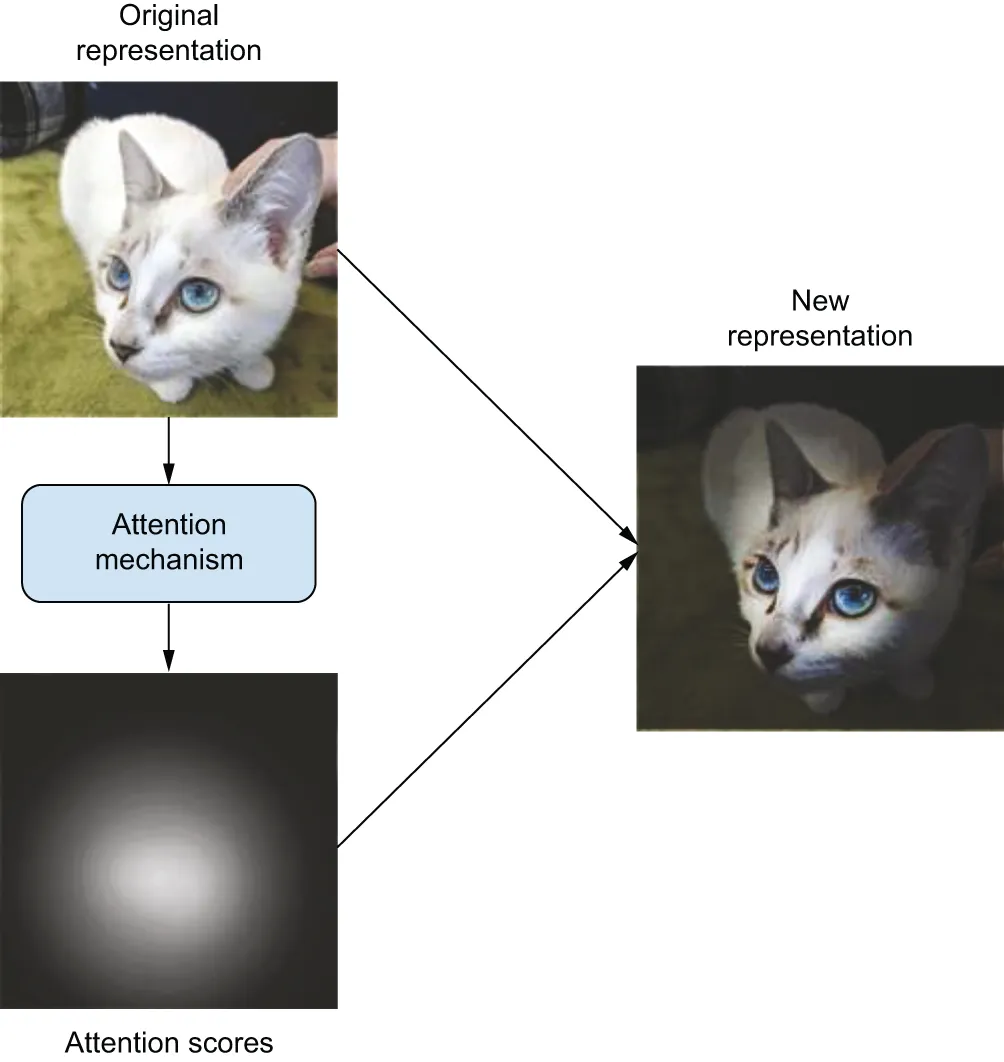
شکل ۱۵.۳: مفهوم کلی توجه در یادگیری عمیق: به ویژگیهای ورودی امتیازهای توجه اختصاص داده میشود، که میتوان از آنها برای اطلاعرسانی به نمایش بعدی ورودی استفاده کرد.
توجه ضرب داخلی
Section titled “توجه ضرب داخلی”بیایید به RNN ترجمهٔ خود بازگردیم و مفهوم توجه گزینشی را به آن اضافه کنیم. پیشبینی فقط یک توکن منفرد را در نظر بگیرید. پس از عبور دادن دنبالههای source و target از میان لایههای GRU، برداری خواهیم داشت که نشاندهندهٔ توکن هدفی است که در شرف پیشبینی آن هستیم و دنبالهای از بردارها که نشاندهندهٔ هر کلمه در متن مبدأ است.
با توجه، هدف ما این است که به مدل راهی برای امتیازدهی به تکتک بردارهای موجود در دنبالهٔ مبدأ بر اساس ارتباط آن با کلمهٔ فعلی که در تلاش برای پیشبینی آن هستیم، بدهیم (شکل ۱۵.۴). اگر نمایش برداری یک توکن مبدأ امتیاز بالایی داشته باشد، آن را به طور ویژه مهم در نظر میگیریم؛ در غیر این صورت، کمتر به آن اهمیت میدهیم. در حال حاضر، فرض کنیم این تابع score(target_vector, source_vector) را در اختیار داریم.
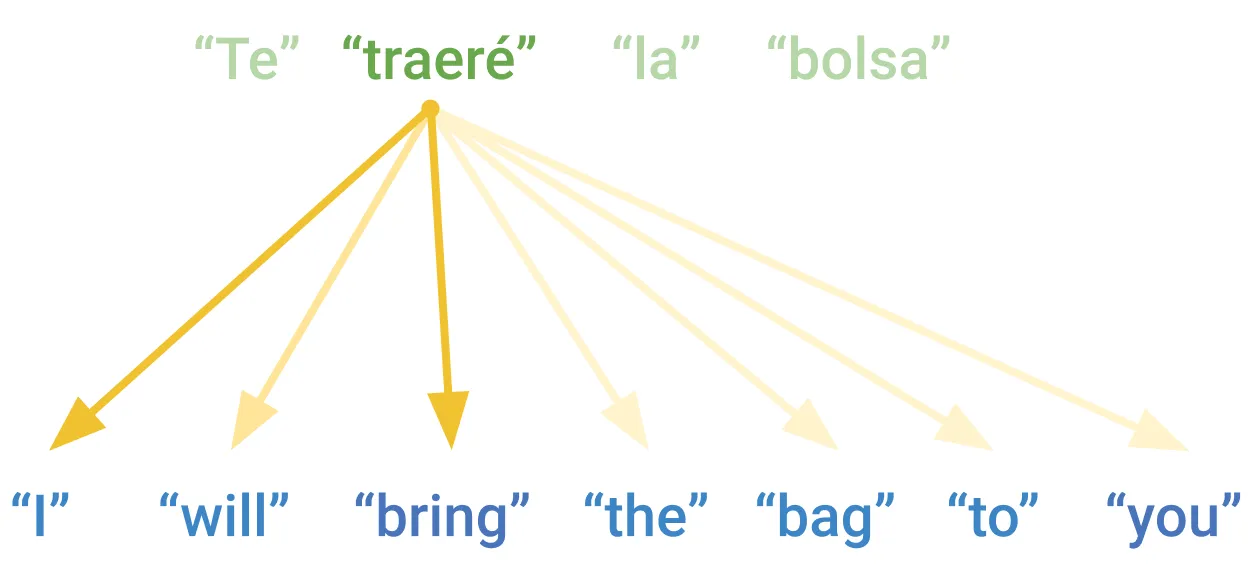
شکل ۱۵.۴: توجه یک امتیاز ارتباط را به هر بردار در یک مبدأ برای هر بردار در یک دنبالهٔ هدف اختصاص میدهد.
برای اینکه توجه به خوبی کار کند، میخواهیم از انتقال اطلاعات مربوط به توکنهای مهم از طریق حلقهای که به اندازهٔ مجموع طول دنبالهٔ مبدأ و هدف ما طولانی است، اجتناب کنیم — این همان جایی است که RNNها شروع به شکست میکنند. یک راه ساده برای انجام این کار این است که مجموع وزنداری از تمام بردارهای مبدأ بر اساس این امتیازی که محاسبه خواهیم کرد بگیریم. همچنین مناسب خواهد بود اگر مجموع تمام امتیازهای توجه برای یک هدف معین برابر با ۱ باشد، زیرا این به مجموع وزندار ما بزرگی قابل پیشبینی میدهد. میتوانیم با عبور دادن امتیازها از یک تابع softmax به این هدف برسیم — چیزی شبیه به این، در شبهکد NumPy:
scores = [score(target, source) for source in sources]scores = softmax(scores)combined = np.sum(scores * sources)اما چگونه باید این امتیاز ارتباط را محاسبه کنیم؟ هنگامی که پژوهشگران برای اولین بار با توجه کار کردند، این سوال موضوع بزرگی برای بررسی بود. معلوم میشود که یکی از سرراستترین رویکردها بهترین است. ما میتوانیم از ضرب داخلی (dot-product) به عنوان مقیاس سادهای از فاصله بین بردارهای هدف و مبدأ استفاده کنیم. اگر بردارهای مبدأ و هدف به یکدیگر نزدیک باشند، فرض میکنیم این به معنای مرتبط بودن توکن مبدأ با پیشبینی ما است. در انتهای این فصل، بررسی خواهیم کرد که چرا این فرض از نظر شهودی منطقی است.
بیایید شبهکد خود را بهروز کنیم. میتوانیم قطعهکد خود را با مدیریت کل دنبالهٔ هدف به صورت یکباره کاملتر کنیم — این معادل اجرای قطعهکد قبلی ما در یک حلقه برای هر توکن در دنبالهٔ هدف خواهد بود. هنگامی که هر دو target و source دنباله باشند، امتیازهای توجه یک ماتریس خواهند بود. هر سطر نشان میدهد که یک کلمهٔ هدف چقدر برای یک کلمهٔ مبدأ در مجموع وزندار ارزش قائل است (شکل ۱۵.۵ را ببینید). ما از نمادگذاری Einsum به عنوان روشی مناسب برای نوشتن ضرب داخلی و مجموع وزندار استفاده خواهیم کرد:
def dot_product_attention(target, source):    # Takes the dot-product between all target and source vectors,    # where b = batch size, t = target length, s = source length, and d    # = vector size    scores = np.einsum("btd,bsd->bts", target, source)    scores = softmax(scores, axis=-1)    # Computes a weighted sum of all source vectors for each target    # vector    return np.einsum("bts,bsd->btd", scores, source)
dot_product_attention(target, source)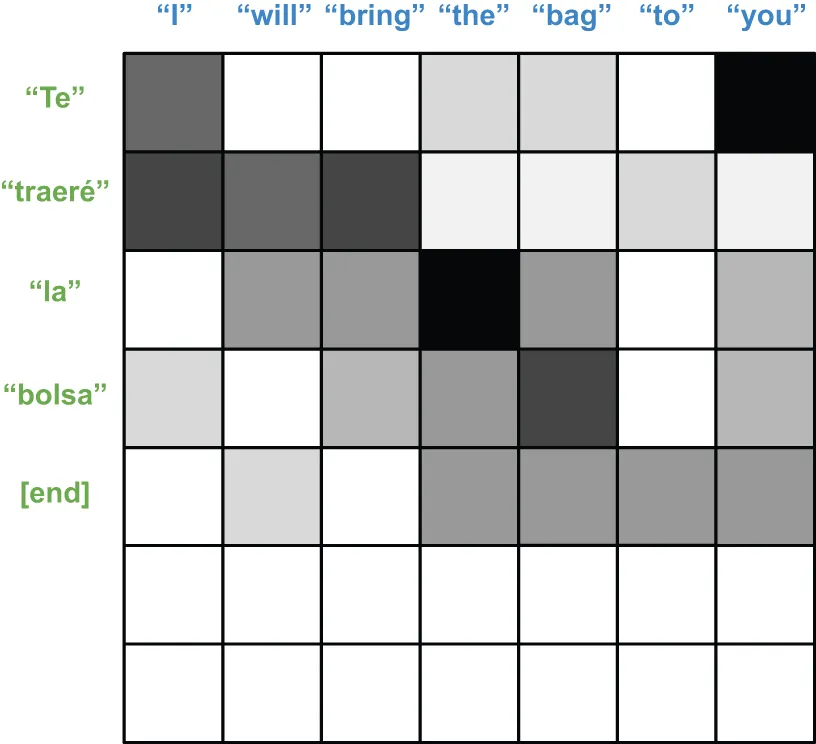
شکل ۱۵.۵: هنگامی که هم هدف و هم مبدأ دنباله هستند، امتیازهای توجه یک ماتریس دوبعدی هستند. هر سطر امتیازهای توجه را برای کلمهای که سعی در پیشبینی آن داریم (به رنگ سبز) نشان میدهد.
اگر به مدل پارامترهایی برای کنترل امتیاز توجه بدهیم، میتوانیم فضای فرضیه (hypothesis space) این مکانیزم توجه را بسیار غنیتر کنیم. اگر هر دو بردار مبدأ و هدف را با لایههای Dense تصویر کنیم، مدل میتواند یک فضای مشترک مناسب پیدا کند که در آن بردارهای مبدأ در صورتی که به کیفیت کلی پیشبینی کمک کنند، به بردارهای هدف نزدیک باشند. به طور مشابه، باید به مدل اجازه دهیم بردارهای مبدأ را قبل از ترکیب شدن در یک فضای کاملاً جداگانه و یک بار دیگر پس از جمعبندی تصویر کند.
ما همچنین میتوانیم نامگذاری کمی متفاوتی را برای ورودیها اتخاذ کنیم که در این حوزه استاندارد شده است. آنچه به تازگی نوشتیم تقریباً به صورت sum(score(target, source) * source) خلاصه میشود. ما این را به طور معادل با نامهای ورودی متفاوت به صورت sum(score(query, key) * value) خواهیم نوشت. این نسخهٔ سه آرگومانی عمومیتر است — در موارد نادر، ممکن است نخواهید از همان برداری برای امتیازدهی به ورودیهای مبدأ خود استفاده کنید که برای جمعبندی ورودیهای مبدأ خود به کار میگیرید.
این اصطلاحات از موتورهای جستجو و سیستمهای توصیهگر میآیند. یک ابزار جستجو را برای جستجوی عکسها در یک پایگاه داده تصور کنید — «پرسوجو (query)» عبارت جستجوی شماست، «کلیدها (keys)» برچسبهای عکسی هستند که برای تطبیق با پرسوجو استفاده میکنید، و در نهایت، «مقادیر (values)» خود عکسها هستند (شکل ۱۵.۶). مکانیزم توجهی که ما در حال ساخت آن هستیم تقریباً شبیه به این نوع جستجو است.
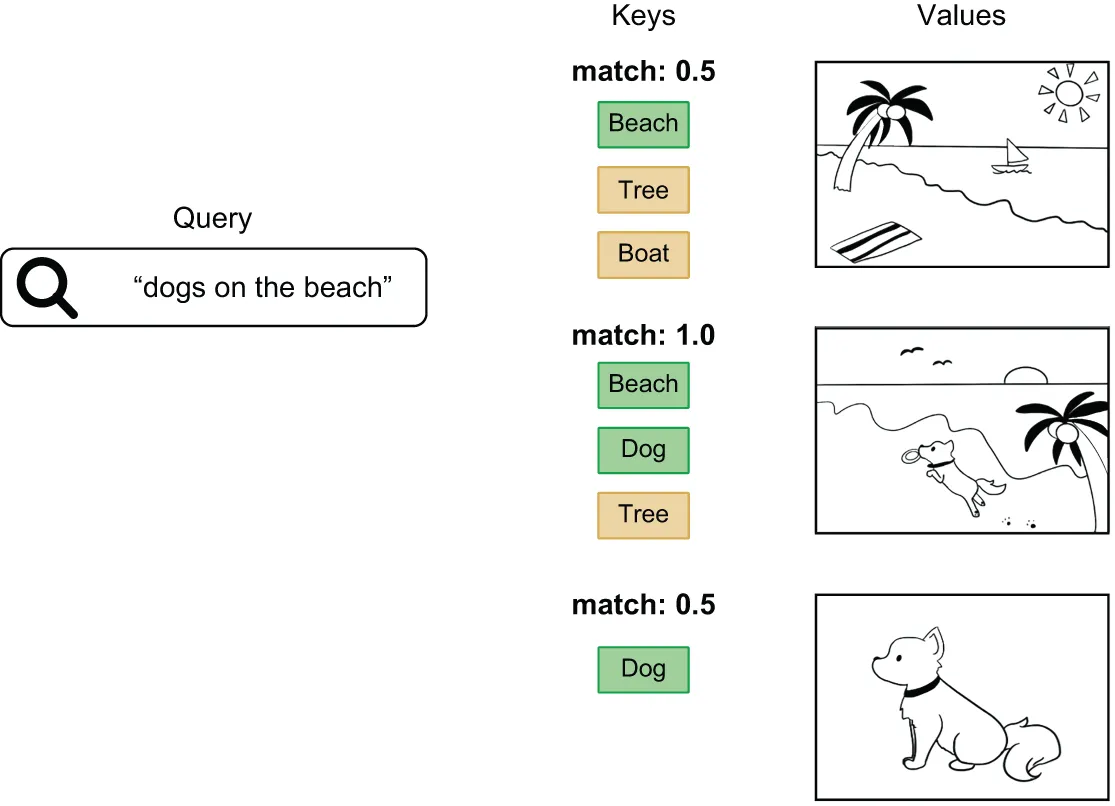
شکل ۱۵.۶: بازیابی تصاویر از یک پایگاه داده: پرسوجو (query) با مجموعهای از کلیدها (keys) مقایسه میشود، و امتیازهای مطابقت برای رتبهبندی مقادیر (values) (تصاویر) استفاده میشوند.
بیایید شبهکد خود را بهروز کنیم، به طوری که توجه پارامتریشدهای با استفاده از اصطلاحات جدید خود داشته باشیم:
query_dense = layers.Dense(dim)key_dense = layers.Dense(dim)value_dense = layers.Dense(dim)output_dense = layers.Dense(dim)
def parameterized_attention(query, key, value):    query = query_dense(query)    key = key_dense(key)    value = value_dense(value)    scores = np.einsum("btd,bsd->bts", query, key)    scores = softmax(scores, axis=-1)    outputs = np.einsum("bts,bsd->btd", scores, value)    return output_dense(outputs)
parameterized_attention(query=target, key=source, value=source)
این بلوک یک مکانیزم توجه کاملاً کاربردی است! ما به تازگی تابعی نوشتیم که به مدل اجازه میدهد به طور زمینهمحور و بسته به کلمهٔ هدفی که در حال رمزگشایی آن هستیم، اطلاعات را از هر کجای دنبالهٔ مبدأ استخراج کند.
نویسندگان مقالهٔ «Attention is all you need» از طریق آزمون و خطا دو تغییر دیگر در مکانیزم ما ایجاد کردند. اولین مورد یک ضریب مقیاسبندی ساده است. هنگامی که بردارهای ورودی طولانی میشوند، امتیازهای حاصل از ضرب داخلی میتوانند بسیار بزرگ شوند، که این امر میتواند پایداری گرادیانهای سافتمکس ما را تحت تأثیر قرار دهد. راهحل ساده است: ما میتوانیم امتیازهای سافتمکس خود را کمی کوچکتر کنیم. مقیاسبندی با جذر طول بردار برای هر اندازهٔ برداری به خوبی کار میکند.
مورد دیگر به گویایی و قدرت بیان مکانیزم توجه مربوط میشود. مجموع سافتمکسی که انجام میدهیم قدرتمند است — این به ما اجازه میدهد اتصالی مستقیم بین بخشهای دوردست یک دنباله برقرار کنیم. اما جمعبندی همچنین بیپرده و خشن است: اگر مدل سعی کند همزمان به تعداد زیادی توکن توجه کند، ویژگیهای جالب توکنهای مبدأ منفرد در نمایش ترکیبی «محو» خواهند شد. یک ترفند ساده که به خوبی کار میکند این است که این عملیات توجه را چندین بار برای همان دنباله انجام دهیم، با چندین سر (head) توجه مختلف که همان محاسبات را با پارامترهای متفاوت اجرا میکنند:
query_dense = [layers.Dense(head_dim) for i in range(num_heads)]key_dense = [layers.Dense(head_dim) for i in range(num_heads)]value_dense = [layers.Dense(head_dim) for i in range(num_heads)]output_dense = layers.Dense(head_dim * num_heads)
def multi_head_attention(query, key, value):    head_outputs = []    for i in range(num_heads):        query = query_dense[i](query)        key = key_dense[i](key)        value = value_dense[i](value)        scores = np.einsum("btd,bsd->bts", target, source)        scores = softmax(scores / math.sqrt(head_dim), axis=-1)        head_output = np.einsum("bts,bsd->btd", scores, source)        head_outputs.append(head_output)    outputs = ops.concatenate(head_outputs, axis=-1)    return output_dense(outputs)
multi_head_attention(query=target, key=source, value=source)
با تصویر کردن متفاوت پرسوجو و کلید، یک سر ممکن است یاد بگیرد که با فاعل جملهٔ مبدأ مطابقت داشته باشد، در حالی که سر دیگر ممکن است به علائم نگارشی توجه کند. این توجه چندسر (multi-headed attention) از محدودیت نیاز به ترکیب کل دنبالهٔ مبدأ با یک جمع سافتمکس منفرد جلوگیری میکند (شکل ۱۵.۷).
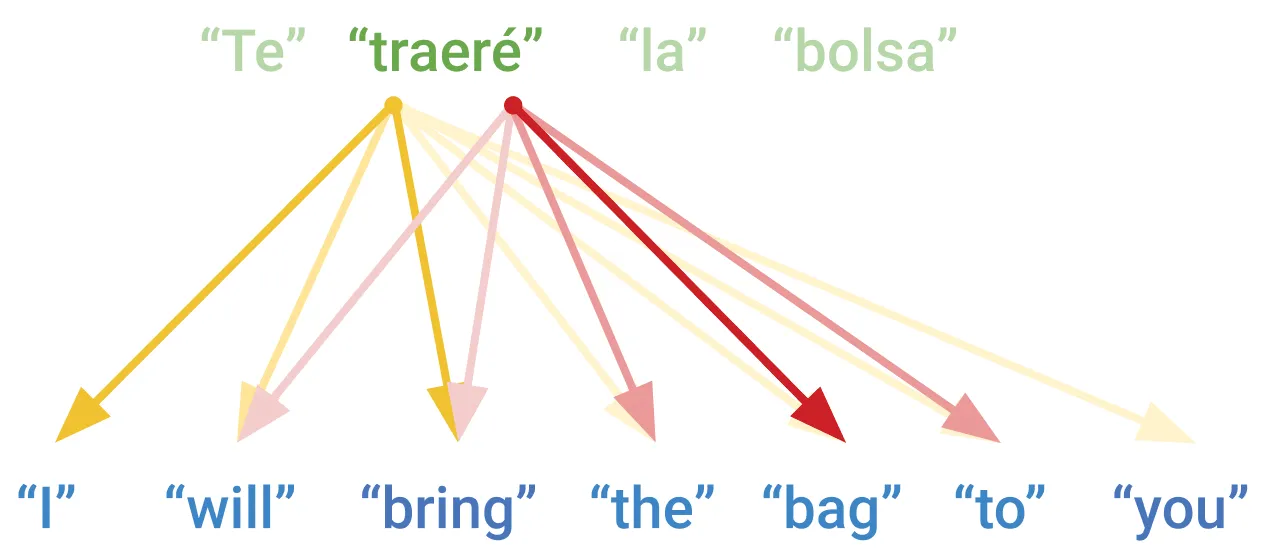
شکل ۱۵.۷: توجه چندسر به هر کلمهٔ هدف اجازه میدهد تا به بخشهای مختلف دنبالهٔ مبدأ در بخشهای جداگانهای از بردار خروجی نهایی توجه کند.
البته در عمل، شما میخواهید این کد را به عنوان یک لایهٔ قابل استفادهٔ مجدد بنویسید. در اینجا کراس هوای شما را دارد. ما میتوانیم کد قبلی خود را با لایهٔ MultiHeadAttention به شرح زیر بازسازی کنیم:
multi_head_attention = keras.layers.MultiHeadAttention( num_heads=num_heads, head_dim=head_dim,)multi_head_attention(query=target, key=source, value=source)بلوک رمزگذار ترنسفورمر
Section titled “بلوک رمزگذار ترنسفورمر”یک راه برای استفاده از لایهٔ MultiHeadAttention افزودن آن به مدل ترجمهٔ RNN موجود ما خواهد بود. ما میتوانیم خروجی دنباله را از رمزگذار و رمزگشای خود به یک لایهٔ توجه ارسال کنیم و از خروجی آن برای بهروزرسانی دنبالهٔ هدف خود قبل از پیشبینی استفاده نماییم. توجه به مدل اجازه میدهد وابستگیهای دوربرد در متن را که لایهٔ GRU با آنها دست به گریبان است مدیریت کند. این کار در واقع تواناییهای یک مدل RNN را بهبود میبخشد و شیوهٔ استفادهٔ اولیه از توجه در اواسط دههٔ ۲۰۱۰ همین بود.
با این حال، نویسندگان «Attention is all you need» متوجه شدند که میتوانید فراتر بروید و از توجه به عنوان یک مکانیزم کلی برای مدیریت تمام دادههای دنبالهای در یک مدل استفاده کنید. اگرچه تاکنون تنها به توجه به عنوان راهی برای مدیریت انتقال اطلاعات بین دو دنباله نگاه کردهایم، شما همچنین میتوانید از توجه به عنوان راهی استفاده کنید که به یک دنباله اجازه میدهد به خودش توجه کند:
multi_head_attention(key=source, value=source, query=source)این کار خودتوجهی (self-attention) نامیده میشود و بسیار قدرتمند است. با خودتوجهی، هر توکن میتواند به تمام توکنهای موجود در دنبالهٔ خود، از جمله خودش، توجه کند و به مدل اجازه دهد نمایشی از کلمه را در زمینهٔ آن یاد بگیرد.
یک جملهٔ مثال را در نظر بگیرید: «قطار سر وقت ایستگاه را ترک کرد.» حالا یک کلمه در جمله را در نظر بگیرید: «ایستگاه». ما دربارهٔ چه نوع ایستگاهی صحبت میکنیم؟ آیا میتواند یک ایستگاه رادیویی باشد؟ شاید ایستگاه فضایی بینالمللی؟ با خودتوجهی، مدل میتواند یاد بگیرد که امتیاز توجه بالایی به جفت «ایستگاه» و «قطار» اختصاص دهد و بردار مورد استفاده برای نمایش «قطار» را در نمایش کلمهٔ «ایستگاه» جمع کند.
خودتوجهی به مدل راهی مؤثر میدهد تا از نمایش یک کلمه در خلأ به نمایش کلمهای مشروط به تمام توکنهای دیگری که در دنباله ظاهر میشوند برود. این بسیار شبیه به کاری است که قرار است یک RNN انجام دهد. آیا میتوانیم فوراً لایههای RNN خود را با MultiHeadAttention جایگزین کنیم؟
تقریباً! اما نه کاملاً؛ ما هنوز به یک عنصر اساسی برای هر شبکهٔ عصبی عمیق نیاز داریم — یک تابع فعالسازی غیرخطی. لایهٔ MultiHeadAttention نگاشتهای خطی از هر عنصر در یک دنبالهٔ مبدأ را ترکیب میکند، اما فقط همین. به یک معنا، این یک عملیات ادغام (pooling) بسیار گویا است. در حالت حدی، طول توکن برابر با یک را در نظر بگیرید. در این حالت، ماتریس امتیاز توجه همیشه یک عدد ۱ تکی است، و کل لایه به یک نگاشت خطی از دنبالهٔ مبدأ، بدون هیچ غیرخطی بودنی خلاصه میشود. شما میتوانید ۱۰۰ لایهٔ توجه را روی هم بچینید و همچنان بتوانید کل محاسبات را به یک ضرب ماتریسی واحد ساده کنید! این یک مشکل واقعی در قدرت بیان مدل ما است.
در یک نقطهای، تمام سلولهای بازگشتی بردار ورودی برای هر توکن را از یک نگاشت متراکم عبور میدهند و یک تابع فعالسازی را اعمال میکنند؛ ما به برنامهای برای چیزی مشابه نیاز داریم. نویسندگان «Attention is all you need» تصمیم گرفتند این مورد را به سادهترین شکل ممکن بازگردانند — چیدن پشتهای از یک شبکهٔ پیشخور (feedforward) متشکل از دو لایهٔ متراکم (dense) با یک تابع فعالسازی در میانهٔ آنها. توجه، اطلاعات را در سرتاسر دنباله منتقل میکند، و شبکهٔ پیشخور نمایش عناصر منفرد دنباله را بهروز مینماید.
ما آمادهٔ شروع ساخت یک مدل ترنسفورمر هستیم. بیایید با جایگزینی رمزگذار مدل ترجمهٔ خود شروع کنیم. ما از خودتوجهی برای انتقال اطلاعات در امتداد دنبالهٔ مبدأ کلمات انگلیسی استفاده خواهیم کرد. ما همچنین دو موردی را که در فصل ۹ یاد گرفتیم هنگام ساخت ConvNetها اهمیت ویژهای دارند اضافه خواهیم کرد: نرمالسازی (normalization) و اتصالات باقیمانده (residual connections).
فهرست ۱۵.۱۴: یک بلوک رمزگذار ترنسفورمر
class TransformerEncoder(keras.Layer):    def __init__(self, hidden_dim, intermediate_dim, num_heads):        super().__init__()        key_dim = hidden_dim // num_heads        # Self-attention layers        self.self_attention = layers.MultiHeadAttention(num_heads, key_dim)        self.self_attention_layernorm = layers.LayerNormalization()        # Feedforward layers        self.feed_forward_1 = layers.Dense(intermediate_dim, activation="relu")        self.feed_forward_2 = layers.Dense(hidden_dim)        self.feed_forward_layernorm = layers.LayerNormalization()
    def call(self, source, source_mask):        # Self-attention computation        residual = x = source        mask = source_mask[:, None, :]        x = self.self_attention(query=x, key=x, value=x, attention_mask=mask)        x = x + residual        x = self.self_attention_layernorm(x)        # Feedforward computation        residual = x        x = self.feed_forward_1(x)        x = self.feed_forward_2(x)        x = x + residual        x = self.feed_forward_layernorm(x)        return x
توجه خواهید کرد که لایههای نرمالسازی که در اینجا استفاده میکنیم لایههای BatchNormalization مانند آنچه در مدلهای تصویر استفاده کردیم نیستند. دلیل آن این است که BatchNormalization برای دادههای دنبالهای به خوبی کار نمیکند. در عوض، ما از لایهٔ LayerNormalization استفاده میکنیم که هر دنباله را به طور مستقل از سایر دنبالهها در دسته نرمالسازی میکند — مانند این، در شبهکد شبیه به NumPy:
# Input shape: (batch_size, sequence_length, embedding_dim)def layer_normalization(batch_of_sequences): # To compute mean and variance, we only pool data over the last # axis. mean = np.mean(batch_of_sequences, keepdims=True, axis=-1) variance = np.var(batch_of_sequences, keepdims=True, axis=-1) return (batch_of_sequences - mean) / varianceاین را با BatchNormalization (در طول آموزش) مقایسه کنید:
# Input shape: (batch_size, height, width, channels)def batch_normalization(batch_of_images): # Pools data over the batch axis (axis 0), which creates # interactions between samples in a batch mean = np.mean(batch_of_images, keepdims=True, axis=(0, 1, 2)) variance = np.var(batch_of_images, keepdims=True, axis=(0, 1, 2)) return (batch_of_images - mean) / varianceدر حالی که BatchNormalization اطلاعات را از نمونههای زیادی برای به دست آوردن آمارهای دقیق میانگینها و واریانسهای ویژگی جمعآوری میکند، LayerNormalization دادهها را در هر دنباله به طور جداگانه تجمیع مینماید، که برای دادههای دنبالهای مناسبتر است.
ما همچنین یک ورودی جدید به نام attention_mask به لایهٔ MultiHeadAttention ارسال میکنیم. این ورودی تانسور بولی به همان شکل امتیازهای توجه ما (batch_size, target_length, source_length) پخش (broadcast) خواهد شد. هنگامی که تنظیم شود، امتیاز توجه را در مکانهای خاصی صفر میکند و مانع از استفاده از توکنهای مبدأ در این مکانها در محاسبات توجه میشود. ما از این برای جلوگیری از توجه هر توکن در دنباله به توکنهای حاشیهگذاری (padding) که فاقد هرگونه اطلاعاتی هستند استفاده خواهیم کرد. لایهٔ رمزگذار ما ورودی source_mask را دریافت میکند که تمام توکنهای غیر حاشیهگذاری را در ورودیهای ما علامتگذاری مینماید و رتبهٔ آن را به شکل (batch_size, 1, source_length) افزایش میدهد تا به عنوان یک attention_mask استفاده شود.
توجه داشته باشید که ورودی و خروجیهای این لایه شکل یکسانی دارند، بنابراین بلوکهای رمزگذار را میتوان روی هم چید و نمایشی به تدریج گویاتر از جملهٔ انگلیسی ورودی ساخت.
بلوک رمزگشا ترنسفورمر
Section titled “بلوک رمزگشا ترنسفورمر”مرحلهٔ بعدی بلوک رمزگشا است. این لایه تقریباً با بلوک رمزگذار یکسان خواهد بود، با این تفاوت که ما میخواهیم رمزگشا از دنبالهٔ خروجی رمزگذار به عنوان یک ورودی استفاده کند. برای انجام این کار، میتوانیم دو بار از توجه استفاده کنیم. ابتدا یک لایهٔ خودتوجهی مانند رمزگذار خود اعمال میکنیم که به هر موقعیت در دنبالهٔ هدف اجازه میدهد از اطلاعات سایر موقعیتهای هدف استفاده کند. سپس لایهٔ MultiHeadAttention دیگری را اضافه میکنیم که هم دنبالهٔ مبدأ و هم دنبالهٔ هدف را به عنوان ورودی دریافت میکند. ما این لایهٔ توجه را توجه متقاطع (cross-attention) مینامیم زیرا اطلاعات را بین رمزگذار و رمزگشا منتقل میکند.
فهرست ۱۵.۱۵: یک بلوک رمزگشا ترنسفورمر
class TransformerDecoder(keras.Layer):    def __init__(self, hidden_dim, intermediate_dim, num_heads):        super().__init__()        key_dim = hidden_dim // num_heads        # Self-attention layers        self.self_attention = layers.MultiHeadAttention(num_heads, key_dim)        self.self_attention_layernorm = layers.LayerNormalization()        # Cross-attention layers        self.cross_attention = layers.MultiHeadAttention(num_heads, key_dim)        self.cross_attention_layernorm = layers.LayerNormalization()        # Feedforward layers        self.feed_forward_1 = layers.Dense(intermediate_dim, activation="relu")        self.feed_forward_2 = layers.Dense(hidden_dim)        self.feed_forward_layernorm = layers.LayerNormalization()
    def call(self, target, source, source_mask):        # Self-attention computation        residual = x = target        x = self.self_attention(query=x, key=x, value=x, use_causal_mask=True)        x = x + residual        x = self.self_attention_layernorm(x)        # Cross-attention computation        residual = x        mask = source_mask[:, None, :]        x = self.cross_attention(            query=x, key=source, value=source, attention_mask=mask        )        x = x + residual        x = self.cross_attention_layernorm(x)        # Feedforward computation        residual = x        x = self.feed_forward_1(x)        x = self.feed_forward_2(x)        x = x + residual        x = self.feed_forward_layernorm(x)        return x
لایهٔ رمزگشای ما هر دو ورودی target و source را دریافت میکند. مانند TransformerEncoder، ما یک source_mask دریافت میکنیم که مکان تمام حاشیهگذاریها را در ورودی مبدأ علامتگذاری میکند (مقدار True برای توکنهای غیر حاشیهگذاری و False برای حاشیهگذاری) و از آن به عنوان یک attention_mask برای لایهٔ توجه متقاطع استفاده مینماییم.
برای لایهٔ خودتوجهی رمزگشا، به نوع متفاوتی از ماسک توجه نیاز داریم. به یاد بیاورید که وقتی رمزگشای RNN خود را ساختیم، از استفاده از یک RNN از نوع Bidirectional خودداری کردیم. اگر از آن استفاده کرده بودیم، مدل میتوانست با دیدن برچسبی که در تلاش برای پیشبینی آن بود به عنوان یک ویژگی، تقلب کند! توجه ذاباً دوطرفه است؛ در خودتوجهی، هر موقعیت توکن در دنبالهٔ هدف میتواند به هر موقعیت دیگری توجه کند. بدون مراقبت ویژه، مدل ما یاد خواهد گرفت که توکن بعدی در دنباله را به عنوان برچسب فعلی منتقل کند و هیچ توانایی برای تولید ترجمههای جدید نخواهد داشت.
ما میتوانیم با یک ماسک توجه «علیتی (causal)» ویژه به جریان اطلاعات یکطرفه دست یابیم. فرض کنید یک ماسک توجه با یکها در بخش مثلثی پایینی مانند این ارسال میکنیم:
[ [1, 0, 0, 0, 0], [1, 1, 0, 0, 0], [1, 1, 1, 0, 0], [1, 1, 1, 1, 0], [1, 1, 1, 1, 1],]هر سطر i را میتوان به عنوان یک ماسک برای توجه برای توکن هدف در موقعیت i خواند. در سطر اول، اولین توکن فقط میتواند به خودش توجه کند. در سطر دوم، دومین توکن میتواند هم به توکن اول و هم به توکن دوم توجه کند، و به همین ترتیب. این به ما همان تأثیر لایهٔ RNN را میدهد، جایی که اطلاعات فقط میتوانند رو به جلو در دنباله منتشر شوند، نه رو به عقب. در کراس، میتوانید این ماسک مثلثی پایینی را به سادگی با ارسال use_casual_mask به لایهٔ MultiHeadAttention هنگام فراخوانی آن مشخص کنید. شکل ۱۵.۸ یک نمایش بصری از لایهها را در هر دو لایهٔ رمزگذار و رمزگشا، هنگامی که در یک مدل ترنسفورمر پشته میشوند نشان میدهد.
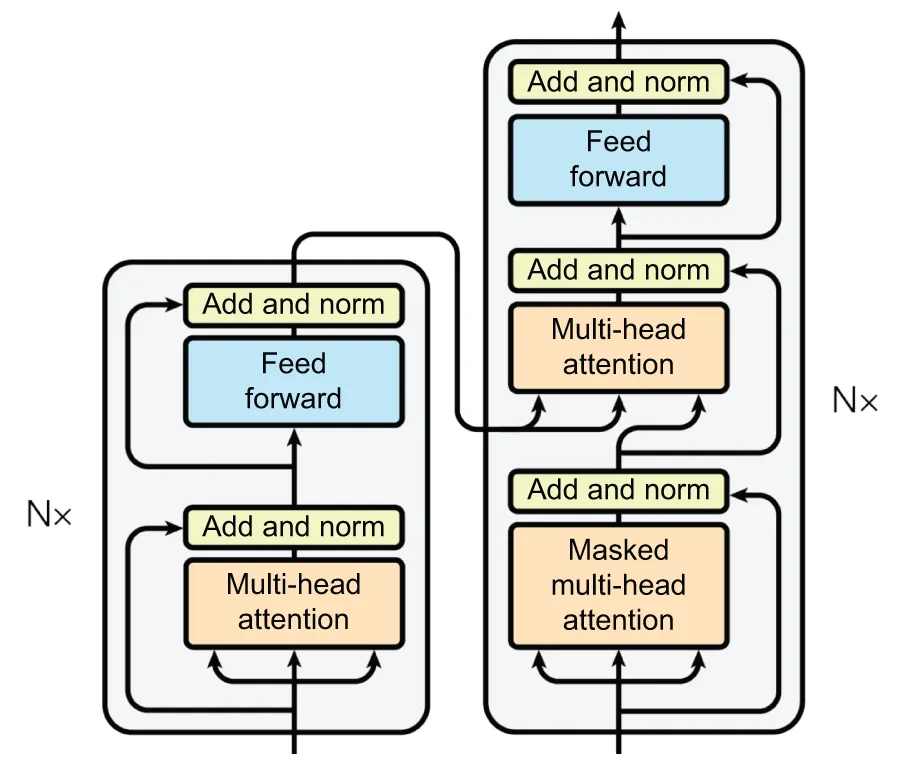
شکل ۱۵.۸: یک نمایش بصری از محاسبات برای هر دو بلوک TransformerEncoder و TransformerDecoder
یادگیری دنبالهبهدنباله با یک ترنسفورمر
Section titled “یادگیری دنبالهبهدنباله با یک ترنسفورمر”بیایید سعی کنیم همهٔ اینها را کنار هم قرار دهیم. ما از همان ساختار پایهای مدل RNN خود استفاده خواهیم کرد و لایههای GRU را با TransformerEncoder و TransformerDecoder خود جایگزین میکنیم. ما در سرتاسر مدل به جز در بلوک پیشخور از 256 به عنوان اندازهٔ جاسازی استفاده خواهیم کرد. در بلوک پیشخور، اندازهٔ جاسازی را قبل از غیرخطی بودن به 2048 افزایش میدهیم و پس از آن به اندازهٔ پنهان مدل بازمیگردانیم. این بعد میانی بزرگ در عمل به خوبی کار میکند.
فهرست ۱۵.۱۶: ساخت یک مدل ترنسفورمر
hidden_dim = 256intermediate_dim = 2048num_heads = 8
source = keras.Input(shape=(None,), dtype="int32", name="english")x = layers.Embedding(vocab_size, hidden_dim)(source)encoder_output = TransformerEncoder(hidden_dim, intermediate_dim, num_heads)(    source=x,    source_mask=source != 0,)
target = keras.Input(shape=(None,), dtype="int32", name="spanish")x = layers.Embedding(vocab_size, hidden_dim)(target)x = TransformerDecoder(hidden_dim, intermediate_dim, num_heads)(    target=x,    source=encoder_output,    source_mask=source != 0,)x = layers.Dropout(0.5)(x)target_predictions = layers.Dense(vocab_size, activation="softmax")(x)transformer = keras.Model([source, target], target_predictions)
بیایید نگاهی به خلاصهٔ مدل ترنسفورمر خود بیندازیم:
>>> transformer.summary()مدل ما تقریباً دقیقاً همان ساختار مدل ترجمهٔ GRU را دارد که قبلاً آموزش دادیم، و توجه اکنون جایگزین لایههای بازگشتی به عنوان مکانیزمی برای انتقال اطلاعات در سرتاسر دنباله شده است. بیایید آموزش مدل را امتحان کنیم:
transformer.compile( optimizer="adam", loss="sparse_categorical_crossentropy", weighted_metrics=["accuracy"],)transformer.fit(train_ds, epochs=15, validation_data=val_ds)پس از آموزش، به حدود ۵۸٪ دقت میرسیم: به طور متوسط، مدل کلمهٔ بعدی در جملهٔ اسپانیایی را در ۵۸٪ مواقع به درستی پیشبینی میکند. چیزی در اینجا درست نیست. آموزش نسبت به مدل RNN به میزان ۷ واحد درصد بدتر است. یا این معماری ترنسفورمر آن چیزی نیست که برایش تبلیغ میشد، یا اینکه ما چیزی را در پیادهسازی خود جا انداختهایم. آیا میتوانید حدس بزنید آن چیست؟
این بخش ظاهراً دربارهٔ مدلهای دنبالهای است. در فصل قبل، دیدیم که ترتیب کلمات چقدر میتواند برای معنا حیاتی باشد. و با این حال، ترنسفورمری که به تازگی ساختیم اصلاً یک مدل دنبالهای نبود. متوجه شدید؟ این مدل از لایههای متراکمی تشکیل شده است که توکنهای دنباله را مستقل از یکدیگر پردازش میکنند و یک لایهٔ توجه که به توکنها به عنوان یک مجموعه نگاه میکند. شما میتوانید ترتیب توکنها را در یک دنباله تغییر دهید، و امتیازهای توجه دوبهدوی یکسان و نمایشهای آگاه از زمینهٔ یکسانی دریافت خواهید کرد. اگر بخواهید تکتک کلمات را در هر جملهٔ مبدأ انگلیسی کاملاً بازآرایی کنید، مدل متوجه نخواهد شد، و باز هم همان دقت را دریافت خواهید کرد. توجه یک مکانیزم پردازش مجموعه است که بر روابط بین جفتهای عناصر دنباله تمرکز دارد — نسبت به اینکه این عناصر در ابتدا، انتها یا در وسط یک دنباله رخ میدهند کور است. پس چرا میگوییم ترنسفورمر یک مدل دنبالهای است؟ و چگونه ممکن است برای ترجمهٔ ماشینی مناسب باشد اگر به ترتیب کلمات نگاه نمیکند؟
برای RNNها، ما به محاسبات لایه تکیه کردیم تا از ترتیب آگاه باشد. در مورد ترنسفورمر، ما در عوض اطلاعات موقعیتی را مستقیماً به دنبالهٔ جاسازیشدهٔ خود تزریق میکنیم. این یک جاسازی موقعیتی (positional embedding) نامیده میشود. بیایید نگاهی بیندازیم.
جاسازی اطلاعات موقعیتی
Section titled “جاسازی اطلاعات موقعیتی”ایدهٔ نهفته در پس یک جاسازی موقعیتی بسیار ساده است: برای اینکه به مدل دسترسی به اطلاعات ترتیب کلمات بدهیم، موقعیت کلمه در جمله را به هر جاسازی کلمه اضافه خواهیم کرد. جاسازیهای کلمهٔ ورودی ما دارای دو مؤلفه خواهند بود: بردار معمول کلمه، که نشاندهندهٔ کلمه مستقل از هر بافت خاصی است، و یک بردار موقعیت، که نشاندهندهٔ موقعیت کلمه در جملهٔ فعلی است. امید است که مدل سپس بهترین راه برای استفاده از این اطلاعات اضافی را کشف کند.
سرراستترین طرح برای افزودن اطلاعات موقعیت، الحاق موقعیت هر کلمه به بردار جاسازی آن خواهد بود. شما یک محور «موقعیت» به بردار اضافه میکنید و آن را با 0 برای اولین کلمه در دنباله، 1 برای دومی و غیره پر میکنید.
با این حال، ممکن است این حالت ایدهآل نباشد زیرا موقعیتها میتوانند اعداد صحیح بسیار بزرگی باشند، که دامنهٔ مقادیر را در بردار جاسازی مختل میکند. همانطور که میدانید، شبکههای عصبی مقادیر ورودی بسیار بزرگ یا توزیعهای ورودی گسسته را دوست ندارند.
نویسندگان مقالهٔ «Attention is all you need» از یک ترفند جالب برای کدگذاری موقعیتهای کلمات استفاده کردند: آنها به جاسازیهای کلمه برداری حاوی مقادیر در محدودهٔ [-1, 1] اضافه کردند که بسته به موقعیت به طور چرخهای تغییر میکرد (آنها از توابع کسینوسی برای دستیابی به این هدف استفاده کردند). این ترفند راهی برای توصیف منحصر به فرد هر عدد صحیح در یک دامنهٔ بزرگ از طریق برداری از مقادیر کوچک ارائه میدهد. این کار هوشمندانه است، اما معلوم میشود که ما میتوانیم کاری سادهتر و مؤثرتر انجام دهیم: ما بردارهای جاسازی موقعیتی را به همان روشی یاد میگیریم که جاسازی اندیسهای کلمات را یاد میگیریم. سپس جاسازیهای موقعیتی خود را به جاسازیهای کلمهٔ متناظر اضافه میکنیم تا یک جاسازی کلمهٔ آگاه از موقعیت به دست آوریم. این یک جاسازی موقعیتی (positional embedding) نامیده میشود. بیایید آن را پیادهسازی کنیم.
فهرست ۱۵.۱۷: یک لایهٔ جاسازی موقعیت آموختهشده
from keras import ops
class PositionalEmbedding(keras.Layer):    def __init__(self, sequence_length, input_dim, output_dim):        super().__init__()        self.token_embeddings = layers.Embedding(input_dim, output_dim)        self.position_embeddings = layers.Embedding(sequence_length, output_dim)
    def call(self, inputs):        # Computes incrementing positions [0, 1, 2...] for each        # sequence in the batch        positions = ops.cumsum(ops.ones_like(inputs), axis=-1) - 1        embedded_tokens = self.token_embeddings(inputs)        embedded_positions = self.position_embeddings(positions)        return embedded_tokens + embedded_positions
ما از این لایهٔ PositionalEmbedding دقیقاً مانند یک لایهٔ معمولی Embedding استفاده خواهیم کرد. بیایید با تلاش برای آموزش ترنسفورمر خود برای بار دوم، آن را در عمل ببینیم.
فهرست ۱۵.۱۸: ساخت یک مدل ترنسفورمر با جاسازیهای موقعیتی
hidden_dim = 256intermediate_dim = 2056num_heads = 8
source = keras.Input(shape=(None,), dtype="int32", name="english")x = PositionalEmbedding(sequence_length, vocab_size, hidden_dim)(source)encoder_output = TransformerEncoder(hidden_dim, intermediate_dim, num_heads)(    source=x,    source_mask=source != 0,)
target = keras.Input(shape=(None,), dtype="int32", name="spanish")x = PositionalEmbedding(sequence_length, vocab_size, hidden_dim)(target)x = TransformerDecoder(hidden_dim, intermediate_dim, num_heads)(    target=x,    source=encoder_output,    source_mask=source != 0,)x = layers.Dropout(0.5)(x)target_predictions = layers.Dense(vocab_size, activation="softmax")(x)transformer = keras.Model([source, target], target_predictions)
با اضافه شدن جاسازی موقعیتی به مدل ما، بیایید آموزش را دوباره امتحان کنیم:
transformer.compile( optimizer="adam", loss="sparse_categorical_crossentropy", weighted_metrics=["accuracy"],)transformer.fit(train_ds, epochs=30, validation_data=val_ds)با بازگشت اطلاعات موقعیتی به مدل، اوضاع بسیار بهتر شد. ما هنگام حدس زدن کلمهٔ بعدی به دقت ۶۷٪ دست یافتیم. این یک بهبود قابل توجه نسبت به مدل GRU است، و این امر زمانی چشمگیرتر میشود که در نظر بگیرید این مدل نصف پارامترهای همتای GRU خود را دارد.
نکتهٔ مهم دیگری که باید دربارهٔ این دور آموزش متوجه شد وجود دارد. آموزش به طور قابل توجهی سریعتر از RNN است — هر دوره حدود یک سوم زمان میبرد. این حتی اگر تعداد پارامترها را با مدل RNN مطابقت دهیم نیز صادق خواهد بود، و این یکی از عوارض جانبی خلاص شدن از انتقال وضعیت حلقهای لایههای GRU ما است. با توجه، هیچ محاسبات حلقهای برای مدیریت در طول آموزش وجود ندارد، به این معنی که روی یک GPU یا TPU، میتوانیم کل محاسبات توجه را در یک مرحله مدیریت کنیم. این امر باعث میشود Transformer سریعتر روی شتابدهندهها آموزش ببیند.
بیایید تولید را با Transformer جدید آموزشدیدهٔ خود دوباره اجرا کنیم. میتوانیم از همان کدی استفاده کنیم که برای نمونهبرداری RNN به کار گرفتیم.
فهرست ۱۵.۱۹: تولید ترجمهها با یک ترنسفورمر
import numpy as np
spa_vocab = spanish_tokenizer.get_vocabulary()spa_index_lookup = dict(zip(range(len(spa_vocab)), spa_vocab))
def generate_translation(input_sentence):    tokenized_input_sentence = english_tokenizer([input_sentence])    decoded_sentence = "[start]"    for i in range(sequence_length):        tokenized_target_sentence = spanish_tokenizer([decoded_sentence])        tokenized_target_sentence = tokenized_target_sentence[:, :-1]        inputs = [tokenized_input_sentence, tokenized_target_sentence]        next_token_predictions = transformer.predict(inputs, verbose=0)        sampled_token_index = np.argmax(next_token_predictions[0, i, :])        sampled_token = spa_index_lookup[sampled_token_index]        decoded_sentence += " " + sampled_token        if sampled_token == "[end]":            break    return decoded_sentence
test_eng_texts = [pair[0] for pair in test_pairs]for _ in range(5):    input_sentence = random.choice(test_eng_texts)    print("-")    print(input_sentence)    print(generate_translation(input_sentence))
با اجرای کد تولید، خروجی زیر را دریافت میکنیم:
-The resemblance between these two men is uncanny.[start] el parecido entre estos cantantes de dos hombres son asombrosa [end]-I'll see you at the library tomorrow.[start] te veré en la biblioteca mañana [end]-Do you know how to ride a bicycle?[start] sabes montar en bici [end]-Tom didn't want to do their dirty work.[start] tom no quería hacer su trabajo [end]-Is he back already?[start] ya ha vuelto [end]از نظر ذهنی، ترنسفورمر به طور قابل توجهی بهتر از مدل ترجمهٔ مبتنی بر GRU عمل میکند. این هنوز یک مدل اسباببازی است، اما یک مدل اسباببازی بهتر است.
ترنسفورمر یک معماری قدرتمند است که پایهای را برای انفجار علاقه به مدلهای پردازش متن ایجاد کرده است. همچنین با معیارهای مدلهای یادگیری عمیق، نسبتاً پیچیده است. پس از دیدن تمام این جزئیات پیادهسازی، ممکن است شخصی به طور معقولی اعتراض کند که همهٔ اینها کاملاً دلخواه به نظر میرسند. جزئیات کوچک بسیار زیادی وجود دارد که باید بر پایهٔ اعتماد پذیرفت. چگونه میتوانیم بدانیم این انتخاب و پیکربندی لایهها بهینه است؟
پاسخ ساده است — بهینه نیست. در طول سالها، تعدادی بهبود برای معماری ترنسفورمر با ایجاد تغییراتی در توجه، نرمالسازی و جاسازیهای موقعیتی پیشنهاد شده است. بسیاری از مدلهای جدید در پژوهشهای امروز با طولانیتر شدن طول دنبالهها، توجه را کاملاً با چیزی با پیچیدگی محاسباتی کمتر جایگزین میکنند. سرانجام، شاید تا زمانی که شما در حال خواندن این کتاب هستید، چیزی جایگزین ترنسفورمر به عنوان معماری غالب مورد استفاده برای مدلسازی زبان شده باشد.
چیزهای زیادی وجود دارد که میتوانیم از ترنسفورمر یاد بگیریم که آزمون زمان را پشت سر خواهند گذاشت. در انتهای این فصل، در مورد آنچه ترنسفورمر را بسیار مؤثر میسازد بحث خواهیم کرد. اما ارزش دارد به یاد داشته باشیم که به عنوان یک کل، حوزهٔ یادگیری ماشین به صورت تجربی حرکت میکند. توجه از تلاش برای تقویت RNNها رشد کرد، و پس از سالها حدس و بررسی توسط تعداد زیادی از افراد، ترنسفورمر را پدید آورد. دلیل کمی وجود دارد که فکر کنیم این فرایند به پایان رسیده است.
طبقهبندی با یک ترنسفورمر پیشآموزشدیده
Section titled “طبقهبندی با یک ترنسفورمر پیشآموزشدیده”پس از مقالهٔ «Attention is all you need»، مردم متوجه شدند که آموزش ترنسفورمر تا چه حد میتواند مقیاسپذیر باشد، به ویژه در مقایسه با مدلهایی که پیش از آن آمده بودند. همانطور که اشاره کردیم، یک مزیت بزرگ این بود که آموزش این مدل سریعتر از RNNها است. دیگر هیچ حلقهای در طول آموزش وجود ندارد، که این امر هنگام کار با GPU یا TPU همیشه مطلوب است.
این معماری همچنین معماری بسیار تشنهٔ دادهای است. ما در بخش قبل اندکی این موضوع را چشیدیم. در حالی که عملکرد اعتبارسنجی مدل ترجمهٔ RNN ما پس از حدود ۵ دوره متوقف شد و به سطح ثابتی رسید، مدل ترنسفورمر پس از ۳۰ دوره آموزش همچنان امتیاز اعتبارسنجی خود را بهبود میبخشید.
این مشاهدات باعث شد بسیاری از افراد تلاش کنند ترنسفورمر را با دادهها، لایهها و پارامترهای بیشتر مقیاس دهند — با نتایجی فوقالعاده. این امر باعث تغییر مشخصی در این حوزه به سمت مدلهای پیشآموزشدیدهٔ بزرگی شد که آموزش آنها میتواند میلیونها دلار هزینه داشته باشد، اما در طیف گستردهای از مسائل حوزهٔ متن عملکرد به مراتب بهتری دارند.
برای آخرین مثال کد خود در بخش متن، مسئلهٔ طبقهبندی متن IMDb خود را بازبینی خواهیم کرد، این بار با یک مدل ترنسفورمر پیشآموزشدیده.
پیشآموزش یک رمزگذار ترنسفورمر
Section titled “پیشآموزش یک رمزگذار ترنسفورمر”یکی از اولین ترنسفورمرهای پیشآموزشدیدهای که در NLP محبوب شد BERT نام داشت، مخفف Bidirectional Encoder Representations from Transformers (نمایشهای رمزگذار دوطرفه از ترنسفورمرها)2. این مقاله و مدل یک سال پس از «Attention Is All You Need» منتشر شدند. ساختار مدل دقیقاً همان بخش رمزگذار ترنسفورمر ترجمهای بود که به تازگی ساختیم. این مدل رمزگذار دوطرفه (bidirectional) است، به این معنا که هر موقعیت در دنباله میتواند به موقعیتهای جلو و پشت سر خود توجه کند. این بدان معناست که این مدل برای محاسبهٔ یک نمایش غنی از متن ورودی مدل خوبی است، اما مدلی نیست که برای اجرای تولید متن در یک حلقه در نظر گرفته شده باشد.
مدل BERT در اندازههایی بین ۱۰۰ میلیون تا ۳۰۰ میلیون پارامتر آموزش داده شد، بسیار بزرگتر از ترنسفورمر ۱۴ میلیون پارامتری که ما به تازگی آموزش دادیم. این بدان معنا بود که مدل برای عملکرد خوب به دادههای آموزشی زیادی نیاز داشت. برای دستیابی به این هدف، نویسندگان از یک دگرگونی در ساختار کلاسیک مدلسازی زبان به نام مدلسازی زبان ماسکگذاریشده (masked language modeling) استفاده کردند. برای پیشآموزش مدل، ما دنبالهای از متن را برمیداریم و حدود ۱۵٪ از توکنها را با یک توکن ویژهٔ [MASK] جایگزین میکنیم. مدل تلاش خواهد کرد تا مقادیر اصلی توکنهای ماسکشده را در طول آموزش پیشبینی کند. در حالی که مدل زبان کلاسیک، که گاهی اوقات مدل زبان علیتی (causal language model) نامیده میشود، تلاش میکند p(token|past tokens) را پیشبینی کند، مدل زبان ماسکگذاریشده تلاش میکند p(token|surrounding tokens) را پیشبینی نماید.
این ساختار آموزشی بدون نظارت است. شما به هیچ برچسبی برای متنی که وارد میکنید نیاز ندارید؛ برای هر دنبالهٔ متنی، میتوانید به راحتی چند توکن تصادفی را انتخاب کرده و آنها را ماسک کنید. این امر یافتن مقدار زیادی دادهٔ متنی مورد نیاز برای آموزش مدلهایی با این اندازه را برای نویسندگان آسان کرد. در بیشتر موارد، آنها از ویکیپدیا به عنوان منبع استفاده کردند.
استفاده از جاسازیهای کلمهٔ پیشآموزشدیده قبلاً در زمان انتشار BERT یک رویهٔ معمول بود — ما خودمان این را در فصل قبل دیدیم. اما پیشآموزش یک ترنسفورمر کامل چیز بسیار قدرتمندتری را به ارمغان آورد — توانایی محاسبهٔ یک جاسازی کلمه برای یک کلمه در بافت کلمات اطراف آن. و ترنسفورمر اجازه میداد این کار در مقیاس و کیفیتی انجام شود که در آن زمان بیسابقه بود.
نویسندگان BERT این مدل را که روی حجم عظیمی از متن پیشآموزش دیده بود، برداشتند و آن را برای دستیابی به نتایج پیشرفته (state-of-the-art) در چندین معیار ارزیابی NLP در آن زمان تخصصی کردند. این یک تغییر مشخص در این حوزه به سمت استفاده از مدلهای بسیار بزرگ و پیشآموزشدیده بود که اغلب تنها با مقدار کمی تنظیم دقیق (fine-tuning) همراه بودند. بیایید این را امتحان کنیم.
بارگذاری یک ترنسفورمر پیشآموزشدیده
Section titled “بارگذاری یک ترنسفورمر پیشآموزشدیده”به جای استفاده از BERT در اینجا، بیایید از یک مدل ادامهدهنده به نام RoBERTa3 استفاده کنیم که مخفف Robustly Optimized BERT است. مدل RoBERTa برخی سادهسازیهای جزئی را در معماری BERT ایجاد کرد، اما مهمتر از همه از دادههای آموزشی بیشتری برای بهبود عملکرد استفاده نمود. مدل BERT از ۱۶ گیگابایت متن زبان انگلیسی، عمدتاً از ویکیپدیا استفاده کرد. نویسندگان RoBERTa از ۱۶۰ گیگابایت متن از سراسر وب استفاده کردند. تخمین زده میشود که آموزش RoBERTa در آن زمان چند صد هزار دلار هزینه داشته است. به دلیل این دادههای آموزشی اضافی، مدل برای تعداد پارامترهای کلی معادل، به طور قابل توجهی بهتر عمل میکند.
برای استفاده از یک مدل پیشآموزشدیده به چند چیز نیاز خواهیم داشت:
- یک توکنساز منطبق — که با خود مدل پیشآموزشدیده استفاده میشود. هر متنی باید به همان شیوهای که در طول پیشآموزش توکنسازی شده است، توکنسازی شود. اگر کلمات نقدهای IMDb ما به اندیسهای توکن متفاوتی نسبت به آنچه در طول پیشآموزش داشتند نگاشت شوند، نمیتوانیم از نمایشهای آموختهشدهٔ هر توکن در مدل استفاده کنیم.
- یک معماری مدل منطبق — برای استفاده از مدل پیشآموزشدیده، باید ریاضیاتی را که به صورت داخلی توسط مدل برای پیشآموزش استفاده شده است دقیقاً بازآفرینی کنیم.
- وزنهای پیشآموزشدیده — این وزنها با آموزش مدل برای حدود یک روز روی ۱۰۲۴ پردازندهٔ گرافیکی (GPU) و میلیاردها کلمهٔ ورودی ایجاد شدهاند.
بازآفرینی کد توکنساز و معماری توسط خودمان چندان دشوار نخواهد بود. بخشهای داخلی مدل تقریباً دقیقاً با TransformerEncoder که قبلاً ساختیم مطابقت دارد. با این حال، تطبیق پیادهسازی یک مدل فرایندی زمانبر است، و همانطور که پیشتر در این کتاب انجام دادیم، میتوانیم در عوض از کتابخانهٔ KerasHub برای دسترسی به پیادهسازیهای مدلهای پیشآموزشدیده برای کراس استفاده کنیم.
بیایید از KerasHub برای بارگذاری یک توکنساز و مدل RoBERTa استفاده کنیم. میتوانیم از سازندهٔ ویژهٔ from_preset() برای بارگذاری وزنها، پیکربندی و داراییهای توکنساز یک مدل پیشآموزشدیده از دیسک استفاده کنیم. ما مدل پایهٔ RoBERTa را بارگذاری خواهیم کرد که کوچکترین نمونه از چند نقطهٔ بازرسی پیشآموزشدیدهای است که با مقالهٔ RoBERTa منتشر شده است.
فهرست ۱۵.۲۰: بارگذاری مدل پیشآموزشدیدهٔ RoBERTa با KerasHub
import keras_hub
tokenizer = keras_hub.models.Tokenizer.from_preset("roberta_base_en")backbone = keras_hub.models.Backbone.from_preset("roberta_base_en")همانطور که انتظار داریم، شیء Tokenizer از متن به دنبالههایی از اعداد صحیح نگاشت میکند. SubWordTokenizer را که در فصل قبل ساختیم به یاد دارید؟ توکنساز RoBERTa تقریباً همان توکنساز است، با تغییرات جزئی برای مدیریت کاراکترهای یونیکد از هر زبانی.
با توجه به اندازهٔ مجموعه دادهٔ پیشآموزش RoBERTa، توکنسازی زیرکلمهای یک ضرورت است. استفاده از یک توکنساز در سطح کاراکتر باعث میشود دنبالههای ورودی بسیار طولانی شوند و آموزش مدل بسیار گرانتر تمام شود. استفاده از یک توکنساز در سطح کلمه به یک واژگان عظیم نیاز دارد تا سعی کند تمام کلمات متمایز را در میلیونها سند متنی استفادهشده از سراسر وب پوشش دهد. دستیابی به پوشش مناسبی از کلمات، اندازهٔ واژگان ما را منفجر میکند و لایهٔ Embedding در ابتدای ترنسفورمر را به طور غیرقابل استفادهای بزرگ میسازد. استفاده از یک توکنساز زیرکلمهای به مدل اجازه میدهد تا هر کلمهای را تنها با یک واژگان ۵۰,۰۰۰ اصطلاحی مدیریت کند:
>>> tokenizer("The quick brown fox")این Backbone که به تازگی بارگذاری کردیم چیست؟ در فصل ۸ دیدیم که backbone اصطلاحی است که اغلب در بینایی ماشین برای شبکهای استفاده میشود که از تصاویر ورودی به یک فضای نهان نگاشت میکند — در واقع یک مدل بینایی بدون سری برای پیشبینی. در KerasHub، یک ستون فقرات (backbone) به هر مدل پیشآموزشدیدهای اطلاق میشود که هنوز برای یک کار خاص تخصصی نشده است. مدلی که به تازگی بارگذاری کردیم یک دنبالهٔ ورودی را دریافت میکند و آن را به یک دنبالهٔ خروجی با شکل (batch_size, sequence_length, 768) جاسازی مینماید، اما برای یک تابع زیان خاص تنظیم نشده است. شما میتوانید از آن برای هر تعداد وظیفهٔ پاییندست استفاده کنید — طبقهبندی جملات، شناسایی بخشهایی از متن با اطلاعات خاص، شناسایی اجزای کلام و غیره.
سپس، ما یک سر طبقهبندی (classification head) را به این ستون فقرات متصل خواهیم کرد که آن را برای تنظیم دقیق طبقهبندی نقد IMDb ما تخصصی میکند. میتوانید این را به عنوان اتصال سرهای مختلف به یک پیچگوشتی در نظر بگیرید: یک سر چهارسو برای یک کار، یک سر دوسو برای کاری دیگر.
بیایید نگاهی به ستون فقرات خود بیندازیم. ما کوچکترین نسخه از RoBERTa را در اینجا بارگذاری کردیم، اما همچنان ۱۲۴ میلیون پارامتر دارد که بزرگترین مدلی است که تا کنون در این کتاب استفاده کردهایم:
>>> backbone.summary()مدل RoBERTa از ۱۲ لایهٔ رمزگذار ترنسفورمر که روی هم چیده شدهاند استفاده میکند. این یک گام بزرگ رو به جلو نسبت به مدل ترجمهٔ ما است!
پیشپردازش نقدهای فیلم IMDb
Section titled “پیشپردازش نقدهای فیلم IMDb”ما میتوانیم از کد بارگذاری IMDb که در فصل ۱۴ استفاده کردیم بدون تغییر مجدداً استفاده کنیم. این کار دادههای نقد فیلم را در یک train_dir و test_dir دانلود میکند و یک مجموعه دادهٔ اعتبارسنجی را در یک val_dir جدا مینماید:
from keras.utils import text_dataset_from_directory
batch_size = 16train_ds = text_dataset_from_directory(train_dir, batch_size=batch_size)val_ds = text_dataset_from_directory(val_dir, batch_size=batch_size)test_ds = text_dataset_from_directory(test_dir, batch_size=batch_size)
پس از بارگذاری، ما بار دیگر یک مجموعهٔ آموزشی از ۲۰,۰۰۰ نقد فیلم و یک مجموعهٔ اعتبارسنجی از ۵,۰۰۰ نقد فیلم داریم.
قبل از تنظیم دقیق مدل طبقهبندی خود، باید نقدهای فیلم خود را با توکنساز RoBERTa که بارگذاری کردهایم توکنسازی کنیم. در طول پیشآموزش، RoBERTa از شکل خاصی از «بستهبندی (packing)» توکنها در یک دنباله استفاده کرد، مشابه کاری که ما برای مدل ترجمهٔ خود انجام دادیم. هر دنباله با یک توکن <s> شروع میشود، با یک توکن </s> پایان مییابد، و به دنبال آن هر تعداد توکن <pad> مانند این قرار میگیرد:
[ ["<s>", "the", "quick", "brown", "fox", "jumped", ".", "</s>"], ["<s>", "the", "panda", "slept", ".", "</s>", "<pad>", "<pad>"],]بسیار مهم است که ترتیب توکنهای استفادهشده برای پیشآموزش را تا حد ممکن دقیق مطابقت دهید؛ در این صورت مدل سریعتر و دقیقتر آموزش خواهد دید. کتابخانهٔ KerasHub لایهای را برای این نوع بستهبندی توکن به نام StartEndPacker ارائه میدهد. این لایه توکنهای شروع، پایان و حاشیهگذاری را اضافه میکند و در صورت لزوم دنبالههای طولانی را به طول دنبالهٔ معین کوتاه مینماید. بیایید از آن همراه با توکنساز خود استفاده کنیم.
فهرست ۱۵.۲۱: پیشپردازش نقدهای فیلم IMDb با توکنساز RoBERTa
def preprocess(text, label):    packer = keras_hub.layers.StartEndPacker(        sequence_length=512,        start_value=tokenizer.start_token_id,        end_value=tokenizer.end_token_id,        pad_value=tokenizer.pad_token_id,        return_padding_mask=True,    )    token_ids, padding_mask = packer(tokenizer(text))    return {"token_ids": token_ids, "padding_mask": padding_mask}, label
preprocessed_train_ds = train_ds.map(preprocess)preprocessed_val_ds = val_ds.map(preprocess)preprocessed_test_ds = test_ds.map(preprocess)
بیایید به یک دستهٔ پیشپردازششدهٔ واحد نگاه کنیم:
>>> next(iter(preprocessed_train_ds))با پیشپردازش ورودیهایمان، آمادهٔ شروع تنظیم دقیق مدل خود هستیم.
تنظیم دقیق یک ترنسفورمر پیشآموزشدیده
Section titled “تنظیم دقیق یک ترنسفورمر پیشآموزشدیده”قبل از اینکه ستون فقرات خود را برای پیشبینی نقدهای فیلم تنظیم دقیق کنیم، باید آن را بهروزرسانی نماییم تا یک برچسب طبقهبندی دودویی را خروجی دهد. ستون فقرات یک دنبالهٔ کامل با شکل (batch_size, sequence_length, 768) را خروجی میدهد، که در آن هر بردار ۷۶۸ بعدی نشاندهندهٔ یک کلمهٔ ورودی در بافت کلمات اطراف آن است. قبل از پیشبینی یک برچسب، باید این دنباله را به یک بردار منفرد به ازای هر نمونه متراکم کنیم.
یک گزینه انجام ادغام میانگین (mean pooling) یا ادغام بیشینه (max pooling) در سرتاسر کل دنباله است که میانگینی از تمام بردارهای توکن را محاسبه میکند. آنچه کمی بهتر کار میکند صرفاً استفاده از نمایش اولین توکن به عنوان مقدار تجمیعشده است. این به دلیل ماهیت توجه در مدل ما است — اولین موقعیت در لایهٔ رمزگذار نهایی قادر خواهد بود به تمام موقعیتهای دیگر در دنباله توجه کند و اطلاعات را از آنها استخراج نماید. بنابراین به جای تجمیع اطلاعات با چیزی خشن، مانند گرفتن میانگین، توجه به ما اجازه میدهد تا اطلاعات را به صورت زمینهمحور در سرتاسر دنباله تجمیع کنیم.
بیایید اکنون یک سر طبقهبندی به ستون فقرات خود اضافه کنیم. ما همچنین یک نگاشت متراکم Dense نهایی را با یک غیرخطی بودن قبل از تولید پیشبینی خروجی اضافه خواهیم کرد.
فهرست ۱۵.۲۲: گسترش مدل پایهٔ RoBERTa برای طبقهبندی
inputs = backbone.inputx = backbone(inputs)# Uses the hidden representation of the first tokenx = x[:, 0, :]x = layers.Dropout(0.1)(x)x = layers.Dense(768, activation="relu")(x)x = layers.Dropout(0.1)(x)outputs = layers.Dense(1, activation="sigmoid")(x)classifier = keras.Model(inputs, outputs)با این کار، ما آمادهٔ تنظیم دقیق و ارزیابی مدل بر روی مجموعه دادهٔ IMDb هستیم.
فهرست ۱۵.۲۳: آموزش مدل طبقهبندی RoBERTa
classifier.compile( optimizer=keras.optimizers.Adam(5e-5), loss="binary_crossentropy", metrics=["accuracy"],)classifier.fit( preprocessed_train_ds, validation_data=preprocessed_val_ds,)در نهایت، بیایید مدل آموزشدیده را ارزیابی کنیم:
>>> classifier.evaluate(preprocessed_test_ds)تنها در یک دورهٔ واحد از آموزش، مدل ما به ۹۳٪ رسید، یک بهبود قابل توجه از سقف ۹۰٪ که در فصل گذشته به آن برخورد کردیم. البته، این مدلی بسیار گرانتر برای استفاده نسبت به طبقهبند بایگرام سادهای است که قبلاً ساختیم، اما مزایای واضحی برای استفاده از چنین مدل بزرگی وجود دارد. و همهٔ اینها با اندازهٔ کوچکتر مدل RoBERTa به دست آمده است. با استفاده از مدل بزرگتر ۳۰۰ میلیون پارامتری، میتوانستیم به دقتی بیش از ۹۵٪ دست یابیم.
چه چیزی ترنسفورمر را مؤثر میسازد؟
Section titled “چه چیزی ترنسفورمر را مؤثر میسازد؟”در سال ۲۰۱۳، در گوگل، توماس میکولوف و همکارانش متوجه چیز شگفتانگیزی شدند. آنها در حال ساخت یک جاسازی پیشآموزشدیده به نام «Word2Vec» بودند، مشابه جاسازی کیسهٔ کلمات پیوسته (CBOW) که در فصل گذشته ساختیم. بسیار شبیه به مدل CBOW ما، هدف آموزشی آنها به دنبال تبدیل روابط همبستگی بین کلمات به روابط فاصله در فضای جاسازی بود: یک بردار با هر کلمه در یک واژگان مرتبط میشد، و بردارها به گونهای بهینهسازی میشدند که ضرب داخلی (نزدیکی کسینوسی) بین بردارهایی که کلمات مکرراً همرخداد را نشان میدهند به ۱ نزدیکتر باشد، در حالی که ضرب داخلی بین بردارهایی که کلمات به ندرت همرخداد را نشان میدهند به ۰ نزدیکتر باشد.
آنها دریافتند که فضای جاسازی حاصل کارهایی بسیار فراتر از ثبت شباهت معنایی انجام میدهد. این فضا دارای نوعی یادگیری نوظهور بود — نوعی «حساب کلمات». برداری در فضا وجود داشت که میتوانستید آن را به بسیاری از اسمهای مذکر اضافه کنید تا نقطهای به دست آورید که نزدیک به معادل مؤنث آن فرود آید، مانند V(king) - V(man) + V(woman) = V(queen)، یک بردار جنسیت. این کاملاً شگفتآور بود؛ مدل به هیچ وجه صریح برای این کار آموزش ندیده بود. به نظر میرسید دهها بردار جادویی از این دست وجود دارد — یک بردار جمع، برداری برای رفتن از نام حیوانات وحشی به نزدیکترین معادل حیوان خانگی آنها و غیره.
حدود ۱۰ سال سریع به جلو حرکت کنیم — اکنون در عصر مدلهای بزرگ و پیشآموزشدیدهٔ ترنسفورمر هستیم. در ظاهر، این مدلها نمیتوانستند دورتر از مدل ابتدایی Word2Vec به نظر برسند. یک ترنسفورمر میتواند زبانی کاملاً روان تولید کند — شاهکاری که Word2Vec کاملاً از انجام آن ناتوان بود. همانطور که در فصل بعد خواهیم دید، چنین مدلهایی میتوانند در مورد تقریباً هر موضوعی آگاه به نظر برسند. و با این حال، آنها در واقع اشتراکات زیادی با Word2Vec قدیمی و خوب دارند.
هر دو مدل به دنبال جاسازی توکنها (کلمات یا زیرکلمات) در یک فضای برداری هستند. هر دو برای یادگیری این فضا به یک اصل بنیادین متکی هستند: توکنهایی که با هم ظاهر میشوند در فضای جاسازی به هم نزدیک میشوند. تابع فاصلهٔ مورد استفاده برای مقایسهٔ توکنها در هر دو مورد، فاصلهٔ کسینوسی است. حتی ابعاد فضای جاسازی نیز مشابه است: برداری با بین ۱۰۰۰ تا ۱۰,۰۰۰ بعد برای نمایش هر کلمه.
در این نقطه، ممکن است اعتراض کنید: یک ترنسفورمر برای پیشبینی کلمات مفقود در یک دنباله آموزش دیده است، نه برای گروهبندی توکنها در یک فضای جاسازی. تابع زیان مدل زبان چگونه با هدف Word2Vec برای بیشینهسازی ضرب داخلی بین توکنهای همرخداد ارتباط دارد؟ پاسخ مکانیزم توجه است.
توجه با اختلاف، حیاتیترین مؤلفه در معماری ترنسفورمر است. این مکانیزمی برای یادگیری یک فضای جاسازی توکن جدید از طریق بازترکیب خطی جاسازیهای توکن از یک فضای قبلی است، در ترکیبهای وزنداری که به توکنهایی که در حال حاضر به یکدیگر «نزدیکتر» هستند (یعنی ضرب داخلی بالاتری دارند) اهمیت بیشتری میدهند. این مکانیزم تمایل دارد بردارهای توکنهای در حال حاضر نزدیک را به سمت یکدیگر بکشد، که در طول زمان به فضایی منجر میشود که در آن روابط همبستگی توکنها به روابط نزدیکی جاسازی (از نظر فاصلهٔ کسینوسی) تبدیل میشوند. ترنسفورمرها با یادگیری مجموعهای از فضاهای جاسازی که به صورت تدریجی پالایش میشوند کار میکنند، که هر کدام بر اساس بازترکیب عناصر از فضای قبلی ساخته شدهاند.
توجه دو ویژگی حیاتی را برای ترنسفورمرها فراهم میکند:
- فضاهای جاسازی که آنها یاد میگیرند از نظر معنایی پیوسته هستند — یعنی حرکت اندک در یک فضای جاسازی فقط معنای انسانی توکنهای متناظر را اندکی تغییر میدهد. فضای Word2Vec نیز این ویژگی را نشان میداد.
- فضاهای جاسازی که آنها یاد میگیرند از نظر معنایی درونیاب هستند — یعنی گرفتن نقطهٔ میانی بین دو نقطه در یک فضای جاسازی، نقطهای را تولید میکند که نشاندهندهٔ «معنای میانی» بین توکنهای متناظر است. این ناشی از این واقعیت است که هر فضای جاسازی جدید با درونیابی بین بردارهای حاصل از فضای قبلی ساخته میشود.
این کاملاً بیشباهت به روش یادگیری مغز نیست. اصل کلیدی یادگیری در مغز یادگیری هبی (Hebbian learning) است — به طور خلاصه، «نورونهایی که با هم شلیک میکنند، به هم متصل میشوند.» روابط همبستگی بین رویدادهای شلیک عصبی (که ممکن است نشاندهندهٔ کنشها یا ورودیهای ادراکی باشند) به روابط نزدیکی در شبکهٔ مغز تبدیل میشوند، درست همانطور که ترنسفورمر و Word2Vec روابط همبستگی را به روابط نزدیکی برداری تبدیل میکنند. هر دو نقشههایی از یک فضای اطلاعاتی هستند.
البته تفاوتهای قابل توجهی بین Word2Vec و ترنسفورمر وجود دارد. مدل Word2Vec برای نمونهبرداری متنی مولد طراحی نشده بود. یک ترنسفورمر میتواند بسیار بزرگتر شود و میتواند تبدیلات بسیار پیچیدهتری را کدگذاری کند. مسئله این است که Word2Vec بسیار شبیه یک مدل اسباببازی است: نسبت آن به مدلهای زبان امروزی مانند نسبت یک رگرسیون لجستیک روی پیکسلهای MNIST به مدلهای پیشرفتهٔ بینایی ماشین است. اصول بنیادین عمدتاً یکسان هستند، اما مدل اسباببازی فاقد هرگونه قدرت نمایش معنادار است. مدل Word2Vec حتی یک شبکهٔ عصبی عمیق نبود — معماری کمعمق و تکلایهای داشت. در همین حال، مدلهای ترنسفورمر امروزی بالاترین قدرت نمایش را در میان تمام مدلهایی دارند که تاکنون آموزش داده شدهاند — آنها دارای دهها لایهٔ توجه و پیشخور پشتهشده هستند، و تعداد پارامترهای آنها به میلیاردها میرسد.
مانند Word2Vec، ترنسفورمر توابع معنایی مفیدی را به عنوان محصول جانبی سازماندهی توکنها در یک فضای برداری یاد میگیرد. اما به لطف این قدرت نمایش افزایشیافته و یک هدف بهینهسازی خودهمبستهٔ بسیار پالایششدهتر، ما دیگر به تبدیلات خطی مانند بردار جنسیت یا بردار جمع محدود نیستیم. ترنسفورمرها میتوانند توابع برداری دلخواه و پیچیدهای را ذخیره کنند — در واقع چنان پیچیده که دقیقتر است به جای توابع، آنها را برنامههای برداری بنامیم.
مدل Word2Vec شما را قادر میساخت کارهای پایهای مانند plural(cat) → cats یا male_to_female(king) → queen را انجام دهید. در همین حال، یک مدل ترنسفورمر بزرگ میتواند جادوی خالص انجام دهد — کارهایی مانند write_this_in_style_of_shakespeare("...your poem...") → "...new poem...". و یک مدل واحد میتواند شامل میلیونها برنامهٔ اینچنینی باشد.
شما میتوانید ترنسفورمر را شبیه به یک پایگاه داده ببینید: اطلاعاتی را ذخیره میکند که میتوانید از طریق توکنهایی که به آن منتقل میکنید بازیابی نمایید. اما دو تفاوت مهم بین ترنسفورمر و یک پایگاه داده وجود دارد.
اولین تفاوت این است که ترنسفورمر نوعی پایگاه دادهٔ پیوسته و درونیاب است. دادههای شما به جای اینکه به عنوان مجموعهای از ورودیهای گسسته ذخیره شوند، به عنوان یک فضای برداری — یک منحنی — ذخیره میشوند. شما میتوانید روی منحنی حرکت کنید (همانطور که بحث کردیم، از نظر معنایی پیوسته است) تا نقاط مجاور و مرتبط را کشف کنید. و میتوانید روی منحنی بین نقاط مختلف داده درونیابی کنید تا میانهٔ آنها را بیابید. این بدان معناست که شما میتوانید بسیار بیشتر از آنچه در پایگاه دادهٔ خود قرار دادهاید از آن بازیابی کنید — اگرچه همهٔ آن دقیق یا معنادار نخواهد بود. درونیابی میتواند به تعمیم منجر شود، اما همچنین میتواند به توهمات (hallucinations) بینجامد — مشکلی مهم که مدلهای زبان مولد امروزی با آن روبرو هستند.
دومین تفاوت این است که ترنسفورمر فقط حاوی داده نیست. برای مدلهایی مانند RoBERTa، که روی صدها هزار سند جمعآوریشده از اینترنت آموزش دیدهاند، دادههای زیادی وجود دارد: حقایق، مکانها، افراد، تاریخها، اشیاء و روابط. اما این مدل همچنین — شاید در وهلهٔ اول — پایگاه دادهای از برنامهها است.
توجه داشته باشید که آنها با نوع برنامههایی که شما عادت دارید با آنها کار کنید متفاوت هستند. اینها مانند برنامههای پایتون نیستند — مجموعهای از گزارههای نمادین که دادهها را گامبهگام پردازش میکنند. در عوض، این برنامههای برداری توابعی به شدت غیرخطی هستند که فضای نهان جاسازی را به خودش نگاشت میکنند، شبیه به بردارهای جادویی Word2Vec، اما بسیار پیچیدهتر.
در فصل بعد، ما مدلهای ترنسفورمر را به مقیاسی کاملاً جدید پیش خواهیم برد. مدلها از میلیاردها پارامتر استفاده خواهند کرد و روی تریلیونها کلمه آموزش خواهند دید. خروجی حاصل از این مدلها اغلب میتواند مانند جادو به نظر برسد — مانند یک کارور باهوش که درون مدل ما نشسته و رشتهها را میکشد. اما مهم است به یاد داشته باشیم که این مدلها اساساً درونیاب هستند — به لطف توجه، آنها یک فضای جاسازی درونیاب را برای بخش قابل توجهی از تمام متون نوشتهشده به زبان انگلیسی یاد میگیرند. سرگردانی در این فضای جاسازی میتواند به تعمیمهای جالب و غیرمنتظرهای منجر شود، اما نمیتواند چیزی بنیادین و جدید را با چیزی نزدیک به هوش واقعی در سطح انسانی ترکیب کند.
- یک مدل زبان (language model) مدلی است که یک توزیع احتمال خاص را یاد میگیرد —
p(token|past tokens):- مدلهای زبان کاربردهای گستردهای دارند، اما مهمترین کاربرد این است که میتوانید با فراخوانی آنها در یک حلقه، متن تولید کنید، جایی که توکن خروجی در یک گام زمانی به توکن ورودی در گام بعدی تبدیل میشود.
- یک مدل زبان ماسکگذاریشده (masked language model) یک توزیع احتمال مرتبط را یاد میگیرد
p(tokens|surrounding tokens)و میتواند برای طبقهبندی متن و توکنهای منفرد مفید باشد. - یک مدل زبان دنبالهبهدنباله (sequence-to-sequence language model) یاد میگیرد که توکن بعدی را با در نظر گرفتن هم توکنهای گذشته در یک دنبالهٔ هدف و هم یک دنبالهٔ مبدأ کاملاً جداگانه و ثابت پیشبینی کند. مدلهای دنبالهبهدنباله برای مسائلی مانند ترجمه و پاسخ به پرسشها مفید هستند.
- یک مدل دنبالهبهدنباله معمولاً دو مؤلفهٔ جداگانه دارد. یک رمزگذار (encoder) نمایشی از دنبالهٔ مبدأ را محاسبه میکند، و یک رمزگشا (decoder) این نمایش را به عنوان ورودی میگیرد و توکن بعدی را در یک دنبالهٔ هدف بر اساس توکنهای گذشته پیشبینی میکند.
- توجه (Attention) مکانیزمی است که به مدل اجازه میدهد به طور گزینشی بر اساس زمینهٔ توکنی که در حال حاضر پردازش میشود، اطلاعات را از هر جای دنباله استخراج کند:
- توجه از مشکلاتی که RNNها با وابستگیهای دوربرد در متن دارند جلوگیری میکند.
- توجه با گرفتن ضرب داخلی (dot-product) دو بردار برای محاسبهٔ امتیاز توجه کار میکند. بردارهای نزدیک به یکدیگر در یک فضای جاسازی در مکانیزم توجه با یکدیگر جمع خواهند شد.
- ترنسفورمر (Transformer) یک معماری مدلسازی دنباله است که از توجه به عنوان تنها مکانیزم برای انتقال اطلاعات در سرتاسر یک دنباله استفاده میکند:
- ترنسفورمر با چیدن متوالی بلوکهایی از توجه متناوب و شبکههای پیشخور دولایهای کار میکند.
- ترنسفورمر میتواند به پارامترهای بسیار و دادههای آموزشی فراوان مقیاس یابد در حالی که همچنان دقت را در مسئلهٔ مدلسازی زبان بهبود میبخشد.
- برخلاف RNNها، ترنسفورمر در زمان آموزش شامل هیچ حلقهٔ وابسته به طول دنباله نیست، که این امر آموزش مدل را به صورت موازی روی چندین ماشین بسیار آسانتر میکند.
- یک رمزگذار ترنسفورمر از توجه دوطرفه برای ساخت نمایشی غنی از یک دنباله استفاده میکند.
- یک رمزگشا ترنسفورمر از توجه علیتی برای پیشبینی کلمهٔ بعدی در یک ساختار مدل زبان استفاده میکند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
واس Bert، «Attention Is All You Need»، مجموعه مقالات سیویکمین کنفرانس بینالمللی سیستمهای پردازش اطلاعات عصبی (۲۰۱۷)، https://arxiv.org/abs/1706.03762. ↩
-
دولین و همکاران، «BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding»، مجموعه مقالات کنفرانس ۲۰۱۹ فصل آمریکای شمالی انجمن زبانشناسی محاسباتی: فناوریهای زبان انسانی، جلد ۱ (۲۰۱۹)، https://arxiv.org/abs/1810.04805. ↩
-
لیو و همکاران، «RoBERTa: A Robustly Optimized BERT Pretraining Approach» (۲۰۱۹)، https://arxiv.org/abs/1907.11692. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.