
فصل ۱۶: تولید متن
هنگامی که برای اولین بار ادعا کردم در آیندهای نه چندان دور، بیشتر محتوای فرهنگی که ما مصرف میکنیم با کمک قابل توجهی از هوش مصنوعی ایجاد خواهد شد، با ناباوری کامل، حتی از سوی متخصصان باسابقهٔ یادگیری ماشین روبرو شدم. آن زمان سال ۲۰۱۴ بود. یک دهه سریع به جلو حرکت کنید، و آن ناباوری با سرعتی باورنکردنی فروکش کرده است. ابزارهای هوش مصنوعی مولد اکنون بخشهای معمولی پردازشگرهای کلمه، ویرایشگرهای تصویر و محیطهای توسعه هستند. جوایز معتبری به ادبیات و هنرهای ایجادشده با مدلهای مولد اهدا میشود — با بحث و مناقشهٔ فراوان.1 دیگر بررسی جهانی که در آن هوش مصنوعی و تلاشهای هنری اغلب در هم تنیدهاند، حس علمیتخیلی ندارد.
از هر نظر عملی، هوش مصنوعی هنوز فاصلهٔ بسیار زیادی با رقابت با فیلمنامهنویسان، نقاشان یا آهنگسازان انسانی دارد. اما جایگزینی انسانها نیازی نیست که هدف باشد و نباید هم باشد. در بسیاری از حوزهها، به ویژه حوزههای خلاقانه، مردم از هوش مصنوعی برای تقویت قابلیتهای خود استفاده خواهند کرد — بیشتر هوش تقویتشده (augmented intelligence) تا هوش مصنوعی.
بخش عمدهای از آفرینش هنری شامل بازشناسی الگو و مهارت فنی است. حواس ادراکی ما، زبان و آثار هنری همگی دارای ساختار آماری هستند، و مدلهای یادگیری عمیق در یادگیری این ساختار سرآمدند. مدلهای یادگیری ماشین میتوانند فضاهای نهان آماری تصاویر، موسیقی و داستانها را یاد بگیرند، و سپس میتوانند از این فضاها نمونهبرداری کنند و آثار هنری جدیدی با ویژگیهای مشابه آنچه مدل در دادههای آموزشی خود دیده است ایجاد نمایند. چنین نمونهبرداری به خودی خود به سختی یک عمل آفرینش هنری محسوب میشود — این صرفاً یک عملیات ریاضی است. تنها تفسیر ما، به عنوان تماشاگران انسانی، به آنچه مدل تولید میکند معنا میبخشد. اما در دستان یک هنرمند ماهر، تولید الگوریتمی میتواند هدایت شود تا معنادار و زیبا شود. نمونهبرداری از فضای نهان میتواند قلممویی شود که به هنرمند قدرت میبخشد، امکانات خلاقانهٔ ما را تقویت میکند، و فضای آنچه را که میتوانیم تصور کنیم گسترش میدهد. حتی میتواند آفرینش هنری را با حذف نیاز به مهارت فنی و تمرین طولانیمدت در دسترستر کند — و رسانهٔ جدیدی از بیان خالص ایجاد نماید که هنر را از مهارت دستی تفکیک میکند.
شکل ۱۶.۱: تصویری که با نرمافزار مولد تصویر Midjourney تولید شده است. پرامپت این بود: «یک منظرهٔ علمیتخیلی و دستکشیده از ساکنانی که در ساختمانی به شکل حرف انگلیسی K قرمز رنگ زندگی میکنند.»
یانیس زناکیس (Iannis Xenakis)، پیشگام آیندهنگر موسیقی الکترونیک و الگوریتمی، همین ایده را در دههٔ ۱۹۶۰، در زمینهٔ کاربرد فناوری خودکارسازی در آهنگسازی به زیبایی بیان کرد:2
آهنگساز با رهایی از محاسبات خستهکننده میتواند خود را وقف مسائل کلی که فرم جدید موسیقی مطرح میکند بنماید و در حین تغییر مقادیر دادههای ورودی، گوشهوکنار این فرم را کشف کند. برای مثال، او ممکن است تمام ترکیبهای سازها را از تکنوازان گرفته تا ارکسترهای مجلسی و ارکسترهای بزرگ آزمایش کند. با کمک رایانههای الکترونیکی، آهنگساز تبدیل به نوعی خلبان میشود: او دکمهها را فشار میدهد، مختصات را وارد میکند، و هدایت فضاپیمایی کیهانی را که در فضای صوت، در میان صورتهای فلکی و کهکشانهای صوتی حرکت میکند بر عهده میگیرد؛ کهکشانهایی که قبلاً فقط میتوانست به عنوان یک رؤیای دوردست به آنها نگاهی بیندازد.
پتانسیل هوش مصنوعی مولد فراتر از تلاشهای هنری گسترش مییابد. در بسیاری از حرفهها، مردم محتوایی ایجاد میکنند که در آن بازشناسی الگو حتی آشکارتر است: به خلاصهسازی اسناد بزرگ، پیادهسازی متن از گفتار، ویرایش غلطهای املایی، یا نشانهگذاری خطاهای رایج در کد فکر کنید. این وظایف روتین مستقیماً با نقاط قوت رویکردهای یادگیری عمیق همخوانی دارند. در مورد نحوهٔ استقرار هوش مصنوعی در محیط کار — با پیامدهای واقعی اجتماعی — موارد زیادی وجود دارد که باید در نظر گرفت.
در دو فصل بعدی، پتانسیل یادگیری عمیق را برای کمک به آفرینش کشف خواهیم کرد. ما یاد خواهیم گرفت که فضاهای نهان را در دامنههای متنی و تصویری سازماندهی کنیم و محتوای جدیدی را از این فضاها بیرون بکشیم. ما با متن شروع خواهیم کرد و ایدهٔ مدل زبانی را که ابتدا در فصل قبل با آن کار کردیم، مقیاس میدهیم. این مدلهای زبان بزرگ یا به اختصار LLMها، در پس دستیارهای دیجیتالی مانند ChatGPT و فهرستی به سرعت در حال رشد از کاربردهای دنیای واقعی قرار دارند.
تاریخچهٔ کوتاهی از تولید دنباله
Section titled “تاریخچهٔ کوتاهی از تولید دنباله”تا همین اواخر، ایدهٔ تولید دنبالهها از یک مدل، یک موضوع فرعی تخصصی در یادگیری ماشین بود — شبکههای بازگشتی مولد تنها در سال ۲۰۱۶ شروع به ورود به جریان اصلی کردند. با این حال، این تکنیکها پیشینهای نسبتاً طولانی دارند که با توسعهٔ الگوریتم LSTM در سال ۱۹۹۷ آغاز شد.
در سال ۲۰۰۲، داگلاس اک (Douglas Eck) برای اولین بار LSTM را برای تولید موسیقی به کار گرفت و به نتایج امیدوارکنندهای دست یافت. اک پژوهشگری در گوگل برین شد و در سال ۲۰۱۶، یک گروه تحقیقاتی جدید به نام Magenta را راهاندازی کرد که بر اعمال تکنیکهای مدرن یادگیری عمیق برای تولید موسیقی جذاب تمرکز داشت. گاهی اوقات، ایدههای خوب ۱۵ سال طول میکشد تا شروع شوند.
در اواخر دههٔ ۲۰۰۰ و اوایل دههٔ ۲۰۱۰، الکس گریوز (Alex Graves) در استفاده از شبکههای بازگشتی برای انواع جدیدی از تولید دادههای دنبالهای پیشگام شد. به ویژه، برخی کار سال ۲۰۱۳ او در مورد استفاده از شبکههای چگالی ترکیبی بازگشتی برای تولید دستخط شبیه به انسان با استفاده از سریهای زمانی موقعیت قلم را به عنوان یک نقطهٔ عطف میدانند. گریوز یک یادداشت کامنتشده را در یک فایل لایتک در سال ۲۰۱۳ که در سرور پیشنویس arXiv بارگذاری شده بود، به جا گذاشت: «تولید دادههای متوالی نزدیکترین حالتی است که رایانهها به رؤیا دیدن میرسند.» این اثر و مفهوم ماشینهایی که رؤیا میبینند، الهامبخشهای مهمی برای من هنگام شروع توسعهٔ کراس بودند.
در سال ۲۰۱۸، یک سال پس از مقالهٔ «Attention Is All You Need» که در فصل قبل بحث کردیم، گروهی از پژوهشگران در سازمانی به نام OpenAI مقالهٔ جدیدی با عنوان «Improving Language Understanding by Generative Pre-Training» منتشر کردند.3 آنها چند جزء را ترکیب کردند:
- پیشآموزش بدون نظارت یک مدل زبان — اساساً آموزش یک مدل برای «حدس زدن توکن بعدی» در یک دنباله، همانطور که با مولد شکسپیر خود در فصل ۱۵ انجام دادیم
- معماری ترنسفورمر
- دادههای متنی در موضوعات مختلف از طریق هزاران کتاب خودناشر
نویسندگان نشان دادند که چنین مدل پیشآموزشدیدهای را میتوان برای دستیابی به عملکرد پیشرفته در طیف گستردهای از وظایف طبقهبندی متن تنظیم دقیق کرد — از سنجش شباهت دو جمله تا پاسخ به یک پرسش چندگزینهای. آنها مدل پیشآموزشدیده را GPT نامیدند، مخفف Generative Pretrained Transformer (ترنسفورمر پیشآموزشدیدهٔ مولد).
مدل GPT همراه با هیچ پیشرفت جدیدی در مدلسازی یا آموزش نبود. آنچه در مورد نتایج جالب توجه بود این بود که چنین ساختار آموزشی عمومی میتوانست تکنیکهای پیچیدهتر را در تعدادی از وظایف شکست دهد. هیچ نرمالسازی متنی پیچیدهای وجود نداشت، نیازی به سفارشیسازی معماری مدل یا دادههای آموزشی بر اساس هر معیار آزمایشی نبود، فقط دادههای پیشآموزش زیاد و توان محاسباتی فراوان وجود داشت.
در سالهای بعد، OpenAI با تمرکزی تکبعدی شروع به مقیاس دادن به این ایده کرد. معماری مدل تنها اندکی تغییر کرد. در طول چهار سال، OpenAI سه نسخه از GPT را منتشر کرد و به صورت زیر مقیاس داد:
- مدل GPT-1 که در سال ۲۰۱۸ منتشر شد، ۱۱۷ میلیون پارامتر داشت و روی ۱ میلیارد توکن آموزش دید.
- مدل GPT-2 که در سال ۲۰۱۹ منتشر شد، ۱.۵ میلیارد پارامتر داشت و روی بیش از ۱۰ میلیارد توکن آموزش دید.
- مدل GPT-3 که در سال ۲۰۲۰ منتشر شد، ۱۷۵ میلیارد پارامتر داشت و روی حدود نیم تریلیون توکن آموزش دید.
ساختار مدلسازی زبان هر یک از این مدلها را قادر ساخت تا متن تولید کنند، و توسعهدهندگان در OpenAI متوجه شدند که با هر جهش در مقیاس، کیفیت این خروجی مولد به طور قابل توجهی افزایش مییابد.
با GPT-1، قابلیتهای مولد مدل بیشتر محصول جانبی پیشآموزش آن بود و نه تمرکز اصلی. آنها مدل را با تنظیم دقیق آن با یک لایهٔ متراکم اضافی برای طبقهبندی ارزیابی کردند، همانطور که ما با RoBERTa در فصل قبل انجام دادیم.
با GPT-2، نویسندگان متوجه شدند که میتوان به مدل چند مثال از یک وظیفه را به عنوان پرامپت داد و بدون هیچگونه تنظیم دقیق، خروجی باکیفیتی تولید کرد. برای مثال، میتوانستید پرامپت زیر را به مدل بدهید تا ترجمهٔ فرانسوی کلمهٔ cheese (پنیر) را دریافت کنید:
Translate English to French:
sea otter => loutre de merpeppermint => menthe poivréeplush giraffe => peluche girafecheese =>
این نوع ساختار یادگیری چندنمونهای (few-shot learning) نامیده میشود، جایی که شما سعی میکنید مسئلهٔ جدیدی را تنها با تعداد انگشتشماری از مثالهای نظارتشده به مدل آموزش دهید — بسیار اندکتر از آنچه برای نزول گرادیان استاندارد لازم است.
با GPT-3، مثالها همیشه لازم نبودند. شما میتوانستید با یک توصیف متنی ساده از مسئله و ورودی به مدل پرامپت بدهید و اغلب نتایج باکیفیتی بگیرید:
Translate English to French:
cheese =>
مدل GPT-3 همچنان گرفتار مسائل بنیادینی بود که هنوز حل نشدهاند. مدلهای LLM اغلب «دچار توهم (hallucinate)» میشوند — خروجی آنها میتواند بدون هیچ نشانهای از وضعیت دقیق به کاملاً غلط تغییر مسیر دهد. آنها به نگارش پرامپت بسیار حساس هستند، به طوری که بازنویسیهای به ظاهر جزئی در پرامپت جهشهای بزرگ صعودی یا نزولی در عملکرد ایجاد میکند. و آنها نمیتوانند با مسائلی که به طور گسترده در دادههای آموزشی آنها مطرح نشدهاند، سازگار شوند.
با این حال، خروجی مولد GPT-3 به اندازهٔ کافی خوب بود که این مدل مبنایی برای ChatGPT شد — اولین مدل مولد گسترده و عمومی در دسترس مصرفکننده. در ماهها و سالهای بعد، ChatGPT سیل سرمایهگذاری و علاقه را برای ساخت LLMها و یافتن کاربردهای جدید برای آنها برانگیخت. در بخش بعدی، ما یک مدل مینیاتوری GPT از خودمان میسازیم تا بهتر درک کنیم که چنین مدلی چگونه کار میکند، چه کاری میتواند انجام دهد، و در کجا شکست میخورد.
آموزش یک مینیجیپیتی
Section titled “آموزش یک مینیجیپیتی”برای شروع پیشآموزش مینیجیپیتی (mini-GPT) خود، به دادههای متنی زیادی نیاز خواهیم داشت. مدل GPT-1 از یک مجموعه داده به نام BooksCorpus استفاده کرد که شامل تعدادی از کتابهای رایگان و خودناشر بود که بدون اجازهٔ صریح نویسندگان به مجموعه داده اضافه شده بودند. این مجموعه داده از آن زمان توسط ناشرانش حذف شده است.
ما از یک مجموعه دادهٔ پیشآموزش جدیدتر به نام «Colossal Clean Crawled Corpus» (C4) استفاده خواهیم کرد که در سال ۲۰۲۰ توسط گوگل منتشر شد. با حجم ۷۵۰ گیگابایت، این مجموعه بسیار بزرگتر از آن است که بتوانیم برای یک مثال کتاب به طور معقولی روی آن آموزش دهیم، بنابراین ما از کمتر از ۱٪ از کل پیکره استفاده خواهیم کرد.
بیایید با دانلود و استخراج دادههای خود شروع کنیم:
فهرست ۱۶.۱: دانلود بخشی از مجموعه دادهٔ C4
import kerasimport pathlib
extract_dir = keras.utils.get_file( fname="mini-c4", origin=( "https://hf.co/datasets/mattdangerw/mini-c4/resolve/main/mini-c4.zip" ), extract=True,)extract_dir = pathlib.Path(extract_dir) / "mini-c4"ما ۵۰ شارد (بخش) از دادههای متنی داریم که هر کدام حاوی حدود ۷۵ مگابایت متن خام است. هر سطر شامل سندی در این وبکاوی با نویسههای خط جدید اسکیپشده است. بیایید به یک سند در اولین شارد خود نگاه کنیم:
>>> with open(extract_dir / "shard0.txt", "r") as f:>>> print(f.readline().replace("\\n", "\n")[:100])ما برای اجرای پیشآموزش برای یک LLM، حتی یک مدل مینیاتوری مانند مدلی که در حال آموزش آن هستیم، نیاز به پیشپردازش دادههای زیادی خواهیم داشت. استفاده از یک روال توکنسازی سریع برای پیشپردازش اسناد منبع به توکنهای عدد صحیح میتواند کار ما را ساده کند.
ما از SentencePiece استفاده خواهیم کرد، کتابخانهای برای توکنسازی زیرکلمهای دادههای متنی. تکنیک واقعی توکنسازی همان توکنسازی کدگذاری جفتبایت است که در فصل ۱۴ خودمان ساختیم، اما این کتابخانه برای سرعت بالا به زبان C++ نوشته شده است و یک تابع detokenize() اضافه میکند که اعداد صحیح را به رشتهها معکوس کرده و آنها را به هم متصل مینماید. ما از یک واژگان از پیش ساختهشده با ۳۲,۰۰۰ اصطلاح واژگان استفاده خواهیم کرد که در فرمت خاص مورد نیاز کتابخانهٔ SentencePiece ذخیره شده است.
همانطور که در فصل گذشته دیدیم، میتوانیم از کتابخانهٔ KerasHub برای دسترسی به برخی توابع اضافی برای کار با مدلهای زبان بزرگ استفاده کنیم. کتابخانهٔ KerasHub کتابخانهٔ SentencePiece را به عنوان یک لایهٔ کراس کپسولهسازی میکند. بیایید آن را امتحان کنیم.
فهرست ۱۶.۲: دانلود یک واژگان SentencePiece و ساخت یک نمونه از توکنساز
import keras_hubimport numpy as np
vocabulary_file = keras.utils.get_file(    origin="https://hf.co/mattdangerw/spiece/resolve/main/vocabulary.proto",)tokenizer = keras_hub.tokenizers.SentencePieceTokenizer(vocabulary_file)
ما میتوانیم از این توکنساز برای نگاشت از متن به دنبالههای عددی به صورت دوطرفه استفاده کنیم:
>>> tokenizer.tokenize("The quick brown fox.")بیایید از این لایه برای توکنسازی متن ورودی خود استفاده کنیم و سپس از tf.data برای پنجرهبندی ورودی خود به دنبالههایی به طول ۲۵۶ استفاده نماییم.
هنگام آموزش GPT، توسعهدهندگان تصمیم گرفتند موارد را ساده نگه دارند و هیچ تلاشی برای جلوگیری از رخ دادن مرزهای سند در میانهٔ یک نمونه انجام ندهند. در عوض، آنها مرز سند را با یک توکن ویژهٔ <|endoftext|> علامتگذاری کردند. ما در اینجا نیز همین کار را انجام خواهیم داد. بار دیگر، ما از tf.data برای خط لولهٔ دادههای ورودی استفاده خواهیم کرد و با هر پشتیبانی آموزش میدهیم.
ما هر شارد فایل را به صورت جداگانه بارگذاری میکنیم و دادههای خروجی را در یک مجموعه دادهٔ واحد در هم میآمیزیم (interleave). این کار بارگذاری دادههای ما را سریع نگه میدارد، و نیازی به نگرانی در مورد تراز شدن متن در مرزهای نمونه نداریم — هر کدام مستقل هستند. با درهمآمیزی، هر پردازنده روی CPU ما میتواند یک فایل جداگانه را به طور همزمان بخواند و توکنسازی کند.
فهرست ۱۶.۳: پیشپردازش ورودی متنی برای پیشآموزش ترنسفورمر
import tensorflow as tf
batch_size = 64sequence_length = 256suffix = np.array([tokenizer.token_to_id("<|endoftext|>")])
def read_file(filename):    ds = tf.data.TextLineDataset(filename)    # Restores newlines    ds = ds.map(lambda x: tf.strings.regex_replace(x, r"\\n", "\n"))    # Tokenizes data    ds = ds.map(tokenizer, num_parallel_calls=8)    # Adds the <|endoftext|> token    return ds.map(lambda x: tf.concat([x, suffix], -1))
files = [str(file) for file in extract_dir.glob("*.txt")]ds = tf.data.Dataset.from_tensor_slices(files)# Combines our file shards into a single datasetds = ds.interleave(read_file, cycle_length=32, num_parallel_calls=32)# Windows tokens into even samples of 256 tokensds = ds.rebatch(sequence_length + 1, drop_remainder=True)# Splits labels, offset by oneds = ds.map(lambda x: (x[:-1], x[1:]))ds = ds.batch(batch_size).prefetch(8)همانطور که اولین بار در فصل ۸ انجام دادیم، خط لولهٔ tf.data خود را با فراخوانی prefetch() پایان میدهیم. این کار تضمین میکند که ما همیشه چند دستهٔ بارگذاریشده روی GPU و آماده برای مدل داشته باشیم.
ما ۵۸,۷۴۶ دسته داریم. اگر بخواهید میتوانید خودتان این را بشمارید — سطر ds.reduce(0, lambda c, _: c + 1) در سرتاسر کل مجموعه داده تکرار خواهد شد و یک شمارنده را افزایش میدهد. اما صرفاً توکنسازی مجموعه دادهای با این اندازه چند دقیقه روی یک CPU با سرعت معقول طول خواهد کشید.
با ۶۴ نمونه در هر دسته و ۲۵۶ توکن در هر نمونه، این کمی کمتر از یک میلیارد توکن داده است. بیایید ۵۰۰ دسته را به عنوان یک مجموعهٔ اعتبارسنجی سریع جدا کنیم، و آمادهٔ شروع پیشآموزش هستیم:
num_batches = 58746num_val_batches = 500num_train_batches = num_batches - num_val_batchesval_ds = ds.take(num_val_batches).repeat()train_ds = ds.skip(num_val_batches).repeat()ساخت مدل
Section titled “ساخت مدل”مدل اصلی GPT ترنسفورمر دنبالهبهدنبالهای را که در فصل قبل دیدیم سادهتر میکند. رویکرد GPT به جای اینکه مانند مدل ترجمهٔ ما یک دنبالهٔ مبدأ و یک دنبالهٔ هدف را با یک رمزگذار و یک رمزگشا دریافت کند، بخش رمزگذار را به طور کامل کنار میگذارد و تنها از رمزگشا استفاده مینماید. این بدان معناست که اطلاعات در یک دنباله فقط میتوانند از چپ به راست حرکت کنند.
این یک شرطبندی جالب از سوی توسعهدهندگان GPT بود. یک مدل فقط-رمزگشا (decoder-only) همچنان میتواند مسائل دنبالهبهدنباله مانند پاسخ به پرسشها را مدیریت کند. با این حال، به جای وارد کردن پرسش و پاسخ به عنوان ورودیهای جداگانه، باید هر دو را در یک دنبالهٔ واحد ترکیب کنیم تا آن را به مدلمان تغذیه نماییم. بنابراین، برخلاف ترنسفورمر اصلی، با توکنهای پرسش هیچ تفاوتی نسبت به توکنهای پاسخ رفتار نمیشود. همهٔ توکنها با مجموعه پارامترهای یکسانی در همان فضای نهان جاسازی میشوند.
پیامد دیگر این رویکرد این است که جریان اطلاعات، حتی برای دنبالههای ورودی، دیگر دوطرفه نیست. با داشتن یک ورودی، مانند «پایتخت فرانسه کجاست؟»، نمایش آموختهشدهٔ کلمهٔ «کجاست» نمیتواند در لایهٔ توجه به کلمات «پایتخت» و «فرانسه» توجه کند. این امر گویایی و قدرت بیان مدل را محدود میکند، اما از نظر سادگی پیشآموزش مزیت عظیمی دارد. ما نیازی به سرپرستی مجموعههای داده با جفتهای ورودی و خروجی نداریم؛ همه چیز میتواند یک دنبالهٔ واحد باشد. ما میتوانیم روی هر متنی که میتوانیم در اینترنت در مقیاسی عظیم بیابیم آموزش دهیم.
بیایید TransformerDecoder را از فصل ۱۵ کپی کنیم اما لایهٔ توجه متقاطع (cross-attention) را که به رمزگشا اجازه میداد به دنبالهٔ رمزگذار توجه کند حذف نماییم. ما همچنین یک تغییر جزئی ایجاد خواهیم کرد و بعد از بلوکهای توجه و پیشخور، دراپاوت (dropout) را اضافه میکنیم. در فصل ۱۵، ما فقط از یک لایهٔ ترنسفورمر واحد در رمزگذار و رمزگشای خود استفاده کردیم، بنابراین توانستیم تنها با استفاده از یک لایهٔ دراپاوت منفرد در انتهای کل مدل خود کار را پیش ببریم. برای مدل GPT خود، ما لایههای متعددی را روی هم خواهیم چید، بنابراین افزودن دراپاوت در هر لایهٔ رمزگشا برای جلوگیری از بیشبرازش بسیار مهم است.
فهرست ۱۶.۴: یک بلوک رمزگشای ترنسفورمر بدون توجه متقاطع
from keras import layers
class TransformerDecoder(keras.Layer):    def __init__(self, hidden_dim, intermediate_dim, num_heads):        super().__init__()        key_dim = hidden_dim // num_heads        # Self-attention layers        self.self_attention = layers.MultiHeadAttention(            num_heads, key_dim, dropout=0.1        )        self.self_attention_layernorm = layers.LayerNormalization()        # Feedforward layers        self.feed_forward_1 = layers.Dense(intermediate_dim, activation="relu")        self.feed_forward_2 = layers.Dense(hidden_dim)        self.feed_forward_layernorm = layers.LayerNormalization()        self.dropout = layers.Dropout(0.1)
    def call(self, inputs):        # Self-attention computation        residual = x = inputs        x = self.self_attention(query=x, key=x, value=x, use_causal_mask=True)        x = self.dropout(x)        x = x + residual        x = self.self_attention_layernorm(x)        # Feedforward computation        residual = x        x = self.feed_forward_1(x)        x = self.feed_forward_2(x)        x = self.dropout(x)        x = x + residual        x = self.feed_forward_layernorm(x)        return x
سپس، میتوانیم لایهٔ PositionalEmbedding را از فصل ۱۵ کپی کنیم. به یاد بیاورید که این لایه به ما روشی ساده برای یادگیری یک جاسازی برای هر موقعیت در یک دنباله و ترکیب آن با جاسازیهای توکن ما میدهد.
یک ترفند تمیز وجود دارد که میتوانیم در اینجا برای صرفهجویی در مقداری از حافظهٔ GPU به کار بگیریم. بزرگترین وزنها در یک مدل ترنسفورمر، جاسازیهای توکن ورودی و لایهٔ پیشبینی متراکم خروجی هستند زیرا آنها با فضای واژگان ما سروکار دارند. وزن جاسازی توکن دارای شکل (vocab_size, hidden_dim) برای جاسازی هر توکن ممکن است. نگاشت خروجی ما دارای شکل (hidden_dim, vocab_size) است تا یک پیشبینی ممیز شناور را برای هر توکن ممکن انجام دهد.
ما در واقع میتوانیم این دو ماتریس وزن را به یکدیگر گره بزنیم. برای محاسبهٔ پیشبینیهای نهایی مدلمان، وضعیتهای پنهان خود را در ترانهادهٔ ماتریس جاسازی توکن خود ضرب خواهیم کرد. شما میتوانید تصویر نهایی ما را به عنوان یک «جاسازی معکوس» در نظر بگیرید. این نگاشت از فضای پنهان به فضای توکن انجام میشود، در حالی که یک جاسازی از فضای توکن به فضای پنهان نگاشت میکند. معلوم میشود که استفاده از وزنهای یکسان برای این نگاشت ورودی و خروجی ایدهٔ خوبی است.
افزودن این به PositionalEmbedding ما ساده است؛ ما فقط یک آرگومان reverse را به متد call اضافه خواهیم کرد، که نگاشت را با ترانهادهٔ جاسازی توکن محاسبه میکند.
فهرست ۱۶.۵: یک لایهٔ جاسازی موقعیتی که میتواند یک جاسازی متنی را معکوس کند
from keras import ops
class PositionalEmbedding(keras.Layer):    def __init__(self, sequence_length, input_dim, output_dim):        super().__init__()        self.token_embeddings = layers.Embedding(input_dim, output_dim)        self.position_embeddings = layers.Embedding(sequence_length, output_dim)
    def call(self, inputs, reverse=False):        if reverse:            token_embeddings = self.token_embeddings.embeddings            return ops.matmul(inputs, ops.transpose(token_embeddings))        positions = ops.cumsum(ops.ones_like(inputs), axis=-1) - 1        embedded_tokens = self.token_embeddings(inputs)        embedded_positions = self.position_embeddings(positions)        return embedded_tokens + embedded_positions
بیایید مدلمان را بسازیم. ما هشت لایهٔ رمزگشا را در یک مدل «مینی» GPT پشته خواهیم کرد.
ما همچنین یک تنظیمات کراس به نام دقت مختلط (mixed precision) را روشن خواهیم کرد تا به آموزش سرعت ببخشیم. این به کراس اجازه میدهد تا با فدا کردن مقداری از دقت عددی، برخی از محاسبات مدل را بسیار سریعتر اجرا کند. در حال حاضر، این موضوع کمی مرموز باقی خواهد ماند، اما یک توضیح کامل در فصل ۱۸ منتظر شماست.
فهرست ۱۶.۶: ایجاد یک مدل تابعی مینیجیپیتی
# Enables mixed precision (see chapter 18)keras.config.set_dtype_policy("mixed_float16")
vocab_size = tokenizer.vocabulary_size()hidden_dim = 512intermediate_dim = 2056num_heads = 8num_layers = 8
inputs = keras.Input(shape=(None,), dtype="int32", name="inputs")embedding = PositionalEmbedding(sequence_length, vocab_size, hidden_dim)x = embedding(inputs)x = layers.LayerNormalization()(x)for i in range(num_layers):    x = TransformerDecoder(hidden_dim, intermediate_dim, num_heads)(x)outputs = embedding(x, reverse=True)mini_gpt = keras.Model(inputs, outputs)
این مدل ۴۱ میلیون پارامتر دارد، که برای مدلهای این کتاب بزرگ است اما در مقایسه با اکثر LLMهای امروزی که بین چند میلیارد تا تریلیونها پارامتر متغیر هستند، کاملاً کوچک است.
پیشآموزش مدل
Section titled “پیشآموزش مدل”آموزش یک ترنسفورمر بزرگ به حساس بودن و قلق داشتن مشهور است — مدل به مقداردهی اولیهٔ پارامترها و انتخاب بهینهساز حساس است. هنگامی که لایههای ترنسفورمر زیادی روی هم چیده میشوند، به راحتی ممکن است دچار انفجار گرادیانها شویم، جایی که پارامترها خیلی سریع بهروز میشوند و تابع زیان ما همگرا نمیشود. یک ترفند که به خوبی کار میکند این است که به صورت خطی در طول تعدادی گام گرمکردن (warmup) به یک نرخ یادگیری کامل برسیم، تا بهروزرسانیهای اولیهٔ ما روی پارامترهای مدلمان کوچک باشند. پیادهسازی این کار در کراس با یک LearningRateSchedule آسان است.
فهرست ۱۶.۷: تعریف یک برنامهٔ نرخ یادگیری سفارشی
class WarmupSchedule(keras.optimizers.schedules.LearningRateSchedule):    def __init__(self):        # Peak learning rate        self.rate = 2e-4        self.warmup_steps = 1_000.0
def __call__(self, step): step = ops.cast(step, dtype="float32") scale = ops.minimum(step / self.warmup_steps, 1.0) return self.rate * scaleمیتوانیم نمودار نرخ یادگیری خود را در طول زمان رسم کنیم تا مطمئن شویم مطابق انتظار ما است (شکل ۱۶.۲):
import matplotlib.pyplot as plt
schedule = WarmupSchedule()x = range(0, 5_000, 100)y = [ops.convert_to_numpy(schedule(step)) for step in x]plt.plot(x, y)plt.xlabel("Train Step")plt.ylabel("Learning Rate")plt.show()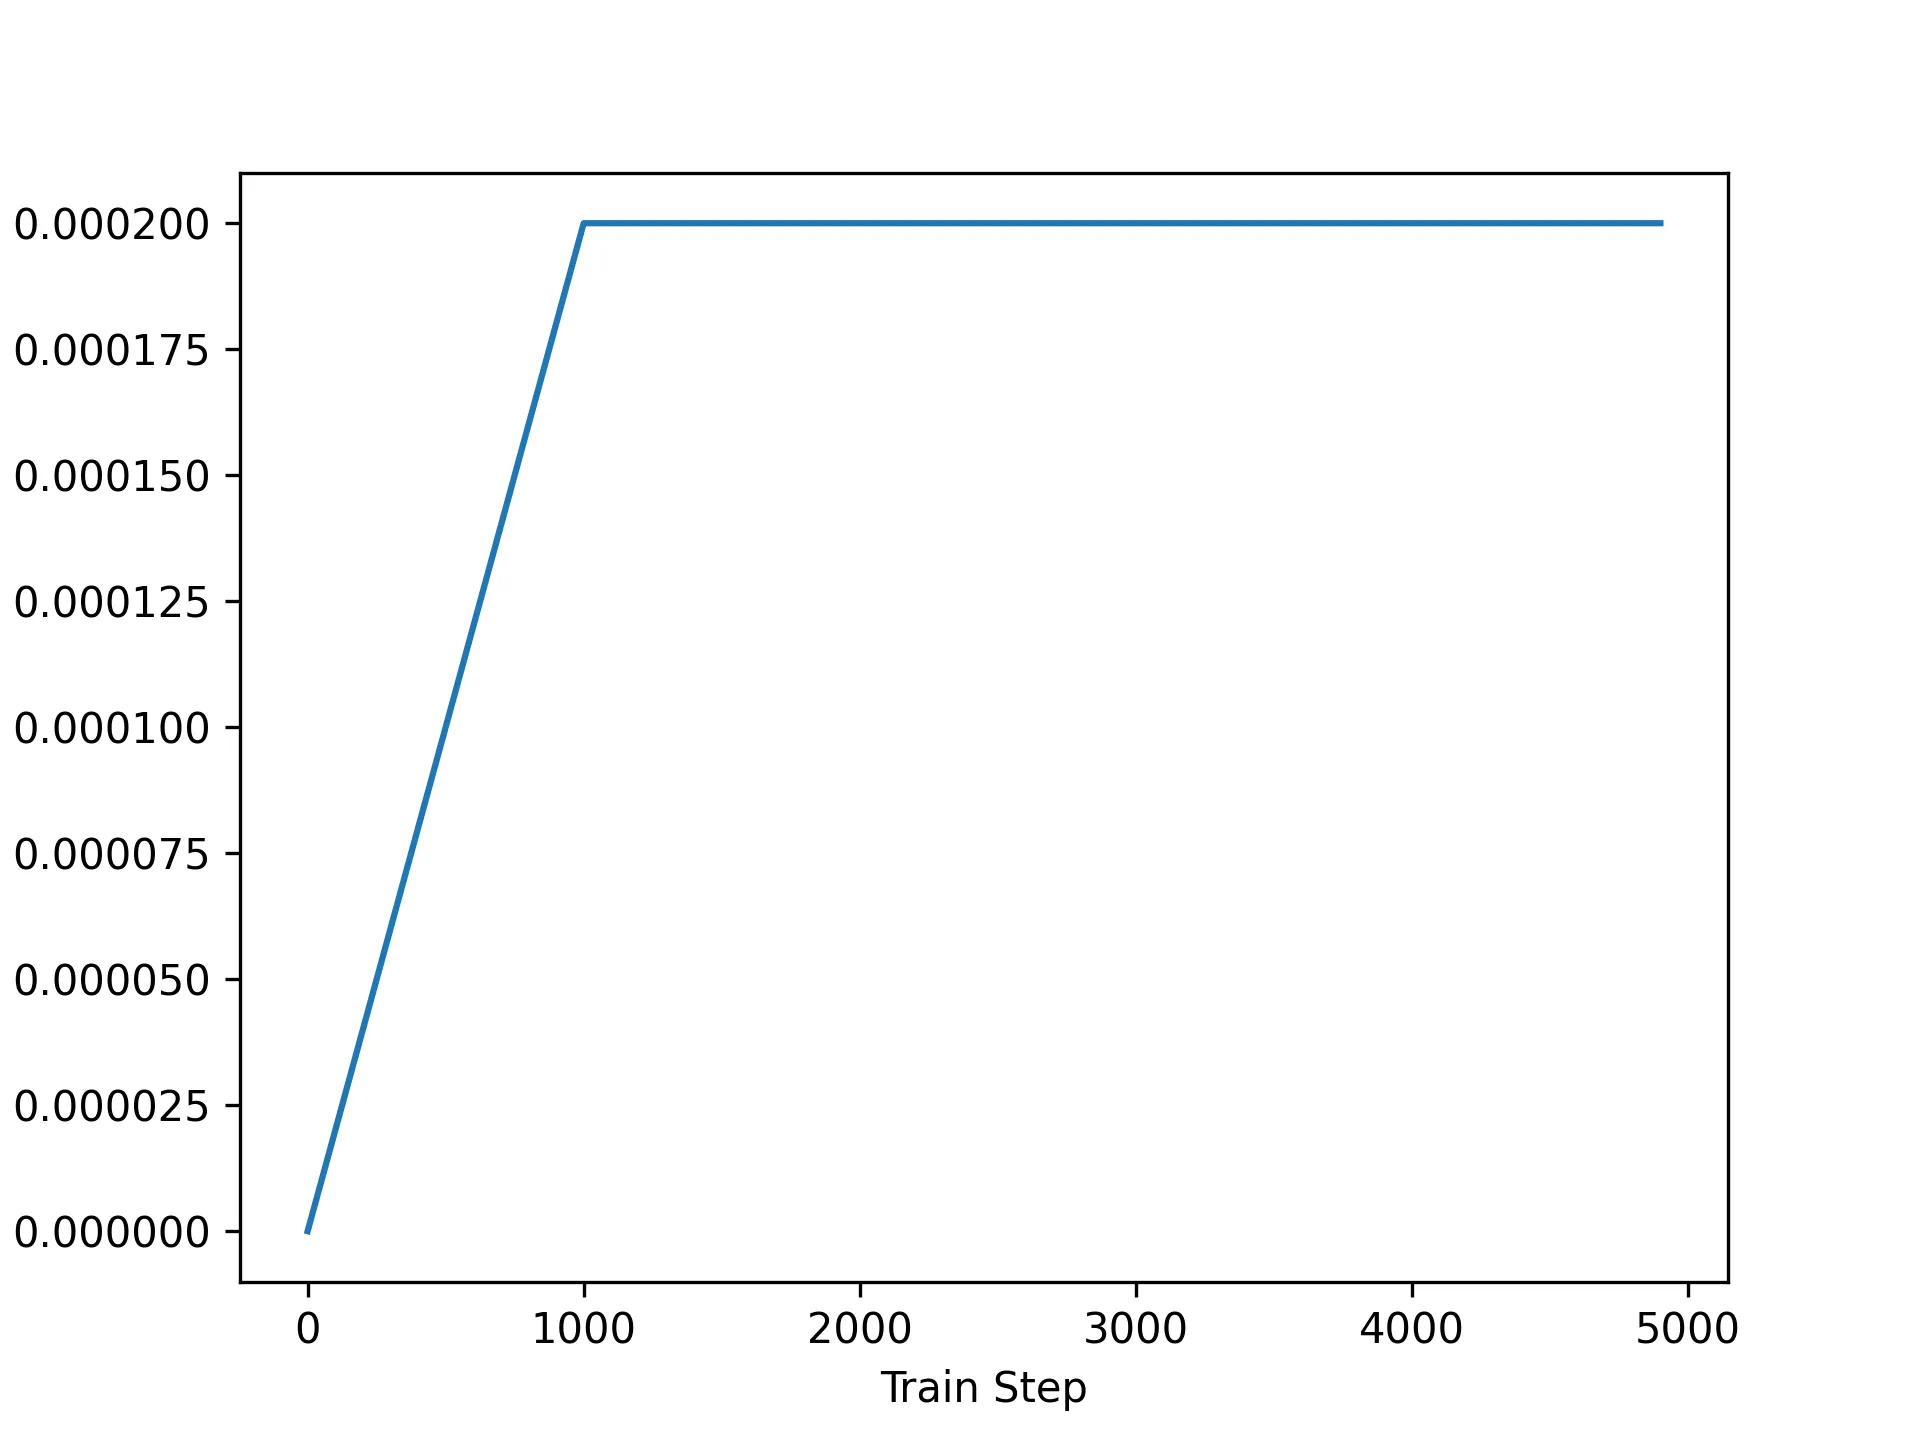
شکل ۱۶.۲: گرمکردن (Warmup) بهروزرسانیهای پارامترهای مدل را در ابتدای آموزش کوچکتر میکند و میتواند به پایداری کمک کند.
ما مدل خود را با استفاده از یک گذر روی ۱ میلیارد توکن خود، که در هشت دوره تقسیم شده است، آموزش خواهیم داد تا بتوانیم گاهی اوقات زیان و دقت مجموعهٔ اعتبارسنجی خود را بررسی کنیم.
ما در حال آموزش یک نسخهٔ مینیاتوری از GPT هستیم، با ۳ برابر پارامتر کمتر از GPT-1 و ۱۰۰ برابر گامهای کلی آموزش کمتر. اما با وجود اینکه آموزش این مدل دو مرتبهٔ بزرگی ارزانتر از کوچکترین مدل GPT است، این فراخوانی به fit() از نظر محاسباتی پرهزینهترین دور آموزش در کل کتاب خواهد بود. اگر هنگام خواندن کد را اجرا میکنید، کارها را به راه بیندازید و نفسی تازه کنید!
فهرست ۱۶.۸: آموزش مدل مینیجیپیتی
num_epochs = 8# Set these to a lower value if you don't want to wait for training.steps_per_epoch = num_train_batches // num_epochsvalidation_steps = num_val_batches
mini_gpt.compile( optimizer=keras.optimizers.Adam(schedule), loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=["accuracy"],)mini_gpt.fit( train_ds, validation_data=val_ds, epochs=num_epochs, steps_per_epoch=steps_per_epoch, validation_steps=validation_steps,)پس از آموزش، مدل ما میتواند توکن بعدی را در یک دنباله در حدود ۳۶٪ مواقع روی مجموعهٔ اعتبارسنجی ما پیشبینی کند، اگرچه چنین معیاری صرفاً یک ابتکار خام است.
توجه داشته باشید که مدل ما کمتر از حد لازم آموزش دیده است (undertrained است). زیان اعتبارسنجی ما پس از هر دوره همچنان کاهش خواهد یافت، که با توجه به اینکه صد برابر گامهای آموزشی کمتری نسبت به GPT-1 استفاده کردیم تعجبآور نیست. آموزش برای مدت طولانیتر ایدهٔ فوقالعادهای خواهد بود، اما ما هم به زمان و هم به پول برای پرداخت هزینهٔ محاسبات نیاز داریم.
بیایید با مدل مینیجیپیتی خود کار کنیم.
رمزگشایی مولد
Section titled “رمزگشایی مولد”برای نمونهبرداری از مقداری خروجی از مدل خود، میتوانیم رویکردی را دنبال کنیم که برای تولید متن شکسپیر یا ترجمههای اسپانیایی در فصل ۱۵ استفاده کردیم. ما یک پرامپت از توکنهای ثابت را به مدل تغذیه میکنیم. برای هر موقعیت در دنبالهٔ ورودی، مدل یک توزیع احتمال را روی کل واژگان برای توکن بعدی خروجی میدهد. با انتخاب محتملترین توکن بعدی در آخرین مکان، افزودن آن به دنبالهٔ خود، و سپس تکرار این فرایند، قادر خواهیم بود دنبالهٔ جدیدی را توکنبهتوکن تولید کنیم.
فهرست ۱۶.۹: یک تابع تولید ساده برای مدل مینیجیپیتی
def generate(prompt, max_length=64): tokens = list(ops.convert_to_numpy(tokenizer(prompt))) prompt_length = len(tokens) for _ in range(max_length - prompt_length): prediction = mini_gpt(ops.convert_to_numpy([tokens])) prediction = ops.convert_to_numpy(prediction[0, -1]) tokens.append(np.argmax(prediction).item()) return tokenizer.detokenize(tokens)بیایید این را با یک پرامپت متنی امتحان کنیم:
>>> prompt = "A piece of advice">>> generate(prompt)اولین چیزی که هنگام اجرای این کد متوجه خواهید شد این است که تکمیل آن چند دقیقه طول میکشد. این کمی گیجکننده است. ما در طول آموزش حدود ۲۰۰,۰۰۰ توکن در ثانیه را روی سختافزار مرجع خود پیشبینی میکردیم. حلقهٔ مولد ممکن است زمان اضافه کند، اما یک دقیقه تأخیر بسیار کند است. چه اتفاقی افتاد؟ بزرگترین دلیل کندی ما، حداقل در پشتیبانهای Jax و TensorFlow، این است که ما در حال اجرای یک محاسبات کامپایلنشده هستیم.
هر بار که fit() یا predict() را اجرا میکنید، کراس محاسباتی را که روی هر دسته از دادهها اجرا میشود کامپایل مینماید. تمام keras.ops استفادهشده از پایتون بیرون کشیده میشوند و به شدت توسط چارچوب پشتیبان بهینهسازی خواهند شد. این کار برای یک دسته کند است اما برای هر فراخوانی بعدی به طرز چشمگیری سریعتر است. با این حال، هنگامی که ما مستقیماً مدل را همانطور که قبلاً انجام دادیم فراخوانی میکنیم، چارچوب پشتیبان باید گذر رو به جلو را در هر مرحله به صورت زنده و بهینهنشده اجرا کند.
راهحل آسان در اینجا تکیه بر predict() است. با predict()، کراس کامپایل را برای ما مدیریت خواهد کرد، اما یک نکتهٔ مهم وجود دارد که باید مراقب آن بود. هنگامی که TensorFlow یا Jax تابعی را کامپایل میکند، این کار را برای یک شکل ورودی خاص انجام میدهد. با یک شکل شناختهشده، پشتیبان میتواند برای سختافزار خاص بهینهسازی کند و دقیقاً بداند چند دستورالعمل پردازندهٔ منفرد یک عملیات تانسور را تشکیل میدهند. اما در تابع تولید ما، مدل خود را با دنبالهای فراخوانی میکنیم که پس از هر پیشبینی شکل آن تغییر میکند. این امر هر بار که predict() را فراخوانی میکنیم، کامپایل مجدد را آغاز میکند.
در عوض، اگر ورودی خود را حاشیهگذاری کنیم تا دنبالهٔ ما همیشه طول یکسانی داشته باشد، میتوانیم از کامپایل مجدد تابع predict() جلوگیری کنیم. بیایید آن را امتحان کنیم.
فهرست ۱۶.۱۰: یک تابع تولید کامپایلشده برای مدل مینیجیپیتی
def compiled_generate(prompt, max_length=64): tokens = list(ops.convert_to_numpy(tokenizer(prompt))) prompt_length = len(tokens) # Pads tokens to the full sequence length tokens = tokens + [0] * (max_length - prompt_length) for i in range(prompt_length, max_length): prediction = mini_gpt.predict(np.array([tokens]), verbose=0) prediction = prediction[0, i - 1] tokens[i] = np.argmax(prediction).item() return tokenizer.detokenize(tokens)بیایید ببینیم این تابع جدید چقدر سریع است:
>>> import timeit>>> tries = 10>>> timeit.timeit(lambda: compiled_generate(prompt), number=tries) / triesفراخوانی تولید ما با کامپایل شدن، از چند دقیقه به کمتر از یک ثانیه رسید. این یک بهبود قابل توجه است.
استراتژیهای نمونهبرداری
Section titled “استراتژیهای نمونهبرداری”مشکل آشکار دیگر با خروجی مولد ما این است که مدل ما اغلب خود را تکرار میکند. در دور آموزش خاص ما، مدل گروه کلمات «get a sense of what you are doing» را بارها و بارها تکرار میکند.
این چندان یک باگ نیست بلکه نتیجهٔ مستقیم هدف آموزشی ما است. مدل ما در تلاش است تا محتملترین توکن بعدی را در یک دنباله در میان حدود یک میلیارد کلمه در موضوعات بسیار بسیار زیاد پیشبینی کند. اگر انتخاب واضحی برای اینکه یک دنباله از متن در ادامه به کجا باید برود وجود نداشته باشد، یک استراتژی مؤثر حدس زدن کلمات رایج یا الگوهای تکراری کلمات است. جای تعجب نیست که مدل ما یاد میگیرد این کار را در طول آموزش تقریباً بلافاصله انجام دهد. اگر میخواستید آموزش مدل ما را خیلی زود متوقف کنید، احتمالاً کلمهٔ "the" را به طور مداوم تولید میکرد، زیرا "the" رایجترین کلمه در زبان انگلیسی است.
در طول حلقهٔ مولد خود، ما همیشه محتملترین توکن پیشبینیشده را در خروجی مدلمان انتخاب کردهایم. اما خروجی ما صرفاً یک توکن پیشبینیشدهٔ منفرد نیست؛ این یک توزیع احتمال در میان تمام ۳۲,۰۰۰ توکن در واژگان ما است.
استفاده از محتملترین خروجی در هر مرحلهٔ تولید جستجوی حریصانه (greedy search) نامیده میشود. این سرراستترین رویکرد برای استفاده از پیشبینیهای مدل است، اما به سختی تنها رویکرد ممکن است. اگر به جای آن مقداری تصادفی بودن به فرایند اضافه کنیم، میتوانیم توزیع احتمال آموختهشده توسط مدل را به طور گستردهتری کاوش کنیم. این میتواند مانع از گیر افتادن ما در حلقههایی از دنبالههای توکن با احتمال بالا شود.
بیایید این را امتحان کنیم. میتوانیم با بازسازی تابع تولید خود شروع کنیم تا بتوانیم تابعی را ارسال کنیم که از پیشبینیهای یک مدل به انتخابی برای توکن بعدی نگاشت میکند. ما این را استراتژی نمونهبرداری (sampling strategy) خود مینامیم:
def compiled_generate(prompt, sample_fn, max_length=64): tokens = list(ops.convert_to_numpy(tokenizer(prompt))) prompt_length = len(tokens) tokens = tokens + [0] * (max_length - prompt_length) for i in range(prompt_length, max_length): prediction = mini_gpt.predict(np.array([tokens]), verbose=0) prediction = prediction[0, i - 1] next_token = ops.convert_to_numpy(sample_fn(prediction)) tokens[i] = np.array(next_token).item() return tokenizer.detokenize(tokens)اکنون میتوانیم جستجوی حریصانهٔ خود را به عنوان یک تابع ساده بنویسیم که به compiled_generate() ارسال میکنیم:
def greedy_search(preds):    return ops.argmax(preds)
compiled_generate(prompt, greedy_search)خروجیهای ترنسفورمر یک توزیع دستهای را تعریف میکنند که در آن هر توکن احتمال معینی برای خروجی داده شدن در هر گام زمانی دارد. به جای اینکه فقط محتملترین توکن را انتخاب کنیم، میتوانیم مستقیماً از این توزیع نمونهبرداری نماییم. متد keras.random.categorical() پیشبینیهای ما را از یک تابع سافتمکس عبور میدهد تا یک توزیع احتمال به دست آورد و سپس به طور تصادفی از آن نمونهبرداری میکند. بیایید آن را امتحان کنیم:
def random_sample(preds, temperature=1.0): preds = preds / temperature return keras.random.categorical(preds[None, :], num_samples=1)[0]>>> compiled_generate(prompt, random_sample)خروجیهای ما متنوعتر هستند، و مدل دیگر در حلقهها گیر نمیافتد. اما نمونهبرداری ما اکنون بیش از حد در حال کاوش است؛ خروجی بدون هیچ پیوستگی به طرز وحشیانهای به این سو و آن سو میپرد.
متوجه خواهید شد که ما پارامتری به نام temperature (دما) را اضافه کردیم. میتوانیم از این پارامتر برای تیزتر کردن یا گستردهتر کردن توزیع احتمال خود استفاده کنیم تا نمونهبرداری ما توزیع ما را کمتر یا بیشتر کاوش کند.
اگر دمای پایینی را ارسال کنیم، همهٔ لاجیتها را قبل از تابع سافتمکس بزرگتر خواهیم کرد، که محتملترین خروجی ما را حتی محتملتر میکند. اگر دمای بالایی را ارسال کنیم، لاجیتهای ما قبل از سافتمکس کوچکتر خواهند بود، و توزیع احتمال ما پراکندهتر خواهد شد. بیایید این را چند بار امتحان کنیم تا ببینیم چگونه بر نمونهبرداری ما تأثیر میگذارد:
>>> from functools import partial>>> compiled_generate(prompt, partial(random_sample, temperature=2.0))در یک دمای بالا، خروجیهای ما دیگر شبیه به انگلیسی نیستند و روی توکنهای به ظاهر تصادفی مستقر میشوند. در یک دمای پایین، رفتار مدل ما شروع به شباهت به جستجوی حریصانه میکند و الگوهای خاصی از متن را بارها و بارها تکرار مینماید.
یکی دیگر از تکنیکهای متداول برای شکل دادن به توزیع ما، محدود کردن نمونهبرداری ما به مجموعهای از محتملترین توکنها است. این کار نمونهبرداری top-k نامیده میشود، که در آن K تعداد کاندیداهایی است که باید کاوش کنید. شکل ۱۶.۳ نشان میدهد که چگونه نمونهبرداری top-k حد وسطی را بین رویکردهای حریصانه و تصادفی ایجاد میکند.
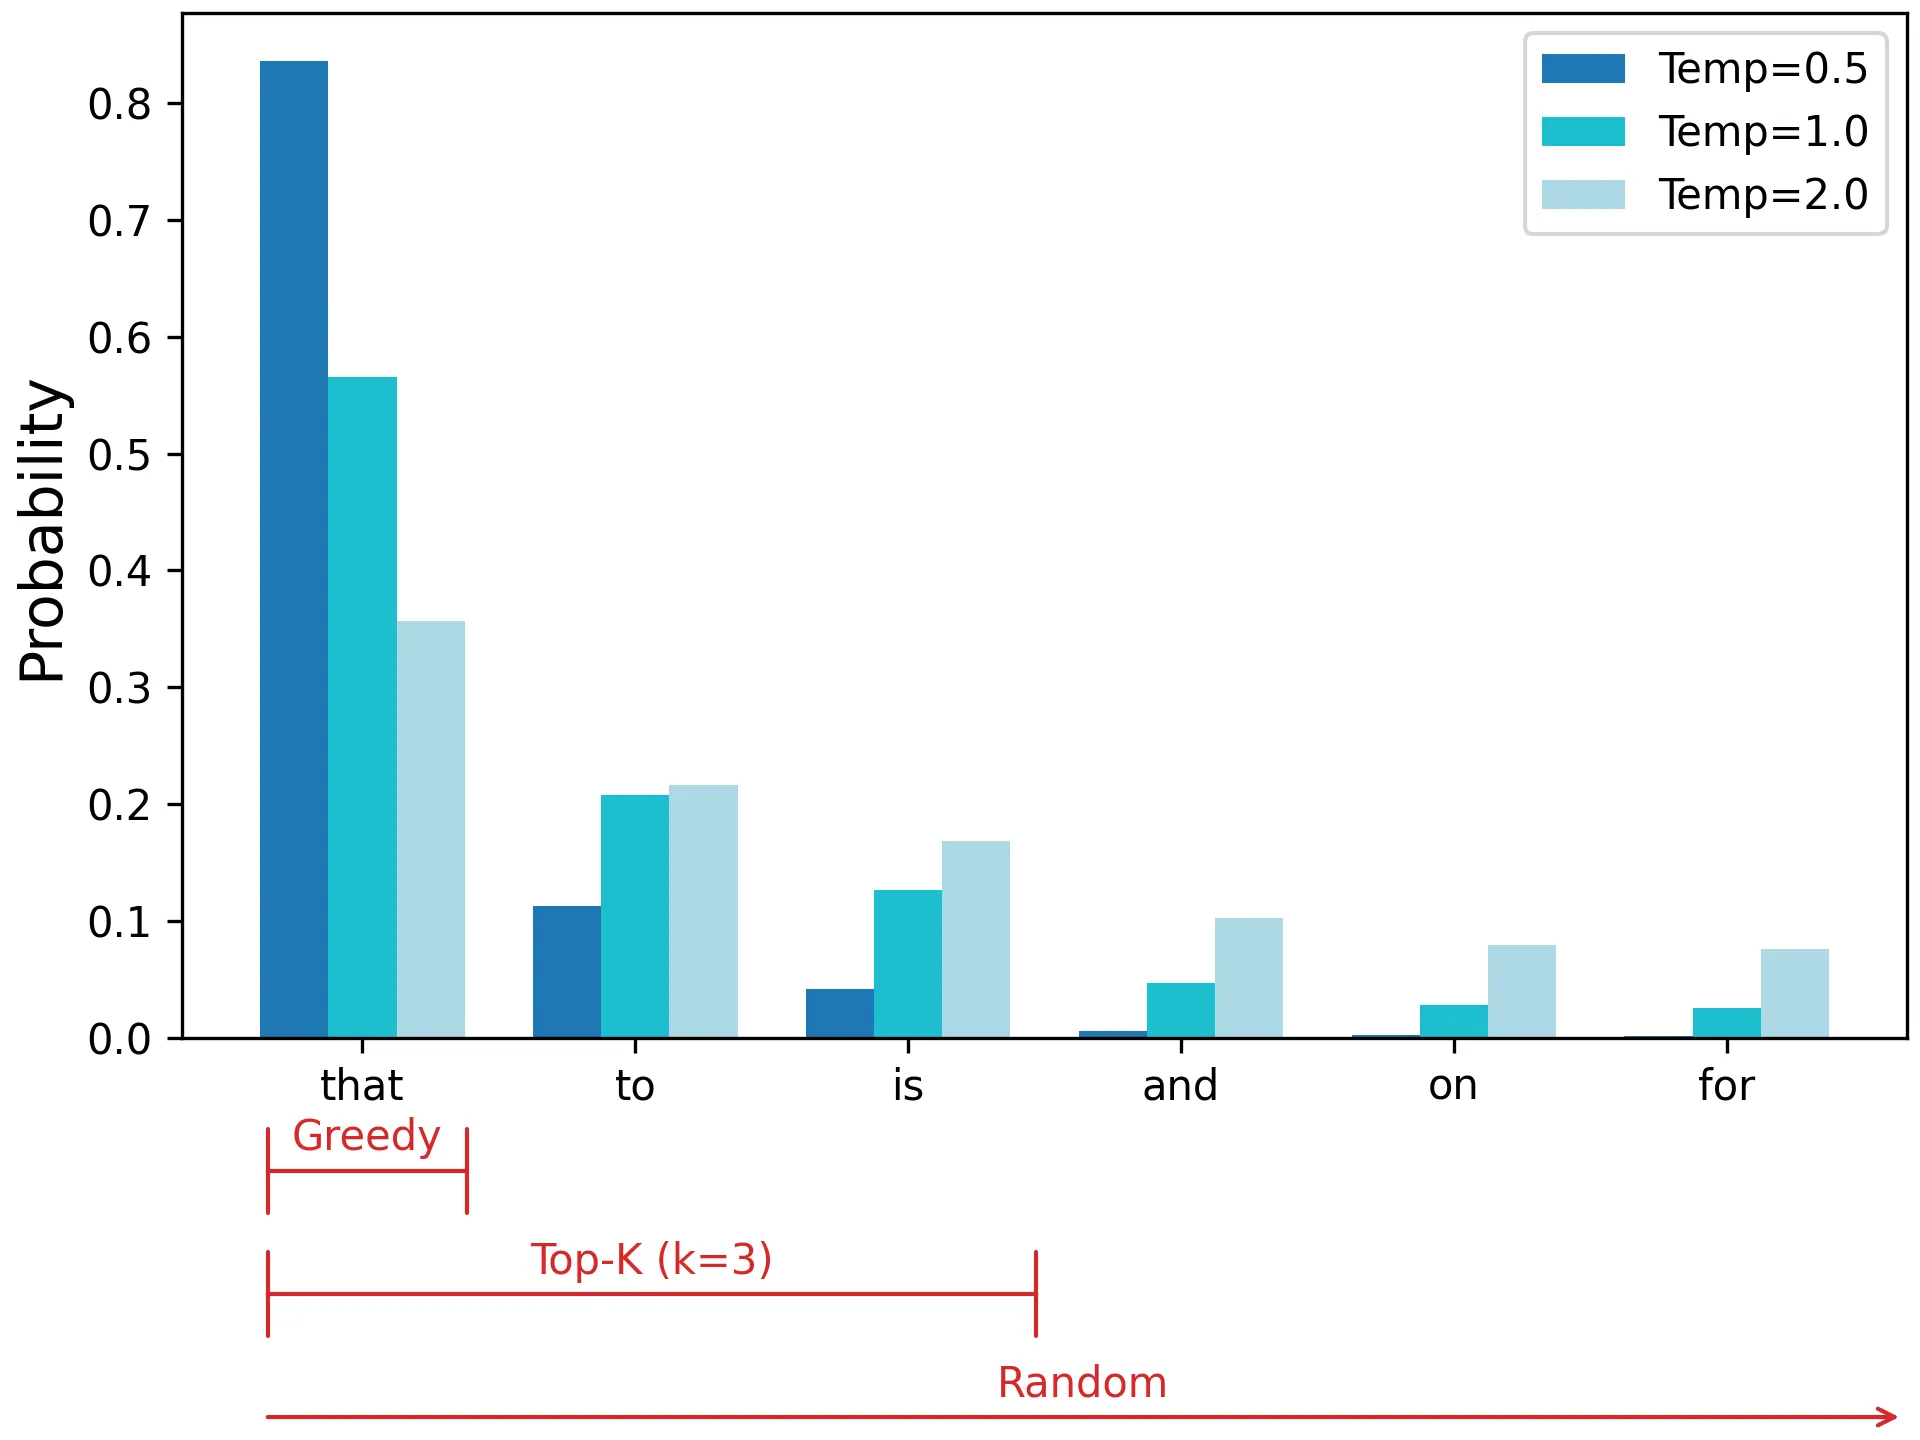
شکل ۱۶.۳: استراتژیهای نمونهبرداری حریصانه، top-k و تصادفی روی همان توزیع احتمال نشان داده شدهاند
بیایید این را در کد امتحان کنیم. ما میتوانیم از keras.ops.top_k برای یافتن K عنصر برتر یک آرایه استفاده کنیم:
def top_k(preds, k=5, temperature=1.0): preds = preds / temperature top_preds, top_indices = ops.top_k(preds, k=k, sorted=False) choice = keras.random.categorical(top_preds[None, :], num_samples=1)[0] return ops.take_along_axis(top_indices, choice, axis=-1)ما میتوانیم چند تغییر مختلف از top-k را امتحان کنیم تا ببینیم چگونه بر نمونهبرداری تأثیر میگذارد:
>>> compiled_generate(prompt, partial(top_k, k=5))ارسال یک حد آستانهٔ top-k با نمونهبرداری دما متفاوت است. ارسال دمای پایین، توکنهای محتمل را محتملتر میکند، اما هیچ توکنی را رد نمیکند. نمونهبرداری top-k احتمال هر چیزی خارج از K کاندیدا را صفر میکند. شما میتوانید این دو را ترکیب کنید، برای مثال، نمونهبرداری از پنج کاندیدای برتر با دمای 0.5:
>>> compiled_generate(prompt, partial(top_k, k=5, temperature=0.5))یک استراتژی نمونهبرداری یک کنترل مهم در هنگام تولید متن است، و رویکردهای بسیار بیشتری وجود دارد. برای مثال، جستجوی باریکهای (beam search) تکنیکی است که با نگه داشتن تعداد ثابتی از «باریکهها» (زنجیرههای مختلف توکنهای پیشبینیشده) برای کاوش در هر گام زمانی، زنجیرههای متعددی از توکنهای پیشبینیشده را به صورت مکاشفهای بررسی میکند.
با نمونهبرداری top-k، مدل ما چیزی نزدیکتر به متن انگلیسی پذیرفتنی تولید میکند، اما فایدهٔ آشکار چندانی برای چنین خروجی وجود ندارد. این با نتایج GPT-1 مطابقت دارد. برای مقالهٔ اولیهٔ GPT، خروجی تولیدشده بیشتر یک کنجکاوی بود، و نتایج پیشرفته تنها با تنظیم دقیق مدلهای طبقهبندی به دست آمد. مینیجیپیتی ما بسیار کمتر از GPT-1 آموزش دیده است.
برای رسیدن به مقیاس LLMهای مولد امروزی، باید تعداد پارامترهای خود را حداقل ۱۰۰ برابر و تعداد مراحل آموزش خود را حداقل ۱,۰۰۰ برابر افزایش دهیم. اگر این کار را میکردیم، همان جهشها در کیفیت را که توسط OpenAI با GPT مشاهده شد میدیدیم. و ما میتوانستیم این کار را انجام دهیم! دستورالعمل آموزشی که قبلاً استفاده کردیم دقیقاً همان طرح اولیهای است که امروزه توسط همهٔ افرادی که LLMها را آموزش میدهند استفاده میشود. تنها بخشهای مفقود، یک بودجهٔ محاسباتی بسیار بزرگ و برخی ترفندها برای آموزش روی چندین ماشین هستند که در فصل ۱۸ پوشش خواهیم داد.
برای یک رویکرد عملیتر، ما به استفاده از یک مدل پیشآموزشدیده منتقل خواهیم شد. این به ما اجازه میدهد رفتار یک LLM را در مقیاس امروزی بررسی کنیم.
استفاده از یک LLM پیشآموزشدیده
Section titled “استفاده از یک LLM پیشآموزشدیده”اکنون که یک مدل زبان کوچک را از ابتدا آموزش دادیم، بیایید استفاده از یک مدل پیشآموزشدیدهٔ یک میلیارد پارامتری را امتحان کنیم و ببینیم چه کارهایی میتواند انجام دهد. با توجه به اینکه پیشآموزش یک ترنسفورمر چقدر میتواند به طرز سرسامآوری گران باشد، بیشتر صنعت پیرامون استفاده از مدلهای پیشآموزشدیدهای که توسط فهرست نسبتاً کوتاهی از شرکتها توسعه یافتهاند متمرکز شده است. این صرفاً یک دغدغهٔ هزینه نیست، بلکه یک دغدغهٔ زیستمحیطی نیز هست — آموزش مدلهای مولد اکنون درصد بزرگی از کل مصرف برق مراکز دادهٔ شرکتهای بزرگ فناوری را تشکیل میدهد.
متا برخی دادههای زیستمحیطی را در مورد Llama 2، یک LLM که در سال ۲۰۲۳ منتشر کرد، به اشتراک گذاشت. این مدل به میزان مناسبی کوچکتر از GPT-3 است، اما برای آموزش به حدود ۱.۳ میلیون کیلووات ساعت برق نیاز داشت — یعنی مصرف برق روزانهٔ حدود ۴۵,۰۰۰ خانوار آمریکایی. اگر هر سازمانی که از یک LLM استفاده میکند خودش پیشآموزش را اجرا میکرد، مقیاس مصرف انرژی درصد قابل توجهی از مصرف انرژی جهانی را تشکیل میداد.
بیایید با یک مدل مولد پیشآموزشدیده از گوگل به نام گما (Gemma) کار کنیم. ما از نسخهٔ سوم مدل Gemma استفاده خواهیم کرد که در سال ۲۰۲۵ برای عموم منتشر شد. برای در دسترس نگه داشتن مثالهای این کتاب، ما از کوچکترین نسخهٔ در دسترس Gemma استفاده خواهیم کرد که دقیقاً حدود ۱ میلیارد پارامتر دارد. این مدل «کوچک» روی تقریباً ۲ تریلیون توکن از دادههای پیشآموزش آموزش دیده است — ۲۰۰۰ برابر توکنهای بیشتر نسبت به مینیجیپیتی که ما به تازگی آموزش دادیم!
تولید متن با مدل گما
Section titled “تولید متن با مدل گما”برای بارگذاری این مدل پیشآموزشدیده، میتوانیم مانند فصلهای قبل از KerasHub استفاده کنیم.
فهرست ۱۶.۱۱: ساخت یک نمونه از LLM پیشآموزشدیده با KerasHub
gemma_lm = keras_hub.models.CausalLM.from_preset( "gemma3_1b", dtype="float32",)تسک CausalLM نمونهٔ دیگری از API تسک سطح بالا است، بسیار شبیه به تسکهای ImageClassifier و ImageSegmenter که پیشتر در این کتاب استفاده کردیم. تسک CausalLM یک توکنساز و یک معماری به درستی مقداردهیشده را در یک مدل واحد کراس ترکیب میکند. کتابخانهٔ KerasHub وزنهای Gemma را در یک معماری به درستی مقداردهیشده بارگذاری کرده و یک توکنساز منطبق را برای وزنهای پیشآموزشدیده بارگذاری مینماید.
بیایید نگاهی به خلاصهٔ مدل Gemma بیندازیم:
>>> gemma_lm.summary()به جای اینکه خودمان یک روال تولید را پیادهسازی کنیم، میتوانیم با استفاده از تابع generate() که به عنوان بخشی از کلاس CausalLM ارائه میشود، کارمان را ساده کنیم. این تابع generate() میتواند با استراتژیهای نمونهبرداری مختلف، همانطور که در بخش قبل بررسی کردیم، کامپایل شود:
>>> gemma_lm.compile(sampler="greedy")>>> gemma_lm.generate("A piece of advice", max_length=40)ما میتوانیم فوراً متوجه چند چیز شویم. اولاً، خروجی بسیار منسجمتر از مدل mini-GPT ما است. تشخیص این متن از بخش زیادی از دادههای آموزشی در مجموعه دادهٔ C4 دشوار خواهد بود. ثانیاً، خروجی هنوز چندان مفید نیست. مدل متنی نسبتاً پذیرفتنی تولید میکند، اما آنچه میتوانید با آن انجام دهید نامشخص است.
همانطور که در مثال mini-GPT دیدیم، این چندان یک باگ نیست بلکه نتیجهٔ هدف پیشآموزش ما است. مدل Gemma با همان هدف «حدس زدن کلمهٔ بعدی» که برای mini-GPT استفاده کردیم آموزش داده شد، به این معنی که عملاً یک تکمیل خودکار لوکس برای اینترنت است. این مدل صرفاً محتملترین کلمه را در دنبالهٔ منفرد خود به طور مداوم تولید میکند، گویی پرامپت شما قطعهای از متن است که در یک سند تصادفی در وب پیدا شده است.
یک راه برای تغییر خروجی ما این است که به مدل یک ورودی طولانیتر پرامپت بدهیم که مشخص کند به دنبال چه نوع خروجی هستیم. برای مثال، اگر به مدل Gemma با دو جملهٔ آغازین یک دستور پخت براونی پرامپت بدهیم، خروجی مفیدتری دریافت میکنیم:
>>> gemma_lm.generate(>>> "The following brownie recipe is easy to make in just a few ">>> "steps.\n\nYou can start by",>>> max_length=40,>>> )اگرچه هنگام کار با مدلی که میتواند «حرف بزند» وسوسهانگیز است که تصور کنیم پرامپت ما را به نوعی روش مکالمهای و انسانی تفسیر میکند، اما هیچ چیزی از این دست در اینجا رخ نمیدهد. ما فقط پرامپتی ساختهایم که برای آن یک دستور پخت واقعی براونی، ادامهٔ محتملتری نسبت به تقلید از کاربری است که در یک فروم درخواست کمک برای شیرینیپزی دارد.
شما میتوانید در ساخت پرامپتها بسیار فراتر بروید. ممکن است با دستورالعملهای زبان طبیعی نقشی را که قرار است پر کند به مدل پرامپت بدهید، برای مثال: "You are a large language model that gives short, helpful answers to people's questions." یا ممکن است به مدل پرامپتی حاوی فهرست بلندی از موضوعات مضر تغذیه کنید که نباید در هیچ پاسخ تولیدشدهای گنجانده شوند.
اگر همهٔ اینها کمی سلیقهای و کنترل آن دشوار به نظر میرسد، این ارزیابی درستی است. تلاش برای سر زدن به بخشهای مختلف توزیع یک مدل از طریق پرامپتنویسی اغلب مفید است، اما پیشبینی اینکه یک مدل چگونه به یک پرامپت مشخص پاسخ خواهد داد بسیار دشوار است.
مشکل مستندشدهٔ دیگری که LLMها با آن مواجه هستند توهمات (hallucinations) است. یک مدل همیشه چیزی خواهد گفت — همیشه یک توکن بعدیِ محتملترین برای یک دنبالهٔ معین وجود دارد. پیدا کردن مکانهایی در توزیع LLM ما که هیچ اساسی در واقعیت ندارند آسان است:
>>> gemma_lm.generate(>>> "Tell me about the 542nd president of the United States.",>>> max_length=40,>>> )البته، این کاملاً بیمعنی و مهمل است، اما مدل نتوانست راه محتملتری برای تکمیل این پرامپت پیدا کند.
توهمات و خروجیهای غیرقابل کنترل مشکلات بنیادین در مدلهای زبان هستند. اگر راهحل جادویی وجود داشته باشد، ما هنوز آن را پیدا نکردهایم. با این حال، رویکردی که کمک شایانی میکند این است که یک مدل را با مثالهایی از انواع خاصی از خروجیهای مولد که مایل به داشتن آنها هستید، بیشتر تنظیم دقیق کنید.
در مورد خاصِ تمایل به ساخت یک ربات گفتگو (chatbot) که بتواند دستورالعملها را دنبال کند، این نوع آموزش تنظیم دقیق دستوری (instruction fine-tuning) نامیده میشود. بیایید مقداری تنظیم دقیق دستوری را با Gemma امتحان کنیم تا آن را به عنوان یک همراه گفتگو بسیار مفیدتر کنیم.
تنظیم دقیق دستوری
Section titled “تنظیم دقیق دستوری”تنظیم دقیق دستوری شامل تغذیهٔ جفتهای ورودی/خروجی به مدل است — یک دستورالعمل کاربر که به دنبال آن یک پاسخ مدل میآید. ما اینها را در یک دنبالهٔ واحد ترکیب میکنیم که تبدیل به دادههای آموزشی جدید برای مدل میشود. برای اینکه در طول آموزش مشخص شود چه زمانی یک دستورالعمل یا پاسخ پایان مییابد، میتوانیم نشانگرهای ویژهای مانند "[instruction]" و "[response]" را مستقیماً به دنبالهٔ ترکیبی اضافه کنیم. نشانهگذاری دقیق اهمیت چندانی نخواهد داشت تا زمانی که ثابت و یکدست باشد.
ما میتوانیم از دنبالهٔ ترکیبی به عنوان دادههای آموزشی معمول، با همان زیان «حدس زدن کلمهٔ بعدی» که برای پیشآموزش یک LLM استفاده کردیم، استفاده کنیم. با انجام آموزش بیشتر با مثالهایی شامل پاسخهای مطلوب، ما اساساً خروجی مدل را در جهتی که میخواهیم خم میکنیم. ما در اینجا فضای نهانی را برای زبان یاد نخواهیم گرفت؛ این کار قبلاً روی تریلیونها توکن پیشآموزش انجام شده است. ما صرفاً نمایش آموختهشده را اندکی هل میدهیم تا لحن و محتوای خروجی را کنترل کنیم.
برای شروع، به یک مجموعه داده از جفتهای دستورالعمل-پاسخ نیاز خواهیم داشت. آموزش رباتهای گفتگو موضوع داغی است، بنابراین مجموعههای دادهٔ زیادی به طور خاص برای این منظور ساخته شدهاند. ما از مجموعه دادهای استفاده خواهیم کرد که توسط شرکت Databricks عمومی شده است. کارکنان این شرکت در ایجاد یک مجموعه داده از ۱۵,۰۰۰ دستورالعمل و پاسخهای دستنویس مشارکت کردند. بیایید آن را دانلود کنیم و دادهها را در یک دنبالهٔ واحد به هم متصل نماییم.
فهرست ۱۶.۱۲: بارگذاری یک مجموعه دادهٔ تنظیم دقیق دستوری
import json
PROMPT_TEMPLATE = """"[instruction]\n{}[end]\n[response]\n"""RESPONSE_TEMPLATE = """{}[end]"""
dataset_path = keras.utils.get_file(    origin=(        "https://hf.co/datasets/databricks/databricks-dolly-15k/"        "resolve/main/databricks-dolly-15k.jsonl"    ),)data = {"prompts": [], "responses": []}with open(dataset_path) as file:    for line in file:        features = json.loads(line)        if features["context"]:            continue        data["prompts"].append(PROMPT_TEMPLATE.format(features["instruction"]))        data["responses"].append(RESPONSE_TEMPLATE.format(features["response"]))
توجه داشته باشید که برخی از مثالها دارای زمینهٔ اضافی هستند — اطلاعات متنی مرتبط با دستورالعمل. برای ساده نگه داشتن امور در حال حاضر، ما آن مثالها را کنار میگذاریم.
بیایید به یک عنصر منفرد در مجموعه دادهٔ خود نگاهی بیندازیم:
>>> data["prompts"][0]قالب پرامپت ما ساختاری قابل پیشبینی به مثالهای ما میدهد. اگرچه Gemma یک مدل دنبالهبهدنباله مانند مترجم انگلیسی به اسپانیایی ما نیست، ما همچنان میتوانیم با آموزش روی پرامپتهایی مانند این و فقط تولید خروجی بعد از نشانگر "[response]"، از آن در یک تنظیم دنبالهبهدنباله استفاده کنیم.
بیایید یک tf.data.Dataset بسازیم و مقداری دادهٔ اعتبارسنجی را جدا کنیم:
ds = tf.data.Dataset.from_tensor_slices(data).shuffle(2000).batch(2)val_ds = ds.take(100)train_ds = ds.skip(100)کلاس CausalLM که از کتابخانهٔ KerasHub بارگذاری کردیم یک شیء سطح بالا برای مدلسازی زبان علیتی سرتاسری است. این کلاس دو شیء را کپسولهسازی میکند: یک لایهٔ preprocessor، که ورودی متنی را پیشپردازش میکند، و یک مدل backbone، که محاسبات عددی گذر رو به جلوی مدل را در بر دارد.
پیشپردازش به طور پیشفرض در توابع سطح بالای کراس مانند fit() و predict() گنجانده شده است. اما بیایید پیشپردازش خود را روی یک دستهٔ واحد اجرا کنیم تا بتوانیم بهتر ببینیم چه کاری انجام میدهد:
>>> preprocessor = gemma_lm.preprocessor>>> preprocessor.sequence_length = 512>>> batch = next(iter(train_ds))>>> x, y, sample_weight = preprocessor(batch)>>> x["token_ids"].shapeلایهٔ پیشپردازنده تمام ورودیها را تا یک طول ثابت حاشیهگذاری میکند و یک ماسک حاشیهگذاری را محاسبه مینماید تا ردیابی کند کدام ورودیهای شناسهٔ توکن صرفاً صفرهای حاشیهگذاری هستند. تانسور sample_weight به ما اجازه میدهد تا فقط یک مقدار زیان را برای توکنهای پاسخ خود محاسبه کنیم. ما واقعاً به زیان برای پرامپت کاربر اهمیت نمیدهیم؛ آن ثابت است، و قطعاً نمیخواهیم زیان را برای صفرهای حاشیهگذاری که به تازگی اضافه کردهایم محاسبه کنیم.
اگر قطعهای از شناسهها و برچسبهای توکن خود را چاپ کنیم، میتوانیم ببینیم که این همان ساختار معمول مدل زبان است، جایی که هر برچسب مقدار توکن بعدی است:
>>> x["token_ids"][0, :5], y[0, :5]انطباق کمرتبه (LoRA)
Section titled “انطباق کمرتبه (LoRA)”اگر همین الان متد fit() را روی یک پردازندهٔ گرافیکی Colab با ۱۶ گیگابایت حافظهٔ دستگاه اجرا کنیم، به سرعت با یک خطای کمبود حافظه (out of memory) مواجه خواهیم شد. اما ما قبلاً مدل را بارگذاری کردهایم و تولید را اجرا کردهایم، پس چرا اکنون با کمبود حافظه مواجه میشویم؟
مدل ۱ میلیارد پارامتری ما حدود ۳.۷ گیگابایت حافظه اشغال میکند. میتوانید آن را در خلاصهٔ مدل قبلی ما مشاهده کنید. بهینهساز Adam که ما استفاده کردهایم باید سه عدد ممیز شناور اضافی را برای هر پارامتر ردیابی کند — گرادیانهای واقعی، یک مقدار سرعت (velocity)، و یک مقدار تکانه (momentum). در مجموع، این مقدار به ۱۵ گیگابایت صرفاً برای وزنها و وضعیت بهینهساز میرسد. ما همچنین به چند گیگابایت حافظه برای ردیابی مقادیر میانی در گذر رو به جلوی مدل نیاز داریم، اما هیچ حافظهٔ اضافهای برای مصرف نداریم. اجرای fit() در همان مرحلهٔ اول آموزش دچار از کارافتادگی میشود. این یک مشکل رایج در هنگام آموزش LLMها است. از آنجا که این مدلها تعداد پارامترهای زیادی دارند، توان عملیاتی GPUها و CPUهای شما دغدغهای ثانویه نسبت به جا دادن مدل در حافظهٔ شتابدهنده است.
ما پیشتر در این کتاب دیدهایم که چگونه میتوانیم بخشهای خاصی از یک مدل را در طول تنظیم دقیق منجمد (freeze) کنیم. آنچه اشاره نکردیم این است که این کار باعث صرفهجویی زیادی در حافظه میشود! ما نیازی به ردیابی متغیرهای بهینهساز برای پارامترهای منجمدشده نداریم — آنها هرگز بهروزرسانی نخواهند شد. این به ما امکان میدهد فضای زیادی را روی یک شتابدهنده ذخیره کنیم.
پژوهشگران به طور گسترده با منجمد کردن پارامترهای مختلف در یک مدل ترنسفورمر در طول تنظیم دقیق آزمایش کردهاند، و معلوم میشود، شاید به طور شهودی، که مهمترین وزنها برای منجمد نشدن در مکانیزم توجه قرار دارند. اما لایههای توجه ما هنوز صدها میلیون پارامتر دارند. آیا میتوانیم حتی بهتر عمل کنیم؟
در سال ۲۰۲۱، پژوهشگران مایکروسافت تکنیکی به نام LoRA را پیشنهاد کردند، مخفف Low-Rank Adaptation of Large Language Models (انطباق کمرتبهٔ مدلهای زبان بزرگ)، دقیقاً برای حل این مشکل حافظه4. برای توضیح آن، بیایید یک لایهٔ نگاشت خطی ساده را تصور کنیم:
class Linear(keras.Layer):    def __init__(self, input_dim, output_dim):        super().__init__()        self.kernel = self.add_weight(shape=(input_dim, output_dim))
    def call(self, inputs):        return ops.matmul(inputs, self.kernel)
مقالهٔ LoRA پیشنهاد میکند که ماتریس kernel را منجمد کنیم و یک تجزیهٔ «کمرتبه» جدید از نگاشت کرنل اضافه نماییم. این تجزیه دارای دو ماتریس نگاشت جدید به نامهای alpha و beta است که به یک rank درونی و از آن تصویر میکنند. بیایید نگاهی بیندازیم:
class LoraLinear(keras.Layer):    def __init__(self, input_dim, output_dim, rank):        super().__init__()        self.kernel = self.add_weight(            shape=(input_dim, output_dim), trainable=False        )        self.alpha = self.add_weight(shape=(input_dim, rank))        self.beta = self.add_weight(shape=(rank, output_dim))
    def call(self, inputs):        frozen = ops.matmul(inputs, self.kernel)        update = ops.matmul(ops.matmul(inputs, self.alpha), self.beta)        return frozen + update
اگر kernel ما دارای شکل 2048 × 2048 باشد، این ۴,۱۹۴,۳۰۴ پارامتر منجمد است. اما اگر مقدار rank را پایین نگه داریم، مثلاً ۸، ما تنها ۳۲,۷۶۸ پارامتر برای تجزیهٔ کمرتبه خواهیم داشت. این بهروزرسانی قدرت بیانی مشابه کرنل اصلی را نخواهد داشت؛ در نقطهٔ میانی باریک، کل بهروزرسانی باید به عنوان هشت عدد ممیز شناور نشان داده شود. اما در طول تنظیم دقیق LLM، شما دیگر به قدرت بیانی که در طول پیشآموزش نیاز داشتید، نیازی ندارید (شکل ۱۶.۴).
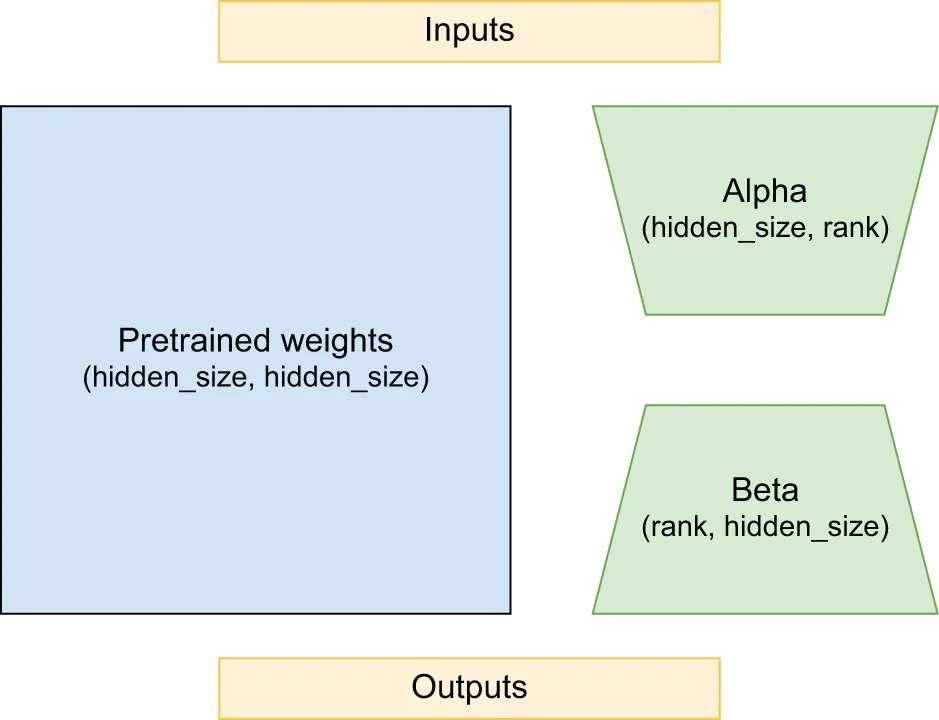
شکل ۱۶.۴: تجزیهٔ کرنل کمرتبه شامل پارامترهای بسیار کمتری نسبت به خود کرنل است.
نویسندگان LoRA پیشنهاد میکنند کل ترنسفورمر را منجمد کرده و وزنهای LoRA را فقط به نگاشتهای پرسوجو (query) و کلید (key) در لایهٔ توجه اضافه کنیم. بیایید آن را امتحان کنیم. مدلهای KerasHub یک متد داخلی برای آموزش LoRA دارند.
فهرست ۱۶.۱۳: فعالسازی آموزش LoRA برای یک مدل KerasHub
gemma_lm.backbone.enable_lora(rank=8)بیایید دوباره به خلاصهٔ مدل خود نگاهی بیندازیم:
>>> gemma_lm.summary()اگرچه پارامترهای مدل ما همچنان ۳.۷ گیگابایت فضا اشغال میکنند، پارامترهای قابل آموزش ما اکنون تنها از ۵ مگابایت داده استفاده میکنند — یک کاهش هزار برابری! این میتواند وضعیت بهینهساز ما را از چندین گیگابایت به صرفاً چند مگابایت روی GPU کاهش دهد (شکل ۱۶.۵).
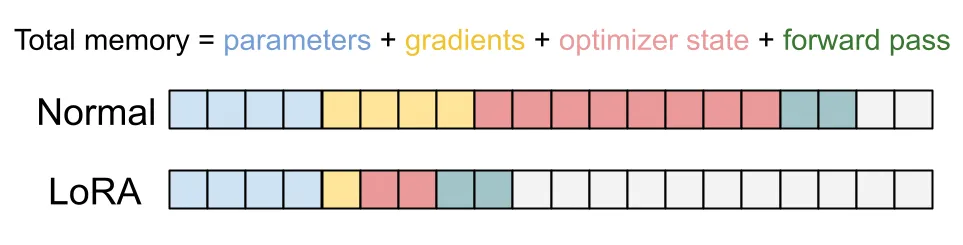
شکل ۱۶.۵: روش LoRA حافظهٔ مورد نیاز برای گرادیانها و وضعیتهای بهینهساز را به شدت کاهش میدهد.
با اعمال این بهینهسازی، سرانجام آمادهایم مدل Gemma خود را با دستورالعملها تنظیم دقیق کنیم. بیایید شروع کنیم.
فهرست ۱۶.۱۴: تنظیم دقیق یک LLM پیشآموزشدیده
gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=keras.optimizers.Adam(5e-5), weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.fit(train_ds, validation_data=val_ds, epochs=1)پس از آموزش، هنگام حدس زدن کلمهٔ بعدی در پاسخ مدلمان به دقت ۵۵٪ میرسیم. این یک جهش بزرگ از دقت ۳۵ درصدی مدل mini-GPT ما است. این قدرت یک مدل بزرگتر و پیشآموزش گستردهتر را نشان میدهد.
آیا تنظیم دقیق ما مدل ما را در پیروی از دستورالعملها بهتر کرد؟ بیایید آن را امتحان کنیم:
>>> gemma_lm.generate(... "[instruction]\nHow can I make brownies?[end]\n"... "[response]\n",... max_length=512,... )بسیار بهتر شد. مدل ما اکنون به جای تلاش برای ادامه دادن صرف فکر متن پرامپت، به سوالات پاسخ خواهد داد.
آیا مشکل توهم را حل کردهایم؟
>>> gemma_lm.generate(... "[instruction]\nWho is the 542nd president of the United States?[end]\n"... "[response]\n",... max_length=512,... )اصلاً. با این حال، ما همچنان میتوانیم از تنظیم دستوری برای ایجاد برخی پیشرفتها در اینجا استفاده کنیم. یک تکنیک رایج آموزش مدل روی تعداد زیادی از جفتهای دستورالعمل/پاسخ است که در آنها پاسخ مورد نظر "I don't know" یا "As a language model, I cannot help you with that" است. این میتواند مدل را آموزش دهد تا از تلاش برای پاسخ دادن به موضوعات خاصی که اغلب در آنها نتایجی با کیفیت پایین میدهد، خودداری کند.
فراتر رفتن با LLMها
Section titled “فراتر رفتن با LLMها”ما اکنون یک مدل GPT را از ابتدا آموزش دادهایم و یک مدل زبان را به ربات گفتگوی اختصاصی خودمان تنظیم دقیق کردهایم. با این حال، ما صرفاً در حال لمس سطح پژوهشهای امروزی LLM هستیم. در این بخش، فهرستی غیرجامع از گسترشها و بهبودهای ساختار پایهای مدلسازی زبان «تکمیل خودکار اینترنت» را پوشش خواهیم داد.
یادگیری تقویتی با بازخورد انسانی (RLHF)
Section titled “یادگیری تقویتی با بازخورد انسانی (RLHF)”نوع تنظیم دقیق دستوری که ما به تازگی انجام دادیم اغلب تنظیم دقیق نظارتشده (supervised fine-tuning) نامیده میشود. این روش نظارتشده است زیرا ما به صورت دستی فهرستی از پرامپتها و پاسخهای نمونه را که از مدل میخواهیم گردآوری میکنیم.
هرگونه نیاز به نوشتن دستی مثالهای متنی تقریباً همیشه تبدیل به یک گلوگاه خواهد شد — دستیابی به چنین دادههایی کند و پرهزینه است. علاوه بر این، این رویکرد توسط سقف عملکرد انسانی در وظیفهٔ پیروی از دستورالعمل محدود خواهد شد. اگر بخواهیم در یک تجربهٔ شبیه به ربات گفتگو بهتر از عملکرد انسانی عمل کنیم، نمیتوانیم برای نظارت بر آموزش LLM به خروجیهای نوشتهشده به صورت دستی تکیه کنیم.
مسئلهٔ واقعی که در تلاش برای بهینهسازی آن هستیم، ترجیح ما برای پاسخهای خاص نسبت به پاسخهای دیگر است. با نمونهای به اندازهٔ کافی بزرگ از افراد، این مسئلهٔ ترجیح کاملاً تعریفشده است، اما کشف چگونگی ترجمه از «ترجیحات ما» به یک تابع زیان که بتوانیم برای محاسبهٔ گرادیانها استفاده کنیم کاملاً دشوار است. این همان چیزی است که یادگیری تقویتی با بازخورد انسانی (Reinforcement Learning with Human Feedback) یا به اختصار RLHF تلاش در حل آن دارد.
اولین گام در تنظیم دقیق RLHF دقیقاً همان کاری است که در بخش قبل انجام دادیم — تنظیم دقیق نظارتشده با پرامپتها و پاسخهای دستنویس. این کار ما را به یک عملکرد مبنای خوب میرساند؛ ما اکنون باید این مبنا را بهبود بخشیم. برای این منظور، ما یک مدل پاداش (reward model) خواهیم ساخت که بتواند به عنوان نمایندهای برای ترجیحات انسانی عمل کند. ما میتوانیم تعداد زیادی پرامپت و پاسخ به این پرامپتها جمعآوری کنیم. برخی از این پاسخها میتوانند دستنویس باشند؛ مدل میتواند موارد دیگر را بنویسد. پاسخها حتی میتوانند توسط سایر LLMهای گفتگو نوشته شوند. سپس باید ارزیابهای انسانی را برای رتبهبندی این پاسخها بر اساس ترجیح به کار بگیریم. با داشتن یک پرامپت و چندین پاسخ بالقوه، وظیفهٔ یک ارزیاب رتبهبندی آنها از مفیدترین تا کمفایدهترین است. چنین جمعآوری دادهای گران و کند است، اما همچنان سریعتر از نوشتن تمام پاسخهای مورد نظر با دست است.
ما میتوانیم از این مجموعه دادهٔ ترجیحات رتبهبندیشده برای ساخت مدل پاداش استفاده کنیم، که یک جفت پرامپت-پاسخ را دریافت میکند و یک مقدار ممیز شناور منفرد را خروجی میدهد. هرچه این مقدار بالاتر باشد، پاسخ بهتر است. این مدل پاداش معمولاً ترنسفورمر دیگری است که کوچکتر است. به جای پیشبینی توکن بعدی، کل یک دنباله را میخواند و یک عدد ممیز شناور منفرد را خروجی میدهد — امتیازی برای یک پاسخ معین.
سپس میتوانیم از این مدل پاداش برای تنظیم بیشتر مدلمان، با استفاده از ساختار یادگیری تقویتی استفاده کنیم. ما در این کتاب خیلی عمیق وارد جزئیات یادگیری تقویتی نخواهیم شد، اما از این اصطلاح نترسید — این اصطلاح به هر ساختار آموزشی اشاره دارد که در آن یک مدل یادگیری عمیق با انجام پیشبینیها (که کنشها یا actions نامیده میشوند) و دریافت بازخورد در مورد آن خروجی (که پاداشها یا rewards نامیده میشوند) یاد میگیرد. به طور خلاصه، پیشبینیهای خود یک مدل تبدیل به دادههای آموزشی آن میشوند.
در مورد ما، کنش صرفاً تولید یک پاسخ به یک پرامپت ورودی است، همانطور که در بالا با تابع generate() انجام میدادیم. پاداش صرفاً اعمال یک مدل رگرسیون جداگانه روی آن خروجی رشتهای است. در اینجا یک مثال ساده در شبهکد آورده شده است.
فهرست ۱۶.۱۵: شبهکد برای سادهترین الگوریتم ممکن RLHF
for prompts in dataset: # Takes an action responses = model.generate(prompts) # Receives a reward rewards = reward_model.predict(responses) good_responses = [] for response, score in zip(responses, rewards): if score > cutoff: good_responses.append(response) # Updates the model parameters. We do not update the reward model. model.fit(good_responses)در این مثال ساده، ما پاسخهای تولیدشدهٔ خود را با یک آستانهٔ پاداش فیلتر میکنیم و صرفاً با خروجی «خوب» به عنوان دادههای آموزشی جدید برای تنظیم دقیق نظارتشدهٔ بیشتر رفتار میکنیم، درست مانند کاری که در بخش قبل انجام دادیم. در عمل، شما معمولاً پاسخهای بد خود را دور نمیریزید، بلکه از الگوریتمهای بهروزرسانی گرادیان تخصصی برای هدایت پارامترهای مدل خود با استفاده از تمام پاسخها و پاداشها استفاده میکنید. هر چه باشد، یک پاسخ بد نشانهٔ خوبی برای این است که چه کاری نباید انجام داد. شرکت OpenAI در ابتدا RLHF را در مقالهای در سال ۲۰۲۲ توصیف کرد5 و از این ساختار آموزشی برای رفتن از پارامترهای پیشآموزشدیدهٔ اولیهٔ GPT-3 به اولین نسخهٔ ChatGPT استفاده نمود.
یک مزیت این ساختار تکرارشونده بودن آن است. شما میتوانید این مدل به تازگی آموزشدیده را بردارید، پاسخهای جدید و بهبودیافتهای به پرامپتها تولید کنید، این پاسخها را بر اساس ترجیحات انسانی رتبهبندی کنید، و یک مدل پاداش جدید و بهبودیافته را آموزش دهید.
استفاده از یک ربات گفتگوی آموزشدیده با RLHF
Section titled “استفاده از یک ربات گفتگوی آموزشدیده با RLHF”ما میتوانیم این موضوع را با امتحان کردن مدلی که با این شکل از تنظیم ترجیحی تکراری آموزش دیده است، عینیتر کنیم. از آنجا که ساخت رباتهای گفتگو «کاربرد فوقالعاده» (killer app) برای مدلهای بزرگ ترنسفورمر است، این یک رویهٔ معمول برای شرکتهایی است که مدلهای پیشآموزشدیدهای مانند Gemma را منتشر میکنند تا نسخههای تخصصی «تنظیمشده با دستورالعمل» را منتشر نمایند که صرفاً برای گفتگو ساخته شدهاند. بیایید سعی کنیم یکی از آنها را اکنون بارگذاری کنیم. این یک مدل ۴ میلیارد پارامتری خواهد بود، چهار برابر اندازهٔ مدلی که به تازگی بارگذاری کردیم و بزرگترین مدلی که در این کتاب استفاده خواهیم کرد:
فهرست ۱۶.۱۶: بارگذاری یک نسخهٔ تنظیمشده با دستورالعمل از Gemma
gemma_lm = keras_hub.models.CausalLM.from_preset( "gemma3_instruct_4b", dtype="bfloat16",)مانند مدل قبلی Gemma که خودمان تنظیم دقیق کردیم، این نقطهٔ بازرسی تنظیمشده با دستورالعمل با قالب خاصی برای قالببندی ورودی خود همراه است. مجدداً، متن دقیق اهمیتی ندارد، آنچه مهم است این است که قالب پرامپت ما با آنچه برای تنظیم مدل استفاده شده است مطابقت داشته باشد:
PROMPT_TEMPLATE = """<start_of_turn>user{}<end_of_turn><start_of_turn>model"""بیایید سعی کنیم از آن یک سوال بپرسیم:
>>> prompt = "Why can't you assign values in Jax tensors? Be brief!">>> gemma_lm.generate(PROMPT_TEMPLATE.format(prompt), max_length=512)این مدل ۴ میلیارد پارامتری ابتدا روی ۱۴ تریلیون توکن از متن پیشآموزش دیده و سپس به طور گسترده تنظیم دقیق شده است تا هنگام پاسخ دادن به سوالات مفیدتر باشد. بخشی از این تنظیم با تنظیم دقیق نظارتشده مانند آنچه در بخش قبل انجام دادیم انجام شد، بخشی با RLHF همانطور که در این بخش پوشش دادیم، و بخشی با تکنیکهای دیگر — مانند استفاده از یک مدل حتی بزرگتر به عنوان «معلم» برای هدایت آموزش. افزایش توانایی در پاسخگویی به پرسشها به راحتی قابل توجه است.
بیایید این مدل را روی پرامپتی امتحان کنیم که در رابطه با توهمات برای ما دردسرساز بوده است:
>>> prompt = "Who is the 542nd president of the United States?">>> gemma_lm.generate(PROMPT_TEMPLATE.format(prompt), max_length=512)این مدل توانمندتر از پذیرش طعمه خودداری میکند. این نتیجهٔ یک تکنیک مدلسازی جدید نیست، بلکه نتیجهٔ آموزش گسترده روی سوالات فریبنده مانند این با پاسخهایی شبیه به پاسخی است که به تازگی دریافت کردیم. در واقع، شما میتوانید در اینجا به وضوح ببینید که چرا حذف توهمات میتواند کمی شبیه به بازی موش و چکش باشد — حتی اگرچه از توهم زدن یک رئیسجمهور ایالات متحده خودداری کرد، مدل اکنون موفق میشود تاریخ امروز را جعل کند.
مدلهای زبان بزرگ چندوجهی
Section titled “مدلهای زبان بزرگ چندوجهی”یک گسترش آشکار برای ربات گفتگو توانایی مدیریت مدهای جدیدی از ورودی است. دستیاری که بتواند به ورودی صوتی پاسخ دهد و تصاویر را پردازش کند، بسیار مفیدتر از دستیاری خواهد بود که فقط میتواند روی متن کار کند.
گسترش یک ترنسفورمر به مدهای مختلف را میتوان به روشی از نظر مفهومی ساده انجام داد. ترنسفورمر یک مدل مختص متن نیست؛ این یک مدل بسیار مؤثر برای یادگیری الگوها در دادههای دنبالهای است. اگر بتوانیم بفهمیم چگونه انواع دیگر دادهها را به یک نمایش دنبالهای تبدیل کنیم، میتوانیم این دنباله را به یک ترنسفورمر تغذیه کرده و با آن آموزش دهیم.
در واقع، مدل Gemma که به تازگی بارگذاری کردیم دقیقاً همین کار را انجام میدهد. این مدل با یک رمزگذار تصویر جداگانهٔ ۴۲۰ میلیون پارامتری همراه است که یک تصویر ورودی را به ۲۵۶ وصله (patch) برش میدهد و هر وصله را به صورت برداری با همان ابعاد بعد پنهان ترنسفورمر Gemma کدگذاری میکند. هر تصویر به صورت یک دنبالهٔ (256, 2560) جاسازی خواهد شد. از آنجا که ۲۵۶۰ بعد پنهان مدل ترنسفورمر Gemma است، این نمایش تصویر را میتوان به سادگی پس از لایهٔ جاسازی توکن به دنبالهٔ متنی ما متصل کرد. شما میتوانید آن را مانند ۲۵۶ توکن ویژه که نشاندهندهٔ تصویر هستند در نظر بگیرید، جایی که به هر بردار (1, 2560) گاهی اوقات یک «توکن نرم (soft token)» گفته میشود (شکل ۱۶.۶). بر خلاف «توکنهای سخت» معمول ما، که در آنها هر شناسهٔ توکن فقط میتواند تعداد ثابتی از بردارهای ممکن را در ماتریس جاسازی توکن ما به خود بگیرد، این توکنهای نرم تصویر میتوانند هر مقدار برداری را که توسط رمزگذار بینایی خروجی داده میشود به خود بگیرند.
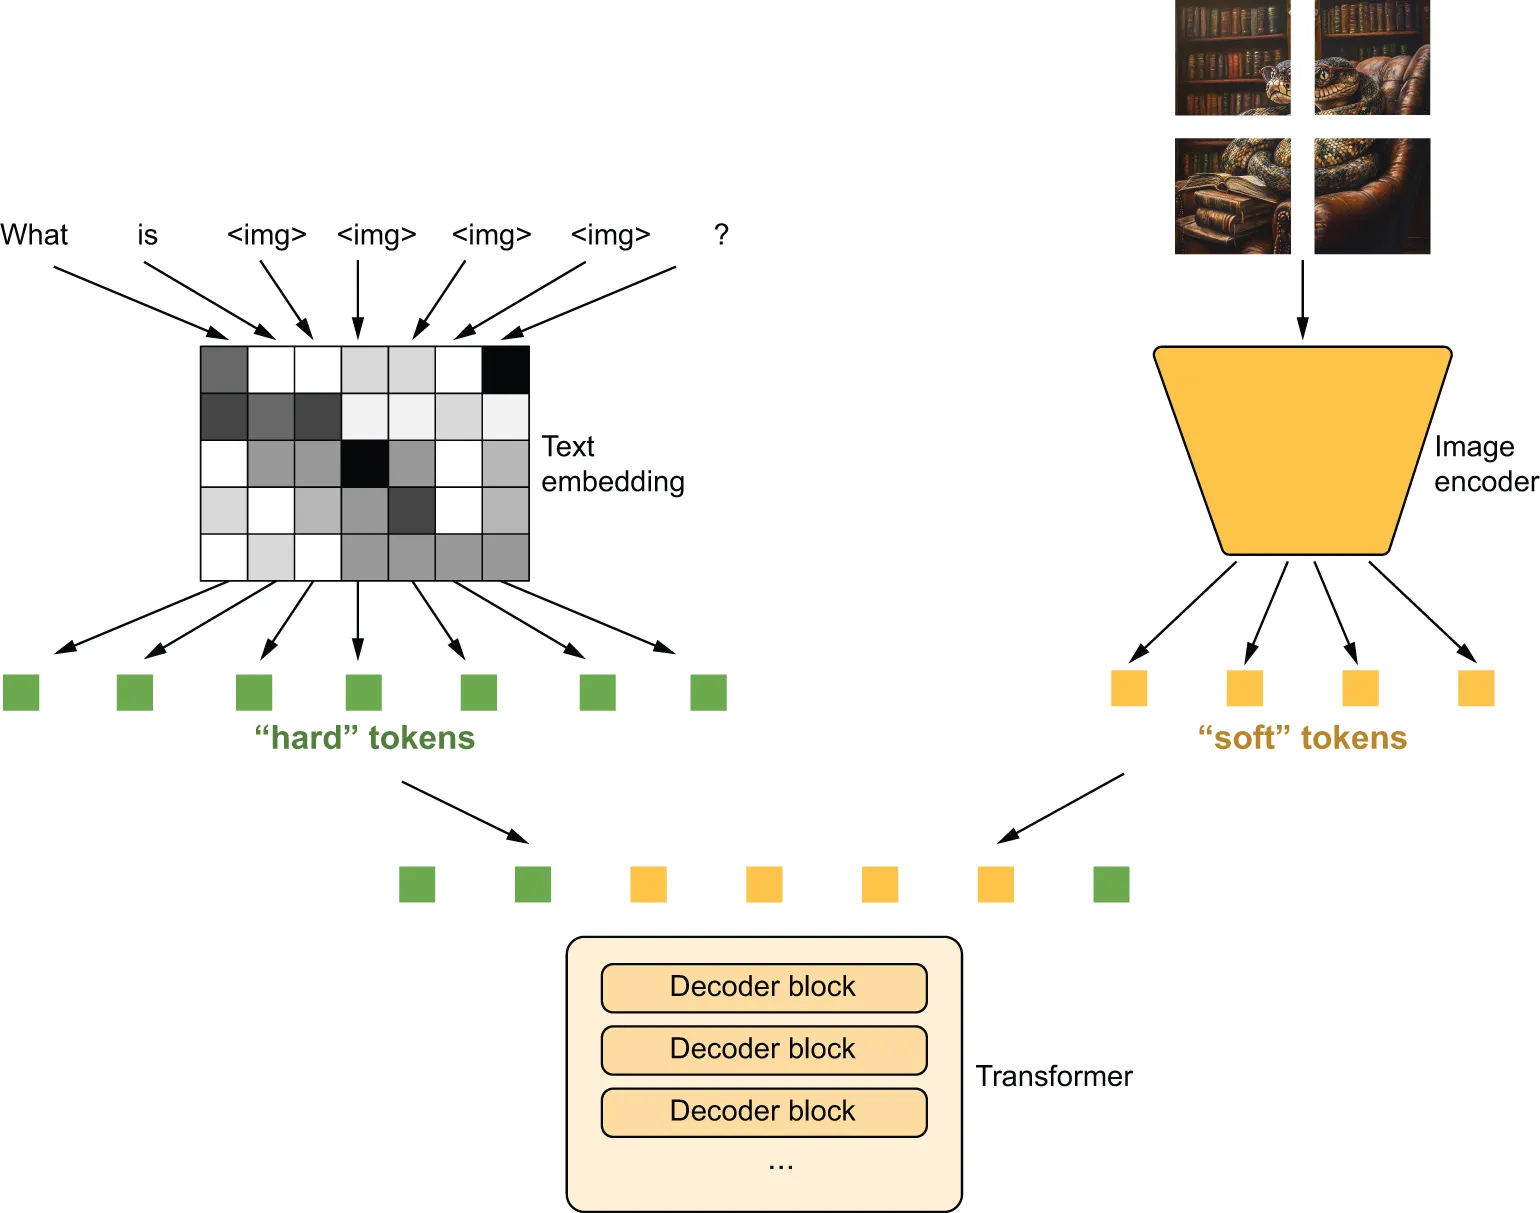
شکل ۱۶.۶: مدیریت ورودی تصویر با به هم متصل کردن توکنهای متنی و توکنهای نرم تصویر
بیایید یک تصویر را بارگذاری کنیم تا ببینیم این کار با کمی جزئیات بیشتر چگونه عمل میکند (شکل ۱۶.۷):
import matplotlib.pyplot as plt
image_url = (    "https://github.com/mattdangerw/keras-nlp-scripts/"    "blob/main/learned-python.png?raw=true")image_path = keras.utils.get_file(origin=image_url)
image = np.array(keras.utils.load_img(image_path))plt.axis("off")plt.imshow(image)plt.show()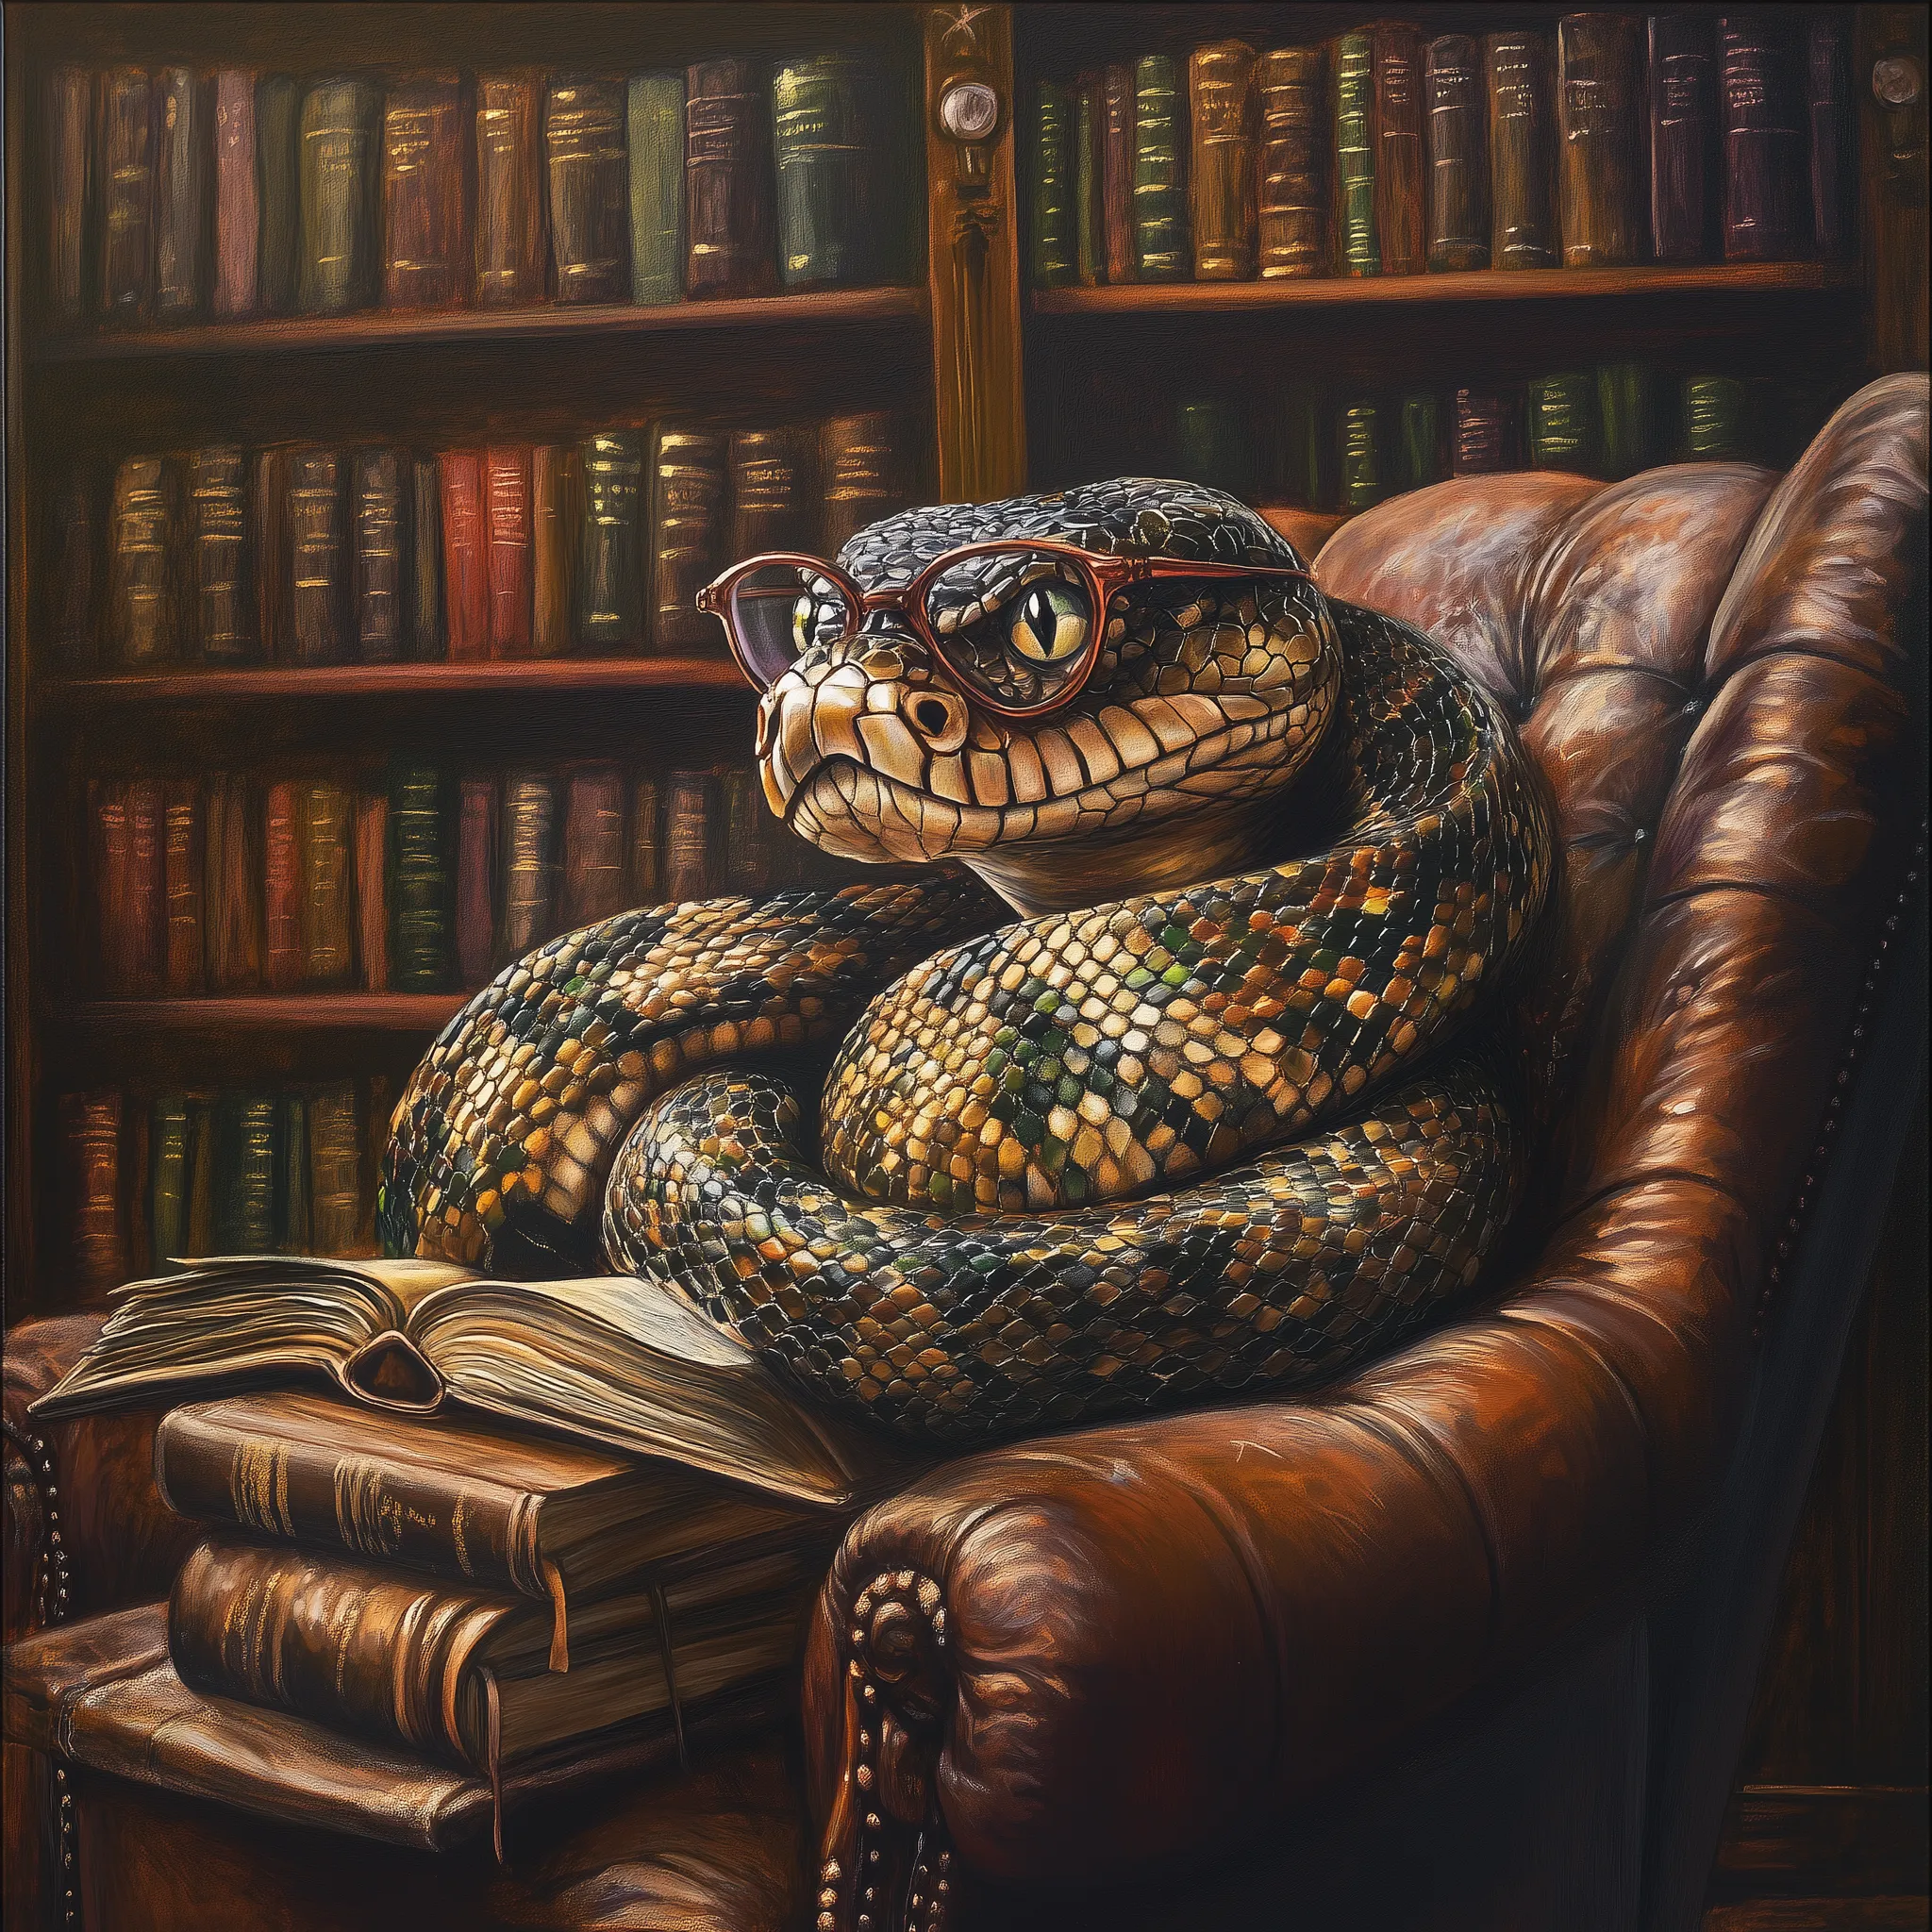
شکل ۱۶.۷: یک تصویر آزمایشی برای مدل Gemma
ما میتوانیم از Gemma برای پرسیدن چند سوال در مورد این تصویر استفاده کنیم:
>>> # Limits the maximum input size of the model>>> gemma_lm.preprocessor.max_images_per_prompt = 1>>> gemma_lm.preprocessor.sequence_length = 512>>> prompt = "What is going on in this image? Be concise!<start_of_image>">>> gemma_lm.generate({... "prompts": PROMPT_TEMPLATE.format(prompt),... "images": [image],... })هر یک از پرامپتهای ورودی ما شامل توکن ویژهٔ <start_of_image> است. این به ۲۵۶ مقدار نگهدارندهٔ مکان در دنبالهٔ ورودی ما تبدیل میشود، که به نوبهٔ خود با توکنهای نرمی که تصویر ما را نشان میدهند جایگزین میگردد.
آموزش برای یک مدل چندوجهی مانند این کاملاً شبیه به پیشآموزش و تنظیم دقیق معمول LLM است. معمولاً میخواهید ابتدا رمزگذار تصویر خود را به طور جداگانه پیشآموزش دهید، همانطور که در ابتدا در فصل ۸ این کتاب انجام دادیم. سپس میتوانید به سادگی همان پیشآموزش پایهای «حدس زدن کلمهٔ بعدی» را انجام دهید و محتوای ترکیبی تصویر و متن را که در یک دنبالهٔ واحد ترکیب شدهاند نیز تغذیه کنید. ترنسفورمر ما برای خروجی دادن توکنهای نرم تصویر آموزش نخواهد دید؛ ما صرفاً زیان را در این مکانهای توکن تصویر صفر میکنیم.
شاید تقریباً جادویی به نظر برسد که بتوانیم به سادگی دادههای تصویری را به یک LLM اضافه کنیم، اما وقتی قدرت مدل دنبالهای را که با آن کار میکنیم در نظر میگیریم، این واقعاً یک نتیجهٔ کاملاً مورد انتظار است. ما یک ترنسفورمر را برداشتهایم، ورودی تصویر خود را به عنوان دادههای دنبالهای بازسازی کردهایم، و آموزش اضافی زیادی انجام دادهایم. مدل میتواند توانایی مدل زبان اصلی را برای دریافت و تولید متن حفظ کند و در عین حال یاد بگیرد که تصاویر را نیز در فضای نهان ترنسفورمر جاسازی نماید.
مدلهای بنیادین
Section titled “مدلهای بنیادین”همانطور که LLMها به مدهای مختلف وارد میشوند، نام «مدل زبان بزرگ» میتواند کمی گمراهکننده شود. آنها زبان را مدلسازی میکنند، اما تصاویر، صدا و شاید حتی دادههای ساختاریافته را نیز در بر میگیرند. در فصل بعد، ما یک معماری متمایز به نام مدلهای نفوذ (diffusion models) را خواهیم دید که از نظر ساختار زیربنایی کاملاً متفاوت عمل میکند اما حسی مشابه دارد — آنها نیز روی مقادیر عظیمی از داده در «مقیاس اینترنت» با یک زیان خودنظارتی آموزش میبینند.
یک اصطلاح چتری برای مدلهایی از این دست مدلهای بنیادین (foundation models) است. به طور خاصتر، یک مدل بنیادین هر مدلی است که روی دادههای گسترده (عموماً با استفاده از خودنظارتی در مقیاس بالا) آموزش دیده است و میتواند برای طیف گستردهای از وظایف پاییندست تنظیم دقیق شود.
به طور کلی، میتوانید یک مدل بنیادین را به عنوان یادگیری برای بازسازی دادههای استخراجشده از بخشهای بزرگی از اینترنت، با داشتن یک نمایش جزئی از آن، در نظر بگیرید. در حالی که LLMها اولین و شناختهشدهترین این مدلها هستند، مدلهای بسیار دیگری نیز وجود دارند. نشانههای بارز یک مدل بنیادین، هدف یادگیری خودنظارتی (یک زیان بازسازی) و این واقعیت است که این مدلها برای یک وظیفهٔ منفرد تخصصی نشدهاند و میتوانند برای تعدادی از اهداف پاییندست استفاده شوند.
این یک تغییر مهم و چشمگیر است که به تازگی در تاریخ طولانی یادگیری ماشین رخ داده است. به جای آموزش یک مدل از ابتدا روی مجموعه دادهٔ فردی خود، اغلب بهتر است از یک مدل بنیادین برای به دست آوردن نمایشی غنی از ورودی خود (خواه تصاویر، متن یا چیز دیگری باشد) استفاده کنید و سپس آن مدل را برای وظیفهٔ پاییندست نهایی خود تخصصی نمایید. البته، این کار با این جنبهٔ منفی همراه است که نیاز به اجرای مدلهای بزرگ با میلیاردها پارامتر دارد، بنابراین برای تمام کاربردهای دنیای واقعی یادگیری ماشین مناسب نیست.
تولید تقویتشده با بازیابی (RAG)
Section titled “تولید تقویتشده با بازیابی (RAG)”قرار دادن اطلاعات اضافی در پرامپت فقط در مدیریت دادههای تصویری مفید نیست؛ این میتواند روشی کلی برای گسترش قابلیتهای یک LLM باشد. یک نمونهٔ قابل توجه زمانی است که از یک LLM برای جستجو استفاده میشود. اگر ما یک LLM را سادهلوحانه با یک موتور جستجو مقایسه کنیم، چند نقص مهلک دارد:
- یک LLM گاهی اوقات چیزهایی را از خود ابداع میکند. این مدل «حقایق» نادرستی را خروجی میدهد که در دادههای آموزشی وجود نداشتند اما میتوانستند از دادههای آموزشی درونیابی شوند. این اطلاعات میتوانند از گمراهکننده تا خطرناک متغیر باشند.
- دانش یک LLM از جهان دارای یک تاریخ انقضا است — در بهترین حالت، تاریخی که مدل پیشآموزش دیده است. آموزش یک LLM کاملاً گران است، و آموزش مداوم روی دادههای جدید امکانپذیر نیست. بنابراین در یک نقطهٔ زمانی اختیاری، دانش یک LLM از جهان به سادگی متوقف خواهد شد.
هیچکس نمیخواهد از موتور جستجویی استفاده کند که فقط میتواند دربارهٔ چیزهایی که شش ماه پیش اتفاق افتاده است به شما بگوید. اما اگر به یک LLM بیشتر شبیه به «نرمافزار مکالمهای» فکر کنیم که میتواند هر دادهٔ دنبالهای را در یک پرامپت مدیریت کند، چه میشود اگر در عوض از مدل به عنوان رابطی برای اطلاعات بازیابیشده توسط جستجوی سنتیتر استفاده کنیم؟ این همان ایدهٔ نهفته در پس تولید تقویتشده با بازیابی (retrieval-augmented generation) یا RAG است.
روش کار RAG این است که یک پرسش اولیهٔ کاربر را میگیرد و نوعی پرسوجو را برای کشیدن زمینهٔ متنی اضافی انجام میدهد. این پرسوجو میتواند به یک پایگاه داده، یک موتور جستجو، یا هر چیزی باشد که بتواند اطلاعات بیشتری در مورد سوال پرسیدهشده توسط کاربر ارائه دهد. سپس این اطلاعات اضافی مستقیماً به پرامپت اضافه میشود. برای مثال، ممکن است پرامپتی مانند این بسازید:
Use the following pieces of context to answer the question.Question: What are some good ways to improve sleep?Context: {text from a medical journal on improving sleep}Answer:یک رویکرد متداول برای جستجوی اطلاعات مرتبط استفاده از یک پایگاه دادهٔ برداری (vector database) است. برای ساخت یک پایگاه دادهٔ برداری، میتوانید از یک LLM یا هر مدلی برای جاسازی مجموعهای از اسناد منبع به صورت بردار استفاده کنید. متن سند در پایگاه داده ذخیره میشود و بردار جاسازی به عنوان کلید استفاده خواهد شد. در طول بازیابی، میتوان مجدداً از یک LLM برای جاسازی پرسوجوی کاربر به عنوان یک بردار استفاده کرد. پایگاه دادهٔ برداری مسئول جستجوی بردارهای کلید نزدیک به بردار پرسوجو و نمایش متن متناظر است. این ممکن است بسیار شبیه به خود مکانیزم توجه به نظر برسد — به یاد بیاورید که اصطلاحات «پرسوجو»، «کلید» و «مقدار» در واقع از سیستمهای پایگاه داده آمدهاند.
نمایش اطلاعات برای کمک به تولید چند کار انجام میدهد:
- راهی واضح برای دور زدن تاریخ انقضای مدل به شما میدهد.
- به مدل اجازه میدهد به دادههای خصوصی دسترسی داشته باشد. شرکتها ممکن است بخواهند از یک LLM آموزشدیده روی دادههای عمومی برای خدمت به عنوان رابطی برای اطلاعات ذخیرهشده به صورت خصوصی استفاده کنند.
- میتواند به استقرار واقعی مدل بر پایهٔ حقایق کمک کند. هیچ راهحل جادویی وجود ندارد که توهمات را به طور کامل متوقف کند، اما یک LLM در صورتی که با زمینهٔ صحیح دربارهٔ موضوع در یک پرامپت مواجه شود، بسیار کمتر احتمال دارد که حقایقی را دربارهٔ یک موضوع از خود جعل کند.
مدلهای «استدلالگر»
Section titled “مدلهای «استدلالگر»”سالها پس از اولین LLMها، پژوهشگران با این واقعیت شناختهشده دست و پنجه نرم میکردند که این مدلها در مسائل ریاضی و معماهای منطقی افتضاح بودند. یک مدل ممکن بود پاسخی بینقص به مسئلهای مستقیماً موجود در دادههای آموزشی خود بدهد، اما با جایگزینی چند نام یا عدد در پرامپت، مشخص میشد که مدل هیچ درکی از آنچه در تلاش برای حل آن بود نداشت. برای بسیاری از مسائل در پردازش زبان طبیعی، LLMها دستورالعمل آسانی برای پیشرفت ارائه دادند: مقدار دادههای آموزشی را افزایش دهید، امتیاز معیارهای آزمایشی را بالا ببرید. با این حال، مسائل ریاضی دورهٔ ابتدایی در برابر پیشرفت مقاومت میکردند.
در سال ۲۰۲۳، پژوهشگران گوگل متوجه شدند که اگر با چند مثال از «نشان دادن مراحل کار» در یک مسئلهٔ ریاضی به مدل پرامپت بدهید — مانند نوشتن تحتاللفظی مراحل همانند کاری که در یک تکلیف درسی انجام میدهید — مدل شروع به انجام همان کار خواهد کرد. همانطور که مدل نوشتن مراحل میانی را تقلید میکرد، در واقع با توجه به خروجیهای خودش، در رسیدن به راهحل صحیح بسیار بهتر عمل میکرد. آنها این روش را پرامپتنویسی «زنجیرهٔ فکر (chain-of-thought)» نامیدند، و این نام ماندگار شد. گروه دیگری از پژوهشگران متوجه شدند که حتی به مثالها هم نیازی نیست؛ شما میتوانید به سادگی با عبارت «بیایید گامبهگام فکر کنیم» به مدل پرامپت بدهید و خروجی بهتری دریافت کنید.
از زمان این اکتشافات، علاقهٔ شدیدی به آموزش مستقیم LLMها برای بهتر شدن در استدلال زنجیرهٔ فکر وجود داشته است. مدلهایی مانند o1 از OpenAI و r1 از DeepSeek با نشان دادن گامهای بزرگ در مسائل ریاضی و کدنویسی از طریق آموزش یک مدل برای «بلند فکر کردن» روی سوالات دشوار، تیتر خبرها را به خود اختصاص دادهاند.
رویکرد این تنظیم دقیق زنجیرهٔ فکر بسیار شبیه به RLHF است. ما ابتدا مدل را روی چند مثال نظارتشده از «نشان دادن مراحل کار» در یک مسئلهٔ ریاضی و رسیدن به پاسخ صحیح آموزش خواهیم داد. سپس، به مدل با یک سوال ریاضی جدید پرامپت میدهیم و بررسی میکنیم که آیا مدل پاسخ نهایی را درست به دست آورده است یا خیر. در نهایت، ما از این خروجیهای تولیدشدهٔ جدید برای تنظیم بیشتر وزنهای مدل استفاده میکنیم.
بیایید این را با مدل Gemma امتحان کنیم. ما میتوانیم مسئلهٔ کلمهای خودمان را بنویسیم و نمونهبرداری تصادفی را روشن کنیم تا هر بار پاسخی تا حدی تصادفی دریافت نماییم:
prompt = """Judy wrote a 2-page letter to 3 friends twice a week for 3 months.How many letters did she write?Be brief, and add "ANSWER:" before your final answer."""
# Turns on random sampling to get a diverse range of outputsgemma_lm.compile(sampler="random")
بیایید تولید چند پاسخ را امتحان کنیم:
>>> gemma_lm.generate(PROMPT_TEMPLATE.format(prompt))در اولین تلاش، مدل ما روی جزئیات اضافی گیر کرد مبنی بر اینکه هر نامه دو صفحه دارد. در تلاش دوم، مدل مسئله را درست حل میکند. این مدل Gemma تنظیمشده با دستورالعمل که ما با آن کار میکنیم قبلاً روی مسائل ریاضی شبیه به این تنظیم شده است؛ شما نتایجی به این خوبی را از مدل «تنظیمنشدهٔ» Gemma از بخش قبل دریافت نمیکردید.
ما میتوانیم این ایده را به شکل بسیار سادهای از آموزش زنجیرهٔ فکر گسترش دهیم:
- مجموعهای از مسائل پایهای ریاضی و استدلال و پاسخهای مورد نظر را جمعآوری کنید.
- تعدادی پاسخ را (با مقداری تصادفی بودن) تولید کنید.
- تمام پاسخهای دارای پاسخ صحیح را از طریق تجزیهٔ رشته پیدا کنید. میتوانید به مدل پرامپت بدهید تا از یک نشانگر متنی خاص برای پاسخ نهایی استفاده کند، همانطور که قبلاً انجام دادیم.
- تنظیم دقیق نظارتشده را روی پاسخهای صحیح، از جمله تمام خروجیهای میانی اجرا کنید.
- تکرار کنید!
فرایند توصیفشدهٔ قبلی یک الگوریتم یادگیری تقویتی است. بررسی پاسخ ما به عنوان محیط (environment) عمل میکند، و خروجیهای تولیدشده کنشهایی (actions) هستند که مدل برای یادگیری استفاده مینماید. همانند RLHF، در عمل شما از یک مرحلهٔ بهروزرسانی گرادیان پیچیدهتر برای استفاده از اطلاعات تمام پاسخها (حتی پاسخهای نادرست) استفاده خواهید کرد، اما اصل بنیادین یکسان است.
همین ایده برای بهبود عملکرد LLM در دامنههای دیگری که پاسخهای واضح و قابل تأییدی برای پرامپتهای متنی دارند استفاده میشود. کدنویسی یک دامنهٔ مهم است — شما میتوانید به LLM پرامپت بدهید تا کد را خروجی دهد و سپس در واقع کد را اجرا کنید تا کیفیت پاسخ را آزمایش نمایید.
در تمام این دامنهها، یک روند واضح است — همانطور که یک مدل یاد میگیرد سوالات دشوارتری را حل کند، زمان بیشتری را صرف «نشان دادن مراحل کار» قبل از رسیدن به پاسخ نهایی خواهد کرد. شما میتوانید این را به عنوان یادگیری مدل برای جستجو روی خروجیهای خودش از راهحلهای بالقوه در نظر بگیرید. ما این ایده را بیشتر در فصل پایانی کتاب بررسی خواهیم کرد.
مدلهای زبان بزرگ (LLMها) به کدام سو میروند؟
Section titled “مدلهای زبان بزرگ (LLMها) به کدام سو میروند؟”با توجه به مسیر پیشرفت LLMها که در ابتدای این فصل مورد بحث قرار گرفت، ممکن است بدیهی به نظر برسد که LLMها به کجا خواهند رفت. پارامترهای بیشتر! عملکرد حتی بهتر! در یک مفهوم کلی، این احتمالاً درست است، اما مسیر ما ممکن است چندان خطی نباشد.
اگر بودجهٔ ثابتی برای پیشآموزش داشته باشید، مثلاً یک میلیون دلار، میتوانید تقریباً آن را به عنوان خرید مقدار ثابتی از محاسبات یا عملیاتهای ممیز شناور (flops) در نظر بگیرید. شما میتوانید این فلاپسها را صرف آموزش با دادههای بیشتر یا آموزش یک مدل بزرگتر کنید. پژوهشهای اخیر اشاره کردهاند که GPT-3 با ۱۷۵ میلیارد پارامتر، برای بودجهٔ محاسباتی خود بیش از حد بزرگ بود. آموزش مدلی کوچکتر روی دادههای بیشتر منجر به عملکرد بهتر مدل میشد. بنابراین اخیراً، اندازههای مدل روندی مسطحتر داشتهاند در حالی که اندازههای داده روندی رو به بالا داشتهاند.
این بدان معنا نیست که مقیاسپذیری متوقف خواهد شد — قدرت محاسباتی بیشتر به طور کلی منجر به عملکرد بهتر LLM میشود، و ما هنوز نشانههایی از یک مجانب که در آن عملکرد پیشبینی توکن بعدی متوقف شود ندیدهایم. شرکتها به سرمایهگذاری میلیاردها دلار در مقیاسدهی LLMها و دیدن اینکه چه قابلیتهای جدیدی پدیدار میشود ادامه میدهند.
شکل ۱۶.۸ جزئیاتی را برای برخی از LLMهای اصلی منتشرشده از ۲۰۱۸ تا ۲۰۲۵ نشان میدهد. میتوانیم توجه کنیم که در حالی که تعداد کل توکنهای استفادهشده برای پیشآموزش به طور پیوسته و عظیمی صعود کرده است، تعداد پارامترهای مدل از زمان GPT-3 به طور قابل توجهی تغییر کرده است. تا حدی، این به این دلیل است که ما اکنون میدانیم GPT-3 کمتر از حد بهینه آموزش دیده بود، اما همچنین به یک دلیل عملیتر است. هنگام استقرار یک مدل، اغلب ارزش دارد که عملکرد را فدای مدل کوچکتری کنید که روی سختافزار ارزانتر جا میشود. یک مدل واقعاً خوب اگر اجرای آن به شدت گران باشد، کمک چندانی نخواهد کرد.
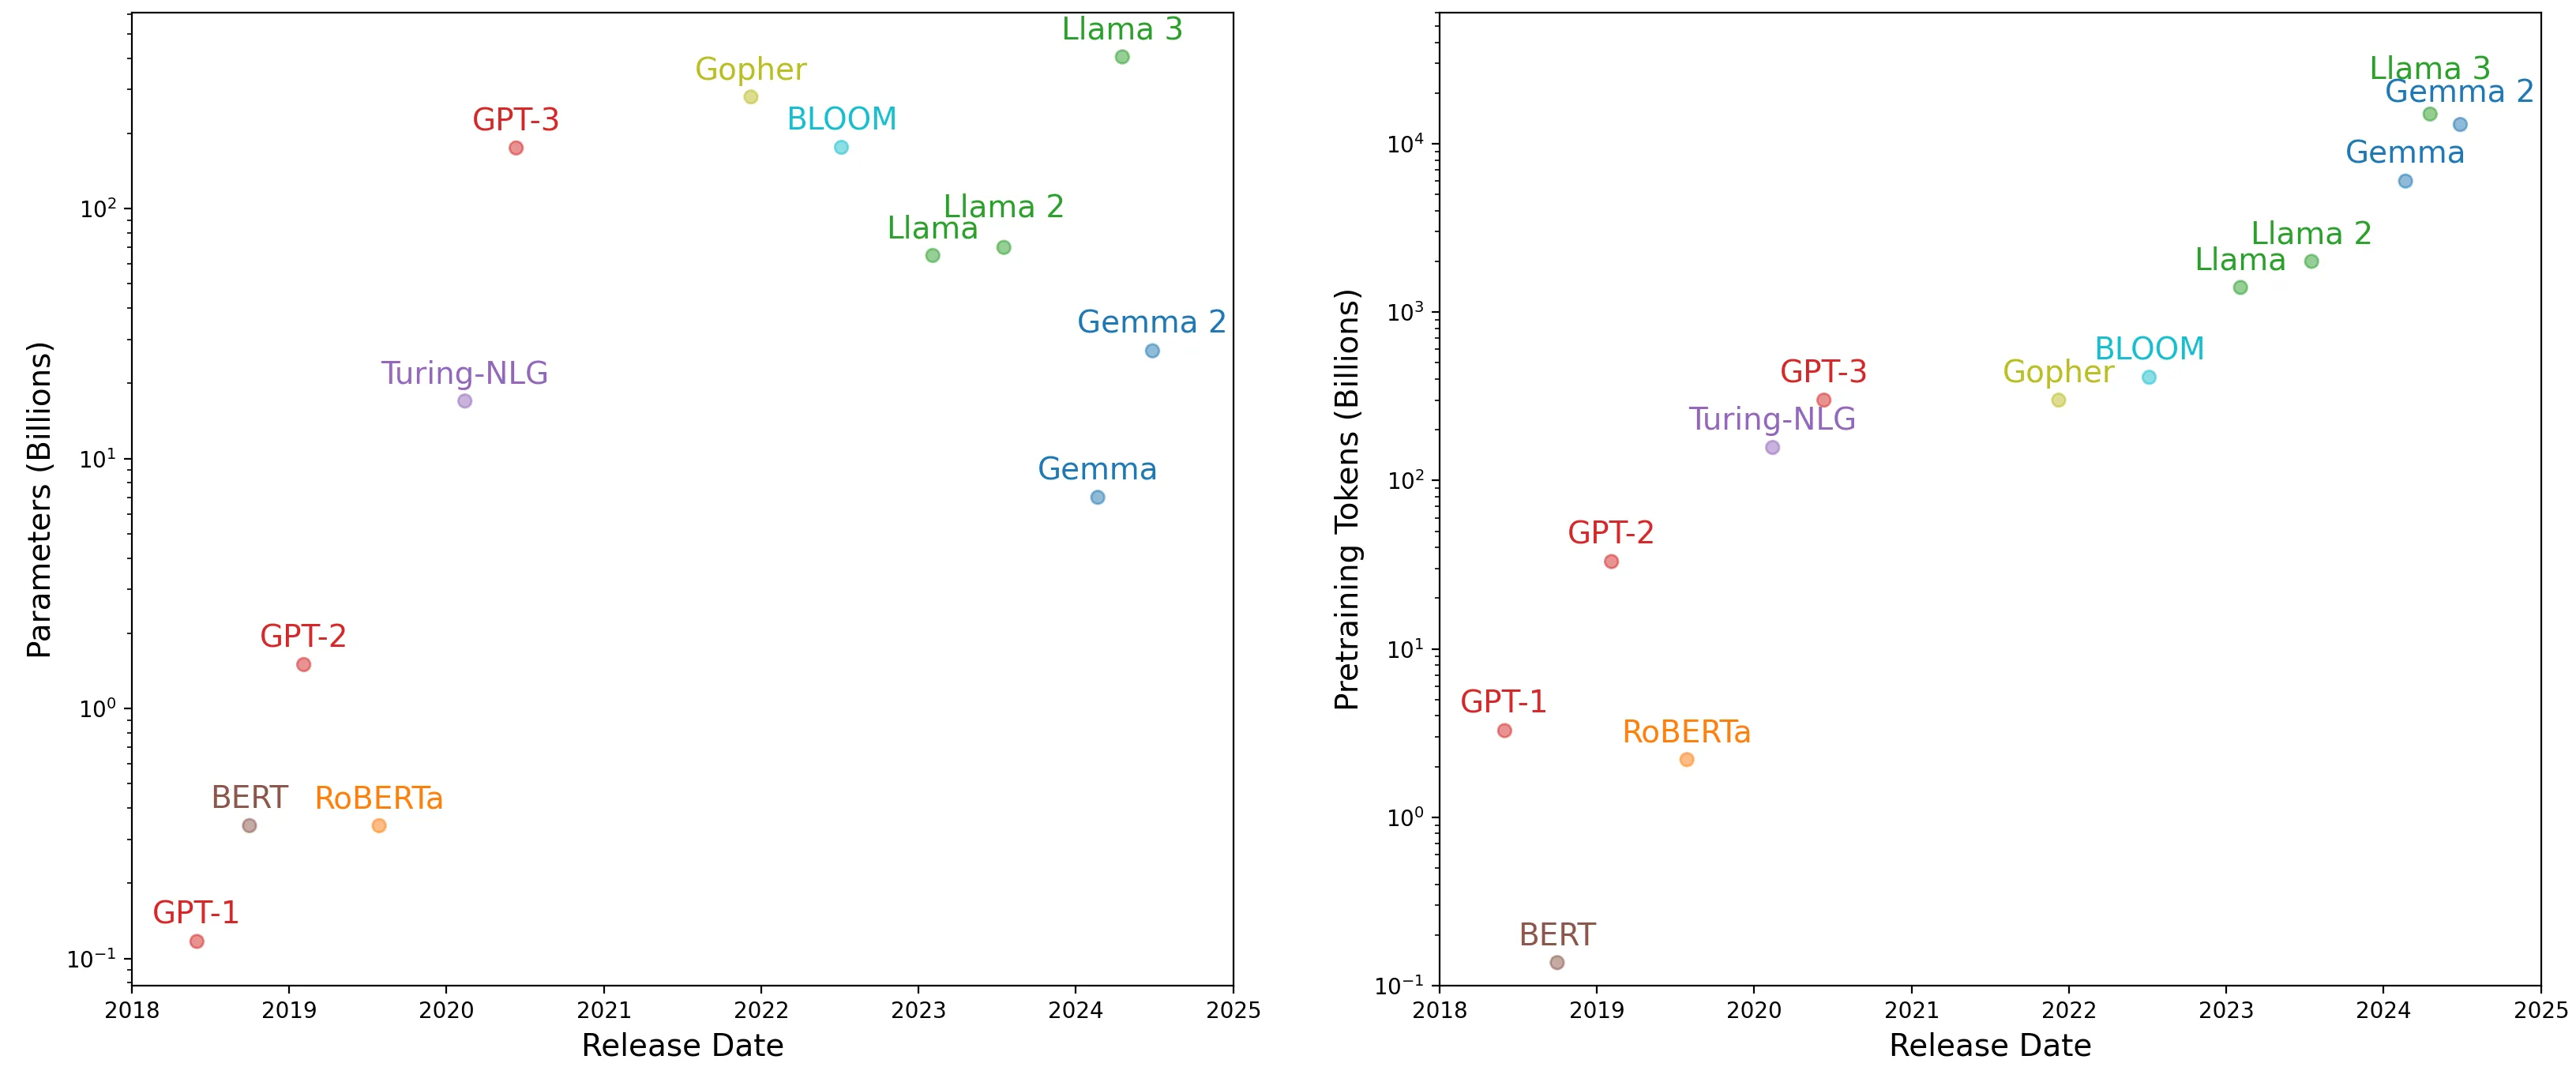
شکل ۱۶.۸: تعداد پارامترهای LLM (سمت چپ) و اندازههای مجموعه دادههای پیشآموزش (سمت راست) در طول زمان. بسیاری از LLMهای اختصاصی اخیر (مانند GPT-4 و Gemini) گنجانده نشدهاند زیرا جزئیات مدل افشا نشده است.
دلیل دیگری وجود دارد که ممکن است نتوانیم به سادگی و بدون فکر این مدلها را مقیاس دهیم: ما در حال اتمام دادههای پیشآموزش هستیم! شرکتهای فناوری در یافتن محتوای باکیفیت، عمومی و نوشتهشده توسط انسان برای اختصاص دادن به پیشآموزش دچار مشکل شدهاند. مدلها حتی شروع به «خوردن دم خود» با آموزش روی بخش قابل توجهی از محتوای ایجادشده توسط سایر LLMها کردهاند، که به مجموعهٔ کاملی از نگرانیهای دیگر برخورد میکند. این یکی از دلایلی است که یادگیری تقویتی اخیراً توجه زیادی را به خود جلب کرده است. اگر بتوانید یک محیط دشوار و خودبسنده ایجاد کنید که مسائل جدیدی را برای تلاش یک LLM ایجاد کند، راهی برای ادامهٔ آموزش با استفاده از خروجیهای خود مدل پیدا کردهاید — بدون نیاز به جستجوی وب برای لقمههای بیشتری از متن باکیفیت.
هیچیک از راهحلهایی که به آنها اشاره کردیم یک راهحل جادویی برای مسائل پیش روی LLMها نخواهد بود. در پایان روز، مشکل بنیادین همچنان باقی میماند که LLMها در یادگیری در مقایسه با انسانها به شدت ناکارآمد هستند. قابلیتهای مدل تنها از آموزش روی چندین مرتبهٔ بزرگی متن بیشتر از آنچه انسانها در طول زندگی خود میخوانند ناشی میشود. همانطور که مقیاسدهی LLMها ادامه مییابد، پژوهشهای بنیادیتر در مورد نحوهٔ ساخت مدلهایی که میتوانند به سرعت با دادههای محدود یاد بگیرند نیز ادامه خواهد یافت.
با این حال، LLMها توانایی ساخت رابطهای روان زبان طبیعی را نشان میدهند، و این به تنهایی تغییر عظیمی در آنچه میتوانیم با دستگاههای محاسباتی به انجام برسانیم به همراه خواهد داشت. در این فصل، ما دستورالعمل پایهای را ارائه دادیم که بسیاری از LLMها برای دستیابی به این قابلیتها از آن استفاده میکنند.
- مدلهای زبان بزرگ یا LLMها، ترکیبی از چند مؤلفهٔ کلیدی هستند:
- معماری ترنسفورمر
- یک وظیفهٔ مدلسازی زبان (پیشبینی توکن بعدی بر اساس توکنهای گذشته)
- مقدار زیادی دادهٔ متنی بدون برچسب
- یک LLM توزیع احتمالی را برای پیشبینی توکنهای منفرد یاد میگیرد. این میتواند با یک استراتژی نمونهبرداری ترکیب شود تا یک رشتهٔ متنی طولانی تولید کند. روشهای متداول زیادی برای نمونهبرداری متن وجود دارد:
- جستجوی حریصانه (Greedy search) محتملترین توکن پیشبینیشده را در هر مرحلهٔ تولید انتخاب میکند.
- نمونهبرداری تصادفی (Random sampling) مستقیماً از توزیع دستهای پیشبینیشده روی تمام توکنها نمونهبرداری میکند.
- نمونهبرداری Top-k توزیع دستهای را به مجموعهٔ K کاندید برتر محدود میکند.
- مدلهای زبان بزرگ (LLMها) از میلیاردها پارامتر استفاده میکنند و روی تریلیونها کلمه از متن آموزش میبینند.
- خروجی LLM غیرقابل اتکا است، و تمام LLMها گاهی اوقات اطلاعات نادرست واقعی را به صورت توهم (hallucinate) تولید میکنند.
- مدلهای LLM را میتوان برای پیروی از دستورالعملها در یک گفتگوی متنی تنظیم دقیق کرد. این نوع تنظیم دقیق تنظیم دقیق دستوری (instruction fine-tuning) نامیده میشود:
- سادهترین شکل تنظیم دقیق دستوری شامل آموزش مستقیم مدل روی جفتهای دستورالعمل و پاسخ است.
- اشکال پیشرفتهتر تنظیم دقیق دستوری شامل یادگیری تقویتی است.
- شایعترین گلوگاه منابع هنگام کار با LLMها، حافظهٔ شتابدهنده است.
- تکنیک LoRA روشی برای کاهش مصرف حافظه از طریق منجمد کردن اکثر پارامترهای ترنسفورمر و تنها بهروزرسانی یک تجزیهٔ کمرتبه از وزنهای نگاشت توجه است.
- مدلهای LLM در صورتی که بتوانید نحوهٔ چارچوببندی این ورودیها یا خروجیها را به عنوان دنبالههایی در یک مسئلهٔ پیشبینی دنباله بیابید، میتوانند دادههایی از مدهای متفاوتی را دریافت یا خروجی دهند.
- یک مدل بنیادین (foundation model) اصطلاحی عمومی برای مدلهایی از هر مدالیته است که با استفاده از خودنظارتی برای طیف گستردهای از وظایف پاییندست آموزش دیدهاند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
در سال ۲۰۲۲، جیسون آلن از نرمافزار تولید تصویر Midjourney برای برنده شدن جایزهٔ هنرمندان دیجیتال استفاده کرد، و در سال ۲۰۲۴، ری کودان یکی از معتبرترین جوایز ادبی ژاپن را برای رمانی که با کمک قابل توجهی از نرمافزارهای مولد نوشته شده بود، دریافت نمود. ↩
-
یانیس زناکیس، «Musiques formelles: nouveaux principes formels de composition musicale»، شمارهٔ ویژهٔ La Revue musicale، شمارههای ۲۵۳-۲۵۴ (۱۹۶۳). ↩
-
الک رادفورد، کارتیک ناراسیمهان، تیم سالیمانس و ایلیا سوتسکور، «Improving Language Understanding by Generative Pre-Training» (۲۰۱۸)، https://mng.bz/GweD. ↩
-
جی. ادوارد هو و همکاران، «LoRA: Low-Rank Adaptation of Large Language Models»، arXiv (۲۰۲۱)، https://arxiv.org/abs/2106.09685. ↩
-
اویانگ و همکاران، «Training Language Models to Follow Instructions with Human Feedback»، مجموعه مقالات سیوششمین کنفرانس بینالمللی سیستمهای پردازش اطلاعات عصبی (۲۰۲۲)، https://arxiv.org/abs/2203.02155. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.