
فصل ۱۷: تولید تصویر
محبوبترین و موفقترین کاربرد هوش مصنوعی خلاق امروزه، تولید تصویر است: یادگیری فضاهای بصری نهان و نمونهبرداری از آنها برای خلق تصاویر کاملاً جدید و بدیع، که از تصاویر واقعی درونیابی شدهاند—تصاویری از انسانهای خیالی، مکانهای خیالی، گربهها و سگهای خیالی، و مواردی از این دست.
در این بخش و بخشهای بعدی، ما برخی مفاهیم سطح بالا را در رابطه با تولید تصویر مرور خواهیم کرد، همراه با پیادهسازی دو تکنیک از تکنیکهای اصلی در این حوزه: خودرمزگذارهای متغیر (VAEs) و مدلهای نفوذ (diffusion models).
یادگیری عمیق برای تولید تصویر
Section titled “یادگیری عمیق برای تولید تصویر”نمونهبرداری از فضاهای نهان تصاویر
Section titled “نمونهبرداری از فضاهای نهان تصاویر”ایدهٔ کلیدی تولید تصویر، توسعهٔ یک فضای نهان (latent space) کمبعد از بازنماییها است (که مانند هر فضای برداری، مجموعهای پیوسته از نقاط است)، به طوری که بتوان هر نقطهای را به یک تصویر با ظاهر واقعگرایانه نگاشت کرد. ماژولی که میتواند یک نقطهٔ نهان را دریافت کرده و یک تصویر خروجی دهد (یک شبکه از پیکسلها)، یک مولد (generator) نامیده میشود (یا در مورد VAEها، یک رمزگشا یا decoder). هنگامی که چنین فضایی توسعه یافت، میتوانید نقاط را به طور پیوسته یا تصادفی از آن نمونهبرداری کنید، و با نگاشت آنها به فضای تصویر، تصاویری تولید کنید که پیش از این هرگز دیده نشدهاند (شکل ۱۷.۱ را ببینید).
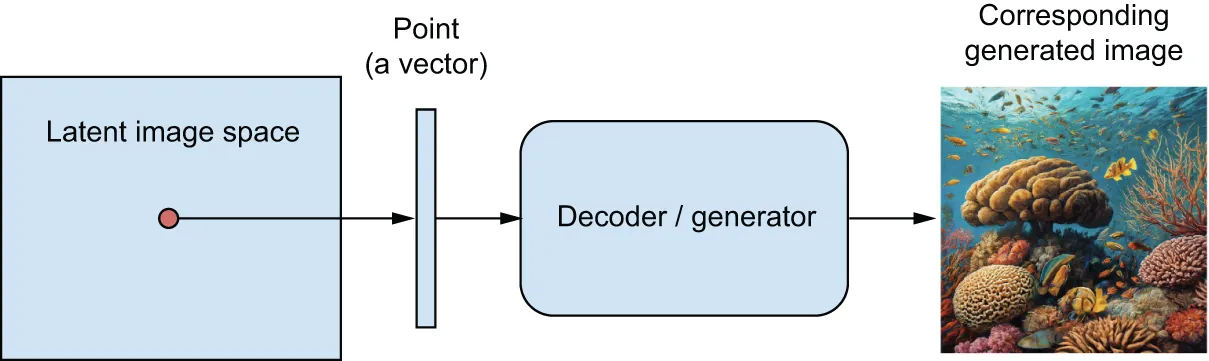
شکل ۱۷.۱: استفاده از یک فضای برداری نهان برای تولید تصاویر جدید و ویرایش تصاویر موجود
علاوه بر این، شرطیسازی با متن (text-conditioning) امکان نگاشت فضایی از اعلانها (prompts) در زبان طبیعی را به فضای نهان تصاویر فراهم میسازد، به طوری که بتوانید تصویری را به صورت متنی توصیف کرده و مدلی داشته باشید که دقیقاً آن تصویر را تولید کند (شکل ۱۷.۲ را ببینید).
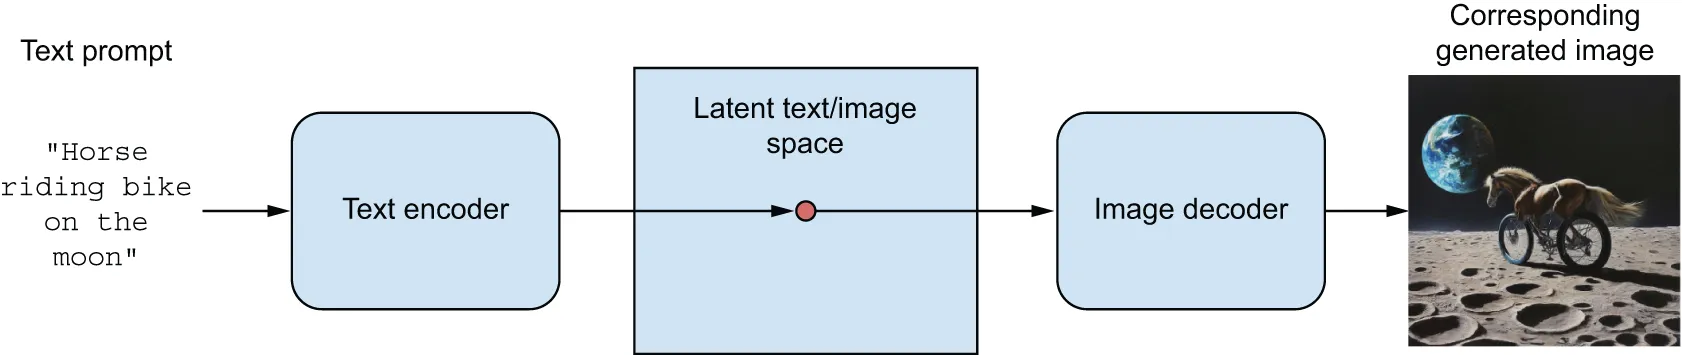
شکل ۱۷.۲: تولید تصویر با هدایت زبان با یک مدل نفوذ
درونیابی بین تصاویر آموزشی متعدد در فضای نهان، چنین مدلهایی را قادر میسازد تا ترکیبهای بیپایانی از مفاهیم را تولید کنند که ممکن است در دنیای واقعی وجود نداشته باشند: یک قلعهٔ قرون وسطایی روی مریخ، سگی که لباس فضانوردی پوشیده است، یا درختی با برگهایی از جنس بلور. مدل میتواند بردارهایی را ترکیب کند که مفاهیم متفاوتی را در فضای نهانش رمزگذاری میکنند تا تصویری ایجاد کند که تمام این مفاهیم را همزمان بازتاب دهد.
البته، هنوز چالشهایی برای غلبه کردن وجود دارد. مانند تمام مدلهای یادگیری عمیق، فضای نهان یک مدل معنایی پیوسته از جهان فیزیکی را رمزگذاری نمیکند؛ بلکه صرفاً ساختار آماری دادههای آموزشی خود را یاد میگیرد. یک مدل نمیداند که یک اسب چهار پا دارد به همان شیوهای که یک انسان درک میکند؛ فقط میداند که ویژگیهای بصری خاصی معمولاً با هم در تصاویر ظاهر میشوند. به همین دلیل است که مدلهای تولید تصویر گاهی اوقات اشتباهات عجیبی مرتکب میشوند، مانند تولید افرادی با شش انگشت، اسبهایی با پاهای اضافی، یا متونی که مانند رشتههای بیمعنی از حروف به نظر میرسند. مدل واقعاً مانند یک هنرمند «نقاشی نمیکشد»؛ بلکه الگوهایی را بازسازی میکند که از مجموعهدادهٔ آموزشی خود درونیابی کرده است.
طیف وسیعی از راهبردهای مختلف برای یادگیری چنین فضاهای نهان از بازنماییهای تصویر وجود دارد که هر یک ویژگیهای خاص خود را دارند. رایجترین انواع مدلهای تولید تصویر عبارتند از:
- مدلهای نفوذ (Diffusion models)
- خودرمزگذارهای متغیر (VAEs)
- شبکههای مولد متخاصم (GANs)
در حالی که ویرایشهای قبلی این کتاب شبکههای GAN را پوشش میدادند، آنها در سالهای اخیر به تدریج از رونق افتادهاند و تقریباً به طور کامل جای خود را به مدلهای نفوذ دادهاند. در این ویرایش، ما هم VAEها و هم مدلهای نفوذ را پوشش خواهیم داد و از GANها صرفنظر میکنیم. در مدلهایی که خودمان خواهیم ساخت، بر مدلهای نفوذ تمرکز خواهیم کرد زیرا آموزش آنها آسانتر است و عموماً نتایج بهتری به دست میدهند.
خودرمزگذارهای متغیر
Section titled “خودرمزگذارهای متغیر”مدلهای VAE، که به طور همزمان توسط کینگما و ولینگ در دسامبر ۲۰۱۳1 و رزند و همکاران در ژانویه ۲۰۱۴2 کشف شدند، نوعی از شبکههای مولد هستند که به ویژه برای وظایف ویرایش تصویر از طریق فضاهای نهان مناسب میباشند.
مدلهای VAE بیش از یک دهه است که وجود دارند، اما تا به امروز همچنان کارآمد و مطرح باقی ماندهاند و در پژوهشهای اخیر به کار گرفته میشوند. مدلهای نفوذ پیشرفتهٔ مدرن (از جمله Stable Diffusion که در انتهای این فصل استفاده خواهیم کرد) برای تولید تصاویر مستقیماً در فضای پیکسل بسیار سنگین و محاسباتی هستند، بنابراین به جای آن در فضای نهان فشردهٔ یک VAE عمل میکنند!
یک خودرمزگذار تصویر کلاسیک، تصویری را میگیرد، آن را از طریق یک ماژول رمزگذار به یک فضای برداری نهان نگاشت میکند، و سپس آن را از طریق یک ماژول رمزگشا به تصویری با همان ابعاد اصلی واگشایی (decode) مینماید (شکل ۱۷.۳ را ببینید). سپس با استفاده از همان تصاویر به عنوان دادههای ورودی و دادههای هدف آموزش داده میشود—به این معنی که خودرمزگذار یاد میگیرد ورودی اصلی را بازسازی کند. با اعمال محدودیتهای مختلف بر «کد» (نقطه در فضای نهان)، میتوان خودرمزگذار را وادار کرد بازنماییهای کموبیش جالبی از دادهها را بیاموزد. متداولترین محدودیت، کمبعد ساختن کد و ایجاد گلوگاه است، که در این حالت رمزگذار به عنوان راهی برای فشردهسازی تصویر ورودی به اطلاعات کمتر عمل میکند.
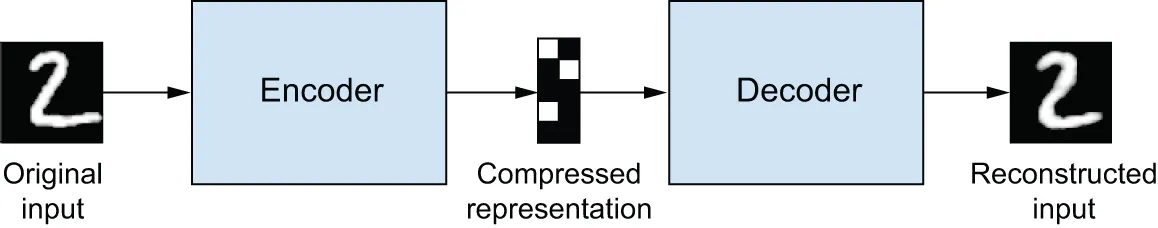
شکل ۱۷.۳: یک خودرمزگذار: نگاشت یک ورودی به یک فضای برداری نهان و بازسازی ورودی از این فضای نهان
در عمل، چنین خودرمزگذارهای کلاسیکی به فضاهای نهان چندان مفید یا با ساختار مناسبی منجر نمیشوند. آنها به ویژه برای تولید تصویر چندان خوب نیستند: فضای نهان آنها پیوسته نیست و در صورت نمونهبرداری از یک بردار تصادفی از آن، بعید است که یک تصویر معتبر بازسازی شود. آنها اساساً کارهای فشردهسازی هستند که تصاویر را در نقاطی مجزا بستهبندی میکنند بدون اینکه فضایی پیوسته و درونیاب میان آنها بسازند.
یک VAE، به جای فشردهسازی تصویر ورودی خود به یک کد ثابت در فضای نهان، تصویر را به پارامترهای یک توزیع آماری تبدیل میکند: یک میانگین و یک واریانس. اساساً، این بدان معناست که ما فرض میکنیم تصویر ورودی توسط یک فرایند آماری تولید شده است، و تصادفی بودن این فرایند باید در طول رمزگذاری و رمزگشایی در نظر گرفته شود. سپس VAE از پارامترهای میانگین و واریانس برای نمونهبرداری تصادفی یک عنصر از توزیع استفاده میکند و آن عنصر را مجدداً به ورودی اصلی واگشایی مینماید (شکل ۱۷.۴ را ببینید). تصادفی بودن این فرایند استحکام را بهبود میبخشد و فضای نهان را وادار میکند در همه جا پیوستگی را حفظ کند: هر نقطهای که در فضای نهان نمونهبرداری شود، تصویری معتبر را بازسازی خواهد کرد.
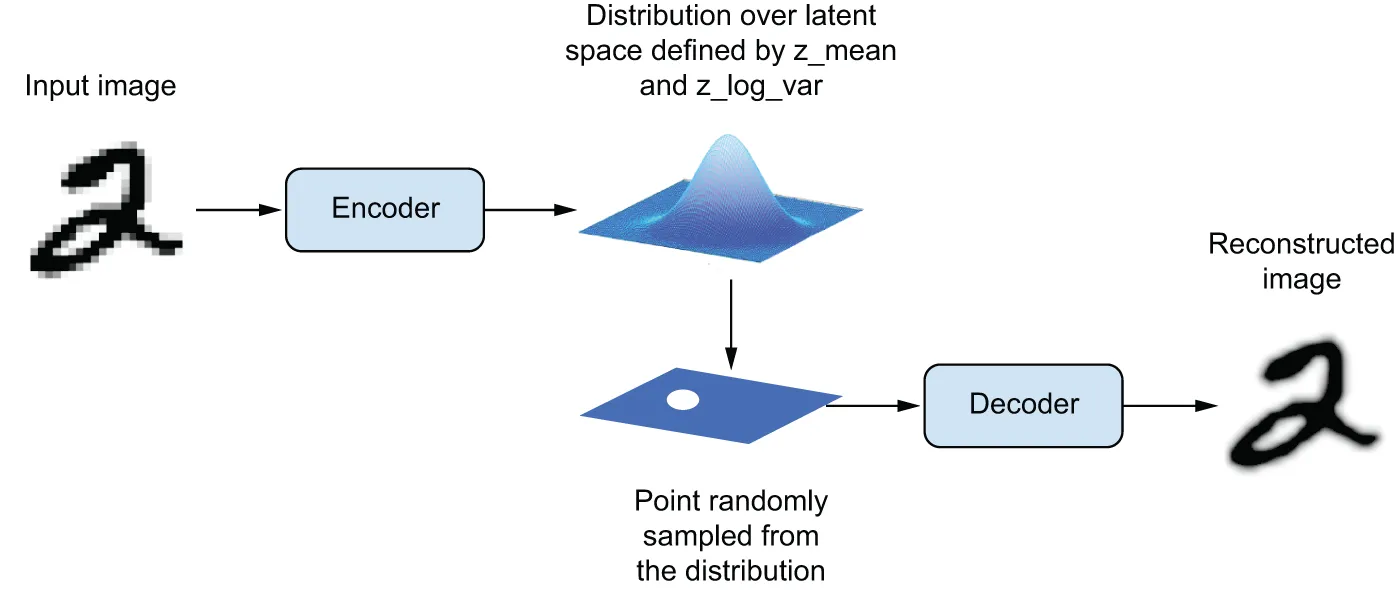
شکل ۱۷.۴: یک VAE تصویری را به دو بردار، z_mean و z_log_sigma نگاشت میکند که یک توزیع احتمال را روی فضای نهان تعریف میکنند، و برای نمونهبرداری از یک نقطهٔ نهان جهت واگشایی استفاده میشود.
از نظر فنی، نحوهٔ کارکرد یک VAE به صورت زیر است:
- یک ماژول رمزگذار، نمونهٔ ورودی
input_imgرا به دو پارامتر در یک فضای نهان از بازنماییها،z_meanوz_log_varianceتبدیل میکند. - شما به طور تصادفی نقطهای به نام
zرا از توزیع نرمال نهانی که فرض شده تصویر ورودی را تولید کرده است نمونهبرداری میکنید، از طریقz = z_mean + exp(z_log_variance) * epsilon، که در آنepsilonتانسوری تصادفی از مقادیر کوچک است. - یک ماژول رمزگشا این نقطه در فضای نهان را مجدداً به تصویر ورودی اصلی نگاشت میکند.
از آنجا که epsilon تصادفی است، این فرایند تضمین میکند هر نقطهای که نزدیک به مکان نهانی باشد که در آن input_img را رمزگذاری کردهاید (z_mean)، میتواند به چیزی شبیه به input_img واگشایی شود، و در نتیجه فضای نهان را وادار میکند به صورت پیوسته معنادار باشد. هر دو نقطهٔ نزدیک در فضای نهان به تصاویری بسیار شبیه به هم واگشایی خواهند شد. پیوستگی، همراه با ابعاد پایین فضای نهان، هر جهتی در فضای نهان را وادار میکند تا یک محور معنادار از تغییر دادهها را رمزگذاری کند، و فضای نهان را بسیار ساختاریافته و در نتیجه کاملاً مناسب برای دستکاری از طریق بردارهای مفهومی میسازد.
پارامترهای یک VAE از طریق دو تابع زیان آموزش داده میشوند: یک زیان بازسازی (reconstruction loss) که نمونههای واگشاییشده را مجبور میکند با ورودیهای اولیه مطابقت داشته باشند، و یک زیان منظمسازی (regularization loss) که به یادگیری توزیعهای نهانٔ خوشساختار کمک میکند و بیشبرازش به دادههای آموزشی را کاهش میدهد. از نظر شماتیک، این فرایند به صورت زیر است:
# Encodes the input into a mean and variance parameterz_mean, z_log_variance = encoder(input_img)# Draws a latent point using a small random epsilonz = z_mean + exp(z_log_variance) * epsilon# Decodes z back to an imagereconstructed_img = decoder(z)# Instantiates the autoencoder model, which maps an input image to its# reconstructionmodel = Model(input_img, reconstructed_img)سپس میتوانید مدل را با استفاده از زیان بازسازی و زیان منظمسازی آموزش دهید. برای زیان منظمسازی، ما معمولاً از عبارتی استفاده میکنیم (واگرایی کولبک-لایبلر یا Kullback–Leibler divergence) که هدف آن سوق دادن توزیع خروجی رمزگذار به سمت یک توزیع نرمال خوشساختار با میانگین ۰ است. این کار فرضی معقول دربارهٔ ساختار فضای نهانی که مدلسازی میکند در اختیار رمزگذار قرار میدهد.
اکنون بیایید ببینیم پیادهسازی یک VAE در عمل چگونه به نظر میرسد!
پیادهسازی یک VAE با کراس
Section titled “پیادهسازی یک VAE با کراس”ما قصد داریم یک VAE پیادهسازی کنیم که میتواند ارقام MNIST را تولید کند. این مدل شامل سه بخش خواهد بود:
- یک شبکهٔ رمزگذار که یک تصویر واقعی را به یک میانگین و یک واریانس در فضای نهان تبدیل میکند
- یک لایهٔ نمونهبرداری که چنین میانگین و واریانسی را دریافت کرده و از آنها برای نمونهبرداری یک نقطهٔ تصادفی از فضای نهان استفاده میکند
- یک شبکهٔ رمزگشا که نقاط را از فضای نهان مجدداً به تصاویر تبدیل مینماید
کد زیر شبکهٔ رمزگذاری را نشان میدهد که استفاده خواهید کرد، و تصاویر را به پارامترهای یک توزیع احتمال روی فضای نهان نگاشت میکند. این شبکه یک ConvNet ساده است که تصویر ورودی x را به دو بردار، z_mean و z_log_var نگاشت میکند. یک جزئیات مهم این است که ما به جای ادغام بیشینه (max pooling)، از گامها (strides) برای کاهش ابعاد نقشههای ویژگی استفاده میکنیم. آخرین باری که این کار را انجام دادیم در مثال بخشبندی تصویر فصل ۱۱ بود. به یاد بیاورید که به طور کلی، برای هر مدلی که به موقعیت مکانی اطلاعات اهمیت میدهد—یعنی اینکه اشیاء کجا در تصویر قرار دارند—گامها به ادغام بیشینه ترجیح داده میشوند، و این مدل نیز چنین است، زیرا باید رمزگذاری تصویری تولید کند که بتوان از آن برای بازسازی یک تصویر معتبر استفاده کرد.
فهرست ۱۷.۱: شبکهٔ رمزگذار VAE
import kerasfrom keras import layers
# Dimensionality of the latent space: a 2D planelatent_dim = 2
image_inputs = keras.Input(shape=(28, 28, 1))x = layers.Conv2D(32, 3, activation="relu", strides=2, padding="same")(    image_inputs)x = layers.Conv2D(64, 3, activation="relu", strides=2, padding="same")(x)x = layers.Flatten()(x)x = layers.Dense(16, activation="relu")(x)# The input image ends up being encoded into these two parameters.z_mean = layers.Dense(latent_dim, name="z_mean")(x)z_log_var = layers.Dense(latent_dim, name="z_log_var")(x)encoder = keras.Model(image_inputs, [z_mean, z_log_var], name="encoder")
خلاصهٔ ساختار آن به شکل زیر است:
>>> encoder.summary()در ادامه کدی آمده است که از z_mean و z_log_var، پارامترهای توزیع آماری که فرض شده است input_img را تولید کردهاند، برای تولید یک نقطهٔ فضای نهان z استفاده میکند.
فهرست ۱۷.۲: لایهٔ نمونهبرداری فضای نهان
from keras import ops
class Sampler(keras.Layer):    def __init__(self, **kwargs):        super().__init__(**kwargs)        # We need a seed generator to use functions from keras.random        # in call().        self.seed_generator = keras.random.SeedGenerator()        self.built = True
    def call(self, z_mean, z_log_var):        batch_size = ops.shape(z_mean)[0]        z_size = ops.shape(z_mean)[1]        epsilon = keras.random.normal(            # Draws a batch of random normal vectors            (batch_size, z_size), seed=self.seed_generator        )        # Applies the VAE sampling formula        return z_mean + ops.exp(0.5 * z_log_var) * epsilon
کد زیر پیادهسازی رمزگشا را نشان میدهد. ما بردار z را به ابعاد یک تصویر تغییر شکل میدهیم و سپس از چند لایهٔ کانولوشن استفاده میکنیم تا به یک تصویر خروجی نهایی برسیم که ابعادی مشابه با input_img اصلی دارد.
فهرست ۱۷.۳: شبکهٔ رمزگشای VAE، نگاشت نقاط فضای نهان به تصاویر
# Input where we'll feed zlatent_inputs = keras.Input(shape=(latent_dim,))# Produces the same number of coefficients we had at the level of the# Flatten layer in the encoderx = layers.Dense(7 * 7 * 64, activation="relu")(latent_inputs)# Reverts the Flatten layer of the encoderx = layers.Reshape((7, 7, 64))(x)# Reverts the Conv2D layers of the encoderx = layers.Conv2DTranspose(64, 3, activation="relu", strides=2, padding="same")( x)x = layers.Conv2DTranspose(32, 3, activation="relu", strides=2, padding="same")( x)# The output ends up with shape (28, 28, 1).decoder_outputs = layers.Conv2D(1, 3, activation="sigmoid", padding="same")(x)decoder = keras.Model(latent_inputs, decoder_outputs, name="decoder")خلاصهٔ ساختار آن به شکل زیر است:
>>> decoder.summary()اکنون، بیایید خود مدل VAE را ایجاد کنیم. این اولین مثال شما از مدلی است که یادگیری نظارتشده انجام نمیدهد (یک خودرمزگذار نمونهای از یادگیری خودنظارتی است زیرا از ورودیهای خود به عنوان اهداف استفاده میکند). هر زمان که از یادگیری نظارتشدهٔ کلاسیک فاصله میگیرید، متداول است که کلاس فرعی از کلاس Model ایجاد کرده و یک train_step() سفارشی برای مشخص کردن منطق جدید آموزش پیادهسازی نمایید، جریانی کاری که در فصل ۷ با آن آشنا شدید. ما میتوانستیم به راحتی این کار را در اینجا انجام دهیم، اما نقطهٔ ضعف این تکنیک این است که محتوای train_step() باید وابسته به بکاند باشد—شما با TensorFlow از GradientTape استفاده میکنید، با PyTorch از loss.backward() استفاده میکنید، و غیره. راه سادهتر برای سفارشیسازی منطق آموزش، پیادهسازی متد compute_loss() و حفظ train_step() پیشفرض است. متد compute_loss() بخش کلیدی منطق مشتقپذیر است که توسط train_step() توکار فراخوانی میشود. از آنجا که این متد شامل دستکاری مستقیم گرادیانها نیست، مستقل نگه داشتن آن از بکاند آسان است.
امضای آن به شکل زیر است:
compute_loss(x, y, y_pred, sample_weight=None, training=True)
که در آن x ورودی مدل است؛ y هدف مدل است (در مورد ما، None است زیرا مجموعهدادهای که استفاده میکنیم فقط ورودی دارد و هدفی ندارد)؛ و y_pred خروجی call() است—پیشبینیهای مدل. در هر جریان کاری آموزش نظارتشده، شما زیان را بر اساس y و y_pred محاسبه میکنید. در مورد ما، از آنجا که y برابر با None است و y_pred حاوی پارامترهای نهان است، ما زیان را با استفاده از x (ورودی اصلی) و reconstruction مشتقشده از y_pred محاسبه خواهیم کرد.
این متد باید یک مقدار اسکالر را برگرداند، یعنی مقدار زیانی که باید کمینهسازی شود. شما همچنین میتوانید از compute_loss() برای بهروزرسانی وضعیت معیارهای خود استفاده کنید، کاری که در مورد ما قصد انجام آن را داریم.
اکنون، بیایید VAE خود را با یک متد سفارشی compute_loss() بنویسیم. این مدل با تمام بکاندها بدون نیاز به هیچ تغییر کدی کار میکند!
فهرست ۱۷.۴: مدل VAE با متد سفارشی compute_loss()
class VAE(keras.Model):    def __init__(self, encoder, decoder, **kwargs):        super().__init__(**kwargs)        self.encoder = encoder        self.decoder = decoder        self.sampler = Sampler()        # We'll use these metrics to keep track of the loss averages        # over each epoch.        self.reconstruction_loss_tracker = keras.metrics.Mean(            name="reconstruction_loss"        )        self.kl_loss_tracker = keras.metrics.Mean(name="kl_loss")
    def call(self, inputs):        return self.encoder(inputs)
    def compute_loss(self, x, y, y_pred, sample_weight=None, training=True):        # Argument x is the model's input.        original = x        # Argument y_pred is the output of call().        z_mean, z_log_var = y_pred        # This is our reconstructed image.        reconstruction = self.decoder(self.sampler(z_mean, z_log_var))
        # We sum the reconstruction loss over the spatial dimensions        # (axes 1 and 2) and take its mean over the batch dimension.        reconstruction_loss = ops.mean(            ops.sum(                keras.losses.binary_crossentropy(x, reconstruction), axis=(1, 2)            )        )        # Adds the regularization term (Kullback–Leibler divergence)        kl_loss = -0.5 * (            1 + z_log_var - ops.square(z_mean) - ops.exp(z_log_var)        )        total_loss = reconstruction_loss + ops.mean(kl_loss)
        # Updates the state of our loss-tracking metrics        self.reconstruction_loss_tracker.update_state(reconstruction_loss)        self.kl_loss_tracker.update_state(kl_loss)        return total_loss
در نهایت، شما آمادهاید تا مدل را روی ارقام MNIST نمونهسازی کرده و آموزش دهید. از آنجا که compute_loss() قبلاً زیان را محاسبه میکند، نیازی به ارسال زیان در متد compile() نیست. ما همچنین برچسبهای هدف را ارسال نمیکنیم (هیچ برچسبی به مدل در fit ارسال نمیشود).
فهرست ۱۷.۵: آموزش دادن VAE
import numpy as np
(x_train, _), (x_test, _) = keras.datasets.mnist.load_data()# We train on all MNIST digits, so we concatenate the training and test# samples.mnist_digits = np.concatenate([x_train, x_test], axis=0)mnist_digits = np.expand_dims(mnist_digits, -1).astype("float32") / 255
vae = VAE(encoder, decoder)# We don't pass a loss argument in compile(), since the loss is already# part of the train_step().vae.compile(optimizer=keras.optimizers.Adam())# We don't pass targets in fit(), since train_step() doesn't expect# any.vae.fit(mnist_digits, epochs=30, batch_size=128)
هنگامی که مدل آموزش دید، میتوانید از شبکهٔ decoder برای تبدیل بردارهای دلخواه در فضای نهان به تصاویر استفاده کنید.
فهرست ۱۷.۶: نمونهبرداری از شبکهای از نقاط از فضای نهان دوبعدی و واگشایی آنها به تصویر
import matplotlib.pyplot as plt
# We'll display a grid of 30 × 30 digits (900 digits total).n = 30digit_size = 28figure = np.zeros((digit_size * n, digit_size * n))
# Samples points linearly on a 2D gridgrid_x = np.linspace(-1, 1, n)grid_y = np.linspace(-1, 1, n)[::-1]
# Iterates over grid locationsfor i, yi in enumerate(grid_y):    for j, xi in enumerate(grid_x):        # For each location, samples a digit and adds it to our figure        z_sample = np.array([[xi, yi]])        x_decoded = vae.decoder.predict(z_sample)        digit = x_decoded[0].reshape(digit_size, digit_size)        figure[            i * digit_size : (i + 1) * digit_size,            j * digit_size : (j + 1) * digit_size,        ] = digit
plt.figure(figsize=(15, 15))start_range = digit_size // 2end_range = n * digit_size + start_rangepixel_range = np.arange(start_range, end_range, digit_size)sample_range_x = np.round(grid_x, 1)sample_range_y = np.round(grid_y, 1)plt.xticks(pixel_range, sample_range_x)plt.yticks(pixel_range, sample_range_y)plt.xlabel("z[0]")plt.ylabel("z[1]")plt.axis("off")plt.imshow(figure, cmap="Greys_r")
شبکهٔ ارقام نمونهبرداریشده (شکل ۱۷.۵ را ببینید) یک توزیع کاملاً پیوسته از کلاسهای رقمی مختلف را نشان میدهد، به طوری که یک رقم با دنبال کردن مسیری در فضای نهان به آرامی به رقمی دیگر تبدیل میشود. جهتهای خاص در این فضا معنادار هستند: برای مثال، جهتی برای «چهار-بودن»، «یک-بودن»، و غیره وجود دارد.
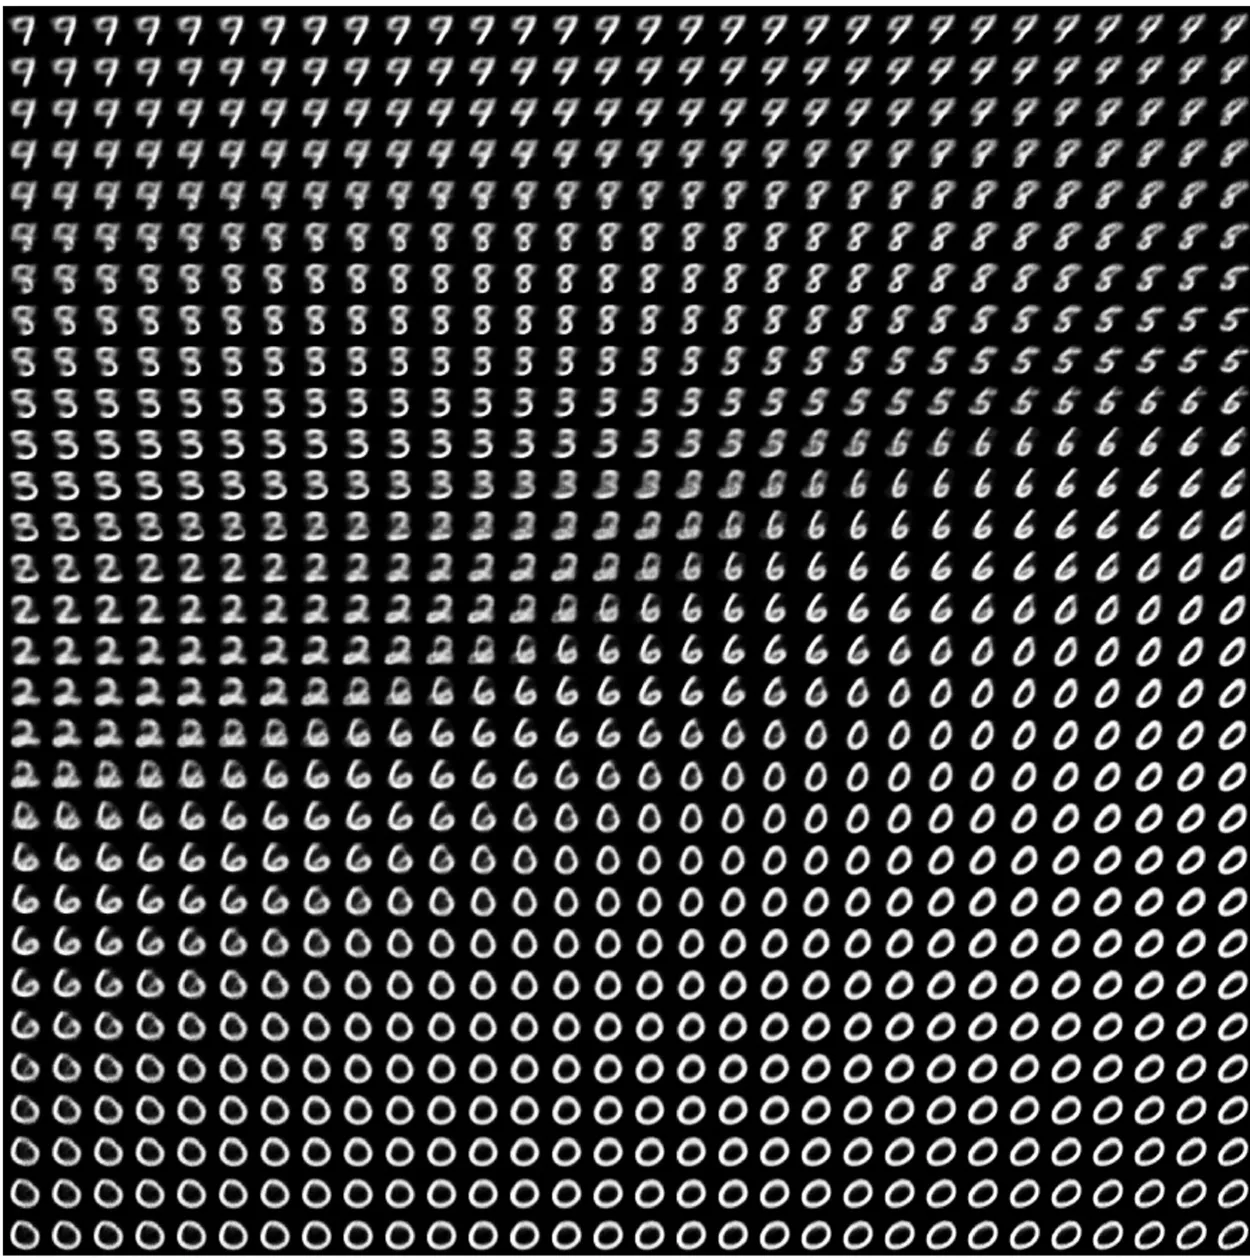
شکل ۱۷.۵: شبکهای از ارقام واگشاییشده از فضای نهان
در بخش بعدی، با جزئیات به بررسی ابزار عمدهٔ دیگری برای تولید تصویر خواهیم پرداخت: مدلهای نفوذ، معماریای که پشت تقریباً تمام سرویسهای تجاری تولید تصویر امروزی قرار دارد.
مدلهای نفوذ
Section titled “مدلهای نفوذ”یکی از کاربردهای دیرینهٔ خودرمزگذارها، نویززدایی (denoising) بوده است: دادن ورودیای به مدل که دارای نویز افزوده است (برای مثال، نویز گاوسی اضافه شده به تصویر، یا بخشهایی که به صورت تصادفی با صفر جایگزین شدهاند)، و هدف قرار دادن تصویر تمیز و اصلی برای خروجی مدل. این کار خودرمزگذار را وادار میکند تا ساختار آماری دادهها را بیاموزد تا بتواند ورودی دارای نویز را بازیابی و تمیز کند. کاربرد مدرنتر این تکنیک، ابر-تفکیکپذیری (super-resolution) تصویر است: ورودی یک تصویر تار با وضوح پایین است، و مدل برای تولید یک تصویر با وضوح بالا با جزئیات واضح و طبیعی آموزش میبیند (شکل ۱۷.۶ را ببینید).
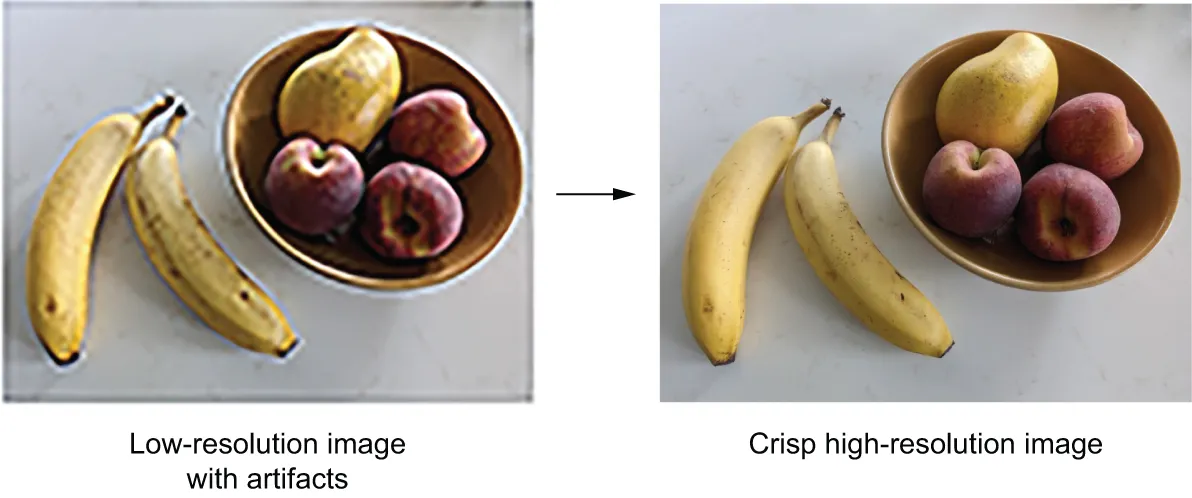
شکل ۱۷.۶: ابر-تفکیکپذیری تصویر: بازیابی جزئیات دقیق با نویززدایی از یک ورودی تار و بزرگنماییشده.
البته این مدلها جزئیات از دست رفته را مانند صحنههای تخیلی «بزرگنمایی کن و تصویر را واضح ساز» در فیلمهای پلیسی به شکل معجزهآسا بازیابی نمیکنند؛ بلکه بر اساس آنچه در طول آموزش دربارهٔ آمارهای بصری یاد گرفتهاند، جزئیاتی با ظاهر واقعگرایانه را توهم (یا حدس) میکنند. وقتی یک مدل ابر-تفکیکپذیری یک بافت مبهم را تمیز میکند، ممکن است الگوی فرضی از الیاف پارچه یا بافت پوست را در آن تزریق نماید، بدون اینکه دقیقاً الگوهای واقعی سوژهٔ اولیه باشند؛ با این حال، تصویر خروجی شارپ، منسجم و از نظر بصری قابل قبول خواهد بود.
موفقیتهای اولیه در نویززدایی تصویر پژوهشگران را به ایدهای جذاب رساند: از آنجا که میتوان از یک خودرمزگذار برای حذف نویز از یک تصویر استفاده کرد، چه اتفاقی میافتد اگر فرآیند نویززدایی را به صورت مکرر و حلقهای اعمال کنیم، هر بار بخش کوچکی از نویز را حذف کرده و از نویز کاملاً تصادفی و خالص شروع کنیم؟ آیا میتوان نویز خالص را به تصویری واقعی تبدیل کرد؟
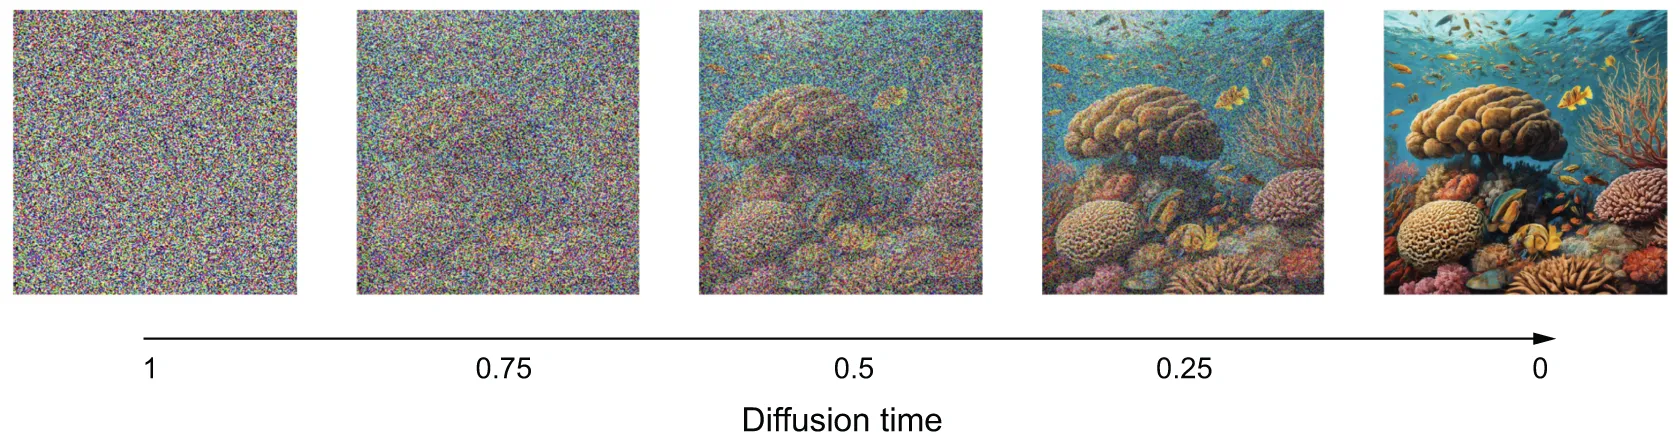
شکل ۱۷.۷: نفوذ معکوس: تبدیل نویز خالص به یک تصویر با اعمال مکرر یک مدل نویززدا، که در هر مرحله مقدار کمی از نویز را حذف میکند.
همانطور که مشخص شد، پاسخ مثبت است! با انجام این کار، شما میتوانید عملاً تصاویری کاملاً جدید را از هیچ خلق کنید—یا بهتر بگوییم، از یک بذر تصادفی از نویز خالص. این ایده، که به عنوان نفوذ معکوس (reverse diffusion) شناخته میشود، پایه و اساس مدلهای نفوذ امروزی است (به این دلیل که افزودن تدریجی نویز به یک تصویر شبیه به یک فرایند نفوذ فیزیکی مانند حل شدن یک قطره جوهر در آب است، بنابراین معکوس کردن این فرایند شبیه به تفکیک جوهر از آب است).
یک مدل نفوذ در اصل یک خودرمزگذار نویززدا در یک حلقه است که میتواند نویز خالص را به تصاویری واضح و واقعگرایانه تبدیل کند. مدلهای نفوذ امروزه روش غالب تولید تصویر هستند، زیرا آموزش آنها بسیار پایدارتر از GANها است و نمونههایی با تنوع بسیار بالا و وفاداری فوقالعاده تولید میکنند.
اکنون، بیایید یکی از این مدلها را با کراس بسازیم.
مجموعهدادهٔ گلهای آکسفورد
Section titled “مجموعهدادهٔ گلهای آکسفورد”مجموعهدادهای که قرار است استفاده کنیم، مجموعهدادهٔ گلهای آکسفورد (Oxford Flowers dataset) است. این مجموعه شامل ۸۱۸۹ تصویر از گلهای متعلق به ۱۰۲ دستهٔ مختلف است.
بیایید آرشیو مجموعهداده را دریافت کرده و آن را استخراج کنیم:
import os
fpath = keras.utils.get_file(    origin="https://www.robots.ox.ac.uk/~vgg/data/flowers/102/102flowers.tgz",    extract=True,)
متغیر fpath اکنون مسیر محلی به دایرکتوری استخراجشده است. تصاویر در زیرپوشهٔ jpg/ قرار دارند. بیایید دادهها را با استفاده از ابزار image_dataset_from_directory بارگذاری کنیم، و سپس تصاویر را برش دهیم و به ابعاد ۱۲۸ در ۱۲۸ تغییر اندازه دهیم:
ما باید اندازهٔ تصاویر خود را به یک اندازهٔ ثابت تغییر دهیم، اما نمیخواهیم نسبت ابعاد آنها تغییر کند زیرا این کار گلها را کشیده یا فشرده میکند. بنابراین از تابع crop_to_aspect_ratio=True در هنگام فراخوانی image_dataset_from_directory استفاده میکنیم تا ابتدا برشهای مربعی مرکزی ایجاد شوند و سپس به ابعاد مناسب (۱۲۸ در ۱۲۸) تغییر مقیاس یابند:
batch_size = 32image_size = 128images_dir = os.path.join(fpath, "jpg")dataset = keras.utils.image_dataset_from_directory( images_dir, # We won't need the labels, just the images. labels=None, image_size=(image_size, image_size), # Crops images when resizing them to preserve their aspect ratio crop_to_aspect_ratio=True,)dataset = dataset.rebatch( # We'd like all batches to have the same size, so we drop the last # (irregular) batch. batch_size, drop_remainder=True,)در اینجا یک تصویر نمونه نشان داده شده است (شکل ۱۷.۸):
from matplotlib import pyplot as plt
for batch in dataset:    img = batch.numpy()[0]    breakplt.imshow(img.astype("uint8"))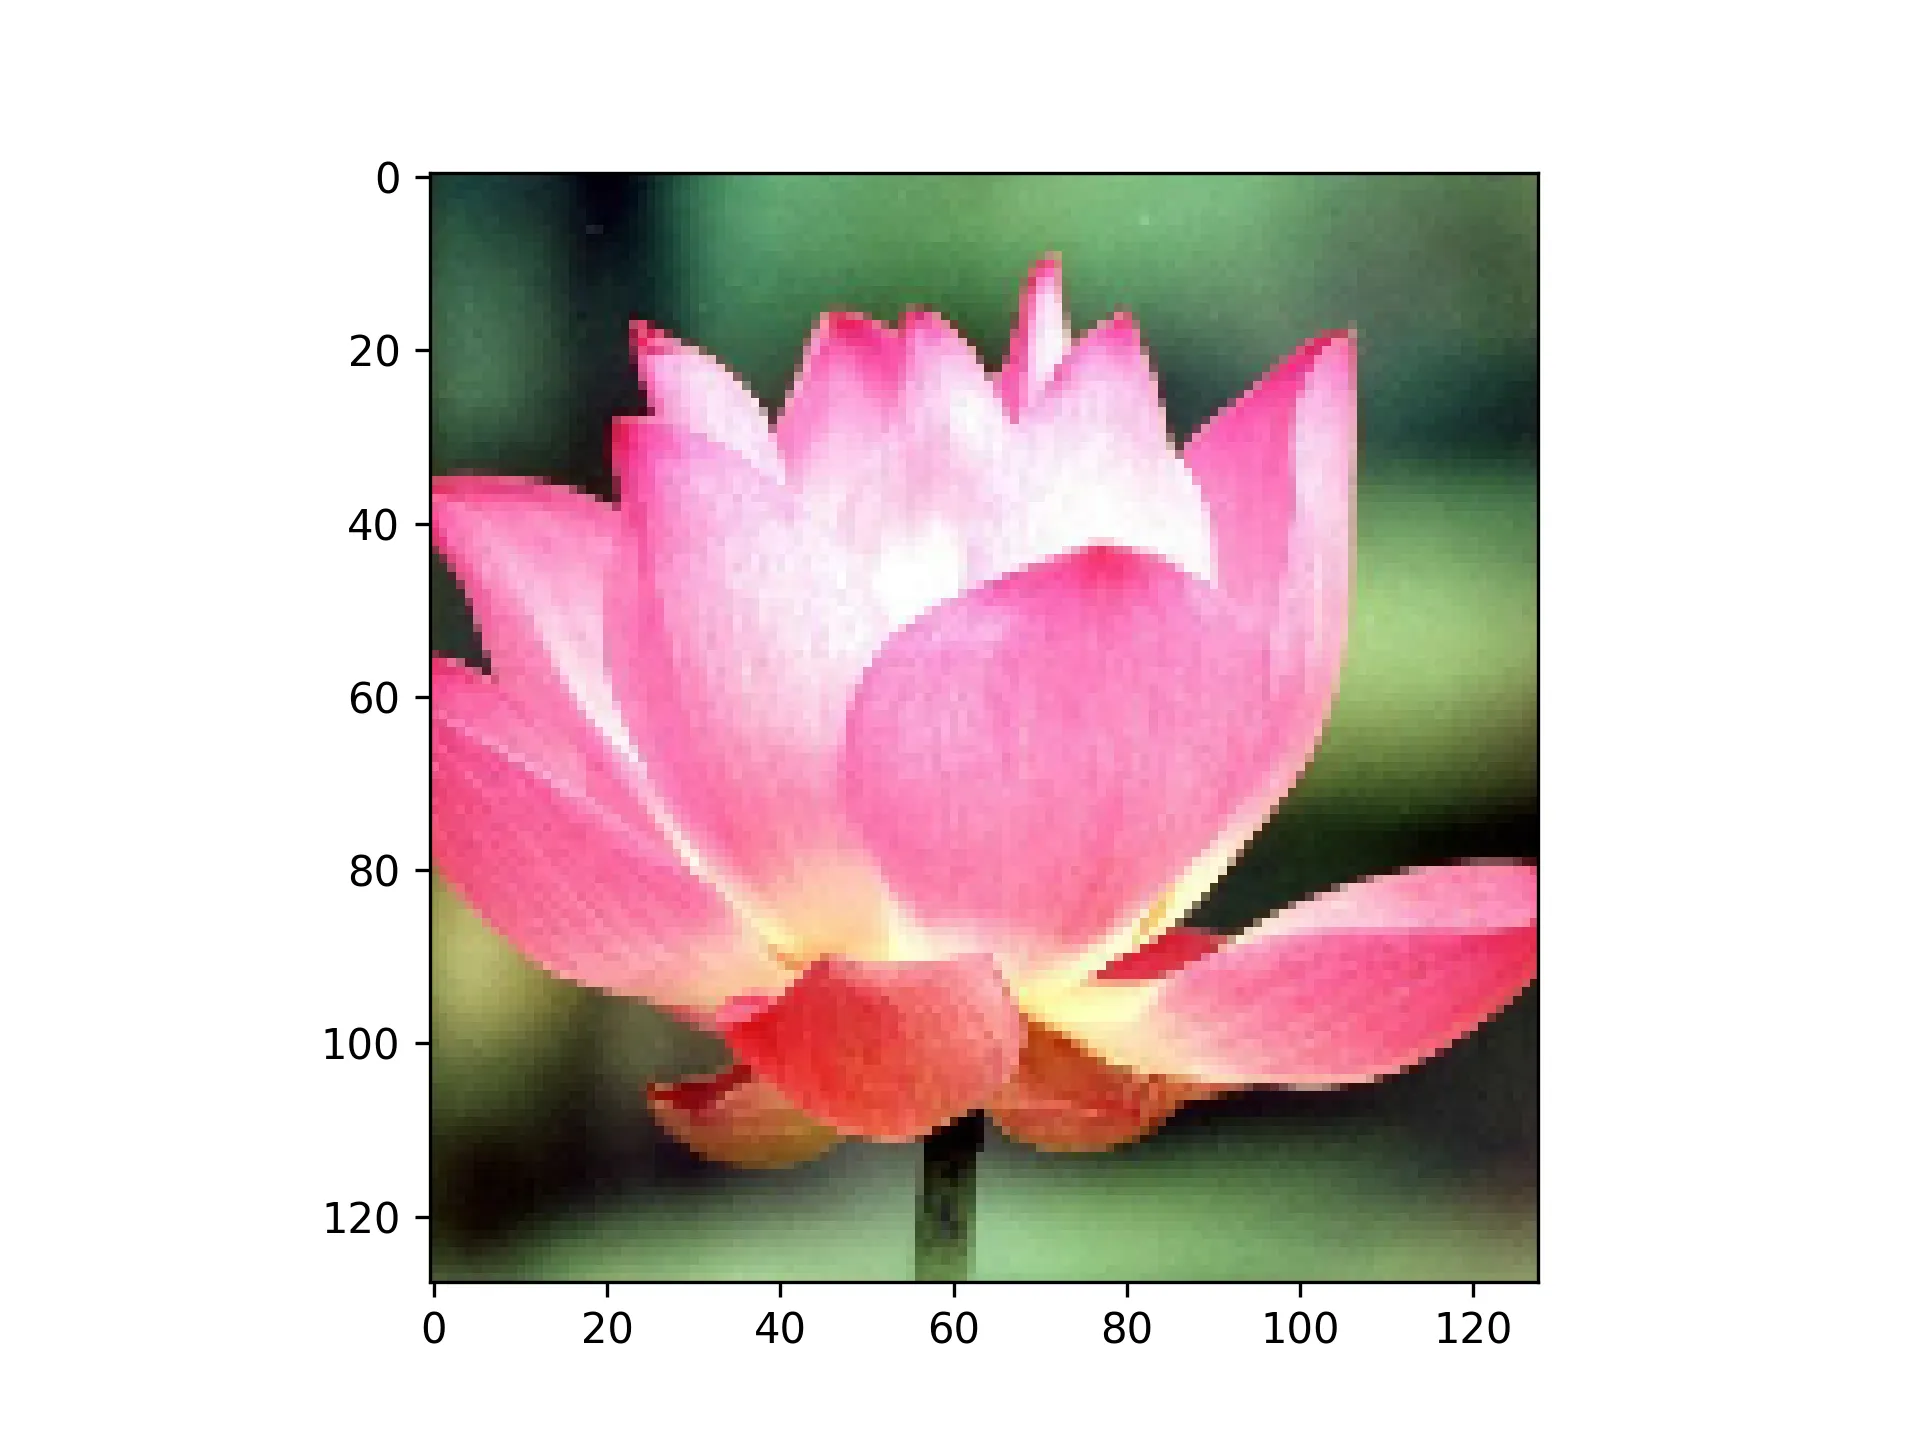
شکل ۱۷.۸: یک تصویر نمونه از مجموعهدادهٔ گلهای آکسفورد.
یک خودرمزگذار نویززدای U-Net
Section titled “یک خودرمزگذار نویززدای U-Net”همان مدل نویززدا در هر تکرار از فرایند نفوذ مجدداً استفاده میشود، و هر بار بخش کمی از نویز را پاک میکند. بنابراین باید به اندازهٔ کافی انعطافپذیر باشد تا بتواند سطوح بسیار متفاوتی از نویز را مدیریت کند: از نویز تقریباً خالص در مراحل ابتدایی، تا تصاویری که تقریباً تمیز هستند و فقط به کمی شفافسازی نهایی نیاز دارند. برای کمک به مدل در تنظیم رفتار خود، ما در هر مرحله به مدل میگوییم که فرآیند نفوذ چقدر پیش رفته است، با دادن متغیری به نام زمان نفوذ (diffusion time) به عنوان ورودی اضافی.
برای مدل نویززدای خود، از یک U-Net استفاده خواهیم کرد—نوعی از ConvNet که در اصل برای بخشبندی تصویر توسعه یافته بود، اما به ابزار استاندارد برای مدلهای نفوذ تبدیل شده است زیرا اندازهٔ تصویر ورودی و خروجی آن کاملاً یکسان است، و اتصالهای جهشی (skip connections) آن به حفظ دقیق ویژگیهای مکانی کمک میکنند (شکل ۱۷.۹ را ببینید).
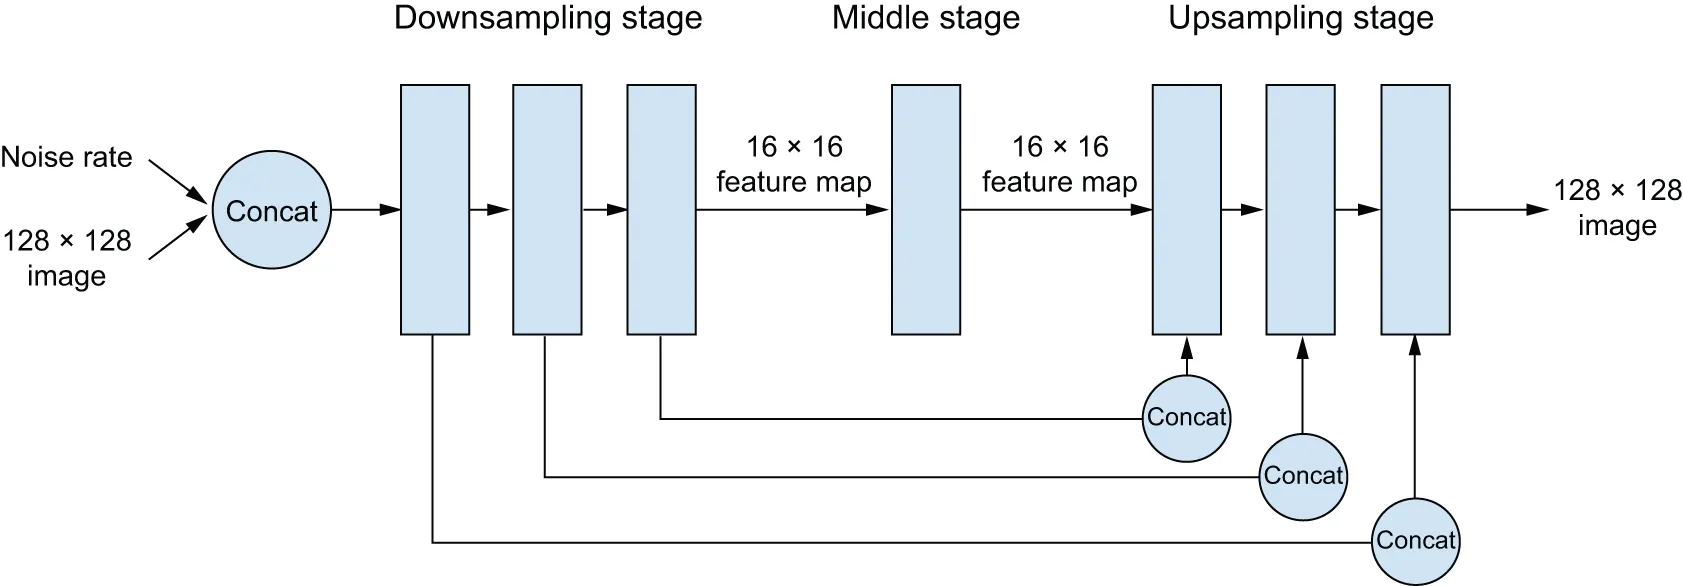
شکل ۱۷.۹: معماری به سبک U-Net ما برای نویززدایی تصویر. به اتصالهای جهشی که مراحل متناظر را در سرتاسر رمزگذار و رمزگشا به هم متصل میکنند توجه کنید.
این معماری دارای سه مرحله است:
- یک مرحلهٔ کاهش نمونهبرداری (downsampling stage)، متشکل از چندین بلوک از لایههای کانولوشن، که در آن ورودیها از اندازهٔ اولیهٔ ۱۲۸ × ۱۲۸ به اندازهای بسیار کوچکتر (در مورد ما، ۱۶ × ۱۶) کاهش نمونهبرداری میشوند.
- یک مرحلهٔ میانی (middle stage)، که در آن نقشهٔ ویژگی دارای اندازهای ثابت است.
- یک مرحلهٔ افزایش نمونهبرداری (upsampling stage)، که در آن نقشهٔ ویژگی دوباره تا اندازهٔ ۱۲۸ × ۱۲۸ افزایش نمونهبرداری میشود.
یک نگاشت ۱ به ۱ بین بلوکهای مراحل کاهش نمونهبرداری و افزایش نمونهبرداری وجود دارد: هر بلوک افزایش نمونهبرداری به بلوک کاهش نمونهبرداری با همان اندازهٔ مکانی متصل است (اتصال جهشی). این ویژگی به اطلاعات فضایی با تفکیکپذیری بالا اجازه میدهد تا گلوگاه فشردهسازی شبکه را دور بزنند، که برای بازیابی جزئیات ظریف پیکسلها در تصویر بازسازیشده بسیار حیاتی است.
بیایید این مدل را با استفاده از API تابعی سرهم کنیم:
# Utility function to apply a block of layers with a residual# connectiondef residual_block(x, width):    input_width = x.shape[3]    if input_width == width:        residual = x    else:        residual = layers.Conv2D(width, 1)(x)    x = layers.BatchNormalization(center=False, scale=False)(x)    x = layers.Conv2D(width, 3, padding="same", activation="swish")(x)    x = layers.Conv2D(width, 3, padding="same")(x)    x = x + residual    return x
def get_model(image_size, widths, block_depth):    noisy_images = keras.Input(shape=(image_size, image_size, 3))    noise_rates = keras.Input(shape=(1, 1, 1))
    x = layers.Conv2D(widths[0], 1)(noisy_images)    n = layers.UpSampling2D(image_size, interpolation="nearest")(noise_rates)    x = layers.Concatenate()([x, n])
    skips = []    # Dowsampling stage    for width in widths[:-1]:        for _ in range(block_depth):            x = residual_block(x, width)            skips.append(x)        x = layers.AveragePooling2D(pool_size=2)(x)
    # Middle stage    for _ in range(block_depth):        x = residual_block(x, widths[-1])
    # Upsampling stage    for width in reversed(widths[:-1]):        x = layers.UpSampling2D(size=2, interpolation="bilinear")(x)        for _ in range(block_depth):            x = layers.Concatenate()([x, skips.pop()])            x = residual_block(x, width)
    # We set the kernel initializer for the last layer to "zeros,"    # making the model predict only zeros after initialization (that    # is, our default assumption before training is "no noise").    pred_noise_masks = layers.Conv2D(3, 1, kernel_initializer="zeros")(x)
    # Creates the functional model    return keras.Model([noisy_images, noise_rates], pred_noise_masks)
شما میتوانید این مدل را با دستوری مانند get_model(image_size=128, widths=[32, 64, 96, 128], block_depth=2) نمونهسازی کنید. این دستور مدلی با حدود ۵ میلیون پارامتر ایجاد میکند که به اندازهٔ کافی برای اهداف ما کوچک است و آموزش آن سریع خواهد بود.
مفاهیم زمان نفوذ و برنامهٔ نفوذ
Section titled “مفاهیم زمان نفوذ و برنامهٔ نفوذ”فرایند نفوذ مجموعهای از مراحل است که در آنها خودرمزگذار نویززدای خود را برای پاک کردن مقدار کمی از نویز اعمال میکنیم. در هر مرحله، تصویری داریم که ترکیبی از سیگنال (تصویر تمیز واقعی) و نویز تصادفی است. متغیری به نام زمان نفوذ (diffusion time) ردیابی میکند که ما کجای فرایند هستیم: از زمان ۱ (نویز خالص، سیگنال صفر) تا زمان ۰ (تصویر تمیز، نویز صفر).
رابطهٔ بین زمان نفوذ فعلی و میزان نویز و سیگنال موجود در تصویر توسط برنامهٔ نفوذ (diffusion schedule) کنترل میشود. به جای یک برنامهٔ خطی ساده، امروزه استاندارد صنعتی استفاده از یک برنامهٔ کسینوسی است، که تغییر نرمتری بین سیگنال و نویز ارائه میدهد و کیفیت تصاویر تولیدشده را به طور چشمگیری بهبود میبخشد (شکل ۱۷.۱۰ را ببینید). ریاضیات این برنامه بر اساس رابطهٔ noise_rate**2 + signal_rate**2 = 1 استوار است، که تضمین میکند واریانس کل تصویر در طول تمام مراحل ثابت بماند.
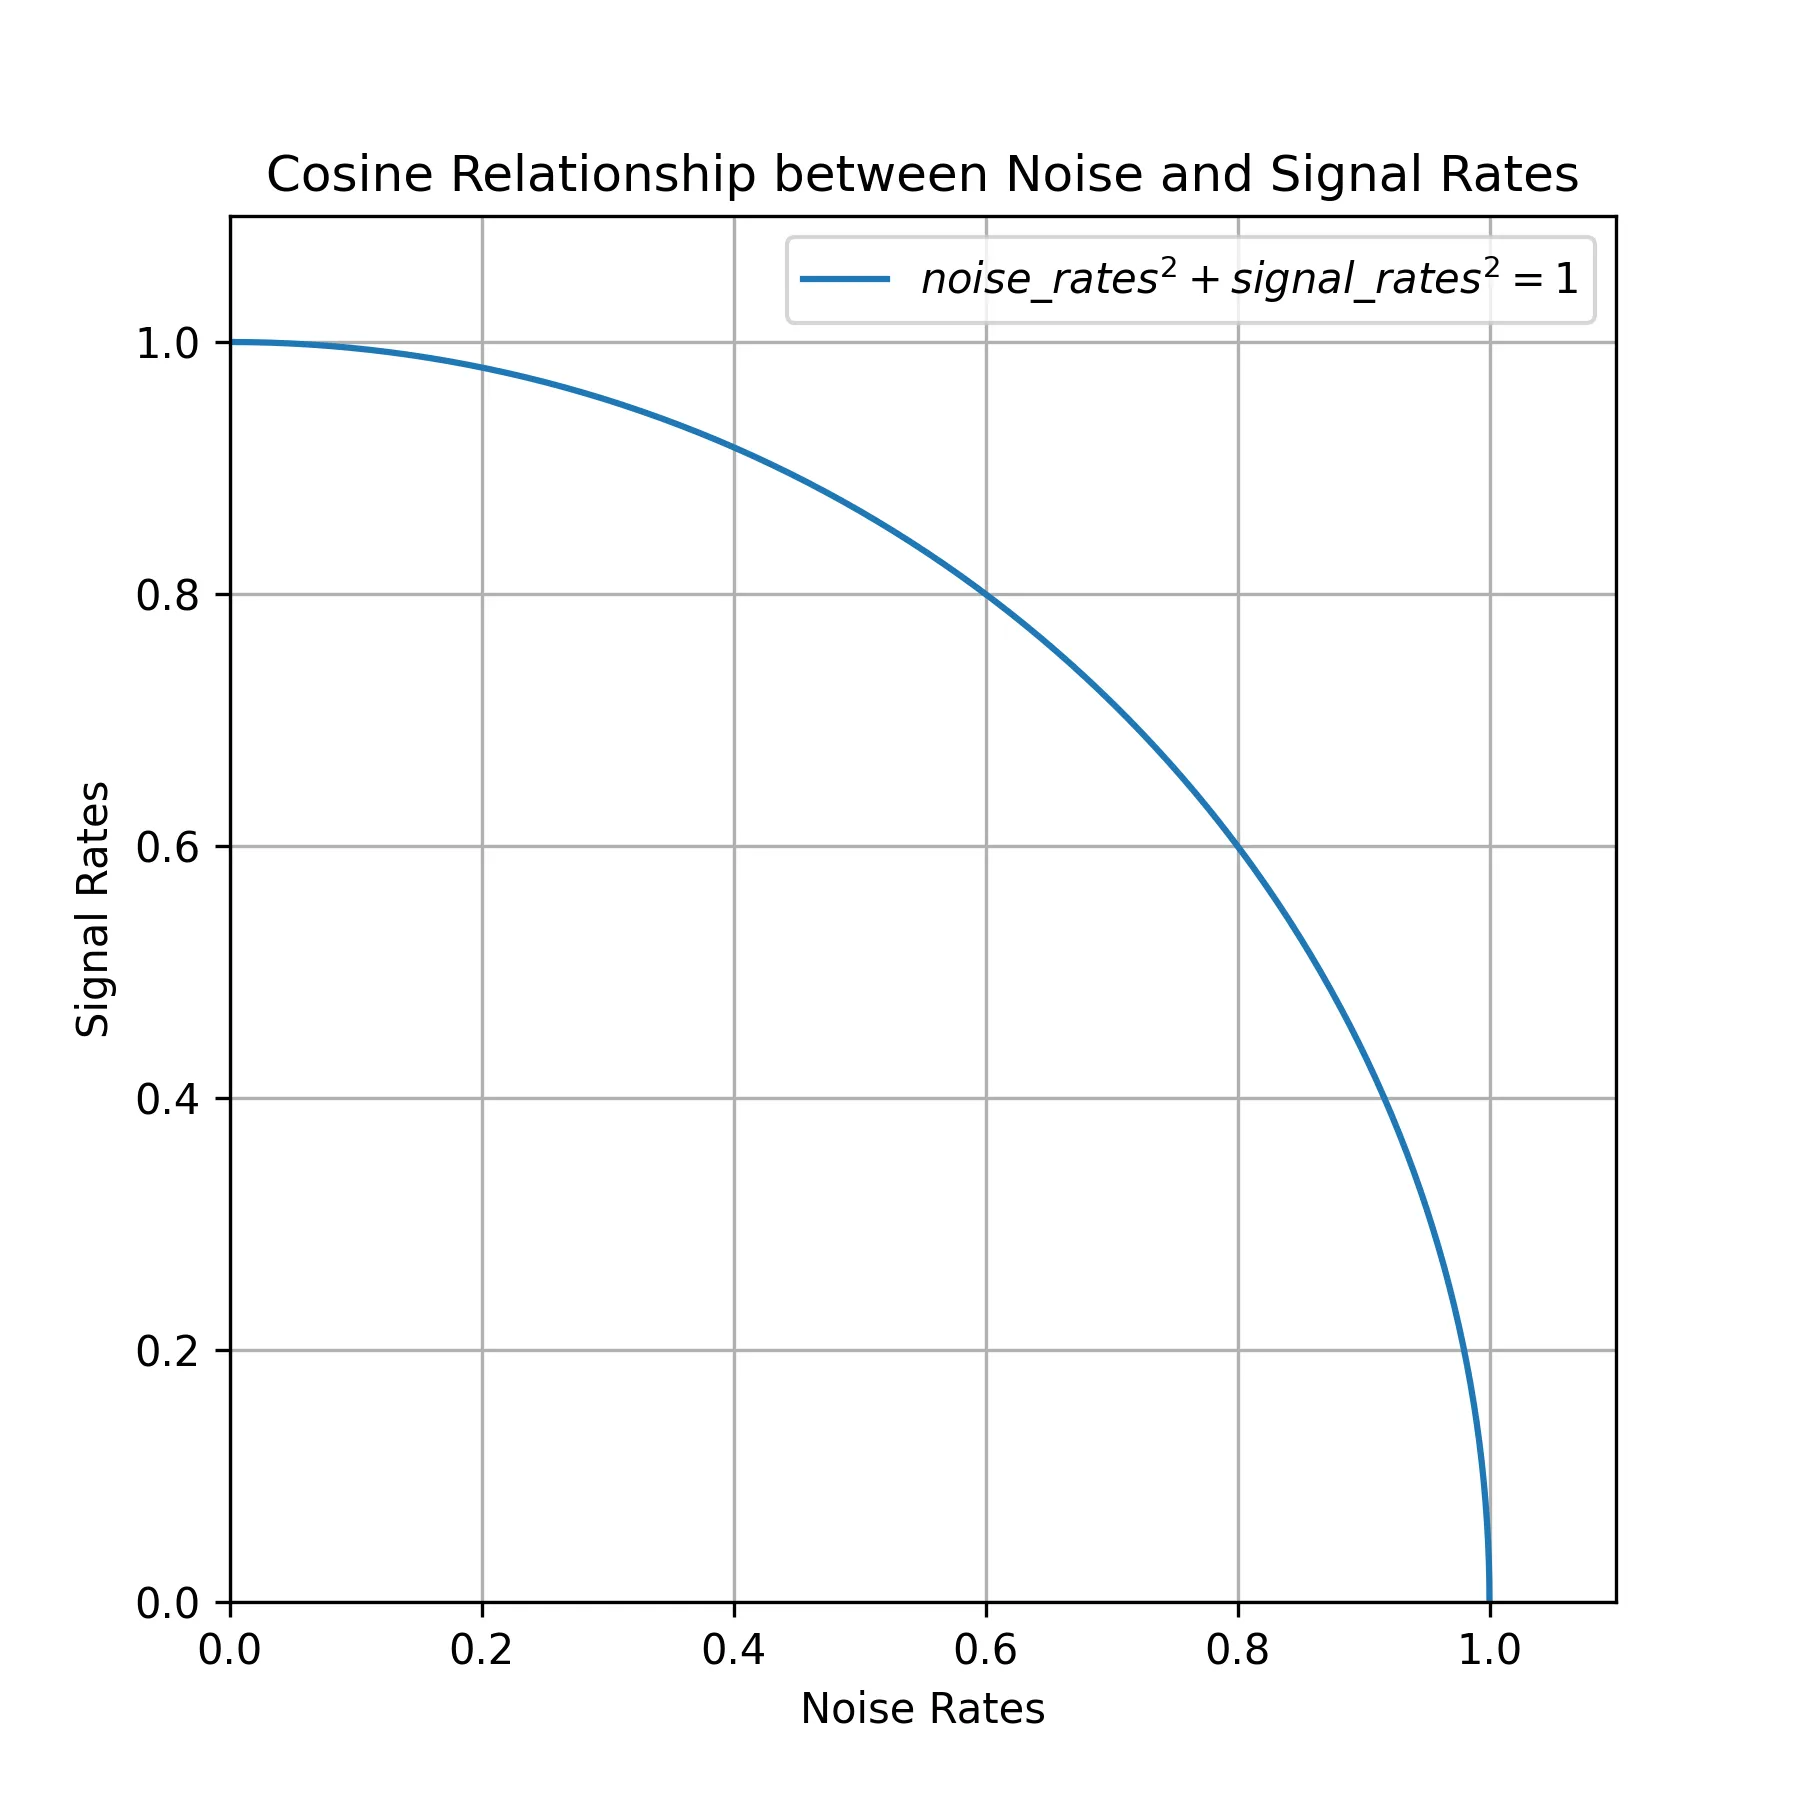
شکل ۱۷.۱۰: رابطهٔ کسینوسی بین زمان نفوذ و نرخهای سیگنال/نویز.
این تابع diffusion_schedule() یک تانسور diffusion_times را به عنوان ورودی دریافت میکند که مقادیری بین ۰ و ۱ را نشان میدهد، و نرخهای نویز و نرخهای سیگنال متناظر را برای هر یک برمیگرداند. این برنامه نرخها را در طول فرایند نفوذ هدایت خواهد کرد.
فهرست ۱۷.۷: برنامهٔ نفوذ
def diffusion_schedule( diffusion_times, min_signal_rate=0.02, max_signal_rate=0.95,): start_angle = ops.cast(ops.arccos(max_signal_rate), "float32") end_angle = ops.cast(ops.arccos(min_signal_rate), "float32") diffusion_angles = start_angle + diffusion_times * (end_angle - start_angle) signal_rates = ops.cos(diffusion_angles) noise_rates = ops.sin(diffusion_angles) return noise_rates, signal_ratesبیایید نحوهٔ نگاشت زمانهای نفوذ (بین ۰ و ۱) را توسط این تابع به نرخهای نویز و نرخهای سیگنال مشخص رسم کنیم (شکل ۱۷.۱۱ را ببینید):
diffusion_times = ops.arange(0.0, 1.0, 0.01)noise_rates, signal_rates = diffusion_schedule(diffusion_times)
# These lines are only necessary if you're using PyTorch, in which case# tensor conversion to NumPy is no longer trivial.diffusion_times = ops.convert_to_numpy(diffusion_times)noise_rates = ops.convert_to_numpy(noise_rates)signal_rates = ops.convert_to_numpy(signal_rates)
plt.plot(diffusion_times, noise_rates, label="Noise rate")plt.plot(diffusion_times, signal_rates, label="Signal rate")
plt.xlabel("Diffusion time")plt.legend()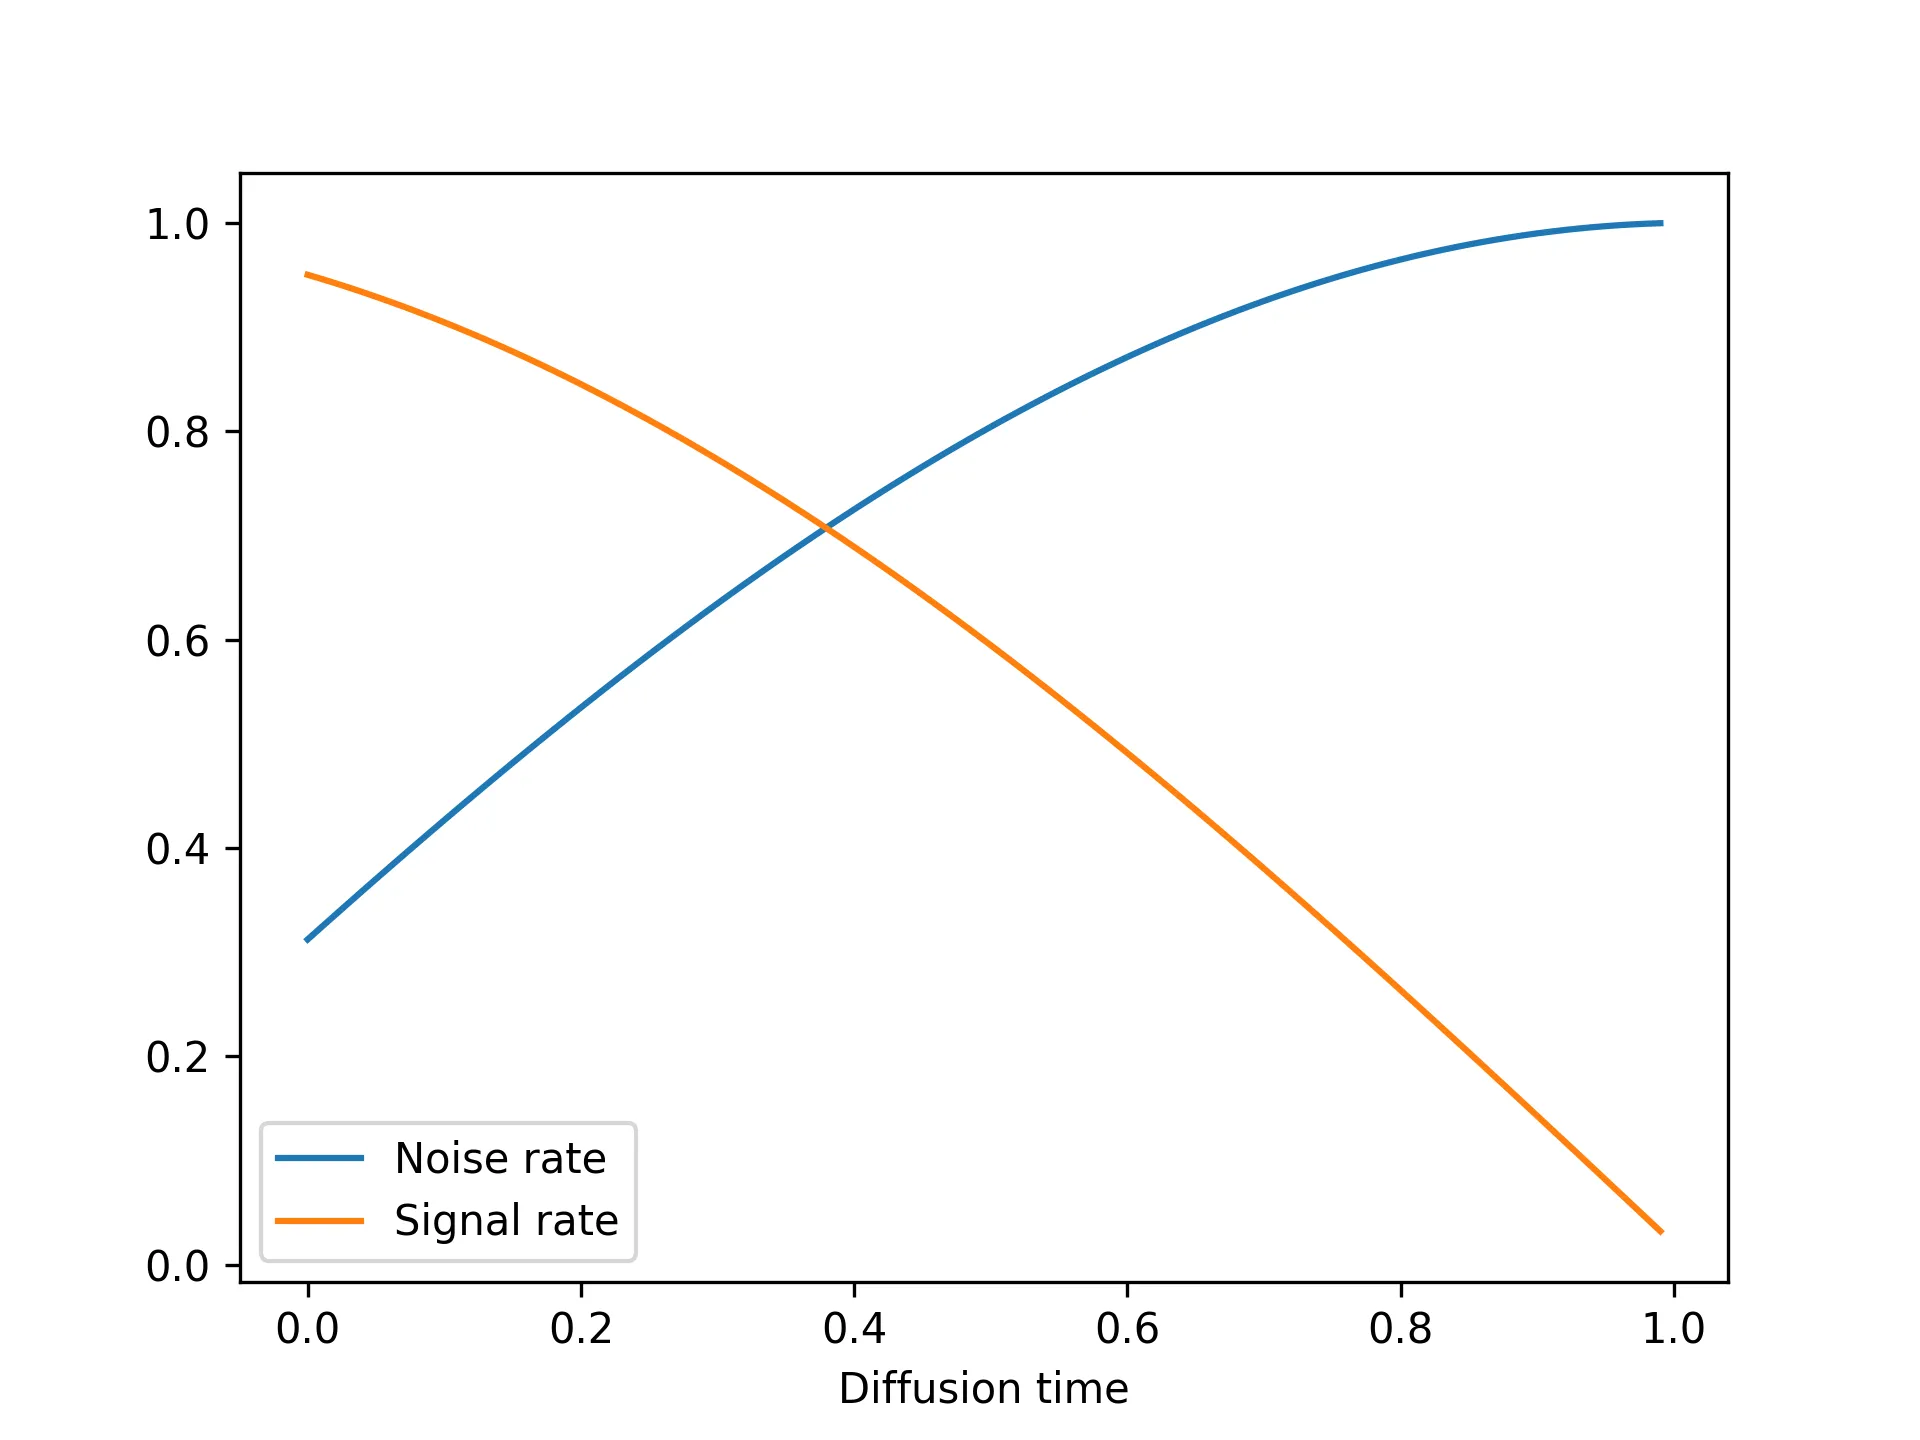
شکل ۱۷.۱۱: برنامهٔ نفوذ کسینوسی ما: نرخ سیگنال از ۱ شروع میشود و کاهش مییابد، در حالی که نرخ نویز از ۰ شروع میشود و افزایش مییابد.
فرایند آموزش
Section titled “فرایند آموزش”بیایید یک کلاس DiffusionModel برای پیادهسازی رویهٔ آموزش ایجاد کنیم. این کلاس مدل نویززدای ما را به همراه دو جزء کمکی در خود نگه خواهد داشت:
- یک تابع زیان — ما از میانگین قدر مطلق خطا (MAE) به عنوان زیان خود استفاده خواهیم کرد، یعنی
mean(abs(real_noise_mask - predicted_noise_mask)). - یک لایهٔ نرمالسازی تصویر — نویزی که به تصاویر اضافه خواهیم کرد دارای واریانس واحد و میانگین صفر خواهد بود، بنابراین مایلیم تصاویر ما نیز به همین صورت نرمالسازی شوند تا دامنهٔ مقادیر نویز با دامنهٔ مقادیر تصاویر مطابقت داشته باشد.
بیایید با نوشتن سازندهٔ مدل شروع کنیم:
class DiffusionModel(keras.Model): def __init__(self, image_size, widths, block_depth, **kwargs): super().__init__(**kwargs) self.image_size = image_size self.denoising_model = get_model(image_size, widths, block_depth) self.seed_generator = keras.random.SeedGenerator() # Our loss function self.loss = keras.losses.MeanAbsoluteError() # We'll use this to normalize input images. self.normalizer = keras.layers.Normalization()اولین متدی که به آن نیاز داریم متد نویززدایی است. این متد به سادگی مدل نویززدا را فراخوانی میکند تا ماسک نویز پیشبینیشده را بازیابی کرده و سپس از آن برای بازسازی یک تصویر نویززداییشده استفاده نماید:
def denoise(self, noisy_images, noise_rates, signal_rates): # Calls the denoising model pred_noise_masks = self.denoising_model([noisy_images, noise_rates]) # Reconstructs the predicted clean image pred_images = ( noisy_images - noise_rates * pred_noise_masks ) / signal_rates return pred_images, pred_noise_masksدر مرحلهٔ بعد نوبت به منطق آموزش میرسد. این مهمترین بخش است! مانند مثال VAE، ما منطق آموزش سفارشی خود را درون متد call() پیادهسازی میکنیم تا بتوانیم از متد پیشفرض train_step() استفاده کنیم و مدل را مستقل از بکاند نگه داریم. رویهٔ آموزش به شرح زیر است:
- تصاویر را نرمالسازی میکند
- زمانهای نفوذ تصادفی را نمونهبرداری میکند (مدل نویززدا باید روی کل طیف زمانهای نفوذ آموزش داده شود)
- نرخهای نویز و نرخهای سیگنال متناظر را محاسبه میکند (با استفاده از برنامهٔ نفوذ)
- نویز تصادفی را به تصاویر تمیز اضافه میکند (بر اساس نرخهای نویز و نرخهای سیگنال محاسبهشده)
- تصاویر را نویززدایی میکند
از آنجا که compute_loss() خروجی call() را به عنوان ورودی دریافت میکند، ما این مراحل را در call() قرار خواهیم داد:
این متد موارد زیر را برمیگرداند:
- تصاویر نویززداییشدهٔ پیشبینیشده
- ماسکهای نویز پیشبینیشده
- ماسکهای نویز واقعی که اعمال کرده بود
این دو مقدار آخر سپس در compute_loss() برای محاسبهٔ زیان مدل روی وظیفهٔ پیشبینی ماسک نویز استفاده میشوند:
    def call(self, images):        images = self.normalizer(images)        # Samples random noise masks        noise_masks = keras.random.normal(            (batch_size, self.image_size, self.image_size, 3),            seed=self.seed_generator,        )        # Samples random diffusion times        diffusion_times = keras.random.uniform(            (batch_size, 1, 1, 1),            minval=0.0,            maxval=1.0,            seed=self.seed_generator,        )        noise_rates, signal_rates = diffusion_schedule(diffusion_times)        # Adds noise to the images        noisy_images = signal_rates * images + noise_rates * noise_masks        # Denoises them        pred_images, pred_noise_masks = self.denoise(            noisy_images, noise_rates, signal_rates        )        return pred_images, pred_noise_masks, noise_masks
    def compute_loss(self, x, y, y_pred, sample_weight=None, training=True):        _, pred_noise_masks, noise_masks = y_pred        return self.loss(noise_masks, pred_noise_masks)
فرایند تولید
Section titled “فرایند تولید”در نهایت، بیایید فرایند تولید تصویر را پیادهسازی کنیم. ما از نویز تصادفی خالص شروع میکنیم، و مدل نویززدای خود را به طور مکرر اعمال مینماییم تا زمانی که به تصاویری با سیگنال بالا و نویز کم برسیم.
def generate(self, num_images, diffusion_steps): noisy_images = keras.random.normal( # Starts from pure noise (num_images, self.image_size, self.image_size, 3), seed=self.seed_generator, ) step_size = 1.0 / diffusion_steps for step in range(diffusion_steps): # Computes appropriate noise rates and signal rates diffusion_times = ops.ones((num_images, 1, 1, 1)) - step * step_size noise_rates, signal_rates = diffusion_schedule(diffusion_times) # Calls denoising model pred_images, pred_noises = self.denoise( noisy_images, noise_rates, signal_rates ) # Prepares noisy images for the next iteration next_diffusion_times = diffusion_times - step_size next_noise_rates, next_signal_rates = diffusion_schedule( next_diffusion_times ) noisy_images = ( next_signal_rates * pred_images + next_noise_rates * pred_noises ) # Denormalizes images so their values fit between 0 and 255 images = ( self.normalizer.mean + pred_images * self.normalizer.variance**0.5 ) return ops.clip(images, 0.0, 255.0)بصریسازی نتایج با یک کالبک سفارشی
Section titled “بصریسازی نتایج با یک کالبک سفارشی”ما معیار ارزیابی مناسبی برای قضاوت دربارهٔ کیفیت تصاویر تولیدشده در حین آموزش نداریم، بنابراین شما میخواهید تصاویر را در پایان هر دوره بصریسازی کنید تا از پیشرفت آموزش مطلع شوید. بیایید یک کالبک سفارشی بنویسیم که در پایان هر دوره یک شبکهٔ ۳ در ۶ از تصاویر تولیدشده را نمایش دهد:
class VisualizationCallback(keras.callbacks.Callback):    def __init__(self, diffusion_steps=20, num_rows=3, num_cols=6):        self.diffusion_steps = diffusion_steps        self.num_rows = num_rows        self.num_cols = num_cols
    def on_epoch_end(self, epoch=None, logs=None):        generated_images = self.model.generate(            num_images=self.num_rows * self.num_cols,            diffusion_steps=self.diffusion_steps,        )
        plt.figure(figsize=(self.num_cols * 2.0, self.num_rows * 2.0))        for row in range(self.num_rows):            for col in range(self.num_cols):                i = row * self.num_cols + col                plt.subplot(self.num_rows, self.num_cols, i + 1)                img = ops.convert_to_numpy(generated_images[i]).astype("uint8")                plt.imshow(img)                plt.axis("off")        plt.tight_layout()        plt.show()        plt.close()
زمان اجرا فرا رسیده است!
Section titled “زمان اجرا فرا رسیده است!”سرانجام زمان آموزش مدل نفوذ ما روی مجموعهدادهٔ گلهای آکسفورد فرا رسیده است. بیایید مدل را نمونهسازی کنیم:
model = DiffusionModel(image_size, widths=[32, 64, 96, 128], block_depth=2)# Computes the mean and variance necessary to perform normalization —# don't forget it!model.normalizer.adapt(dataset)ما قصد داریم از AdamW به عنوان بهینهساز خود استفاده کنیم، همراه با چند گزینهٔ کاربردی که برای کمک به تثبیت آموزش فعال شدهاند:
- کاهش نرخ یادگیری — ما نرخ یادگیری را در طول آموزش به تدریج کاهش میدهیم، از طریق یک برنامهٔ
InverseTimeDecay. - میانگین متحرک نمایی وزنهای مدل — همچنین به عنوان میانگینگیری پولیاک (Polyak averaging) شناخته میشود. این تکنیک یک میانگین متحرک از وزنهای مدل را در حین آموزش نگه میدارد. در پایان هر ۱۰۰ دسته، ما وزنهای مدل را با این مجموعه وزنهای میانگینگیریشده رونویسی میکنیم. این کار به تثبیت بازنماییهای مدل در شرایطی که سطح تابع زیان پر از نویز است کمک شایانی مینماید.
کد آن به صورت زیر است:
model.compile( optimizer=keras.optimizers.AdamW( # Configures the learning rate decay schedule learning_rate=keras.optimizers.schedules.InverseTimeDecay( initial_learning_rate=1e-3, decay_steps=1000, decay_rate=0.1, ), # Turns on Polyak averaging use_ema=True, # Configures how often to overwrite the model's weights with # their exponential moving average ema_overwrite_frequency=100, ),)بیایید مدل را فیت کنیم. ما از کالبک VisualizationCallback خود برای ترسیم نمونههایی از تصاویر تولیدشده در پایان هر دوره، همراه با یک کالبک ModelCheckpoint استفاده خواهیم کرد:
model.fit( dataset, epochs=100, callbacks=[ VisualizationCallback(), keras.callbacks.ModelCheckpoint( filepath="diffusion_model.weights.h5", save_weights_only=True, save_best_only=True, ), ],)اگر کد را در Colab اجرا میکنید، ممکن است با خطای «Buffered data was truncated after reaching the output size limit» مواجه شوید. این اتفاق به این دلیل میافتد که لاگهای fit() شامل تصاویری هستند که فضای زیادی را اشغال میکنند، در حالی که خروجی مجاز برای یک سلول منفرد نوتبوک محدود است. برای دور زدن این مشکل، میتوانید به سادگی پنج فراخوانی model.fit(..., epochs=20) را در پنج سلول متوالی زنجیر کنید. این کار معادل یک فراخوانی منفرد fit(..., epochs=100) است.
پس از ۱۰۰ دوره (که حدود ۹۰ دقیقه روی یک پردازندهٔ گرافیکی T4، یعنی GPU رایگان کولب، طول میکشد)، ما گلهای مولد بسیار زیبایی به دست میآوریم که بسیار متنوع و با جزئیات واضح هستند (شکل ۱۷.۱۲ را ببینید).
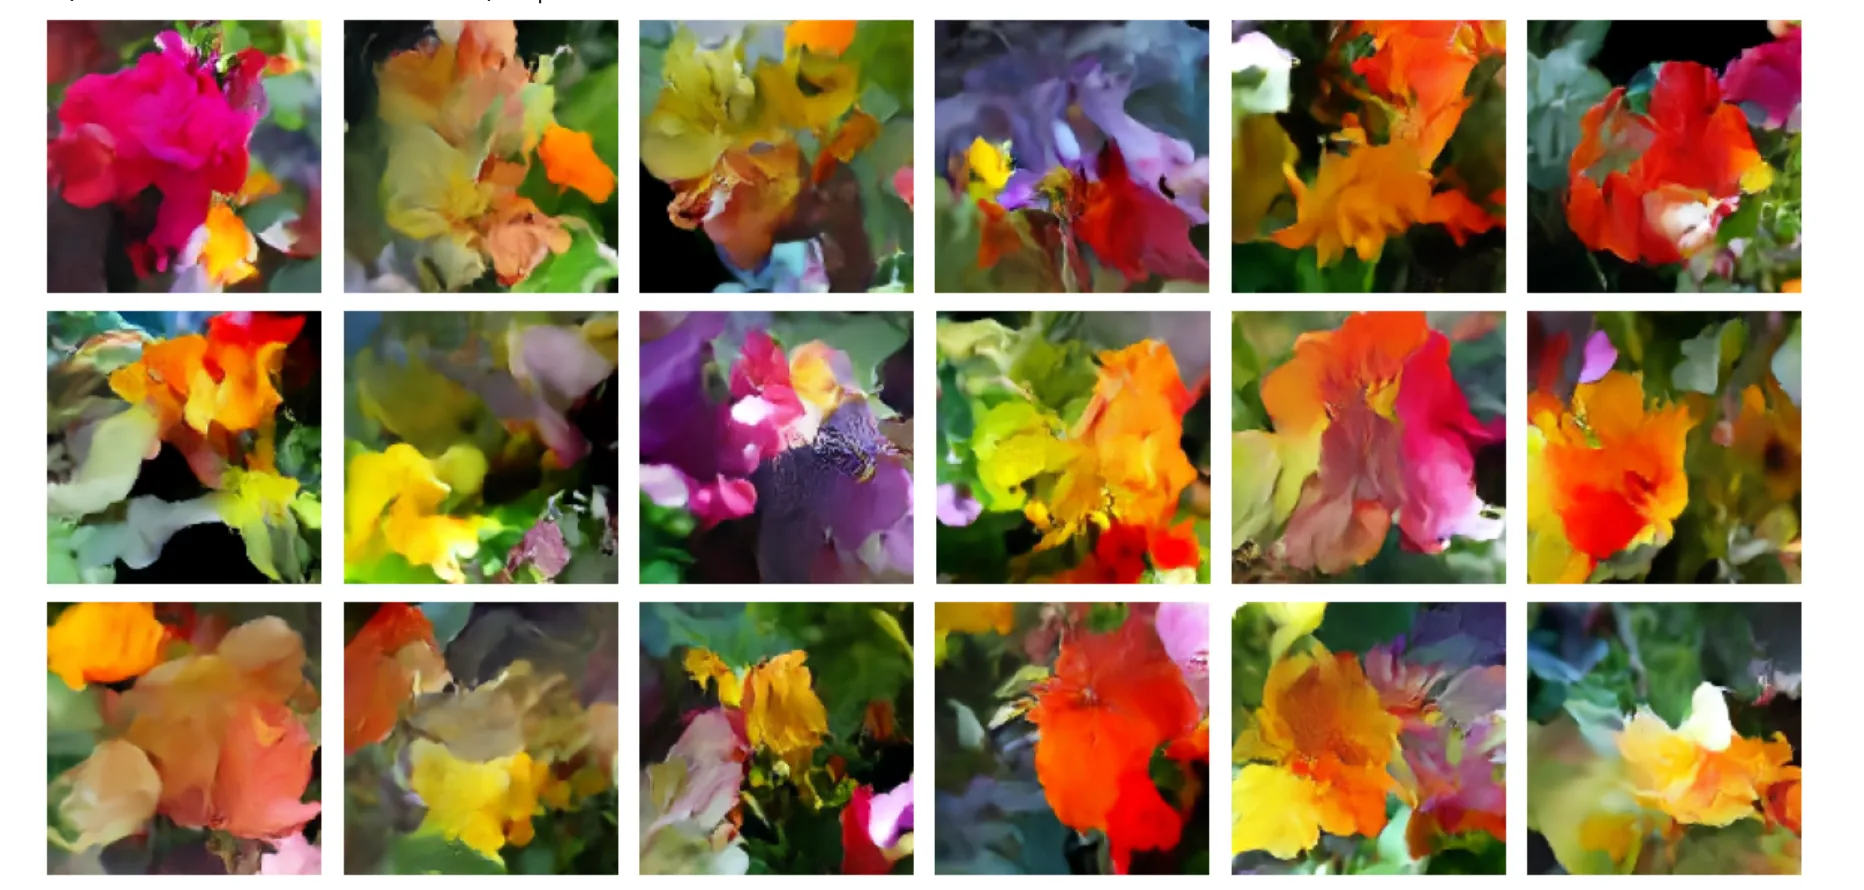
شکل ۱۷.۱۲: نمونههایی از گلهای تولیدشده پس از ۱۰۰ دوره.
شما میتوانید آموزش را حتی برای مدت طولانیتری ادامه دهید و به نتایج واقعگرایانهتری دست یابید.
بنابراین نحوهٔ عملکرد تولید تصویر با مدلهای نفوذ به این صورت است! اکنون، گام بعدی برای باز کردن پتانسیل کامل آنها، افزودن شرطیسازی متنی (text conditioning) است تا بتوانید تصاویر را مستقیماً از روی اعلانهای متنی تولید کنید که موضوع بخش بعدی است.
مدلهای متن به تصویر
Section titled “مدلهای متن به تصویر”ما میتوانیم از همان فرایند اصلی نفوذ برای ایجاد مدلی استفاده کنیم که ورودی متن را به خروجی تصویر نگاشت میکند. برای انجام این کار، ما یک مؤلفهٔ اضافی اضافه میکنیم: یک رمزگذار متن که میتواند اعلانهای ورودی را به بردارهای جاسازی متنی نگاشت کند، شبیه به آنچه در فصلهای ۱۴ و ۱۵ بررسی کردیم. سپس این جاسازیها را در نقاط مختلف به مدل نویززدا تزریق میکنیم، که معمولاً از طریق لایههای توجه متقاطع (cross-attention) انجام میشود. به این ترتیب، مدل نویززدا میتواند خروجیهای خود را بر اساس آنچه در متن توصیف شده است شرطیسازی نماید.
ما میتوانیم ورودی تصویر را دقیقاً به همان روشی که قبلاً انجام دادیم مدیریت کنیم، یعنی نگاشت ورودی دارای نویز به یک خروجی نویززداییشده در طول یک برنامهٔ نفوذ. با این حال، در طول آموزش، اکنون به هر تصویر ورودی یک زیرنویس یا توصیف متنی مرتبط متصل میکنیم. شبکهٔ نویززدا نه تنها تصویر نویزی و زمان نفوذ فعلی را دریافت میکند، بلکه جاسازی متن توصیفکنندهٔ تصویر را نیز میپذیرد. مدل یاد میگیرد تصویر را به گونهای نویززدایی کند که با محتوای متن توصیفشده مطابقت داشته باشد.
پس از پایان آموزش است که اوضاع بسیار هیجانانگیزتر میشود! از آنجا که مدلی را آموزش دادهایم که میتواند نویز خالص را به تصاویری متناظر با یک اعلان متنی مشخص نگاشت کند، اکنون میتوانیم هر اعلان دلخواهی را ارسال کنیم، از یک بذر نویز تصادفی شروع نماییم، و تصویر کاملاً جدیدی تولید کنیم که با توصیف ما همخوانی داشته باشد.
بیایید این کار را امتحان کنیم. در این کتاب عملاً یکی از این مدلها را از ابتدا آموزش نخواهیم داد—شما تمام اطلاعات مورد نیاز برای انجام این کار را در اختیار دارید، اما برای دستیابی به تصاویری واقعاً خیرهکننده، به صدها گیگابایت تصویر با کیفیت بالا و چندین روز آموزش روی پردازندههای گرافیکی سطح سازمانی نیاز خواهید داشت. در عوض، ما از مدل پیشآموزشدیدهٔ Stable Diffusion 3 استفاده خواهیم کرد که از طریق کتابخانهٔ KerasHub به صورت آماده در دسترس است. این مدل میتواند تصاویری با وضوح بالا و بسیار واقعگرایانه را با چند خط کد کوتاه تولید کند:
فهرست ۱۷.۸: ایجاد یک تسک Stable Diffusion 3 با KerasHub
import keras_hub
height, width = 512, 512task = keras_hub.models.TextToImage.from_preset(    "stable_diffusion_3_medium",    image_shape=(height, width, 3),    # A trick to keep memory usage down. More details in chapter 18.    dtype="float16",)prompt = "A NASA astraunaut riding an origami elephant in New York City"task.generate(prompt)
مانند تسک CausalLM که در فصل گذشته بررسی کردیم، تسک TextToImage یک انتزاع سطح بالا است که تمام مراحل خطلوله را در بر میگیرد: توکنایز کردن اعلان، رمزگذاری متن به بردارها، اجرای حلقهٔ نفوذ معکوس، و واگشایی تصویر نهایی. شما میتوانید به سادگی یک اعلان متنی به آن بدهید و یک تصویر دریافت کنید (شکل ۱۷.۱۳ را ببینید):
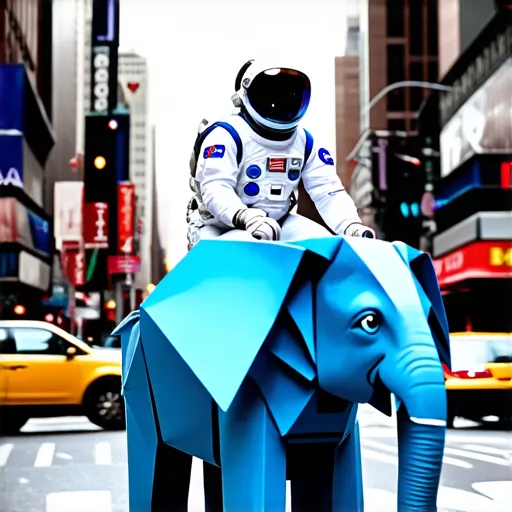
شکل ۱۷.۱۳: یک خروجی نمونه از اعلان ما: «یک کلبهٔ دنج در میان جنگل در فصل پاییز، با دودی که از دودکش بیرون میآید و برگهای طلایی در سراسر اطراف.»
مدل Stable Diffusion در واقع یک «اعلان منفی» (negative prompt) ثانویه را نیز به مدل خود اضافه میکند، که میتواند برای هدایت تصویر به دور از برخی مفاهیم ناخواسته مورد استفاده قرار گیرد. برای مثال، میتوانیم تصویری از یک ساحل استوایی تولید کنیم در حالی که صریحاً رنگ آبی را از ورودی خود حذف مینماییم:
task.generate( { "prompts": prompt, "negative_prompts": "blue color", })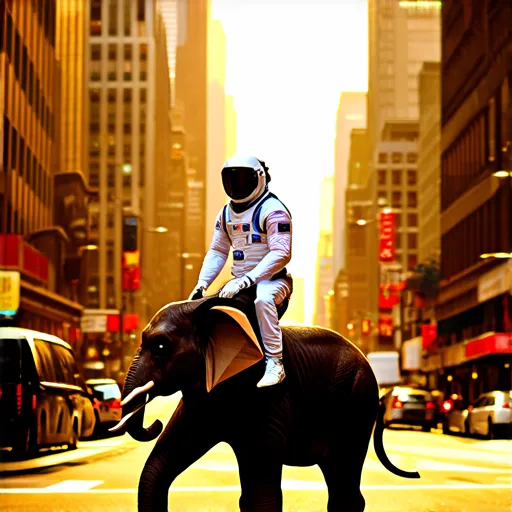
شکل ۱۷.۱۴: استفاده از یک اعلان منفی از «درختان» برای حذف تمام شاخوبرگها از تصویر.
مانند متد generate() برای مدلهای متنی که در فصل قبل استفاده کردیم، ما چند پارامتر اختیاری اضافی در اختیار داریم که میتوانیم از آنها برای کنترل فرایند تولید استفاده کنیم. مهمترین آنها guidance_scale است که تعیین میکند مدل تا چه اندازه باید اعلان متنی را به شدت دنبال کند. بیایید مقیاس هدایت را تغییر دهیم و فرایند را در عمل مشاهده کنیم (شکل ۱۷.۱۵):
import numpy as npfrom PIL import Image
def display(images):    return Image.fromarray(np.concatenate(images, axis=1))
display([task.generate(prompt, num_steps=x) for x in [5, 10, 15, 20, 25]])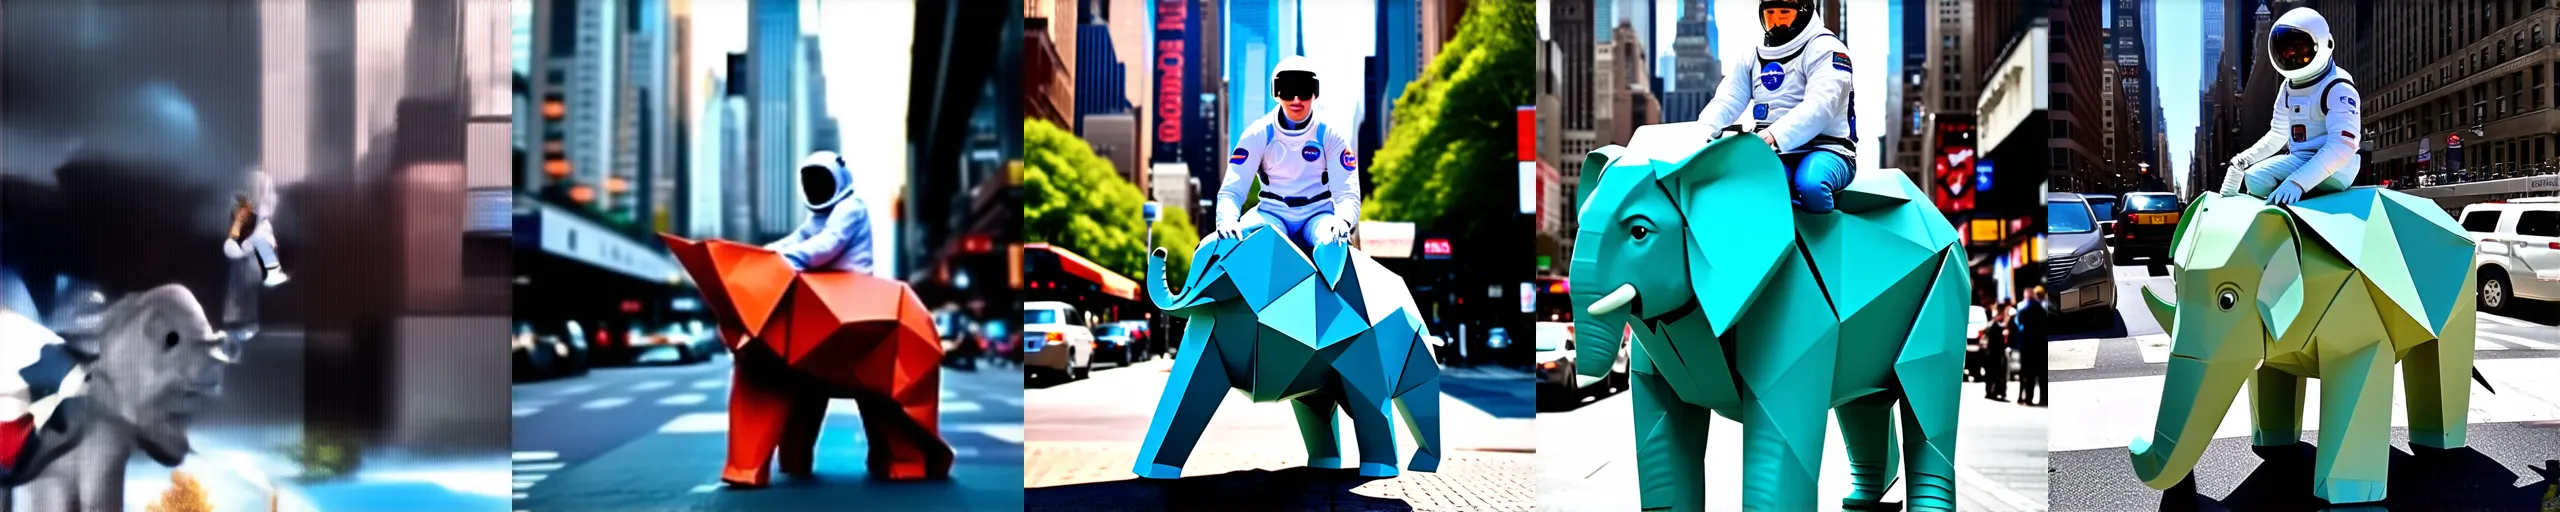
شکل ۱۷.۱۵: کنترل سبک و واقعگرایی تصاویر تولیدشده با مقیاسهای هدایت (guidance scales). مقیاس ۰ اشکالی گلآلود و انتزاعی تولید میکند، در حالی که مقیاس ۱۰ خروجیهایی پرکنتراست، سبکیافته و فوقواقعگرایانه میسازد.
کاوش در فضای نهان یک مدل متن به تصویر
Section titled “کاوش در فضای نهان یک مدل متن به تصویر”احتمالاً هیچ راهی بهتر از مدلهای نفوذ متن برای دیدن ماهیت درونیاب (interpolative) شبکههای عصبی عمیق وجود ندارد. ما میتوانیم با درونیابی بین جاسازیهای متنی برای دو مفهوم کاملاً متفاوت و مشاهدهٔ نحوهٔ تغییر نرم تصویر تولیدشده از مفهومی به مفهوم دیگر، به وضوح ببینیم که این مدلها چگونه مفاهیم را در فضای نهان خود ترکیب و ادغام میکنند.
پیش از آنکه بتوانیم این کار را انجام دهیم، باید تابع سطح بالای generate() خود را به بخشهای تشکیلدهندهٔ آن تجزیه کنیم تا بتوانیم مستقیماً با بردارهای جاسازی متنی کار کنیم. بیایید این کار را انجام دهیم:
فهرست ۱۷.۹: تجزیهٔ خطلولهٔ Stable Diffusion 3 به رمزگذاری متن و نفوذ تصویر
from keras import random
def get_text_embeddings(prompt):    token_ids = task.preprocessor.generate_preprocess([prompt])    # We don't care about negative prompts here, but the model expects    # them.    negative_token_ids = task.preprocessor.generate_preprocess([""])    return task.backbone.encode_text_step(token_ids, negative_token_ids)
def denoise_with_text_embeddings(embeddings, num_steps=28, guidance_scale=7.0):    # Creates pure noise to denoise into an image    latents = random.normal((1, height // 8, width // 8, 16))    for step in range(num_steps):        latents = task.backbone.denoise_step(            latents,            embeddings,            step,            num_steps,            guidance_scale,        )    return task.backbone.decode_step(latents)[0]
# Rescales our images back to [0, 255]def scale_output(x):    x = ops.convert_to_numpy(x)    x = np.clip((x + 1.0) / 2.0, 0.0, 1.0)    return np.round(x * 255.0).astype("uint8")
embeddings = get_text_embeddings(prompt)image = denoise_with_text_embeddings(embeddings)scale_output(image)
فرایند تولید ما دارای سه مرحلهٔ متمایز است:
- ابتدا، اعلانهای خود را دریافت میکنیم، آنها را توکنایز کرده و با رمزگذار متن خود جاسازی مینماییم.
- دوم، جاسازیهای متنی و نویز خالص را دریافت کرده و به تدریج نویز را به یک تصویر نهان «نویززدایی» میکنیم.
- سوم، تصویر نهان را با رمزگشای VAE به یک تصویر پیکسلی واقعی واگشایی مینماییم.
یک نکته که در اینجا باید مورد توجه قرار گیرد این است که جاسازیهای متنی ما در واقع حاوی چهار تانسور جداگانه هستند:
>>> [x.shape for x in embeddings]- دنبالهٔ رمزگذار اعلان مثبت
- دنبالهٔ رمزگذار اعلان منفی
- بردار رمزگذار اعلان مثبت
- بردار رمزگذار اعلان منفی
به جای ارسال تنها بردار نهایی متنی جاسازیشده به مدل نویززدا، مؤلفان Stable Diffusion متوجه شدند که ارسال هر دو نوع بازنمایی دنبالهای کامل و بردار خلاصهٔ ادغامشده، کیفیت تولید را بهبود میبخشد. بنابراین جاسازی متنی ما در واقع یک ساختار چندتانسوری است.
با تجزیهٔ تابع generate()، اکنون میتوانیم پیمایش در فضای نهان بین دو جاسازی متنی را امتحان کنیم.
متوجه خواهید شد که ما از یک تابع درونیابی ویژه به نام slerp (درونیابی خطی کروی) برای پیمایش بین جاسازیهای متنی خود استفاده میکنیم، به جای استفاده از درونیابی خطی ساده (lerp). دلیل این امر این است که بردارهای جاسازی با ابعاد بالا تمایل دارند روی سطح یک ابرکره (hypersphere) قرار گیرند نه روی یک خط مستقیم، بنابراین حرکت در امتداد یک کمان کروی هندسهٔ طبیعی فضای بازنمایی را بسیار بهتر حفظ میکند.
خیلی نگران ریاضیات آن نباشید؛ برای مثال ما اهمیت چندانی ندارد، اما درک این شهود مهم است: درونیابی خطی کروی کوتاهترین مسیر بین دو نقطه را در امتداد سطح یک کره دنبال میکند، نه اینکه از درون حجم داخلی کره برش بزند، جایی که هیچ دادهای توسط مدل مشاهده نشده است.
فهرست ۱۷.۱۰: تابعی برای انجام درونیابی کروی بین دو جاسازی متنی
from keras import ops
def slerp(t, v1, v2):    v1, v2 = ops.cast(v1, "float32"), ops.cast(v2, "float32")    v1_norm = ops.linalg.norm(ops.ravel(v1))    v2_norm = ops.linalg.norm(ops.ravel(v2))    dot = ops.sum(v1 * v2 / (v1_norm * v2_norm))    theta_0 = ops.arccos(dot)    sin_theta_0 = ops.sin(theta_0)    theta_t = theta_0 * t    sin_theta_t = ops.sin(theta_t)    s0 = ops.sin(theta_0 - theta_t) / sin_theta_0    s1 = sin_theta_t / sin_theta_0    return s0 * v1 + s1 * v2
def interpolate_text_embeddings(e1, e2, start=0, stop=1, num=10):    embeddings = []    for t in np.linspace(start, stop, num):        embeddings.append(            (                # The second and fourth text embeddings are for the                # negative prompt, which we do not use.                slerp(t, e1[0], e2[0]),                e1[1],                slerp(t, e1[2], e2[2]),                e1[3],            )        )    return embeddings
البته، چندگونای (manifold) آموختهشده توسط مدل جاسازی متن ما در واقع کاملاً کروی نیست. اما این یک سطح هموار در یک فضای با ابعاد بالا است، و slerp تقریب بسیار بهتری نسبت به یک خط مستقیم ساده است (شکل ۱۷.۱۶ را ببینید).
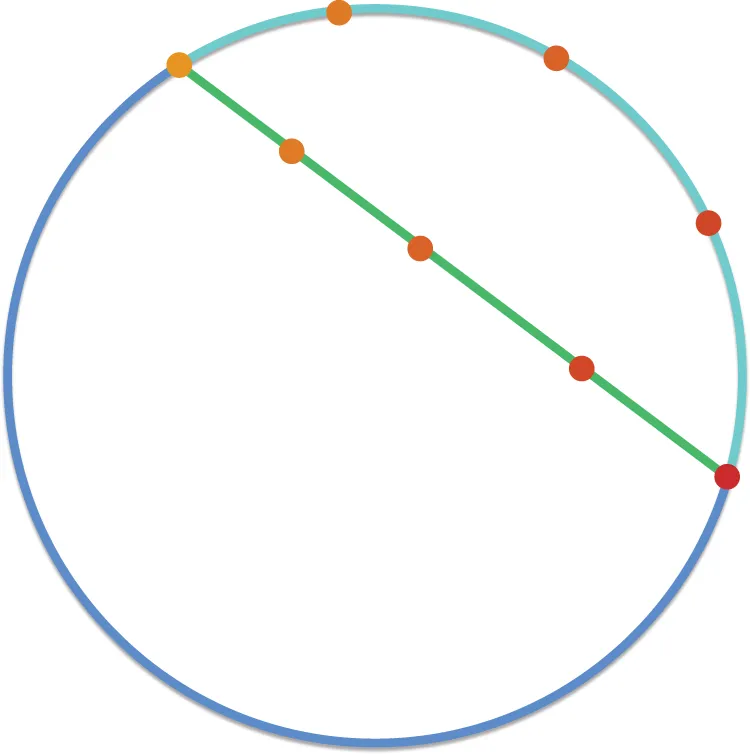
شکل ۱۷.۱۶: درونیابی کروی بین یک نقاشی آبرنگ و یک تصویر عکاسیشده.
با تعریف درونیابی خود، بیایید پیمایش بین جاسازیهای متنی را برای دو اعلان امتحان کنیم و یک سری تصاویر در طول این مسیر تولید نماییم. با تغییر تدریجی از یک سگ خانگی دوستانه به یک بشقابپرندهٔ بیگانه، پیوستگی کامل و درونیاب بودن فضای بصری آموختهشده به صورت بصری کاملاً آشکار میشود (شکل ۱۷.۱۷):
prompt1 = "A friendly dog looking up in a field of flowers"prompt2 = "A horrifying, tentacled creature hovering over a field of flowers"e1 = get_text_embeddings(prompt1)e2 = get_text_embeddings(prompt2)
images = []# Zooms in to the middle of the overall interpolation from [0, 1]for et in interpolate_text_embeddings(e1, e2, start=0.5, stop=0.6, num=9):    image = denoise_with_text_embeddings(et)    images.append(scale_output(image))display(images)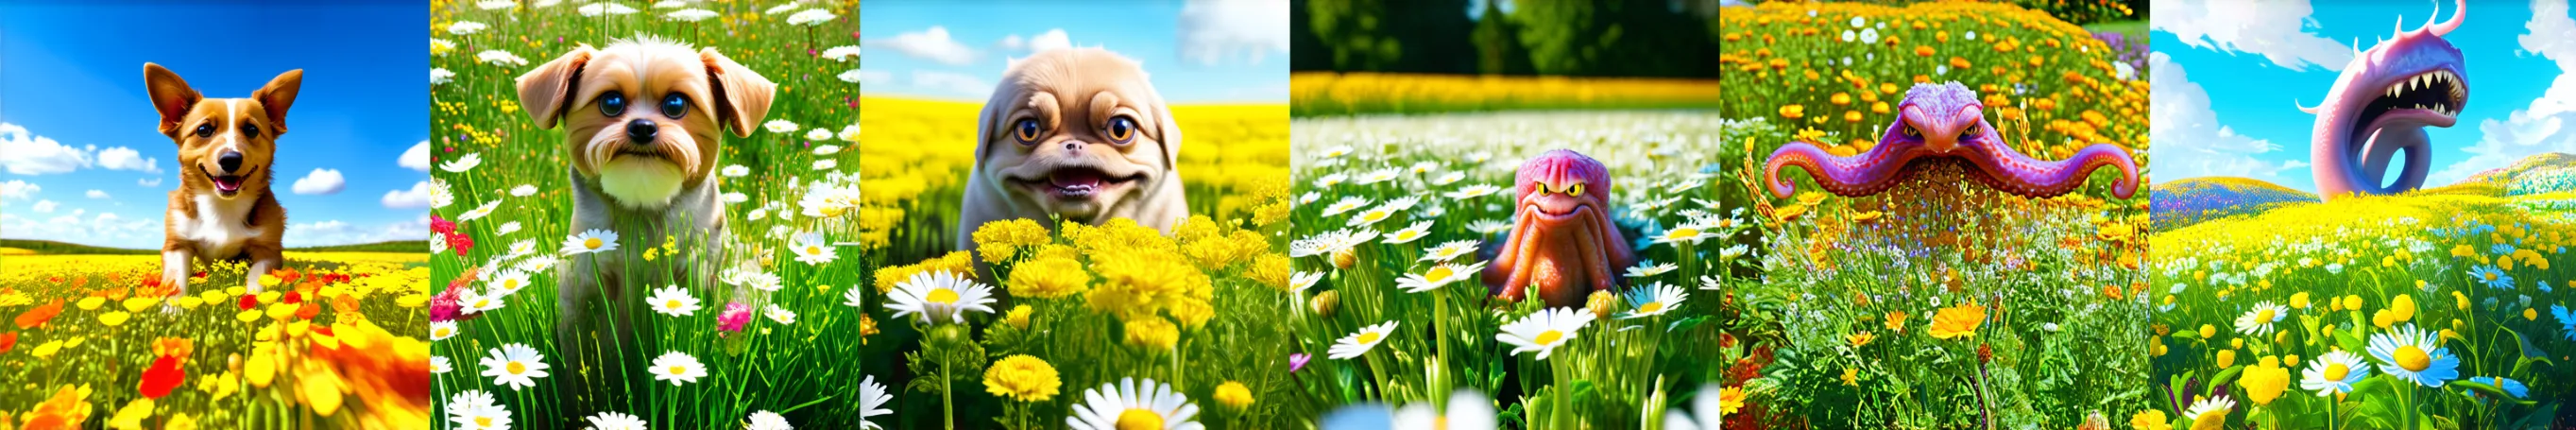
شکل ۱۷.۱۷: درونیابی بین دو مفهوم: سگی دوستداشتنی و یک سفینهٔ فضایی بیگانگان.
این ممکن است اولین باری که آن را امتحان میکنید مانند جادو به نظر برسد، اما هیچ چیز جادویی در مورد آن وجود ندارد—درونیابی قابلیت اساسی شبکههای عصبی عمیق است. به محض اینکه یک مدل عمیق یاد میگیرد دادهها را به یک فضای پیوسته نگاشت کند، میتوانید بین هر دو نقطهای حرکت کنید و ببینید که مدل مفاهیم میانی را چگونه تعبیر میکند، حتی برای خروجیهایی به پیچیدگی تصاویر طبیعی.
- تولید تصویر با یادگیری عمیق از طریق یادگیری فضاهای نهانی انجام میشود که اطلاعات آماری مربوط به یک مجموعه داده از تصاویر را ثبت میکنند. با نمونهبرداری و رمزگشایی نقاط از فضای نهان، میتوانید تصاویری را تولید کنید که قبلاً هرگز دیده نشدهاند. سه ابزار عمده برای انجام این کار وجود دارد: VAEها، مدلهای نفوذ، و GANها.
- مدلهای VAE به نمایشهای نهانٔ بسیار ساختاریافته و پیوسته منجر میشوند. به همین دلیل، آنها برای انجام انواع ویرایش تصویر در فضای نهان به خوبی کار میکنند: تعویض چهره، تبدیل چهرهٔ اخمآلود به چهرهٔ خندان، و غیره. آنها همچنین برای ساخت انیمیشنهای مبتنی بر فضای نهان به خوبی عمل میکنند، مانند پویاسازی یک حرکت در امتداد یک مقطع از فضای نهان، که نشان میدهد یک تصویر اولیه به آرامی و به شیوهای پیوسته به تصاویر مختلف تبدیل میشود.
- مدلهای نفوذ خروجیهای بسیار واقعگرایانهای تولید میکنند و امروزه روش غالب تولید تصویر هستند. آنها با نویززدایی مکرر یک تصویر، شروع از نویز خالص کار میکنند. آنها میتوانند به راحتی با زیرنویسهای متنی شرطیسازی شوند تا مدلهای متن به تصویر ایجاد کنند.
- مدل Stable Diffusion 3 یک مدل پیشرفته و پیشآموزشدیدهٔ متن به تصویر است که میتوانید از آن برای ایجاد تصاویر بسیار واقعگرایانه از خودتان استفاده کنید.
- فضای نهان بصری آموختهشده توسط چنین مدلهای نفوذ متن به تصویر اساساً درونیاب است. شما میتوانید این را با درونیابی بین جاسازیهای متنی مورد استفاده به عنوان ورودیهای فرایند نفوذ و دستیابی به یک درونیابی نرم بین تصاویر به عنوان خروجی مشاهده کنید.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
دیدریک پی. کینگما و مکس ولینگ، «Auto-Encoding Variational Bayes»، arXiv (۲۰۱۳)، https://arxiv.org/abs/1312.6114. ↩
-
دانیلو خیمنز رزنده، شاکر محمد، و دان ویرسترا، «Stochastic Backpropagation and Approximate Inference in Deep Generative Models»، arXiv (۲۰۱۴)، https://arxiv.org/abs/1401.4082. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.