
فصل ۱۸: بهترین شیوهها برای دنیای واقعی
از آغاز این کتاب مسیر بسیار بلندی را پیمودهاید. اکنون میتوانید مدلهای طبقهبندی تصویر، مدلهای قطعهبندی تصویر، مدلهای رگرسیون سری زمانی، مدلهای طبقهبندی متن، ترنسفورمرها، مدلهای زبانی ترنسفورمری خودبازگشتی، VAEها و مدلهای نفوذ تصویر را آموزش دهید. اما تا به اینجا، تمام مدلهای شما در مقیاس کوچک آموزش دیدهاند—روی مجموعهدادههای کوچک، با یک GPU منفرد—و شما عمدتاً از پیکربندیهای پیشفرضی استفاده کردهاید که ما برایتان آماده کرده بودیم، بدون اینکه زمان زیادی را صرف استخراج آخرین قطرههای کارایی از آنها کنید.
با این حال، در دنیای واقعی، مهندسی یادگیری عمیق فراتر از آموزش دادن یک مدل پیشفرض است. شما باید با مجموعهدادههای عظیم کار کنید که نیازمند چندین GPU یا خوشههای TPU هستند. شما باید با بهینهسازی دقیق معماری مدل خود، نتایج برتر در سطح رقابتهای Kaggle به دست آورید. و باید مدلهای خود را برای استنتاج بلادرنگ سریع، کارآمد و کممصرف سازید.
این فصل برای پر کردن این شکاف و ارائهٔ بهترین شیوههایی است که با گذار از یادگیرندهٔ یادگیری ماشین به یک متخصص حرفهای یادگیری عمیق به آنها نیاز خواهید داشت.
بیشترین بهرهوری از مدلهای خود
Section titled “بیشترین بهرهوری از مدلهای خود”آزمایش کورکورانهٔ پیکربندیهای مختلف معماری به اندازهٔ کافی خوب عمل میکند اگر فقط نیاز به چیزی داشته باشید که کار کند. با این حال، اگر هدف شما دستیابی به بهترین عملکرد ممکن در یک وظیفه باشد (مانند برنده شدن در یک مسابقه یا ارائهٔ یک ویژگی تجاری حیاتی)، باید فراتر از حدس و گمان بروید. در این بخش، تکنیکهای ضروری را برای به حداکثر رساندن کارایی مدلهای خود پوشش خواهیم داد: بهینهسازی ابرپارامترها و انسمبل مدلها.
بهینهسازی ابرپارامترها
Section titled “بهینهسازی ابرپارامترها”هنگام ساخت یک مدل یادگیری عمیق، باید تصمیمات به ظاهر اختیاری زیادی اتخاذ کنید: مدل باید چند لایه داشته باشد؟ هر لایه باید چند واحد یا فیلتر داشته باشد؟ آیا باید از relu به عنوان فعالسازی استفاده کنید، یا تابع دیگری؟ آیا باید پس از یک لایهٔ خاص از BatchNormalization استفاده کنید؟ چقدر باید از Dropout استفاده شود؟ نرخ یادگیری چقدر باشد؟ و به همین ترتیب. این پارامترهای ساختار معماری و آموزش، ابرپارامترها (hyperparameters) نامیده میشوند تا آنها را از پارامترها (وزنهای شبکه) که از طریق پسانتشار آموزش داده میشوند متمایز سازند.
در عمل، مهندسان و پژوهشگران باتجربهٔ یادگیری ماشین با گذشت زمان بینشی به دست میآورند که چه چیزی کار میکند و چه چیزی کارایی ندارد—آنها شهودی قوی دربارهٔ اینکه چه انتخابهای ابرپارامتری برای وظایف خاص مناسب هستند توسعه میدهند. با این حال، هیچ قانون صلب و قاطعی وجود ندارد؛ آنچه برای یک وظیفه عالی کار میکند ممکن است روی وظیفهای دیگر شکست بخورد.
بنابراین، شما باید فضای تصمیمات ممکن را به صورت خودکار، روشمند و اصولی کاوش کنید: باید به طور مداوم گزینههای مختلف را جستجو کنید، آنها را ارزیابی نمایید و بهترین پیکربندی را انتخاب کنید. این دقیقاً همان کاری است که بهینهسازی ابرپارامترها انجام میدهد.
فرایند بهینهسازی ابرپارامترها معمولاً به شکل زیر است:
- انتخاب یک مجموعه از ابرپارامترها (به صورت خودکار).
- ساخت مدل متناظر با آنها.
- برازش مدل به دادههای آموزشی خود، و اندازهگیری عملکرد روی دادههای اعتبارسنجی.
- انتخاب مجموعهٔ بعدی از ابرپارامترها برای آزمایش (به صورت خودکار).
- تکرار این مراحل.
- در نهایت، ارزیابی بهترین مدل روی دادههای آزمون.
کلید این فرایند الگوریتمی است که رابطهٔ بین عملکرد اعتبارسنجی و مقادیر مختلف ابرپارامترها را تحلیل میکند تا مجموعهٔ بعدی از ابرپارامترها را برای ارزیابی انتخاب نماید. این میتواند از طریق جستجوی تصادفی، بهینهسازی بیزی، یا تکنیکهای تخصصی دیگر انجام شود.
آموزش دادن وزنهای یک مدل نسبتاً آسان است: شما یک تابع زیان را روی یک مینیبچ از دادهها محاسبه میکنید و سپس از پسانتشار برای حرکت دادن وزنها در جهتی که زیان را کاهش میدهد استفاده مینمایید (نزول گرادیان). در مقابل، بهینهسازی ابرپارامترها چالشهای متفاوتی را ارائه میدهد:
- فضای ابرپارامترها معمولاً از تصمیمات گسسته تشکیل شده است و بنابراین پیوسته یا مشتقپذیر نیست. از این رو، معمولاً نمیتوانید نزول گرادیان را در فضای ابرپارامترها اجرا کنید. در عوض، باید به الگوریتمهای جستجویی تکیه کنید که بسیار کمتر از نزول گرادیان کارآمد هستند.
- محاسبهٔ سیگنال بازخورد (آیا این مجموعه از ابرپارامترها به یک مدل با عملکرد بالا منجر میشود؟) میتواند بسیار پرهزینه باشد، زیرا نیازمند ساخت و آموزش یک مدل کاملاً جدید از ابتدا روی دادههای آموزشی شما است—فرآیندی که بسته به دادهها و مدل میتواند ساعتها یا حتی روزها طول بکشد.
خوشبختانه ابزاری وجود دارد که تنظیم ابرپارامترها را سادهتر میکند: KerasTuner. بیایید به بررسی آن بپردازیم.
استفاده از KerasTuner
Section titled “استفاده از KerasTuner”بیایید با نصب KerasTuner شروع کنیم:
!pip install keras-tuner -qایدهٔ کلیدی که KerasTuner بر اساس آن ساخته شده این است که به شما امکان میدهد مقادیر سختکدشدهٔ ابرپارامترها را، مانند units=32 یا activation="relu"، با انتخابهای پویا از یک فضای جستجو (search space) جایگزین کنید، مانند hp.Int("units", min_value=16, max_value=256, step=16) یا hp.Choice("activation", ["relu", "tanh"]).
برای تعیین یک فضای جستجو، یک تابع ساخت مدل را تعریف کنید (فهرست بعدی را ببینید). این تابع یک آرگومان hp دریافت میکند، که شیءای است که برای نمونهسازی ابرپارامترها استفاده میشود، و یک مدل کامپایلشدهٔ کراس را برمیگرداند.
فهرست ۱۸.۱: یک تابع ساخت مدل KerasTuner
import kerasfrom keras import layers
def build_model(hp):    # Sample hyperparameter values from the hp object. After sampling,    # these values (such as the "units" variable here) are just regular    # Python constants.    units = hp.Int(name="units", min_value=16, max_value=64, step=16)    model = keras.Sequential(        [            layers.Dense(units, activation="relu"),            layers.Dense(10, activation="softmax"),        ]    )    # Different kinds of hyperparameters are available: Int, Float,    # Boolean, Choice.    optimizer = hp.Choice(name="optimizer", values=["rmsprop", "adam"])    model.compile(        optimizer=optimizer,        loss="sparse_categorical_crossentropy",        metrics=["accuracy"],    )    # The function returns a compiled model.    return model
اگر میخواهید رویکردی ماژولارتر و با قابلیت پیکربندی بالاتر را برای ساخت مدل در پیش بگیرید، میتوانید کلاس فرعی از کلاس HyperModel نیز ایجاد کرده و متد build آن را پیادهسازی نمایید.
فهرست ۱۸.۲: یک HyperModel در KerasTuner
import keras_tuner as kt
class SimpleMLP(kt.HyperModel):    # Thanks to the object-oriented approach, we can configure model    # constants as constructor arguments (instead of hardcoding them in    # the model-building function).    def __init__(self, num_classes):        self.num_classes = num_classes
    # The build method is identical to our prior build_model standalone    # function.    def build(self, hp):        units = hp.Int(name="units", min_value=16, max_value=64, step=16)        model = keras.Sequential(            [                layers.Dense(units, activation="relu"),                layers.Dense(self.num_classes, activation="softmax"),            ]        )        optimizer = hp.Choice(name="optimizer", values=["rmsprop", "adam"])        model.compile(            optimizer=optimizer,            loss="sparse_categorical_crossentropy",            metrics=["accuracy"],        )        return model
hypermodel = SimpleMLP(num_classes=10)
گام بعدی تعریف یک «تیونر» (tuner) است. از نظر شماتیک، میتوانید یک تیونر را مانند یک حلقهٔ for در نظر بگیرید که به صورت تکراری کارهای زیر را انجام میدهد:
- انتخاب یک مجموعه از مقادیر ابرپارامترها
- فراخوانی تابع ساخت مدل با این مقادیر برای ایجاد یک مدل
- آموزش دادن مدل و ثبت معیارهای آن
کتابخانهٔ KerasTuner چندین تیونر توکار در دسترس دارد—RandomSearch، BayesianOptimization، و Hyperband. بیایید BayesianOptimization را امتحان کنیم، تیونری که تلاش میکند مدلی احتمالی بسازد که تخمین بزند کدام مقادیر ابرپارامترها احتمالاً بهترین نتایج را بر اساس نتایج انتخابهای قبلی ارائه میدهند:
tuner = kt.BayesianOptimization( # Specifies the model-building function (or hypermodel instance) build_model, # Specifies the metric that the tuner will seek to optimize. Always # specify validation metrics, since the goal of the search process # is to find models that generalize! objective="val_accuracy", # Maximum number of different model configurations ("trials") to # try before ending the search max_trials=20, # To reduce metrics variance, you can train the same model multiple # times and average the results. executions_per_trial is how many # training rounds (executions) to run for each model configuration # (trial). executions_per_trial=2, # Where to store search logs directory="mnist_kt_test", # Whether to overwrite data in the directory to start a new search. # Set this to True if you've modified the model-building function # or to False to resume a previously started search with the same # model-building function. overwrite=True,)شما میتوانید یک نمای کلی از فضای جستجو را از طریق متد search_space_summary() نمایش دهید:
>>> tuner.search_space_summary()در نهایت، بیایید جستجو را آغاز کنیم. فراموش نکنید دادههای اعتبارسنجی را ارسال کنید و مطمئن شوید که هرگز از مجموعهٔ آزمون خود به عنوان دادههای اعتبارسنجی استفاده نمیکنید، زیرا در غیر این صورت به سرعت روی مجموعهٔ آزمون بیشبرازش خواهید کرد و دیگر نمیتوانید به معیارهای آزمون خود اعتماد کنید:
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()x_train = x_train.reshape((-1, 28 * 28)).astype("float32") / 255x_test = x_test.reshape((-1, 28 * 28)).astype("float32") / 255# Reserves these for laterx_train_full = x_train[:]y_train_full = y_train[:]# Sets aside a validation setnum_val_samples = 10000x_train, x_val = x_train[:-num_val_samples], x_train[-num_val_samples:]y_train, y_val = y_train[:-num_val_samples], y_train[-num_val_samples:]callbacks = [ # Uses a large number of epochs (you don't know in advance how many # epochs each model will need) and uses an EarlyStopping callback # to stop training when you start overfitting keras.callbacks.EarlyStopping(monitor="val_loss", patience=5),]# This takes the same arguments as fit() (it simply passes them down to# fit() for each new model).tuner.search( x_train, y_train, batch_size=128, epochs=100, validation_data=(x_val, y_val), callbacks=callbacks, verbose=2,)مثال قبلی تنها در عرض چند دقیقه اجرا میشود، زیرا ما تنها تعداد کمی از انتخابهای ممکن را بررسی میکنیم و روی زیرمجموعهای کوچک از ارقام MNIST برای تنها دو دوره آموزش میدهیم. در یک وظیفهٔ دنیای واقعی، جستجو احتمالاً ساعتها یا حتی روزها طول میکشد.
پس از اتمام جستجو، میتوانید بهترین پیکربندیهای ابرپارامتری را جستجو کنید، که میتوانید از آنها برای ایجاد مدلهایی استفاده نمایید که سپس قابل آموزش مجدد هستند.
فهرست ۱۸.۳: استعلام بهترین پیکربندیهای ابرپارامتری
top_n = 4# Returns a list of HyperParameters objects, which you can pass to the# model-building functionbest_hps = tuner.get_best_hyperparameters(top_n)معمولاً، هنگام آموزش مجدد این مدلها، ممکن است بخواهید دادههای اعتبارسنجی را نیز به عنوان بخشی از دادههای آموزشی لحاظ کنید (آموزش روی دادههای کامل آموزشی)، چرا که دیگر نیازی به ارزیابی مدل روی دادههای اعتبارسنجی ندارید. با این حال، پیش از انجام این کار، باید یک مسئلهٔ ظریف را حل کنید: چند دوره باید مدل نهایی را آموزش دهید؟ اگر برای تعداد دورههای بیش از حد آموزش دهید، دچار بیشبرازش خواهید شد؛ و اگر برای تعداد دورههای کمتری آموزش دهید، کمبرازش رخ خواهد داد.
قبل از اینکه بتوانیم روی کل دادههای آموزشی آموزش دهیم، یک پارامتر نهایی وجود دارد که باید مشخص کنیم: تعداد بهینهٔ دورهها. برای پیدا کردن آن، ابتدا مدل را فقط روی مجموعهٔ دادههای آموزشی آموزش میدهیم و از کالبک EarlyStopping روی مجموعهٔ اعتبارسنجی برای یافتن بهترین دوره استفاده میکنیم:
def get_best_epoch(hp): model = build_model(hp) callbacks = [ keras.callbacks.EarlyStopping( # Note the very high patience value. monitor="val_loss", mode="min", patience=10 ) ] history = model.fit( x_train, y_train, validation_data=(x_val, y_val), epochs=100, batch_size=128, callbacks=callbacks, ) val_loss_per_epoch = history.history["val_loss"] best_epoch = val_loss_per_epoch.index(min(val_loss_per_epoch)) + 1 print(f"Best epoch: {best_epoch}") return best_epochو در نهایت، روی کل مجموعهٔ داده برای مدتی کمی طولانیتر از این تعداد دوره آموزش میدهیم، زیرا روی دادههای بیشتری آموزش میدهید—در این مورد، ۲۰٪ دادهٔ بیشتر:
def get_best_trained_model(hp):    best_epoch = get_best_epoch(hp)    model = build_model(hp)    model.fit(        x_train_full, y_train_full, batch_size=128, epochs=int(best_epoch * 1.2)    )    return model
best_models = []for hp in best_hps:    model = get_best_trained_model(hp)    model.evaluate(x_test, y_test)    best_models.append(model)
اگر نگران کمی عملکرد پایینتر نیستید، یک میانبر وجود دارد که میتوانید در پیش بگیرید: کافی است از تیونر برای بازیابی بهترین مدلهایی که مستقیماً در طول جستجو آموزش دیدهاند، با وزنهای از پیش ذخیرهشدهٔ آنها استفاده کنید، بدون اینکه مدلهای جدید را از ابتدا آموزش مجدد دهید:
best_models = tuner.get_best_models(top_n)هنر خلق فضای جستجوی مناسب
Section titled “هنر خلق فضای جستجوی مناسب”به طور کلی، بهینهسازی ابرپارامترها یک تکنیک قدرتمند است که برای دستیابی به عملکرد پیشرفته در هر وظیفهای یا برنده شدن در مسابقات یادگیری ماشین یک ضرورت مطلق به شمار میرود.
با این حال، انجام تنظیم ابرپارامترها جایگزینی برای آشنایی با بهترین شیوههای معماری مدل نیست. ابرپارامترها نمیتوانند یک معماری اساساً نامناسب را نجات دهند. اگر فضای جستجوی شما فقط شامل گزینههای ضعیف باشد، تیونر شما بهترین گزینه را از میان گزینههای بد پیدا خواهد کرد!
خبر خوب: با استفاده از تنظیم ابرپارامترها، تصمیمات پیکربندی که باید اتخاذ کنید از تصمیمات ریزمقیاس (این لایه باید چند واحد داشته باشد؟) به تصمیمات سطح بالاتر ارتقا مییابد: این وظیفه چه خانوادهای از معماریها را میطلبد؟ هدف تابع زیان مناسب چیست؟ و به همین ترتیب.
با پیروی از این منطق، KerasTuner تلاش میکند فضاهای جستجوی از پیش ساختهشدهای را ارائه دهد که برای حوزههای وسیعی از مسائل مرتبط هستند، مانند طبقهبندی تصویر، پردازش متن و مواردی از این قبیل. این فضاها میتوانند بدون نیاز به طراحی دستی کل فضای جستجو مورد استفاده قرار گیرند.
انسمبل مدلها
Section titled “انسمبل مدلها”یکی دیگر از تکنیکهای قدرتمند برای به دست آوردن بهترین نتایج ممکن در یک وظیفه، انسمبل مدلها (model ensembling) است. انسمبل به معنای تجمیع پیشبینیهای مجموعهای از مدلهای مختلف برای تولید پیشبینیهای بهتر است. اگر به مسابقات یادگیری ماشین (به ویژه در پلتفرم Kaggle) نگاه کنید، متوجه خواهید شد که برندگان تقریباً همیشه از انسمبلهای بزرگی از مدلها استفاده میکنند که هر مدل منفردی را با اختلاف چشمگیر شکست میدهند.
انسمبل بر این فرض استوار است که مدلهای مختلف با عملکرد خوب که به طور مستقل آموزش دیدهاند، احتمالاً به دلایل متفاوتی خوب عمل میکنند: هر مدل به بخشهای متفاوتی از دادهها برای انجام پیشبینیهای خود نگاه میکند و بخشی از «حقیقت» را دریافت مینماید، اما نه کل حقیقت را. با ترکیب دیدگاههای آنها، میتوانید بازنمایی بسیار دقیقتری از دادهها نسبت به آنچه هر مدل منفردی میتواند ارائه دهد به دست آورید.
بیایید از طبقهبندی به عنوان مثال استفاده کنیم. سادهترین راه برای تجمیع پیشبینیهای مجموعهای از دستهبندها (برای انسمبل کردن دستهبندها) میانگینگیری از پیشبینیهای آنها در زمان استنتاج است:
# Uses four different models to compute initial predictionspreds_a = model_a.predict(x_val)preds_b = model_b.predict(x_val)preds_c = model_c.predict(x_val)preds_d = model_d.predict(x_val)# This new prediction array should be more accurate than any of the# initial ones.final_preds = 0.25 * (preds_a + preds_b + preds_c + preds_d)با این حال، این روش تنها زمانی به خوبی کار میکند که دستهبندها کموبیش به یک اندازه خوب باشند. اگر یکی از آنها به طور قابل توجهی بدتر از بقیه باشد، پیشبینی نهایی ممکن است به خوبی بهترین مدل گروه نباشد.
یک راه هوشمندانهتر برای انسمبل دستهبندها، انجام یک میانگین وزنی است، که در آن وزنها روی دادههای اعتبارسنجی آموخته میشوند: به مدلهای بهتر وزنهای بالاتری داده میشود و به مدلهای ضعیفتر وزنهای کمتری تعلق میگیرد. برای جستجوی یک مجموعهٔ خوب از وزنهای انسمبل، میتوانید از جستجوی تصادفی یا یک الگوریتم بهینهسازی سادهٔ بدون مشتق، مانند الگوریتم نلدر-مید (Nelder-Mead) استفاده کنید:
preds_a = model_a.predict(x_val)preds_b = model_b.predict(x_val)preds_c = model_c.predict(x_val)preds_d = model_d.predict(x_val)# These weights (0.5, 0.25, 0.1, 0.15) are assumed to be learned# empirically.final_preds = 0.5 * preds_a + 0.25 * preds_b + 0.1 * preds_c + 0.15 * preds_dتنوعهای ممکن بسیاری وجود دارد: برای مثال، میتوانید میانگین نمایی از پیشبینیها را بگیرید. در عمل، یک میانگین وزنی ساده با وزنهایی که روی یک مجموعهٔ اعتبارسنجی بهینهسازی شدهاند، یک مبنای قوی و قابل اعتماد است.
کلید موفقیت انسمبل، تنوع (diversity) مجموعهٔ دستهبندها است. تنوع همان قدرت است. اگر همهٔ مدلهای شما اشتباهات یکسانی را مرتکب شوند، انسمبل کردن کمکی به رفع آن نخواهد کرد. اما اگر آنها اشتباهات متفاوتی مرتکب شوند، خطاهای آنها یکدیگر را خنثی میکنند و پیشبینی میانگین بسیار پایدارتر و دقیقتر خواهد شد.
به همین دلیل، شما باید مدلهایی را انسمبل کنید که تا حد امکان خوب هستند در حالی که تا حد امکان با یکدیگر متفاوت میباشند. این معمولاً به معنای استفاده از معماریهای کاملاً متفاوت یا حتی رویکردهای کاملاً متفاوت است (مانند انسمبل کردن یک شبکهٔ عصبی عمیق با یک درخت تصمیم گرادیانبوستشده مانند XGBoost یا LightGBM).
یک چیزی که من متوجه شدهام در عمل بسیار خوب کار میکند—اما به هر دامنهٔ مسئلهای تعمیم نمییابد—انسمبل کردن مدلهای مبتنی بر یادگیری عمیق با درختهای تصمیم گرادیانبوستشده است. این دو خانواده از مدلها نقاط قوت کاملاً متفاوتی دارند و ترکیب آنها اغلب عملکرد فوقالعادهای به همراه دارد.
مقیاسپذیری آموزش مدل با چندین دستگاه
Section titled “مقیاسپذیری آموزش مدل با چندین دستگاه”مفهوم «حلقهٔ پیشرفت» را که در فصل ۷ معرفی کردیم به یاد بیاورید: کیفیت ایدههای شما تابعی از تعداد دفعاتی است که میتوانید چرخهٔ داشتن یک ایده، کدنویسی آن در یک آزمایش، و بررسی نتایج آن را طی کنید (شکل ۱۸.۱ را ببینید).
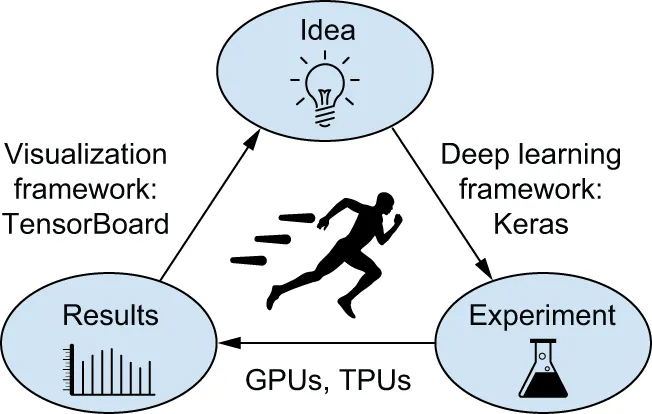
شکل ۱۸.۱: حلقهٔ پیشرفت
همانطور که تخصص خود را در API کراس توسعه میدهید، سرعت شما در کدنویسی آزمایشهای یادگیری عمیق دیگر گلوگاه نخواهد بود. در عوض، گلوگاه به سرعتی تبدیل میشود که سختافزار شما میتواند آزمایشهای شما را اجرا کند. اینجاست که مقیاسبندی افقی مطرح میشود: با افزودن دستگاههای محاسباتی بیشتر (GPUها یا TPUها)، میتوانید آموزش را چندین برابر تسریع کنید.
در این بخش، خواهید آموخت که چگونه اجرای آموزشهای خود را با استفاده از چندین GPU یا TPU مقیاسپذیر کنید.
آموزش با چندین GPU
Section titled “آموزش با چندین GPU”در حالی که GPUها هر سال قدرتمندتر میشوند، مدلهای یادگیری عمیق نیز به طور فزایندهای بزرگتر میشوند و به حافظه و قدرت محاسباتی بسیار بیشتری نسبت به آنچه در یک پردازندهٔ گرافیکی منفرد ارائه میشود نیاز دارند. علاوه بر این، مجموعهدادههای مدرن آنقدر عظیم هستند که آموزش روی یک دستگاه ممکن است هفتهها به طول بینجامد.
دو راه برای توزیع محاسبات بین چندین دستگاه وجود دارد: موازیسازی دادهها (data parallelism) و موازیسازی مدل (model parallelism).
با موازیسازی دادهها، یک مدل منفرد روی چندین دستگاه یا چندین ماشین رونویسی (همانندسازی) میشود. هر یک از نسخههای کپی مدل پردازش دستهای متفاوت از دادهها را بر عهده میگیرد و سپس گرادیانهای تمام دستگاهها تجمیع شده و برای بهروزرسانی وزنهای مدل مشترک به کار میروند.
با موازیسازی مدل، بخشهای مختلف یک مدل واحد روی دستگاههای مختلف اجرا میشوند و یک دستهٔ منفرد از دادهها را با همکاری یکدیگر پردازش میکنند. این رویکرد زمانی استفاده میشود که یک مدل آنقدر بزرگ است که در حافظهٔ یک GPU منفرد جای نمیگیرد.
سپس، البته، میتوانید موازیسازی دادهها و موازیسازی مدل را با هم ترکیب کنید: یک مدل واحد را میتوان در چندین دستگاه تقسیم کرد، و کل این ساختار را میتوان چندین بار رونویسی نمود (شکل ۱۸.۲ را ببینید).
بیایید ببینیم این سازوکار در عمل چگونه کار میکند.
موازیسازی دادهها: رونویسی مدل شما روی هر GPU
Section titled “موازیسازی دادهها: رونویسی مدل شما روی هر GPU”موازیسازی دادهها متداولترین شکل آموزش توزیعشده است. این روش بر اساس یک اصل ساده عمل میکند: تقسیم کن و غلبه کن. فرض کنید به دو GPU دسترسی دارید و میخواهید یک دسته از دادهها را پردازش کنید. به جای اینکه تمام دسته را به یک GPU بفرستید، دسته را به دو زیردستهٔ برابر تقسیم میکنید و هر زیردسته را به یکی از GPUها ارسال مینمایید:
- در زمان استنتاج — ما پیشبینیهای هر زیردسته را بازیابی کرده و آنها را به هم متصل (الحاق) میکنیم تا پیشبینیهای مربوط به کل دسته را به دست آوریم.
- در زمان آموزش — ما گرادیانهای محاسبهشده روی هر زیردسته را بازیابی کرده و میانگین آنها را میگیریم. سپس از گرادیانهای میانگینگیریشده برای بهروزرسانی وزنهای مدل روی هر دو دستگاه استفاده میکنیم.
موازیسازی دادهها روشی ساده و بسیار مقیاسپذیر برای آموزش سریعتر مدلهای شما است. اگر دستگاههای بیشتری در اختیار دارید، فقط کافی است اندازهٔ دستهٔ خود را متناسب با آن افزایش دهید.
موازیسازی مدل: تقسیم مدل شما بین چندین GPU
Section titled “موازیسازی مدل: تقسیم مدل شما بین چندین GPU”اینجاست که موازیسازی مدل (model parallelism) وارد عمل میشود. در حالی که موازیسازی دادهها با تقسیم دستههای دادههای شما در میان دستگاهها عمل میکند و در عین حال مدل کاملی را روی هر دستگاه نگه میدارد، موازیسازی مدل خود مدل را بین دستگاهها تقسیم میکند. این روش زمانی ضروری است که وزنهای مدل یا حافظهٔ فعالسازیهای میانی آنقدر زیاد است که در یک دستگاه واحد جا نمیشود. مدل زیر را در نظر بگیرید:
فهرست ۱۸.۴: یک مدل با اتصال متراکم و بزرگ
model = keras.Sequential( [ keras.layers.Input(shape=(16000,)), keras.layers.Dense(64000, activation="relu"), keras.layers.Dense(8000, activation="sigmoid"), ])هر نمونه دارای ۱۶,۰۰۰ ویژگی است و توسط دو لایهٔ Dense عظیم با ۳۲,۰۰۰ واحد به ۸,۰۰۰ دستهٔ بالقوه دارای همپوشانی طبقهبندی میشود. اولین لایهٔ متراکم دارای ۱۶,۰۰۰ × ۳۲,۰۰۰ وزن است که معادل ۵۱۲ میلیون پارامتر است! با در نظر گرفتن متغیرهای بهینهساز، وزنهای این لایه به تنهایی چندین گیگابایت حافظه مصرف میکنند. چگونه میتوانیم چنین مدلی را بین دستگاهها تقسیم کنیم؟ دو راهبرد وجود دارد: بخشبندی افقی و بخشبندی عمودی.
در بخشبندی افقی، هر دستگاه لایههای متفاوتی از مدل را پردازش میکند. برای مثال، در مدل قبلی، ممکن است لایهٔ اول را روی GPU 0 و لایهٔ دوم را روی GPU 1 قرار دهید. با این حال، این کار یک گلوگاه ذاتی ایجاد میکند: GPU 1 نمیتواند محاسبات خود را آغاز کند تا زمانی که GPU 0 محاسبات لایهٔ اول را به پایان برساند. این امر منجر به ایجاد خطلولهای میشود که در آن دستگاهها اغلب بیکار میمانند مگر اینکه از روشهای پیچیدهٔ همپوشانی خطلوله (pipelining) استفاده کنید.
در بخشبندی عمودی، هر لایه بین تمام دستگاههای موجود تقسیم میشود. از آنجا که لایهها معمولاً به عنوان ضرب ماتریسی پیادهسازی میشوند، تقسیم یک لایه به سادگی به معنای تقسیم ماتریس وزنهای آن در طول یکی از ابعاد آن است. برای مثال، میتوان ماتریس وزن ۱۶,۰۰۰ در ۳۲,۰۰۰ لایهٔ اول را به دو نیمهٔ ۱۶,۰۰۰ در ۱۶,۰۰۰ تقسیم کرد، به طوری که GPU 0 نیمی از محاسبات و GPU 1 نیم دیگر را انجام دهد، و سپس خروجیها با الحاق به یکدیگر متصل شوند:
half_kernel_0 = kernel[:, :32000]half_bias_0 = bias[:32000]
half_kernel_1 = kernel[:, 32000:]half_bias_1 = bias[32000:]
with keras.device("gpu:0"):    half_output_0 = keras.ops.matmul(inputs, half_kernel_0) + half_bias_0
with keras.device("gpu:1"):    half_output_1 = keras.ops.matmul(inputs, half_kernel_1) + half_bias_1
در دنیای واقعی، شما اغلب مایل خواهید بود که موازیسازی دادهها و موازیسازی مدل را با یکدیگر ترکیب کنید. برای مثال، مدل خود را بین دو GPU تقسیم میکنید، و سپس این ساختار دونفره را چهار بار در یک خوشهٔ هشت دستگاهی رونویسی مینمایید (شکل ۱۸.۲ را ببینید).
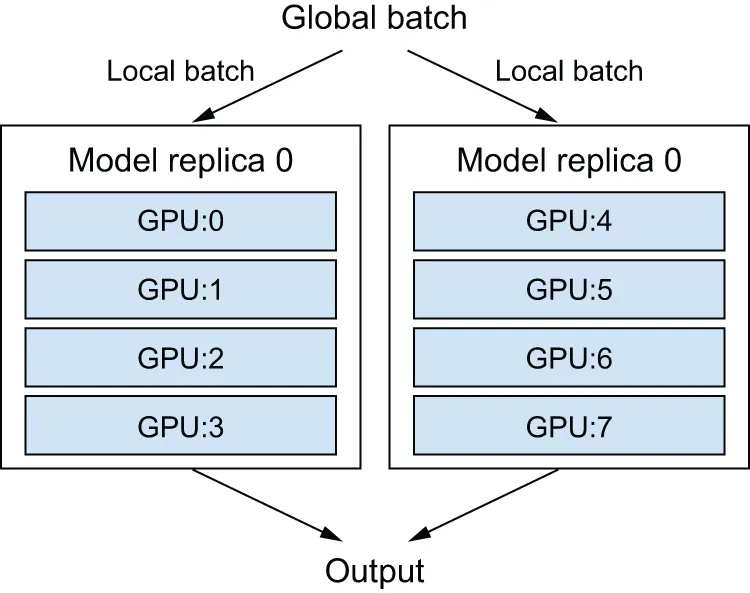
شکل ۱۸.۲: توزیع یک مدل در هشت دستگاه: دو نسخه از مدل، که هر یک توسط گروهی متشکل از چهار دستگاه مدیریت میشوند.
آموزش توزیعشده در عمل
Section titled “آموزش توزیعشده در عمل”اکنون بیایید ببینیم چگونه میتوان این مفاهیم را در عمل پیادهسازی کرد. ما فقط به بکاند JAX خواهیم پرداخت، زیرا مدرنترین و انعطافپذیرترین پشتیبانی را از موازیسازی دادهها و مدل با استفاده از یک رویکرد یکپارچه ارائه میدهد.
دسترسی به دو یا چند GPU
Section titled “دسترسی به دو یا چند GPU”ابتدا، شما باید به چندین GPU دسترسی داشته باشید. تا به امروز، گوگل کولب تنها به شما اجازه میدهد از یک GPU واحد استفاده کنید، بنابراین باید فراتر از کولب بروید. شما چند گزینه در اختیار دارید:
- دو تا هشت GPU تهیه کنید، آنها را روی یک دستگاه واحد سوار کنید (این کار به منبع تغذیهٔ بسیار قدرتمندی نیاز دارد)، و درایورهای CUDA، cuDNN و غیره را نصب کنید. برای اکثر افراد، این بهترین گزینه نیست.
- یک ماشین مجازی چند-GPU را در یکی از ارائهدهندگان ابری اصلی مانند Google Cloud Platform (GCP)، Amazon Web Services (AWS)، یا Microsoft Azure اجاره کنید. ماشینهای مجهز به چندین پردازندهٔ گرافیکی مانند A100 یا H100 در این پلتفرمها به راحتی در دسترس هستند.
- از سرویسهای تخصصی مانند Lambda Labs، Paperspace، یا RunPod استفاده کنید که نمونههای GPU ابری را با هزینهای مناسب و تنظیمات آسان ارائه میدهند.
ما وارد جزئیات نحوهٔ راهاندازی ماشینهای مجازی چند-GPU در فضای ابری نمیشویم، زیرا چنین دستورالعملهایی به سرعت تغییر میکنند، اما تمام ارائهدهندگان اسناد و راهنماهای گامبهگام عالی ارائه میدهند.
استفاده از موازیسازی دادهها با JAX
Section titled “استفاده از موازیسازی دادهها با JAX”استفاده از موازیسازی دادهها با کراس و JAX بسیار ساده است: قبل از ساخت مدل خود، کافی است خط کد زیر را اضافه کنید:
keras.distribution.set_distribution(keras.distribution.DataParallel())همین و بس.
اگر کنترل دقیقتری میخواهید، میتوانید مشخص کنید که میخواهید از کدام دستگاهها استفاده کنید. میتوانید دستگاههای موجود را از طریق دستور زیر فهرست نمایید:
keras.distribution.list_devices()این دستور فهرستی از رشتهها را برمیگرداند—نامهای دستگاههای شما، مانند "gpu:0"، "gpu:1"، و غیره. سپس میتوانید یک زیرمجموعه از آنها را به سازندهٔ DataParallel ارسال کنید:
keras.distribution.set_distribution( keras.distribution.DataParallel(["gpu:0", "gpu:1"]))در یک دنیای آرمانی، آموزش روی N پردازندهٔ گرافیکی باید به افزایش سرعتی با ضریب N منجر شود. با این حال، در عمل، ارتباطات بین دستگاهها مقداری سربار ایجاد میکند. به عنوان یک قاعدهٔ تجربی:
- با دو GPU، افزایش سرعت نزدیک به ۲ برابر باقی میماند.
- با چهار GPU، افزایش سرعت حدود ۳.۸ برابر است.
- با هشت GPU، حدود ۷.۳ برابر است.
البته این فرض میکند که شما از یک اندازهٔ دستهٔ سراسری به اندازهٔ کافی بزرگ استفاده میکنید تا هر GPU با ظرفیت کامل مشغول بماند. اگر اندازهٔ دستهٔ شما بیش از حد کوچک باشد، سربار ارتباطات نسبت به محاسبات مفید افزایش یافته و مقیاسپذیری کاهش مییابد.
استفاده از موازیسازی مدل با JAX
Section titled “استفاده از موازیسازی مدل با JAX”کراس همچنین ابزارهای قدرتمندی برای سفارشیسازی کامل نحوهٔ انجام آموزش توزیعشده ارائه میدهد، از جمله موازیسازی مدل و ترکیبی از موازیسازی دادهها و مدل. این ابزارها حول دو کلاس کلیدی سازماندهی شدهاند: DeviceMesh و LayoutMap.
کلاس DeviceMesh
Section titled “کلاس DeviceMesh”ابتدا، شما باید مفهوم یک مش دستگاه (device mesh) را درک کنید. مش دستگاه به سادگی شبکهای از دستگاهها است که در امتداد یک یا چند بعد سازماندهی شدهاند. این مثال را با هشت GPU در نظر بگیرید:
gpu:0 | gpu:4--------|---------gpu:1 | gpu:5--------|---------gpu:2 | gpu:6--------|---------gpu:3 | gpu:7ایدهٔ اصلی این است که دستگاهها را به گروههایی سازماندهیشده در امتداد محورها تفکیک کنیم. به طور معمول، یک محور مسئول موازیسازی دادهها خواهد بود (رونویسی مدل) و محور دیگر مسئول موازیسازی مدل خواهد بود (تقسیم مدل). در این مثال، ما میتوانیم یک محور ۴ تایی برای دادهها و یک محور ۲ تایی برای مدل داشته باشیم.
یک مش دستگاه نیازی نیست دوبعدی باشد—میتواند هر شکلی که میخواهید داشته باشد. با این حال، در عمل، تقریباً همیشه از یک مش ۱ بعدی (برای موازیسازی دادههای خالص یا مدل خالص) یا یک مش ۲ بعدی (برای ترکیب هر دو) استفاده خواهید کرد.
بیایید یک مش دستگاه ۲ در ۴ در کراس بسازیم:
device_mesh = keras.distribution.DeviceMesh( # We assume eight devices, organized as a 2 × 4 grid. shape=(2, 4), # It's convenient to give your axes meaningful names! axis_names=["data", "model"],)توجه داشته باشید که میتوانید دستگاههایی را که میخواهید استفاده کنید به صراحت نیز مشخص نمایید:
devices = [f"gpu:{i}" for i in range(8)]device_mesh = keras.distribution.DeviceMesh( shape=(2, 4), axis_names=["data", "model"], devices=devices,)همانطور که ممکن است از آرگومان axis_names حدس زده باشید، ما قصد داریم از دستگاهها در امتداد محور ۰ برای موازیسازی دادهها و در امتداد محور ۱ برای موازیسازی مدل استفاده کنیم.
کلاس LayoutMap
Section titled “کلاس LayoutMap”اکنون که مش خود را در اختیار داریم، باید به کراس بگوییم که چگونه بخشهای مختلف محاسبات را بین ابعاد مش دستگاه ما تقسیم کند.
برای تعیین اینکه بخشهای مختلف محاسبات کجا باید انجام شوند، ما از متغیرها به عنوان چارچوب مرجع خود استفاده میکنیم. از آنجا که تمام محاسبات در یک مدل در نهایت شامل خواندن یا نوشتن روی متغیرهای مدل هستند، تعیین نحوهٔ تقسیم متغیرها به طور خودکار تعیین میکند که محاسبات مربوط به آنها کجا انجام پذیرد.
یک متغیر را در نظر بگیرید. فرض کنید شکل آن (32, 64) باشد. دو کار وجود دارد که میتوانید با این متغیر انجام دهید:
- میتوانید آن را در امتداد یک محور از مش خود رونویسی (همانندسازی) کنید تا هر دستگاه در امتداد آن محور همان مقدار را مشاهده کند.
- میتوانید آن را در امتداد یک محور از مش خود خرد (shard) کنید، به طوری که هر دستگاه تنها بخشی از متغیر را ذخیره کند.
توجه داشته باشید که متغیر ما دو بعد دارد. نکتهٔ مهم این است که «خرد کردن» یا «رونویسی کردن» تصمیماتی هستند که برای هر بعد اتخاذ میشوند—برای هر متغیر، باید مشخص کنید که آیا هر یک از محورهای آن خرد شود یا رونویسی گردد.
کلاسی که برای انتقال این تصمیمات به کراس استفاده خواهید کرد، کلاس LayoutMap است. یک LayoutMap اساساً یک فرهنگ لغت تخصصی است که الگوهای نام متغیرها را به تصمیمات مربوط به خرد کردن نگاشت میکند. این کلاس شکلی شبیه به این دارد:
{ # None means "replicate the variable along this dimension." "sequential/dense_1/kernel": (None, "model"), # "model" means "shard the variable along this dimension across the # devices of the model axis of the device mesh." "sequential/dense_1/bias": ("model",), ...}این اولین باری است که با مفهوم مسیر متغیر (variable path) مواجه میشوید—این مسیر به سادگی یک رشته است که متغیر را در ساختار مدل شناسایی میکند، مشابه مسیر یک فایل در یک سیستم فایل.
در اینجا نحوهٔ چاپ مسیرهای تمام متغیرهای یک مدل آمده است:
for v in model.variables: print(v.path)روی مدل مثال از فهرست ۱۸.۴، آنچه به دست میآوریم به شرح زیر است:
sequential/dense/kernelsequential/dense/biassequential/dense_1/kernelsequential/dense_1/biasاکنون بیایید این متغیرها را خرد و رونویسی کنیم. در مورد یک مدل ساده مانند این مدل، قاعدهٔ تجربی شما به شرح زیر خواهد بود:
- آخرین بعد متغیر را در امتداد محور مش
"model"خرد کنید. - تمام ابعاد دیگر را به صورت رونویسیشده رها کنید (با تعیین مقدار
None).
به اندازهٔ کافی ساده است، درست است؟ مانند این:
layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["sequential/dense/kernel"] = (None, "model")layout_map["sequential/dense/bias"] = ("model",)layout_map["sequential/dense_1/kernel"] = (None, "model")layout_map["sequential/dense_1/bias"] = ("model",)در نهایت، با تنظیم پیکربندی توزیع به شکل زیر، به کراس میگوییم که هنگام نمونهسازی متغیرها به این چیدمان خرد کردن مراجعه کند:
model_parallel = keras.distribution.ModelParallel( layout_map=layout_map, # This argument tells Keras to use the mesh axis named "data" for # data parallelism. batch_dim_name="data",)keras.distribution.set_distribution(model_parallel)هنگامی که پیکربندی توزیع تنظیم شد، میتوانید مدل خود را ایجاد کرده و آن را با fit() آموزش دهید. هیچ بخش دیگری از کد شما نیازی به تغییر ندارد!
برای بررسی نحوهٔ خرد شدن متغیرهای خود، میتوانید ویژگی variable.value.sharding را مانند زیر بازرسی کنید:
>>> model.layers[0].kernel.value.shardingحتی میتوانید آن را از طریق ابزار کمکی JAX به نام jax.debug.visualize_sharding بصریسازی کنید:
import jax
value = model.layers[0].kernel.valuejax.debug.visualize_sharding(value.shape, value.sharding)آموزش روی TPU
Section titled “آموزش روی TPU”فراتر از GPUها، به طور کلی در دنیای یادگیری عمیق گرایشی به سمت انتقال جریانهای کاری به سختافزارهای تخصصیتر، به ویژه واحدهای پردازش تانسور (TPUها) گوگل وجود دارد. TPUها تراشههای سفارشی هستند که به طور خاص برای محاسبات جبر خطی و ضرب ماتریسی در یادگیری عمیق بهینهسازی شدهاند.
آموزش روی TPU نیازمند پشت سر گذاشتن برخی پیشنیازها است. اما ارزش تلاش اضافی را دارد: TPUها واقعاً، واقعاً سریع هستند، به ویژه برای مدلهای بزرگ مانند ترنسفورمرها.
شما در واقع میتوانید از TPU v2 به صورت رایگان در کولب استفاده کنید. در منوی کولب، در زیر برگهٔ Runtime، در پنجرهٔ Change Runtime Type، کافی است گزینهٔ TPU را انتخاب نمایید.
هنگام اجرای کد کراس با بکاند JAX روی یک نوتبوک با پشتیبانی از TPU، به چیزی بیش از فراخوانی keras.distribution.set_distribution(DataParallel()) نیاز ندارید، و کدهای شما به طور خودکار از تمام هستههای TPU استفاده خواهند کرد.
استفاده از همجوشی گامها برای بهبود بهرهوری TPU
Section titled “استفاده از همجوشی گامها برای بهبود بهرهوری TPU”از آنجا که یک TPU قدرت محاسباتی عظیمی در دسترس دارد، برای اینکه هستههای TPU به طور کامل مورد بهرهبرداری قرار گیرند، باید با دستههای بسیار بزرگی آموزش دهید. اگر اندازهٔ دستهٔ شما بیش از حد کوچک باشد، TPU بخش زیادی از زمان خود را صرف هماهنگی بین مراحل آموزش میکند تا انجام محاسبات واقعی.
با این حال، یک ترفند ساده وجود دارد که میتوانید برای حفظ دستههایی با اندازهٔ معقول و در عین حال حفظ بهرهوری کامل از TPU استفاده کنید: همجوشی گامها (step fusing). همجوشی گامها به معنای اجرای چندین مرحلهٔ آموزش (مثلاً ۱۰ یا ۲۰ مرحله) درون یک اجرای کامپایلشدهٔ واحد روی TPU است، بدون اینکه کنترل برنامه پس از هر مرحله به پایتون بازگردد. این کار میتواند به افزایش چشمگیر سرعت منجر شود:
model.compile(..., steps_per_execution=8)سرعتبخشی به آموزش و استنتاج با محاسبات دقت پایینتر
Section titled “سرعتبخشی به آموزش و استنتاج با محاسبات دقت پایینتر”چه میشد اگر به شما میگفتم تکنیک سادهای وجود دارد که میتوانید از آن برای افزایش سرعت آموزش و استنتاج تقریباً هر مدلی به میزان ۲ برابر یا بیشتر، همراه با کاهش مصرف حافظه به نصف، بدون هیچ هزینهای در عملکرد مدل یا با هزینهای ناچیز استفاده کنید؟ این تکنیک وجود دارد: استفاده از محاسبات با دقت پایینتر است.
درک دقت ممیز شناور
Section titled “درک دقت ممیز شناور”دقت برای اعداد همانند تفکیکپذیری (resolution) برای تصاویر است. از آنجا که رایانهها فقط میتوانند ۰ها و ۱ها را پردازش کنند، هر عددی که در نرمافزار ذخیره میکنید باید به تعداد محدودی بیت تبدیل شود. برای یک تصویر پیکسلی، داشتن پیکسلهای بیشتر به معنای جزئیات دقیقتر است؛ به همین ترتیب، برای اعداد در رایانه، داشتن بیتهای بیشتر به معنای دقت بالاتر است.
اعداد ممیز شناور نیز همینگونه هستند. در ریاضیات، اعداد حقیقی یک محور پیوسته را تشکیل میدهند: تعداد بیشماری عدد بین هر دو نقطه وجود دارد. اما در رایانه، شما نمیتوانید بینهایت عدد را ذخیره کنید، بنابراین تنها میتوانید زیرمجموعهٔ محدودی از مقادیر را تقریب بزنید.
سه سطح از دقت وجود دارد که معمولاً از آنها استفاده میکنید:
- دقت نیمه (half precision)، یا
float16، که در آن اعداد روی ۱۶ بیت ذخیره میشوند - دقت تکی (single precision)، یا
float32، که در آن اعداد روی ۳۲ بیت ذخیره میشوند - دقت دوگانه (double precision)، یا
float64، که در آن اعداد روی ۶۴ بیت ذخیره میشوند
شما حتی میتوانید به سراغ float8 بروید، همانطور که کمی بعد خواهید دید.
راه اندیشیدن دربارهٔ وضوح اعداد ممیز شناور، بر حسب کوچکترین فاصله بین دو عدد متوالی در یک مقیاس معین است. در float32، شما حدود ۷ رقم بااهمیت اعشاری دقت دارید، در حالی که در float16، تنها حدود ۳ تا ۴ رقم بااهمیت اعشاری در اختیار خواهید داشت.
استنتاج با Float16
Section titled “استنتاج با Float16”هر مدلی که تا به اینجای کتاب دیدهاید از اعداد با دقت تکی استفاده کرده است: این مدلها وضعیت خود را به صورت متغیرهای float32 ذخیره کرده و تمام محاسبات خود را با استفاده از عملیات float32 انجام دادهاند. دقت تکی برای یادگیری عمیق پیشفرض تاریخی بوده است.
با این حال، پردازندههای گرافیکی و TPUهای مدرن دارای سختافزارهای تخصصی هستند که میتوانند عملیات ۱۶ بیتی را بسیار سریعتر و با مصرف حافظهٔ بسیار کمتری اجرا کنند. در اکثر پردازندههای گرافیکی انویدیا (از نسل Volta و Turing به بعد)، هستههای تانسور (Tensor Cores) محاسبات ۱۶ بیتی را تا چند برابر سریعتر از محاسبات ۳۲ بیتی استاندارد پردازش میکنند! شما میتوانید به سادگی پیشفرض دقت اعشاری کراس را با یک خط کد تغییر دهید:
import keras
keras.config.set_dtype_policy("float16")
توجه داشته باشید که این کار باید قبل از تعریف مدل شما انجام شود. انجام این کار باعث افزایش سرعت فوقالعادهای در استنتاج مدل شما میشود و مصرف حافظه را به نصف کاهش میدهد.
همچنین یک جایگزین برای float16 وجود دارد که روی برخی دستگاهها، به ویژه TPUها، بهتر کار میکند: bfloat16 (فرمت اعشاری مغز یا Brain Floating Point). در حالی که float16 استاندارد ۵ بیت برای توان و ۱۰ بیت برای مانتیس اختصاص میدهد، bfloat16 همان ۸ بیت توان float32 را حفظ میکند و مانتیس را به ۷ بیت کاهش میدهد (جدول ۱۸.۱ را ببینید). این ویژگی به آن دامنهٔ دینامیکی یکسانی با float32 میدهد و آن را در برابر سرریزها یا زیرریزهای عددی بسیار مقاومتر میسازد.
جدول ۱۸.۱: تفاوت بین float16 و bfloat16
| نوع داده (dtype) | float16 | bfloat16 |
|---|---|---|
| بیتهای توان | 5 | 8 |
| بیتهای مانتیس | 10 | 7 |
| بیتهای علامت | 1 | 1 |
آموزش با دقت مختلط
Section titled “آموزش با دقت مختلط”تنظیم دقت پیشفرض اعشاری روی ۱۶ بیت روشی عالی برای سرعتبخشی به استنتاج است. اکنون، وقتی نوبت به آموزش میرسد، اگر سعی کنید کل مدل را به طور کامل در float16 آموزش دهید، احتمالاً به سرعت با مشکل مواجه خواهید شد: آموزش یا ناپایدار میشود یا کاملاً واگرا میگردد، زیرا گرادیانها در طول پسانتشار دچار زیرریز عددی (underflow) میشوند (به صفر میل میکنند).
با این حال، شما میتوانید از یک رویکرد ترکیبی استفاده کنید: این همان چیزی است که آموزش با دقت مختلط (mixed-precision training) نامیده میشود. ایده این است که متغیرهای مدل را در float32 نگه داریم (برای اطمینان از پایداری عددی و حفظ دقیق بهروزرسانیهای کوچک گرادیان)، اما محاسبات گذر رفت (forward pass) و بخش اعظم گذر برگشت را در float16 انجام دهیم تا از سرعت بالای هستههای محاسباتی ۱۶ بیتی بهرهمند شویم.
شما میتوانید دقت مختلط را به این شکل فعال کنید:
import keras
keras.config.set_dtype_policy("mixed_float16")
به طور معمول، بخش عمدهٔ گذر رفت مدل در float16 انجام خواهد شد (به استثنای لایههای خاصی که از نظر عددی حساس هستند). وزنهای مدل در float32 ذخیره میشوند، اما قبل از استفاده در محاسبات هر لایه، به float16 تبدیل میشوند، و گرادیانها در نهایت با متغیرهای float32 ادغام میگردند.
لایههای کراس دارای دو ویژگی variable_dtype و compute_dtype هستند. به طور پیشفرض، هر دوی آنها float32 هستند. وقتی سیاست "mixed_float16" را فعال میکنید، variable_dtype برابر با float32 و compute_dtype برابر با float16 خواهد شد.
برخی عملیات ممکن است در float16 از نظر عددی ناپایدار باشند (به ویژه توابع softmax و crossentropy). برای لایههای خروجی، معمولاً ترجیح داده میشود محاسبات به صراحت در float32 انجام شود، کاری که کراس به طور خودکار هنگام تشخیص سیاستهای دقت مختلط مدیریت میکند.
استفاده از مقیاسبندی زیان با دقت مختلط
Section titled “استفاده از مقیاسبندی زیان با دقت مختلط”در طول آموزش، گرادیانها میتوانند بسیار کوچک شوند. هنگام استفاده از دقت مختلط، گرادیانهای شما در طول پسانتشار در float16 محاسبه میشوند، و اگر قدر مطلق آنها کمتر از حداقل مقدار قابل نمایش در ۱۶ بیت (حدود 10-5) شود، به صفر گرد میشوند (زیرریز عددی). اگر گرادیانها صفر شوند، مدل دیگر چیزی یاد نمیگیرد!
مقادیر گرادیان متناسب با مقدار زیان هستند، بنابراین برای بزرگتر کردن گرادیانها، یک ترفند ساده این است که تابع زیان را در یک ضریب بزرگ (مثلاً ۱۲۸ یا ۱۰۲۴) ضرب کنیم تا گرادیانها در محدودهٔ قابل نمایش float16 قرار گیرند. سپس، پس از پسانتشار و درست قبل از بهروزرسانی وزنهای float32، گرادیانها را مجدداً بر همان ضریب تقسیم میکنیم تا مقیاس واقعی آنها بازیابی شود. این تکنیک مقیاسبندی زیان (loss scaling) نامیده میشود.
کراس این فرآیند را بسیار آسان کرده است. اگر میخواهید از یک ضریب مقیاسبندی ثابت استفاده کنید، میتوانید به سادگی آرگومان loss_scale_factor را به بهینهساز ارسال نمایید:
optimizer = keras.optimizers.Adam(learning_rate=1e-3, loss_scale_factor=10)اگر مایلید بهینهساز ضریب مقیاسبندی مناسب را به صورت پویا و خودکار پیدا کند، میتوانید از پوشش LossScaleOptimizer نیز استفاده کنید:
optimizer = keras.optimizers.LossScaleOptimizer( keras.optimizers.Adam(learning_rate=1e-3))استفاده از LossScaleOptimizer معمولاً بهترین گزینهٔ شما است: مقدار بهینهٔ مقیاسبندی میتواند در طول مراحل مختلف آموزش تغییر کند، و این بهینهساز ضریب را بر اساس وقوع سرریزها به طور خودکار تطبیق میدهد.
فراتر از دقت مختلط: آموزش با float8
Section titled “فراتر از دقت مختلط: آموزش با float8”اگر اجرای گذر رفت در دقت ۱۶ بیتی چنین مزایای عملکردی چشمگیری دارد، ممکن است بپرسید: آیا میتوانیم حتی پایینتر برویم؟ آیا میتوانیم از اعداد ۸ بیتی استفاده کنیم؟ پاسخ مثبت است: این همان آموزش با float8 است.
آموزش با دقت مختلط با استفاده از float16 در گذر رفت آخرین سطح دقتی است که «به صورت رایگان» و بدون تنظیمات خاص کار میکند. رفتن به float8 نیازمند مقیاسبندی پویا و مداوم تانسورهای ورودی و وزنها قبل از هر ضرب ماتریسی است، زیرا دامنهٔ مقادیر در ۸ بیت به شدت محدود است.
چارچوب کراس یک پیادهسازی توکار برای آموزش با float8 ارائه میدهد. از آنجا که این تکنیک به طور خاص به سختافزارهای مدرن (مانند GPUهای سری NVIDIA H100 یا TPU v5) نیاز دارد، این ویژگی به شما اجازه میدهد مدلهای ترنسفورمر بسیار عظیم را با سرعتی باورنکردنی آموزش دهید:
from keras import ops
x = ops.array([[0.1, 0.9], [1.2, -0.8]])kernel = ops.array([[-0.1, -2.2], [1.1, 0.7]])
نکتهٔ مهم این است که این سربار اضافی دارای هزینهٔ محاسباتی است. اگر مدل شما بیش از حد کوچک باشد یا پردازندهٔ گرافیکی شما به اندازهٔ کافی قدرتمند نباشد، آموزش با float8 ممکن است در واقع کندتر از float16 باشد. این تکنیک در درجهٔ اول برای مدلهای بسیار بزرگ با میلیاردها پارامتر طراحی شده است.
استنتاج سریعتر با کوانتیزاسیون
Section titled “استنتاج سریعتر با کوانتیزاسیون”اجرای استنتاج در float16—یا حتی float8—به افزایش سرعت بسیار خوبی برای مدل شما منجر خواهد شد. اما اگر میخواهید مدلی را روی دستگاههای لبهای (مانند تلفنهای همراه یا میکروکنترلرها) مستقر کنید، یا اگر نیاز دارید هزینهٔ سرورهای ابری استنتاج خود را به حداقل برسانید، میتوانید یک گام فراتر بروید و از کوانتیزاسیون (quantization) بر روی اعداد صحیح (مانند int8) استفاده کنید.
اگر میخواهید کوانتیزاسیون را از ابتدا پیادهسازی کنید، ریاضیات آن بسیار ساده است: ایدهٔ کلی این است که تمام مقادیر float32 را در یک ضریب ثابت ضرب کرده و آنها را به نزدیکترین عدد صحیح در محدودهٔ -۱۲۸ تا ۱۲۷ گرد کنیم. سپس، پس از انجام محاسبات جبری صحیح، نتیجه را مجدداً با تقسیم بر همان ضرایب به مقیاس اعشاری برگردانیم (کوانتیزاسیونزدایی یا dequantization):
def abs_max_quantize(value):    # Max of absolute value of the tensor    abs_max = ops.max(ops.abs(value), keepdims=True)    # Scale is max of int range divided by max of tensor (1e-7 is to    # avoid dividing by 0).    scale = ops.divide(127, abs_max + 1e-7)    # Scales the value    scaled_value = value * scale    # Rounding and clipping first is more accurate than directly    # casting.    scaled_value = ops.clip(ops.round(scaled_value), -127, 127)    # Casts to int8    scaled_value = ops.cast(scaled_value, dtype="int8")    return scaled_value, scale
int_x, x_scale = abs_max_quantize(x)int_kernel, kernel_scale = abs_max_quantize(kernel)
بیایید این موضوع را با یک مثال ملموس بررسی کنیم. فرض کنید میخواهید عملیات matmul(x, kernel) را با متغیرهایی که مقادیر تصادفی استاندارد دارند انجام دهید:
اگر بخواهید این مقادیر را بدون مقیاسبندی اولیه مستقیماً به int8 تبدیل کنید، بسیار مخرب خواهد بود زیرا تمام مقادیر بین -۱ و ۱ به ۰ گرد میشوند. اما با مقیاسبندی مناسب، دامنهٔ کامل ۸ بیتی حفظ میشود:
اکنون میتوانیم یک matmul صحیح و بسیار سریعتر را اجرا کنیم و خروجی را از مقیاس خارج نماییم:
int_y = ops.matmul(int_x, int_kernel)y = ops.cast(int_y, dtype="float32") / (x_scale * kernel_scale)میزان دقت آن چقدر است؟ بیایید y کوانتیزهشدهٔ خود را با خروجی matmul استاندارد در float32 مقایسه کنیم:
>>> yبسیار دقیق است! برای یک ضرب ماتریسی بزرگ، انجام این کار محاسبات بسیار زیادی را برای شما صرفهجویی میکند، زیرا محاسبات int8 هم از نظر پهنای باند حافظه و هم از نظر توان پردازشی بسیار سبکتر از float32 هستند.
البته، من انتظار ندارم که شما هرگز کوانتیزاسیون را به صورت دستی پیادهسازی کنید—این کار بسیار وقتگیر و غیرعملی خواهد بود. کراس ابزارهای توکار و پشتیبانی کاملی برای کوانتیزاسیون خودکار لایهها و مدلها فراهم میکند، به طوری که میتوانید یک مدل را تنها با تنظیم یک پرچم ساده کوانتیزه نمایید:
# Instantiates a model (or any quantizable layer)model = ...# Boom!model.quantize("int8")# Now predict() and call() will run (partially) in int8!predictions = model.predict(...)- شما میتوانید از تنظیم ابرپارامترها و KerasTuner برای خودکارسازی فرآیند خستهکنندهٔ یافتن بهترین پیکربندی مدل استفاده کنید. اما مراقب بیشبرازش روی مجموعهٔ اعتبارسنجی باشید!
- گروهی (انسمبل) از مدلهای متنوع اغلب میتواند کیفیت پیشبینیهای شما را به میزان قابل توجهی بهبود بخشد.
- برای مقیاسپذیری بیشتر جریانهای کاری خود، میتوانید از موازیسازی دادهها (data parallelism) برای آموزش یک مدل روی چندین دستگاه استفاده کنید، به شرطی که مدل به اندازهٔ کافی کوچک باشد که در یک دستگاه واحد جا شود.
- برای مدلهای بزرگتر، میتوانید از موازیسازی مدل (model parallelism) نیز برای تقسیم متغیرها و محاسبات مدل خود بین چندین دستگاه استفاده نمایید.
- شما میتوانید آموزش مدل روی GPUها یا TPUها را با فعال کردن دقت مختلط (mixed precision) سرعت بخشید—به طور کلی بدون هزینهٔ خاصی، افزایش سرعت چشمگیری دریافت خواهید کرد.
- شما همچنین میتوانید استنتاج را با استفاده از دقت
float16یا حتی کوانتیزاسیونint8تسریع نمایید.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.