
فصل ۱۹: آیندهٔ هوش مصنوعی
برای استفادهٔ مناسب از یک ابزار، شما نه تنها باید درک کنید که آن ابزار چه کارهایی را میتواند انجام دهد، بلکه باید بدانید چه کارهایی را نمیتواند انجام دهد. من قصد دارم مروری بر برخی از محدودیتهای کلیدی یادگیری عمیق ارائه دهم. سپس، برخی دیدگاههای پژوهشی و پیشبینیها را دربارهٔ سیر تکاملی آیندهٔ هوش مصنوعی و آنچه برای رسیدن به هوش عمومی در سطح انسان نیاز است مطرح خواهم کرد. این مباحث به ویژه اگر مایل به ورود به پژوهشهای بنیادین باشید برای شما جالب خواهد بود.
محدودیتهای یادگیری عمیق
Section titled “محدودیتهای یادگیری عمیق”کارهای بیشماری وجود دارد که میتوانید با یادگیری عمیق انجام دهید. اما یادگیری عمیق نمیتواند همهچیز را انجام دهد، و تفاوتهای اساسی بین هوش انسانی و مدلهای یادگیری عمیق کنونی وجود دارد. درک این محدودیتها برای هر کسی که میخواهد از هوش مصنوعی به شیوهای مؤثر در عمل استفاده کند، یا روی آیندهٔ آن کار نماید، ضروری است.
مدلهای یادگیری عمیق در سازگاری با موقعیتهای بدیع دچار مشکل میشوند
Section titled “مدلهای یادگیری عمیق در سازگاری با موقعیتهای بدیع دچار مشکل میشوند”مدلهای یادگیری عمیق منحنیهای پارامتری بزرگی هستند که روی مجموعهدادههای عظیم فیت شدهاند. این سرچشمهٔ قدرت آنها است—آنها میتوانند ساختارهای آماری پیچیده را یاد بگیرند و درونیابیهای نرمی بین نقاط دادهای که قبلاً دیدهاند انجام دهند. اما این همچنین منشأ بزرگترین محدودیت آنها است.
اول و مهمتر از همه، یک منحنی پارامتری تنها قادر به ذخیرهسازی اطلاعات است—این در واقع نوعی پایگاه داده است. حتی اگر فضایی با ابعاد بسیار بالا باشد که بتوانید در آن درونیابی کنید، مدل صرفاً الگوهایی را بازتولید میکند که در دادههای آموزشی آن رمزگذاری شدهاند.
تنها کاری که میتوانید با یک پایگاه دادهٔ ایستا انجام دهید بازیابی اطلاعات است. و این دقیقاً همان کاری است که مدلهای یادگیری عمیق انجام میدهند: وقتی یک ورودی جدید به آنها میدهید، آنها به دنبال نزدیکترین الگوها در دادههای آموزشی خود میگردند و آنها را برای تشکیل یک خروجی درونیابی مینمایند. اگر ورودی در توزیع آماری دادههای آموزشی قرار داشته باشد، مدل عملکرد درخشانی خواهد داشت. اما اگر ورودی با هر چیزی که مدل قبلاً دیده است به طور اساسی متفاوت باشد، مدل به طرز فاجعهباری شکست میخورد.
این امر در مورد بزرگترین مدلهای مولد نیز صدق میکند. در سالهای اخیر، ظهور مدلهای زبانی بزرگ (LLMها) این توهم را ایجاد کرده است که این مدلها میتوانند استدلال کنند یا با موقعیتهای کاملاً جدید سازگار شوند. اما وقتی چنین مدلهایی را با وظایفی آزمایش میکنید که واقعاً خارج از توزیع دادههای آموزشی آنها هستند—وظایفی که نیازمند ترکیب نوآورانهای از مفاهیم هستند که مدل قبلاً ندیده است—متوجه میشوید که آنها قادر به حل سادهترین معماها نیز نیستند.
به معمای نشان داده شده در شکل ۱۹.۱ نگاه کنید. آیا راهحل را پیدا کردید؟ عالی است. خیلی سخت نیست، اینطور نیست؟ اما برای پیشرفتهترین مدلهای هوش مصنوعی امروزی، این معما کاملاً غیرقابل حل است. چرا؟ چون این یک الگوی بصری جدید است که در دادههای آموزشی آنها وجود نداشته است. یک انسان میتواند قوانین این معما را در چند ثانیه استنباط کند زیرا انسانها توانایی یادگیری مفاهیم انتزاعی جدید در لحظه را دارند. مدلهای یادگیری عمیق این توانایی را ندارند: آنها نمیتوانند با شرایط واقعاً بدیع و پیشبینینشده سازگار شوند.
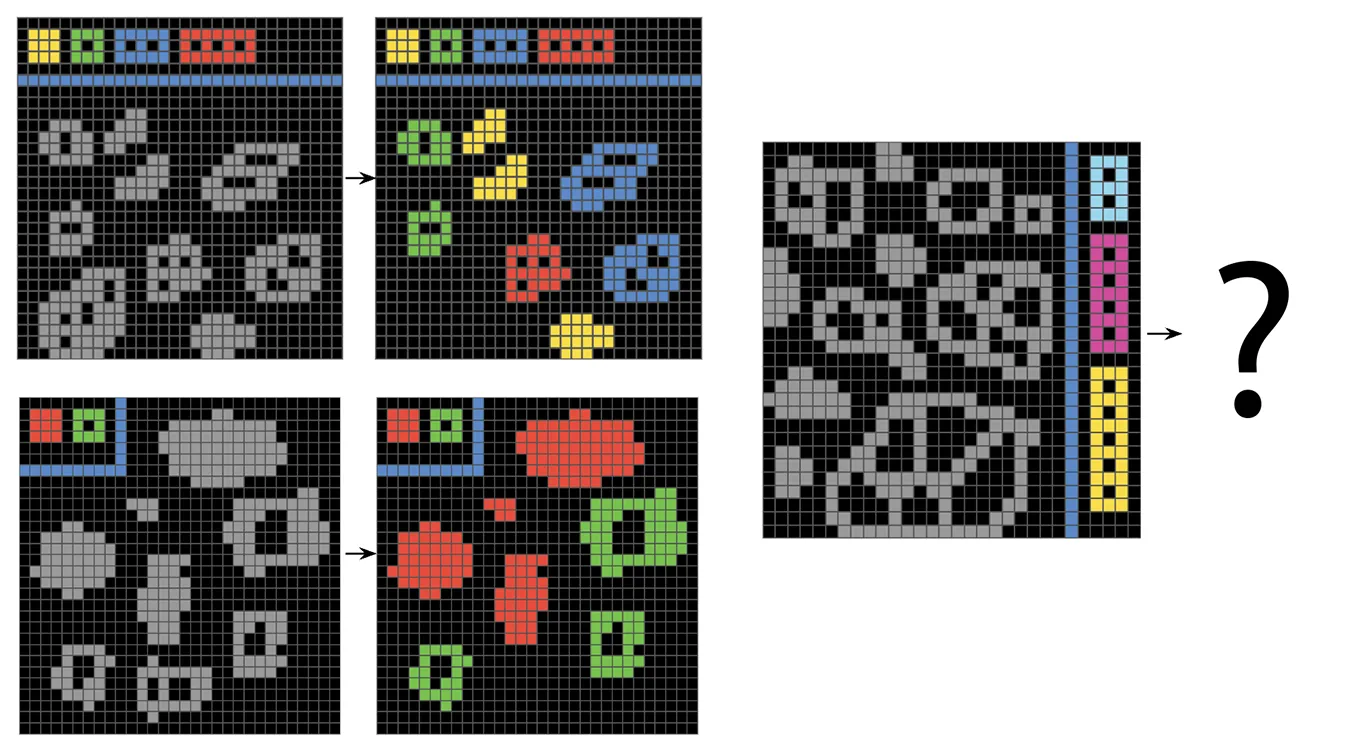
شکل ۱۹.۱: یک معمای ساده اما بدیع
این حالت شکست حتی در مورد تغییرات بسیار جزئی از الگویی که یک مدل زبانی بارها در دادههای آموزشی خود با آن مواجه شده است نیز رخ میدهد. مسئلهٔ معروف مانتی هال (Monty Hall problem) را در نظر بگیرید: یک معمای احتمالات کلاسیک با سه در، که پشت یکی از آنها یک ماشین و پشت دو تای دیگر بز قرار دارد. مدلهای زبانی این مسئله را به طور کامل حفظ کردهاند و میتوانند پاسخ صحیح را با تحلیل کامل تکرار کنند. با این حال، اگر شما شرایط مسئله را به گونهای تغییر دهید که منطق آن کاملاً دگرگون شود اما کلمات یکسان باقی بمانند (برای مثال، مجری به صورت تصادفی در را باز میکند، یا هر دو در باقیمانده در باز میشوند—شکل ۱۹.۲ را ببینید)، مدل همچنان همان پاسخ حفظشدهٔ استاندارد را طوطیوار تکرار میکند، بدون اینکه متوجه شود شرایط تغییر یافته پاسخ را بیمعنی کرده است!
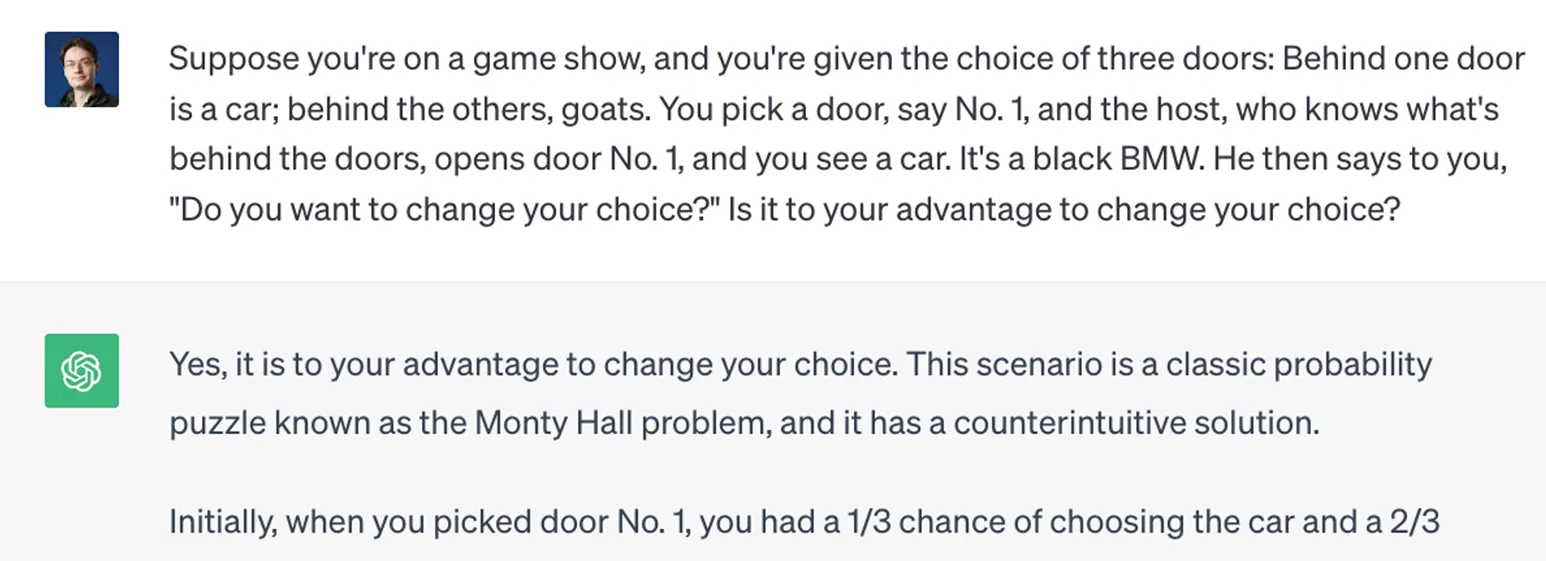
شکل ۱۹.۲: گونهای از مسئلهٔ مانتی هال که نشان میدهد مدلهای زبانی صرفاً الگوها را از حافظه تکرار میکنند بدون اینکه سناریو را بفهمند.
شایان ذکر است که این اعلانهای خاص بعداً با اضافه کردن قواعد ویژه یا دادههای جدید اصلاح شدند. امروزه بیش از ۲۵,۰۰۰ نفر وجود دارند که به عنوان برچسبزن داده کار میکنند تا چنین مواردی را رفع کنند. اما این کار مانند زدن یک چسب زخم روی یک زخم عمیق است: شما نمیتوانید تمام تغییرات ممکن از تمام مسائل را به صورت دستی برچسبگذاری کنید. مسئلهٔ بنیادین این است که مدل نمیتواند به طور مستقل استدلال کند؛ بلکه تنها زمانی پاسخ درست میدهد که مسئله قبلاً در دادههای آموزشیاش دیده شده باشد.
مدلهای یادگیری عمیق به نحوهٔ بیان و سایر عوامل حواسپرتی بسیار حساس هستند
Section titled “مدلهای یادگیری عمیق به نحوهٔ بیان و سایر عوامل حواسپرتی بسیار حساس هستند”یک مشکل بسیار نزدیک، حساسیت فوقالعادهٔ مدلهای یادگیری عمیق به نحوهٔ ارائهٔ ورودی آنها است. در یادگیری ماشین، این پدیده تحت عنوان نمونههای متخاصم (adversarial examples) شناخته میشود: تغییرات بسیار کوچک و نامحسوس در ورودی که معنای آن را برای انسان تغییر نمیدهند، اما باعث میشوند مدل خروجی کاملاً متفاوتی تولید کند (شکل ۱۹.۳ را ببینید).
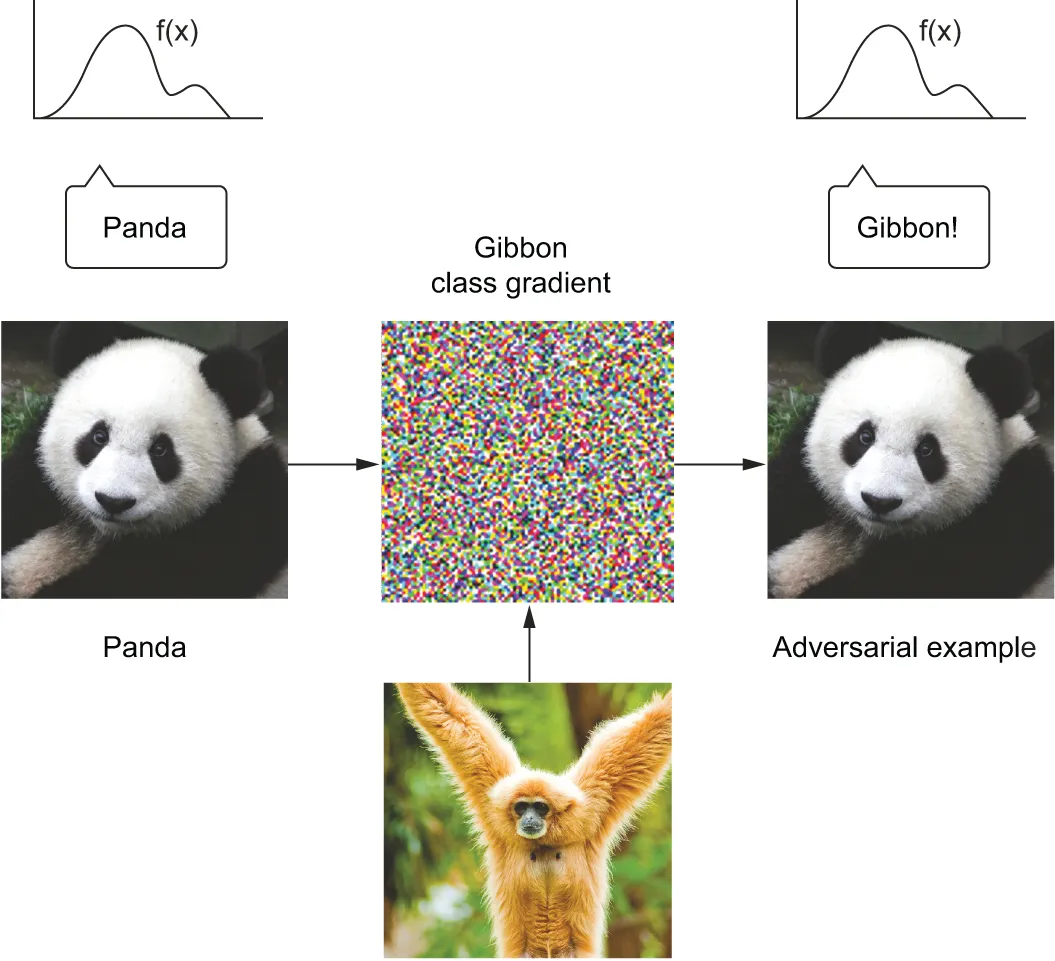
شکل ۱۹.۳: یک نمونهٔ متخاصم: تغییرات نامحسوس برای چشم انسان باعث میشود مدل یک پاندا را با اطمینان بالا به عنوان گیبون دستهبندی کند.
به طور مشابه، از طریق صعود گرادیان، میتوانید یک تصویر را کمی اصلاح کنید تا پیشبینی کلاس را برای یک دستهٔ دلخواه به حداکثر برسانید، بدون اینکه تصویر تغییر چشمگیری برای چشم انسان داشته باشد.
به همین ترتیب، مدلهای زبانی بزرگ از حساسیت بسیار بالایی نسبت به جزئیات جزئی در اعلانهای خود رنج میبرند. تغییرات بیضرر در اعلان میتواند کارایی مدل را از عالی به افتضاح تبدیل کند. پژوهشگران این موضوع را در وظایف استدلال ریاضی ساده به نمایش گذاشتهاند1:
«آلیس N برادر دارد و همچنین M خواهر دارد. برادر آلیس چند خواهر دارد؟»
پاسخ، البته، M + 1 است (خواهران آلیس به علاوهٔ خود آلیس). برای یک مدل زبانی، پرسیدن این سؤال با نامهای مختلف، یا تغییر ترتیب کلمات، یا افزودن یک جملهٔ بیربط، اغلب باعث میشود مدل پاسخی کاملاً اشتباه با اعتمادبهنفس بالا ارائه دهد.
این حساسیت بیش از حد به نحوهٔ بیان، مفهوم مهندسی اعلان (prompt engineering) را به وجود آورده است. مهندسی اعلان هنر آزمون و خطای عبارتهای مختلف برای یافتن اعلانی است که مدل را وادار به تولید خروجی مورد نظر میکند.
آنچه پشت این پدیده قرار دارد این است که یک مدل زبانی یک منحنی پارامتری بزرگ است—رسانهای برای ذخیرهٔ دانش و برنامهها در یک فضای برداری نهان با ابعاد بالا.
از آنجا که دانش و برنامههای ایندکسشده توسط مدل زبانی درونیاب هستند، شما میتوانید در فضای نهان حرکت کنید تا نزدیکترین الگوها را بیابید.
مهندسی اعلان فرایند جستجو در فضای نهان است تا اعلان جستجویی (lookup query) پیدا شود که به نظر میرسد بهترین نتایج را برای یک وظیفهٔ معین ارائه میدهد.
مدلهای یادگیری عمیق در یادگیری برنامههای تعمیمپذیر با چالش روبرو هستند
Section titled “مدلهای یادگیری عمیق در یادگیری برنامههای تعمیمپذیر با چالش روبرو هستند”مشکل مدلهای یادگیری عمیق فقط این نیست که به تکرار کورکورانهٔ الگوهایی که حفظ کردهاند محدود هستند. مشکل این است که حتی زمانی که الگوهایی را یاد میگیرند، آنها برنامههای واقعاً تعمیمپذیر را یاد نمیگیرند.
مسئلهٔ جمع کردن دو عدد را در نظر بگیرید که به صورت دنبالهای از کاراکترها نمایش داده شدهاند—مانند «۴ ۳ ۵ ۷ + ۸ ۹ ۳ ۶». سعی کنید یک مدل یادگیری عمیق (یک ترنسفورمر، یک LSTM یا هر مدل دیگری) را آموزش دهید تا این کار را انجام دهد. مدل به راحتی یاد میگیرد که اعدادی با طول مشابه با دادههای آموزشی را جمع کند. اما به محض اینکه دو عدد با ۲۰ رقم به آن بدهید در حالی که دادههای آموزشی فقط تا ۱۰ رقم بودهاند، مدل کاملاً شکست خواهد خورد!
این در مورد پیشرفتهترین مدلهای زبانی نیز صدق میکند—حداقل آنهایی که صریحاً برای اجرای قطعهکدهای پایتون به صورت سختکد برنامهریزی نشدهاند. یک ترنسفورمر الگوریتم جمع حسابی عمومی را یاد نمیگیرد؛ بلکه یک درونیابی تقریبی از جمع را یاد میگیرد.
دلیل اینکه چرا یک مدل یادگیری عمیق حتی پس از دیدن میلیونها مثال، الگوریتم دقیق جمع را یاد نمیگیرد، این است که شیوهٔ یادگیری آن—نزول گرادیان روی یک منحنی هموار و پیوسته—به صورت ساختاری برای یادگیری برنامههای گسسته، الگوریتمی و نمادین نامناسب است.
خطر انسانانگاری مدلهای یادگیری ماشین
Section titled “خطر انسانانگاری مدلهای یادگیری ماشین”درک خود ما از تصاویر، صداها و زبان در تجربیات حسی-حرکتی ما به عنوان انسان ریشه دارد. وقتی کلمهٔ «سگ» را میشنویم، آن کلمه به تجربیات ما از دیدن سگها، لمس کردن خز آنها، شنیدن پارس آنها، و تعامل با آنها در جهان فیزیکی متصل است. در مقابل، یک مدل یادگیری عمیق هیچ ارجاعی به جهان واقعی ندارد: این مدلها صرفاً دستکاریکنندههای آماری نمادها و بردارها هستند (شکل ۱۹.۴ را ببینید).
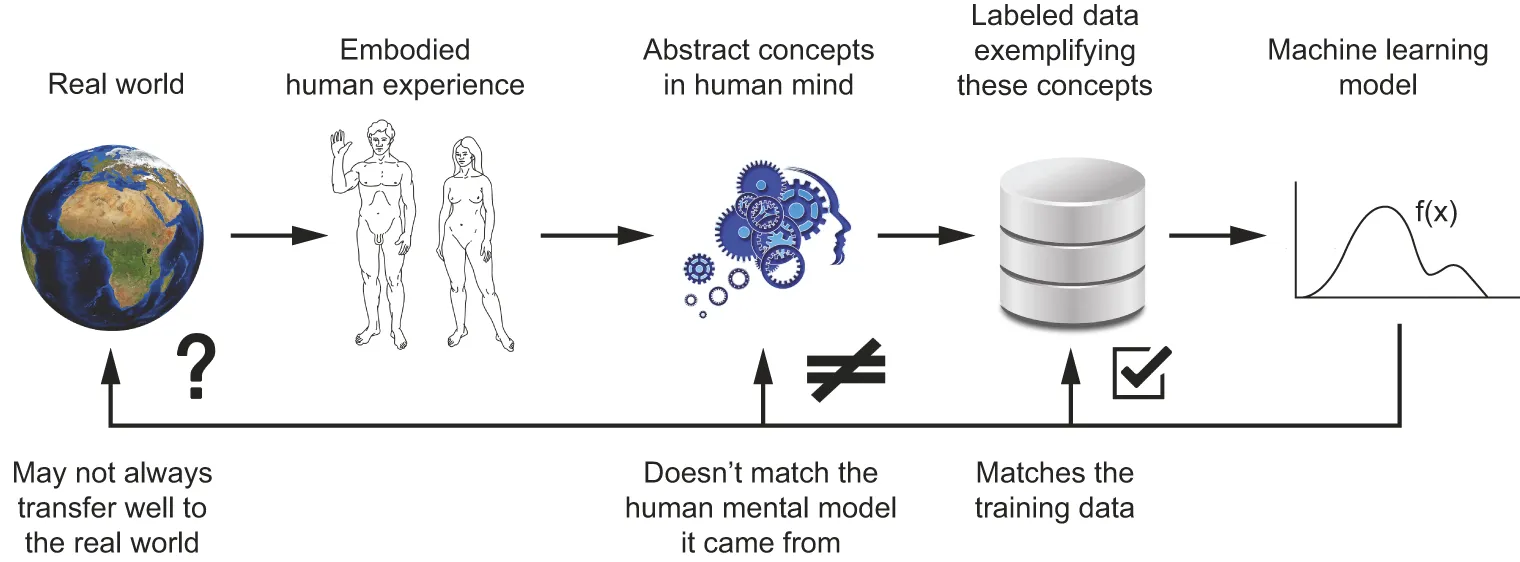
شکل ۱۹.۴: مدلهای کنونی یادگیری ماشین: منحنیهایی با ابعاد بالا که الگوها را درونیابی میکنند، بدون درک واقعی از جهان زیربنایی.
یک خطر واقعی در هوش مصنوعی معاصر، تفسیر نادرست عملکرد مدلهای یادگیری عمیق و برآورد بیش از حد تواناییهای آنها است—پدیدهای که به عنوان انسانانگاری (anthropomorphism) شناخته میشود. از آنجا که مدلهای زبانی متنهای فصیح و سلیس تولید میکنند، انسانها به طور طبیعی فرض میکنند که این مدلها مانند یک شخص فکر میکنند، قصد دارند، و جهان را درک مینمایند.
به عنوان یک متخصص یادگیری ماشین، همیشه مراقب این دام باشید و هرگز فریب این تصور را نخورید که شبکههای عصبی عمیق واقعاً همانگونه که ما درک میکنیم «میفهمند». آنها تطبیقدهندههای الگوی آماری بسیار قدرتمند هستند، اما هیچ چیزی فراتر از آن نیستند.
مقیاس همهچیز نیست
Section titled “مقیاس همهچیز نیست”آیا میتوانیم صرفاً با افزایش مداوم مقیاس مدلهای خود بر محدودیتهای یادگیری عمیق غلبه کنیم؟ آیا مقیاس تنها چیزی است که به آن نیاز داریم؟ برخی افراد چنین استدلال میکنند: اگر پارامترهای بیشتری اضافه کنیم، دادههای بیشتری جمعآوری کنیم و قدرت محاسباتی بیشتری به کار بگیریم، استدلال و هوش واقعی به عنوان ویژگیهای ظهوریافته (emergent properties) خودبهخود پدیدار خواهند شد.
طرفداران این دیدگاه به «قوانین مقیاسبندی» (scaling laws) به عنوان مدرک اشاره میکنند. قوانین مقیاسبندی یک رابطهٔ تجربی بین اندازهٔ مدل، اندازهٔ مجموعهداده، بودجهٔ محاسباتی و عملکرد مدل هستند. آنها نشان میدهند که با افزایش این مقادیر، عملکرد به شیوهای قابل پیشبینی با یک قانون توانی بهبود مییابد. بنابراین، استدلال چنین پیش میرود که فقط باید به افزایش مقیاس ادامه دهیم تا به هوش عمومی مصنوعی (AGI) برسیم!
واقعیت این است که افزایش مقیاس مدلها به هیچ پیشرفتی در مورد مسائلی که در بخشهای قبلی برشمردم منجر نشده است: مدلها همچنان در تعمیم به موقعیتهای واقعاً بدیع شکست میخورند، به نحوهٔ بیان به شدت حساس هستند، و نمیتوانند الگوریتمهای دقیق را یاد بگیرند. در واقع دو دلیل اساسی برای این امر وجود دارد:
- مدلهای یادگیری عمیق به استفاده از برنامههای درونیابیشدهای محدود هستند که در زمان آموزش به خاطر سپردهاند. آنها به تنهایی قادر نیستند برنامههای جدید را از ابتدا برای سازگاری با موقعیتهای بدیع سنتز کنند.
- قوانین مقیاسبندی از ابتدا هرگز دربارهٔ هوش نبودهاند—آنها دربارهٔ فشردهسازی هستند. آنها به ما میگویند که با بزرگتر کردن یک پایگاه داده و تغذیهٔ دادههای بیشتر به آن، قابلیتهای بازیابی آن بهبود مییابد. آنها به ما نمیگویند که یک پایگاه داده ناگهان قادر به تفکر اصیل و مستقل خواهد شد.
افزایش مقیاس تکنیکهای کنونی یادگیری عمیق با افزودن لایههای بیشتر و دادههای آموزشی بیشتر این مشکلات را حل نخواهد کرد، زیرا این محدودیتها در خود معماری زیربنایی و روش بهینهسازی ریشه دارند، نه در مقیاس آن.
بیایید نگاه دقیقتری به آنچه هوش بیولوژیکی را از رویکرد یادگیری عمیق متمایز میکند بیندازیم.
خودکارهها در برابر عاملهای هوشمند
Section titled “خودکارهها در برابر عاملهای هوشمند”تفاوتهای بنیادینی بین تغییر شکل هندسی سرراست از ورودی به خروجی که یادگیری عمیق انجام میدهد، و روشی که انسانها فکر میکنند و رفتار مینمایند وجود دارد.
بیایید کمی به عقب بازگردیم و بپرسیم: هدف هوش چیست؟ اصلاً چرا هوش به وجود آمد؟ در تاریخ تکامل، مغزها پدید آمدند زیرا موجودات زنده نیاز داشتند در محیطهای پویا حرکت کنند، غذا پیدا کنند و از خطرات بگریزند.
تکامل مانند یک برنامهنویس بود، و مغزها رایانههایی بودند که کدهای دادهشده توسط تکامل را به دقت اجرا میکردند. از آنجا که تکامل روندی بسیار کند داشت، کدی که به موجودات اولیه داده شد بسیار ایستا و سفتوسخت بود.
توجه داشته باشید که این مغزهای اولیه واقعاً به خودی خود هوشمند نبودند. آنها در واقع خودکارهها (automatons) بودند: سیستمهای کاملاً واکنشی که در پاسخ به محرکهای خاص، رفتارهای از پیش برنامهریزیشدهای را اجرا میکردند (شکل ۱۹.۵ را ببینید).
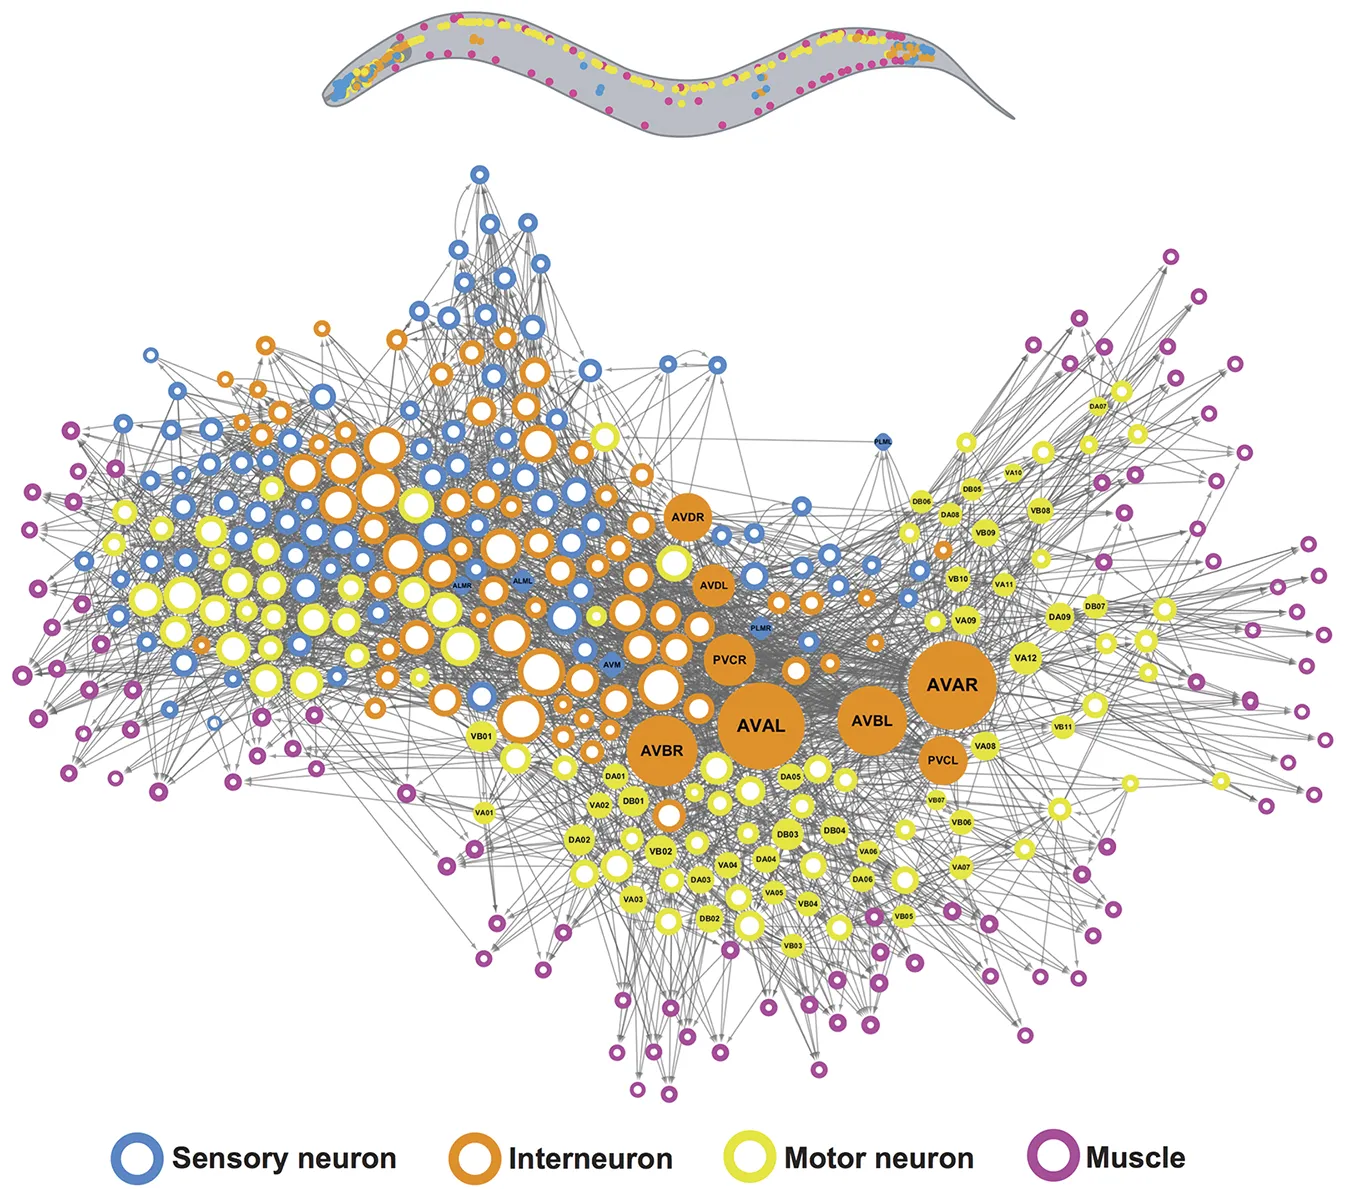
شکل ۱۹.۵: شبکهٔ عصبی کرم C. elegans، یک خودکارهٔ بیولوژیکی با ۳۰۲ نورون.
حوزهٔ هوش مصنوعی برای مدتهای طولانی از خلط دو مفهوم هوش (intelligence) و خودکارسازی (automation) رنج برده است2. یک ساعت مکانیکی پیچیده یا کرم C. elegans خودکار هستند، اما هوشمند نیستند. آنها در محیط از پیش تعیینشدهٔ خود عالی کار میکنند، اما در مواجهه با شرایط پیشبینینشده کاملاً درمانده میشوند.
در مقابل، عاملهای هوشمند، مانند ما انسانها، از هوش سیال خود برای یافتن راهی به جلو در شرایط کاملاً ناشناخته استفاده میکنند. انسانها چگونه این کار را انجام میدهند؟
تعمیم محلی در برابر تعمیم فرین
Section titled “تعمیم محلی در برابر تعمیم فرین”انسانها قادر به کارهایی به مراتب فراتر از نگاشت محرکهای آنی به پاسخهای آنی—همانند یک شبکهٔ عمیق یا یک خودکارهٔ بیولوژیکی—هستند. ما توانایی ساخت مدلهای ذهنی از جهان را داریم، میتوانیم پیامدهای اقدامات خود را شبیهسازی کنیم، و میتوانیم دانش خود را به حوزههای کاملاً جدید منتقل نماییم (شکل ۱۹.۶ را ببینید).
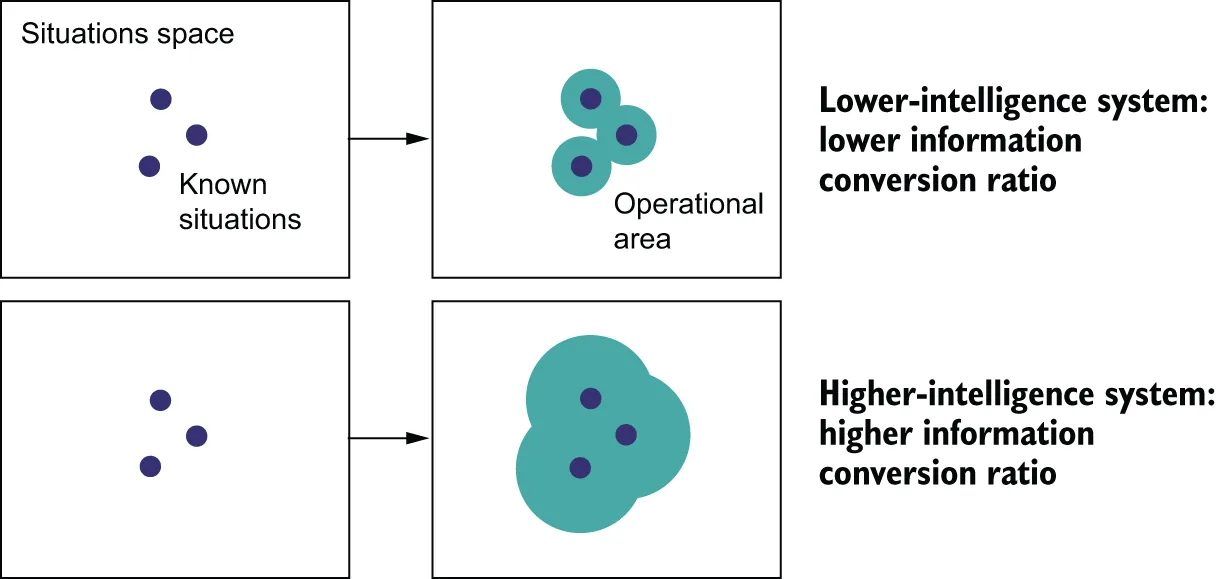
شکل ۱۹.۶: تعمیم محلی در برابر تعمیم فرین. سیستم ۱ (یادگیری عمیق) به صورت محلی درون یک چندگونای آماری از وضعیتهای قبلاً دیده شده درونیابی میکند، در حالی که سیستم ۲ (استدلال و هوش) میتواند با سنتز برنامهها در لحظه، با وضعیتهای کاملاً بدیع سازگار شود.
این توانایی استفاده از انتزاع (abstraction) و استدلال (reasoning) برای مدیریت تجربیاتی که هرگز برای آنها آماده نبودهایم، تعمیم فرین (extreme generalization) نامیده میشود. این ویژگی در تضاد شدید با تعمیم محلی (local generalization) است که شبکههای عصبی عمیق انجام میدهند، جایی که مدل تنها میتواند در اطراف همسایگی نزدیک نمونههای آموزشی خود درونیابی کند.
این امر در تضاد آشکار با کاری است که سیستمهای شبیه به خودکاره انجام میدهند. یک خودکارهٔ بسیار سفتوسخت هیچ توانایی سازگاری نخواهد داشت: اگر باد متفاوتی بوزد یا مانعی جدید ظاهر شود، به سادگی به مانع برخورد میکند.
برای مثال، مسئلهٔ یادگیری پارامترهای پرتاب مناسب برای فرود آوردن یک موشک روی ماه را در نظر بگیرید. یک سیستم یادگیری عمیق نیازمند میلیاردها پرتاب شبیهسازیشده در سناریوهای مختلف است تا بتواند یک نگاشت آماری محلی یاد بگیرد. در مقابل، دانشمندان ناسا توانستند با استفاده از معادلات فیزیک نیوتن و استدلال انتزاعی، موشک آپولو ۱۱ را در اولین تلاش واقعی با موفقیت روی ماه بنشانند بدون اینکه قبلاً آن را به صورت فیزیکی آزمایش کرده باشند!
هدف هوش
Section titled “هدف هوش”این تمایز بین عاملهای هوشمند با سازگاری بالا و خودکارههای صلب ما را به تکامل مغز بازمیگرداند3.
مغزها مسئول تولید رفتار هستند. اگر مجموعهای از شرایطی که یک ارگانیسم با آن روبرو میشد عمدتاً ایستا و تکراری بود، خودکارسازی صلب بهترین راهبرد به شمار میرفت: کممصرف، سریع، و بدون نیاز به تفکر. اما محیطهای دنیای واقعی پر از تغییرات پیشبینینشده، شکارچیان جدید و فرصتهای غیرمنتظره هستند.
مغز، به عنوان یک موتور تولید رفتار کارآمد، خود را برای برآورده کردن این نیاز تطبیق داد. این موتور برای سازگاری (adaptability) بهینهسازی شد: توانایی درک شرایط جدید و سنتز رفتارهای جدید در لحظه.
این ماهیت واقعی هوش است: توانایی استفادهٔ کارآمد از اطلاعات موجود برای سازگاری با موقعیتهای ناشناخته و حل مسائل بدیع با حداقل میزان تجربهٔ قبلی.
پیمودن طیف تعمیم
Section titled “پیمودن طیف تعمیم”به عنوان یک طرح کلی، میتوانید تاریخ تکاملی هوش بیولوژیکی را به عنوان یک صعود آهسته در امتداد یک طیف از تعمیم خلاصه کنید: از خودکارههای صلب با تعمیم صفر، به سمت یادگیری عادتی با تعمیم محلی، و در نهایت به سمت هوش سیال و تعمیم فرین در انسانها.
پیشرفت هوش مصنوعی در طول ۷۰ سال گذشته شباهتهای شگفتانگیزی با این مسیر تکاملی دارد. سیستمهای اولیهٔ هوش مصنوعی (سیستمهای مبتنی بر نماد و قواعد کارشناسی) خودکارههای صلبی بودند که توسط مهندسان برنامهریزی میشدند. یادگیری ماشین و یادگیری عمیق نشاندهندهٔ گذار به سمت سیستمهایی بودند که میتوانند الگوها را از دادهها یاد بگیرند—یعنی تعمیم محلی.
امروزه، ما ممکن است در آستانهٔ گام تکاملی بعدی قرار داشته باشیم. ما در حال حرکت به سمت سیستمهایی هستیم که به تعمیم گسترده (broad generalization) دست مییابند، اما هنوز به تعمیم فرین واقعی دست نیافتهایم.
با این حال، پارادایم یادگیری عمیق به خودکارسازی شناختی محدود مانده است: برچسب «هوش» در هوش مصنوعی مدرن تا حد زیادی یک نام نادرست است، زیرا این سیستمها صرفاً مهارتهای تثبیتشده را خودکار میکنند، نه اینکه هوش سیال جدیدی تولید نمایند.
البته، منظور من کمارزش جلوه دادن دستاوردهای یادگیری عمیق نیست. خودکارسازی شناختی فوقالعاده مفید و انقلابی است و بخش بزرگی از کارهای روزمرهٔ ما را متحول خواهد کرد. اما نباید خودکارسازی را با هوش عمومی اشتباه گرفت.
چگونه هوش بسازیم
Section titled “چگونه هوش بسازیم”تا به اینجا، آموختهاید که هوش فراتر از درونیابی روی چندگونای نهان است که توسط مدلهای یادگیری عمیق انجام میشود. برای ساخت سیستمهای هوش مصنوعی واقعاً مستقل و سازگار، باید درک کنیم که هوش اساساً چگونه کار میکند و چگونه میتوانیم مدلهایی بسازیم که فراتر از برازش منحنی عمل کنند.
هوش عبارت است از توانایی استفاده از تجربیات گذشته (و دانش پیشین ذاتی) برای مواجهه با موقعیتهای بدیع و غیرمنتظره، و یادگیری سریع مهارتهای جدید با حداقل اطلاعات.
هوش به این دلیل کار میکند که هیچ چیز در جهان واقعاً و به طور کامل بدون سابقه و بیارتباط با گذشته نیست. هنگامی که با چیزی کاملاً جدید روبرو میشویم، میتوانیم شباهتها و قیاسهایی بین موقعیت جدید و تجربیات گذشتهٔ خود ترسیم کنیم. ما مفاهیم انتزاعی را که در یک حوزه یاد گرفتهایم استخراج کرده و آنها را به حوزهای کاملاً متفاوت تعمیم میدهیم.
علاوه بر چنین قیاسهای صریح و آشکاری، ما به طور مداوم در حال انجام قیاسهای کوچکتر و ضمنی هستیم—در هر ثانیهای که بیداریم. وقتی یک دستگیرهٔ در را میبینید که قبلاً هرگز ندیدهاید، بدون تردید میدانید که چگونه آن را بچرخانید، زیرا ساختار کارکردی آن مشابه تمام دستگیرههایی است که قبلاً تجربه کردهاید.
این قیاسها صرفاً در ذهن ما نیستند؛ خود واقعیت فیزیکی پر از همریختیها (isomorphisms) است. معادلات الکترومغناطیس شباهتهای شگفتانگیزی با جریان سیالات دارند؛ رشد شاخههای درخت از الگوهای ریاضی مشابه با رعدوبرق یا رگهای خونی پیروی میکند. جهان بر اساس اصول ساختاری محدودی ساخته شده است که در مقیاسها و اشکال بیشمار تکرار میشوند.
فرضیهٔ کالیدوسکوپ
Section titled “فرضیهٔ کالیدوسکوپ”من این را فرضیهٔ کالیدوسکوپ (kaleidoscope hypothesis) مینامم: تجربهٔ ما از جهان دارای پیچیدگی بیپایانی به نظر میرسد، اما این پیچیدگی تنها حاصل ترکیب مجدد مداوم مجموعهٔ کوچکی از بلوکهای سازندهٔ بنیادین است، درست مانند یک کالیدوسکوپ (زیبابین) که با بازتاب دادن چند مهرهٔ رنگی ساده در آینهها، طرحهای پیچیده و بیپایانی تولید میکند (شکل ۱۹.۷ را ببینید).
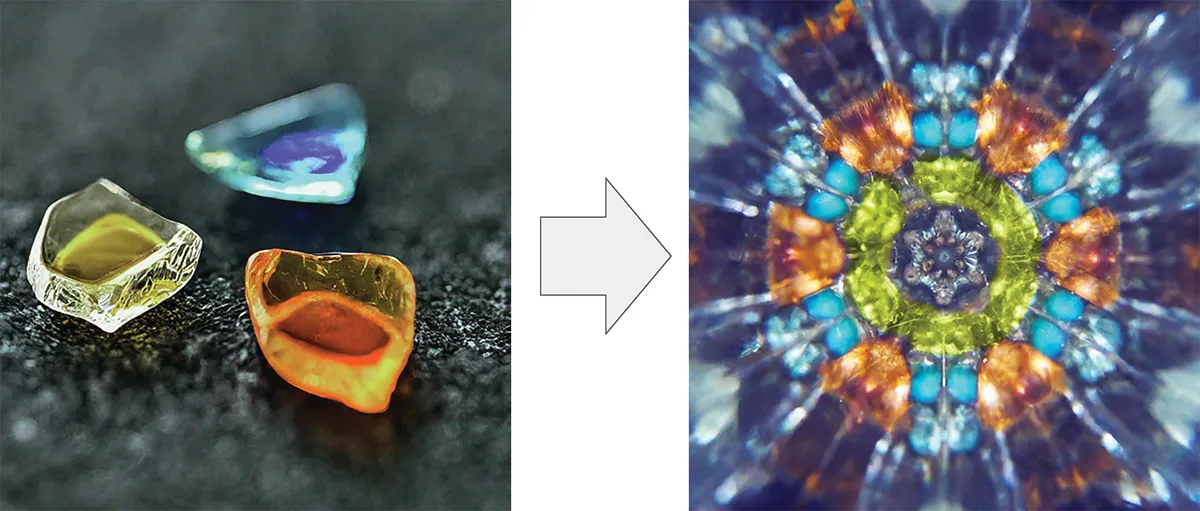
شکل ۱۹.۷: یک کالیدوسکوپ الگوهای غنی (اما تکرارشوندهای) را از طریق بازتاب دادن مجموعهای کوچک از مهرههای رنگی ثابت تولید میکند. هوش مصنوعی مولد نیز به طور مشابه عمل میکند: الگوهای ثابتی را که در دادههای آموزشیاش وجود دارند منعکس و درونیابی مینماید.
هوش توانایی کاوش در تجربیات شما برای شناسایی این «اتمهای معنا» است که ظاهراً میتوان آنها را مجدداً برای درک هر چیز جدیدی ترکیب کرد.
جوهر هوش: اکتساب انتزاع و ترکیب مجدد
Section titled “جوهر هوش: اکتساب انتزاع و ترکیب مجدد”این فرایند شامل دو بخش کلیدی است:
- اکتساب انتزاع (Abstraction acquisition) — استخراج کارآمد مفاهیم انتزاعی فشرده و با قابلیت استفادهٔ مجدد از جریانی از تجربیات یا دادهها. این شامل شناسایی ساختارهای زیربنایی، اصول، یا برنامههای نهفته در مشاهدات است.
- ترکیب مجدد انتزاعها (Abstraction recombination) — کنار هم قرار دادن انعطافپذیر این مفاهیم انتزاعی برای درک موقعیتهای جدید یا حل مسائل بدیع. این نیازمند توانایی استدلال، شبیهسازی، و آزمایش ترکیبهای جدید در لحظه است.
تأکید بر کارایی (efficiency) بسیار حیاتی است. میزان هوشمندی شما بر اساس این سنجیده میشود که چقدر کارآمد میتوانید دادهها و اطلاعات را به مهارتهای جدید تبدیل کنید (شکل ۱۹.۸ را ببینید). یک سیستم با تعمیم ضعیف ممکن است با دیدن یک میلیارد مثال یاد بگیرد یک وظیفه را به خوبی انجام دهد، اما یک عامل واقعاً هوشمند همان مهارت را تنها با دیدن دو یا سه مثال کسب میکند!
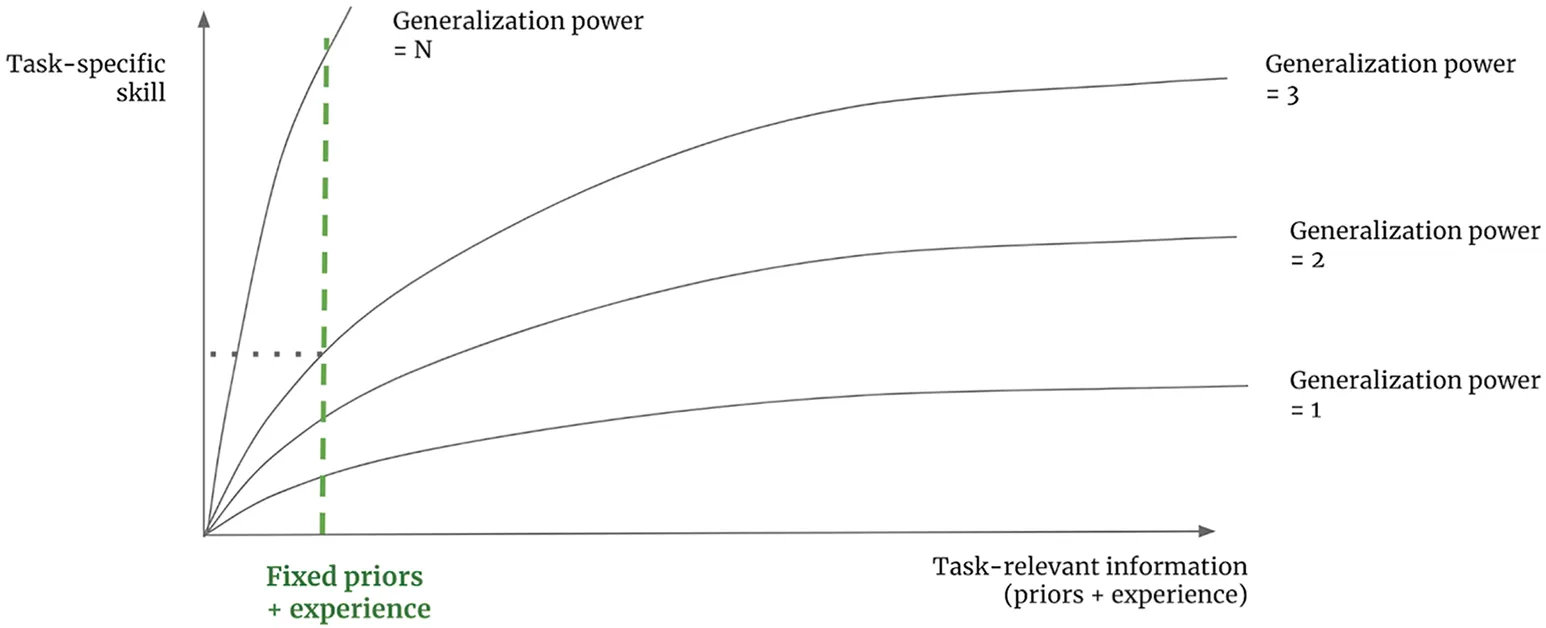
شکل ۱۹.۸: یک سیستم با تعمیم پایین میتواند با دریافت اطلاعات کافی (دادههای آموزشی) به سطح بالایی از مهارت در یک وظیفه دست یابد، در حالی که یک سیستم با تعمیم بالا (عامل هوشمند) با اطلاعات بسیار اندک به مهارت بالا میرسد.
و این سرچشمهٔ دو مشکل اصلی در پارادایم کلاسیک یادگیری عمیق است:
- این مدلها کاملاً فاقد قابلیت ترکیب مجدد در لحظه هستند. آنها کار مناسبی را در اکتساب انتزاعها در زمان آموزش از طریق نزول گرادیان انجام میدهند، اما بنا به طراحی خود، هیچ توانایی برای ترکیب مجدد این انتزاعها در زمان آزمون ندارند تا با یک وظیفهٔ ناشناخته سازگار شوند.
- آنها از نظر کارایی دادهها به شدت ناکارآمد هستند: یک مدل زبانی نیازمند خواندن تریلیونها توکن (معادل صدها طول عمر انسانی) است تا مهارتهایی را یاد بگیرد که یک کودک پنجساله با چند ساعت تجربه فرا میگیرد.
بنابراین چگونه میتوانیم فراتر از این محدودیتها گام برداریم؟
اهمیت تعیین هدف درست
Section titled “اهمیت تعیین هدف درست”هوش بیولوژیکی پاسخی به سؤالی بود که طبیعت مطرح کرد. به همین ترتیب، اگر ما میخواهیم هوش مصنوعی واقعی توسعه دهیم، ابتدا باید وظایف و اهداف درستی را به عنوان سنگ محک پیشرفت تعیین کنیم.
اثری که به طور مداوم در طراحی سیستمها مشاهده میکنید قاعدهٔ میانبر (shortcut rule) است: اگر روی بهینهسازی یک معیار منفرد یا یک وظیفهٔ خاص تمرکز کنید، سیستم شما راهی پیدا خواهد کرد تا آن وظیفه را بدون یادگیری توانایی عمومی مورد نظر شما حل کند. سیستم میانبر میزند!
این موضوع را اغلب در مسابقات یادگیری ماشین میبینید. در سال ۲۰۰۹، نتفلیکس چالشی با جایزهٔ ۱ میلیون دلاری برگزار کرد تا سیستم توصیهگر آنها بهینهسازی شود. تیم برنده انسمبل بسیار پیچیدهای از صدها مدل ساخت که روی دادههای ثابت رقابت عالی عمل میکرد، اما به قدری پیچیده و غیرعملی بود که نتفلیکس هرگز نتوانست آن را در محیط عملیاتی خود مستقر کند!
قاعدهٔ میانبر در طول چند دههٔ گذشته در سراسر هوش مصنوعی حضور داشته است. در دههٔ ۱۹۷۰، آلن تورینگ و دیگر پیشگامان پیشنهاد کردند که اگر یک رایانه بتواند در بازی شطرنج بر انسان غلبه کند، به هوش عمومی دست یافته است.
بیش از دو دهه بعد، این رؤیا به حقیقت پیوست: در سال ۱۹۹۷، ابررایانهٔ Deep Blue از شرکت IBM گری کاسپاروف، بهترین شطرنجباز تاریخ را شکست داد. اما Deep Blue کاملاً فاقد هوش عمومی بود: این سیستم فقط یک موتور جستجوی درختی عظیم و موازی با ارزیابی موقعیت سختافزاری بود. این ماشین حتی نمیتوانست بازی دوز (تیکتاکتو) انجام دهد!
تا به امروز، معیار اصلی موفقیت در حوزهٔ هوش مصنوعی، حل وظایف خاص بوده است، از شطرنج و بازی Go گرفته تا تشخیص گفتار، ترجمهٔ ماشینی، و بنچمارکهای سؤال و جواب. اما حل یک وظیفهٔ خاص هوش عمومی ایجاد نمیکند؛ تنها به خودکارسازی آن وظیفه منجر میشود.
اگر این سخن تعجبآور به نظر میرسد، به یاد داشته باشید که هوش انسانی با مهارت در یک زمینهٔ خاص تعریف نمیشود؛ بلکه با توانایی کسب مهارتهای جدید در زمینههای ناشناخته مشخص میگردد.
به طور خلاصه، با ثابت نگه داشتن وظیفه، شما نیاز به مدیریت عدم قطعیت و نوآوری را حذف میکنید، و از آنجا که ماهیت هوش دقیقاً مواجهه با نوآوری است، شما عملاً نیاز به هوش را از معادله حذف کردهاید!
یک هدف جدید: سازگاری در لحظه
Section titled “یک هدف جدید: سازگاری در لحظه”برای اینکه هوش مصنوعی را واقعاً هوشمند کنیم و توانایی مقابله با تنوع شگفتانگیز و ماهیت همواره در حال تغییر جهان را به آن ببخشیم، باید هوش مصنوعی را نه بر اساس مهارتی که از قبل دارد، بلکه بر اساس توانایی آن در سازگاری در لحظه (on-the-fly adaptation) ارزیابی کنیم4.
از دیدگاه من، هوش را میتوان دقیقاً به عنوان یک نسبت کارایی (efficiency ratio) کمیسازی کرد: نسبت تبدیل بین تجربیات گذشته از یک سو، و توانایی انطباق با وظایف و مسائل جدید با حداقل دادههای جدید از سوی دیگر.
در سالهای ۲۰۱۸ و ۲۰۱۹، من یک مجموعهدادهٔ بنچمارک به نام Abstraction and Reasoning Corpus یا ARC-AGI توسعه دادم (شکل ۱۹.۹ را ببینید). این بنچمارک به طور خاص برای سنجش توانایی یک سیستم هوش مصنوعی در درک مسائل کاملاً جدید و استنباط قوانین حاکم بر آنها تنها با مشاهدهٔ دو یا سه مثال طراحی شده است.
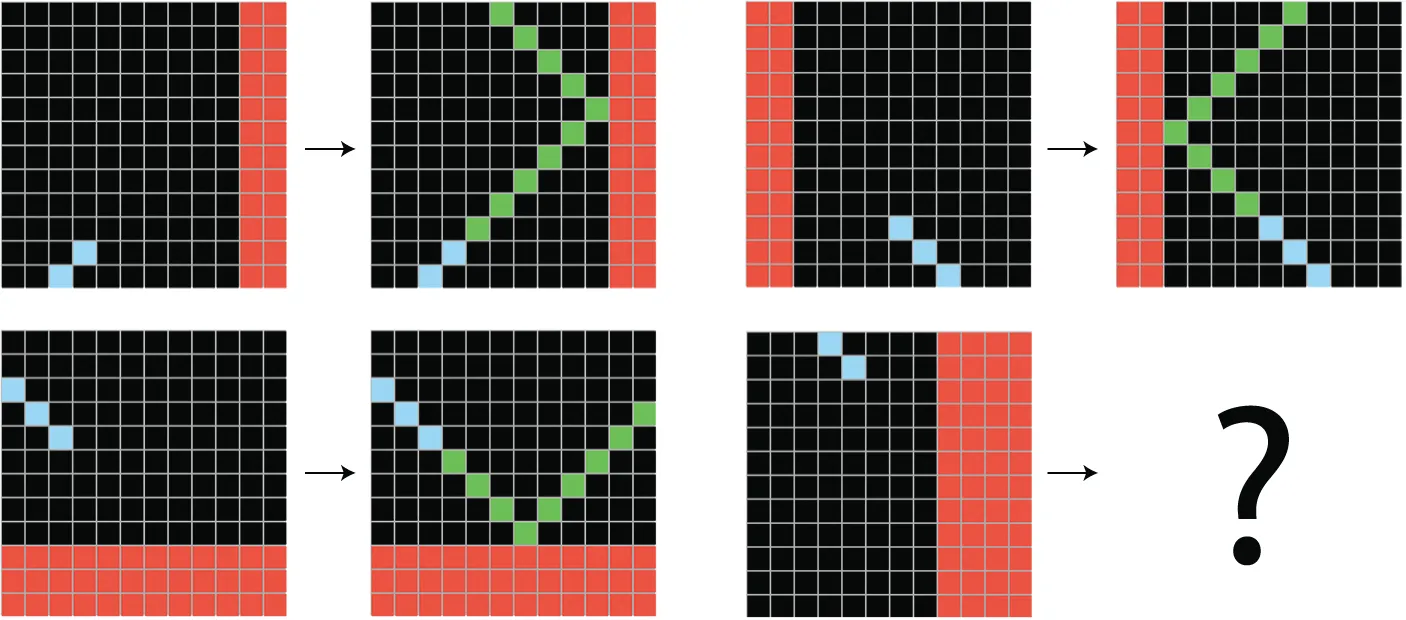
شکل ۱۹.۹: یک تسک ARC-AGI: ماهیت تبدیل باید صرفاً از روی چند مثال ورودی-خروجی استنباط شود.
در مقایسه با آزمونهای ضریب هوشی (IQ)، دو ویژگی دربارهٔ ARC-AGI منحصربهفرد است. اول، ARC به دنبال سنجش قدرت تعمیم از طریق مواجهه با مسائلی است که عمداً به گونهای ساخته شدهاند که شبیه هیچ دادهٔ آموزشی از پیش موجودی نباشند. شما نمیتوانید یک تسک ARC را صرفاً با جستجو در حافظه حل کنید.
علاوه بر این، ARC-AGI تلاش میکند دانش پیشین (prior knowledge) را که به آزمون میآورید کنترل کند. این آزمون به هیچ زبان انسانی، دانش تاریخی یا مفاهیم فرهنگی متکی نیست؛ بلکه تنها از مفاهیم هستهای شهودی استفاده میکند که هر کودک انسان به طور طبیعی از بدو تولد یا در ماههای اول زندگی درک میکند: اشیاء، خطوط تقارن، شمارش ساده، داخل و خارج بودن، و پیوستگی مکانی.
جایزهٔ ARC
Section titled “جایزهٔ ARC”در سال ۲۰۲۴، برای سرعت بخشیدن به پیشرفت به سمت سیستمهای هوش مصنوعی با قابلیت انتزاع سیال و استدلال، بنیاد غیرانتفاعی ARC Prize رقابتی را با جوایز نقدی بیش از ۱ میلیون دلار راهاندازی کرد تا توجه جامعهٔ پژوهشی را به این چالش جلب نماید.
بنچمارک ARC-AGI به طور شگفتآوری در برابر پارادایم افزایش مقیاس یادگیری عمیق مقاومت نشان داده است. بیشتر مدلهای زبانی پیشرو، با وجود آموزش روی تقریباً تمام دادههای متنی اینترنت و میلیاردها دلار سرمایهگذاری، امتیازات بسیار پایینی (زیر ۱۰٪ یا ۲۰٪) در نسخهٔ ارزیابی پنهان ARC-AGI کسب کردند.
اگر سیستم خود را ۵۰,۰۰۰ برابر بزرگتر کنید و هنوز پیشرفت معناداری نداشته باشید، این یک هشدار بزرگ است که مسیر کنونی به مقصد مورد نظر منتهی نمیشود!
عصر سازگاری در زمان آزمون
Section titled “عصر سازگاری در زمان آزمون”در سال ۲۰۲۴، همهچیز تغییر کرد. آن سال شاهد یک چرخش بزرگ در گفتمان هوش مصنوعی بود—چرخشی که تا حدی با جایزهٔ ARC سرعت گرفت: آگاهی از اینکه آموزش ایستا کافی نیست و ما به سازگاری در زمان آزمون (Test-Time Adaptation یا TTA) نیاز داریم.
اصطلاح TTA به روشهایی اشاره دارد که در آنها سیستم هوش مصنوعی در حین مواجهه با خود آزمون، با استفاده از بازخورد و مثالهای موجود، به استدلال فعال یا یادگیری پویا میپردازد، نه اینکه صرفاً خروجی مدل ایستای خود را در یک گذر برگشتناپذیر بیرون دهد.
چندین روش برای پیادهسازی سازگاری در زمان آزمون وجود دارد:
- آموزش در زمان آزمون (Test-time training) — مدل برخی از پارامترهای خود را بر اساس مثالهای ارائهشده در تسک آزمون، با استفاده از نزول گرادیان تنظیم میکند.
- روشهای جستجو (Search methods) — سیستم از میان فضایی از راهحلهای ممکن، برنامهها، یا زنجیرههای استدلال به جستجو میپردازد و کاندیداها را در برابر محدودیتهای مسئله ارزیابی میکند.
- سنتز برنامه (Program synthesis) — سیستم به تولید صریح برنامههای کامپیوتری نمادینی میپردازد که تبدیل مشاهدهشده را پیادهسازی میکنند، و سپس آن برنامه را برای حل مسئله اجرا مینماید.
این رویکردهای TTA به سیستمهای هوش مصنوعی اجازه میدهند انعطافپذیرتر باشند و شرایط بدیع را بسیار بهتر از مدلهای ایستا مدیریت کنند. هر رویکرد پیشرو در رقابت ARC Prize 2024 از ترکیبی از این روشها استفاده کرد.
مدت کوتاهی پس از پایان مسابقه، در اواخر دسامبر ۲۰۲۴، شرکت OpenAI از مدل استدلال زمان آزمون خود به نام o3 رونمایی کرد که توانست به امتیاز چشمگیر ۷۵.۷٪ روی ARC-AGI-1 دست یابد (در حالی که با هزینهٔ محاسباتی بیشتر به ۸۷.۵٪ نیز رسید).
آیا این بدان معناست که AGI حل شد؟ آیا o3 به اندازهٔ یک انسان هوشمند بود؟
نه کاملاً. اولاً، در حالی که عملکرد o3 یک دستاورد تاریخی بود، با هزینهای سرسامآور به دست آمد—دهها هزار دلار محاسبات GPU برای حل یک آزمون، در حالی که یک انسان با مغزی ۲۰ واتی در ۲۰ دقیقه آن را حل میکند!
ثانیاً، ما متوجه شدیم که o3 هنوز توسط بسیاری از تسکهایی که انسانها آنها را بسیار ساده میدانستند به راحتی گمراه میشد (مانند تسک نشان داده شده در شکل ۱۹.۱۰).
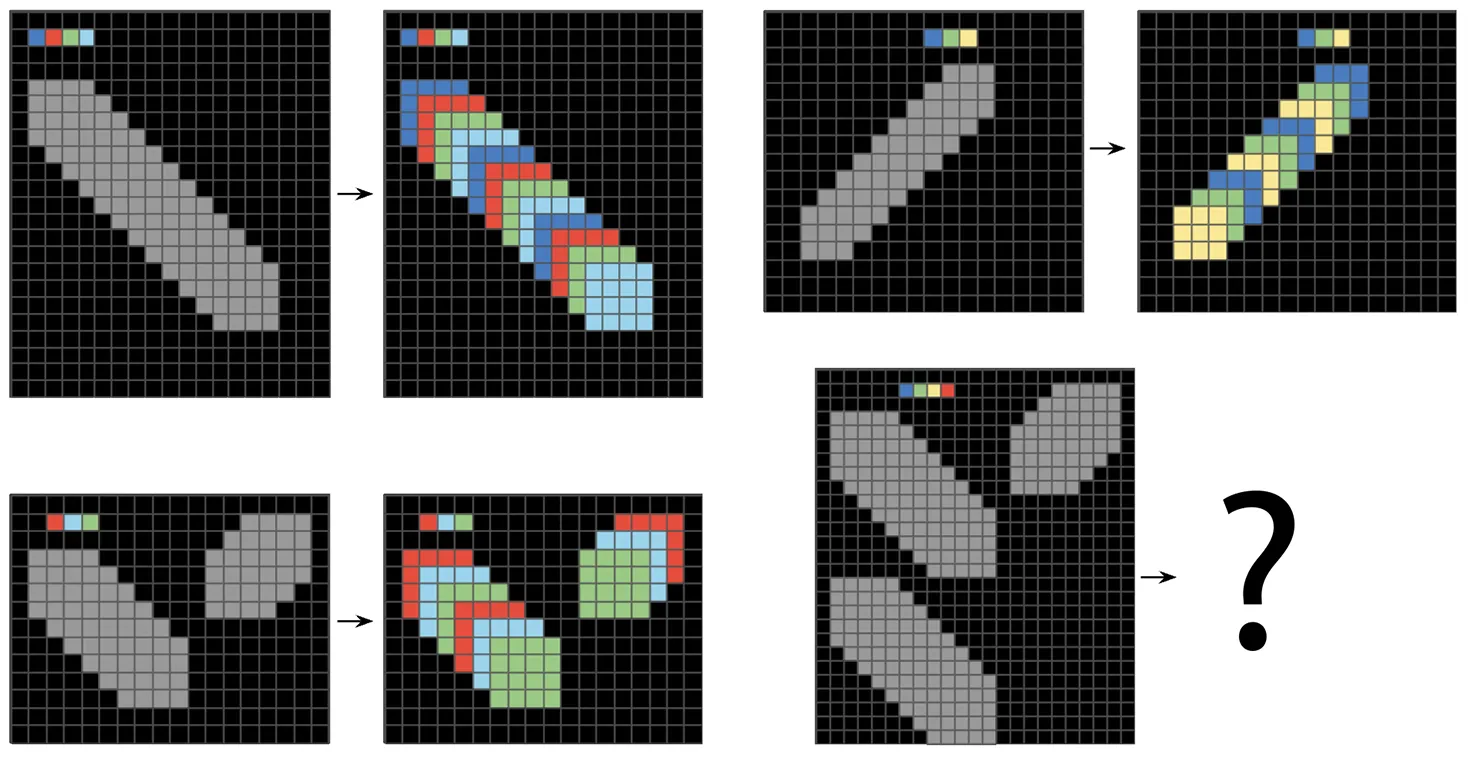
شکل ۱۹.۱۰: نمونهای از تسکی که توسط مدل o3 حل نشد، علیرغم اینکه برای یک کودک دبستانی به سادگی قابل حل است.
آزمون ARC-AGI 2
Section titled “آزمون ARC-AGI 2”و بدین ترتیب، در مارس ۲۰۲۵، بنیاد ARC Prize آزمون ARC-AGI-2 را معرفی کرد. این نسخه دقیقاً همان قالب نسخهٔ اول را حفظ کرد، اما تسکهایی را معرفی نمود که نیازمند استدلال ترکیبی عمیقتر و خلاقیت ساختاری بیشتری بودند، تا اطمینان حاصل شود که سیستمها واقعاً تعمیم فرین را نشان میدهند نه تطبیق الگوهای سطحی (شکل ۱۹.۱۱ را ببینید).
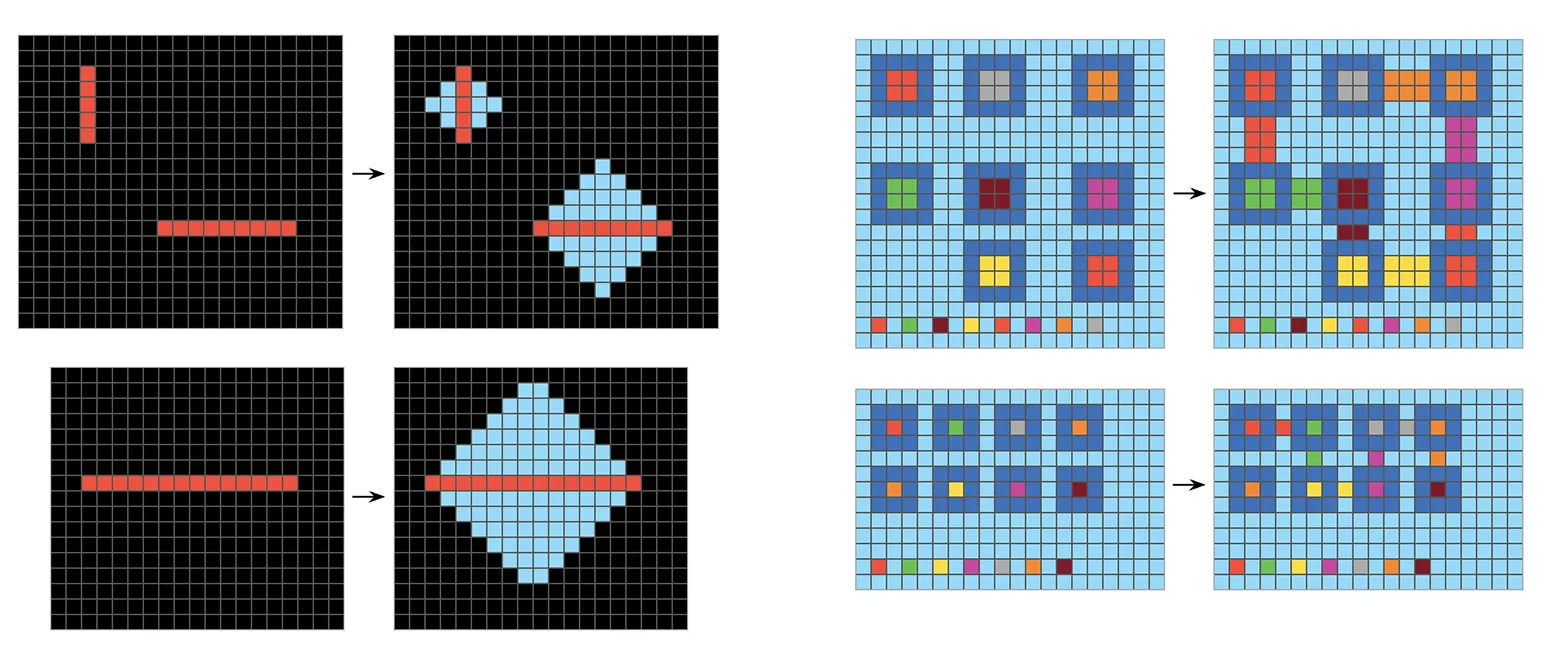
شکل ۱۹.۱۱: تسک معمولی ARC-AGI-1 (چپ) در برابر تسک ARC-AGI-2 (راست)، که نیازمند استدلال چندمرحلهای غنیتر و سازگاری ساختاری عمیقتر است.
نتایج اولیهٔ آزمایشهای هوش مصنوعی روی ARC-AGI 2 هشیارکننده بود: حتی پیشرفتهترین سیستمها مانند o3 با این مجموعهٔ جدید به شدت دستوپنجه نرم کردند و امتیازات بسیار پایینتری به دست آوردند. این نشان میدهد که مسیر رسیدن به هوش عمومی هنوز در آغاز راه است و ما به پیشرفتهای مفهومی عمیقتری نیاز داریم.
اجزای مفقوده: جستجو و نمادها
Section titled “اجزای مفقوده: جستجو و نمادها”برای حل کامل ARC-AGI، به ویژه نسخهٔ ۲، به چه چیزهایی نیاز است؟ امیدوارم این چالش شما را به این فکر وا دارد که واقعاً برای حرکت از تطبیق الگوهای آماری صرف به سمت هوش عمومی واقعی به چه چیزی نیاز داریم.
پیشتر گفتم که هوش از دو بخش تشکیل شده است: اکتساب انتزاع و ترکیب مجدد انتزاعها. یادگیری عمیق در حال حاضر تنها بخشی از نیمهٔ اول این معادله را انجام میدهد. برای تکمیل این پازل، باید بفهمیم که انتزاعها واقعاً از چه چیزی ساخته شدهاند.
دو قطب انتزاع
Section titled “دو قطب انتزاع”اکتساب انتزاع با مقایسهٔ چیزها با یکدیگر آغاز میشود. نکتهٔ بسیار مهم این است که دو شیوهٔ کاملاً متمایز وجود دارد که ذهن میتواند چیزها را به هم مرتبط سازد: قیاس ارزشمحور (مبتنی بر مقدار) و قیاس برنامهمحور.
قیاس ارزشمحور
Section titled “قیاس ارزشمحور”اولین راه برای مرتبط ساختن چیزها با یکدیگر، مقایسهٔ شباهت (similarity comparison) است که به انتزاع ارزشمحور (value-centric abstraction) منجر میشود (شکل ۱۹.۱۲ را ببینید).
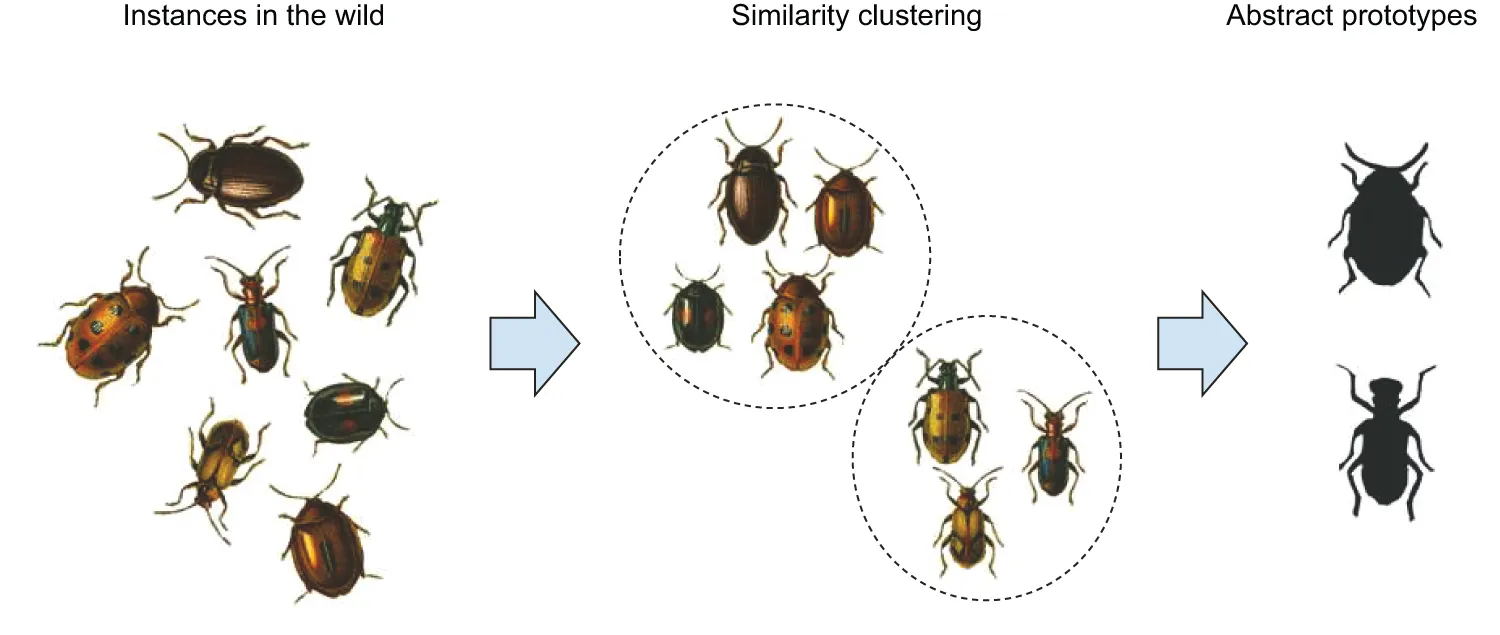
شکل ۱۹.۱۲: قیاس ارزشمحور آیتمها را بر اساس شباهت ویژگیهای پیوسته در یک فضای برداری مشترک به یکدیگر مرتبط میسازد.
فرض کنید با تعدادی سوسک مختلف در حیاط پشتی خود مواجه میشوید که متعلق به چندین گونه هستند. شما متوجه میشوید که برخی از آنها بزرگ و سیاه هستند، در حالی که برخی دیگر کوچک و سبز میباشند. با خوشهبندی این حشرات بر اساس رنگ، اندازه و شکل، مفاهیم نمونهای (prototypes) از هر نوع سوسک در ذهن شما شکل میگیرد. در اینجا، انتزاع از طریق نوعی «میانگینگیری» از نمونهها در یک فضای ویژگی پیوسته حاصل میشود.
آیا این آشنا به نظر میرسد؟ این دقیقاً توصیفی از نحوهٔ عملکرد یادگیری ماشین نظارتنشده (مانند الگوریتم K-means) یا فضاهای نهان شبکههای عصبی عمیق است.
بسیاری از تواناییهای شناختی خود شما نیز بر همین اساس کار میکنند. به عنوان یک انسان، شما به طور مداوم قیاسهای ارزشمحور انجام میدهید: وقتی چهرهٔ یک دوست را از زاویهای جدید تشخیص میدهید، یا سبک نقاشی یک هنرمند را در اثری جدید شناسایی میکنید، مغز شما در حال تطبیق بردارهای ویژگی پیوسته است. این اساس شهود، ادراک بصری و شنوایی است.
قیاس برنامهمحور
Section titled “قیاس برنامهمحور”با این حال، نکتهٔ حیاتی این است که شناخت بسیار فراتر از دستهبندی فوری، تقریبی و شهودی است که انتزاعهای ارزشمحور ارائه میدهند. قطب دیگر انتزاع، انتزاع برنامهمحور (program-centric abstraction) است، که بر اساس تطبیق ساختاری دقیق و روابط عملیاتی کار میکند (شکل ۱۹.۱۳ را ببینید).
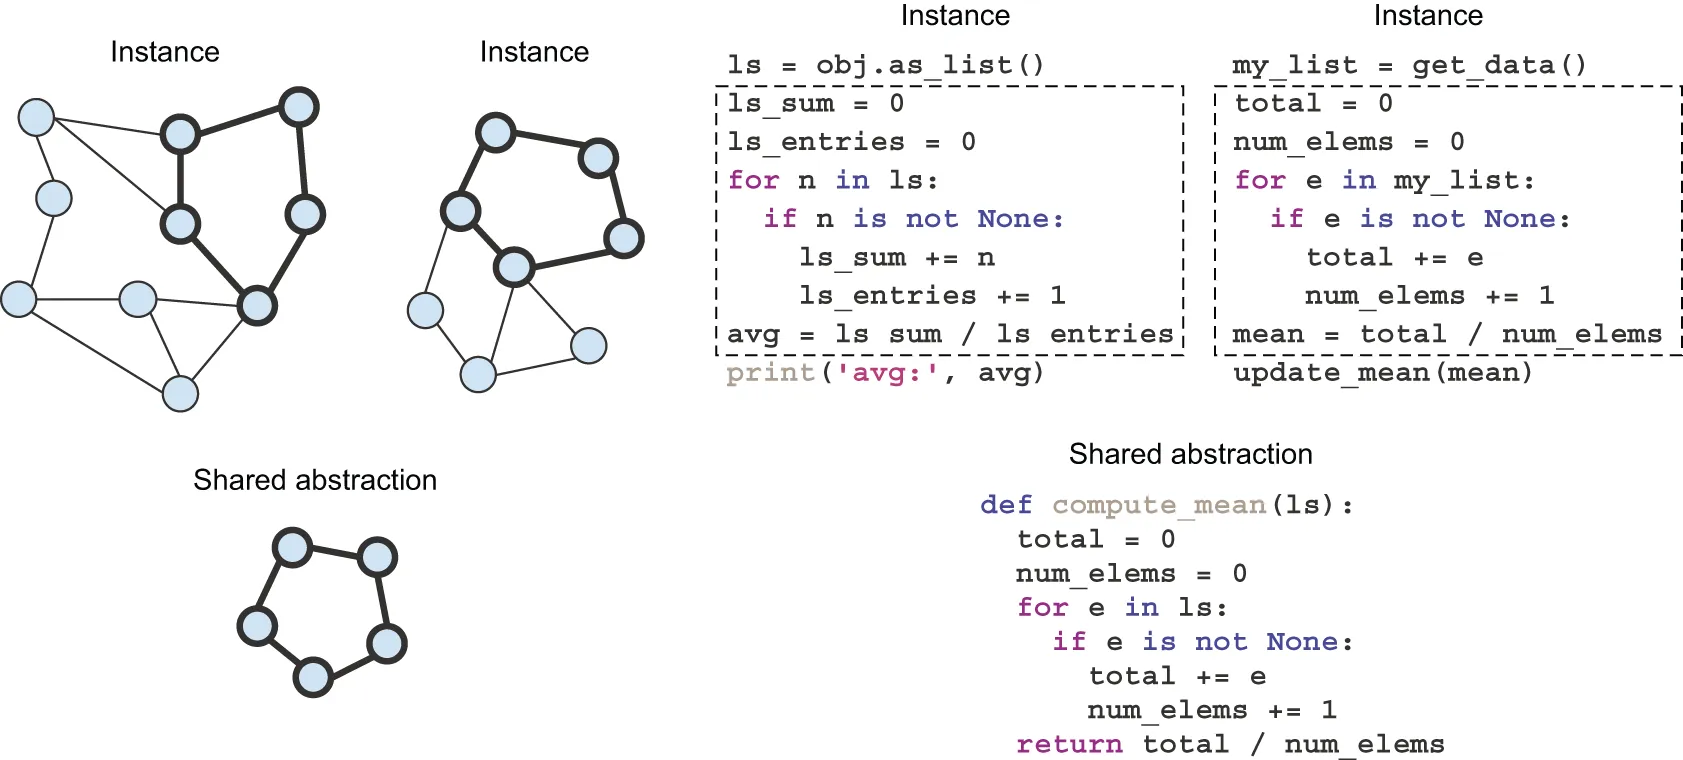
شکل ۱۹.۱۳: قیاس برنامهمحور روابط ساختاری مشترک و قوانین عملیاتی را در سراسر حوزهها شناسایی میکند.
در مهندسی نرمافزار، شما اغلب توابع یا کلاسهای متفاوتی مینویسید که به نظر میرسد اشتراکات زیادی دارند. وقتی متوجه میشوید که این توابع منطق یکسانی را با انواع دادههای مختلف پیادهسازی میکنند، آن منطق مشترک را در یک تابع انتزاعی یا عمومی بازنویسی (refactor) مینمایید. این بازنویسی یک میانگین هندسی نیست؛ بلکه یک همریختی ساختاری دقیق است.
این نوع قیاسسازی از طریق تطبیق دقیق ساختاری درون ساختارهای گسستهٔ مختلف به هیچ وجه منحصر به کدنویسی نیست. این پایه و اساس ریاضیات، فیزیک نظری، شطرنج، بازی با کلمات، و تمام استدلالهای منطقی سختگیرانه است.
جدول ۱۹.۱ این دو قطب انتزاع را در کنار یکدیگر مقایسه میکند.
جدول ۱۹.۱: دو قطب انتزاع
| انتزاع ارزشمحور | انتزاع برنامهمحور |
|---|---|
| چیزها را بر اساس فاصله به هم مرتبط میکند | چیزها را بر اساس تطبیق دقیق ساختاری مرتبط میکند |
| پیوسته، با ریشه در هندسه | گسسته، با ریشه در توپولوژی |
| انتزاعها را از طریق «میانگینگیری» نمونهها به «نمونههای اولیه» تولید میکند | انتزاعها را با جداسازی زیرساختارهای همریخت در میان نمونهها تولید میکند |
| پایه و اساس ادراک و شهود است | پایه و اساس استدلال و برنامهریزی است |
| فوری، فازی، تقریبی | کند، دقیق، سختگیرانه |
| برای تولید نتایج قابل اعتماد به تجربیات زیادی نیاز دارد | از نظر تجربه کارآمد است: میتواند روی دو نمونه عمل کند |
شناخت به عنوان ترکیبی از هر دو نوع انتزاع
Section titled “شناخت به عنوان ترکیبی از هر دو نوع انتزاع”هر کاری که ما انجام میدهیم، و هر آنچه فکر میکنیم، ترکیبی از این دو نوع انتزاع است. شما به سختی میتوانید یک فعالیت ذهنی انسانی را پیدا کنید که فقط یکی از آنها باشد. ادراک حسی ورودیهای خام را به مفاهیم تقریبی ارزشمحور تبدیل میکند، و سپس استدلال برنامهمحور این مفاهیم را برای حل مسائل و برنامهریزی اقدامات ساختار میدهد.
این دو قطب مکمل یکدیگر هستند، و پیوند آنها است که تعمیم فرین را امکانپذیر میسازد. هیچ ذهنی نمیتواند تنها با اتکا به یکی از این دو قطب به هوش واقعی در سطح انسان دست یابد.
چرا یادگیری عمیق پاسخی کامل برای تولید انتزاع نیست
Section titled “چرا یادگیری عمیق پاسخی کامل برای تولید انتزاع نیست”یادگیری عمیق در رمزگذاری انتزاعهای ارزشمحور فوقالعاده عمل میکند، اما اساساً توانایی تولید انتزاعهای برنامهمحور را ندارد. این امر در ماهیت مشتقپذیر و پیوستهٔ آن ریشه دارد: نزول گرادیان نمیتواند روی گرههای گسسته و گرافهای عملیاتی ناپیوسته پرش کند.
اکنون، در اینجا یک هشدار وجود دارد. تا به اینجا، من هر نوع انتزاع را کاملاً جدا از دیگری ارائه دادهام. در تئوری، یک شبکهٔ عصبی به اندازهٔ کافی بزرگ میتواند هر تابعی را تقریب بزند.
با این حال، به وضوح انواع مسائلی وجود دارند که برای یکی از این دو بسیار مناسبتر از دیگری هستند. سعی کنید یک مدل یادگیری عمیق را آموزش دهید تا بدون هیچ برنامهنویسی نمادینی، مرتبسازی حبابی یا تحلیل منطقی گزارهها را با تعمیم کامل یاد بگیرد؛ این کار به شدت شکننده و نیازمند دادههای بیپایان خواهد بود5.
برعکس، مسائل ادراکی برای فرایندهای استدلال گسسته بسیار نامناسب هستند. سعی کنید برنامهای به زبان پایتون خالص با استفاده از شروط if/else بنویسید تا گربهها را در عکسها تشخیص دهد؛ به سرعت شکست خواهید خورد.
به همین دلیل، بعید است که شاهد ظهور رویکردی باشیم که مسائل استدلال را صرفاً با آموزش منحنیهای پیوستهٔ بزرگتر حل کند.
یک رویکرد جایگزین برای هوش مصنوعی: سنتز برنامه
Section titled “یک رویکرد جایگزین برای هوش مصنوعی: سنتز برنامه”تا سال ۲۰۲۴، سیستمهای هوش مصنوعی با قابلیت استدلال گسستهٔ واقعی همگی توسط برنامهنویسان انسانی به صورت سختکد نوشته میشدند—برای مثال، موتورهای بازی شطرنج یا سیستمهای اثبات قضایا. اما اگر بخواهیم یک سیستم هوش مصنوعی این برنامهها را خودبهخود تولید کند، چه رویکردی باید در پیش گرفت؟ پاسخ سنتز برنامه (program synthesis) است (شکل ۱۹.۱۴ را ببینید).
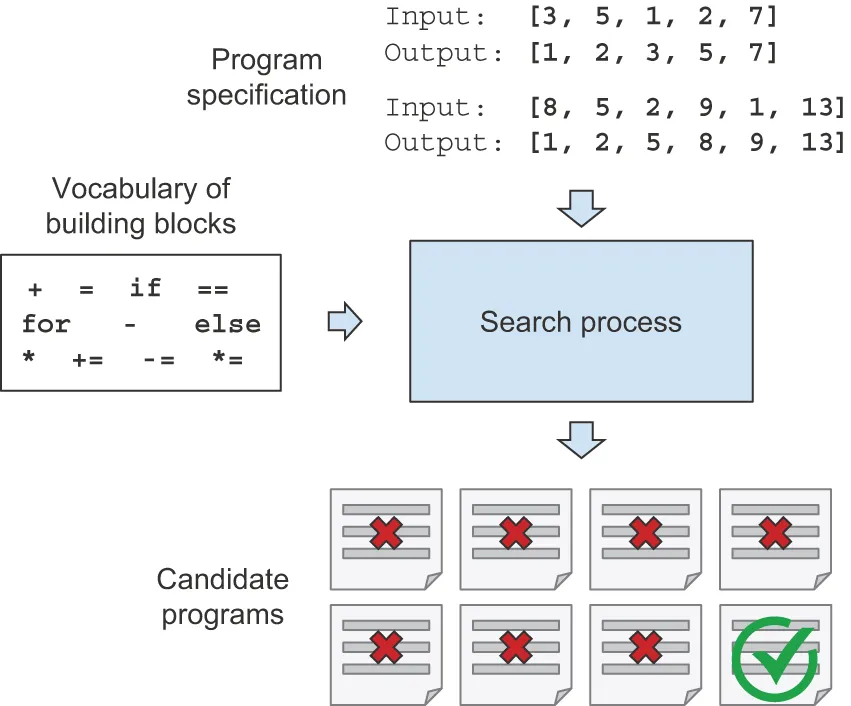
شکل ۱۹.۱۴: نمایی شماتیک از سنتز برنامه: جستجو در فضایی از عملگرهای الگوریتمی گسسته برای یافتن برنامهای که مشخصات ورودی-خروجی دادهشده را برآورده سازد.
سنتز برنامه شامل تولید خودکار برنامههای ساده با استفاده از یک الگوریتم جستجو (احتمالاً هدایتشده توسط یک مدل یادگیری ماشین) روی فضایی از بلوکهای سازندهٔ نرمافزاری گسسته است. جدول ۱۹.۲ یادگیری ماشین و سنتز برنامه را مقایسه میکند.
جدول ۱۹.۲: یادگیری ماشین در برابر سنتز برنامه
| یادگیری ماشین | سنتز برنامه |
|---|---|
| مدل: تابع پارامتری مشتقپذیر | مدل: گرافی از عملگرها از یک زبان برنامهنویسی |
| موتور: نزول گرادیان | موتور: جستجوی گسسته (مانند جستجوی ژنتیک یا درخت جستجو) |
| برای تولید نتایج قابل اعتماد به دادههای زیادی نیاز دارد | از نظر داده کارآمد است: میتواند با دو مثال آموزشی کار کند |
سنتز برنامه روشی است که از طریق آن قابلیتهای انتزاع برنامهمحور را به سیستمهای هوش مصنوعی خود اضافه خواهیم کرد. این مؤلفهٔ گمشده است که امکان استدلال صریح، بازنویسی قوانین، و تعمیم فرین را فراهم میسازد.
ترکیب یادگیری عمیق و سنتز برنامه
Section titled “ترکیب یادگیری عمیق و سنتز برنامه”البته یادگیری عمیق قرار نیست کنار گذاشته شود. سنتز برنامه جایگزین آن نیست؛ بلکه مکمل آن است. آیندهٔ هوش مصنوعی در ترکیب هماهنگ این دو پارادایم نهفته است. دو راه اصلی برای پیوند آنها وجود دارد:
- توسعهٔ سیستمهایی که هم ماژولهای یادگیری عمیق و هم ماژولهای الگوریتمی گسسته را ادغام میکنند
- استفاده از یادگیری عمیق برای کارآمدتر ساختن فرایند جستجوی برنامه
بیایید هر یک از این مسیرها را بررسی کنیم.
ادغام ماژولهای یادگیری عمیق و ماژولهای الگوریتمی در سیستمهای ترکیبی
Section titled “ادغام ماژولهای یادگیری عمیق و ماژولهای الگوریتمی در سیستمهای ترکیبی”امروزه، بسیاری از قدرتمندترین سیستمهای هوش مصنوعی ماهیتی ترکیبی (هیبرید) دارند: آنها هم از مدلهای یادگیری عمیق و هم از برنامههای نمادین دستساز استفاده میکنند. برای مثال، AlphaGo از شبکههای عصبی عمیق برای ارزیابی شهودی موقعیتهای صفحه استفاده میکرد، در حالی که تصمیم نهایی با جستجوی درخت مونتکارلو (MCTS)—یک الگوریتم گسسته—گرفته میشد. سیستمهای خودروهای خودران نیز برای ادراک از یادگیری عمیق و برای برنامهریزی مسیر از ماژولهای کنترلی کلاسیک بهره میبرند.
برای هر دوی این سیستمها—AlphaGo و وسایل نقلیهٔ خودران—ترکیب برنامههای گسستهٔ انسانساز با مدلهای پیوسته یادگرفتهشده کلید موفقیت بود. با این حال، ماژولهای الگوریتمی همچنان توسط مهندسان انسانی به صورت دستی کدگذاری میشدند. گام بعدی این است که سیستم بتواند خود این برنامهها را یاد بگیرد (شکل ۱۹.۱۵ را ببینید).
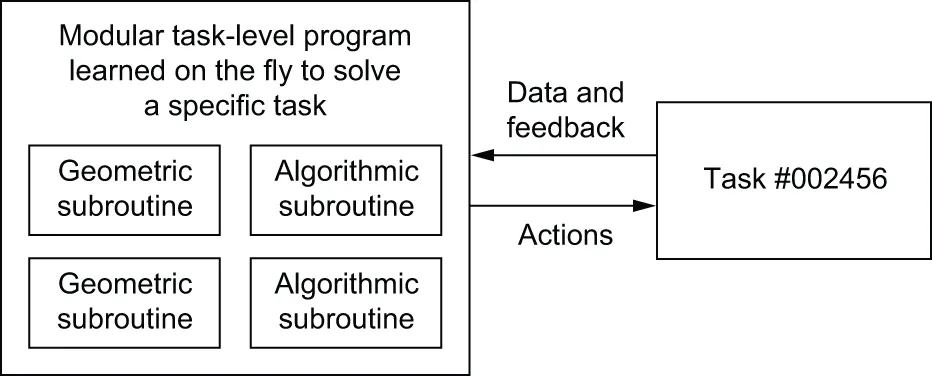
شکل ۱۹.۱۵: یک برنامهٔ آموختهشده که هم به ماژولهای ادراکی (یادگیری عمیق) و هم به ماژولهای الگوریتمی گسسته (سنتز برنامه) متکی است.
این ساختار چه شکلی خواهد داشت؟ نوع شناختهشدهای از شبکه را در نظر بگیرید: شبکههای عصبی بازگشتی (RNNها). مهم است به یاد داشته باشیم که یک RNN در واقع مدلی است که یک حلقهٔ for را در اطراف یک سلول مشتقپذیر اجرا میکند. در آینده، ما برنامههای پیچیدهتری با حلقهها، شاخهبندیها، فراخوانی توابع، و پشتههای حافظه خواهیم داشت که سلولهای یادگیری عمیق را در نقاط کلیدی در خود جای میدهند.
ما از وضعیت دوگانهای که در آن از یک سو هوش الگوریتمی سختکدشده (نرمافزارهای دستساز) و از سوی دیگر هوش هندسی پیوسته (یادگیری عمیق) داریم، به سمت برنامههایی ترکیبی و انعطافپذیر حرکت خواهیم کرد.
استفاده از یادگیری عمیق برای هدایت جستجوی برنامه
Section titled “استفاده از یادگیری عمیق برای هدایت جستجوی برنامه”امروزه، سنتز برنامه با مانعی بزرگ روبرو است: از نظر محاسباتی به شدت ناکارآمد است. فضای تمام برنامههای ممکن با افزایش طول برنامه به صورت ترکیبیاتی و انفجاری منفجر میشود. یک جستجوی کورکورانه حتی برای برنامههایی با ۵ یا ۶ خط کد ساعتها طول میکشد.
برای پیشرفت، باید سنتز برنامه را با نزدیکتر کردن آن به نحوهٔ فکر کردن برنامهنویسان انسانی کارآمد سازیم. وقتی یک انسان کد مینویسد، تمام کلمات کلیدی ممکن در پایتون را به صورت تصادفی امتحان نمیکند؛ بلکه از شهود و تجربهٔ گذشته برای حدس زدن ساختار راهحل استفاده مینماید.
یادگیری عمیق میتواند دقیقاً همین نقش را برای سنتز برنامه ایفا کند: اگرچه هر برنامهٔ خاص ممکن است گسسته باشد، اما توزیع برنامههای محتمل روی یک فضای پیوسته قرار دارد. یک شبکهٔ عصبی میتواند شهودی غنی دربارهٔ اینکه کدام برنامهها احتمالاً برای یک مسئلهٔ خاص کارساز هستند ارائه دهد و فضای جستجو را هزاران برابر محدود کند.
به یاد داشته باشید که استدلال انسانی به شدت توسط انتزاعهای ارزشمحور هدایت میشود—یعنی با بازشناسی الگو و شهود. با قرار دادن یادگیری عمیق به عنوان راهنمای شهودی برای موتور جستجوی نمادین، میتوانیم به سیستمهایی دست یابیم که هم سریع و شهودی هستند و هم دقیق و تعمیمپذیر.
ترکیب مجدد مؤلفههای ماژولار و یادگیری مادامالعمر
Section titled “ترکیب مجدد مؤلفههای ماژولار و یادگیری مادامالعمر”اگر مدلها پیچیدهتر شوند و بر فراز عملگرهای الگوریتمی غنیتری ساخته شوند، این پیچیدگی فزاینده به روشهای بهتری برای سازماندهی مجدد و استفادهٔ مجدد از مهارتها نیاز خواهد داشت.
با مدلهای پایهٔ مدرن، ما به دنیایی نزدیک میشویم که در آن سیستمهای هوش مصنوعی مقادیر عظیمی از دانش را ذخیره میکنند. با این حال، این دانش درون وزنهای یک شبکهٔ منفرد منجمد و ادغام شده است، بدون اینکه امکان استفادهٔ ماژولار از آن وجود داشته باشد.
برای حل تعمیم ترکیبی (compositional generalization)، باید بتوانیم مؤلفههای برنامهای مستحکمی را در موقعیتهای مختلف بازترکیب کنیم (شکل ۱۹.۱۶ را ببینید).
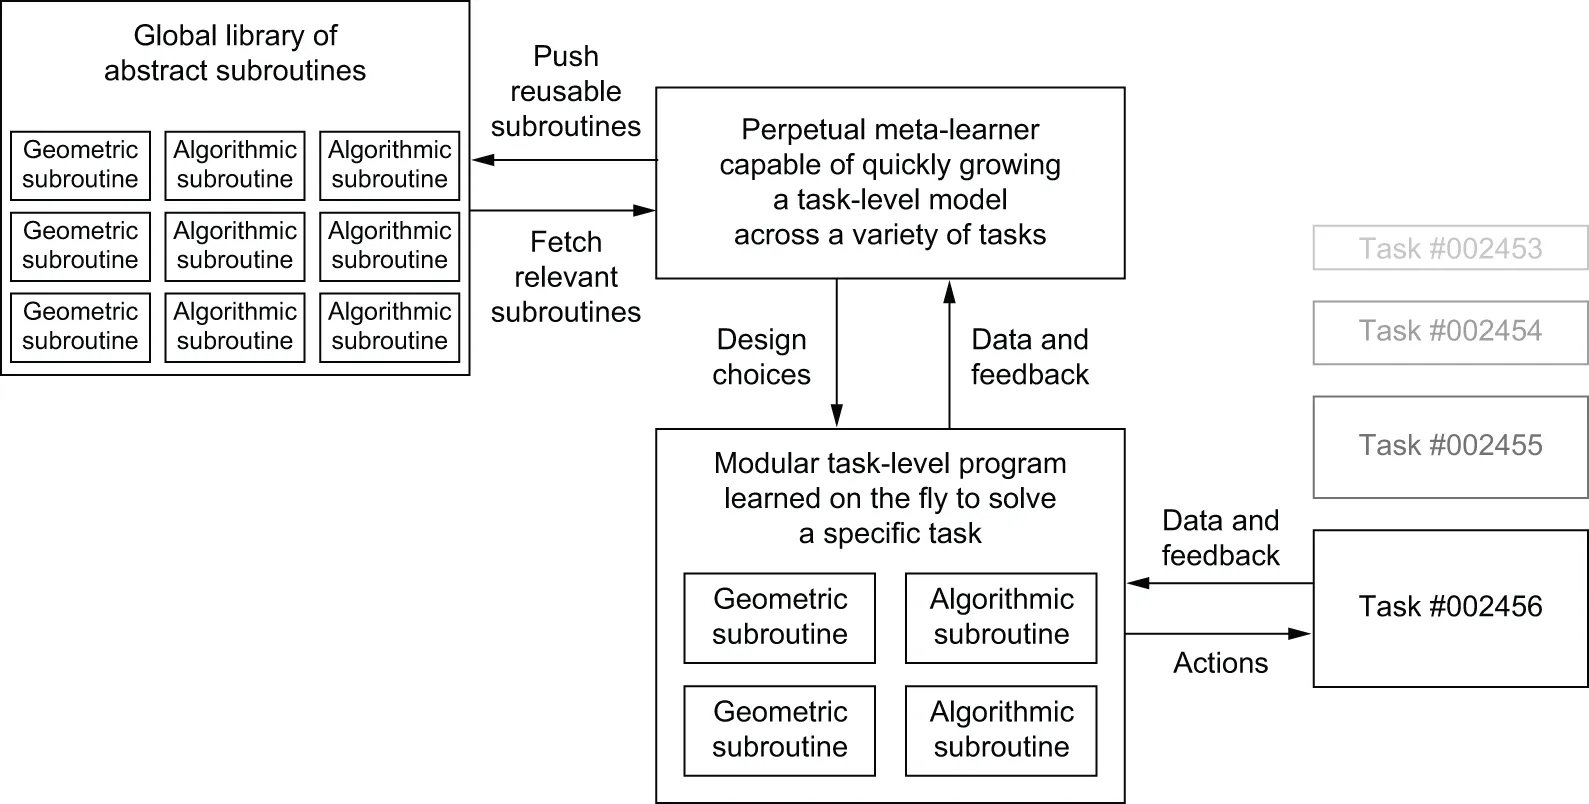
شکل ۱۹.۱۶: یک فرا-یادگیرنده که میتواند در پاسخ به وظایف جدید به سرعت مدلهای تخصصی تولید کند و کتابخانهٔ انتزاعهای با قابلیت استفادهٔ مجدد خود را به طور مداوم گسترش دهد.
به فرایند توسعهٔ نرمافزار امروزی فکر کنید: وقتی یک مهندس مسئلهٔ خاصی را حل میکند (مثلاً درخواستهای HTTP در پایتون)، راهحل را به عنوان یک کتابخانهٔ ماژولار بستهبندی میکند (مانند کتابخانهٔ requests). پس از آن، هیچ برنامهنویس دیگری نیازی به اختراع مجدد چرخ ندارد؛ همه به سادگی آن را وارد میکنند و روی ساخت قابلیتهای سطح بالاتر تمرکز مینمایند. سیستمهای آیندهٔ هوش مصنوعی نیز باید دارای یک کتابخانهٔ جهانی از مهارتها و زیرروالهای ماژولار باشند که با مواجهه با مسائل جدید، به طور پیوسته رشد کرده و غنیتر شود—مفهومی که به عنوان یادگیری مادامالعمر (lifelong learning) شناخته میشود.
چشمانداز بلندمدت
Section titled “چشمانداز بلندمدت”به طور خلاصه، در اینجا چشمانداز بلندمدت من برای هوش مصنوعی ارائه شده است:
- مدلها بیشتر شبیه به برنامهها خواهند بود و قابلیتهایی خواهند داشت که بسیار فراتر از تبدیلهای پیوستهٔ هندسی دادههای ورودی است که در حال حاضر با آنها کار میکنیم. این برنامهها ویژگیهایی مانند استدلال رسمی، بازنمایی ساختاریافته و تضمینهای دقیق منطقی را در بر خواهند گرفت.
- به طور مشخص، مدلها ماژولهای الگوریتمی (ارائهدهندهٔ استدلال رسمی، جستجو و انتزاعهای نمادین) را با ماژولهای هندسی (ارائهدهندهٔ شهود غیررسمی، بازشناسی الگو و نگاشت ادراکی) در هم خواهند آمیخت.
- چنین مدلهایی به جای اینکه توسط مهندسان انسانی کدگذاری شوند، به طور خودکار از طریق مؤلفههای ماژولار ذخیرهشده در یک کتابخانهٔ جهانی از زیرروالهای قابل استفادهٔ مجدد رشد خواهند کرد —کتابخانهای که از طریق یادگیری و حل مداوم هزاران وظیفه تکامل مییابد.
- فرایندی که برای رشد مدلهای جدید در میان ترکیبهای ممکن از زیرروالها به جستجو میپردازد یک فرایند جستجوی گسسته (سنتز برنامه) خواهد بود، اما این جستجو به شدت توسط نوعی شهود هدایتکننده مبتنی بر یادگیری عمیق راهنمایی خواهد شد.
- این کتابخانهٔ جهانی زیرروالها و سیستم رشد مدل متناظر با آن قادر خواهد بود به شکلی از تعمیم فرین شبیه به انسان دست یابد: با مواجهه با یک وظیفه یا موقعیت کاملاً جدید، سیستم میتواند با استفاده از دادههای بسیار اندک، مدل جدیدی را در لحظه برای حل آن مسئله سنتز کند، و انتزاعهای جدید حاصل از آن وظیفه را به کتابخانهٔ رو به رشد خود بیفزاید.
این سیستم مدلساز که به طور مداوم یاد میگیرد و رشد میکند را میتوان به عنوان یک هوش عمومی مصنوعی (AGI) تفسیر کرد. اما انتظار هیچ آخرالزمان رباتیک تکینگی (singularitarian robot apocalypse) را نداشته باشید: این صرفاً یک فانتزی محض است که از یک رشته سوءبرداشتهای عمیق دربارهٔ هر دو مفهوم هوش و فناوری ناشی میشود. با این حال، چنین نقدی در این کتاب نمیگنجد.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
همچنین نگاه کنید به ماریانا نژورینا، لوسیا سیپولینا-کون، مهدی چرتی، و جنیا جیتسف، «آلیس در سرزمین عجایب: وظایف سادهای که فروپاشی کامل استدلال را در مدلهای زبانی بزرگ پیشرفته نشان میدهند»، arXiv، https://arxiv.org/abs/2406.02061. ↩
-
تری وینوگراد، «رویهها به عنوان بازنمایی دادهها در یک برنامهٔ کامپیوتری برای درک زبان طبیعی»، ۱۹۷۱. ↩
-
مایکل شیک، «وازینیاک: آیا یک کامپیوتر میتواند یک فنجان قهوه درست کند؟»، Fast Company، مارس ۲۰۱۰. ↩
-
فرانسوا شوله، «دربارهٔ سنجش هوش»، ۲۰۱۹. ↩
-
نوها دزیری و همکاران، «ایمان و سرنوشت: محدودیتهای ترنسفورمرها در ترکیبپذیری»، مقالات سیوهفتمین کنفرانس بینالمللی سیستمهای پردازش اطلاعات عصبی (۲۰۲۳)، https://arxiv.org/abs/2305.18654. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.