
دیتاست هدی: ارقام دستنویس فارسی در پایتون
برای اینکه الگوریتمها را روی دادهی تصویری واقعی امتحان کنیم، سراغ مجموعهای میرویم که برای ما فارسیزبانها آشناست: ارقام دستنویس فارسی.
هدی از کجا آمده؟
Section titled “هدی از کجا آمده؟”مجموعهی ارقام دستنویس هدی اولین مجموعهی بزرگ ارقام دستنویس فارسی است. این مجموعه در دانشگاه تربیت مدرس، در یک پروژهی کارشناسی ارشد دربارهی بازشناسی فرمهای دستنویس، زیر نظر دکتر احسانالله کبیر تهیه شد.
ایدهی جمعآوریاش هوشمندانه بود. در فرمهای ثبتنام کنکور، داوطلب کد خود را در خانههای جداگانه، هر رقم در یک خانه، مینوشت. کد درست هر داوطلب از قبل معلوم بود؛ پس برچسب هر رقم خودکار به دست میآمد و لازم نبود کسی دهها هزار رقم را دستی برچسب بزند. حدود ۱۲ هزار فرم از آزمون کارشناسی ارشد سال ۱۳۸۴ و آزمون کاردانی سال ۱۳۸۳ اسکن شد و ارقام بریده شدند. مجموعهی کامل ۱۰۲٬۳۵۳ نمونه دارد. فایلی که در این دوره استفاده میکنیم ۶۰٬۰۰۰ نمونه دارد؛ از هر رقم ۶٬۰۰۰ تا.
دادهها از قبل تمیز شدهاند:
- برش تنگ: دور هر رقم هیچ حاشیهای نیست. برای الگوریتمهای کلاسیک مثل KNN این خیلی مهم است.
- دودویی (باینری): فقط دو مقدار ۰ و ۲۵۵ دارد. پررنگ یا کمرنگ بودن خودکار و مداد اهمیتی ندارد؛ فقط مهم است جوهر هست یا نیست.
- معکوس: پسزمینه سیاه و رقم سفید است. الگوریتمها معمولاً به «وجود» چیزی حساساند (عدد بزرگ) تا نبودنش (صفر)، پس بهتر است جایی که جوهر هست عدد بزرگ داشته باشد.
خواندن فایل
Section titled “خواندن فایل”داده در قالب فایل .mat متلب منتشر شده (آن زمان متلب رایجتر از پایتون بود). کتابخانهی SciPy میتواند این فایلها را بخواند. فایل را از مخزن نوتبوکهای دوره یا همین سایت دانلود کنید.
import numpy as npfrom scipy import ioimport matplotlib.pyplot as pltimport cv2
dataset = io.loadmat("dataset/Data_hoda_full.mat")type(dataset)       # dictdataset.keys()      # ['__header__', '__version__', '__globals__', 'Data', 'labels']
حاصل یک دیکشنری پایتون است. سه کلید اول اطلاعاتی دربارهی فایلاند (نسخهی متلب، تاریخ ساخت و غیره). دادهی اصلی در Data و labels است:
dataset["Data"].shape # (60000, 1)dataset["Data"][0, 0].shape # (27, 20) — خود تصویرdataset["labels"][0, 0] # 6squeeze: دور ریختن بُعد اضافه
Section titled “squeeze: دور ریختن بُعد اضافه”متلب همهچیز را دستکم دوبعدی نگه میدارد، برای همین شکل داده (60000, 1) است و همیشه باید یک 0 اضافه بنویسیم. np.squeeze بعدهایی را که اندازهشان ۱ است حذف میکند:
images = np.squeeze(dataset["Data"])     # (60000,)labels = np.squeeze(dataset["labels"])   # (60000,)
i = 12plt.imshow(images[i], cmap="gray")plt.title(labels[i])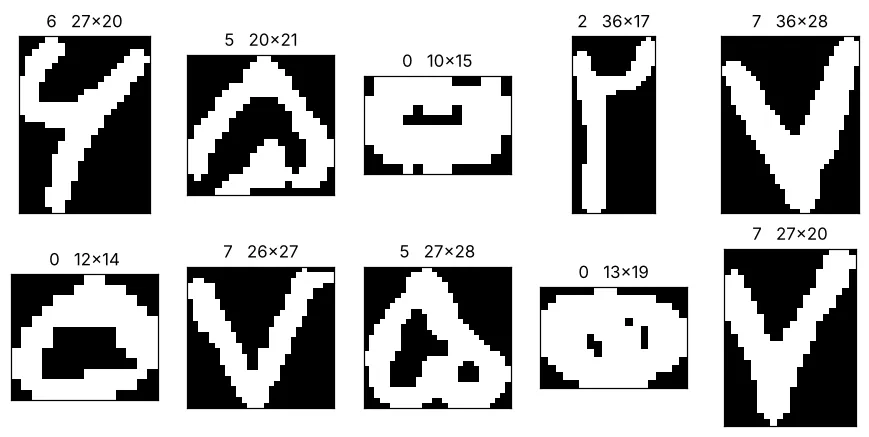
بالای هر تصویر برچسب و ابعادش آمده. دو نکته معلوم است: دادهها درهم (shuffled) هستند و اندازهها متفاوت است؛ صفر پهن و کوتاه است و دو بلند و باریک. اندازهی هر تصویر را میتوانید با images[i].shape ببینید.
آماده کردن برای الگوریتم
Section titled “آماده کردن برای الگوریتم”کتابخانههای یادگیری ماشین مثل scikit-learn داده را به شکل یک ماتریس میخواهند: نمونه، هر کدام با ویژگی. اگر بخواهیم خود پیکسلها ویژگی باشند، دو کار لازم است:
۱. هماندازه کردن
Section titled “۱. هماندازه کردن”همهی تصویرها باید تعداد پیکسل یکسان داشته باشند. با OpenCV همه را ۵×۵ میکنیم:
X_train_original = images[:1000]y_train = labels[:1000]X_test_original = images[1000:1200]y_test = labels[1000:1200]
X_train_5x5 = [cv2.resize(img, dsize=(5, 5)) for img in X_train_original]X_test_5x5 = [cv2.resize(img, dsize=(5, 5)) for img in X_test_original]
برای سرعت، فعلاً فقط هزار نمونه برای آموزش و دویست نمونهی بعدی برای آزمون برمیداریم. دادههای آزمون نباید در آموزش دیده شده باشند.
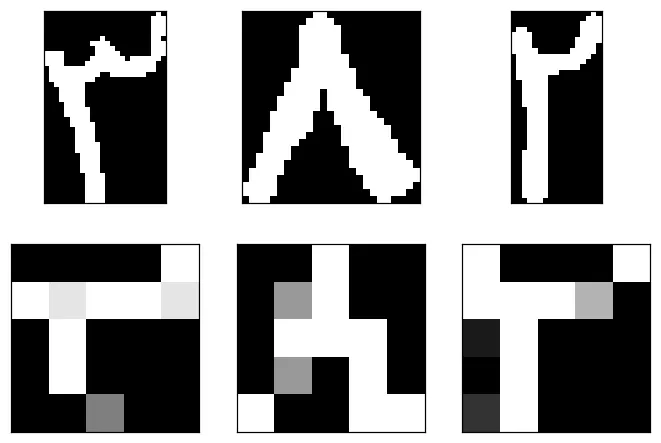
۵×۵ خیلی بیرحمانه است؛ دندانههای سه تقریباً از بین رفته و نسبت طول به عرض هم به هم خورده. ولی خواهیم دید همین برای KNN دقت ۹۶ درصد میدهد. وقتی تصویر دودویی کوچک میشود، دیگر دودویی نمیماند: هر پیکسل جدید میانگینی از چند پیکسل قدیمی است و خانههایی که بخشیشان سفید بوده خاکستری میشوند.
۲. صاف کردن (flatten)
Section titled “۲. صاف کردن (flatten)”هر تصویر ۵×۵ را به یک بردار ۲۵تایی تبدیل میکنیم:
X_train = np.reshape(X_train_5x5, [-1, 25]) # (1000, 25)X_test = np.reshape(X_test_5x5, [-1, 25]) # (200, 25)-1 یعنی «این بعد را خودت حساب کن». ۱۰۰۰ تصویر ۵×۵ روی هم ۲۵٬۰۰۰ عدد است؛ اگر هر ردیف ۲۵ عدد داشته باشد، تعداد ردیفها ۱۰۰۰ میشود. فایدهاش این است که اگر بعداً تعداد نمونهها را عوض کردید، لازم نیست این خط را تغییر دهید. اگر عددی بدهید که بخشپذیر نباشد (مثلاً ۲۶)، NumPy خطا میدهد.
همه با هم: تابع load_hoda
Section titled “همه با هم: تابع load_hoda”این مراحل را در یک فایل dataset.py میگذاریم تا در درسهای بعد با یک خط داده را بخوانیم:
import cv2import numpy as npfrom scipy import io
def load_hoda(training_sample_size=1000, test_sample_size=200, size=5):    trs, tes = training_sample_size, test_sample_size    dataset = io.loadmat("./dataset/Data_hoda_full.mat")
    X_train_original = np.squeeze(dataset["Data"][:trs])    y_train = np.squeeze(dataset["labels"][:trs])    X_test_original = np.squeeze(dataset["Data"][trs:trs + tes])    y_test = np.squeeze(dataset["labels"][trs:trs + tes])
    X_train = [cv2.resize(img, dsize=(size, size)) for img in X_train_original]    X_test = [cv2.resize(img, dsize=(size, size)) for img in X_test_original]
    X_train = np.reshape(X_train, [-1, size ** 2])    X_test = np.reshape(X_test, [-1, size ** 2])    return X_train, y_train, X_test, y_test
from dataset import load_hoda
X_train, y_train, X_test, y_test = load_hoda()پایتون هر فایل .py را که کنار نوتبوک باشد، مثل یک کتابخانه میشناسد.
- هدی مجموعهی ارقام دستنویس فارسی است که از فرمهای کنکور جمع شده؛ ارقام برش تنگ خوردهاند، دودوییاند و رقم سفید روی زمینهی سیاه است.
scipy.io.loadmatفایل متلب را به دیکشنری تبدیل میکند وnp.squeezeبعدهای اضافه را حذف میکند.- برای scikit-learn همهی تصویرها را هماندازه (
cv2.resize) و بعد به بردار تبدیل (reshape) میکنیم.
ادامه: طبقهبندی همین ارقام با KNN
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.