
پیدا کردن رقمها در عکس با مؤلفههای همبند (Connected Components)
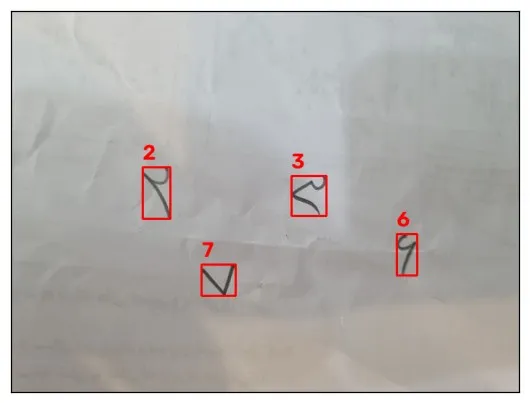
مدل KNN که روی دیتاست هدی آموزش دادیم فقط رقمی را میشناسد که برش تنگ خورده، دودویی است و روی زمینهی سیاه نوشته شده. آیا این در عمل به درد میخورد؟ بله؛ به شرطی که بتوانیم عکس واقعی را به همین شکل دربیاوریم. در این درس از یک عکس موبایل از کاغذی که چند رقم رویش نوشته شده شروع میکنیم و به اینجا میرسیم:
مؤلفهی همبند چیست؟
Section titled “مؤلفهی همبند چیست؟”تصویری دودویی را در نظر بگیرید: پسزمینه سیاه و چند شکل سفید. مؤلفهی همبند (connected component) مجموعهای از پیکسلهای سفید است که به هم راه دارند. الگوریتم پیدا کردنش ساده است:
- یک پیکسل سفید که هنوز علامت نخورده بردار و علامتش بزن.
- همسایههایش را نگاه کن؛ هر همسایهی سفید را علامت بزن.
- همین کار را برای همسایههای آنها تکرار کن، تا جایی که دیگر همسایهی سفید تازهای نماند. همهی این پیکسلها یک مؤلفهاند.
- برای پیکسل سفید بعدی که علامت نخورده، از اول شروع کن.
برای هر مؤلفه میشود موقعیت، عرض، ارتفاع، مساحت و مرکز ثقلش را حساب کرد.
همسایه یعنی چه؟ دو تعریف رایج داریم:
- چهارهمسایگی: فقط بالا، پایین، چپ و راست.
- هشتهمسایگی: قطرها هم همسایه حساب میشوند.
با چهارهمسایگی، دو پیکسل که فقط از گوشه به هم چسبیدهاند دو مؤلفهی جدا هستند؛ با هشتهمسایگی یکی. برای ارقام دستنویس هشتهمسایگی مناسبتر است، چون خطهای مورب باید یک تکه بمانند. این مفهوم از نظریهی گراف آمده و جاهای دیگری مثل مسیریابی هم کاربرد دارد. OpenCV آن را آماده پیادهسازی کرده است.
گام ۱: خواندن و خاکستری کردن
Section titled “گام ۱: خواندن و خاکستری کردن”import cv2import numpy as npimport matplotlib.pyplot as plt
img = cv2.imread("persian-digits.jpg") # رنگی، با ترتیب BGRgray = cv2.imread("persian-digits.jpg", 0) # خاکستری؛ شکل (525, 700)plt.imshow(img[:, :, ::-1]) # برای نمایش، BGR را به RGB برگردان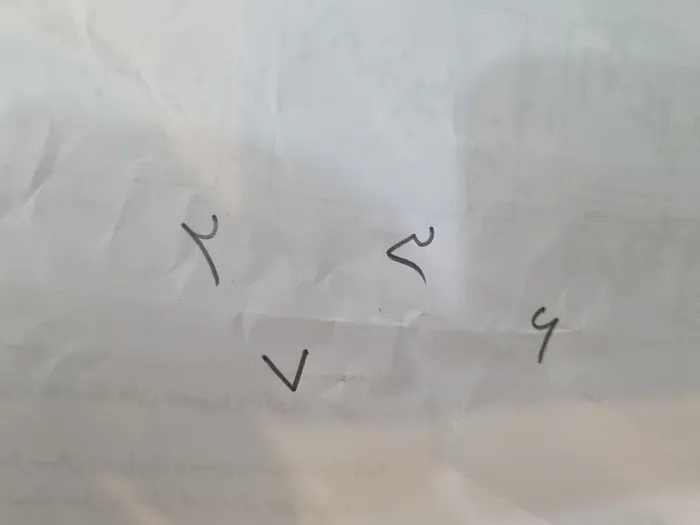
در تصویر خاکستری، کاغذ روشن به ۲۵۵ نزدیک است و جای خودکار به صفر.
گام ۲: دودویی کردن و معکوس کردن
Section titled “گام ۲: دودویی کردن و معکوس کردن”سادهترین راه برای دودویی کردن، آستانهگذاری است: پیکسلهای کمتر از وسط بازه (۱۲۷٫۵) صفر و بقیه ۲۵۵.
g = gray.copy()g[gray < 127.5] = 0g[gray >= 127.5] = 255حالا جوهر سیاه است و کاغذ سفید، ولی الگوریتم مؤلفهی همبند (و مدل ما) برعکسش را میخواهد. یک اشتباه رایج این است که بخواهیم با همان شرطها جای ۰ و ۲۵۵ را عوض کنیم:
g[g > 127.5] = 0 # همهی سفیدها صفر شدند...g[g < 127.5] = 255 # ...و حالا همهی پیکسلها زیر ۱۲۷٫۵ هستند، پس همه ۲۵۵ میشوند!دستور دوم روی نتیجهی دستور اول اجرا میشود، پس کل تصویر یک رنگ میشود. راه درست یک تفریق ساده است:
g = 255 - g # صفر میشود ۲۵۵ و ۲۵۵ میشود صفر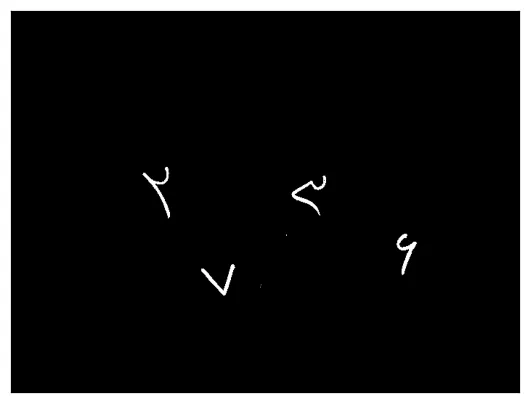
آستانهی ثابت ۱۲۷٫۵ فقط وقتی خوب کار میکند که نور عکس تقریباً یکنواخت باشد. برای عکسهایی با سایه و نور ناهمگون، روشهای آستانهگذاری تطبیقی (adaptive) بهترند.
گام ۳: پیدا کردن مؤلفهها
Section titled “گام ۳: پیدا کردن مؤلفهها”OpenCV چند نسخه از این تابع دارد. نسخهی WithStats علاوه بر برچسبگذاری، آمار هر مؤلفه را هم برمیگرداند:
n, labels, stats, centroids = cv2.connectedComponentsWithStats(g, connectivity=8)print(n) # 8print(stats.shape) # (8, 5)n: تعداد مؤلفهها، بهعلاوهی پسزمینه که همیشه مؤلفهی شمارهی صفر است.labels: آرایهای هماندازهی تصویر که در هر پیکسل شمارهی مؤلفهی آن نوشته شده (۰ برای پسزمینه، ۱، ۲، …).stats: برای هر مؤلفه پنج عدد:x،y، عرض، ارتفاع و مساحت (تعداد پیکسل).centroids: مرکز ثقل هر مؤلفه.
چهار رقم داشتیم ولی الگوریتم هفت مؤلفه (بهجز پسزمینه) پیدا کرده. سه تای اضافه نقطههای خیلی کوچکیاند، با عرض و ارتفاع یک یا دو پیکسل: خردههای مداد یا لکههای کاغذ که چشم ما نمیبیند ولی کامپیوتر به یک پیکسل هم حساس است.
گام ۴: حذف نویز، برش و پیشبینی
Section titled “گام ۴: حذف نویز، برش و پیشبینی”از مؤلفهی ۱ شروع میکنیم (صفر پسزمینه است)، مؤلفههای خیلی کوچک را کنار میگذاریم و بقیه را به همان شکلی درمیآوریم که مدل در آموزش دیده:
for i in range(1, n): x, y, w, h, area = stats[i] if w > 5 and h > 5: # نویزهای کوچک را رد کن digit = g[y:y + h, x:x + w] # برش تنگ؛ سطرها با y، ستونها با x X = cv2.resize(digit, (5, 5)).reshape(1, 25) pred = model.predict(X)[0] # model همان KNN آموزشدیده روی هدی است print(pred)خروجی: ۲، ۳، ۶ و ۷. همه درست.
دقت کنید stats مختصات را به شکل (x, y) میدهد، یعنی اول ستون و بعد سطر؛ ولی برای برش آرایهی NumPy اول سطر (y) و بعد ستون (x) را مینویسیم.
گام ۵: نوشتن نتیجه روی عکس
Section titled “گام ۵: نوشتن نتیجه روی عکس”به جای چاپ کردن، نتیجه را روی عکس رنگی اصلی میکشیم. OpenCV برای این کار تابعهای سادهای دارد. رنگها در OpenCV هم به ترتیب BGR هستند، پس (0, 0, 255) قرمز است:
for i in range(1, n):    x, y, w, h, area = stats[i]    if w > 5 and h > 5:        X = cv2.resize(g[y:y + h, x:x + w], (5, 5)).reshape(1, 25)        pred = model.predict(X)[0]        cv2.putText(img, str(pred), (x, y - 10), cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 0, 255), 2)        cv2.rectangle(img, (x, y), (x + w, y + h), (0, 0, 255), 2)
plt.imshow(img[:, :, ::-1])
putText متن را جایی مینویسد که نقطهی پایینچپش (x, y - 10) باشد، یعنی ده پیکسل بالای کادر. rectangle یک کادر از گوشهی بالاچپ تا گوشهی پایینراست میکشد. هر دو، تصویر را درجا تغییر میدهند.
این روش کجا میشکند؟
Section titled “این روش کجا میشکند؟”- حاشیه: اگر موقع برش ده پیکسل حاشیه اضافه کنید (
g[y-10:y+h+10, x-10:x+w+10])، تقریباً همهی پیشبینیها خراب میشود. مدل روی رقمهایی با برش تنگ آموزش دیده. - نور ناهمگون: با سایهی شدید روی کاغذ، آستانهی ثابت بخشی از کاغذ را جوهر حساب میکند.
- رقمهای بههمچسبیده: دو رقم که به هم وصل شدهاند یک مؤلفه میشوند.
- رقمهای تکهتکه: رقمی که خودکار وسطش قطع شده دو مؤلفه میشود.
با این حال، با کمی دقت در پیشپردازش، همین مدل ساده روی یک برگهی واقعی کار میکند. پیشپردازش در پروژههای واقعی گاهی به اندازهی خود مدل اهمیت دارد.
- مؤلفهی همبند مجموعهای از پیکسلهای سفید است که از طریق همسایهها به هم راه دارند؛ چهار یا هشتهمسایگی.
cv2.connectedComponentsWithStatsتعداد مؤلفهها، برچسب هر پیکسل، آمار(x, y, w, h, area)و مرکز ثقل را برمیگرداند. مؤلفهی صفر پسزمینه است.- مسیر کامل: خاکستری ← آستانه ← معکوس ← مؤلفهها ← حذف نویز ← برش تنگ ← تغییر اندازه ← پیشبینی.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.