
فصل ۴: طبقهبندی و رگرسیون
این فصل طراحی شده است تا شما را با استفاده از شبکههای عصبی برای حل مسائل واقعی شروع کند. شما دانشی را که از فصلهای ۲ و ۳ به دست آوردهاید تثبیت خواهید کرد و آنچه را که یاد گرفتهاید در سه وظیفهٔ جدید که سه کاربرد رایج شبکههای عصبی را پوشش میدهند به کار خواهید گرفت — طبقهبندی دودویی، طبقهبندی دستهای و رگرسیون اسکالر:
- طبقهبندی نقدهای فیلم بهعنوان مثبت یا منفی (طبقهبندی دودویی)
- طبقهبندی خبرگزاریها بر اساس موضوع (طبقهبندی دستهای)
- تخمین قیمت یک خانه با توجه به دادههای املاک (رگرسیون اسکالر)
این مثالها اولین برخورد شما با گردشکارهای سرتاسری یادگیری ماشین خواهند بود: شما با پیشپردازش داده، اصول پایهٔ معماری مدل و ارزیابی مدل آشنا خواهید شد.
در پایان این فصل، قادر خواهید بود از شبکههای عصبی برای مدیریت وظایف سادهٔ طبقهبندی و رگرسیون روی دادههای برداری استفاده کنید. سپس آمادهٔ شروع ساختن یک درک اصولی و مبتنی بر نظریه از یادگیری ماشین در فصل ۵ خواهید بود.
طبقهبندی نقدهای فیلم: یک مثال طبقهبندی دودویی
Section titled “طبقهبندی نقدهای فیلم: یک مثال طبقهبندی دودویی”طبقهبندی دوکلاسه، یا طبقهبندی دودویی، یکی از رایجترین انواع مسائل یادگیری ماشین است. در این مثال، یاد میگیرید نقدهای فیلم را بر اساس محتوای متنی آنها به مثبت یا منفی طبقهبندی کنید.
مجموعهدادهٔ IMDb
Section titled “مجموعهدادهٔ IMDb”شما با مجموعهدادهٔ IMDb کار خواهید کرد: مجموعهای از ۵۰,۰۰۰ نقد بهشدت قطبی از پایگاه دادهٔ فیلم اینترنتی. آنها به ۲۵,۰۰۰ نقد برای آموزش و ۲۵,۰۰۰ نقد برای آزمایش تقسیم شدهاند، که هر مجموعه شامل ۵۰٪ نقدهای منفی و ۵۰٪ نقدهای مثبت است.
درست مانند مجموعهدادهٔ MNIST، مجموعهدادهٔ IMDb همراه Keras بستهبندی شده است. این مجموعه قبلاً پیشپردازش شده است: نقدها (دنبالههایی از کلمات) به دنبالههایی از اعداد صحیح تبدیل شدهاند، که در آن هر عدد صحیح نمایندهٔ یک کلمهٔ خاص در یک فرهنگ لغت است. این به ما امکان میدهد روی ساختن مدل، آموزش و ارزیابی تمرکز کنیم. در فصل ۱۴، یاد خواهید گرفت که چگونه ورودی متن خام را از صفر پردازش کنید.
کد زیر مجموعهداده را بارگذاری میکند (وقتی برای اولین بار اجرا کنید، حدود ۸۰ مگابایت داده روی دستگاه شما دانلود میشود).
لیستینگ ۴.۱: بارگذاری مجموعهدادهٔ IMDb
from keras.datasets import imdb
(train_data, train_labels), (test_data, test_labels) = imdb.load_data(    num_words=10000)
آرگومان num_words=10000 به این معناست که شما فقط ۱۰,۰۰۰ کلمهٔ پرتکرار در دادههای آموزشی را نگه میدارید. کلمات نادر کنار گذاشته میشوند. این به شما امکان میدهد با دادههای برداری با اندازهٔ قابل مدیریت کار کنید. اگر این محدودیت را تعیین نمیکردیم، با ۸۸,۵۸۵ کلمهٔ یکتا در دادههای آموزشی کار میکردیم که بهطور غیرضروری بزرگ است. بسیاری از این کلمات فقط در یک نمونه ظاهر میشوند و بنابراین نمیتوانند بهطور معناداری برای طبقهبندی استفاده شوند.
متغیرهای train_data و test_data آرایههای NumPy از نقدها هستند؛ هر نقد یک لیست از شاخصهای کلمات است (که یک دنباله از کلمات را کدگذاری میکند). train_labels و test_labels آرایههای NumPy از ۰ها و ۱ها هستند، که در آن ۰ نمایندهٔ منفی و ۱ نمایندهٔ مثبت است:
>>> train_data[0]از آنجا که خود را به ۱۰,۰۰۰ کلمهٔ پرتکرار محدود میکنید، هیچ شاخص کلمهای از ۱۰,۰۰۰ فراتر نمیرود:
>>> max([max(sequence) for sequence in train_data])برای سرگرمی، بیایید سریع یکی از این نقدها را به کلمات انگلیسی رمزگشایی کنیم.
لیستینگ ۴.۲: رمزگشایی نقدها به متن
# word_index is a dictionary mapping words to an integer index.word_index = imdb.get_word_index()# Reverses it, mapping integer indices to wordsreverse_word_index = dict([(value, key) for (key, value) in word_index.items()])# Decodes the review. Note that the indices are offset by 3 because 0,# 1, and 2 are reserved indices for "padding," "start of sequence," and# "unknown."decoded_review = " ".join( [reverse_word_index.get(i - 3, "?") for i in train_data[0]])بیایید ببینیم چه چیزی به دست آوردیم:
>>> decoded_review[:100]توجه داشته باشید که ? ابتدایی با یک توکن شروع مطابقت دارد که به ابتدای هر نقد اضافه شده است.
آمادهسازی دادهها
Section titled “آمادهسازی دادهها”شما نمیتوانید مستقیماً لیستهایی از اعداد صحیح را به یک شبکهٔ عصبی تغذیه کنید. آنها طولهای متفاوتی دارند، در حالی که یک شبکهٔ عصبی انتظار دارد دستههای پیوستهای از داده را پردازش کند. باید لیستهای خود را به تانسور تبدیل کنید. دو راه برای انجام این کار وجود دارد:
- لیستهای خود را پر کنید تا همه طول یکسانی داشته باشند، سپس آنها را به یک تانسور عدد صحیح با شکل
(samples, max_length)تبدیل کنید، و مدل خود را با لایهای شروع کنید که قادر به مدیریت چنین تانسورهای عدد صحیح باشد (لایهٔEmbedding، که بعداً در کتاب با جزئیات پوشش میدهیم). - لیستهای خود را چند-داغ (multi-hot) کدگذاری کنید تا آنها را به بردارهایی از ۰ها و ۱ها تبدیل کنید که حضور یا عدم حضور تمام کلمات ممکن را منعکس کند. برای مثال، این به معنای تبدیل دنبالهٔ
[8, 5]به یک بردار ۱۰,۰۰۰ بُعدی است که همهاش صفر خواهد بود بهجز شاخصهای ۵ و ۸ که ۱ خواهند بود.
بیایید راهحل دوم را برای برداریسازی داده انتخاب کنیم. وقتی بهصورت دستی انجام شود، فرآیند شبیه به موارد زیر است.
لیستینگ ۴.۳: کدگذاری دنبالههای عدد صحیح از طریق کدگذاری چند-داغ
import numpy as np
def multi_hot_encode(sequences, num_classes):    # Creates an all-zero matrix of shape (len(sequences), num_classes)    results = np.zeros((len(sequences), num_classes))    for i, sequence in enumerate(sequences):        # Sets specific indices of results[i] to 1s        results[i][sequence] = 1.0    return results
# Vectorized training datax_train = multi_hot_encode(train_data, num_classes=10000)# Vectorized test datax_test = multi_hot_encode(test_data, num_classes=10000)
اکنون نمونهها اینگونه به نظر میرسند:
>>> x_train[0]علاوه بر برداریسازی دنبالههای ورودی، باید برچسبهای آنها را نیز برداریسازی کنید، که ساده است. برچسبهای ما از قبل آرایههای NumPy هستند، بنابراین فقط نوع را از اعداد صحیح به ممیز شناور تبدیل کنید:
y_train = train_labels.astype("float32")y_test = test_labels.astype("float32")اکنون دادهها آمادهٔ تغذیه به یک شبکهٔ عصبی هستند.
ساختن مدل شما
Section titled “ساختن مدل شما”دادههای ورودی بردارها هستند و برچسبها اسکالرها (۱ها و ۰ها): این یکی از سادهترین تنظیمات مسئلهای است که تاکنون با آن روبرو خواهید شد. نوعی از مدل که روی چنین مسئلهای عملکرد خوبی دارد، یک پشتهٔ ساده از لایههای متراکم (Dense) با فعالسازیهای relu است.
دو تصمیم کلیدی معماری برای چنین پشتهای از لایههای Dense باید گرفته شود:
- چند لایه استفاده شود
- چند واحد برای هر لایه انتخاب شود
در فصل ۵، اصول رسمی برای راهنمایی شما در این انتخابها یاد خواهید گرفت. فعلاً، باید به ما در انتخاب معماری زیر اعتماد کنید:
- دو لایهٔ میانی با ۱۶ واحد هر کدام
- یک لایهٔ سوم که پیشبینی اسکالر دربارهٔ احساسات نقد فعلی را خروجی میدهد
شکل ۴.۱ نشان میدهد مدل چگونه به نظر میرسد. پیادهسازی Keras در اینجا آمده است، مشابه مثال MNIST که قبلاً دیدید.
لیستینگ ۴.۴: تعریف مدل
import kerasfrom keras import layers
model = keras.Sequential(    [        layers.Dense(16, activation="relu"),        layers.Dense(16, activation="relu"),        layers.Dense(1, activation="sigmoid"),    ])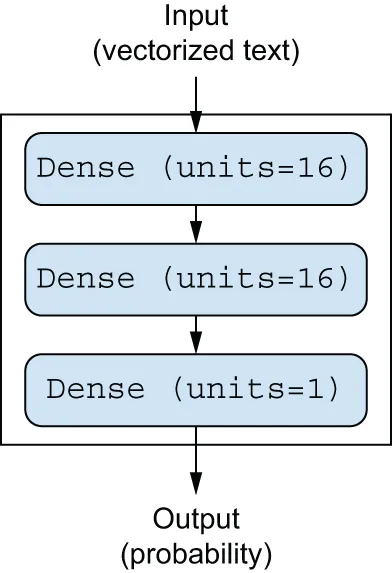
شکل ۴.۱: مدل سهلایه
اولین آرگومانی که به هر لایهٔ Dense پاس داده میشود تعداد واحدهای موجود در لایه است: بُعدیت فضای بازنمایی لایه. شما از فصلهای ۲ و ۳ به یاد دارید که هر لایهٔ Dense با فعالسازی relu زنجیرهٔ زیر از عملیات تانسوری را پیادهسازی میکند:
output = relu(dot(input, W) + b)داشتن ۱۶ واحد به این معنی است که ماتریس وزن W شکل (input_dimension, 16) خواهد داشت: ضرب داخلی با W دادههای ورودی را روی یک فضای بازنمایی ۱۶ بُعدی تصویر میکند (و سپس بردار بایاس b را اضافه میکنید و عملیات relu را اعمال میکنید). میتوانید بهطور شهودی بُعدیت فضای بازنمایی خود را بهعنوان «مدت آزادیای که به مدل در یادگیری بازنماییهای داخلی میدهید» درک کنید. داشتن واحدهای بیشتر (یک فضای بازنمایی با ابعاد بالاتر) به مدل شما امکان میدهد بازنماییهای پیچیدهتری یاد بگیرد، اما مدل را از نظر محاسباتی گرانتر میکند و ممکن است منجر به یادگیری الگوهای ناخواسته شود (الگوهایی که عملکرد روی دادههای آموزشی را بهبود میبخشند اما نه روی دادههای آزمایشی).
لایههای میانی از relu بهعنوان تابع فعالسازی خود استفاده میکنند و لایهٔ نهایی از فعالسازی sigmoid برای خروجی یک احتمال استفاده میکند (یک نمره بین ۰ و ۱، که نشان میدهد چقدر احتمال دارد نقد مثبت باشد). یک relu (واحد خطی اصلاحشده) تابعی است که برای صفر کردن مقادیر منفی طراحی شده است (شکل ۴.۲ را ببینید)، در حالی که یک sigmoid مقادیر دلخواه را به بازهٔ [0, 1] «فشرده» میکند (شکل ۴.۳ را ببینید) و چیزی را خروجی میدهد که میتواند بهعنوان یک احتمال تفسیر شود.
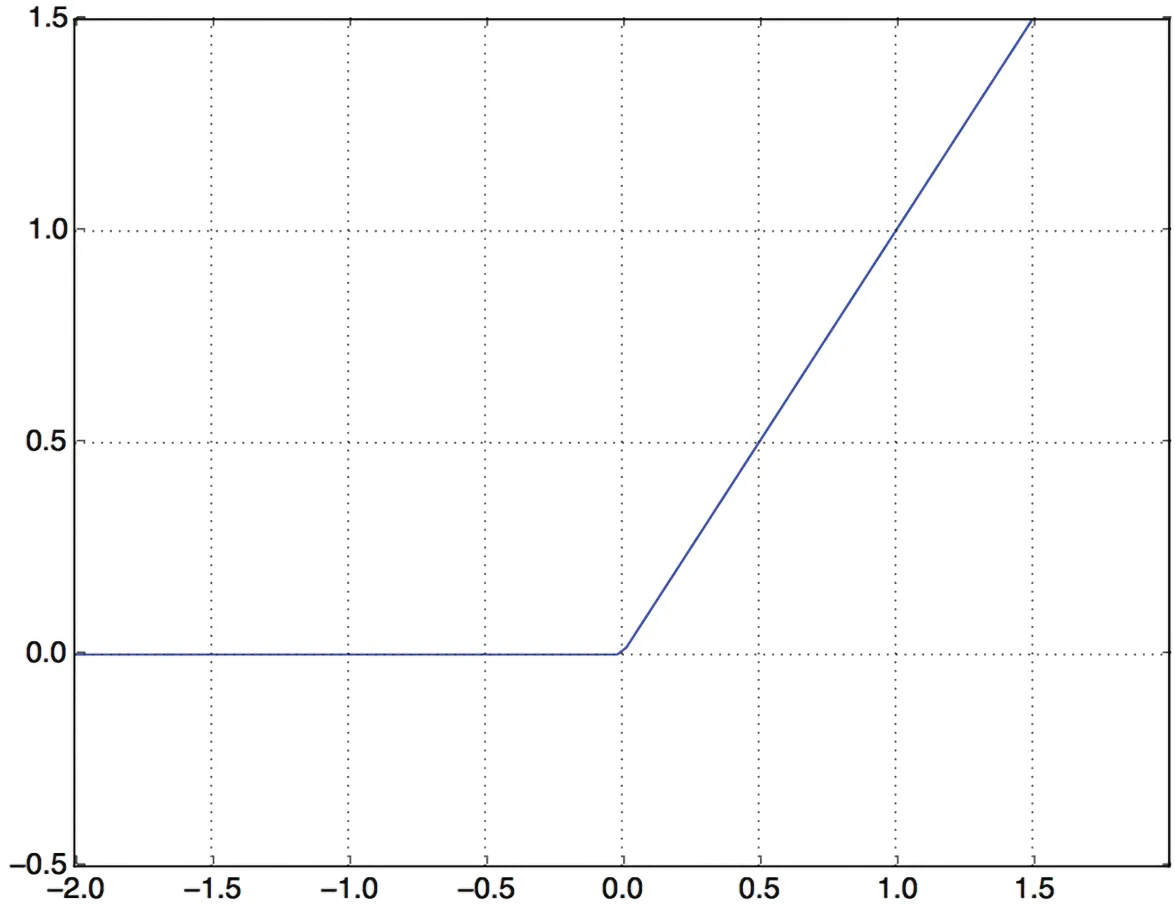
شکل ۴.۲: تابع واحد خطی اصلاحشده
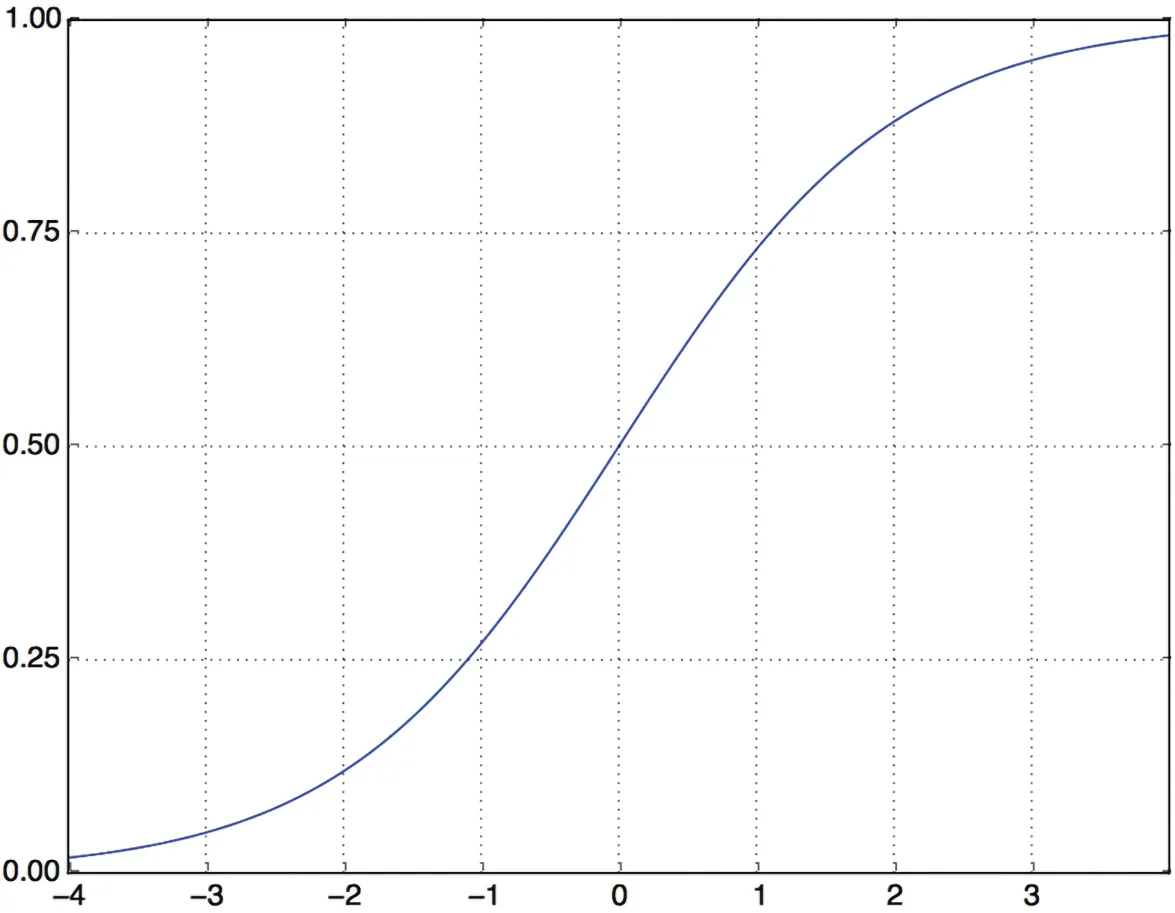
شکل ۴.۳: تابع sigmoid
در نهایت، باید یک تابع زیان و یک بهینهساز انتخاب کنید. از آنجا که با یک مسئلهٔ طبقهبندی دودویی روبرو هستید و خروجی مدل شما یک احتمال است (مدل خود را با یک لایهٔ تکواحدی با فعالسازی sigmoid به پایان میرسانید)، بهتر است از زیان binary_crossentropy استفاده کنید. این تنها انتخاب قابل اجرا نیست: میتوانستید برای مثال از mean_squared_error استفاده کنید. اما crossentropy معمولاً بهترین انتخاب است وقتی با مدلهایی سر و کار دارید که احتمال خروجی میدهند. Crossentropy کمیتی از حوزهٔ نظریهٔ اطلاعات است که فاصلهٔ بین توزیعهای احتمال یا، در این مورد، بین توزیع حقیقت پایه و پیشبینیهای شما را اندازهگیری میکند.
در مورد انتخاب بهینهساز، ما adam را انتخاب میکنیم که معمولاً یک انتخاب پیشفرض خوب برای تقریباً هر مسئلهای است.
این مرحلهای است که مدل را با بهینهساز adam و تابع زیان binary_crossentropy پیکربندی میکنید. توجه داشته باشید که دقت را نیز در طول آموزش نظارت خواهید کرد.
لیستینگ ۴.۵: کامپایل مدل
model.compile( optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"],)اعتبارسنجی رویکرد شما
Section titled “اعتبارسنجی رویکرد شما”همانطور که در فصل ۳ یاد گرفتید، یک مدل یادگیری عمیق هرگز نباید روی دادههای آموزشی خود ارزیابی شود — رویهٔ استاندارد استفاده از یک «مجموعهٔ اعتبارسنجی» برای نظارت بر دقت مدل در طول آموزش است. در اینجا، شما با کنار گذاشتن ۱۰,۰۰۰ نمونه از دادههای آموزشی اصلی، یک مجموعهٔ اعتبارسنجی ایجاد خواهید کرد.
ممکن است بپرسید، چرا بهسادگی از دادههای آزمون برای ارزیابی مدل استفاده نکنیم؟ به نظر میرسد این کار سادهتر باشد. دلیل آن این است که میخواهید از نتایجی که در مجموعهٔ اعتبارسنجی به دست میآورید برای راهنمایی انتخابهای بعدی خود بهمنظور بهبود آموزش استفاده کنید — برای مثال، انتخاب اندازهٔ مدل یا تعداد دورههایی که باید آموزش دهید. وقتی شروع به انجام این کار میکنید، امتیازات اعتبارسنجی شما دیگر بازتاب دقیقی از عملکرد مدل روی دادههای کاملاً جدید نخواهند بود، زیرا مدل بهطور عمدی برای عملکرد بهتر روی دادههای اعتبارسنجی تنظیم شده است. بهتر است همیشه مجموعهای از نمونههای هرگز دیده نشده را نگه دارید تا بتوانید دور نهایی ارزیابی را کاملاً بیطرفانه انجام دهید، و این دقیقاً همان کاری است که مجموعهٔ آزمون انجام میدهد. در فصل بعدی بیشتر در این مورد صحبت خواهیم کرد.
لیستینگ ۴.۶: کنار گذاشتن یک مجموعهٔ اعتبارسنجی
x_val = x_train[:10000]partial_x_train = x_train[10000:]y_val = y_train[:10000]partial_y_train = y_train[10000:]اکنون مدل را برای ۲۰ دوره (۲۰ تکرار روی تمام نمونههای موجود در دادههای آموزش)، در دستههای کوچک (mini-batches) با ۵۱۲ نمونه آموزش خواهید داد. همزمان، زیان و دقت را روی ۱۰,۰۰۰ نمونهای که کنار گذاشتهاید نظارت خواهید کرد. این کار را با ارسال دادههای اعتبارسنجی به عنوان آرگومان validation_data به model.fit() انجام میدهید.
لیستینگ ۴.۷: آموزش مدل شما
history = model.fit( partial_x_train, partial_y_train, epochs=20, batch_size=512, validation_data=(x_val, y_val),)روی CPU، این کار کمتر از ۲ ثانیه در هر دوره طول میکشد — آموزش در ۲۰ ثانیه به پایان میرسد. در پایان هر دوره، یک مکث کوتاه وجود دارد زیرا مدل زیان و دقت خود را روی ۱۰,۰۰۰ نمونه از دادههای اعتبارسنجی محاسبه میکند.
توجه داشته باشید که فراخوانی model.fit() یک شیء History را برمیگرداند، همانطور که در فصل ۳ دیدید. این شیء عضوی به نام history دارد که دیکشنری شامل دادههایی دربارهٔ تمام اتفاقاتی است که در طول آموزش رخ داده است. بیایید نگاهی به آن بیندازیم:
>>> history_dict = history.history>>> history_dict.keys()این دیکشنری شامل چهار ورودی است: یکی برای هر معیاری که در طول آموزش و اعتبارسنجی نظارت میشد. در دو لیستینگ زیر، بیایید از Matplotlib برای رسم زیان آموزش و اعتبارسنجی در کنار یکدیگر (شکل ۴.۴ را ببینید)، و همچنین دقت آموزش و اعتبارسنجی (شکل ۴.۵ را ببینید) استفاده کنیم. توجه داشته باشید که نتایج شما ممکن است به دلیل مقداردهی اولیهٔ تصادفی متفاوت برای مدل شما، اندکی تفاوت داشته باشد.
لیستینگ ۴.۸: رسم زیان آموزش و اعتبارسنجی
import matplotlib.pyplot as plt
history_dict = history.historyloss_values = history_dict["loss"]val_loss_values = history_dict["val_loss"]epochs = range(1, len(loss_values) + 1)# "r--" is for "dashed red line."plt.plot(epochs, loss_values, "r--", label="Training loss")# "b" is for "solid blue line."plt.plot(epochs, val_loss_values, "b", label="Validation loss")plt.title("[IMDB] Training and validation loss")plt.xlabel("Epochs")plt.xticks(epochs)plt.ylabel("Loss")plt.legend()plt.show()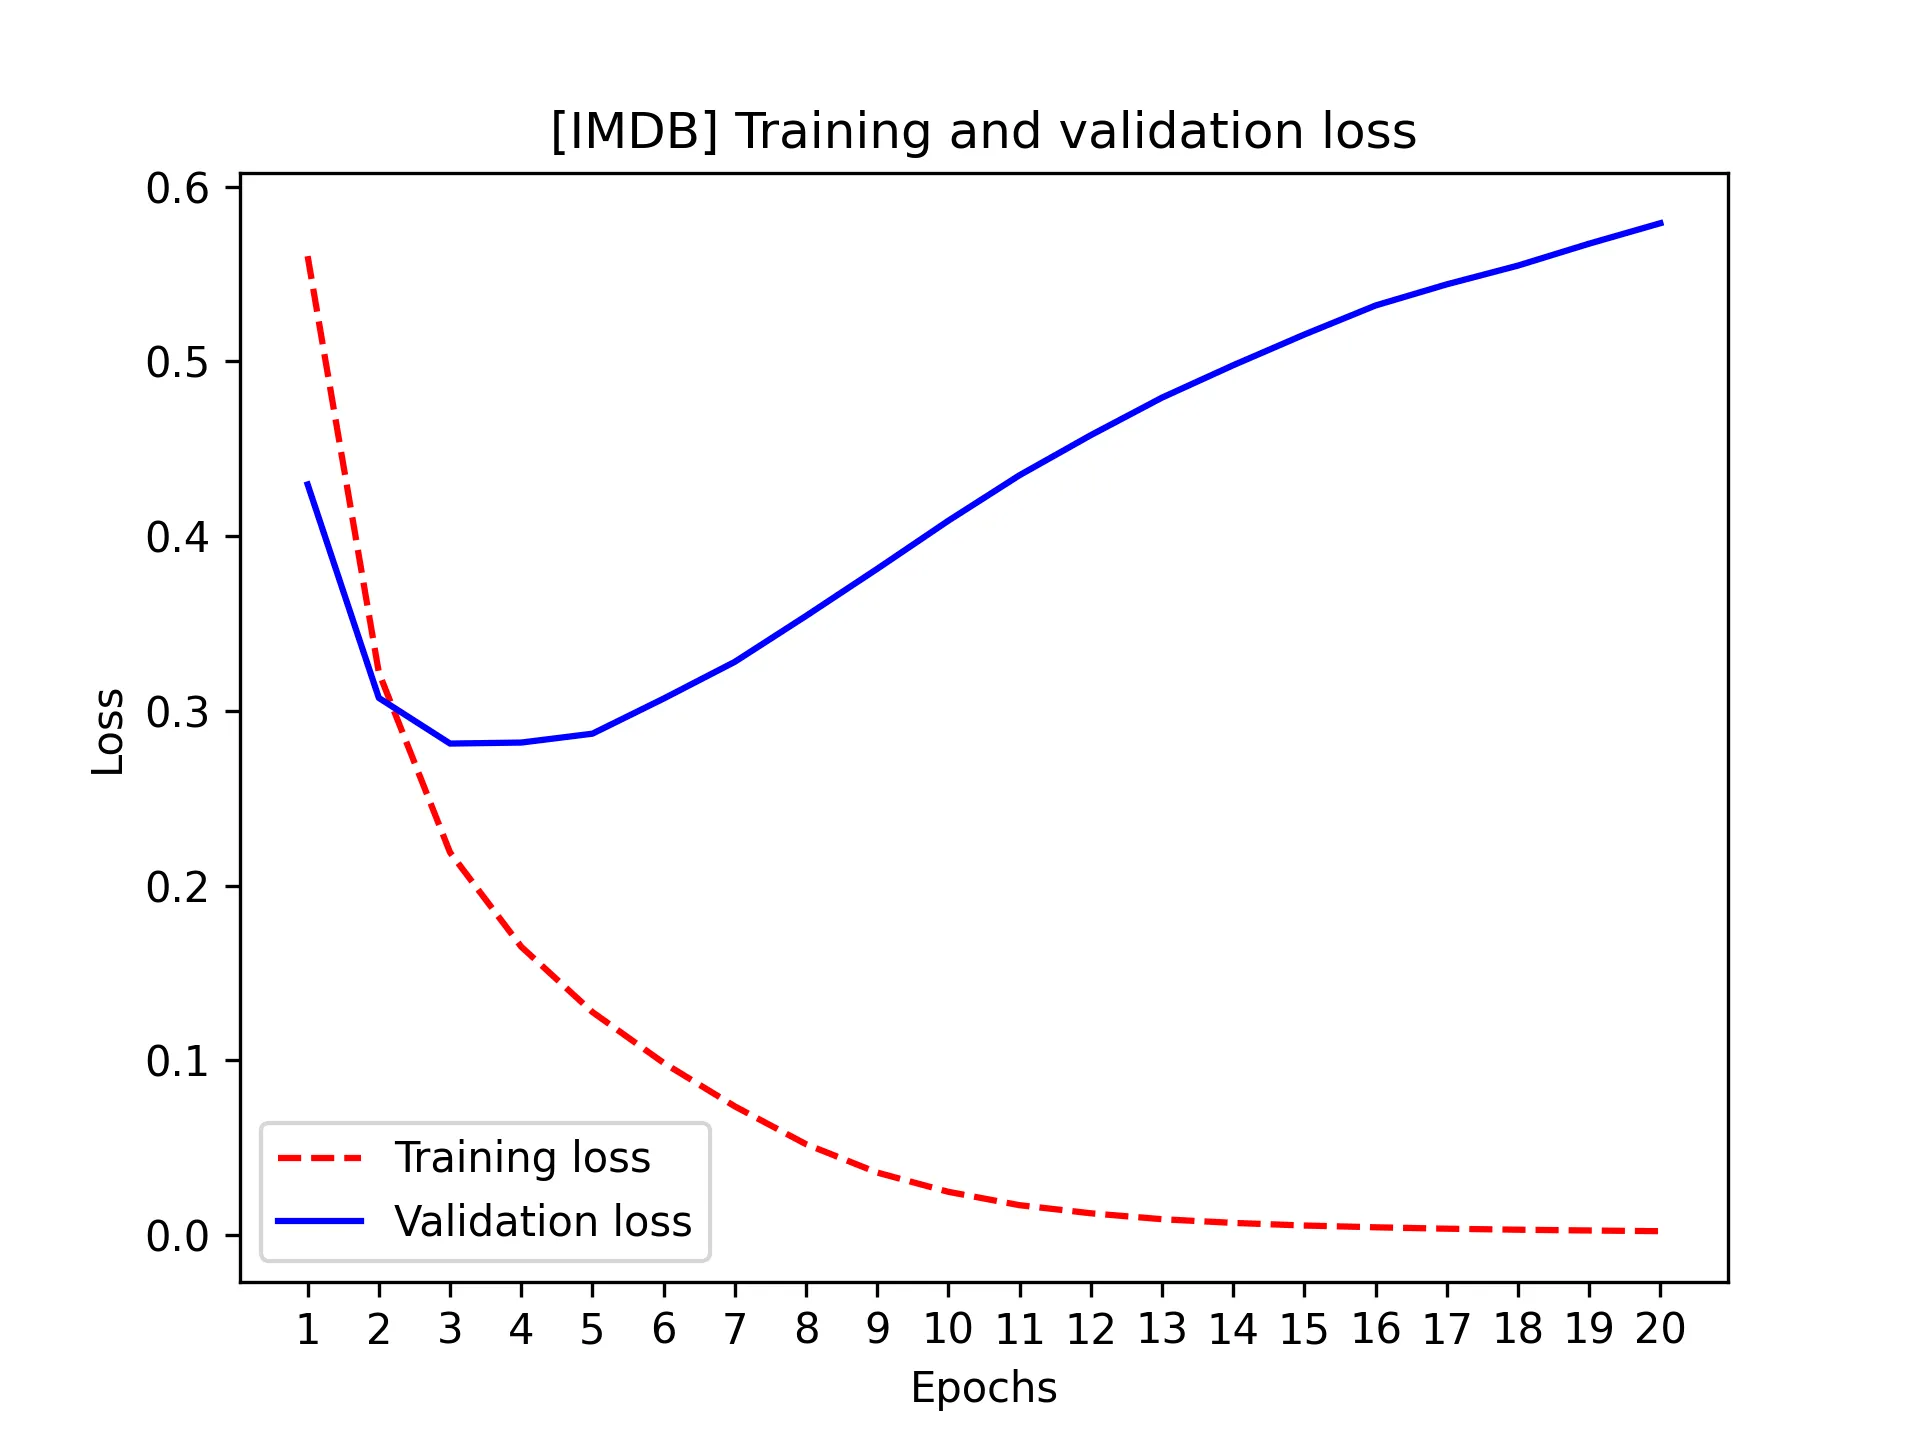
شکل ۴.۴: زیان آموزش و اعتبارسنجی
لیستینگ ۴.۹: رسم دقت آموزش و اعتبارسنجی
# Clears the figureplt.clf()acc = history_dict["accuracy"]val_acc = history_dict["val_accuracy"]plt.plot(epochs, acc, "r--", label="Training acc")plt.plot(epochs, val_acc, "b", label="Validation acc")plt.title("[IMDB] Training and validation accuracy")plt.xlabel("Epochs")plt.xticks(epochs)plt.ylabel("Accuracy")plt.legend()plt.show()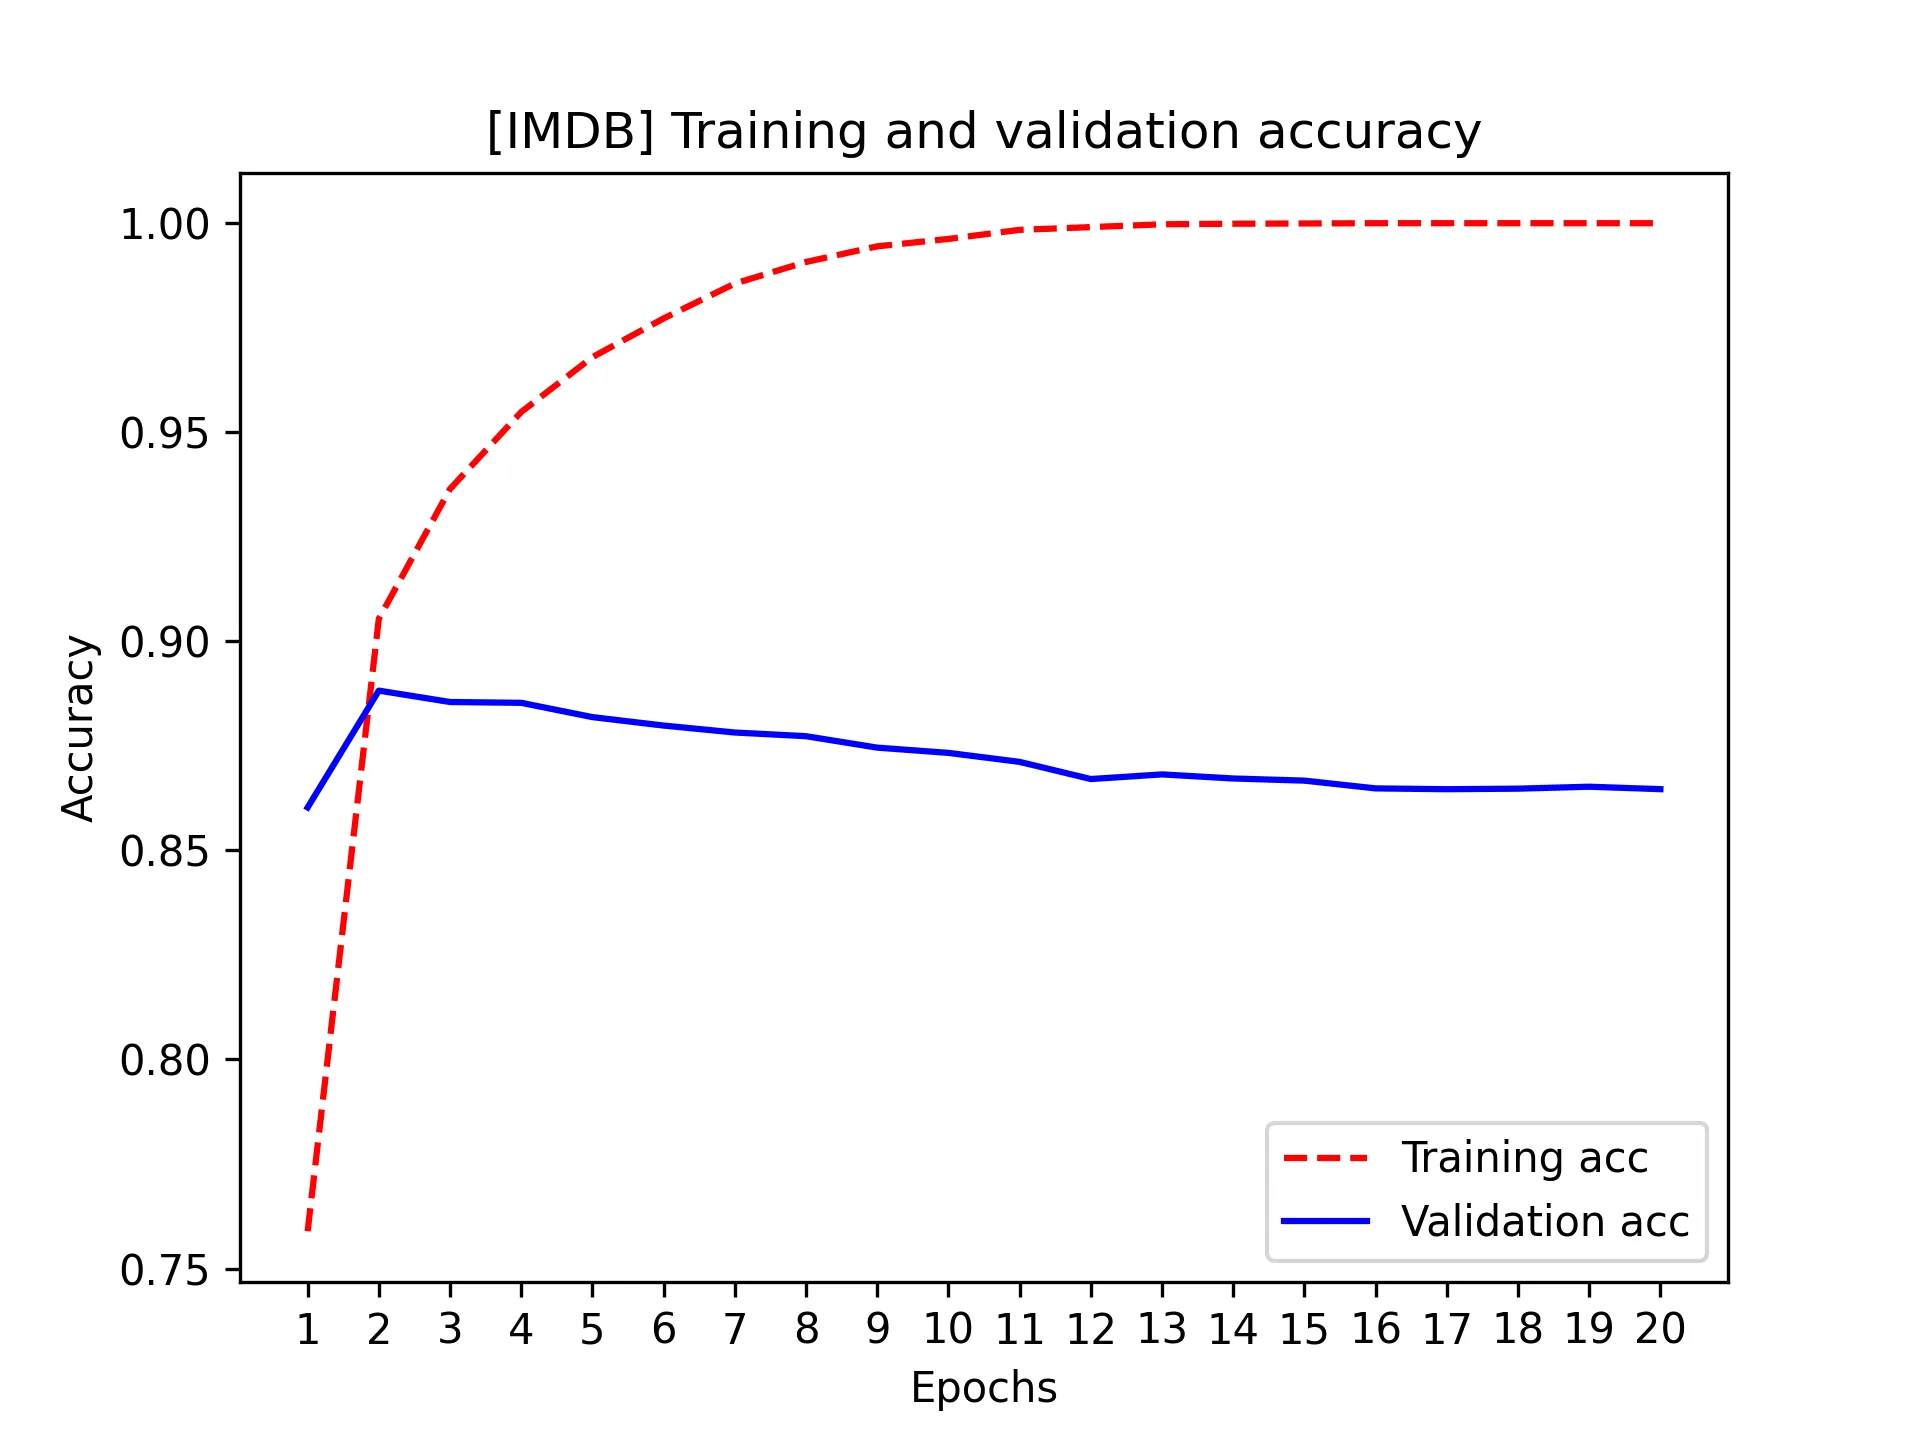
شکل ۴.۵: دقت آموزش و اعتبارسنجی
همانطور که میبینید، زیان آموزش با هر دوره کاهش مییابد و دقت آموزش با هر دوره افزایش پیدا میکند. این همان چیزی است که هنگام اجرای بهینهسازی نزول گرادیان انتظار دارید — مقداری که سعی در کمینهسازی آن دارید باید با هر تکرار کمتر شود. اما این موضوع برای زیان و دقت اعتبارسنجی صدق نمیکند: به نظر میرسد آنها در دورهٔ چهارم به اوج خود میرسند. این نمونهای از چیزی است که قبلاً در مورد آن هشدار دادیم: مدلی که عملکرد بهتری روی دادههای آموزش دارد، لزوماً مدلی نیست که روی دادههایی که قبلاً هرگز ندیده است بهتر عمل کند. به بیان دقیق، آنچه مشاهده میکنید بیشبرازش (overfitting) است: پس از دورهٔ چهارم، شما بیشازحد روی دادههای آموزش بهینهسازی میکنید و در نهایت بازنماییهایی را یاد میگیرید که مختص دادههای آموزش هستند و به دادههای خارج از مجموعهٔ آموزش تعمیم نمییابند.
در این حالت، برای جلوگیری از بیشبرازش، میتوانید آموزش را پس از چهار دوره متوقف کنید. بهطور کلی، میتوانید از طیف وسیعی از تکنیکها برای کاهش بیشبرازش استفاده کنید که در فصل ۵ آنها را بررسی خواهیم کرد.
بیایید یک مدل جدید را از ابتدا به مدت چهار دوره آموزش دهیم و سپس آن را روی دادههای آزمون ارزیابی کنیم.
لیستینگ ۴.۱۰: آموزش مدل برای چهار دوره
model = keras.Sequential( [ layers.Dense(16, activation="relu"), layers.Dense(16, activation="relu"), layers.Dense(1, activation="sigmoid"), ])model.compile( optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"],)model.fit(x_train, y_train, epochs=4, batch_size=512)results = model.evaluate(x_test, y_test)نتایج نهایی به شرح زیر است:
>>> resultsاین رویکرد نسبتاً ساده به دقت ۸۸٪ دست مییابد. با رویکردهای پیشرفتهتر، باید بتوانید به حدود ۹۵٪ نزدیک شوید.
استفاده از مدل آموزشدیده برای تولید پیشبینی روی دادههای جدید
Section titled “استفاده از مدل آموزشدیده برای تولید پیشبینی روی دادههای جدید”پس از آموزش یک مدل، میخواهید از آن در یک محیط عملی استفاده کنید. میتوانید با استفاده از متد predict احتمال مثبت بودن نقدها را ایجاد کنید، همانطور که در فصل ۳ آموختید:
>>> model.predict(x_test)همانطور که میبینید، مدل برای برخی نمونهها مطمئن است (۰.۹۹ یا بیشتر، یا ۰.۰۱ یا کمتر) اما برای برخی دیگر اطمینان کمتری دارد (۰.۶، ۰.۴).
آزمایشهای بیشتر
Section titled “آزمایشهای بیشتر”آزمایشهای زیر کمک میکنند تا متقاعد شوید انتخابهای معماری که انجام دادهاید همگی نسبتاً معقول بودهاند، هرچند هنوز جایی برای بهبود وجود دارد:
- شما از دو لایهٔ بازنمایی قبل از لایهٔ طبقهبندی نهایی استفاده کردید. سعی کنید از یک یا سه لایهٔ بازنمایی استفاده کنید و ببینید این کار چگونه بر دقت اعتبارسنجی و آزمون تأثیر میگذارد.
- سعی کنید از لایههایی با واحدهای بیشتر یا واحدهای کمتر استفاده کنید: ۳۲ واحد، ۶۴ واحد و غیره.
- سعی کنید به جای تابع زیان
binary_crossentropyازmean_squared_errorاستفاده کنید. - سعی کنید به جای
reluاز تابع فعالسازیtanh(فعالسازیای که در روزهای اولیهٔ شبکههای عصبی محبوب بود) استفاده کنید.
جمعبندی
Section titled “جمعبندی”نکات کلیدی که باید از این مثال به خاطر بسپارید عبارتند از:
- معمولاً باید پیشپردازشهای قابل توجهی روی دادههای خام خود انجام دهید تا بتوانید آنها را — بهصورت تانسورها — به یک شبکهٔ عصبی تغذیه کنید. دنبالههای کلمات را میتوان به عنوان بردارهای دودویی کدگذاری کرد، اما گزینههای کدگذاری دیگری نیز وجود دارند.
- پشتههایی از لایههای
Denseبا فعالسازیهایreluمیتوانند طیف گستردهای از مسائل (از جمله طبقهبندی احساسات) را حل کنند و شما مکرراً از آنها استفاده خواهید کرد. - در یک مسئلهٔ طبقهبندی دودویی (دو کلاس خروجی)، مدل شما باید با یک لایهٔ
Denseبا یک واحد و فعالسازیsigmoidبه پایان برسد: خروجی مدل شما باید یک اسکالر بین ۰ و ۱ باشد که یک احتمال را کدگذاری میکند. - با چنین خروجی سیگموئید اسکالری در یک مسئلهٔ طبقهبندی دودویی، تابع زیانی که باید استفاده کنید
binary_crossentropyاست. - بهینهساز
adamبهطور کلی برای تقریباً هر مسئلهای انتخابی به اندازهٔ کافی خوب است. این یک دغدغه کمتر برای شماست. - شبکههای عصبی همزمان با اینکه روی دادههای آموزش خود بهتر میشوند، در نهایت شروع به بیشبرازش میکنند و نتایج به مراتب بدتری روی دادههایی که ندیدهاند به دست میآورند. مطمئن شوید که همیشه عملکرد را روی دادههایی خارج از مجموعهٔ آموزش نظارت میکنید!
طبقهبندی خبرها: یک مثال طبقهبندی چندکلاسه
Section titled “طبقهبندی خبرها: یک مثال طبقهبندی چندکلاسه”در بخش قبل، دیدید که چگونه ورودیهای برداری را با استفاده از یک شبکهٔ عصبی متراکم (densely connected) به دو کلاس متقابلاً منحصربهفرد طبقهبندی کنید. اما وقتی بیش از دو کلاس داشته باشید چه اتفاقی میافتد؟
در این بخش، مدلی برای طبقهبندی خبرهای رویترز (Reuters) به ۴۶ موضوع متقابلاً منحصربهفرد خواهید ساخت. از آنجا که کلاسهای زیادی دارید، این مسئله نمونهای از طبقهبندی چندکلاسه (multiclass classification) است، و از آنجا که هر نقطهٔ داده باید تنها در یک دسته طبقهبندی شود، مسئله دقیقتر یک نمونه از طبقهبندی چندکلاسهٔ تکبرچسبی (single-label, multiclass classification) است. اگر هر نقطهٔ داده میتوانست متعلق به چندین دسته (مثلاً چندین موضوع) باشد، این یک مسئلهٔ طبقهبندی چندکلاسهٔ چندبرچسبی (multilabel multiclass classification) میبود.
مجموعهدادهٔ رویترز
Section titled “مجموعهدادهٔ رویترز”شما با مجموعهدادهٔ رویترز کار خواهید کرد؛ مجموعهای از خبرهای کوتاه و موضوعات آنها که توسط رویترز در سال ۱۹۸۶ منتشر شده است. این یک مجموعهدادهٔ اسباببازی بسیار ساده و پرکاربرد برای طبقهبندی متن است. ۴۶ موضوع مختلف وجود دارد؛ برخی موضوعات نسبت به سایرین بازنمایی بیشتری دارند، اما هر موضوع حداقل ۱۰ نمونه در مجموعهٔ آموزش دارد.
همانند IMDb و MNIST، مجموعهدادهٔ رویترز نیز به عنوان بخشی از Keras بستهبندی شده است. بیایید نگاهی به آن بیندازیم.
لیستینگ ۴.۱۱: بارگذاری مجموعهدادهٔ رویترز
from keras.datasets import reuters
(train_data, train_labels), (test_data, test_labels) = reuters.load_data(    num_words=10000)
همانند مجموعهدادهٔ IMDb، آرگومان num_words=10000 دادهها را به ۱۰,۰۰۰ کلمهٔ پرتکرار موجود در دادهها محدود میکند.
شما ۸,۹۸۲ نمونهٔ آموزش و ۲,۲۴۶ نمونهٔ آزمون دارید:
>>> len(train_data)همانند نقدهای IMDb، هر نمونه لیستی از اعداد صحیح (شناسههای کلمات) است:
>>> train_data[10]در صورت کنجکاوی، در اینجا نحوهٔ رمزگشایی مجدد آن به کلمات آورده شده است.
لیستینگ ۴.۱۲: رمزگشایی خبرها به متن
word_index = reuters.get_word_index()reverse_word_index = dict([(value, key) for (key, value) in word_index.items()])decoded_newswire = " ".join( # The indices are offset by 3 because 0, 1, and 2 are reserved # indices for "padding," "start of sequence," and "unknown." [reverse_word_index.get(i - 3, "?") for i in train_data[10]])برچسب مرتبط با یک نمونه یک عدد صحیح بین ۰ و ۴۵ است — شاخص موضوع:
>>> train_labels[10]آمادهسازی دادهها
Section titled “آمادهسازی دادهها”میتوانید دادهها را دقیقاً با همان کدی که در مثال قبلی استفاده کردید برداریسازی کنید.
لیستینگ ۴.۱۳: کدگذاری دادههای ورودی
# Vectorized training datax_train = multi_hot_encode(train_data, num_classes=10000)# Vectorized test datax_test = multi_hot_encode(test_data, num_classes=10000)برای برداریسازی برچسبها، دو احتمال وجود دارد: میتوانید برچسبها را به همان شکل فعلی (به صورت اعداد صحیح) رها کنید، یا میتوانید از کدگذاری وان-هات (one-hot encoding) استفاده کنید. کدگذاری وان-هات یک قالب پرکاربرد برای دادههای دستهای است که کدگذاری دستهای (categorical encoding) نیز نامیده میشود. در این مورد، کدگذاری وان-هات برچسبهای ما شامل جاسازی هر برچسب به عنوان یک بردار تمامصفر با طول ۴۶ است که در آن شاخص مربوط به برچسب مقدار ۱ دارد. در اینجا مثالی از نحوهٔ انجام دستی آن آورده شده است:
لیستینگ ۴.۱۴: کدگذاری برچسبها
def one_hot_encode(labels, num_classes=46):    results = np.zeros((len(labels), num_classes))    for i, label in enumerate(labels):        results[i, label] = 1.0    return results
# Vectorized training labelsy_train = one_hot_encode(train_labels)# Vectorized test labelsy_test = one_hot_encode(test_labels)
توجه داشته باشید که روشی داخلی در Keras برای انجام این کار وجود دارد:
from keras.utils import to_categorical
y_train = to_categorical(train_labels)y_test = to_categorical(test_labels)
ساختن مدل شما
Section titled “ساختن مدل شما”این مسئلهٔ طبقهبندی موضوع شبیه به مثال قبلی طبقهبندی نقدهای فیلم به نظر میرسد: در هر دو مورد، در حال تلاش برای طبقهبندی برشهای کوتاه متن هستیم. اما یک محدودیت جدید در اینجا وجود دارد: تعداد کلاسهای خروجی از ۲ به ۴۶ افزایش یافته است. بعد فضای خروجی بسیار بزرگتر است.
در پشتهای از لایههای Dense مانند آنچه قبلاً استفاده میکردید، هر لایه فقط میتواند به اطلاعاتی دسترسی داشته باشد که در خروجی لایهٔ قبلی وجود دارد. اگر یک لایه برخی از اطلاعات مرتبط با مسئلهٔ طبقهبندی را حذف کند، این اطلاعات هرگز توسط لایههای بعدی قابل بازیابی نیستند: هر لایه بهطور بالقوه میتواند به یک گلوگاه اطلاعاتی (information bottleneck) تبدیل شود. در مثال قبلی، از لایههای میانی ۱۶ بعدی استفاده کردید، اما یک فضای ۱۶ بعدی ممکن است برای یادگیری تفکیک بین ۴۶ کلاس مختلف بیشازحد محدود باشد: چنین لایههای کوچکی ممکن است به عنوان گلوگاه اطلاعاتی عمل کرده و اطلاعات مفید را بهطور دائمی حذف کنند.
به همین دلیل، شما از لایههای میانی بزرگتری استفاده خواهید کرد. بیایید ۶۴ واحد را انتخاب کنیم.
لیستینگ ۴.۱۵: تعریف مدل
model = keras.Sequential( [ layers.Dense(64, activation="relu"), layers.Dense(64, activation="relu"), layers.Dense(46, activation="softmax"), ])دو نکتهٔ دیگر وجود دارد که باید در مورد این معماری به آنها توجه کنید:
- شما مدل را با یک لایهٔ
Denseبا اندازهٔ ۴۶ به پایان میرسانید. این بدان معناست که برای هر نمونهٔ ورودی، شبکه یک بردار خروجی ۴۶ بعدی تولید خواهد کرد. هر بعد در این بردار یک کلاس خروجی متفاوت را کدگذاری میکند. - لایهٔ آخر از فعالسازی
softmaxاستفاده میکند. شما این الگو را در مثال MNIST دیدید. این بدان معناست که مدل یک توزیع احتمال روی ۴۶ کلاس خروجی مختلف تولید خواهد کرد — برای هر نمونهٔ ورودی، مدل یک بردار خروجی ۴۶ بعدی تولید میکند که در آنoutput[i]احتمال تعلق نمونه به کلاسiاست. مجموع این ۴۶ امتیاز برابر با ۱ خواهد بود.
بهترین تابع زیان برای استفاده در این مورد categorical_crossentropy است. این تابع فاصلهٔ بین دو توزیع احتمال را اندازهگیری میکند: در اینجا، بین توزیع احتمال خروجی توسط شبکه و توزیع واقعی برچسبها. با کمینهسازی فاصله بین این دو توزیع، شبکه را آموزش میدهید تا خروجیهایی تولید کند که تا حد ممکن به برچسبهای واقعی نزدیک باشند.
همانند بار قبل، دقت را نیز نظارت خواهیم کرد. با این حال، دقت ممکن است کمی فریبنده باشد وقتی تعداد زیادی کلاس داریم که توزیع نامتعادلی دارند. برای نمونههایی که تشخیص آنها دشوار است، ممکن است مدل ما پیشبینی درستی نداشته باشد، اما پاسخ صحیح همچنان در میان چند احتمال برتر آن قرار گیرد. برای نظارت بر این موضوع، میتوانیم معیاری به نام دقت ۳تای برتر (top-3 accuracy) را اضافه کنیم که بررسی میکند آیا برچسب هدف در بین ۳ حدس برتر مدل قرار دارد یا خیر:
لیستینگ ۴.۱۶: کامپایل مدل
top_3_accuracy = keras.metrics.TopKCategoricalAccuracy( k=3, name="top_3_accuracy")model.compile( optimizer="adam", loss="categorical_crossentropy", metrics=["accuracy", top_3_accuracy],)اعتبارسنجی رویکرد شما
Section titled “اعتبارسنجی رویکرد شما”بیایید ۱,۰۰۰ نمونه در دادههای آموزشی را کنار بگذاریم تا به عنوان مجموعهٔ اعتبارسنجی استفاده شوند.
لیستینگ ۴.۱۷: کنار گذاشتن یک مجموعهٔ اعتبارسنجی
x_val = x_train[:1000]partial_x_train = x_train[1000:]y_val = y_train[:1000]partial_y_train = y_train[1000:]اکنون، بیایید مدل را برای ۲۰ دوره آموزش دهیم.
لیستینگ ۴.۱۸: آموزش مدل
history = model.fit( partial_x_train, partial_y_train, epochs=20, batch_size=512, validation_data=(x_val, y_val),)و در نهایت، بیایید منحنیهای زیان و دقت آن را نمایش دهیم (شکلهای ۴.۶ و ۴.۷ را ببینید).
لیستینگ ۴.۱۹: رسم زیان آموزش و اعتبارسنجی
loss = history.history["loss"]val_loss = history.history["val_loss"]epochs = range(1, len(loss) + 1)plt.plot(epochs, loss, "r--", label="Training loss")plt.plot(epochs, val_loss, "b", label="Validation loss")plt.title("Training and validation loss")plt.xlabel("Epochs")plt.xticks(epochs)plt.ylabel("Loss")plt.legend()plt.show()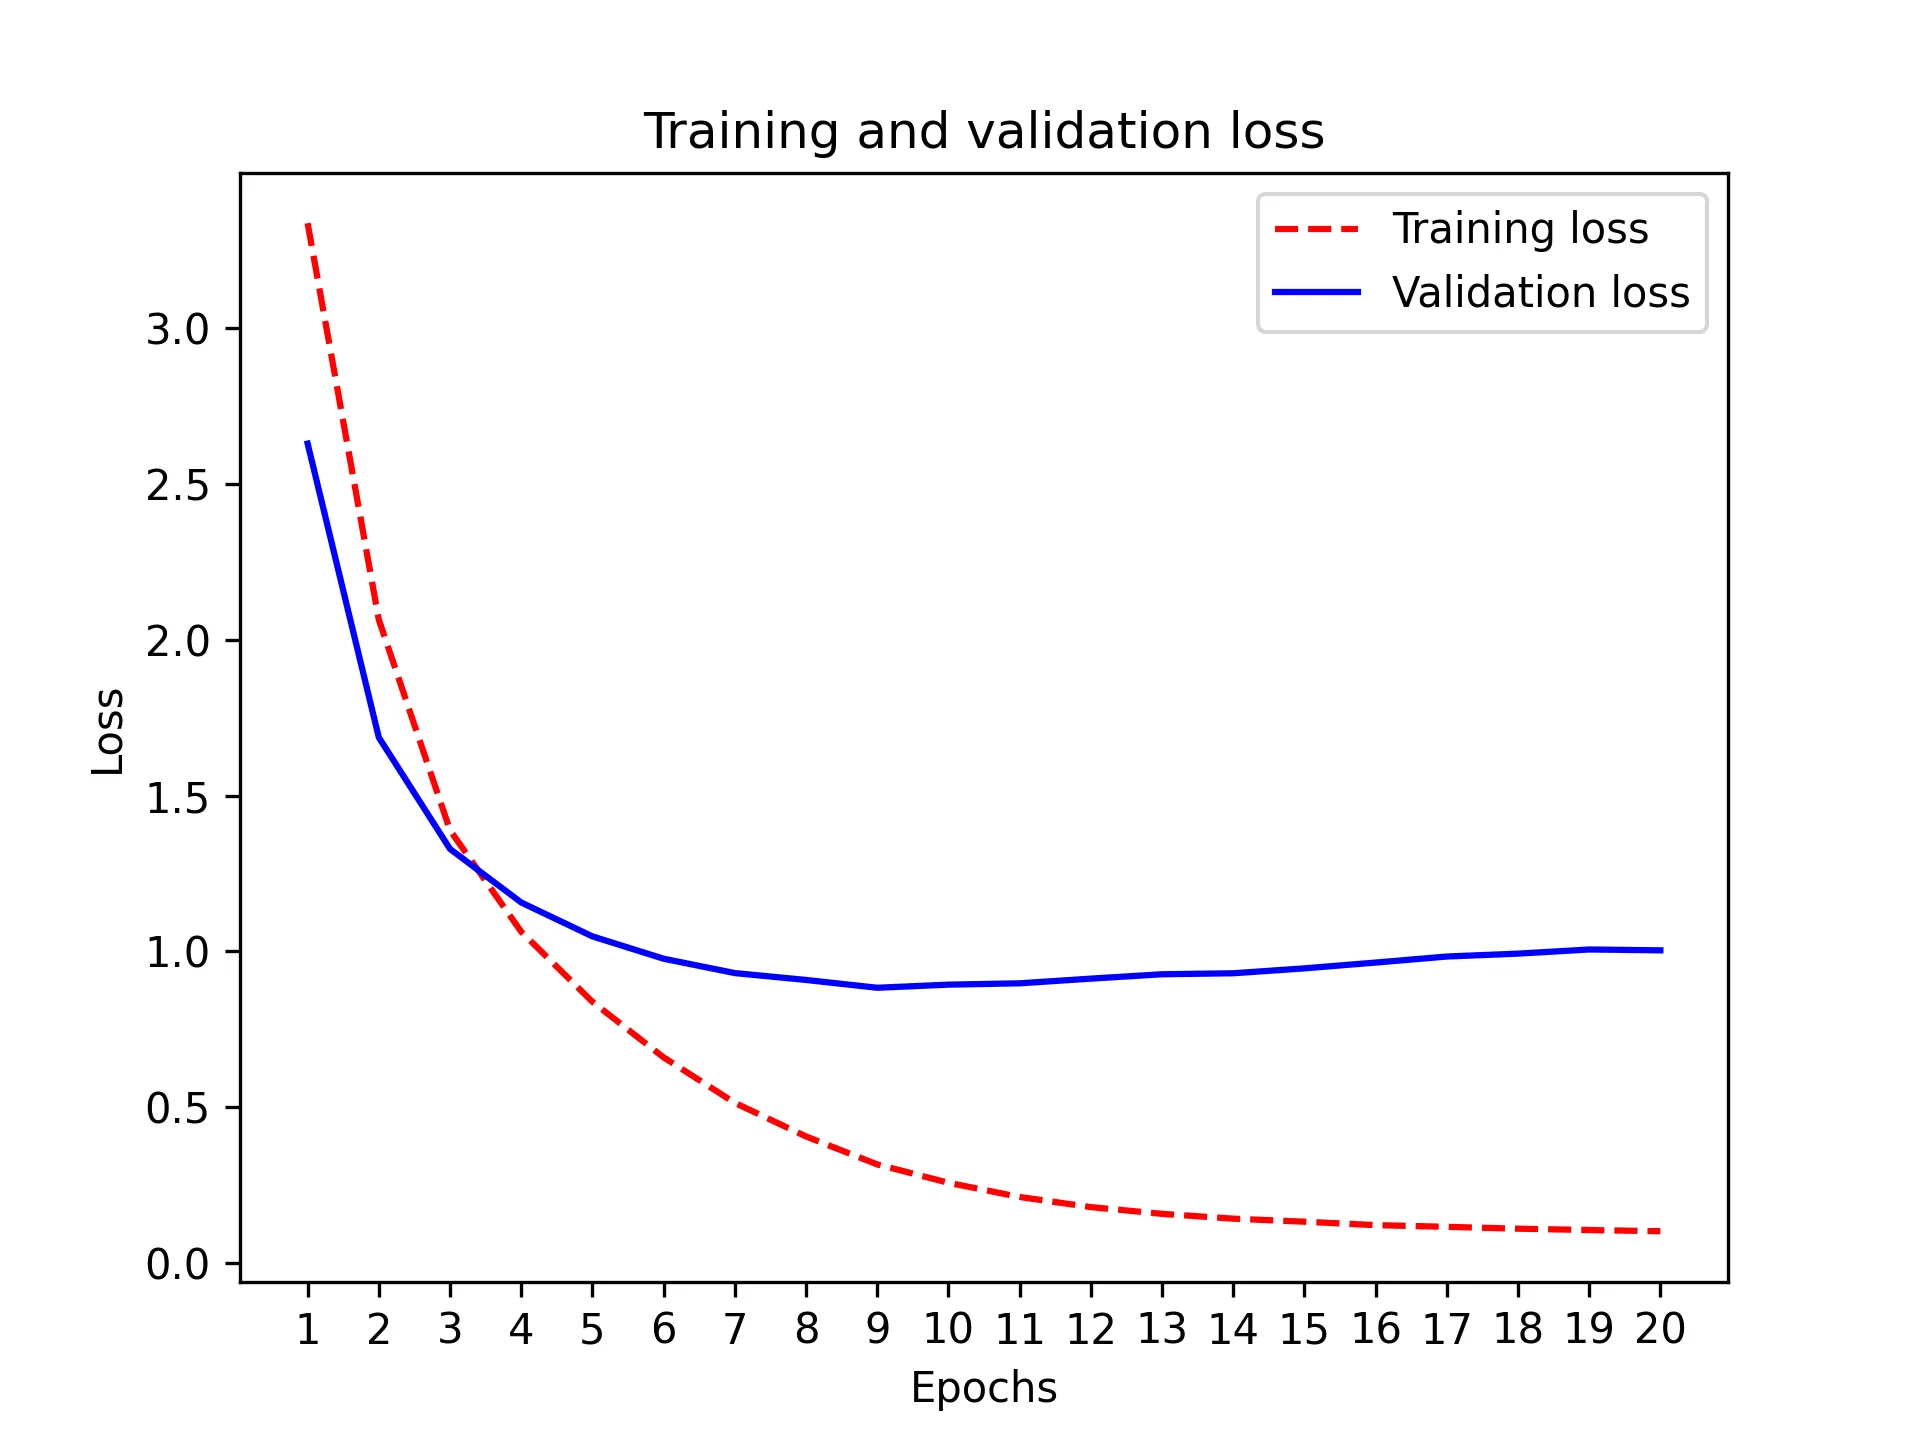
شکل ۴.۶: زیان آموزش و اعتبارسنجی
لیستینگ ۴.۲۰: رسم دقت آموزش و اعتبارسنجی
plt.clf()acc = history.history["accuracy"]val_acc = history.history["val_accuracy"]plt.plot(epochs, acc, "r--", label="Training accuracy")plt.plot(epochs, val_acc, "b", label="Validation accuracy")plt.title("Training and validation accuracy")plt.xlabel("Epochs")plt.xticks(epochs)plt.ylabel("Accuracy")plt.legend()plt.show()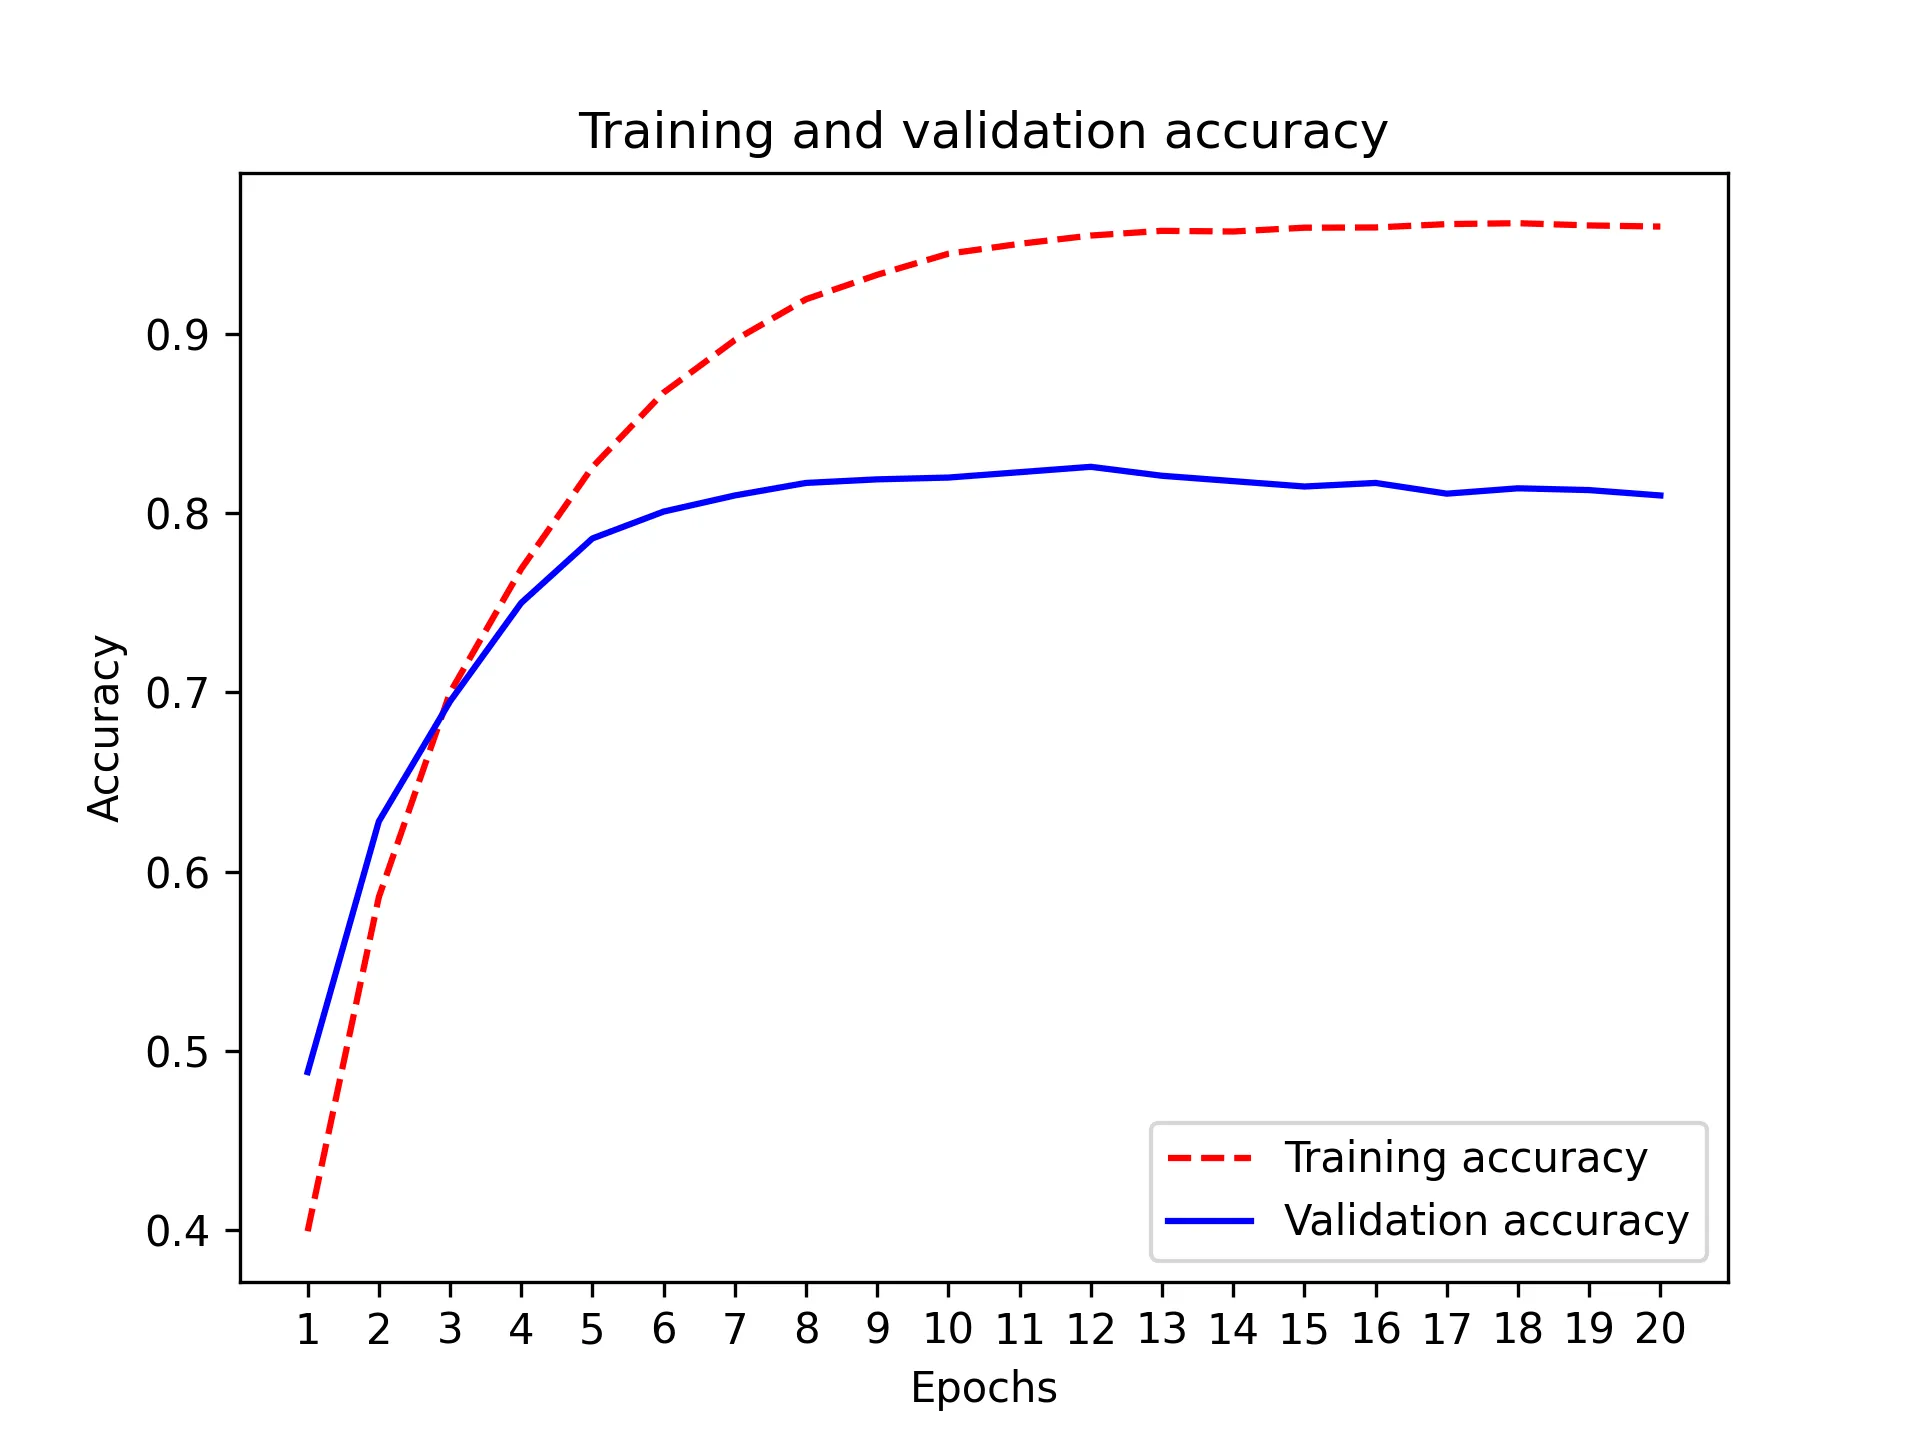
شکل ۴.۷: دقت آموزش و اعتبارسنجی
همچنین میتوانیم دقت ۳تای برتر را رسم کنیم (شکل ۴.۸ را ببینید).
لیستینگ ۴.۲۱: رسم دقت ۳تای برتر آموزش و اعتبارسنجی
plt.clf()acc = history.history["top_3_accuracy"]val_acc = history.history["val_top_3_accuracy"]plt.plot(epochs, acc, "r--", label="Training top-3 accuracy")plt.plot(epochs, val_acc, "b", label="Validation top-3 accuracy")plt.title("Training and validation top-3 accuracy")plt.xlabel("Epochs")plt.xticks(epochs)plt.ylabel("Top-3 accuracy")plt.legend()plt.show()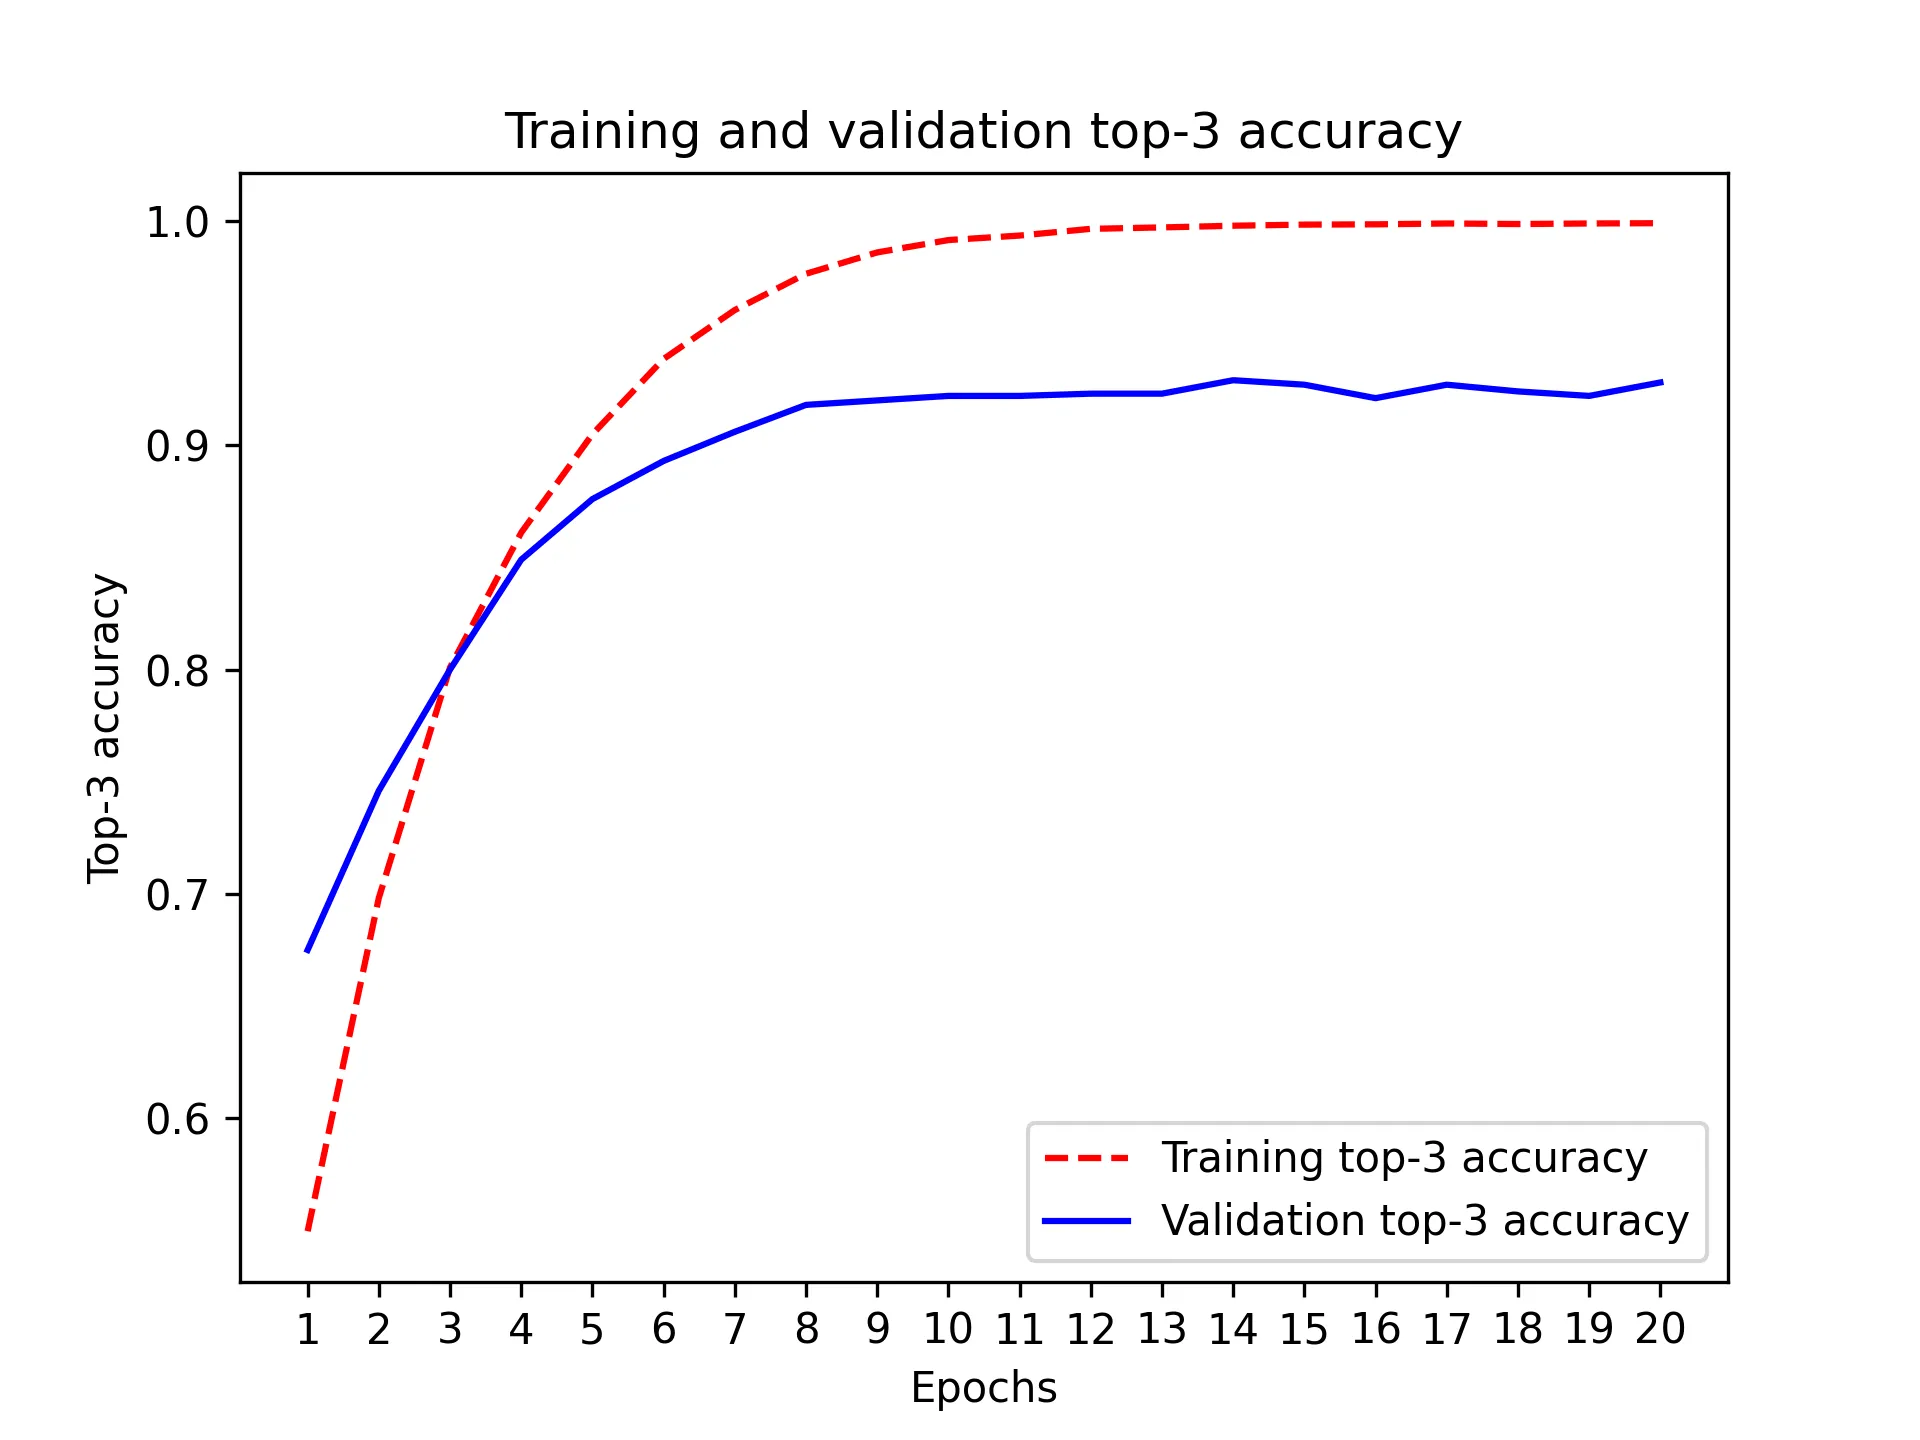
شکل ۴.۸: دقت آموزش و اعتبارسنجی
مدل پس از ۹ دوره شروع به بیشبرازش میکند. بیایید یک مدل جدید را از ابتدا به مدت ۹ دوره آموزش دهیم و سپس آن را روی مجموعهٔ آزمون ارزیابی کنیم.
لیستینگ ۴.۲۲: بازآموزی یک مدل از ابتدا
model = keras.Sequential( [ layers.Dense(64, activation="relu"), layers.Dense(64, activation="relu"), layers.Dense(46, activation="softmax"), ])model.compile( optimizer="adam", loss="categorical_crossentropy", metrics=["accuracy"],)model.fit( x_train, y_train, epochs=9, batch_size=512,)results = model.evaluate(x_test, y_test)در اینجا نتایج نهایی آمده است:
>>> resultsاین رویکرد به دقت تقریبی ۸۰٪ میرسد. در یک مسئلهٔ طبقهبندی دودویی متوازن، امتیازی که توسط یک طبقهبند کاملاً تصادفی به دست میآید ۵۰٪ است. اما در این مورد، یک خط پایهٔ تصادفی چگونه عمل میکند؟ میتوانیم با پیادهسازی یک خط پایهٔ تصادفی سریعاً آن را بررسی کنیم:
>>> import copy>>> test_labels_copy = copy.copy(test_labels)>>> np.random.shuffle(test_labels_copy)>>> hits_array = np.array(test_labels == test_labels_copy)>>> hits_array.mean()همانطور که میبینید، یک طبقهبند تصادفی به دقت طبقهبندی حدود ۱۹٪ میرسد، بنابراین نتایج مدل ما در مقایسه بسیار خوب به نظر میرسند.
تولید پیشبینیها روی دادههای جدید
Section titled “تولید پیشبینیها روی دادههای جدید”فراخوانی متد predict مدل روی نمونههای جدید، یک توزیع احتمال روی تمام ۴۶ موضوع را برمیگرداند. بیایید پیشبینیهای موضوع را برای تمام دادههای آزمون تولید کنیم:
predictions = model.predict(x_test)هر ورودی در «predictions» یک بردار با طول ۴۶ است:
>>> predictions[0].shapeضرایب این بردار برابر با ۱ جمع میشوند، زیرا یک توزیع احتمال را تشکیل میدهند:
>>> np.sum(predictions[0])بزرگترین ورودی، کلاس پیشبینیشده است — کلاسی با بیشترین احتمال:
>>> np.argmax(predictions[0])روشی دیگر برای مدیریت برچسبها و زیان
Section titled “روشی دیگر برای مدیریت برچسبها و زیان”پیشتر اشاره کردیم که روش دیگر برای کدگذاری برچسبها، رها کردن آنها به عنوان اعداد صحیح است:
y_train = train_labelsy_test = test_labelsتنها چیزی که این رویکرد تغییر میدهد، انتخاب تابع زیان است. تابع زیانی که در لیستینگ ۴.۱۶ استفاده شد، categorical_crossentropy، انتظار دارد که برچسبها از یک کدگذاری دستهای (وان-هات) پیروی کنند. با برچسبهای عدد صحیح، باید از sparse_categorical_crossentropy استفاده کنید:
model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)این تابع زیان جدید هنوز از نظر ریاضی دقیقاً همان categorical_crossentropy است؛ فقط یک رابط کاربری متفاوت دارد.
اهمیت داشتن لایههای میانی به اندازهٔ کافی بزرگ
Section titled “اهمیت داشتن لایههای میانی به اندازهٔ کافی بزرگ”قبلاً اشاره کردیم که از آنجا که خروجیهای نهایی ۴۶ بعدی هستند، باید از لایههای میانی با کمتر از ۴۶ بعد اجتناب کنید. اکنون بیایید ببینیم چه اتفاقی میافتد وقتی با معرفی لایههای میانی که بهطور قابل توجهی کمتر از ۴۶ بعدی هستند (برای مثال ۴ بعدی)، یک گلوگاه اطلاعاتی ایجاد کنیم.
لیستینگ ۴.۲۳: مدلی با یک گلوگاه اطلاعاتی
model = keras.Sequential( [ layers.Dense(64, activation="relu"), layers.Dense(4, activation="relu"), layers.Dense(46, activation="softmax"), ])model.compile( optimizer="adam", loss="categorical_crossentropy", metrics=["accuracy"],)model.fit( partial_x_train, partial_y_train, epochs=20, batch_size=128, validation_data=(x_val, y_val),)مدل اکنون در حدود ۷۱٪ به اوج دقت اعتبارسنجی خود میرسد که کاهشی مطلق به میزان ۸٪ است.
این افت عمدتاً ناشی از این واقعیت است که سعی میکنید اطلاعات زیادی (اطلاعات کافی برای بازیابی مرزهای تفکیک ۴۶ کلاس) را در یک فضای بازنمایی با بعد بسیار پایین فشرده کنید. مدل قادر است بیشتر اطلاعات لازم را در این بازنماییهای ۴ بعدی جا دهد، اما نه تمام آن را.
آزمایشهای بیشتر
Section titled “آزمایشهای بیشتر”همانند مثال قبلی، شما را تشویق میکنیم که آزمایشهای زیر را امتحان کنید تا احساس شهودی در مورد تصمیمات پیکربندی که گرفتهایم به دست آورید:
- سعی کنید از لایههایی با واحدهای بیشتر یا واحدهای کمتر استفاده کنید: ۳۲ واحد، ۱۲۸ واحد و غیره.
- شما از دو لایهٔ میانی قبل از لایهٔ طبقهبندی نهایی softmax استفاده کردید. اکنون سعی کنید از یک لایهٔ میانی یا سه لایهٔ میانی استفاده کنید.
جمعبندی
Section titled “جمعبندی”نکات کلیدی که باید از این مثال به خاطر بسپارید عبارتند از:
- اگر در حال تلاش برای طبقهبندی نقاط داده بین N کلاس هستید، مدل شما باید با یک لایهٔ
Denseبا اندازهٔ N به پایان برسد. - در یک مسئلهٔ طبقهبندی چندکلاسهٔ تکبرچسبی، مدل شما باید با فعالسازی
softmaxخاتمه یابد تا یک توزیع احتمال روی N کلاس خروجی تولید کند. - کراسانتروپی دستهای (Categorical crossentropy) تقریباً همیشه تابع زیانی است که باید برای چنین مسائلی استفاده کنید. این تابع فاصله بین توزیعهای احتمال خروجی توسط مدل و توزیع واقعی اهداف را کمینه میکند.
- دو روش برای مدیریت برچسبها در طبقهبندی چندکلاسه وجود دارد:
- کدگذاری برچسبها از طریق کدگذاری دستهای (که به عنوان کدگذاری وان-هات نیز شناخته میشود) و استفاده از
categorical_crossentropyبه عنوان تابع زیان - کدگذاری برچسبها به صورت اعداد صحیح و استفاده از تابع زیان
sparse_categorical_crossentropy
- کدگذاری برچسبها از طریق کدگذاری دستهای (که به عنوان کدگذاری وان-هات نیز شناخته میشود) و استفاده از
- اگر نیاز دارید دادهها را در تعداد زیادی دسته طبقهبندی کنید، باید از ایجاد گلوگاههای اطلاعاتی در مدل خود به دلیل لایههای میانی بیشازحد کوچک اجتناب نمایید.
پیشبینی قیمت مسکن: یک مثال رگرسیون
Section titled “پیشبینی قیمت مسکن: یک مثال رگرسیون”دو مثال قبلی به عنوان مسائل طبقهبندی در نظر گرفته میشدند، که در آنها هدف پیشبینی یک برچسب گسستهٔ منفرد برای یک نقطهٔ دادهٔ ورودی بود. نوع رایج دیگری از مسائل یادگیری ماشین، رگرسیون (regression) است که شامل پیشبینی یک مقدار پیوسته به جای یک برچسب گسسته است: برای مثال، پیشبینی دمای فردا با توجه به دادههای هواشناسی، یا پیشبینی مدتزمانی که یک پروژهٔ نرمافزاری بر اساس مشخصاتش برای تکمیل نیاز دارد.
مجموعهدادهٔ قیمت مسکن کالیفرنیا
Section titled “مجموعهدادهٔ قیمت مسکن کالیفرنیا”شما تلاش خواهید کرد تا قیمت میانهٔ مسکن را در مناطق مختلف کالیفرنیا در سال ۱۹۹۰ بر اساس دادههای سرشماری آن زمان پیشبینی کنید.
هر نقطهٔ داده در مجموعهداده نشاندهندهٔ اطلاعاتی دربارهٔ یک «گروه بلوک» (block group) است که کوچکترین واحد جغرافیایی است که ادارهٔ سرشماری ایالات متحده برای آن دادههای نمونه منتشر میکند (یک گروه بلوک معمولاً جمعیتی بین ۶۰۰ تا ۳,۰۰۰ نفر دارد). برای راحتی، ما به آنها به عنوان «مناطق» (districts) اشاره خواهیم کرد.
برای هر منطقه، ما موارد زیر را میدانیم:
- موقعیت مکانی آن بر حسب طول و عرض جغرافیایی
- سن میانهٔ خانهها در منطقه
- تعداد کل اتاقها و تعداد کل اتاقهای خواب در منطقه
- جمعیت منطقه و تعداد خانوارها
- درآمد میانهٔ افراد در منطقه
- ارزش میانهٔ خانهها در منطقه
این در مجموع هشت متغیر است (طول و عرض جغرافیایی به عنوان دو متغیر به حساب میآیند). هدف ما پیشبینی آخرین متغیر، یعنی ارزش میانهٔ مسکن، بر اساس هفت متغیر دیگر به عنوان ورودی است.
این مجموعهداده دارای یک ویژگی مشترک در دنیای واقعی است: اندازهٔ آن کوچک است. در مجموع ۲۰,۶۴۰ منطقه در مجموعهداده وجود دارد، اما ما فقط از کسر کوچکی از آن — ۶۰۰ نمونه — استفاده خواهیم کرد تا شرایط کار با دادههای محدود را شبیهسازی کنیم، موقعیتی که اغلب در عمل با آن روبرو خواهید شد.
لیستینگ ۴.۲۴: بارگذاری مجموعهدادهٔ قیمت مسکن کالیفرنیا
from keras.datasets import california_housing
# Make sure to pass version="small" to get the right dataset.(train_data, train_targets), (test_data, test_targets) = (    california_housing.load_data(version="small"))
بیایید به دادهها نگاهی بیندازیم:
>>> train_data.shapeهمانطور که میبینید، ما ۴۸۰ نمونهٔ آموزش و ۱۲۰ نمونهٔ آزمون داریم که هر کدام دارای ۸ ویژگی عددی هستند. اهداف، ارزشهای میانهٔ خانهها در منطقهٔ مورد نظر به دلار هستند:
>>> train_targetsقیمتها بین ۶۰,۰۰۰ تا ۵۰۰,۰۰۰ دلار هستند. اگر این ارقام ارزان به نظر میرسند، به یاد داشته باشید که این مربوط به سال ۱۹۹۰ است و این قیمتها بر اساس تورم تعدیل نشدهاند.
آمادهسازی دادهها
Section titled “آمادهسازی دادهها”تغذیهٔ مقادیری که همگی دامنههای کاملاً متفاوتی دارند به یک شبکهٔ عصبی مشکلساز خواهد بود. مدل ممکن است بتواند بهطور خودکار با چنین دادههای ناهمگنی سازگار شود، اما این کار قطعاً یادگیری را دشوارتر میکند. یک روش استاندارد و بهینه برای مدیریت چنین دادههایی، اعمال نرمالسازی ویژگیها است: برای هر ویژگی در دادههای ورودی (یک ستون در ماتریس دادههای ورودی)، میانگین ویژگی را کم کرده و بر انحراف معیار تقسیم میکنیم، به طوری که مرکز ویژگی در ۰ قرار گیرد و دارای انحراف معیار واحد باشد. این کار را میتوان به سادگی در NumPy انجام داد.
لیستینگ ۴.۲۵: نرمالسازی دادهها
mean = train_data.mean(axis=0)std = train_data.std(axis=0)x_train = (train_data - mean) / stdx_test = (test_data - mean) / stdتوجه داشته باشید که مقادیر استفادهشده برای نرمالسازی دادههای آزمون با استفاده از دادههای آموزش محاسبه میشوند. شما هرگز نباید در گردشکار خود از مقادیری استفاده کنید که روی دادههای آزمون محاسبه شدهاند، حتی برای چیزی به سادگی نرمالسازی دادهها.
علاوه بر این، ما باید اهداف را نیز مقیاسبندی کنیم. ورودیهای نرمالشدهٔ ما مقادیری در حدود ۱- تا ۱ هستند، در حالی که اهداف ما بین ۶۰,۰۰۰ تا ۵۰۰,۰۰۰ دلار قرار دارند. در یادگیری عمیق، معمولاً بهتر است ورودیها و خروجیهای مدل در دامنههای مشابهی باشند، زیرا خروجیهای بسیار بزرگ میتوانند منجر به بهروزرسانیهای گرادیان بسیار بزرگ شوند و فرایند آموزش را ناپایدار کنند. در این مورد، ما اهداف را به صدها هزار دلار مقیاسبندی میکنیم:
لیستینگ ۴.۲۶: مقیاسبندی اهداف
y_train = train_targets / 100000y_test = test_targets / 100000ساختن مدل شما
Section titled “ساختن مدل شما”از آنجا که نمونههای بسیار کمی در دسترس هستند، از یک مدل بسیار کوچک با دو لایهٔ میانی استفاده خواهید کرد که هر کدام ۶۴ واحد دارند. بهطور کلی، هرچه دادههای آموزشی کمتری داشته باشید، بیشبرازش بدتر خواهد بود و استفاده از یک مدل کوچک یکی از راههای کاهش بیشبرازش است.
لیستینگ ۴.۲۷: تعریف مدل
def get_model(): # Because you need to instantiate the same model multiple times, # you use a function to construct it. model = keras.Sequential( [ layers.Dense(64, activation="relu"), layers.Dense(64, activation="relu"), layers.Dense(1), ] ) model.compile( optimizer="adam", loss="mean_squared_error", metrics=["mean_absolute_error"], ) return modelمدل با یک واحد منفرد و بدون هیچ فعالسازی به پایان میرسد: این یک لایهٔ خطی خواهد بود. این یک پیکربندی معمول برای رگرسیون اسکالر است (رگرسیونی که در آن سعی در پیشبینی یک مقدار پیوستهٔ منفرد دارید). اعمال تابع فعالسازی، دامنهٔ خروجی را محدود میکند؛ برای مثال، اگر از تابع فعالسازی sigmoid در لایهٔ آخر استفاده میکردید، مدل فقط میتوانست مقادیری بین ۰ و ۱ را پیشبینی کند. در اینجا، چون لایهٔ آخر کاملاً خطی است، مدل آزاد است تا مقادیر را در هر دامنهای پیشبینی کند.
توجه داشته باشید که مدل را با تابع زیان mean_squared_error کامپایل میکنید — میانگین مربعات خطا (MSE)، مجذور تفاضل بین پیشبینیها و اهداف. این یک تابع زیان پرکاربرد برای مسائل رگرسیون است.
شما همچنین در حال نظارت بر یک معیار جدید در طول آموزش هستید: میانگین خطای قدرمطلق (MAE). این معیار صرفاً قدرمطلق تفاضل بین پیشبینیها و اهداف است. برای مثال، MAE برابر با ۰.۵ در این مسئله به معنای آن است که پیشبینیهای شما بهطور متوسط ۵۰,۰۰۰ دلار خطا دارند (چون اهداف بر حسب صدها هزار دلار مقیاسبندی شدهاند).
اعتبارسنجی رویکرد شما با استفاده از اعتبارسنجی K-بخشی
Section titled “اعتبارسنجی رویکرد شما با استفاده از اعتبارسنجی K-بخشی”برای ارزیابی مدل خود در حین تنظیم پارامترهای آن (مانند تعداد دورههای استفادهشده برای آموزش)، میتوانستید دادهها را به یک مجموعهٔ آموزش و یک مجموعهٔ اعتبارسنجی تقسیم کنید، همانطور که در مثالهای قبلی انجام دادید. اما از آنجا که نقاط دادهٔ بسیار کمی دارید، مجموعهٔ اعتبارسنجی بسیار کوچک خواهد بود (مثلاً حدود ۱۰۰ نمونه). در نتیجه، بسته به اینکه کدام نقاط داده را برای اعتبارسنجی و کدام را برای آموزش انتخاب کنید، امتیازات اعتبارسنجی ممکن است واریانس زیادی داشته باشند: امتیازات اعتبارسنجی ممکن است با توجه به برش اعتبارسنجی نوسان زیادی داشته باشند. این امر مانع از آن میشود که بتوانید مدل خود را به طور قابل اعتمادی ارزیابی کنید.
بهترین روش در چنین شرایطی استفاده از اعتبارسنجی متقاطع K-بخشی (K-fold cross-validation) است (شکل ۴.۹ را ببینید). این روش شامل تقسیم دادههای موجود به K بخش (معمولاً K = ۴ یا ۵)، ایجاد K مدل یکسان، و آموزش هر یک روی K - ۱ بخش در حین ارزیابی روی بخش باقیمانده است. سپس امتیاز اعتبارسنجی برای مدل مورد استفاده، میانگین K امتیاز اعتبارسنجی به دست آمده خواهد بود. از نظر کد، این کار ساده است.
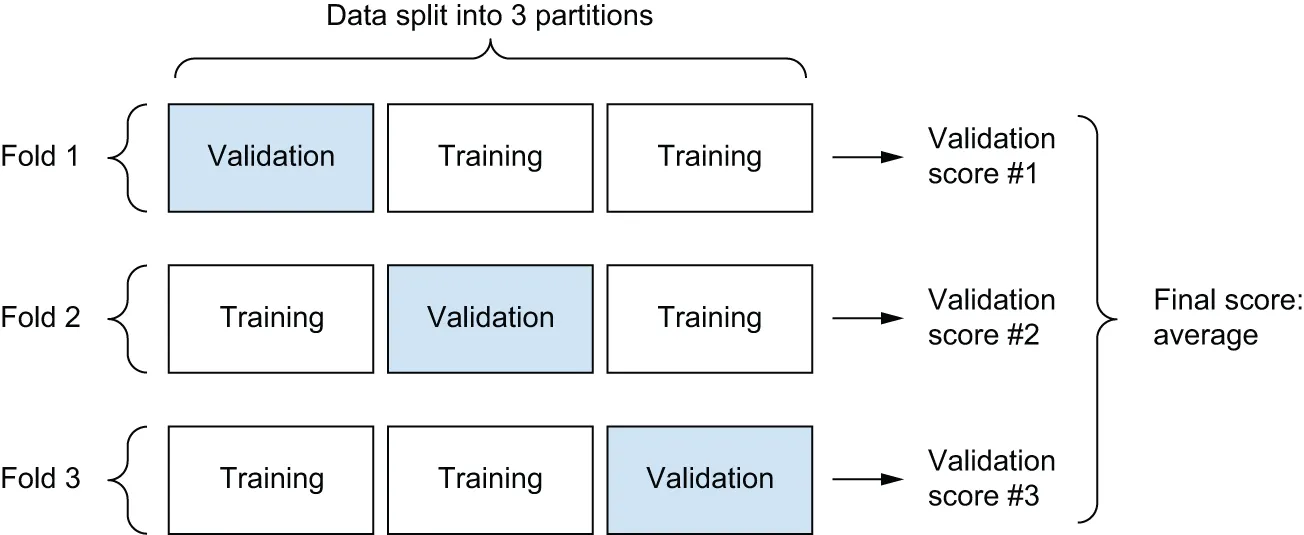
شکل ۴.۹: اعتبارسنجی متقاطع سهبخشی
لیستینگ ۴.۲۸: اعتبارسنجی K-بخشی
k = 4num_val_samples = len(x_train) // knum_epochs = 50all_scores = []for i in range(k): print(f"Processing fold #{i + 1}") # Prepares the validation data: data from partition #k fold_x_val = x_train[i * num_val_samples : (i + 1) * num_val_samples] fold_y_val = y_train[i * num_val_samples : (i + 1) * num_val_samples] # Prepares the training data: data from all other partitions fold_x_train = np.concatenate( [x_train[: i * num_val_samples], x_train[(i + 1) * num_val_samples :]], axis=0, ) fold_y_train = np.concatenate( [y_train[: i * num_val_samples], y_train[(i + 1) * num_val_samples :]], axis=0, ) # Builds the Keras model (already compiled) model = get_model() # Trains the model model.fit( fold_x_train, fold_y_train, epochs=num_epochs, batch_size=16, verbose=0, ) # Evaluates the model on the validation data scores = model.evaluate(fold_x_val, fold_y_val, verbose=0) val_loss, val_mae = scores all_scores.append(val_mae)اجرای این کار با num_epochs = 50 نتایج زیر را به همراه دارد:
>>> [round(value, 3) for value in all_scores]اجراهای مختلف در واقع امتیازات اعتبارسنجی کاملاً متفاوتی را نشان میدهند (از ۰.۴۴۵ تا ۰.۵۵۱). میانگین (۰.۴۹۷) معیار بسیار قابلاعتمادتری نسبت به هر یک از این امتیازات منفرد است — این کل ماهیت اعتبارسنجی K-بخشی است. در این مورد، ما بهطور متوسط حدود ۵۰,۰۰۰ دلار خطا داریم که در مقایسه با دامنهٔ قیمتها که از ۶۰,۰۰۰ تا ۵۰۰,۰۰۰ دلار متغیر است، قابل توجه است.
بیایید سعی کنیم مدل را کمی طولانیتر آموزش دهیم: ۲۰۰ دوره. برای ثبت اینکه مدل در هر دوره چقدر خوب عمل میکند، حلقهٔ آموزش را اصلاح خواهیم کرد تا امتیاز اعتبارسنجی هر دوره را ذخیره کند.
لیستینگ ۴.۲۹: ذخیرهٔ لاگهای اعتبارسنجی در هر بخش
k = 4num_val_samples = len(x_train) // knum_epochs = 200all_mae_histories = []for i in range(k): print(f"Processing fold #{i + 1}") # Prepares the validation data: data from partition #k fold_x_val = x_train[i * num_val_samples : (i + 1) * num_val_samples] fold_y_val = y_train[i * num_val_samples : (i + 1) * num_val_samples] # Prepares the training data: data from all other partitions fold_x_train = np.concatenate( [x_train[: i * num_val_samples], x_train[(i + 1) * num_val_samples :]], axis=0, ) fold_y_train = np.concatenate( [y_train[: i * num_val_samples], y_train[(i + 1) * num_val_samples :]], axis=0, ) # Builds the Keras model (already compiled) model = get_model() # Trains the model history = model.fit( fold_x_train, fold_y_train, validation_data=(fold_x_val, fold_y_val), epochs=num_epochs, batch_size=16, verbose=0, ) mae_history = history.history["val_mean_absolute_error"] all_mae_histories.append(mae_history)سپس میتوانید میانگین امتیازات میانگین خطای قدرمطلق (MAE) در هر دوره را برای تمام بخشها محاسبه کنید.
لیستینگ ۴.۳۰: ساخت تاریخچهٔ میانگین امتیازات اعتبارسنجی K-بخشی متوالی
average_mae_history = [ np.mean([x[i] for x in all_mae_histories]) for i in range(num_epochs)]بیایید این را رسم کنیم؛ شکل ۴.۱۰ را ببینید.
لیستینگ ۴.۳۱: رسم امتیازات اعتبارسنجی
epochs = range(1, len(average_mae_history) + 1)plt.plot(epochs, average_mae_history)plt.xlabel("Epochs")plt.ylabel("Validation MAE")plt.show()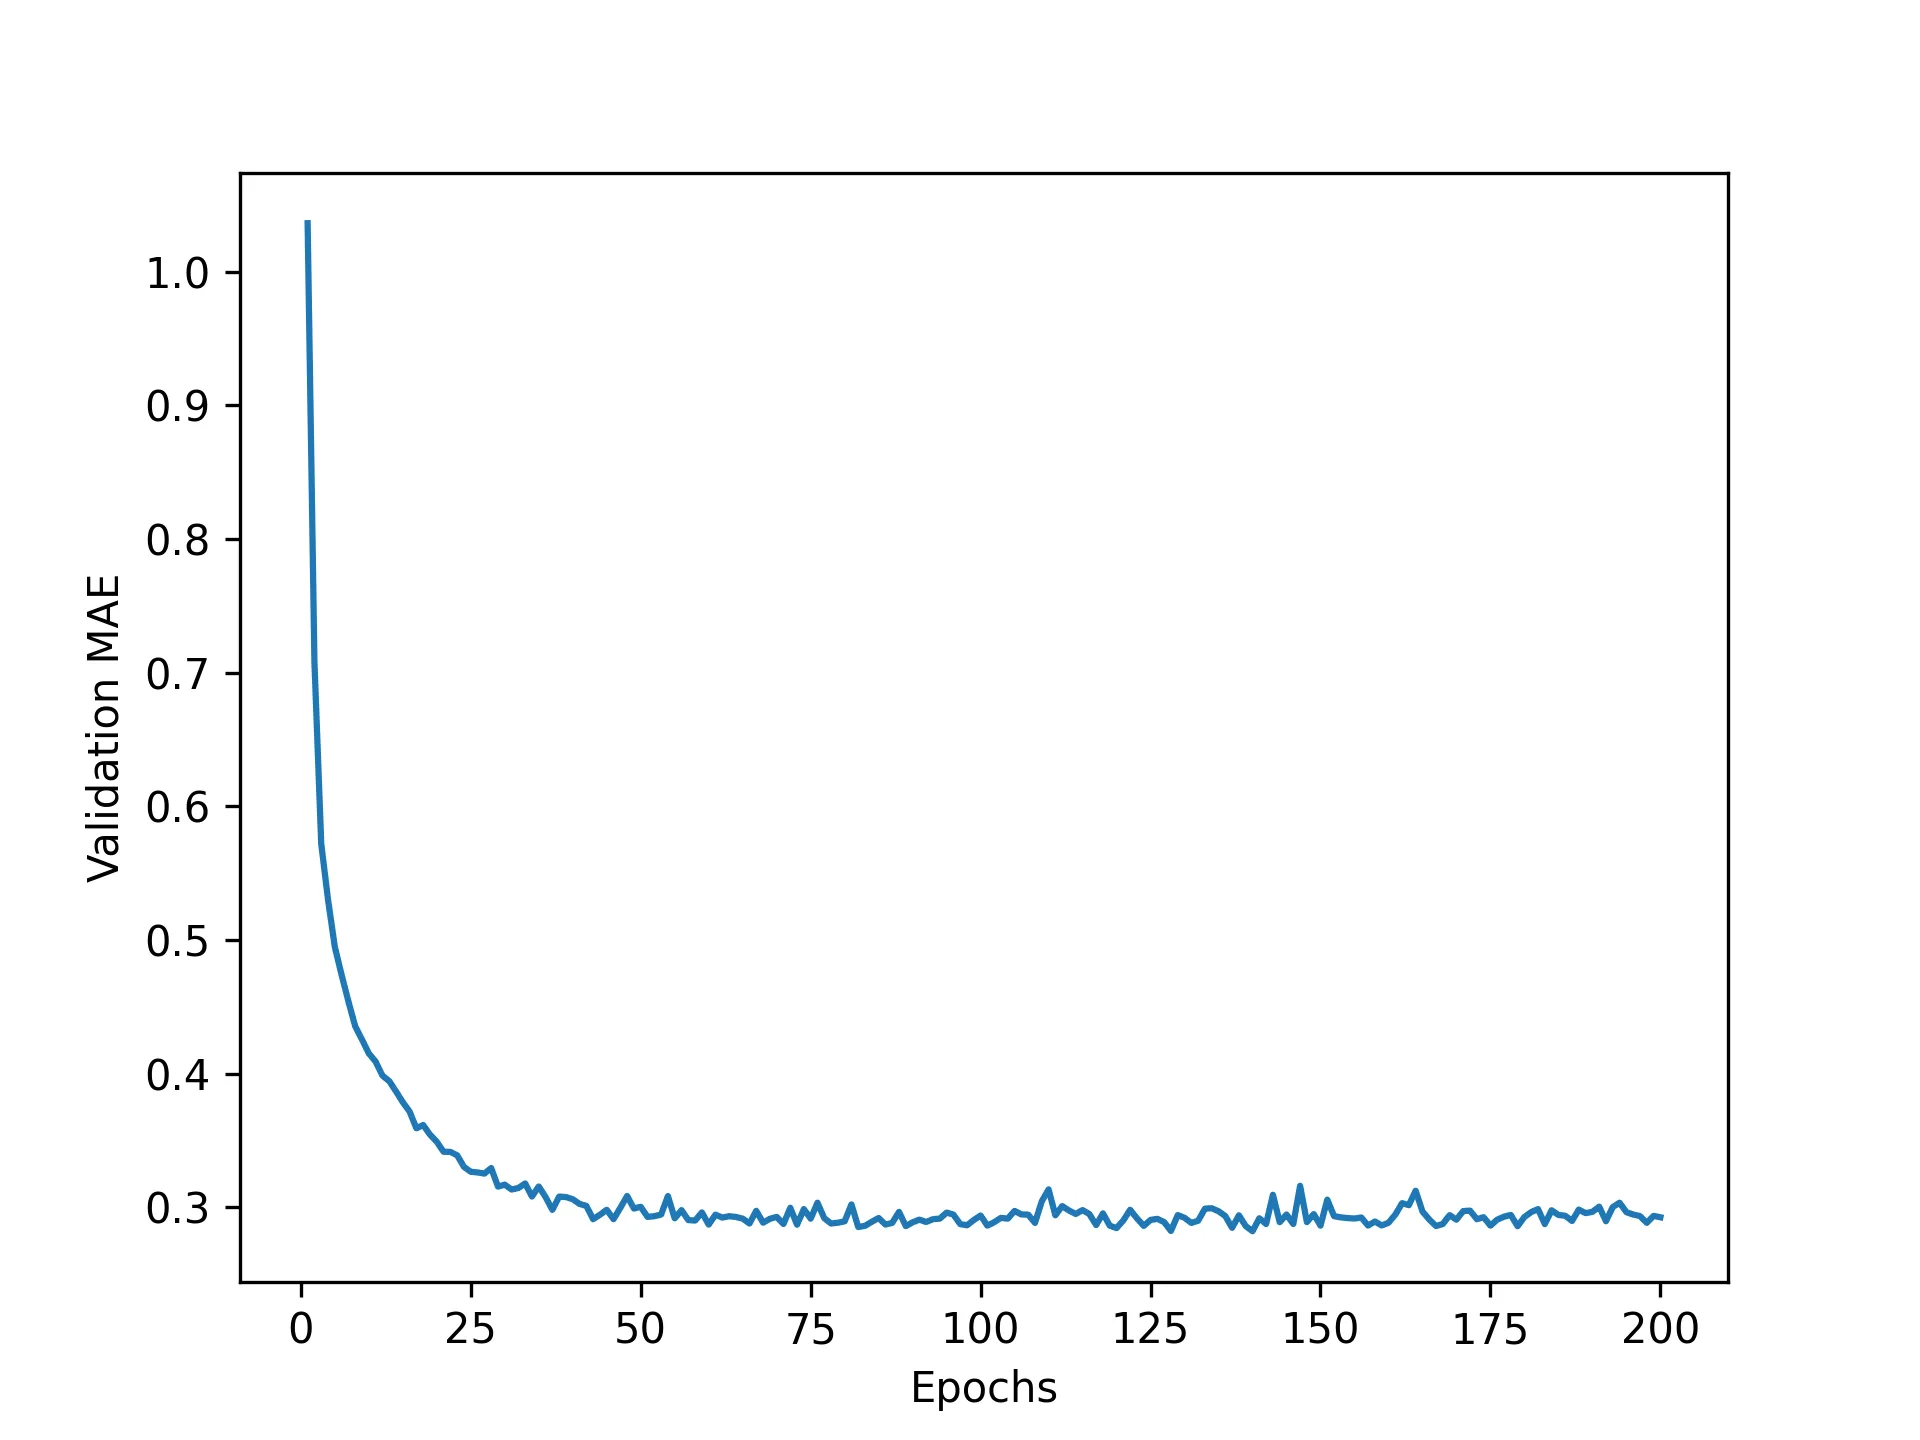
شکل ۴.۱۰: میانگین خطای قدرمطلق اعتبارسنجی بر حسب دورهها
ممکن است خواندن نمودار به دلیل یک مشکل مقیاسبندی کمی دشوار باشد: MAE اعتبارسنجی برای چند دورهٔ اول بهطور چشمگیری بالاتر از مقادیری است که در ادامه میآیند. بیایید ۱۰ نقطهٔ دادهٔ اول را که در مقیاس متفاوتی نسبت به بقیهٔ منحنی هستند حذف کنیم.
لیستینگ ۴.۳۲: رسم امتیازات اعتبارسنجی با حذف ۱۰ نقطهٔ دادهٔ اول
truncated_mae_history = average_mae_history[10:]epochs = range(10, len(truncated_mae_history) + 10)plt.plot(epochs, truncated_mae_history)plt.xlabel("Epochs")plt.ylabel("Validation MAE")plt.show()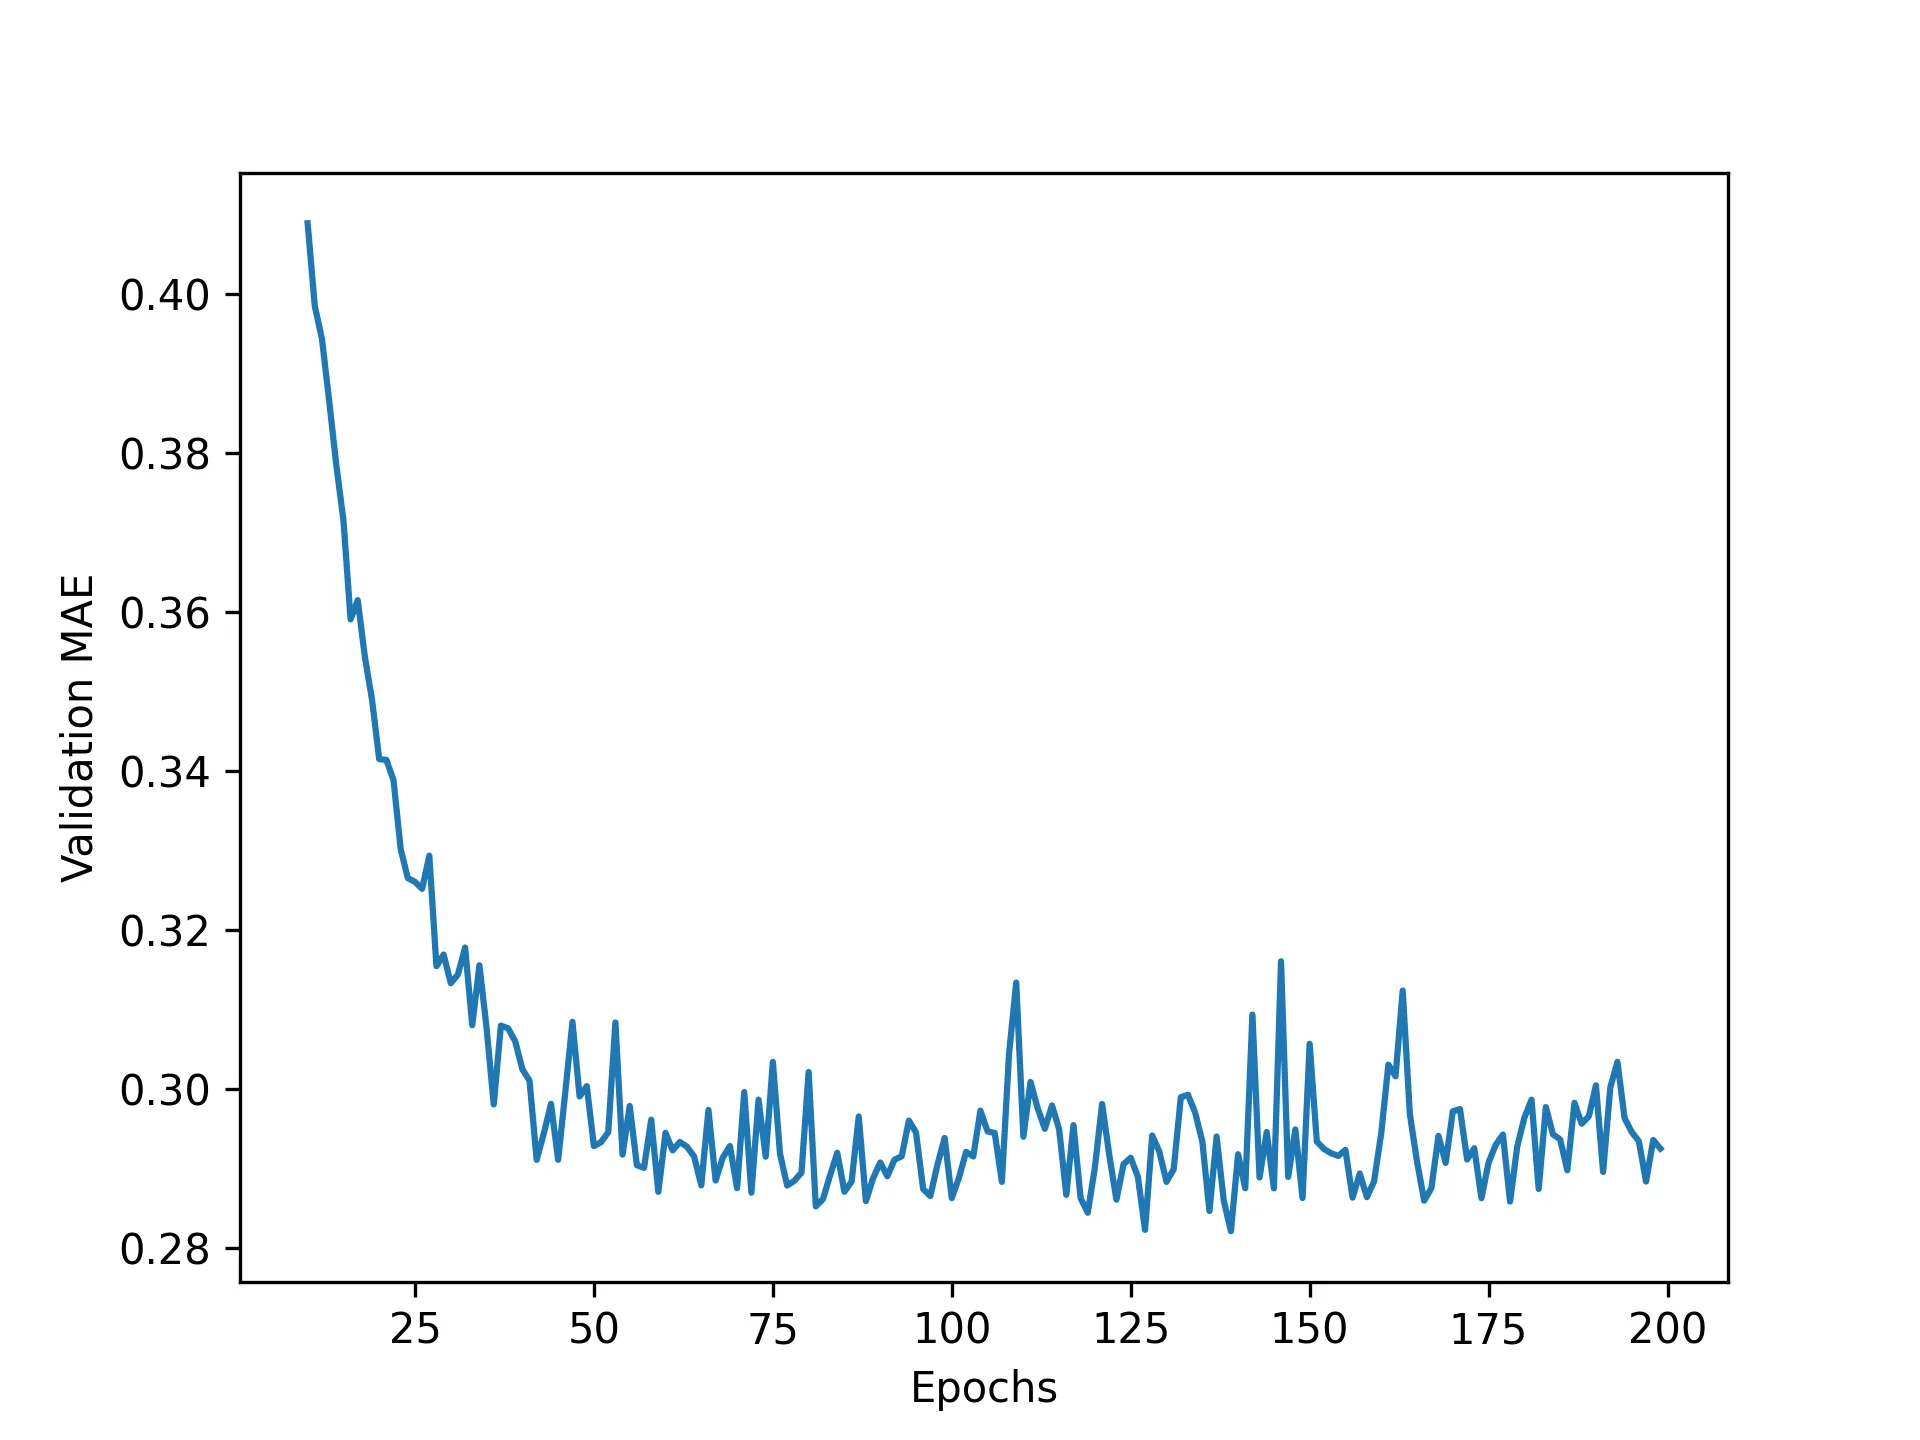
شکل ۴.۱۱: میانگین خطای قدرمطلق اعتبارسنجی بر حسب دورهها، با حذف ۱۰ دورهٔ اول
با توجه به این نمودار (شکل ۴.۱۱ را ببینید)، MAE اعتبارسنجی پس از حدود ۱۳۰ دوره بهبود قابل توجهی را متوقف میکند. پس از آن نقطه، بیشبرازش آغاز میشود.
هنگامی که تنظیم سایر پارامترهای مدل خود را به پایان رساندید (علاوه بر تعداد دورهها، میتوانید اندازهٔ لایههای میانی را نیز تنظیم کنید)، میتوانید یک مدل نهایی را روی تمام دادههای آموزشی آموزش دهید و سپس عملکرد آن را روی دادههای آزمون ارزیابی کنید.
لیستینگ ۴.۳۳: آموزش مدل نهایی
# Gets a fresh, compiled modelmodel = get_model()# Trains it on the entirety of the datamodel.fit(x_train, y_train, epochs=130, batch_size=16, verbose=0)test_mean_squared_error, test_mean_absolute_error = model.evaluate( x_test, y_test)در اینجا نتیجهٔ نهایی آمده است:
>>> round(test_mean_absolute_error, 3)ما هنوز بهطور متوسط حدود ۳۱,۰۰۰ دلار خطا داریم.
تولید پیشبینیها روی دادههای جدید
Section titled “تولید پیشبینیها روی دادههای جدید”هنگام فراخوانی predict() روی مدل طبقهبندی دودویی خود، برای هر نمونه یک امتیاز احتمال بین ۰ و ۱ دریافت میکردیم. با مدل طبقهبندی چندکلاسه، یک توزیع احتمال روی ۴۶ کلاس دریافت میکردیم. اکنون، با این مدل رگرسیون اسکالر، predict() پیشبینیهای مدل را به عنوان مقادیر عددی پیوسته برمیگرداند:
>>> predictions = model.predict(x_test)>>> predictions[0]برای اولین منطقه در مجموعهٔ آزمون، قیمت خانه بهطور متوسط حدود ۲۸۳,۰۰۰ دلار پیشبینی شده است.
جمعبندی
Section titled “جمعبندی”نکات کلیدی که باید از این مثال رگرسیون اسکالر به خاطر بسپارید عبارتند از:
- رگرسیون با استفاده از توابع زیان متفاوتی نسبت به آنچه برای طبقهبندی استفاده کردیم انجام میشود. میانگین مربعات خطا (MSE) یک تابع زیان است که معمولاً برای رگرسیون استفاده میشود.
- به طور مشابه، معیارهای ارزیابی مورد استفاده برای رگرسیون با معیارهای طبقهبندی متفاوت هستند؛ طبیعتاً مفهوم دقت (accuracy) برای رگرسیون صدق نمیکند. یک معیار رایج رگرسیون، میانگین خطای قدرمطلق (MAE) است.
- هنگامی که ویژگیها در دادههای ورودی مقادیری در دامنههای مختلف دارند، هر ویژگی باید بهطور مستقل به عنوان یک مرحلهٔ پیشپردازش مقیاسبندی شود.
- هنگامی که دادههای کمی در دسترس است، استفاده از اعتبارسنجی K-بخشی یک روش عالی برای ارزیابی قابل اعتماد مدل شماست.
- هنگامی که دادههای آموزشی کمی در دسترس است، ترجیح داده میشود از یک مدل کوچک با تعداد کمی لایههای میانی (معمولاً تنها یک یا دو لایه) استفاده شود تا از بیشبرازش شدید جلوگیری به عمل آید.
- سه نوع از رایجترین انواع وظایف یادگیری ماشین روی دادههای برداری عبارتند از طبقهبندی دودویی، طبقهبندی چندکلاسه، و رگرسیون اسکالر. هر وظیفه از توابع زیان متفاوتی استفاده میکند:
binary_crossentropyبرای طبقهبندی دودوییcategorical_crossentropyبرای طبقهبندی چندکلاسهmean_squared_errorبرای رگرسیون اسکالر
- معمولاً قبل از ارسال دادههای خام به یک شبکهٔ عصبی، باید آنها را پیشپردازش کنید.
- وقتی دادههای شما ویژگیهایی با دامنههای متفاوت دارند، هر ویژگی را بهطور مستقل مقیاسبندی کنید.
- همزمان با ادامهٔ آموزش، شبکههای عصبی در نهایت شروع به بیشبرازش میکنند و نتایج به مراتب بدتری روی دادههای ندیدهشده به دست میآورند.
- اگر دادههای زیادی ندارید، از یک مدل کوچک با تنها یک یا دو لایهٔ میانی استفاده کنید تا از بیشبرازش شدید جلوگیری کنید.
- اگر دادههای شما به دستههای زیادی تقسیم شدهاند، در صورت کوچک بودن بیشازحد لایههای میانی، ممکن است باعث ایجاد گلوگاههای اطلاعاتی شوید.
- وقتی با دادههای کمی کار میکنید، اعتبارسنجی K-بخشی میتواند به ارزیابی قابل اعتماد مدل شما کمک کند.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.