
فصل ۵: مبانی یادگیری ماشین
پس از سه مثال عملی در فصل ۴، باید شروع به آشنایی با نحوهٔ رویکرد به مسائل طبقهبندی و رگرسیون با استفاده از شبکههای عصبی کرده باشید و مسئلهٔ اصلی یادگیری ماشین را witnessed کرده باشید: بیشبرازش. این فصل برخی از شهود جدید شما دربارهٔ یادگیری ماشین را به یک چارچوب مفهومی محکم رسمی تبدیل میکند و بر اهمیت ارزیابی دقیق مدل و تعادل بین آموزش و تعمیم تأکید میکند.
تعمیم: هدف یادگیری ماشین
Section titled “تعمیم: هدف یادگیری ماشین”در سه مثال ارائهشده در فصل ۴ — پیشبینی نقدهای فیلم، طبقهبندی موضوع و رگرسیون قیمت خانه — ما دادهها را به یک مجموعهٔ آموزشی، یک مجموعهٔ اعتبارسنجی و یک مجموعهٔ آزمایشی تقسیم کردیم. دلیل اینکه مدلها را روی همان دادههایی که آموزش دیدهاند ارزیابی نکنیم بهسرعت آشکار شد: پس از تنها چند دوره، عملکرد روی دادههای هرگز دیدهنشده شروع به واگرایی از عملکرد روی دادههای آموزشی کرد، که همیشه با پیشرفت آموزش بهبود مییابد. مدلها شروع به بیشبرازش کردند. بیشبرازش در هر مسئلهٔ یادگیری ماشین اتفاق میافتد.
مسئلهٔ بنیادین در یادگیری ماشین تنش بین بهینهسازی و تعمیم است. بهینهسازی به فرآیند تنظیم یک مدل برای به دست آوردن بهترین عملکرد ممکن روی دادههای آموزشی اشاره دارد (یادگیری در یادگیری ماشین)، در حالی که تعمیم به اینکه مدل آموزشدیده چقدر خوب روی دادههایی که هرگز ندیده است عمل میکند اشاره دارد. هدف بازی البته به دست آوردن تعمیم خوب است، اما شما تعمیم را کنترل نمیکنید؛ شما فقط میتوانید مدل را به دادههای آموزشیاش برازش دهید. اگر این کار را بیش از حد خوب انجام دهید، بیشبرازش شروع میشود و تعمیم رنج میبرد.
اما چه چیزی باعث بیشبرازش میشود؟ چگونه میتوانیم به تعمیم خوب دست یابیم؟
کمبرازش و بیشبرازش
Section titled “کمبرازش و بیشبرازش”برای تمام مدلهایی که در فصل قبل دیدید، عملکرد روی دادههای اعتبارسنجی نگهداشتهشده در ابتدا با پیشرفت آموزش بهبود مییافت و سپس inevitably پس از مدتی به اوج میرسید. این الگو (که در شکل ۵.۱ نشان داده شده است) جهانی است. شما آن را با هر نوع مدل و هر مجموعهدادهای خواهید دید.
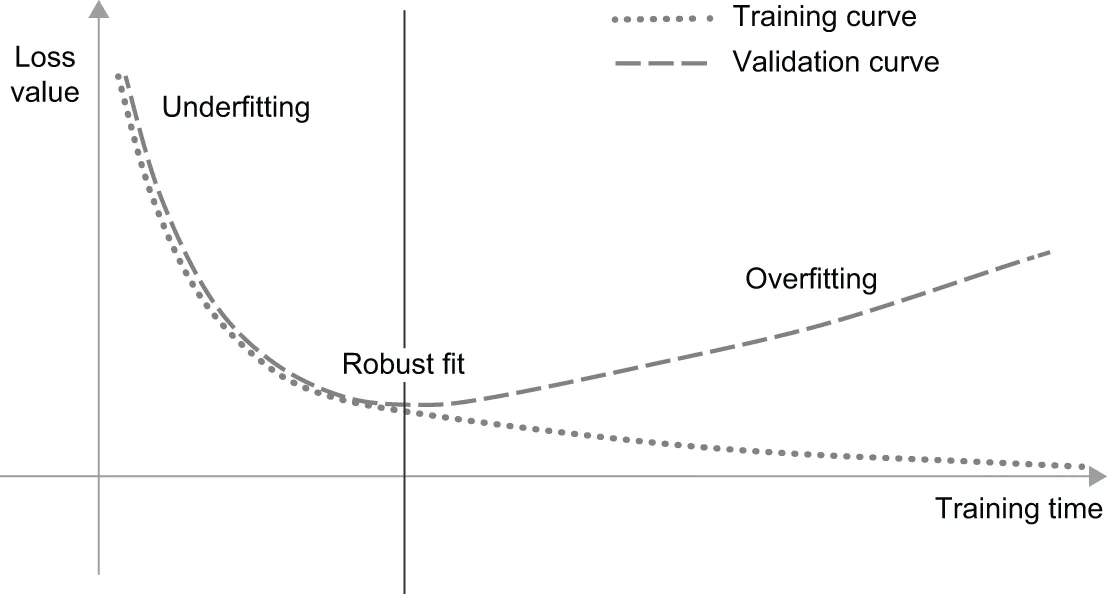
شکل ۵.۱: رفتار متعارف بیشبرازش
در ابتدای آموزش، بهینهسازی و تعمیم همبسته هستند: هر چه زیان روی دادههای آموزشی کمتر باشد، زیان روی دادههای آزمایشی کمتر است. در حالی که این اتفاق میافتد، گفته میشود مدل شما کمبرازش است: هنوز پیشرفتی برای انجام دادن وجود دارد؛ شبکه هنوز تمام الگوهای مرتبط در دادههای آموزشی را مدلسازی نکرده است. اما پس از تعداد معینی تکرار روی دادههای آموزشی، تعمیم متوقف میشود و معیارهای اعتبارسنجی متوقف میشوند و سپس شروع به کاهش میکنند: مدل شروع به بیشبرازش میکند. یعنی شروع به یادگیری الگوهایی میکند که مخصوص دادههای آموزشی هستند اما وقتی صحبت از دادههای جدید میشود گمراهکننده یا نامرتبط هستند.
بیشبرازش بهویژه زمانی محتمل است که دادههای شما نویزی باشند، اگر شامل عدم قطعیت باشند، یا اگر شامل ویژگیهای نادر باشند. بیایید به مثالهای عینی نگاه کنیم.
دادههای آموزشی نویزی
Section titled “دادههای آموزشی نویزی”در مجموعهدادههای دنیای واقعی، نسبتاً رایج است که برخی ورودیها نامعتبر باشند. برای مثال، یک رقم MNIST میتواند یک تصویر کاملاً سیاه باشد — یا چیزی شبیه شکل ۵.۲.
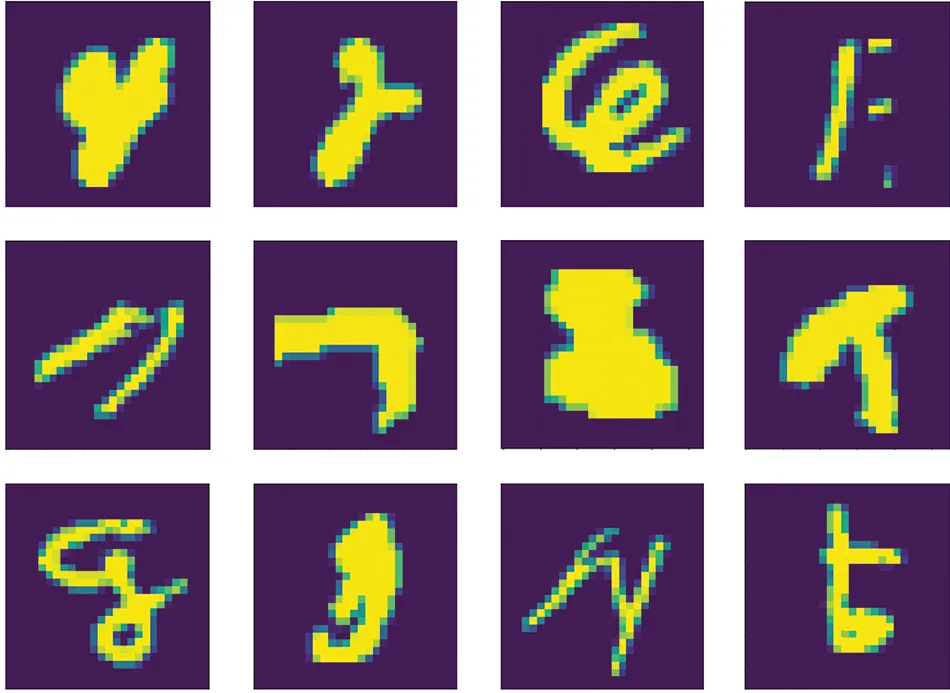
شکل ۵.۲: چند نمونهٔ آموزشی MNIST نسبتاً عجیب
اینها چیستند؟ ما هم نمیدانیم. اما همهٔ آنها بخشی از مجموعهٔ آموزشی MNIST هستند. آنچه حتی بدتر است، داشتن ورودیهای کاملاً معتبری است که در نهایت اشتباه برچسبگذاری میشوند، مانند آنهایی که در شکل ۵.۳ نشان داده شدهاند.
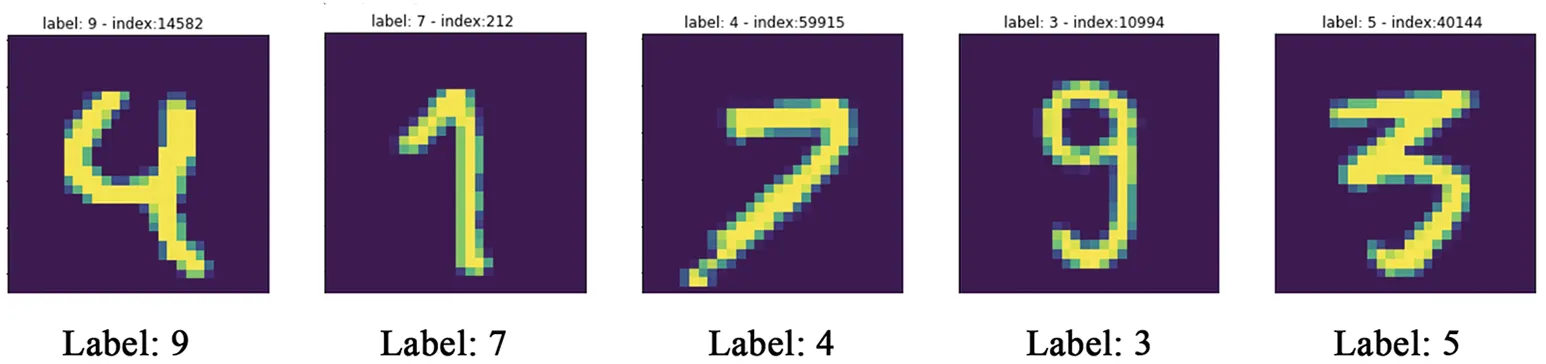
شکل ۵.۳: نمونههای آموزشی MNIST با برچسب اشتباه
اگر یک مدل برای گنجاندن چنین نقاط پرت تلاش کند، عملکرد تعمیم آن کاهش مییابد، همانطور که در شکل ۵.۴ نشان داده شده است. برای مثال، یک ۴ که بسیار نزدیک به ۴ اشتباه برچسبخورده در شکل ۵.۳ به نظر میرسد ممکن است در نهایت بهعنوان ۹ طبقهبندی شود.
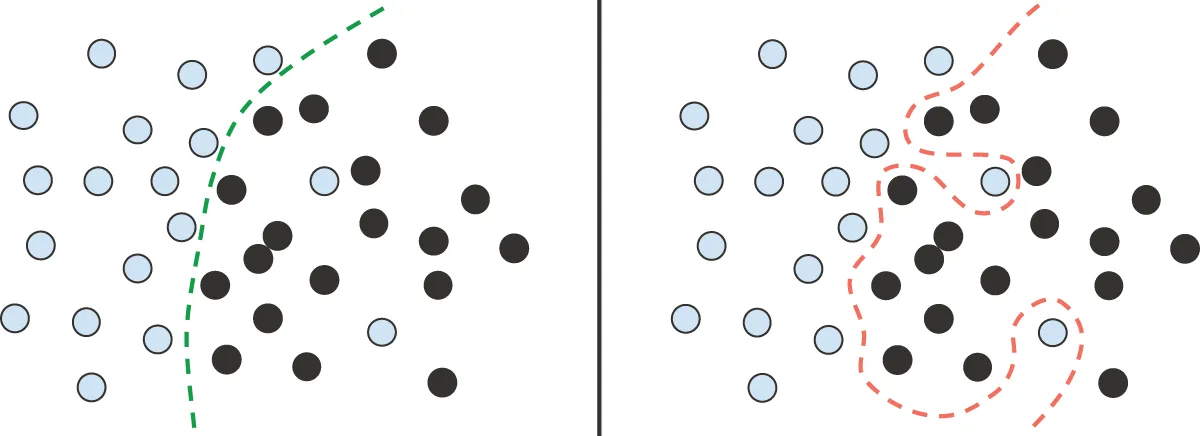
شکل ۵.۴: برخورد با نقاط پرت: برازش قوی در مقابل بیشبرازش
ویژگیهای مبهم
Section titled “ویژگیهای مبهم”همهٔ نویز داده از عدم دقت ناشی نمیشود — حتی دادههای کاملاً تمیز و بهدرستی برچسبگذاریشده میتوانند زمانی نویزی باشند که مسئله شامل عدم قطعیت و ابهام باشد (شکل ۵.۵ را ببینید). در وظایف طبقهبندی، اغلب اینطور است که برخی نواحی از فضای ویژگی ورودی همزمان با چندین کلاس مرتبط هستند. فرض کنید مدلی توسعه میدهید که تصویری از یک موز میگیرد و پیشبینی میکند که موز نارس، رسیده یا فاسد است. این دستهها مرزهای عینی ندارند، بنابراین همان تصویر ممکن است توسط برچسبگذاران انسانی مختلف بهعنوان نارس یا رسیده طبقهبندی شود. بهطور مشابه، بسیاری از مسائل شامل تصادفی بودن هستند. میتوانستید از دادههای فشار جو برای پیشبینی اینکه فردا باران میبارد یا نه استفاده کنید، اما همان اندازهگیریهای دقیق ممکن است گاهی با باران و گاهی با آسمان صاف همراه شوند — با مقداری احتمال.
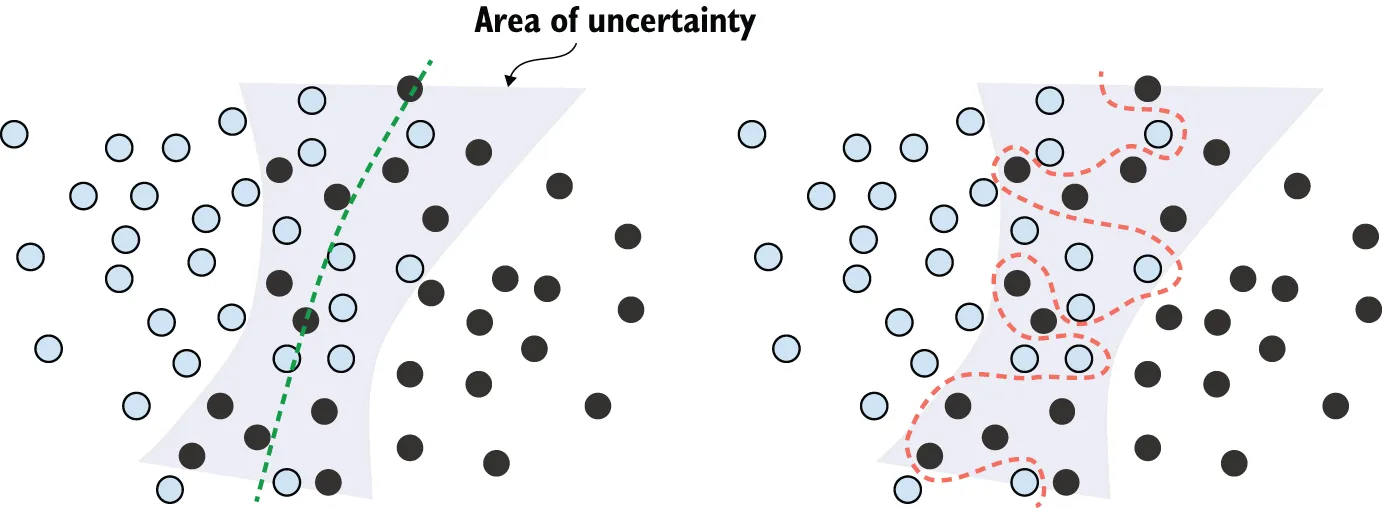
شکل ۵.۵: برازش قوی در مقابل بیشبرازش که ناحیهٔ مبهمی از فضای ویژگی را به وجود میآورد
یک مدل میتواند روی چنین دادههای احتمالاتی بیشبرازش کند با اطمینان بیشازحد دربارهٔ نواحی مبهم فضای ویژگی، مانند شکل ۵.۶. یک برازش قویتر نقاط دادهٔ فردی را نادیده میگیرد و به تصویر بزرگتر نگاه میکند.
ویژگیهای نادر و همبستگیهای کاذب
Section titled “ویژگیهای نادر و همبستگیهای کاذب”اگر در زندگی خود فقط دو گربهٔ نارنجی خالدار دیده باشید و هر دو اتفاقاً بهشدت غیراجتماعی بودهاند، ممکن است استنتاج کنید که گربههای نارنجی خالدار عموماً احتمالاً غیراجتماعی هستند. این بیشبرازش است: اگر در معرض تنوع گستردهتری از گربهها، از جمله گربههای نارنجی بیشتر قرار میگرفتید، یاد میگرفتید که رنگ گربه با شخصیت آن همبستگی خوبی ندارد.
بهطور مشابه، مدلهای یادگیری ماشین آموزشدیده روی مجموعهدادههایی که شامل مقادیر ویژگی نادر هستند بهشدت مستعد بیشبرازش هستند. در یک وظیفهٔ طبقهبندی احساسات، اگر کلمهٔ «چریمویا» (میوهای بومی آند) فقط در یک متن در دادههای آموزشی ظاهر شود، و این متن اتفاقاً احساسی منفی داشته باشد، یک مدل ضعیف تنظیمشده ممکن است وزن بسیار بالایی روی این کلمه بگذارد و همیشه متنهای جدیدی که به چریمویا اشاره میکنند را منفی طبقهبندی کند، در حالی که از نظر عینی هیچ چیز منفی دربارهٔ چریمویا وجود ندارد.1
مهم است که یک مقدار ویژگی نیازی ندارد فقط چند بار ظاهر شود تا منجر به همبستگیهای کاذب شود. کلمهای را در نظر بگیرید که در ۱۰۰ نمونه در دادههای آموزشی شما ظاهر میشود و ۵۴٪ مواقع با احساس مثبت و ۴۶٪ مواقع با احساس منفی مرتبط است. این تفاوت ممکن است کاملاً یک نوسان آماری باشد، با این حال مدل شما احتمالاً یاد میگیرد از آن ویژگی برای وظیفهٔ طبقهبندی خود استفاده کند. این یکی از رایجترین منابع بیشبرازش است.
در اینجا یک مثال قابل توجه است. MNIST را بگیرید. یک مجموعهٔ آموزشی جدید با الحاق ۷۸۴ بُعد نویز سفید به ۷۸۴ بُعد موجود داده ایجاد کنید — بنابراین نیمی از داده اکنون نویز است. برای مقایسه، یک مجموعهدادهٔ معادل نیز با الحاق ۷۸۴ بُعد همهصفر ایجاد کنید. الحاق ویژگیهای بیمعنی ما بههیچوجه بر محتوای اطلاعاتی دادهها تأثیر نمیگذارد: ما فقط دادههای نامرتبط اضافه میکنیم. دقت طبقهبندی انسانی بههیچوجه تحت تأثیر این تبدیلها قرار نمیگیرد.
لیستینگ ۵.۱: افزودن کانالهای نویز سفید یا کانالهای همهصفر به MNIST
from keras.datasets import mnistimport numpy as np
(train_images, train_labels), _ = mnist.load_data()train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255
train_images_with_noise_channels = np.concatenate(    [train_images, np.random.random((len(train_images), 784))], axis=1)
train_images_with_zeros_channels = np.concatenate(    [train_images, np.zeros((len(train_images), 784))], axis=1)
حالا، بیایید مدل فصل ۲ را روی هر دو مجموعهٔ آموزشی آموزش دهیم.
لیستینگ ۵.۲: آموزش همان مدل روی دادههای MNIST با کانالهای نویز یا کانالهای همهصفر
import kerasfrom keras import layers
def get_model():    model = keras.Sequential(        [            layers.Dense(512, activation="relu"),            layers.Dense(10, activation="softmax"),        ]    )    model.compile(        optimizer="adam",        loss="sparse_categorical_crossentropy",        metrics=["accuracy"],    )    return model
model = get_model()history_noise = model.fit(    train_images_with_noise_channels,    train_labels,    epochs=10,    batch_size=128,    validation_split=0.2,)
model = get_model()history_zeros = model.fit(    train_images_with_zeros_channels,    train_labels,    epochs=10,    batch_size=128,    validation_split=0.2,)
با وجود اینکه داده در هر دو حالت اطلاعات یکسانی دارد، دقت اعتبارسنجی مدل آموزشدیده با کانالهای نویز حدود یک درصد پایینتر است — صرفاً از طریق تأثیر همبستگیهای کاذب (شکل ۵.۶). هر چه کانالهای نویز بیشتری اضافه کنید، دقت بیشتر کاهش مییابد.
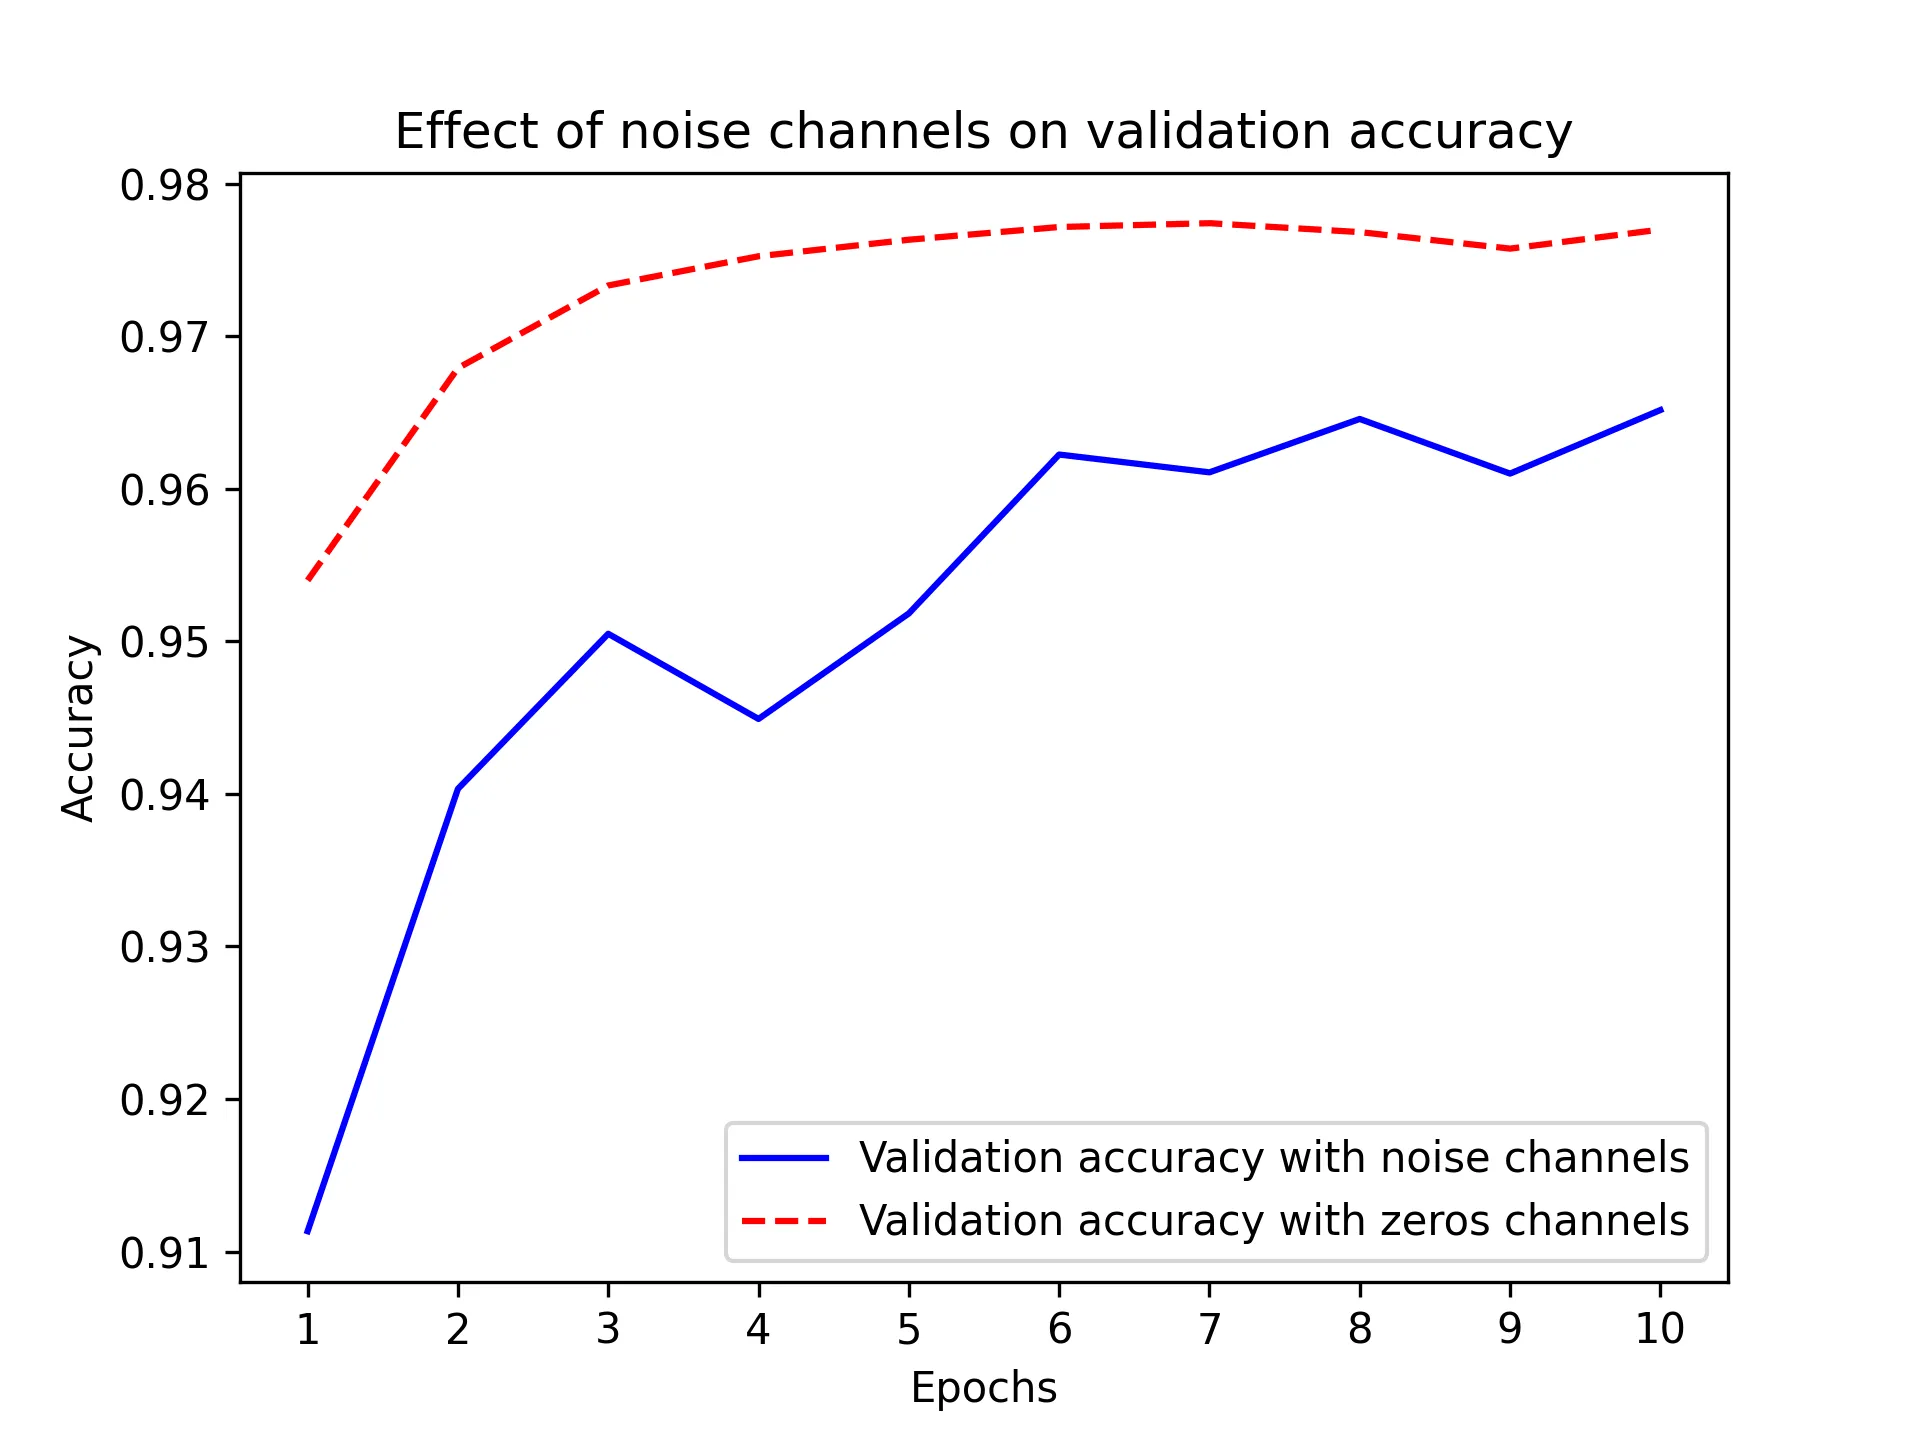
شکل ۵.۶: تأثیر کانالهای نویز بر دقت اعتبارسنجی
ویژگیهای نویزی inevitably منجر به بیشبرازش میشوند. به این ترتیب، در مواردی که مطمئن نیستید ویژگیهایی که دارید آموزنده هستند یا حواسپرتکننده، رایج است که قبل از آموزش انتخاب ویژگی انجام دهید. محدود کردن دادههای IMDB به ۱۰,۰۰۰ کلمهٔ رایجتر یک شکل خام انتخاب ویژگی بود، برای مثال. روش معمول برای انجام انتخاب ویژگی این است که یک نمرهٔ سودمندی برای هر ویژگی موجود محاسبه کنید — معیاری از اینکه ویژگی نسبت به وظیفه چقدر آموزنده است، مانند اطلاعات متقابل بین ویژگی و برچسبها — و فقط ویژگیهایی را نگه دارید که بالای یک آستانه هستند. انجام این کار کانالهای نویز سفید را در مثال قبلی فیلتر میکند.
ماهیت تعمیم در یادگیری عمیق
Section titled “ماهیت تعمیم در یادگیری عمیق”یک واقعیت قابل توجه دربارهٔ مدلهای یادگیری عمیق این است که میتوان آنها را طوری آموزش داد که هر چیزی را برازش دهند، تا زمانی که قدرت بازنمایی کافی داشته باشند.
باور نمیکنید؟ سعی کنید ترتیب برچسبهای MNIST را به هم بزنید و یک مدل روی آن آموزش دهید. حتی اگر هیچ رابطهای بین ورودیها و برچسبهای بههمریخته وجود نداشته باشد، زیان آموزش بهخوبی کاهش مییابد، حتی با یک مدل نسبتاً کوچک. طبیعتاً زیان اعتبارسنجی در طول زمان اصلاً بهبود نمییابد، زیرا در این تنظیم هیچ امکانی برای تعمیم وجود ندارد.
لیستینگ ۵.۳: برازش یک مدل MNIST با برچسبهای تصادفی بههمریخته
(train_images, train_labels), _ = mnist.load_data()train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255
# Copies train_labelsrandom_train_labels = train_labels[:]np.random.shuffle(random_train_labels)
model = keras.Sequential(    [        layers.Dense(512, activation="relu"),        layers.Dense(10, activation="softmax"),    ])model.compile(    optimizer="rmsprop",    loss="sparse_categorical_crossentropy",    metrics=["accuracy"],)model.fit(    train_images,    random_train_labels,    epochs=100,    batch_size=128,    validation_split=0.2,)
در واقع، حتی نیازی نیست این کار را با دادههای MNIST انجام دهید — میتوانید بهسادگی ورودیهای نویز سفید و برچسبهای تصادفی تولید کنید. میتوانستید یک مدل روی آن هم برازش دهید، تا زمانی که پارامترهای کافی داشته باشد. این کار صرفاً ورودیهای خاص را حفظ میکند، بسیار شبیه به یک دیکشنری پایتون.
اگر اینطور است، پس چرا مدلهای یادگیری عمیق اصلاً تعمیم مییابند؟ آیا نباید صرفاً یک نگاشت موردی بین ورودیها و اهداف آموزشی یاد بگیرند، مانند یک dict فانتزی؟ چه انتظاری میتوانیم داشته باشیم که این نگاشت برای ورودیهای جدید کار کند؟
همانطور که معلوم است، ماهیت تعمیم در یادگیری عمیق نسبتاً ارتباط کمی با خود مدلهای یادگیری عمیق دارد و بیشتر به ساختار اطلاعات در دنیای واقعی مربوط میشود. بیایید نگاهی بیندازیم به آنچه واقعاً در اینجا میگذرد.
فرضیهٔ منیفولد
Section titled “فرضیهٔ منیفولد”ورودی یک طبقهبند MNIST (قبل از پیشپردازش) یک آرایهٔ ۲۸×۲۸ از اعداد صحیح بین ۰ و ۲۵۵ است. بنابراین تعداد کل مقادیر ورودی ممکن ۲۵۶ به توان ۷۸۴ است — بسیار بیشتر از تعداد اتمهای جهان. با این حال، تعداد بسیار کمی از این ورودیها شبیه نمونههای معتبر MNIST خواهند بود: ارقام دستنویس واقعی فقط یک زیرفضای کوچک از فضای والد تمام آرایههای ۲۸×۲۸ uint8 ممکن را اشغال میکنند. علاوه بر این، این زیرفضا فقط مجموعهای از نقاط پراکنده بهصورت تصادفی در فضای والد نیست: این زیرفضا بهشدت ساختاریافته است.
اول، زیرفضای ارقام دستنویس معتبر پیوسته است: اگر یک نمونه بگیرید و کمی آن را تغییر دهید، هنوز بهعنوان همان رقم دستنویس قابل تشخیص خواهد بود. علاوه بر این، تمام نمونههای زیرفضای معتبر توسط مسیرهای صافی که از زیرفضا میگذرند به هم متصل هستند. این بدان معناست که اگر دو رقم MNIST تصادفی A و B بگیرید، دنبالهای از تصاویر «میانی» وجود دارد که A را به B تبدیل میکند، بهطوری که دو رقم متوالی بسیار نزدیک به هم هستند (شکل ۵.۷ را ببینید). شاید چند شکل مبهم نزدیک به مرز بین دو کلاس وجود داشته باشد، اما حتی این شکلها نیز بسیار شبیه رقم به نظر میرسند.
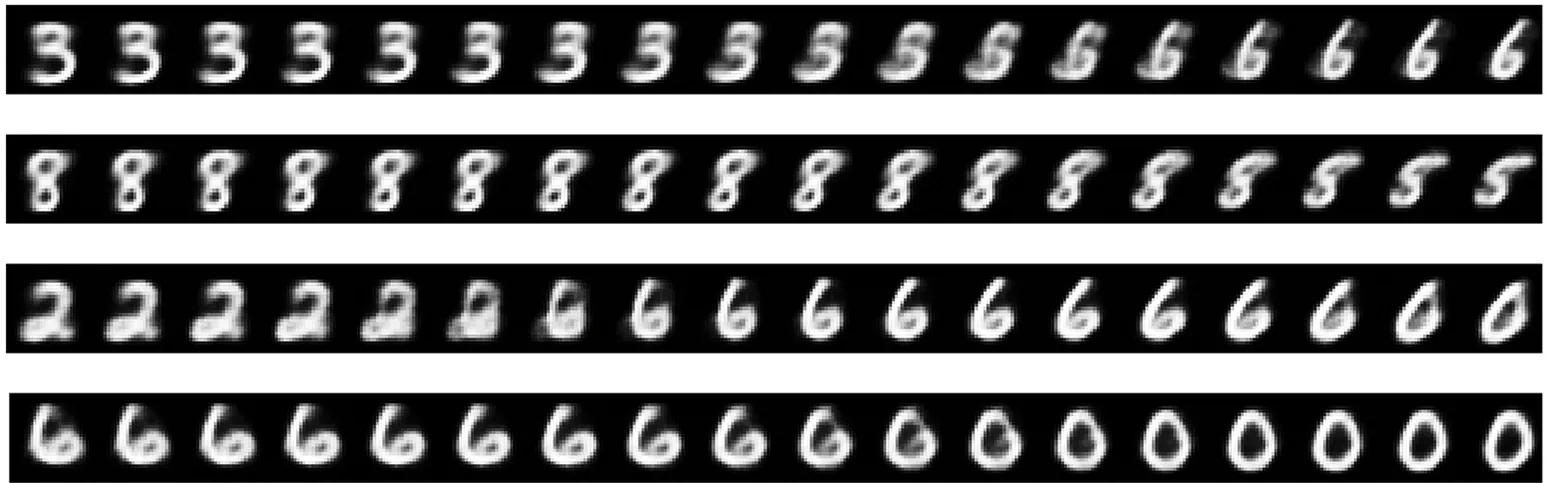
شکل ۵.۷: ارقام مختلف MNIST که بهتدریج به یکدیگر تبدیل میشوند، نشان میدهد که فضای ارقام دستنویس یک «منیفولد» را تشکیل میدهد. این تصویر با استفاده از کد فصل ۱۷ تولید شده است.
از نظر فنی، میگویید که ارقام دستنویس یک منیفولد در فضای آرایههای ۲۸×۲۸ uint8 ممکن را تشکیل میدهند. این کلمهٔ بزرگی است، اما مفهوم کاملاً شهودی است. یک منیفولد یک زیرفضای کمبعدتر از یک فضای والد است که بهصورت محلی شبیه به یک فضای خطی (اقلیدسی) است. برای مثال، یک منحنی صاف در صفحه یک منیفولد 1D در یک فضای 2D است زیرا برای هر نقطه از منحنی میتوانید یک خط مماس رسم کنید (منحنی را میتوان در هر نقطه با یک خط تقریب زد). یک سطح صاف در یک فضای 3D یک منیفولد 2D است. و به همین ترتیب.
بهطور کلیتر، فرضیهٔ منیفولد بیان میکند که تمام دادههای طبیعی روی یک منیفولد کمبعد در فضای بعدبالایی که در آن کدگذاری شدهاند قرار دارند. این یک ادعای نسبتاً قوی دربارهٔ ساختار اطلاعات در جهان است. تا آنجا که میدانیم، این درست است، و دلیلی است که یادگیری عمیق کار میکند. این برای ارقام MNIST، و همچنین برای چهرههای انسانی، ریختشناسی درخت، صداهای صدای انسان و حتی زبان طبیعی صادق است.
فرضیهٔ منیفولد دلالت دارد بر
- مدلهای یادگیری ماشین فقط باید زیرفضاهای نسبتاً ساده، کمبعد و بهشدت ساختاریافته در فضای ورودی بالقوه خود (منیفولدهای نهفته) را برازش دهند.
- درون یکی از این منیفولدها، همیشه امکان درونیابی بین دو ورودی وجود دارد — یعنی تبدیل یکی به دیگری از طریق یک مسیر پیوسته که در طول آن همه نقاط روی منیفولد قرار میگیرند.
توانایی درونیابی بین نمونهها کلید درک تعمیم در یادگیری عمیق است.
درونیابی بهعنوان منبع تعمیم
Section titled “درونیابی بهعنوان منبع تعمیم”اگر با نقاط دادهای کار میکنید که میتوانند درونیابی شوند، میتوانید شروع به معنا بخشیدن به نقاطی کنید که هرگز ندیدهاید با ارتباط دادن آنها به نقاط دیگری که نزدیک در منیفولد قرار دارند. به عبارت دیگر، میتوانید کل فضای را با استفاده از تنها یک نمونه از فضا درک کنید. میتوانید از درونیابی برای پر کردن جاهای خالی استفاده کنید.
توجه داشته باشید که درونیابی روی منیفولد نهفته با درونیابی خطی در فضای والد متفاوت است، همانطور که در شکل ۵.۸ نشان داده شده است. برای مثال، میانگین پیکسلها بین دو رقم MNIST معمولاً یک رقم معتبر نیست.
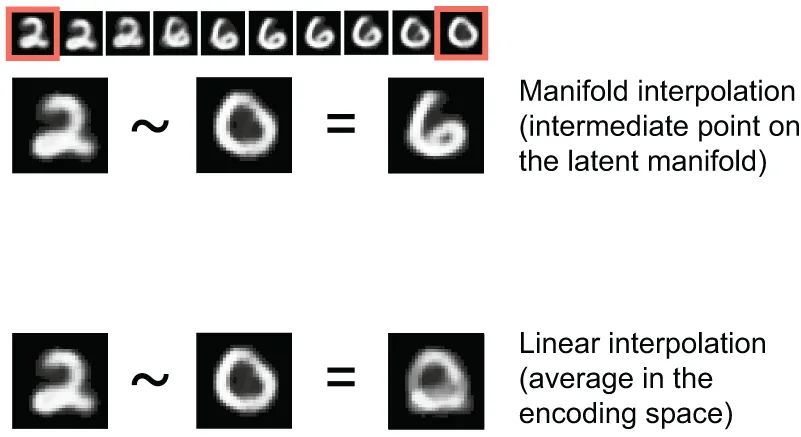
شکل ۵.۸: تفاوت بین درونیابی خطی و درونیابی روی منیفولد نهفته. هر نقطه روی منیفولد نهفته ارقام یک رقم معتبر است، اما میانگین دو رقم معمولاً نیست.
بهطور حیاتی، اگرچه یادگیری عمیق از طریق درونیابی روی یک تقریب یادگرفتهشده از منیفولد داده به تعمیم دست مییابد، اشتباه است که فرض کنیم درونیابی همهٔ آن چیزی است که تعمیم دربارهٔ آن است. این نوک کوه یخ است. درونیابی فقط میتواند به شما در درک چیزهایی که بسیار نزدیک به آنچه قبلاً دیدهاید هستند کمک کند: این تعمیم محلی را ممکن میسازد. اما بهطور قابل توجهی، انسانها همیشه با نوآوری شدید سر و کار دارند و خوب عمل میکنند. شما نیازی ندارید که از قبل روی نمونههای بیشماری از هر موقعیتی که تاکنون با آن روبرو خواهید شد آموزش ببینید. هر یک از روزهای شما با هر روزی که قبلاً تجربه کردهاید متفاوت است و با هر روزی که هر کسی از آغاز بشریت تجربه کرده است متفاوت است. میتوانید بین گذراندن یک هفته در نیویورک، یک هفته در شانگهای و یک هفته در بنگلور جابهجا شوید بدون نیاز به هزاران عمر یادگیری و تمرین برای هر شهر.
انسانها قادر به تعمیم شدید هستند، که توسط مکانیزمهای شناختی غیر از درونیابی ممکن میشود — انتزاع، مدلهای نمادین از جهان، استدلال، منطق، عقل سلیم، پیشینیهای ذاتی دربارهٔ جهان — آنچه عموماً عقل مینامیم، در مقابل شهود و تشخیص الگو. دومی عمدتاً ماهیت درونیابی دارند، اما اولی اینطور نیست. هر دو برای هوش ضروری هستند. در فصل ۱۹ بیشتر دربارهٔ این صحبت خواهیم کرد.
چرا یادگیری عمیق کار میکند
Section titled “چرا یادگیری عمیق کار میکند”استعارهٔ توپ کاغذی مچالهشده از فصل ۲ را به یاد دارید؟ یک ورق کاغذ یک منیفولد 2D در فضای 3D را نشان میدهد (شکل ۵.۹). یک مدل یادگیری عمیق ابزاری برای باز کردن توپهای کاغذی است — یعنی برای از هم باز کردن منیفولدهای نهفته.
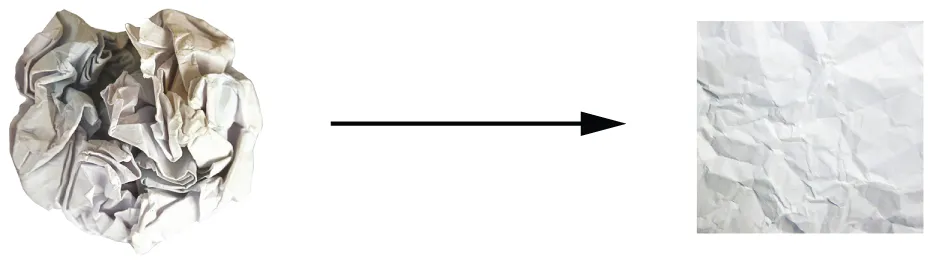
شکل ۵.۹: باز کردن یک منیفولد پیچیده از داده
یک مدل یادگیری عمیق اساساً یک منحنی بسیار بعدبالا است. این منحنی صاف و پیوسته است (با محدودیتهای اضافی بر ساختار آن، که از پیشینیهای معماری مدل نشأت میگیرند) زیرا باید مشتقپذیر باشد. و آن منحنی از طریق نزول گرادیان به نقاط داده برازش داده میشود — بهصورت صاف و تدریجی. بر اساس ساخت، یادگیری عمیق دربارهٔ گرفتن یک منحنی بزرگ و پیچیده — یک منیفولد — و تنظیم تدریجی پارامترهای آن تا زمانی که به برخی نقاط دادهٔ آموزشی برازش یابد است.
این منحنی شامل پارامترهای کافی است که میتواند هر چیزی را برازش دهد. در واقع، اگر مدل خود را بهاندازهٔ کافی طولانی آموزش دهید، در نهایت صرفاً دادههای آموزشی خود را حفظ میکند و اصلاً تعمیم نمییابد. با این حال، دادهای که به آن برازش میدهید از نقاط منزوی پراکنده در فضای زیرین ساخته نشده است. دادههای شما یک منیفولد بهشدت ساختاریافته و کمبعد در فضای ورودی تشکیل میدهند — این همان فرضیهٔ منیفولد است. و از آنجا که برازش منحنی مدل شما به این داده بهصورت تدریجی و صاف در طول زمان، با پیشرفت نزول گرادیان اتفاق میافتد، یک نقطهٔ میانی در طول آموزش وجود خواهد داشت که در آن مدل تقریباً منیفولد طبیعی داده را تقریب میزند، همانطور که در شکل ۵.۱۰ میبینید.
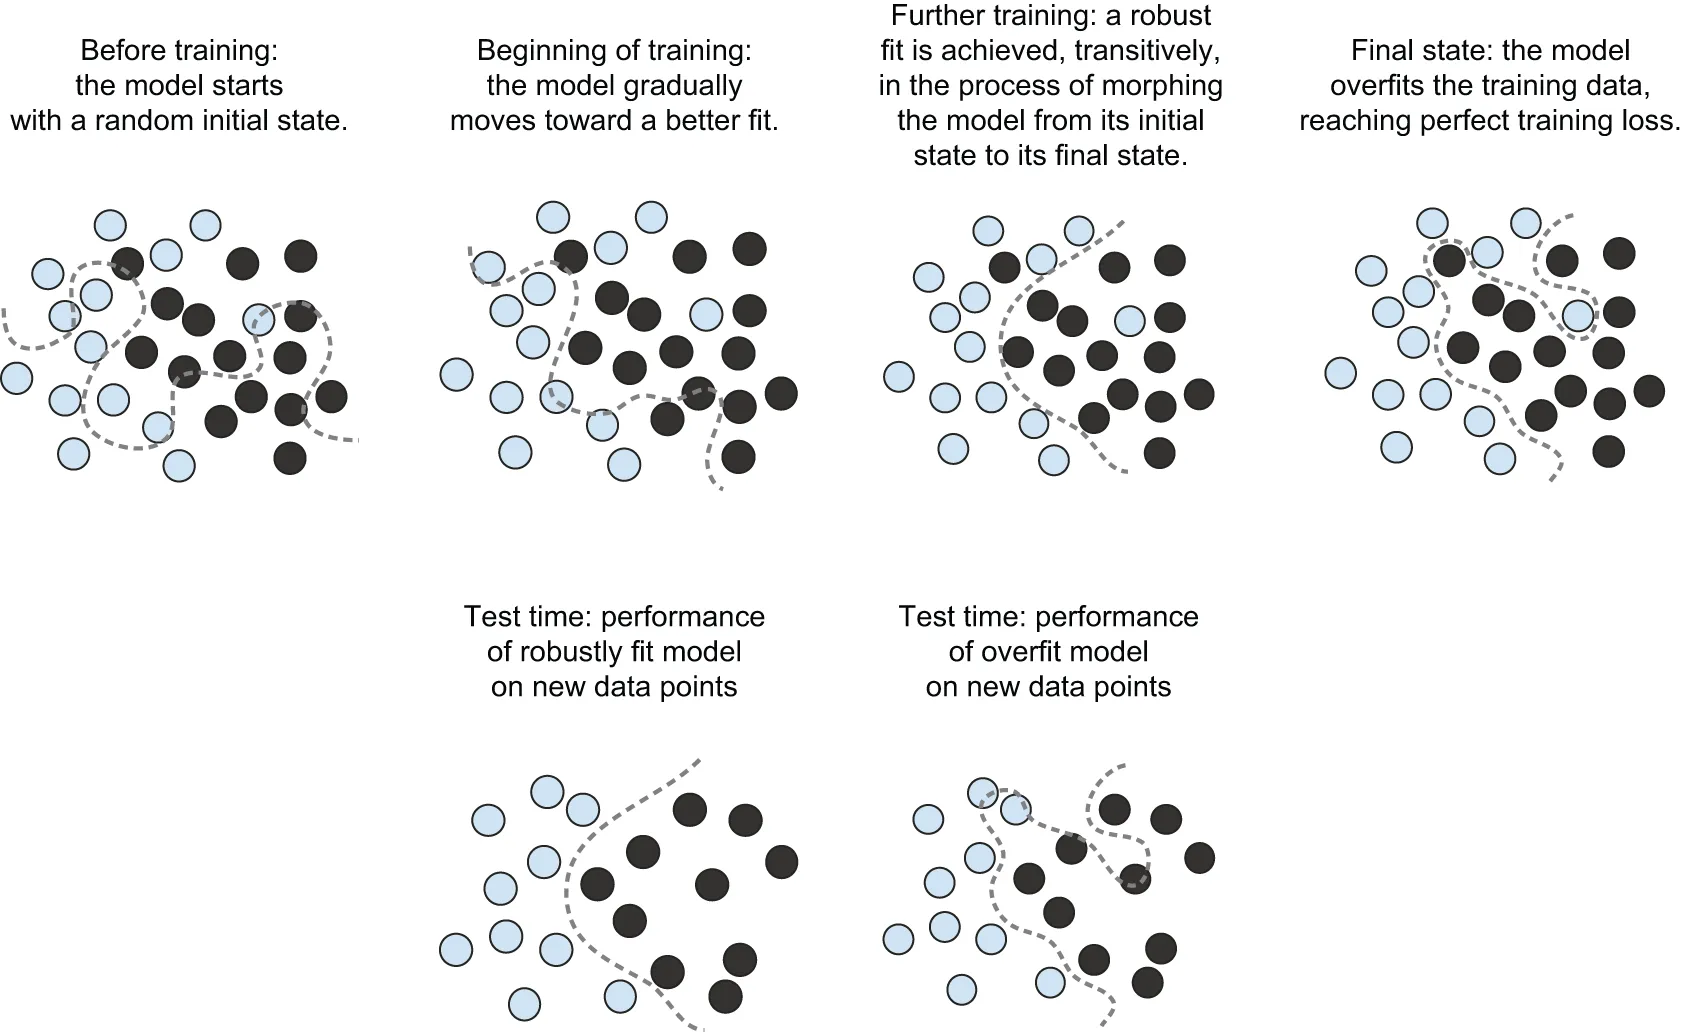
شکل ۵.۱۰: رفتن از یک مدل تصادفی به یک مدل بیشبرازششده و دستیابی به یک برازش قوی بهعنوان یک حالت میانی
حرکت در طول منحنی یادگرفتهشده توسط مدل در آن نقطه به حرکت در طول منیفولد نهفتهٔ واقعی داده نزدیک میشود. به این ترتیب، مدل قادر خواهد بود از طریق درونیابی بین ورودیهای آموزشی، به ورودیهای هرگز دیدهنشده معنا بدهد.
علاوه بر واقعیت سادهٔ اینکه قدرت بازنمایی کافی دارند، چند ویژگی از مدلهای یادگیری عمیق وجود دارد که آنها را بهویژه برای یادگیری منیفولدهای نهفته مناسب میکند:
- مدلهای یادگیری عمیق یک نگاشت صاف و پیوسته از ورودیهایشان به خروجیهایشان پیادهسازی میکنند. این نگاشت باید صاف و پیوسته باشد زیرا باید مشتقپذیر باشد، از روی ناچاری (در غیر این صورت نمیتوانستید نزول گرادیان انجام دهید). این صافی به تقریب منیفولدهای نهفته کمک میکند، که از همان ویژگیها پیروی میکنند.
- مدلهای یادگیری عمیق تمایل دارند بهگونهای ساختار یابند که «شکل» اطلاعات موجود در دادههای آموزشیشان را منعکس کنند (از طریق پیشینیهای معماری). این بهطور خاص برای مدلهای پردازش تصویر (فصلهای ۸-۱۲ را ببینید) و مدلهای پردازش دنباله (فصل ۱۳ را ببینید) صادق است. بهطور کلیتر، شبکههای عصبی عمیق بازنماییهای یادگرفتهشده خود را به روشی سلسلهمراتبی و ماژولار ساختار میدهند، که بازتاب روشی است که دادههای طبیعی سازماندهی میشوند.
دادههای آموزشی اهمیت paramount دارند
Section titled “دادههای آموزشی اهمیت paramount دارند”در حالی که یادگیری عمیق واقعاً برای یادگیری منیفولد مناسب است، قدرت تعمیم بیشتر نتیجهٔ ساختار طبیعی دادههای شماست تا نتیجهٔ هر ویژگی از مدل شما. شما فقط در صورتی قادر به تعمیم خواهید بود که دادههایتان یک منیفولد را تشکیل دهند که در آن نقاط میتوانند درونیابی شوند. هر چه ویژگیهای شما آموزندهتر و کمنویزتر باشند، بهتر قادر به تعمیم خواهید بود، زیرا فضای ورودی شما سادهتر و بهتر ساختاریافته خواهد بود. گردآوری داده و مهندسی ویژگی برای تعمیم ضروری هستند.
علاوه بر این، از آنجا که یادگیری عمیق برازش منحنی است، برای اینکه یک مدل عملکرد خوبی داشته باشد، باید روی یک نمونهبرداری چگال از فضای ورودیاش آموزش دیده باشد. یک «نمونهبرداری چگال» در این زمینه به این معناست که دادههای آموزشی باید بهطور چگال کل منیفولد دادهٔ ورودی را پوشش دهند (شکل ۵.۱۱ را ببینید). این بهویژه در نزدیکی مرزهای تصمیم صادق است. با یک نمونهبرداری بهاندازهٔ کافی چگال، ممکن است با درونیابی بین ورودیهای آموزشی گذشته، بدون نیاز به استفاده از عقل سلیم، استدلال انتزاعی یا دانش خارجی دربارهٔ جهان — همه چیزهایی که مدلهای یادگیری ماشین به آنها دسترسی ندارند — به ورودیهای جدید معنا ببخشید.
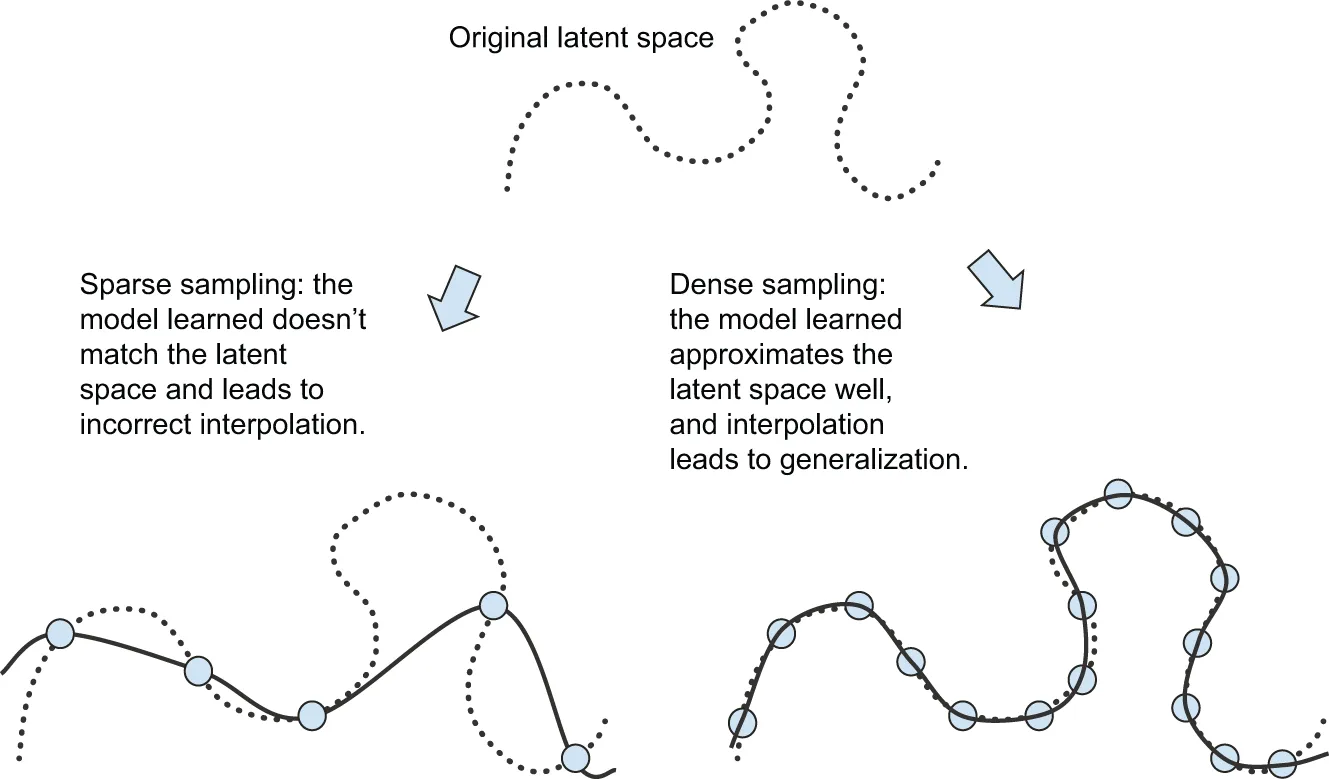
شکل ۵.۱۱: یک نمونهبرداری چگال از فضای ورودی برای یادگیری مدلی قادر به تعمیم دقیق ضروری است.
به این ترتیب، همیشه باید در ذهن داشته باشید که بهترین راه برای بهبود یک مدل یادگیری عمیق آموزش آن روی دادههای بیشتر یا بهتر است (البته، افزودن دادههای بیشازحد نویزی یا نادرست به تعمیم آسیب میرساند). پوشش چگالتر منیفولد دادهٔ ورودی مدلی را به دست میدهد که بهتر تعمیم مییابد. هرگز نباید از یک مدل یادگیری عمیق انتظار داشته باشید که کاری بیش از درونیابی خام بین نمونههای آموزشیاش انجام دهد، و بنابراین باید هر کاری که میتوانید انجام دهید تا درونیابی را تا حد ممکن آسان کنید. تنها چیزی که در یک مدل یادگیری عمیق پیدا خواهید کرد همان چیزی است که در آن قرار میدهید: پیشینیهای کدگذاریشده در معماری آن و دادههایی که روی آن آموزش دیده است.
وقتی به دست آوردن دادهٔ بیشتر ممکن نیست، بهترین راهحل بعدی تنظیم مقدار اطلاعاتی است که مدل شما مجاز به ذخیرهسازی آن است، یا افزودن محدودیتهایی بر صافی منحنی مدل است. اگر یک شبکه فقط بتواند تعداد کمی الگو یا الگوهای بسیار منظم را حفظ کند، فرآیند بهینهسازی آن را مجبور میکند روی برجستهترین الگوها تمرکز کند، که شانس بهتری برای تعمیم خوب دارند. فرآیند مبارزه با بیشبرازش به این روش تنظیم نامیده میشود. ما تکنیکهای تنظیم را با عمق در بخش ۵.۴.۴ مرور خواهیم کرد.
قبل از اینکه شروع به تنظیم مدل خود برای کمک به تعمیم بهتر کنید، به راهی برای ارزیابی اینکه مدل شما در حال حاضر چگونه عمل میکند نیاز دارید. در بخش زیر، دربارهٔ نحوهٔ نظارت بر تعمیم در طول توسعهٔ مدل خواهید آموخت: ارزیابی مدل.
ارزیابی مدلهای یادگیری ماشین
Section titled “ارزیابی مدلهای یادگیری ماشین”شما فقط میتوانید آنچه را که میتوانید مشاهده کنید کنترل کنید. از آنجا که هدف شما توسعهٔ مدلهایی است که بتوانند با موفقیت به دادههای جدید تعمیم یابند، ضروری است که بتوانید قدرت تعمیم مدل خود را بهطور قابل اعتماد اندازهگیری کنید. در این بخش، بهطور رسمی روشهای مختلفی را که میتوانید مدلهای یادگیری ماشین را ارزیابی کنید معرفی میکنیم. شما قبلاً بیشتر آنها را در فصل قبل در عمل دیدهاید.
مجموعههای آموزشی، اعتبارسنجی و آزمایشی
Section titled “مجموعههای آموزشی، اعتبارسنجی و آزمایشی”ارزیابی یک مدل همیشه به تقسیم دادههای موجود به سه مجموعه خلاصه میشود: آموزشی، اعتبارسنجی و آزمایشی. شما روی دادههای آموزشی آموزش میدهید و مدل خود را روی دادههای اعتبارسنجی ارزیابی میکنید. وقتی مدل شما آمادهٔ زمان اصلی شد، آن را یک بار نهایی روی دادههای آزمایشی آزمایش میکنید، که قرار است تا حد ممکن شبیه به دادههای تولیدی باشد. سپس میتوانید مدل را در تولید مستقر کنید.
ممکن است بپرسید، چرا دو مجموعه نداشته باشیم: یک مجموعهٔ آموزشی و یک مجموعهٔ آزمایشی؟ روی دادههای آموزشی آموزش میدهید و روی دادههای آزمایشی ارزیابی میکنید. بسیار سادهتر!
دلیل این است که توسعهٔ یک مدل همیشه شامل تنظیم پیکربندی آن است: برای مثال، انتخاب تعداد لایهها یا اندازهٔ لایهها (که فراپارامترهای مدل نامیده میشوند، برای تمایز از پارامترها که وزنهای شبکه هستند). شما این تنظیم را با استفاده از عملکرد مدل روی دادههای اعتبارسنجی بهعنوان سیگنال بازخورد انجام میدهید. در اصل، این تنظیم شکلی از یادگیری است: جستجو برای یک پیکربندی خوب در برخی فضای پارامتر. در نتیجه، تنظیم پیکربندی مدل بر اساس عملکرد آن روی مجموعهٔ اعتبارسنجی میتواند بهسرعت منجر به بیشبرازش به مجموعهٔ اعتبارسنجی شود، حتی اگر مدل شما هرگز مستقیماً روی آن آموزش ندیده باشد.
مرکز این پدیده مفهوم نشت اطلاعات است. هر بار که یک فراپارامتر از مدل خود را بر اساس عملکرد مدل روی مجموعهٔ اعتبارسنجی تنظیم میکنید، مقداری اطلاعات دربارهٔ دادههای اعتبارسنجی به مدل نشت میکند. اگر این کار را فقط یک بار، برای یک پارامتر انجام دهید، بیتهای اطلاعاتی بسیار کمی نشت میکنند و مجموعهٔ اعتبارسنجی شما برای ارزیابی مدل قابل اعتماد باقی میماند. اما اگر این کار را بارها تکرار کنید — اجرای یک آزمایش، ارزیابی روی مجموعهٔ اعتبارسنجی و اصلاح مدل خود بهعنوان نتیجه — آنگاه مقدار فزایندهٔ قابل توجهی از اطلاعات دربارهٔ مجموعهٔ اعتبارسنجی را به مدل نشت میدهید.
در پایان روز، با مدلی مواجه خواهید شد که بهطور مصنوعی روی دادههای اعتبارسنجی عملکرد خوبی دارد زیرا برای همان چیزی که بهینهسازی کردهاید. شما به عملکرد روی دادههای کاملاً جدید اهمیت میدهید، نه دادههای اعتبارسنجی، بنابراین باید از یک مجموعهدادهٔ کاملاً متفاوت و هرگز دیدهنشده برای ارزیابی مدل استفاده کنید: مجموعهٔ آزمایشی. مدل شما نباید به هیچ اطلاعاتی دربارهٔ مجموعهٔ آزمایشی دسترسی داشته باشد، حتی بهطور غیرمستقیم. اگر هر چیزی دربارهٔ مدل بر اساس عملکرد مجموعهٔ آزمایشی تنظیم شده باشد، اندازهگیری تعمیم شما معیوب خواهد بود.
تقسیم دادههای خود به مجموعههای آموزشی، اعتبارسنجی و آزمایشی ممکن است ساده به نظر برسد، اما چند روش پیشرفته برای انجام این کار وجود دارد که میتواند زمانی که دادهٔ کمی در دسترس است مفید باشد. بیایید سه دستور ارزیابی کلاسیک را مرور کنیم: اعتبارسنجی سادهٔ نگهداشتهشده، اعتبارسنجی K-تایی و اعتبارسنجی K-تایی تکراری با بههمریختن. همچنین دربارهٔ استفاده از خطوط پایهٔ عقل سلیم برای بررسی اینکه آموزش شما به جایی میرسد صحبت خواهیم کرد.
اعتبارسنجی سادهٔ نگهداشتهشده
Section titled “اعتبارسنجی سادهٔ نگهداشتهشده”بخشی از دادههای خود را بهعنوان مجموعهٔ آزمایشی کنار بگذارید. روی دادههای باقیمانده آموزش دهید و روی مجموعهٔ آزمایشی ارزیابی کنید. همانطور که در بخشهای قبلی دیدید، برای جلوگیری از نشت اطلاعات، نباید مدل خود را بر اساس مجموعهٔ آزمایشی تنظیم کنید، و بنابراین باید یک مجموعهٔ اعتبارسنجی نیز رزرو کنید.
از نظر شماتیک، اعتبارسنجی نگهداشتهشده شبیه شکل ۵.۱۲ است. لیستینگ زیر یک پیادهسازی ساده را نشان میدهد.
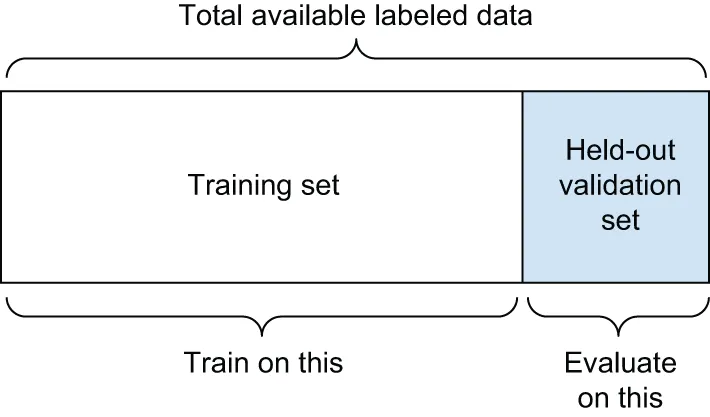
شکل ۵.۱۲: تقسیم اعتبارسنجی سادهٔ نگهداشتهشده
لیستینگ ۵.۴: اعتبارسنجی نگهداشتهشده (توجه داشته باشید که برچسبها برای سادگی حذف شدهاند)
num_validation_samples = 10000# Shuffling the data is usually appropriate.np.random.shuffle(data)# Defines the validation setvalidation_data = data[:num_validation_samples]# Defines the training settraining_data = data[num_validation_samples:]# Trains a model on the training data and evaluates it on the# validation datamodel = get_model()model.fit(training_data, ...)validation_score = model.evaluate(validation_data, ...)
# At this point, you can tune your model, retrain it, evaluate it, tune# it again, and so on....
# Once you've tuned your hyperparameters, it's common to train your# final model from scratch on all non-test data available.model = get_model()model.fit(    np.concatenate([training_data, validation_data]),    ...,)test_score = model.evaluate(test_data, ...)
این سادهترین پروتکل ارزیابی است و از یک نقص رنج میبرد: اگر دادهٔ کمی در دسترس باشد، مجموعههای اعتبارسنجی و آزمایشی شما ممکن است شامل نمونههای بسیار کمی باشند که از نظر آماری نمایندهٔ دادههای در دسترس باشند. تشخیص این آسان است: اگر دورهای مختلف بههمریختن تصادفی دادهها قبل از تقسیم در نهایت معیارهای بسیار متفاوتی از عملکرد مدل به دست دهند، پس با این مشکل روبرو هستید. اعتبارسنجی K-تایی و اعتبارسنجی K-تایی تکراری دو روش برای حل این مشکل هستند، همانطور که در ادامه بحث میشود.
اعتبارسنجی K-تایی
Section titled “اعتبارسنجی K-تایی”با این رویکرد، دادههای خود را به K قسمت با اندازهٔ مساوی تقسیم میکنید. برای هر قسمت i، یک مدل روی K - 1 قسمت باقیمانده آموزش دهید و آن را روی قسمت i ارزیابی کنید. نمرهٔ نهایی شما سپس میانگین نمرات K به دستآمده است. این روش زمانی مفید است که عملکرد مدل شما واریانس قابل توجهی بر اساس تقسیم آموزش/آزمایش شما نشان دهد. مانند اعتبارسنجی نگهداشتهشده، این روش شما را از استفاده از یک مجموعهٔ اعتبارسنجی متمایز برای کالیبراسیون مدل معاف نمیکند.
از نظر شماتیک، اعتبارسنجی متقاطع K-تایی شبیه شکل ۵.۱۳ است. لیستینگ ۵.۶ یک پیادهسازی ساده را نشان میدهد.
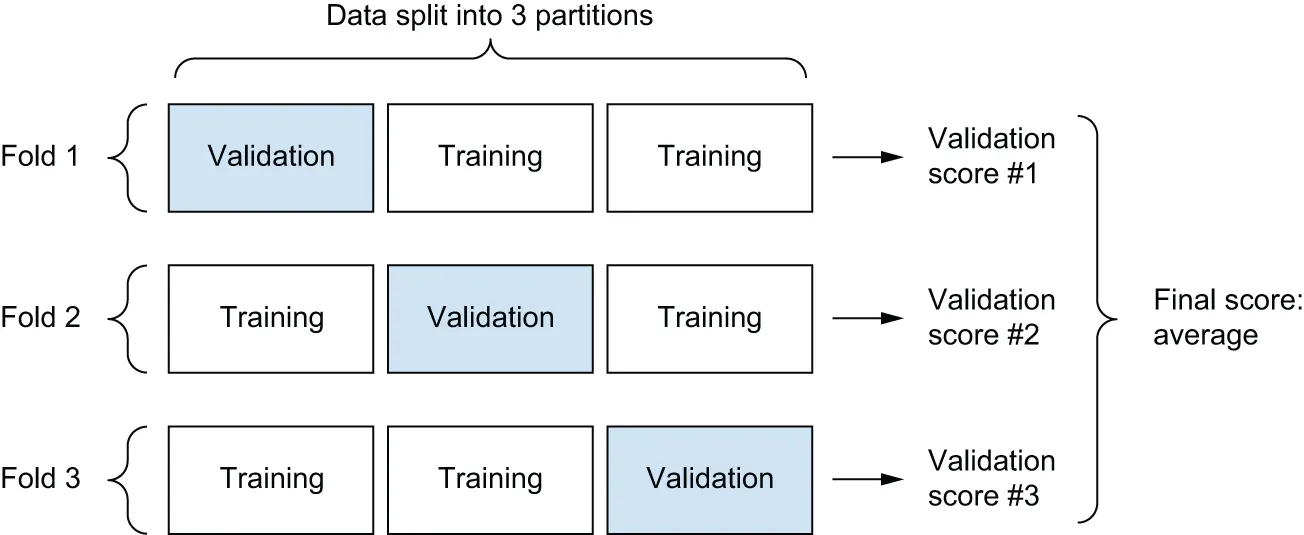
شکل ۵.۱۳: اعتبارسنجی سهتایی
لیستینگ ۵.۵: اعتبارسنجی متقاطع K-تایی (توجه داشته باشید که برچسبها برای سادگی حذف شدهاند)
k = 3num_validation_samples = len(data) // knp.random.shuffle(data)validation_scores = []for fold in range(k): # Selects the validation-data partition validation_data = data[ num_validation_samples * fold : num_validation_samples * (fold + 1) ] # Uses the remainder of the data as training data. training_data = np.concatenate( data[: num_validation_samples * fold], data[num_validation_samples * (fold + 1) :], ) # Creates a brand-new instance of the model (untrained) model = get_model() model.fit(training_data, ...) validation_score = model.evaluate(validation_data, ...) validation_scores.append(validation_score)# Validation score: average of the validation scores of the k foldsvalidation_score = np.average(validation_scores)# Trains the final model on all non-test data availablemodel = get_model()model.fit(data, ...)test_score = model.evaluate(test_data, ...)اعتبارسنجی K-تایی تکراری با بههمریختن
Section titled “اعتبارسنجی K-تایی تکراری با بههمریختن”این یکی برای موقعیتهایی است که دادهٔ نسبتاً کمی در دسترس دارید و باید مدل خود را تا حد ممکن دقیق ارزیابی کنید. من آن را در مسابقات Kaggle بسیار مفید یافتهام. شامل اعمال اعتبارسنجی K-تایی چندین بار است، با بههمریختن دادهها هر بار قبل از تقسیم آن به K روش. نمرهٔ نهایی میانگین نمرات بهدستآمده در هر اجرای اعتبارسنجی K-تایی است. توجه داشته باشید که در نهایت P * K مدل را آموزش و ارزیابی میکنید (که P تعداد تکرارهایی است که استفاده میکنید)، که میتواند بسیار گران باشد.
غلبه بر یک خط پایهٔ عقل سلیم
Section titled “غلبه بر یک خط پایهٔ عقل سلیم”علاوه بر پروتکلهای ارزیابی مختلفی که در دسترس دارید، یک چیز آخر که باید بدانید استفاده از خطوط پایهٔ عقل سلیم است.
آموزش یک مدل یادگیری عمیق کمی شبیه فشار دادن دکمهای است که یک موشک را در یک جهان موازی پرتاب میکند. نمیتوانید آن را بشنوید یا ببینید. نمیتوانید فرآیند یادگیری منیفولد را مشاهده کنید — این فرآیند در فضایی با هزاران بُعد اتفاق میافتد و حتی اگر آن را به 3D تصویر کنید، نمیتوانید آن را تفسیر کنید. تنها بازخوردی که دارید معیارهای اعتبارسنجی شما هستند — مانند یک ارتفاعسنج روی موشک نامرئی شما.
یک نکتهٔ بهویژه مهم این است که بتوانید بگویید آیا اصلاً از زمین بلند میشوید یا نه. ارتفاعی که از آن شروع کردید چه بود؟ به نظر میرسد مدل شما دقت ۱۵٪ دارد، آیا این خوب است؟ قبل از شروع کار با یک مجموعهداده، همیشه باید یک خط پایهٔ ساده انتخاب کنید که سعی در شکستن آن داشته باشید. اگر از آن آستانه عبور کنید، میدانید که کار درستی انجام میدهید: مدل شما در واقع از اطلاعات موجود در دادههای ورودی برای انجام پیشبینیهایی که تعمیم مییابند استفاده میکند — میتوانید ادامه دهید. این خط پایه میتواند عملکرد یک طبقهبند تصادفی یا عملکرد سادهترین تکنیک غیر یادگیری ماشین باشد که میتوانید تصور کنید.
برای مثال، در مثال طبقهبندی ارقام MNIST، یک خط پایهٔ ساده دقت اعتبارسنجی بیشتر از ۰.۱ (طبقهبند تصادفی) خواهد بود؛ در مثال IMDB، دقت اعتبارسنجی بیشتر از ۰.۵ خواهد بود. در مثال Reuters، حدود ۰.۱۸-۰.۱۹ به دلیل عدم تعادل کلاس خواهد بود. اگر یک مسئلهٔ طبقهبندی دودویی دارید که در آن ۹۰٪ نمونهها به کلاس A و ۱۰٪ به کلاس B تعلق دارند، طبقهبندی که همیشه A پیشبینی میکند در حال حاضر دقت اعتبارسنجی ۰.۹ را به دست میآورد و باید بهتر از آن عمل کنید.
داشتن یک خط پایهٔ عقل سلیم که میتوانید به آن مراجعه کنید زمانی ضروری است که روی مسئلهای کار میکنید که هیچکس قبلاً حل نکرده است. اگر نمیتوانید یک راهحل ساده را شکست دهید، مدل شما بیارزش است — شاید مدل اشتباهی استفاده میکنید یا شاید مسئلهای که با آن سر و کار دارید اصلاً با یادگیری ماشین قابل رویکرد نیست. زمان بازگشت به تختهٔ طراحی است.
نکاتی که باید دربارهٔ ارزیابی مدل در ذهن داشته باشید
Section titled “نکاتی که باید دربارهٔ ارزیابی مدل در ذهن داشته باشید”هنگام انتخاب یک پروتکل ارزیابی به موارد زیر توجه کنید:
- نمایندگی داده — شما میخواهید هم مجموعهٔ آموزشی و هم مجموعهٔ آزمایشی نمایندهٔ دادههای در دسترس باشند. برای مثال، اگر سعی در طبقهبندی تصاویر ارقام دارید و از آرایهای از نمونهها شروع میکنید که نمونهها بر اساس کلاسشان مرتب شدهاند، گرفتن ۸۰٪ اول آرایه بهعنوان مجموعهٔ آموزشی و ۲۰٪ باقیمانده بهعنوان مجموعهٔ آزمایشی منجر میشود که مجموعهٔ آموزشی شما فقط شامل کلاسهای ۰-۷ باشد، در حالی که مجموعهٔ آزمایشی شما فقط شامل کلاسهای ۸-۹ باشد. این یک اشتباه مضحک به نظر میرسد، اما بهطور شگفتآوری رایج است. به همین دلیل، معمولاً باید دادههای خود را بهطور تصادفی بههم بریزید قبل از تقسیم آن به مجموعههای آموزشی و آزمایشی.
- پیکان زمان — اگر سعی در پیشبینی آینده با توجه به گذشته دارید (برای مثال، آب و هوای فردا، حرکات سهام و غیره)، نباید دادههای خود را بهطور تصادفی قبل از تقسیم بههم بریزید زیرا این کار یک نشت زمانی ایجاد میکند: مدل شما بهطور مؤثر روی دادههای آینده آموزش میبیند. در چنین موقعیتهایی، همیشه باید اطمینان حاصل کنید که تمام دادههای مجموعهٔ آزمایشی شما پسین نسبت به دادههای مجموعهٔ آموزشی هستند.
- افزونگی در دادههای شما — اگر برخی نقاط داده در دادههای شما دو بار ظاهر شوند (نسبتاً رایج با دادههای دنیای واقعی)، بههمریختن دادهها و تقسیم آن به مجموعهٔ آموزشی و اعتبارسنجی منجر به افزونگی بین مجموعههای آموزشی و اعتبارسنجی میشود. در واقع، شما در حال آزمایش روی بخشی از دادههای آموزشی خود هستید، که بدترین کاری است که میتوانید انجام دهید! مطمئن شوید که مجموعهٔ آموزشی و مجموعهٔ اعتبارسنجی شما جدا از هم هستند.
داشتن یک راه قابل اعتماد برای ارزیابی عملکرد مدل شما چگونگی نظارت بر تنش در قلب یادگیری ماشین — بین بهینهسازی و تعمیم، کمبرازش و بیشبرازش — را ممکن میسازد.
بهبود برازش مدل
Section titled “بهبود برازش مدل”برای دستیابی به برازش کامل، ابتدا باید بیشبرازش کنید. از آنجا که از قبل نمیدانید مرز کجاست، باید از آن عبور کنید تا آن را پیدا کنید. بنابراین، هدف اولیهٔ شما هنگام شروع کار روی یک مسئله دستیابی به مدلی است که مقداری قدرت تعمیم نشان دهد و قادر به بیشبرازش باشد. وقتی چنین مدلی دارید، روی اصلاح تعمیم با مبارزه با بیشبرازش تمرکز خواهید کرد.
سه مشکل رایج وجود دارد که در این مرحله با آنها روبرو خواهید شد:
- آموزش شروع نمیشود: زیان آموزش شما در طول زمان کاهش نمییابد.
- آموزش بهخوبی شروع میشود، اما مدل شما بهطور معناداری تعمیم نمییابد: نمیتوانید خط پایهٔ عقل سلیم خود را شکست دهید.
- زیان آموزش و اعتبارسنجی هر دو در طول زمان کاهش مییابند و میتوانید خط پایهٔ خود را شکست دهید، اما به نظر نمیرسد قادر به بیشبرازش باشید، که نشان میدهد هنوز کمبرازش هستید.
بیایید ببینیم چگونه میتوانید به این مسائل بپردازید تا به اولین نقطهٔ عطف بزرگ یک پروژهٔ یادگیری ماشین دست یابید: به دست آوردن مدلی که مقداری قدرت تعمیم دارد (میتواند یک خط پایهٔ ساده را شکست دهد) و قادر به بیشبرازش است.
تنظیم پارامترهای کلیدی نزول گرادیان
Section titled “تنظیم پارامترهای کلیدی نزول گرادیان”گاهی اوقات، آموزش شروع نمیشود یا خیلی زود متوقف میشود. زیان شما گیر کرده است. این همیشه چیزی است که میتوانید بر آن غلبه کنید: به یاد داشته باشید که میتوانید یک مدل را به دادههای تصادفی برازش دهید. حتی اگر هیچ چیز دربارهٔ مسئلهٔ شما معنی نداشته باشد، باید هنوز قادر به آموزش چیزی باشید — اگر فقط با حفظ دادههای آموزشی.
وقتی این اتفاق میافتد، همیشه مشکلی در پیکربندی فرآیند نزول گرادیان است: انتخاب بهینهساز، توزیع مقادیر اولیه در وزنهای مدل، نرخ یادگیری یا اندازهٔ دسته. همهٔ این پارامترها به هم وابسته هستند و به این ترتیب، معمولاً کافی است نرخ یادگیری و اندازهٔ دسته را تنظیم کنید در حالی که بقیهٔ پارامترها ثابت میمانند.
بیایید به یک مثال عینی نگاه کنیم: مدل MNIST فصل ۲ را با یک نرخ یادگیری نامناسب بزرگ به مقدار ۱ آموزش دهیم.
لیستینگ ۵.۶: آموزش یک مدل MNIST با نرخ یادگیری نادرست بالا
(train_images, train_labels), _ = mnist.load_data()train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255
model = keras.Sequential(    [        layers.Dense(512, activation="relu"),        layers.Dense(10, activation="softmax"),    ])model.compile(    optimizer=keras.optimizers.RMSprop(learning_rate=1.0),    loss="sparse_categorical_crossentropy",    metrics=["accuracy"],)model.fit(    train_images, train_labels, epochs=10, batch_size=128, validation_split=0.2)
مدل بهسرعت به دقت آموزش و اعتبارسنجی در محدودهٔ ۲۰٪ تا ۴۰٪ میرسد اما نمیتواند از آن فراتر رود. بیایید نرخ یادگیری را به مقدار معقولتر 1e-2 کاهش دهیم:
لیستینگ ۵.۷: همان مدل با نرخ یادگیری مناسبتر
model = keras.Sequential( [ layers.Dense(512, activation="relu"), layers.Dense(10, activation="softmax"), ])model.compile( optimizer=keras.optimizers.RMSprop(learning_rate=1e-2), loss="sparse_categorical_crossentropy", metrics=["accuracy"],)model.fit( train_images, train_labels, epochs=10, batch_size=128, validation_split=0.2)اکنون مدل قادر به آموزش است.
اگر خود را در موقعیت مشابهی یافتید، سعی کنید
- نرخ یادگیری را کاهش یا افزایش دهید. نرخ یادگیری که خیلی بالا باشد ممکن است منجر به بهروزرسانیهایی شود که بسیار فراتر از یک برازش مناسب میروند، مانند مثال قبلی، و نرخ یادگیری که خیلی پایین باشد ممکن است آموزش را چنان کند کند که به نظر متوقف شده باشد.
- اندازهٔ دسته را افزایش دهید. دستهای با نمونههای بیشتر منجر به گرادیانهایی میشود که آموزندهتر و کمنویزتر هستند (واریانس پایینتر).
در نهایت، پیکربندیای پیدا خواهید کرد که آموزش را شروع میکند.
استفاده از پیشینیهای معماری بهتر
Section titled “استفاده از پیشینیهای معماری بهتر”مدلی دارید که برازش میشود، اما به دلایلی معیارهای اعتبارسنجی شما اصلاً بهبود نمییابند. آنها نسبت به آنچه یک طبقهبند تصادفی به دست میآورد بهتر نیستند: مدل شما آموزش میبیند اما تعمیم نمییابد. چه خبر است؟
این شاید بدترین وضعیت یادگیری ماشینی باشد که میتوانید در آن قرار بگیرید. این نشان میدهد که چیزی اساساً در رویکرد شما اشتباه است و ممکن است بهراحتی نتوانید بگویید چیست. در اینجا چند نکته آورده شده است.
اول، ممکن است دادههای ورودی که استفاده میکنید بهسادگی حاوی اطلاعات کافی برای پیشبینی اهداف شما نباشند: مسئله آنگونه که فرمولبندی شده قابل حل نیست. این همان چیزی است که قبلاً اتفاق افتاد وقتی سعی کردیم یک مدل MNIST را با برچسبهای بههمریخته برازش دهیم: مدل بهخوبی آموزش میدید، اما دقت اعتبارسنجی در ۱۰٪ گیر میکرد، زیرا تعمیم با چنین مجموعهدادهای بهوضوح غیرممکن بود.
همچنین ممکن است نوع مدلی که استفاده میکنید برای مسئلهٔ پیشرو مناسب نباشد. برای مثال، در فصل ۱۳، مثال یک مسئلهٔ پیشبینی سری زمانی را خواهید دید که در آن یک معماری متراکم متصل قادر به شکست یک خط پایهٔ ساده نیست، در حالی که یک معماری بازگشتی مناسبتر موفق به تعمیم خوب میشود. استفاده از مدلی که فرضیات درست دربارهٔ مسئله میسازد برای دستیابی به تعمیم ضروری است: باید از پیشینیهای معماری درست استفاده کنید.
در فصلهای آینده، دربارهٔ بهترین معماریها برای انواع روشهای داده — تصاویر، متن، سریهای زمانی و غیره — یاد خواهید گرفت. بهطور کلی، همیشه باید مطمئن شوید که دربارهٔ بهترین روشهای معماری برای نوع وظیفهای که به آن حمله میکنید مطالعه میکنید — احتمالاً اولین کسی نیستید که تلاش میکنید.
افزایش ظرفیت مدل
Section titled “افزایش ظرفیت مدل”اگر موفق به رسیدن به مدلی میشوید که برازش میشود، جایی که معیارهای اعتبارسنجی کاهش مییابند و به نظر میرسد حداقل سطحی از قدرت تعمیم را به دست میآورید، تبریک میگویم: تقریباً آنجا هستید. در ادامه، باید مدل خود را وادار کنید که شروع به بیشبرازش کند.
مدل کوچک زیر را در نظر بگیرید — یک رگرسیون لجستیک ساده — که روی پیکسلهای MNIST آموزش دیده است.
لیستینگ ۵.۸: یک رگرسیون لجستیک ساده روی MNIST
model = keras.Sequential([layers.Dense(10, activation="softmax")])model.compile( optimizer="rmsprop", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)history_small_model = model.fit( train_images, train_labels, epochs=20, batch_size=128, validation_split=0.2)منحنیهای زیانی به دست میآورید که شبیه این هستند (شکل ۵.۱۴ را ببینید):
import matplotlib.pyplot as plt
val_loss = history_small_model.history["val_loss"]epochs = range(1, 21)plt.plot(epochs, val_loss, "b-", label="Validation loss")plt.title("Validation loss for a model with insufficient capacity")plt.xlabel("Epochs")plt.ylabel("Loss")plt.legend()plt.show()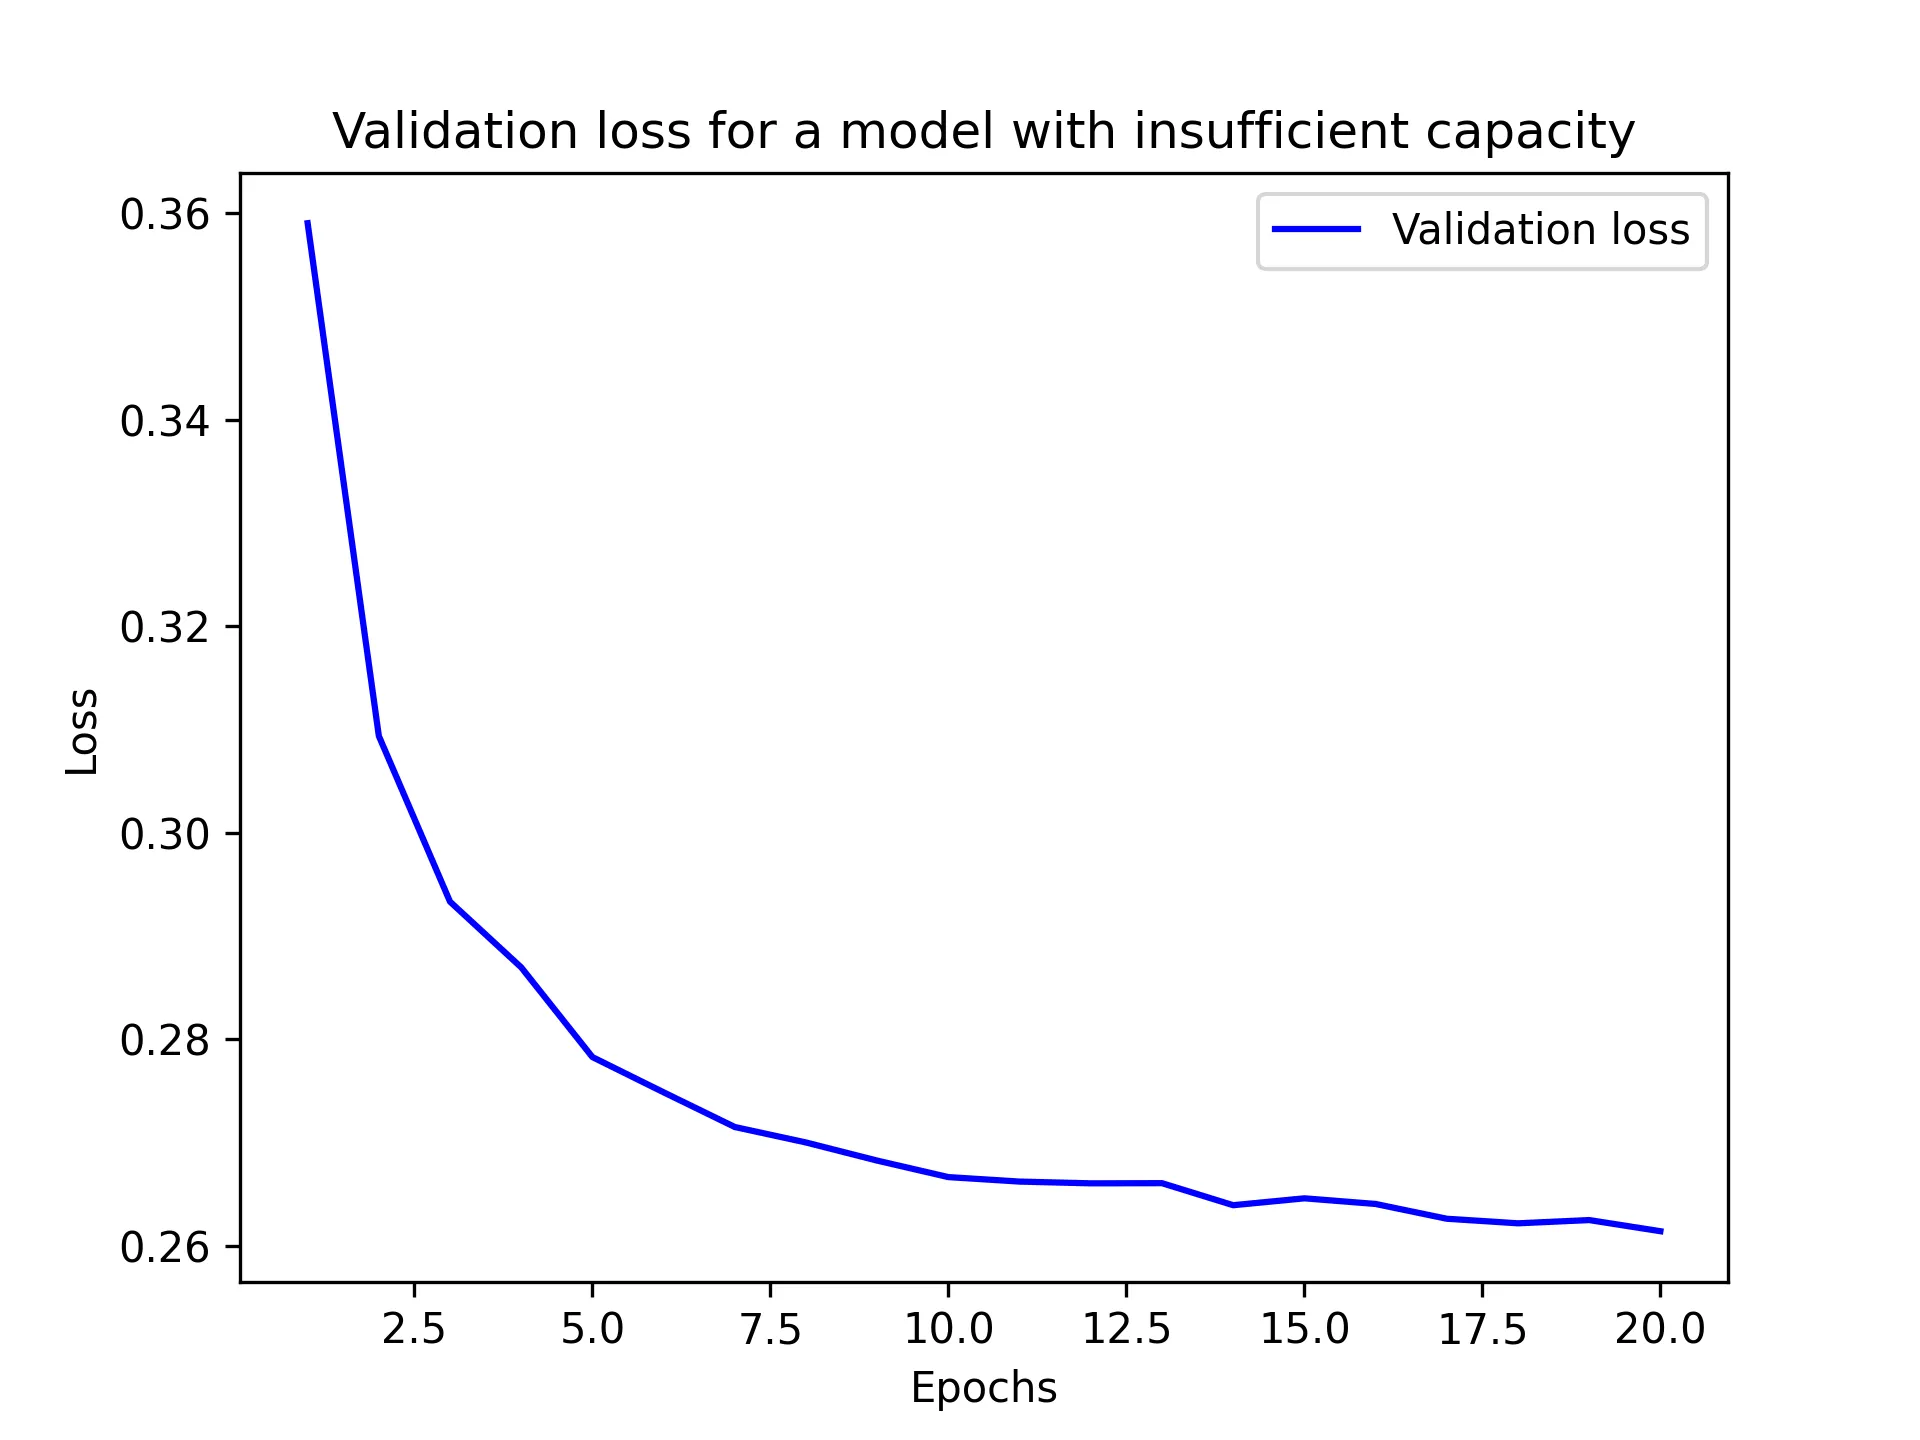
شکل ۵.۱۴: تأثیر ظرفیت ناکافی مدل بر منحنیهای زیان
به نظر میرسد معیارهای اعتبارسنجی متوقف میشوند یا بسیار آهسته بهبود مییابند، بهجای اینکه به اوج برسند و مسیر خود را معکوس کنند. زیان اعتبارسنجی به ۰.۲۶ میرسد و همانجا میماند. میتوانید برازش کنید، اما نمیتوانید بهوضوح بیشبرازش کنید، حتی پس از تکرارهای زیادی روی دادههای آموزشی. احتمالاً در حرفهٔ خود اغلب با منحنیهای مشابهی روبرو خواهید شد.
به یاد داشته باشید که باید همیشه امکان بیشبرازش وجود داشته باشد. بسیار شبیه به مسئلهٔ «زیان آموزش کاهش نمییابد»، این مشکلی است که همیشه میتوان آن را حل کرد. اگر به نظر میرسد نمیتوانید بیشبرازش کنید، احتمالاً مشکلی در قدرت بازنمایی مدل شما وجود دارد: به مدل بزرگتری نیاز دارید، مدلی با ظرفیت بیشتر — یعنی قادر به ذخیرهٔ اطلاعات بیشتر. میتوانید قدرت بازنمایی را با افزودن لایههای بیشتر، استفاده از لایههای بزرگتر (لایههایی با پارامترهای بیشتر) یا استفاده از انواع لایههایی که برای مسئلهٔ پیشرو مناسبتر هستند (پیشینیهای معماری بهتر) افزایش دهید.
بیایید یک مدل بزرگتر را امتحان کنیم، با دو لایهٔ میانی با ۱۲۸ واحد هر کدام:
model = keras.Sequential( [ layers.Dense(128, activation="relu"), layers.Dense(128, activation="relu"), layers.Dense(10, activation="softmax"), ])model.compile( optimizer="rmsprop", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)history_large_model = model.fit( train_images, train_labels, epochs=20, batch_size=128, validation_split=0.2,)منحنیهای آموزش اکنون دقیقاً همانطور که باید به نظر میرسند: مدل بهسرعت برازش میشود و پس از هشت دوره شروع به بیشبرازش میکند (شکل ۵.۱۵ را ببینید):
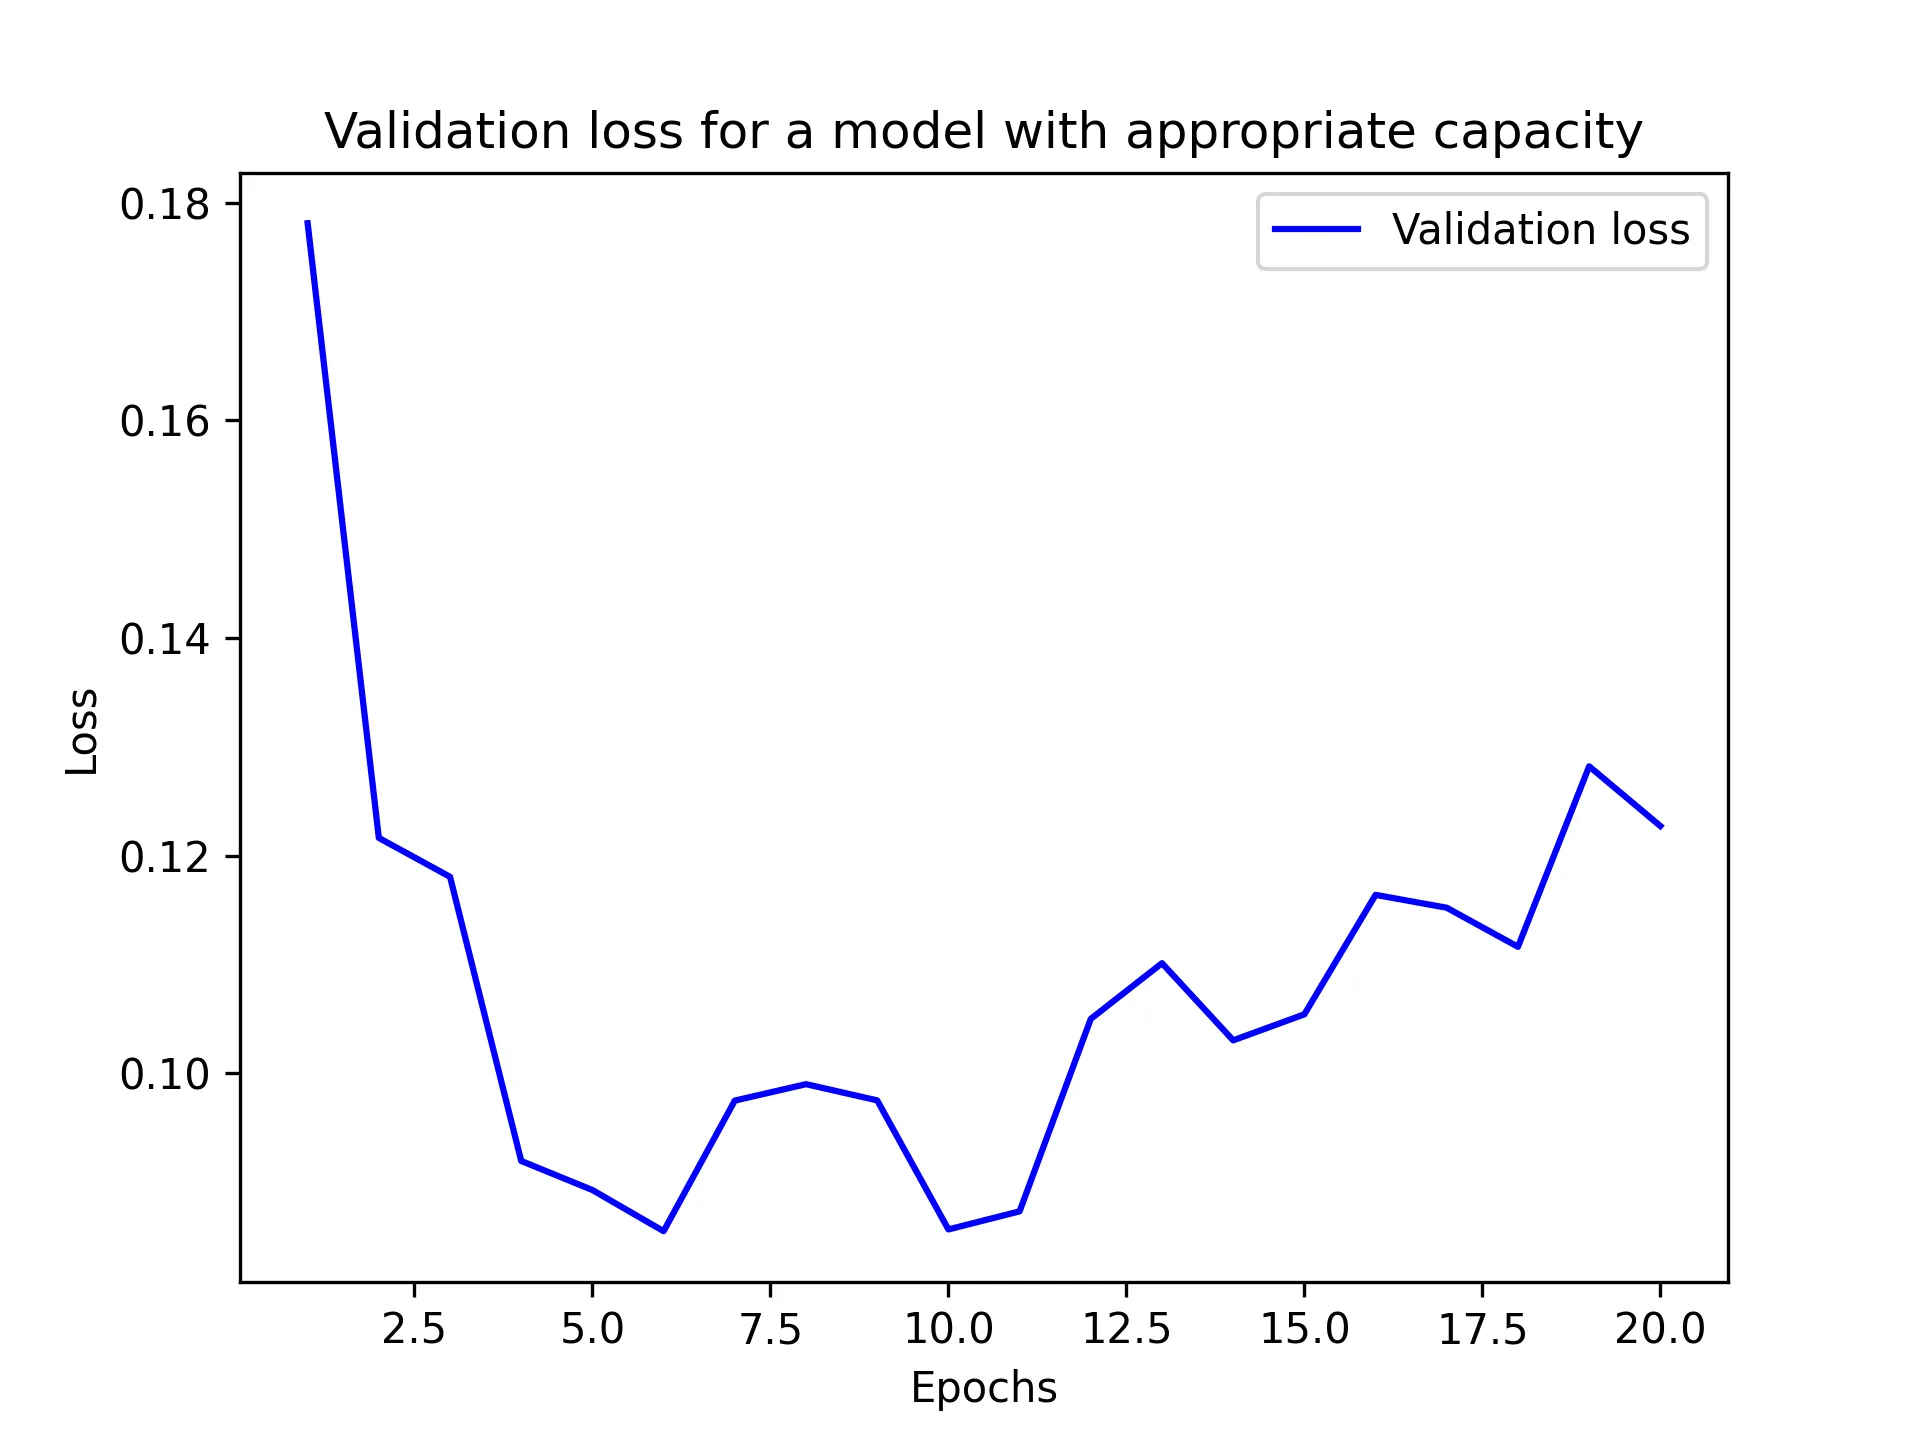
شکل ۵.۱۵: زیان اعتبارسنجی برای مدلی با ظرفیت مناسب
توجه داشته باشید که در حالی که استاندارد است با مدلهایی کار کنید که برای مسئلهٔ پیشرو بسیار پرپارامتر هستند، قطعاً میتواند چیزی به نام ظرفیت حفظ بیش از حد وجود داشته باشد. خواهید دانست مدل شما خیلی بزرگ است اگر بلافاصله شروع به بیشبرازش کند. در اینجا آنچه برای یک مدل MNIST با سه لایهٔ میانی با ۲,۰۴۸ واحد هر کدام اتفاق میافتد آمده است (شکل ۵.۱۶ را ببینید):
model = keras.Sequential( [ layers.Dense(2048, activation="relu"), layers.Dense(2048, activation="relu"), layers.Dense(2048, activation="relu"), layers.Dense(10, activation="softmax"), ])model.compile( optimizer="rmsprop", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)history_very_large_model = model.fit( train_images, train_labels, epochs=20, # When training larger models, you can reduce the batch size to # limit memory consumption. batch_size=32, validation_split=0.2,)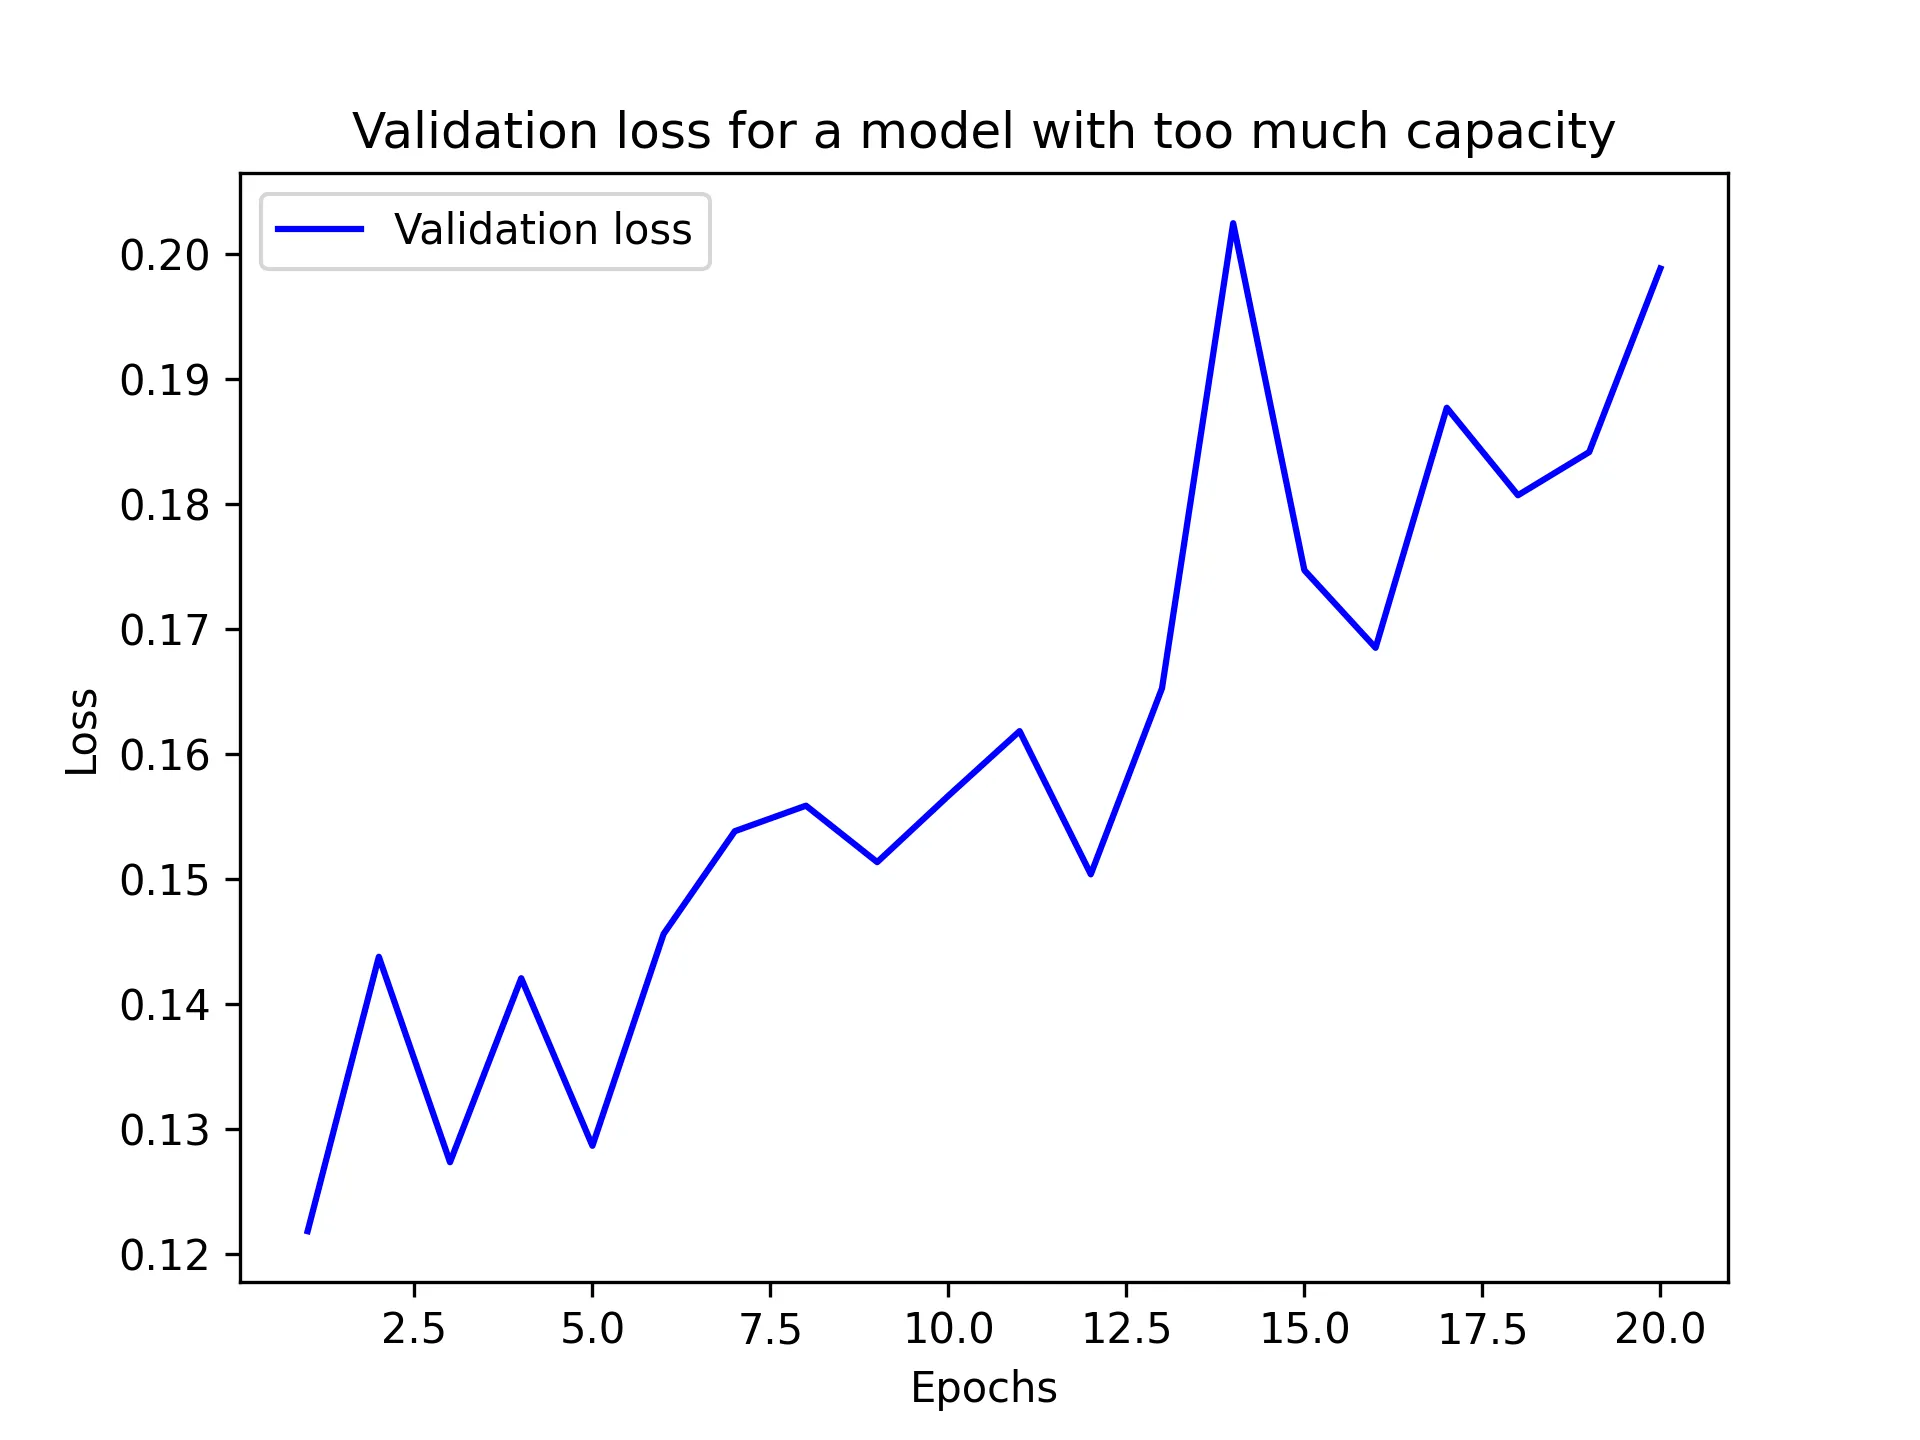
شکل ۵.۱۶: تأثیر ظرفیت بیش از حد مدل بر زیان اعتبارسنجی
بهبود تعمیم
Section titled “بهبود تعمیم”وقتی مدل شما نشان داد که مقداری قدرت تعمیم دارد و قادر به بیشبرازش است، زمان آن است که تمرکز خود را به سمت بیشینهسازی تعمیم تغییر دهید.
گردآوری مجموعهداده
Section titled “گردآوری مجموعهداده”شما قبلاً یاد گرفتهاید که تعمیم در یادگیری عمیق از ساختار نهفتهٔ دادههای شما سرچشمه میگیرد. اگر دادههای شما امکان درونیابی صاف بین نمونهها را فراهم میکنند، آنگاه قادر به آموزش یک مدل یادگیری عمیق خواهید بود که تعمیم مییابد. اگر مسئلهٔ شما بیشازحد نویزی یا اساساً گسسته است، مانند مرتبسازی لیست، یادگیری عمیق به شما کمک نخواهد کرد. یادگیری عمیق برازش منحنی است، نه جادو.
به این ترتیب، ضروری است که مطمئن شوید با یک مجموعهدادهٔ مناسب کار میکنید. صرف تلاش و پول بیشتر روی جمعآوری داده تقریباً همیشه بازده سرمایهگذاری بسیار بیشتری نسبت به صرف همان مقدار روی توسعهٔ مدل بهتر به همراه دارد:
- مطمئن شوید که دادهٔ کافی دارید. به یاد داشته باشید که به یک نمونهبرداری چگال از فضای ورودی-متقاطع-خروجی نیاز دارید. دادهٔ بیشتر مدل بهتری به دست میدهد. گاهی اوقات، مسائلی که در ابتدا غیرممکن به نظر میرسند با یک مجموعهدادهٔ بزرگتر قابل حل میشوند.
- خطاهای برچسبگذاری را به حداقل برسانید — ورودیهای خود را برای بررسی ناهنجاریها تجسم کنید و برچسبهای خود را تصحیح کنید.
- دادههای خود را تمیز کنید و با مقادیر گمشده برخورد کنید (این را در فصل بعد پوشش میدهیم).
- اگر ویژگیهای زیادی دارید و مطمئن نیستید کدام یک واقعاً مفید هستند، انتخاب ویژگی انجام دهید.
یک راه بهویژه مهم که میتوانید پتانسیل تعمیم دادههای خود را بهبود بخشید مهندسی ویژگی است. برای بیشتر مسائل یادگیری ماشین، مهندسی ویژگی یک عنصر کلیدی برای موفقیت است. بیایید نگاهی بیندازیم.
مهندسی ویژگی
Section titled “مهندسی ویژگی”مهندسی ویژگی فرآیند استفاده از دانش خود دربارهٔ دادهها و دربارهٔ الگوریتم یادگیری ماشین در دسترس (در این مورد، یک شبکهٔ عصبی) برای کارکرد بهتر الگوریتم با اعمال تبدیلهای سختکدشده (یادنگرفته) به دادهها قبل از ورود آنها به مدل است. در بسیاری از موارد، منطقی نیست انتظار داشته باشیم یک مدل یادگیری ماشین بتواند از دادههای کاملاً دلخواه یاد بگیرد. دادهها باید بهگونهای به مدل ارائه شوند که کار مدل را آسانتر کند.
بیایید به یک مثال شهودی نگاه کنیم. فرض کنید سعی در توسعهٔ مدلی دارید که میتواند بهعنوان ورودی تصویری از یک ساعت بگیرد و زمان روز را خروجی دهد (شکل ۵.۱۷ را ببینید). اگر انتخاب کنید از پیکسلهای خام تصویر بهعنوان دادههای ورودی استفاده کنید، یک مسئلهٔ یادگیری ماشین دشوار پیش روی دارید. برای حل آن به یک شبکهٔ عصبی کانولوشنی نیاز خواهید داشت و باید منابع محاسباتی قابل توجهی برای آموزش شبکه صرف کنید.
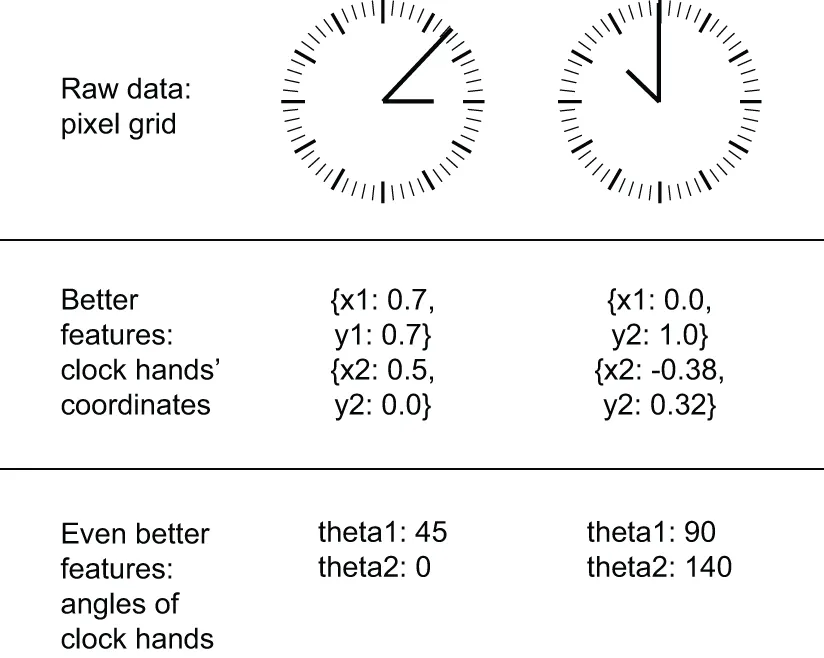
شکل ۵.۱۷: مهندسی ویژگی برای خواندن زمان روی یک ساعت
اما اگر از قبل مسئله را در سطح بالا درک میکنید (میدانید انسانها چگونه زمان را روی صفحهٔ ساعت میخوانند)، آنگاه میتوانید ویژگیهای ورودی بسیار بهتری برای یک الگوریتم یادگیری ماشین ارائه دهید: برای مثال، نوشتن یک اسکریپت پایتون پنج خطی برای دنبال کردن پیکسلهای سیاه عقربههای ساعت و خروجی مختصات (x, y) نوک هر عقربه آسان است. سپس یک الگوریتم یادگیری ماشین ساده میتواند یاد بگیرد این مختصات را با زمان مناسب روز مرتبط کند.
میتوانید حتی فراتر بروید: یک تغییر مختصات انجام دهید و مختصات (x, y) را بهصورت مختصات قطبی نسبت به مرکز تصویر بیان کنید. ورودی شما به زاویهٔ theta هر عقربهٔ ساعت تبدیل میشود. در این مرحله، ویژگیهای شما مسئله را آنقدر آسان میکنند که هیچ یادگیری ماشینی لازم نیست؛ یک عملیات گرد کردن ساده و جستجوی دیکشنری کافی است تا زمان تقریبی روز را بازیابی کنید.
این جوهر مهندسی ویژگی است: آسانتر کردن یک مسئله با بیان آن به روشی سادهتر. منیفولد نهفته را صافتر، سادهتر و بهتر سازماندهی کنید. معمولاً نیازمند درک عمیق مسئله است.
قبل از یادگیری عمیق، مهندسی ویژگی مهمترین بخش گردشکار یادگیری ماشین بود زیرا الگوریتمهای کمعمق کلاسیک فضای فرضیهٔ بهاندازهٔ کافی غنی برای یادگیری ویژگیهای مفید بهتنهایی نداشتند. روشی که دادهها را به الگوریتم ارائه میدادید کاملاً برای موفقیت آن حیاتی بود. برای مثال، قبل از اینکه شبکههای عصبی کانولوشنی در مسئلهٔ طبقهبندی ارقام MNIST موفق شوند، راهحلها معمولاً بر اساس ویژگیهای سختکدشده مانند تعداد حلقهها در یک تصویر رقم، ارتفاع هر رقم در یک تصویر، هیستوگرام مقادیر پیکسل و غیره بودند.
خوشبختانه، یادگیری عمیق مدرن نیاز به بیشتر مهندسی ویژگی را حذف میکند زیرا شبکههای عصبی قادر به استخراج خودکار ویژگیهای مفید از دادههای خام هستند. آیا این به این معناست که تا زمانی که از شبکههای عصبی عمیق استفاده میکنید نیازی به نگرانی دربارهٔ مهندسی ویژگی ندارید؟ نه، به دو دلیل:
- ویژگیهای خوب هنوز به شما امکان میدهند مسائل را ظریفتر و با منابع کمتر حل کنید. برای مثال، حل مسئلهٔ خواندن صفحهٔ ساعت با استفاده از یک شبکهٔ عصبی کانولوشنی مضحک خواهد بود.
- ویژگیهای خوب به شما امکان میدهند یک مسئله را با دادهٔ بسیار کمتری حل کنید. توانایی مدلهای یادگیری عمیق در یادگیری ویژگیها بهتنهایی به در دسترس بودن دادههای آموزشی زیاد متکی است؛ اگر فقط چند نمونه دارید، آنگاه ارزش اطلاعاتی ویژگیهایشان حیاتی میشود.
استفاده از توقف زودهنگام
Section titled “استفاده از توقف زودهنگام”در یادگیری عمیق، ما همیشه از مدلهایی استفاده میکنیم که بهشدت پرپارامتر هستند: آنها بسیار بیشتر از حداقل لازم برای برازش به منیفولد نهفتهٔ داده، درجهٔ آزادی دارند. این پرپارامتری بودن مشکلی نیست زیرا شما هرگز یک مدل یادگیری عمیق را کاملاً برازش نمیکنید. چنین برازشی اصلاً تعمیم نمییابد. شما همیشه آموزش را بسیار قبل از رسیدن به حداقل زیان آموزشی ممکن متوقف خواهید کرد.
یافتن نقطهٔ دقیق در طول آموزش که در آن به برازشپذیرترین حالت رسیدهاید — مرز دقیق بین یک منحنی کمبرازش و یک منحنی بیشبرازش — یکی از مؤثرترین کارهایی است که میتوانید برای بهبود تعمیم انجام دهید.
در مثالهای فصل قبل، با آموزش مدلهای خود برای مدت طولانیتر از حد نیاز شروع میکردیم تا تعداد دورههایی که بهترین معیارهای اعتبارسنجی را به دست میدهند کشف کنیم، سپس یک مدل جدید را دقیقاً برای همان تعداد دوره دوباره آموزش میدادیم. این کاملاً استاندارد است. با این حال، این کار از شما میخواهد کار اضافی انجام دهید، که گاهی میتواند گران باشد. طبیعتاً، میتوانستید مدل خود را در پایان هر دوره ذخیره کنید، سپس پس از یافتن بهترین دوره، از نزدیکترین مدل ذخیرهشدهای که دارید دوباره استفاده کنید. در Keras، معمول است که این کار را با یک callback EarlyStopping انجام دهید، که بهمحض توقف بهبود معیارهای اعتبارسنجی، آموزش را قطع میکند و در همان حال بهترین حالت مدل شناختهشده را به خاطر میسپارد. استفاده از callbackها را در فصل ۷ یاد خواهید گرفت.
تنظیم مدل شما
Section titled “تنظیم مدل شما”تکنیکهای تنظیم مجموعهای از بهترین روشها هستند که فعالانه توانایی مدل را برای برازش کامل به دادههای آموزشی مختل میکنند، با هدف عملکرد بهتر مدل در طول اعتبارسنجی. این «تنظیم» مدل نامیده میشود زیرا تمایل دارد مدل را سادهتر، «منظمتر»، منحنی آن را صافتر و «عمومیتر» کند — بنابراین کمتر مخصوص مجموعهٔ آموزشی و بهتر قادر به تعمیم با تقریب نزدیکتر منیفولد نهفتهٔ داده است. به خاطر داشته باشید که «تنظیم» یک مدل فرآیندی است که همیشه باید با یک رویهٔ ارزیابی دقیق هدایت شود. شما فقط در صورتی به تعمیم دست خواهید یافت که بتوانید آن را اندازهگیری کنید.
بیایید برخی از رایجترین تکنیکهای تنظیم را مرور کنیم و آنها را در عمل روی مدل طبقهبندی فیلم از فصل ۴ اعمال کنیم تا عملکرد آن را بهبود دهیم.
کاهش اندازهٔ شبکه
Section titled “کاهش اندازهٔ شبکه”شما قبلاً یاد گرفتهاید که مدلی که خیلی کوچک است بیشبرازش نمیشود. سادهترین راه برای کاهش بیشبرازش کاهش اندازهٔ مدل است (تعداد پارامترهای یادگیریپذیر در مدل، که توسط تعداد لایهها و تعداد واحدهای هر لایه تعیین میشود). اگر مدل منابع حفظ محدودی داشته باشد، نمیتواند صرفاً دادههای آموزشی خود را حفظ کند. برای کمینه کردن زیان خود، باید به یادگیری بازنماییهای فشردهای متوسل شود که قدرت پیشبینی دربارهٔ اهداف دارند — دقیقاً همان نوع بازنماییهایی که به آنها علاقهمندیم. در همان زمان، به خاطر داشته باشید که باید از مدلهایی با پارامترهای کافی استفاده کنید که کمبرازش نشوند: مدل شما نباید از منابع حفظ Starved شود. مصالحهای بین ظرفیت بیش از حد و ظرفیت ناکافی وجود دارد.
متأسفانه، هیچ فرمول جادویی برای تعیین تعداد درست لایهها یا اندازهٔ درست هر لایه وجود ندارد. باید آرایهای از معماریهای مختلف را ارزیابی کنید (روی مجموعهٔ اعتبارسنجی خود، نه مجموعهٔ آزمایشی، البته) تا اندازهٔ مدل درست برای دادههای خود را پیدا کنید. گردشکار کلی برای یافتن اندازهٔ مدل مناسب شروع با لایهها و پارامترهای نسبتاً کم و افزایش اندازهٔ لایهها یا افزودن لایههای جدید تا مشاهدهٔ بازده نزولی نسبت به زیان اعتبارسنجی است.
بیایید این را روی مدل طبقهبندی نقد فیلم امتحان کنیم. در اینجا یک نسخهٔ فشردهٔ مدل از فصل ۴ آمده است.
لیستینگ ۵.۹: مدل اصلی
from keras.datasets import imdb
(train_data, train_labels), _ = imdb.load_data(num_words=10000)
def vectorize_sequences(sequences, dimension=10000):    results = np.zeros((len(sequences), dimension))    for i, sequence in enumerate(sequences):        results[i, sequence] = 1.0    return results
train_data = vectorize_sequences(train_data)
model = keras.Sequential(    [        layers.Dense(16, activation="relu"),        layers.Dense(16, activation="relu"),        layers.Dense(1, activation="sigmoid"),    ])model.compile(    optimizer="rmsprop",    loss="binary_crossentropy",    metrics=["accuracy"],)history_original = model.fit(    train_data,    train_labels,    epochs=20,    batch_size=512,    validation_split=0.4,)
حالا بیایید سعی کنیم آن را با این مدل کوچکتر جایگزین کنیم.
لیستینگ ۵.۱۰: نسخهٔ مدل با ظرفیت پایینتر
model = keras.Sequential( [ layers.Dense(4, activation="relu"), layers.Dense(4, activation="relu"), layers.Dense(1, activation="sigmoid"), ])model.compile( optimizer="rmsprop", loss="binary_crossentropy", metrics=["accuracy"],)history_smaller_model = model.fit( train_data, train_labels, epochs=20, batch_size=512, validation_split=0.4,)شکل ۵.۱۸ مقایسهٔ زیانهای اعتبارسنجی مدل اصلی و مدل کوچکتر را نشان میدهد.
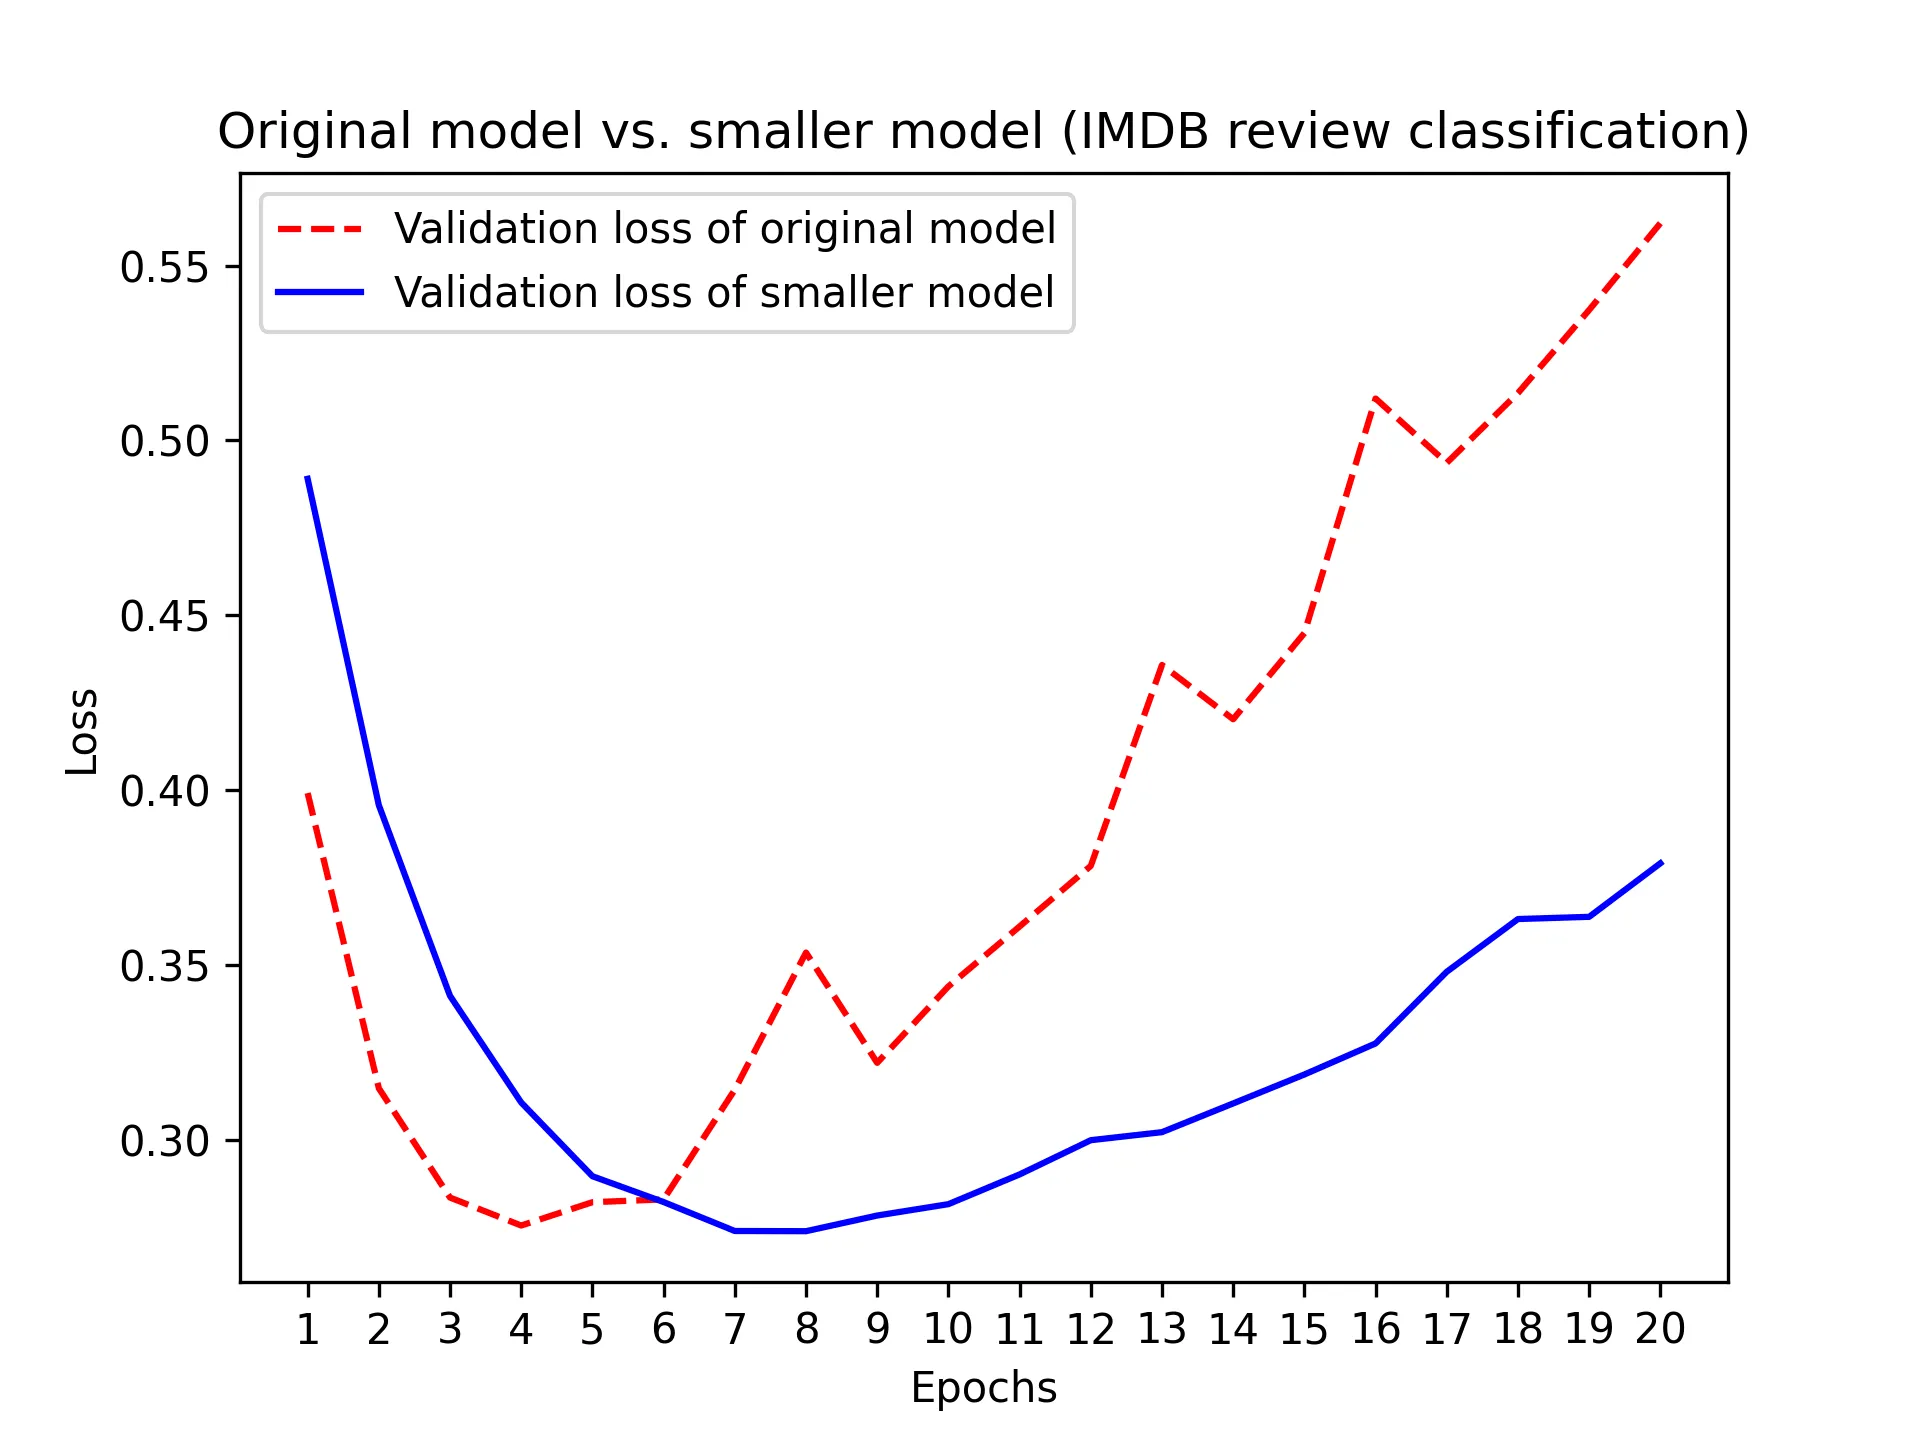
شکل ۵.۱۸: مدل اصلی در مقابل مدل کوچکتر روی طبقهبندی نقد IMDb
همانطور که میبینید، مدل کوچکتر دیرتر از مدل مرجع شروع به بیشبرازش میکند (پس از شش دوره بهجای چهار)، و عملکرد آن پس از شروع بیشبرازش آهستهتر کاهش مییابد.
حالا، بیایید به معیار خود مدلی اضافه کنیم که ظرفیت بسیار بیشتری دارد — بسیار بیشتر از آنچه مسئله حکم میکند.
لیستینگ ۵.۱۱: نسخهٔ مدل با ظرفیت بالاتر
model = keras.Sequential( [ layers.Dense(512, activation="relu"), layers.Dense(512, activation="relu"), layers.Dense(1, activation="sigmoid"), ])model.compile( optimizer="rmsprop", loss="binary_crossentropy", metrics=["accuracy"],)history_larger_model = model.fit( train_data, train_labels, epochs=20, batch_size=512, validation_split=0.4,)شکل ۵.۱۹ نشان میدهد مدل بزرگتر نسبت به مدل مرجع چگونه عمل میکند. مدل بزرگتر تقریباً بلافاصله، پس از فقط یک دوره، شروع به بیشبرازش میکند و بسیار شدیدتر بیشبرازش میکند. زیان اعتبارسنجی آن نیز پرنویزتر است. زیان آموزش را خیلی سریع به نزدیک صفر میرساند. هر چه مدل ظرفیت بیشتری داشته باشد، سریعتر میتواند دادههای آموزشی را مدلسازی کند (که منجر به زیان آموزش پایین میشود)، اما بیشتر مستعد بیشبرازش است (که منجر به تفاوت زیاد بین زیان آموزش و اعتبارسنجی میشود).
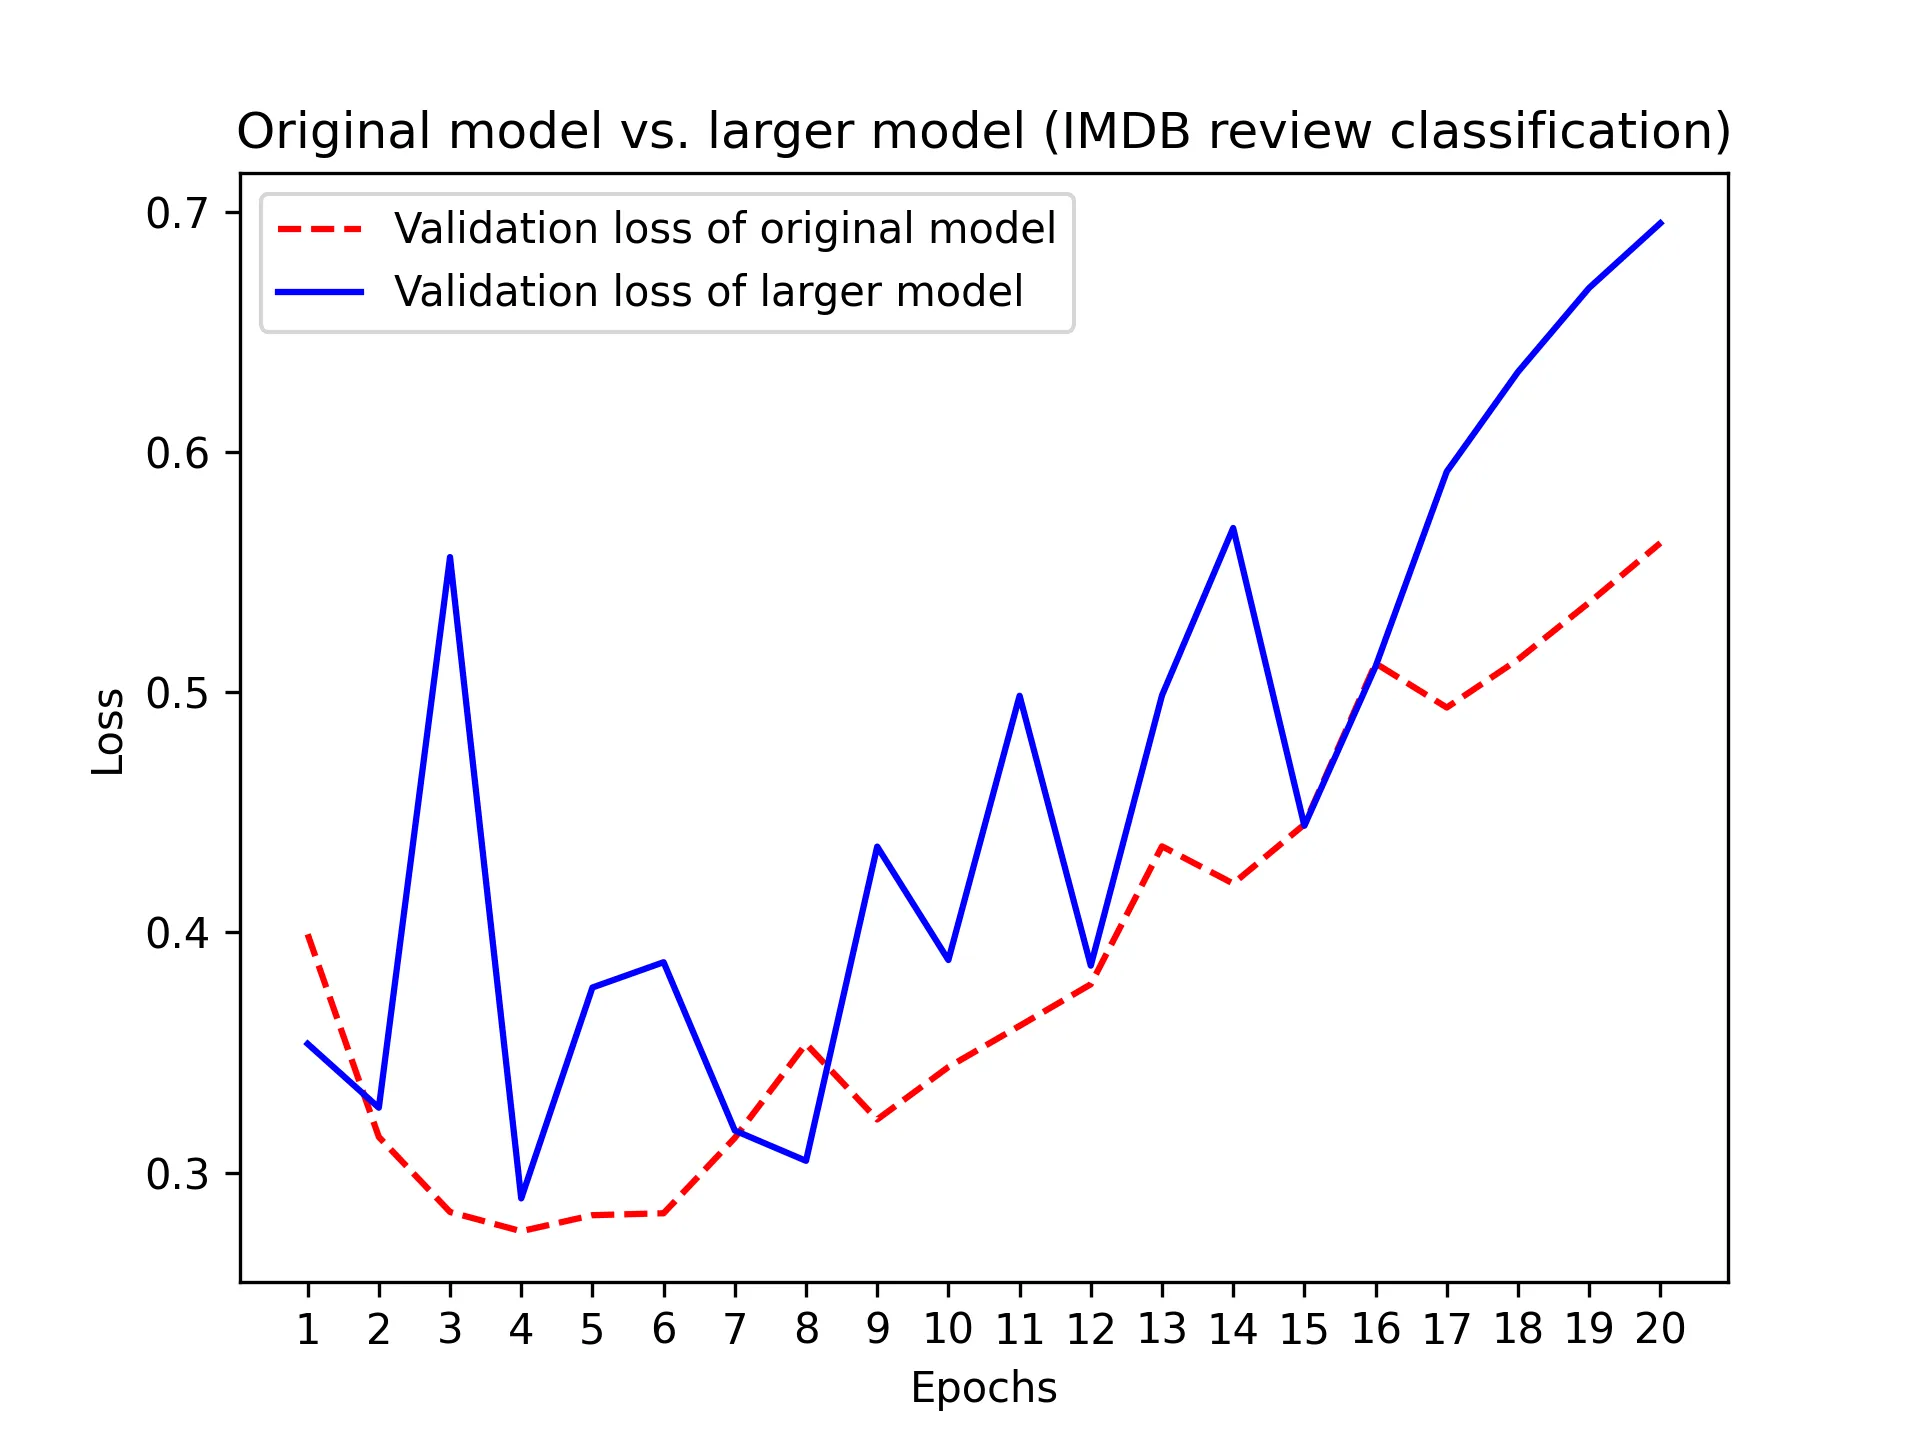
شکل ۵.۱۹: مدل اصلی در مقابل مدل بسیار بزرگتر روی طبقهبندی نقد IMDB
افزودن تنظیم وزن
Section titled “افزودن تنظیم وزن”ممکن است با اصل تیغ اوکام آشنا باشید: با توجه به دو توضیح برای یک چیز، توضیحی که به احتمال زیاد درست است سادهترین است — توضیحی که فرضیات کمتری میسازد. این ایده در مورد مدلهای یادگرفتهشده توسط شبکههای عصبی نیز صدق میکند: با توجه به برخی دادههای آموزشی و یک معماری شبکه، مجموعههای متعددی از مقادیر وزنی (مدلهای متعدد) میتوانند دادهها را توضیح دهند. مدلهای سادهتر کمتر از مدلهای پیچیده بیشبرازش میکنند.
یک مدل ساده در این زمینه مدلی است که توزیع مقادیر پارامتر آن آنتروپی کمتری دارد (یا مدلی با پارامترهای کمتر، همانطور که در بخش قبل دیدید). بنابراین یک راه رایج برای کاهش بیشبرازش اعمال محدودیتهایی بر پیچیدگی یک مدل با مجبور کردن وزنهای آن به گرفتن فقط مقادیر کوچک است، که توزیع مقادیر وزن را منظمتر میکند. این تنظیم وزن نامیده میشود و با افزودن یک هزینه مرتبط با داشتن وزنهای بزرگ به تابع زیان مدل انجام میشود. این هزینه در دو طعم ارائه میشود:
- تنظیم L1 — هزینه اضافهشده متناسب با قدر مطلق ضرایب وزن است (نرم L1 وزنها).
- تنظیم L2 — هزینه اضافهشده متناسب با مجذور مقدار ضرایب وزن است (نرم L2 وزنها). تنظیم L2 در زمینهٔ شبکههای عصبی افت وزن نیز نامیده میشود. اجازه ندهید نامهای مختلف شما را گیج کنند: افت وزن از نظر ریاضی همان تنظیم L2 است.
در Keras، تنظیم وزن با پاس دادن نمونههای تنظیمکنندهٔ وزن به لایهها بهعنوان آرگومانهای کلمهٔ کلیدی اضافه میشود. بیایید تنظیم وزن L2 را به مدل طبقهبندی نقد فیلم اضافه کنیم.
لیستینگ ۵.۱۲: افزودن تنظیم وزن L2 به مدل
from keras.regularizers import l2
model = keras.Sequential(    [        layers.Dense(16, kernel_regularizer=l2(0.002), activation="relu"),        layers.Dense(16, kernel_regularizer=l2(0.002), activation="relu"),        layers.Dense(1, activation="sigmoid"),    ])model.compile(    optimizer="rmsprop",    loss="binary_crossentropy",    metrics=["accuracy"],)history_l2_reg = model.fit(    train_data,    train_labels,    epochs=20,    batch_size=512,    validation_split=0.4,)
l2(0.002) به این معناست که هر ضریب در ماتریس وزن لایه 0.002 * weight_coefficient_value ** 2 را به کل زیان مدل اضافه میکند. توجه داشته باشید که چون این جریمه فقط در زمان آموزش اضافه میشود، زیان این مدل در آموزش بسیار بالاتر از آزمایش خواهد بود.
شکل ۵.۲۰ تأثیر جریمهٔ تنظیم L2 را نشان میدهد. همانطور که میبینید، مدل با تنظیم L2 بسیار مقاومتر در برابر بیشبرازش نسبت به مدل مرجع شده است، حتی اگر هر دو مدل تعداد پارامترهای یکسانی داشته باشند: شکل ۵.۲۰ را ببینید:
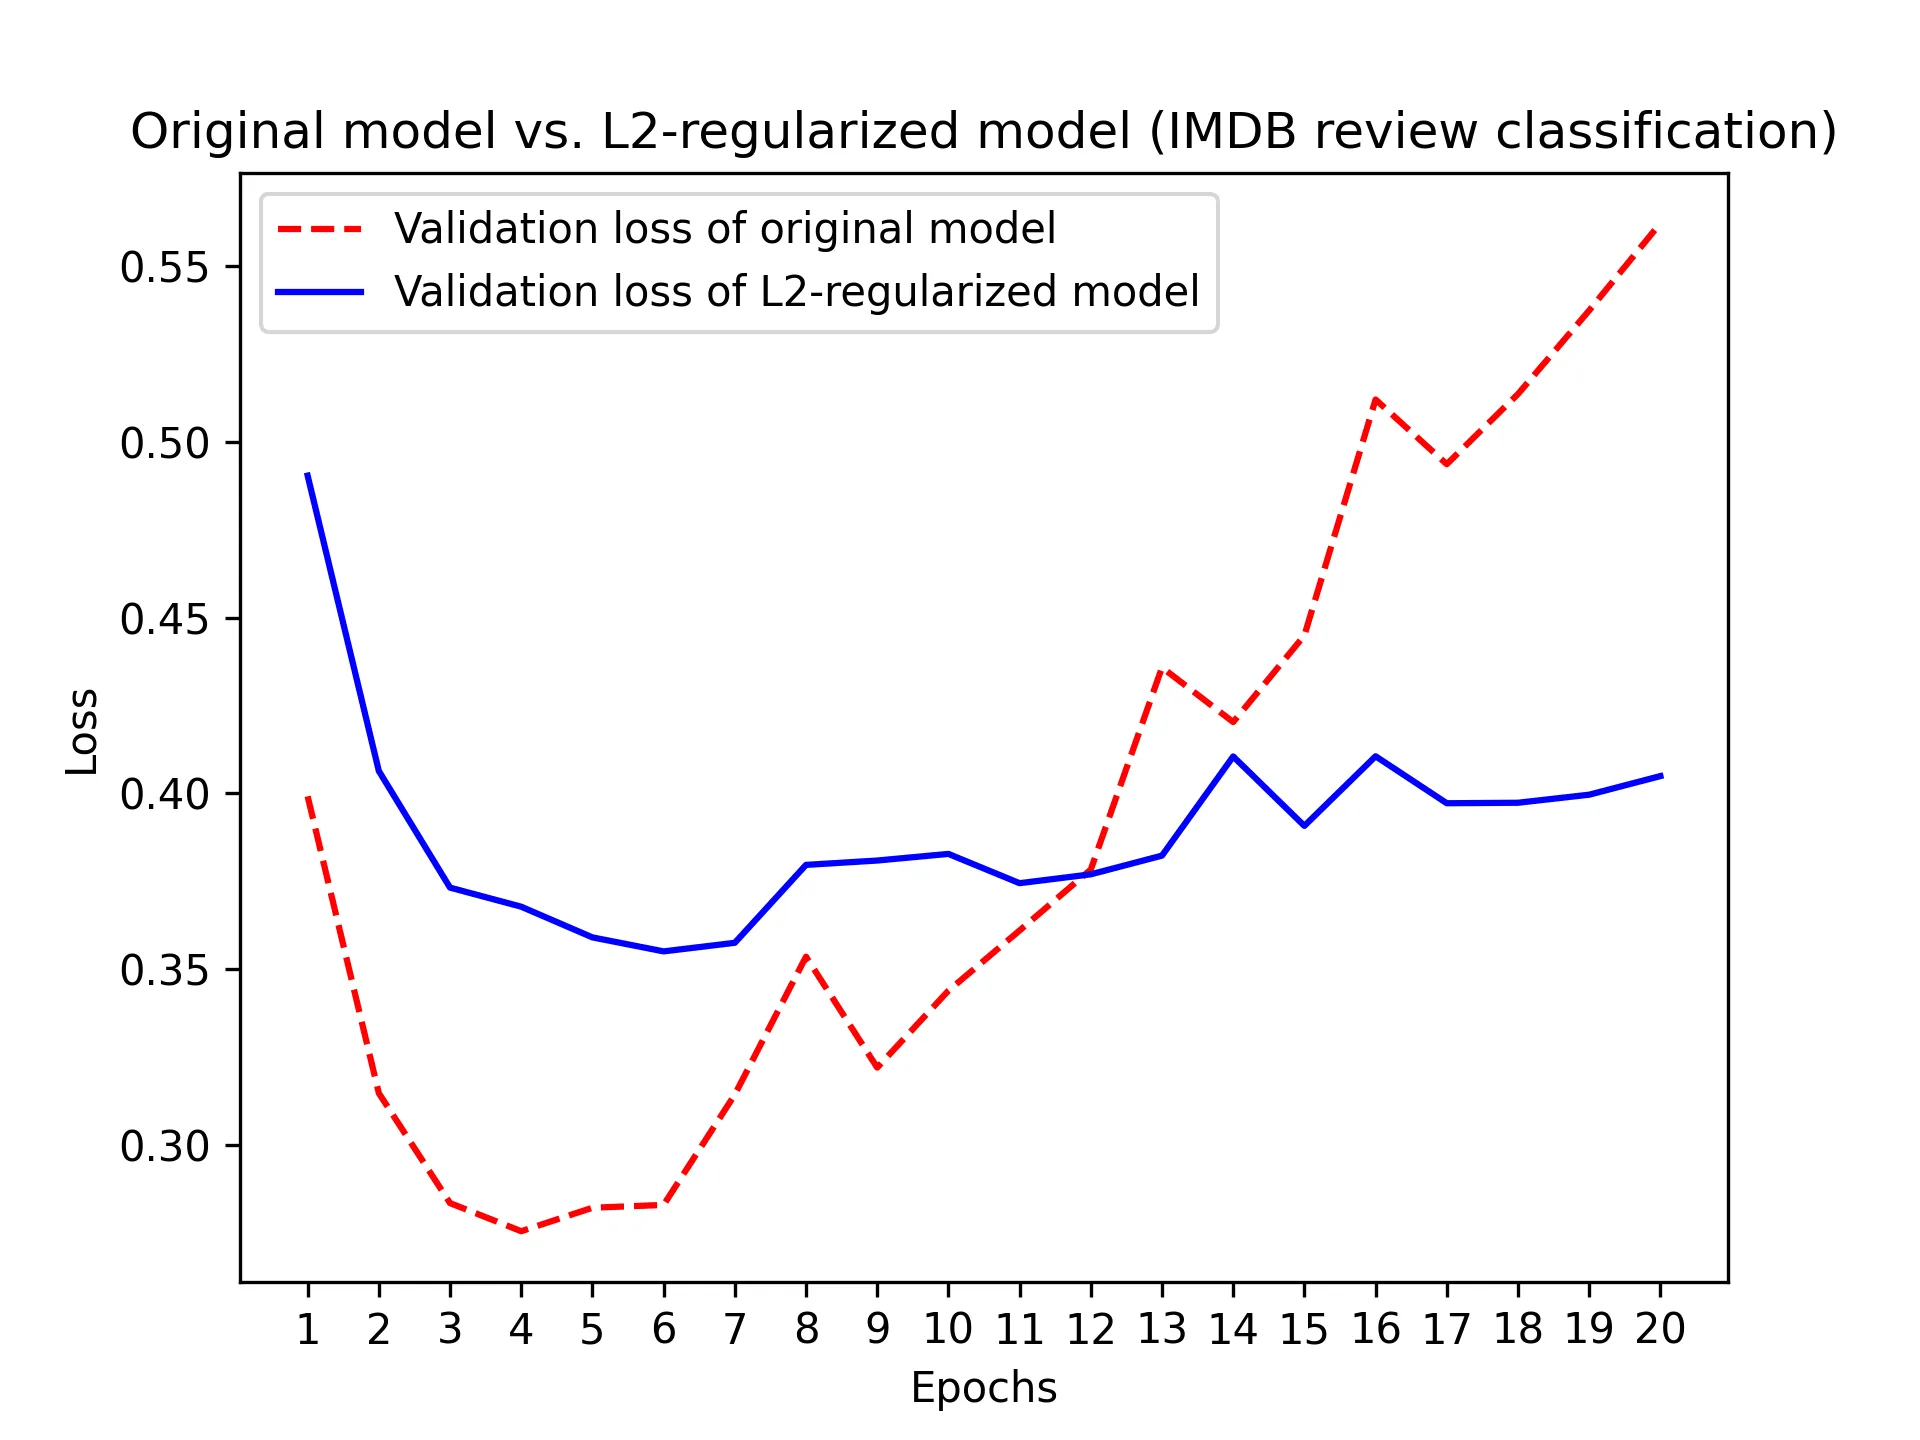
شکل ۵.۲۰: تأثیر تنظیم وزن L2 بر زیان اعتبارسنجی
بهعنوان جایگزینی برای تنظیم L2، میتوانید از یکی از تنظیمکنندههای وزن Keras زیر استفاده کنید.
لیستینگ ۵.۱۳: تنظیمکنندههای وزن مختلف موجود در Keras
from keras import regularizers
# L1 regularizationregularizers.l1(0.001)# Simultaneous L1 and L2 regularizationregularizers.l1_l2(l1=0.001, l2=0.001)
توجه داشته باشید که تنظیم وزن معمولاً برای مدلهای یادگیری عمیق کوچکتر استفاده میشود. مدلهای یادگیری عمیق بزرگ تمایل دارند آنقدر پرپارامتر باشند که اعمال محدودیتها بر مقادیر وزن تأثیر زیادی بر ظرفیت مدل و تعمیم نداشته باشد. در این موارد، یک تکنیک تنظیم متفاوت ترجیح داده میشود: dropout.
افزودن dropout
Section titled “افزودن dropout”Dropout، که توسط جف هینتون و دانشجویانش در دانشگاه تورنتو توسعه یافت، یکی از مؤثرترین و رایجترین تکنیکهای تنظیم برای شبکههای عصبی است. Dropout، که به یک لایه اعمال میشود، شامل حذف تصادفی (تنظیم به صفر) تعدادی از ویژگیهای خروجی لایه در طول آموزش است. فرض کنید یک لایهٔ معین معمولاً برای یک نمونهٔ ورودی معین در طول آموزش برداری مانند [0.2, 0.5, 1.3, 0.8, 1.1] برمیگرداند. پس از اعمال dropout، این بردار چند ورودی صفر خواهد داشت که بهصورت تصادفی توزیع شدهاند: برای مثال، [0, 0.5, 1.3, 0, 1.1]. نرخ dropout کسری از ویژگیهایی است که صفر میشوند؛ معمولاً بین ۰.۲ و ۰.۵ تنظیم میشود. در زمان آزمایش، هیچ واحدی حذف نمیشود؛ در عوض، مقادیر خروجی لایه با ضریبی برابر با نرخ dropout کاهش مییابند تا برای این واقعیت که واحدهای بیشتری نسبت به زمان آموزش فعال هستند تعادل برقرار شود.
یک ماتریس NumPy حاوی خروجی یک لایه، layer_output، با شکل (batch_size, features) را در نظر بگیرید. در زمان آموزش، کسری از مقادیر در ماتریس را بهصورت تصادفی صفر میکنیم:
# At training time, drops out 50% of the units in the outputlayer_output *= np.random.randint(low=0, high=2, size=layer_output.shape)در زمان آزمایش، خروجی را با نرخ dropout کاهش میدهیم. در اینجا، با ۰.۵ مقیاس میکنیم (زیرا قبلاً نیمی از واحدها را حذف کرده بودیم):
# At test timelayer_output *= 0.5توجه داشته باشید که این فرآیند میتواند با انجام هر دو عملیات در زمان آموزش و بدون تغییر ماندن خروجی در زمان آزمایش پیادهسازی شود، که اغلب روش پیادهسازی در عمل است (شکل ۵.۲۱ را ببینید):
# At training timelayer_output *= np.random.randint(low=0, high=2, size=layer_output.shape)# Note that we're scaling up rather scaling down in this case.layer_output /= 0.5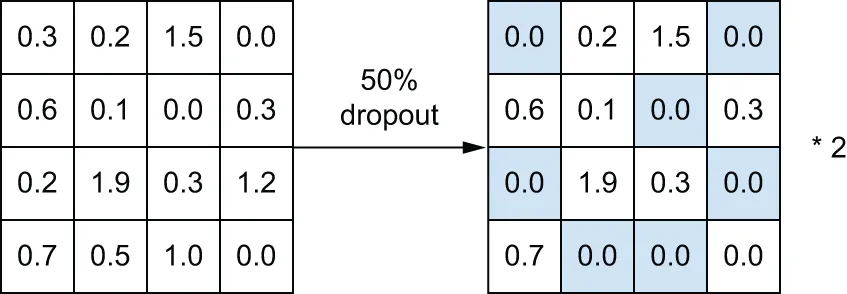
شکل ۵.۲۱: Dropout اعمالشده به یک ماتریس فعالسازی در زمان آموزش، با مقیاسبندی مجدد که در طول آموزش اتفاق میافتد. در زمان آزمایش، ماتریس فعالسازی بدون تغییر میماند.
این تکنیک ممکن است عجیب و دلخواه به نظر برسد. چرا این کار به کاهش بیشبرازش کمک میکند؟ هینتون میگوید او از جمله از یک مکانیزم پیشگیری از تقلب که توسط بانکها استفاده میشود الهام گرفته است:
به بانکم رفتم. صندوقدارها مدام عوض میشدند و از یکی از آنها پرسیدم چرا. او گفت نمیداند اما آنها خیلی جابهجا میشوند. فهمیدم که باید به این دلیل باشد که برای تقلب موفق در بانک به همکاری بین کارمندان نیاز است. این باعث شد متوجه شوم که حذف تصادفی زیرمجموعهٔ متفاوتی از نورونها در هر مثال از توطئهها جلوگیری میکند و بدین ترتیب بیشبرازش را کاهش میدهد.
ایدهٔ اصلی این است که وارد کردن نویز در مقادیر خروجی یک لایه میتواند الگوهای تصادفی را که معنادار نیستند (آنچه هینتون به آن توطئهها اشاره میکند) بشکند، که مدل در صورت عدم وجود نویز شروع به حفظ کردن آنها میکند.
در Keras، میتوانید dropout را در یک مدل از طریق لایهٔ Dropout معرفی کنید، که به خروجی لایهٔ بلافاصله قبل اعمال میشود. بیایید دو لایهٔ Dropout به مدل IMDB اضافه کنیم تا ببینیم چقدر در کاهش بیشبرازش خوب عمل میکنند.
لیستینگ ۵.۱۴: افزودن dropout به مدل IMDB
model = keras.Sequential( [ layers.Dense(16, activation="relu"), layers.Dropout(0.5), layers.Dense(16, activation="relu"), layers.Dropout(0.5), layers.Dense(1, activation="sigmoid"), ])model.compile( optimizer="rmsprop", loss="binary_crossentropy", metrics=["accuracy"],)history_dropout = model.fit( train_data, train_labels, epochs=20, batch_size=512, validation_split=0.4,)شکل ۵.۲۲ نمودار نتایج را نشان میدهد. این یک بهبود آشکار نسبت به مدل مرجع است. همچنین به نظر میرسد بسیار بهتر از تنظیم L2 کار میکند زیرا کمترین زیان اعتبارسنجی به دستآمده بهبود یافته است:
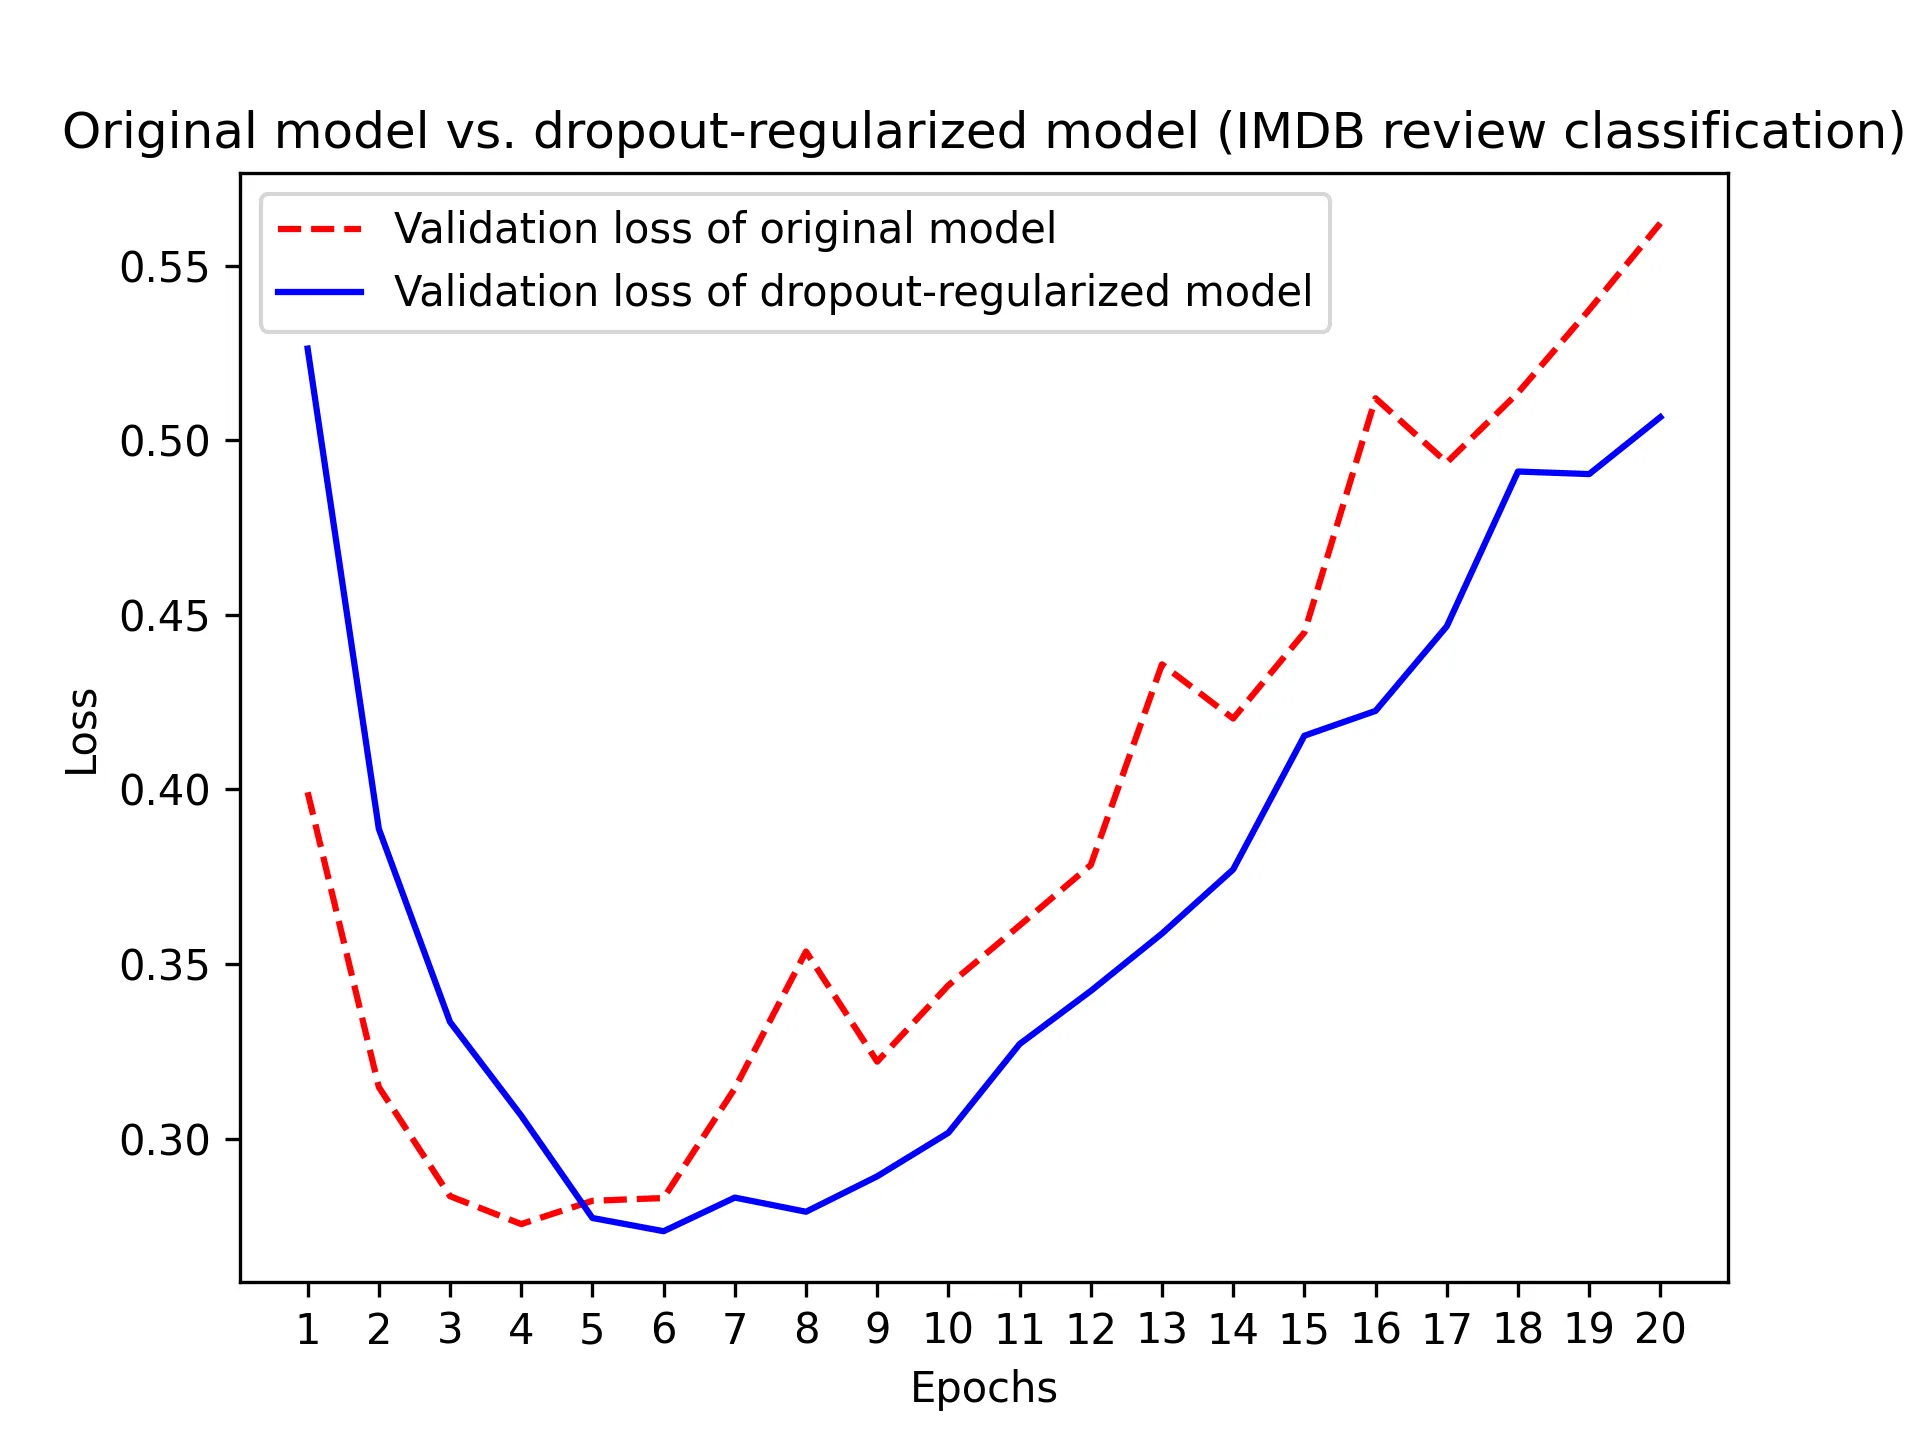
شکل ۵.۲۲: تأثیر dropout بر زیان اعتبارسنجی
برای جمعبندی، اینها رایجترین راهها برای بیشینهسازی تعمیم و جلوگیری از بیشبرازش در شبکههای عصبی هستند:
- به دست آوردن دادههای آموزشی بیشتر، یا دادههای آموزشی بهتر
- توسعهٔ ویژگیهای بهتر
- کاهش ظرفیت مدل
- افزودن تنظیم وزن (برای مدلهای کوچکتر)
- افزودن dropout
- هدف یک مدل یادگیری ماشین تعمیم است: عملکرد دقیق روی ورودیهای هرگز دیدهنشده. این سختتر از آنچه به نظر میرسد است.
- یک شبکهٔ عصبی عمیق با یادگیری یک مدل پارامتری که میتواند با موفقیت بین نمونههای آموزشی درونیابی کند به تعمیم دست مییابد. گفته میشود چنین مدلی منیفولد نهفتهٔ دادههای آموزشی را یاد گرفته است. به همین دلیل است که مدلهای یادگیری عمیق فقط میتوانند به ورودیهایی که بسیار نزدیک به آنچه در طول آموزش دیدهاند معنا بدهند.
- مسئلهٔ بنیادین در یادگیری ماشین تنش بین بهینهسازی و تعمیم است: برای دستیابی به تعمیم، ابتدا باید به برازش خوبی با دادههای آموزشی برسید، اما بهبود برازش مدل شما با دادههای آموزشی inevitably پس از مدتی شروع به آسیب رساندن به تعمیم میکند. هر بهترین روش یادگیری عمیق به مدیریت این تنش میپردازد.
- توانایی مدلهای یادگیری عمیق در تعمیم از این واقعیت ناشی میشود که آنها موفق به یادگیری تقریب منیفولد نهفتهٔ دادههای خود میشوند و بنابراین میتوانند از طریق درونیابی به ورودیهای جدید معنا بدهند.
- ضروری است که بتوانید قدرت تعمیم مدل خود را در طول توسعهٔ آن بهطور دقیق ارزیابی کنید. شما آرایهای از روشهای ارزیابی در اختیار دارید، از اعتبارسنجی سادهٔ نگهداشتهشده تا اعتبارسنجی متقاطع K-تایی و اعتبارسنجی متقاطع K-تایی تکراری با بههمریختن. به یاد داشته باشید که همیشه یک مجموعهٔ آزمایشی کاملاً جدا برای ارزیابی نهایی مدل نگه دارید، زیرا ممکن است نشت اطلاعات از دادههای اعتبارسنجی به مدل شما رخ داده باشد.
- وقتی شروع به کار روی یک مدل میکنید، هدف اولیهٔ شما دستیابی به مدلی است که مقداری قدرت تعمیم دارد و میتواند بیشبرازش کند. بهترین روشها برای انجام این کار شامل تنظیم نرخ یادگیری و اندازهٔ دسته، استفاده از پیشینیهای معماری بهتر، افزایش ظرفیت مدل یا صرفاً آموزش طولانیتر است.
- وقتی مدل شما شروع به بیشبرازش میکند، هدف شما به بهبود تعمیم از طریق تنظیم مدل تغییر میکند. میتوانید ظرفیت مدل خود را کاهش دهید، dropout یا تنظیم وزن اضافه کنید و از توقف زودهنگام استفاده کنید. و طبیعتاً، یک مجموعهدادهٔ بزرگتر یا بهتر همیشه راه شمارهٔ یک برای کمک به تعمیم مدل است.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
مارک تواین حتی آن را «لذیذترین میوهای که بشر میشناسد» نامید. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.