
فصل ۳: معرفی TensorFlow، PyTorch، JAX و Keras
این فصل قصد دارد همهٔ آنچه برای شروع یادگیری عمیق در عمل نیاز دارید را به شما بدهد. ابتدا با سه چارچوب محبوب یادگیری عمیق که میتوانند با Keras استفاده شوند آشنا میشوید:
- TensorFlow ( https://tensorflow.org )
- PyTorch ( https://pytorch.org/ )
- JAX ( https://jax.readthedocs.io/ )
سپس، با تکیه بر اولین برخوردی که در فصل ۲ با Keras داشتید، اجزای اصلی شبکههای عصبی و نحوهٔ ترجمهٔ آنها به APIهای Keras را مرور خواهیم کرد.
در پایان این فصل، آمادهٔ حرکت به سمت کاربردهای عملی و واقعی خواهید بود — که از فصل ۴ شروع میشود.
تاریخچهٔ مختصر چارچوبهای یادگیری عمیق
Section titled “تاریخچهٔ مختصر چارچوبهای یادگیری عمیق”در دنیای واقعی، شما قرار نیست کد سطح پایین را از صفر بنویسید، همانطور که در پایان فصل ۲ انجام دادیم. در عوض، از یک چارچوب استفاده خواهید کرد. بهجز Keras، چارچوبهای اصلی یادگیری عمیق امروز JAX، TensorFlow و PyTorch هستند. این کتاب همهٔ چهار مورد را به شما آموزش میدهد.
اگر تازه با یادگیری عمیق شروع کردهاید، ممکن است به نظر برسد که همهٔ این چارچوبها از ازل وجود داشتهاند. در واقعیت، همهٔ آنها نسبتاً جدید هستند، و Keras قدیمیترین در میان این چهار است (در مارس ۲۰۱۵ عرضه شد). ایدههای پشت این چارچوبها، با این حال، تاریخچهٔ طولانی دارند — اولین مقاله در مورد مشتقگیری خودکار در سال ۱۹۶۴ منتشر شد1
همهٔ این چارچوبها سه ویژگی کلیدی را ترکیب میکنند:
- راهی برای محاسبهٔ گرادیان برای توابع مشتقپذیر دلخواه (مشتقگیری خودکار)
- راهی برای اجرای محاسبات تانسوری روی CPUها و GPUها (و احتمالاً روی سایر سختافزارهای تخصصی یادگیری عمیق)
- راهی برای توزیع محاسبات در چندین دستگاه یا چندین کامپیوتر، مانند چندین GPU روی یک کامپیوتر، یا حتی چندین GPU در چندین کامپیوتر مجزا
در کنار هم، این سه ویژگی ساده تمام یادگیری عمیق مدرن را ممکن میسازند.
مدت زیادی طول کشید تا این حوزه راهحلهای قوی برای هر سه مشکل توسعه دهد و آن راهحلها را در قالبی قابل استفادهٔ مجدد بستهبندی کند. از آغاز آن در دههٔ ۱۹۶۰ و تا دههٔ ۲۰۰۰، مشتقگیری خودکار هیچ کاربرد عملی در یادگیری ماشین نداشت — افرادی که با شبکههای عصبی کار میکردند صرفاً منطق گرادیان خود را دستی و معمولاً به زبانی مانند C++ مینوشتند. در همین حال، برنامهنویسی GPU تقریباً غیرممکن بود.
اوضاع در اواخر دههٔ ۲۰۰۰ شروع به تغییر آهسته کرد. اول، پایتون و اکوسیستم آن بهآرامی در جامعهٔ علمی محبوبیت پیدا کردند و از MATLAB و C++ پیشی گرفتند. دوم، NVIDIA در سال ۲۰۰۶ CUDA را منتشر کرد و امکان ساخت شبکههای عصبی را که میتوانستند روی GPUهای مصرفی اجرا شوند باز کرد. تمرکز اولیهٔ CUDA بر شبیهسازی فیزیک بود نه یادگیری ماشین، اما این مانع از آن نشد که محققان یادگیری ماشین از سال ۲۰۰۹ شروع به پیادهسازی شبکههای عصبی مبتنی بر CUDA کنند. آنها معمولاً پیادهسازیهای یکبارمصرفی بودند که روی یک GPU واحد و بدون هیچ مشتقگیری خودکار اجرا میشدند.
اولین چارچوبی که مشتقگیری خودکار و محاسبات GPU را برای آموزش مدلهای یادگیری عمیق ممکن کرد Theano بود، در حدود سال ۲۰۰۹. Theano جد مفهومی تمام ابزارهای مدرن یادگیری عمیق است. این چارچوب در سالهای ۲۰۱۳-۲۰۱۴ پس از اینکه نتایج مسابقهٔ ImageNet 2012 علاقهٔ جهانی را به یادگیری عمیق برانگیخت، در جامعهٔ تحقیقاتی یادگیری ماشین شروع به جلب توجه کرد. در همان زمان، چند کتابخانهٔ دیگر یادگیری عمیق با پشتیبانی GPU در دنیای بینایی ماشین شروع به محبوبیت کردند — بهویژه Torch 7 (مبتنی بر Lua) و Caffe (مبتنی بر C++). Keras در اوایل سال ۲۰۱۵ بهعنوان یک کتابخانهٔ یادگیری عمیق سطح بالاتر و آسانتر، با قدرت Theano، عرضه شد و بهسرعت در میان چند هزار نفری که در آن زمان به یادگیری عمیق علاقهمند بودند محبوب شد.
سپس در اواخر سال ۲۰۱۵، گوگل TensorFlow را عرضه کرد که بسیاری از ایدههای کلیدی Theano را گرفت و پشتیبانی از محاسبات توزیعشدهٔ در مقیاس بزرگ را اضافه کرد. انتشار TensorFlow یک نقطهٔ عطف بود که یادگیری عمیق را به جریان اصلی آگاهی توسعهدهندگان رساند. Keras بلافاصله پشتیبانی از TensorFlow را اضافه کرد. تا اواسط سال ۲۰۱۶، بیش از نیمی از تمام کاربران TensorFlow از آن از طریق Keras استفاده میکردند.
در پاسخ به TensorFlow، متا (که در آن زمان Facebook نام داشت) حدود یک سال بعد PyTorch را عرضه کرد، با الهام از ایدههای Chainer (یک چارچوب خاص اما نوآورانه که در اواسط سال ۲۰۱۵ عرضه شد و اکنون مدتهاست مرده است) و NumPy-Autograd، یک کتابخانهٔ مشتقگیری خودکار فقط CPU برای NumPy که توسط Maclaurin و همکاران در سال ۲۰۱۴ منتشر شد. در همین حال، گوگل TPUها را بهعنوان جایگزینی برای GPUها، همراه با XLA، یک کامپایلر با کارایی بالا که برای اجرای TensorFlow روی TPUها توسعه یافته بود، منتشر کرد.
چند سال بعد، در گوگل، متیو جانسون — یکی از توسعهدهندگانی که روی NumPy-Autograd کار کرده بود — JAX را بهعنوان روشی جایگزین برای استفاده از مشتقگیری خودکار با XLA منتشر کرد. JAX بهسرعت به لطف API مینیمال و مقیاسپذیری بالایش در میان محققان محبوب شد. امروزه، Keras، TensorFlow، PyTorch و JAX چارچوبهای برتر در دنیای یادگیری عمیق هستند.
با نگاهی به این تاریخچهٔ پرآشوب، میتوانیم بپرسیم چه چیزی در آینده خواهد آمد؟ آیا چارچوب جدیدی فردا ظهور خواهد کرد؟ آیا به زبان برنامهنویسی جدیدی یا پلتفرم سختافزاری جدیدی روی خواهیم آورد؟
اگر از من بپرسید، سه چیز امروز قطعی است:
- پایتون برنده شده است. اکوسیستم یادگیری ماشین و علم دادهٔ آن در این مرحله بهسادگی بسیار پرانرژی است. زبان کاملاً جدیدی برای جایگزینی آن نخواهد بود — حداقل نه در ۱۵ سال آینده.
- ما در یک دنیای چندچارچوبی هستیم — هر چهار چارچوب بهخوبی تثبیت شدهاند و بعید است در چند سال آینده جایی بروند. ایدهٔ خوبی است که کمی دربارهٔ هر یک از آنها یاد بگیرید. با این حال، بسیار ممکن است که چارچوبهای جدید در آینده محبوبیت پیدا کنند، علاوه بر آنها؛ MLX که اخیراً توسط اپل منتشر شده میتواند یکی از این نمونهها باشد. در این زمینه، استفاده از Keras یک مزیت قابلتوجه است: شما باید بتوانید مدلهای موجود Keras خود را از طریق یک بکاند جدید Keras روی هر چارچوب نوظهور جدیدی اجرا کنید. Keras پایداری آیندهنگر را برای توسعهدهندگان یادگیری ماشین فراهم خواهد کرد، همانطور که از سال ۲۰۱۵ — زمانی که نه TensorFlow و نه PyTorch و نه JAX وجود داشتند — این کار را کرده است.
- تراشههای جدید مطمئناً ممکن است در آینده ظهور کنند، در کنار GPUهای NVIDIA و TPUهای گوگل. برای مثال، خط GPU شرکت AMD احتمالاً روزهای درخشانی در پیش دارد. اما هر چنین تراشهٔ جدیدی برای جلب توجه باید با چارچوبهای موجود کار کند. بعید است سختافزار جدید گردشکارهای شما را مختل کند.
چگونه این چارچوبها به یکدیگر مرتبط هستند
Section titled “چگونه این چارچوبها به یکدیگر مرتبط هستند”Keras، TensorFlow، PyTorch و JAX همگی مجموعه ویژگیهای یکسانی ندارند و قابل تعویض نیستند. آنها تا حدی همپوشانی دارند، اما تا حد زیادی نقشهای متفاوتی برای موارد استفادهٔ متفاوت ایفا میکنند. بزرگترین تفاوت بین Keras و سه مورد دیگر است. Keras یک چارچوب سطح بالا است، در حالی که بقیه سطح پایینتر هستند. ساختن یک خانه را تصور کنید. Keras مانند یک کیت ساختوساز پیشساخته است: یک رابط کاربری ساده برای راهاندازی و آموزش شبکههای عصبی فراهم میکند. در مقابل، TensorFlow، PyTorch و JAX مانند مواد خام مورد استفاده در ساختوساز هستند.
همانطور که در فصلهای قبل دیدید، آموزش یک شبکهٔ عصبی حول مفاهیم زیر میچرخد:
- اول، دستکاری تانسور سطح پایین — زیرساختی که زیربنای تمام یادگیری ماشین مدرن است. این به APIهای سطح پایین موجود در TensorFlow، PyTorch 2 و JAX ترجمه میشود:
- تانسورها ، از جمله تانسورهای ویژهای که وضعیت شبکه را ذخیره میکنند ( متغیرها )
- عملیات تانسوری مانند جمع،
reluیاmatmul - پسانتشار ، راهی برای محاسبهٔ گرادیان عبارات ریاضی
- دوم، مفاهیم سطح بالای یادگیری عمیق — این به APIهای Keras ترجمه میشود:
- لایهها ، که در یک مدل ترکیب میشوند
- یک تابع زیان ، که سیگنال بازخورد مورد استفاده برای یادگیری را تعریف میکند
- یک بهینهساز ، که تعیین میکند یادگیری چگونه پیش میرود
- معیارها برای ارزیابی عملکرد مدل، مانند دقت
- یک حلقهٔ آموزش که نزول گرادیان تصادفی با دستهٔ کوچک را اجرا میکند
علاوه بر این، Keras منحصر به فرد است زیرا یک چارچوب کاملاً مستقل نیست. برای اجرا به یک موتور بکاند نیاز دارد (شکل ۳.۴ را ببینید)، بسیار شبیه به یک کیت ساخت خانهٔ پیشساخته که باید مواد اولیه را از جایی تأمین کند. TensorFlow، PyTorch و JAX همگی میتوانند بهعنوان بکاند Keras استفاده شوند. علاوه بر این، Keras میتواند روی NumPy اجرا شود، اما از آنجا که NumPy APIی برای گرادیانها فراهم نمیکند، گردشکارهای Keras روی NumPy به پیشبینی از یک مدل محدود میشوند — آموزش غیرممکن است.
حالا که درک روشنتری از چگونگی شکلگیری همهٔ این چارچوبها و ارتباطشان با هم دارید، بیایید به آنچه کار با آنها شبیه است بپردازیم. ما آنها را به ترتیب زمانی پوشش خواهیم داد: ابتدا TensorFlow، سپس PyTorch و در نهایت JAX.
معرفی TensorFlow
Section titled “معرفی TensorFlow”TensorFlow یک چارچوب یادگیری ماشین متنباز مبتنی بر پایتون است که عمدتاً توسط گوگل توسعه یافته است. انتشار اولیهٔ آن در نوامبر ۲۰۱۵، بهدنبال آن نسخهٔ ۱ در فوریهٔ ۲۰۱۷ و نسخهٔ ۲ در اکتبر ۲۰۱۹ بود. TensorFlow بهطور گسترده در کاربردهای یادگیری ماشین در سطح تولید در صنعت استفاده میشود.
مهم است که به خاطر داشته باشید TensorFlow چیزی بیش از یک کتابخانهٔ واحد است. این یک پلتفرم است که خانهٔ اکوسیستم وسیعی از اجزاست، برخی توسط گوگل و برخی توسط اشخاص ثالث توسعه یافتهاند. برای مثال، TFX برای مدیریت گردشکار یادگیری ماشین در سطح صنعتی، TF-Serving برای استقرار تولیدی، کیت بهینهسازی TF برای کوانتیزهسازی و هرس مدل، و TFLite و MediaPipe برای استقرار در برنامههای موبایل وجود دارند.
در کنار هم، این اجزا طیف بسیار گستردهای از موارد استفاده را پوشش میدهند، از تحقیقات پیشرو تا کاربردهای تولیدی در مقیاس بزرگ.
گامهای اول با TensorFlow
Section titled “گامهای اول با TensorFlow”در پاراگرافهای بعدی، با تمام مبانی TensorFlow آشنا خواهید شد. ما مفاهیم کلیدی زیر را پوشش خواهیم داد:
- تانسورها و متغیرها
- عملیات عددی در TensorFlow
- محاسبهٔ گرادیانها با
GradientTape - سریع کردن توابع TensorFlow با استفاده از کامپایل در زمان اجرا (just-in-time)
سپس معرفی را با یک مثال سرتاسری به پایان میبریم: یک پیادهسازی خالص TensorFlow از رگرسیون خطی.
بیایید این تانسورها را به جریان بیندازیم.
تانسورها و متغیرها در TensorFlow
Section titled “تانسورها و متغیرها در TensorFlow”برای انجام هر کاری در TensorFlow، به چند تانسور نیاز خواهیم داشت. چندین روش مختلف برای ایجاد آنها وجود دارد.
تانسورهای ثابت
Section titled “تانسورهای ثابت”تانسورها باید با مقداری اولیه ایجاد شوند، بنابراین روشهای رایج برای ایجاد تانسور از طریق tf.ones (معادل np.ones) و tf.zeros (معادل np.zeros) است. همچنین میتوانید یک تانسور از مقادیر پایتون یا NumPy با استفاده از tf.constant ایجاد کنید.
لیستینگ ۳.۱: تانسورهای همهیک یا همهصفر
>>> import tensorflow as tf>>> # Equivalent to np.ones(shape=(2, 1))>>> tf.ones(shape=(2, 1))تانسورهای تصادفی
Section titled “تانسورهای تصادفی”همچنین میتوانید تانسورهای پر از مقادیر تصادفی را از طریق یکی از متدهای زیرماژول tf.random (معادل زیرماژول np.random) ایجاد کنید.
لیستینگ ۳.۲: تانسورهای تصادفی
>>> # Tensor of random values drawn from a normal distribution with>>> # mean 0 and standard deviation 1. Equivalent to>>> # np.random.normal(size=(3, 1), loc=0., scale=1.).>>> x = tf.random.normal(shape=(3, 1), mean=0., stddev=1.)>>> print(x)تخصیص تانسور و کلاس Variable
Section titled “تخصیص تانسور و کلاس Variable”یک تفاوت قابلتوجه بین آرایههای NumPy و تانسورهای TensorFlow این است که تانسورهای TensorFlow قابل تخصیص نیستند: آنها ثابت هستند. برای مثال، در NumPy میتوانید کار زیر را انجام دهید.
لیستینگ ۳.۳: آرایههای NumPy قابل تخصیص هستند
import numpy as np
x = np.ones(shape=(2, 2))x[0, 0] = 0.0
سعی کنید همین کار را در TensorFlow انجام دهید: با خطا مواجه خواهید شد، EagerTensor object does not support item assignment.
لیستینگ ۳.۴: تانسورهای TensorFlow قابل تخصیص نیستند
x = tf.ones(shape=(2, 2))# This will fail, as a tensor isn't assignable.x[0, 0] = 0.0برای آموزش یک مدل، باید وضعیت آن را بهروزرسانی کنیم، که مجموعهای از تانسورهاست. اگر تانسورها قابل تخصیص نیستند، پس چگونه این کار را انجام دهیم؟ اینجاست که متغیرها وارد میشوند. tf.Variable کلاسی است که برای مدیریت وضعیت قابل تغییر در TensorFlow طراحی شده است.
برای ایجاد یک متغیر، باید مقداری اولیه، مانند یک تانسور تصادفی، ارائه دهید.
لیستینگ ۳.۵: ایجاد یک tf.Variable
>>> v = tf.Variable(initial_value=tf.random.normal(shape=(3, 1)))>>> print(v)وضعیت یک متغیر را میتوان از طریق متد assign آن تغییر داد.
لیستینگ ۳.۶: تخصیص یک مقدار به یک Variable
>>> v.assign(tf.ones((3, 1)))تخصیص همچنین برای زیرمجموعهای از ضرایب کار میکند.
لیستینگ ۳.۷: تخصیص یک مقدار به زیرمجموعهای از یک Variable
>>> v[0, 0].assign(3.)بهطور مشابه، assign_add و assign_sub معادلهای کارآمد += و -= هستند.
لیستینگ ۳.۸: استفاده از assign_add
>>> v.assign_add(tf.ones((3, 1)))عملیات تانسوری: انجام ریاضیات در TensorFlow
Section titled “عملیات تانسوری: انجام ریاضیات در TensorFlow”درست مانند NumPy، TensorFlow مجموعهٔ بزرگی از عملیات تانسوری برای بیان فرمولهای ریاضی ارائه میدهد. در اینجا چند مثال آورده شده است.
لیستینگ ۳.۹: چند عملیات ریاضی پایه در TensorFlow
a = tf.ones((2, 2))# Takes the square, same as np.squareb = tf.square(a)# Takes the square root, same as np.sqrtc = tf.sqrt(a)# Adds two tensors (element-wise)d = b + c# Takes the product of two tensors (see chapter 2), same as np.matmule = tf.matmul(a, b)# Concatenates a and b along axis 0, same as np.concatenatef = tf.concat((a, b), axis=0)در اینجا معادل لایهٔ Dense که در فصل ۲ دیدیم آمده است:
def dense(inputs, W, b): return tf.nn.relu(tf.matmul(inputs, W) + b)گرادیانها در TensorFlow: نگاهی دوباره به API GradientTape
Section titled “گرادیانها در TensorFlow: نگاهی دوباره به API GradientTape”تا اینجا، TensorFlow به نظر میرسد بسیار شبیه NumPy است. اما در اینجا چیزی است که NumPy نمیتواند انجام دهد: بازیابی گرادیان هر عبارت مشتقپذیر نسبت به هر یک از ورودیهایش. فقط یک محدودهٔ GradientTape باز کنید، محاسباتی را روی یک یا چند تانسور ورودی اعمال کنید و گرادیان نتیجه را نسبت به ورودیها بازیابی کنید.
لیستینگ ۳.۱۰: استفاده از GradientTape
input_var = tf.Variable(initial_value=3.0)with tf.GradientTape() as tape: result = tf.square(input_var)gradient = tape.gradient(result, input_var)این معمولاً برای بازیابی گرادیانهای زیان یک مدل نسبت به وزنهایش استفاده میشود: gradients = tape.gradient(loss, weights).
در فصل ۲ دیدید که GradientTape چگونه روی یک ورودی یا لیستی از ورودیها کار میکند و چگونه ورودیها میتوانند اسکالر یا تانسورهای بعدبالا باشند.
تا اینجا، تنها حالتی را دیدهاید که تانسورهای ورودی در tape.gradient() متغیرهای TensorFlow بودند. در واقع ممکن است این ورودیها هر تانسور دلخواهی باشند. با این حال، بهطور پیشفرض فقط متغیرهای آموزشپذیر ردیابی میشوند. با یک تانسور ثابت، باید بهصورت دستی آن را بهعنوان تحت ردیابی علامتگذاری کنید، با فراخوانی tape.watch() روی آن.
لیستینگ ۳.۱۱: استفاده از GradientTape با ورودیهای تانسور ثابت
input_const = tf.constant(3.0)with tf.GradientTape() as tape: tape.watch(input_const) result = tf.square(input_const)gradient = tape.gradient(result, input_const)چرا؟ زیرا ذخیرهٔ پیشگیرانهٔ اطلاعات مورد نیاز برای محاسبهٔ گرادیان هر چیزی نسبت به هر چیزی بسیار گران خواهد بود. برای جلوگیری از هدر رفتن منابع، نوار باید بداند چه چیزی را زیر نظر بگیرد. متغیرهای آموزشپذیر بهطور پیشفرض زیر نظر گرفته میشوند زیرا محاسبهٔ گرادیان زیان نسبت به لیستی از متغیرهای آموزشپذیر رایجترین کاربرد نوار گرادیان است.
نوار گرادیان یک ابزار قدرتمند است، حتی قادر به محاسبهٔ گرادیانهای مرتبهٔ دوم — یعنی گرادیان یک گرادیان. برای مثال، گرادیان موقعیت یک شیء نسبت به زمان، سرعت آن شیء است، و گرادیان مرتبهٔ دوم شتاب آن است.
اگر موقعیت یک سیب در حال سقوط را در امتداد یک محور عمودی در طول زمان اندازهگیری کنید و دریابید که position(time) = 4.9 * time ** 2 را تأیید میکند، شتاب آن چیست؟ بیایید از دو نوار گرادیان تودرتو برای فهمیدن استفاده کنیم.
لیستینگ ۳.۱۲: استفاده از نوارهای گرادیان تودرتو برای محاسبهٔ گرادیانهای مرتبهٔ دوم
time = tf.Variable(0.0)with tf.GradientTape() as outer_tape: with tf.GradientTape() as inner_tape: position = 4.9 * time**2 speed = inner_tape.gradient(position, time)# We use the outer tape to compute the gradient of the gradient from# the inner tape. Naturally, the answer is 4.9 * 2 = 9.8.acceleration = outer_tape.gradient(speed, time)سریع کردن توابع TensorFlow با استفاده از کامپایل
Section titled “سریع کردن توابع TensorFlow با استفاده از کامپایل”تمام کدهای TensorFlow که تاکنون نوشتهاید بهصورت “مشتاقانه” (eagerly) اجرا شدهاند. این بدان معناست که عملیات یکی پس از دیگری در زمان اجرای پایتون اجرا میشوند، بسیار شبیه به هر کد پایتون یا NumPy. اجرای مشتاقانه برای اشکالزدایی عالی است، اما معمولاً نسبتاً کند است. اغلب میتواند مفید باشد که برخی محاسبات را موازی کرد، یا عملیات را “ادغام” کرد — جایگزینی دو عملیات متوالی، مانند matmul و سپس relu، با یک عملیات واحد و کارآمدتر که همان کار را بدون مادیسازی خروجی میانی انجام میدهد.
این را میتوان از طریق کامپایل به دست آورد. ایدهٔ کلی کامپایل این است که توابع خاصی که در پایتون نوشتهاید را بگیرید، آنها را از پایتون خارج کنید، بهطور خودکار آنها را به یک “برنامهٔ کامپایلشده” سریعتر و کارآمدتر بازنویسی کنید، و سپس آن برنامه را از زمان اجرای پایتون فراخوانی کنید.
مزیت اصلی کامپایل عملکرد بهبودیافته است. یک اشکال نیز وجود دارد: کدی که مینویسید دیگر کدی نیست که اجرا میشود، که میتواند تجربهٔ اشکالزدایی را دردناک کند. فقط پس از اینکه قبلاً کد خود را در زمان اجرای پایتون اشکالزدایی کردید، کامپایل را فعال کنید.
میتوانید کامپایل را روی هر تابع TensorFlow با پیچیدن آن در دکوراتور tf.function اعمال کنید، مانند این:
@tf.functiondef dense(inputs, W, b): return tf.nn.relu(tf.matmul(inputs, W) + b)وقتی این کار را انجام میدهید، هر فراخوانی به dense() با فراخوانی به یک برنامهٔ کامپایلشده جایگزین میشود که نسخهٔ بهینهشدهتری از تابع را پیادهسازی میکند. اولین فراخوانی به تابع کمی بیشتر طول میکشد، زیرا TensorFlow کد شما را کامپایل خواهد کرد. این فقط یک بار اتفاق میافتد — تمام فراخوانیهای بعدی به همان تابع سریع خواهند بود.
TensorFlow دو حالت کامپایل دارد:
- اول، حالت پیشفرض، که ما آن را “حالت گراف” مینامیم. هر تابعی که با
@tf.functionتزئین شده باشد در حالت گراف اجرا میشود. - دوم، کامپایل با XLA، یک کامپایلر با کارایی بالا برای یادگیری ماشین (مخفف Accelerated Linear Algebra). میتوانید آن را با مشخص کردن
jit_compile=Trueفعال کنید، مانند این:
@tf.function(jit_compile=True)def dense(inputs, W, b): return tf.nn.relu(tf.matmul(inputs, W) + b)اغلب اتفاق میافتد که کامپایل یک تابع با XLA آن را سریعتر از حالت گراف اجرا میکند — اگرچه اجرای تابع برای اولین بار بیشتر طول میکشد، زیرا کامپایلر کار بیشتری برای انجام دارد.
یک مثال سرتاسری: یک طبقهبند خطی در TensorFlow خالص
Section titled “یک مثال سرتاسری: یک طبقهبند خطی در TensorFlow خالص”شما دربارهٔ تانسورها، متغیرها و عملیات تانسوری میدانید و میدانید چگونه گرادیانها را محاسبه کنید. این برای ساخت هر مدل یادگیری ماشین مبتنی بر TensorFlow مبتنی بر نزول گرادیان کافی است. بیایید یک مثال سرتاسری را مرور کنیم تا مطمئن شویم همهچیز کاملاً روشن است.
در یک مصاحبهٔ شغلی یادگیری ماشین، ممکن است از شما خواسته شود یک طبقهبند خطی را از صفر پیادهسازی کنید: یک کار بسیار ساده که بهعنوان فیلتری بین نامزدهایی که حداقل پیشزمینهٔ یادگیری ماشین دارند و کسانی که ندارند عمل میکند. بیایید شما را از این فیلتر عبور دهیم و از دانش تازهیافتهٔ TensorFlow خود برای پیادهسازی چنین طبقهبند خطی استفاده کنیم.
ابتدا، بیایید دادههای مصنوعی بهخوبی جداپذیر خطی برای کار ایجاد کنیم: دو کلاس نقطه در یک صفحهٔ دوبعدی.
لیستینگ ۳.۱۳: تولید دو کلاس از نقاط تصادفی در یک صفحهٔ دوبعدی
import numpy as np
num_samples_per_class = 1000negative_samples = np.random.multivariate_normal(    # Generates the first class of points: 1,000 random 2D points with    # specified "mean" and "covariance matrix." Intuitively, the    # "covariance matrix" describes the shape of the point cloud, and    # the "mean" describes its position in the plane. `cov=[[1,    # 0.5],[0.5, 1]]` corresponds to "an oval-like point cloud oriented    # from bottom left to top right."    mean=[0, 3], cov=[[1, 0.5], [0.5, 1]], size=num_samples_per_class)positive_samples = np.random.multivariate_normal(    # Generates the other class of points with a different mean and the    # same covariance matrix (point cloud with a different position and    # the same shape)    mean=[3, 0], cov=[[1, 0.5], [0.5, 1]], size=num_samples_per_class)
negative_samples و positive_samples هر دو آرایههایی با شکل (1000, 2) هستند. بیایید آنها را در یک آرایهٔ واحد با شکل (2000, 2) روی هم بچینیم.
لیستینگ ۳.۱۴: روی هم چیدن دو کلاس در یک آرایه با شکل (2000, 2)
inputs = np.vstack((negative_samples, positive_samples)).astype(np.float32)بیایید برچسبهای هدف متناظر را تولید کنیم، آرایهای از ۰ها و ۱ها با شکل (2000, 1)، که در آن targets[i, 0] اگر inputs[i] متعلق به کلاس ۰ باشد صفر است (و برعکس).
لیستینگ ۳.۱۵: تولید اهداف متناظر (۰ و ۱)
targets = np.vstack( ( np.zeros((num_samples_per_class, 1), dtype="float32"), np.ones((num_samples_per_class, 1), dtype="float32"), ))بیایید دادههایمان را با Matplotlib، یک کتابخانهٔ تجسم دادهٔ معروف پایتون (از پیش نصبشده در Colab، بنابراین نیازی به نصب آن ندارید)، رسم کنیم، همانطور که در شکل ۳.۱ نشان داده شده است.
لیستینگ ۳.۱۶: رسم دو کلاس نقطه
import matplotlib.pyplot as plt
plt.scatter(inputs[:, 0], inputs[:, 1], c=targets[:, 0])plt.show()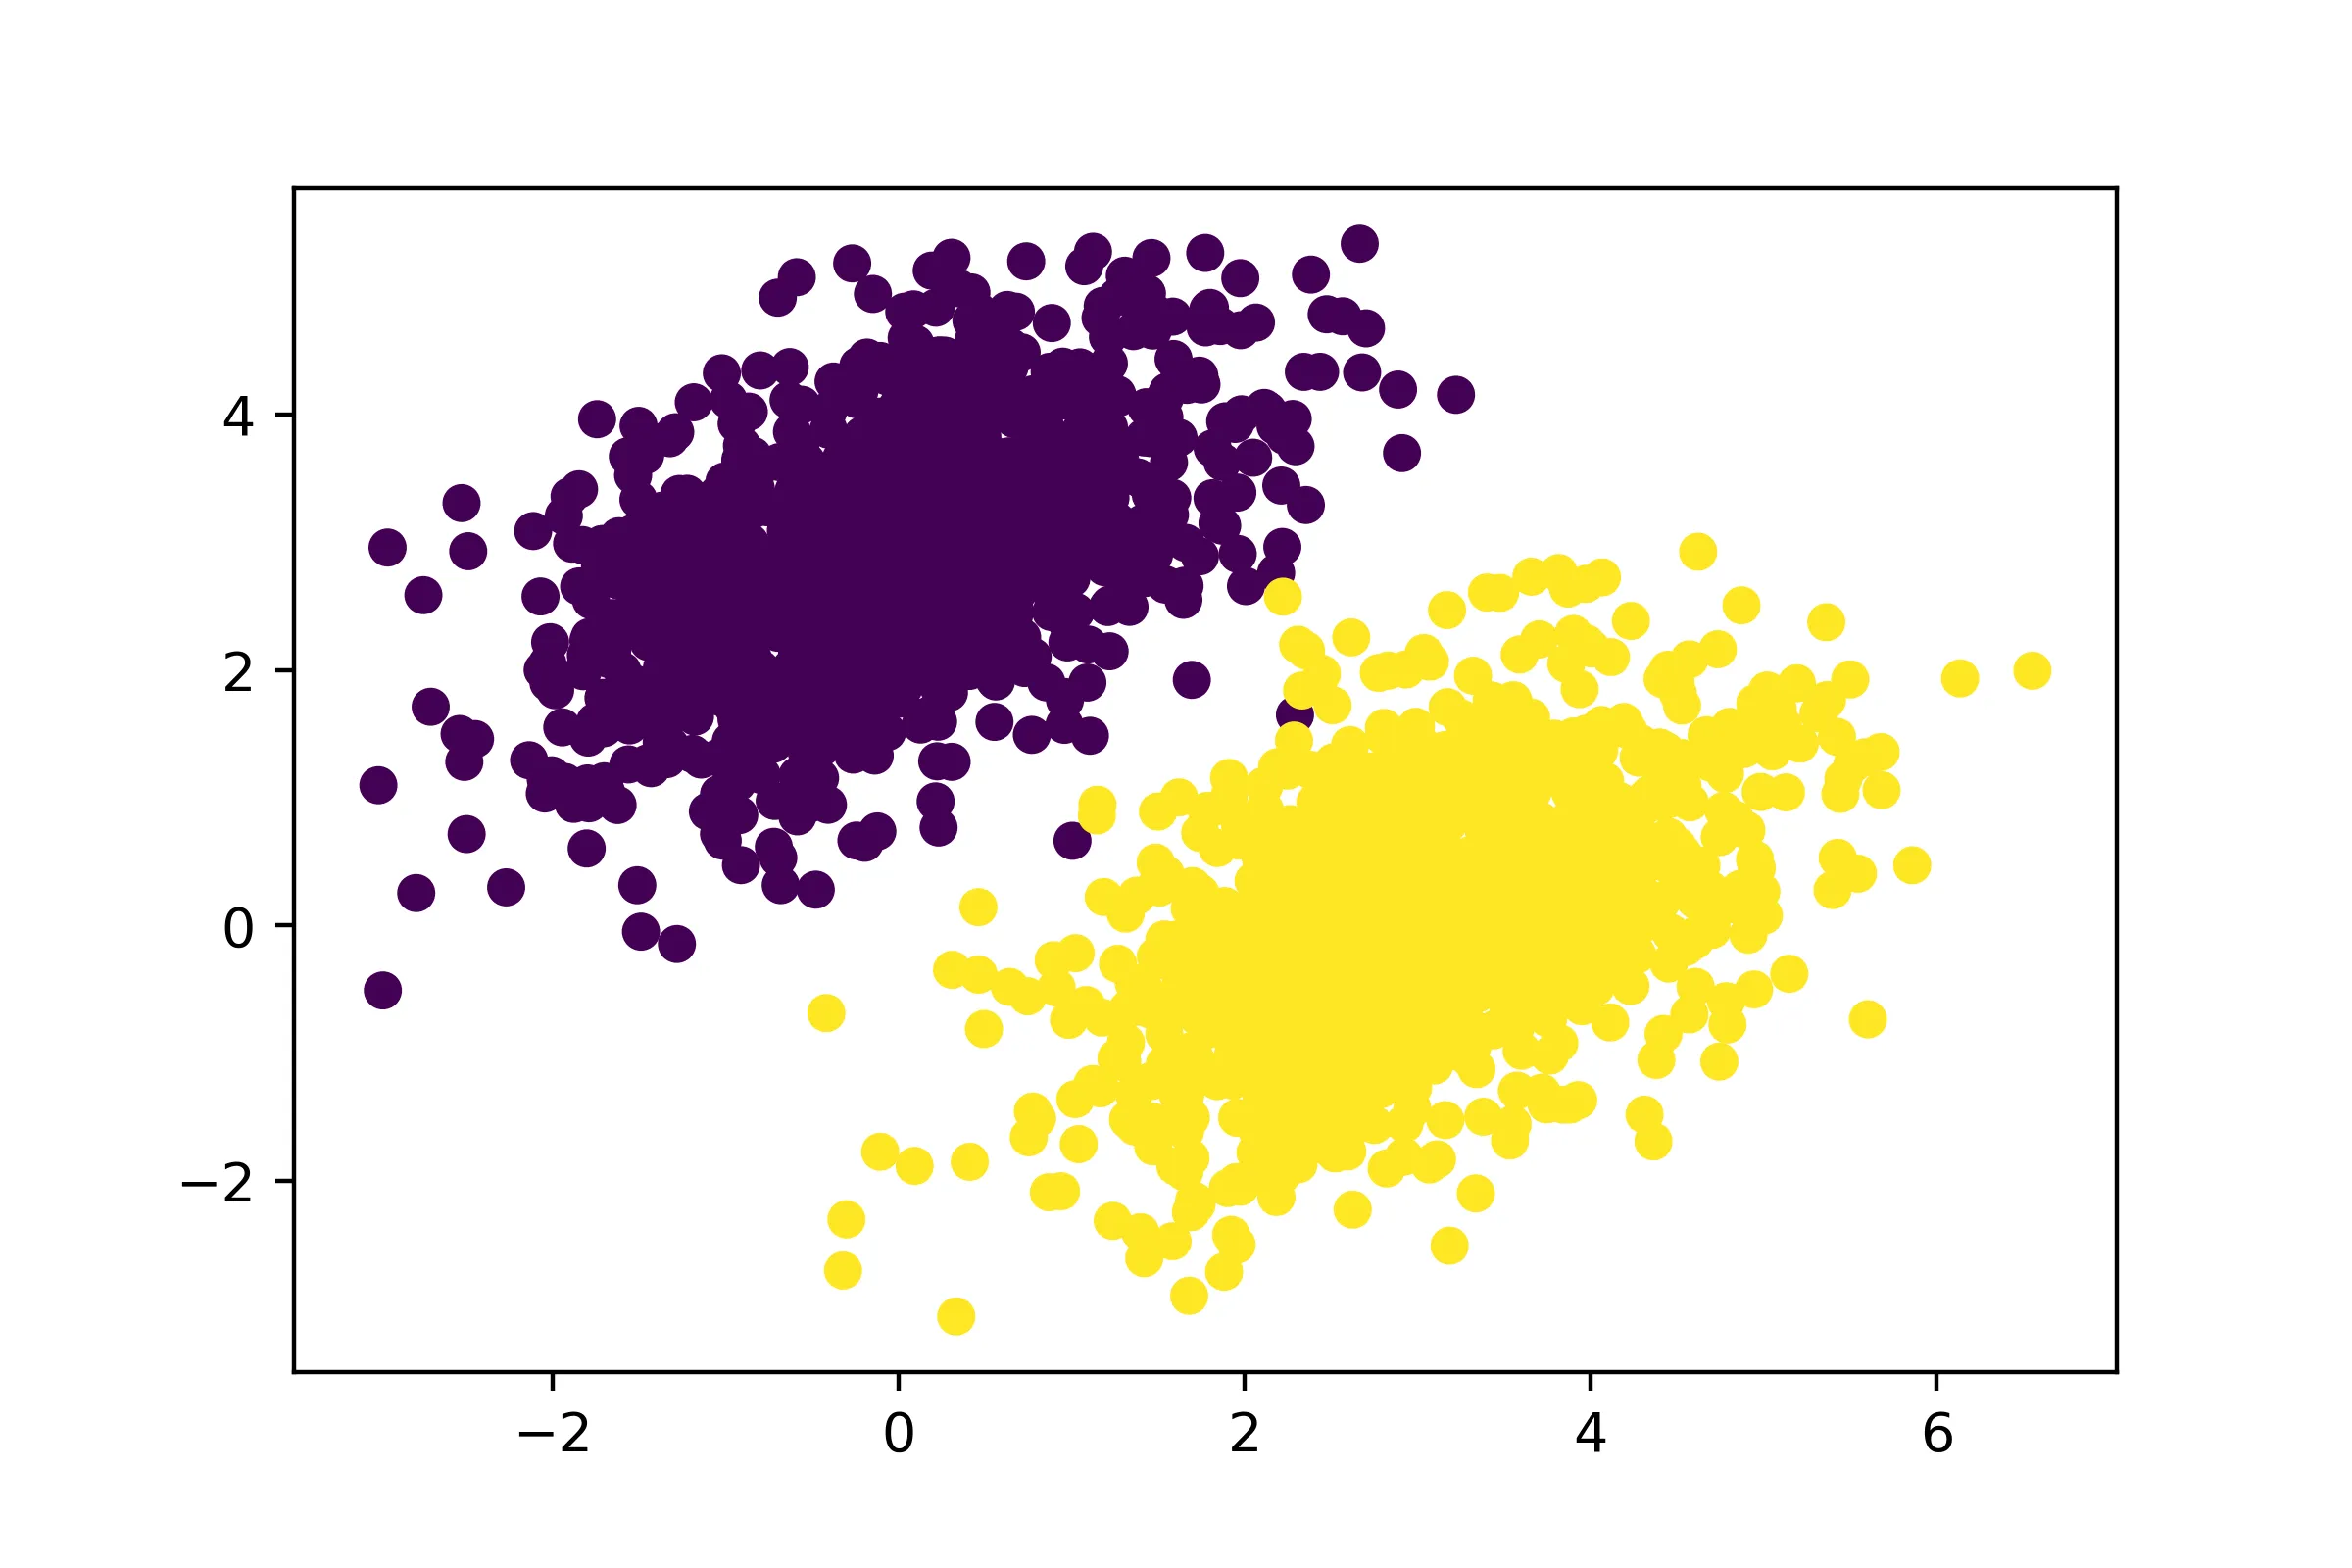
شکل ۳.۱: دادههای مصنوعی ما: دو کلاس از نقاط تصادفی در صفحهٔ دوبعدی
حالا، بیایید یک طبقهبند خطی ایجاد کنیم که بتواند یاد بگیرد این دو خوشه را جدا کند. یک طبقهبند خطی یک تبدیل آفین (prediction = matmul(input, W) + b) است که برای کمینه کردن مجذور تفاوت بین پیشبینیها و اهداف آموزش دیده است.
همانطور که خواهید دید، این در واقع مثال بسیار سادهتری از مثال سرتاسری یک شبکهٔ عصبی دوتایی اسباببازی در پایان فصل ۲ است. با این حال، این بار، باید بتوانید همهچیز را دربارهٔ کد، خط به خط، درک کنید.
بیایید متغیرهای W و b خود را ایجاد کنیم، که بهترتیب با مقادیر تصادفی و صفر مقداردهی شدهاند.
لیستینگ ۳.۱۷: ایجاد متغیرهای طبقهبند خطی
# The inputs will be 2D points.input_dim = 2# The output predictions will be a single score per sample (close to 0# if the sample is predicted to be in class 0, and close to 1 if the# sample is predicted to be in class 1).output_dim = 1W = tf.Variable(initial_value=tf.random.uniform(shape=(input_dim, output_dim)))b = tf.Variable(initial_value=tf.zeros(shape=(output_dim,)))این تابع گذر رو به جلو ما است.
لیستینگ ۳.۱۸: تابع گذر رو به جلو
def model(inputs, W, b): return tf.matmul(inputs, W) + bاز آنجا که طبقهبند خطی ما روی ورودیهای دوبعدی کار میکند، W در واقع فقط دو ضریب اسکالر است: W = [[w1], [w2]]. در همین حال، b یک ضریب اسکالر واحد است. به این ترتیب، برای نقطهٔ ورودی معین [x, y]، مقدار پیشبینی آن برابر است با prediction = [[w1], [w2]] • [x, y] + b = w1 * x + w2 * y + b.
این تابع زیان ما است.
لیستینگ ۳.۱۹: تابع زیان میانگین مربعات خطا
def mean_squared_error(targets, predictions): # per_sample_losses will be a tensor with the same shape as targets # and predictions, containing per-sample loss scores. per_sample_losses = tf.square(targets - predictions) # We need to average these per-sample loss scores into a single # scalar loss value: reduce_mean does this. return tf.reduce_mean(per_sample_losses)حالا به گام آموزش میرویم که برخی دادههای آموزشی دریافت میکند و وزنهای W و b را برای کمینه کردن زیان روی دادهها بهروزرسانی میکند.
لیستینگ ۳.۲۰: تابع گام آموزش
learning_rate = 0.1
# Wraps the function in a tf.function decorator to speed it up@tf.function(jit_compile=True)def training_step(inputs, targets, W, b):    # Forward pass, inside of a gradient tape scope    with tf.GradientTape() as tape:        predictions = model(inputs, W, b)        loss = mean_squared_error(predictions, targets)    # Retrieves the gradient of the loss with regard to weights    grad_loss_wrt_W, grad_loss_wrt_b = tape.gradient(loss, [W, b])    # Updates the weights    W.assign_sub(grad_loss_wrt_W * learning_rate)    b.assign_sub(grad_loss_wrt_b * learning_rate)    return loss
برای سادگی، ما بهجای آموزش با دستهٔ کوچک، آموزش دستهای انجام خواهیم داد: هر گام آموزش (محاسبهٔ گرادیان و بهروزرسانی وزن) را روی کل داده اجرا میکنیم، نه با تکرار روی داده در دستههای کوچک. از یک طرف، این بدان معناست که اجرای هر گام آموزش بسیار بیشتر طول میکشد، زیرا گذر رو به جلو و گرادیانها را برای ۲,۰۰۰ نمونه بهطور همزمان محاسبه میکنیم. از سوی دیگر، هر بهروزرسانی گرادیان در کاهش زیان روی دادههای آموزشی بسیار مؤثرتر خواهد بود، زیرا اطلاعاتی از تمام نمونههای آموزشی را در بر میگیرد نه فقط برای مثال ۱۲۸ نمونهٔ تصادفی. در نتیجه، به گامهای آموزش بسیار کمتری نیاز خواهیم داشت و باید از نرخ یادگیری بزرگتری نسبت به آنچه معمولاً برای آموزش با دستهٔ کوچک استفاده میکنیم استفاده کنیم (از learning_rate = 0.1 استفاده خواهیم کرد، همانطور که قبلاً تعریف شد).
لیستینگ ۳.۲۱: حلقهٔ آموزش دستهای
for step in range(40): loss = training_step(inputs, targets, W, b) print(f"Loss at step {step}: {loss:.4f}")پس از ۴۰ گام، به نظر میرسد زیان آموزش حدود ۰.۰۲۵ تثبیت شده است. بیایید رسم کنیم مدل خطی ما چگونه نقاط دادهٔ آموزشی را طبقهبندی میکند، همانطور که در شکل ۳.۲ نشان داده شده است. از آنجا که اهداف ما ۰ و ۱ هستند، یک نقطهٔ ورودی معین بهعنوان “۰” طبقهبندی میشود اگر مقدار پیشبینی آن زیر ۰.۵ باشد و بهعنوان “۱” اگر بالای ۰.۵ باشد:
predictions = model(inputs, W, b)plt.scatter(inputs[:, 0], inputs[:, 1], c=predictions[:, 0] > 0.5)plt.show()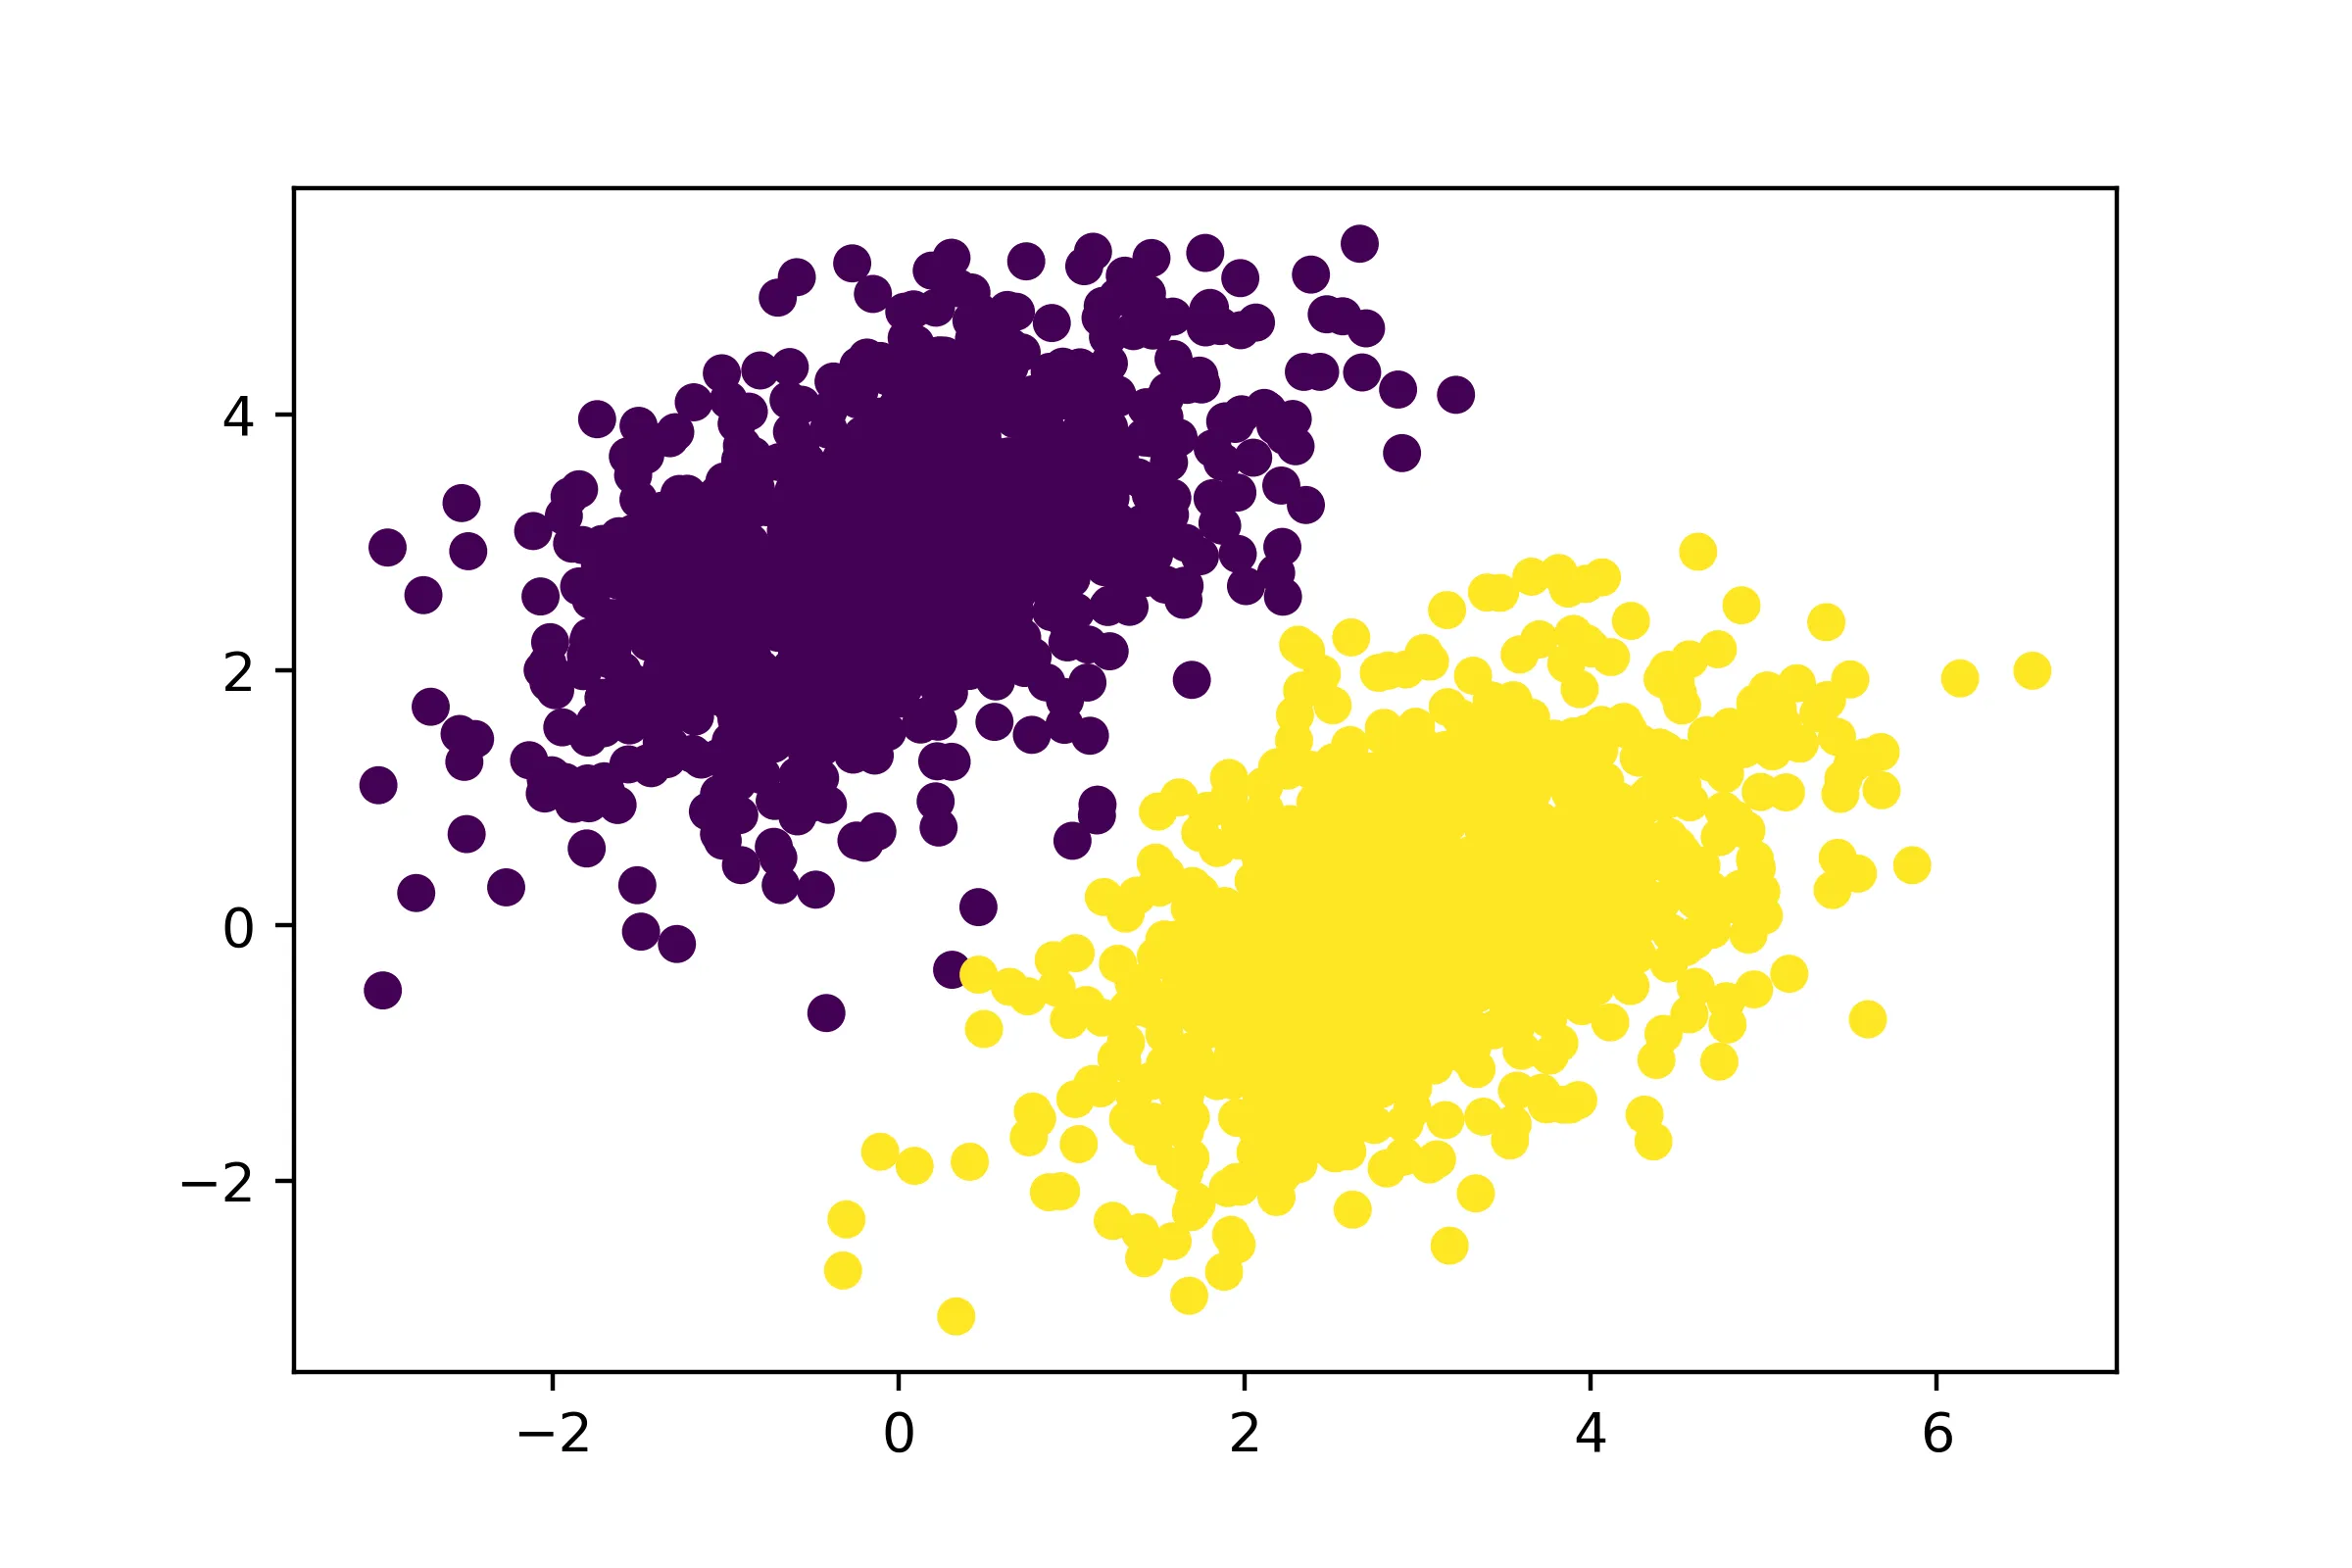
شکل ۳.۲: پیشبینیهای مدل ما روی ورودیهای آموزشی: بسیار شبیه به اهداف آموزشی
به یاد بیاورید که مقدار پیشبینی برای نقطهٔ معین [x, y] بهسادگی prediction == [[w1], [w2]] • [x, y] + b == w1 * x + w2 * y + b است. بنابراین، کلاس “۰” بهصورت w1 * x + w2 * y + b < 0.5 و کلاس “۱” بهصورت w1 * x + w2 * y + b > 0.5 تعریف میشود. متوجه خواهید شد که آنچه به آن نگاه میکنید در واقع معادلهٔ یک خط در صفحهٔ دوبعدی است: w1 * x + w2 * y + b = 0.5. کلاس ۱ بالای خط است؛ کلاس ۰ زیر خط است. ممکن است به دیدن معادلات خط به قالب y = a * x + b عادت کرده باشید؛ در همان قالب، خط ما به y = - w1 / w2 * x + (0.5 - b) / w2 تبدیل میشود.
بیایید این خط را رسم کنیم، همانطور که در شکل ۳.۳ نشان داده شده است:
# Generates 100 regularly spaced numbers between -1 and 4, which we# will use to plot our linex = np.linspace(-1, 4, 100)# This is our line's equation.y = -W[0] / W[1] * x + (0.5 - b) / W[1]# Plots our line (`"-r"` means "plot it as a red line")plt.plot(x, y, "-r")# Plots our model's predictions on the same plotplt.scatter(inputs[:, 0], inputs[:, 1], c=predictions[:, 0] > 0.5)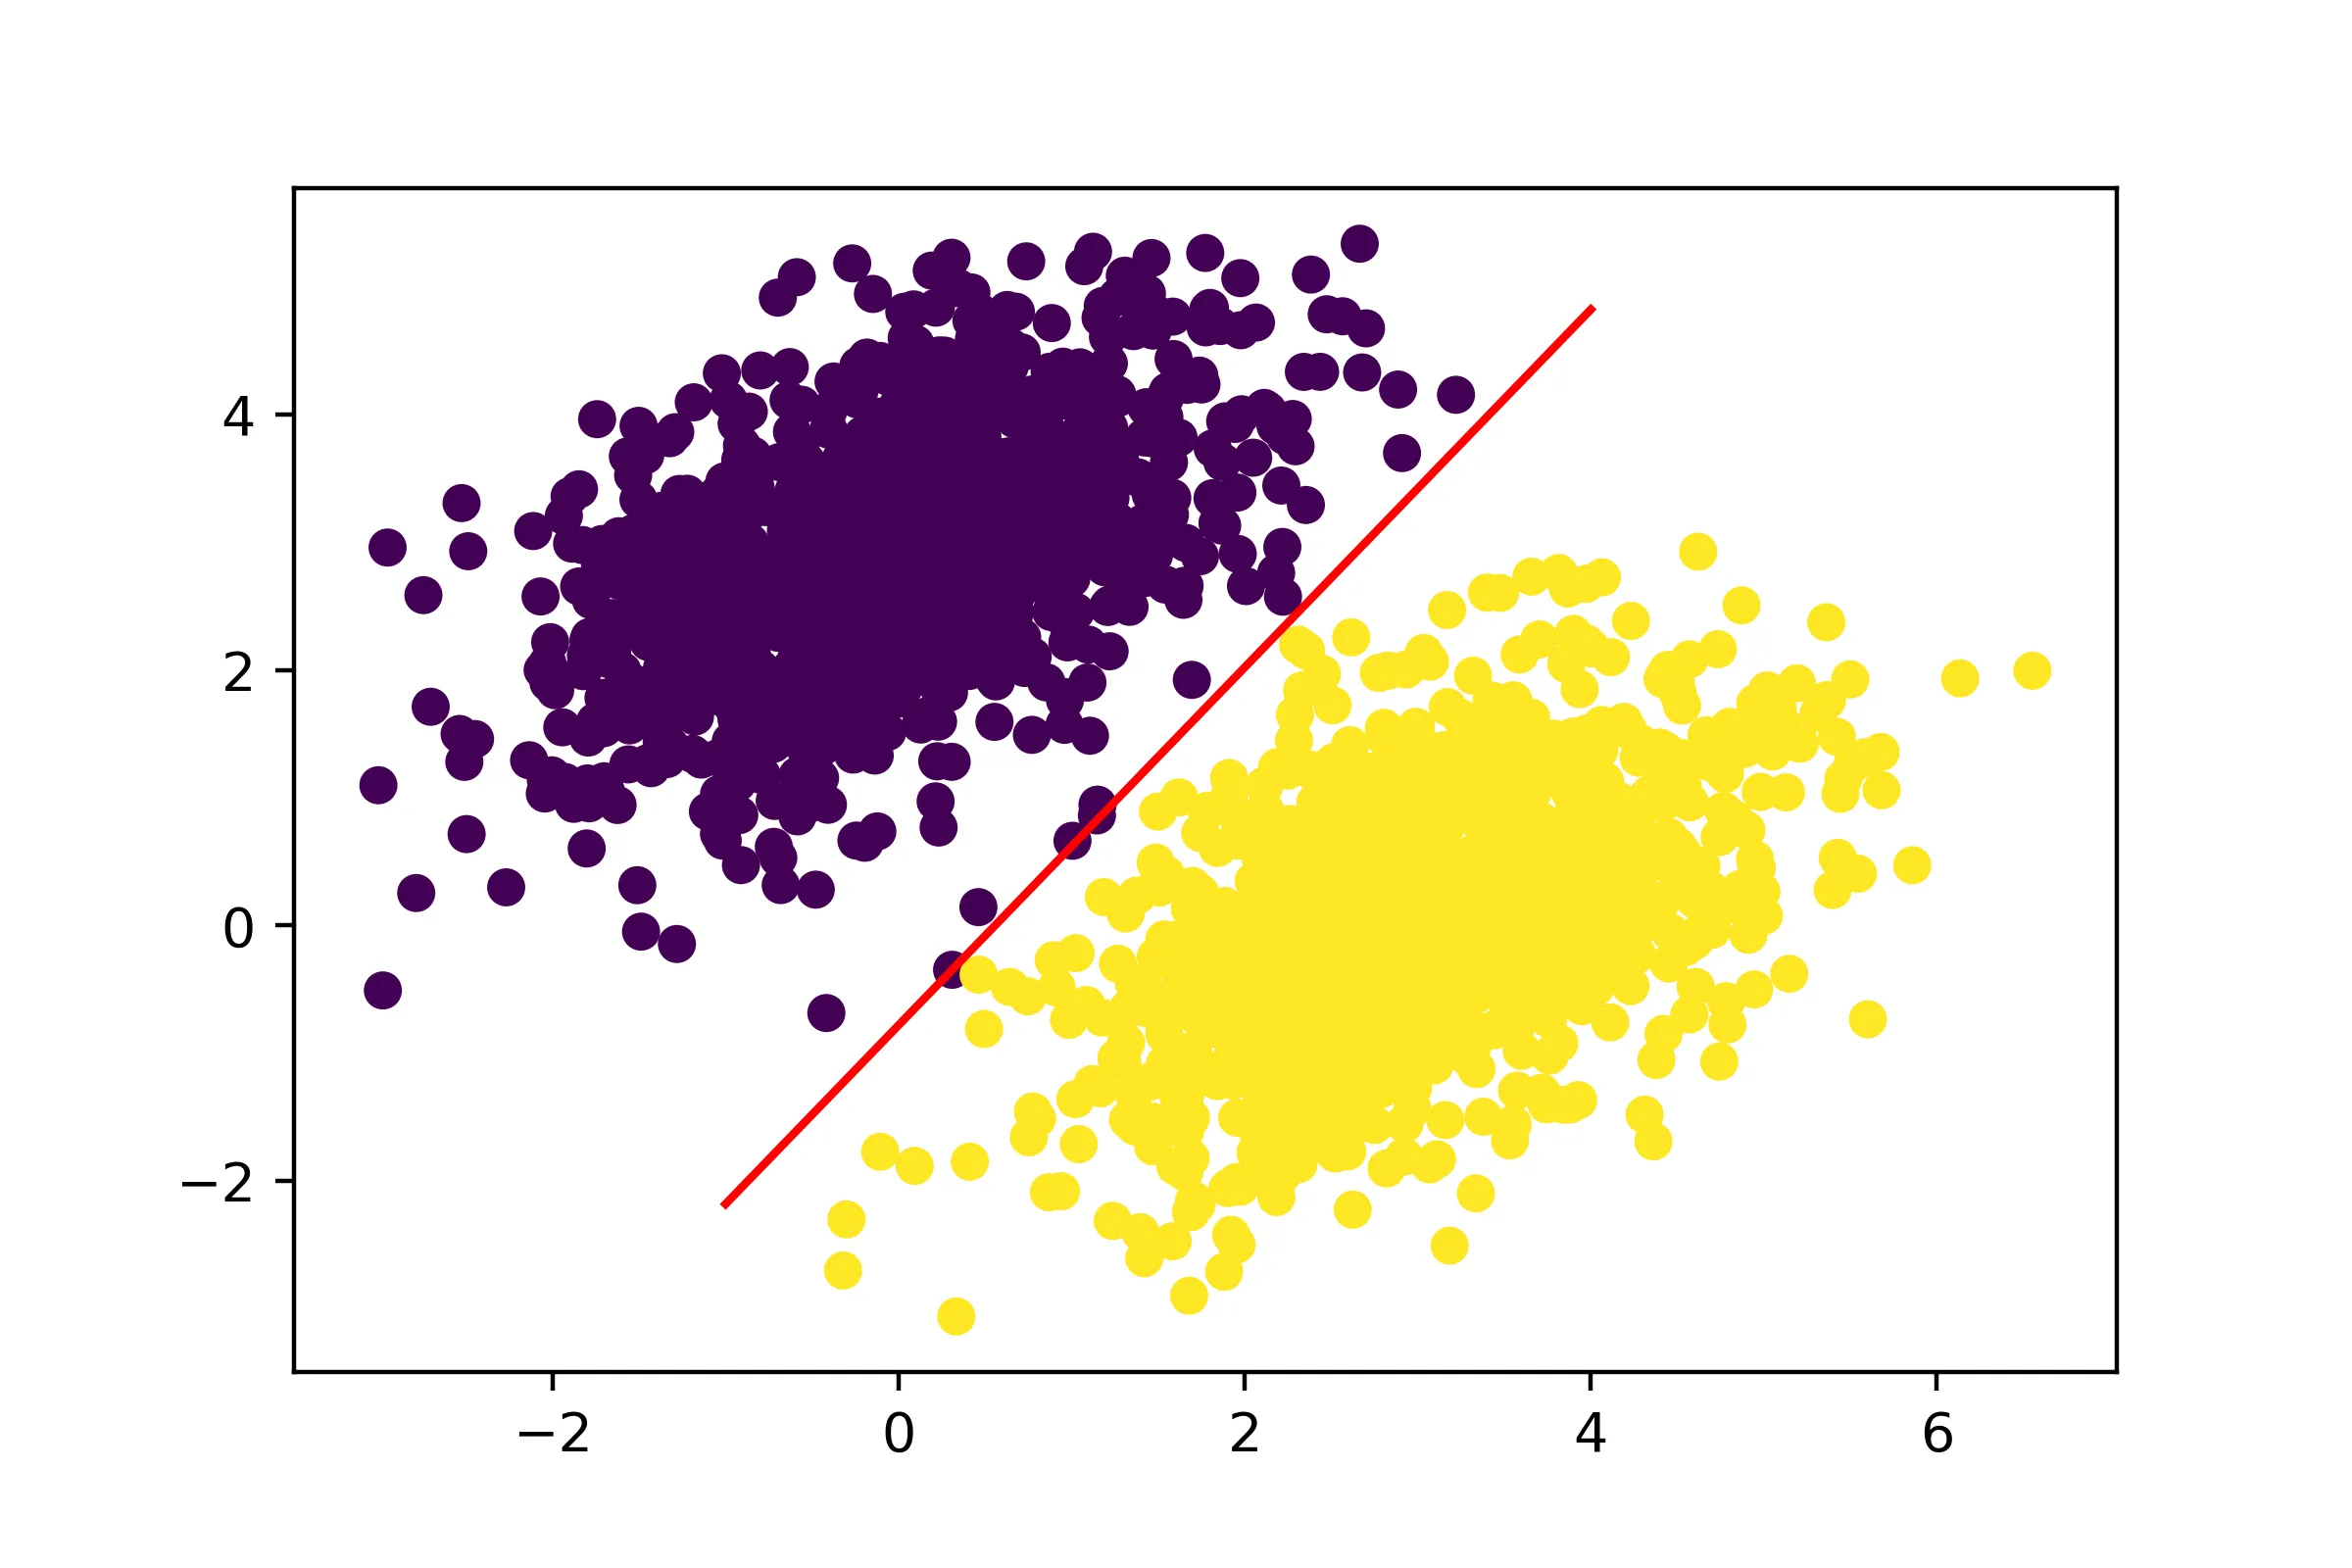
شکل ۳.۳: مدل ما، بهصورت یک خط تجسمشده
این واقعاً همان چیزی است که یک طبقهبند خطی دربارهٔ آن است: یافتن پارامترهای یک خط (یا در فضاهای با ابعاد بالاتر، یک ابرصفحه) که دو کلاس داده را بهطور تمیز جدا کند.
چه چیزی رویکرد TensorFlow را منحصر به فرد میکند
Section titled “چه چیزی رویکرد TensorFlow را منحصر به فرد میکند”اکنون با تمام APIهای پایهای که زیربنای گردشکارهای مبتنی بر TensorFlow هستند آشنا هستید و در شرف شیرجه زدن به چارچوبهای بیشتر — بهویژه PyTorch و JAX — هستید. چه چیزی کار با TensorFlow را از کار با هر چارچوب دیگری متمایز میکند؟ چه زمانی باید از TensorFlow استفاده کنید و چه زمانی میتوانید از چیز دیگری استفاده کنید؟
اگر از ما بپرسید، مزایای اصلی TensorFlow عبارتند از:
- به لطف حالت گراف و کامپایل XLA، سریع است. معمولاً بهطور قابلتوجهی سریعتر از PyTorch و NumPy است، اگرچه JAX اغلب حتی سریعتر است.
- از نظر ویژگیها بسیار کامل است. منحصر به فرد در میان تمام چارچوبها، از تانسورهای رشتهای و همچنین “تانسورهای ژنده” (تانسورهایی که در آنها ورودیهای مختلف ممکن است ابعاد متفاوتی داشته باشند — بسیار مفید برای مدیریت دنبالهها بدون نیاز به پر کردن آنها تا یک طول مشترک) پشتیبانی میکند. همچنین پشتیبانی فوقالعادهای از پیشپردازش داده از طریق API بسیار کارآمد
tf.dataدارد.tf.dataآنقدر خوب است که حتی JAX آن را برای پیشپردازش داده توصیه میکند. هر کاری که نیاز دارید انجام دهید، TensorFlow راهحلی برای آن دارد. - اکوسیستم آن برای استقرار تولیدی، بالغترین در میان تمام چارچوبهاست، بهویژه وقتی صحبت از استقرار در موبایل یا مرورگر میشود.
با این حال، TensorFlow دارای چند نقص قابلتوجه است:
- API بسیار گستردهای دارد — روی دیگر سکهٔ کامل بودن از نظر ویژگی. TensorFlow شامل هزاران عملیات مختلف است.
- API عددی آن گاهی با API NumPy ناسازگار است و اگر از قبل با NumPy آشنا باشید، نزدیک شدن به آن را کمی دشوارتر میکند.
- پلتفرم محبوب اشتراکگذاری مدلهای از پیش آموزشدیده Hugging Face پشتیبانی کمتری از TensorFlow دارد، که به این معناست که جدیدترین مدلهای هوش مصنوعی مولد ممکن است همیشه در TensorFlow در دسترس نباشند.
حالا بیایید به سراغ PyTorch برویم.
معرفی PyTorch
Section titled “معرفی PyTorch”PyTorch یک چارچوب یادگیری ماشین متنباز مبتنی بر پایتون است که عمدتاً توسط متا (سابقاً Facebook) توسعه یافته است. در ابتدا در سپتامبر ۲۰۱۶ (بهعنوان پاسخی به انتشار TensorFlow) منتشر شد، با نسخهٔ ۱.۰ آن در سال ۲۰۱۸ و نسخهٔ ۲.۰ آن در سال ۲۰۲۳ عرضه شد. PyTorch سبک برنامهنویسی خود را از چارچوب از کار افتادهٔ Chainer به ارث میبرد که خودش از NumPy-Autograd الهام گرفته بود. PyTorch بهطور گسترده در جامعهٔ تحقیقاتی یادگیری ماشین استفاده میشود.
مانند TensorFlow، PyTorch در مرکز اکوسیستم بزرگی از بستههای مرتبط قرار دارد، مانند torchvision، torchaudio یا پلتفرم محبوب اشتراکگذاری مدل Hugging Face.
API PyTorch سطح بالاتری از TensorFlow و JAX دارد: شامل لایهها و بهینهسازها، مانند Keras است. این لایهها و بهینهسازها هنگام استفاده از Keras با بکاند PyTorch با گردشکارهای Keras سازگار هستند.
گامهای اول با PyTorch
Section titled “گامهای اول با PyTorch”در پاراگرافهای بعدی، با تمام مبانی PyTorch آشنا خواهید شد. ما مفاهیم کلیدی زیر را پوشش خواهیم داد:
- تانسورها و پارامترها
- عملیات عددی در PyTorch
- محاسبهٔ گرادیانها با متد
backward() - بستهبندی محاسبات با کلاس
Module - سریع کردن PyTorch با استفاده از کامپایل
ما معرفی را با پیادهسازی مجدد مثال سرتاسری رگرسیون خطی خود در PyTorch خالص به پایان میبریم.
تانسورها و پارامترها در PyTorch
Section titled “تانسورها و پارامترها در PyTorch”یک تلهٔ اولیه دربارهٔ PyTorch این است که بستهٔ آن pytorch نام ندارد. در واقع torch نام دارد. آن را با pip install torch نصب میکنید و با import torch وارد میکنید.
مانند NumPy و TensorFlow، شیء در قلب چارچوب تانسور است. ابتدا، بیایید چند تانسور PyTorch به دست آوریم.
تانسورهای ثابت
Section titled “تانسورهای ثابت”در اینجا چند تانسور ثابت آورده شده است.
لیستینگ ۳.۲۲: تانسورهای همهیک یا همهصفر
>>> import torch>>> # Unlike in other frameworks, the shape argument is named "size">>> # rather than "shape.">>> torch.ones(size=(2, 1))تانسورهای تصادفی
Section titled “تانسورهای تصادفی”ایجاد تانسور تصادفی مشابه NumPy و TensorFlow است، اما با نحو متفاوت. تابع normal را در نظر بگیرید: این تابع آرگومان shape نمیگیرد. در عوض، میانگین و انحراف معیار باید بهصورت تانسورهای PyTorch با شکل خروجی مورد انتظار ارائه شوند.
لیستینگ ۳.۲۳: تانسورهای تصادفی
>>> # Equivalent to tf.random.normal(shape=(3, 1), mean=0., stddev=1.)>>> torch.normal(... mean=torch.zeros(size=(3, 1)),... std=torch.ones(size=(3, 1)))در مورد ایجاد یک تانسور تصادفی یکنواخت، این کار را از طریق torch.rand انجام میدهید. برخلاف np.random.uniform یا tf.random.uniform، شکل خروجی باید بهعنوان آرگومانهای مستقل برای هر بُعد ارائه شود، مانند این:
>>> # Equivalent to tf.random.uniform(shape=(3, 1), minval=0.,>>> # maxval=1.)>>> torch.rand(3, 1)تخصیص تانسور و کلاس Parameter
Section titled “تخصیص تانسور و کلاس Parameter”مانند آرایههای NumPy، اما برخلاف تانسورهای TensorFlow، تانسورهای PyTorch قابل تخصیص هستند. میتوانید عملیاتی مانند این انجام دهید:
>>> x = torch.zeros(size=(2, 1))>>> x[0, 0] = 1.>>> xاگرچه میتوانید از یک torch.Tensor معمولی برای ذخیرهٔ وضعیت آموزشپذیر یک مدل استفاده کنید، PyTorch یک زیرکلاس تانسور تخصصی برای این منظور فراهم میکند: کلاس torch.nn.parameter.Parameter. در مقایسه با یک تانسور معمولی، وضوح معنایی فراهم میکند — اگر یک Parameter ببینید، میدانید که یک قطعه از وضعیت آموزشپذیر است، در حالی که یک Tensor میتواند هر چیزی باشد. در نتیجه، PyTorch را قادر میسازد تا بهطور خودکار Parameterهایی را که به مدلهای PyTorch اختصاص میدهید ردیابی و بازیابی کند — مشابه کاری که Keras با نمونههای Variable Keras انجام میدهد.
این یک Parameter است.
لیستینگ ۳.۲۴: ایجاد یک پارامتر PyTorch
>>> x = torch.zeros(size=(2, 1))>>> # A Parameter can only be created using a torch.Tensor value — no>>> # NumPy arrays allowed.>>> p = torch.nn.parameter.Parameter(data=x)عملیات تانسوری: انجام ریاضیات در PyTorch
Section titled “عملیات تانسوری: انجام ریاضیات در PyTorch”ریاضیات در PyTorch دقیقاً مانند ریاضیات در NumPy یا TensorFlow کار میکند، اگرچه مانند TensorFlow، API PyTorch اغلب به روشهای ظریفی از API NumPy واگرا میشود.
لیستینگ ۳.۲۵: چند عملیات ریاضی پایه در PyTorch
a = torch.ones((2, 2))# Takes the square, same as np.squareb = torch.square(a)# Takes the square root, same as np.sqrtc = torch.sqrt(a)# Adds two tensors (element-wise)d = b + c# Takes the product of two tensors (see chapter 2), same as np.matmule = torch.matmul(a, b)# Concatenates a and b along axis 0, same as np.concatenatef = torch.cat((a, b), dim=0)این یک لایهٔ dense است:
def dense(inputs, W, b): return torch.nn.relu(torch.matmul(inputs, W) + b)محاسبهٔ گرادیانها با PyTorch
Section titled “محاسبهٔ گرادیانها با PyTorch”هیچ “نوار گرادیان” صریحی در PyTorch وجود ندارد. مکانیزم مشابهی وجود دارد: وقتی هر محاسبهای را در PyTorch اجرا میکنید، چارچوب یک گراف محاسباتی یکبارمصرف (یک “نوار”) ایجاد میکند که آنچه را که تازه اتفاق افتاده ثبت میکند. با این حال، آن نوار از کاربر پنهان است. API عمومی برای استفاده از آن در سطح خود تانسورهاست: میتوانید tensor.backward() را فراخوانی کنید تا پسانتشار را از طریق تمام عملیات قبلاً اجراشده که به آن تانسور منجر شدهاند اجرا کنید. انجام این کار ویژگی .grad تمام تانسورهایی را که گرادیان را ردیابی میکنند پر میکند.
لیستینگ ۳.۲۶: محاسبهٔ یک گرادیان با .backward()
>>> # To compute gradients with respect to a tensor, it must be created>>> # with requires_grad=True.>>> input_var = torch.tensor(3.0, requires_grad=True)>>> result = torch.square(input_var)>>> # Calling backward() populates the "grad" attribute on all tensors>>> # create with requires_grad=True.>>> result.backward()>>> gradient = input_var.grad>>> gradientاگر چندین بار پشت سر هم backward() را فراخوانی کنید، ویژگی .grad گرادیانها را “انباشته” میکند: هر فراخوانی جدید گرادیان جدید را با گرادیان قبلی جمع میکند. برای مثال، در کد زیر، input_var.grad گرادیان square(input_var) نسبت به input_var نیست؛ بلکه مجموع آن گرادیان و گرادیان قبلاً محاسبهشده است — مقدار آن از زمان قطعهکد قبلی ما دو برابر شده است:
>>> result = torch.square(input_var)>>> result.backward()>>> # .grad will sum all gradient values from each time backward() is>>> # called.>>> input_var.gradبرای بازنشانی گرادیانها، میتوانید بهسادگی .grad را روی None تنظیم کنید:
>>> input_var.grad = Noneحالا بیایید این را در عمل به کار ببریم!
یک مثال سرتاسری: یک طبقهبند خطی در PyTorch خالص
Section titled “یک مثال سرتاسری: یک طبقهبند خطی در PyTorch خالص”اکنون بهاندازهٔ کافی PyTorch میدانید که طبقهبند خطی خود را در PyTorch بازنویسی کنید. بسیار شبیه به نسخهٔ TensorFlow باقی خواهد ماند — تنها تفاوت عمده در نحوهٔ محاسبهٔ گرادیانها است.
بیایید با ایجاد متغیرهای مدل خود شروع کنیم. فراموش نکنید که requires_grad=True را پاس دهید تا بتوانیم گرادیانها را نسبت به آنها محاسبه کنیم:
input_dim = 2output_dim = 1
W = torch.rand(input_dim, output_dim, requires_grad=True)b = torch.zeros(output_dim, requires_grad=True)
این مدل ما است — تا اینجا تفاوتی نیست. ما فقط از tf.matmul به torch.matmul رفتیم:
def model(inputs, W, b): return torch.matmul(inputs, W) + bاین تابع زیان ما است. ما فقط از tf.square به torch.square و از tf.reduce_mean به torch.mean تغییر میکنیم:
def mean_squared_error(targets, predictions): per_sample_losses = torch.square(targets - predictions) return torch.mean(per_sample_losses)حالا برای گام آموزش. نحوهٔ کار آن به این صورت است:
loss.backward()پسانتشار را از گره خروجیlossآغاز میکند و ویژگیtensor.gradرا روی تمام تانسورهایی که در محاسبهٔlossدخیل بودند پر میکند.tensor.gradگرادیان زیان نسبت به آن تانسور را نشان میدهد.- ما از ویژگی
.gradبرای بازیابی گرادیانهای زیان نسبت بهWوbاستفاده میکنیم. - ما
Wوbرا با استفاده از آن گرادیانها بهروزرسانی میکنیم. از آنجا که این بهروزرسانیها قرار نیست بخشی از گذر رو به عقب باشند، آنها را در یک محدودهٔtorch.no_grad()انجام میدهیم که محاسبهٔ گرادیان را برای همهچیز درون آن نادیده میگیرد. - محتوای ویژگی
.gradپارامترهایWوbخود را با تنظیم آن رویNoneبازنشانی میکنیم. اگر این کار را نمیکردیم، مقادیر گرادیان در چندین فراخوانیtraining_step()انباشته میشدند و مقادیر نامعتبری را به دنبال داشتند:
learning_rate = 0.1
def training_step(inputs, targets, W, b):    # Forward pass    predictions = model(inputs)    loss = mean_squared_error(targets, predictions)    # Computes gradients    loss.backward()    # Retrieves gradients    grad_loss_wrt_W, grad_loss_wrt_b = W.grad, b.grad    with torch.no_grad():        # Updates weights inside a no_grad scope        W -= grad_loss_wrt_W * learning_rate        b -= grad_loss_wrt_b * learning_rate    # Resets gradients    W.grad = None    b.grad = None    return loss
این میتوانست حتی سادهتر شود — بیایید ببینیم چگونه.
بستهبندی وضعیت و محاسبات با کلاس Module
Section titled “بستهبندی وضعیت و محاسبات با کلاس Module”PyTorch همچنین یک API سطح بالاتر و شیءگرا برای انجام پسانتشار دارد که مستلزم تکیه بر دو کلاس جدید است: کلاس torch.nn.Module و یک کلاس بهینهساز از ماژول torch.optim، مانند torch.optim.SGD (معادل keras.optimizers.SGD).
ایدهٔ کلی این است که یک زیرکلاس از torch.nn.Module تعریف کنید که
- برخی
Parameterها را برای ذخیرهٔ متغیرهای وضعیت نگه میدارد. اینها در متد__init__()تعریف میشوند. - محاسبهٔ گذر رو به جلو را در متد
forward()پیادهسازی میکند.
باید دقیقاً شبیه موارد زیر به نظر برسد.
لیستینگ ۳.۲۷: تعریف یک torch.nn.Module
class LinearModel(torch.nn.Module):    def __init__(self):        super().__init__()        self.W = torch.nn.Parameter(torch.rand(input_dim, output_dim))        self.b = torch.nn.Parameter(torch.zeros(output_dim))
    def forward(self, inputs):        return torch.matmul(inputs, self.W) + self.b
اکنون میتوانیم LinearModel خود را نمونهسازی کنیم:
model = LinearModel()هنگام استفاده از نمونهٔ torch.nn.Module، بهجای فراخوانی مستقیم متد forward()، از __call__() استفاده میکنید (یعنی مستقیماً کلاس مدل را روی ورودیها فراخوانی میکنید)، که به forward() هدایت میشود اما چند قلاب چارچوبی به آن اضافه میکند:
torch_inputs = torch.tensor(inputs)output = model(torch_inputs)حالا، بیایید یک بهینهساز PyTorch به دست آوریم. برای نمونهسازی آن، باید لیست پارامترهایی را که بهینهساز قصد بهروزرسانی آنها را دارد ارائه دهید. میتوانید آن را از نمونهٔ Module خود از طریق .parameters() بازیابی کنید:
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)با استفاده از نمونهٔ Module و بهینهساز SGD PyTorch، میتوانیم یک گام آموزش سادهشده را اجرا کنیم:
def training_step(inputs, targets): predictions = model(inputs) loss = mean_squared_error(targets, predictions) loss.backward() optimizer.step() model.zero_grad() return lossقبلاً، بهروزرسانی پارامترهای مدل اینگونه بود:
with torch.no_grad(): W -= grad_loss_wrt_W * learning_rate b -= grad_loss_wrt_b * learning_rateحالا میتوانیم فقط optimizer.step() را انجام دهیم.
بهطور مشابه، قبلاً باید گرادیانهای پارامتر را با انجام tensor.grad = None روی هر کدام بهصورت دستی بازنشانی میکردیم. حالا میتوانیم فقط model.zero_grad() را انجام دهیم.
بهطور کلی، این ممکن است کمی گیجکننده به نظر برسد — به نظر میرسد تانسور زیان، بهینهساز و نمونهٔ Module همگی از طریق برخی مکانیزمهای پنهان پسزمینه از یکدیگر آگاه هستند. آنها از طریق یک کنش از راه دور خارقالعاده با یکدیگر تعامل دارند. نگران نباشید — میتوانید این توالی مراحل (loss.backward() - optimizer.step() - model.zero_grad()) را بهعنوان یک طلسم جادویی که هر زمان نیاز به نوشتن تابع گام آموزش دارید باید بخوانید در نظر بگیرید. فقط مطمئن شوید که model.zero_grad() را فراموش نمیکنید. این یک باگ عمده خواهد بود (و متأسفانه کاملاً رایج است)!
سریع کردن ماژولهای PyTorch با استفاده از کامپایل
Section titled “سریع کردن ماژولهای PyTorch با استفاده از کامپایل”یک چیز آخر. مشابه اینکه TensorFlow به شما اجازه میدهد توابع را برای عملکرد بهتر کامپایل کنید، PyTorch به شما اجازه میدهد توابع یا حتی نمونههای Module را از طریق ابزار torch.compile() کامپایل کنید. این API از کامپایلر مخصوص PyTorch به نام Dynamo استفاده میکند.
بیایید آن را روی Module رگرسیون خطی خود امتحان کنیم:
compiled_model = torch.compile(model)شیء حاصل قرار است دقیقاً مانند اصلی کار کند — بهجز اینکه گذر رو به جلو و رو به عقب باید سریعتر اجرا شوند.
همچنین میتوانید از torch.compile() بهعنوان دکوراتور تابع استفاده کنید:
@torch.compiledef dense(inputs, W, b): return torch.nn.relu(torch.matmul(inputs, W) + b)در عمل، بیشتر کدهای PyTorch از کامپایل استفاده نمیکنند و بهسادگی بهصورت مشتاقانه اجرا میشوند، زیرا کامپایلر ممکن است همیشه با همهٔ مدلها کار نکند و وقتی هم کار میکند ممکن است همیشه منجر به سرعتبخشی نشود. برخلاف TensorFlow و Jax که کامپایل از ابتدا در آنها تعبیه شده بود، کامپایلر PyTorch یک افزودهٔ نسبتاً اخیر است.
چه چیزی رویکرد PyTorch را منحصر به فرد میکند
Section titled “چه چیزی رویکرد PyTorch را منحصر به فرد میکند”در مقایسه با TensorFlow و JAX که در ادامه پوشش خواهیم داد، چه چیزی PyTorch را متمایز میکند؟ چرا باید از آن استفاده کنید یا نکنید؟
در اینجا دو نقطه قوت کلیدی PyTorch آورده شده است:
- کد PyTorch بهطور پیشفرض مشتاقانه اجرا میشود و اشکالزدایی را آسان میکند. توجه داشته باشید که این در مورد کد TensorFlow و JAX نیز صادق است، اما یک تفاوت بزرگ این است که PyTorch عموماً در نظر گرفته شده که همیشه مشتاقانه اجرا شود، در حالی که هر پروژهٔ جدی TensorFlow یا JAX inevitably در نقطهای به کامپایل نیاز پیدا میکند، که میتواند تجربهٔ اشکالزدایی را بهطور قابلتوجهی خراب کند.
- پلتفرم محبوب اشتراکگذاری مدلهای از پیش آموزشدیده Hugging Face پشتیبانی درجهیک از PyTorch دارد، که به این معناست هر مدلی که بخواهید استفاده کنید احتمالاً در PyTorch موجود است. این محرک اصلی پذیرش PyTorch امروز است.
در همین حال، برخی معایب استفاده از PyTorch نیز وجود دارد:
- مانند TensorFlow، API PyTorch با NumPy ناسازگار است. علاوه بر این، از نظر داخلی نیز ناسازگار است. برای مثال، کلمهٔ کلیدی پرکاربرد
axisبسته به تابع گاهیdimنامیده میشود. برخی عملیات تولید اعداد شبهتصادفی آرگومانseedمیگیرند؛ برخی نه. و به همین ترتیب. این میتواند یادگیری PyTorch را ناامیدکننده کند، بهویژه وقتی از NumPy میآیید. - به دلیل تمرکز بر اجرای مشتاقانه، PyTorch نسبتاً کند است — این کندترین چارچوب در میان تمام چارچوبهای اصلی با اختلاف زیاد است. برای بیشتر مدلها، ممکن است با JAX ۲۰٪ یا ۳۰٪ سرعت بیشتر ببینید. برای برخی مدلها — بهویژه مدلهای بزرگ — ممکن است حتی با استفاده از
torch.compile()هم با JAX سرعت ۳ یا ۵ برابری ببینید. - اگرچه ممکن است از طریق
torch.compile()کد PyTorch را سریعتر کرد، کامپایلر Dynamo PyTorch در این زمان (در سال ۲۰۲۵) کاملاً بیاثر و پر از درهای تله است. در نتیجه، تنها درصد بسیار کوچکی از پایگاه کاربری PyTorch از کامپایل استفاده میکنند. شاید این در نسخههای آینده بهبود یابد!
معرفی JAX
Section titled “معرفی JAX”JAX یک کتابخانهٔ متنباز برای محاسبات مشتقپذیر است که عمدتاً توسط گوگل توسعه یافته است. پس از انتشار در سال ۲۰۱۸، JAX بهسرعت در جامعهٔ تحقیقاتی محبوبیت پیدا کرد، بهویژه به دلیل توانایی آن در استفاده از TPUهای گوگل در مقیاس بزرگ. امروزه، JAX توسط بیشتر بازیکنان برتر در فضای هوش مصنوعی مولد — شرکتهایی مانند DeepMind، Apple، Midjourney، Anthropic، Cohere و غیره استفاده میشود.
JAX رویکردی بیحالت به محاسبات را میپذیرد، به این معنی که توابع در JAX هیچ وضعیت پایدارداری را حفظ نمیکنند. این با برنامهنویسی دستوری سنتی که در آن متغیرها میتوانند مقادیر را بین فراخوانیهای تابع نگه دارند، در تضاد است.
ماهیت بیحالت توابع JAX چندین مزیت دارد. بهطور خاص، موازیسازی خودکار مؤثر و محاسبات توزیعشده را ممکن میسازد، زیرا توابع میتوانند بهطور مستقل و بدون نیاز به همگامسازی اجرا شوند. مقیاسپذیری شدید JAX برای رسیدگی به مسائل یادگیری ماشین در مقیاس بسیار بزرگ که شرکتهایی مانند گوگل و DeepMind با آن روبرو هستند ضروری است.
گامهای اول با JAX
Section titled “گامهای اول با JAX”ما مفاهیم کلیدی زیر را پوشش خواهیم داد:
- کلاس
array - عملیات تصادفی در JAX
- عملیات عددی در JAX
- محاسبهٔ گرادیانها از طریق
jax.gradوjax.value_and_grad - سریع کردن توابع JAX با بهرهگیری از کامپایل در زمان اجرا
بیایید شروع کنیم.
تانسورها در JAX
Section titled “تانسورها در JAX”یکی از بهترین ویژگیهای JAX این است که سعی نمیکند API عددی مستقل و مشابه NumPy اما کمی واگرای خود را پیادهسازی کند. در عوض، فقط API NumPy را همانطور که هست پیادهسازی میکند. این API بهصورت فضای نام jax.numpy در دسترس است و اغلب برای اختصار با jnp وارد میشود.
در اینجا چند آرایهٔ JAX آورده شده است.
لیستینگ ۳.۲۸: تانسورهای همهیک یا همهصفر
>>> from jax import numpy as jnp>>> jnp.ones(shape=(2, 1))با این حال، دو تفاوت جزئی بین jax.numpy و API واقعی NumPy وجود دارد: تولید اعداد تصادفی و تخصیص آرایه. بیایید نگاهی بیندازیم.
تولید اعداد تصادفی در JAX
Section titled “تولید اعداد تصادفی در JAX”اولین تفاوت بین JAX و NumPy به روشی مربوط میشود که JAX عملیات تصادفی را مدیریت میکند — چیزی که بهعنوان عملیات “PRNG” (تولید اعداد شبهتصادفی) شناخته میشود. قبلاً گفتیم که JAX بیحالت است، که به این معناست که کد JAX نمیتواند به هیچ وضعیت سراسری پنهانی تکیه کند. کد NumPy زیر را در نظر بگیرید.
لیستینگ ۳.۲۹: تانسورهای تصادفی
>>> np.random.normal(size=(3,))چگونه دومین فراخوانی np.random.normal() میدانست که مقداری متفاوت از اولین فراخوانی برگرداند؟ درست است — یک قطعهٔ پنهان از وضعیت سراسری است. در واقع میتوانید آن وضعیت سراسری را از طریق np.random.get_state() بازیابی کنید و از طریق np.random.seed(seed) تنظیم کنید.
در یک چارچوب بیحالت، نمیتوانیم هیچ وضعیت سراسری داشته باشیم. همان فراخوانی API باید همیشه همان مقدار را برگرداند. در نتیجه، در یک نسخهٔ بیحالت از NumPy، باید برای به دست آوردن مقادیر متفاوت به پاس دادن آرگومانهای seed مختلف به فراخوانیهای np.random خود تکیه کنید.
حالا، اغلب اوقات فراخوانیهای PRNG شما در توابعی خواهند بود که چندین بار فراخوانی میشوند و قرار است هر بار از مقادیر تصادفی متفاوتی استفاده کنند. اگر نمیخواهید به هیچ وضعیت سراسری تکیه کنید، این نیازمند مدیریت وضعیت seed خود در خارج از تابع هدف است، مانند این:
def apply_noise(x, seed):    np.random.seed(seed)    x = x * np.random.normal((3,))    return x
seed = 1337y = apply_noise(x, seed)seed += 1z = apply_noise(x, seed)
اساساً در JAX هم همینطور است. با این حال، JAX از seedهای عدد صحیح استفاده نمیکند. این چارچوب از ساختارهای آرایهای ویژهای به نام کلیدها استفاده میکند. میتوانید یکی از یک مقدار عدد صحیح ایجاد کنید، مانند این:
import jax
seed_key = jax.random.key(1337)
برای وادار کردن شما به همیشه ارائهٔ یک “کلید” seed به فراخوانیهای PRNG، تمام عملیات استفادهکننده از PRNG در JAX key (seed تصادفی) را بهعنوان اولین آرگومان موقعیتی خود میگیرند. در اینجا نحوهٔ استفاده از random.normal() آمده است:
>>> seed_key = jax.random.key(0)>>> jax.random.normal(seed_key, shape=(3,))دو فراخوانی random.normal() که کلید seed یکسانی دریافت کنند همیشه مقدار یکسانی برمیگردانند.
لیستینگ ۳.۳۰: استفاده از seed تصادفی در Jax
>>> seed_key = jax.random.key(123)>>> jax.random.normal(seed_key, shape=(3,))اگر به یک کلید seed جدید نیاز دارید، میتوانید بهسادگی یکی از کلید موجود با استفاده از تابع jax.random.split() ایجاد کنید. این تابع قطعی است، بنابراین همان توالی splitها همیشه منجر به همان کلید seed نهایی میشود:
>>> seed_key = jax.random.key(123)>>> jax.random.normal(seed_key, shape=(3,))این قطعاً کار بیشتری از np.random است! اما مزایای بیحالتی بسیار بیشتر از هزینههای آن است: کد شما را برداریپذیر میکند (یعنی کامپایلر JAX میتواند بهطور خودکار آن را به کد بسیار موازی تبدیل کند) در حالی که قطعیت را حفظ میکند (یعنی میتوانید همان کد را دو بار با نتایج یکسان اجرا کنید). دستیابی به این با یک وضعیت PRNG سراسری غیرممکن است.
تخصیص تانسور
Section titled “تخصیص تانسور”دومین تفاوت بین JAX و NumPy تخصیص تانسور است. مانند TensorFlow، آرایههای JAX درجا قابل تخصیص نیستند. این به این دلیل است که هر نوع اصلاح درجا با طراحی بیحالت JAX در تضاد خواهد بود. در عوض، اگر نیاز به بهروزرسانی یک تانسور دارید، باید یک تانسور جدید با مقدار مورد نظر ایجاد کنید. JAX این کار را با ارائهٔ API at()/set() آسان میکند. این متدها به شما امکان میدهند یک تانسور جدید با یک عنصر بهروزرسانیشده در یک شاخص خاص ایجاد کنید. در اینجا مثالی از نحوهٔ بهروزرسانی اولین عنصر یک آرایهٔ JAX به یک مقدار جدید آورده شده است.
لیستینگ ۳.۳۱: اصلاح مقادیر در یک آرایهٔ JAX
>>> x = jnp.array([1, 2, 3], dtype="float32")>>> new_x = x.at[0].set(10)بهاندازهٔ کافی ساده!
عملیات تانسوری: انجام ریاضیات در JAX
Section titled “عملیات تانسوری: انجام ریاضیات در JAX”انجام ریاضیات در JAX دقیقاً مانند NumPy است. این بار نیازی به یادگیری چیز جدیدی نیست!
لیستینگ ۳.۳۲: چند عملیات ریاضی پایه در JAX
a = jnp.ones((2, 2))# Takes the squareb = jnp.square(a)# Takes the square rootc = jnp.sqrt(a)# Adds two tensors (element-wise)d = b + c# Takes the product of two tensors (see chapter 2)e = jnp.matmul(a, b)# Multiplies two tensors (element-wise)e *= dاین یک لایهٔ dense است:
def dense(inputs, W, b): return jax.nn.relu(jnp.matmul(inputs, W) + b)محاسبهٔ گرادیانها با JAX
Section titled “محاسبهٔ گرادیانها با JAX”برخلاف TensorFlow و PyTorch، JAX رویکردی فرابرنامهنویسی به محاسبهٔ گرادیان دارد. فرابرنامهنویسی به ایدهٔ داشتن توابعی که توابع را برمیگردانند اشاره دارد — میتوانید آنها را “فراتوابع” بنامید. در عمل، JAX به شما اجازه میدهد یک تابع محاسبهٔ زیان را به یک تابع محاسبهٔ گرادیان تبدیل کنید. بنابراین محاسبهٔ گرادیانها در JAX یک فرآیند سه مرحلهای است:
- یک تابع زیان تعریف کنید،
compute_loss(). grad_fn = jax.grad(compute_loss)را فراخوانی کنید تا یک تابع محاسبهٔ گرادیان به دست آورید.grad_fnرا فراخوانی کنید تا مقادیر گرادیان را بازیابی کنید.
تابع زیان باید ویژگیهای زیر را تأیید کند:
- باید یک مقدار زیان اسکالر برگرداند.
- اولین آرگومان آن (که در مثال زیر نیز تنها آرگومان آن است) باید شامل آرایههای وضعیتی باشد که به گرادیانهایشان نیاز داریم. این آرگومان معمولاً
stateنامیده میشود. برای مثال، این اولین آرگومان میتواند یک آرایهٔ واحد، لیستی از آرایهها یا دیکشنری از آرایهها باشد.
بیایید به یک مثال ساده نگاه کنیم. در اینجا یک تابع محاسبهٔ زیان آورده شده است که یک اسکالر واحد input_var میگیرد و یک مقدار زیان اسکالر برمیگرداند — فقط مجذور ورودی:
def compute_loss(input_var): return jnp.square(input_var)اکنون میتوانیم ابزار JAX یعنی jax.grad() را روی این تابع زیان فراخوانی کنیم. این ابزار یک تابع محاسبهٔ گرادیان برمیگرداند — تابعی که همان آرگومانهای تابع زیان اصلی را میگیرد و گرادیان زیان نسبت به input_var را برمیگرداند:
grad_fn = jax.grad(compute_loss)وقتی grad_fn() را به دست آوردید، میتوانید آن را با همان آرگومانهای compute_loss() فراخوانی کنید و آرایههای گرادیان متناظر با اولین آرگومان compute_loss() را برمیگرداند. در مورد ما، اولین آرگومان یک آرایهٔ واحد بود، بنابراین grad_fn() مستقیماً گرادیان زیان نسبت به آن یک آرایه را برمیگرداند:
input_var = jnp.array(3.0)grad_of_loss_wrt_input_var = grad_fn(input_var)بهترین روشهای محاسبهٔ گرادیان در JAX
Section titled “بهترین روشهای محاسبهٔ گرادیان در JAX”تا اینجا خوب پیش رفتیم! فرابرنامهنویسی کلمهٔ بزرگی است، اما معلوم میشود که کاملاً ساده است. حالا، در موارد استفادهٔ واقعی، چند چیز دیگر وجود دارد که باید در نظر بگیرید. بیایید نگاهی بیندازیم.
برگرداندن مقدار زیان
Section titled “برگرداندن مقدار زیان”معمولاً اینطور است که نه فقط به آرایهٔ گرادیان نیاز دارید، بلکه به مقدار زیان نیز نیاز دارید. محاسبهٔ مجدد آن بهطور مستقل در خارج از grad_fn() نسبتاً ناکارآمد خواهد بود، بنابراین در عوض میتوانید grad_fn() خود را طوری پیکربندی کنید که مقدار زیان را نیز برگرداند. این کار با استفاده از ابزار JAX یعنی jax.value_and_grad() بهجای jax.grad() انجام میشود. این ابزار یکسان کار میکند، اما یک تاپل از مقادیر برمیگرداند که اولین ورودی آن مقدار زیان و دومین ورودی گرادیان(ها) است:
grad_fn = jax.value_and_grad(compute_loss)output, grad_of_loss_wrt_input_var = grad_fn(input_var)گرفتن گرادیانها برای یک تابع پیچیده
Section titled “گرفتن گرادیانها برای یک تابع پیچیده”حالا، اگر به گرادیان برای بیش از یک متغیر نیاز داشته باشید چه؟ و اگر تابع compute_loss() شما بیش از یک ورودی داشته باشد چه؟
فرض کنید وضعیت شما شامل سه متغیر a، b و c است و تابع زیان شما دو ورودی x و y دارد. بهسادگی آن را اینگونه ساختار میدهید:
# state contains a, b, and c. It must be the first argument.def compute_loss(state, x, y):    ...    return loss
grad_fn = jax.value_and_grad(compute_loss)state = (a, b, c)# grads_of_loss_wrt_state has the same structure as state.loss, grads_of_loss_wrt_state = grad_fn(state, x, y)
توجه داشته باشید که state لازم نیست یک تاپل باشد — میتواند یک دیکشنری، لیست یا هر ساختار تودرتویی از تاپلها، دیکشنریها و لیستها باشد. در اصطلاح JAX، چنین ساختار تودرتویی درخت نامیده میشود.
برگرداندن خروجیهای کمکی
Section titled “برگرداندن خروجیهای کمکی”در نهایت، اگر تابع compute_loss() شما نیاز به برگرداندن بیش از فقط زیان داشته باشد چه؟ فرض کنید میخواهید یک مقدار اضافی output را که بهعنوان محصول جانبی محاسبهٔ زیان محاسبه میشود برگردانید. چگونه آن را خارج کنید؟
از آرگومان has_aux استفاده میکنید:
- تابع زیان را ویرایش کنید تا یک تاپل برگرداند که اولین ورودی آن زیان و دومین ورودی خروجی اضافی شماست.
- آرگومان
has_aux=Trueرا بهvalue_and_grad()پاس دهید. این بهvalue_and_grad()میگوید که نهتنها گرادیان بلکه خروجی(های) “کمکی”compute_loss()را نیز برگرداند، مانند این:
def compute_loss(state, x, y):    ...    # Returns a tuple    return loss, output
# Passes has_aux=True heregrad_fn = jax.value_and_grad(compute_loss, has_aux=True)# Gets back a nested tupleloss, (grads_of_loss_wrt_state, output) = grad_fn(state, x, y)
مسلماً، در این مرحله چیزها شروع به نسبتاً پیچیده شدن میکنند. نگران نباشید، این تقریباً بهسختی JAX است! تقریباً هر چیز دیگری در مقایسه سادهتر است.
سریع کردن توابع JAX با @jax.jit
Section titled “سریع کردن توابع JAX با @jax.jit”یک چیز دیگر. بهعنوان یک کاربر JAX، اغلب از دکوراتور @jax.jit استفاده خواهید کرد که دقیقاً مانند دکوراتور @tf.function(jit_compile=True) عمل میکند. این دکوراتور هر تابع JAX بیحالت را به یک قطعه کد کامپایلشده با XLA تبدیل میکند و معمولاً سرعت اجرای قابلتوجهی به ارمغان میآورد:
@jax.jitdef dense(inputs, W, b): return jax.nn.relu(jnp.matmul(inputs, W) + b)توجه داشته باشید که فقط میتوانید یک تابع بیحالت را تزئین کنید — هر تانسوری که توسط تابع بهروزرسانی میشود باید بخشی از مقادیر بازگشتی آن باشد.
یک مثال سرتاسری: یک طبقهبند خطی در JAX خالص
Section titled “یک مثال سرتاسری: یک طبقهبند خطی در JAX خالص”اکنون بهاندازهٔ کافی JAX میدانید که نسخهٔ JAX طبقهبند خطی خود را بنویسید. دو تفاوت عمده با نسخههای TensorFlow و PyTorch که قبلاً دیدهاید وجود دارد:
- تمام توابعی که ایجاد خواهیم کرد بیحالت خواهند بود. این بدان معناست که وضعیت (آرایههای
Wوb) بهعنوان آرگومانهای تابع ارائه میشود، و اگر توسط تابع اصلاح شوند، مقدار جدیدشان توسط تابع برگردانده میشود. - گرادیانها با استفاده از ابزار JAX
value_and_grad()محاسبه میشوند.
بیایید شروع کنیم. تابع مدل و تابع میانگین مربعات خطا باید آشنا به نظر برسند:
def model(inputs, W, b):    return jnp.matmul(inputs, W) + b
def mean_squared_error(targets, predictions):    per_sample_losses = jnp.square(targets - predictions)    return jnp.mean(per_sample_losses)
برای محاسبهٔ گرادیانها، باید محاسبهٔ زیان را در یک تابع واحد compute_loss() بستهبندی کنیم. این تابع کل زیان را بهصورت یک اسکالر برمیگرداند، و state را بهعنوان اولین آرگومان خود میگیرد — تاپلی از تمام تانسورهایی که به گرادیانهایشان نیاز داریم:
def compute_loss(state, inputs, targets): W, b = state predictions = model(inputs, W, b) loss = mean_squared_error(targets, predictions) return lossفراخوانی jax.value_and_grad() روی این تابع یک تابع جدید به ما میدهد، با همان آرگومان compute_loss، که هم زیان و هم گرادیانهای زیان نسبت به عناصر state را برمیگرداند:
grad_fn = jax.value_and_grad(compute_loss)سپس، میتوانیم تابع گام آموزش خود را تنظیم کنیم. ساده به نظر میرسد. توجه داشته باشید که برخلاف معادلهای TensorFlow و PyTorch، باید بیحالت باشد، و بنابراین باید مقادیر بهروزرسانیشدهٔ تانسورهای W و b را برگرداند:
learning_rate = 0.1
# We use the jax.jit decorator to take advantage of XLA compilation.@jax.jitdef training_step(inputs, targets, W, b):    # Computes the forward pass and backward pass in one go    loss, grads = grad_fn((W, b), inputs, targets)    grad_wrt_W, grad_wrt_b = grads    # Updates W and b    W = W - grad_wrt_W * learning_rate    b = b - grad_wrt_b * learning_rate    # Make sure to return the new values of W and b in addition to the    # loss!    return loss, W, b
از آنجا که learning_rate را در طول مثال تغییر نخواهیم داد، میتوانیم آن را بخشی از خود تابع در نظر بگیریم نه وضعیت مدل. اگر میخواستیم نرخ یادگیری را در طول آموزش تغییر دهیم، باید آن را نیز پاس میدادیم.
در نهایت، آمادهٔ اجرای حلقهٔ آموزش کامل هستیم. W و b را مقداردهی اولیه میکنیم و مکرراً آنها را از طریق فراخوانیهای بیحالت training_step() بهروزرسانی میکنیم:
input_dim = 2output_dim = 1
W = jax.numpy.array(np.random.uniform(size=(input_dim, output_dim)))b = jax.numpy.array(np.zeros(shape=(output_dim,)))state = (W, b)for step in range(40):    loss, W, b = training_step(inputs, targets, W, b)    print(f"Loss at step {step}: {loss:.4f}")
تمام شد! اکنون میتوانید یک حلقهٔ آموزش سفارشی در JAX بنویسید.
چه چیزی رویکرد JAX را منحصر به فرد میکند
Section titled “چه چیزی رویکرد JAX را منحصر به فرد میکند”چیز اصلی که JAX را در میان چارچوبهای یادگیری ماشین مدرن منحصر به فرد میکند، فلسفهٔ کارکردی و بیحالت آن است. اگرچه ممکن است در ابتدا باعث اصطکاک به نظر برسد، اما همان چیزی است که قدرت JAX را باز میکند — توانایی آن در کامپایل به کد بسیار سریع و مقیاسپذیری به مدلهای دلخواه بزرگ و دستگاههای دلخواه زیاد.
چیزهای زیادی برای دوست داشتن در JAX وجود دارد:
- سریع است. برای بیشتر مدلها، سریعترین در میان تمام چارچوبهایی است که تاکنون دیدهاید.
- API عددی آن کاملاً با NumPy سازگار است و یادگیری آن را pleasant میکند.
- بهترین گزینه برای آموزش مدلها روی TPUهاست، زیرا از ابتدا برای XLA و TPUها توسعه یافته است.
استفاده از JAX همچنین میتواند مقداری اصطکاک برای توسعهدهنده به همراه داشته باشد:
- استفاده از فرابرنامهنویسی و کامپایل میتواند اشکالزدایی را در مقایسه با اجرای مشتاقانهٔ خالص بهطور قابلتوجهی دشوارتر کند.
- حلقههای آموزش سطح پایین تمایل دارند پرحجمتر و دشوارتر از TensorFlow یا PyTorch نوشته شوند.
در این مرحله، مبانی TensorFlow، PyTorch و JAX را میدانید و میتوانید از این چارچوبها برای پیادهسازی یک طبقهبند خطی پایه از صفر استفاده کنید. این یک پایهٔ محکم برای ساختن است. اکنون زمان آن است که به یک مسیر مولدتر برای یادگیری عمیق بروید: API Keras.
معرفی Keras
Section titled “معرفی Keras”Keras یک API یادگیری عمیق برای پایتون است که روشی راحت برای تعریف و آموزش هر نوع مدل یادگیری عمیق فراهم میکند. در مارس ۲۰۱۵ با نسخهٔ ۲ در سال ۲۰۱۷ و نسخهٔ ۳ در سال ۲۰۲۳ عرضه شد.
کاربران Keras از محققان دانشگاهی، مهندسان و دانشمندان داده در استارتاپها و شرکتهای بزرگ گرفته تا دانشجویان تحصیلات تکمیلی و علاقهمندان را شامل میشوند. Keras در گوگل، Netflix، Uber، YouTube، CERN، NASA، Yelp، Instacart، Square، Waymo، YouTube و هزاران سازمان کوچکتر که روی طیف گستردهای از مسائل در هر صنعتی کار میکنند استفاده میشود. توصیههای YouTube شما از مدلهای Keras سرچشمه میگیرند. خودروهای خودران Waymo برای پردازش دادههای حسگر به مدلهای Keras متکی هستند. Keras همچنین یک چارچوب محبوب در Kaggle، وبسایت مسابقات یادگیری ماشین است.
از آنجا که Keras پایگاه کاربری متنوعی دارد، شما را مجبور نمیکند که یک روش «واقعی» واحد برای ساخت و آموزش مدلها را دنبال کنید. در عوض، طیف گستردهای از گردشکارهای مختلف را ممکن میسازد، از بسیار سطح بالا تا بسیار سطح پایین، متناظر با پروفایلهای کاربری مختلف. برای مثال، شما آرایهای از روشها برای ساخت مدلها و آرایهای از روشها برای آموزش آنها دارید، که هر کدام نشاندهندهٔ مصالحهای بین کاربردپذیری و انعطافپذیری هستند. در فصل ۷، بخش قابلتوجهی از این طیف گردشکارها را با جزئیات مرور خواهیم کرد.
گامهای اول با Keras
Section titled “گامهای اول با Keras”قبل از نوشتن کد Keras، هنگام راهاندازی کتابخانه قبل از وارد کردن آن، چند چیز باید در نظر گرفته شود.
انتخاب یک چارچوب بکاند
Section titled “انتخاب یک چارچوب بکاند”Keras میتواند همراه با JAX، TensorFlow یا PyTorch استفاده شود. آنها «چارچوبهای بکاند» Keras هستند. از طریق این چارچوبهای بکاند، Keras میتواند روی انواع مختلف سختافزار اجرا شود (شکل ۳.۴ را ببینید) — GPU، TPU یا CPU ساده — بهطور یکپارچه به هزاران ماشین مقیاسپذیر شود و در انواع پلتفرمها مستقر شود.
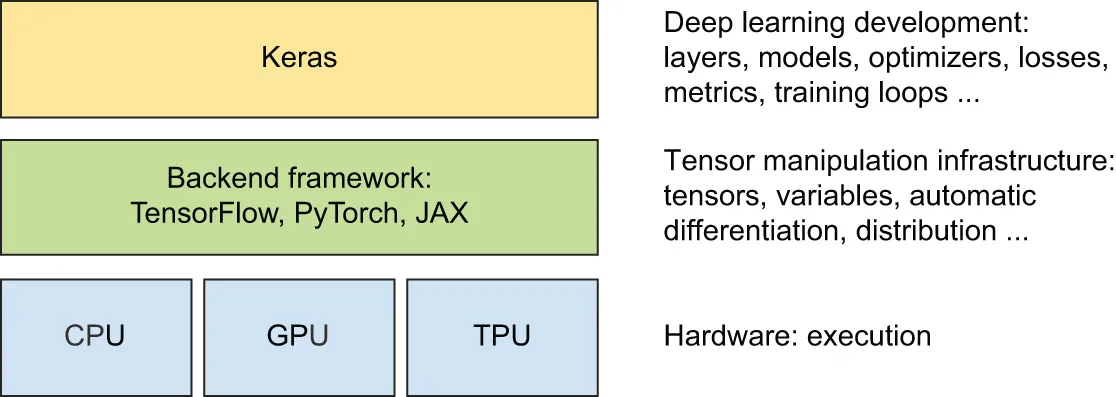
شکل ۳.۴: Keras و بکاندهایش. بکاند یک پلتفرم محاسبات تانسوری سطح پایین است؛ Keras یک API سطح بالای یادگیری عمیق است.
چارچوبهای بکاند قابل اتصال هستند: میتوانید پس از نوشتن کد Keras به یک چارچوب بکاند دیگر سوئیچ کنید. شما به یک چارچوب و یک اکوسیستم واحد قفل نمیشوید — میتوانید مدلهای خود را بسته به نیازهای فعلی از JAX به TensorFlow به PyTorch منتقل کنید. برای مثال، وقتی یک مدل Keras را توسعه میدهید، میتوانید آن را با PyTorch اشکالزدایی کنید، با JAX روی TPU برای حداکثر کارایی آموزش دهید و در نهایت با ابزار عالی از اکوسیستم TensorFlow استنتاج را اجرا کنید.
بکاند پیشفرض Keras در حال حاضر TensorFlow است، بنابراین اگر در یک محیط تازه و بدون هیچ پیکربندی import keras را اجرا کنید، روی TensorFlow اجرا خواهید شد. دو راه برای انتخاب بکاند متفاوت وجود دارد:
- متغیر محیطی
KERAS_BACKENDرا تنظیم کنید. قبل از شروع REPL پایتون، میتوانید دستور شل زیر را برای استفاده از JAX بهعنوان بکاند Keras اجرا کنید:export KERAS_BACKEND=jax. از طرف دیگر، میتوانید قطعهکد زیر را در بالای فایل پایتون یا نوتبوک خود اضافه کنید (توجه داشته باشید که باید حتماً قبل از اولینimport kerasباشد):
import os
# Sets the environment variable from within the Python runtimeos.environ["KERAS_BACKEND"] = "jax"
# Only then should you import Keras.import keras- فایل پیکربندی محلی Keras خود را در
~/.keras/keras.jsonویرایش کنید. اگر قبلاً یک بار Keras را وارد کرده باشید، این فایل با تنظیمات پیشفرض ایجاد شده است. میتوانید از هر ویرایشگر متنی برای باز کردن و اصلاح آن استفاده کنید — این یک فایل JSON قابلخواندن برای انسان است. باید چیزی شبیه به این باشد:
{ # Default floating-point precision. It should typically not be # changed. "floatx": "float32", # Default numerical fuzzing factor. It should typically not be # changed. "epsilon": 1e-07, # Change "tensorflow" to "jax" or "torch." "backend": "tensorflow", # This is the default image layout. We'll talk about this in # chapter 8. "image_data_format": "channels_last",}حالا، ممکن است بپرسید کدام بکاند را باید انتخاب کنم؟ واقعاً انتخاب خودتان است: تمام مثالهای کد Keras در ادامهٔ این کتاب با هر سه بکاند سازگار خواهند بود. اگر نیاز به کد مخصوص بکاند ایجاد شد (مثلاً در فصل ۷)، هر سه نسخه — TensorFlow، PyTorch، JAX — را به شما نشان خواهم داد. اگر ترجیح خاصی برای بکاند ندارید، توصیهٔ شخصی من JAX است. معمولاً با عملکردترین بکاند است.
وقتی بکاند شما پیکربندی شد، میتوانید شروع به ساختن و آموزش مدلهای Keras کنید. بیایید نگاهی بیندازیم.
لایهها: بلوکهای سازندهٔ یادگیری عمیق
Section titled “لایهها: بلوکهای سازندهٔ یادگیری عمیق”ساختار دادهٔ بنیادین در شبکههای عصبی لایه است که در فصل ۲ با آن آشنا شدید. یک لایه یک ماژول پردازش داده است که بهعنوان ورودی یک یا چند تانسور میگیرد و یک یا چند تانسور خروجی میدهد. برخی لایهها بیحالت هستند، اما بیشتر اوقات لایهها یک حالت دارند: وزنهای لایه، یک یا چند تانسور که با نزول گرادیان تصادفی یاد گرفته میشوند و با هم دانش شبکه را تشکیل میدهند.
انواع مختلف لایهها برای قالبهای تانسوری مختلف و انواع مختلف پردازش داده مناسب هستند. برای مثال، دادههای برداری ساده که در تانسورهای دوبعدی با شکل (samples, features) ذخیره میشوند، اغلب توسط لایههای متراکم که به آنها کاملاً متصل یا dense نیز گفته میشود پردازش میشوند (کلاس Dense در Keras). دادههای دنبالهای که در تانسورهای سهبعدی با شکل (samples, timesteps, features) ذخیره میشوند، معمولاً توسط لایههای بازگشتی مانند LSTM یا لایههای کانولوشن 1D (Conv1D) پردازش میشوند. دادههای تصویری که در تانسورهای مرتبهٔ ۴ ذخیره میشوند، معمولاً توسط لایههای کانولوشن 2D (Conv2D) پردازش میشوند.
میتوانید لایهها را بهعنوان آجرهای لگو یادگیری عمیق در نظر بگیرید، استعارهای که توسط Keras صریح شده است. ساختن مدلهای یادگیری عمیق در Keras با اتصال لایههای سازگار به یکدیگر برای تشکیل خطوط لولهٔ تبدیل دادهٔ مفید انجام میشود.
کلاس پایهٔ Layer در Keras
Section titled “کلاس پایهٔ Layer در Keras”یک API ساده باید یک انتزاع واحد داشته باشد که همهچیز حول آن میچرخد. در Keras، آن Layer است. همهچیز در Keras یا یک Layer است یا چیزی که نزدیک با Layer تعامل دارد.
یک Layer شیئی است که مقداری وضعیت (وزنها) و مقداری محاسبه (یک گذر رو به جلو) را کپسوله میکند. وزنها معمولاً در build() تعریف میشوند (اگرچه میتوانند در سازنده __init__() نیز ایجاد شوند)، و محاسبه در متد call() تعریف میشود.
در فصل قبل، ما یک کلاس NaiveDense پیادهسازی کردیم که شامل دو وزن W و b بود و محاسبهٔ output = activation(matmul(input, W) + b) را اعمال میکرد. در زیر همان لایه در Keras چگونه خواهد بود.
لیستینگ ۳.۳۳: یک لایهٔ dense ساده از صفر در Keras
import keras
# All Keras layers inherit from the base Layer class.class SimpleDense(keras.Layer):    def __init__(self, units, activation=None):        super().__init__()        self.units = units        self.activation = activation
    # Weight creation takes place in the build() method.    def build(self, input_shape):        batch_dim, input_dim = input_shape        # add_weight is a shortcut method for creating weights. It's        # also possible to create standalone variables and assign them        # as layer attributes, like self.W = keras.Variable(shape=...,        # initializer=...).        self.W = self.add_weight(            shape=(input_dim, self.units), initializer="random_normal"        )        self.b = self.add_weight(shape=(self.units,), initializer="zeros")
    # We define the forward pass computation in the call() method.    def call(self, inputs):        y = keras.ops.matmul(inputs, self.W) + self.b        if self.activation is not None:            y = self.activation(y)        return y
در بخش بعدی، هدف این متدهای build() و call() را با جزئیات پوشش خواهیم داد. نگران نباشید اگر هنوز همهچیز را درک نمیکنید!
پس از نمونهسازی، لایهای مانند این میتواند دقیقاً مانند یک تابع استفاده شود و بهعنوان ورودی یک تانسور بگیرد:
>>> # Instantiates our layer, defined previously>>> my_dense = SimpleDense(units=32, activation=keras.ops.relu)>>> # Creates some test inputs>>> input_tensor = keras.ops.ones(shape=(2, 784))>>> # Calls the layer on the inputs, just like a function>>> output_tensor = my_dense(input_tensor)>>> print(output_tensor.shape)حالا، احتمالاً تعجب میکنید که چرا مجبور شدیم call() و build() را پیادهسازی کنیم، در حالی که در نهایت لایهٔ خود را با فراخوانی سادهٔ آن، یعنی با استفاده از متد __call__ آن، استفاده کردیم. به این دلیل است که میخواهیم بتوانیم وضعیت را دقیقاً در زمان مناسب ایجاد کنیم. بیایید ببینیم این چگونه کار میکند.
استنتاج خودکار شکل: ساختن لایهها در پرواز
Section titled “استنتاج خودکار شکل: ساختن لایهها در پرواز”درست مانند آجرهای لگو، شما فقط میتوانید لایههایی را به هم «کلیپ» کنید که سازگار باشند. مفهوم سازگاری لایه در اینجا بهطور خاص به این واقعیت اشاره دارد که هر لایه فقط تانسورهای ورودی با یک شکل خاص را میپذیرد و تانسورهای خروجی با یک شکل خاص را برمیگرداند. مثال زیر را در نظر بگیرید:
from keras import layers
# A dense layer with 32 output unitslayer = layers.Dense(32, activation="relu")
این لایه تانسوری را برمیگرداند که بُعد غیردستهای آن ۳۲ است. فقط میتواند به یک لایهٔ پاییندستی متصل شود که انتظار بردارهای ۳۲ بُعدی را بهعنوان ورودی خود دارد.
هنگام استفاده از Keras، در بیشتر اوقات نیازی به نگرانی در مورد سازگاری اندازه ندارید زیرا لایههایی که به مدلهای خود اضافه میکنید بهطور پویا برای مطابقت با شکل ورودیهای دریافتی ساخته میشوند. برای مثال، فرض کنید موارد زیر را بنویسید:
from keras import modelsfrom keras import layers
model = models.Sequential( [ layers.Dense(32, activation="relu"), layers.Dense(32), ])لایهها هیچ اطلاعاتی دربارهٔ شکل ورودیهایشان دریافت نکردند. در عوض، آنها بهطور خودکار شکل ورودی خود را بهعنوان شکل اولین ورودیهایی که میبینند استنتاج کردند.
در نسخهٔ اسباببازی لایهٔ Dense که در فصل ۲ پیادهسازی کردیم، مجبور بودیم اندازهٔ ورودی لایه را بهصراحت به سازنده پاس دهیم تا بتوانیم وزنهایش را ایجاد کنیم. این ایدهآل نیست، زیرا منجر به مدلهایی میشود که شبیه این هستند، که در آن هر لایهٔ جدید باید از شکل لایهٔ قبلی آگاه شود:
model = NaiveSequential( [ NaiveDense(input_size=784, output_size=32, activation="relu"), NaiveDense(input_size=32, output_size=64, activation="relu"), NaiveDense(input_size=64, output_size=32, activation="relu"), NaiveDense(input_size=32, output_size=10, activation="softmax"), ])حتی بدتر میشد وقتی قواعد استفادهشده توسط یک لایه برای تولید شکل خروجیاش پیچیده باشد. برای مثال، اگر لایهٔ ما خروجیهایی با شکل (batch, input_size * 2 if input_size % 2 == 0 else input_size * 3) برمیگرداند چه؟
اگر بخواهیم NaiveDense خود را بهعنوان یک لایهٔ Keras قادر به استنتاج خودکار شکل دوباره پیادهسازی کنیم، شبیه لایهٔ SimpleDense با متدهای build() و call() آن خواهد بود.
در SimpleDense Keras، ما دیگر وزنها را در سازنده مانند مثال قبلی ایجاد نمیکنیم. در عوض، آنها را در یک متد اختصاصی ایجاد وضعیت build() ایجاد میکنیم، که بهعنوان آرگومان اولین شکل ورودی دیدهشده توسط لایه را دریافت میکند. متد build() بهطور خودکار اولین بار که لایه فراخوانی میشود (از طریق متد __call__() آن) فراخوانی میشود. در واقع، به همین دلیل است که ما محاسبه را در یک متد جداگانه call() تعریف کردیم نه مستقیماً در متد __call__()! متد __call__() لایهٔ پایه بهطور شماتیک شبیه این است:
def __call__(self, inputs): if not self.built: self.build(inputs.shape) self.built = True return self.call(inputs)با استنتاج خودکار شکل، مثال قبلی ما ساده و تمیز میشود:
model = keras.Sequential( [ SimpleDense(32, activation="relu"), SimpleDense(64, activation="relu"), SimpleDense(32, activation="relu"), SimpleDense(10, activation="softmax"), ])توجه داشته باشید که استنتاج خودکار شکل تنها چیزی نیست که متد __call__() کلاس Layer مدیریت میکند. این متد مراقب بسیاری چیزهای دیگر است، بهویژه مسیریابی بین اجرای مشتاقانه و گراف، و ماسکگذاری ورودی (که در فصل ۱۴ پوشش میدهیم). برای حالا، فقط به یاد داشته باشید: هنگام پیادهسازی لایههای خودتان، گذر رو به جلو را در متد call() قرار دهید.
از لایهها به مدلها
Section titled “از لایهها به مدلها”یک مدل یادگیری عمیق یک گراف از لایههاست. در Keras، آن کلاس Model است. تا کنون، فقط مدلهای Sequential را دیدهاید (زیرکلاسی از Model)، که پشتههای سادهای از لایهها هستند و یک ورودی واحد را به یک خروجی واحد نگاشت میکنند. اما با پیشرفت، با تنوع بسیار گستردهتری از توپولوژیهای شبکه روبرو خواهید شد. برخی از رایجترین آنها عبارتند از
- شبکههای دوشاخه
- شبکههای چندسره
- اتصالات باقیمانده
توپولوژی شبکه میتواند کاملاً پیچیده شود. برای مثال، شکل ۳.۵ توپولوژی گراف لایههای یک Transformer را نشان میدهد، یک معماری رایج که برای پردازش دادههای متنی طراحی شده است.
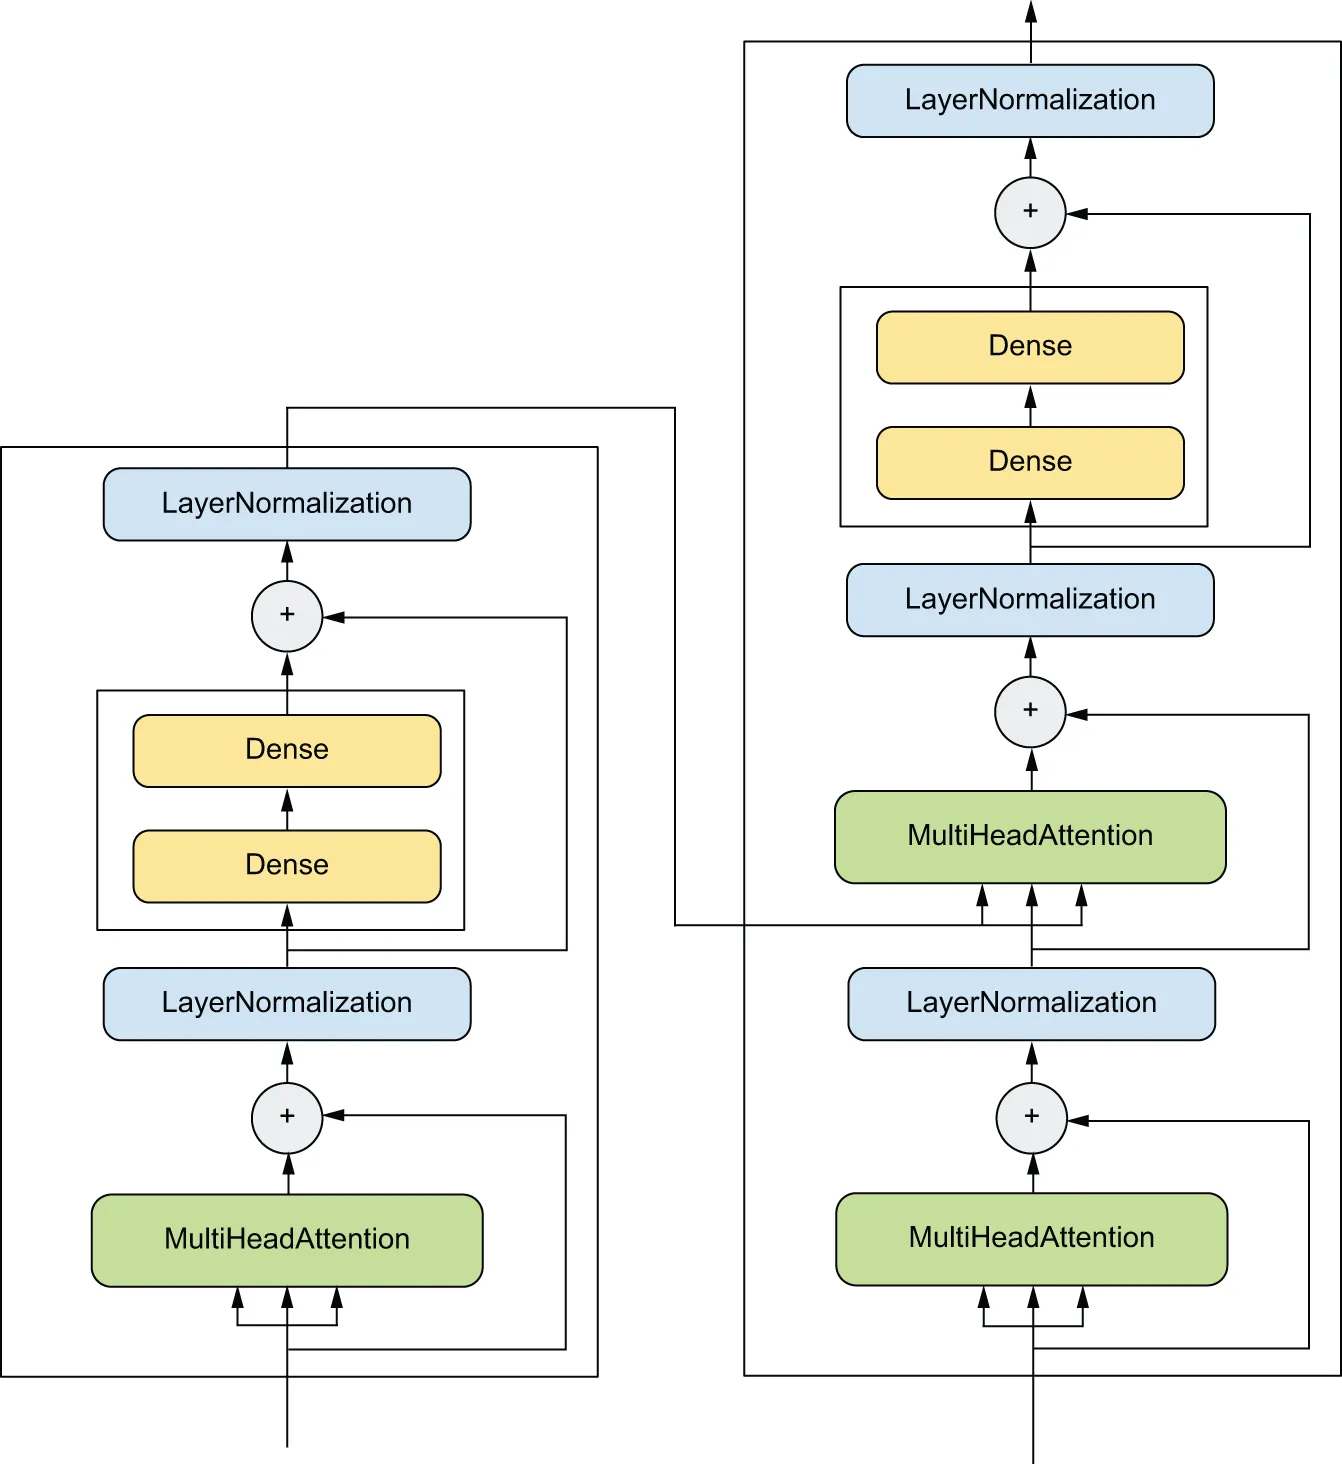
شکل ۳.۵: معماری Transformer. چیزهای زیادی در اینجا در جریان است. در طول چند فصل آینده، بهسمت درک آن بالا میروید (در فصل ۱۵).
بهطور کلی دو راه برای ساختن چنین مدلهایی در Keras وجود دارد: میتوانید مستقیماً زیرکلاس Model را ایجاد کنید، یا میتوانید از Functional API استفاده کنید، که به شما اجازه میدهد با کد کمتر کارهای بیشتری انجام دهید. هر دو رویکرد را در فصل ۷ پوشش خواهیم داد.
توپولوژی یک مدل یک فضای فرضیه را تعریف میکند. ممکن است به یاد داشته باشید که در فصل ۱، یادگیری ماشین را بهعنوان «جستجوی بازنماییهای مفید از برخی دادههای ورودی، در یک فضای احتمالات از پیش تعریفشده، با هدایت یک سیگنال بازخورد» توصیف کردیم. با انتخاب یک توپولوژی شبکه، فضای احتمالات (فضای فرضیه) خود را به یک سری خاص از عملیات تانسوری محدود میکنید که دادههای ورودی را به دادههای خروجی نگاشت میکنند. آنچه سپس به دنبال آن خواهید بود مجموعهٔ خوبی از مقادیر برای تانسورهای وزنی دخیل در این عملیات تانسوری است.
برای یادگیری از داده، باید دربارهٔ آن فرضیاتی بسازید. این فرضیات تعریف میکنند که چه چیزی میتواند یاد گرفته شود. به این ترتیب، ساختار فضای فرضیهٔ شما — معماری مدل شما — بسیار مهم است. این ساختار فرضیاتی را که دربارهٔ مسئلهٔ خود میسازید کدگذاری میکند، دانش پیشینی که مدل با آن شروع میکند. برای مثال، اگر روی یک مسئلهٔ طبقهبندی دوکلاسه با مدلی متشکل از یک لایهٔ Dense بدون فعالسازی (یک تبدیل آفین خالص) کار میکنید، فرض میکنید که دو کلاس شما جداپذیر خطی هستند.
انتخاب معماری شبکهٔ درست بیشتر هنر است تا علم، و اگرچه برخی بهترین روشها و اصول وجود دارند که میتوانید بر آنها تکیه کنید، فقط تمرین میتواند به شما کمک کند یک معمار شبکهٔ عصبی مناسب شوید. فصلهای بعدی هم اصول صریح برای ساختن شبکههای عصبی را به شما آموزش میدهند و هم به شما کمک میکنند شهود پیدا کنید که چه چیزی برای مسائل خاص کار میکند یا نمیکند. شما یک شهود محکم دربارهٔ اینکه چه نوع معماریهای مدل برای انواع مختلف مسائل کار میکنند، چگونه این شبکهها را در عمل بسازید، چگونه پیکربندی یادگیری درست را انتخاب کنید و چگونه یک مدل را تا رسیدن به نتایج مورد نظر تنظیم کنید، خواهید ساخت.
مرحلهٔ “کامپایل”: پیکربندی فرآیند یادگیری
Section titled “مرحلهٔ “کامپایل”: پیکربندی فرآیند یادگیری”وقتی معماری مدل تعریف شد، هنوز باید سه چیز دیگر را انتخاب کنید:
- تابع زیان (تابع هدف) — کمیتی که در طول آموزش کمینه میشود. این معیاری از موفقیت برای وظیفهٔ پیشرو است.
- بهینهساز — تعیین میکند که شبکه چگونه بر اساس تابع زیان بهروزرسانی میشود. این یک نوع خاص از نزول گرادیان تصادفی (SGD) را پیادهسازی میکند.
- معیارها — معیارهای موفقیتی که میخواهید در طول آموزش و اعتبارسنجی نظارت کنید، مانند دقت طبقهبندی. برخلاف زیان، آموزش مستقیماً برای این معیارها بهینهسازی نمیکند. بنابراین، معیارها نیازی به مشتقپذیری ندارند.
وقتی زیان، بهینهساز و معیارهای خود را انتخاب کردید، میتوانید از متدهای داخلی compile() و fit() برای شروع آموزش مدل خود استفاده کنید. از طرف دیگر، میتوانید حلقههای آموزش سفارشی خود را بنویسید — نحوهٔ انجام این کار را در فصل ۷ پوشش میدهیم. کار بسیار بیشتری است! برای حالا، بیایید نگاهی به compile() و fit() بیندازیم.
متد compile() فرآیند آموزش را پیکربندی میکند — قبلاً در اولین مثال شبکهٔ عصبی خود در فصل ۲ با آن آشنا شدید. آرگومانهای optimizer، loss و metrics (یک لیست) را میگیرد:
# Defines a linear classifiermodel = keras.Sequential([keras.layers.Dense(1)])model.compile( # Specifies the optimizer by name: RMSprop (it's case-insensitive) optimizer="rmsprop", # Specifies the loss by name: mean squared error loss="mean_squared_error", # Specifies a list of metrics: in this case, only accuracy metrics=["accuracy"],)در فراخوانی قبلی compile()، ما بهینهساز، زیان و معیارها را بهصورت رشتههایی (مانند "rmsprop") پاس دادیم. این رشتهها در واقع میانبرهایی هستند که به اشیاء پایتون تبدیل میشوند. برای مثال، "rmsprop" به keras.optimizers.RMSprop() تبدیل میشود. مهم است که بتوان این آرگومانها را بهصورت نمونههای شیء نیز مشخص کرد، مانند این:
model.compile( optimizer=keras.optimizers.RMSprop(), loss=keras.losses.MeanSquaredError(), metrics=[keras.metrics.BinaryAccuracy()],)این زمانی مفید است که بخواهید زیانها یا معیارهای سفارشی خود را پاس دهید یا بخواهید اشیاء مورد استفادهٔ خود را بیشتر پیکربندی کنید — برای مثال، با پاس دادن آرگومان learning_rate به بهینهساز:
model.compile( optimizer=keras.optimizers.RMSprop(learning_rate=1e-4), loss=my_custom_loss, metrics=[my_custom_metric_1, my_custom_metric_2],)در فصل ۷، نحوهٔ ایجاد زیانها و معیارهای سفارشی را پوشش میدهیم. بهطور کلی، لازم نیست زیانها، معیارها یا بهینهسازهای خود را از صفر ایجاد کنید زیرا Keras طیف گستردهای از گزینههای داخلی را ارائه میدهد که احتمالاً شامل آنچه نیاز دارید میشود:
- بهینهسازها
SGD()(با یا بدون مومنتوم)RMSprop()Adam()- و غیره.
- زیانها
CategoricalCrossentropy()SparseCategoricalCrossentropy()BinaryCrossentropy()MeanSquaredError()KLDivergence()CosineSimilarity()- و غیره.
- معیارها
CategoricalAccuracy()SparseCategoricalAccuracy()BinaryAccuracy()AUC()Precision()Recall()- و غیره.
در سراسر این کتاب، کاربردهای عینی بسیاری از این گزینهها را خواهید دید.
انتخاب یک تابع زیان
Section titled “انتخاب یک تابع زیان”انتخاب تابع زیان درست برای مسئلهٔ درست بسیار مهم است: شبکهٔ شما از هر میانبری که بتواند برای کمینه کردن زیان استفاده میکند. بنابراین اگر هدف بهطور کامل با موفقیت برای وظیفهٔ پیشرو همبستگی نداشته باشد، شبکهٔ شما در نهایت کارهایی انجام میدهد که ممکن است نخواهید. یک هوش مصنوعی احمق و قادر مطلق را تصور کنید که با SGD آموزش دیده و این تابع هدف ضعیف انتخابشده را دارد: «میانگین رفاه همهٔ انسانهای زنده را بیشینه کن.» برای آسانتر کردن کار خود، این هوش مصنوعی ممکن است انتخاب کند همهٔ انسانها را بهجز چند نفر بکشد و روی رفاه باقیماندهها تمرکز کند زیرا میانگین رفاه تحت تأثیر تعداد انسانهای باقیمانده نیست. این ممکن است آنچه در نظر داشتید نباشد! فقط به یاد داشته باشید که تمام شبکههای عصبی که میسازید به همان اندازه در کاهش تابع زیان خود بیرحم خواهند بود، پس هدف را عاقلانه انتخاب کنید، وگرنه باید با عوارض جانبی ناخواسته روبرو شوید.
خوشبختانه، وقتی صحبت از مسائل رایج مانند طبقهبندی، رگرسیون و پیشبینی دنباله میشود، دستورالعملهای سادهای وجود دارد که میتوانید برای انتخاب زیان صحیح دنبال کنید. برای مثال، از آنتروپی متقاطع دودویی برای یک مسئلهٔ طبقهبندی دوکلاسه استفاده خواهید کرد، از آنتروپی متقاطع دستهای برای یک مسئلهٔ طبقهبندی چندکلاسه و غیره. فقط زمانی که روی مسائل تحقیقاتی واقعاً جدید کار میکنید باید توابع زیان خود را توسعه دهید. در چند فصل آینده، بهصراحت مشخص میکنیم که کدام توابع زیان را برای طیف گستردهای از وظایف رایج انتخاب کنید.
درک متد fit
Section titled “درک متد fit”پس از compile() نوبت به fit() میرسد. متد fit خود حلقهٔ آموزش را پیادهسازی میکند. آرگومانهای کلیدی آن عبارتند از
- داده (ورودیها و اهداف) برای آموزش. معمولاً بهصورت آرایههای NumPy یا یک شیء
Datasetدر TensorFlow پاس داده میشود. در فصلهای بعدی دربارهٔ APIDatasetبیشتر خواهید آموخت. - تعداد دورهها برای آموزش: حلقهٔ آموزش چند بار باید روی دادههای پاسدادهشده تکرار شود.
- اندازهٔ دستهٔ مورد استفاده در هر دوره از نزول گرادیان تصادفی با دستهٔ کوچک: تعداد نمونههای آموزشی که برای محاسبهٔ گرادیان یک گام بهروزرسانی وزن در نظر گرفته میشود.
لیستینگ ۳.۳۴: فراخوانی fit با دادههای NumPy
history = model.fit( # The input examples, as a NumPy array inputs, # The corresponding training targets, as a NumPy array targets, # The training loop will iterate over the data 5 times. epochs=5, # The training loop will iterate over the data in batches of 128 # examples. batch_size=128,)فراخوانی fit یک شیء History برمیگرداند. این شیء شامل یک فیلد history است که یک دیکشنری نگاشتکنندهٔ کلیدهایی مانند "loss" یا نام معیارهای خاص به لیست مقادیر هر دورهٔ آنهاست:
>>> history.historyنظارت بر زیان و معیارها روی دادههای اعتبارسنجی
Section titled “نظارت بر زیان و معیارها روی دادههای اعتبارسنجی”هدف یادگیری ماشین به دست آوردن مدلهایی نیست که روی دادههای آموزشی عملکرد خوبی دارند، که آسان است — تنها کاری که باید انجام دهید دنبال کردن گرادیان است. هدف به دست آوردن مدلهایی است که بهطور کلی عملکرد خوبی دارند، بهویژه روی نقاط دادهای که مدل هرگز با آنها روبرو نشده است. صرفاً به این دلیل که یک مدل روی دادههای آموزشی خود عملکرد خوبی دارد به این معنی نیست که روی دادههایی که هرگز ندیده است عملکرد خوبی خواهد داشت! برای مثال، ممکن است مدل شما در نهایت صرفاً یک نگاشت بین نمونههای آموزشی شما و اهدافشان را حفظ کند، که برای وظیفهٔ پیشبینی اهداف برای دادههایی که مدل هرگز ندیده است بیفایده خواهد بود. این نکته را با جزئیات بسیار بیشتری در فصل ۵ پوشش خواهیم داد.
برای زیر نظر گرفتن نحوهٔ عملکرد مدل روی دادههای جدید، رویهٔ استاندارد این است که زیرمجموعهای از دادههای آموزشی را بهعنوان «دادههای اعتبارسنجی» کنار بگذارید: مدل را روی این داده آموزش نمیدهید، اما از آن برای محاسبهٔ مقدار زیان و معیارها استفاده میکنید. این کار را با استفاده از آرگومان validation_data در fit() انجام میدهید. مانند دادههای آموزشی، دادههای اعتبارسنجی میتوانند بهصورت آرایههای NumPy یا یک شیء Dataset در TensorFlow پاس داده شوند.
لیستینگ ۳.۳۵: استفاده از آرگومان دادههای اعتبارسنجی
model = keras.Sequential([keras.layers.Dense(1)])model.compile(    optimizer=keras.optimizers.RMSprop(learning_rate=0.1),    loss=keras.losses.MeanSquaredError(),    metrics=[keras.metrics.BinaryAccuracy()],)
# To avoid having samples from only one class in the validation data,# shuffles the inputs and targets using a random indices permutationindices_permutation = np.random.permutation(len(inputs))shuffled_inputs = inputs[indices_permutation]shuffled_targets = targets[indices_permutation]
# Reserves 30% of the training inputs and targets for "validation."# (We'll exclude these samples from training and reserve them to# compute the "validation loss" and metrics).num_validation_samples = int(0.3 * len(inputs))val_inputs = shuffled_inputs[:num_validation_samples]val_targets = shuffled_targets[:num_validation_samples]training_inputs = shuffled_inputs[num_validation_samples:]training_targets = shuffled_targets[num_validation_samples:]model.fit(    # Training data, used to update the weights of the model    training_inputs,    training_targets,    epochs=5,    batch_size=16,    # Validation data, used only to monitor the "validation loss" and    # metrics    validation_data=(val_inputs, val_targets),)
مقدار زیان روی دادههای اعتبارسنجی زیان اعتبارسنجی نامیده میشود، برای تمایز از زیان آموزش. توجه داشته باشید که جدا نگه داشتن دادههای آموزشی و اعتبارسنجی ضروری است: هدف اعتبارسنجی نظارت بر این است که آیا آنچه مدل یاد میگیرد واقعاً روی دادههای جدید مفید است. اگر هر یک از دادههای اعتبارسنجی توسط مدل در طول آموزش دیده شده باشد، زیان و معیارهای اعتبارسنجی شما معیوب خواهند بود.
اگر میخواهید پس از اتمام آموزش زیان و معیارهای اعتبارسنجی را محاسبه کنید، میتوانید متد evaluate را فراخوانی کنید:
loss_and_metrics = model.evaluate(val_inputs, val_targets, batch_size=128)
evaluate() در دستههایی (با اندازهٔ batch_size) روی دادههای پاسدادهشده تکرار میکند و لیستی از اسکالرها را برمیگرداند که اولین ورودی آن زیان اعتبارسنجی و ورودیهای بعدی معیارهای اعتبارسنجی هستند. اگر مدل معیاری نداشته باشد، فقط زیان اعتبارسنجی برگردانده میشود (بهجای یک لیست).
استنتاج: استفاده از یک مدل پس از آموزش
Section titled “استنتاج: استفاده از یک مدل پس از آموزش”وقتی مدل خود را آموزش دادید، میخواهید از آن برای انجام پیشبینی روی دادههای جدید استفاده کنید. این استنتاج نامیده میشود. برای انجام این کار، یک رویکرد ساده این است که بهسادگی مدل را __call__ کنید:
# Takes a NumPy array or a tensor for your current backend and returns# a tensor for your current backendpredictions = model(new_inputs)با این حال، این کار تمام ورودیهای موجود در new_inputs را یکجا پردازش میکند، که ممکن است اگر با دادههای زیادی روبرو هستید امکانپذیر نباشد (بهطور خاص، ممکن است به حافظهٔ بیشتری از آنچه GPU شما دارد نیاز داشته باشد).
روش بهتر برای انجام استنتاج استفاده از متد predict() است. این متد در دستههای کوچک روی دادهها تکرار میکند و یک آرایهٔ NumPy از پیشبینیها برمیگرداند. و برخلاف __call__، میتواند اشیاء Dataset در TensorFlow را نیز پردازش کند:
# Takes a NumPy array or a Dataset and returns a NumPy arraypredictions = model.predict(new_inputs, batch_size=128)برای مثال، اگر از predict() روی برخی از دادههای اعتبارسنجی خود با مدل خطی که قبلاً آموزش دادیم استفاده کنیم، نمرات اسکالری به دست میآوریم که با پیشبینی مدل برای هر نمونهٔ ورودی مطابقت دارند:
>>> predictions = model.predict(val_inputs, batch_size=128)>>> print(predictions[:10])در حال حاضر، این تمام چیزی است که باید دربارهٔ مدلهای Keras بدانید. در این مرحله، آمادهاید به حل مسائل واقعی یادگیری ماشین با Keras در فصل بعد بپردازید.
- TensorFlow، PyTorch و JAX سه چارچوب محبوب سطح پایین برای محاسبات عددی و مشتقگیری خودکار هستند. هر یک روش خاص خود و نقاط قوت و ضعف خود را دارند.
- Keras یک API سطح بالا برای ساخت و آموزش شبکههای عصبی است. میتوان از آن با TensorFlow، PyTorch یا JAX استفاده کرد — فقط بکاندی را که بیشتر دوست دارید انتخاب کنید.
- کلاس مرکزی Keras کلاس
Layerاست. یک لایه مقداری وزن و مقداری محاسبه را کپسوله میکند. لایهها در مدلها مونتاژ میشوند. - قبل از شروع آموزش یک مدل، باید یک بهینهساز، یک زیان و چند معیار انتخاب کنید که از طریق متد
model.compile()مشخص میکنید. - برای آموزش یک مدل، میتوانید از متد
fit()استفاده کنید که نزول گرادیان دستهای کوچک را برای شما اجرا میکند. همچنین میتوانید از آن برای نظارت بر زیان و معیارهای خود روی دادههای اعتبارسنجی استفاده کنید، مجموعهای از ورودیها که مدل در طول آموزش نمیبیند. - وقتی مدل شما آموزش دید، میتوانید از متد
model.predict()برای تولید پیشبینی روی ورودیهای جدید استفاده کنید.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
R. E. Wengert, “A Simple Automatic Derivative Evaluation Program,” Communications of the ACM, 7 no. 8 (1964). ↩
-
توجه داشته باشید که PyTorch تا حدی یک مورد میانی است: در حالی که عمدتاً یک چارچوب سطح پایین است، لایهها و بهینهسازهای خودش را نیز شامل میشود. با این حال، اگر از PyTorch همراه با Keras استفاده کنید، تنها با APIهای سطح پایین PyTorch مانند عملیات تانسوری تعامل خواهید داشت. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.