
فصل ۲: بلوکهای سازندهٔ ریاضی شبکههای عصبی
درک یادگیری عمیق نیازمند آشنایی با بسیاری از مفاهیم سادهٔ ریاضی است: تانسورها، عملیات تانسوری، مشتقگیری، نزول گرادیان و غیره. هدف ما در این فصل ایجاد شهود در مورد این مفاهیم بدون بیشازحد فنی شدن است. بهطور خاص، از نمادگذاری ریاضی که میتواند موانع غیرضروری برای کسانی که پیشزمینهٔ ریاضی ندارند ایجاد کند و برای توضیح خوب چیزها ضروری نیست، دوری خواهیم کرد. دقیقترین و بدون ابهامترین توصیف یک عملیات ریاضی، کد اجرایی آن است.
برای فراهم کردن زمینهٔ کافی برای معرفی تانسورها و نزول گرادیان، فصل را با یک مثال عملی از یک شبکهٔ عصبی آغاز میکنیم. سپس هر مفهوم جدیدی را که معرفی شده است، نقطهبهنقطه مرور میکنیم. به یاد داشته باشید که این مفاهیم برای درک مثالهای عملی که در فصلهای بعدی ارائه میشوند ضروری خواهند بود!
پس از خواندن این فصل، درک شهودی از نظریهٔ ریاضی پشت یادگیری عمیق خواهید داشت و آمادهٔ شروع بررسی چارچوبهای یادگیری عمیق مدرن در فصل ۳ خواهید بود.
نگاهی اول به یک شبکهٔ عصبی
Section titled “نگاهی اول به یک شبکهٔ عصبی”بیایید به یک مثال عینی از یک شبکهٔ عصبی نگاه کنیم که از کتابخانهٔ یادگیری ماشین Keras برای یادگیری طبقهبندی ارقام دستنویس استفاده میکند. ما در سراسر این کتاب از Keras بهطور گسترده استفاده خواهیم کرد. این یک کتابخانهٔ سطح بالا و ساده است که به ما امکان میدهد روی مفاهیمی که میخواهیم پوشش دهیم تمرکز کنیم.
مگر اینکه قبلاً با Keras یا کتابخانههای مشابه تجربه داشته باشید، درک کامل این مثال اول ممکن نخواهد بود. اشکالی ندارد. در چند بخش آینده، هر عنصر در این مثال را بررسی و با جزئیات توضیح خواهیم داد. بنابراین نگران نباشید اگر برخی مراحل دلخواه به نظر میرسند یا شبیه جادو هستند! باید از جایی شروع کنیم.
مسئلهای که در اینجا سعی در حل آن داریم طبقهبندی تصاویر خاکستری ارقام دستنویس (۲۸×۲۸ پیکسل) به ۱۰ دسته (۰ تا ۹) است. ما از مجموعهدادهٔ MNIST استفاده خواهیم کرد، یک کلاسیک در جامعهٔ یادگیری ماشین که تقریباً بهاندازهٔ خود این حوزه قدمت دارد و بهطور فشرده مطالعه شده است. این مجموعهای از ۶۰,۰۰۰ تصویر آموزشی بهعلاوهٔ ۱۰,۰۰۰ تصویر آزمایشی است که توسط مؤسسهٔ ملی استانداردها و فناوری (NIST در MNIST) در دههٔ ۱۹۸۰ جمعآوری شده است. میتوانید «حل» MNIST را «Hello World» یادگیری عمیق در نظر بگیرید — کاری که برای تأیید عملکرد صحیح الگوریتمهایتان انجام میدهید. با تبدیل شدن به یک متخصص یادگیری ماشین، MNIST را بارها و بارها در مقالات علمی، پستهای وبلاگ و غیره خواهید دید. میتوانید چند نمونهٔ MNIST را در شکل ۲.۱ ببینید.
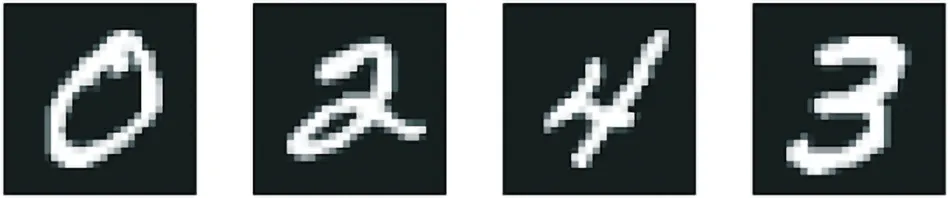
شکل ۲.۱: نمونه ارقام MNIST
مجموعهدادهٔ MNIST بهصورت از پیش بارگذاریشده در Keras، به شکل مجموعهای از چهار آرایهٔ NumPy موجود است.
لیستینگ ۲.۱: بارگذاری مجموعهدادهٔ MNIST در Keras
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
train_images و train_labels مجموعهٔ آموزش را تشکیل میدهند، دادهای که مدل از آن یاد میگیرد. سپس مدل روی مجموعهٔ آزمایشی test_images و test_labels آزمایش میشود. تصاویر بهصورت آرایههای NumPy کدگذاری شدهاند و برچسبها آرایهای از ارقام از ۰ تا ۹ هستند. تصاویر و برچسبها تطابق یکبهیک دارند.
بیایید به دادههای آموزشی نگاه کنیم:
>>> train_images.shapeو این دادههای آزمایشی است:
>>> test_images.shapeگردش کار به این صورت خواهد بود. ابتدا شبکهٔ عصبی را با دادههای آموزشی train_images و train_labels تغذیه میکنیم. سپس شبکه یاد میگیرد تصاویر و برچسبها را به هم مرتبط کند. در نهایت، از شبکه میخواهیم برای test_images پیشبینی تولید کند و بررسی میکنیم که آیا این پیشبینیها با برچسبهای test_labels مطابقت دارند یا خیر.
بیایید شبکه را بسازیم — دوباره به یاد داشته باشید که انتظار نمیرود از قبل همهچیز را در این مثال درک کنید.
لیستینگ ۲.۲: معماری شبکه
import kerasfrom keras import layers
model = keras.Sequential(    [        layers.Dense(512, activation="relu"),        layers.Dense(10, activation="softmax"),    ])
بلوک سازندهٔ اصلی شبکههای عصبی لایه است. میتوانید یک لایه را بهعنوان فیلتری برای داده در نظر بگیرید: برخی دادهها وارد میشوند و به شکلی مفیدتر خارج میشوند. بهطور خاص، لایهها بازنماییهایی را از دادههای تغذیهشده به آنها استخراج میکنند — امیدواریم بازنماییهایی معنادارتر برای مسئلهٔ پیشرو. بیشتر یادگیری عمیق شامل زنجیرهسازی لایههای سادهای است که شکلی از تقطیر تدریجی داده را پیادهسازی میکنند. یک مدل یادگیری عمیق مانند یک الک برای پردازش داده است که از توالی فیلترهای دادهٔ بهطور فزاینده تصفیهشده — لایهها — ساخته شده است.
در اینجا، مدل ما از توالی دو لایهٔ Dense تشکیل شده است که لایههای عصبی متراکم (که به آنها کاملاً متصل نیز میگویند) هستند. لایهٔ دوم (و آخر) یک لایهٔ طبقهبندی softmax ۱۰-way است، به این معنی که آرایهای از ۱۰ نمرهٔ احتمال (مجموع برابر با ۱) برمیگرداند. هر نمره احتمال اینکه تصویر رقم فعلی متعلق به یکی از ۱۰ کلاس رقم ما باشد را نشان میدهد.
برای آمادهسازی مدل برای آموزش، باید سه چیز دیگر را بهعنوان بخشی از مرحلهٔ کامپایل انتخاب کنیم:
- تابع زیان — چگونه مدل میتواند عملکرد خود را روی دادههای آموزشی اندازهگیری کند و بنابراین چگونه میتواند خود را در جهت درست هدایت کند.
- بهینهساز — مکانیزمی که از طریق آن مدل بر اساس دادههای آموزشی که میبیند خود را بهروزرسانی میکند تا عملکرد خود را بهبود بخشد.
- معیارهایی برای نظارت در طول آموزش و آزمایش — در اینجا، ما فقط به دقت (نسبت تصاویری که بهدرستی طبقهبندی شدهاند) اهمیت میدهیم.
هدف دقیق تابع زیان و بهینهساز در طول دو فصل آینده روشن خواهد شد.
لیستینگ ۲.۳: مرحلهٔ کامپایل
model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)قبل از آموزش، دادهها را پیشپردازش میکنیم با تغییر شکل آنها به شکلی که مدل انتظار دارد و مقیاسبندی آنها بهگونهای که همهٔ مقادیر در بازهٔ [0, 1] باشند. قبلاً، تصاویر آموزشی ما در آرایهای با شکل (60000, 28, 28) از نوع uint8 با مقادیر در بازهٔ [0, 255] ذخیره شده بودند. ما آن را به یک آرایهٔ float32 با شکل (60000, 28 * 28) و مقادیر بین 0 و 1 تبدیل میکنیم.
لیستینگ ۲.۴: آمادهسازی دادههای تصویری
train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255test_images = test_images.reshape((10000, 28 * 28))test_images = test_images.astype("float32") / 255اکنون آمادهایم مدل را آموزش دهیم، که در Keras از طریق فراخوانی متد fit() مدل انجام میشود — ما مدل را به دادههای آموزشیاش برازش میدهیم.
لیستینگ ۲.۵: «برازش» مدل
model.fit(train_images, train_labels, epochs=5, batch_size=128)در طول آموزش دو کمیت نمایش داده میشود: زیان مدل روی دادههای آموزشی و دقت مدل روی دادههای آموزشی. ما بهسرعت به دقت ۰.۹۸۹ (۹۸.۹٪) روی دادههای آموزشی میرسیم.
حالا که یک مدل آموزشدیده داریم، میتوانیم از آن برای پیشبینی احتمالات کلاس برای ارقام جدید — تصاویری که بخشی از دادههای آموزشی نبودند، مانند آنهایی که از مجموعهٔ آزمایشی میآیند — استفاده کنیم.
لیستینگ ۲.۶: استفاده از مدل برای انجام پیشبینی
>>> test_digits = test_images[0:10]>>> predictions = model.predict(test_digits)>>> predictions[0]هر عدد با شاخص i در آن آرایه با احتمال اینکه تصویر رقم test_digits[0] متعلق به کلاس i باشد مطابقت دارد.
این اولین رقم آزمایشی بالاترین نمرهٔ احتمال (۰.۹۹۹۹۹۱۰۶، تقریباً ۱) را در شاخص ۷ دارد، بنابراین طبق مدل ما باید یک ۷ باشد:
>>> predictions[0].argmax()میتوانیم بررسی کنیم که برچسب آزمایشی موافق است:
>>> test_labels[0]بهطور متوسط، مدل ما چقدر خوب ارقام هرگز دیدهنشده را طبقهبندی میکند؟ بیایید با محاسبهٔ دقت متوسط روی کل مجموعهٔ آزمایشی بررسی کنیم.
لیستینگ ۲.۷: ارزیابی مدل روی دادههای جدید
>>> test_loss, test_acc = model.evaluate(test_images, test_labels)>>> print(f"test_acc: {test_acc}")دقت مجموعهٔ آزمایشی ۹۷.۸٪ است — که تقریباً دو برابر نرخ خطای مجموعهٔ آموزشی است (با دقت ۹۸.۹٪). این شکاف بین دقت آموزش و دقت آزمایش نمونهای از بیشبرازش است: این واقعیت که مدلهای یادگیری ماشین تمایل دارند روی دادههای جدید بدتر از دادههای آموزشی خود عمل کنند. بیشبرازش موضوع اصلی فصل ۵ است.
این اولین مثال ما را به پایان میرساند. شما همین الان دیدید که چگونه میتوانید یک شبکهٔ عصبی برای طبقهبندی ارقام دستنویس در کمتر از ۱۵ خط کد پایتون بسازید و آموزش دهید. در این فصل و فصل بعد، به جزئیات هر قطعهٔ متحرکی که پیشنمایش کردیم میپردازیم و روشن میکنیم که در پشت صحنه چه میگذرد. شما دربارهٔ تانسورها، اشیاء ذخیرهسازی داده که به مدل وارد میشوند، یاد خواهید گرفت؛ عملیات تانسوری، که لایهها از آن ساخته شدهاند؛ و نزول گرادیان، که به مدل شما اجازه میدهد از مثالهای آموزشی خود یاد بگیرد.
بازنمایی داده برای شبکههای عصبی
Section titled “بازنمایی داده برای شبکههای عصبی”در مثال قبلی، از دادههای ذخیرهشده در آرایههای چندبعدی NumPy شروع کردیم که به آنها تانسور نیز گفته میشود. بهطور کلی، تمام سیستمهای یادگیری ماشین فعلی از تانسورها بهعنوان ساختار دادهٔ پایهٔ خود استفاده میکنند. تانسورها برای این حوزه بنیادین هستند — آنقدر بنیادین که چارچوب TensorFlow به نام آنها نامگذاری شد. پس تانسور چیست؟
در هستهٔ خود، یک تانسور یک ظرف برای داده است — معمولاً دادههای عددی. بنابراین ظرفی برای اعداد است. ممکن است از قبل با ماتریسها آشنا باشید، که تانسورهای مرتبهٔ ۲ هستند: تانسورها تعمیمی از ماتریسها به تعداد دلخواهی از ابعاد هستند (توجه داشته باشید که در زمینهٔ تانسورها، یک بُعد اغلب محور نامیده میشود).
بررسی جزئیات تانسورها ممکن است در ابتدا کمی انتزاعی به نظر برسد. اما کاملاً ارزشش را دارد — دستکاری تانسورها نان و کرهٔ هر کد یادگیری ماشینی خواهد بود که مینویسید.
اسکالرها (تانسورهای مرتبهٔ ۰)
Section titled “اسکالرها (تانسورهای مرتبهٔ ۰)”تانسوری که فقط شامل یک عدد است اسکالر نامیده میشود (یا تانسور اسکالر، تانسور مرتبهٔ ۰، یا تانسور 0D). در NumPy، یک عدد float32 یا float64 یک تانسور اسکالر (یا آرایهٔ اسکالر) است. میتوانید تعداد محورهای یک تانسور NumPy را از طریق ویژگی ndim نمایش دهید؛ یک تانسور اسکالر ۰ محور دارد (ndim == 0). تعداد محورهای یک تانسور همچنین مرتبه آن نامیده میشود. این یک اسکالر NumPy است:
>>> import numpy as np>>> x = np.array(12)>>> xبردارها (تانسورهای مرتبهٔ ۱)
Section titled “بردارها (تانسورهای مرتبهٔ ۱)”آرایهای از اعداد بردار نامیده میشود (یا تانسور مرتبهٔ ۱ یا تانسور 1D). یک تانسور مرتبهٔ ۱ دقیقاً یک محور دارد. موارد زیر یک بردار NumPy است:
>>> x = np.array([12, 3, 6, 14, 7])>>> xاین بردار پنج ورودی دارد و بنابراین بردار ۵ بُعدی نامیده میشود. یک بردار 5D را با یک تانسور 5D اشتباه نگیرید! یک بردار 5D فقط یک محور دارد و پنج بُعد در امتداد آن محور دارد، در حالی که یک تانسور 5D پنج محور دارد (و ممکن است هر تعداد بُعد در امتداد هر محور داشته باشد). بُعدیت میتواند یا به تعداد ورودیها در امتداد یک محور خاص اشاره کند (مانند مورد بردار 5D ما) یا به تعداد محورهای یک تانسور (مانند یک تانسور 5D)، که گاهی اوقات میتواند گیجکننده باشد. در حالت دوم، از نظر فنی صحیحتر است که از تانسور با مرتبهٔ ۵ صحبت کنیم (مرتبهٔ یک تانسور تعداد محورهای آن است)، اما نماد مبهم تانسور 5D بههرحال رایج است.
ماتریسها (تانسورهای مرتبهٔ ۲)
Section titled “ماتریسها (تانسورهای مرتبهٔ ۲)”آرایهای از بردارها یک ماتریس است (یا تانسور مرتبهٔ ۲ یا تانسور 2D). یک ماتریس دو محور دارد (که اغلب به آنها سطرها و ستونها گفته میشود). میتوانید یک ماتریس را بهصورت یک شبکهٔ مستطیلی از اعداد تجسم کنید. این یک ماتریس NumPy است:
>>> x = np.array([[5, 78, 2, 34, 0],... [6, 79, 3, 35, 1],... [7, 80, 4, 36, 2]])>>> x.ndimورودیهای محور اول سطرها و ورودیهای محور دوم ستونها نامیده میشوند. در مثال قبلی، [5, 78, 2, 34, 0] سطر اول x است و [5, 6, 7] ستون اول آن است.
تانسورهای مرتبهٔ ۳ و تانسورهای مرتبهٔ بالاتر
Section titled “تانسورهای مرتبهٔ ۳ و تانسورهای مرتبهٔ بالاتر”اگر چنین ماتریسهایی را در یک آرایهٔ جدید بستهبندی کنید، یک تانسور مرتبهٔ ۳ (یا تانسور 3D) به دست میآورید که میتوانید آن را بهصورت یک مکعب از اعداد تجسم کنید. موارد زیر یک تانسور مرتبهٔ ۳ NumPy است:
>>> x = np.array([[[5, 78, 2, 34, 0],... [6, 79, 3, 35, 1],... [7, 80, 4, 36, 2]],... [[5, 78, 2, 34, 0],... [6, 79, 3, 35, 1],... [7, 80, 4, 36, 2]],... [[5, 78, 2, 34, 0],... [6, 79, 3, 35, 1],... [7, 80, 4, 36, 2]]])>>> x.ndimبا بستهبندی تانسورهای مرتبهٔ ۳ در یک آرایه، میتوانید یک تانسور مرتبهٔ ۴ ایجاد کنید و به همین ترتیب. در یادگیری عمیق، بهطور کلی تانسورهایی با مرتبههای ۰ تا ۴ را دستکاری میکنید، اگرچه ممکن است اگر دادههای ویدیویی پردازش کنید تا مرتبهٔ ۵ هم بروید.
ویژگیهای کلیدی
Section titled “ویژگیهای کلیدی”یک تانسور توسط سه ویژگی کلیدی تعریف میشود:
- تعداد محورها (مرتبه) — برای مثال، یک تانسور مرتبهٔ ۳ سه محور دارد و یک ماتریس دو محور دارد. این در کتابخانههای پایتون مانند NumPy، JAX، TensorFlow و PyTorch
ndimتانسور نیز نامیده میشود. - شکل — این یک تاپل از اعداد صحیح است که توصیف میکند تانسور در امتداد هر محور چند بُعد دارد. برای مثال، مثال ماتریس قبلی شکل
(3, 5)دارد و مثال تانسور مرتبهٔ ۳ شکل(3, 3, 5)دارد. یک بردار شکلی با یک عضو دارد، مانند(5,)، در حالی که یک اسکالر شکل خالی()دارد. - نوع داده (که معمولاً در کتابخانههای پایتون
dtypeنامیده میشود) — این نوع دادههای موجود در تانسور است؛ برای مثال، نوع یک تانسور میتواندfloat16،float32،float64،uint8،boolو غیره باشد. در TensorFlow، احتمالاً با تانسورهایstringنیز روبرو خواهید شد.
برای عینیتر کردن این موضوع، بیایید به دادههایی که در مثال MNIST پردازش کردیم بازگردیم. ابتدا مجموعهدادهٔ MNIST را بارگذاری میکنیم:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
سپس، تعداد محورهای تانسور train_images را نمایش میدهیم، ویژگی ndim:
>>> train_images.ndimشکل آن این است:
>>> train_images.shapeو این نوع داده آن است، ویژگی dtype:
>>> train_images.dtypeبنابراین چیزی که در اینجا داریم یک تانسور مرتبهٔ ۳ از اعداد صحیح ۸ بیتی است. بهطور دقیقتر، این آرایهای از ۶۰,۰۰۰ ماتریس ۲۸×۲۸ از اعداد صحیح است. هر یک از این ماتریسها یک تصویر خاکستری با مقادیر بین ۰ و ۲۵۵ است.
بیایید رقم چهارم را در این تانسور مرتبهٔ ۳ با استفاده از کتابخانهٔ Matplotlib (بخشی از مجموعهٔ علمی استاندارد پایتون) نمایش دهیم؛ شکل ۲.۲ را ببینید.
لیستینگ ۲.۸: نمایش رقم چهارم
import matplotlib.pyplot as plt
digit = train_images[4]plt.imshow(digit, cmap=plt.cm.binary)plt.show()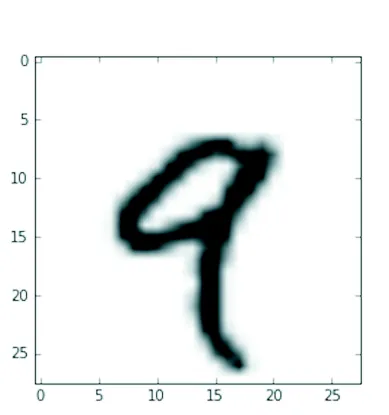
شکل ۲.۲: چهارمین نمونه در مجموعهدادهٔ ما
طبیعتاً، برچسب مربوطه فقط عدد صحیح ۹ است:
>>> train_labels[4]دستکاری تانسورها در NumPy
Section titled “دستکاری تانسورها در NumPy”در مثال قبلی، با استفاده از نحو train_images[i] یک رقم خاص را در امتداد محور اول انتخاب کردیم. انتخاب عناصر خاص در یک تانسور برش تانسور نامیده میشود. بیایید به عملیات برش تانسوری که میتوانید روی آرایههای NumPy انجام دهید نگاه کنیم.
مثال زیر ارقام #۱۰ تا #۱۰۰ را انتخاب میکند (#۱۰۰ شامل نمیشود) و آنها را در آرایهای با شکل (90, 28, 28) قرار میدهد:
>>> my_slice = train_images[10:100]>>> my_slice.shapeاین معادل نماد دقیقتر زیر است که یک شاخص شروع و یک شاخص توقف برای برش در امتداد هر محور تانسور مشخص میکند. توجه داشته باشید که : معادل انتخاب کل محور است:
>>> # Equivalent to the previous example>>> my_slice = train_images[10:100, :, :]>>> my_slice.shapeبهطور کلی، ممکن است برشهایی بین هر دو شاخص در امتداد هر محور تانسور انتخاب کنید. برای مثال، برای انتخاب ۱۴×۱۴ پیکسل در گوشهٔ پایین سمت راست همهٔ تصاویر، این کار را انجام میدهید:
my_slice = train_images[:, 14:, 14:]استفاده از شاخصهای منفی نیز ممکن است. درست مانند شاخصهای منفی در لیستهای پایتون، آنها موقعیتی را نسبت به انتهای محور فعلی نشان میدهند. برای برش تصاویر به تکههای ۱۴×۱۴ پیکسل در مرکز، این کار را انجام دهید:
my_slice = train_images[:, 7:-7, 7:-7]مفهوم دستههای داده
Section titled “مفهوم دستههای داده”بهطور کلی، محور اول (محور ۰، زیرا شاخصگذاری از ۰ شروع میشود) در تمام تانسورهای دادهای که در یادگیری عمیق با آنها روبرو خواهید شد، محور نمونهها خواهد بود. در مثال MNIST، «نمونهها» تصاویر ارقام هستند.
علاوه بر این، مدلهای یادگیری عمیق یک مجموعهدادهٔ کامل را یکجا پردازش نمیکنند؛ بلکه داده را به «دستههای» کوچک (batches)، یا گروههایی از نمونهها با اندازهٔ ثابت، تقسیم میکنند. بهطور عینی، در اینجا یک دسته از ارقام MNIST ما با اندازهٔ دستهٔ ۱۲۸ آمده است:
batch = train_images[:128]و این دستهٔ بعدی است:
batch = train_images[128:256]و دستهٔ nام:
n = 3batch = train_images[128 * n : 128 * (n + 1)]هنگام در نظر گرفتن چنین تانسور دستهای، محور اول (محور ۰) محور دسته (یا بُعد دسته) نامیده میشود. شما اغلب هنگام استفاده از Keras و سایر کتابخانههای یادگیری عمیق با این اصطلاح روبرو خواهید شد.
نمونههای دنیای واقعی از تانسورهای داده
Section titled “نمونههای دنیای واقعی از تانسورهای داده”بیایید تانسورهای داده را با چند مثال مشابه آنچه بعداً با آنها روبرو خواهید شد عینیتر کنیم. دادههایی که دستکاری خواهید کرد تقریباً همیشه در یکی از دستههای زیر قرار میگیرند:
- دادههای برداری — تانسورهای مرتبهٔ ۲ با شکل
(samples, features)، که در آن هر نمونه یک بردار از ویژگیهای عددی («ویژگیها») است. - دادههای سری زمانی یا دنبالهای — تانسورهای مرتبهٔ ۳ با شکل
(samples, timesteps, features)، که در آن هر نمونه یک دنباله (با طولtimesteps) از بردارهای ویژگی است. - تصاویر — تانسورهای مرتبهٔ ۴ با شکل
(samples, height, width, channels)، که در آن هر نمونه یک شبکهٔ دوبعدی از پیکسلهاست و هر پیکسل با بردار مقادیر («کانالها») نمایش داده میشود. - ویدیو — تانسورهای مرتبهٔ ۵ با شکل
(samples, frames, height, width, channels)، که در آن هر نمونه یک دنباله (با طولframes) از تصاویر است.
دادههای برداری
Section titled “دادههای برداری”دادههای برداری یکی از رایجترین موارد است. در چنین مجموعهدادهای، هر نقطه دادهٔ منفرد میتواند بهصورت یک بردار کدگذاری شود، و بنابراین یک دسته داده بهصورت یک تانسور مرتبهٔ ۲ (یعنی آرایهای از بردارها) کدگذاری میشود، که در آن محور اول محور نمونهها و محور دوم محور ویژگیها است.
بیایید به دو مثال نگاه کنیم:
- یک مجموعهدادهٔ اکچوئری از افراد، که در آن سن، جنسیت و درآمد هر فرد را در نظر میگیریم. هر فرد میتواند بهصورت بردار سه مقدار مشخص شود، و بنابراین یک مجموعهدادهٔ کامل از ۱۰۰,۰۰۰ نفر میتواند در یک تانسور مرتبهٔ ۲ با شکل
(100000, 3)ذخیره شود. - یک مجموعهداده از اسناد متنی، که در آن هر سند را با تعداد دفعاتی که هر کلمه در آن ظاهر میشود (از یک فرهنگ لغت ۲۰,۰۰۰ کلمهٔ رایج) نمایش میدهیم. هر سند میتواند بهصورت برداری از ۲۰,۰۰۰ مقدار کدگذاری شود (یک شمارش بهازای هر کلمه در فرهنگ لغت)، و بنابراین یک مجموعهدادهٔ کامل از ۵۰۰ سند میتواند در یک تانسور با شکل
(500, 20000)ذخیره شود.
دادههای سری زمانی یا دنبالهای
Section titled “دادههای سری زمانی یا دنبالهای”هر زمان که زمان در دادههای شما مهم باشد (یا مفهوم ترتیب دنباله)، منطقی است که آن را در یک تانسور مرتبهٔ ۳ با یک محور زمانی صریح ذخیره کنید. هر نمونه میتواند بهصورت دنبالهای از بردارها (یک تانسور مرتبهٔ ۲) کدگذاری شود، و بنابراین یک دسته داده بهصورت یک تانسور مرتبهٔ ۳ کدگذاری میشود (شکل ۲.۳ را ببینید).
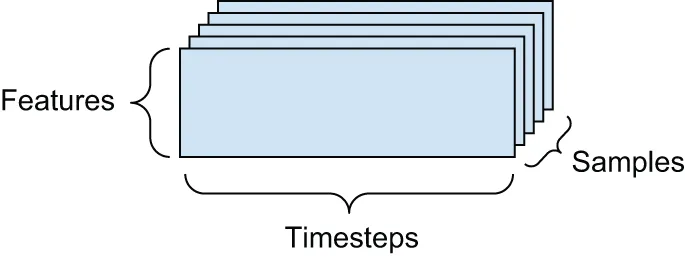
شکل ۲.۳: یک تانسور دادهٔ سری زمانی مرتبهٔ ۳
محور زمان همیشه طبق قرارداد محور دوم (محور با شاخص ۱) است. بیایید به چند مثال نگاه کنیم:
- یک مجموعهداده از قیمت سهام — هر دقیقه، قیمت فعلی سهام، بالاترین قیمت در دقیقهٔ گذشته و پایینترین قیمت در دقیقهٔ گذشته را ذخیره میکنیم. بنابراین هر دقیقه بهصورت یک بردار 3D کدگذاری میشود، یک روز کامل معاملات بهصورت ماتریسی با شکل
(390, 3)کدگذاری میشود (۳۹۰ دقیقه در یک روز معاملاتی وجود دارد)، و دادههای ۲۵۰ روز میتواند در یک تانسور مرتبهٔ ۳ با شکل(250, 390, 3)ذخیره شود. در اینجا، هر نمونه یک روز داده خواهد بود. - یک مجموعهداده از توییتها، که در آن هر توییت را بهصورت دنبالهای از ۲۸۰ کاراکتر از الفبای ۱۲۸ کاراکتر یکتا کدگذاری میکنیم — در این تنظیم، هر کاراکتر میتواند بهصورت یک بردار دودویی با اندازهٔ ۱۲۸ کدگذاری شود (یک بردار همهصفر بهجز یک ورودی ۱ در شاخص مربوط به کاراکتر). سپس هر توییت میتواند بهصورت یک تانسور مرتبهٔ ۲ با شکل
(280, 128)کدگذاری شود، و یک مجموعهدادهٔ ۱ میلیون توییت میتواند در یک تانسور با شکل(1000000, 280, 128)ذخیره شود.
دادههای تصویری
Section titled “دادههای تصویری”تصاویر معمولاً سه بُعد دارند: ارتفاع، عرض و عمق رنگ. اگرچه تصاویر خاکستری (مانند ارقام MNIST ما) فقط یک کانال رنگی دارند و بنابراین میتوانستند در تانسورهای مرتبهٔ ۲ ذخیره شوند، طبق قرارداد تانسورهای تصویری همیشه مرتبهٔ ۳ هستند، با یک کانال رنگی یکبعدی برای تصاویر خاکستری. یک دسته از ۱۲۸ تصویر خاکستری با اندازهٔ ۲۵۶×۲۵۶ میتواند در یک تانسور با شکل (128, 256, 256, 1) ذخیره شود، و یک دسته از ۱۲۸ تصویر رنگی میتواند در یک تانسور با شکل (128, 256, 256, 3) ذخیره شود (شکل ۲.۴ را ببینید).
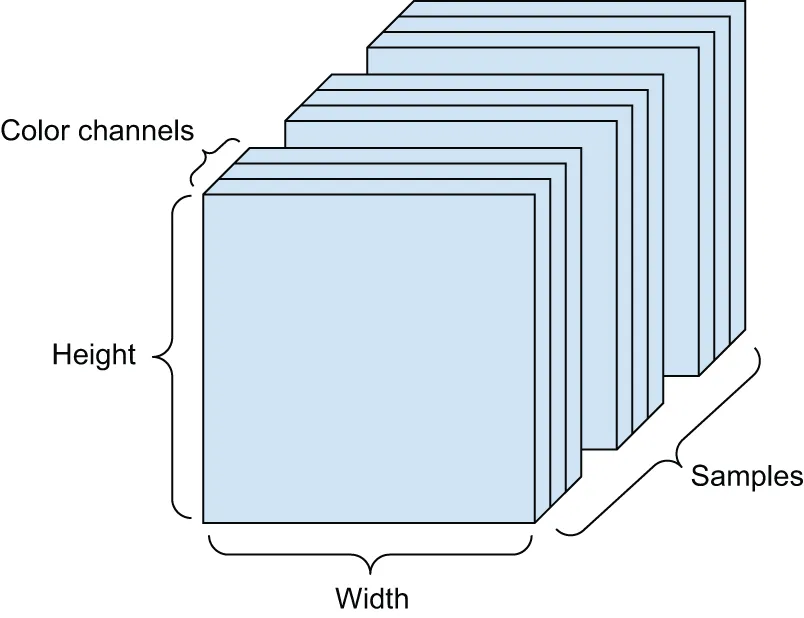
شکل ۲.۴: یک تانسور دادهٔ تصویری مرتبهٔ ۴
دو قرارداد برای شکل تانسورهای تصویری وجود دارد: قرارداد کانال آخر (که در JAX و TensorFlow و همچنین بیشتر ابزارهای یادگیری عمیق دیگر استاندارد است) و قرارداد کانال اول (که در PyTorch استاندارد است).
قرارداد کانال آخر محور عمق رنگ را در انتها قرار میدهد: (samples, height, width, color_depth). در همین حال، قرارداد کانال اول محور عمق رنگ را دقیقاً بعد از محور دسته قرار میدهد: (samples, color_depth, height, width). با قرارداد کانال اول، مثالهای قبلی به (128, 1, 256, 256) و (128, 3, 256, 256) تبدیل میشوند. API Keras از هر دو قالب پشتیبانی میکند.
دادههای ویدیویی
Section titled “دادههای ویدیویی”دادههای ویدیویی یکی از معدود انواع دادهٔ دنیای واقعی است که برای آن به تانسورهای مرتبهٔ ۵ نیاز خواهید داشت. یک ویدیو را میتوان بهعنوان دنبالهای از فریمها درک کرد که هر فریم یک تصویر رنگی است. از آنجا که هر فریم میتواند در یک تانسور مرتبهٔ ۳ (height, width, color_depth) ذخیره شود، یک دنباله از فریمها میتواند در یک تانسور مرتبهٔ ۴ (frames, height, width, color_depth) ذخیره شود، و بنابراین یک دسته از ویدیوهای مختلف میتواند در یک تانسور مرتبهٔ ۵ با شکل (samples, frames, height, width, color_depth) ذخیره شود.
برای مثال، یک کلیپ ویدیویی ۶۰ ثانیهای ۱۴۴×۲۵۶ یوتیوب که با ۴ فریم در ثانیه نمونهبرداری شده، ۲۴۰ فریم خواهد داشت. یک دسته از چهار چنین کلیپ ویدیویی در یک تانسور با شکل (4, 240, 144, 256, 3) ذخیره میشود. این در مجموع ۱۰۶,۱۶۸,۳۲۰ مقدار است! اگر dtype تانسور float32 بود، هر مقدار در ۳۲ بیت ذخیره میشد، بنابراین تانسور ۴۲۵ مگابایت را نشان میداد. سنگین! ویدیوهایی که در زندگی واقعی با آنها روبرو میشوید بسیار سبکتر هستند زیرا در float32 ذخیره نمیشوند و معمولاً با ضریب زیادی فشرده میشوند (مانند قالب MPEG).
چرخدندههای شبکههای عصبی: عملیات تانسوری
Section titled “چرخدندههای شبکههای عصبی: عملیات تانسوری”درست مانند هر برنامهٔ کامپیوتری که در نهایت میتواند به مجموعهٔ کوچکی از عملیات دودویی روی ورودیهای دودویی (AND، OR، NOR و غیره) تقلیل یابد، تمام تبدیلهایی که شبکههای عصبی عمیق یاد میگیرند میتوانند به تعداد انگشتشماری عملیات تانسوری (یا توابع تانسوری) که روی تانسورهای دادهٔ عددی اعمال میشوند تقلیل یابند. برای مثال، میتوان تانسورها را جمع کرد، تانسورها را ضرب کرد و غیره.
در مثال اولیهٔ ما، مدل خود را با روی هم چیدن لایههای Dense میساختیم. یک نمونهٔ لایهٔ Keras به این صورت است:
keras.layers.Dense(512, activation="relu")این لایه را میتوان بهعنوان یک تابع تفسیر کرد که بهعنوان ورودی یک ماتریس میگیرد و ماتریس دیگری برمیگرداند — یک بازنمایی جدید برای تانسور ورودی. بهطور خاص، تابع به شرح زیر است (که در آن W یک ماتریس و b یک بردار است، هر دو ویژگیهای لایه):
output = relu(matmul(input, W) + b)بیایید این را باز کنیم. ما در اینجا سه عملیات تانسوری داریم:
- یک ضرب تانسوری (
matmul) بین تانسور ورودی و تانسوری به نامW. - یک جمع (
+) بین ماتریس حاصل و بردارb. - یک عملیات
relu:relu(x)برابر است باmax(x, 0)."relu"مخفف «REctified Linear Unit» است.
عملیات عنصر به عنصر
Section titled “عملیات عنصر به عنصر”عملیات relu و جمع عملیات عنصر به عنصر هستند: عملیاتی که بهطور مستقل روی هر ورودی در تانسورهای مورد نظر اعمال میشوند. این بدان معناست که این عملیات بهشدت برای پیادهسازیهای موازی انبوه (پیادهسازیهای برداریشده، اصطلاحی که از معماری ابررایانهٔ پردازندهٔ برداری در دورهٔ ۱۹۷۰-۱۹۹۰ میآید) مناسب هستند. اگر میخواهید یک پیادهسازی سادهٔ پایتون از یک عملیات عنصر به عنصر بنویسید، از یک حلقهٔ for استفاده میکنید، مانند این پیادهسازی سادهٔ عملیات relu عنصر به عنصر:
def naive_relu(x): # x is a rank-2 NumPy tensor. assert len(x.shape) == 2 # Avoids overwriting the input tensor x = x.copy() for i in range(x.shape[0]): for j in range(x.shape[1]): x[i, j] = max(x[i, j], 0) return xمیتوانستید همین کار را برای جمع انجام دهید:
def naive_add(x, y): # x and y are rank-2 NumPy tensors. assert len(x.shape) == 2 assert x.shape == y.shape # Avoids overwriting the input tensor x = x.copy() for i in range(x.shape[0]): for j in range(x.shape[1]): x[i, j] += y[i, j] return xبر اساس همین اصل، میتوانید ضرب، تفریق و غیره را عنصر به عنصر انجام دهید.
در عمل، هنگام کار با آرایههای NumPy، این عملیات بهصورت توابع داخلی بهینهشدهٔ NumPy در دسترس هستند، که خودشان کارهای سنگین را به یک پیادهسازی Basic Linear Algebra Subprograms (BLAS) واگذار میکنند. BLASها زیربرنامههای دستکاری تانسور سطح پایین، بسیار موازی و کارآمد هستند که معمولاً در Fortran یا C پیادهسازی میشوند.
بنابراین، در NumPy، میتوانید عملیات عنصر به عنصر زیر را انجام دهید و بسیار سریع خواهد بود:
import numpy as np
# Element-wise additionz = x + y# Element-wise reluz = np.maximum(z, 0.0)
بیایید واقعاً تفاوت را زمانبندی کنیم:
import time
x = np.random.random((20, 100))y = np.random.random((20, 100))
t0 = time.time()for _ in range(1000):    z = x + y    z = np.maximum(z, 0.0)print("Took: {0:.2f} s".format(time.time() - t0))
این ۰.۰۲ ثانیه طول میکشد. در همین حال، نسخهٔ ساده ۲.۴۵ ثانیه طول میکشد:
t0 = time.time()for _ in range(1000): z = naive_add(x, y) z = naive_relu(z)print("Took: {0:.2f} s".format(time.time() - t0))بهطور مشابه، هنگام اجرای کد JAX/TensorFlow/PyTorch روی GPU، عملیات عنصر به عنصر از طریق پیادهسازیهای کاملاً برداریشدهٔ CUDA اجرا میشوند که میتوانند از معماری تراشهٔ GPU بسیار موازی بهترین استفاده را ببرند.
پیادهسازی سادهٔ naive_add قبلی ما فقط از جمع تانسورهای مرتبهٔ ۲ با شکلهای یکسان پشتیبانی میکرد. اما در لایهٔ Dense که قبلاً معرفی شد، ما یک تانسور مرتبهٔ ۲ را با یک بردار جمع کردیم. وقتی شکل دو تانسوری که جمع میشوند متفاوت باشد چه اتفاقی میافتد؟
در صورت امکان، و اگر ابهامی وجود نداشته باشد، تانسور کوچکتر برای مطابقت با شکل تانسور بزرگتر پخش میشود. پخش از دو مرحله تشکیل شده است:
- محورهایی (که محورهای پخش نامیده میشوند) به تانسور کوچکتر اضافه میشوند تا با
ndimتانسور بزرگتر مطابقت داشته باشند. - تانسور کوچکتر در کنار این محورهای جدید تکرار میشود تا با شکل کامل تانسور بزرگتر مطابقت داشته باشد.
بیایید به یک مثال عینی نگاه کنیم. X با شکل (32, 10) و y با شکل (10,) را در نظر بگیرید:
import numpy as np
# X is a random matrix with shape (32, 10).X = np.random.random((32, 10))# y is a random vector with shape (10,).y = np.random.random((10,))
ابتدا، یک محور اول خالی به y اضافه میکنیم که شکل آن (1, 10) میشود:
# The shape of y is now (1, 10).y = np.expand_dims(y, axis=0)سپس، y را ۳۲ بار در کنار این محور جدید تکرار میکنیم، بهطوری که در نهایت یک تانسور Y با شکل (32, 10) به دست میآوریم، که در آن Y[i, :] == y برای i در range(0, 32):
# Repeat y 32 times along axis 0 to obtain Y with shape (32, 10).Y = np.tile(y, (32, 1))در این مرحله، میتوانیم X و Y را جمع کنیم چون شکل یکسانی دارند.
از نظر پیادهسازی، هیچ تانسور جدید مرتبهٔ ۲ ایجاد نمیشود چون این کار بهشدت ناکارآمد خواهد بود. عملیات تکرار کاملاً مجازی است: در سطح الگوریتمی اتفاق میافتد نه در سطح حافظه. اما فکر کردن به بردار که ۳۲ بار در کنار یک محور جدید تکرار میشود یک مدل ذهنی مفید است. این یک پیادهسازی سادهٔ آن خواهد بود:
def naive_add_matrix_and_vector(x, y): # x is a rank-2 NumPy tensor. assert len(x.shape) == 2 # y is a NumPy vector. assert len(y.shape) == 1 assert x.shape[1] == y.shape[0] # Avoids overwriting the input tensor x = x.copy() for i in range(x.shape[0]): for j in range(x.shape[1]): x[i, j] += y[j] return xبا پخش، بهطور کلی میتوانید عملیات عنصر به عنصر دو تانسوری را اعمال کنید اگر یک تانسور شکل (a, b, … n, n + 1, … m) و دیگری شکل (n, n + 1, … m) داشته باشد. پخش سپس بهطور خودکار برای محورهای a تا n - 1 اتفاق میافتد.
مثال زیر عملیات maximum عنصر به عنصر را روی دو تانسور با شکلهای مختلف از طریق پخش اعمال میکند:
import numpy as np
# x is a random tensor with shape (64, 3, 32, 10).x = np.random.random((64, 3, 32, 10))# y is a random tensor with shape (32, 10).y = np.random.random((32, 10))# The output z has shape (64, 3, 32, 10) like x.z = np.maximum(x, y)
ضرب تانسوری
Section titled “ضرب تانسوری”ضرب تانسوری، که ضرب نقطهای یا matmul (مخفف «ضرب ماتریسی») نیز نامیده میشود، یکی از رایجترین و مفیدترین عملیات تانسوری است.
در NumPy، ضرب تانسوری با تابع np.matmul انجام میشود و در Keras با تابع keras.ops.matmul. نحو مختصر آن عملگر @ در پایتون است:
x = np.random.random((32,))y = np.random.random((32,))
# Takes the product between x and yz = np.matmul(x, y)# This is equivalent.z = x @ y
در نمادگذاری ریاضی، این عملیات را با یک نقطه (•) یادداشت میکنید (از این رو نام «ضرب نقطهای»):
z = x • yاز نظر ریاضی، عملیات matmul چه کاری انجام میدهد؟ بیایید با ضرب دو بردار x و y شروع کنیم. به شرح زیر محاسبه میشود:
def naive_vector_product(x, y): # x and y are NumPy vectors. assert len(x.shape) == 1 assert len(y.shape) == 1 assert x.shape[0] == y.shape[0] z = 0.0 for i in range(x.shape[0]): z += x[i] * y[i] return zمتوجه شدهاید که حاصلضرب دو بردار یک اسکالر است و فقط بردارهایی با تعداد عناصر یکسان برای این عملیات سازگار هستند.
همچنین میتوانید حاصلضرب یک ماتریس x و یک بردار y را بگیرید، که برداری را برمیگرداند که در آن ضرایب حاصلضربهای بین y و سطرهای x هستند. آن را به شرح زیر پیادهسازی میکنید:
def naive_matrix_vector_product(x, y): # x is a NumPy matrix. assert len(x.shape) == 2 # y is a NumPy vector. assert len(y.shape) == 1 # The 1st dimension of x must equal the 0th dimension of y! assert x.shape[1] == y.shape[0] # This operation returns a vector of 0s with as many rows as x. z = np.zeros(x.shape[0]) for i in range(x.shape[0]): for j in range(x.shape[1]): z[i] += x[i, j] * y[j] return zهمچنین میتوانستید از کدی که قبلاً نوشتیم دوباره استفاده کنید، که رابطهٔ بین حاصلضرب ماتریس-بردار و حاصلضرب بردار را برجسته میکند:
def naive_matrix_vector_product(x, y): z = np.zeros(x.shape[0]) for i in range(x.shape[0]): z[i] = naive_vector_product(x[i, :], y) return zتوجه داشته باشید که بهمحض اینکه یکی از دو تانسور ndim بزرگتر از ۱ داشته باشد، matmul دیگر متقارن نیست، یعنی matmul(x, y) با matmul(y, x) یکسان نیست.
البته، ضرب تانسوری به تانسورهایی با تعداد دلخواهی از محورها تعمیم مییابد. رایجترین کاربردها ممکن است حاصلضرب بین دو ماتریس باشد. میتوانید حاصلضرب دو ماتریس x و y (matmul(x, y)) را بگیرید اگر و تنها اگر x.shape[1] == y.shape[0]. نتیجه یک ماتریس با شکل (x.shape[0], y.shape[1]) است، که در آن ضرایب حاصلضربهای برداری بین سطرهای x و ستونهای y هستند. این پیادهسازی سادهٔ آن است:
def naive_matrix_product(x, y): # x and y are NumPy matrices. assert len(x.shape) == 2 assert len(y.shape) == 2 # The 1st dimension of x must equal the 0th dimension of y! assert x.shape[1] == y.shape[0] # This operation returns a matrix of 0s with a specific shape. z = np.zeros((x.shape[0], y.shape[1])) # Iterates over the rows of x ... for i in range(x.shape[0]): # ... and over the columns of y. for j in range(y.shape[1]): row_x = x[i, :] column_y = y[:, j] z[i, j] = naive_vector_product(row_x, column_y) return zبرای درک سازگاری شکل حاصلضرب برداری، کمک میکند تانسورهای ورودی و خروجی را همانطور که در شکل ۲.۵ نشان داده شده تراز کنید.
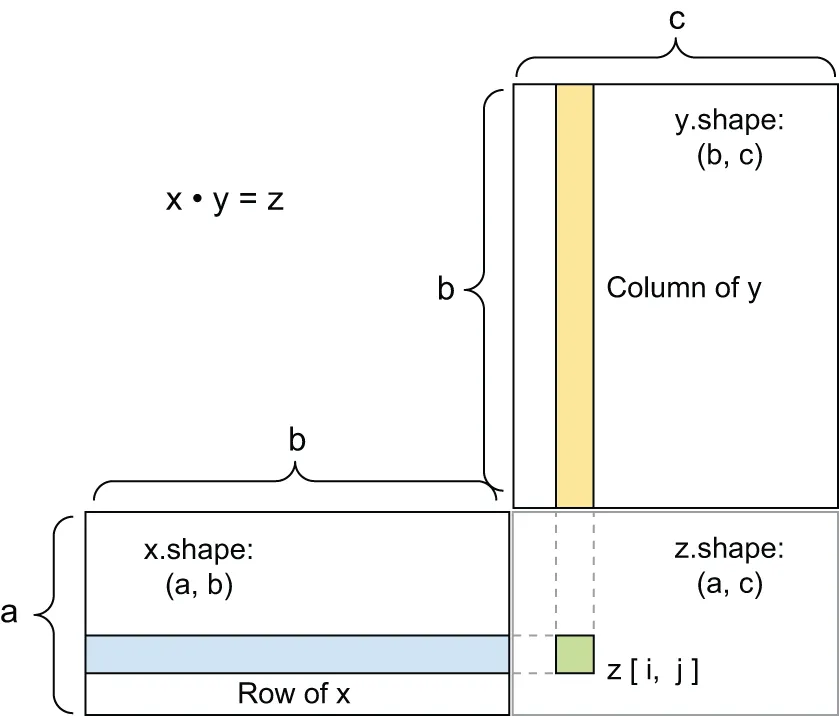
شکل ۲.۵: نمودار جعبهای حاصلضرب ماتریسی
x، y و z بهصورت مستطیلهایی (جعبههای تحتاللفظی ضرایب) تصویر شدهاند. از آنجا که سطرهای x و ستونهای y باید اندازهٔ یکسانی داشته باشند، نتیجه میشود که عرض x باید با ارتفاع y مطابقت داشته باشد. اگر بعداً الگوریتمهای یادگیری ماشین جدیدی توسعه دهید، احتمالاً اغلب چنین نمودارهایی رسم خواهید کرد.
بهطور کلیتر، میتوانید حاصلضرب بین تانسورهای با ابعاد بالاتر را بگیرید، با پیروی از همان قواعد سازگاری شکل که برای حالت 2D بیان شد:
(a, b, c, d) • (d,) -> (a, b, c)(a, b, c, d) • (d, e) -> (a, b, c, e)و به همین ترتیب.
تغییر شکل تانسور
Section titled “تغییر شکل تانسور”نوع سومی از عملیات تانسوری که درک آن ضروری است تغییر شکل تانسور است. اگرچه در لایههای Dense در مثال اول شبکهٔ عصبی ما استفاده نشد، ما از آن هنگام پیشپردازش دادههای ارقام قبل از تغذیه به مدل استفاده کردیم:
train_images = train_images.reshape((60000, 28 * 28))تغییر شکل یک تانسور به معنای مرتبسازی مجدد سطرها و ستونهای آن برای مطابقت با یک شکل هدف است. طبیعتاً، تانسور تغییر شکلیافته همان تعداد کل ضرایب تانسور اولیه را دارد. تغییر شکل با مثالهای ساده به بهترین شکل درک میشود:
>>> x = np.array([[0., 1.],... [2., 3.],... [4., 5.]])>>> x.shapeیک مورد خاص از تغییر شکل که معمولاً با آن روبرو میشوید جابهجایی است. جابهجا کردن یک ماتریس به معنای مبادلهٔ سطرها و ستونهای آن است، بهطوری که x[i, :] تبدیل به x[:, i] شود:
>>> # Creates an all-zeros matrix of shape (300, 20)>>> x = np.zeros((300, 20))>>> x = np.transpose(x)>>> x.shapeتفسیر هندسی عملیات تانسوری
Section titled “تفسیر هندسی عملیات تانسوری”از آنجا که محتویات تانسورهای دستکاریشده توسط عملیات تانسوری میتوانند بهعنوان مختصات نقاط در برخی فضای هندسی تفسیر شوند، همهٔ عملیات تانسوری یک تفسیر هندسی دارند. برای مثال، جمع را در نظر بگیرید. با بردار زیر شروع میکنیم:
A = [0.5, 1]این یک نقطه در یک فضای دوبعدی است (شکل ۲.۶ را ببینید). رایج است که یک بردار را بهصورت یک پیکان که مبدأ را به نقطه متصل میکند تصویر کنید، همانطور که در شکل ۲.۷ نشان داده شده است.
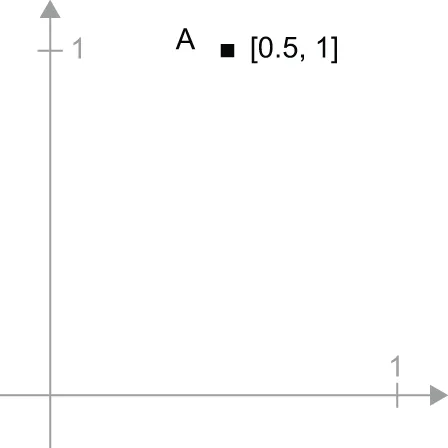
شکل ۲.۶: یک نقطه در یک فضای دوبعدی
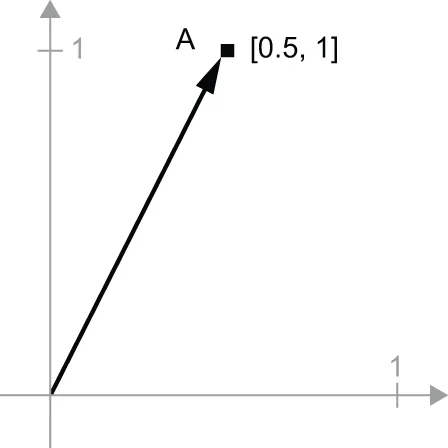
شکل ۲.۷: یک نقطه در یک فضای دوبعدی که بهصورت یک پیکان تصویر شده است
بیایید یک نقطهٔ جدید، B = [1, 0.25] را در نظر بگیریم که آن را به نقطهٔ قبلی اضافه میکنیم. این کار از نظر هندسی با زنجیره کردن پیکانهای بردار انجام میشود، با مکان حاصل بهعنوان برداری که مجموع دو بردار قبلی را نشان میدهد (شکل ۲.۸ را ببینید). همانطور که میبینید، جمع بردار B به بردار A نشاندهندهٔ عمل کپی کردن نقطهٔ A در مکان جدید است، که فاصله و جهت آن از نقطهٔ اصلی A توسط بردار B تعیین میشود. اگر همان جمع بردار را به گروهی از نقاط در صفحه (یک «شیء») اعمال کنید، در حال ایجاد یک کپی از کل شیء در یک مکان جدید هستید (شکل ۲.۹ را ببینید). بنابراین جمع تانسوری نشاندهندهٔ عمل انتقال یک شیء (حرکت دادن شیء بدون تغییر شکل آن) به مقدار معینی در جهت معین است.
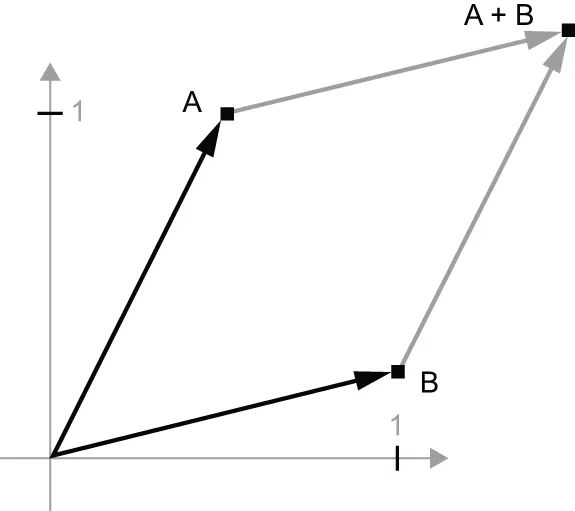
شکل ۲.۸: تفسیر هندسی جمع دو بردار
بهطور کلی، عملیات هندسی ابتدایی، مانند انتقال، چرخش، مقیاسبندی، کجکردن و غیره، میتوانند بهصورت عملیات تانسوری بیان شوند. در اینجا چند مثال آورده شده است:
- انتقال — همانطور که دیدید، جمع یک بردار به یک نقطه، این نقطه را به مقدار ثابتی در جهت ثابتی حرکت میدهد. اعمالشده به مجموعهای از نقاط (مانند یک شیء دوبعدی)، این «انتقال» نامیده میشود (شکل ۲.۹ را ببینید).
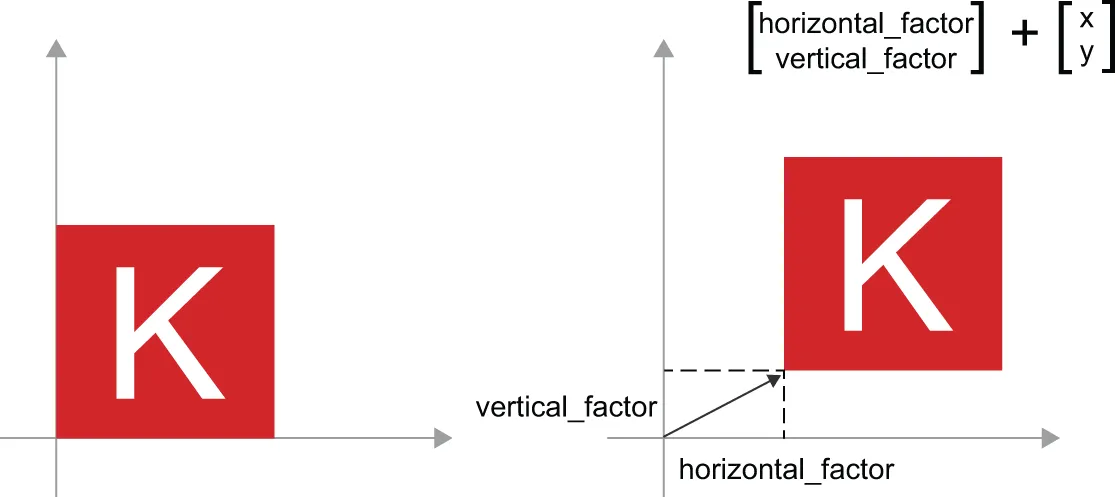
شکل ۲.۹: انتقال دوبعدی بهصورت جمع برداری
- چرخش — چرخش پادساعتگرد یک بردار دوبعدی با زاویهٔ تتا (شکل ۲.۱۰ را ببینید) میتواند از طریق حاصلضرب با یک ماتریس ۲×۲
R = [[cos(theta), -sin(theta)], [sin(theta), cos(theta)]]به دست آید.
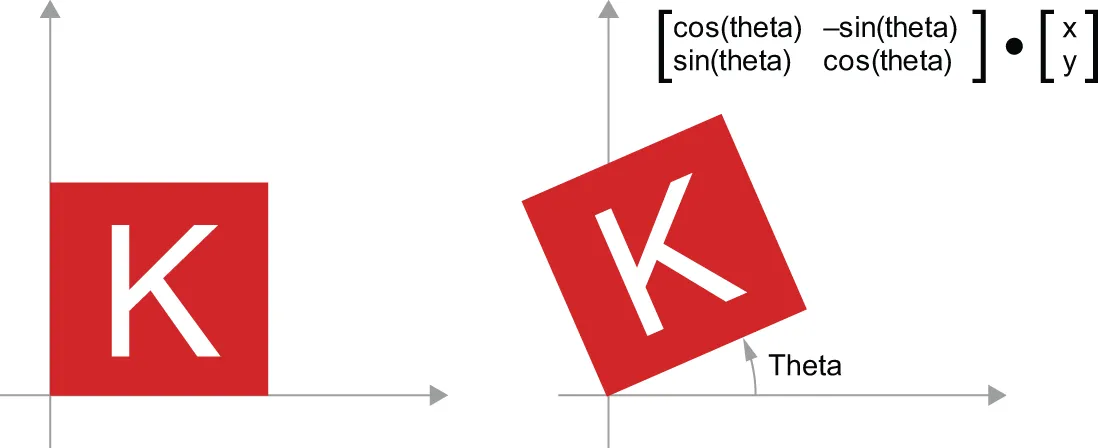
شکل ۲.۱۰: چرخش دوبعدی (پادساعتگرد) بهصورت حاصلضرب ماتریسی
- مقیاسبندی — مقیاسبندی عمودی و افقی تصویر (شکل ۲.۱۱ را ببینید) میتواند از طریق حاصلضرب با یک ماتریس ۲×۲
S = [[horizontal_factor, 0], [0, vertical_factor]]به دست آید (توجه داشته باشید که چنین ماتریسی «ماتریس قطری» نامیده میشود زیرا فقط ضرایب غیرصفر در «قطر» خود دارد، از بالا سمت چپ به پایین سمت راست).
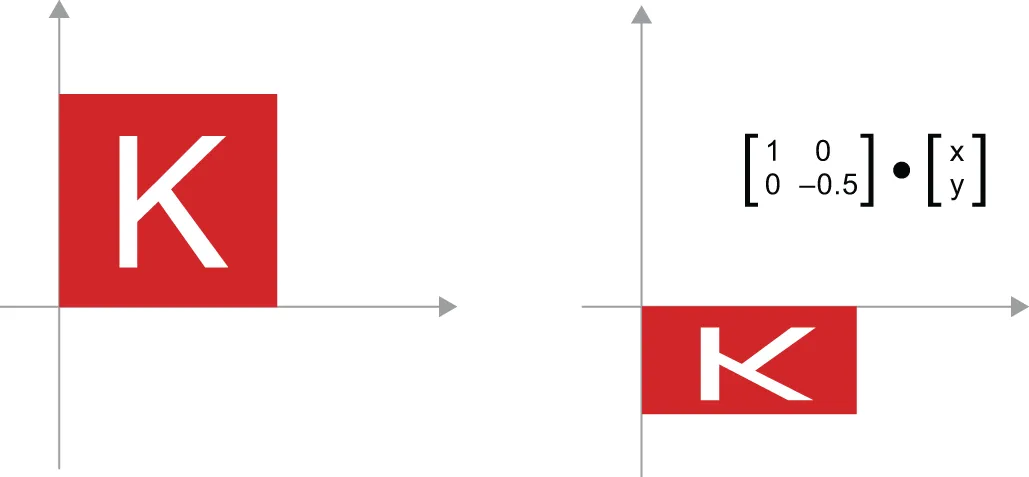
شکل ۲.۱۱: مقیاسبندی دوبعدی بهصورت حاصلضرب ماتریسی
- تبدیل خطی — حاصلضرب با یک ماتریس دلخواه یک تبدیل خطی را پیادهسازی میکند. توجه داشته باشید که مقیاسبندی و چرخش که قبلاً دیده شد، طبق تعریف، تبدیلهای خطی هستند.
- تبدیل آفین — یک تبدیل آفین (شکل ۲.۱۲ را ببینید) ترکیب یک تبدیل خطی (که از طریق حاصلضرب ماتریسی به دست میآید) و یک انتقال (که از طریق جمع برداری به دست میآید) است. همانطور که احتمالاً تشخیص دادهاید، این دقیقاً محاسبهٔ
y = W @ x + bاست که توسط لایهٔDenseپیادهسازی میشود! یک لایهٔDenseبدون تابع فعالسازی یک لایهٔ آفین است.
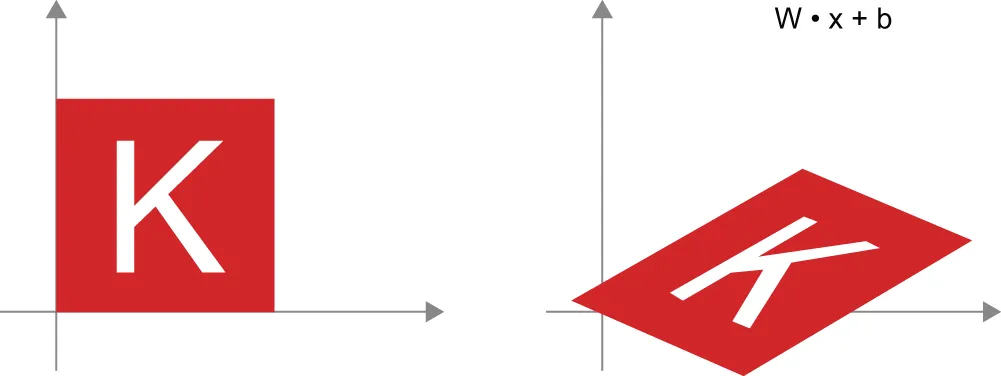
شکل ۲.۱۲: تبدیل آفین در صفحه
- لایهٔ
Denseبا فعالسازیrelu— یک مشاهدهٔ مهم دربارهٔ تبدیلهای آفین این است که اگر بسیاری از آنها را بهطور مکرر اعمال کنید، هنوز در نهایت یک تبدیل آفین به دست میآورید (بنابراین میتوانستید همان یک تبدیل آفین را در وهلهٔ اول اعمال کنید). بیایید با دو تا امتحان کنیم:affine2(affine1(x)) = W2 @ (W1 @ x + b1) + b2 = (W2 @ W1) @ x + (W2 @ b1 + b2). این یک تبدیل آفین است که در آن بخش خطی ماتریسW2 @ W1و بخش انتقال بردارW2 @ b1 + b2است. در نتیجه، یک شبکهٔ عصبی چندلایه که کاملاً از لایههایDenseبدون فعالسازی ساخته شده باشد، معادل یک لایهٔDenseواحد خواهد بود. این شبکهٔ عصبی «عمیق» فقط یک مدل خطی در لباس مبدل خواهد بود! به همین دلیل است که به توابع فعالسازی، مانندrelu(که در شکل ۲.۱۳ در عمل دیده میشود)، نیاز داریم. به لطف توابع فعالسازی، زنجیرهای از لایههایDenseمیتواند تبدیل هندسی غیرخطی بسیار پیچیدهای را پیادهسازی کند، که منجر به فضاهای فرضیهٔ بسیار غنی برای شبکههای عصبی عمیق شما میشود. این ایده را با جزئیات بیشتر در فصل بعد پوشش میدهیم.
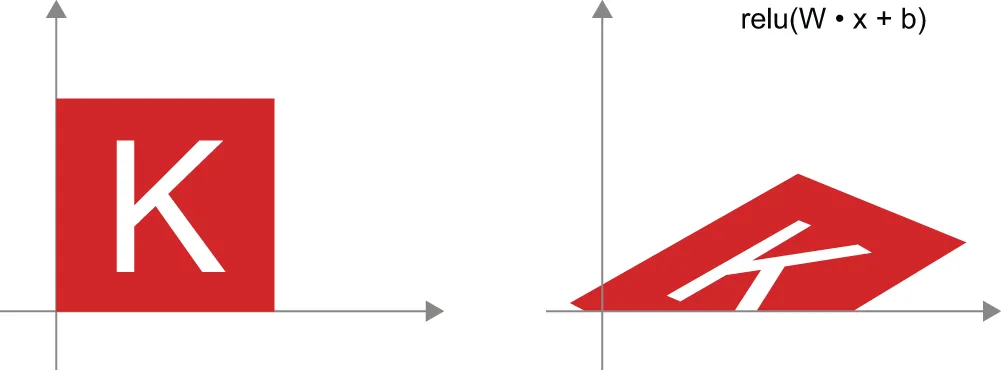
شکل ۲.۱۳: تبدیل آفین و سپس فعالسازی relu
تفسیر هندسی یادگیری عمیق
Section titled “تفسیر هندسی یادگیری عمیق”شما همین الان یاد گرفتید که شبکههای عصبی کاملاً از زنجیرههایی از عملیات تانسوری تشکیل شدهاند و همهٔ این عملیات تانسوری صرفاً تبدیلهای هندسی سادهٔ دادههای ورودی هستند. نتیجه میشود که میتوانید یک شبکهٔ عصبی را بهعنوان یک تبدیل هندسی بسیار پیچیده در یک فضای با ابعاد بالا تفسیر کنید که از طریق مجموعهای از مراحل ساده پیادهسازی میشود.
در ۳D، تصویر ذهنی زیر ممکن است مفید باشد. دو ورق کاغذ رنگی را تصور کنید: یکی قرمز و یکی آبی. یکی را روی دیگری قرار دهید. حالا آنها را با هم به شکل یک توپ کوچک مچاله کنید. آن توپ کاغذی مچالهشده دادهٔ ورودی شماست و هر ورق کاغذ یک کلاس داده در یک مسئلهٔ طبقهبندی است. آنچه یک شبکهٔ عصبی قرار است انجام دهد این است که تبدیلی از توپ کاغذی بیابد که آن را باز کند تا دو کلاس دوباره بهطور تمیز قابل تفکیک شوند (شکل ۲.۱۴ را ببینید). با یادگیری عمیق، این کار بهصورت مجموعهای از تبدیلهای سادهٔ فضای 3D پیادهسازی میشود، مانند آنچه میتوانستید با انگشتان خود روی توپ کاغذی اعمال کنید، یک حرکت در یک زمان.
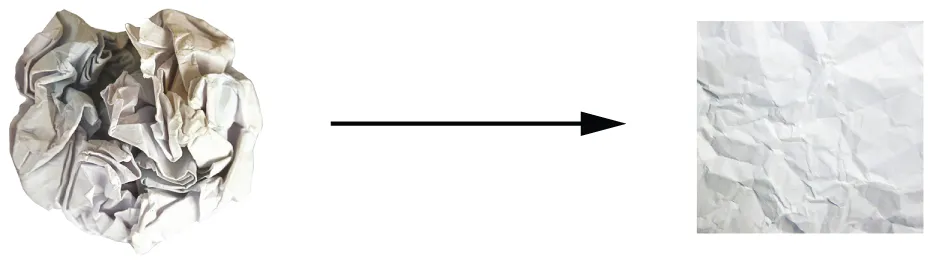
شکل ۲.۱۴: باز کردن یک منیفولد پیچیده از داده
باز کردن توپهای کاغذی همان چیزی است که یادگیری ماشین دربارهٔ آن است: یافتن بازنماییهای تمیز برای منیفولدهای دادهٔ پیچیده و بهشدت تاشده در فضاهای با ابعاد بالا (منیفولد یک سطح پیوسته است، مانند ورق کاغذ مچالهشدهٔ ما). در این مرحله، باید شهود نسبتاً خوبی داشته باشید که چرا یادگیری عمیق در این کار عالی است: این رویکرد تجزیهٔ تدریجی یک تبدیل هندسی پیچیده به زنجیرهای بلند از تبدیلهای ابتدایی را در پیش میگیرد، که تقریباً همان استراتژیای است که یک انسان برای باز کردن یک توپ کاغذی دنبال میکند. هر لایه در یک شبکهٔ عمیق تبدیلی را اعمال میکند که داده را کمی از هم باز میکند — و یک پشتهٔ عمیق از لایهها فرآیند باز کردن بسیار پیچیدهای را قابل حل میکند.
موتور شبکههای عصبی: بهینهسازی مبتنی بر گرادیان
Section titled “موتور شبکههای عصبی: بهینهسازی مبتنی بر گرادیان”همانطور که در بخش قبل دیدید، هر لایهٔ عصبی از مثال مدل اول ما دادههای ورودی خود را به شرح زیر تبدیل میکند:
output = relu(matmul(input, W) + b)در این عبارت، W و b تانسورهایی هستند که ویژگیهای لایه هستند. آنها وزنها یا پارامترهای آموزشپذیر لایه نامیده میشوند (بهترتیب ویژگیهای kernel و bias). این وزنها حاوی اطلاعاتی هستند که مدل از طریق قرار گرفتن در معرض دادههای آموزشی یاد گرفته است.
در ابتدا، این ماتریسهای وزن با مقادیر تصادفی کوچک پر میشوند (مرحلهای به نام مقداردهی تصادفی). البته، هیچ دلیلی وجود ندارد که انتظار داشته باشیم relu(matmul(input, W) + b) وقتی W و b تصادفی هستند، بازنماییهای مفیدی تولید کند. بازنماییهای حاصل بیمعنی هستند — اما آنها یک نقطهٔ شروع هستند. آنچه در ادامه میآید تنظیم تدریجی این وزنها بر اساس یک سیگنال بازخورد است. این تنظیم تدریجی، که آموزش نیز نامیده میشود، اساساً همان یادگیری است که یادگیری ماشین دربارهٔ آن است.
این اتفاق در چیزی به نام حلقهٔ آموزش رخ میدهد که به شرح زیر کار میکند. این مراحل را در یک حلقه تکرار کنید تا زیان بهاندازهٔ کافی پایین به نظر برسد:
- یک دسته از نمونههای آموزشی
xو اهداف متناظرy_trueرا انتخاب کنید. - مدل را روی
xاجرا کنید (مرحلهای به نام گذر رو به جلو ) تا پیشبینیهایy_predبه دست آید. - زیان مدل را روی دسته محاسبه کنید، معیاری از عدم تطابق بین
y_predوy_true. - تمام وزنهای مدل را بهگونهای بهروزرسانی کنید که زیان روی این دسته کمی کاهش یابد.
در نهایت به مدلی میرسید که زیان بسیار پایینی روی دادههای آموزشی خود دارد: عدم تطابق پایین بین پیشبینیهای y_pred و اهداف مورد انتظار y_true. مدل «یاد گرفته است» ورودیهای خود را به اهداف صحیح نگاشت دهد. از دور، ممکن است شبیه جادو به نظر برسد، اما وقتی آن را به مراحل ابتدایی تقلیل دهید، معلوم میشود که ساده است.
مرحلهٔ ۱ بهاندازهٔ کافی آسان به نظر میرسد — فقط کد I/O است. مراحل ۲ و ۳ صرفاً اعمال تعداد انگشتشماری عملیات تانسوری هستند، بنابراین میتوانستید این مراحل را صرفاً از آنچه در بخش قبل یاد گرفتید پیادهسازی کنید. بخش دشوار مرحلهٔ ۴ است: بهروزرسانی وزنهای مدل. با توجه به یک ضریب وزن منفرد در مدل، چگونه میتوانید محاسبه کنید که آیا ضریب باید افزایش یابد یا کاهش یابد، و چقدر؟
یک راهحل ساده این است که همهٔ وزنهای مدل را ثابت نگه دارید بهجز ضریب اسکالری که در نظر گرفته میشود و مقادیر مختلفی را برای این ضریب امتحان کنید. فرض کنید مقدار اولیهٔ ضریب ۰.۳ است. پس از گذر رو به جلو روی یک دسته داده، زیان مدل روی دسته ۰.۵ است. اگر مقدار ضریب را به ۰.۳۵ تغییر دهید و گذر رو به جلو را دوباره اجرا کنید، زیان به ۰.۶ افزایش مییابد. اما اگر ضریب را به ۰.۲۵ کاهش دهید، زیان به ۰.۴ میرسد. در این حالت، به نظر میرسد که بهروزرسانی ضریب با –۰.۰۵ به کمینهسازی زیان کمک میکند. این کار باید برای همهٔ ضرایب مدل تکرار شود.
اما چنین رویکردی بهطور وحشتناکی ناکارآمد خواهد بود زیرا برای هر ضریب منفرد (که تعدادشان زیاد است، معمولاً حداقل چند هزار و بهطور بالقوه تا میلیاردها) باید دو گذر رو به جلو (که گران هستند) محاسبه کنید. خوشبختانه، رویکرد بسیار بهتری وجود دارد: نزول گرادیان.
نزول گرادیان تکنیک بهینهسازی است که شبکههای عصبی مدرن را نیرو میدهد. ایدهٔ اصلی آن این است. همهٔ توابعی که در مدلهای ما استفاده میشوند (مانند matmul یا +) ورودی خود را بهصورت صاف و پیوسته تبدیل میکنند: اگر به z = x + y نگاه کنید، برای مثال، یک تغییر کوچک در y تنها منجر به یک تغییر کوچک در z میشود، و اگر جهت تغییر در y را بدانید، میتوانید جهت تغییر در z را استنتاج کنید. از نظر ریاضی، میگویید این توابع مشتقپذیر هستند. اگر چنین توابعی را زنجیره کنید، تابع بزرگتری که به دست میآورید هنوز مشتقپذیر است. بهطور خاص، این در مورد تابعی که ضرایب مدل را به زیان مدل روی یک دسته داده نگاشت میکند صدق میکند: یک تغییر کوچک در ضرایب مدل منجر به یک تغییر کوچک و قابل پیشبینی در مقدار زیان میشود. این شما را قادر میسازد از عملگر ریاضی به نام گرادیان برای توصیف چگونگی تغییر زیان هنگام حرکت ضرایب مدل در جهات مختلف استفاده کنید. اگر این گرادیان را محاسبه کنید، میتوانید از آن برای حرکت ضرایب (همه بهطور همزمان در یک بهروزرسانی واحد، نه یکییکی) در جهتی که زیان را کاهش میدهد استفاده کنید.
اگر از قبل میدانید مشتقپذیر به چه معناست و گرادیان چیست، میتوانید دو بخش بعدی را نادیده بگیرید. در غیر این صورت، موارد زیر به شما کمک میکند این مفاهیم را درک کنید.
مشتق چیست؟
Section titled “مشتق چیست؟”یک تابع پیوسته و صاف f(x) = y را در نظر بگیرید که یک عدد x را به یک عدد جدید y نگاشت میکند. میتوانیم از تابع در شکل ۲.۱۵ بهعنوان مثال استفاده کنیم.
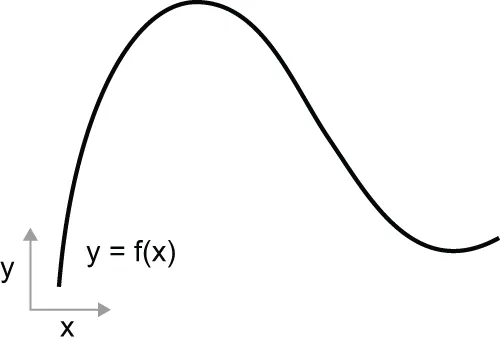
شکل ۲.۱۵: یک تابع پیوسته و صاف
از آنجا که تابع پیوسته است، یک تغییر کوچک در x تنها میتواند منجر به یک تغییر کوچک در y شود — این شهود پشت پیوستگی است. فرض کنید x را با یک عامل کوچک epsilon_x افزایش میدهید: این منجر به یک تغییر کوچک epsilon_y در y میشود، همانطور که در شکل ۲.۱۶ نشان داده شده است.
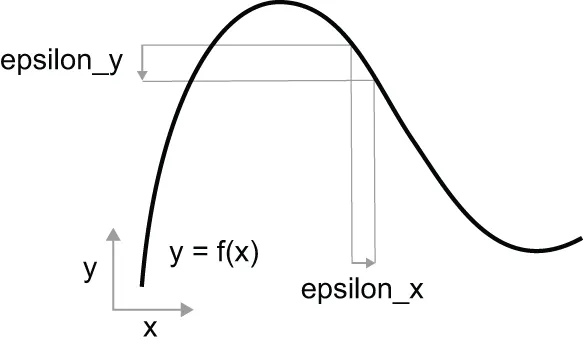
شکل ۲.۱۶: با یک تابع پیوسته، یک تغییر کوچک در x منجر به یک تغییر کوچک در y میشود.
علاوه بر این، از آنجا که تابع صاف است (منحنی آن هیچ زاویهٔ تندی ندارد)، وقتی epsilon_x بهاندازهٔ کافی کوچک باشد، حول یک نقطهٔ خاص p، میتوان f را بهصورت یک تابع خطی با شیب a تقریب زد، بهطوری که epsilon_y برابر با a * epsilon_x شود:
f(x + epsilon_x) = y + a * epsilon_xبدیهی است که این تقریب خطی تنها زمانی معتبر است که x بهاندازهٔ کافی نزدیک به p باشد.
شیب a مشتق f در p نامیده میشود. اگر a منفی باشد، به این معنی است که یک افزایش کوچک در x حول p منجر به کاهش f(x) میشود، همانطور که در شکل ۲.۱۷ نشان داده شده است، و اگر a مثبت باشد، یک افزایش کوچک در x منجر به افزایش f(x) میشود. علاوه بر این، قدر مطلق a (بزرگی مشتق) به شما میگوید این افزایش یا کاهش چقدر سریع اتفاق میافتد.
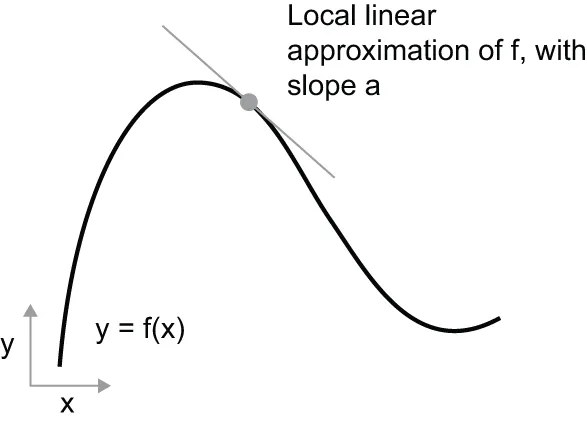
شکل ۲.۱۷: مشتق f در p
برای هر تابع مشتقپذیر f(x) (مشتقپذیر یعنی «قابل مشتقگیری است»: برای مثال، توابع صاف و پیوسته مشتقپذیر هستند)، یک تابع مشتق f'(x) وجود دارد که مقادیر x را به شیب تقریب خطی محلی f در آن نقاط نگاشت میکند. برای مثال، مشتق cos(x) برابر -sin(x) است، مشتق f(x) = a * x برابر f'(x) = a است و غیره.
توانایی مشتقگیری توابع ابزار بسیار قدرتمندی است وقتی صحبت از بهینهسازی میشود، یعنی وظیفهٔ یافتن مقادیر x که مقدار f(x) را کمینه میکنند. اگر سعی میکنید x را با یک عامل epsilon_x بهروزرسانی کنید تا f(x) را کمینه کنید و مشتق f را میدانید، کارتان تمام است: مشتق کاملاً توصیف میکند که f(x) با تغییر x چگونه تغییر میکند. اگر میخواهید مقدار f(x) را کاهش دهید، فقط باید x را کمی در جهت خلاف مشتق حرکت دهید.
مشتق یک عملیات تانسوری: گرادیان
Section titled “مشتق یک عملیات تانسوری: گرادیان”تابعی که به آن نگاه میکردیم یک مقدار اسکالر x را به یک مقدار اسکالر دیگر y تبدیل میکرد: میتوانستید آن را بهصورت یک منحنی در یک صفحهٔ دوبعدی رسم کنید. حالا، تابعی را تصور کنید که یک تاپل از اسکالرها (x, y) را به یک مقدار اسکالر z تبدیل میکند: این یک عملیات برداری خواهد بود. میتوانستید آن را بهصورت یک سطح دوبعدی در یک فضای 3D رسم کنید (که با مختصات x, y, z ایندکس میشود). به همین ترتیب، میتوانید توابعی را تصور کنید که بهعنوان ورودی ماتریس میگیرند، توابعی که بهعنوان ورودی تانسورهای مرتبهٔ ۳ میگیرند و غیره.
مفهوم مشتقگیری میتواند به هر چنین تابعی اعمال شود، تا زمانی که سطوح توصیفشده توسط آنها پیوسته و صاف باشند. مشتق یک عملیات تانسوری (یا تابع تانسوری) گرادیان نامیده میشود. گرادیانها فقط تعمیم مفهوم مشتق به توابعی هستند که تانسورها را بهعنوان ورودی میگیرند. به یاد بیاورید که چگونه برای یک تابع اسکالر، مشتق شیب محلی منحنی تابع را نشان میدهد؟ به همان روش، گرادیان یک تابع تانسوری انحنا سطح چندبعدی توصیفشده توسط تابع را نشان میدهد. این مشخص میکند که خروجی تابع چگونه با تغییر پارامترهای ورودی آن تغییر میکند.
بیایید به یک مثال مبتنی بر یادگیری ماشین نگاه کنیم. در نظر بگیرید
- یک بردار ورودی
x(یک نمونه در یک مجموعهداده) - یک ماتریس
W(وزنهای یک مدل) - یک هدف
y_true(آنچه مدل باید یاد بگیرد بهxمرتبط کند) - یک تابع زیان
loss(برای اندازهگیری شکاف بین پیشبینیهای فعلی مدل وy_true).
میتوانید از W برای محاسبهٔ یک کاندید هدف y_pred و سپس محاسبهٔ زیان، یا عدم تطابق، بین کاندید هدف y_pred و هدف y_true استفاده کنید:
# We use the model weights W to make a prediction for x.y_pred = matmul(x, W)# We estimate how far off the prediction was.loss_value = loss(y_pred, y_true)حالا، میخواهیم از گرادیانها برای فهمیدن چگونگی بهروزرسانی W برای کوچکتر کردن loss_value استفاده کنیم. چگونه این کار را انجام دهیم؟
با توجه به ورودیهای ثابت x و y_true، عملیات قبلی را میتوان بهعنوان تابعی که مقادیر W (وزنهای مدل) را به مقادیر زیان نگاشت میکند تفسیر کرد:
# f describes the curve (or high-dimensional surface) formed by loss# values when W varies.loss_value = f(W)فرض کنید مقدار فعلی W برابر W0 است. سپس مشتق f در نقطهٔ W0 تانسوری است به نام grad(loss_value, W0)، با همان شکل W، که در آن هر ضریب grad(loss_value, W0)[i, j] جهت و بزرگی تغییر در loss_value را نشان میدهد که هنگام تغییر W0[i, j] مشاهده میکنید. آن تانسور grad(loss_value, W0) گرادیان تابع f(W) = loss_value در W0 است، که همچنین «گرادیان loss_value نسبت به W حول W0» نامیده میشود.
بهطور عینی، grad(loss_value, W0) چه چیزی را نشان میدهد؟ قبلاً دیدید که مشتق یک تابع f(x) از یک ضریب منفرد میتواند بهعنوان شیب منحنی f تفسیر شود. به همین ترتیب، grad(loss_value, W0) را میتوان بهعنوان تانسوری توصیفکنندهٔ انحنا loss_value = f(W) حول W0 تفسیر کرد. هر مشتق جزئی انحنای f را در یک جهت خاص توصیف میکند.
ما همین الان دیدیم که برای یک تابع f(x)، میتوانید مقدار f(x) را با حرکت دادن x کمی در جهت خلاف مشتق کاهش دهید. به روشی بسیار مشابه، با یک تابع f(W) از یک تانسور، میتوانید loss_value = f(W) را با حرکت دادن W در جهت خلاف گرادیان کاهش دهید، مانند بهروزرسانی W1 = W0 - step * grad(f(W0), W0) که در آن step یک عامل مقیاسبندی کوچک است. این به معنای رفتن خلاف انحناست، که بهطور شهودی باید شما را پایینتر روی منحنی قرار دهد. توجه داشته باشید که عامل مقیاسبندی step لازم است زیرا grad(loss_value, W0) فقط انحنا را زمانی تقریب میزند که نزدیک W0 باشید، بنابراین نمیخواهید از W0 خیلی دور شوید.
نزول گرادیان تصادفی
Section titled “نزول گرادیان تصادفی”با توجه به یک تابع مشتقپذیر، از نظر تئوری میتوان کمینهٔ آن را بهصورت تحلیلی یافت: مشخص است که کمینهٔ یک تابع نقطهای است که مشتق در آن صفر است، بنابراین تنها کاری که باید انجام دهید یافتن تمام نقاطی است که مشتق به صفر میرسد و بررسی اینکه تابع در کدام یک از این نقاط کمترین مقدار را دارد.
اعمالشده به یک شبکهٔ عصبی، این به معنای یافتن تحلیلی ترکیب مقادیر وزنی است که کوچکترین تابع زیان ممکن را به دست میدهد. این کار با حل معادلهٔ grad(f(W), W) = 0 برای W انجام میشود. این یک معادلهٔ چندجملهای با N متغیر است، که در آن N تعداد ضرایب مدل است. اگرچه حل چنین معادلهای برای N = 2 یا N = 3 ممکن است، اما برای شبکههای عصبی واقعی که تعداد پارامترهایشان هرگز کمتر از چند هزار نیست و گاهی میتواند میلیاردها باشد، غیرقابل حل است.
در عوض، میتوانید از الگوریتم چهار مرحلهای که در ابتدای این بخش شرح داده شد استفاده کنید: پارامترها را بر اساس مقدار زیان فعلی روی یک دسته دادهٔ تصادفی، کمیکمی تغییر دهید. چون با یک تابع مشتقپذیر سر و کار دارید، میتوانید گرادیان آن را محاسبه کنید، که راهی کارآمد برای پیادهسازی مرحلهٔ ۴ به شما میدهد. اگر وزنها را در جهت خلاف گرادیان بهروزرسانی کنید، زیان هر بار کمی کمتر میشود:
- یک دسته از نمونههای آموزشی
xو اهداف متناظرy_trueرا انتخاب کنید. - مدل را روی
xاجرا کنید تا پیشبینیهایy_predبه دست آید (این گذر رو به جلو نامیده میشود). - زیان مدل را روی دسته محاسبه کنید، معیاری از عدم تطابق بین
y_predوy_true. - گرادیان زیان را نسبت به پارامترهای مدل محاسبه کنید (این گذر رو به عقب نامیده میشود).
- پارامترها را کمی در جهت خلاف گرادیان حرکت دهید — برای مثال،
W -= learning_rate * gradient— و بدین ترتیب زیان روی دسته را کمی کاهش دهید. نرخ یادگیری (اینجاlearning_rate) یک عامل اسکالر است که «سرعت» فرآیند نزول گرادیان را تعدیل میکند.
بهاندازهٔ کافی ساده! آنچه توصیف کردیم نزول گرادیان تصادفی با دستهٔ کوچک (mini-batch SGD) نامیده میشود. اصطلاح تصادفی به این واقعیت اشاره دارد که هر دسته داده بهصورت تصادفی انتخاب میشود (تصادفی مترادف علمی تصادفی است). شکل ۲.۱۸ نشان میدهد در حالت 1D چه اتفاقی میافتد، وقتی مدل فقط یک پارامتر دارد و شما فقط یک نمونهٔ آموزشی دارید.
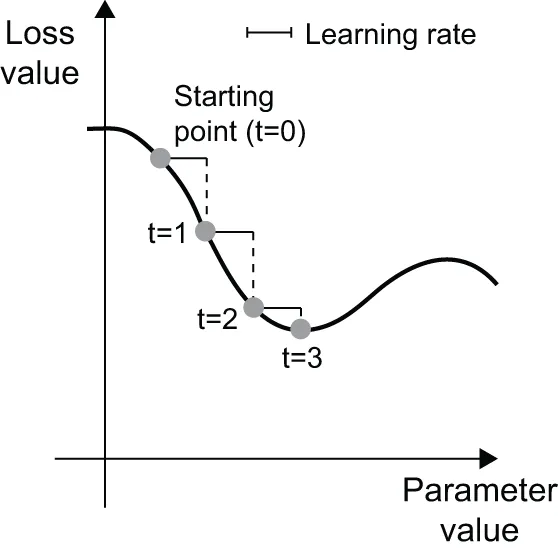
شکل ۲.۱۸: نزول گرادیان تصادفی روی یک منحنی زیان 1D (یک پارامتر یادگیریپذیر)
میتوانیم بهطور شهودی ببینیم که انتخاب یک مقدار معقول برای عامل learning_rate مهم است. اگر خیلی کوچک باشد، فرود در منحنی تکرارهای زیادی طول میکشد و ممکن است در یک کمینهٔ محلی گیر کند. اگر learning_rate خیلی بزرگ باشد، بهروزرسانیهای شما ممکن است شما را به مکانهای کاملاً تصادفی روی منحنی ببرد.
توجه داشته باشید که یک نوع دیگر از الگوریتم SGD با دستهٔ کوچک این است که در هر تکرار یک نمونه و هدف واحد انتخاب کنید، نه یک دسته داده. این SGD واقعی خواهد بود (در مقابل SGD با دستهٔ کوچک). از سوی دیگر، با رفتن به انتهای مخالف، میتوانید هر مرحله را روی تمام دادههای موجود اجرا کنید، که نزول گرادیان دستهای نامیده میشود. هر بهروزرسانی سپس دقیقتر خواهد بود، اما بسیار گرانتر. مصالحهٔ کارآمد بین این دو انتها استفاده از دستههای کوچک با اندازهٔ معقول است.
اگرچه شکل ۲.۱۸ نزول گرادیان را در یک فضای پارامتری 1D نشان میدهد، در عمل از نزول گرادیان در فضاهای بسیار بعدبالا استفاده خواهید کرد: هر ضریب وزن در یک شبکهٔ عصبی یک بُعد آزاد در فضا است و ممکن است دهها هزار یا حتی میلیونها از آنها وجود داشته باشد. برای کمک به ایجاد شهود دربارهٔ سطوح زیان، میتوانید نزول گرادیان را در یک سطح زیان دوبعدی نیز تجسم کنید، همانطور که در شکل ۲.۱۹ نشان داده شده است. اما نمیتوانید بهطور ممکن آنچه فرآیند واقعی آموزش یک شبکهٔ عصبی شبیه آن است را تجسم کنید — نمیتوانید یک فضای ۱,۰۰۰,۰۰۰ بعدی را به شکلی که برای انسان معنادار باشد نمایش دهید. بنابراین، خوب است که به خاطر داشته باشید که شهودی که از طریق این بازنماییهای کمبعد ایجاد میکنید ممکن است در عمل همیشه دقیق نباشند. این از نظر تاریخی منبع مشکلاتی در دنیای تحقیقات یادگیری عمیق بوده است.
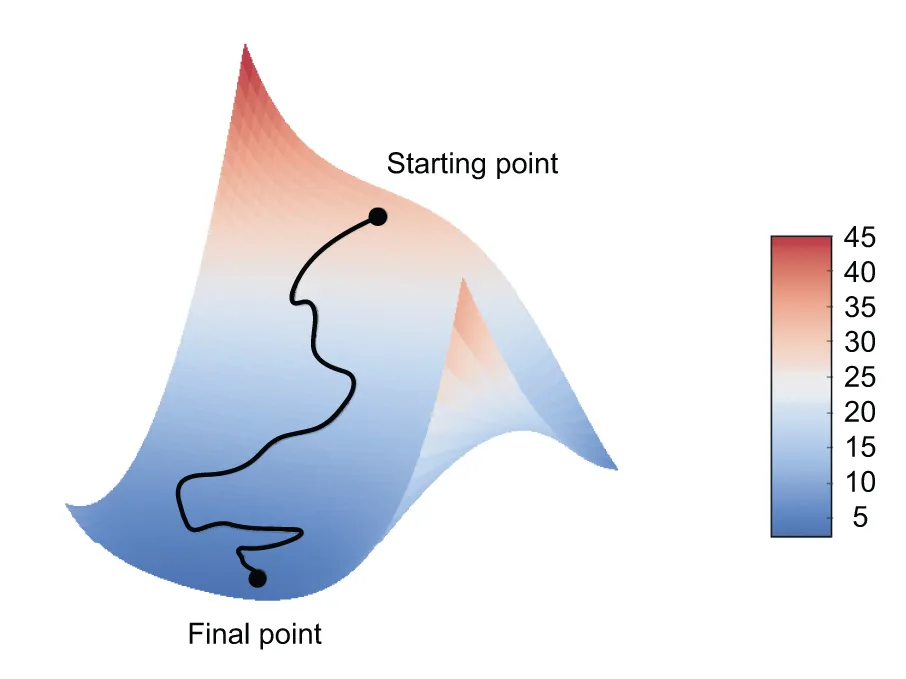
شکل ۲.۱۹: نزول گرادیان روی یک سطح زیان دوبعدی (دو پارامتر یادگیریپذیر)
علاوه بر این، انواع مختلفی از SGD وجود دارد که با در نظر گرفتن بهروزرسانیهای وزنی قبلی هنگام محاسبهٔ بهروزرسانی وزن بعدی، نه فقط نگاه کردن به مقدار فعلی گرادیانها، متفاوت هستند. برای مثال، SGD با مومنتوم، و همچنین Adagrad، RMSprop و چندین مورد دیگر وجود دارد. چنین انواعی بهعنوان روشهای بهینهسازی یا بهینهسازها شناخته میشوند. بهطور خاص، مفهوم مومنتوم که در بسیاری از این انواع استفاده میشود، شایستهٔ توجه شماست. مومنتوم به دو مشکل SGD میپردازد: سرعت همگرایی و کمینههای محلی. شکل ۲.۲۰ را در نظر بگیرید که منحنی زیان را بهعنوان تابعی از یک پارامتر مدل نشان میدهد.
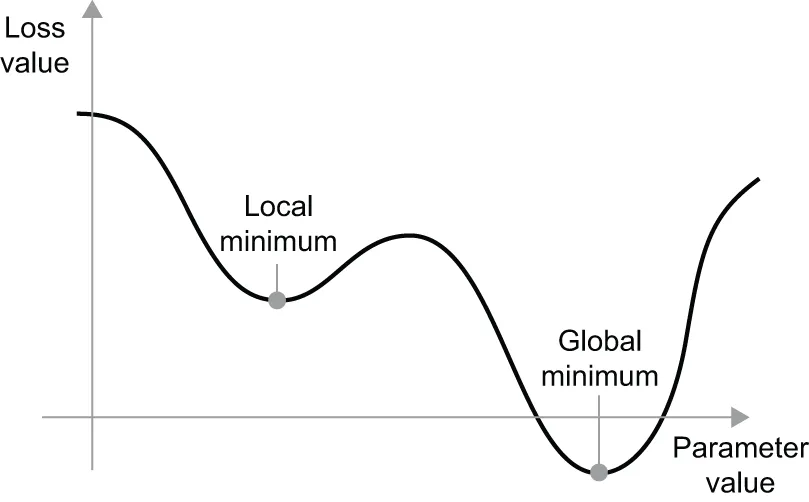
شکل ۲.۲۰: یک کمینهٔ محلی و یک کمینهٔ جهانی
همانطور که میبینید، حول یک مقدار پارامتر خاص، یک کمینهٔ محلی وجود دارد: حول آن نقطه، حرکت به چپ منجر به افزایش زیان میشود، اما حرکت به راست نیز همینطور. اگر پارامتر مورد نظر با SGD با نرخ یادگیری کوچک بهینه میشد، فرآیند بهینهسازی در کمینهٔ محلی گیر میکرد و به کمینهٔ جهانی نمیرسید.
میتوانید با استفاده از مومنتوم، که از فیزیک الهام گرفته شده است، از چنین مشکلاتی اجتناب کنید. یک تصویر ذهنی مفید در اینجا این است که فرآیند بهینهسازی را بهعنوان یک توپ کوچک که در منحنی زیان میغلتد در نظر بگیرید. اگر مومنتوم کافی داشته باشد، توپ در یک دره گیر نمیکند و در نهایت به کمینهٔ جهانی میرسد. مومنتوم با حرکت دادن توپ در هر مرحله بر اساس نهتنها مقدار شیب فعلی (شتاب فعلی) بلکه بر اساس سرعت فعلی (ناشی از شتاب گذشته) پیادهسازی میشود. در عمل، این به معنای بهروزرسانی پارامتر w بر اساس نهتنها مقدار گرادیان فعلی بلکه بر اساس بهروزرسانی پارامتر قبلی است، مانند این پیادهسازی ساده:
past_velocity = 0.0# Constant momentum factormomentum = 0.1# Optimization loopwhile loss > 0.01: w, loss, gradient = get_current_parameters() velocity = past_velocity * momentum - learning_rate * gradient w = w + momentum * velocity - learning_rate * gradient past_velocity = velocity update_parameter(w)زنجیرهسازی مشتقات: الگوریتم پسانتشار
Section titled “زنجیرهسازی مشتقات: الگوریتم پسانتشار”در الگوریتم مورد بحث قبلی، ما بهسادگی فرض کردیم که چون یک تابع مشتقپذیر است، میتوانیم گرادیان آن را بهراحتی محاسبه کنیم. اما آیا این درست است؟ چگونه میتوانیم گرادیان عبارات پیچیده را در عمل محاسبه کنیم؟ در مثال شبکهٔ دولایهٔ ما، چگونه میتوانیم گرادیان زیان نسبت به وزنها را به دست آوریم؟ اینجاست که الگوریتم پسانتشار وارد میشود.
قاعدهٔ زنجیرهای
Section titled “قاعدهٔ زنجیرهای”پسانتشار راهی برای استفاده از مشتق عملیات ساده (مانند جمع، relu یا ضرب تانسوری) برای محاسبهٔ آسان گرادیان ترکیبهای پیچیدهٔ دلخواه از این عملیات اتمی است. بهطور حیاتی، یک شبکهٔ عصبی از بسیاری از عملیات تانسوری زنجیرهشده تشکیل شده است که هر کدام مشتق ساده و شناختهشدهای دارند. برای مثال، مدل مثال اول ما میتواند بهصورت تابعی با پارامترهای W1، b1، W2 و b2 (متعلق به لایههای Dense اول و دوم) بیان شود، که شامل عملیات اتمی matmul، relu، softmax و + و همچنین تابع زیان ما loss است که همه بهراحتی مشتقپذیر هستند:
loss_value = loss( y_true, softmax(matmul(relu(matmul(inputs, W1) + b1), W2) + b2),)حساب دیفرانسیل به ما میگوید که چنین زنجیرهای از توابع را میتوان با استفاده از اتحاد زیر مشتقگیری کرد، که قاعدهٔ زنجیرهای نامیده میشود. دو تابع f و g و همچنین تابع ترکیبی fg را در نظر بگیرید بهطوری که y = fg(x) == f(g(x)):
def fg(x): x1 = g(x) y = f(x1) return yسپس قاعدهٔ زنجیرهای بیان میکند که grad(y, x) == grad(y, x1) * grad(x1, x). این شما را قادر میسازد مشتق fg را محاسبه کنید تا زمانی که مشتقهای f و g را بدانید. قاعدهٔ زنجیرهای به این دلیل نامیده میشود که وقتی توابع میانی بیشتری اضافه میکنید، شبیه یک زنجیره میشود:
def fghj(x):    x1 = j(x)    x2 = h(x1)    x3 = g(x2)    y = f(x3)    return y
grad(y, x) == grad(y, x3) * grad(x3, x2) * grad(x2, x1) * grad(x1, x)
اعمال قاعدهٔ زنجیرهای به محاسبهٔ مقادیر گرادیان یک شبکهٔ عصبی منجر به الگوریتمی به نام پسانتشار میشود. بیایید ببینیم این چگونه بهطور عینی کار میکند.
مشتقگیری خودکار با گرافهای محاسباتی
Section titled “مشتقگیری خودکار با گرافهای محاسباتی”یک راه مفید برای فکر کردن به پسانتشار از نظر گرافهای محاسباتی است. یک گراف محاسباتی ساختار دادهای است که در قلب انقلاب یادگیری عمیق قرار دارد. این یک گراف جهتدار غیرمدور از عملیات است — در مورد ما، عملیات تانسوری. برای مثال، شکل ۲.۲۱ نمایش گراف مدل اول ما است.
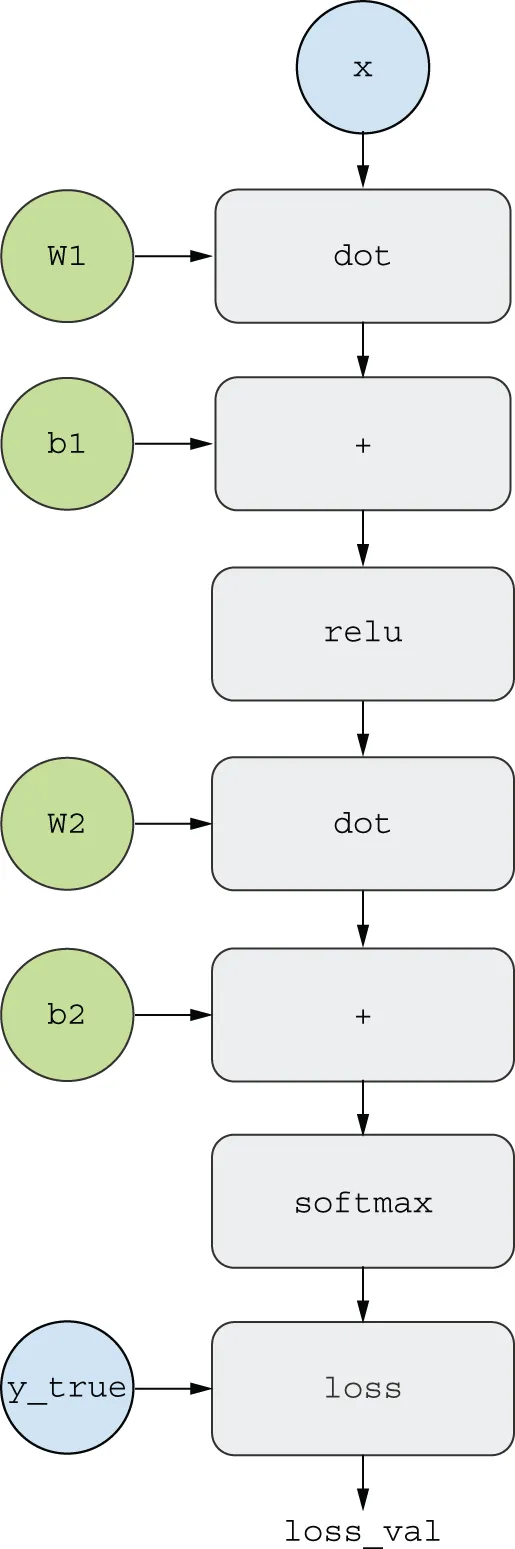
شکل ۲.۲۱: نمایش گراف محاسباتی مدل دولایهٔ ما
گرافهای محاسباتی یک انتزاع بسیار موفق در علوم کامپیوتر بودهاند زیرا به ما امکان میدهند محاسبه را بهعنوان داده رفتار کنیم: یک عبارت قابل محاسبه بهصورت یک ساختار دادهٔ قابل خواندن توسط ماشین کدگذاری میشود که میتواند بهعنوان ورودی یا خروجی یک برنامهٔ دیگر استفاده شود. برای مثال، میتوانید برنامهای را تصور کنید که یک گراف محاسباتی دریافت میکند و یک گراف محاسباتی جدید که نسخهٔ توزیعشدهٔ در مقیاس بزرگ همان محاسبه را پیادهسازی میکند برمیگرداند — این به این معنی است که میتوانید هر محاسبهای را بدون نوشتن منطق توزیع خود توزیع کنید. یا تصور کنید… برنامهای که یک گراف محاسباتی دریافت میکند و میتواند بهطور خودکار مشتق عبارتی که نشان میدهد را تولید کند. انجام این کارها بسیار آسانتر است اگر محاسبهٔ شما بهصورت یک ساختار دادهٔ گراف صریح بیان شود، نه برای مثال، خطوطی از کاراکترهای ASCII در یک فایل .py.
برای توضیح واضح پسانتشار، بیایید به یک مثال واقعاً ابتدایی از یک گراف محاسباتی نگاه کنیم. ما یک نسخهٔ سادهشده از گراف شکل ۲.۲۱ را در نظر میگیریم، که در آن فقط یک لایهٔ خطی داریم و همهٔ متغیرها اسکالر هستند، همانطور که در شکل ۲.۲۲ نشان داده شده است. ما دو متغیر اسکالر w، b، یک ورودی اسکالر x را میگیریم و برخی عملیات را روی آنها اعمال میکنیم تا در یک خروجی y ترکیب شوند. در نهایت، یک تابع زیان خطای قدر مطلق اعمال میکنیم: loss_val = abs(y_true - y). از آنجا که میخواهیم w و b را بهگونهای بهروزرسانی کنیم که loss_val را کمینه کند، به محاسبهٔ grad(loss_val, b) و grad(loss_val, w) علاقهمندیم.
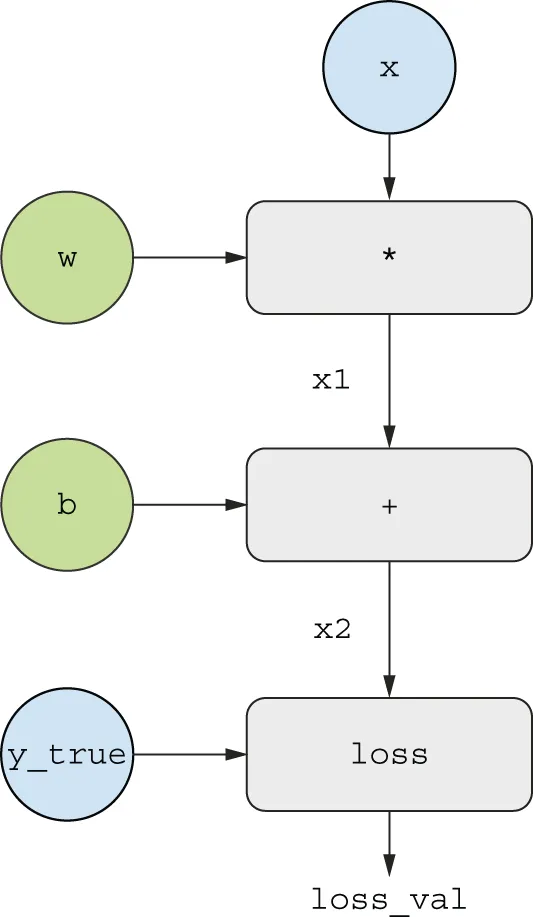
شکل ۲.۲۲: یک مثال ابتدایی از یک گراف محاسباتی
بیایید مقادیر عینی برای “گرههای ورودی” در گراف تعیین کنیم — یعنی ورودی x، هدف y_true، w و b (شکل ۲.۲۳). این مقادیر را به تمام گرههای گراف، از بالا به پایین، منتشر میکنیم تا به loss_val برسیم. این گذر رو به جلو است.
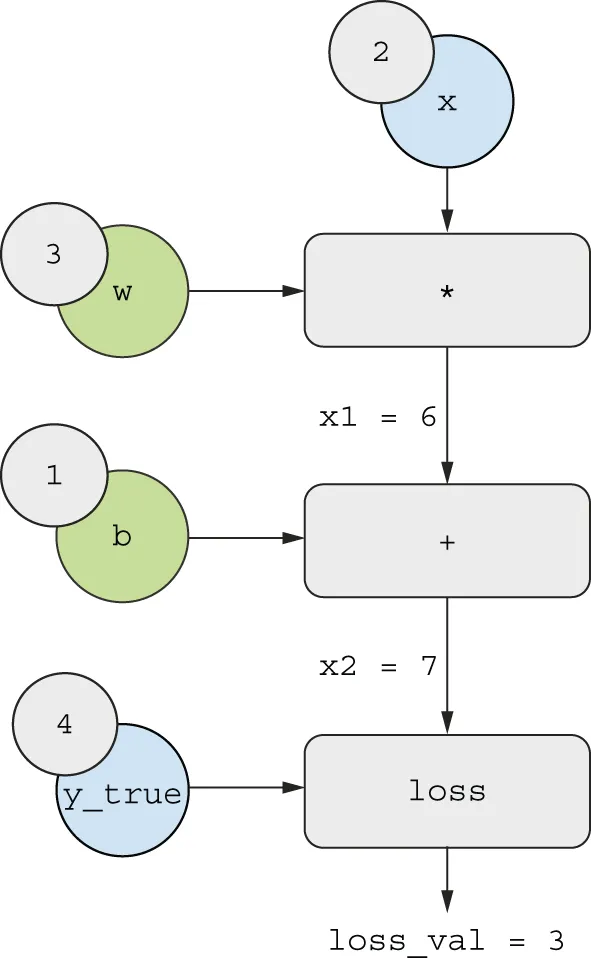
شکل ۲.۲۳: اجرای یک گذر رو به جلو
حالا بیایید گراف را “معکوس” کنیم: برای هر یال در گراف از A به B، یک یال مخالف از B به A ایجاد میکنیم و میپرسیم: “وقتی A تغییر میکند، B چقدر تغییر میکند؟” یعنی grad(B, A) چیست؟ هر یال معکوس را با این مقدار حاشیهنویسی میکنیم (شکل ۲.۲۴). این گراف رو به عقب گذر رو به عقب را نشان میدهد.
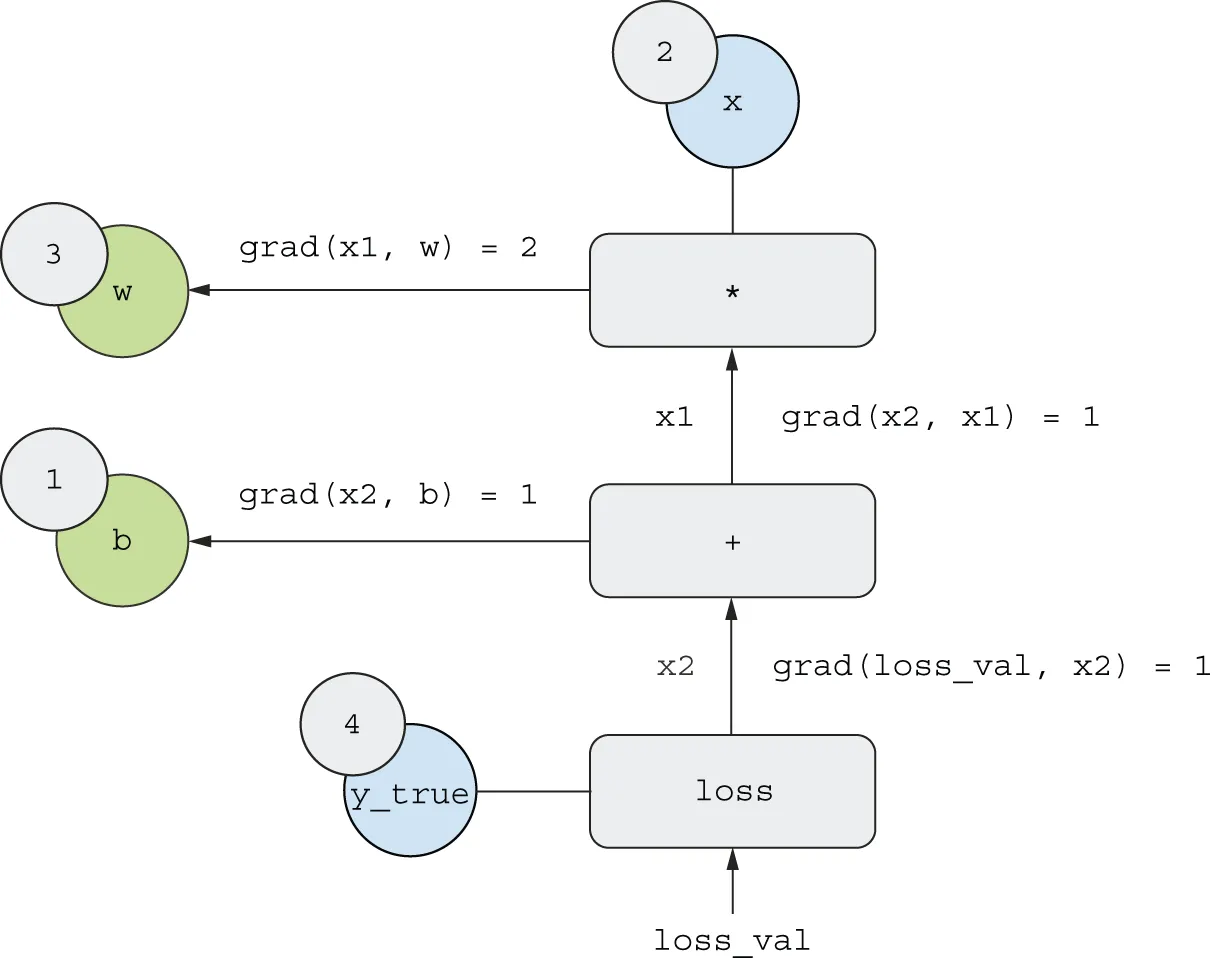
شکل ۲.۲۴: اجرای یک گذر رو به عقب
ما داریم
grad(loss_val, x2) = 1زیرا وقتیx2به مقدار اپسیلون تغییر میکند،loss_val = abs(4 - x2)به همان مقدار تغییر میکند.grad(x2, x1) = 1زیرا وقتیx1به مقدار اپسیلون تغییر میکند،x2 = x1 + b = x1 + 1به همان مقدار تغییر میکند.grad(x2, b) = 1زیرا وقتیbبه مقدار اپسیلون تغییر میکند،x2 = x1 + b = 6 + bبه همان مقدار تغییر میکند.grad(x1, w) = 2زیرا وقتیwبه مقدار اپسیلون تغییر میکند،x1 = x * w = 2 * wبه مقدار2 * epsilonتغییر میکند.
آنچه قاعدهٔ زنجیرهای دربارهٔ این گراف رو به عقب میگوید این است که میتوانید مشتق یک گره نسبت به گره دیگر را با ضرب مشتقهای هر یال در طول مسیری که دو گره را به هم متصل میکند به دست آورید. برای مثال، grad(loss_val, w) = grad(loss_val, x2) * grad(x2, x1) * grad(x1, w).
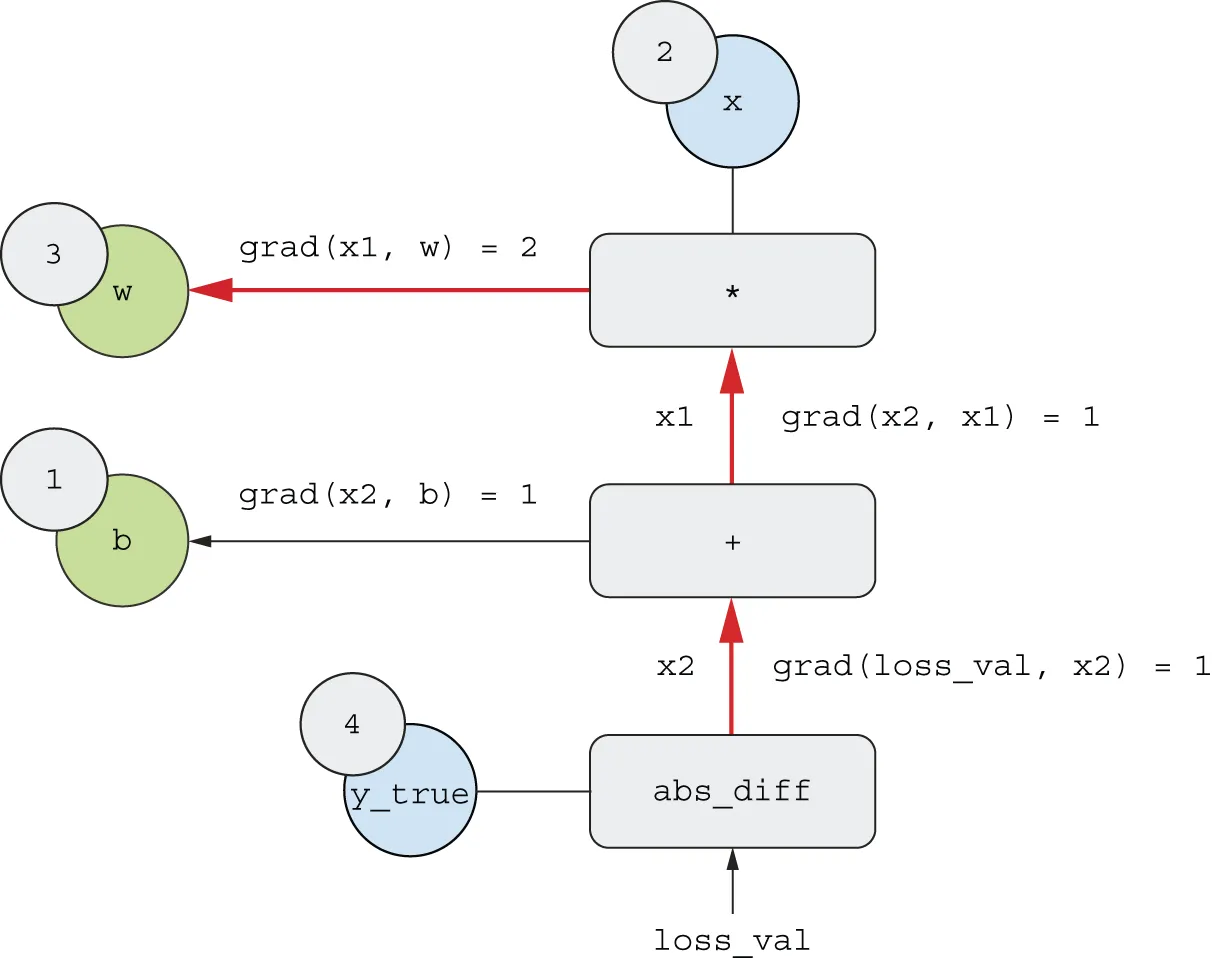
شکل ۲.۲۵: مسیر از loss_val به w در گراف رو به عقب
با اعمال قاعدهٔ زنجیرهای به گراف خود، آنچه به دنبالش بودیم به دست میآوریم:
grad(loss_val, w) = 1 * 1 * 2 = 2grad(loss_val, b) = 1 * 1 = 1
و با این، شما پسانتشار را در عمل دیدید! پسانتشار بهسادگی اعمال قاعدهٔ زنجیرهای به یک گراف محاسباتی است. چیز بیشتری در آن نیست. پسانتشار با مقدار زیان نهایی شروع میشود و از لایههای بالایی به لایههای پایینی به عقب کار میکند و سهمی که هر پارامتر در مقدار زیان داشته است را محاسبه میکند. نام “پسانتشار” از اینجا میآید: ما سهمهای زیان گرههای مختلف را در یک گراف محاسباتی “به عقب منتشر” میکنیم.
امروزه، مردم شبکههای عصبی را در چارچوبهای مدرنی پیادهسازی میکنند که قادر به مشتقگیری خودکار هستند، مانند JAX، TensorFlow و PyTorch. مشتقگیری خودکار با همان نوع گراف محاسباتی که قبلاً ارائه شد پیادهسازی میشود. مشتقگیری خودکار این امکان را میدهد که گرادیانهای ترکیبهای دلخواه از عملیات تانسوری مشتقپذیر را بدون هیچ کار اضافی بهجز نوشتن گذر رو به جلو بازیابی کنید. وقتی من اولین شبکههای عصبی خود را در دههٔ ۲۰۰۰ به زبان C مینوشتم، مجبور بودم گرادیانهایم را دستی بنویسم. حالا، به لطف ابزارهای مشتقگیری خودکار مدرن، هرگز مجبور نخواهید بود پسانتشار را خودتان پیادهسازی کنید. خودتان را خوششانس بدانید!
نگاهی دوباره به مثال اول ما
Section titled “نگاهی دوباره به مثال اول ما”شما به پایان این فصل نزدیک میشوید و اکنون باید درک کلی از آنچه در پشت صحنهٔ یک شبکهٔ عصبی میگذرد داشته باشید. آنچه در ابتدای فصل یک جعبهٔ سیاه جادویی بود، به تصویر روشنتری تبدیل شده است، همانطور که در شکل ۲.۲۶ نشان داده شده است: مدل، متشکل از لایههایی که به هم زنجیره شدهاند، دادههای ورودی را به پیشبینیها نگاشت میکند. تابع زیان سپس این پیشبینیها را با اهداف مقایسه میکند و یک مقدار زیان تولید میکند: معیاری از اینکه پیشبینیهای مدل چقدر با آنچه انتظار میرفت مطابقت دارند. بهینهساز از این مقدار زیان برای بهروزرسانی وزنهای مدل استفاده میکند.
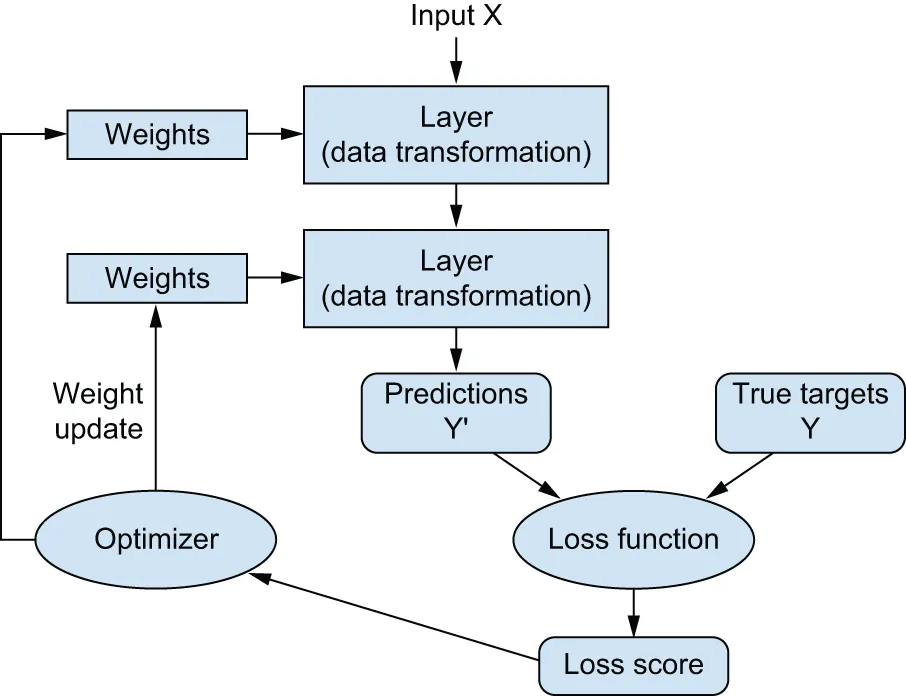
شکل ۲.۲۶: رابطهٔ بین شبکه، لایهها، تابع زیان و بهینهساز
بیایید به مثال اول برگردیم و هر قطعهٔ آن را در پرتو آنچه در بخشهای قبلی یاد گرفتید مرور کنیم.
این دادهٔ ورودی بود:
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255test_images = test_images.reshape((10000, 28 * 28))test_images = test_images.astype("float32") / 255حالا میفهمید که تصاویر ورودی در تانسورهای NumPy ذخیره میشوند، که در اینجا بهصورت تانسورهای float32 با شکل (60000, 784) (دادههای آموزشی) و (10000, 784) (دادههای آزمایشی) قالببندی شدهاند.
این مدل ما بود:
model = keras.Sequential( [ layers.Dense(512, activation="relu"), layers.Dense(10, activation="softmax"), ])حالا میفهمید که این مدل از زنجیرهای از دو لایهٔ Dense تشکیل شده است، که هر لایه چند عملیات تانسوری ساده را روی دادههای ورودی اعمال میکند، و این عملیات شامل تانسورهای وزن است. تانسورهای وزن، که ویژگیهای لایهها هستند، جایی هستند که دانش مدل پایدار میماند.
این مرحلهٔ کامپایل مدل بود:
model.compile( optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"],)حالا میفهمید که "sparse_categorical_crossentropy" تابع زیانی است که بهعنوان سیگنال بازخورد برای یادگیری تانسورهای وزن استفاده میشود، که فاز آموزش تلاش خواهد کرد آن را کمینه کند. همچنین میدانید که این کاهش زیان از طریق نزول گرادیان تصادفی با دستهٔ کوچک اتفاق میافتد. قواعد دقیق حاکم بر یک استفادهٔ خاص از نزول گرادیان توسط بهینهساز "adam" که بهعنوان اولین آرگومان پاس داده شده تعریف میشود.
در نهایت، این حلقهٔ آموزش بود:
model.fit( train_images, train_labels, epochs=5, batch_size=128,)حالا میفهمید وقتی fit را فراخوانی میکنید چه اتفاقی میافتد: مدل شروع به تکرار روی دادههای آموزشی در دستههای کوچک ۱۲۸ نمونهای، ۵ بار (هر تکرار روی تمام دادههای آموزشی دوره نامیده میشود) میکند. برای هر دسته، مدل گرادیان زیان نسبت به وزنها را محاسبه میکند (با استفاده از الگوریتم پسانتشار که از قاعدهٔ زنجیرهای در حساب دیفرانسیل مشتق شده است) و وزنها را در جهتی حرکت میدهد که مقدار زیان را برای این دسته کاهش دهد.
پس از این ۵ دوره، مدل ۲,۳۴۵ بهروزرسانی گرادیان انجام داده است (۴۶۹ در هر دوره) و زیان مدل بهاندازهٔ کافی پایین خواهد بود که مدل قادر به طبقهبندی ارقام دستنویس با دقت بالا باشد.
در این مرحله، شما بیشتر آنچه دربارهٔ شبکههای عصبی باید بدانید را میدانید. بیایید با پیادهسازی مجدد یک نسخهٔ سادهشده از آن مثال اول بهصورت گامبهگام، فقط با استفاده از عملیات سطح پایین، این را ثابت کنیم.
پیادهسازی مجدد مثال اول ما از صفر
Section titled “پیادهسازی مجدد مثال اول ما از صفر”چه چیزی بهتر از پیادهسازی همهچیز از صفر برای نشان دادن درک کامل و بدون ابهام؟ البته، آنچه “از صفر” در اینجا به معنای آن است نسبی است: ما عملیات تانسوری پایه را دوباره پیادهسازی نمیکنیم و پسانتشار را پیادهسازی نمیکنیم. اما تا آنجا پایین میرویم که هر مرحلهٔ محاسباتی صریح شود.
نگران نباشید اگر هنوز هر جزئیات کوچک در این مثال را کاملاً درک نمیکنید. فصل بعد با جزئیات بیشتری به API Keras میپردازد. برای حالا، فقط سعی کنید اصل ماجرا را دنبال کنید — هدف این مثال کمک به تبلور درک شما از ریاضیات یادگیری عمیق با استفاده از یک پیادهسازی عینی است. بیایید شروع کنیم!
یک کلاس Dense ساده
Section titled “یک کلاس Dense ساده”قبلاً یاد گرفتید که لایهٔ Dense تبدیل ورودی زیر را پیادهسازی میکند، که در آن W و b پارامترهای مدل هستند و activation یک تابع عنصر به عنصر (معمولاً relu) است:
output = activation(matmul(input, W) + b)بیایید یک کلاس سادهٔ پایتون NaiveDense پیادهسازی کنیم که دو متغیر Keras W و b ایجاد میکند و یک متد __call__() ارائه میدهد که تبدیل قبلی را اعمال میکند:
# keras.ops is where you will find all the tensor operations you need.import kerasfrom keras import ops
class NaiveDense:    def __init__(self, input_size, output_size, activation=None):        self.activation = activation        self.W = keras.Variable(            # Creates a matrix W of shape (input_size, output_size),            # initialized with random values drawn from a uniform            # distribution            shape=(input_size, output_size), initializer="uniform"        )        # Creates a vector b of shape (output_size,), initialized with        # zeros        self.b = keras.Variable(shape=(output_size,), initializer="zeros")
    # Applies the forward pass    def __call__(self, inputs):        x = ops.matmul(inputs, self.W)        x = x + self.b        if self.activation is not None:            x = self.activation(x)        return x
    @property    # The convenience method for retrieving the layer's weights    def weights(self):        return [self.W, self.b]
یک کلاس Sequential ساده
Section titled “یک کلاس Sequential ساده”حالا، بیایید یک کلاس NaiveSequential برای زنجیره کردن این لایهها ایجاد کنیم. این کلاس لیستی از لایهها را میپیچد و یک متد __call__() ارائه میدهد که بهسادگی لایههای زیرین را به ترتیب روی ورودیها فراخوانی میکند. همچنین یک ویژگی weights برای پیگیری آسان پارامترهای لایهها دارد:
class NaiveSequential:    def __init__(self, layers):        self.layers = layers
    def __call__(self, inputs):        x = inputs        for layer in self.layers:            x = layer(x)        return x
    @property    def weights(self):        weights = []        for layer in self.layers:            weights += layer.weights        return weights
با استفاده از این کلاس NaiveDense و این کلاس NaiveSequential، میتوانیم یک مدل Keras ساختگی ایجاد کنیم:
model = NaiveSequential( [ NaiveDense(input_size=28 * 28, output_size=512, activation=ops.relu), NaiveDense(input_size=512, output_size=10, activation=ops.softmax), ])assert len(model.weights) == 4یک تولیدکنندهٔ دسته
Section titled “یک تولیدکنندهٔ دسته”در ادامه، به راهی برای تکرار روی دادههای MNIST در دستههای کوچک نیاز داریم. این آسان است:
import math
class BatchGenerator:    def __init__(self, images, labels, batch_size=128):        assert len(images) == len(labels)        self.index = 0        self.images = images        self.labels = labels        self.batch_size = batch_size        self.num_batches = math.ceil(len(images) / batch_size)
    def next(self):        images = self.images[self.index : self.index + self.batch_size]        labels = self.labels[self.index : self.index + self.batch_size]        self.index += self.batch_size        return images, labels
اجرای یک گام آموزش
Section titled “اجرای یک گام آموزش”دشوارترین بخش فرآیند “گام آموزش” است: بهروزرسانی وزنهای مدل پس از اجرای آن روی یک دسته داده. ما باید
- پیشبینیهای مدل را برای تصاویر موجود در دسته محاسبه کنیم
- مقدار زیان را برای این پیشبینیها با توجه به برچسبهای واقعی محاسبه کنیم
- گرادیان زیان نسبت به وزنهای مدل را محاسبه کنیم
- وزنها را به مقدار کمی در جهت مخالف گرادیان حرکت دهیم
لیستینگ ۲.۹: یک گام از آموزش
def one_training_step(model, images_batch, labels_batch): # Runs the "forward pass" predictions = model(images_batch) loss = ops.sparse_categorical_crossentropy(labels_batch, predictions) average_loss = ops.mean(loss) # Computes the gradient of the loss with regard to the weights. The # output, gradients, is a list where each entry corresponds to a # weight from the model.weights list. We haven't defined this # function yet! gradients = get_gradients_of_loss_wrt_weights(loss, model.weights) # Updates the weights using the gradients. We haven't defined this # function yet! update_weights(gradients, model.weights) return lossمرحلهٔ بهروزرسانی وزن
Section titled “مرحلهٔ بهروزرسانی وزن”همانطور که میدانید، هدف مرحلهٔ “بهروزرسانی وزن” (که با تابع update_weights() نشان داده میشود) حرکت دادن وزنها “کمی” در جهتی است که زیان روی این دسته را کاهش دهد. بزرگی حرکت توسط “نرخ یادگیری” تعیین میشود که معمولاً یک کمیت کوچک است. سادهترین راه برای پیادهسازی این تابع update_weights() کم کردن gradient * learning_rate از هر وزن است:
learning_rate = 1e-3
def update_weights(gradients, weights):    for g, w in zip(gradients, weights):        # Assigns a new value to the variable, in place        w.assign(w - g * learning_rate)
در عمل، تقریباً هرگز یک مرحلهٔ بهروزرسانی وزن را به این صورت دستی پیادهسازی نمیکنید. در عوض، از یک نمونهٔ Optimizer از Keras استفاده میکنید — مانند این:
from keras import optimizers
optimizer = optimizers.SGD(learning_rate=1e-3)
def update_weights(gradients, weights):    optimizer.apply_gradients(zip(gradients, weights))
محاسبهٔ گرادیان
Section titled “محاسبهٔ گرادیان”حالا، فقط یک چیز هنوز کم داریم: محاسبهٔ گرادیان (که با تابع get_gradients_of_loss_wrt_weights() در لیستینگ ۲.۹ نشان داده شده است). در بخش قبلی، شرح دادیم که چگونه میتوانیم از قاعدهٔ زنجیرهای برای به دست آوردن گرادیانهای یک زنجیره از توابع با توجه به مشتقهای فردی آنها استفاده کنیم، فرآیندی که بهعنوان پسانتشار شناخته میشود. ما میتوانستیم پسانتشار را از صفر در اینجا دوباره پیادهسازی کنیم، اما این کار نسبتاً دستوپاگیر خواهد بود، بهویژه چون از عملیات softmax و زیان crossentropy استفاده میکنیم که مشتقهای نسبتاً پرحجمی دارند.
در عوض، میتوانیم به مکانیزم مشتقگیری خودکاری که در یکی از چارچوبهای سطح پایین پشتیبانیشده توسط Keras، مانند TensorFlow، JAX یا PyTorch، تعبیه شده است تکیه کنیم. برای اهداف این مثال، بیایید TensorFlow را انتخاب کنیم. در فصل بعد دربارهٔ TensorFlow، JAX و PyTorch بیشتر خواهید آموخت.
APIیی که از طریق آن میتوانید از قابلیتهای مشتقگیری خودکار TensorFlow استفاده کنید، شیء tf.GradientTape است. این یک محدودهٔ پایتون است که عملیات تانسوری را که درون آن اجرا میشوند “ضبط” میکند، بهصورت یک گراف محاسباتی (که گاهی نوار نامیده میشود). سپس میتوان از این گراف برای بازیابی گرادیان هر مقدار اسکالر نسبت به هر مجموعهای از مقادیر ورودی استفاده کرد:
import tensorflow as tf
# Instantiates a scalar tensor with value 0x = tf.zeros(shape=())# Opens a GradientTape scopewith tf.GradientTape() as tape:    # Inside the scope, applies some tensor operations to our variable    y = 2 * x + 3# Uses the tape to retrieve the gradient of the output y with respect# to our variable xgrad_of_y_wrt_x = tape.gradient(y, x)
بیایید تابع one_training_step() خود را با استفاده از GradientTape در TensorFlow بازنویسی کنیم (با صرفنظر از نیاز به یک تابع جداگانه get_gradients_of_loss_wrt_weights()):
def one_training_step(model, images_batch, labels_batch): with tf.GradientTape() as tape: predictions = model(images_batch) loss = ops.sparse_categorical_crossentropy(labels_batch, predictions) average_loss = ops.mean(loss) gradients = tape.gradient(average_loss, model.weights) update_weights(gradients, model.weights) return average_lossحالا که گام آموزش هر دستهٔ ما آماده است، میتوانیم به پیادهسازی یک دورهٔ کامل آموزش برویم.
حلقهٔ آموزش کامل
Section titled “حلقهٔ آموزش کامل”یک دورهٔ آموزش بهسادگی شامل تکرار گام آموزش برای هر دسته در دادههای آموزشی است، و حلقهٔ آموزش کامل بهسادگی تکرار یک دوره است:
def fit(model, images, labels, epochs, batch_size=128): for epoch_counter in range(epochs): print(f"Epoch {epoch_counter}") batch_generator = BatchGenerator(images, labels) for batch_counter in range(batch_generator.num_batches): images_batch, labels_batch = batch_generator.next() loss = one_training_step(model, images_batch, labels_batch) if batch_counter % 100 == 0: print(f"loss at batch {batch_counter}: {loss:.2f}")بیایید آن را امتحان کنیم:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
train_images = train_images.reshape((60000, 28 * 28))train_images = train_images.astype("float32") / 255test_images = test_images.reshape((10000, 28 * 28))test_images = test_images.astype("float32") / 255
fit(model, train_images, train_labels, epochs=10, batch_size=128)
ارزیابی مدل
Section titled “ارزیابی مدل”میتوانیم مدل را با گرفتن argmax از پیشبینیهای آن روی تصاویر آزمایشی و مقایسه با برچسبهای مورد انتظار ارزیابی کنیم:
>>> predictions = model(test_images)>>> predicted_labels = ops.argmax(predictions, axis=1)>>> matches = predicted_labels == test_labels>>> f"accuracy: {ops.mean(matches):.2f}"همهچیز تمام شد! همانطور که میبینید، انجام “دستی” کاری که میتوانید در چند خط کد Keras انجام دهید، کار نسبتاً زیادی است. اما از آنجا که این مراحل را طی کردهاید، اکنون باید درک شفاف و روشنی از آنچه در داخل یک شبکهٔ عصبی هنگام فراخوانی fit() میگذرد داشته باشید. داشتن این مدل ذهنی سطح پایین از آنچه کد شما در پشت صحنه انجام میدهد، شما را قادر میسازد بهتر از ویژگیهای سطح بالای API Keras استفاده کنید.
- تانسورها پایه و اساس سیستمهای یادگیری ماشین مدرن را تشکیل میدهند. آنها در انواع مختلفی از
dtype،rankوshapeعرضه میشوند. - میتوانید تانسورهای عددی را از طریق عملیات تانسوری (مانند جمع، ضرب تانسوری یا ضرب عنصر به عنصر) دستکاری کنید، که میتوانند بهعنوان کدگذاری تبدیلهای هندسی تفسیر شوند. بهطور کلی، همهچیز در یادگیری عمیق قابل تفسیر هندسی است.
- مدلهای یادگیری عمیق از زنجیرههایی از عملیات تانسوری ساده تشکیل شدهاند که توسط وزنها پارامتری شدهاند، که خودشان تانسور هستند. وزنهای یک مدل جایی هستند که “دانش” آن ذخیره میشود.
- یادگیری به معنای یافتن مجموعهای از مقادیر برای وزنهای مدل است که یک تابع زیان را برای مجموعهای از نمونههای دادهٔ آموزشی و اهداف متناظرشان کمینه کند.
- یادگیری با انتخاب دستههای تصادفی از نمونههای داده و اهدافشان و محاسبهٔ گرادیان پارامترهای مدل نسبت به زیان روی دسته اتفاق میافتد. سپس پارامترهای مدل کمی (بزرگی حرکت توسط نرخ یادگیری تعیین میشود) در جهت مخالف گرادیان حرکت میکنند. این نزول گرادیان دستهای کوچک نامیده میشود.
- کل فرآیند یادگیری به این واقعیت امکانپذیر میشود که همهٔ عملیات تانسوری در شبکههای عصبی مشتقپذیر هستند، و بنابراین میتوان قاعدهٔ زنجیرهای مشتقگیری را برای یافتن تابع گرادیان که پارامترهای فعلی و دستهٔ دادهٔ فعلی را به یک مقدار گرادیان نگاشت میکند اعمال کرد. این پسانتشار نامیده میشود.
- دو مفهوم کلیدی که در فصلهای آینده اغلب خواهید دید زیان و بهینهسازها هستند. اینها دو چیزی هستند که باید قبل از شروع تغذیهٔ داده به مدل تعریف کنید:
- زیان کمیتی است که سعی خواهید کرد در طول آموزش آن را کمینه کنید، بنابراین باید معیاری از موفقیت برای وظیفهای که میخواهید حل کنید باشد.
- بهینهساز روش دقیقی را مشخص میکند که در آن گرادیان زیان برای بهروزرسانی پارامترها استفاده میشود: برای مثال، میتواند بهینهساز RMSProp، SGD با مومنتوم و غیره باشد.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.