
فصل ۱: یادگیری عمیق چیست؟
در طول دههٔ گذشته، هوش مصنوعی (AI) موضوع هیاهوی شدید رسانهای بوده است. یادگیری ماشین، یادگیری عمیق و هوش مصنوعی در مقالات بیشماری مطرح میشوند، اغلب خارج از نشریات فناوریمحور. به ما آیندهای از چتباتهای هوشمند، خودروهای خودران و دستیارهای مجازی وعده داده شده است — آیندهای که گاهی با نوری تیره و گاهی آرمانشهری به تصویر کشیده میشود، جایی که مشاغل انسانی کمیاب خواهند بود و بیشتر فعالیتهای اقتصادی توسط رباتها یا عاملهای هوش مصنوعی انجام میشود. برای یک متخصص یادگیری ماشین، مهم است که بتواند سیگنال را در میان نویز تشخیص دهد، تا بتوانید تحولات جهانشمول را از بیانیههای مطبوعاتی بیشازحد تبلیغشده جدا کنید. آیندهٔ ما در خطر است و این آیندهای است که شما در آن نقش فعالی دارید: پس از خواندن این کتاب، شما یکی از کسانی خواهید بود که میتوانند این سیستمهای هوش مصنوعی را توسعه دهند. پس بیایید به این سؤالات بپردازیم: یادگیری عمیق تاکنون چه چیزی به دست آورده است؟ چقدر مهم است؟ به کجا میرویم؟ آیا باید هیاهو را باور کنید؟
هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
Section titled “هوش مصنوعی، یادگیری ماشین و یادگیری عمیق”ابتدا باید بهوضوح تعریف کنیم که وقتی از هوش مصنوعی صحبت میکنیم منظورمان چیست. هوش مصنوعی، یادگیری ماشین و یادگیری عمیق چیستند (شکل ۱.۱)؟ چه رابطهای با یکدیگر دارند؟
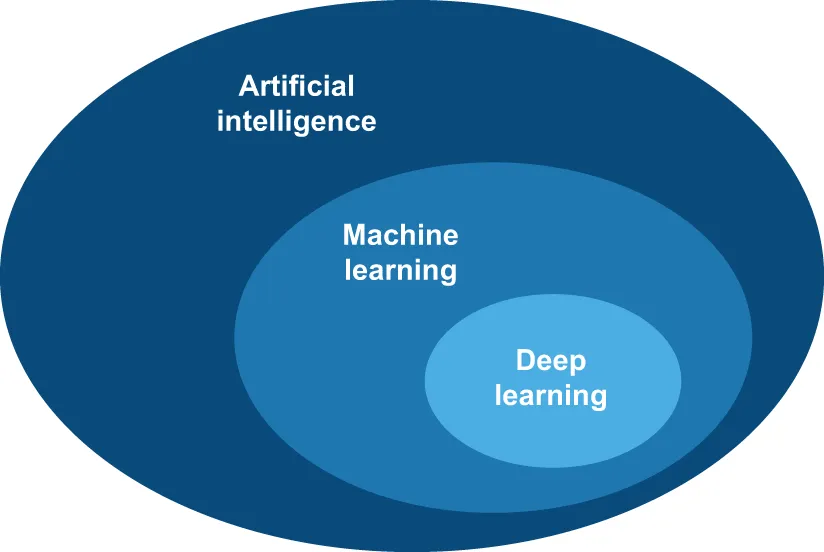
شکل ۱.۱: هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
هوش مصنوعی
Section titled “هوش مصنوعی”هوش مصنوعی در دههٔ ۱۹۵۰ متولد شد، زمانی که چند پیشگام از حوزهٔ نوپای علوم کامپیوتر شروع به پرسیدن این سؤال کردند که آیا میتوان کامپیوترها را به «فکر کردن» واداشت — سؤالی که عواقب آن را هنوز در حال بررسی هستیم.
در حالی که بسیاری از ایدههای زیربنایی در سالها و حتی دهههای قبل در حال شکلگیری بود، «هوش مصنوعی» سرانجام در سال ۱۹۵۶ بهعنوان یک حوزهٔ تحقیقاتی متبلور شد، زمانی که جان مککارتی، که در آن زمان استادیار جوان ریاضیات در کالج دارتموث بود، یک کارگاه تابستانی را با پیشنهاد زیر سازماندهی کرد:
مطالعه بر اساس این حدس پیش خواهد رفت که هر جنبهای از یادگیری یا هر ویژگی دیگر هوش میتواند در اصل بهطور دقیق توصیف شود بهگونهای که یک ماشین بتواند آن را شبیهسازی کند. تلاشی برای یافتن چگونگی واداشتن ماشینها به استفاده از زبان، شکلدادن به انتزاعها و مفاهیم، حل انواع مسائلی که اکنون برای انسان محفوظ است، و بهبود خودشان انجام خواهد شد. ما فکر میکنیم که پیشرفت قابلتوجهی در یکی یا بیشتر از این مسائل میتواند حاصل شود اگر گروهی منتخب از دانشمندان برای یک تابستان با هم کار کنند.
در پایان تابستان، کارگاه بدون حل کامل معمایی که برای بررسی آن تعیین شده بود به پایان رسید. با این حال، افراد زیادی در آن شرکت کردند که بعدها به پیشگامان این حوزه تبدیل شدند، و جرقهٔ یک انقلاب فکری را زد که تا به امروز ادامه دارد.
بهطور مختصر، هوش مصنوعی را میتوان بهعنوان تلاش برای خودکارسازی وظایف فکری که معمولاً توسط انسان انجام میشود توصیف کرد. به این ترتیب، هوش مصنوعی یک حوزهٔ عمومی است که یادگیری ماشین و یادگیری عمیق را در بر میگیرد، اما شامل رویکردهای بسیار بیشتری نیز میشود که ممکن است هیچ یادگیریای در آنها دخیل نباشد. در نظر بگیرید که تا دههٔ ۱۹۸۰، بیشتر کتابهای درسی هوش مصنوعی اصلاً به «یادگیری» اشاره نمیکردند! برنامههای شطرنج اولیه، برای مثال، تنها شامل قواعد سختکدشدهای بودند که توسط برنامهنویسان ساخته شده بود و بهعنوان یادگیری ماشین واجد شرایط نبودند. در واقع، برای مدت نسبتاً طولانی، بیشتر کارشناسان بر این باور بودند که هوش مصنوعی در سطح انسان میتواند با داشتن مجموعهای بهاندازهٔ کافی بزرگ از قواعد صریح برای دستکاری دانش ذخیرهشده در پایگاههای دادهٔ صریح توسط برنامهنویسان به دست آید. این رویکرد بهعنوان هوش مصنوعی نمادین شناخته میشود. این پارادایم غالب در هوش مصنوعی از دههٔ ۱۹۵۰ تا اواخر دههٔ ۱۹۸۰ بود و در طول رونق سیستمهای خبره در دههٔ ۱۹۸۰ به اوج محبوبیت خود رسید.
اگرچه هوش مصنوعی نمادین برای حل مسائل خوب تعریفشده و منطقی، مانند بازی شطرنج، مناسب بود، اما معلوم شد که برای یافتن قواعد صریح برای حل مسائل پیچیدهتر و مبهمتر مانند طبقهبندی تصویر، تشخیص گفتار یا ترجمهٔ زبان طبیعی، غیرقابل حل است. رویکرد جدیدی برای جایگزینی هوش مصنوعی نمادین پدیدار شد: یادگیری ماشین.
یادگیری ماشین
Section titled “یادگیری ماشین”در انگلستان ویکتوریایی، لیدی آدا لاولیس دوست و همکار چارلز بابیج، مخترع موتور تحلیلی بود: اولین کامپیوتر مکانیکی همهمنظورهٔ شناختهشده. اگرچه موتور تحلیلی آیندهنگر و بسیار جلوتر از زمان خود بود، اما در طراحی آن در دهههای ۱۸۳۰ و ۱۸۴۰ بهعنوان یک کامپیوتر همهمنظوره در نظر گرفته نشده بود، زیرا مفهوم محاسبات همهمنظوره هنوز اختراع نشده بود. این موتور صرفاً بهعنوان راهی برای استفاده از عملیات مکانیکی برای خودکارسازی محاسبات خاصی از حوزهٔ تحلیل ریاضی در نظر گرفته شده بود — از این رو نام موتور تحلیلی. به این ترتیب، از نظر فکری وارث تلاشهای قبلی برای کدگذاری عملیات ریاضی به شکل چرخدنده بود، مانند پاسکالین، یا ماشینحساب لایبنیتس، نسخهٔ اصلاحشدهٔ پاسکالین. پاسکالین که توسط بلز پاسکال در سال ۱۶۴۲ (در سن ۱۹ سالگی!) طراحی شد، اولین ماشینحساب مکانیکی جهان بود — میتوانست ارقام را جمع، تفریق، ضرب یا حتی تقسیم کند.
در سال ۱۸۴۳، آدا لاولیس دربارهٔ اختراع موتور تحلیلی اظهار نظر کرد:
موتور تحلیلی هیچ ادعایی برای خلق کردن ندارد. میتواند هر کاری را که ما بدانیم چگونه به آن دستور دهیم انجام دهد… قلمرو آن کمک به ما در در دسترس قرار دادن آن چیزی است که قبلاً با آن آشنا هستیم.
حتی با ۱۸۲ سال دیدگاه تاریخی، مشاهدهٔ لیدی لاولیس همچنان قابلتوجه است. آیا یک کامپیوتر همهمنظوره میتواند چیزی را «خلق» کند، یا همیشه محکوم به اجرای کسلکنندهٔ فرآیندهایی است که ما انسانها کاملاً درک میکنیم؟ آیا میتواند روزی قادر به هیچ اندیشهٔ اصیلی باشد؟ آیا میتواند از تجربه یاد بگیرد؟ آیا میتواند خلاقیت نشان دهد؟
اظهار نظر او بعداً توسط پیشگام هوش مصنوعی آلن تورینگ بهعنوان «اعتراض لیدی لاولیس» در مقالهٔ مهم سال ۱۹۵۰ او «ماشینهای محاسباتی و هوش» نقل شد،1 که آزمون تورینگ را معرفی کرد2 و همچنین مفاهیم کلیدیای را که قرار بود هوش مصنوعی را شکل دهند. تورینگ بر این عقیده بود — که در آن زمان بسیار تحریکآمیز بود — که کامپیوترها میتوانند در اصل طوری ساخته شوند که تمام جنبههای هوش انسانی را شبیهسازی کنند.
روش معمول برای واداشتن کامپیوتر به انجام کار مفید این است که یک برنامهنویس انسانی قواعدی را بنویسد — یک برنامهٔ کامپیوتری — تا برای تبدیل دادههای ورودی به پاسخهای مناسب دنبال شود، درست مانند لیدی لاولیس که دستورالعملهای گامبهگام را برای اجرای موتور تحلیلی مینوشت. یادگیری ماشین این را برعکس میکند: ماشین به دادههای ورودی و پاسخهای متناظر نگاه میکند و میفهمد که قواعد باید چه باشند (شکل ۱.۲).
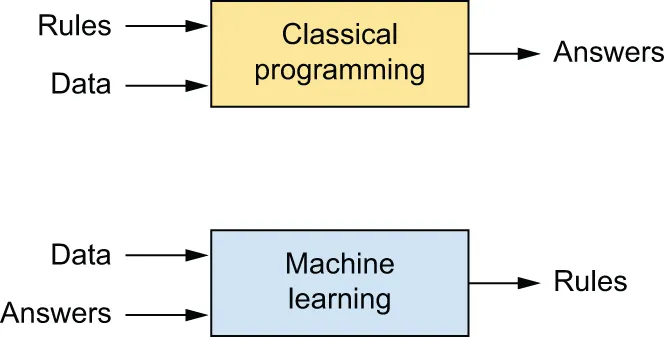
شکل ۱.۲: یادگیری ماشین: یک پارادایم برنامهنویسی جدید
یک سیستم یادگیری ماشین آموزش میبیند نه اینکه صراحتاً برنامهنویسی شود. نمونههای زیادی مرتبط با یک وظیفه به آن ارائه میشود و ساختار آماری در این نمونهها را مییابد که در نهایت به سیستم اجازه میدهد قواعدی برای خودکارسازی آن وظیفه ارائه دهد. برای مثال، اگر میخواهید وظیفهٔ برچسبگذاری تصاویر تعطیلات خود را خودکار کنید، میتوانید به یک سیستم یادگیری ماشین نمونههای زیادی از تصاویری که قبلاً توسط انسان برچسبگذاری شدهاند ارائه دهید، و سیستم قواعد آماری برای associating تصاویر خاص به برچسبهای خاص مانند «منظره» یا «غذا» یاد میگیرد.
اگرچه یادگیری ماشین تنها در دههٔ ۱۹۹۰ شروع به شکوفایی کرد، اما بهسرعت به محبوبترین و موفقترین زیرحوزهٔ هوش مصنوعی تبدیل شده است، روندی که توسط در دسترس بودن سختافزار سریعتر و مجموعهدادههای بزرگتر هدایت میشود. یادگیری ماشین با آمار ریاضی مرتبط است، اما از چند جهت مهم با آمار متفاوت است — به همان معنایی که پزشکی با شیمی مرتبط است اما نمیتوان آن را به شیمی تقلیل داد، زیرا پزشکی با سیستمهای متمایز خود با خواص متمایز خود سر و کار دارد. برخلاف آمار، یادگیری ماشین تمایل دارد با مجموعهدادههای بزرگ و پیچیده (مانند مجموعهدادهای از میلیونها تصویر، که هر کدام از دهها هزار پیکسل تشکیل شده است) سر و کار داشته باشد که تحلیل آماری کلاسیک مانند تحلیل بیزی برای آنها غیرعملی خواهد بود. در نتیجه، یادگیری ماشین، و بهویژه یادگیری عمیق، نسبتاً نظریهٔ ریاضی کمتری نشان میدهد — شاید بیش از حد کم — و اساساً یک رشتهٔ مهندسی است. برخلاف فیزیک نظری یا ریاضیات، یادگیری ماشین یک حوزهٔ بسیار عملی است که توسط یافتههای تجربی هدایت میشود و بهشدت به پیشرفتهای نرمافزاری و سختافزاری وابسته است.
یادگیری قواعد و بازنماییها از داده
Section titled “یادگیری قواعد و بازنماییها از داده”برای تعریف یادگیری عمیق و درک تفاوت بین یادگیری عمیق و سایر رویکردهای یادگیری ماشین، ابتدا باید ایدهای از آنچه الگوریتمهای یادگیری ماشین انجام میدهند داشته باشیم. ما قبلاً گفتیم که یادگیری ماشین قواعدی برای اجرای یک وظیفهٔ پردازش داده کشف میکند، با توجه به نمونههایی از آنچه انتظار میرود. بنابراین، برای انجام یادگیری ماشین، به سه چیز نیاز داریم:
- نقاط دادهٔ ورودی — برای مثال، اگر وظیفه تشخیص گفتار است، این نقاط داده میتوانند فایلهای صوتی افراد در حال صحبت باشند. اگر وظیفه برچسبگذاری تصویر است، میتوانند تصاویر باشند.
- نمونههایی از خروجی مورد انتظار — در یک وظیفهٔ تشخیص گفتار، اینها میتوانند رونوشتهای تولیدشده توسط انسان از فایلهای صوتی باشند. در یک وظیفهٔ تصویری، خروجیهای مورد انتظار میتوانند برچسبهایی مانند «سگ»، «گربه» و غیره باشند.
- راهی برای اندازهگیری اینکه آیا الگوریتم کار خوبی انجام میدهد — این برای تعیین فاصلهٔ بین خروجی فعلی الگوریتم و خروجی مورد انتظار آن ضروری است. این اندازهگیری بهعنوان یک سیگنال بازخورد برای تنظیم نحوهٔ کار الگوریتم استفاده میشود. این مرحلهٔ تنظیم همان چیزی است که ما آن را یادگیری مینامیم.
یک مدل یادگیری ماشین دادههای ورودی خود را به خروجیهای معنادار تبدیل میکند، فرآیندی که از طریق قرار گرفتن در معرض نمونههای شناختهشدهٔ ورودیها و خروجیها «یاد گرفته» میشود. بنابراین، مسئلهٔ اصلی در یادگیری ماشین و یادگیری عمیق تبدیل معنادار داده است: به عبارت دیگر، یادگیری بازنماییهای مفید از دادههای ورودی در دسترس — بازنماییهایی که ما را به خروجی مورد انتظار نزدیکتر میکنند.
قبل از اینکه بیشتر پیش برویم، بازنمایی چیست؟ در هستهٔ خود، راهی متفاوت برای نگاه کردن به داده برای بازنمایی یا کدگذاری داده است. برای مثال، یک تصویر رنگی را میتوان در قالب RGB (قرمز-سبز-آبی) یا در قالب HSV (رنگ-اشباع-ارزش) کدگذاری کرد: اینها دو بازنمایی متفاوت از دادههای یکسان هستند. برخی وظایف که ممکن است با یک بازنمایی دشوار باشند، با دیگری آسان میشوند. برای مثال، وظیفهٔ «همهٔ پیکسلهای قرمز تصویر را انتخاب کن» در قالب RGB سادهتر است، در حالی که «تصویر را کماشباعتر کن» در قالب HSV سادهتر است. مدلهای یادگیری ماشین همه دربارهٔ یافتن بازنماییهای مناسب برای دادههای ورودی خود هستند — تبدیلهایی از داده که آن را برای وظیفهٔ پیشرو مناسبتر میکند.
بیایید این را عینی کنیم. یک محور x، یک محور y و چند نقطه را در نظر بگیرید که با مختصاتشان در سیستم (x, y) نمایش داده میشوند، همانطور که در شکل ۱.۳ نشان داده شده است.
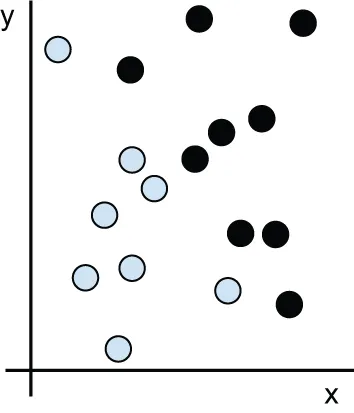
شکل ۱.۳: چند نمونه داده
همانطور که میبینید، چند نقطهٔ سفید و چند نقطهٔ سیاه داریم. فرض کنید میخواهیم الگوریتمی توسعه دهیم که بتواند مختصات (x, y) یک نقطه را بگیرد و خروجی دهد که آیا آن نقطه به احتمال زیاد سیاه است یا سفید. در این مورد،
- ورودیها مختصات نقاط ما هستند.
- خروجیهای مورد انتظار رنگ نقاط ما هستند.
- راهی برای اندازهگیری اینکه آیا الگوریتم ما کار خوبی انجام میدهد میتواند برای مثال، درصد نقاطی باشد که بهدرستی طبقهبندی میشوند.
آنچه در اینجا نیاز داریم یک بازنمایی جدید از دادههایمان است که نقاط سفید را بهطور تمیز از نقاط سیاه جدا کند. یک تبدیل که میتوانستیم استفاده کنیم، از میان بسیاری از احتمالات دیگر، تغییر مختصات است که در شکل ۱.۴ نشان داده شده است.
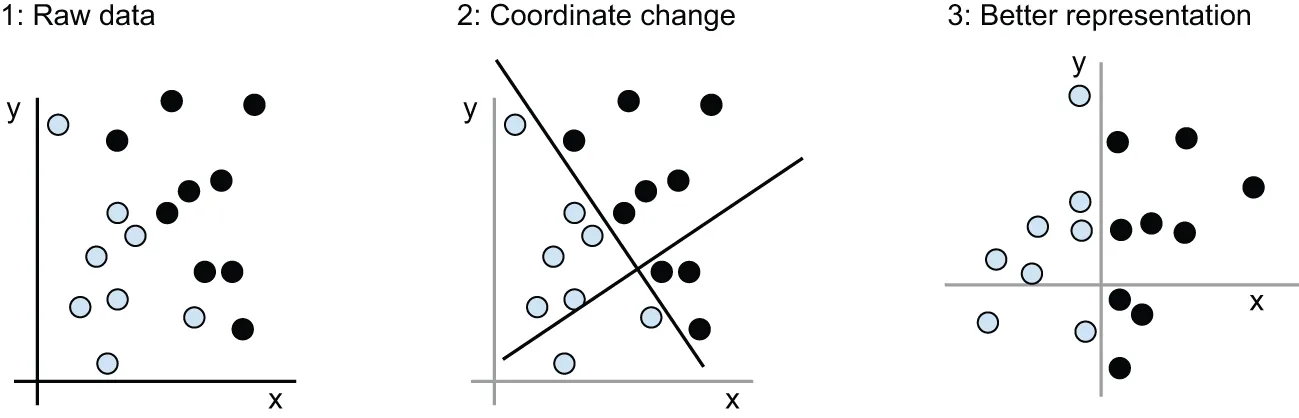
شکل ۱.۴: تغییر مختصات
در این سیستم مختصات جدید، مختصات نقاط ما را میتوان بازنمایی جدیدی از دادههایمان دانست. و بازنمایی خوبی است! با این بازنمایی، مسئلهٔ طبقهبندی سیاه/سفید را میتوان بهصورت یک قاعدهٔ ساده بیان کرد: «نقاط سیاه آنهایی هستند که x > 0»، یا «نقاط سفید آنهایی هستند که x < 0». این بازنمایی جدید، همراه با این قاعدهٔ ساده، مسئلهٔ طبقهبندی را بهطور تمیز حل میکند.
در این مورد، ما تغییر مختصات را دستی تعریف کردیم: از هوش انسانی خود برای ارائهٔ بازنمایی مناسب خود از داده استفاده کردیم. این برای چنین مسئلهٔ بسیار سادهای اشکالی ندارد، اما آیا میتوانستید همین کار را در صورتی که وظیفه طبقهبندی تصاویر ارقام دستنویس بود انجام دهید؟ آیا میتوانستید تبدیلهای تصویری صریح و قابلاجرا با کامپیوتر بنویسید که تفاوت بین ۶ و ۸، بین ۱ و ۷ را در انواع مختلف دستخطوط روشن کند؟
این کار تا حدی ممکن است. قواعد مبتنی بر بازنمایی ارقام مانند «شمارش تعداد حلقههای بسته» یا هیستوگرامهای پیکسلی افقی و عمودی میتوانند کار قابلقبولی در تشخیص ارقام دستنویس از یکدیگر انجام دهند. اما یافتن چنین بازنماییهای مفیدی بهصورت دستی کار دشواری است و همانطور که میتوانید تصور کنید سیستم قاعدهمحور حاصل شکننده و نگهداری آن یک کابوس خواهد بود. هر بار که با نمونهٔ جدیدی از دستخط برخورد میکردید که قواعد بهدقت اندیشیدهشدهٔ شما را نقض میکرد، باید تبدیلهای دادهٔ جدید و قواعد جدیدی اضافه میکردید، در حالی که تعامل آنها با هر قاعدهٔ قبلی را در نظر میگرفتید.
احتمالاً فکر میکنید، اگر این فرآیند اینقدر دردناک است، آیا میتوانیم آن را خودکار کنیم؟ چه میشود اگر بهطور سیستماتیک به جستجوی مجموعههای مختلفی از بازنماییهای دادهٔ تولیدشده بهطور خودکار و قواعد مبتنی بر آنها بپردازیم، و بازنماییهای خوب را با استفاده از درصد ارقامی که بهدرستی در یک مجموعهدادهٔ توسعه طبقهبندی میشوند بهعنوان بازخورد شناسایی کنیم؟ آنگاه در حال انجام یادگیری ماشین خواهیم بود. یادگیری، در زمینهٔ یادگیری ماشین، یک فرآیند جستجوی خودکار برای تبدیلهای داده توصیف میکند که بازنماییهای مفیدی از برخی دادهها تولید میکنند، با هدایت یک سیگنال بازخورد — بازنماییهایی که برای قواعد سادهتر حلکنندهٔ وظیفهٔ پیشرو مناسب هستند.
این تبدیلها میتوانند تغییر مختصات باشند (مانند مثال طبقهبندی مختصات دوبعدی ما) یا هیستوگرام پیکسلها و شمارش حلقهها (مانند مثال طبقهبندی ارقام ما)، اما میتوانند تصویربرداریهای خطی، ترجمهها و عملیات غیرخطی (مانند «همهٔ نقاطی را انتخاب کن که x > 0») و غیره نیز باشند. الگوریتمهای یادگیری ماشین معمولاً در یافتن این تبدیلها خلاق نیستند؛ آنها صرفاً در یک مجموعهٔ از پیش تعریفشده از عملیات، که فضای فرضیه نامیده میشود، جستجو میکنند. برای مثال، فضای تمام تغییرهای مختصات ممکن، فضای فرضیهٔ ما در مثال طبقهبندی مختصات دوبعدی خواهد بود.
پس این چیزی است که یادگیری ماشین است، بهطور مختصر: جستجوی بازنماییها و قواعد مفید روی برخی دادههای ورودی، در یک فضای از پیش تعریفشده از احتمالات، با استفاده از هدایت یک سیگنال بازخورد. این ایدهٔ ساده به ما امکان میدهد طیف قابلتوجهی از وظایف فکری را حل کنیم، از رانندگی خودکار تا پرسش و پاسخ زبان طبیعی.
اکنون که میدانید منظور ما از یادگیری چیست، بیایید نگاهی بیندازیم به آنچه یادگیری عمیق را خاص میکند.
«عمیق» در «یادگیری عمیق»
Section titled “«عمیق» در «یادگیری عمیق»”یادگیری عمیق یک زیرحوزهٔ خاص از یادگیری ماشین است؛ رویکرد جدیدی به یادگیری بازنماییها از داده است که بر یادگیری لایههای متوالی از بازنماییهای بهطور فزاینده معنادار تأکید دارد. «عمیق» در «یادگیری عمیق» اشاره به هیچ نوع درک عمیقتری که توسط این رویکرد به دست میآید ندارد؛ بلکه مخفف این ایده است که لایههای متوالی بازنماییها. اینکه چند لایه در یک مدل از داده سهم دارند عمق مدل نامیده میشود. نامهای مناسب دیگر برای این حوزه میتوانست یادگیری بازنماییهای لایهای یا یادگیری بازنماییهای سلسلهمراتبی باشد. یادگیری عمیق مدرن اغلب شامل دهها یا حتی صدها لایهٔ متوالی از بازنماییهاست و همهٔ آنها بهطور خودکار از طریق قرار گرفتن در معرض دادههای آموزشی یاد گرفته میشوند. در همین حال، سایر رویکردهای یادگیری ماشین تمایل دارند تنها بر یادگیری یک یا دو لایه از بازنماییهای داده تمرکز کنند (مثلاً گرفتن یک هیستوگرام پیکسلی و سپس اعمال یک قاعدهٔ طبقهبندی)؛ از این رو گاهی یادگیری کمعمق نامیده میشوند.
در یادگیری عمیق، این بازنماییهای لایهای از طریق مدلهایی به نام شبکههای عصبی یاد گرفته میشوند که در لایههای تحتاللفظی روی هم چیده شدهاند. اصطلاح شبکهٔ عصبی اشارهای به عصبشناسی است، اما اگرچه برخی از مفاهیم اصلی در یادگیری عمیق تا حدی با الهام از درک ما از مغز (بهویژه قشر بینایی) توسعه یافتهاند، مدلهای یادگیری عمیق مدلهای مغز نیستند. هیچ شواهدی وجود ندارد که مغز چیزی شبیه به مکانیزمهای یادگیری مورد استفاده در مدلهای یادگیری عمیق مدرن را پیادهسازی کند. ممکن است با مقالات علمی عامهپسند مواجه شوید که اعلام میکنند یادگیری عمیق مانند مغز کار میکند یا از مغز مدلسازی شده است، اما اینطور نیست. این برای تازهواردان به این حوزه گیجکننده و ضدبازده خواهد بود که فکر کنند یادگیری عمیق به هر شکلی با عصبشناسی مرتبط است؛ شما به آن هالهٔ رمز و راز «درست مثل ذهن ما» نیازی ندارید و میتوانید هر چیزی که دربارهٔ پیوندهای فرضی بین یادگیری عمیق و زیستشناسی خواندهاید را فراموش کنید. برای اهداف ما، یادگیری عمیق یک چارچوب ریاضی برای یادگیری بازنماییها از داده است.
بازنماییهایی که یک الگوریتم یادگیری عمیق یاد میگیرد چه شکلی هستند؟ بیایید بررسی کنیم که چگونه یک شبکهٔ چندلایه (شکل ۱.۵ را ببینید) یک تصویر از یک رقم را برای تشخیص اینکه چه رقمی است تبدیل میکند.
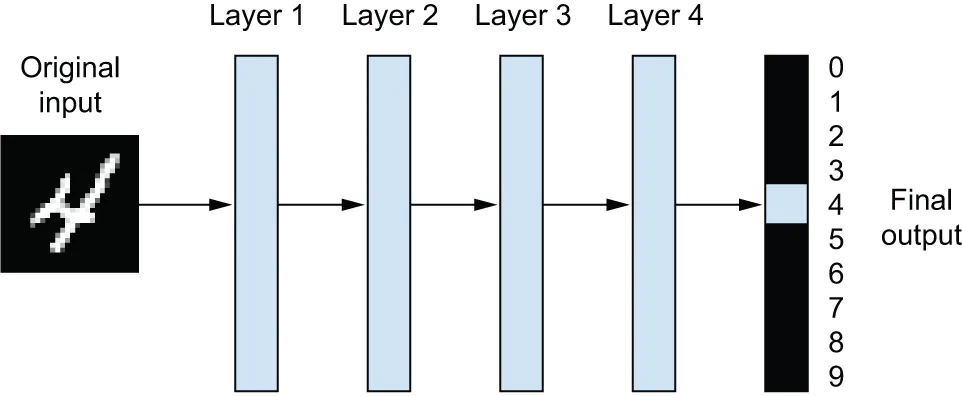
شکل ۱.۵: یک شبکهٔ عصبی عمیق برای طبقهبندی ارقام
همانطور که در شکل ۱.۶ میبینید، شبکه تصویر رقم را به بازنماییهایی تبدیل میکند که بهطور فزاینده از تصویر اصلی متفاوت و بهطور فزاینده دربارهٔ نتیجهٔ نهایی آموزنده هستند. میتوانید یک شبکهٔ عمیق را بهعنوان یک فرآیند چندمرحلهای تقطیر اطلاعات در نظر بگیرید، جایی که اطلاعات از فیلترهای متوالی عبور میکند و بهطور فزاینده تصفیهشده بیرون میآید (یعنی برای برخی وظایف مفید).
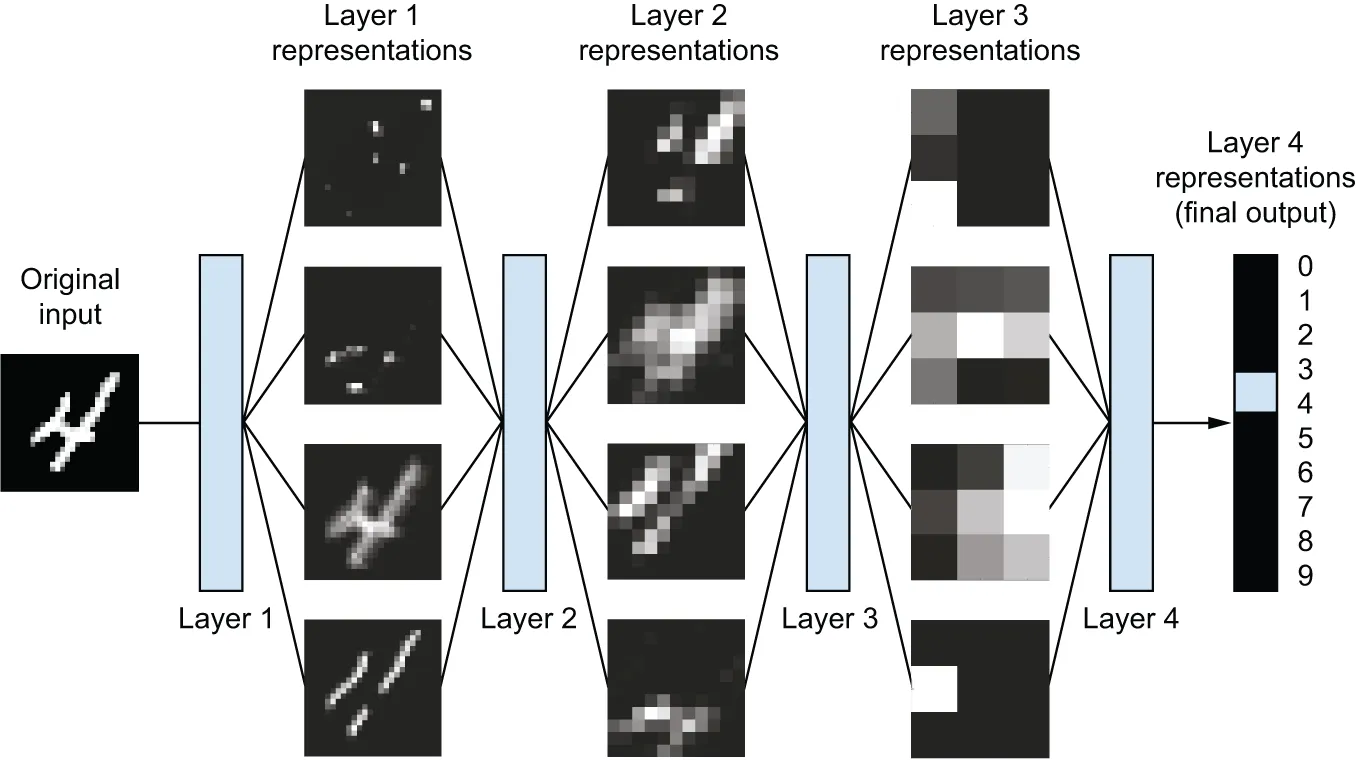
شکل ۱.۶: بازنماییهای عمیق یادگرفتهشده توسط یک مدل طبقهبندی ارقام
پس این چیزی است که یادگیری عمیق، از نظر فنی، هست: یک روش چندمرحلهای برای یادگیری بازنماییهای داده. این ایدهٔ سادهای است، اما همانطور که معلوم است، مکانیزمهای بسیار ساده، اگر بهاندازهٔ کافی مقیاسپذیر شوند، میتوانند شبیه جادو به نظر برسند.
درک نحوهٔ کار یادگیری عمیق در سه شکل
Section titled “درک نحوهٔ کار یادگیری عمیق در سه شکل”در این مرحله، میدانید که یادگیری ماشین دربارهٔ نگاشت ورودیها (مانند تصاویر) به اهداف (مانند برچسب «گربه») است، که با مشاهدهٔ نمونههای زیادی از ورودیها و اهداف انجام میشود. همچنین میدانید که شبکههای عصبی عمیق این نگاشت ورودی به هدف را از طریق یک توالی عمیق از تبدیلهای سادهٔ داده (لایهها) انجام میدهند و این تبدیلهای داده از طریق قرار گرفتن در معرض نمونهها یاد گرفته میشوند. حالا بیایید ببینیم این یادگیری چگونه بهطور عینی اتفاق میافتد.
مشخصات آنچه یک لایه با دادههای ورودی خود انجام میدهد در وزنهای لایه ذخیره میشود، که در اصل مجموعهای از اعداد هستند. از نظر فنی، میگوییم تبدیلی که یک لایه پیادهسازی میکند توسط وزنهایش پارامتری شده است (شکل ۱.۷ را ببینید). (وزنها گاهی اوقات پارامترهای یک لایه نیز نامیده میشوند.) در این زمینه، یادگیری به معنای یافتن مجموعهای از مقادیر برای وزنهای تمام لایههای یک شبکه است، بهگونهای که شبکه بهدرستی ورودیهای نمونه را به اهداف مرتبطشان نگاشت کند. اما نکته اینجاست: یک شبکهٔ عصبی عمیق میتواند دهها میلیون پارامتر داشته باشد. یافتن مقدار صحیح برای همهٔ آنها ممکن است کار دلهرهآوری به نظر برسد، بهویژه با توجه به اینکه تغییر مقدار یک پارامتر بر رفتار همهٔ پارامترهای دیگر تأثیر میگذارد!
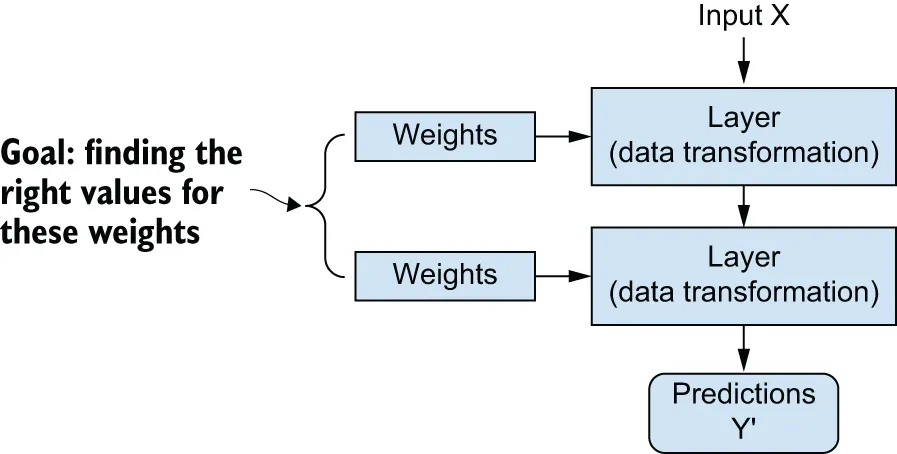
شکل ۱.۷: یک شبکهٔ عصبی توسط وزنهایش پارامتری میشود.
برای کنترل چیزی، ابتدا باید بتوانید آن را مشاهده کنید. برای کنترل خروجی یک شبکهٔ عصبی، باید بتوانید اندازهگیری کنید که این خروجی چقدر از آنچه انتظار داشتید فاصله دارد. این وظیفهٔ تابع زیان شبکه است که گاهی تابع هدف یا تابع زیان نیز نامیده میشود. تابع زیان پیشبینیهای شبکه و هدف واقعی (آنچه میخواستید شبکه خروجی دهد) را میگیرد و یک نمرهٔ فاصله محاسبه میکند که نشان میدهد شبکه در این مثال خاص چقدر خوب عمل کرده است (شکل ۱.۸ را ببینید).
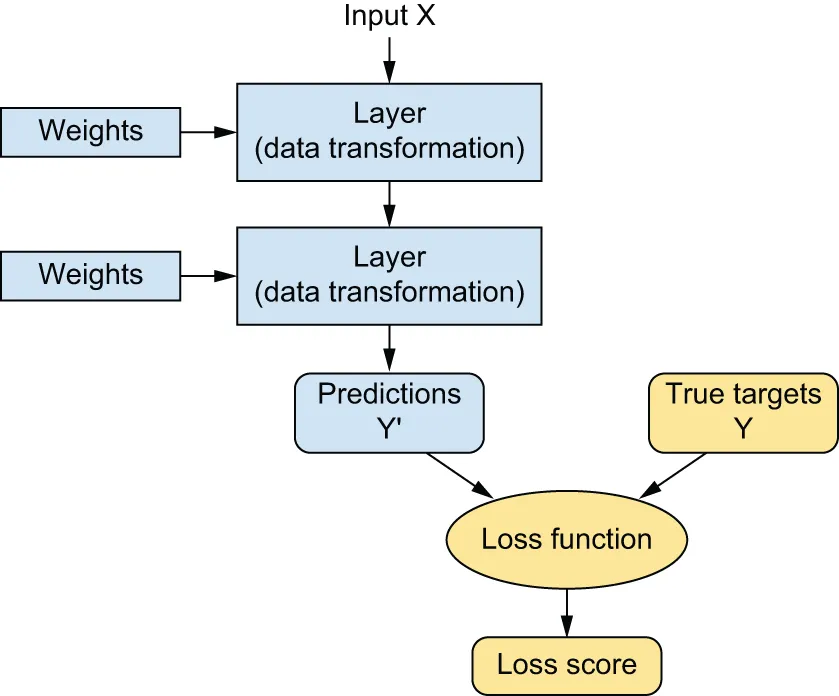
شکل ۱.۸: تابع زیان کیفیت خروجی شبکه را اندازهگیری میکند.
ترفند بنیادین در یادگیری عمیق استفاده از این نمره بهعنوان یک سیگنال بازخورد برای تنظیم مقدار وزنها به مقدار کمی، در جهتی است که نمرهٔ زیان را برای مثال فعلی کاهش میدهد (شکل ۱.۹ را ببینید). این تنظیم وظیفهٔ بهینهساز است که الگوریتم پسانتشار را پیادهسازی میکند: الگوریتم مرکزی در یادگیری عمیق. فصل بعد با جزئیات بیشتری توضیح میدهد که پسانتشار چگونه کار میکند.
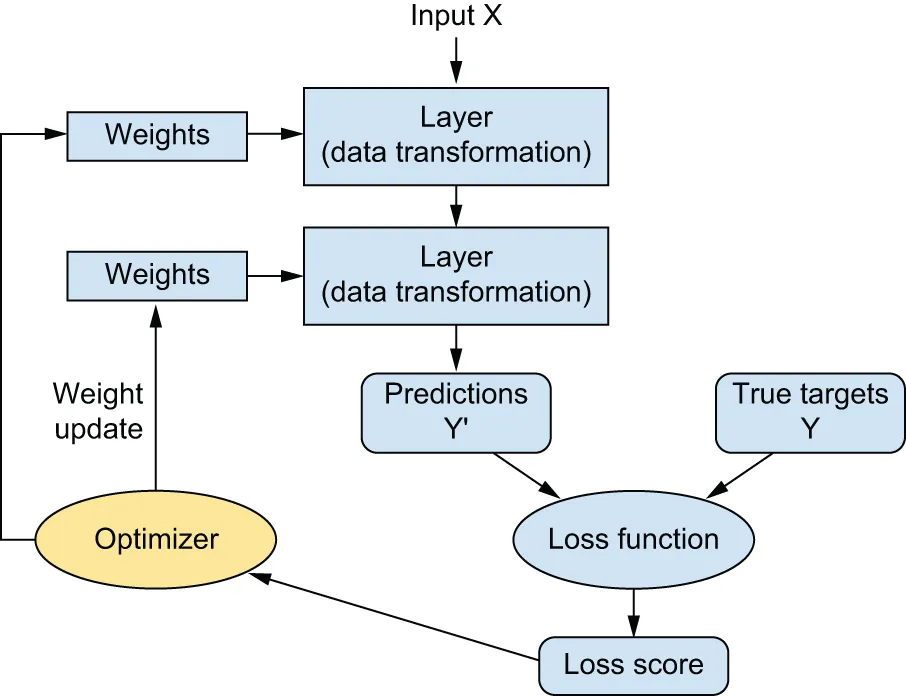
شکل ۱.۹: نمرهٔ زیان بهعنوان سیگنال بازخورد برای تنظیم وزنها استفاده میشود.
در ابتدا، وزنهای شبکه مقادیر تصادفی اختصاص مییابند، بنابراین شبکه صرفاً مجموعهای از تبدیلهای تصادفی را پیادهسازی میکند. طبیعتاً خروجی آن از آنچه در حالت ایدهآل باید باشد فاصلهٔ زیادی دارد و نمرهٔ زیان بر همین اساس بسیار بالا است. اما با هر مثالی که شبکه پردازش میکند، وزنها کمی در جهت صحیح تنظیم میشوند و نمرهٔ زیان کاهش مییابد. این حلقهٔ آموزش است که با تکرار به تعداد کافی (معمولاً دهها بار عبور از هزاران مثال)، مقادیر وزنی را به دست میدهد که تابع زیان را کمینه میکنند. شبکهای با کمترین زیان شبکهای است که خروجیهایش تا حد ممکن به اهداف نزدیک هستند: یک شبکهٔ آموزشدیده. یک بار دیگر، مکانیزمی ساده است که اگر مقیاسپذیر شود، شبیه جادو به نظر میرسد.
چه چیزی یادگیری عمیق را متفاوت میکند
Section titled “چه چیزی یادگیری عمیق را متفاوت میکند”آیا چیز خاصی در شبکههای عصبی عمیق وجود دارد که آنها را به رویکرد «درست» برای سرمایهگذاری شرکتها و هجوم محققان تبدیل میکند؟ آیا ۲۰ سال دیگر هنوز از شبکههای عصبی عمیق استفاده خواهیم کرد؟
یادگیری عمیق چندین ویژگی دارد که جایگاه آن را بهعنوان یک انقلاب هوش مصنوعی توجیه میکند و ماندگار است. ممکن است چند دهه بعد از شبکههای عصبی استفاده نکنیم، اما هر چیزی که استفاده کنیم مستقیماً از یادگیری عمیق مدرن و مفاهیم اصلی آن وارث خواهد بود. این ویژگیهای مهم را میتوان بهطور کلی به سه دسته تقسیم کرد:
- سادگی — یادگیری عمیق حل مسئله را بسیار آسانتر میکند، زیرا آنچه زمانی مهمترین مرحله در یک گردشکار یادگیری ماشین بود را خودکار میکند: مهندسی ویژگی. تکنیکهای قبلی یادگیری ماشین — یادگیری کمعمق — تنها شامل تبدیل دادههای ورودی به یکی دو فضای بازنمایی متوالی بودند، که برای بیشتر مسائل بهاندازهٔ کافی بیانگر نبود. به این ترتیب، انسانها مجبور بودند برای قابلپردازشتر کردن دادههای ورودی اولیه برای این روشها، کارهای زیادی انجام دهند: آنها مجبور بودند بازنماییهای خوبی را برای دادههای خود دستی مهندسی کنند. این مهندسی ویژگی نامیده میشود. یادگیری عمیق، از سوی دیگر، این مرحله را کاملاً خودکار میکند: با یادگیری عمیق، شما همهٔ ویژگیها را در یک گذر یاد میگیرید بهجای اینکه خودتان آنها را مهندسی کنید. این کار گردشکارهای یادگیری ماشین را بسیار ساده کرده و اغلب خطوط لولهٔ پیچیدهٔ چندمرحلهای را با یک مدل یادگیری عمیق سرتاسری ساده جایگزین میکند.
- مقیاسپذیری — یادگیری عمیق بهشدت برای موازیسازی روی GPUها یا سختافزار تخصصیتر یادگیری ماشین مناسب است، بنابراین میتواند از قانون مور بهطور کامل استفاده کند. علاوه بر این، مدلهای یادگیری عمیق با تکرار روی دستههای کوچک داده (batches) آموزش میبینند، و این امکان را میدهد که روی مجموعهدادههایی با اندازهٔ دلخواه آموزش ببینند. (تنها گلوگاه مقدار توان محاسباتی موازی در دسترس است که به لطف قانون مور، سدی است که بهسرعت در حال جابهجایی است.)
- همهکاره بودن و قابلیت استفادهٔ مجدد — برخلاف بسیاری از رویکردهای قبلی یادگیری ماشین، مدلهای یادگیری عمیق میتوانند روی دادههای اضافی آموزش ببینند بدون اینکه از صفر شروع کنند، و آنها را برای یادگیری پیوستهٔ آنلاین عملی میکند — ویژگی مهمی برای مدلهای تولیدی بسیار بزرگ. علاوه بر این، مدلهای یادگیری عمیق آموزشدیده قابل استفادهٔ مجدد و بازاستفاده هستند: این ایدهٔ بزرگ پشت «مدلهای بنیادی» است — مدلهای بزرگی که روی مقادیر عظیمی از داده آموزش دیدهاند، و میتوانند در بسیاری از وظایف جدید با آموزش مجدد کم یا حتی بدون هیچ آموزش مجددی استفاده شوند.
عصر هوش مصنوعی مولد
Section titled “عصر هوش مصنوعی مولد”شاید شناختهشدهترین نمونهٔ یادگیری عمیق امروزه، موج اخیر کاربردهای هوش مصنوعی مولد باشد — دستیارهای چتبات مانند ChatGPT، Gemini و Claude، و همچنین سرویسهای تولید تصویر مانند Midjourney. این برنامهها با توانایی خود در تولید محتوای آموزنده یا حتی خلاقانه در پاسخ به درخواستهای ساده، تخیل عمومی را به خود جلب کردهاند و مرزهای بین خلاقیت انسان و ماشین را محو کردهاند.
هوش مصنوعی مولد توسط «مدلهای بنیادی» بسیار بزرگی تقویت میشود که یاد میگیرند محتوای متن و تصویر تغذیهشده به آنها را بازسازی کنند — بازسازی یک تصویر واضح از یک نسخهٔ نویزی، پیشبینی کلمهٔ بعدی در یک جمله، و غیره. این بدان معناست که اهداف در شکل ۱.۸ از خود ورودی گرفته میشوند. این یادگیری خودنظارتی نامیده میشود و این مدلها را قادر میسازد از مقادیر عظیمی از دادههای بدون برچسب استفاده کنند. حذف حاشیهنویسیهای دستی داده که برندهای قبلی یادگیری ماشین را محدود کرده بود، سطحی از مقیاس را باز کرده است که هرگز دیده نشده بود — برخی از این مدلهای بنیادی صدها میلیارد پارامتر دارند و روی بیش از ۱ پتابایت داده آموزش دیدهاند، با هزینهای بالغ بر دهها میلیون دلار.
این مدلهای بنیادی بهعنوان نوعی پایگاه دادهٔ فازی از دانش بشری عمل میکنند، و آنها را برای طیف بسیار گستردهای از کاربردها بدون نیاز به برنامهنویسی خاص یا آموزش مجدد مناسب میسازند. از آنجا که آنها قبلاً چیزهای زیادی را حفظ کردهاند، میتوانند مسائل جدید را صرفاً از طریق پرامپتدهی حل کنند — پرسوجو از بازنماییهای دانشی که یاد گرفتهاند و بازگرداندن خروجی که بیشترین احتمال ارتباط با پرامپت شما را دارد.
هوش مصنوعی مولد تنها در سال ۲۰۲۲ به آگاهی جریان اصلی رسید، اما تاریخچهٔ طولانی دارد — اولین آزمایشها با تولید متن به دههٔ ۱۹۹۰ بازمیگردد. ویرایش اول این کتاب، که در سال ۲۰۱۷ منتشر شد، قبلاً یک فصل قابلتوجه با عنوان «هوش مصنوعی مولد» داشت که تکنیکهای تولید متن و تصویر آن زمان را بررسی میکرد و در همان حال وعدهٔ مفهوم عجیب آن زمان را میداد که «بهزودی» بخش زیادی از محتوای فرهنگی که مصرف میکنیم با کمک هوش مصنوعی ایجاد خواهد شد.
آنچه یادگیری عمیق تاکنون به دست آورده است
Section titled “آنچه یادگیری عمیق تاکنون به دست آورده است”در طول دههٔ گذشته، یادگیری عمیق چیزی کمتر از یک انقلاب فناوری به دست نیاورده است، که با نتایج قابلتوجه در وظایف ادراکی از ۲۰۱۳ تا ۲۰۱۷ آغاز شد، سپس پیشرفت سریع در وظایف پردازش زبان طبیعی از ۲۰۱۷ تا ۲۰۲۲، و در نهایت با موجی از کاربردهای متحولکنندهٔ هوش مصنوعی مولد از ۲۰۲۲ تاکنون به اوج رسید.
یادگیری عمیق پیشرفتهای عمدهای را ممکن ساخته است، همه در مسائل بسیار چالشبرانگیزی که مدتها از دسترس ماشینها دور مانده بودند:
- چتباتهای روان و بسیار همهکاره مانند ChatGPT و Gemini
- دستیارهای برنامهنویسی مانند GitHub Copilot
- تولید تصویر فوتورئالیستیک
- طبقهبندی تصویر در سطح انسان
- رونویسی گفتار در سطح انسان
- رونویسی دستنوشته و متن چاپی در سطح انسان
- ترجمهٔ ماشینی بهطور چشمگیری بهبودیافته
- تبدیل متن به گفتار بهطور چشمگیری بهبودیافته
- رانندگی خودکار در سطح انسان، که تا سال ۲۰۲۵ در فینیکس، سانفرانسیسکو، لسآنجلس و آستین برای عموم به کار گرفته شده است
- سیستمهای توصیهگر بهبودیافته، همانطور که YouTube، Netflix یا Spotify استفاده میکنند
- بازی Go، شطرنج و پوکر در سطح فوقانسانی
ما هنوز در حال بررسی گسترهٔ کامل آنچه یادگیری عمیق میتواند انجام دهد هستیم. ما شروع به اعمال آن با موفقیت زیاد در طیف گستردهای از مسائلی کردهایم که تصور میشد فقط چند سال پیش غیرقابل حل باشند — رونویسی خودکار دهها هزار نسخهٔ خطی باستانی نگهداریشده در آرشیو مخفی واتیکان، تشخیص و طبقهبندی بیماریهای گیاهی در مزارع با یک گوشی هوشمند ساده، کمک به متخصصان انکولوژی یا رادیولوژیستها در تفسیر دادههای تصویربرداری پزشکی، پیشبینی بلایای طبیعی مانند سیل، طوفان و حتی زلزله. با هر نقطهٔ عطف، به عصری نزدیکتر میشویم که یادگیری عمیق در هر فعالیت و هر زمینهٔ تلاش بشری به ما کمک میکند — علم، پزشکی، تولید، انرژی، حملونقل، توسعهٔ نرمافزار، کشاورزی و حتی آفرینش هنری.
مراقب هیاهوی کوتاهمدت باشید
Section titled “مراقب هیاهوی کوتاهمدت باشید”این زنجیرهٔ بهظاهر توقفناپذیر موفقیتها منجر به موجی از هیاهوی شدید شده است، که برخی از آن تا حدی مستند است، اما بیشتر آن فقط افسانههای خیالی است. در اوایل سال ۲۰۲۳، اندکی پس از انتشار GPT-4 توسط OpenAI، بسیاری از کارشناسان ادعا میکردند که «دیگر کسی نیازی به کار کردن ندارد» و بیکاری گسترده ظرف یک سال فرا خواهد رسید، یا اینکه بهرهوری اقتصادی بهزودی ۱۰ تا ۱۰۰ برابر افزایش مییابد. البته، دو سال بعد، هیچیک از اینها محقق نشده است — نرخ بیکاری در ایالات متحده پایین مانده است، در حالی که معیارهای بهرهوری بسیار دور از انفجار وعده داده شده هستند. سوءتفاهم نکنید: تأثیر هوش مصنوعی — بهویژه هوش مصنوعی مولد — در حال حاضر قابلتوجه است و بهطور قابلملاحظهای سریع رشد میکند. تا اواسط سال ۲۰۲۵، هوش مصنوعی مولد دهها میلیارد دلار درآمد سالانه تولید میکرد، که برای صنعتی که دو سال پیش وجود نداشت بسیار چشمگیر است! اما هنوز تأثیر چندانی در اقتصاد کلی ندارد و در مقایسه با وعدههای کاملاً بیمهار که در آغاز آن غرق شده بودیم ناچیز است.
در حالی که بحثها دربارهٔ بیکاری و افزایش ۱۰۰ برابری بهرهوری ناشی از هوش مصنوعی در حال ایجاد اضطراب است، جنبهٔ حتی هیجانانگیزتری از هیاهوی هوش مصنوعی وجود دارد. این جنبه، ظهور قریبالوقوع هوش عمومی در سطح انسان (AGI) یا حتی «فوق هوش» بسیار فراتر از تواناییهای انسانی را اعلام میکند. این ادعاها ترسهایی فراتر از اختلال اقتصادی را دامن میزنند — ممکن است خود گونهٔ انسان در خطر جایگزینی با آفریدههای دیجیتال ما باشد.
ممکن است وسوسهانگیز باشد که تازهواردان به این حوزه فرض کنند که موفقیتهای عملی هوش مصنوعی مولد باعث ایمان به AGI نزدیک شده است، اما در واقع برعکس است. ادعاهای AGI نزدیک ابتدا آمدند و بهطور قابلتوجهی به ظهور هوش مصنوعی مولد کمک کردند. در اوایل سال ۲۰۱۳، ترسهایی در میان نخبگان فناوری وجود داشت که AGI ممکن است ظرف چند سال فرا برسد. در آن زمان، ایده این بود که DeepMind، یک استارتاپ تحقیقاتی هوش مصنوعی لندن که توسط گوگل خریداری شد، در مسیر دستیابی به آن بود. این باور نیروی محرکهٔ تأسیس OpenAI در سال ۲۰۱۵ بود، که در ابتدا قصد داشت یک وزنهٔ متعادلکنندهٔ متنباز برای DeepMind باشد. OpenAI نقش حیاتی در شروع هوش مصنوعی مولد ایفا کرد، بنابراین در یک پیچ عجیب، این باور به AGI نزدیک بود که ظهور هوش مصنوعی مولد را تقویت کرد، نه برعکس. در سال ۲۰۱۶، پیشنهاد جذب OpenAI این بود که تا سال ۲۰۲۰ به AGI دست خواهد یافت! انصافاً، در آن زمان فقط اقلیتی از افراد در صنعت فناوری به چنین جدول زمانی خوشبینانهای اعتقاد داشتند. با این حال، تا اوایل سال ۲۰۲۳، بخش قابلتوجهی از مهندسان در منطقهٔ خلیج سانفرانسیسکو ظاهراً متقاعد شده بودند که AGI ظرف چند سال آینده فرا خواهد رسید.
حیاتی است که به چنین ادعاهایی با دوز سالمی از شک گرایش داشته باشید. با وجود نامش، «هوش مصنوعی» امروزی بهطور دقیقتر بهعنوان «خودکارسازی شناختی» توصیف میشود — کدگذاری و عملیاتیسازی مهارتها و دانش انسانی. هوش مصنوعی در حل مسائلی با الزامات محدود یا مسائلی که نمونههای دقیق فراوان در دسترس است عالی است. این دربارهٔ تقویت تواناییهای کامپیوترهاست، نه تکرار ذهن انسان.
برای روشن بودن، خودکارسازی شناختی فوقالعاده مفید است. اما هوش — خودمختاری شناختی — موجودیت متفاوتی است. اینگونه فکر کنید: هوش مصنوعی مانند یک شخصیت کارتونی است، در حالی که هوش مانند یک موجود زنده است. یک کارتون، مهم نیست چقدر واقعگرایانه باشد، تنها میتواند صحنههایی را که برای آن کشیده شده بازی کند. یک موجود زنده، از سوی دیگر، میتواند خود را با غیرمنتظره وفق دهد.
ممکن است بپرسید: «اگر کارتون با واقعگرایی کافی کشیده شود و صحنههای کافی را پوشش دهد، چه تفاوتی وجود دارد؟» اگر یک مدل زبان بزرگ بتواند وقتی از آن سؤال میشود پاسخ بهاندازهٔ کافی شبیه انسان تولید کند، آیا مهم است که دارای خودمختاری شناختی واقعی باشد؟ تفاوت کلیدی سازگاری است. هوش توانایی رویارویی با ناشناخته، سازگاری با آن و یادگیری از آن است. خودکارسازی، حتی در بهترین حالت، تنها میتواند موقعیتهایی را که برای آن آموزش دیده یا برنامهنویسی شده مدیریت کند. به همین دلیل است که ایجاد خودکارسازی قوی اینقدر چالشبرانگیز است — نیازمند در نظر گرفتن هر سناریوی ممکن است.
پس نگران نباشید که هوش مصنوعی ناگهان خودآگاه شود و بشریت را تسخیر کند. فناوری امروزی بهسادگی در آن جهت پیش نمیرود. حتی با پیشرفتهای چشمگیر، هوش مصنوعی یک ابزار پیچیده باقی خواهد ماند، نه یک موجود هوشیار. این مانند انتظار سفر در زمان از یک ساعت بهتر است — آنها کاملاً چیزهای متفاوتی هستند.
تابستان میتواند به زمستان تبدیل شود
Section titled “تابستان میتواند به زمستان تبدیل شود”خطر انتظارات کوتاهمدت متورم این است که وقتی فناوری بهناچار کمتر از انتظار ظاهر شود، سرمایهگذاری تحقیقاتی میتواند خشک شود و پیشرفت را برای مدت طولانی کند کند. این قبلاً اتفاق افتاده است. دو بار در گذشته، هوش مصنوعی چرخهای از خوشبینی شدید و سپس ناامیدی و تردید را تجربه کرد، که نتیجهٔ آن کمبود بودجه بود. با هوش مصنوعی نمادین در دههٔ ۱۹۶۰ شروع شد. در آن روزهای اولیه، پیشبینیها دربارهٔ هوش مصنوعی بسیار بالا بود. یکی از شناختهشدهترین پیشگامان و طرفداران رویکرد هوش مصنوعی نمادین، ماروین مینسکی بود که در سال ۱۹۶۷ ادعا کرد: «در طول یک نسل… مسئلهٔ ایجاد “هوش مصنوعی” بهطور اساسی حل خواهد شد.» سه سال بعد، در سال ۱۹۷۰، او پیشبینی دقیقتری ارائه داد: «ظرف سه تا هشت سال ما ماشینی با هوش عمومی یک انسان متوسط خواهیم داشت.» در سال ۲۰۲۵، چنین دستاوردی هنوز دور از دسترس به نظر میرسد — آنقدر دور که هیچ راهی برای پیشبینی مدت زمان آن نداریم — اما در دههٔ ۱۹۶۰ و اوایل دههٔ ۱۹۷۰، چندین کارشناس معتقد بودند که در شرف وقوع است (همانطور که امروزه بسیاری معتقدند). چند سال بعد، با محقق نشدن این انتظارات بالا، محققان و بودجههای دولتی از این حوزه روی گرداندند و آغاز اولین زمستان هوش مصنوعی را رقم زدند (اشارهای به زمستان هستهای، زیرا این مدت کوتاهی پس از اوج جنگ سرد بود).
این آخرین بار نبود. در دههٔ ۱۹۸۰، رویکرد جدیدی به هوش مصنوعی نمادین، سیستمهای خبره، در میان شرکتهای بزرگ شروع به رشد کرد. چند داستان موفقیت اولیه موجی از سرمایهگذاری را برانگیخت و شرکتها در سراسر جهان بخشهای هوش مصنوعی داخلی خود را برای توسعهٔ سیستمهای خبره راهاندازی کردند. حدود سال ۱۹۸۵، شرکتها سالانه بیش از ۱ میلیارد دلار روی این فناوری خرج میکردند؛ اما تا اوایل دههٔ ۱۹۹۰، این سیستمها نگهداری گران، مقیاسپذیری دشوار و دامنهٔ محدودی داشتند و علاقه به آنها فروکش کرد. بدین ترتیب دومین زمستان هوش مصنوعی آغاز شد. ممکن است در حال حاضر شاهد سومین چرخهٔ هیاهو و ناامیدی هوش مصنوعی باشیم — و ما هنوز در مرحلهٔ خوشبینی شدید هستیم.
دیدگاه فعلی من این است که بعید است شاهد عقبنشینی کامل از تحقیقات هوش مصنوعی مانند آنچه در دههٔ ۱۹۹۰ دیدیم باشیم. اگر زمستانی در کار باشد، باید بسیار ملایم باشد. هوش مصنوعی قبلاً ارزش جهانشمول خود را نشان داده است. با این حال، به نظر اجتنابناپذیر است که مقداری از باد از حباب هوش مصنوعی ۲۰۲۳-۲۰۲۴ خارج شود. در حال حاضر، سرمایهگذاری در هوش مصنوعی، عمدتاً در مراکز داده و GPUها، سالانه از ۱۰۰ میلیارد دلار فراتر میرود، در حالی که تولید درآمد بهطور قابلملاحظهای عقبتر است، نزدیک به ۱۰ میلیارد دلار. هوش مصنوعی در حال حاضر توسط مدیران اجرایی و سرمایهگذاران نه بر اساس آنچه به انجام رسانده، بلکه بر اساس آنچه به ما گفته میشود ممکن است بهزودی قادر به انجام آن باشد قضاوت میشود — که بخش زیادی از آن بهطور پایدار از دسترس فناوریهای موجود خارج خواهد ماند. چیزی باید کوتاه بیاید. اما اینکه دقیقاً با تخلیهٔ حباب هوش مصنوعی چه اتفاقی خواهد افتاد هنوز نامشخص است.
وعدهٔ هوش مصنوعی
Section titled “وعدهٔ هوش مصنوعی”اگرچه ممکن است انتظارات کوتاهمدت غیرواقعی برای هوش مصنوعی داشته باشیم، تصویر بلندمدت روشن به نظر میرسد. ما تازه شروع به اعمال یادگیری عمیق در بسیاری از مسائل مهمی کردهایم که میتواند برای آنها متحولکننده باشد، از تشخیصهای پزشکی تا دستیارهای دیجیتال.
در سال ۲۰۱۷، در همین کتاب نوشتم:
در حال حاضر، ممکن است باور این سخت باشد که هوش مصنوعی بتواند تأثیر بزرگی بر جهان ما داشته باشد، زیرا هنوز بهطور گسترده مستقر نشده است — بسیار شبیه به سال ۱۹۹۵ که باور به تأثیر آیندهٔ اینترنت دشوار بود. در آن زمان، بیشتر مردم نمیدیدند که اینترنت چگونه به آنها مربوط میشود و چگونه زندگیشان را تغییر خواهد داد. همینطور در مورد یادگیری عمیق و هوش مصنوعی امروز صادق است. اما اشتباه نکنید: هوش مصنوعی در راه است. در آیندهٔ نهچندان دور، هوش مصنوعی دستیار شما، حتی دوست شما خواهد بود؛ به سؤالات شما پاسخ میدهد، به آموزش فرزندانتان کمک میکند و مراقب سلامتی شما خواهد بود. مواد غذایی شما را به در خانهتان تحویل میدهد و شما را از نقطهٔ A به نقطهٔ B میبرد. رابط شما با دنیایی بهطور فزاینده پیچیده و اطلاعاتمحور خواهد بود. و حتی مهمتر، هوش مصنوعی به بشریت بهعنوان یک کل کمک میکند تا پیش برود، با کمک به دانشمندان انسانی در اکتشافات پیشگامانهٔ جدید در تمام زمینههای علمی، از ژنومیک تا ریاضیات.
با پرش به سال ۲۰۲۵، بیشتر این چیزها یا محقق شدهاند یا در آستانهٔ تحقق هستند — و این فقط شروع است:
- دهها میلیون نفر روزانه از چتباتهای هوش مصنوعی مانند ChatGPT، Gemini و Claude بهعنوان دستیار استفاده میکنند. در واقع، پرسش و پاسخ و «آموزش فرزندانتان» (کمک به تکالیف) بهعنوان کاربردهای برتر این چتباتها ظاهر شدهاند! برای بسیاری از مردم، هوش مصنوعی در حال حاضر رابط اصلی با اطلاعات جهان است.
- صدها هزار نفر با «دوستان» هوش مصنوعی در برنامههایی مانند Character.ai تعامل دارند.
- رانندگی خودکار کامل قبلاً در مقیاس در شهرهایی مانند فینیکس، سانفرانسیسکو، لسآنجلس و آستین مستقر شده است.
- هوش مصنوعی در حال پیشرفتهای عمدهای برای کمک به تسریع علم است. مدل AlphaFold از DeepMind به زیستشناسان کمک میکند تا ساختار پروتئینها را با دقت بیسابقهای پیشبینی کنند. ریاضیدان برجسته ترنس تائو معتقد است که تا حدود سال ۲۰۲۶، هوش مصنوعی میتواند در صورت استفادهٔ مناسب، به یک همنویسندهٔ قابلاعتماد در تحقیقات ریاضی و سایر زمینهها تبدیل شود.
انقلاب هوش مصنوعی، که زمانی یک رؤیای دور بود، اکنون بهسرعت در برابر چشمان ما در حال آشکار شدن است. در این مسیر، ممکن است با چند ناکامی روبرو شویم — بسیار شبیه به اینکه صنعت اینترنت در سالهای ۱۹۹۸-۱۹۹۹ بیشازحد تبلیغ شد و از سقوطی رنج برد که سرمایهگذاری را در سراسر اوایل دههٔ ۲۰۰۰ خشکاند. اما ما در نهایت به آنجا خواهیم رسید. هوش مصنوعی در نهایت تقریباً در هر فرآیندی که جامعه و زندگی روزمرهٔ ما را میسازد به کار گرفته خواهد شد، بسیار شبیه به اینترنت امروز.
هیاهوی کوتاهمدت را باور نکنید، اما به دیدگاه بلندمدت ایمان داشته باشید. ممکن است مدتی طول بکشد تا هوش مصنوعی به پتانسیل واقعی خود مستقر شود — پتانسیلی که هیچکس هنوز جرأت نداشته است گسترهٔ کامل آن را در خواب ببیند — اما هوش مصنوعی در راه است و جهان ما را به شکلی خارقالعاده متحول خواهد کرد.
حق نشر متن اصلی: ©۲۰۲۵ Manning Publications، François Chollet و Matthew Watson. این صفحه ترجمهی فارسی است؛ متن اصلی را در deeplearningwithpython.io بخوانید یا نسخهی چاپی را از Manning بخرید.
Footnotes
Section titled “Footnotes”-
A. M. Turing, “Computing Machinery and Intelligence,” Mind 59, no. 236 (1950): 433-460. ↩
-
اگرچه آزمون تورینگ گاهی بهعنوان یک آزمون تحتاللفظی تفسیر شده است — هدفی که حوزهٔ هوش مصنوعی باید برای رسیدن به آن تلاش کند — تورینگ صرفاً آن را بهعنوان یک ابزار مفهومی در یک بحث فلسفی دربارهٔ ماهیت شناخت در نظر داشت. ↩
مقدمهای بر یادگیری عمیق، آموزش رایگان و فارسی یادگیری عمیق.